쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
86건 · "정규화"조건 지우기 ×
001 21:11 당일 +331 AI 코딩 에이전트를 위한 로컬 영상 편집기 FFmpeg-Skill 공개 Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. AI · 머신러닝 · kajisho5/ffmpeg-skill · Python
Key Point 클라우드나 API 키 없이 로컬에서 실행되며 에이전트가 정확하게 영상 편집을 수행할 수 있도록 설계된 도구라, AI 코딩 에이전트의 멀티모달 기능 확대와 오프라인 작업 흐름에 영향을 미친다.
핵심 요약
Claude Code, Cursor, Codex와 같은 코딩 에이전트가 사용할 수 있는 로컬 영상 편집 도구 FFmpeg-Skill이 공개되었다. 42개의 FFmpeg 도구를 제공하며, 클라우드나 API 키 없이 Python 표준 라이브러리만으로 동작한다. 각 도구는 명확한 입력 스키마를 가진 argparse 기반 스크립트로, 쉘 명령어 대신 타입이 지정된 인자로 작동한다. 전체 요약 13문장 읽기 → 002 03:11 ▲ 137 · 댓글 39 파이어폭스, 브라우저 핑거프린팅 방어 강화 파이어폭스가 쿠키 없이도 사용자를 추적하는 브라우저 핑거프린팅 기법에 대한 방어를 강화했다. 보안 · Open research, stronger privacy: Making Firefox users harder to fingerprint
Key Point 쿠키 없는 사용자 추적 기술에 대한 구체적인 방어 방식과 그 효과를 실제 데이터로 입증한 연구로, 브라우저 개인정보보호의 기술적 진전을 보여준다.
핵심 요약
파이어폭스가 쿠키 없이도 사용자를 추적하는 브라우저 핑거프린팅 기법에 대한 방어를 강화했다. 화면 해상도, 프로세서 개수 등 추적 스크립트가 의존하는 특정 브라우저 정보를 제한하고 정규화해 사용자들이 더 유사해 보이도록 만든다. 모질라는 약 2,500만 명의 파이어폭스 사용자 데이터를 바탕으로 연구했으며, OHTTP 릴레이를 통해 IP 주소와 요청 내용을 분리하고 수집 후 수개월 뒤 개별 데이터를 삭제했다. 전체 요약 9문장 읽기 → 003 15:11 ▲ 15 · 댓글 4 깊은 신경망의 정보 손실을 잡다, DepthGraft 기법 LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다. AI · 머신러닝 · DepthGraft: Structural Regularization through Hierarchical Cross-Layer KV Reconstruction
Key Point 모델의 깊이를 키우면서 정보 손실을 막고 캐시를 줄일 수 있는 구조적 기법이 제시되어, 더 효율적인 초대형 언어모델 개발에 실질적 가능성을 보여준다.
핵심 요약
LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다. 교차 계층 연결은 이 문제를 완화하지만 기존 방식은 계산이나 메모리 접근을 추가로 늘린다. 연구팀은 교차 계층 KV(Key-Value) 공유 방식을 효율적인 연결 방법으로 재검토했으며, KV 재사용이 깊은 계층에서 얕은-중간 계층의 KV 생성으로 직접 기울기 경로를 만들어 KV 표현 구조를 정규화한다는 점을 발견했다. 전체 요약 9문장 읽기 → 004 18:11 ▲ 70 · 댓글 2 3D 가우시안 스플래팅, 장면 규모 차이 극복하다 기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. AI · 머신러닝 · SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes
Key Point 3D 장면 재구성의 핵심 문제인 규모 변화에 대한 보다 견고한 해결책을 제시해 3DGS 기반 응용 분야에서 일반화 성능을 높일 수 있다.
핵심 요약
기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. 이 불일치로 인해 가우시안 스케일 타겟에 체계적 편향이 생기고 학습 신호가 모호해지는 문제가 발생한다. SplatAnything은 Gaussian Spacing Normalization(GSNorm)을 도입해 장면 수준의 가우시안 간격 통계를 정규화하고 예측을 위한 일관된 공간 기준을 제공한다. 전체 요약 5문장 읽기 → 005 18:15 ▲ 12 · 댓글 8 선형 어텐션의 게이팅과 읽기 방식을 개선한 Muir 제안 선형 어텐션은 맥락을 고정 크기의 키-값 상태로 압축해 선형 시간 학습과 상수 메모리 추론을 가능하게 한다. AI · 머신러닝 · Muir: Linear Attention with Sensitivity-Allocated Gating and Matched-Filter Readout
Key Point 선형 어텐션의 상태 업데이트 민감도 비대칭을 처음 분석하고 이를 바탕으로 설계한 Muir가 Transformer와 최신 모델을 능가하는 성능을 달성했으며, 수백만 토큰 외삽까지 안정적으로 동작해 장문맥 모델의 새로운 방향을 제시한다.
핵심 요약
선형 어텐션은 맥락을 고정 크기의 키-값 상태로 압축해 선형 시간 학습과 상수 메모리 추론을 가능하게 한다. 기존 Gated DeltaNet-2(GDN-2)는 채널별 감쇠와 분리된 전체 계수 지우기·쓰기 게이트를 사용하는데, 저자들은 상태 업데이트가 쓰기보다 지우기에 훨씬 덜 민감함을 발견했다. 키 활성화와 단위 정규화가 키 에너지를 채널의 희소 부분집합에 집중시키는 반면, 값 쓰기는 모든 채널을 스케일링하므로 지우기 게이트는 더 낮은 계수로 매개변수화될 수 있다. 전체 요약 10문장 읽기 → 006 12:11 ▲ 104 · 댓글 88 촘스키 vs 확률 모델, 언어학의 두 문화 촘스키의 확률 모델 비판에 대해 핑커의 질문으로부터 출발한 에세이로, 통계 모델의 성공 이유를 다룬다. AI · 머신러닝 · Chomsky and the two cultures of statistical learning (2011)
Key Point 통계 기반 언어 모델의 지배적 성공이 정당한지, 아니면 촘스키 식 형식 이론이 올바른 길인지를 놓고 벌어진 언어학의 근본적 논쟁을 명확히 이해할 수 있다.
핵심 요약
촘스키의 확률 모델 비판에 대해 핑커의 질문으로부터 출발한 에세이로, 통계 모델의 성공 이유를 다룬다. 2차 마르코프 모델로 10만 개 어휘를 표현하려면 1경(10¹⁵) 개의 확률값이 필요하며, 이는 데이터 통계 학습과 평활화 기법 없이는 불가능하다. 이상 기체 법칙처럼 확률·통계 모델이 현실을 완벽히 설명하지 못해도 정확한 예측과 통찰력을 제공할 수 있음을 보인다. 전체 요약 10문장 읽기 → 007 00:11 새 버전 Tailwind CSS 4.3.5 릴리스, 성능 개선 및 버그 수정 함수형 variant 값이 많은 프로젝트에서 정규화 성능을 개선했습니다. 웹 · 프론트엔드 · tailwindlabs/tailwindcss@v4.3.5
Key Point 많은 variant 값을 다루는 프로젝트와 WebContainers 환경에서 발생하던 성능 저하와 안정성 문제가 개선되어 더 안정적인 빌드 환경을 제공합니다.
핵심 요약
함수형 variant 값이 많은 프로젝트에서 정규화 성능을 개선했습니다. color-mix() 함수에서 색상 보간 방식이 없을 때 크래시나 잘못된 폴백을 생성하는 문제를 수정했습니다. @tailwindcss/oxide-wasm32-wasi가 무한 대기 상태(NAPI_RS_FORCE_WASI=error, WebContainers 등)에서 로드되지 않는 문제를 해결했습니다. 전체 요약 7문장 읽기 → 008 12:54 ▲ 11 · 댓글 2 루프 구조 언어 모델 Dory1.0-4B 공개, 작은 규모로 더 큰 모델 능력 구현 Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. AI · 머신러닝 · Dory1.0-4B: A Looped Normalized-GPT
Key Point 작은 규모 모델이 루프 구조를 통해 더 큰 모델 수준의 성능을 달성할 수 있다는 것을 보여주며, 토큰 생성 효율과 메모리 사용 최적화 방식이 에지 디바이스와 추론 비용 절감에 영향을 미친다.
핵심 요약
Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. 정규화 Transformer 기반으로 입력 블록, 공유 루프 블록, 출력 블록으로 구성하며, 추론 시 루프 블록을 가변 횟수로 반복 실행할 수 있다. 6조 개 토큰으로 사전 학습했으며, 초기 4.5조 토큰은 NVFP4 양자화로 학습했고 이후 컨텍스트 길이를 256K로 확장했다. 전체 요약 9문장 읽기 → 009 21:11 ▲ 21 · 댓글 3 LLM 자기증류 학습의 메모리 효율을 높인 뮤온 최적화 기법 자기증류(Self-Distillation) 방식의 LLM 학습에서 지수이동평균(EMA) 기반 교사 모델이 이미 학생 업데이트 이력을 보유하고 있는데도 기존 뮤온 옵티마이저는 별도의 모멘텀 버퍼를 유지해 메모리를 낭비한다. AI · 머신러닝 · MUON-RT Reusing the Teacher's Trajectory for Momentum-Free Muon for LLM Self-Distillation
Key Point 메모리 오버헤드를 크게 줄이면서도 LLM 학습 성능을 개선하는 옵티마이저 개선으로, 제한된 리소스에서 대규모 모델을 학습하려는 개발자들에게 직접적인 영향이 있다.
핵심 요약
자기증류(Self-Distillation) 방식의 LLM 학습에서 지수이동평균(EMA) 기반 교사 모델이 이미 학생 업데이트 이력을 보유하고 있는데도 기존 뮤온 옵티마이저는 별도의 모멘텀 버퍼를 유지해 메모리를 낭비한다. 뮤온-알티(Muon-RT)는 교사-학생 간 변위(displacement)를 재사용해 숨겨진 가중치 행렬의 모멘텀 버퍼를 제거한다. 이 변위가 적용된 업데이트의 지수가중 이력을 인코딩하며 시간적으로 상관없는 노이즈를 평활한다는 것을 로컬 모델 가정 하에서 증명했다. 전체 요약 7문장 읽기 → 010 18:13 ▲ 25 · 댓글 2 동영상 감정 표현 평가하는 자기진화형 보상 체계 EmoReward GRPO가 코드와 수학 같은 검증 가능한 영역에서는 성과를 냈지만, 동영상의 감정 표현 평가는 주관적 미학에 의존해 객관적 평가 기준이 없는 문제가 있었다. AI · 머신러닝 · EmoReward: Self-Evolving Reward Calibration for Emotional Video Generation RL
Key Point 감정 표현이 있는 동영상 생성을 평가하려면 기존 고정 보상 방식보다 상황에 맞는 적응형 평가 체계가 필요한데, EmoReward가 학습 과정 자체에서 보상의 신뢰도를 학습해 자동으로 가중치를 조정하는 방법을 제시한다.
핵심 요약
GRPO가 코드와 수학 같은 검증 가능한 영역에서는 성과를 냈지만, 동영상의 감정 표현 평가는 주관적 미학에 의존해 객관적 평가 기준이 없는 문제가 있었다. 기존 방식은 시각 품질, 모션 품질, 텍스트 정렬에 고정된 보상을 사용해 감정 의도를 제대로 포착하지 못했고, 보상 조작 위험이 있으며, RLHF는 확장이 어렵고 개인 미학 차이에 따라 보정이 복잡해진다. EmoReward는 실제 학습 중에 수집한 보상 추적에서 증거 신뢰도를 추출해 다음 학습에서 다중 보상 가중치를 적응적으로 조정하는 자기진화 메커니즘을 제안한다. 전체 요약 8문장 읽기 → 011 09:11 ▲ 167 · 댓글 21 생성형 AI의 수학적 기초를 다룬 입문서 출간 Tianhua Chen이 생성형 AI의 수학적 기초를 다루는 195페이지 분량의 입문서를 arXiv에 공개했다. AI · 머신러닝 · The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer
Key Point 생성형 AI를 체계적으로 학습하려는 개발자나 연구자에게 PCA부터 최신 모델까지 일관된 수학적 기초를 제공하는 교재가 생겼다는 점이 중요하다.
핵심 요약
Tianhua Chen이 생성형 AI의 수학적 기초를 다루는 195페이지 분량의 입문서를 arXiv에 공개했다. 이 책은 주요 생성 모델들(PCA, 확률적 PCA, 변분 오토인코더, 확산 모델, 정규화 흐름, 자기회귀 모델, GAN, Wasserstein GAN, 에너지 기반 모델)을 연결하는 일관된 경로를 제시한다. 도출 과정을 중심으로 구성되어 최근의 모든 아키텍처나 구현 세부사항을 다루기보다는 생성 모델링의 구조를 수학적 엄밀함을 잃지 않으면서 이해하기 쉽게 만드는 데 초점을 맞췄다. 전체 요약 6문장 읽기 → 012 03:11 ▲ 100 · 댓글 58 유니코드 문자로 도메인 해킹하기 유니코드의 특수 기호 중에는 TLD(최상위 도메인)로 정규화되는 것들이 있다. 예를 들어 ℡(전화 기호)는 .tel 도메인으로, №(번호 기호)는 .no 도메인으로 변환된다. 웹 · 프론트엔드 · Domain hacks with unusual Unicode characters (2018)
Key Point 유니코드를 이용한 도메인 변형이 모든 최신 브라우저에서 작동하지만 소셜 미디어 플랫폼에서 인식되지 않는 차이가 있으며, 보안 필터 우회라는 실제 위협으로도 작용할 수 있다는 점이 중요하다.
핵심 요약
유니코드의 특수 기호 중에는 TLD(최상위 도메인)로 정규화되는 것들이 있다. 예를 들어 ℡(전화 기호)는 .tel 도메인으로, №(번호 기호)는 .no 도메인으로 변환된다. 이 특성을 이용하면 일반 도메인에서도 https://edent.℡/ 같은 유니코드 문자를 포함한 URL을 만들 수 있으며, 이는 모든 최신 브라우저에서 작동한다. 도메인 어디든지 특수 기호를 사용할 수 있다. Script(𝒮𝒸𝓇𝒾𝓅𝓉), Math Bold(𝐞𝐱𝐚𝐦𝐩𝐥𝐞), Fraktur(𝖋𝖎𝖘𝖕), Superscript(ᵉˣᵃᵐᵖˡᵉ), Subscript(ₑₓₐₘₚₗₑ) 등 다양한 Unicode 문자 집합을 적용할 수 있다. 전체 요약 8문장 읽기 → 013 21:11 당일 +101 Limusic, YouTube Music의 경량 네이티브 데스크톱 클라이언트 Rust와 Tauri로 만든 YouTube Music 데스크톱 클라이언트로, Electron 없이 YouTube의 내부 API에 직접 접속해 음악을 스트리밍한다. 오픈소스 · 도구 · SimoHypers/limusic · Rust
Key Point Electron 없이 Rust와 Tauri로 가볍게 구현한 YouTube Music 클라이언트로, 광고 제거와 함께 기존 웹 앱보다 훨씬 더 풍부한 기능을 제공하는 오픈소스 대안이다.
핵심 요약
Rust와 Tauri로 만든 YouTube Music 데스크톱 클라이언트로, Electron 없이 YouTube의 내부 API에 직접 접속해 음악을 스트리밍한다. 광고 없는 재생, 검색·브라우징, Google 계정 로그인 또는 쿠키 입력을 통한 다중 계정 지원, 플레이리스트 및 좋아요 노래 관리 등의 기능을 제공한다. 가사는 Boidu, LRCLIB, YouTube Music, Netease, QQ Music, Kugou에서 가져오며 단어 단위 타이밍과 번역을 지원한다. 전체 요약 12문장 읽기 → 014 18:11 ▲ 19 · 댓글 2 확산 모델 가속, 게이트 재구성에서 비롯된다 REPA, dispersive regularization 등 확산 트랜스포머 학습 가속 기법들이 작동하는 방식을 재검토한 논문이다. AI · 머신러닝 · No Channels Left Behind: Understanding Diffusion Acceleration through Residual Gates
Key Point 확산 모델 가속의 진짜 메커니즘이 특성 구조가 아닌 잔차 게이트 재구성에서 비롯되며, 이를 정량화하고 개선하는 새로운 방법을 제시한다.
핵심 요약
REPA, dispersive regularization 등 확산 트랜스포머 학습 가속 기법들이 작동하는 방식을 재검토한 논문이다. 기존에는 추가 감독(auxiliary objectives), 공간 구조 우선순위, 개선된 특성 기하학으로 설명했으나 실제 핵심은 다르다. AdaLN-Zero 잔차 게이트 α가 가속 방법들에 의해 대폭 재구성되며, 이것이 가속의 주요 원인임을 밝혔다. 전체 요약 8문장 읽기 → 015 18:11 ▲ 11 · 댓글 2 가중치 정규화 학습의 진짜 핵심은 유효 학습률 스케줄 Weight-Normalized(WN) 학습이 기존 Weight Decay(WD)보다 사전학습 손실을 크게 줄이는 것으로 보고되고 있으나, 그 개선은 정규화 자체보다는 유효 학습률(ELR) 궤적이 주된 원인임을 밝혔다. AI · 머신러닝 · Your LR Schedule May Not Be Principled: Effective Learning Rate Scheduling in Weight-Normalized Training
Key Point Weight Decay 기반 학습에서 최고 성능을 달성하려면 명목 학습률이 아닌 유효 학습률 궤적을 직접 최적화해야 한다는 실질적 교훈을 제시한다.
핵심 요약
Weight-Normalized(WN) 학습이 기존 Weight Decay(WD)보다 사전학습 손실을 크게 줄이는 것으로 보고되고 있으나, 그 개선은 정규화 자체보다는 유효 학습률(ELR) 궤적이 주된 원인임을 밝혔다. WN과 WD의 ELR 궤적을 일치시키면 훈련 손실 동역학이 대부분 겹쳐지므로, 스케줄 설계는 명목 학습률(LR)이 아닌 ELR을 직접 대상으로 해야 한다. 이 원칙을 바탕으로 이론적으로 유도된 1/t 감쇠에 선형 보정을 더한 AIR(Affine Inverse-square-Root decay) 스케줄을 제안하며, 유한 훈련 기간 동안 목표 최고점과 말기 LR을 만족하도록 설계했다. 전체 요약 6문장 읽기 → 016 00:11 ▲ 136 · 댓글 11 Azure API 연결의 교차 테넌트 침투 취약점 5개 발견 Azure Logic Apps의 API Connections 아키텍처에서 다섯 개의 중대한 교차 테넌트 침투 취약점을 발견해 $200,000을 수익으로 획득했다. 보안 · Azure's Weakest Link – Five Full Cross-Tenant Compromises
Key Point Azure Logic Apps 사용자가 자신의 API Connections이 다른 테넌트의 민감한 데이터(Key Vault 비밀, SQL 데이터)에 노출될 수 있는 다층 보안 우회 방식을 알아야 한다.
핵심 요약
Azure Logic Apps의 API Connections 아키텍처에서 다섯 개의 중대한 교차 테넌트 침투 취약점을 발견해 $200,000을 수익으로 획득했다. API Connections는 Logic App이 API Management 인스턴스를 거쳐 백엔드 서비스(Key Vault, SQL Database, Jira, Salesforce 등)에 접근하며, 토큰 교환을 통해 구성된 자격증명으로 요청을 처리한다. ARM REST API의 DynamicInvoke 또는 /extensions/proxy/ 엔드포인트를 통해 API Management 서비스를 직접 호출할 수 있으며, ARM은 모든 리소스에 대한 접근 권한을 가지고 있다. 전체 요약 10문장 읽기 → 017 21:11 당일 +1,096 AI 봇 팀을 채팅 앱에서 운영하는 오픈소스 플랫폼 Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. AI · 머신러닝 · milind-soni/OpenMausBot · TypeScript
Key Point AI 에이전트 플랫폼의 오픈소스 진영이 확대되는 가운데, 사용자 자신의 모델과 로컬 머신에서 여러 봇을 독립적으로 운영할 수 있는 대안이 등장했다.
핵심 요약
Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. 각 봇은 독립적인 모델·클라우드 컴퓨터·연결된 앱을 가지며, 메시지 사이드바의 연락처처럼 상호작용한다. 봇이 실행할 셸 명령·파일 편집·질문은 인라인 카드로 표시되어 사용자가 승인·거부하거나 답변할 수 있다. 전체 요약 13문장 읽기 → 018 09:11 ▲ 106 · 댓글 17 엔비디아, 40개 언어 지원하는 오픈 음성인식 모델 공개 엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. AI · 머신러닝 · Nvidia Nemotron 3.5 Transcribe: open ASR for 40 languages
Key Point 음성-텍스트 변환이 대규모 언어모델의 다음 병목이 되는 시점에 40개 언어를 지원하고 프롬프트·미세조정으로 도메인 적응이 가능한 오픈 모델이 공개됨에 따라, 음성 애플리케이션 개발 환경이 크게 바뀐다.
핵심 요약
엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. 최대 1시간 길이 음성을 처리하고 최대 8명의 화자를 레이블링하며, 자연어 프롬프트로 출력을 제어할 수 있어 의료 받아쓰기·다국어 회의 등 도메인별 요구에 맞춘 결과를 얻을 수 있다. Hugging Face 오픈 ASR 리더보드 영어 부문에서 5.33% 평균 WER로 오픈 가중치 모델 중 1위, Artificial Analysis 레더보드에서 약 4B 활성 매개변수로 2.8% AA-WER을 달성해 파레토 경계에 위치한다. 전체 요약 12문장 읽기 → 019 06:11 당일 +659 오픈소스 AI SOC로 보안 대응을 자동화하다 보안 도구에서 수집한 로그를 정규화한 후 2535개의 탐지 규칙을 실행해 위협을 자동 분류하고 AI 에이전트가 조사하며 사람이 승인한 후 대응 조치를 취하는 자체 호스팅 가능한 오픈소스 SOC이다. 보안 · beenuar/AiSOC · Python
Key Point API 키 없이 AI 기반 위협 조사를 자체 호스팅으로 실행할 수 있는 오픈소스 SOC가 등장했으며, 모든 AI 추론이 기록되어 감사 가능하고 대응은 사람이 승인해야 한다는 점이 기존 자동화 도구와 다르다.
핵심 요약
보안 도구에서 수집한 로그를 정규화한 후 2535개의 탐지 규칙을 실행해 위협을 자동 분류하고 AI 에이전트가 조사하며 사람이 승인한 후 대응 조치를 취하는 자체 호스팅 가능한 오픈소스 SOC이다. 도입에 명령어 한 줄로 Docker, Python, 필요한 보안 자격증을 모두 설치할 수 있으며 8GB 메모리와 20GB 디스크, Python 3.9+ 그리고 bash만 있으면 된다. Splunk, Sentinel, Elastic, CrowdStrike, Okta, AWS, Kubernetes 등 87개의 데이터 커넥터를 지원하며 클라우드 환경에서는 S3-SQS, GCP Pub/Sub, Azure Event Hubs, syslog/CEF 리스너로 로그를 수집한다. 전체 요약 10문장 읽기 → 020 03:11 ▲ 16 · 댓글 2 슬라이더로 이미지 편집 강도 미세 조종하기 이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. AI · 머신러닝 · SliderEdit++: Improved Slider Trajectories in Instruction-Based Image Editing
Key Point 이미지 편집에서 사용자가 원하는 강도를 정밀하게 조절할 수 있는 방법이 개선돼, 생성형 이미지 편집 도구가 더 직관적이고 빠르게 동작하게 된다.
핵심 요약
이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. 논문은 이 문제를 체계적으로 연구하기 위해 다양한 편집 카테고리를 포함한 종합 벤치마크 SlideBench를 제시했으며, 단조성·지각적 연속성·슬라이더 간 독립성을 측정하는 통일된 평가 지표를 제공한다. SliderEdit++는 편집 궤적의 양 끝점만 지도하는 기존 방식 대신 중간 과정의 궤적을 명시적으로 정규화한다. 전체 요약 6문장 읽기 → 021 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 022 12:11 ▲ 359 · 댓글 3 성공한 궤적도 학습 데이터로 부족한 이유 도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. AI · 머신러닝 · Trajectory2Gym: Decision-Grounded Compositional Interaction Synthesis for Tool-Use Agents
Key Point 기존에 성공한 상호작용만 학습 데이터로 사용하는 방식의 근본적 문제를 제시하고, 다단계 의존성과 결정 근거를 모두 만족하는 상호작용을 설계하는 방법을 제안하여 에이전트의 학습 효율을 크게 개선한다.
핵심 요약
도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. 효과적인 궤적 감독을 위해서는 중요한 관찰-행동 의존성이 모두 표현되는 구성 커버리지와 각 행동이 에이전트의 학습 가능한 상호작용 이력으로 정당화되는 결정 기반이라는 두 가지 조건이 필요하다. Trajectory2Gym은 지원이 부족한 구성 구조 주변에 실행 가능한 상호작용을 구성하고, 실제 실행에서 정당화된 결정들만을 감독 신호로 사용한다. 전체 요약 8문장 읽기 → 023 03:11 ▲ 129 · 댓글 39 S&P 500 기업의 시가총액을 '직원 1명당 가치'로 시각화 S&P 500 기업들을 시가총액에 비례한 버블로 표현한 시각화 도구를 공개했다. 스타트업 · 비즈니스 · Show HN: I put employees inside S&P 500 market-cap bubbles
Key Point 기업의 시가총액을 직원 수로 정규화해 '직원 1명당 가치' 관점에서 기술 기업과 전통 산업의 효율성 격차를 한눈에 볼 수 있기 때문이다.
핵심 요약
S&P 500 기업들을 시가총액에 비례한 버블로 표현한 시각화 도구를 공개했다. 각 버블 내부의 막대 인물은 직원을 나타내며, 모두 같은 크기로 표시된다. 버블이 촘촘하면 직원 1명당 시가총액이 낮고, 버블이 넓은데 인물이 적으면 직원 1명당 가치가 높다는 의미다. 전체 요약 7문장 읽기 → 024 03:11 ▲ 112 · 댓글 51 DOM과 Canvas를 통합하는 HTML-in-Canvas API 등장 Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 웹 · 프론트엔드 · The HTML-in-Canvas API origin trial
Key Point 웹 게임과 3D 편집기 같은 고성능 Canvas 앱에서 텍스트 접근성, find-in-page, 브라우저 확장 등 DOM의 모든 기능을 동시에 사용할 수 있게 되므로, 복잡한 시각 애플리케이션의 아키텍처 설계 방식이 근본적으로 달라진다.
핵심 요약
Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 이 API는 DOM 콘텐츠를 2D canvas 또는 WebGL/WebGPU 텍스처에 직접 렌더링하면서 상호작용과 접근성을 유지한다. DOM은 텍스트 레이아웃, 접근성, 번역, find-in-page 등 브라우저 기능을 제공하지만 그래픽 성능이 제한적이고, Canvas는 고성능이지만 이러한 기능들이 완전히 작동하지 않는다. 전체 요약 9문장 읽기 → 025 18:11 ▲ 20 · 댓글 2 LLM 에이전트의 검증기 생성 능력을 평가하는 벤치마크 공개 LLM 에이전트가 작업 완료 후 출력물을 검증하고 합성 학습 데이터를 필터링할 수 있도록, 주어진 지시사항과 환경으로부터 실행 가능한 검증기를 생성하는 능력을 연구했다. AI · 머신러닝 · VerifierBench: Benchmarking the Generation of Executable Verifiers for LLM Agents
Key Point LLM 에이전트가 생성한 검증기들이 실제로는 지나치게 엄격한 기준으로 유효한 솔루션을 배제하는 문제를 처음으로 대규모로 분석했으며, 에이전트 검증 시스템의 근본적 한계를 드러낸다.
핵심 요약
LLM 에이전트가 작업 완료 후 출력물을 검증하고 합성 학습 데이터를 필터링할 수 있도록, 주어진 지시사항과 환경으로부터 실행 가능한 검증기를 생성하는 능력을 연구했다. VerifierBench는 6개 에이전트 벤치마크에서 수집한 222개 작업으로 구성되며, 도구 호출·상태 기반·코드 검증 3가지 유형을 포함하고 4,993개의 숨겨진 테스트 케이스(대체 해결책 및 공격 포함)를 갖추고 있다. Verifier4Verifier(V4V)라는 6단계 감시 시스템이 소스 검증기와 테스트 스위트를 선별한다. 전체 요약 8문장 읽기 → 026 12:11 ▲ 51 · 댓글 2 확산 모델의 특성을 선별하는 정책 기반 마스킹 기법 기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. AI · 머신러닝 · Policy-Mask: Budget-Aware Adaptation of Diffusion Features to Discriminative Tasks
Key Point 차별적 작업에 확산 모델의 특성을 재활용할 때 수동으로 설정하던 추출 규칙을 자동으로 최적화해 다양한 시각 이해 작업에서 성능 향상을 실현한다.
핵심 요약
기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. 확산 과정의 타임스텝, 네트워크 깊이, 채널 세 가지를 모두 함께 최적화하되, 채널 수 제한(예산)을 고려한다. 채널 점수가 선택된 채널 수에 따라 증가하는 문제를 정규화로 해결하여 세 개의 정책이 균형있게 학습되도록 한다. 전체 요약 6문장 읽기 → 027 21:11 ▲ 104 · 댓글 30 Nintendo Switch 2 첫 소프트웨어 탈옥 성공 ns2jb는 Switch 2 최초의 소프트웨어 온리 탈옥으로, 임의의 네이티브 코드를 일반 시스모듈이나 내장 fs 시스모듈로 실행할 수 있게 해준다. 하드웨어 · 시스템 · Jailbreaking the Switch 2
Key Point Switch 2에 대한 첫 실용적인 탈옥 도구가 등장했으며, 소프트웨어만으로 시스모듈 권한을 획득하는 방법을 구체적으로 공개했으므로 홈브루 및 에뮬레이션 커뮤니티에 중대한 영향을 미칠 것이다.
핵심 요약
ns2jb는 Switch 2 최초의 소프트웨어 온리 탈옥으로, 임의의 네이티브 코드를 일반 시스모듈이나 내장 fs 시스모듈로 실행할 수 있게 해준다. 홈브루, 게임 역공학 및 모딩, 세이브 백업, MMIO를 통한 주변기기 접근이 가능해졌으며, 시연으로 Mario Kart World를 모딩했다. 처음 시도는 WebKit 브라우저 공격으로 n-day 취약점을 이용해 초기 코드 실행을 얻으려 했다. 전체 요약 13문장 읽기 → 028 03:11 새 버전 OpenAI Python SDK 3.36.0 릴리스 OpenAI Python SDK 3.36.0이 출시되었으며, Vertex AI가 Responses API에서 지원되기 시작했다. AI · 머신러닝 · openai/openai-python@v3.36.0
Key Point OpenAI API를 Python으로 사용하는 개발자들이 Vertex AI 지원, WebSocket 안정성 개선, 음성 관리 기능을 통해 더 다양한 플랫폼과 안정적인 연결을 확보할 수 있게 되었다.
핵심 요약
OpenAI Python SDK 3.36.0이 출시되었으며, Vertex AI가 Responses API에서 지원되기 시작했다. 캐시 쓰기 사용량 통계 집계 및 컴팩션 트리거 ID 기능이 API에 추가되었다. 음성 동의 관리와 네이티브 동기 WebSocket 옵션 타입이 새로 지원된다. 전체 요약 8문장 읽기 → 029 21:11 새 버전 Node.js 26.12.1, 11개 보안 취약점 수정 Node.js 26.12.1이 보안 릴리스로 공개됐으며 CVE-2026-106069, CVE-2026-106072 등 11개의 취약점을 수정했다. 인프라 · 데브옵스 · nodejs/node@v26.12.1
Key Point TLS, DNS, 암호화 등 보안 핵심 영역의 11개 취약점 수정으로 프로덕션 환경의 Node.js 애플리케이션 보안을 강화하는 중요 업데이트다.
핵심 요약
Node.js 26.12.1이 보안 릴리스로 공개됐으며 CVE-2026-106069, CVE-2026-106072 등 11개의 취약점을 수정했다. TLS 모듈에서 비표준 IP 주소 거부 기능(High) 및 IP 정규화 회귀 문제를 수정하고, 블로킹된 공개 키가 포함된 인증서 체인 거부 기능을 추가했다. DNS 모듈에서 null 바이트 입력 검증을 추가했으며(High), HTTP 에이전트 데이터 보호 기능을 I/O 없이 작동하도록 개선했다(Medium). 전체 요약 6문장 읽기 → 030 21:11 새 버전 Node.js v24.22.1 'Krypton' LTS 보안 업데이트 Node.js v24.22.1은 보안 취약점 9개(CVE-2026-105481, CVE-2026-105482 등)를 포함한 보안 릴리스다. 인프라 · 데브옵스 · nodejs/node@v24.22.1
Key Point Node.js LTS 버전의 보안 취약점을 즉시 패치한 만큼, 프로덕션 환경에서 보안 위협에 대한 노출을 줄이기 위해 신속한 업그레이드가 필요하다.
핵심 요약
Node.js v24.22.1은 보안 취약점 9개(CVE-2026-105481, CVE-2026-105482 등)를 포함한 보안 릴리스다. HTTP 에이전트 데이터 보호 기능이 I/O 없이도 동작하도록 개선되었으며, DNS resolve 함수가 null 바이트를 검증하도록 강화됐다. TLS에서 IP 주소 정규화 회귀 문제를 수정하고 비정준형 IP 주소를 거부하는 검증이 추가됐다. 전체 요약 7문장 읽기 → 031 18:11 ▲ 18 · 댓글 2 그림 그려지는 과정을 시간 지도로 제어하기 미술 생성 AI는 정적 이미지 합성에서 인간의 회화 과정을 모방하는 동적 비디오 생성으로 발전했으나, 기존 모델들은 창작 과정을 블랙박스로 취급한다. AI · 머신러닝 · Painting Change Map as guidance for generating painting processes
Key Point 기존 회화 영상 생성 모델은 사용자가 어느 부분을 언제 그려야 하는지 제어할 수 없는데, 이 연구는 시공간 변화 지도로 획 수준의 정밀한 제어를 처음 가능하게 한다.
핵심 요약
미술 생성 AI는 정적 이미지 합성에서 인간의 회화 과정을 모방하는 동적 비디오 생성으로 발전했으나, 기존 모델들은 창작 과정을 블랙박스로 취급한다. 현재의 조건 메커니즘은 Canny 엣지나 깊이 맵처럼 너무 경직되었거나 진행률 같은 단순 스칼라 변수로 너무 단순화되어, 그림이 시간에 따라 어떻게 진화하는지 사용자가 조종할 수 없다. 이 연구는 '페인팅 체인지 맵'이라는 새로운 시공간 제어 메커니즘을 제안하는데, 이는 1,000 타임스텝 전체에서 정규화된 구조적 변화를 명시적으로 추적한다. 전체 요약 7문장 읽기 → 032 15:11 ▲ 154 · 댓글 2 반복 모델이 긴 문제를 푸는 법: 진행도 정렬 재귀 반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. AI · 머신러닝 · PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking
Key Point 반복 모델의 길이 외삽 성능을 16배까지 개선하는 기법이 제시되어, 재귀 신경망의 일반화 한계를 다루는 근본적인 접근 방식을 보여준다.
핵심 요약
반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. 순차적 상태 추적 작업에서 최종 답변 감독만으로는 각 반복이 얼마나 진행해야 하는지 명시하지 않으며, 반복된 업데이트가 재귀 상태의 스케일을 변화시킨다. PAR(Progress-Aligned Recurrence)는 k번째 반복의 예측을 처음 k개 연산 후의 상태와 일치하도록 학습하고, 재귀 상태를 첫 반복의 규범으로 정규화한다. 전체 요약 10문장 읽기 → 033 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 034 09:11 ▲ 13 · 댓글 2 형식검증으로 강화한 LLM 에이전트 학습, Lean4AgenticRL LLM의 에이전트 능력을 강화하기 위해 복잡한 소프트웨어 엔지니어링과 터미널 작업 문제를 풀어야 하는 상황에서, 기존 모델들은 고수준의 결과 보상에만 의존해 학습 효율이 낮았다. AI · 머신러닝 · Lean4AgenticRL: Advancing Agentic RL with Verifiable Multi-level Process Rewards
Key Point 기존 LLM 에이전트 학습에서 다단계 보상 검증을 도입해 실제 성능 향상을 입증한 사례로, 형식 검증이 강화학습 효과성을 높일 수 있음을 보여준다.
핵심 요약
LLM의 에이전트 능력을 강화하기 위해 복잡한 소프트웨어 엔지니어링과 터미널 작업 문제를 풀어야 하는 상황에서, 기존 모델들은 고수준의 결과 보상에만 의존해 학습 효율이 낮았다. Lean4AgenticRL은 Lean4 형식화 체계에 다단계 프로세스 보상을 통합한 첫 번째 프레임워크로, 에이전트의 능력과 제어성 사이 균형을 맞추는 문제별 워크플로우 시스템을 구축한다. 워크플로우 형식화와 다단계 보상 주석 방식을 통해 일반 하니스 시스템 내에서 에이전트 동작을 검증하며, 저수준 도구 호출 보상과 중수준 워크플로우 단계 보상을 포함한다. 전체 요약 7문장 읽기 → 035 18:11 ▲ 28 · 댓글 2 메모리 간섭 줄인 선형 어텐션, 장문맥 모델링에 강하다 KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. AI · 머신러닝 · Kronecker Delta Rule for Long Context Linear Attention
Key Point 메모리 간섭을 크게 줄이면서 안정성까지 갖춘 선형 어텐션이 장문맥 모델링 성능에서 기존 방식을 앞서면서, 대형 언어모델의 효율적인 장문맥 처리 방식이 진화하고 있음을 보여준다.
핵심 요약
KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. xLSTM 계열을 확장해 메모리 수정 메커니즘을 추가했으며, 특정 연관성을 정정하면서도 행렬 공간의 단일 방향으로만 메모리를 변경한다. 이러한 최소한의 침습적 메모리 수정 방식은 기존 델타 규칙 업데이트 대비 이전에 저장된 정보와의 간섭을 줄여 장문맥 언어 모델링에 적합하다. 전체 요약 8문장 읽기 → 036 18:11 ▲ 13 · 댓글 2 자막·로고 자동 제거하는 AI 모델과 벤치마크 공개 비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. AI · 머신러닝 · DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
Key Point 비디오 편집·정제 작업의 자동화를 가능하게 하는 새로운 방법론과 평가 기준이 제시되었기 때문입니다.
핵심 요약
비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. 기존 방식은 시간 정보 활용이나 조건부 생성을 썼지만 잔여 오버레이를 남기고 장면 구조를 왜곡할 수 있었다. DeOverlay라는 소스 앵커드 플로우 모델을 제안하는데, 소스 잠재 표현에서 고정된 가이던스로 깨끗한 영상을 복원한다. 전체 요약 11문장 읽기 → 037 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 038 15:11 ▲ 204 · 댓글 3 LLM이 실무 경영과학 컨설팅을 제대로 할 수 있을까 LLM 에이전트가 원본 비즈니스 자료만으로 전문가 수준의 경영과학(OR) 솔루션을 제공할 수 있는지 평가하는 OR-License 벤치마크를 공개했다. AI · 머신러닝 · OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
Key Point 실제 컨설팅 프로젝트 자료로 구성한 처음의 OR 벤치마크로, 현재 LLM이 비즈니스 최적화 문제를 전문가 수준으로 해결할 때의 실제 격차를 보여주기 때문이다.
핵심 요약
LLM 에이전트가 원본 비즈니스 자료만으로 전문가 수준의 경영과학(OR) 솔루션을 제공할 수 있는지 평가하는 OR-License 벤치마크를 공개했다. 실제 유료 OR 컨설팅 프로젝트 3,680만 달러 규모의 10개 산업 분야 31개 사례로 구성되며, 원본 요구사항·입력 데이터·납품 형식을 그대로 유지한다. ORSim이라는 제어된 클라이언트 시뮬레이터를 도입해 비즈니스 정보는 제공하되 OR 전문성은 공급하지 않는 환경에서 정보 수집 과정을 추적한다. 전체 요약 9문장 읽기 → 039 12:11 ▲ 36 · 댓글 1 이미지 여러 번 편집할 때 화질 유지하기 사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. AI · 머신러닝 · MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
Key Point 연속된 이미지 편집 작업에서 화질 저하와 이전 편집 손실 문제를 해결하는 실질적인 기술이 나왔다.
핵심 요약
사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. 이 논문은 자동회귀 확산 기반의 통합 멀티모달 모델(UMM)을 위한 새로운 훈련 방식인 MT Forcing을 제안한다. 단일 턴 분포 매칭 증류(Single-Turn DMD)는 교사 모델이 원본 이미지에 누적된 편집을 한 번에 적용한 결과로 학생 모델의 자동 롤아웃을 감독하여, 반복적 오류 누적 없이 시각적 품질 지도를 제공한다. 전체 요약 5문장 읽기 → 040 21:11 당일 +186 회사 채용 페이지를 직접 수집하는 오픈소스 채용 검색엔진 freehire는 채용 공고를 회사의 ATS(지원자 추적 시스템) 직접 수집하는 오픈소스 검색엔진으로, 리크루터 재게시나 중개자 없이 3.3M+ 공고를 294,000+ 회사에서 관리한다. 오픈소스 · 도구 · strelov1/freehire · Go
Key Point 채용공고 수집에서 지원·추적까지 전 과정을 오픈소스로 관리하는 인프라를 제공해 구직자가 중개자 없이 원본 정보에 직접 접근할 수 있도록 한다.
핵심 요약
freehire는 채용 공고를 회사의 ATS(지원자 추적 시스템) 직접 수집하는 오픈소스 검색엔진으로, 리크루터 재게시나 중개자 없이 3.3M+ 공고를 294,000+ 회사에서 관리한다. Workday, Greenhouse, Lever, Ashby, iCIMS 등 92개 ATS 플랫폼, 100개 채용사이트·집계자, 30개 회사 채용페이지로부터 225개 라이브 소스를 통해 데이터를 수집한다. 공고는 정규화되어 단일 스키마로 변환되고 중복 제거되며, 지역·근무형태·경력·기술·연봉 등으로 패싯 검색이 가능하다. 전체 요약 10문장 읽기 → 041 18:11 ▲ 106 · 댓글 34 인텔 8087의 부동소수점 덧셈·뺄셈 마이크로코드 분석 1980년 인텔이 IBM PC 시스템의 부동소수점 연산을 약 100배 빠르게 만든 8087 칩을 출시했으며, 이 글은 칩을 직접 분해해 덧셈과 뺄셈 구현 방식을 설명한다. 하드웨어 · 시스템 · The Intel 8087 chip: floating-point addition and subtraction
Key Point 1980년대 칩 설계의 정수 가산기·비트 시프터 같은 전용 회로와 마이크로코드 최적화가 어떻게 부동소수점 연산 속도를 100배 향상시켰는지 보여주며, 현대 CPU의 부동소수점 처리 기초를 이해할 수 있다.
핵심 요약
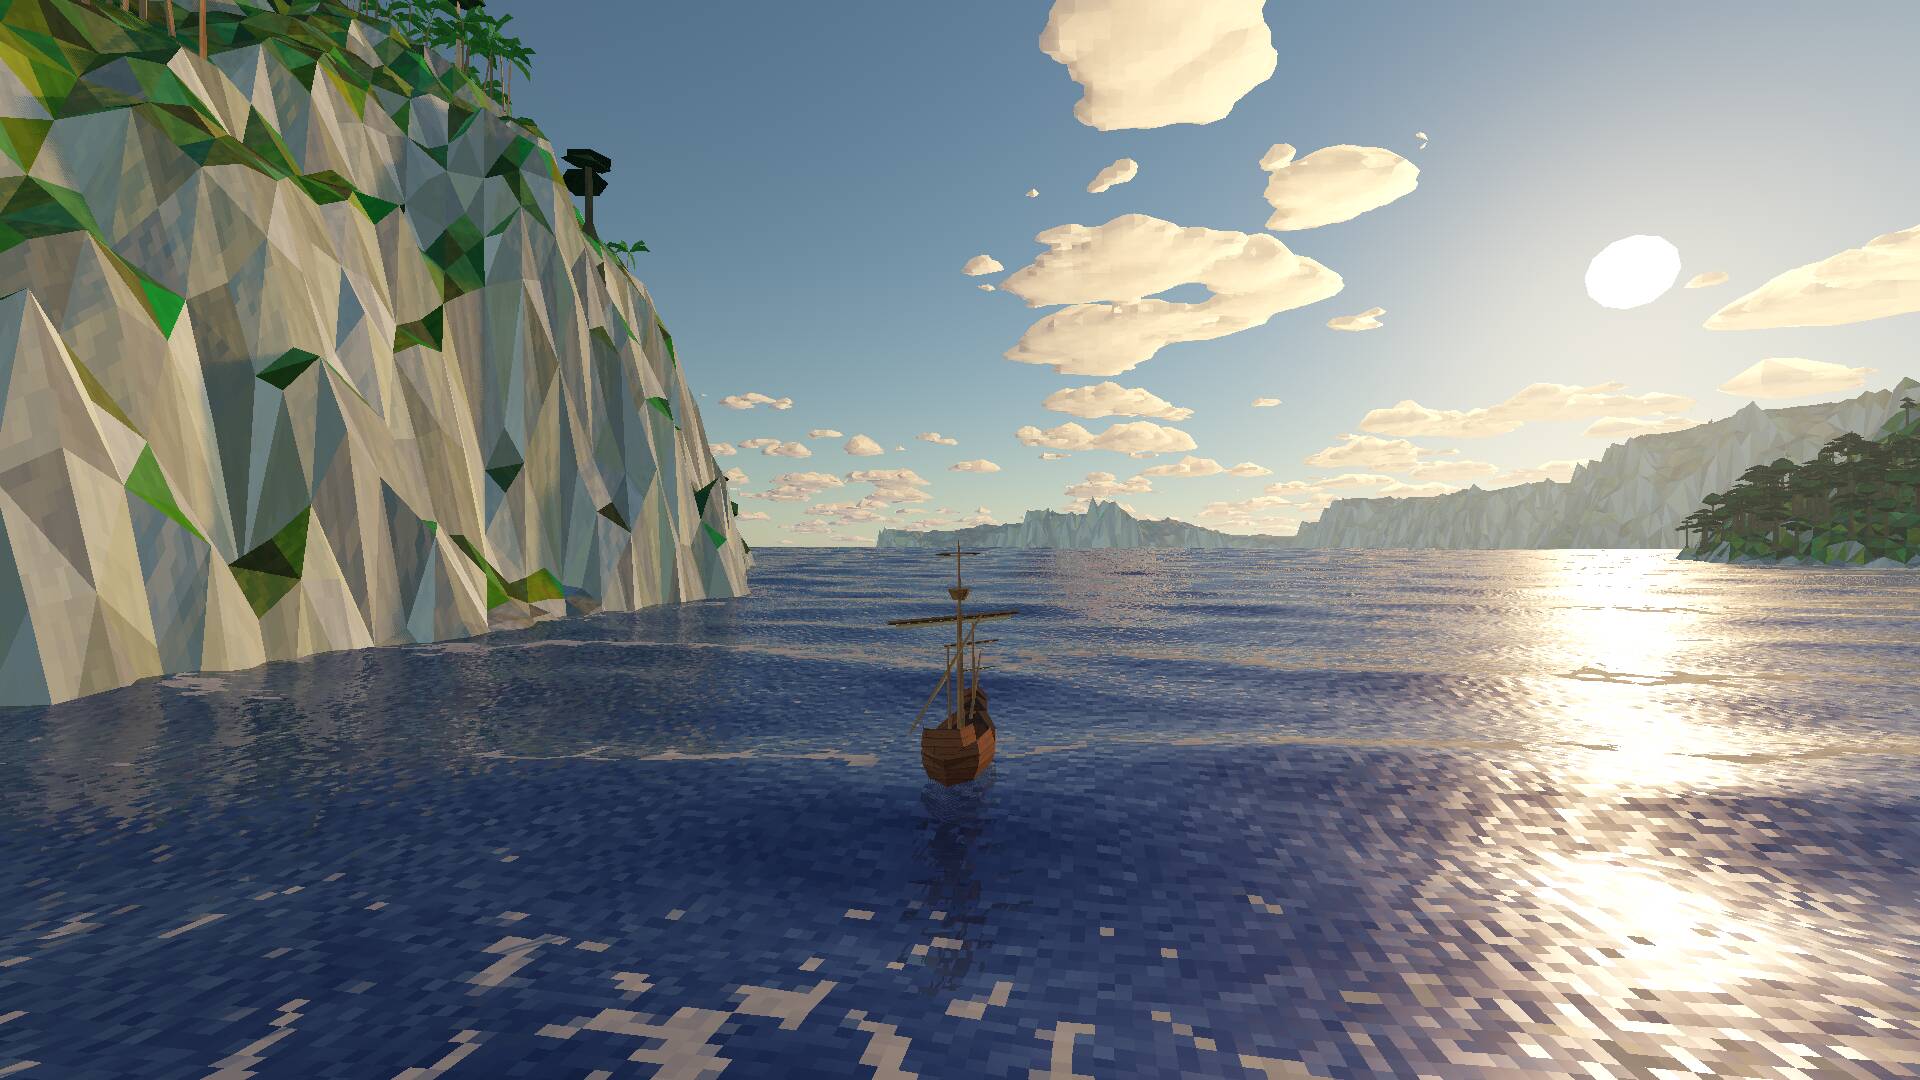
1980년 인텔이 IBM PC 시스템의 부동소수점 연산을 약 100배 빠르게 만든 8087 칩을 출시했으며, 이 글은 칩을 직접 분해해 덧셈과 뺄셈 구현 방식을 설명한다. 8087은 부동소수점 수를 '부호 × 유효숫자 × 2^지수' 형태로 표현하며, 덧셈과 뺄셈을 위해 먼저 두 수의 소수점을 정렬한 후 정수 연산을 수행하고 결과를 정규화해야 한다. 칩 내부에는 80비트 임시 실수 형식(15비트 지수, 64비트 유효숫자)을 저장하는 8개의 스택 레지스터와, 덧셈·뺄셈·곱셈·나눗셈에 사용되는 69비트 정수 가산기, 임의 비트 수로 빠르게 시프트 가능한 비트 시프터, 선행 영 비트 카운팅 회로 등이 있다. 전체 요약 12문장 읽기 → 042 06:11 ▲ 106 · 댓글 7 게임 엔진에서 현실적인 하늘 렌더링하기 Rust로 몬테카를로 광선 추적기를 직접 구현해 POV-Ray가 다중산란을 시뮬레이션하지 않음을 확인했고, 이를 반영한 새로운 조회 테이블로 구름의 밝기와 조명이 더 균일해졌다. 기타 · Rendering pretty sky in Around The World game
Key Point 게임에서 구름과 하늘을 물리 기반으로 렌더링하는 실무 기법들과 각 문제에 대한 구체적인 해결책을 단계별로 보여주는 개발자 맞춤형 사례 연구다.
핵심 요약
Rust로 몬테카를로 광선 추적기를 직접 구현해 POV-Ray가 다중산란을 시뮬레이션하지 않음을 확인했고, 이를 반영한 새로운 조회 테이블로 구름의 밝기와 조명이 더 균일해졌다. 구름이 하늘의 간접광(파란색)을 받도록 표면 법선을 아래에서 위로 향하게 조정하면, 낮에는 파란 톤이, 일몰에는 핑크 톤이 생겨 현실적인 모습이 된다. 대기 산란 계산 순서를 '외부산란 후 내부산란' 형태로 바꾸니 태양이 머리 위에 있을 때도 수평선 근처가 부자연스럽게 노란색으로 보이는 현상이 개선됐다. 전체 요약 6문장 읽기 → 043 12:11 ▲ 106 · 댓글 2 희소 자동인코더 표현이 얼마나 합성적인지 검증 희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. AI · 머신러닝 · Behavioral Compositionality of Sparse Autoencoder Representations
Key Point SAE 특성이 실제로 신경망 행동을 독립적으로 설명하는지가 오랫동안 미해결 문제였는데, 이 논문이 정량적 측정 방법과 한계를 처음 체계적으로 보여줌으로써 해석가능 AI 연구의 방향을 제시한다.
핵심 요약
희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. 연구팀은 SAE Additivity Residuals(SAR)를 도입해 설명되지 않은 행동 변이를 상호작용 차수별로 측정하며, 모집단 SAR은 정확히 그 차수 이상의 상호작용 에너지 정규화값이다. 학습된 SAE 좌표와 같은 부분공간의 합 보존 무작위 회전을 비교하면, 18개의 모델과 행동 설정 모두에서 학습된 좌표가 더 낮은 1차 잔차를 보인다. 전체 요약 6문장 읽기 → 044 21:11 ▲ 285 · 댓글 2 AI 에이전트의 '마지막 한 발' 평가 벤치마크 등장 기존 AI 에이전트 벤치마크는 명확히 정의된 과제만 평가하지만, 실제 현장에서는 모호한 요구사항 해석과 운영 중인 시스템 작업이 필수다. AI · 머신러닝 · FDE-Gym: The Last Mile of AI Delivery
Key Point LLM 에이전트가 실제 고객 환경에서 얼마나 잘 작동하는지를 처음으로 체계적으로 평가한 벤치마크로, 기존 학술 평가와 현실 간의 큰 격차를 실증한다.
핵심 요약
기존 AI 에이전트 벤치마크는 명확히 정의된 과제만 평가하지만, 실제 현장에서는 모호한 요구사항 해석과 운영 중인 시스템 작업이 필수다. Hugging Face가 20개 산업 시나리오 95개 실제 과제를 담은 FDE-Gym 벤치마크를 공개했으며, 각 과제는 현장 엔지니어의 실제 프로젝트에서 개편했다. 시뮬레이션된 고객 환경에서 에이전트는 이해관계자와 상호작용하며 운영 환경 같은 시스템을 직접 수정해 솔루션을 제공하고, 고객 비즈니스 지표 개선도를 0~1로 정규화해 채팅·테스트 횟수 페널티를 적용한다. 전체 요약 5문장 읽기 → 045 15:11 ▲ 56 · 댓글 2 다중 보상 학습에서 각 보상을 관련 토큰에만 할당하는 방법 언어모델은 도구 호출의 정확성·형식, 복잡한 지시의 개별 제약 등 여러 검증 가능한 보상으로 동시에 학습된다. AI · 머신러닝 · Each Reward to Its Relevant Tokens: Reward-Specific Token-Level Credit Assignment for Multi-Reward RL
Key Point 언어모델 강화학습에서 여러 보상을 동시에 처리할 때 각 보상이 실제로 영향을 미치는 위치에만 효과적으로 할당하는 방식의 개선으로, 수렴 속도와 성능 모두를 높인다.
핵심 요약
언어모델은 도구 호출의 정확성·형식, 복잡한 지시의 개별 제약 등 여러 검증 가능한 보상으로 동시에 학습된다. 기존의 보상-분리 정규화(GDPO)는 각 보상을 따로 정규화해 보상 조합을 구별하지만, 각 검증기가 몇 위치만 확인함에도 모든 보상의 이점을 전체 응답에 균등하게 분산한다. 이 논문이 제안하는 MRTPO는 보상별로 검증기가 확인하는 정보를 이용해, 각 보상의 이점을 관련 토큰에만 할당한다. 전체 요약 5문장 읽기 → 046 09:11 새 버전 Angular 22.2.3 배포, 보안 및 성능 개선 Angular 22.2.3 버전이 릴리스되었다. 웹 · 프론트엔드 · angular/angular@v22.2.3
Key Point 프로토타입 오염 보안 강화와 다양한 버그 수정으로 프레임워크의 안정성이 개선되어 Angular 기반 프로젝트를 운영하는 개발팀이 업데이트를 검토해야 한다.
핵심 요약
Angular 22.2.3 버전이 릴리스되었다. common 모듈에서 프로토타입 오염(prototype pollution) 공격으로부터 매개변수 인코딩을 강화했다. compiler에서 @boundary 블록을 제어 흐름 내용 투영 진단에 포함시키고, ReadTemporaryExpr.isEquivalent에서 피연산자 비교를 개선했다. 전체 요약 12문장 읽기 → 047 18:11 ▲ 81 · 댓글 1 미적 코드 생성, 시각 보상으로 가능해졌다 슬라이드·포스터·대시보드처럼 시각적으로 복잡한 UI를 코드로 생성하되, 레이아웃과 색감이 실제로 어떻게 보일지 반영하기 어렵다는 문제가 있었다. AI · 머신러닝 · AesCode: Aesthetic Code Generation with Decoupled Cross-Modal Rewards
Key Point 시각 설계가 필요한 UI 코드 생성에서 미적 품질과 정확성을 동시에 달성하는 새로운 접근법이 기존 모델의 한계를 구체적으로 수치로 극복해냈다.
핵심 요약
슬라이드·포스터·대시보드처럼 시각적으로 복잡한 UI를 코드로 생성하되, 레이아웃과 색감이 실제로 어떻게 보일지 반영하기 어렵다는 문제가 있었다. AesCode는 사용자 지시문에 따라 코드를 생성하되, 같은 지시문으로 만든 이미지를 시각 미적 참조로 활용한다. 생성된 코드를 디자인 그래프로 표현해 각 속성을 추적 가능하게 만들고, 이 그래프로부터 두 종류의 보상을 만든다. 전체 요약 8문장 읽기 → 048 21:11 ▲ 25 · 댓글 2 과거 거리 풍경 복원, 위성 데이터로 세대를 뛰어넘다 도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. AI · 머신러닝 · CrossTimeEdit: A Decade-Spanning Cross-View Dataset and Reward-Guided Editing for Historical Street-View Generation
Key Point 위성 이미지와 시간 정보를 활용한 역사 거리 풍경 복원 기술로, 도시 아카이브나 도시계획 분야에서 데이터 부족 문제를 해결할 수 있는 새로운 접근 방식을 제시한다.
핵심 요약
도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. VIGOR-his는 3대륙 11개 도시의 10년 단위 거리 풍경 쿼드러플렛 43,653개를 포함하며, 공간 쌍짓기·일관성 검증·변화 분류·위성 기반 변화 설명 생성 및 검증 등 자동화 파이프라인을 거친다. CrossTimeEdit는 FLUX.2 4B 모델을 기반으로 거리 풍경 생성을 편집 작업으로 재구성하며, 최근 거리 풍경으로 시점과 불변 부분을 제약하고 시간별 위성 차이를 변화 증거로 활용한다. 전체 요약 6문장 읽기 → 049 18:12 ▲ 10 · 댓글 2 정책 증류에서 상대적 차이의 전이 메커니즘 규명 온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. AI · 머신러닝 · Rethinking Relative Policy Differences Transfer of On-Policy Distillation
Key Point 강화학습 정책 증류에서 어떤 강사-참조 조합이 효과적인지, 모델 간 지식 전이 가능 조건을 규명해 실제 응용의 성공률을 높일 수 있기 때문이다.
핵심 요약
온-정책 증류(OPD)는 강사 정책에서 학생 정책을 감독하되, 기존에는 강사가 월등히 뛰어나야 효과적이었다. 최근 연구는 강사의 절대 분포 대신 강사와 참조 정책 간의 상대적 차이를 전이하는 방식을 제안했지만, 어떤 차이가 유용한 감독을 제공하고 어떤 대상이 이득을 볼 수 있는지는 불명확했다. 연구팀은 프록시 강사와 프록시 참조 간의 로그 확률 비를 KL 정규화 정책 최적화의 암묵적 보상으로 해석하는 통합 이론을 개발했다. 전체 요약 9문장 읽기 → 050 12:11 ▲ 33 · 댓글 2 확률 분포 일치로 보정 없이 확산 언어모델 양자화 확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. AI · 머신러닝 · SoloQ: Calibration-Free Quantization for Diffusion Language Models
Key Point 확산 기반 언어모델의 배포 효율성이 점점 중요해지는 상황에서, 보정 데이터 없이도 정확도를 유지하는 양자화 기법이 실무 적용 시간을 크게 단축할 수 있다.
핵심 요약
확산 기반 토큰 생성 언어모델(dLLM)은 자동회귀 모델의 대안으로 주목받고 있으나, 전체 시퀀스 역노이징과 블록 확산의 메모리 오버헤드로 배포가 어렵다. 기존 양자화 방법들은 마스킹 상태와 노이징 단계마다 활성화 분포가 바뀌어 보정 데이터가 필수였다. SoloQ는 가중치와 활성화를 정규화된 회전 기저로 매핑해 예측 가능한 주변 분포를 만들고, 이를 통해 데이터 독립적 양자화를 실현한다. 전체 요약 8문장 읽기 → 051 12:11 ▲ 107 · 댓글 34 상용 공간 오디오 필터를 역공학으로 복제하다 Linux에서 사용할 간단한 공간 오디오 효과 프로그램을 만들기 위해 상용 프로그램을 분석했다. 인프라 · 데브옵스 · How I reverse engineered a commercial spatial audio effect
Key Point 복잡한 신호처리 알고리즘을 역공학하는 체계적 방법론을 제시하며, 이론과 실측을 결합한 실무적 접근이 개발자들의 음향 프로그래밍 방식에 참고할 만하다.
핵심 요약
Linux에서 사용할 간단한 공간 오디오 효과 프로그램을 만들기 위해 상용 프로그램을 분석했다. 처음에는 HRTF(머리 관련 전달 함수)와 심리음향 기법을 시도했지만 LLM의 이론적 설명만으로는 개선 방법을 찾을 수 없었다. 대신 프로그램의 정확한 내부 알고리즘을 이해하기보다 필터의 실제 동작을 측정·분석하는 방식으로 전환했다. 전체 요약 8문장 읽기 → 052 12:11 ▲ 12 · 댓글 2 공간 추론 AI, 도구 없이도 학습 가능 멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. AI · 머신러닝 · SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
Key Point 공간 추론 능력이 필요한 비전-언어 작업에서 외부 도구 의존을 제거하면서도 성능을 유지할 수 있다는 점이 중요하며, 자기 증류를 통한 에이전트 능력 내재화는 더 효율적인 AI 시스템 구축에 시사점을 준다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. 연구팀은 MLLM이 도구 없이 공간 추론을 스스로 수행할 수 있는지 탐구했고, 검증된 코딩 에이전트의 실행 추적(trace)을 요약해 모델에 보여주면 내부 사고 과정이 활성화됨을 발견했다. 이를 바탕으로 SpatialOPSD라는 자기 증류(self-distillation) 프레임워크를 제안했으며, 검증된 에이전트 추적을 특권 정보로 취급해 모델에 공간 추론을 내재화한다. 전체 요약 5문장 읽기 → 053 06:11 새 버전 Ruff 0.17.0, 코드 서명과 새로운 규칙 기본값 적용 macOS와 Windows 릴리스의 실행 파일이 코드 서명되었다. macOS는 Apple Developer ID 인증서로 서명·공증되었고, Windows는 Azure Artifact Signing으로 Authenticode 타임스탬프 서명을 받아 바이너리 무결성 검증과 퍼블리셔 기반 허용 목록을 지원한다. 오픈소스 · 도구 · astral-sh/ruff@0.17.0
Key Point 파이썬 기본 버전 변경과 기본 규칙 비활성화로 기존 프로젝트의 린트 결과가 달라질 수 있으며, conda-forge 설치 방식의 사용 방법이 변경되므로 ruff 사용자의 즉각적인 대응이 필요하다.
핵심 요약
macOS와 Windows 릴리스의 실행 파일이 코드 서명되었다. macOS는 Apple Developer ID 인증서로 서명·공증되었고, Windows는 Azure Artifact Signing으로 Authenticode 타임스탬프 서명을 받아 바이너리 무결성 검증과 퍼블리셔 기반 허용 목록을 지원한다. Python 기본 버전이 변경되었다. 버전 미설정 시 3.10에서 3.11로, 문법 검사 시 3.14에서 3.15로 올라갔다. 기본 활성화 규칙이 변경되었다. flake8-datetimez의 7개 규칙(DTZ001, DTZ005, DTZ006, DTZ007, DTZ011, DTZ012, DTZ901)은 더 이상 기본 활성화되지 않으며, F406(undefined-local-with-nested-import-star-usage)은 새로 기본 활성화된다. 전체 요약 12문장 읽기 → 054 21:11 당일 +196 영상 자동 생성, 이제 AI 편집기에 장착한다 Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. AI · 머신러닝 · Vincentwei1021/video-shotcraft · TypeScript
Key Point AI가 제품 영상을 완전 자동으로 제작하고 웹에서 바로 편집할 수 있는 프로덕션 도구가 오픈소스로 공개됐으며, 기업 마케팅 영상 제작 방식이 크게 바뀔 가능성을 보여준다.
핵심 요약
Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. 152장의 샷 레시피 카드, 214개 모션 프리뷰, 9가지 필름 테마(Ink Press, Modern Light, Midnight 등)를 제공한다. 스토리보딩, 2.5D 카메라 움직임, 비트 싱크 컷, 영화급 음향 설계가 자동으로 적용되며, 템플릿은 36.2초 1920×1080 30fps 완성본으로 검증됐다. 전체 요약 11문장 읽기 → 055 18:30 ▲ 12 · 댓글 2 세계모델의 핵심 정보를 압축 저장하는 ALeWM 기법 JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. AI · 머신러닝 · Adaptive Latent Capacity for World Models
Key Point 예측 불필요한 정보를 제거하고 필요한 정보만 압축 저장함으로써 세계모델의 효율성과 계획 능력을 동시에 높이는 방법을 제시한다.
핵심 요약
JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. ALeWM은 접두사(prefix) 길이에 대한 수열 조건부 분포를 학습하고, 샘플링된 입력 접두사로부터 다음 임베딩 전체를 추정하도록 예측기를 훈련한다. 기존 붕괴 방지 목적함수들은 잠재 좌표 전체에 걸친 변동만 유도하고 예측 중요도에 따라 정렬하지 않는 문제를 해결하기 위해, MixSIGReg이라는 새로운 정규화 기법을 도입했다. 전체 요약 7문장 읽기 → 056 18:30 ▲ 19 · 댓글 2 LLM 정책 학습의 동기화 문제를 푸는 KLPO 프레임워크 LLM 에이전트의 비동기 강화학습에서 이전 버전으로 생성한 궤적을 현재 정책으로 학습하는 과정에서 샘플러와 트레이너의 확률 분포가 달라지는 문제를 다룬다. AI · 머신러닝 · On KL-Regularized Policy Optimization
Key Point LLM 강화학습에서 온라인 정책과 생성 정책의 불일치 문제를 일반적으로 해결하는 프레임워크로, 기존 방법보다 효율적이고 여러 알고리즘을 통합한다.
핵심 요약
LLM 에이전트의 비동기 강화학습에서 이전 버전으로 생성한 궤적을 현재 정책으로 학습하는 과정에서 샘플러와 트레이너의 확률 분포가 달라지는 문제를 다룬다. 기존 방식(클리핑이나 GRPO)은 편향을 초래하거나 긴 에피소드에서 계산 비용이 크다는 문제가 있다. 저자들은 KL-정규화 정책 최적화(KLPO)를 제안하며, KL 정규화 항을 샘플러 확률에 고정해 중요도 가중치 없이 직접 최적화할 수 있게 한다. 전체 요약 8문장 읽기 → 057 18:30 ▲ 32 · 댓글 2 반복 자기 증류 중 성능 붕괴 막는 ReSAIL 논문 발표 LLM 에이전트의 반복 자기 증류를 통한 재귀적 자기 개선은 순환이 거듭날수록 배포 성능과 특권 정보(PI) 조건부 성능이 붕괴되는 문제가 있다. AI · 머신러닝 · ReSAIL: Mitigating Collapse in Iterative Agent Self-Distillation
Key Point LLM 에이전트의 지속적인 자기 개선이 현실적으로 작동하려면 반복 순환 간 성능 저하를 반드시 해결해야 하는데, ReSAIL이 이를 첫 번째로 효과적으로 해결한 접근 방식을 제시하기 때문이다.
핵심 요약
LLM 에이전트의 반복 자기 증류를 통한 재귀적 자기 개선은 순환이 거듭날수록 배포 성능과 특권 정보(PI) 조건부 성능이 붕괴되는 문제가 있다. ReSAIL(Retentive and Selective Augmentation for Iterative Self-Distillation)은 이 붕괴를 해결하기 위해 특권 정보가 교사 모델의 예측을 크게 변화시키는 상호작용 단계를 선별하는 플러그인 증강 기법이다. 선별된 단계와 미선별 단계 모두에서 학생 모델의 PI 조건부 출력 분포를 고정 교사 모델로 정규화하여 다음 순환에서 감독용 PI 조건부 행동을 보존한다. 전체 요약 6문장 읽기 → 058 18:30 ▲ 37 · 댓글 1 LLM 추론 안정성 높이는 새 학습 기법 제안 대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. AI · 머신러닝 · Semifactual Credit-Augmented Policy Optimization
Key Point 토큰 수준의 미세한 신용 할당으로 LLM 추론 정확도를 5~6% 개선하는 새로운 학습 기법으로, 프롬프트 표현에 과민한 모델의 근본적 문제를 다룬다.
핵심 요약
대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. 연구팀은 답을 유지하면서 프롬프트만 변경하는 반사실적 개입으로 이를 분석했고, 토큰 수준에서 큰 민감도 편차가 있으며 불안정한 토큰을 디코딩 중에 억제하면 모델 가중치를 업데이트하지 않아도 추론 정확도가 높아짐을 발견했다. 기존의 그룹상대정책최적화(GRPO)는 모든 응답 토큰에 동일한 이점을 할당하여 추론과 무관한 특성 의존성까지 강화할 수 있다는 한계가 있다. 전체 요약 7문장 읽기 → 059 09:11 ▲ 11 · 댓글 2 생의학 문장 인코더를 선택 결정 모델로 변환하는 방법 검색 학습으로 훈련된 생의학 문장 인코더를 스키마 제약이 있는 예/아니오 질문에 답하는 타입 결정 모델로 변환하는 SBERT2S1을 제시했다. AI · 머신러닝 · From Retrieval to Typed Decisions: Calibrated System One Models from Biomedical Sentence Encoders
Key Point 생의학 자연언어 이해 작업에서 검색 학습의 효과가 모델 구조에 따라 크게 달라진다는 점과 기존 강화학습 방식의 구체적인 한계를 정량적으로 규명했다.
핵심 요약
검색 학습으로 훈련된 생의학 문장 인코더를 스키마 제약이 있는 예/아니오 질문에 답하는 타입 결정 모델로 변환하는 SBERT2S1을 제시했다. 6개의 모델 쌍에서 제로샷 테스트 결과, 검색 학습이 있으면 내용 있는 선택지 매칭이 개선되는 것을 확인했다. 미세조정 후 효과는 모델 구조에 따라 달라졌는데, 검색 사전 정보를 유지하는 PFR 구조는 5개 모델 쌍과 3개 훈련 크기에서 15번 중 10번 개선되었으나, 교차 주의 구조(C)는 5번 악화되고 1번만 개선됐다. 전체 요약 7문장 읽기 → 060 12:11 ▲ 19 · 댓글 2 의미·기하 구조 동시 학습, 픽셀 확산 모델 성능 끌어올리다 Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. AI · 머신러닝 · PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
Key Point 의미 정보와 기하 정보를 분리해 학습하는 구조적 혁신으로 텍스트-이미지 생성부터 이미지 편집까지 여러 작업에서 동시에 성능을 끌어올렸으며, 전통적 단일 정렬 방식의 한계를 넘었다.
핵심 요약
Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. 최근 분석이 정렬 효과의 핵심이 의미 정보가 아닌 공간 구조(spatial structure)임을 지적했으나, 그러한 구조를 예측하도록 훈련된 기초 모델들은 간과되어 왔다. 픽셀 공간 확산에서 SAM2, Depth Anything v2, Metric3D v2는 DINOv2 단독 기준보다 우수하며, 특히 기하 정보를 학습하는 모델들이 분할 모델을 앞선다. 전체 요약 10문장 읽기 → 061 21:11 ▲ 29 · 댓글 2 다중 보상 학습 최적화하는 CorrGRPO 알고리즘 Group Relative Policy Optimization(GRPO)은 추론 언어 모델 학습에 널리 쓰이며, 동일 프롬프트 롤아웃에서 보상을 중심화·정규화해 이점을 계산한다. AI · 머신러닝 · CorrGRPO: Correlation-Normalized GRPO for Multi-Reward Learning
Key Point 여러 목표를 동시에 최적화해야 하는 언어 모델 학습에서 각 보상의 영향력을 균형 있게 조절하는 새로운 방법을 제시하므로, 추론 모델과 에이전트 개발자에게 실질적인 개선 기회를 제공한다.
핵심 요약
Group Relative Policy Optimization(GRPO)은 추론 언어 모델 학습에 널리 쓰이며, 동일 프롬프트 롤아웃에서 보상을 중심화·정규화해 이점을 계산한다. 다중 보상 처리 시 기존 GRPO는 보상 성분을 합산한 뒤 그룹 내 표준편차로 정규화하는데, 분산이 모든 보상 공분산의 합이 된다. 중심화된 보상이 고정될 때 공분산이 클수록 이점이 작아지므로, 보상 간 상관성에 따라 업데이트 크기가 적응하지만 대규모 보상이 정규화를 지배해 소규모 보상 신호를 억제한다. 전체 요약 8문장 읽기 → 062 15:11 ▲ 56 · 댓글 2 다중 보상 RL에서 희소 신호까지 균등하게 학습시키는 방법 다중 보상 강화학습은 LLM이 여러 행동 목표를 동시에 만족하도록 훈련하는데, GDPO의 보상별 정규화 방식도 목표마다 학습 진도가 불균형하다는 문제가 있다. AI · 머신러닝 · Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL
Key Point 다중 보상 학습에서 일부 목표만 우선 학습되는 문제를 밀도 기반의 수학적 분석으로 해결하고, 훈련 효율을 크게 개선한 방법론이다.
핵심 요약
다중 보상 강화학습은 LLM이 여러 행동 목표를 동시에 만족하도록 훈련하는데, GDPO의 보상별 정규화 방식도 목표마다 학습 진도가 불균형하다는 문제가 있다. 연구팀은 '장점 에너지(advantage energy)'—배치 내 보상의 제곱된 장점의 합—를 분석하여, 이 에너지가 '활동 밀도'(보상이 0이 아닌 상대적 장점을 제공하는 롤아웃 그룹의 비율)에 비례함을 증명했다. 이는 배치 단위의 신호 불균형을 드러내고, 보상 기여도 보정의 근거를 제공한다. 전체 요약 7문장 읽기 → 063 06:11 ▲ 12 · 댓글 2 동영상 스트림으로 자기지도학습하는 StreamMAE 제시 자기지도학습은 영아 시각 발달을 모방하지만 현재 학습은 이미지를 무작위로 섞어 쓰는데, 이 논문은 연속 동영상 스트림으로부터의 학습을 연구했다. AI · 머신러닝 · I Have a Stream: Making Self-Supervised Learning Work on Continuous Video
Key Point 영아가 학습하는 방식과 유사한 연속 동영상 스트림에서 자기지도학습이 왜 어려운지, 그리고 이를 극복하는 기술적 방법을 제시하는 논문으로, 현실 세계의 실시간 영상 데이터 활용에 영향을 미칠 수 있다.
핵심 요약
자기지도학습은 영아 시각 발달을 모방하지만 현재 학습은 이미지를 무작위로 섞어 쓰는데, 이 논문은 연속 동영상 스트림으로부터의 학습을 연구했다. 95시간 도시 산책 동영상으로 만든 WT++ 데이터셋에서 시간 순서대로 슬라이딩 윈도우 배치로 프레임을 처리하되, 전역 셔플이나 멀티에포크 재생 없이 학습했다. 대조 학습과 증류 기반 방법은 이 설정에서 성능이 떨어졌고, MAE도 기준 i.i.d. 사전학습에 못 미쳤다. 전체 요약 6문장 읽기 → 064 21:11 당일 +213 215개 해킹 도구를 한곳에, AI로 검색하고 실행하는 통합 보안 플랫폼 Python 기반 올인원 보안 테스트 도구로, 정찰, OSINT, 웹, 무선, 피싱, 포렌식, 사후 착취 등 21개 카테고리의 215개 도구를 한 콘솔에서 관리한다. 보안 · Z4nzu/hackingtool · Python
Key Point 보안 테스트의 도구 분산 문제를 AI 기반 통합 콘솔로 해결하고, 정찰부터 사후 착취까지 전 단계의 도구를 한 프레임워크에서 관리·실행할 수 있게 한다.
핵심 요약
Python 기반 올인원 보안 테스트 도구로, 정찰, OSINT, 웹, 무선, 피싱, 포렌식, 사후 착취 등 21개 카테고리의 215개 도구를 한 콘솔에서 관리한다. AI 레이어가 자연어 입력을 올바른 도구와 정확한 명령어로 변환해주며, 사용자는 '/find'로 필요한 도구를 GitHub API까지 검색하고 '/goal'로 목표를 단계별로 계획·실행할 수 있다. Python 3.10 이상, Linux·macOS 환경에서 pipx나 Docker로 설치 가능하며, 별도 런타임(Go, Ruby, tmux 등)이 필요한 도구도 있지만 핵심 앱은 독립적으로 동작한다. 전체 요약 10문장 읽기 → 065 21:11 당일 +128 다양한 골격에 애니메이션을 주는 통합 모델 UniMate 공개 SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. AI · 머신러닝 · Friedrich-M/UniMate · Python
Key Point 텍스트 기반 3D 애니메이션 생성의 일반화 문제를 단일 모델로 해결한 첫 사례이며, 영상 제작·게임 개발·디지털 캐릭터 제작 분야의 자동화를 크게 앞당길 기술이기 때문이다.
핵심 요약
SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. UniML3D라는 13,006개 텍스트 쌍 모션 시퀀스 데이터셋을 구축했으며, Mixamo, Objaverse-XL, Truebones ZOO에서 수집한 자산을 통일된 형식으로 정규화했다. 텍스트 프롬프트와 3D 리깅된 자산만으로 실시간 모션 생성이 가능하며, 스켈레톤별 재학습이나 테스트 시점 최적화가 필요 없다. 전체 요약 9문장 읽기 → 066 15:11 ▲ 96 · 댓글 1 진화 알고리즘에 웹 검색 최적화 더하다 LLM 기반 진화 알고리즘이 부족한 지식으로 인해 진행이 막힐 때 웹 검색으로 관련 문서를 공급하면 도움이 되지만, 단순히 검색 도구를 추가하면 솔루션이 바뀔 때도 같은 페이지만 반복해서 반환하는 문제가 있다. AI · 머신러닝 · EvoDuet: Bilevel Co-Evolution of Web Searching and Task Solving for Scientific Discovery
Key Point 큰 언어모델의 진화 알고리즘에서 웹 검색을 정교하게 제어해 지식 부족 문제를 해결하는 새로운 방법이 기존 기록을 경신했다.
핵심 요약
LLM 기반 진화 알고리즘이 부족한 지식으로 인해 진행이 막힐 때 웹 검색으로 관련 문서를 공급하면 도움이 되지만, 단순히 검색 도구를 추가하면 솔루션이 바뀔 때도 같은 페이지만 반복해서 반환하는 문제가 있다. EvoDuet은 모델 파라미터를 고정한 채 솔루션과 검색 쿼리를 동시에 진화시키는 이층 최적화 방법이다. 각 반복 단계마다 LLM이 지식 부족을 판단해 새 문서를 검색하거나 저장된 문서를 재사용하거나 검색 없이 진행할 수 있는 '검색 게이트'를 제공한다. 전체 요약 7문장 읽기 → 067 18:11 ▲ 15 · 댓글 2 로봇 매니퓨레이션을 위한 영상 시뮬레이터 WorldLine 공개 로봇 학습의 물리적 실행 비용을 줄이기 위해 영상 생성 모델 기반 시각 시뮬레이터가 필요한데, 기존 모델은 행동 추종 정확도와 로봇-객체 동역학 일관성이 부족하고 구체적 제어 데이터에 의존한다. AI · 머신러닝 · WorldLine: Action-Driven Visual Simulation for Robotic Manipulation
Key Point 로봇 매니퓰레이션 학습에서 물리적 실행 없이 행동 결과를 예측할 수 있는 범용 시뮬레이터는 개발 비용과 안전 위험을 크게 줄일 수 있기 때문입니다.
핵심 요약
로봇 학습의 물리적 실행 비용을 줄이기 위해 영상 생성 모델 기반 시각 시뮬레이터가 필요한데, 기존 모델은 행동 추종 정확도와 로봇-객체 동역학 일관성이 부족하고 구체적 제어 데이터에 의존한다. WorldLine은 행동 기반 시각 시뮬레이터로, 전이 가능한 동역학 학습을 이질적인 행동 그라운딩으로부터 분리한다. 10,000시간 이상의 행동 없는 로봇 영상과 10개 이상 로봇 체형에서 2,000시간 이상의 행동 궤적으로 학습한다. 전체 요약 8문장 읽기 → 068 12:11 ▲ 26 · 댓글 2 세계 모델의 표현 기하학을 다시 설계하다 JEPA 계열 잠재 세계 모델은 행동 조건 역학을 표현 공간에서 학습하며, 보통 유클리드 거리로 목표까지의 거리를 계산해 행동 후보를 평가한다. AI · 머신러닝 · Anisotropic Representations Improve Planning in JEPA World Models
Key Point 표현 정규화 방식의 변경이 세계 모델 기반 계획에 미치는 영향을 실증적으로 보여주므로, 이를 따르는 연구나 실제 모델 개발에 참고할 수 있다.
핵심 요약
JEPA 계열 잠재 세계 모델은 행동 조건 역학을 표현 공간에서 학습하며, 보통 유클리드 거리로 목표까지의 거리를 계산해 행동 후보를 평가한다. 기존 동적 모델은 표현 붕괴를 막기 위해 등방 가우시안 정규화를 사용했는데, 이것이 예측은 정확하더라도 작업의 실제 비용과 다른 기하학을 만들 수 있다. 연구팀은 이 불일치를 해결하기 위해 AnisoWM을 제안했으며, 고정된 추적과 비등방성 제약 하에서 학습 가능한 대각 공분산을 사용한다. 전체 요약 6문장 읽기 → 069 03:11 ▲ 10 · 댓글 3 강화학습으로 LLM 정책 증류 효율성 높이기 논문은 정책 증류(OPD)를 강화학습 관점으로 분석해 역KL 목적함수와 KL정규화 정책 최적화의 연결성을 규명했다. AI · 머신러닝 · An RL View of OPD: Least Square Policy Distillation for Sample-Efficient LLM Reasoning
Key Point LLM 정책 증류의 표본 효율성을 강화학습 이론으로 획기적으로 개선한 방법론으로, 수학 추론 등 복잡한 작업에서 필요한 롤아웃을 대폭 줄일 수 있다.
핵심 요약
논문은 정책 증류(OPD)를 강화학습 관점으로 분석해 역KL 목적함수와 KL정규화 정책 최적화의 연결성을 규명했다. 이를 바탕으로 최소제곱 정책 증류(LSPD) 프레임워크를 제안했으며, 값 기반 RL의 낙관적 탐색과 오프정책 데이터 재사용을 결합했다. LSPD는 탐색 중 정책 다양성을 유지하면서도 이전에 수집한 궤적을 반복 학습해 롤아웃 효율성을 개선한다. 전체 요약 6문장 읽기 → 070 18:11 ▲ 64 · 댓글 1 어텐션의 계산 효율을 높이는 MALA 메커니즘 제안 기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. AI · 머신러닝 · MassAlloc Attention: Let Attention Allocate Its Own Compute
Key Point Full Attention의 비효율적 계산 패턴을 식별하고 실제 기여도 기반 할당으로 2~3배 속도 향상을 달성하면서도 모델 성능을 유지하는 방법으로, 대규모 언어 모델의 추론·학습 효율을 개선하는 데 직결된다.
핵심 요약
기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. MALA(MassAlloc Attention)는 정규화된 기여도에 따라 후속 계산을 선택적으로 할당하는 퓨즈드 어텐션 프리미티브로, 순전파는 온라인 소프트맥스 정규화기를, 역전파는 최종 정규화기를 재사용한다. 하나의 공통 임계값으로 학습과 추론에서 적응적 유지(retention)가 가능하며, 8K 토큰 비교에서 생략된 질량은 0.0188%로 기준 오라클의 0.0182%에 근접한다. 전체 요약 7문장 읽기 → 071 15:11 ▲ 27 · 댓글 1 깊은 신경망에서 잔차 연결이 정말 효과적일까 Transformer의 깊이를 늘리면 계산 능력이 증가하지만, 깊어질수록 추가 레이어의 기여도가 감소하는 문제가 있다. AI · 머신러닝 · DepthBench: Measuring How Residual Connections Enable More Computational Depth
Key Point Transformer 모델 설계에서 깊이를 늘릴 때 어떤 구조 기법이 실제로 효과적인지를 과학적으로 증명하는 연구로, 향후 대규모 모델 개발 방향을 결정하는 기초가 될 수 있다.
핵심 요약
Transformer의 깊이를 늘리면 계산 능력이 증가하지만, 깊어질수록 추가 레이어의 기여도가 감소하는 문제가 있다. 최근 LayerNorm Scaling, mHC, AttnRes 같은 기법들이 정규화와 잔차 연결을 개선해 정보 흐름을 강화한다고 주장한다. 하지만 이런 기법들이 실제로 아키텍처 깊이를 계산상 깊이로 전환하는지, 다른 요인의 영향은 없는지 불명확하다. 전체 요약 9문장 읽기 → 072 15:11 ▲ 140 · 댓글 2 다중 전문가 모델 통합, 피드백 균형이 결정한다 강화학습으로 한 언어모델을 수학, 코딩, 지시 따르기 등 단일 분야에 특화된 여러 전문가 모델로 나눌 수 있지만, 사용자는 모든 능력을 갖춘 하나의 모델이 필요하다. AI · 머신러닝 · Beyond Teacher Assignment: Domain-Normalized Multi-Teacher On-Policy Distillation
Key Point 여러 전문 분야의 언어모델을 하나로 통합할 때 단순 라우팅만으로는 부족하며, 도메인별 피드백의 강도를 정규화해야 모든 능력을 균형 있게 갖춘 학생 모델을 만들 수 있다는 실증적 발견을 제시한다.
핵심 요약
강화학습으로 한 언어모델을 수학, 코딩, 지시 따르기 등 단일 분야에 특화된 여러 전문가 모델로 나눌 수 있지만, 사용자는 모든 능력을 갖춘 하나의 모델이 필요하다. 기존 다중교사 정책 내 증류(MOPD) 방식은 학생 모델이 각 프롬프트에 답하면 해당 분야의 전문가가 모든 토큰에 대해 피드백을 주도록 라우팅하는 방식으로 통합한다. Qwen 3.5 세 가지 크기에서 실험한 결과, MOPD 학생 모델은 최고의 단일 전문가 모델을 이기지 못했으며 수학 전문가의 장점을 거의 얻지 못했다. 전체 요약 8문장 읽기 → 073 09:11 새 버전 uv 0.12.20 릴리스, 락파일 재사용·메타데이터 빌드 개선 Python 패키지 관리 도구 uv 0.12.20이 2026년 9월 28일 공개되었다. 오픈소스 · 도구 · astral-sh/uv@0.12.20
Key Point Python 의존성 해석과 설치를 담당하는 핵심 도구의 안정성 개선으로, 특히 복잡한 워크스페이스·반복 의존성·크로스 플랫폼 환경에서 버그가 수정되었다.
핵심 요약
Python 패키지 관리 도구 uv 0.12.20이 2026년 9월 28일 공개되었다. 의존성 선언이 의미상 동일하면 락파일을 재사용하고, CRLF 셔뱅을 가진 wheel 스크립트 설치 시 두 번째 줄 인코딩 선언을 보존한다. preview 기능으로 정규화된 요구사항 선언을 락파일에 작성하며, 첫 번째 파티 워크스페이스 프로젝트의 메타데이터 빌드를 --no-build 플래그 아래서도 허용한다. 전체 요약 9문장 읽기 → 074 00:11 ▲ 177 · 댓글 83 IRC 표준으로 작동하는 연합형 채팅 네트워크 Parley Parley는 중앙 서버 없이 DNS와 HTTPS 서명으로 개별 인스턴스들이 연결되는 분산 채팅 네트워크다. 웹 · 프론트엔드 · Parley: Federated, decentralised chat that speaks plain IRC
Key Point IRC 클라이언트를 그대로 쓰면서 중앙 통제 없이 서로 다른 인스턴스 간에 채팅하는 연합형 네트워크를 실현했으며, 온전한 기술 명세와 Docker 배포 가능한 구현을 제공한다.
핵심 요약
Parley는 중앙 서버 없이 DNS와 HTTPS 서명으로 개별 인스턴스들이 연결되는 분산 채팅 네트워크다. 일반 IRC 클라이언트(irssi, WeeChat, Textual 등)로 바로 접속하며, alice@foo.com처럼 이메일 형식의 정체성을 사용한다. 전역 채널 #dev는 연결된 모든 인스턴스에 복제되고, 로컬 채널 ¬es는 해당 인스턴스에만 존재한다. 전체 요약 11문장 읽기 → 075 12:11 ▲ 117 · 댓글 3 인코더 레이어 융합 최적화로 이미지 생성-재구성 성능 차이 해소 Representation Autoencoder(RAE)는 사전학습된 비전 인코더의 피처를 재구성과 확산 잠재공간으로 재사용해 이미지 생성에 강력한 표현을 통합한다. AI · 머신러닝 · FuseReg: Regularizing Layer Fusion Mitigates the Reconstruction-Generation Gap in Representation Autoencoders
Key Point RAE 기반 이미지 생성 시스템에서 인코더 레이어 선택에 따른 성능 트레이드오프를 정규화 기법으로 해결하는 방법을 제시해, 생성 품질과 재구성 품질을 동시에 개선할 수 있음을 보여준다.
핵심 요약
Representation Autoencoder(RAE)는 사전학습된 비전 인코더의 피처를 재구성과 확산 잠재공간으로 재사용해 이미지 생성에 강력한 표현을 통합한다. 기존 RAE는 어느 인코더 레이어가 생성기와 픽셀 디코더의 공유 잠재공간을 형성할지 결정해야 하는데, 얕은 레이어는 세부 픽셀 정보를 잘 보존하지만 깊은 레이어는 생성 품질이 우수한 트레이드오프가 존재한다. FuseReg는 휴리스틱 피처 선택을 인코더 레이어의 무작위 부분집합 학습으로 대체하여 레이어 간 불일치의 민감도를 명시적으로 페널라이즈한다. 전체 요약 6문장 읽기 → 076 03:11 ▲ 106 · 댓글 11 Intel 8087의 탄젠트 계산, CORDIC과 다항식의 결합 1980년 Intel 8087 칩의 탄젠트 명령어(FPTAN) 알고리즘을 역공학으로 분석한 글로, 8086 대비 90마이크로초 vs 13,000마이크로초의 극적인 성능 향상을 달성한 메커니즘을 설명한다. 하드웨어 · 시스템 · Reverse-engineering the Intel 8087's tangent algorithm: more than CORDIC
Key Point 정수 시대 최고 성능의 부동소수점 칩이 어떻게 극복할 수 없어 보이던 성능 한계를 넘었는지 하드웨어 레벨에서 역공학한 분석으로, 현대 칩 설계가 해결하는 문제들의 근원을 보여준다.
핵심 요약
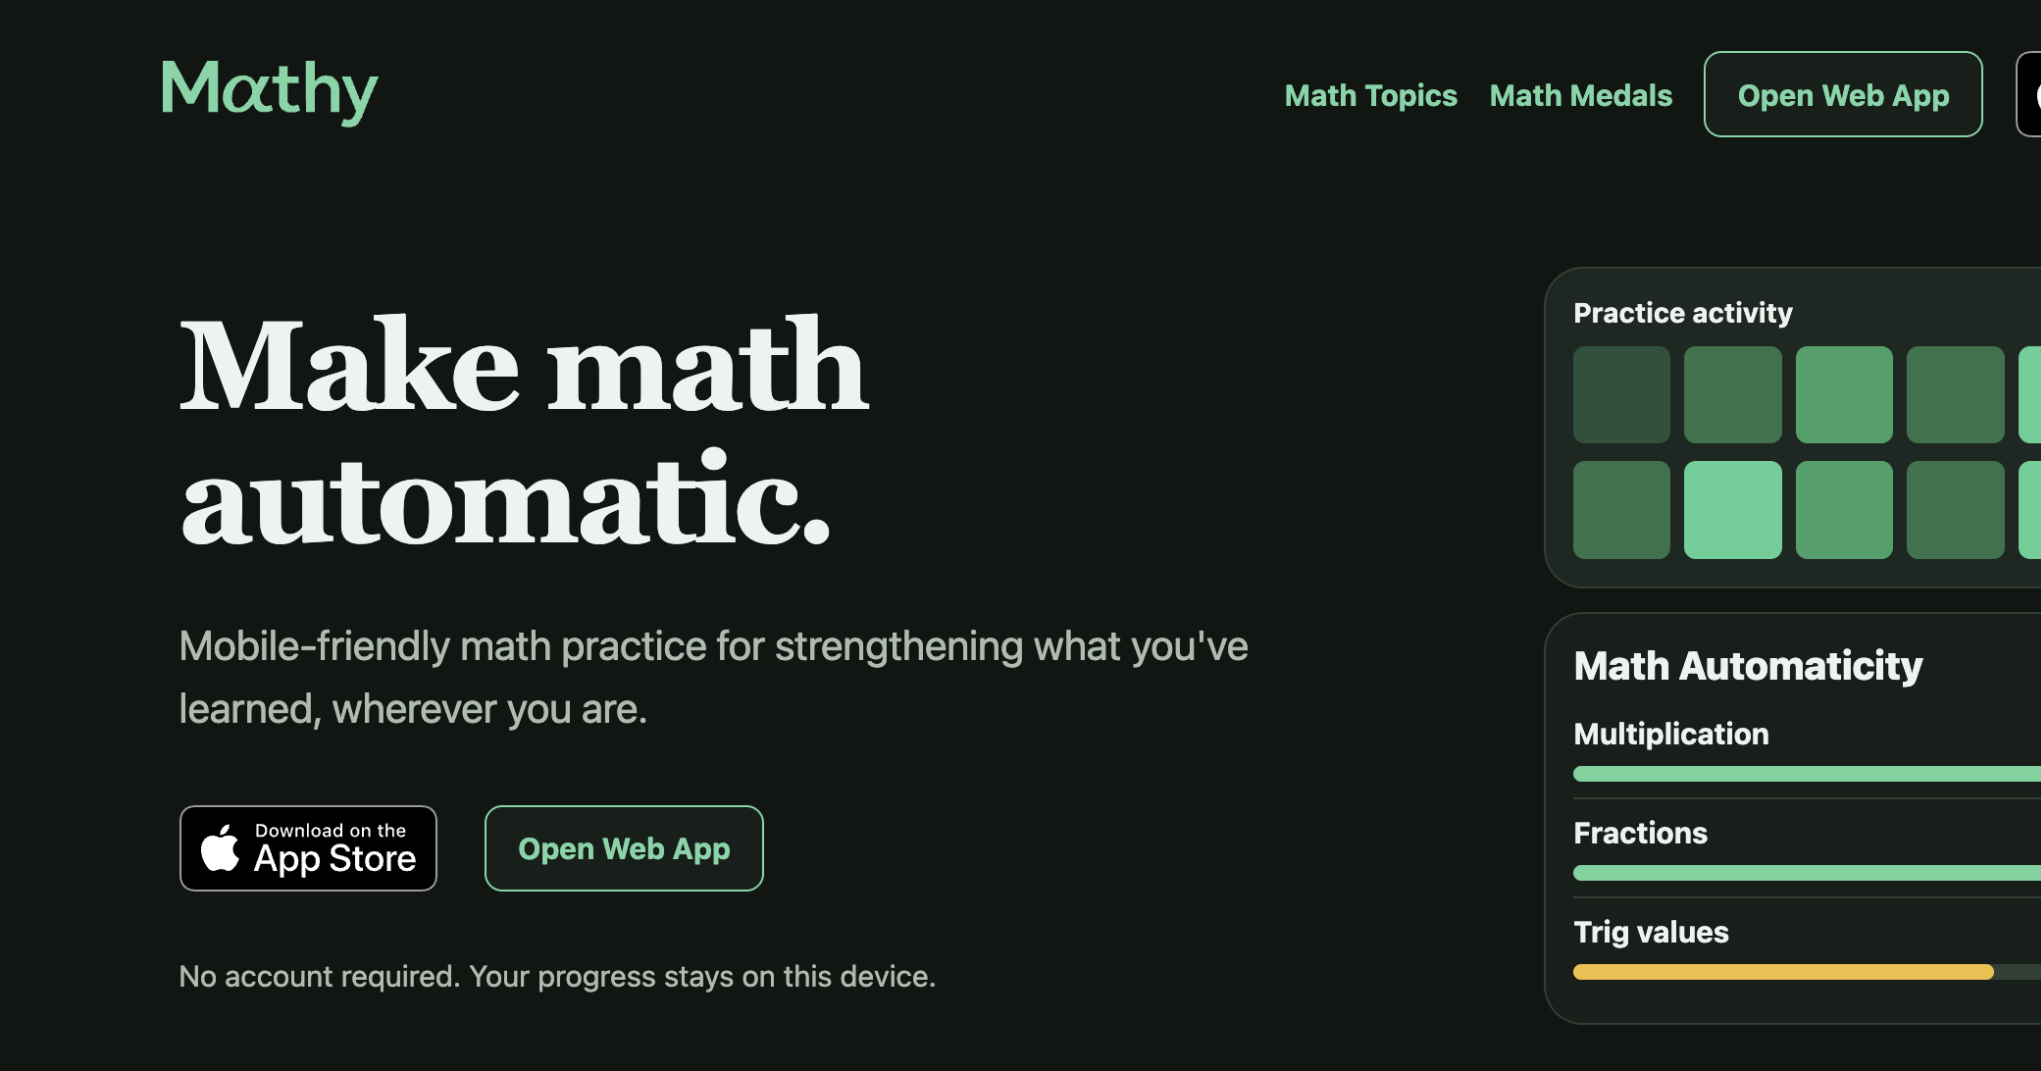
1980년 Intel 8087 칩의 탄젠트 명령어(FPTAN) 알고리즘을 역공학으로 분석한 글로, 8086 대비 90마이크로초 vs 13,000마이크로초의 극적인 성능 향상을 달성한 메커니즘을 설명한다. 8087은 CORDIC(좌표 회전 디지털 컴퓨터) 알고리즘과 Padé 근사 다항식을 결합했으며, 이는 1950년대 B-58 Hustler 폭격기 항법 컴퓨터를 위해 개발된 CORDIC을 16비트 정확도까지만 적용하고 나머지 각도는 다항식으로 처리하는 방식이다. CORDIC은 삼각함수를 특수 각도(arctan(2^-n))의 조합으로 분해한 뒤 회전 행렬을 적용하는데, 시프트와 덧셈만으로 계산할 수 있어 하드웨어 친화적이며 각 반복마다 1비트의 정확도를 얻는다. 전체 요약 12문장 읽기 → 077 00:11 ▲ 100 · 댓글 30 수학 자동화를 위한 모바일 앱 'Mathy' 출시 수학 개념 학습이 아닌 자동화된 계산·공식 암기를 위한 무료 모바일 앱 Mathy를 개발자가 공개했다. 웹 · 프론트엔드 · Show HN: Make math automatic with Mathy
Key Point 수학 학습자가 직접 개발한 무료 자동화 연습 도구로, 기존 플래시카드의 불편함을 해결하고 개념 학습이 아닌 순수 숙련도 유지에만 초점을 맞춘 새로운 접근 방식을 보여준다.
핵심 요약
수학 개념 학습이 아닌 자동화된 계산·공식 암기를 위한 무료 모바일 앱 Mathy를 개발자가 공개했다. Math Academy의 학습자가 보충 학습 도구로 쓸 수 있도록 설계했으며, FSRS 간격 반복 알고리즘을 이용해 습득 상태에 따라 복습 일정을 자동으로 조정한다. 숙련도가 올라갈수록 복습 빈도가 줄어드는 구조로, 자동화 달성 후엔 주기적 유지만으로 충분하도록 한다. 전체 요약 12문장 읽기 → 078 22:26 당일 +411 에이전트가 학습하는 장기 메모리 시스템 Hindsight 공개 Hindsight는 대화 기록 재호출이 아닌 학습 능력에 중점을 둔 에이전트 메모리 시스템으로, RAG와 지식그래프의 한계를 극복하고 LongMemEval 벤치마크에서 최고 성능을 기록했다. AI · 머신러닝 · vectorize-io/hindsight · Python
Key Point 에이전트가 단순히 과거 대화를 불러오는 것을 넘어 경험에서 배우고 정신 모델을 스스로 구축하도록 설계된 새로운 메모리 시스템으로, 기존 RAG와 지식그래프의 한계를 기술적으로 해결하면서도 LongMemEval에서 검증된 성능을 제공하고 있다.
핵심 요약
Hindsight는 대화 기록 재호출이 아닌 학습 능력에 중점을 둔 에이전트 메모리 시스템으로, RAG와 지식그래프의 한계를 극복하고 LongMemEval 벤치마크에서 최고 성능을 기록했다. 세계 사실, 에이전트 경험, 관찰, 정신 모델 등 4가지 메모리 타입을 바이오미메틱 데이터 구조로 조직하며, 메모리 뱅크 내에 엔티티, 관계, 시계열과 희소/밀집 벡터 표현을 결합한다. Retain(정보 저장) 연산은 LLM으로 사실과 관계를 추출하고 정규화하며, Recall(검색) 연산은 의미론적·키워드·그래프·시간 범위 필터링을 병렬로 수행한 뒤 역상호 순위 융합과 교차 인코더로 재정렬한다. 전체 요약 13문장 읽기 → 079 22:26 새 버전 Rails 8.1.4 릴리스, 126개 버그 수정 Rails 8.1.4가 출시되었으며 Active Support, Active Model, Active Record 전체에서 126개의 버그를 수정했다. 웹 · 프론트엔드 · rails/rails@v8.1.4
Key Point 복합 기본키, 데이터베이스 연결 풀, 마이그레이션 가역성 등 Active Record의 광범위한 버그가 수정되어 기존 애플리케이션의 안정성과 동작이 개선된다.
핵심 요약
Rails 8.1.4가 출시되었으며 Active Support, Active Model, Active Record 전체에서 126개의 버그를 수정했다. Active Support에서는 SyntaxError 디버그 페이지 렌더링, JSON 3.0 호환성, number_to_human_size의 테라바이트 이상 단위 지원(페타/엑사/제타바이트) 등을 개선했다. Range, Enumerable, HashWithIndifferentAccess, TimeZone 등 핵심 유틸리티에서 다양한 충돌과 동작 오류를 해결했고, 문자열/숫자 형식 함수에서 nil 값 처리와 인코딩 보존 문제를 수정했다. 전체 요약 10문장 읽기 → 080 22:29 당일 +193 AI 에이전트의 학습 기록을 모아 재사용 가능한 메모리로 만드는 Beacon Claude Code, Cursor, Codex, OpenCode 등 20여 개의 AI 코딩 에이전트 도구에서 세션 기록을 수집해 한곳에 통합하는 오픈소스 메모리 레이어다. AI · 머신러닝 · Asymptote-Labs/agent-beacon · Go
Key Point 여러 AI 코딩 에이전트를 함께 쓰는 개발자라면 각 도구마다 격리된 세션 기록 때문에 같은 문제를 반복 학습하는 비효율을 겪는데, Beacon은 이를 통합 메모리로 전환해 크로스 도구 학습의 누적 효과를 만든다.
핵심 요약
Claude Code, Cursor, Codex, OpenCode 등 20여 개의 AI 코딩 에이전트 도구에서 세션 기록을 수집해 한곳에 통합하는 오픈소스 메모리 레이어다. 에이전트의 프롬프트·응답·도구 호출·명령·파일 활동·승인·MCP 상호작용·토큰 사용을 OpenTelemetry 기반 공통 형식으로 정규화한다. 워크플로우·디버깅 패턴·저장소 규칙 등 유용한 지식을 추출해 미래 에이전트가 접근할 수 있도록 Agent Skills 형태로 제공한다. 전체 요약 9문장 읽기 → 081 22:29 ▲ 16 · 댓글 3 토큰화 효율 높이는 기능 분해 방식 제안 기존 서브워드 토크나이저는 같은 단어의 대소문자·악센트 변형(hello, Hello, Héllo)을 서로 다른 어휘로 처리해 임베딩 공간이 파편화되거나, 정규화로 정보를 손실시킨다. AI · 머신러닝 · The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
Key Point 같은 단어의 다양한 표기를 효율적으로 처리해 모델의 어휘 크기를 줄이고 코드 생성 정확도를 높이는 실질적 개선 방법이기 때문입니다.
핵심 요약
기존 서브워드 토크나이저는 같은 단어의 대소문자·악센트 변형(hello, Hello, Héllo)을 서로 다른 어휘로 처리해 임베딩 공간이 파편화되거나, 정규화로 정보를 손실시킨다. 논문은 직교 및 구조 변형을 함수형 분해로 처리하는 Functionalizer를 제안한다. 대문자화(CAPITALIZE), 발음 기호(13개 전용 옵코드), 문자 반복(REPEAT, MULTIREPEAT) 등의 가역 연산자를 사용해 유니코드 개인용 영역에 인코딩한 프리픽스 스트림으로 정규 기본 토큰 앞에 붙인다. 전체 요약 6문장 읽기 → 082 22:29 ▲ 112 · 댓글 26 클라우드플레어, HTTP Vary 헤더 캐싱 지원 시작 HTTP의 Vary 응답 헤더는 캐시에 요청의 어떤 필드가 응답에 영향을 미치는지 알려주지만, 어떤 차이가 실제로 중요한지는 알려주지 않는 것이 문제다. 인프라 · 데브옵스 · We just shipped support for the ugliest part of HTTP: Vary
Key Point 같은 URL에서 언어나 형식이 다른 여러 응답을 캐싱할 때 효율성을 잃던 문제를 해결하는 방식이 나왔으므로, CDN을 쓰는 개발자와 운영자에게 캐시 전략을 재검토할 기회를 제공한다.
핵심 요약
HTTP의 Vary 응답 헤더는 캐시에 요청의 어떤 필드가 응답에 영향을 미치는지 알려주지만, 어떤 차이가 실제로 중요한지는 알려주지 않는 것이 문제다. 같은 URL이 서로 다른 이미지 형식이나 언어로 여러 응답을 가질 수 있을 때, 캐시가 Vary를 무시하면 잘못된 응답을 전달하고, 모든 값을 구별하면 캐시 항목이 수천 개로 증가해 재사용성이 떨어진다. 원점 서버가 영어, 프랑스어, 독일어 3가지만 지원해도 클라이언트의 Accept-Language 값이 다르면 캐시는 같은 응답을 별개 항목으로 저장하고, 수십 개 필드에서 변동하면 1000개 이상의 조합이 생겨 캐시 효율이 급락한다. 전체 요약 11문장 읽기 → 083 18:11 ▲ 63 · 댓글 4 기업 문서 RAG를 위한 효율적 청킹 기법 D-RAC 공개 Hugging Face가 기업용 RAG 시스템을 위한 Document Retrieval-Aware Chunking(D-RAC) 기법을 발표했다. AI · 머신러닝 · Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware Ingestion of Enterprise Documents via PDF Normalization and Multimodal Markdown Conversion
Key Point enterprise RAG 도입 시 문서 처리 비용과 속도가 실무상 가장 큰 병목이며, 이 기법이 정규화 단계에서 극적인 효율 개선을 달성했기 때문이다.
핵심 요약
Hugging Face가 기업용 RAG 시스템을 위한 Document Retrieval-Aware Chunking(D-RAC) 기법을 발표했다. 모든 문서 포맷을 PDF로 정규화한 뒤 멀티모달 LLM으로 단 한 번의 처리만으로 검색 최적화된 마크다운으로 변환한다. 표는 자체 포함 문장으로 재작성되고 제목 계층 구조가 보존되며, 청킹은 ID 기반 파싱과 경량 LLM 처리만 거친다. 전체 요약 6문장 읽기 → 084 16:18 ▲ 196 · 댓글 2 LLM 에이전트 자동 최적화, 과적합 방지 기법 제시 LLM 에이전트의 성능을 좌우하는 프롬프트·제어 흐름·도구·메모리 등 구성 요소를 자동으로 개선하는 재귀적 자체 개선(RSI) 방식이 학습 데이터에 과적합되는 문제를 확인했다. AI · 머신러닝 · RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
Key Point LLM 에이전트 자동 최적화가 실무 문제인 과적합을 해결하면서 일반화 성능을 확보한 방법론으로, 에이전트 개발의 효율성과 신뢰성을 동시에 높인다.
핵심 요약
LLM 에이전트의 성능을 좌우하는 프롬프트·제어 흐름·도구·메모리 등 구성 요소를 자동으로 개선하는 재귀적 자체 개선(RSI) 방식이 학습 데이터에 과적합되는 문제를 확인했다. 구글 연구팀이 제안한 RRSI는 제약 조건을 도입해 과적합을 줄인다: 제안 모듈에서 편집 횟수를 시간에 따라 제한하고 미탐색 경로를 선호하며, 선택 모듈에서 벤치마크 특화 제안과 불필요한 변경을 거른다. 코딩·에이전트 작업·설계 과제 8개 벤치마크에서 학습 데이터에는 최대 14.1점, 미학습 데이터에는 최대 4.7점 성능 향상을 달성했다. 전체 요약 4문장 읽기 → 085 21:11 ▲ 179 · 댓글 98 브라우저에서 LLM 의사결정 방식 직접 비교 OpenJev는 로컬 LLM이 선택지별 확률을 계산하는 두 가지 방식을 브라우저에서 직접 비교하는 인터랙티브 도구다. 기타 · OpenJev
Key Point 두 의사결정 방식의 성능 차이를 실측할 수 있어, LLM을 실제 애플리케이션에 활용할 때 최적의 방법을 선택하는 데 도움이 된다. ai
핵심 요약
OpenJev는 로컬 LLM이 선택지별 확률을 계산하는 두 가지 방식을 브라우저에서 직접 비교하는 인터랙티브 도구다. 한 방식은 모델의 로짓(logits)을 직접 읽어 정규화하고, 다른 방식은 모델이 확률을 JSON 텍스트로 생성하도록 요청한다. Qwen3 0.6B(639MB), MiniCPM5 2B(1.56GB), Qwen3.5 4B(3.01GB) 세 가지 크기의 모델을 선택해 실행할 수 있다. 전체 요약 5문장 읽기 → 086 00:10 ▲ 102 · 댓글 23 PyTorch로 직접 구현한 최신 LLM 아키텍처 학습 저장소 최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다. AI · 머신러닝 · OpenArch – PyTorch implementations of modern LLM architectures
Key Point LLM 아키텍처의 세부 설계 차이를 명확히 읽고 비교하고 싶은 개발자라면, 프로덕션 코드의 복잡성 없이 각 선택지가 어떻게 구현되는지 바로 확인할 수 있다.
핵심 요약
최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다. GPT-2, Llama 2/3/4, Qwen, Mistral, DeepSeek R1 등 11개 텍스트 모델과 PaliGemma, Qwen3 등 멀티모달 모델을 구현 중이며, 추가로 72개 아키텍처 전체 구현을 목표로 한다. 주의 메커니즘(MHA, GQA, MQA, MLA), 정규화(RMSNorm, QK-Norm), 위치 인코딩(RoPE, NoPE), MoE 라우팅 등 현대 LLM들이 사용하는 구조적 선택지를 명시적으로 표현해 비교하기 쉽게 했다. 전체 요약 5문장 읽기 →