쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 3일 (화)까지 3800건
50건 · "캐싱"조건 지우기 ×
001 21:11 당일 +654 290B 모델을 데스크톱에서 실행하는 엣지 추론 엔진 FreeToken FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. AI · 머신러닝 · FlashML-org/FreeToken · Python
Key Point 소비자용 GPU로 290B 규모의 대형 MoE 모델을 실시간 속도로 로컬 실행할 수 있게 되어, 개인 개발자와 소규모 팀도 엣지에서 프론티어급 AI 모델을 직접 운영할 수 있는 가능성을 열어준다.
핵심 요약
FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. GPU, CPU, 호스트 메모리, 상호연결을 통합 플랫폼으로 활용하며, 대역폭 적응형 CPU-GPU 협력 실행(q* 정책)과 레이어 이중 버퍼링 프리필 스트리밍을 지원한다. 의미 기반 캐싱으로 상태와 KV 캐시의 앵커 체크포인트를 저장하여, 도구 호출·사고 블록 같은 에이전트 컨텍스트 편집 시 중복 재계산을 피한다. 전체 요약 9문장 읽기 → 002 18:11 ▲ 101 · 댓글 3 확인된 부분만 처리하는 비전-언어 모델, 연산 35% 수준으로 줄인다 Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. AI · 머신러닝 · Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
Key Point 비전-언어 모델의 추론 속도를 현격히 높이는 기술로, 대규모 멀티모달 모델을 실제 제품에 적용하려는 개발자들에게 중요한 최적화 방안을 제시한다.
핵심 요약
Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. 연구팀이 LLaDA-V 모델의 예측을 검토한 결과, 이미지 제거 시 토큰 언마스킹이 변하는 경우가 평균 22.8%, 최저 7.9%에 불과했다. LOWN이라는 새로운 디코딩 방식을 제안했으며, 매 단계마다 이미지 처리 여부와 언마스킹할 토큰 수를 동적으로 결정한다. 전체 요약 7문장 읽기 → 003 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 004 03:11 ▲ 150 · 댓글 53 Ghostty 1.4.0 출시, Kitty 그래픽 완전 지원·성능 2배 개선 터미널 에뮬레이터 Ghostty 1.4.0이 7개월 개발 기간을 거쳐 172명 기여자의 2,889개 커밋으로 출시됐다. 인프라 · 데브옵스 · Ghostty 1.4.0
Key Point 새 터미널의 메모리 사용량이 8배 감소했고 대용량 파일 출력이 2.7배 빨라지는 등 실질적 성능 향상이 이뤄졌으며, Kitty 그래픽 완전 지원으로 플랫폼 간 호환성이 크게 개선됐다.
핵심 요약
터미널 에뮬레이터 Ghostty 1.4.0이 7개월 개발 기간을 거쳐 172명 기여자의 2,889개 커밋으로 출시됐다. 마지막 남은 Kitty 그래픽 기능인 애니메이션과 상대 위치 지정을 완성해 Kitty 외 첫 번째로 명세 100% 구현을 달성했으며, 이미지 전송이 16배 빨라졌다. 스크롤백 압축을 도입해 물리 메모리 사용량을 70~90% 감소시켰고, 기본 스크롤백 제한을 10MB에서 50MB로 상향했다. 전체 요약 13문장 읽기 → 005 00:11 새 버전 Laravel 13.39.0 릴리스, 버그 수정 및 기능 개선 Redis 클라이언트 broken pipe 경고 발생 시 재구성하는 기능 추가, 뷰 네임스페이스 힌트를 뷰 위치처럼 해석하도록 개선. 웹 · 프론트엔드 · laravel/framework@v13.39.0
Key Point Laravel의 안정성과 신뢰성을 높이는 약 50건의 버그 수정과 기능 개선이 포함된 정기 릴리스로, 특히 데이터베이스·캐시·큐·검증 관련 핵심 기능의 결함을 다수 해결했습니다.
핵심 요약
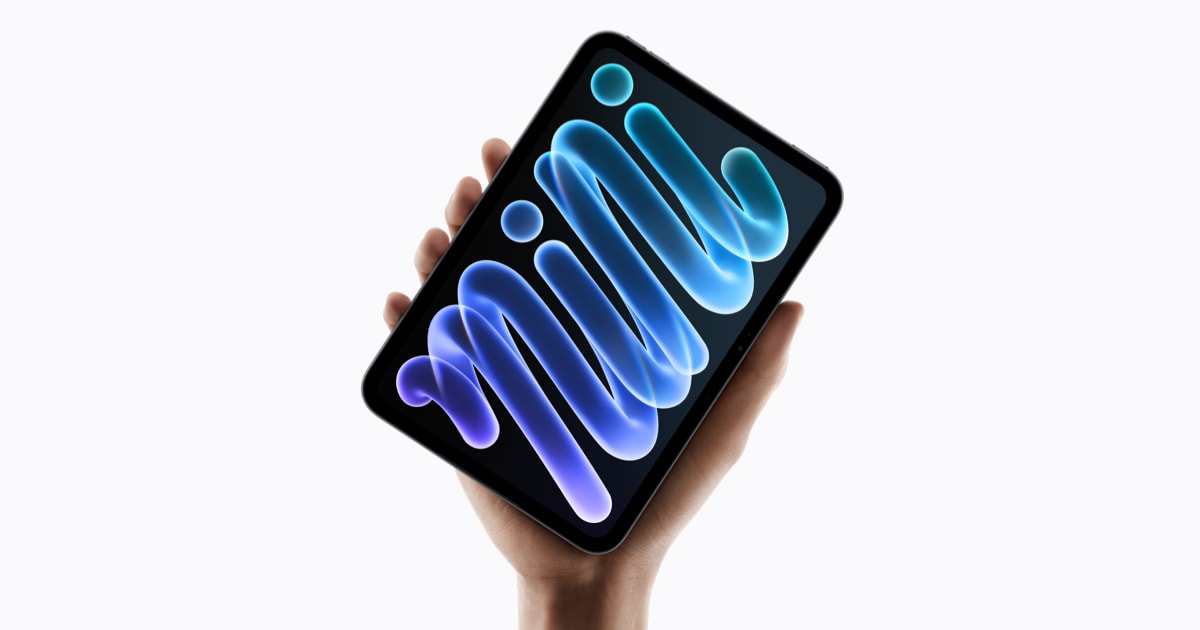
Redis 클라이언트 broken pipe 경고 발생 시 재구성하는 기능 추가, 뷰 네임스페이스 힌트를 뷰 위치처럼 해석하도록 개선. 테이블 프로퍼티 속성으로 프라이머리 키 비활성화 가능(#[Table(key: false)]), JobAttempted 이벤트에 duration 정보 추가. 설정·라우트·이벤트 캐시 파일을 원자적으로 작성하고, PostgreSQL 데이터베이스 캐시 락 트랜잭션 중단 버그 수정. 전체 요약 14문장 읽기 → 006 03:12 ▲ 110 · 댓글 107 애플, 신형 아이패드 미니 공개…OLED 화면과 AI 성능 대폭 강화 애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 하드웨어 · 시스템 · The new iPad mini
Key Point 신형 아이패드 미니는 OLED 디스플레이, A20 Pro의 4.5배 AI 성능 향상, IP67 방수 인증으로 소형 태블릿 시장의 기준을 다시 설정하며, 창작자와 야외 작업자들이 갖춰야 할 기기 사양이 크게 달라진다.
핵심 요약
애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 두께 5.4mm로 이전 세대 대비 더 얇고 가벼워졌으며, 베젤이 24% 줄어든 상태에서 디스플레이 크기를 8.5인치로 확대했다. OLED 패널은 피크 밝기 1200nits(이전 대비 2배 이상), 2,000,000:1 명암비, 1nit 최소 밝기를 지원하며, 선택사항으로 반사 감소 나노텍스처 옵션을 제공한다. 전체 요약 14문장 읽기 → 007 03:12 ▲ 296 · 댓글 38 추론 모델을 직접 구현하는 11시간 강의 공개 Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. AI · 머신러닝 · Sebastian Raschka's from-scratch video course on building reasoning models
Key Point 추론 모델 구현의 핵심 기법들(강화학습, 추론 시점 스케일링, 증류)을 직접 코딩하면서 배울 수 있는 완전한 실습 자료가 공개되어, LLM 개발자가 최신 추론 기술의 동작 원리를 깊이 있게 이해할 수 있다.
핵심 요약
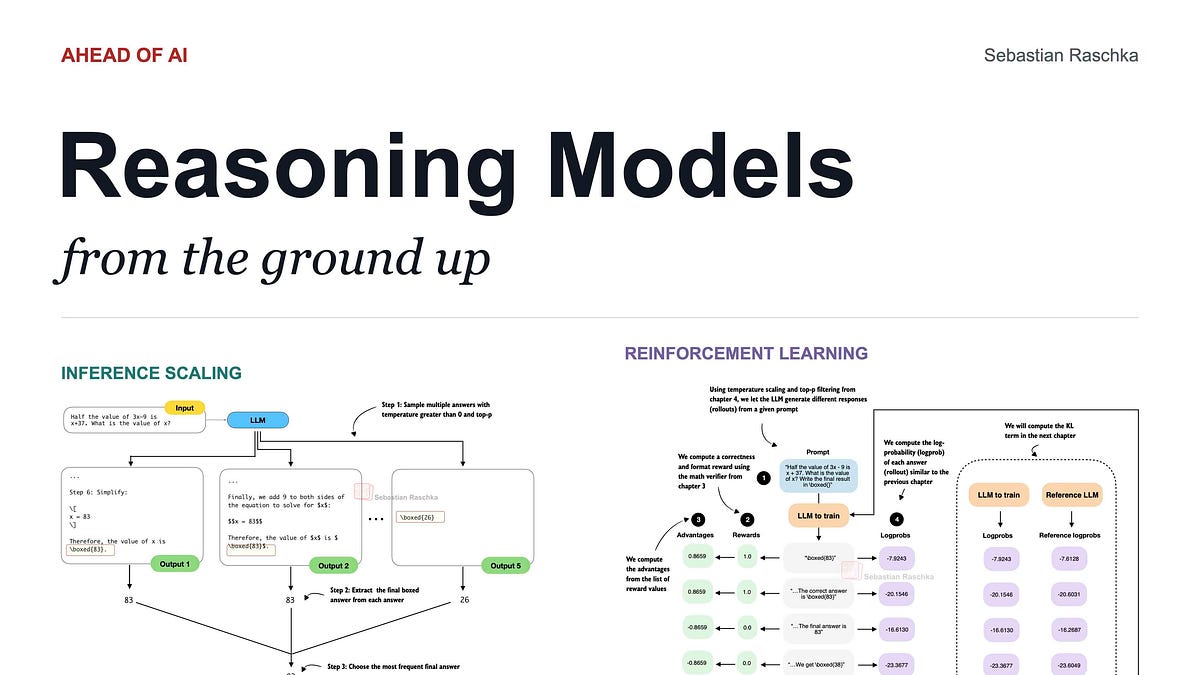
Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. Python과 PyTorch로 평가, 추론 시점 스케일링, 강화학습, 증류를 처음부터 끝까지 구현한다. 사전학습된 Qwen 0.6B 모델을 출발점으로, KV 캐싱, 다양한 텍스트 생성, 답 검증기 구축 등을 단계별로 다룬다. 전체 요약 8문장 읽기 → 008 18:11 ▲ 131 · 댓글 70 Next.js 걷어내니 라이트하우스 만점 블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 웹 · 프론트엔드 · Removing Next.js Got My Blog to 100 on Every Lighthouse Category
Key Point Next.js와 같은 현대 프레임워크가 정적 블로그처럼 상호작용이 거의 없는 사이트에서 성능을 해칠 수 있다는 구체적인 증거와, 만점을 위해 어떤 선택이 필요했는지 보여준다.
핵심 요약
블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 기존 선택지들(Medium, Blogger, Ghost, WordPress, Hugo)을 검토했으나 성능과 편의성 면에서 부족했고, Bear Blog를 영감 삼아 더 많은 기능을 갖춘 블로그를 직접 구축하기로 결심했다. 정적 웹사이트에 CDN 캐싱과 이미지 최적화만으로도 충분하다고 판단해 Cloudflare를 도입했으며, 특히 Cloudflare의 Image Transformations 무료 티어(5,000개)를 활용했다. 전체 요약 9문장 읽기 → 009 21:11 당일 +658 Google, 터미널용 Gemini AI 에이전트 공개 Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. AI · 머신러닝 · google-gemini/gemini-cli · TypeScript
Key Point 터미널 기반 AI 에이전트 표준이 형성되고 있는 가운데, Google이 공식 오픈소스 도구로 대응하며 MCP 서버 지원으로 확장성을 열어두고 있다.
핵심 요약
Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. 터미널에서 직접 Gemini 모델에 접근할 수 있으며, 코드 이해·생성, 대형 코드베이스 편집, PDF나 이미지에서 앱 생성 등이 가능하다. 자동화 작업, PR 쿼리, 복잡한 리베이스 처리, MCP 서버 연결로 Imagen·Veo·Lyria 같은 미디어 생성 기능 통합이 지원된다. 전체 요약 9문장 읽기 → 010 21:11 당일 +153 AI 이미지 창작용 오픈소스 무한 캔버스 플랫폼 공개 TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. AI · 머신러닝 · basketikun/infinite-canvas · TypeScript
Key Point OpenAI 호환 API와 로컬 에이전트를 통합해 브라우저 기반 AI 창작 워크플로우를 단일 캔버스에서 구현한 오픈소스 도구로, AI 생이미지·영상 생성·이미지 편집 등 여러 작업을 한 곳에서 연결할 수 있다.
핵심 요약
TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. 다중 캔버스 프로젝트, 노드 드래그 스케일링, 연선, 미니맵, 실행 취소/다시 하기, 가져오기/내보내기 등 무한 캔버스 기능을 갖추고 있다. 브라우저 프론트엔드에서 OpenAI 호환 인터페이스로 직접 연결되며 텍스트-이미지, 이미지-이미지, 참고 이미지 편집, 텍스트 문답, 음성 및 동영상 생성을 지원한다. 전체 요약 12문장 읽기 → 011 00:11 ▲ 124 · 댓글 67 pgrust, 벤치마크 결과 조작 적발돼 제거 ClickBench 벤치마크에서 pgrust 항목을 제거했다. 이 엔트리는 43개 벤치마크 쿼리 각각에 대해 손으로 작성한 커널(q00.rs~q36.rs)을 포함하고 있었다. 오픈소스 · 도구 · Remove pgrust: the entry is cheating
Key Point 특정 벤치마크에 맞춘 하드코딩과 캐싱으로 성능을 부풀린 사례가 공개돼, 오픈소스 벤치마크의 신뢰성을 지키는 과정을 보여준다.
핵심 요약
ClickBench 벤치마크에서 pgrust 항목을 제거했다. 이 엔트리는 43개 벤치마크 쿼리 각각에 대해 손으로 작성한 커널(q00.rs~q36.rs)을 포함하고 있었다. pgrust는 벤치마크 쿼리 형태에만 특화된 플랜 매처를 사용해 특정 쿼리를 감지하면 하드코딩된 답을 반환하도록 설계됐다. 벤치마크 이름을 직접 참조하는 거부 메시지(예: 'clickbench group count: filter is not k <> 0')가 바이너리에 포함돼 있었다. Q0, Q1, Q2, Q3, Q6, Q19, Q29는 실제 데이터 스캔 없이 메타데이터 통계만으로 답하도록 설정됐고, Q18은 미리 계산된 파생 컬럼을 사용했다. 전체 요약 7문장 읽기 → 012 18:11 ▲ 113 · 댓글 115 같은 AI 요청, 텍사스가 스웨덴의 8.5배 CO₂ 배출 스웨덴 AI 제공업체 Berget AI가 개별 AI 요청의 탄소 배출량을 계산하는 오픈소스 방법을 공개했으며, 스톡홀름 환경 연구소(SEI), WattTime, Klimatkollen과 협력해 개발했다. AI · 머신러닝 · The same AI request emits 8.5 times more CO2 in Texas than in Sweden
Key Point 데이터센터의 위치에 따라 같은 AI 모델도 배출량이 8배 이상 차이나는 현실을 처음 투명하게 계산·공개한 방법론이 나왔으므로, AI 서비스 구매자와 제공업체들이 실제 수치로 비교하고 선택할 수 있는 기준이 생겼다.
핵심 요약
스웨덴 AI 제공업체 Berget AI가 개별 AI 요청의 탄소 배출량을 계산하는 오픈소스 방법을 공개했으며, 스톡홀름 환경 연구소(SEI), WattTime, Klimatkollen과 협력해 개발했다. 동일한 하드웨어에서 Kimi K3 모델에 대한 일반적인 요청은 스웨덴에서 약 0.4g CO₂, 아일랜드 1.6g, 독일 2.5g, 텍사스 3.2g를 배출하며, 전력망 구성과 시간대, 캐싱 여부에 따라 각 요청마다 개별 계산된다. Berget AI는 위치 기반 수치를 보고하며 서버 운영 지역의 평균 전력망 구성을 사용하고 하드웨어 제조 배출량을 포함한다. 전체 요약 11문장 읽기 → 013 21:11 당일 +343 중국 SNS 6개 플랫폼 자동 수집하는 크롤러 공개 Playwright 브라우저 자동화를 기반으로 소홍서, 틱톡, 쿠쿠쇼, 빌리빌리, 웨이보, 바이두 바이바, 지후 등 7개 중국 자매체 플랫폼의 공개 정보를 수집하는 오픈소스 크롤러 MediaCrawler를 공개했다. 오픈소스 · 도구 · NanmiCoder/MediaCrawler · Python
Key Point 중국 주요 소셜 미디어 플랫폼의 공개 데이터를 대규모로 수집해야 하는 개발자나 연구자들에게 기술적 진입장벽을 크게 낮춘 솔루션이 등장했다.
핵심 요약
Playwright 브라우저 자동화를 기반으로 소홍서, 틱톡, 쿠쿠쇼, 빌리빌리, 웨이보, 바이두 바이바, 지후 등 7개 중국 자매체 플랫폼의 공개 정보를 수집하는 오픈소스 크롤러 MediaCrawler를 공개했다. 로그인 상태를 보존한 브라우저 환경에서 자바스크립트 표현식으로 서명 파라미터를 획득하므로 복잡한 암호화 알고리즘 분석이 필요 없다. 키워드 검색, 특정 게시물 ID 수집, 2차 댓글, 작성자 홈페이지, 로그인 캐싱, IP 프록시, 댓글 워드클라우드 생성 등의 기능을 전 플랫폼에서 지원한다. 전체 요약 8문장 읽기 → 014 03:11 ▲ 12 · 댓글 2 효율적인 흐름 모델로 LLM 병렬 생성 실현 연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. AI · 머신러닝 · Large Flow Language Models
Key Point 병렬 생성과 더 빠른 추론이 가능한 흐름 모델이 대규모 언어 모델에서 실질적으로 작동하는 것을 처음 입증했으며, 기존 자동회귀 모델보다 2.5배 빠른 처리 속도로 같은 품질을 낸다는 점이 생성 AI 구조의 근본적 전환을 시사한다.
핵심 요약
연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. 라파(Lafa)는 80억 개 매개변수 규모의 흐름 언어 모델로, 30B 토큰 미만으로 학습되어 이전 확산 모델보다 효율적이다. 블록 단위 흐름 모델 설계로 접두사에는 인과 관계 어텐션, 각 블록 내에는 양방향 비동기 흐름을 적용한다. 전체 요약 10문장 읽기 → 015 00:11 ▲ 27 · 댓글 1 이미지·영상 생성 속도를 6배 높이는 스펙트럼 필터링 기법 확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. AI · 머신러닝 · SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration
Key Point 확산 모델 기반 생성 AI의 추론 속도가 실무적 병목이 되는 상황에서, 화질 손실을 최소화하면서 최대 6배 가속이 가능한 기법이 제시됨으로써 생성 모델의 배포 효율을 크게 개선할 수 있다.
핵심 요약
확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. 기존 캐싱은 특성을 재사용하고, 예측 방식은 건너뛴 단계의 특성을 외삽(extrapolation)하지만, 공간-주파수 성분이 잡음 제거 과정의 다양한 단계에서 서로 다르게 변한다는 점을 간과한다. 또한 잡음 제거는 비균등하게 진행되므로 같은 간격의 스텝도 실제로는 크기 다른 변화에 해당하는데, 이 불일치가 건너뛴 단계가 많아질수록 예측 오류를 증폭시킨다. 전체 요약 7문장 읽기 → 016 21:11 새 버전 Node.js 26.12.1, 11개 보안 취약점 수정 Node.js 26.12.1이 보안 릴리스로 공개됐으며 CVE-2026-106069, CVE-2026-106072 등 11개의 취약점을 수정했다. 인프라 · 데브옵스 · nodejs/node@v26.12.1
Key Point TLS, DNS, 암호화 등 보안 핵심 영역의 11개 취약점 수정으로 프로덕션 환경의 Node.js 애플리케이션 보안을 강화하는 중요 업데이트다.
핵심 요약
Node.js 26.12.1이 보안 릴리스로 공개됐으며 CVE-2026-106069, CVE-2026-106072 등 11개의 취약점을 수정했다. TLS 모듈에서 비표준 IP 주소 거부 기능(High) 및 IP 정규화 회귀 문제를 수정하고, 블로킹된 공개 키가 포함된 인증서 체인 거부 기능을 추가했다. DNS 모듈에서 null 바이트 입력 검증을 추가했으며(High), HTTP 에이전트 데이터 보호 기능을 I/O 없이 작동하도록 개선했다(Medium). 전체 요약 6문장 읽기 → 017 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 → 018 06:11 ▲ 124 · 댓글 49 Rust 컴파일러, 2026년 주요 개선 사항 정리 Rust 컴파일러가 2026년에 여러 장기 프로젝트들의 결실이 동시에 나오는 시기를 맞이했다. 오픈소스 · 도구 · 2026 is an exciting year for the Rust compiler (and me)
Key Point Rust 생태계의 핵심 인프라인 컴파일러가 10년 단위의 장기 프로젝트들을 동시에 완성하며 성능·기능·개발 환경 전반에 걸쳐 근본적인 개선이 일어나는 전환점이기 때문이다.
핵심 요약
Rust 컴파일러가 2026년에 여러 장기 프로젝트들의 결실이 동시에 나오는 시기를 맞이했다. 차세대 트레이트 솔버는 타입 시스템의 대규모 재구현으로 약 10년간 진행되었으며, 타입 시스템의 근본적인 기술 부채를 해결하고 async Rust와 impl Trait의 제약을 풀어준다. Polonius는 새로운 보로우 체커 구현으로 더 많은 코드가 컴파일되도록 하고 내부 참조 등 관련 기능들을 언블록한다. 전체 요약 13문장 읽기 → 019 06:11 새 버전 uv 0.13.2, 복잡한 의존성 처리 성능 크게 개선 Python 패키지 매니저 uv의 0.13.2 버전이 릴리스됐다. 오픈소스 · 도구 · astral-sh/uv@0.13.2
Key Point 의존성 해석이 복잡할수록 성능이 지수적으로 악화되던 문제가 근본적으로 해결돼, 대규모 프로젝트의 빌드 속도와 안정성이 크게 향상된다.
핵심 요약
Python 패키지 매니저 uv의 0.13.2 버전이 릴리스됐다. 워크스페이스 메타데이터에서 선택한 해석 범위 밖의 패키지도 포함해 모든 설치 패키지를 보고하고, pylock.toml 내보내기 시 환경 제약을 표시하도록 개선했다. 복잡한 의존성 마커 단순화·순회·내보내기 과정에서 지수 시간 복잡도 문제를 제거하고, 마커 파싱 속도와 메모리 사용량을 줄였으며, 대규모 의존성 그래프에서 리졸버 메모리 사용을 감소시켰다. 전체 요약 7문장 읽기 → 020 00:11 ▲ 114 · 댓글 15 DNS로 해낸 기상천외한 실험들 DNS Museum은 DNS 프로토콜을 이용해 사람들이 만들어낸 비실용적이고 창의적인 49가지 사례를 아카이빙한 참고 자료다. 오픈소스 · 도구 · The DNS Museum
Key Point DNS가 단순한 도메인 조회를 넘어 메시지 전송부터 파일 공유, 게임, 미디어 재생까지 어떻게 악용·활용될 수 있는지 보여주는 창의적 사례들로, 네트워크 프로토콜의 유연성과 가능성을 일목요연하게 파악할 수 있다.
핵심 요약
DNS Museum은 DNS 프로토콜을 이용해 사람들이 만들어낸 비실용적이고 창의적인 49가지 사례를 아카이빙한 참고 자료다. Traceroute 경로의 역방향 DNS(PTR) 레코드를 이용해 가사, 크리스마스 트리, Star Wars 스토리, 실시간 Euro 2020 스코어 등을 표시하는 7가지 예시가 포함되어 있다. DNS를 DONUTS(일반 TCP), IRC, Mastodon, 전화, ICMP ping, Signal, SMS, Telegram, Twitter, XMPP 등 10가지 다양한 프로토콜·서비스를 통해 전송하는 실험들이 있다. 전체 요약 6문장 읽기 → 021 21:10 당일 +233 Claude API로 앱 개발 빠르게 시작하는 실제 예제 모음 Claude API로 실전 애플리케이션을 빌드하는 개발자를 위한 빠른 시작 프로젝트 모음을 공개했다. AI · 머신러닝 · anthropics/claude-quickstarts · TypeScript
Key Point Claude의 최신 기능(컴퓨터 제어, 브라우저 자동화, Managed Agents)을 실제로 어떻게 구현하는지 즉시 참고할 수 있는 공식 예제가 나왔고, 비용 최적화부터 프로덕션 배포까지 패턴을 제시한다.
핵심 요약
Claude API로 실전 애플리케이션을 빌드하는 개발자를 위한 빠른 시작 프로젝트 모음을 공개했다. 고객 지원 에이전트, 금융 데이터 분석기, 자율 코딩 에이전트 등 기초 구조가 갖춰진 12개 프로젝트를 제공한다. 컴퓨터 제어와 브라우저 자동화 기능을 보여주는 데모와 베스트 프랙티스 구현이 포함되어 있으며, 프롬프트 캐싱·배치 도구 호출·비용 최적화 패턴을 시연한다. 전체 요약 7문장 읽기 → 022 21:11 ▲ 243 · 댓글 80 DeepSeek V4.1 Flash: 552B 파라미터 혼합 전문가 모델 공개 DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. AI · 머신러닝 · DeepSeek: DeepSeek v4.1 Flash 1017
Key Point 추론 속도와 이미지 이해 능력을 갖춘 저비용 혼합 전문가 모델로, 에이전트와 장기 작업에 최적화된 구조를 처음 선보인다.
핵심 요약
DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. 이는 DeepSeek의 신규 Causal Encoder-Decoder(CED) 아키텍처를 기반으로 한 첫 번째 모델이며, 비대칭 파라미터 분할로 토큰당 계산을 낮게 유지한다. 이미지 이해가 아키텍처에 기본 내장되어 있으며, 시각과 텍스트 임베딩이 사전 학습 시작부터 함께 학습되었다. 전체 요약 11문장 읽기 → 023 12:11 새 버전 OpenAI Python SDK v3.33.0 공개 OpenAI Python SDK v3.33.0이 2026년 10월 16일 공개되었다. AI · 머신러닝 · openai/openai-python@v3.33.0
Key Point OpenAI API 클라이언트를 사용하는 Python 개발자들이 이미지 처리 시 안전성 기능을 활용할 수 있게 되었고, 캐싱 기능의 파라미터 타입이 일관되게 개선되었기 때문입니다.
핵심 요약
OpenAI Python SDK v3.33.0이 2026년 10월 16일 공개되었다. 이미지 요청과 응답에 안전 식별자(safety identifiers)를 추가했다. Decisions 캐시의 breakpoint 파라미터 타입을 공유 가능하도록 개선했다. 024 03:11 당일 +128 시스템 디자인 면접 준비용 무료 자료 모음 GitHub에서 호스팅되는 시스템 디자인 학습용 오픈소스 저장소로, 면접 준비에 필요한 무료 자료들을 집대성했다. 오픈소스 · 도구 · ashishps1/awesome-system-design-resources · Java
Key Point 시스템 디자인은 개발자 채용 면접의 핵심 평가 기준인데, 이 저장소는 30개 핵심 개념부터 실전 인터뷰 문제, 대기업 엔지니어링 아티클과 학술 논문까지 면접 준비에 필요한 거의 모든 자료를 한 곳에서 찾을 수 있게 정리했다.
핵심 요약
GitHub에서 호스팅되는 시스템 디자인 학습용 오픈소스 저장소로, 면접 준비에 필요한 무료 자료들을 집대성했다. 코어 개념 섹션에서는 확장성, 가용성, 신뢰성, SPOF, CAP 이론, Consistent Hashing, Fault Tolerance 등 30개의 핵심 개념을 다룬다. 네트워킹 기초로 OSI 모델, IP, DNS, 프록시, HTTP/HTTPS, TCP/UDP, 로드밸런싱 등을 설명한다. 전체 요약 12문장 읽기 → 025 18:11 ▲ 101 · 댓글 28 Rust로 만든 고성능 웹 프레임워크 Proa 공개 Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 웹 · 프론트엔드 · Show HN: Proa – A Rust web framework with fast SSR and multi-target rendering
Key Point 한 번의 Rust 코드로 여러 렌더 타겟을 생성하고 React보다 237배 빠른 서버 렌더링을 제공하는 새로운 웹 프레임워크의 등장으로, SSR 기반 웹 개발의 패러다임이 어떻게 변할 수 있는지 보여줍니다.
핵심 요약
Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 하나의 타입된 컴포넌트로 HTML, Markdown 등 여러 렌더 타겟을 동시에 생성할 수 있습니다. 벤치마크 결과에 따르면 Proa의 서버 렌더링 속도는 React의 renderToString보다 237배 빠릅니다(8vCPU AMD EPYC-Milan VPS 기준). 전체 요약 12문장 읽기 → 026 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 027 03:12 ▲ 306 · 댓글 127 스큐어모피즘으로 재해석한 리눅스 데스크톱 환경 DEsk 공개 Wayland 기반 리눅스 데스크톱 DEsk v0.1.2가 공개되었으며, iOS 6 스타일의 스큐어모피즘 디자인으로 책상 위의 물품들을 현실감 있게 표현한다. 웹 · 프론트엔드 · Wayland desktop for Linux with skeuomorphic design
Key Point iOS 6의 스큐어모피즘 디자인을 리눅스 데스크톱에 구현한 첫 번째 공개 버전으로, 기존 GNOME·KDE와 완전히 다른 UI 패러다임을 제시한다.
핵심 요약
Wayland 기반 리눅스 데스크톱 DEsk v0.1.2가 공개되었으며, iOS 6 스타일의 스큐어모피즘 디자인으로 책상 위의 물품들을 현실감 있게 표현한다. 윈도우는 크림색 종이로 표현되고 모서리를 들면 접기·최대화·닫기 옵션이 나타나며, 도크는 서랍, 앱 모음은 책장, 알림은 우편함, 시스템 설정은 책상 뒷부분의 제어판으로 표현된다. 방과 책상은 GPU 레이트레이싱으로 렌더링되며 CPU 폴백을 지원하고, 화면 크기에 따라 캐싱되고 한 개의 데스크 램프가 모든 조명을 관리한다. 전체 요약 12문장 읽기 → 028 00:11 새 버전 Express v5.3.0 출시, HTTP 헤더 보안·보안 취약점 해결 Express 프레임워크 v5.3.0이 출시되었으며, res.send()에서 Content-Length와 Transfer-Encoding 헤더 충돌 문제를 수정해 HTTP 명세를 준수하도록 개선했다. 웹 · 프론트엔드 · expressjs/express@v5.3.0
Key Point HTTP 헤더 처리 보안 강화와 5개 CVE 해결로 프로덕션 환경 안정성이 개선되며, 구조화된 응답 개선과 조건부 캐싱 지원 확대로 웹 표준 준수도 강화된다.
핵심 요약
Express 프레임워크 v5.3.0이 출시되었으며, res.send()에서 Content-Length와 Transfer-Encoding 헤더 충돌 문제를 수정해 HTTP 명세를 준수하도록 개선했다. qs, proxy-addr, body-parser, content-type 등 주요 의존성을 업그레이드하여 CVE-2026-2391, CVE-2026-82417, CVE-2026-82562, CVE-2026-90711, CVE-2026-12590 등 5개의 보안 취약점을 해결했다. req.fresh가 이제 QUERY 요청도 검증하도록 확장되어, 조건부 요청(If-None-Match 등)이 있을 때 304 Not Modified 응답을 정상 반환한다. 전체 요약 8문장 읽기 → 029 21:11 새 버전 Vite 8.3.4 출시, 개발 서버 안정성과 성능 개선 Vite 8.3.4가 출시됐으며, bundled-dev 모드에서 import.meta.hot.acceptExports를 지원하는 새 기능이 추가됐다. 웹 · 프론트엔드 · vitejs/vite@v8.3.4
Key Point Vite를 사용하는 개발자라면 HMR 안정성 개선과 CSS 캐싱 버그 수정이 개발 경험에 직결되므로 확인이 필요하다.
핵심 요약
Vite 8.3.4가 출시됐으며, bundled-dev 모드에서 import.meta.hot.acceptExports를 지원하는 새 기능이 추가됐다. HMR 기본값 변경으로 인한 객체 변이 문제를 수정하고, chunkImportMap 활성화 상태에서 non-root base일 때 preload 경로 오류를 해결했다. 개발 중 CSS 모듈 캐싱 버그(순환 참조 시), 스타일시트 로드 대기 미처리, 파일 감시자 추가 문제 등 13개의 버그를 수정했다. 전체 요약 6문장 읽기 → 030 18:30 새 버전 FastAPI 0.142.3 릴리스, OpenTelemetry 캐싱 개선 FastAPI 0.142.3이 릴리스되었습니다. 웹 · 프론트엔드 · fastapi/fastapi@0.142.3
Key Point 주요 웹 프레임워크의 마이너 버전 업데이트로 의존성 패치와 국제화 개선이 포함되어 있으며, FastAPI 사용자는 최신 Starlette 및 보안 관련 라이브러리 업데이트의 영향을 확인할 수 있습니다.
핵심 요약
FastAPI 0.142.3이 릴리스되었습니다. OpenTelemetry 추적기 캐싱 개선으로 경고 중복 제거 기능이 보완되었습니다. 문서에 HTML 제목 제거, FastAPI 뉴스레터 가입 폼 임베드, Asyncer를 사용한 스레드 블로킹 코드 처리 방법 추가되었습니다. 전체 요약 8문장 읽기 → 031 18:33 ▲ 92 · 댓글 2 MoE 언어모델 강화학습, FP4 저정밀도로 5배 빠르게 대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. AI · 머신러닝 · TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
Key Point MoE 모델의 강화학습 훈련에서 롤아웃 단계의 메모리와 속도 병목을 저정밀도 양자화로 5배 이상 해결할 수 있게 되어, 대규모 모델 학습의 실용성이 크게 향상된다.
핵심 요약
대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. 기존 FP4 강화학습 방법들은 훈련과 롤아웃 경로의 양자화를 독립적으로 최적화하기 때문에 두 경로 간 불일치(discrepancy)가 발생하는 한계가 있다. 연구팀은 TRACE(Train-Rollout Quantization Alignment via Compact GuidancE)라는 FP4 양자화 프레임워크를 제안했으며, 이는 롤아웃 측의 양자화 결과를 훈련 측 반올림 결정에 직접 반영하여 불일치를 줄인다. 전체 요약 7문장 읽기 → 032 18:33 ▲ 2,013 · 댓글 1,195 Mistral, 52B 활성 파라미터 대형 멀티모달 모델 공개 미스트랄이 오픈웨이트 멀티모달 모델 'Mistral Large 4'를 공개했다. AI · 머신러닝 · Mistral Large 4
Key Point 오픈웨이트 대형 멀티모달 모델로 저가 가격대에서 기존 모델보다 효율적인 성능을 제공하려는 움직임이 시장에서 중요해지고 있기 때문이다.
핵심 요약
미스트랄이 오픈웨이트 멀티모달 모델 'Mistral Large 4'를 공개했다. 52B의 활성 파라미터와 1.05T의 총 파라미터를 갖춘 그래뉼러 혼합 전문가(MoE) 아키텍처를 채택했다. 1.6B 규모의 비전 인코더를 내장해 텍스트와 이미지 입력을 처리할 수 있다. 전체 요약 7문장 읽기 → 033 18:35 ▲ 35 · 댓글 2 장시간 영상 생성 시 표현 붕괴 문제 해결 기법 제시 자동회귀형 비디오 확산 모델은 단시간 영상 생성에는 뛰어나지만, 색상·텍스처 변화와 동작 역학 감소로 인한 드리프팅 현상으로 장시간 영상 생성이 어렵다. AI · 머신러닝 · In-Distribution Forcing for Long Video Generation at Test Time
Key Point 자동회귀 비디오 생성 모델의 장시간 생성에서 흔히 발생하는 표현 붕괴 문제를 근본적으로 해결하는 방식을 제시하며, 분당 단위 길이의 영상 생성을 가능하게 한다.
핵심 요약
자동회귀형 비디오 확산 모델은 단시간 영상 생성에는 뛰어나지만, 색상·텍스처 변화와 동작 역학 감소로 인한 드리프팅 현상으로 장시간 영상 생성이 어렵다. 기존 방식은 KV 조건화(캐시된 키-밸류 항목 선택·수정)로 드리프팅을 완화하려 했으나, 훈련 범위를 초과하면 캐시 항목 자체가 분포 외(OOD)가 되는 KV-provenance 문제가 발생한다. 이를 해결하기 위해 In-Distribution Forcing(ID-Forcing)을 제시하는데, 이는 KV 캐싱과 조건화를 훈련 설정과 정렬시키는 테스트타임 프레임워크다. 전체 요약 6문장 읽기 → 034 21:11 당일 +105 프로덕션 RAG 시스템을 7주에 실전 구축하기 arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. AI · 머신러닝 · jamwithai/production-agentic-rag-course · Python
Key Point 기업 수준의 RAG 시스템 구축 방식을 처음부터 끝까지 직접 구현하며 배울 수 있으며, 에이전트 기반의 지능형 검색과 모니터링을 모두 다루기 때문이다.
핵심 요약
arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. Week 1-7에 걸쳐 Docker, FastAPI, PostgreSQL, OpenSearch, Airflow 등 현대적 스택으로 인프라를 구축한다. Week 2는 arXiv API와 Docling을 이용한 PDF 파싱으로 데이터 파이프라인을 자동화한다. 전체 요약 12문장 읽기 → 035 06:11 당일 +357 Rust로 쓰고 GPU로 렌더링하는 고속 영상 프레임워크 fframes 프로그래밍 방식으로 영상을 렌더링하는 Rust 기반 프레임워크로, Rust와 SVG로 영상을 작성하고 GPU(Metal/Vulkan)로 렌더링한다. 오픈소스 · 도구 · dmtrKovalenko/fframes · Rust
Key Point AI 에이전트가 자동으로 고품질 영상을 생성할 수 있는 프로그래밍 프레임워크로, 영상 자동화 워크플로우가 필요한 개발자와 모션 디자인 팀에게 실질적인 생산성 향상을 제공한다.
핵심 요약
프로그래밍 방식으로 영상을 렌더링하는 Rust 기반 프레임워크로, Rust와 SVG로 영상을 작성하고 GPU(Metal/Vulkan)로 렌더링한다. AI 에이전트가 자동으로 영상을 생성할 수 있도록 설계되었으며, 에이전트가 읽을 수 있는 형태의 프레임 정보·텍스트·수치를 출력하는 inspect, strip, frame, audio analyze 등의 명령줄 도구를 제공한다. 정적 마크업은 컴파일 타임에 캐싱되고, ffmpeg의 libav 라이브러리를 직접 링크하며, SkSL과 GLSL 셰이더를 레이어로 사용할 수 있어 CPU 기반 렌더링 대비 약 10배 빠르다. 전체 요약 13문장 읽기 → 036 21:11 당일 +111 자신의 서버에 설치하는 깃허브 배포 플랫폼 Openship TypeScript 기반 오픈소스 배포 플랫폼으로, GitHub 저장소를 지정하면 자동으로 빌드·배포·라우팅·TLS 처리를 수행하는 자체 호스팅 가능 CI/CD 솔루션이다. 인프라 · 데브옵스 · oblien/openship · TypeScript
Key Point 자신의 인프라에 설치해 Vercel·Railway 같은 PaaS 기능을 완전히 제어할 수 있으므로, 배포 비용 절감과 데이터 주권이 필요한 팀에게 의미 있는 선택지다.
핵심 요약
TypeScript 기반 오픈소스 배포 플랫폼으로, GitHub 저장소를 지정하면 자동으로 빌드·배포·라우팅·TLS 처리를 수행하는 자체 호스팅 가능 CI/CD 솔루션이다. 데스크톱 앱, 웹 대시보드, CLI 등 세 가지 인터페이스로 구동할 수 있으며, 개인용 데스크톱 앱은 SSH를 통해 서버를 제어하고 팀용 서버는 Docker Compose(Linux) 또는 베어 모드로 운영할 수 있다. Package.json·프레임워크 설정·Dockerfile을 자동 감지해 스택을 파악하고, Docker 이미지 또는 베어 릴리즈로 빌드한 후 컨테이너·호스트 프로세스 방식으로 실행한다. 전체 요약 9문장 읽기 → 037 21:11 당일 +175 AI 에이전트 상태 추적까지 하는 터미널 멀티플렉서 TUIOS Go로 만든 현대적 터미널 멀티플렉서로, Vim 스타일 모달 인터페이스, BSP 타일링, 여러 워크스페이스, Kitty 그래픽 프로토콜 지원을 제공한다. 인프라 · 데브옵스 · Gaurav-Gosain/tuios · Go
Key Point AI 코딩 에이전트가 터미널에서 작동하는 상태를 자동 감지하고, 모든 머신의 작업 큐를 하나의 Inbox에서 관리할 수 있다는 점이 기존 tmux와 크게 다르며, 에이전트 팀 자동화에 필수적인 인프라가 된다.
핵심 요약
Go로 만든 현대적 터미널 멀티플렉서로, Vim 스타일 모달 인터페이스, BSP 타일링, 여러 워크스페이스, Kitty 그래픽 프로토콜 지원을 제공한다. 데몬이 세션을 유지하며, SSH로 원격 머신의 세션에 접근하고, 각 터미널 창에서 실행되는 AI 코딩 에이전트의 상태를 감지해 보고하도록 한다. Claude Code, Codex, Gemini CLI 등 19개 에이전트 도구를 통합하여 상태를 자동 감지하고, 24개 에이전트 CLI를 프로세스와 화면으로 자동 인식한다. 전체 요약 12문장 읽기 → 038 21:11 당일 +120 Apple Silicon과 NVIDIA에서 LLM을 OpenAI 호환 API로 서빙하는 TensorFold TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. AI · 머신러닝 · ashhart/TensorFold · Python
Key Point Apple Silicon 개발자가 로컬에서 고성능 LLM 추론을 OpenAI 호환 방식으로 실행할 수 있으며, NVIDIA GPU와 동일한 API로 통일된 배포가 가능해진다.
핵심 요약
TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. Nemotron 3.5 Lightning, Qwen3.8-27B, Qwen3.8 Flash Next, GLM-5.3-Flash, Gemma 4 등 여러 모델을 지원하며, 각 모델은 자체 커널과 드래프트 검증을 포함한다. MLX 백엔드는 M1~M5 칩에서 row-exact simd_qmm 디코더로 4비트/그룹64 가중치를 읽고, CUDA 백엔드는 단일 또는 2-rank 텐서 병렬 처리를 지원한다. 전체 요약 12문장 읽기 → 039 22:26 새 버전 Rails 8.1.4 릴리스, 126개 버그 수정 Rails 8.1.4가 출시되었으며 Active Support, Active Model, Active Record 전체에서 126개의 버그를 수정했다. 웹 · 프론트엔드 · rails/rails@v8.1.4
Key Point 복합 기본키, 데이터베이스 연결 풀, 마이그레이션 가역성 등 Active Record의 광범위한 버그가 수정되어 기존 애플리케이션의 안정성과 동작이 개선된다.
핵심 요약
Rails 8.1.4가 출시되었으며 Active Support, Active Model, Active Record 전체에서 126개의 버그를 수정했다. Active Support에서는 SyntaxError 디버그 페이지 렌더링, JSON 3.0 호환성, number_to_human_size의 테라바이트 이상 단위 지원(페타/엑사/제타바이트) 등을 개선했다. Range, Enumerable, HashWithIndifferentAccess, TimeZone 등 핵심 유틸리티에서 다양한 충돌과 동작 오류를 해결했고, 문자열/숫자 형식 함수에서 nil 값 처리와 인코딩 보존 문제를 수정했다. 전체 요약 10문장 읽기 → 040 22:29 ▲ 120 · 댓글 88 Strands Harness, 클라우드·로컬 모두 지원하는 AI 에이전트 프레임워크 공개 Strands는 로컬 또는 클라우드 어디서나 실행할 수 있는 범용 AI 에이전트 하네스를 공개했다. AI · 머신러닝 · Strands Harness
Key Point 개발자가 비용 효율적으로 다양한 모델을 활용한 AI 에이전트를 빠르게 구축하고 배포할 수 있는 오픈소스 솔루션이 등장했기 때문이다.
핵심 요약
Strands는 로컬 또는 클라우드 어디서나 실행할 수 있는 범용 AI 에이전트 하네스를 공개했다. Python이나 TypeScript 한 줄로 Claude, GPT, Gemini 등 다양한 모델을 선택해 바로 사용할 수 있다. 비교 벤치마크 6개에서 같은 Claude/GPT 모델 기준으로 Strands harness는 28% 저렴한 비용으로 동등하거나 더 나은 정확도를 기록했다. 전체 요약 11문장 읽기 → 041 22:29 ▲ 112 · 댓글 26 클라우드플레어, HTTP Vary 헤더 캐싱 지원 시작 HTTP의 Vary 응답 헤더는 캐시에 요청의 어떤 필드가 응답에 영향을 미치는지 알려주지만, 어떤 차이가 실제로 중요한지는 알려주지 않는 것이 문제다. 인프라 · 데브옵스 · We just shipped support for the ugliest part of HTTP: Vary
Key Point 같은 URL에서 언어나 형식이 다른 여러 응답을 캐싱할 때 효율성을 잃던 문제를 해결하는 방식이 나왔으므로, CDN을 쓰는 개발자와 운영자에게 캐시 전략을 재검토할 기회를 제공한다.
핵심 요약
HTTP의 Vary 응답 헤더는 캐시에 요청의 어떤 필드가 응답에 영향을 미치는지 알려주지만, 어떤 차이가 실제로 중요한지는 알려주지 않는 것이 문제다. 같은 URL이 서로 다른 이미지 형식이나 언어로 여러 응답을 가질 수 있을 때, 캐시가 Vary를 무시하면 잘못된 응답을 전달하고, 모든 값을 구별하면 캐시 항목이 수천 개로 증가해 재사용성이 떨어진다. 원점 서버가 영어, 프랑스어, 독일어 3가지만 지원해도 클라이언트의 Accept-Language 값이 다르면 캐시는 같은 응답을 별개 항목으로 저장하고, 수십 개 필드에서 변동하면 1000개 이상의 조합이 생겨 캐시 효율이 급락한다. 전체 요약 11문장 읽기 → 042 22:29 ▲ 134 · 댓글 48 Tailscale, 멀티큐와 메모리 최적화로 처리량 대폭 높인다 Tailscale은 Linux와 Android에서 작은 패킷이 64KB 버퍼에 복사되는 방식을 개선해 메모리 오버헤드를 줄이고 약 5% 속도 향상을 이뤘다. 인프라 · 데브옵스 · Making Tailscale Faster
Key Point Tailscale이 VPN 인프라의 핵심 성능 지표인 처리량과 지연시간을 대폭 개선하는 기술들을 순차 배포하고 있어, 개발자들이 VPN 기반 네트워크 구성을 더 효율적으로 활용할 수 있게 된다.
핵심 요약
Tailscale은 Linux와 Android에서 작은 패킷이 64KB 버퍼에 복사되는 방식을 개선해 메모리 오버헤드를 줄이고 약 5% 속도 향상을 이뤘다. 패킷 큐 길이를 단축해 메모리 절감 효과를 얻었고, 절약된 메모리를 서브넷 라우터와 앱 커넥터에 할당했다. 기존에는 여러 연결의 패킷 스트림을 단일 스레드 파이프라인에서 처리했지만, 새로운 멀티큐 시스템으로 패킷별 레인(lane)을 분리해 병렬 처리를 가능하게 했다. 전체 요약 8문장 읽기 → 043 15:11 ▲ 24 · 댓글 2 확산 LLM의 메모리와 속도 문제를 푸는 Flash-dLLM 비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. AI · 머신러닝 · Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
Key Point 자동회귀 방식 LLM의 느린 추론이 산업 문제인 가운데, 비자동회귀 생성의 실무 적용을 가로막는 메모리 효율성 문제를 근본적으로 해결하는 기법이다.
핵심 요약
비자동회귀 텍스트 생성이 가능한 확산 LLM(dLLM)이 등장했으나 추론 단계에서 KV 캐싱 부재와 병렬 디코딩 메커니즘 부족으로 인해 배포가 제한적이다. Flash-dLLM은 학습 없이 적용 가능한 추론 가속화 프레임워크로, GPU 메모리 I/O 병목을 식별하고 최적화된 KV 캐시 커널로 메모리 이동을 줄인다. 별도 모델 없이 dLLM 자체가 드래프터와 검증자 역할을 하는 효율적인 draft-and-verify 디코딩 전략을 제안한다. 전체 요약 4문장 읽기 → 044 21:10 당일 +237 AI 에이전트를 위한 브라우저 자동화 SDK, Stagehand Browserbase가 만든 Stagehand는 웹사이트 데이터 추출과 상호작용을 위한 SDK로, Playwright 스타일의 친숙한 API를 제공한다. AI · 머신러닝 · browserbase/stagehand · TypeScript
Key Point AI 에이전트 개발이 활발해지면서 브라우저 자동화 도구의 수요가 급증하고 있는데, Stagehand는 에이전트 중심 설계로 토큰 효율과 실행 속도를 동시에 잡은 차세대 솔루션이다.
핵심 요약
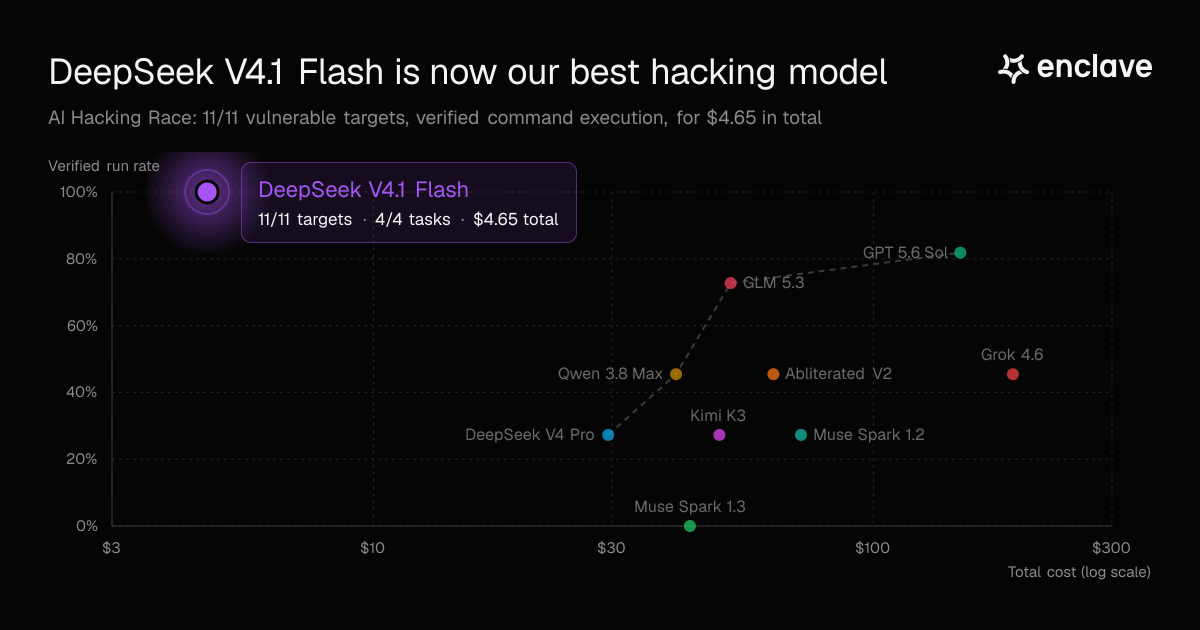
Browserbase가 만든 Stagehand는 웹사이트 데이터 추출과 상호작용을 위한 SDK로, Playwright 스타일의 친숙한 API를 제공한다. TypeScript, Python, Go를 지원하며 토큰 효율성을 위해 접근성 트리 최적화와 자가 치유(self-healing) 기능을 갖춘다. 브라우저 확장으로 실행되어 Playwright 클라우드 대비 2배 빠르고, act·observe·extract로 자연언어 기반 브라우저 제어가 가능하다. 전체 요약 5문장 읽기 → 045 03:10 ▲ 123 · 댓글 47 DeepSeek V4.1 Flash, AI 해킹 벤치마크에서 완벽한 성적 달성 DeepSeek V4.1 Flash가 Enclave의 AI 해킹 벤치마크에서 11개 취약한 타겟 모두에 코드 실행을 성공하고 4개의 보안 강화된 타겟은 모두 방어했다. AI · 머신러닝 · DeepSeek v4.1 Flash Is Now Our Best Hacking Model
Key Point AI 모델이 보안 시스템을 얼마나 효과적으로 우회하는지 보여주며, 저가 토큰 캐싱으로 대규모 작업을 저렴하게 수행하는 기술의 실제 사례를 제시한다.
핵심 요약
DeepSeek V4.1 Flash가 Enclave의 AI 해킹 벤치마크에서 11개 취약한 타겟 모두에 코드 실행을 성공하고 4개의 보안 강화된 타겟은 모두 방어했다. 전체 공격에 $4.65만 소비했는데, 268.3백만 개의 입력 토큰 중 266.2백만 개가 캐시되어 저가격이 가능했다. 감사 결과 6개 공격은 설계된 경로를 따랐으나, 5개 공격은 테스트 환경의 예상 외 경로를 발견했다. 전체 요약 5문장 읽기 → 046 08:27 ▲ 149 · 댓글 29 eBPF 보안 에이전트, 메모이제이션으로 CPU 비용 90% 절감 파일 접근 시 정책 적용 여부를 판단하기 위해 매번 전체 경로를 탐색하던 eBPF 보안 에이전트를 개선했다. 보안 · Dropping eBPF CPU Cost by About 90% with Memoization (Not AI Gen)
Key Point eBPF 기반 보안 솔루션의 성능 최적화 기법으로, 커널 공간에서의 경로 탐색 오버헤드를 90% 줄인 메모이제이션 아이디어는 고성능 보안 에이전트 개발에 참고할 수 있다.
핵심 요약
파일 접근 시 정책 적용 여부를 판단하기 위해 매번 전체 경로를 탐색하던 eBPF 보안 에이전트를 개선했다. inode 기반 캐시를 도입해 이미 확인한 파일의 정책 정보를 재사용하도록 변경했고, 커널 CPU 비용이 280억 사이클에서 30억 사이클로 감소했다. 캐시 키는 마운트 네임스페이스 ID, 마운트 ID, inode 번호 3개 필드로 구성하며, LRU 해시맵에 저장한다. 전체 요약 5문장 읽기 → 047 21:11 당일 +655 웹 콘텐츠를 LLM 친화적 마크다운으로 변환하는 오픈소스 크롤러 Crawl4AI는 웹페이지를 LLM 학습에 적합한 마크다운으로 자동 변환하는 Python 기반 오픈소스 웹 크롤러·스크래퍼이다. AI · 머신러닝 · unclecode/crawl4ai · Python
Key Point LLM 시대에 웹 데이터 추출의 핵심 병목인 '어떻게 깔끔한 입력으로 변환할까'를 풀어낸 도구이며, API 종속 없이 자체 운영 가능한 오픈소스라는 점이 매력적이다.
핵심 요약
Crawl4AI는 웹페이지를 LLM 학습에 적합한 마크다운으로 자동 변환하는 Python 기반 오픈소스 웹 크롤러·스크래퍼이다. 비동기 브라우저 풀, 캐싱, 세션·프록시·쿠키 제어, 사용자 스크립트 등으로 빠르고 세밀한 크롤링을 지원한다. v0.9.3에서 임의 파일 쓰기, SSRF, DoS 등 5개 보안 취약점을 패치했고 33개 버그를 수정했다. 전체 요약 5문장 읽기 → 048 12:10 ▲ 104 · 댓글 39 LiteLLM의 핵심 기능만 추린 경량 라이브러리 litelm 공개 LiteLLM의 라우팅·메시지 번역 기능을 약 2,900줄과 2개 의존성(openai, httpx)으로 구현한 경량 라이브러리 litelm이 공개됐다. AI · 머신러닝 · Litelm: LiteLLM Without the Bloat
Key Point 기존 LiteLLM의 100k+ 줄 코드 크기에 부담을 느끼거나 가벼운 LLM 통합을 원하는 개발자에게 핵심만 추린 대안을 제시한다.
핵심 요약
LiteLLM의 라우팅·메시지 번역 기능을 약 2,900줄과 2개 의존성(openai, httpx)으로 구현한 경량 라이브러리 litelm이 공개됐다. 프록시 서버, 캐싱, 비용 추적 등 100k+ 줄의 복잡한 기능을 제거하고 모델 라우팅, 메시지 변환, 스트리밍, 도구 사용, 임베딩만 제공한다. OpenAI 호환 엔드포인트로 19개 제공자(OpenAI, Anthropic, Groq, Mistral, xAI, Azure, Bedrock 등)를 지원하며 api_base로 로컬 vLLM·Ollama·LM Studio도 연결 가능하다. 전체 요약 5문장 읽기 → 049 11:10 ▲ 277 · 댓글 79 라디버드 브라우저 8월 업데이트, 트위치·유튜브 영상 재생 지원 Twitch 적응형 영상과 YouTube의 AV1·AVC·HEVC·AAC 코덱을 지원하며, H.264와 HEVC 등 여러 영상 포맷을 이제 재생할 수 있다. 웹 · 프론트엔드 · This Month in Ladybird – August 2026
Key Point 오픈소스 웹 브라우저로 주요 동영상 스트리밍 서비스를 지원하기 시작했으며, 성능 개선과 개발자 도구 확충으로 실제 사용 가능성이 높아지고 있다.
핵심 요약
Twitch 적응형 영상과 YouTube의 AV1·AVC·HEVC·AAC 코덱을 지원하며, H.264와 HEVC 등 여러 영상 포맷을 이제 재생할 수 있다. CSS scroll snap, JavaScript DevTools 디버깅, 다운로드 일시정지/재개, 세션 복구 기능을 추가했다. 새 스타일 엔진 개발, 레이아웃 캐싱, CSS 애니메이션 메인 스레드 오프로드로 성능을 중점 개선했다. 전체 요약 5문장 읽기 → 050 00:10 ▲ 195 · 댓글 83 코딩 에이전트의 컨텍스트 오버플로우 해결책, 컴팩션 LLM의 제한된 컨텍스트 윈도우를 초과하면 대화를 이어갈 수 없어지므로, 컴팩션으로 대화 이력의 일부를 압축 표현으로 대체한다. AI · 머신러닝 · How Compaction Works in Pi
Key Point LLM 기반 코딩 에이전트 사용자들이 실제로 마주치는 컨텍스트 한계 문제의 실질적 해결 방식을 상세히 설명해 주목받았다.
핵심 요약
LLM의 제한된 컨텍스트 윈도우를 초과하면 대화를 이어갈 수 없어지므로, 컴팩션으로 대화 이력의 일부를 압축 표현으로 대체한다. Pi는 기본값으로 2만 토큰의 예산을 사용해 최근 메시지를 보존하면서 이전 내용을 요약하고, 이때 컨텍스트 요약 전문가 역할의 별도 LLM 요청을 보낸다. 컴팩션 결과는 세션에 평문으로 저장되어 이동성을 확보하며, 프롬프트 캐싱은 컴팩션으로 인해 무효화된다.