쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
50건 · "MoE"조건 지우기 ×
001 15:11 ▲ 100 · 댓글 8 ANSI/ASCII 아트팩 아카이브 '16 컬러스' 공개 16colo.rs는 ANSI 및 ASCII 아트팩을 수집·보존하는 온라인 아카이브이다. 기타 · 16colo.rs – ANSI/ASCII art archive
Key Point BBS 시대 컴퓨터 아트 문화의 역사적 산물을 현대에 보존·공유하는 플랫폼으로, 레트로 문화와 디지털 유산 보존에 관심이 있는 개발자라면 참고할 만하다.
핵심 요약
16colo.rs는 ANSI 및 ASCII 아트팩을 수집·보존하는 온라인 아카이브이다. ANSI/ASCII 아트는 원래 텍스트모드 콘솔 디스플레이용으로 제작된 예술 형식으로, 1990년대 초 다이얼업 BBS(전자게시판)의 성장과 함께 인기를 얻었다. 아티스트 집단들이 월간 아트팩 컬렉션을 공개하면서 ACiD, iCE 등 저명한 그룹 간 경쟁이 벌어졌고, 이는 아트 씬의 활동을 크게 촉발했다. 전체 요약 6문장 읽기 → 002 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 003 21:11 ▲ 14 · 댓글 2 주의력 레이어에 희소성 더하는 Nestor 모델 제안 현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. AI · 머신러닝 · Nested Sparsity for Scalable Pretraining and Continual Learning
Key Point 조건부 계산의 새로운 메커니즘이 기존 MoE 모델의 학습 효율과 연속 학습 능력을 동시에 개선하는 구체적인 방법을 제시하고 있습니다.
핵심 요약
현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. 이 논문은 주의력 연산자를 일반화한 대안적 조건부 계산 메커니즘을 제안하며, 이는 MoE 희소성과 계층적으로 결합되는 '중첩 희소성'을 만든다. Nestor라 명명한 이 모델은 동일한 계산량과 희소성에서 기존 MoE 트랜스포머보다 언어 모델 사전학습에서 더 나은 성능을 보인다. 전체 요약 6문장 읽기 → 004 15:11 ▲ 22 · 댓글 5 MoE 모델의 채널 선택, 보정 데이터 없이 가능 Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. AI · 머신러닝 · Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
Key Point 현재 MoE 모델 최적화의 표준인 보정 기반 임계값이 예산 보장과 성능 향상을 모두 충족하지 못하며, 보정 없는 top-k와 경량 리더로 더 안정적이고 빠른 디코딩을 달성할 수 있음을 보여준다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. 기존 방식은 오프라인 데이터로 보정한 임계값을 사용하지만, 임계값을 통과하는 채널 수는 입력마다 달라져 실제 읽기 예산이 불안정하다: Prox는 18% 읽기 예산으로 보정되었으나 실제로는 평균 12.9%만 읽는다. Top-k 방식은 각 토큰의 k개 최고점수 채널을 선택하며 보정 데이터가 필요 없다. 전체 요약 8문장 읽기 → 005 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 006 18:11 ▲ 97 · 댓글 2 320B 파라미터 에이전트 모델 IQuest-Q1 공개 IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. AI · 머신러닝 · IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
Key Point 희소 MoE 구조로 320B 파라미터의 15%만 활성화하면서도 복잡한 다단계 학습 파이프라인을 통해 에이전트 능력을 강화한 방식이 새로운 표준이 될 수 있기 때문입니다.
핵심 요약
IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. 3단계 학습 과정으로 개발되었습니다: 첫 번째는 Stable SplitNorm, Muon, muP를 결합한 안정적 사전학습으로, 두 번째 단계에서 코딩 데이터 비중을 높여 안전한 학습률 마진을 확보합니다. 두 번째 단계는 도메인과 포맷 전반에 걸쳐 데이터 혼합을 확장하고 컨텍스트를 점진적으로 늘리는 세부 중기 학습입니다. 전체 요약 6문장 읽기 → 007 12:11 ▲ 30 · 댓글 3 MoE 모델의 중복 제거, 메타 전문가로 70-80% 파라미터만 써도 된다 MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. AI · 머신러닝 · Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE
Key Point 모델 매개변수 규모를 키우면서 MoE 효율성을 30~40% 개선할 수 있는 구조적 혁신으로, 대규모 언어 모델 개발의 비용 효율성을 크게 높일 수 있다.
핵심 요약
MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. 연구팀은 계층 간 공유 Meta Expert가 기존 Local Expert보다 더 효율적일 수 있다고 가설을 세우고 실증적 비교를 진행했다. Meta Expert를 도입한 모델은 파라미터 중복도가 낮고, 교차 엔트로피 손실이 작으며, 다운스트림 작업 정확도가 높았다. 전체 요약 5문장 읽기 → 008 18:11 ▲ 24 · 댓글 3 양자화와 추론으로 MoE 오프로딩 병목 해결한 Specter MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. AI · 머신러닝 · Specter: Fast MoE Inference via Quantization-Enabled Multi-Step Speculative Offloading
Key Point 메모리 제약이 있는 환경에서 MoE 모델 추론 속도를 1.5배 이상 개선할 수 있다는 것은 대형 모델을 일반 GPU에서 실행하려는 개발자들에게 직접 영향을 미친다.
핵심 요약
MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. Specter는 양자화된 경량 드래프트 모델을 기기에서 효율적으로 실행하면서도 전문가 활성화 패턴의 충실도를 유지한다. 드래프트 모델의 다단계 예측을 통해 향후 전문가 사용을 미리 파악하고, 런타임이 검증 전에 전문가 이동과 실행을 미리 조직할 수 있다. 전체 요약 5문장 읽기 → 009 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 → 010 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 011 12:11 ▲ 12 · 댓글 3 순환 언어 모델의 구조 설계: Huginn이 Ouro를 앞서다 Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. AI · 머신러닝 · Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
Key Point 순환 아키텍처는 파라미터 효율성과 추론 효율을 동시에 개선할 수 있는 차세대 언어 모델 설계 방향인데, 이 논문은 어떤 구조적 선택이 실제로 성능을 결정하는지 체계적으로 규명했기 때문이다.
핵심 요약
Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. 같은 규모와 토큰 예산에서 학습한 모델들을 비교하여 재귀 배치, 입력 주입, 재귀 상태 구성의 영향을 개별적으로 측정했다. Prelude-Recurrent-Block-Coda 샌드위치 아키텍처가 문맥 추출과 추론 집약적 작업에서 일관되게 성능을 높이는 것을 확인했다. 전체 요약 8문장 읽기 → 012 18:11 ▲ 135 · 댓글 43 DeepSeek, 552B 파라미터 추론 모델 V4.1 Flash 1017 공개 DeepSeek가 2026년 10월에 V4.1 Flash 1017 (Max) 모델을 오픈웨이트로 공개했다. 총 552억 개 파라미터 중 추론 시 16억 개만 활성화하는 MoE(Mixture of Experts) 구조를 사용한다. AI · 머신러닝 · DeepSeek V4.1 Flash 1017 (Max)
Key Point DeepSeek의 최신 고효율 모델이 오픈웨이트로 공개되어 누구나 자유롭게 활용할 수 있게 되었으며, 적정 가격에 동급 모델보다 빠른 성능을 제공한다.
핵심 요약
DeepSeek가 2026년 10월에 V4.1 Flash 1017 (Max) 모델을 오픈웨이트로 공개했다. 총 552억 개 파라미터 중 추론 시 16억 개만 활성화하는 MoE(Mixture of Experts) 구조를 사용한다. Artificial Analysis 벤치마크에서 지능지수 45점으로 같은 크기의 오픈웨이트 모델 중 평균(19점)을 크게 상회한다. 입력당 $0.30, 출력당 $1.20의 가격으로 일반적인 모델보다 저렴한 편이다. 초당 230.4 토큰 생성 속도로 같은 크기 모델 중 평균(77.9토큰)보다 빠르고, 첫 토큰까지 1.08초의 지연 시간은 경쟁 모델(중앙값 1.69초)과 비교해 우수하다. 전체 요약 6문장 읽기 → 013 12:10 ▲ 10 · 댓글 2 GQA의 3가지 딜레마를 동시에 푸는 Virtual Head Attention 긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. AI · 머신러닝 · Virtual Head Attention
Key Point KV 캐시 메모리와 학습 효율, 모델 품질의 균형을 동시에 달성해야 하는 LLM 개발자들이 GQA의 근본적 한계를 극복할 수 있는 방법을 제시합니다.
핵심 요약
긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. VHA는 두 개의 경량 선형 연산으로 구성되는데, Q Premix가 쿼리 헤드 개수를 절반으로 줄인 상태에서 KV 그룹 내 가상 헤드 다양성을 복구하고, Linear Postmix가 낮은 순위의 I + AB^top 잔여 구조를 통해 헤드 간 특징을 융합한다. VHA는 비선형 연산을 도입하지 않으므로 Premix와 Postmix를 추론 시간에 각각 쿼리 프로젝션과 출력 프로젝션으로 폴드할 수 있어, 표준 GQA-2 아키텍처로 축약되면서 기존의 모든 GQA 추론 최적화를 직접 재사용할 수 있다. 전체 요약 6문장 읽기 → 014 21:11 ▲ 243 · 댓글 80 DeepSeek V4.1 Flash: 552B 파라미터 혼합 전문가 모델 공개 DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. AI · 머신러닝 · DeepSeek: DeepSeek v4.1 Flash 1017
Key Point 추론 속도와 이미지 이해 능력을 갖춘 저비용 혼합 전문가 모델로, 에이전트와 장기 작업에 최적화된 구조를 처음 선보인다.
핵심 요약
DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. 이는 DeepSeek의 신규 Causal Encoder-Decoder(CED) 아키텍처를 기반으로 한 첫 번째 모델이며, 비대칭 파라미터 분할로 토큰당 계산을 낮게 유지한다. 이미지 이해가 아키텍처에 기본 내장되어 있으며, 시각과 텍스트 임베딩이 사전 학습 시작부터 함께 학습되었다. 전체 요약 11문장 읽기 → 015 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 016 00:11 새 버전 Transformers v5.20.1 출시, Beam 모델 추가 및 버그 수정 Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. AI · 머신러닝 · huggingface/transformers@v5.20.1
Key Point 새로운 고성능 모델 Beam이 추가되고 여러 모델 호환성 및 로딩 버그가 수정되어, 기존 Transformers 사용자와 새로운 모델을 시도하려는 개발자 모두에게 영향이 있다.
핵심 요약
Hugging Face Transformers 라이브러리 v5.20.1이 출시되었으며, Reflection AI의 새 모델 Beam이 추가되었다. Beam은 토큰 효율적인 프론티어급 모델로 코딩과 에이전트 작업에 최적화되어 있다. 자체 하드웨어, 인프라, 클라우드에서 실행할 수 있으며 특정 요구사항에 맞게 커스터마이징 가능하다. 전체 요약 6문장 읽기 → 017 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 018 12:11 ▲ 64 · 댓글 1 루프형 MoE 모델, 비대칭 연산 배분으로 효율 19% 개선 루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. AI · 머신러닝 · LatentLoop: Scaling Looped MoE Models with Asymmetric Compute Allocation
Key Point 파라미터 효율성을 중시하는 개발팀이 더 작은 모델로 더 나은 성능을 달성할 수 있는 구조적 개선 방안을 얻을 수 있기 때문입니다.
핵심 요약
루프형 Mixture-of-Experts(MoE) 모델은 파라미터를 재사용하면서 스파스 연산으로 성능을 높이는데, 같은 블록을 여러 번 거칠 때 각 방문마다 서로 다른 역할을 한다. 연구진이 공유 블록을 두 번 적용하는 모델에서 각 방문별로 별도의 잔차 계수를 학습한 결과, 첫 번째 방문에서 더 작은 스케일이 나타났다. 첫 번째 방문의 스케일을 줄이면 성능이 유지되거나 개선되지만, 두 번째 방문을 같은 정도로 줄이면 성능이 떨어진다. 전체 요약 8문장 읽기 → 019 12:11 ▲ 34 · 댓글 4 깊이 축 주의 메커니즘 확장으로 신경망 효율성 1.58배 향상 Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. AI · 머신러닝 · Multi-Stream Attention Residuals
Key Point 대규모 신경망의 효율성을 단순한 아키텍처 변경만으로 1.58배 향상시키는 방법을 제시하여 모델 학습과 배포 비용 절감에 직접 영향을 줄 수 있습니다.
핵심 요약
Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. 다중헤드 어텐션의 성공에 영감을 받아 Multi-Stream Attention Residuals(MSAR)을 제안했으며, 이는 AttnRes를 다중헤드 깊이 어텐션으로 확장한 것입니다. MSAR은 다중규모 인과 합성곱을 통해 시퀀스 문맥에서 스트림 다양성을 도출하여, 각 헤드가 서로 다른 문맥 관점을 통해 과거 표현을 검색할 수 있습니다. 전체 요약 6문장 읽기 → 020 12:11 ▲ 12 · 댓글 2 강화학습의 그래디언트 기아 현상 해결하는 ReSPO 논문 검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다. AI · 머신러닝 · ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning
Key Point 강화학습 모델 훈련에서 정책 최적화 과정의 근본적인 문제를 진단하고 이를 해결하는 새로운 알고리즘을 제시하여, 특히 데이터 재사용 효율성이 중요한 LLM 훈련에 직접 적용될 수 있기 때문이다.
핵심 요약
검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다. 기존 클리핑 기반 정책 최적화에서 '부호 의존 그래디언트 기아' 문제가 발생하는데, 이는 클리핑이 저중요도 가중치 영역의 미생성 긍정 응답을 억제하면서 동시에 고중요도 영역의 과도 생성 부정 응답이 지배하게 되는 현상이다. 연구팀은 ReSPO(Reshaped Sequence Policy Optimization)를 제안하는데, α-발산 변분 목적함수와 지수 분산 제어 틸트에서 파생된 부드러운 이중 분기 시퀀스 레벨 커널로 클리핑을 대체한다. 전체 요약 6문장 읽기 → 021 21:11 당일 +114 텐센트, 33개 언어 지원하는 다중언어 번역 모델 공개 텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. AI · 머신러닝 · Tencent-Hunyuan/Hy-MT2 · Python
Key Point 번역 모델의 성능이 상용 API를 능가하는 수준에 도달했으며, 극저비트 양자화로 온디바이스 배포가 실질적으로 가능해졌다.
핵심 요약
텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. 1.8B 모델은 AngelSlim의 1.25비트 극저비트 양자화로 저장 크기를 440MB까지 줄이고 추론 속도를 1.5배 높였다. 평가 결과 7B와 30B-A3B 모델은 DeepSeek-V4-Pro, Kimi K2.6 같은 오픈소스 모델을 능가하며, 1.8B 모델도 마이크로소프트·더바오 등 상용 API를 전반적으로 능가한다. 전체 요약 9문장 읽기 → 022 15:13 ▲ 74 · 댓글 2 강화학습으로 스스로 개선하는 초대형 모델 MiMo-V2.6 공개 Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. AI · 머신러닝 · MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
Key Point 장기 시퀀스 처리와 복합 작업에서 초대형 모델이 스스로 개선되도록 하는 RL 확장 기법이 어떻게 작동하는지, 그 구체적인 구현과 한계를 다루기 때문에 모델 개선 연구자와 개발자가 참고할 수 있다.
핵심 요약
Hugging Face와 협력 연구팀이 강화학습(RL) 규모를 확대하여 초대형 기초 모델의 자기 개선을 가능하게 하는 MiMo-V2.6 시리즈를 발표했다. RL 훈련 전에 다양한 멀티모달 데이터를 이용해 중간 학습을 수행하고, 하이브리드 SWA 구조의 사전학습 모델을 기반으로 확장 가능한 인프라를 구축했다. RL 계산을 세 가지 방향으로 확장했다: (1) 비동기 훈련으로 스텝당 1,568개 샘플과 2.7~3.7B 토큰 처리, 최대 1M 길이 컨텍스트 지원, (2) 코드·일반·시각·사이버 도메인을 포함한 다양한 환경과 에이전트 구성, (3) 그룹별 에이전트 채점으로 장기 작업의 정확한 보상 신호와 토큰 효율성 개선. 전체 요약 6문장 읽기 → 023 12:11 ▲ 111 · 댓글 25 스텝펀의 1백만 토큰 초대형 컨텍스트 모델 Step 5 Preview 공개 스텝펀이 에이전틱 작업 전용 플래그십 모델 Step 5 Preview를 OpenRouter를 통해 공개했다. AI · 머신러닝 · Step 5 Preview, a 1M-context MoE from StepFun, shows up on OpenRouter
Key Point 1백만 토큰의 초대형 컨텍스트로 긴 문서와 코드베이스를 한 번에 처리할 수 있어, AI 에이전트 구축과 복잡한 소프트웨어 엔지니어링 작업을 크게 단순화한다.
핵심 요약
스텝펀이 에이전틱 작업 전용 플래그십 모델 Step 5 Preview를 OpenRouter를 통해 공개했다. 27B 활성/600B 총 파라미터의 스파스 Mixture-of-Experts 아키텍처로 설계되었으며, 소프트웨어 엔지니어링과 재무 분야에서 강점을 보인다. 1,000,000 토큰의 초대형 컨텍스트 윈도우를 지원하며 최대 64,000개의 생성 토큰을 처리할 수 있다. 전체 요약 10문장 읽기 → 024 18:30 ▲ 13 · 댓글 4 MoE 모델 디코딩 성능 2배 근처로 높이는 프레임워크 Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. AI · 머신러닝 · SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
Key Point MoE 모델의 디코딩 병목을 해결하는 새로운 방식으로 정확도 손실을 최소화하면서 처리량을 획기적으로 높일 수 있다는 점이 중요하다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. 기존 전문가 가지치기(pruning)는 계산이 필요한 prefill 단계도 함께 가지쳐 모델 품질 저하에 비해 처리량 향상이 미미하다. SlimWise는 추론 각 단계별로 전문가 풀을 다르게 구성하는 서빙 프레임워크로, prefill은 전체 모델로 수행하고 decode는 가지친 모델을 사용한다. 전체 요약 6문장 읽기 → 025 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 026 18:33 ▲ 92 · 댓글 2 MoE 언어모델 강화학습, FP4 저정밀도로 5배 빠르게 대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. AI · 머신러닝 · TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
Key Point MoE 모델의 강화학습 훈련에서 롤아웃 단계의 메모리와 속도 병목을 저정밀도 양자화로 5배 이상 해결할 수 있게 되어, 대규모 모델 학습의 실용성이 크게 향상된다.
핵심 요약
대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. 기존 FP4 강화학습 방법들은 훈련과 롤아웃 경로의 양자화를 독립적으로 최적화하기 때문에 두 경로 간 불일치(discrepancy)가 발생하는 한계가 있다. 연구팀은 TRACE(Train-Rollout Quantization Alignment via Compact GuidancE)라는 FP4 양자화 프레임워크를 제안했으며, 이는 롤아웃 측의 양자화 결과를 훈련 측 반올림 결정에 직접 반영하여 불일치를 줄인다. 전체 요약 7문장 읽기 → 027 18:33 당일 +199 DeepSeek의 GPU GEMM 커널 라이브러리 오픈소스 공개 DeepGEMM은 NVIDIA GPU에 최적화된 통합 텐서 코어 커널 라이브러리로, 대언어모델(LLM)의 핵심 연산인 GEMM(FP8, FP4, BF16), Mega MoE, MQA 스코링 등을 단일 CUDA 코드베이스에 통합했다. AI · 머신러닝 · deepseek-ai/DeepGEMM · Cuda
Key Point LLM 추론·학습 성능을 좌우하는 GEMM 커널을 DeepSeek이 직접 최적화한 오픈소스 공개로, 고속 LLM 인프라 구축 시 활용할 수 있는 기반 도구가 확보된다.
핵심 요약
DeepGEMM은 NVIDIA GPU에 최적화된 통합 텐서 코어 커널 라이브러리로, 대언어모델(LLM)의 핵심 연산인 GEMM(FP8, FP4, BF16), Mega MoE, MQA 스코링 등을 단일 CUDA 코드베이스에 통합했다. CUTLASS와 CuTe의 개념을 참고하되 무거운 템플릿 의존성을 피하고, 런타임 JIT 컴파일(DeepJIT)로 설치 시 CUDA 컴파일을 요구하지 않는다. 각 행렬 크기에 따라 전문가 튜닝 라이브러리 수준 이상의 성능을 제공하며, H800에서 최대 1550 TFLOPS를 달성한다. 전체 요약 11문장 읽기 → 028 18:33 ▲ 339 · 댓글 396 AI가 설계한 오픈소스 AI 가속기, openTPU 공개 AI 에이전트가 설계한 오픈소스 AI 가속기 openTPU를 공개했으며, 하드웨어 설계(SystemVerilog)부터 호스트 소프트웨어까지 한 저장소에 담아 교육용으로도 활용 가능하게 구성했다. AI · 머신러닝 · OpenTPU – An open-source AI accelerator, developed by AI
Key Point GPU나 TPU 없이 FPGA로 LLM 추론을 달성했을 뿐 아니라, 전체 설계 과정을 오픈소스로 공개해 누구나 AI 가속기의 구조를 디코딩부터 회로까지 깊이 있게 학습할 수 있다.
핵심 요약
AI 에이전트가 설계한 오픈소스 AI 가속기 openTPU를 공개했으며, 하드웨어 설계(SystemVerilog)부터 호스트 소프트웨어까지 한 저장소에 담아 교육용으로도 활용 가능하게 구성했다. Xilinx Kintex-7 FPGA 카드(DDR3 2채널)에서 LFM2.5-230M int8 모델 기준 디코딩 52.3 tok/s, 프리필 335.4 tok/s 성능을 달성했고, 10개 현대 모델의 실제 가중치로 테스트해 시뮬레이터와 비트 정확도로 일치함을 확인했다. 4비트 양자화(FP4 블록 스케일) 지원으로 토큰당 바이트를 약 1/3 감소시키고 디코딩 속도를 40~45% 높였으며, int8 헤드는 정확도 유지를 위해 유지했다. 전체 요약 9문장 읽기 → 029 18:33 ▲ 2,013 · 댓글 1,195 Mistral, 52B 활성 파라미터 대형 멀티모달 모델 공개 미스트랄이 오픈웨이트 멀티모달 모델 'Mistral Large 4'를 공개했다. AI · 머신러닝 · Mistral Large 4
Key Point 오픈웨이트 대형 멀티모달 모델로 저가 가격대에서 기존 모델보다 효율적인 성능을 제공하려는 움직임이 시장에서 중요해지고 있기 때문이다.
핵심 요약
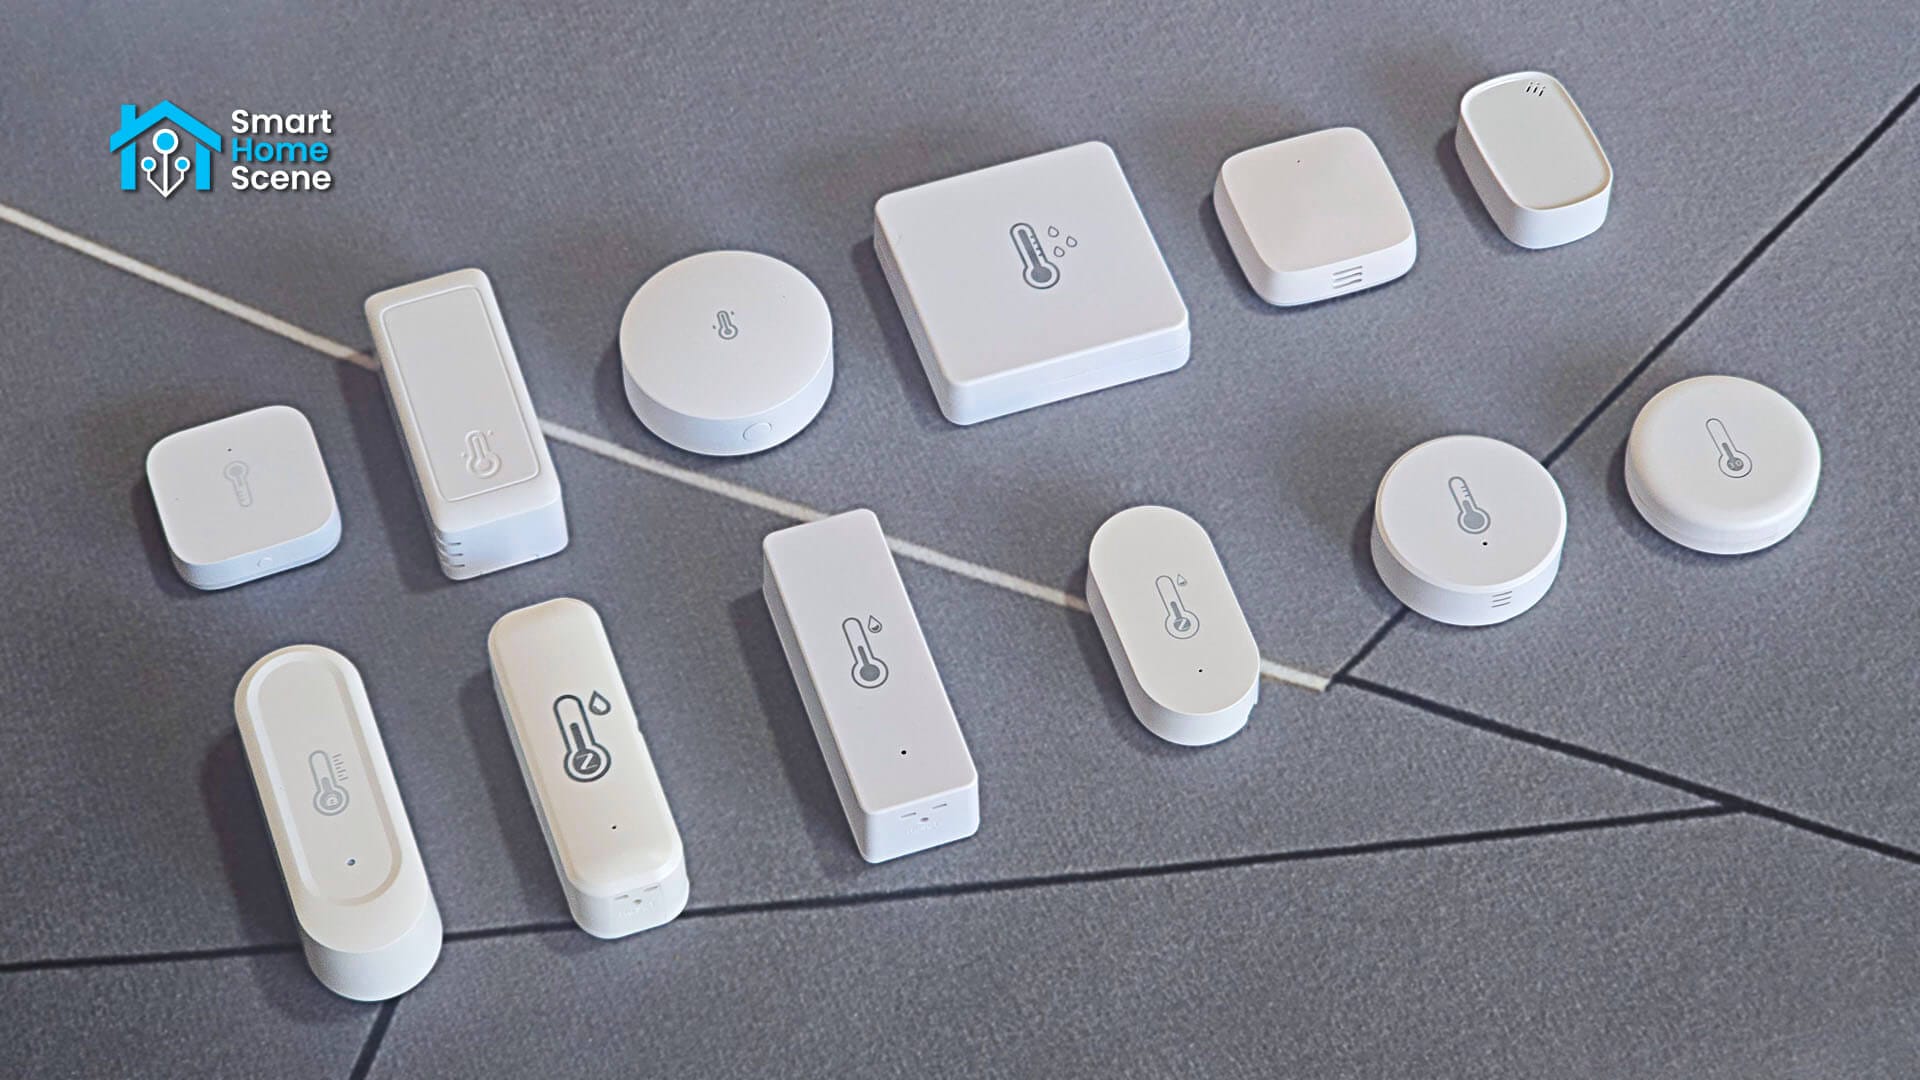
미스트랄이 오픈웨이트 멀티모달 모델 'Mistral Large 4'를 공개했다. 52B의 활성 파라미터와 1.05T의 총 파라미터를 갖춘 그래뉼러 혼합 전문가(MoE) 아키텍처를 채택했다. 1.6B 규모의 비전 인코더를 내장해 텍스트와 이미지 입력을 처리할 수 있다. 전체 요약 7문장 읽기 → 030 18:35 ▲ 243 · 댓글 123 실제 측정한 12개 Zigbee 온습도센서 정확도 비교 AliExpress에서 주로 구매되는 Aqara·Sonoff·Tuya·Thirdreality·Zemismart·Moes 등의 Zigbee 온습도센서 12개를 실제 환경에서 비교 테스트했다. 하드웨어 · 시스템 · Best-selling Zigbee temperature sensors tested and compared
Key Point 스마트홈에서 가장 저렴한 Zigbee 온습도센서를 선택할 때 정확도·배터리 수명·보고 간격 조정 가능성이 매우 다르므로 실제 측정 데이터에 기반한 선택이 필요하다.
핵심 요약
AliExpress에서 주로 구매되는 Aqara·Sonoff·Tuya·Thirdreality·Zemismart·Moes 등의 Zigbee 온습도센서 12개를 실제 환경에서 비교 테스트했다. 캘리브레이션된 기준 센서(Xiaomi Miaomiaoce MHO-C401)와 나란히 놓고 약 10일간 측정했으며, 기준 센서는 정육점의 법정 검증 온도계로 영점을 재조정했다. 온도 정확도는 Paulie(Sonoff SNZB-02P)와 Carmela(Sonoff SNZB-02B)가 평균 0.2°C 편차로 가장 우수했고, Livia·Adriana·Furio는 0.5~0.8°C 오차를 보였다. 전체 요약 12문장 읽기 → 031 06:11 ▲ 16 · 댓글 2 같은 블록 반복으로 LLM 깊이를 늘리는 LOOM 기법 Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. AI · 머신러닝 · Looping Beyond Twice: A Scalable Recipe for Looped Mixture-of-Experts
Key Point 같은 블록을 몇 번까지 반복할 수 있는지, 그리고 MoE 라우터의 동작 특성을 고려해 어떻게 효율적으로 설계할지가 실무 모델 개발에 직결된다.
핵심 요약
Looped Transformers는 같은 Transformer 블록을 반복 적용해 파라미터를 늘리지 않고 모델의 유효 깊이를 증가시킨다. 기존 연구는 반복 횟수 증가에 따른 성능 이득이 빠르게 감소해 2번 반복으로 제한했으며, MoE 모델에서 특히 이 문제가 심했다. LOOM은 두 가지 병목을 진단했다: 반복할 때마다 hidden-state 분산이 증가해 깊은 모델이 불안정해지는 '깊이의 저주' 현상, 그리고 라우터가 매번 같은 expert를 선택해 계산 다양성이 떨어지는 'expert 선택 붕괴' 현상이다. 전체 요약 8문장 읽기 → 032 06:11 ▲ 160 · 댓글 46 Reflection, 501B 파라미터 오픈소스 모델 'Beam' 공개 Reflection이 오픈가중치 희소 혼합전문가(MoE) 모델인 Beam을 발표했다. 총 501억 개 파라미터 중 23억 개만 활성화되며, 코딩·추론·에이전트 작업에 최적화됐다. AI · 머신러닝 · Beam: Reflection's 501B open-weight model
Key Point 고효율 오픈소스 에이전트 모델이 공개되며, 특히 추론 효율에서 훨씬 큰 모델과 경쟁할 수 있다는 점이 엔터프라이즈 코딩 워크로드에 미치는 영향이 크다.
핵심 요약
Reflection이 오픈가중치 희소 혼합전문가(MoE) 모델인 Beam을 발표했다. 총 501억 개 파라미터 중 23억 개만 활성화되며, 코딩·추론·에이전트 작업에 최적화됐다. Beam은 웹과 라이선스 데이터셋의 23.8조 개 토큰으로 사전학습되었으며, 10.5K NVIDIA GB300 GPU에서 4주간 RL을 실행해 1억 개 이상의 롤아웃을 생성했다. 코딩·에이전트 작업에서 GLM 5.2와 경쟁력 있는 성능을 보이며, Qwen 3.8-Max에 근접한다. 특히 추론 효율에서 우위가 있어 GLM 5.2 대비 3~4배 적은 계산량으로 유사한 추론 능력을 제공한다. 전체 요약 12문장 읽기 → 033 00:11 ▲ 107 · 댓글 19 독일 Aleph Alpha, 주권형 언어모델 Kolibri 공개 Aleph Alpha가 78B 총 파라미터(3B 활성화)의 영-독일 이중언어 Mixture-of-Experts 모델 Kolibri를 공개했으며, 최대 1M 토큰의 컨텍스트 윈도우를 지원하고 Apache 2.0 라이선스로 Hugging Face에서 다운로드 가능하다. AI · 머신러닝 · Kolibri Has Landed: A Sovereign Open-Weight Model
Key Point EU 규제에 맞춘 독일 기업의 오픈소스 모델이 소규모 활성 파라미터로 대형 모델을 능가하는 성능을 달성했으며, 투명한 공급망과 온프레미스 배포로 정부·산업 고객의 데이터 주권을 보장하는 새로운 접근 방식을 보여준다.
핵심 요약
Aleph Alpha가 78B 총 파라미터(3B 활성화)의 영-독일 이중언어 Mixture-of-Experts 모델 Kolibri를 공개했으며, 최대 1M 토큰의 컨텍스트 윈도우를 지원하고 Apache 2.0 라이선스로 Hugging Face에서 다운로드 가능하다. Kolibri는 정부·산업·항공우주 등 규제 대상 영역의 임무 수행을 위해 독일어, 추론, 수학, 에이전트 행동에 최적화되었으며, 개별 고객의 사용 사례에 맞춘 성능을 제공한다. 모델은 공급망 투명성, 독일 및 핀란드 인프라 기반 운영, 완전한 배포 자유도를 제공하여 주권성을 확보했으며, EU AI법과 GDPR 준수를 설계 초기부터 반영했다. 전체 요약 13문장 읽기 → 034 00:11 ▲ 160 · 댓글 91 독일의 주권형 AI, 78억 파라미터 콜리브리 공개 Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: Germany's new sovereign AI model Kolibri
Key Point EU AI 규정 준수, 데이터 독립성, 독일어 추론을 통합한 오픈웨이트 모델로 유럽 규제권 내 AI 자립이 기술적으로 가능함을 보여주며, 금융·공공·항공우주 등 데이터 민감 산업에 기존 대규모 모델 의존도를 낮힐 선택지를 제공한다.
핵심 요약
Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. 78.1억 개 파라미터 중 토큰당 3.46억 개(4.4%)만 활성화되며, 262,144 토큰 기본 문맥에서 최대 104만 8576 토큰까지 검증됐다. 독일 및 핀란드 인프라에서 768개 NVIDIA B200 GPU로 24조 토큰을 학습했으며, 독일 법률에 따라 구축돼 조직이 자체 서버에서 완전히 제어 가능하다. 전체 요약 12문장 읽기 → 035 21:11 당일 +152 언어 모델 검열 자동 제거 도구 Heretic 공개 GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. AI · 머신러닝 · p-e-w/heretic · Python
Key Point 안전 필터를 우회하는 완전 자동화 도구의 등장으로, 모델 수정 기술의 접근성이 크게 낮아졌으며 이로 인한 악용 가능성 증가와 기술 민주화 사이의 균형 문제가 제기된다.
핵심 요약
GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. 사용자가 명령줄 명령만으로 모델을 처리할 수 있으며, 트랜스포머 구조 이해가 필요 없다. Gemma-3-12B-IT 기준으로 Heretic이 생성한 모델은 유해 프롬프트 거부율 3/100, KL 발산 0.16으로, 수동 절제 모델(KL 발산 0.45~1.04)보다 원래 성능을 더 잘 보존했다. 전체 요약 9문장 읽기 → 036 21:11 ▲ 60 · 댓글 2 적응형 전문가 혼합으로 확산 모델의 소수 단계 생성 개선 마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. AI · 머신러닝 · E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models
Key Point 확산 모델의 가장 큰 장점인 소수 단계 고속 생성을 개선하는 새로운 방법으로, 기존 접근법의 근본적인 문제(후방 붕괴)를 회피하면서 매개변수 효율성을 유지한다.
핵심 요약
마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. 최근 연구는 위치 간 상관관계를 포착하기 위해 변분 자동인코더로 학습된 연속 가우시안 잠재변수를 도입했으나, 이러한 접근법은 잠재변수가 무시되는 후방 붕괴(posterior collapse) 문제에 빠지기 쉽다. 본 논문은 강화된 혼합-전문가(E-MoE) 방법을 제안하며, MoE 백본의 전문가 라우팅 결정으로 주어진 이산 공유 잠재변수에 대한 분해된 분포의 혼합으로 역프로세스를 구성한다. 전체 요약 5문장 읽기 → 037 06:11 ▲ 17 · 댓글 2 반복 구조와 희소 전문가 모델의 스케일링 법칙 제시 로프드 트랜스포머(반복 구조)와 MoE(혼합 전문가)는 서로 다른 효율성 경로를 제공한다: 반복 구조는 파라미터 수 고정 상태에서 계산 깊이를 늘리고, MoE 희소성은 활성 연산 고정 상태에서 총 용량을 확장한다. AI · 머신러닝 · Scaling Laws for Looped Mixture of Experts
Key Point 반복 구조와 희소 전문가 모델을 함께 스케일링하는 첫 통합 법칙으로, 제한된 연산량에서 효율성 극대화를 원하는 대규모 모델 개발의 새로운 설계 기준을 제공한다.
핵심 요약
로프드 트랜스포머(반복 구조)와 MoE(혼합 전문가)는 서로 다른 효율성 경로를 제공한다: 반복 구조는 파라미터 수 고정 상태에서 계산 깊이를 늘리고, MoE 희소성은 활성 연산 고정 상태에서 총 용량을 확장한다. 기존 스케일링 법칙은 반복 구조와 희소성을 따로 모델링했으나, 이 논문은 반복 구조와 희소성을 모델 크기·데이터와 함께 통합 모델링하는 'Loop Scaling Laws'를 제시했다. 핵심은 희소성-조건부 반복 매핑으로, 반복을 통한 유효 파라미터 이득을 특성화하고 희소성이 이 이득을 어떻게 높이는지를 나타낸다. 전체 요약 7문장 읽기 → 038 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 → 039 21:11 당일 +124 Neuro-sama 같은 AI 캐릭터를 직접 만드는 오픈소스 프로젝트 AIRI Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. AI · 머신러닝 · moeru-ai/airi · TypeScript
Key Point Neuro-sama 같은 AI 가상 캐릭터를 누구나 직접 구축할 수 있는 완전한 오픈소스 플랫폼이 나왔고, 게임 플레이부터 음성 채팅까지 놀라운 수준의 기능을 갖추고 있다.
핵심 요약
Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. 브라우저, macOS, Windows 데스크톱, 모바일 PWA 등 다양한 플랫폼에서 실시간 음성 채팅이 가능하며, Minecraft, Factorio, Kerbal Space Program 등 여러 게임을 플레이할 수 있다. WebGPU, WebAssembly, Web Workers 등 웹 기술로 그래픽과 레이아웃을 처리하면서도, NVIDIA CUDA와 Apple Metal을 통한 네이티브 추론으로 성능을 확보하는 하이브리드 아키텍처를 채택했다. 전체 요약 12문장 읽기 → 040 21:11 ▲ 10 · 댓글 1 80B 파라미터지만 13B만 쓰는 혼연 AI, 오픈소스 공개 혼연(Hunyuan)이 80억 개 파라미터 중 추론 시 13억 개만 활성화하는 혼합 전문가(MoE) 구조의 대규모 언어모델 Hunyuan-A13B를 오픈소스로 공개했다. AI · 머신러닝 · Hunyuan-A13B Technical Report
Key Point MoE 구조로 큰 모델의 성능을 유지하면서 추론 비용을 대폭 줄였으므로, 제한된 리소스 환경에서 강력한 LLM을 배포하려는 개발자와 조직에 직접적인 대안이 된다.
핵심 요약
혼연(Hunyuan)이 80억 개 파라미터 중 추론 시 13억 개만 활성화하는 혼합 전문가(MoE) 구조의 대규모 언어모델 Hunyuan-A13B를 오픈소스로 공개했다. 모델은 20조 개 토큰으로 사전학습되었으며, STEM 데이터를 강화해 사실 정확성과 추론 능력을 개선했다. 고품질 지도학습 미세조정과 대규모 강화학습으로 성능을 더욱 끌어올렸다. 전체 요약 6문장 읽기 → 041 18:11 ▲ 42 · 댓글 3 다국어 텍스트 인식에 최적화된 MoE 아키텍처 다국어 OCR의 문제점을 해결하기 위해 script-aware Mixture-of-Experts(ScriptMoE) 아키텍처를 제안했다. AI · 머신러닝 · All-in-One Multilingual Scene Text Recognition with Script-aware Mixture-of-Experts
Key Point 언어별 별도 모델 배포 비용과 복잡성 없이 실무 OCR 성능을 크게 개선하는 실용적 기술로, 다국어 텍스트 인식이 필요한 개발자들이 주목할 만하다.
핵심 요약
다국어 OCR의 문제점을 해결하기 위해 script-aware Mixture-of-Experts(ScriptMoE) 아키텍처를 제안했다. TextMuSS-10M이라는 10개 문자 체계와 229개 언어를 포함한 대규모 합성 텍스트 데이터셋을 구축했다. ScriptMoE는 단일 비전 인코더와 이미지별 라우터가 상위 2개의 문자 체계 전문 모듈로 분배하는 희소 MoE 블록으로 구성된다. 전체 요약 5문장 읽기 → 042 15:11 ▲ 12 · 댓글 2 대문자와 소문자를 구분해 읽는 메모리, 문맥에 따라 다른 의미 포착 LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. AI · 머신러닝 · MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
Key Point 토큰의 다중 의미를 문맥으로 구분해 메모리 효율성과 정확도를 동시에 높이는 기법으로, 소형 언어모델 최적화와 임베딩 기술 발전에 직결됩니다.
핵심 요약
LLM 효율성을 높이기 위해 Mixture of Memory Embeddings(MoME)를 제안했습니다. 기존 메모리 임베딩은 토큰을 고정된 하나의 항목으로만 매핑하는데, MoME는 각 토큰마다 M개의 슬롯 중 문맥에 맞게 선택해 읽습니다. 예를 들어 'python'은 프로그래밍 언어와 동물이라는 서로 다른 의미를 같은 토큰이지만 별도의 메모리 슬롯으로 저장 및 구분합니다. Llama-3, Qwen3, MobileLLM 등 여러 모델 아키텍처에서 기존 Value Embedding, Bigram, STEM 방식보다 성능이 우수했습니다. 전체 요약 5문장 읽기 → 043 16:18 ▲ 97 · 댓글 3 세 가지 제약을 동시에 푼 전문가 혼합 모델 등장 Mixture-of-Experts(MoE)의 참여도, 계산량, 메모리 비용을 독립적으로 제어할 수 없는 문제를 IntBMoE가 해결했습니다. AI · 머신러닝 · IntBMoE: Integrating Block-Level Conditioning into Expert Composition for Full-Participation Mixture-of-Experts
Key Point MoE는 모델 용량을 확장하는 핵심 기술인데, IntBMoE가 참여도·계산·메모리 세 제약을 동시에 독립적으로 제어할 수 있게 되면서 대규모 추천 시스템의 실전 배포 가능성을 열었습니다.
핵심 요약
Mixture-of-Experts(MoE)의 참여도, 계산량, 메모리 비용을 독립적으로 제어할 수 없는 문제를 IntBMoE가 해결했습니다. 블록 조건화된 MoE로 모든 전문가가 토큰 생성에 기여하며(완전 참여), 라우터가 일부 블록만 실행해 계산량을 낮추고, 학습된 코드북이 메모리를 제한합니다. 하이퍼네트워크가 각 층의 전문가들을 동적으로 합성하고, Dual-Path Residual Gating이 두 경로를 곱셈 게이팅으로 연결합니다. 전체 요약 5문장 읽기 → 044 09:10 ▲ 102 · 댓글 26 무한 개수 가중치 생성하는 LLM 아키텍처 제안 정적 사전학습 데이터 대신 실시간 상호작용 데이터로부터 모델 가중치를 생성하는 '무한-파라미터 LLM'이 제안됐다. AI · 머신러닝 · Infinite-Parameter LLMs: Generating and Adapting Weights from Live Data
Key Point LLM이 배포 후 사용자 상호작용 데이터를 학습하는 방식의 근본적 전환을 제시해, 미세조정 없이 동적 적응을 추구하는 개발자와 연구자에게 새로운 설계 방향을 제공한다.
핵심 요약
정적 사전학습 데이터 대신 실시간 상호작용 데이터로부터 모델 가중치를 생성하는 '무한-파라미터 LLM'이 제안됐다. 하이퍼네트워크가 사용자 입력이나 정정 같은 런타임 데이터를 공유 기본 네트워크의 저랭크 변조로 변환해 가중치를 동적으로 생성한다. 베이지안 신념으로 생성기의 잠재 코드를 추적해 세션 진행 중 가중치를 재계산하므로, 한 번만 읽고 고정하던 방식과 달라진다. 전체 요약 5문장 읽기 → 045 16:56 ▲ 114 · 댓글 8 DeepSeek, KV 캐시 압축으로 추론 속도 420 토큰/초 달성 DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. AI · 머신러닝 · DeepSeek-v4.1 Flash: Pushing the Limits of KV Cache Compression
Key Point 에이전트 워크플로우에서 일반적인 병목인 장문맥 프리필 계산과 KV 캐시 저장 비용을 획기적으로 줄인 새로운 모델 아키텍처 설계가 장기 맥락 처리와 배포 비용 절감에 어떻게 영향을 미치는지 보여준다.
핵심 요약
DeepSeek-v4.1 Flash는 552B 매개변수 멀티모달 모델로, 에이전트 워크플로우에서 증가하는 컨텍스트와 도구 호출로 인한 프리필 계산 부담을 해결하기 위해 설계됐다. KV 캐시 압축을 위해 채널·시퀀스·레이어 세 차원에서 최적화를 진행했으며, 같은 시퀀스 길이에서 런타임 KV 캐시는 v4-Flash의 1/4, 영구 저장소는 1/8 수준으로 줄었다. Causal Encoder-Decoder(CED) 아키텍처를 도입해 프리필 단계에서 8B, 디코딩 단계에서 16B 매개변수만 활성화되도록 설계했으며, 이는 입력 중심의 에이전트 시나리오에 특히 효율적이다. 전체 요약 12문장 읽기 → 046 00:10 ▲ 102 · 댓글 23 PyTorch로 직접 구현한 최신 LLM 아키텍처 학습 저장소 최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다. AI · 머신러닝 · OpenArch – PyTorch implementations of modern LLM architectures
Key Point LLM 아키텍처의 세부 설계 차이를 명확히 읽고 비교하고 싶은 개발자라면, 프로덕션 코드의 복잡성 없이 각 선택지가 어떻게 구현되는지 바로 확인할 수 있다.
핵심 요약
최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다. GPT-2, Llama 2/3/4, Qwen, Mistral, DeepSeek R1 등 11개 텍스트 모델과 PaliGemma, Qwen3 등 멀티모달 모델을 구현 중이며, 추가로 72개 아키텍처 전체 구현을 목표로 한다. 주의 메커니즘(MHA, GQA, MQA, MLA), 정규화(RMSNorm, QK-Norm), 위치 인코딩(RoPE, NoPE), MoE 라우팅 등 현대 LLM들이 사용하는 구조적 선택지를 명시적으로 표현해 비교하기 쉽게 했다. 전체 요약 5문장 읽기 → 047 21:11 당일 +873 일반 PC에서 744B 규모 대규모 언어모델 실행하는 C 엔진 공개 Colibrì는 순수 C와 의존성 없이 744B~2.8T 규모 MoE 모델을 일반 하드웨어에서 실행하는 추론 엔진이다. 오픈소스 · 도구 · JustVugg/colibri · C
Key Point 소유한 PC로 최대 2.8T 규모 모델을 실행할 수 있는 가능성을 보여주며, 하이퍼스케일러 하드웨어 의존성을 제거해 대규모 모델 접근성을 크게 낮춘다.
핵심 요약
Colibrì는 순수 C와 의존성 없이 744B~2.8T 규모 MoE 모델을 일반 하드웨어에서 실행하는 추론 엔진이다. VRAM, RAM, 디스크를 하나의 계층 구조로 취급해 제한된 고속 메모리에서도 모델 정확도를 유지하며 속도만 조절된다. GLM, Kimi, DeepSeek, Qwen 등 8개 모델 계열을 지원하며 각각 하나의 C 파일로 구현되어 동일한 인터페이스(coli chat/serve/web)를 사용한다. 전체 요약 5문장 읽기 → 048 08:12 ▲ 211 · 댓글 112 280억 파라미터 Kimi K3를 맥북에서 초당 1토큰 속도로 구동 삼성 M5 Max 맥북 프로(128GB)에서 280억 파라미터 Kimi K3 MoE 모델을 4개 SSD에서 스트리밍하며 초당 1.00토큰의 안정적 디코딩 속도를 달성했다. AI · 머신러닝 · Kimi K3 (2.8T) at 1 token/s on a MacBook Pro, streamed from four SSDs
Key Point 280억 개 파라미터를 가진 대규모 언어모델을 품질 손상 없이 소비자용 하드웨어에서 구동하는 것이 가능함을 보여주며, 가정용 AI 인프라의 현실적 가능성을 시사한다.
핵심 요약
삼성 M5 Max 맥북 프로(128GB)에서 280억 파라미터 Kimi K3 MoE 모델을 4개 SSD에서 스트리밍하며 초당 1.00토큰의 안정적 디코딩 속도를 달성했다. 모델의 1.45TB 전문가 가중치는 SSD에서 동적으로 로드되며, 프리필 단계에서 각 레이어의 전문가를 8배 중복 읽기하면서 약 6.3분의 지연이 발생한다. 기존 공개 벤치마크(0.68토큰/s)보다 43% 빠른 성능을 기록했으며, 드라이브 개수에 따라 1개 52%, 2개 73%, 3개 90%의 속도 향상을 보인다. 전체 요약 5문장 읽기 → 049 20:31 ▲ 951 · 댓글 399 DeepSeek V4 Pro 정식 공개 DeepSeek V4 Pro 0813은 DeepSeek이 출시한 대규모 혼합 전문가(MoE) 모델이다. AI · 머신러닝 · DeepSeek V4 Pro 0813
Key Point DeepSeek의 최신 고성능 모델이 정식 공개되면서 개발자들의 관심이 집중되고 있다.
핵심 요약
DeepSeek V4 Pro 0813은 DeepSeek이 출시한 대규모 혼합 전문가(MoE) 모델이다. OpenRouter를 통해 호스팅되며, 실시간 성능 지표와 가격 정보를 제공한다. OpenAI 호환 API로 대부분의 SDK에서 베이스 URL만 변경하여 사용할 수 있다. 050 20:31 ▲ 643 · 댓글 151 알리바바 Qwen3.8 공개, 2.4T 규모 오픈소스 LLM 알리바바가 Qwen 시리즈 중 가장 강력한 모델인 Qwen3.8을 공개했으며, 2.4T 매개변수 중 95B가 활성화되는 혼합 전문가(MoE) 구조로 설계됐다. AI · 머신러닝 · Qwen3.8-2.4T
Key Point Qwen-Max급 오픈 모델의 첫 공개로, 개발 커뮤니티에서 높은 관심을 받으며 코딩과 에이전트 작업 성능을 주목하고 있다.
핵심 요약
알리바바가 Qwen 시리즈 중 가장 강력한 모델인 Qwen3.8을 공개했으며, 2.4T 매개변수 중 95B가 활성화되는 혼합 전문가(MoE) 구조로 설계됐다. 코딩, 전문 작업, 연구, 장기 에이전트 작업 전반에서 상당한 성능 향상을 제공하며, 복잡한 다단계 작업 완료 신뢰성이 강화됐다. 최대 1,010,000 토큰까지 확장 가능한 맥락 길이와 추론 깊이를 조절할 수 있는 유연한 사고 제어 기능을 지원한다.