쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "최적화"조건 지우기 ×
001 15:11 ▲ 13 · 댓글 1 멀티모달 LLM의 정보 검색 메커니즘 분석 멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. AI · 머신러닝 · A Broader Look into MLLM's Retrieval Heads
Key Point 멀티모달 LLM의 정보 검색 능력이 특정 어텐션 헤드에 집중되어 있다는 발견은 이들 모델의 작동 원리를 이해하는 핵심이며, 최적화를 통해 성능을 구체적으로 개선할 수 있는 방법을 제시한다.
핵심 요약
멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. 이 연구는 기존 연구의 한계를 확장해 음성-시각 입력 같은 새로운 모달리티를 포함한 18개 모델 체크포인트를 분석했다. 같은 답이 음성 또는 화면에 표시되는 쌍을 이루는 입력으로 테스트한 결과, 증거 내용이 같으면 검색 헤드는 새로운 모달리티에서도 희소성을 유지한다. 전체 요약 6문장 읽기 → 002 03:11 ▲ 10 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
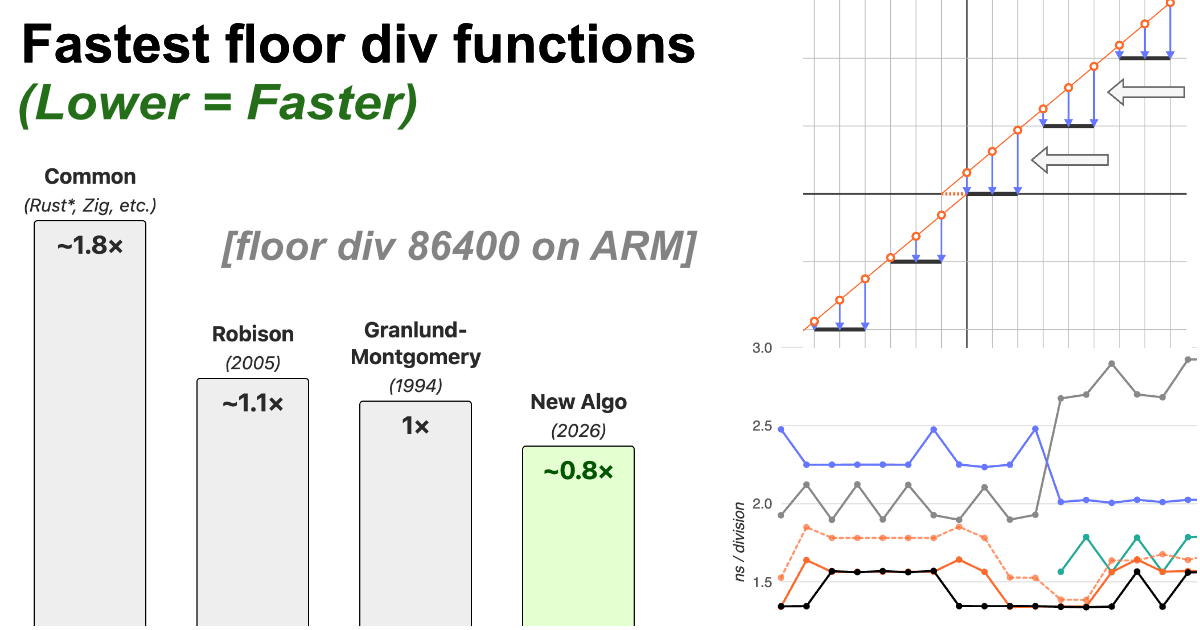
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 003 00:11 ▲ 123 · 댓글 10 64비트 부호있는 정수 나눗셈을 더 빠르게 하는 새로운 알고리즘 부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 인프라 · 데브옵스 · A new faster algorithm to compute 64-bit signed floor division
Key Point 정수 나눗셈은 단순해 보이지만 음수 처리와 성능 최적화가 깊이 있으며, 다양한 CPU에서 구현 방식을 달리 선택해야 하므로 저수준 성능 최적화가 중요한 시스템 프로그래밍에 실질적 가치가 있습니다.
핵심 요약
부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 컴파일 타임에 나누는 수가 정해진 경우, 기존 방법은 곱셈 1회 + 2~3 사이클 또는 나머지 계산이 필요했으며, 음수 처리를 위해 추가 분기나 비교가 들어갑니다. 1994년 Granlund·Montgomery 논문의 기법을 확장하면 양수 나눗셈을 부호 반사로 처리해 5~6 사이클을 3 사이클로 단축할 수 있고, 2005년 Arch D. Robison 논문은 곱셈-더하기-시프트 조합으로 더 단순한 구현을 제시했습니다. 전체 요약 10문장 읽기 → 004 21:11 당일 +152 로컬 배포 가능한 개인용 AI 어시스턴트 QwenPaw Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. AI · 머신러닝 · agentscope-ai/QwenPaw · TypeScript
Key Point 로컬 배포로 데이터 프라이버시를 보장하면서도 멀티 채널 지원과 고급 보안 기능을 갖춘 오픈소스 AI 어시스턴트가 공개되어, 개인/팀 단위의 자동화와 협업 워크플로우를 완전히 자체 제어할 수 있게 되었다.
핵심 요약
Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. 3계층 메모리 시스템을 갖추고 있다: 실시간 작업 맥락, 전체 대화 기록, ReMe 기반의 자체 진화하는 개인 지식베이스로 대화와 자료가 마크다운 메모리로 변환되어 검색 및 연결이 가능하다. 에이전트 작업에 최적화된 QwenPaw-Flash 모델(2B/4B/9B/35B-A3B/27B)을 자체 개발했으며, API 키 없이 로컬 실행이 가능하거나 Ollama, LM Studio, 14개 이상의 클라우드 제공자를 지원한다. 전체 요약 13문장 읽기 → 005 21:11 ▲ 18 · 댓글 4 LLM 에이전트 처리, 도구 응답 대기를 고려한 스케줄링으로 성능 향상 LLM 기반 에이전트 서빙은 GPU 클러스터에서의 모델 추론과 분산된 CPU의 외부 도구 실행을 반복하며 진행된다. AI · 머신러닝 · TAO: Tool-Aware Joint Scheduling for LLM-Based Agentic Serving
Key Point LLM 에이전트의 성능 병목이 어디에 있는지, 그리고 도구 응답 준비 상태를 고려한 스케줄링이 왜 기존 방식보다 효과적인지를 보여주는 구체적인 개선 수치를 제시한다.
핵심 요약
LLM 기반 에이전트 서빙은 GPU 클러스터에서의 모델 추론과 분산된 CPU의 외부 도구 실행을 반복하며 진행된다. 기존 시스템들은 외부 도구의 응답 준비 상태를 성능 평가에 반영하지 않아 자원을 낭비하고, 휴리스틱 전략으로 GPU 준입과 배치를 결정해 스케줄링 최적화가 부족했다. TAO는 도구 응답 준비 상태, 노드별 캐시 크레딧(시간 감쇠 적용), 토큰 차지 공간을 결합한 가치 인터페이스를 제공한다. 전체 요약 5문장 읽기 → 006 15:11 ▲ 208 · 댓글 49 Claude Code 상태 표시줄이 토큰의 15~20% 낭비하는 이유와 해제법 Claude Code는 30초마다 백그라운드 에이전트의 전체 트랜스크립트를 모델(보통 Opus)로 보내 '최근 동작을 3~5단어로 설명'하도록 요청하며, 답은 에이전트 패널의 상태 줄만 업데이트한다. AI · 머신러닝 · Claude Code burns ~15–20% of your tokens on a 3-word status line
Key Point Claude Code의 상태 표시 기능이 전체 토큰 사용량의 최대 1/5을 낭비하고 있으며, 공식 설정으로는 비활성화할 수 없다는 점이 중요하다.
핵심 요약
Claude Code는 30초마다 백그라운드 에이전트의 전체 트랜스크립트를 모델(보통 Opus)로 보내 '최근 동작을 3~5단어로 설명'하도록 요청하며, 답은 에이전트 패널의 상태 줄만 업데이트한다. 이 agent_summary 기능은 Claude Code 전체 토큰 사용량의 15~20%(일부 측정에선 18~26%)를 차지하지만, 사용자는 끌 방법이 없다. 2.1.232버전(2026년 8월)부터 기본 활성화되었으며, OpenTelemetry export 분석으로 주 대화보다 많은 비용을 소비함이 드러났다. 전체 요약 10문장 읽기 → 007 06:11 새 버전 Node.js v24.22.2 LTS 릴리스, V8 버그 수정과 스트림 개선 포함 Node.js v24.22.2 'Krypton' LTS 버전이 출시되었다. 인프라 · 데브옵스 · nodejs/node@v24.22.2
Key Point LTS 버전 릴리스는 프로덕션 환경에서 장기간 지원되는 안정적인 버전이므로, 버그 수정과 성능 개선 사항을 확인할 필요가 있다.
핵심 요약
Node.js v24.22.2 'Krypton' LTS 버전이 출시되었다. V8 엔진의 여러 백포트 패치가 적용되어 버그 수정이 이루어졌다. 스트림의 비동기 컨텍스트 유지 문제를 해결하는 개선이 포함되었다. 전체 요약 4문장 읽기 → 008 06:11 ▲ 11 · 댓글 2 AI 에이전트가 자신의 개선 방법을 스스로 최적화한다 언어 에이전트가 재사용 가능한 스킬에 절차적 지식을 저장하는데, 기존 스킬 최적화 방법들은 사람이 설계한 고정된 절차를 따르거나 각 작업마다 메타스킬을 재학습한다. AI · 머신러닝 · Skill^{infty}: Recursive Self-Improvement for Agent Skill Optimization
Key Point AI 에이전트가 문제 해결 방법 자체를 자동으로 개선할 수 있는 체계가 나왔으며, 이는 AGI로 향하는 재귀적 자기개선의 실질적 구현 사례다.
핵심 요약
언어 에이전트가 재사용 가능한 스킬에 절차적 지식을 저장하는데, 기존 스킬 최적화 방법들은 사람이 설계한 고정된 절차를 따르거나 각 작업마다 메타스킬을 재학습한다. Skill^∞는 메타 에이전트가 메타스킬을 따라 작업 스킬을 최적화하고, 동일한 절차로 메타스킬 자신도 최적화하는 재귀적 자기개선(RSI) 방식을 제시한다. 최적화 과정은 에이전트가 주도하며, 실행 추적을 진단하고 후보를 제안하며 독립적 검토를 요청하고 탐색 예산을 배분하는 단계들을 정의한다. 전체 요약 6문장 읽기 → 009 03:11 ▲ 12 · 댓글 2 폐쇄형 선택지 판정용 소형 언어 인코더 설계 방식 비교 도구 선택 같은 폐쇄형 결정 작업을 위해 얼마나 작은 인코더를 쓸 수 있는지, 그리고 선택지를 함께 읽을지 개별로 읽을지를 비교하는 연구다. AI · 머신러닝 · Joint or Per-Option? Compact Encoders for Closed-Set Decisions from 17 Million to 1 Billion Parameters
Key Point 소형 언어 모델로 도구 선택·카테고리 분류 같은 의사결정을 더 빠르고 안정적으로 처리할 수 있는 설계 방식이 검증되어, 프로덕션 LLM 파이프라인 최적화에 직접 영향을 미친다.
핵심 요약
도구 선택 같은 폐쇄형 결정 작업을 위해 얼마나 작은 인코더를 쓸 수 있는지, 그리고 선택지를 함께 읽을지 개별로 읽을지를 비교하는 연구다. 3개 시드로 3천2백만 파라미터에서 실험한 결과 선택지별 채점(per-option scoring) 방식이 37개 벤치마크 병합 테스트에서 공동 채점(joint scoring) 방식을 보정 후 5.8점 능력 차이로 이기고, 유사한 훈련량 조건에서는 2.8점 앞선다. 외부 벤치마크 2개도 이 경향을 보였으나 미학습 작업에서는 통계적 유의성이 없다. 전체 요약 8문장 읽기 → 010 00:11 ▲ 381 · 댓글 4 LLM 에이전트 강화학습, 턴 단위 신용할당으로 최적화 장시간 작업을 수행하는 LLM 에이전트는 환경과 상호작용하며 각 행동을 토큰 단위로 생성한다. AI · 머신러닝 · Multiscale Policy Optimization for Long-Horizon LLM Agents
Key Point LLM 에이전트의 장시간 작업에서 어디에 책임을 할당할지 판단하는 방식을 개선함으로써, 복잡한 추론 작업에서 강화학습 효율을 높일 수 있기 때문이다.
핵심 요약
장시간 작업을 수행하는 LLM 에이전트는 환경과 상호작용하며 각 행동을 토큰 단위로 생성한다. 현재 방식에서 비평가(critic) 값이 주로 턴(turn) 간에 변화하는 것을 발견했다. 이에 따라 턴 단위에서 최적화하면서 토큰 간 신용할당을 세밀하게 조정할 필요가 있다. 전체 요약 7문장 읽기 → 011 00:11 ▲ 120 · 댓글 25 20년 된 비즈니스 게임의 비밀을 풀다 2001년 작 비즈니스 시뮬레이션 게임 '패스트 푸드 타이쿤 2'를 역컴파일해 그 구조를 분석한 결과를 공개했다. 하드웨어 · 시스템 · Decompiling Fast Food Tycoon 2: Drawing the World
Key Point 20년 전 고전 게임의 역컴파일을 통해 당시 게임 개발의 세부 기술(렌더 최적화, 라이팅 시스템, AI 스케줄링)과 게임 디자인(평가 알고리즘)의 정교함이 드러났으며, 현대 게임 개발과 비교할 때 아날로그 시대 게임이 얼마나 치밀했는지 보여준다.
핵심 요약
2001년 작 비즈니스 시뮬레이션 게임 '패스트 푸드 타이쿤 2'를 역컴파일해 그 구조를 분석한 결과를 공개했다. GPT-6.1 Sol Medium과 Ghidra를 활용해 fastfood2.exe의 4,046개 함수를 약 9.5MB의 C 형태 코드로 변환하고 SQLite에 로드해 함수 간 관계를 검색할 수 있게 만들었다. ReadProcessMemory API와 Windows 메시지 핸들러 패칭을 통해 실행 중인 게임의 메모리를 검사하고 UI 스레드에서 명령을 실행할 수 있도록 했다. 전체 요약 9문장 읽기 → 012 18:11 ▲ 30 · 댓글 3 루핑 트랜스포머의 역전파 자르기, 규모 법칙으로 최적값 찾다 루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. AI · 머신러닝 · Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
Key Point 루핑 트랜스포머의 학습에서 계산량 절약을 위한 역전파 자르기가 실제로 최적인지를 대규모 실험으로 체계적으로 검증한 결과로, 효율성과 성능의 트레이드오프를 명확히 한다.
핵심 요약
루핑 트랜스포머는 공유 레이어 블록을 반복 사용해 학습 가능한 매개변수 수는 유지하면서 계산 깊이를 늘리는 구조이며, 역전파 시간(BPTT)으로 학습된다. 학습 계산량을 줄이기 위해 BPTT를 최근 몇 루프로 잘라내는 방식이 흔하지만, 잘라냄으로 인한 기울기 편향이 루핑의 이점을 약화시킬 수 있다. 연구팀은 약 600번의 학습 실행을 통해 모델 크기, 학습 토큰 수, 정방향·역방향 루프 횟수를 함께 변화시켜 루핑과 잘라냄의 효과를 포착하는 통합 규모 법칙을 도출했다. 전체 요약 8문장 읽기 → 013 15:11 ▲ 22 · 댓글 5 MoE 모델의 채널 선택, 보정 데이터 없이 가능 Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. AI · 머신러닝 · Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
Key Point 현재 MoE 모델 최적화의 표준인 보정 기반 임계값이 예산 보장과 성능 향상을 모두 충족하지 못하며, 보정 없는 top-k와 경량 리더로 더 안정적이고 빠른 디코딩을 달성할 수 있음을 보여준다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. 기존 방식은 오프라인 데이터로 보정한 임계값을 사용하지만, 임계값을 통과하는 채널 수는 입력마다 달라져 실제 읽기 예산이 불안정하다: Prox는 18% 읽기 예산으로 보정되었으나 실제로는 평균 12.9%만 읽는다. Top-k 방식은 각 토큰의 k개 최고점수 채널을 선택하며 보정 데이터가 필요 없다. 전체 요약 8문장 읽기 → 014 12:11 ▲ 17 · 댓글 2 이전 시행 기록으로 AI 에이전트 성능 끌어올리기 상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. AI · 머신러닝 · ReGE: Stronger Agents through Experience Synthesis
Key Point 에이전트가 자체 실행 기록을 재활용해 성능을 크게 높일 수 있으며, 비용도 획기적으로 절감할 수 있음을 실증했기 때문에 복잡한 작업을 수행하는 AI 시스템의 구축 방식을 바꿀 가능성이 있다.
핵심 요약
상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. ReGE는 이러한 기록된 경험을 새로운 시도의 지침으로 변환하는 프레임워크다. 주요 구현인 ReGE-Syn은 단일 코치 호출로 제한된 실행 기록과 사용 가능한 결과물을 과제별 발견사항과 제안된 행동, 관련 함정을 연결한 자율적 지침으로 종합한다. 전체 요약 10문장 읽기 → 015 12:11 ▲ 153 · 댓글 133 클로드, 신약 개발 6개 기관과 현장 연구로 확장 Anthropic의 생명과학팀이 Claude를 이용해 신약 개발을 가속화하기 위해 BigHat Biosciences, Bristol Myers Squibb, Divergence Labs, Enveda, Generate Biomedicines, The Column Group과 파트너십을 체결했다. AI · 머신러닝 · Early progress on accelerating drug development with Claude
Key Point 신약 개발의 여러 단계(분자 설계, 최적화, 규제 문서, 임상 시험 계획)에서 Claude의 구체적 효과가 입증되었으며, 대형 제약사부터 스타트업까지 실제 프로그램과 연계한 생명과학 AI 활용이 본격화되는 시점이다.
핵심 요약
Anthropic의 생명과학팀이 Claude를 이용해 신약 개발을 가속화하기 위해 BigHat Biosciences, Bristol Myers Squibb, Divergence Labs, Enveda, Generate Biomedicines, The Column Group과 파트너십을 체결했다. Generate Biomedicines는 Claude Code로 CAR T-cell 치료법의 유전자 지시를 70% 단축했으며, 랩 테스트에서 암세포 퇴치는 효율적이고 면역세포의 수용체 생성은 약 10배 증가했다. Divergence Labs는 Claude가 약 1개월간 약 35,000개의 항체 설계를 자동 생성하도록 해 식품 알레르기 치료법 개발을 진행했으며, 초기 테스트에서 IgE에 결합할 3개, 분리할 20개 설계를 발견했다. 전체 요약 12문장 읽기 → 016 09:11 ▲ 110 · 댓글 40 리퀴드 AI, 멀티모달 소형 모델 LFM3 공개 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence
Key Point 클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다. LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다. 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다. 전체 요약 10문장 읽기 → 017 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 018 03:11 새 버전 OpenAI Python SDK v3.40.0 릴리스, 프롬프트 캐시 TTL 옵션 추가 OpenAI Python SDK v3.40.0이 릴리스되었으며, 주요 기능으로 프롬프트 캐시 브레이크포인트 TTL(Time-To-Live) 옵션이 추가되었다. AI · 머신러닝 · openai/openai-python@v3.40.0
Key Point 프롬프트 캐시 TTL 옵션은 API 호출 시 캐시된 토큰의 유효기간을 세밀하게 제어할 수 있게 해주므로, OpenAI API를 활용하는 개발자들이 비용 최적화와 캐시 정책을 더 정교하게 관리할 수 있다.
핵심 요약
OpenAI Python SDK v3.40.0이 릴리스되었으며, 주요 기능으로 프롬프트 캐시 브레이크포인트 TTL(Time-To-Live) 옵션이 추가되었다. 브라우저 데모 의존성을 명시적으로 지정하는 버그 수정이 포함되었다. 생성된 코드 분리 기록 및 검증 프로세스를 업데이트하고 SDK 헬퍼를 보존하는 개선사항이 적용되었다. 전체 요약 5문장 읽기 → 019 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 020 00:11 ▲ 26 · 댓글 2 LLM 에이전트 강화학습의 신용 할당 문제 해결한 ProAS 프레임워크 LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. AI · 머신러닝 · ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
Key Point 다단계 추론이 필요한 LLM 에이전트의 강화학습 효율성을 크게 개선하는 방법론이 제시되어, 언어 모델 기반 자동화 시스템의 성능 향상에 직결된다.
핵심 요약
LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. 이 접근 방식은 선호되는 궤적에서 구조적으로 비합리적인 행동을 강화하고, 비선호 궤적에서 각 행동의 하위 편차를 무시한다. ProAS는 동적으로 진화하는 에이전틱 레퍼런스 그래프(ARG)를 활용해 비합리적 인센티브 마스킹(MUI)과 비대칭 페널티 재배분(APR)을 통한 세밀한 신용 할당을 구현한다. 전체 요약 5문장 읽기 → 021 00:11 ▲ 21 · 댓글 2 추측 샘플링과 확산 모델의 속도-품질 트레이드오프 분석 추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. AI · 머신러닝 · Speculative Diffusion is a Tale of Two Tradeoffs
Key Point LLM 추론 성능을 높이는 두 가지 기술(추측 디코딩과 확산 모델)의 트레이드오프를 체계적으로 분석함으로써 최적 조합 방식을 제시한다.
핵심 요약
추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. 최근 개발된 확산 LLM(dLLM)은 더 적은 확산 스텝으로 출력 품질을 떨어뜨려도 대폭의 속도 향상을 달성할 수 있다는 점에서 다르다. 확산 모델은 토큰을 병렬로 생성하기 때문에 자회귀 모델보다 빠르게 샘플링할 수 있어, 추측 디코딩의 초안 모델로 유망하다. 전체 요약 6문장 읽기 → 022 00:11 ▲ 24 · 댓글 2 저정밀 연산 RL에서 성능과 안정성을 동시에 확보한 miniTE 공개 Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. AI · 머신러닝 · miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
Key Point LLM 강화학습에서 저정밀 연산의 수치 안정성 문제를 해결하고 1.4배 이상의 처리 속도 향상을 달성한 기술이 공개되어, 더 효율적이고 저비용의 LLM 학습이 가능해진다.
핵심 요약
Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. 단순히 모델 가중치와 수치 형식을 맞추는 것만으로는 일관된 정책 평가를 보장할 수 없으며, 크로스 엔진 수치 정렬이 중요함을 확인했다. miniTE는 실행 진단, 크로스 엔진 수치 정렬, W4A4 GEMM 계산을 결합한 경량 프레임워크로, RL 목적함수를 수정하지 않으면서도 수치 일관성을 개선한다. 전체 요약 6문장 읽기 → 023 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 024 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 025 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 026 15:11 ▲ 35 · 댓글 2 통일된 설계 원칙으로 텍스트-이미지 프롬프트 자동 개선 사용자의 불충분한 텍스트 요청을 시각적으로 완성된 프롬프트로 변환하는 Qwen-Image-PE를 발표했다. AI · 머신러닝 · Qwen-Image-PE: Learning Visual Design for Text-to-Image Prompt Enhancement
Key Point 프롬프트 개선이 더 이상 일반적 의미 전달에만 중점을 두지 않고, 조명·구도·미학 같은 시각 설계 원칙을 구체적으로 학습하게 되면서 텍스트-이미지 생성의 품질 천장이 크게 올라간다.
핵심 요약
사용자의 불충분한 텍스트 요청을 시각적으로 완성된 프롬프트로 변환하는 Qwen-Image-PE를 발표했다. 감독된 미세조정과 강화학습 2단계 훈련으로 조명, 구도, 레이아웃, 디테일 등 세부 설계 요소를 학습한다. Caption-Based Reverse Distillation(CRD)은 잘 디자인된 이미지의 밀집 캡션을 설계 지도신호로 사용하고, Groupwise Design Reward(GDR)는 동일 요청의 모든 후보 이미지를 비교해 개선한다. 전체 요약 8문장 읽기 → 027 15:11 ▲ 38 · 댓글 2 LLM으로 과학 원리를 실시간 구축하는 'Principia' 프레임워크 과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. AI · 머신러닝 · Principia: Test-Time Hypotheses to Principle Construction for Scientific Discovery
Key Point 과학 발견 과정에서 원리 도출의 병목을 자동화하고, 테스트 타임에 진화하는 지식 구축 방식이 여러 분자·생물학 영역에서 기존 방법을 능가하는 성과를 입증했다.
핵심 요약
과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. 기존 방식은 가설을 원리로 변환하는 단계에서 방대한 영역 전문지식·시간·노력이 필요해 병목이 되고 있다. Principia는 LLM 기반 프레임워크로, 테스트 타임에 과학 원리를 구축하고 지속적으로 개선한다. 전체 요약 7문장 읽기 → 028 15:11 ▲ 50 · 댓글 2 보상 해킹을 막는 정밀도 기반 강화학습 루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. AI · 머신러닝 · Eat Your Precision: Precision Objective Mitigates Reward Hacking in Rubric-based RL
Key Point 강화학습 보상 함수 설계의 핵심 문제인 목적 왜곡(reward hacking)을 정밀도 메트릭으로 체계적으로 해결하는 방법이 의료·건강 등 신뢰도가 중요한 분야에서 큰 성능 개선을 보여주고 있다.
핵심 요약
루브릭 기반 강화학습은 검증 불가능한 작업에서 효과적이지만, 루브릭 커버리지의 가중치로만 보상을 정의해 재현율만 최대화하는 문제가 있다. 이로 인해 RL 학습 모델은 내용이 길고 불필요하거나 사실적으로 틀린 부분이 많아져 기본 모델보다 선호도가 낮아진다. 이를 해결하기 위해 FORK 보상을 제시하는데, 이는 재현율과 함께 정밀도 목적을 동시에 최적화한다. 전체 요약 7문장 읽기 → 029 12:11 새 버전 uv 0.13.6 출시, 대규모 프로젝트 메모리 사용량 대폭 감축 uv 0.13.6이 2026년 10월 26일 출시되었다. 오픈소스 · 도구 · astral-sh/uv@0.13.6
Key Point Python 패키지 관리자 uv의 주요 성능 개선판으로, 메모리 효율을 크게 높였고 여러 버그를 수정하여 대규모 프로젝트 작업 시 안정성이 향상되었다.
핵심 요약
uv 0.13.6이 2026년 10월 26일 출시되었다. CPython 3.11.18, 3.12.16, 3.13.18, 3.14.10, 3.15.2 버전을 추가 지원한다. 대규모 워크스페이스 의존성 해결 시 메모리 사용량을 여러 최적화를 통해 감축했고, 대규모 프로젝트 락·업그레이드 시에도 메모리 사용량을 줄였다. 전체 요약 9문장 읽기 → 030 12:11 새 버전 ruff 0.17.3 릴리스, 성능 최적화와 버그 수정 Python 린터·포매터 ruff의 0.17.3 버전이 2026년 10월 26일 공개되었다. 오픈소스 · 도구 · astral-sh/ruff@0.17.3
Key Point Python 프로젝트의 코드 품질 관리 도구로 쓰이는 ruff가 성능을 대폭 개선하고 기존 버그를 수정했으므로 업그레이드할 가치가 있다.
핵심 요약
Python 린터·포매터 ruff의 0.17.3 버전이 2026년 10월 26일 공개되었다. 새 기능으로는 의심스러운 코드 패턴 감지를 위한 shared-clock-mock 프리뷰 기능이 추가되었다. UP032 규칙에서 f-string으로의 부정확한 변환 버그가 수정되었다. 전체 요약 7문장 읽기 → 031 06:11 ▲ 143 · 댓글 45 $2 마이크로컨트롤러에서 SIMD로 컴퓨터 비전 가속하기 ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. 하드웨어 · 시스템 · SIMD-accelerated computer vision on a $2 microcontroller
Key Point $2 저가 마이크로컨트롤러의 숨겨진 SIMD 명령어를 활용해 컴퓨터 비전 성능을 2배 향상시킨 방법과, 하드웨어 제약을 창의적으로 극복한 어셈블리 최적화 기법을 배울 수 있다.
핵심 요약
ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. ESP32-S3는 240MHz 듀얼코어 CPU, WiFi, BLE 라디오를 탑재한 저가 칩이지만 SIMD 명령어 지원에 대한 정보가 거의 알려져 있지 않아 직접 실험과 최적화를 진행했다. SIMD 구현 과정에서 미정렬 읽기 불지원 문제를 두 개의 인접한 레지스터를 읽은 후 슬라이스 추출 명령어로 극복했다. 전체 요약 6문장 읽기 → 032 00:11 ▲ 143 · 댓글 117 웹사이트를 인쇄 가능하게 설계해야 하는 이유 저자는 인쇄된 문서로 읽을 때 더 집중이 잘 되어 웹사이트를 인쇄하기 좋게 만들려고 시도했다. 웹 · 프론트엔드 · Websites Should Be Printable
Key Point 웹 접근성과 사용자 친화성을 확장하는 간단한 방법이며, CSS만으로 구현할 수 있어 추가 비용 없이 적용 가능하다.
핵심 요약
저자는 인쇄된 문서로 읽을 때 더 집중이 잘 되어 웹사이트를 인쇄하기 좋게 만들려고 시도했다. 처음 자신의 웹사이트를 인쇄했을 때 텍스트 크기가 너무 크고 헤더가 보기 흉했으며 링크 색상이 흑백 인쇄에서 안 보였다. CSS의 @media print 쿼리를 활용해 인쇄 전용 스타일을 정의할 수 있으며, 특정 요소는 숨기고 다른 요소는 인쇄 시에만 표시하도록 제어할 수 있다. 전체 요약 7문장 읽기 → 033 21:12 ▲ 23 · 댓글 2 신경망 가중치를 이산 결정 경로로 표현하는 TWIG 제안 신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. AI · 머신러닝 · Every Weight Is a Path of Shared Discrete Decisions
Key Point 신경망 가중치 압축 방식을 통합하는 새로운 표현이 기존 양자화 방법보다 회로 비용을 크게 줄일 수 있음을 보여주기 때문이다.
핵심 요약
신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. 같은 영역에 속한 가중치들은 경로의 상위 부분을 공유하며, 각 결정은 트리 아래의 모든 가중치에 상속되어 한 번만 저장하고 적용된다. 임의의 학습된 신경망을 TWIG로 표현할 수 있으며, 2의 거듭제곱 결정을 사용할 때 가중치 계층이 거의 모두 선(wire)과 가산기로 이루어진 회로가 되어 고정 가중치 칩에 적합하다. 전체 요약 7문장 읽기 → 034 18:11 ▲ 114 · 댓글 56 N64 레이싱 게임 F-Zero X을 닌텐도 3DS로 이식 완료 F-Zero X 디컴파일 코드베이스(G-Diffuser)를 닌텐도 3DS로 이식한 프로젝트의 사후분석 문서로, 2026년 8월 11일부터 10월 19일까지 두 단계(24일 스프린트 + 43일 후속 개발)에 걸쳐 진행되었다. 하드웨어 · 시스템 · F-Zero X on Nintendo 3DS
Key Point AI 에이전트 147개를 동원해 N64 게임을 3DS로 이식한 대규모 자동화 개발 프로젝트의 전체 과정과 최적화 기법, 비용 투명성을 공개한 사례로, 현대 AI 보조 개발의 스케일과 효율성을 보여준다.
핵심 요약
F-Zero X 디컴파일 코드베이스(G-Diffuser)를 닌텐도 3DS로 이식한 프로젝트의 사후분석 문서로, 2026년 8월 11일부터 10월 19일까지 두 단계(24일 스프린트 + 43일 후속 개발)에 걸쳐 진행되었다. 첫 번째 단계(8월 11일~9월 3일)에서 New 3DS에서 3D 스테레오스코픽으로 60fps 달성했으며, 한 명의 디렉터와 147개 이상의 AI 에이전트가 참여했다. 두 번째 단계(9월 7일~10월 19일)에서 Old 3DS 지원, 네이티브 렌더러, N64 64DD 익스팬션 킷 기능을 추가했다. 전체 요약 13문장 읽기 → 035 18:11 ▲ 126 · 댓글 29 완전 로컬 처리 PDF 도구 PaperPilot 공개 Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. AI · 머신러닝 · PaperPilot – Zero-Cloud, Pure-Rust PDF Engine with WASM and MCP
Key Point AI 에이전트에 PDF 처리 기능을 안전하게 통합할 수 있는 방법이 생겼고, 클라우드 전송 없이 로컬에서만 동작해 데이터 프라이버시를 보장한다.
핵심 요약
Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. Claude Desktop, Cursor 등 MCP 클라이언트에 플러그인으로 제공되어 AI 에이전트가 PDF 병합, 분할, OCR, 압축을 수행할 수 있다. CLI, 브라우저(WASM), Tauri 기반 데스크톱 앱, localhost REST API 등 5가지 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 036 18:11 ▲ 131 · 댓글 70 Next.js 걷어내니 라이트하우스 만점 블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 웹 · 프론트엔드 · Removing Next.js Got My Blog to 100 on Every Lighthouse Category
Key Point Next.js와 같은 현대 프레임워크가 정적 블로그처럼 상호작용이 거의 없는 사이트에서 성능을 해칠 수 있다는 구체적인 증거와, 만점을 위해 어떤 선택이 필요했는지 보여준다.
핵심 요약
블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 기존 선택지들(Medium, Blogger, Ghost, WordPress, Hugo)을 검토했으나 성능과 편의성 면에서 부족했고, Bear Blog를 영감 삼아 더 많은 기능을 갖춘 블로그를 직접 구축하기로 결심했다. 정적 웹사이트에 CDN 캐싱과 이미지 최적화만으로도 충분하다고 판단해 Cloudflare를 도입했으며, 특히 Cloudflare의 Image Transformations 무료 티어(5,000개)를 활용했다. 전체 요약 9문장 읽기 → 037 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
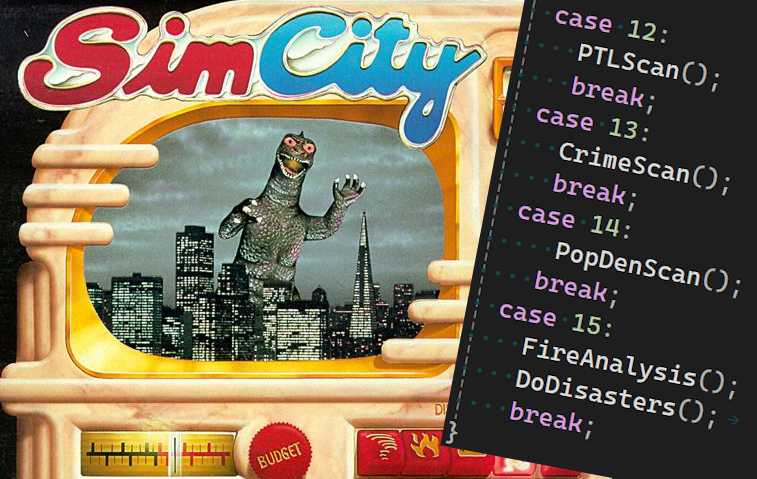
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 038 03:11 ▲ 100 · 댓글 29 16MHz 386SX CPU에서 돌린 초대 심시티의 최적화 비법 1989년 초대 심시티는 16MHz로 작동하는 인텔 386SX 프로세서에서 풀 기능의 도시 시뮬레이션을 구현했으며, 2008년 GPL 라이선스로 공개된 마이크로폴리스 소스코드를 통해 그 최적화 기법을 분석할 수 있다. 하드웨어 · 시스템 · How to run a city builder on 16 MHz
Key Point 초고성능 현대 하드웨어에서도 시뮬레이션 게임이 버거워하는 반면, 30년 전 16MHz CPU에서 풀 기능 도시 시뮬레이션을 돌렸던 기법이 오늘날 최신 게임 엔진에서도 여전히 핵심 최적화 원리로 쓰이고 있다.
핵심 요약
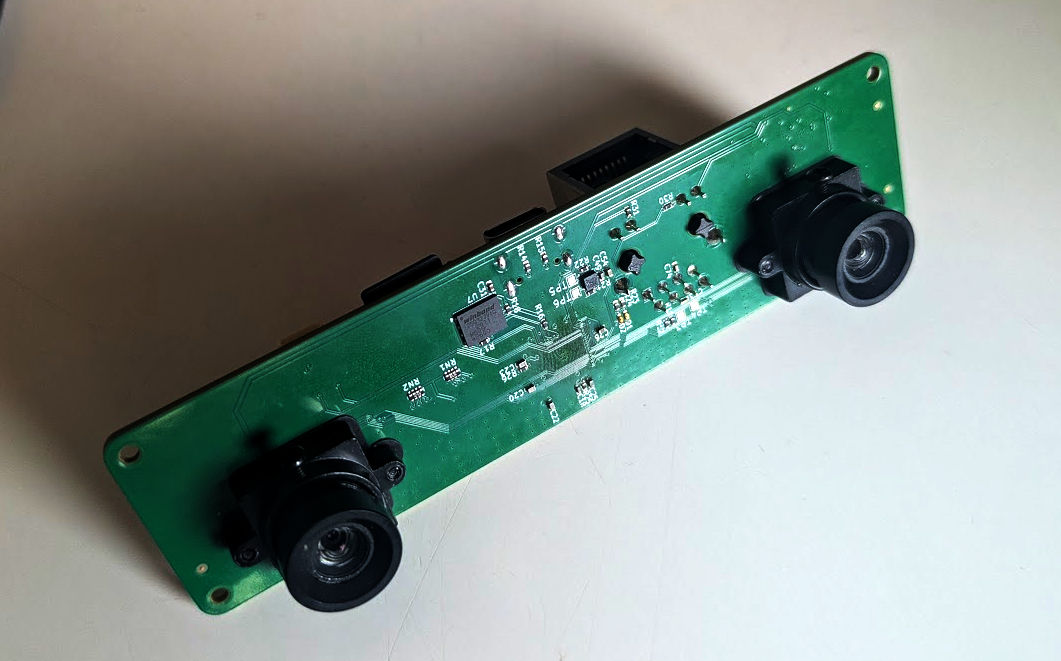
1989년 초대 심시티는 16MHz로 작동하는 인텔 386SX 프로세서에서 풀 기능의 도시 시뮬레이션을 구현했으며, 2008년 GPL 라이선스로 공개된 마이크로폴리스 소스코드를 통해 그 최적화 기법을 분석할 수 있다. 시뮬레이션의 핵심은 Simulate() 함수로, 교통, 화재, 전력, 범죄 등 각 시스템을 업데이트하는데 매 프레임마다 모든 함수를 호출하면 CPU가 감당할 수 없다. 해결책은 mod16 파라미터를 사용해 0~15 사이를 순환하며 각 프레임마다 특정 시뮬레이션 부분만 실행하는 것으로, 전체 시뮬레이션이 완성되려면 평균 8프레임, 최악의 경우 15프레임이 필요하다. 전체 요약 7문장 읽기 → 039 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 040 21:11 당일 +658 Google, 터미널용 Gemini AI 에이전트 공개 Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. AI · 머신러닝 · google-gemini/gemini-cli · TypeScript
Key Point 터미널 기반 AI 에이전트 표준이 형성되고 있는 가운데, Google이 공식 오픈소스 도구로 대응하며 MCP 서버 지원으로 확장성을 열어두고 있다.
핵심 요약
Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. 터미널에서 직접 Gemini 모델에 접근할 수 있으며, 코드 이해·생성, 대형 코드베이스 편집, PDF나 이미지에서 앱 생성 등이 가능하다. 자동화 작업, PR 쿼리, 복잡한 리베이스 처리, MCP 서버 연결로 Imagen·Veo·Lyria 같은 미디어 생성 기능 통합이 지원된다. 전체 요약 9문장 읽기 → 041 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 042 18:11 ▲ 149 · 댓글 53 세레브라스, 3조개 파라미터 모델을 59개 웨이퍼에 분산 배포 세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 인프라 · 데브옵스 · Cerebras Deploys Trillion-Parameter AI Models
Key Point 대규모 언어모델 추론 인프라의 실제 배포 방식을 보여주는 기술 사례로, GPU가 아닌 웨이퍼 기반 칩에서 조 단위 모델을 어떻게 효율적으로 운영하는지 알 수 있다.
핵심 요약
세레브라스 WSE-3T 웨이퍼 하나는 44GB의 온칩 메모리를 가지지만, 조 단위 모델의 가중치는 테라바이트 규모여서 여러 웨이퍼에 분산 배포해야 한다. 3조 파라미터 규모의 공개 모델 키미 K3를 예시로, 4비트 양자화 기준 각 레이어는 약 16GB가 필요하다. 키미 K3의 경우 69개 선형 주의 레이어(각 웨이퍼당 2개씩 배치 가능)와 24개 밀집 레이어(각 웨이퍼당 1개씩, 나머지는 KV 캐시용)로 총 59개 웨이퍼가 필요하다. 전체 요약 8문장 읽기 → 043 12:11 ▲ 14 · 댓글 8 자연어 정책을 신경기호 프로그램으로 컴파일하는 SCOPE LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. AI · 머신러닝 · SCOPE: Compiling Natural-Language Policies into Neurosymbolic Predicate Programs
Key Point 정책 집행의 정확도·안정성·비용·해석 가능성을 동시에 해결하는 신경기호 접근법이 저렴한 모델에서도 대규모 언어모델 수준의 성능을 낼 수 있음을 보여준다.
핵심 요약
LLM 에이전트의 정책 집행이 단일 턴 콘텐츠 검증에서 여러 턴의 대화와 도구 호출 궤적을 평가하는 복합 정책으로 진화했다. 미세 조정한 가드레일 모델은 빠르지만 복합 정책에서 성능이 저하되고, LLM-as-a-judge는 높은 정확도를 달성하지만 추론 비용이 높고 예측이 불안정하다. SCOPE는 정책을 신경 술어, 결정적 추출기, 이들의 출력을 조합하는 코드로 이루어진 실행 가능한 프로그램으로 컴파일한다. 전체 요약 8문장 읽기 → 044 12:11 ▲ 11 · 댓글 3 확산 모델의 토큰 선택 정책, 숨은 상태와 신뢰도로 최적화 마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. AI · 머신러닝 · What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
Key Point 마스크 확산 모델의 속도 최적화는 LLM 추론 효율성 개선의 핵심 과제인데, 이 논문이 정책 설계의 구체적인 선택지(교사 신호, 입력 특성, 정책 크기)를 실험으로 검증하고 실용적인 기준(10% NFE 감소)을 제시한다.
핵심 요약
마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. 연구진은 감독 학습 정책을 디코딩 절차의 증류로 보고, 교사 모델이 어떤 예측을 확정 가능하다고 표시하는지, 정책이 어느 상태에서 이를 모방하는지, 정책이 무엇을 관찰하는지, 함수 평가 횟수(NFE) 감소분이 정책 오버헤드를 상쇄하려면 얼마인지를 독립적으로 분석했다. 최종 출력과 일치하는 예측을 확정 가능으로 표시하는 것은 NFE가 낮을 때 지나치게 허용적이며, 숨은 상태는 단독으로는 약하지만 신뢰도로 보완할 수 있다는 것을 발견했다. 전체 요약 6문장 읽기 → 045 12:11 ▲ 224 · 댓글 185 AI가 이전 불가능했던 소프트웨어를 현실로 만든다 AI 능력의 급격한 향상으로 이전엔 비용이 너무 커서 시도하지 않던 소프트웨어 프로젝트들이 이제 실현 가능해졌다. AI · 머신러닝 · We should be more ambitious with the software we build
Key Point AI 모델의 성능 급증으로 불가능했던 소프트웨어 개발이 현실화되는 한편, 누가, 어떤 조건에서 이를 활용할 수 있는지가 핵심 관심사다.
핵심 요약
AI 능력의 급격한 향상으로 이전엔 비용이 너무 커서 시도하지 않던 소프트웨어 프로젝트들이 이제 실현 가능해졌다. PostgreSQL을 Rust로 재작성하는 pgrust 프로젝트는 철저한 테스트 과정에서 PostgreSQL 내 수치 버그, JSONPath 포맷 캐시 버그, 메모리 안전 버그 등 여러 실제 버그를 발견했으며, 성능 최적화에 초점을 맞추고 있다. 저자는 정규표현식 엔진, ripgrep 포크, Rust 컴파일 속도 개선 도구 등을 몇 시간 내에 구현했는데, 5년 전이라면 1년 이상 걸렸을 작업들이다. 전체 요약 10문장 읽기 → 046 12:11 ▲ 15 · 댓글 2 화학 추론을 검증하는 '몰린' 언어 공개 화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. AI · 머신러닝 · MolLean: A Process-Verifiable Language for Chemical Reasoning
Key Point 화학 분자 추론에서 언어 모델의 거짓 주장을 실시간으로 검증·수정할 수 있는 새로운 시스템이 제시되었으며, 12개 과제에서 모두 기존 방식을 앞서갔다.
핵심 요약
화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. 이를 해결하기 위해 MolLean이라는 과정 검증 가능한 언어를 개발했으며, 명시적 분자 상태에 기반해 화학 추론을 진행한다. Lean 기반 커널은 기본 그래프 편집부터 복합 변환까지 상태 전이와 분자 기반 명제를 계층적으로 검증한다. 전체 요약 10문장 읽기 → 047 09:11 ▲ 192 · 댓글 145 메모리 안전성과 성능을 모두 잡은 구스 언어 공개 Goose는 힙 할당자, 가비지 컬렉터, 라이프타임 애너테이션이 없는 메모리 안전 시스템 언어로, C와 Rust 문법을 따릅니다. 오픈소스 · 도구 · The Goose Programming Language
Key Point 힙 할당·가비지 컬렉션·라이프타임 문법을 모두 제거하면서도 안전성을 보장해 C++과 Rust보다 빠르고 메모리 효율적인 새로운 시스템 언어 설계가 실제로 동작하는 방식을 보여줍니다.
핵심 요약
Goose는 힙 할당자, 가비지 컬렉터, 라이프타임 애너테이션이 없는 메모리 안전 시스템 언어로, C와 Rust 문법을 따릅니다. 벤치마크 16개 기준 구스는 일반적인 C++보다 3.3배, 손으로 최적화한 C++보다 1.16배, 안전한 Rust보다 1.12배 빠르면서 메모리는 1.9배, 1.3배, 1.2배 적게 씁니다. 컴파일러가 정적으로 할당하는 데이터 스택 위에 모든 동적 값이 인라인으로 살며, 스코프 끝에서 한 번의 저장 명령으로 메모리가 해제됩니다. 전체 요약 12문장 읽기 → 048 06:11 새 버전 Rust 1.98.0 출시, 수명 단축 강제 해제와 안전성 검사 강화 Rust 1.98.0이 출시되었다. 언어 기능 면에서는 불변 위치에서도 &mut의 수명 단축을 허용하게 되어 Cell<&'long mut i32>에서 Cell<&'short mut dyn Send>로 강제 변환할 수 있다. 오픈소스 · 도구 · rust-lang/rust@1.98.0
Key Point Rust를 실무에서 쓰는 개발자라면 호환성 변화와 새로운 안전 검사 규칙, 플랫폼 지원 정책의 변화를 파악해야 기존 코드가 컴파일되지 않는 상황을 피할 수 있다.
핵심 요약
Rust 1.98.0이 출시되었다. 언어 기능 면에서는 불변 위치에서도 &mut의 수명 단축을 허용하게 되어 Cell<&'long mut i32>에서 Cell<&'short mut dyn Send>로 강제 변환할 수 있다. memcmp, memset, strlen 같은 코어 런타임 심볼을 대상으로 invalid_runtime_symbol_definitions 린트(금지 기본값)와 suspicious_runtime_symbol_definitions 린트(경고 기본값)가 추가되었으며, 향후 확대될 예정이다. c_void_returns 린트(경고 기본값)로 core::ffi::c_void를 반환 타입으로 사용하는 것을 검사한다. 전체 요약 9문장 읽기 → 049 06:11 ▲ 102 · 댓글 84 AI가 쓴 글이 어려운 이유: 정보 밀도 최적화 때문 AI 생성 텍스트가 최근 이해하기 어려워졌다는 광범위한 인식이 있어, 심리언어학적 특징을 분석한 연구가 나왔다. AI · 머신러닝 · Why is AI generated language so hard to understand?
Key Point AI 모델들이 의도하지 않게 생성하는 비자연스러운 문법 구조가 정보 밀도 최적화 때문이라는 구체적 원인을 밝혔으며, 향후 더 읽기 쉬운 AI 텍스트를 만드는 방향을 제시한다.
핵심 요약
AI 생성 텍스트가 최근 이해하기 어려워졌다는 광범위한 인식이 있어, 심리언어학적 특징을 분석한 연구가 나왔다. 연구팀은 목적어 상대절, 긴 통사 의존성, 저빈도 n-그램 등 인간의 처리 난이도와 상관관계가 있는 요소들을 조사했다. 9개 최신 모델 모두 생명이 없는 주어와 동사 활용 및 저빈도 n-그램을 더 많이 사용했으며, 대부분 더 긴 의존성, 적층된 명사, 대화에서 축약된 목적어 상대절을 더 많이 사용했다. 전체 요약 7문장 읽기 → 050 06:11 ▲ 106 · 댓글 57 Dream-1, 미세조정 없이 새 로봇 제어하는 범용 로봇 정책 공개 Dream Labs가 $90M 시드펀딩으로 설립을 발표하며 World Action Model 기반의 범용 로봇 정책 Dream-1을 공개 API로 제공한다. AI · 머신러닝 · Dream-1
Key Point 기존 로봇은 각 기종마다 별도 데이터와 미세조정이 필요했지만, Dream-1은 처음 보는 로봇을 즉시 제어할 수 있어 로봇 개발자와 스타트업의 진입장벽을 크게 낮춘다.
핵심 요약
Dream Labs가 $90M 시드펀딩으로 설립을 발표하며 World Action Model 기반의 범용 로봇 정책 Dream-1을 공개 API로 제공한다. Dream-1은 이전에 본 적 없는 로봇, 작업, 환경에서 제로샷 일반화가 가능하며, 미세조정이나 로봇별 데이터 수집 없이도 작동한다. 로봇팔 비용이 $2k까지 하락하고 하양이 $399짜리 마이크로덕 4일간 1만 대 이상 판매되면서 대중용 로봇 시장이 성장 중이다. 전체 요약 13문장 읽기 → 051 06:11 ▲ 143 · 댓글 53 엔비디아 RTX 3000 시리즈, 커널 모듈로 FP/BF16 성능 잠금 해제 GPU unlock은 리눅스 커널 모듈로 엔비디아 RTX 3090 Ti, 3090, 3080, 3070, 3060 등 GA102/GA103/GA104/GA106 칩 기반 카드의 FP/BF16 명령어 발급 속도를 전문가용 수준으로 끌어올린다. 하드웨어 · 시스템 · GPU-unlock: FP/BF16 instruction issue rate on Nvidia 3000's cards
Key Point GeForce 게이밍 카드의 하드웨어 성능을 전문가용 수준으로 해제하는 커널 모듈 방식이 등장했으며, 드라이버 업데이트 때마다 수동 패치 없이 작동하는 점과 구체적인 성능 배수를 통해 AI/ML 워크로드 비용 최적화 전략을 바꿀 수 있다.
핵심 요약
GPU unlock은 리눅스 커널 모듈로 엔비디아 RTX 3090 Ti, 3090, 3080, 3070, 3060 등 GA102/GA103/GA104/GA106 칩 기반 카드의 FP/BF16 명령어 발급 속도를 전문가용 수준으로 끌어올린다. NVIDIA 드라이버 바인딩 전에 조기 실행되는 방식으로, 새 드라이버 출시 때마다 매번 수동 패치할 필요가 없다. 속도 선택자(SS0 0x88888888, SS1 0x8)를 기록하고 FLR을 수행한 뒤 작동하며, CMP 언로커의 V67/PLM 기법과 UEFI 방식의 사전 드라이버 타이밍을 결합한다. 전체 요약 13문장 읽기 → 052 06:11 새 버전 Rust 1.95.0 출시, let 패턴 가드 안정화 if let 가드를 match 암에서 정식 기능으로 안정화하고, PowerPC/PowerPC64 인라인 어셈블리도 안정화했다. 오픈소스 · 도구 · rust-lang/rust@1.95.0
Key Point 데이터 처리와 메모리 조작을 더 효율적으로 하는 다수의 API가 안정화되고, 주요 임베디드·모바일 플랫폼의 공식 지원 범위가 크게 확대됐다.
핵심 요약
if let 가드를 match 암에서 정식 기능으로 안정화하고, PowerPC/PowerPC64 인라인 어셈블리도 안정화했다. const 블록 평가 방식을 일관되게 정리해 패턴 매칭의 의미를 크레이트·모듈과 독립적으로 만들었다. powerpc64-unknown-linux-musl을 Tier 2 지원 플랫폼으로 승격하고, Apple TV/Watch/Vision 기기의 aarch64 타겟 6개도 Tier 2로 올렸다. 전체 요약 12문장 읽기 → 053 00:11 ▲ 112 · 댓글 34 VLC 가우시안 블러 필터를 C와 C#으로 경주시켜봤다 VLC 4의 가우시안 블러 필터를 C 원본과 C# 포트의 성능 비교하기 위해 동일한 환경에서 테스트했다. 인프라 · 데브옵스 · C vs. C#: racing VLC's Gaussian blur
Key Point C# .NET AOT는 CPU 집약적 비디오 필터에서 C 대비 8~10% 수준으로 경쟁력 있으며, 컴파일러 최적화로 격차를 더 줄일 수 있다는 점이 주목할 만하다.
핵심 요약
VLC 4의 가우시안 블러 필터를 C 원본과 C# 포트의 성능 비교하기 위해 동일한 환경에서 테스트했다. 라인 바이 라인 포트에서 C# 버전은 약 23% 더 느렸는데, 원인은 가비지 컬렉터가 아니라 RyuJIT 코드 생성기가 Math.Min을 매 루프마다 재계산하기 때문이다. 루프 경계를 사전 계산하고 nint 인덱스를 사용하는 두 줄의 수정으로 C# 성능을 8% 범위 내로 개선했다. 전체 요약 12문장 읽기 → 054 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 055 18:11 ▲ 13 · 댓글 2 언어모델이 언어모델 개선을 학습하다 LLM을 이용해 AI 연구를 자동화할 수 있지만, 실제 피드백으로 효과적인 개선안을 제안하는 능력을 학습하는 데는 두 가지 문제가 있다. AI · 머신러닝 · Language Models Learn to Improve Language Models
Key Point LLM이 AI 개발 프로세스를 자동으로 개선하는 능력을 갖추게 되면서 모델 개발 비용과 속도의 판도가 바뀔 수 있기 때문입니다.
핵심 요약
LLM을 이용해 AI 연구를 자동화할 수 있지만, 실제 피드백으로 효과적인 개선안을 제안하는 능력을 학습하는 데는 두 가지 문제가 있다. 첫째, 강화학습으로 수만 개 제안을 평가하려면 수십만 GPU시간이 필요해 비용이 매우 크다. 둘째, 대리 피드백은 정책 최적화 과정에서 과대평가된 제안을 선호하면서 신뢰도가 떨어진다. 전체 요약 7문장 읽기 → 056 18:11 ▲ 107 · 댓글 10 함수형 언어 Roc, C의 DEFLATE 성능에 8.9% 차까지 접근 함수형 프로그래밍 언어 Roc으로 작성한 roc-deflate 패키지가 C로 만들어진 최적화된 DEFLATE 라이브러리 libdeflate와 성능을 비교했다. AI · 머신러닝 · How close can pure functional programming get to C?
Key Point 함수형 프로그래밍 언어가 명령형 저수준 언어와의 성능 격차를 얼마나 좁힐 수 있는지 실제로 입증했으며, 메모리 안전성 같은 보장을 위해 치르는 성능 대가가 실제로는 미미할 수 있음을 보여준다.
핵심 요약
함수형 프로그래밍 언어 Roc으로 작성한 roc-deflate 패키지가 C로 만들어진 최적화된 DEFLATE 라이브러리 libdeflate와 성능을 비교했다. Silesia 코퍼스로 144개 벤치마크를 실행한 결과, Ryzen 3900X 기준 중앙값 8.9%, M1 MacBook Pro 기준 2.6% 느렸다. 최악의 경우 18% 느렸지만 특정 입력에서는 18% 빠르기도 했으며, 이는 두 구현의 차이일 뿐 Roc의 성능 한계가 C보다 낮다는 의미다. 전체 요약 10문장 읽기 → 057 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 058 12:10 ▲ 10 · 댓글 1 확산 언어 모델로 리서치 속도 6배 가속화 심화된 리서치 시스템은 계획, 증거 수집, 종합, 수정을 반복하는데 종단간 지연이 상용 활용에 큰 병목이다. AI · 머신러닝 · DiffResearch: Accelerating Deep Research with Diffusion Language Models
Key Point 자동 회귀 모델 기반의 현재 리서치 시스템이 느린 이유를 근본적으로 해결하는 대안 기술을 제시하며, 실제로 6배 속도 개선과 품질 유지를 동시에 달성했기 때문이다.
핵심 요약
심화된 리서치 시스템은 계획, 증거 수집, 종합, 수정을 반복하는데 종단간 지연이 상용 활용에 큰 병목이다. 기존 대부분의 프로덕션 시스템은 자동 회귀(AR) 언어 모델에 기반하며 좌에서 우로의 디코딩 방식을 사용한다. DiffResearch는 확산 언어 모델(dLLM)을 모든 단계의 핵심에 놓는 오픈 멀티 에이전트 리서치 프레임워크다. 전체 요약 9문장 읽기 → 059 03:11 새 버전 올라마, 엔비디아 네모트론 3.5 볼트 지원 올라마 v0.40.10에서 엔비디아의 네모트론 3.5 볼트 E4B 멀티모달 언어 모델을 지원한다. AI · 머신러닝 · ollama/ollama@v0.40.10
Key Point 로컬에서 실행 가능한 경량 멀티모달 모델의 추가로 더 낮은 리소스에서 온디바이스 AI를 사용하려는 개발자의 선택지가 늘었다.
핵심 요약
올라마 v0.40.10에서 엔비디아의 네모트론 3.5 볼트 E4B 멀티모달 언어 모델을 지원한다. 네모트론 3.5 볼트는 젬마 4 기반의 경량 비전-언어 모델로 로컬 대화, 이미지 이해, 도구 사용에 최적화되어 있다. 128K 토큰의 긴 컨텍스트 윈도우를 지원하며 추측 디코딩을 위한 드래프트 모델을 포함하고 있다. 전체 요약 4문장 읽기 → 060 03:11 ▲ 166 · 댓글 47 OpenSSL 4.1.0 출시, DTLS 1.3 지원 추가 OpenSSL 4.1.0은 DTLS 1.3(RFC 9147) 지원, RFC 8701 GREASE, IKEV2 KDF, DTLS SSL listener API 지원 등 주요 기능을 추가한 정식 릴리스다. 보안 · OpenSSL 4.1.0
Key Point OpenSSL의 주요 보안 라이브러리 업데이트로 DTLS 1.3 지원과 암호화 알고리즘 최적화를 통해 서버 보안과 성능 모두에 영향을 미치며, 특히 DTLS 관련 알려진 이슈들을 파악해야 즉시 적용 여부를 판단할 수 있다.
핵심 요약
OpenSSL 4.1.0은 DTLS 1.3(RFC 9147) 지원, RFC 8701 GREASE, IKEV2 KDF, DTLS SSL listener API 지원 등 주요 기능을 추가한 정식 릴리스다. ML-DSA와 ML-KEM의 NTT 연산을 ppc64le에서 최적화했고, x86_64에서 ML-DSA 최적화, AVX-512 기반 SHAKE x4 연산, AES-CBC 복호화 VAES 최적화를 적용했다. tsget 유틸리티는 더 이상 관리되지 않는 WWW::Curl::Easy에서 Net::Curl::Easy로 변경되었으며, 업그레이드 전 Net::Curl::Easy 설치가 필요하다. 전체 요약 10문장 읽기 → 061 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 062 21:11 당일 +110 AI를 위한 PDF 파서, 접근성 자동화까지 지원 OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 오픈소스 · 도구 · opendataloader-project/opendataloader-pdf · Java
Key Point LLM 기반 애플리케이션의 문서 처리 성능을 크게 좌우하는 PDF 파싱 도구이면서 동시에 전 세계 규제 대상이 되고 있는 PDF 접근성 자동화를 오픈소스로 제공하는 점이 의미 있다.
핵심 요약
OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 200개 실제 PDF로 벤치마크한 결과 전체 정확도 0.907(표 추출 0.928)로 기존 도구 중 1위이며, 하이브리드 모드에서 복잡한 테이블·수식·차트를 AI로 처리한다. 로컬 모드는 결정적(deterministic) 출력으로 0.015초/페이지 속도, 하이브리드 모드는 0.463초/페이지로 처리하며 Python·Node.js·Java SDK를 제공한다. 전체 요약 8문장 읽기 → 063 18:11 ▲ 16 · 댓글 2 대화 모델, 사용자의 방언에 맞춰 응답하도록 학습 사람들은 상대방에 따라 말투를 달리 하지만, 현재의 채팅 모델은 사용자가 비표준 영어나 방언을 써도 표준 영어로만 응답한다. AI · 머신러닝 · Answering in the User's Variety: Calibrated Accommodation Pairs for Post-Training
Key Point AI 모델의 공정성 이슈로, 특정 인종·지역 방언을 상대로 한 은연중 차별이 학습 단계에서 어떻게 발생하는지, 그리고 이를 기술적으로 개선할 수 있는지를 보여준다.
핵심 요약
사람들은 상대방에 따라 말투를 달리 하지만, 현재의 채팅 모델은 사용자가 비표준 영어나 방언을 써도 표준 영어로만 응답한다. 연구팀은 지도 학습(SFT)에서 선호도 최적화(DPO)와 강화학습까지 각 학습 단계에서 모델의 사용자 모방 경향이 어떻게 바뀌는지 추적했다. 10개 오픈 모델에서 학습 후 단계들은 모든 비공식적 표현을 표준화했으나, 응답 확률을 보정한 후에도 DPO는 아프리카계 미국인 영어(AAE)와 싱글리시보다 영국·호주 영어 철자 일치를 선호했다. 전체 요약 7문장 읽기 → 064 18:11 ▲ 23 · 댓글 2 3D 씬 복원 속도·메모리 획기적으로 개선한 RLSplat Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. AI · 머신러닝 · RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
Key Point 모바일이나 엣지 디바이스 같은 자원 제약 환경에서 3D 씬 복원의 실용성을 획기적으로 높이는 기술로, 기존 방식의 비효율성(고정적 오버헤드)을 근본적으로 해결했다.
핵심 요약
Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. 기존 예산 제어 FF3DGS 방식들은 추론 단계의 비용을 고려하지 않았는데, 목표한 개수의 가우시안 표현을 만들기 위해 먼저 밀집한 가우시안을 예측한 후 제거하거나 선택하기 때문에 예산과 무관하게 거의 일정한 지연 시간과 피크 메모리를 소비한다. 새로운 RLSplat 방식은 자원 선형 예산 제어 FF3DGS 프레임워크로, 가우시안 예산이 감소함에 따라 표현 크기, 추론 지연 시간, 피크 메모리가 모두 선형적으로 감소한다. 전체 요약 7문장 읽기 → 065 15:11 ▲ 173 · 댓글 2 영화 같은 영상 생성, MLLM 정보를 제대로 활용하는 학습법 제안 영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. AI · 머신러닝 · Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation
Key Point 비디오 확산 모델이 MLLM의 정보를 무시하는 근본 문제를 해결함으로써 멀티모달 정보 기반의 영상 생성 품질을 크게 향상시키는 방법론을 제시합니다.
핵심 요약
영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. 멀티모달 대형언어모델(MLLM)이 유용한 선행 정보를 제공하지만, 비디오 확산 트랜스포머(DiT)가 직접 조건화 경로로 이를 우회하거나 충분히 활용하지 못한다. 연구팀은 요소 인식 예측 학습(FAPL)을 제안해 MLLM 잠재값을 유효하게 활용하는 것을 전제로 설정했다. 전체 요약 8문장 읽기 → 066 12:11 ▲ 10 · 댓글 2 언어 모델, 여러 작업 동시 처리 시 오류 급증 최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. AI · 머신러닝 · On the Fragility of Tasks under Composition: Implicit Budgeting in Language Models
Key Point 언어 모델이 실제로 복합 작업을 처리하는 방식의 근본적 제약을 밝혀 모델 설계와 프롬프트 최적화 방향을 제시한다.
핵심 요약
최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. 이 성능 저하는 단순한 오류의 축적으로 설명할 수 없으며, 오픈 가중치 모델과 Claude Opus 5에서 공통으로 나타난다. 원인은 '암묵적 사고 예산(implicit thinking budget)'으로, 여러 작업 구성 상황에서 모델이 각 작업당 사용하는 토큰 수가 개별 처리 시보다 훨씬 적어진다. 전체 요약 7문장 읽기 → 067 12:11 ▲ 51 · 댓글 2 확산 모델의 특성을 선별하는 정책 기반 마스킹 기법 기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. AI · 머신러닝 · Policy-Mask: Budget-Aware Adaptation of Diffusion Features to Discriminative Tasks
Key Point 차별적 작업에 확산 모델의 특성을 재활용할 때 수동으로 설정하던 추출 규칙을 자동으로 최적화해 다양한 시각 이해 작업에서 성능 향상을 실현한다.
핵심 요약
기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. 확산 과정의 타임스텝, 네트워크 깊이, 채널 세 가지를 모두 함께 최적화하되, 채널 수 제한(예산)을 고려한다. 채널 점수가 선택된 채널 수에 따라 증가하는 문제를 정규화로 해결하여 세 개의 정책이 균형있게 학습되도록 한다. 전체 요약 6문장 읽기 → 068 06:11 새 버전 Ruff 0.17.2 출시, 정규식 컴파일 검사 외 버그 수정 Python 린트·포매터 도구인 Ruff 0.17.2가 2026년 10월 22일 공개되었다. 오픈소스 · 도구 · astral-sh/ruff@0.17.2
Key Point 새로운 린트 규칙과 성능 개선, 설정 옵션 확대로 개발 흐름을 더 효율적으로 만드는 업데이트다.
핵심 요약
Python 린트·포매터 도구인 Ruff 0.17.2가 2026년 10월 22일 공개되었다. 새 프리뷰 기능으로 불필요한 정규식 컴파일을 감지하는 규칙이 추가되었다. 타입 변수의 별표 제약, 백슬래시 이스케이프된 *args와 **kwargs, 별표 요소 처리 등의 버그를 수정했다. 전체 요약 7문장 읽기 → 069 03:11 ▲ 207 · 댓글 113 지난 12개월 보안 사건 236건 실시간 추적 pwn.watch는 최근 12개월간 발생한 236건의 보안 사건을 심각도별로 추적하는 대시보드로, 현재 37건이 활성화 상태며 그 중 16건이 중대(Critical) 수준이다. 보안 · What's Getting Pwned
Key Point 지난 수주일간 GitLab 정규식 컴파일러(CVSS 10.0), Plex Media Server 체인, 대형 은행 AI 에이전트 침입 등 인증 없는 원격 코드 실행 및 공급망 공격이 집중되고 있으며, 개발자 도구와 금융 플랫폼이 동시에 타격을 받고 있는 상황을 파악할 수 있다.
핵심 요약
pwn.watch는 최근 12개월간 발생한 236건의 보안 사건을 심각도별로 추적하는 대시보드로, 현재 37건이 활성화 상태며 그 중 16건이 중대(Critical) 수준이다. 지난 11일간(1월 2-12일) 신규 사건이 없는 상태가 가장 오래 지속되었으며, 현재 심각도 가중치로는 중대 4점·높음 3점·중간 2점·낮음 1점·업데이트 0.5점으로 계산된다. Arista VeloCloud Orchestrator의 CVSS 9.9 SQL 인젝션 취약점(CVE-2026-114625)이 적극적으로 악용되고 있으며, 인증된 사용자가 관리자 권한을 탈취할 수 있다. 전체 요약 16문장 읽기 → 070 00:11 ▲ 21 · 댓글 1 에이전트 강화학습, 다양한 도구 구성으로 일반화 능력 향상 에이전트 시스템의 핵심인 하네스(harness)는 모델의 도구 사용, 컨텍스트 관리, 장기 작업 조정을 담당하는데, 이를 효과적으로 활용하려면 강화학습이 필수다. AI · 머신러닝 · Harness Scaling for Generalizable Agentic Reinforcement Learning
Key Point 에이전트 RL의 성능이 도구 구성 설정의 다양성에 따라 크게 달라지는 만큼, 이 새로운 스케일링 차원이 실제 시스템 배포 시 안정성과 적응성을 높일 수 있다.
핵심 요약
에이전트 시스템의 핵심인 하네스(harness)는 모델의 도구 사용, 컨텍스트 관리, 장기 작업 조정을 담당하는데, 이를 효과적으로 활용하려면 강화학습이 필수다. 기존 접근법은 단일 하네스로만 학습해 특정 구성에 최적화되고 다른 설정으로의 전이 능력이 제한됐다. 연구팀은 '하네스 스케일링(Harness Scaling)'을 제안해 다양한 실행 구성으로 학습 범위를 확대한다. 전체 요약 6문장 읽기 → 071 00:11 ▲ 130 · 댓글 22 지도 폴리곤 삼각분할 6배 가속, earstrip 공개 지도 엔진의 폴리곤 삼각분할 라이브러리 earstrip을 ISC 라이선스로 공개했으며, C++ 헤더 파일과 WebAssembly npm 빌드를 제공한다. 웹 · 프론트엔드 · Faster than earcut: triangulating 3.7M map polygons in 489 ms
Key Point 지도 렌더링 성능의 병목인 폴리곤 삼각분할을 6배 가속하고 오픈소스로 공개해 웹 지도 서비스의 성능 개선에 직접 활용 가능하다.
핵심 요약
지도 엔진의 폴리곤 삼각분할 라이브러리 earstrip을 ISC 라이선스로 공개했으며, C++ 헤더 파일과 WebAssembly npm 빌드를 제공한다. C++에서는 earcut.hpp보다 14% 빠르고, 브라우저 환경에서는 earcut.js보다 1.4~2.1배 빠르다. GPU는 삼각형만 그리므로 건물·공원 등 다각형 지도 요소들을 먼저 삼각형으로 잘라야 한다. 전체 요약 11문장 읽기 → 072 21:11 당일 +104 구글, PyTorch를 TPU에서 실행하는 백엔드 공개 Google이 PyTorch 모델을 Google의 TPU(Tensor Processing Unit) 장치에서 실행할 수 있게 하는 torch_tpu 백엔드를 오픈소스로 공개했다. AI · 머신러닝 · google-pytorch/torch_tpu · C++
Key Point PyTorch 기반 프로젝트를 Google TPU에서 GPU 대신 더 저렴하게 실행할 수 있는 경로가 생겼고, ML 엔지니어와 연구자들이 다양한 가속 옵션을 선택할 수 있게 됐다.
핵심 요약
Google이 PyTorch 모델을 Google의 TPU(Tensor Processing Unit) 장치에서 실행할 수 있게 하는 torch_tpu 백엔드를 오픈소스로 공개했다. PyTorch 연산을 위한 ATen 커널 구현, XLA 계산 최적화를 위한 컴파일 캐시, 데이터 병렬화와 텐서 병렬화를 지원하는 분산 학습 기능을 포함한다. Llama, Qwen, ResNet, DLRM, minGPT, UNet 등 다양한 모델의 예제와 torch.compile()을 통한 그래프 모드 실행 통합, 디버깅 및 벤치마킹 유틸리티를 제공한다. 전체 요약 7문장 읽기 → 073 21:11 ▲ 28 · 댓글 2 반복되는 작업을 스스로 학습하게 하는 에이전트 훈련법 Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. AI · 머신러닝 · DeLoop: Repeated Actions as Self-Supervision for Long-Horizon Agents
Key Point 장시간 작업을 하는 AI 에이전트의 비효율을 근본적으로 줄일 수 있는 훈련 기법으로, 추가 라벨링 없이 에이전트 자신의 경험으로부터 학습하는 방식을 제시한다.
핵심 요약
Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. DeLoop는 이런 루프를 줄이기 위한 자기지도 학습 방법으로, 에이전트 자신의 실행 기록에서 감독 신호를 얻는다. 같은 작업 실행 내에서 반복된 액션을 부정 사례, 그 이후 처음 나오는 다른 액션을 긍정 사례로 삼아 직접 선호도 최적화로 학습한다. 전체 요약 6문장 읽기 → 074 21:11 ▲ 22 · 댓글 7 4비트 재귀 상태 양자화로 LLM 배치 처리 메모리 절감 선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. AI · 머신러닝 · PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
Key Point LLM 추론 시 배치 크기를 제약하는 상태 메모리를 4비트로 양자화할 수 있다면, 같은 GPU 메모리로 더 많은 요청을 동시 처리할 수 있기 때문이다.
핵심 요약
선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. 상태를 낮은 정밀도로 저장하면 더 많은 시퀀스가 가속기를 공유할 수 있지만, 기존 양자화 방식은 매 토큰 생성 후 반올림하므로 4비트에서 정확도 손실이 크다. PACE는 사후 4비트 상태 양자화 기법으로, 매 토큰마다가 아니라 여러 토큰 생성 후에만 한 번 상태를 반올림하고, 그 사이 생성된 토큰을 작은 버퍼에 보관한다. 전체 요약 8문장 읽기 → 075 21:11 ▲ 50 · 댓글 1 RAG 파이프라인 최적화는 부품 조합 방식이 핵심 RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. AI · 머신러닝 · Retrieval Augmented Generation Compositionality
Key Point RAG 시스템을 구축할 때 각 기법을 따로 최적화하는 현재 관행이 실제 성능 향상으로 이어지지 않으며, 전체 구성 방식과 코퍼스 규모를 함께 고려해야 한다는 점을 실증한 연구다.
핵심 요약
RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. 개방형 프레임워크 LASAGNA를 활용해 8개 벤치마크와 5K~200K 문서 규모 코퍼스에서 450개 구성을 테스트했다. 개별적으로 강한 검색 기법 3개는 +47% 성능 향상을 예측했으나, 함께 사용하면 +17%만 달성해 조합 시 성능 이득이 감소했다. 전체 요약 6문장 읽기 → 076 18:11 ▲ 25 · 댓글 2 AI 에이전트, 과학 모델 개선에서 얼마나 성과낼까 연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. AI · 머신러닝 · Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?
Key Point 실제 과학 문제 해결에서 AI 에이전트의 현재 수준을 정량적으로 파악할 수 있으며, 단순 하이퍼파라미터 조정을 넘어 진정한 과학적 창의성이 부족한 부분이 명확해진다.
핵심 요약
연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. 11개 분야의 20개 벤치마크를 대상으로 평가했을 때, Claude Opus는 평균 10.4%의 상대적 성능 개선을 달성했으며 모든 실행에서 학문적 부정행위 없이 진행되었다. 하지만 이 개선 사항은 거의 전부가 데이터 전처리, 하이퍼파라미터 조정, 앙상블 같은 표준 ML 엔지니어링 기법에서 비롯되었으며 실제 과학적 통찰력은 부족했다. 전체 요약 6문장 읽기 → 077 18:11 ▲ 17 · 댓글 2 학생 모델이 생성한 질문을 자동으로 최적화해 증류 학습 개선 온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. AI · 머신러닝 · Ask to Distill: Learning to Synthesize Data for On-Policy Distillation
Key Point 학생 모델이 생성한 합성 데이터만으로도 실제 데이터와 같은 수준의 증류 학습 효과를 얻을 수 있으며, 정답이나 보상 없이도 질문 품질을 자동 최적화하는 방법을 제시해 데이터 수집 비용을 크게 줄일 수 있다.
핵심 요약
온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. 새로 생성한 질문이 증류 학습에 가치 있는지 평가하되, 정답에 접근하지 않고도 더 나은 질문을 자동 생성하는 'Ask-to-Distill' 프레임워크를 제시. 학생 모델 기반의 합성 엔진을 학생과 교사의 불일치도, 교사 확률 질량, 길이·다양성 제어를 결합한 분포적 대리 지표로 최적화. 전체 요약 7문장 읽기 → 078 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 079 15:11 ▲ 155 · 댓글 2 한 손 조작 넘어 양손 협력까지, 범용 로봇 제어 모델 DONIC 기존 손가락 섬세한 조작 모델들은 단일 손 조작과 제한된 상호작용만 다뤄 일상의 양손 협력 작업을 못 다뤘다. AI · 머신러닝 · DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
Key Point 로봇이 두 손을 동시에 협력시켜 복잡한 조작 작업을 할 수 있도록 하는 첫 범용 모델로, 인간의 시연 영상만으로 학습할 수 있다는 점이 실용적 의미를 갖는다.
핵심 요약
기존 손가락 섬세한 조작 모델들은 단일 손 조작과 제한된 상호작용만 다뤄 일상의 양손 협력 작업을 못 다뤘다. 연구팀은 첫 범용 양손 추적기 DONIC과 229개 물체를 포함한 1,575개 시퀀스의 양손 상호작용 데이터셋 BiHOI를 공개했다. DONIC은 근처정책최적화(PPO)와 행동복제를 결합하고, 성공한 실행을 재훈련 데이터로 재활용하는 피드백 루프를 사용한다. 전체 요약 6문장 읽기 → 080 15:11 ▲ 23 · 댓글 3 영상 생성 AI의 주의 계산 최적화, 훈련 없이 처리 시간 단축 비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. AI · 머신러닝 · Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
Key Point 비디오 생성 모델의 추론 속도를 실질적으로 단축할 수 있는 실용적 최적화 방법을 제시하며, 훈련 없이 적용 가능해 즉시 도입할 수 있다.
핵심 요약
비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. 연구팀은 다른 레이어와 디노이징 단계에서 어텐션 스파시티를 줄일 때 최종 영상 품질에 영향을 주는 정도가 크게 다르다는 것을 발견했다. 중요한 발견은 품질에 가장 민감한 레이어-단계 조합이 입력 데이터에 관계없이 거의 변하지 않는다는 점이다. 전체 요약 8문장 읽기 → 081 12:11 새 버전 uv 0.13.5, 보안 패치와 CPython 3.15.1 지원 uv 0.13.5에서 CPython 3.15.1, 3.14.9, 3.13.17의 보안 패치 버전을 포함한 python-build-standalone 20261021로 업데이트했다. 인프라 · 데브옵스 · astral-sh/uv@0.13.5
Key Point Python 3.9·3.10 사용자와 pip의 신뢰할 수 없는 인증서 번들을 마주했던 개발자들이 즉시 설치 및 검증해야 하는 보안 업데이트다.
핵심 요약
uv 0.13.5에서 CPython 3.15.1, 3.14.9, 3.13.17의 보안 패치 버전을 포함한 python-build-standalone 20261021로 업데이트했다. pip 26.2.2와 certifi 2026.10.19를 사전 설치하며, 두 버전 모두 손상된 eMudhra/emSign 루트 인증서를 제거했다. 기존 가상 환경은 자동으로 업그레이드되지 않으므로 uv python upgrade를 실행하고 pip를 별도로 업그레이드해야 한다. 전체 요약 7문장 읽기 → 082 12:11 ▲ 135 · 댓글 1 LLM 에이전트 캐시 관리, 비용 28% 절감 LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. AI · 머신러닝 · Cache Engineering for Agents
Key Point LLM 에이전트의 장시간 작업에서 캐시 관리 오버헤드가 최대 비용이 되는 상황에서, 궤적 수정 없이 캐시를 제어하고 비용을 27.7% 줄이는 새로운 방식의 등장으로 에이전트 성능 최적화의 패러다임이 바뀌고 있다.
핵심 요약
LLM 에이전트가 장시간 작업을 수행할 때 key-value(KV) 캐시의 I/O와 저장이 가장 큰 비용이 되고, 궤적(trajectory)이 컨텍스트 길이를 초과하면서 캐시 크기 조절이 필수가 되었다. 기존 방식인 히스토리 정리·요약은 궤적을 변경해서 이미 캐시된 상태를 무효화하고 비용이 많이 드는 재-프리필(re-prefilling)을 촉발한다. 연구팀은 cache engineering이라는 새로운 방식을 제안했는데, 궤적을 수정하지 않으면서 에이전트가 활성 KV 캐시를 직접 제어할 수 있게 한다. 전체 요약 10문장 읽기 → 083 12:11 ▲ 17 · 댓글 8 AI 에이전트 학습, 사용자·환경과 함께 진화시키다 LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. AI · 머신러닝 · EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents
Key Point 훈련 시스템 전체를 적응형으로 진화시키는 방식이 다중 턴 강화학습 성능을 대폭 향상시키는 것으로 나타났으며, 이는 에이전트 개발의 기존 접근 방식을 바꿀 수 있는 경험적 증거를 제시한다.
핵심 요약
LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. 기존 접근법은 보상 재설계나 감독 강화로 이를 해결했지만, 사용자 시뮬레이터와 환경을 고정된 것으로 취급했다. EAU는 메타 에이전트 프레임워크로, 훈련 중 궤적·도구 추적·보상·통계를 모니터링하며 실패와 무정보 상호작용을 진단한다. 전체 요약 7문장 읽기 → 084 06:11 ▲ 13 · 댓글 2 개방형 RL 학습 과정을 자동으로 조정하는 HarnessRL 제안 자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. AI · 머신러닝 · HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL
Key Point 개방형 과제를 통해 AI 모델을 훈련할 때 보상 신호의 붕괴와 오류를 자동으로 탐지하고 수정하는 메커니즘이 필요한 상황에서, 훈련 과정 자체를 동적으로 조정하는 접근이 효율성을 크게 개선할 수 있음을 보여준다.
핵심 요약
자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. 점수가 균일하게 낮거나 높게 붕괴되는 비차별적 보상과 높은 점수가 실제 답변 품질과 맞지 않는 허위 보상이라는 두 가지 실패 양식이 존재한다. 이는 정책이 진화하면서도 작업 샘플링, 탐색, 평가 설정이 고정되어 있기 때문이다. 전체 요약 8문장 읽기 → 085 06:11 ▲ 12 · 댓글 2 확률 오차 줄이는 AI 에이전트 프레임워크 RiseHarness 장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. AI · 머신러닝 · Harness Self-Evolution for Long-Horizon Terminal Agents
Key Point 모델 가중치를 고정하고 실행 로직만 개선해 AI 에이전트의 신뢰성을 높이는 새로운 접근법으로, 확률적 오류로 인한 작업 실패 문제를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. RiseHarness는 모델 가중치를 고정한 채로 에이전트 하네스(harness)를 반복 개선하는 프레임워크로, 같은 설정에서 성공과 실패를 오가는 작업에 초점을 맞춘다. 런타임 모니터에서 수집한 내부 하네스 추적과 에이전트 궤적을 결합해 모델 액션이 명령 실행, 피드백, 컨텍스트 관리, 완료 결정과 어떻게 상호작용하는지 검토한다. 전체 요약 9문장 읽기 → 086 03:11 ▲ 12 · 댓글 2 효율적인 흐름 모델로 LLM 병렬 생성 실현 연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. AI · 머신러닝 · Large Flow Language Models
Key Point 병렬 생성과 더 빠른 추론이 가능한 흐름 모델이 대규모 언어 모델에서 실질적으로 작동하는 것을 처음 입증했으며, 기존 자동회귀 모델보다 2.5배 빠른 처리 속도로 같은 품질을 낸다는 점이 생성 AI 구조의 근본적 전환을 시사한다.
핵심 요약
연속 흐름 언어 모델(continuous flow language model)은 이산 확산 모델에 없는 병렬 생성, 제어, 가속 기능을 제공한다. 라파(Lafa)는 80억 개 매개변수 규모의 흐름 언어 모델로, 30B 토큰 미만으로 학습되어 이전 확산 모델보다 효율적이다. 블록 단위 흐름 모델 설계로 접두사에는 인과 관계 어텐션, 각 블록 내에는 양방향 비동기 흐름을 적용한다. 전체 요약 10문장 읽기 → 087 00:11 ▲ 13 · 댓글 2 에지 기기용 LLM 커널 생성 벤치마크 공개 LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. AI · 머신러닝 · EdgeKernelBench: Unified LLM-Driven Kernel Generation for Edge Backends
Key Point 에지 디바이스 배포는 서버와 달리 하드웨어가 다양하고 제약이 크기 때문에, LLM으로 생성한 커널을 실제로 잘 동작하게 하려면 새로운 평가 방식과 최적화 전략이 필요하다는 점이 중요하다.
핵심 요약
LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. EdgeKernelBench는 통합 IR 배포 프레임워크와 에지 워크로드용 계층적 벤치마크를 결합하여, 재사용 가능한 계산·스케줄링·메모리 결정을 통합 IR로 캡처하고 컴파일러 인터페이스를 통해 각 백엔드에 연결한다. 벤치마크는 개별 연산자부터 컴팩트 모델 그래프까지 점진적으로 확대된 프로그램 범위를 포함하며, 대표적인 에지 애플리케이션 도메인을 아우른다. 전체 요약 6문장 읽기 → 088 00:11 ▲ 14 · 댓글 1 에이전트 제어 모델, 비용만 올리고 성능은 못 올려 AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. AI · 머신러닝 · Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success
Key Point 작은 모델을 에이전트 제어에 쓰면 비용이 줄 것이라는 가정이 현실 데이터에서 부정되었으며, 오프라인 성능이 좋아도 실제 배포에서는 역효과를 낼 수 있음을 보여준다.
핵심 요약
AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. Terminal-Bench 2.1의 21개 과제(315시험)에서 Jev는 성공률을 73.0%에서 73.0%로 유지하면서 시도당 비용을 19% 올렸다(기하평균 비율 1.19, 95% 신뢰구간 1.02-1.36). Jev는 Claude Haiku 5.5 소형 언어 모델보다 21% 싸웠지만 위약 대조(개발 단계 선택 빈도로 샘플링)보다는 22% 더 비쌌다. 전체 요약 6문장 읽기 → 089 00:11 ▲ 27 · 댓글 1 이미지·영상 생성 속도를 6배 높이는 스펙트럼 필터링 기법 확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. AI · 머신러닝 · SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration
Key Point 확산 모델 기반 생성 AI의 추론 속도가 실무적 병목이 되는 상황에서, 화질 손실을 최소화하면서 최대 6배 가속이 가능한 기법이 제시됨으로써 생성 모델의 배포 효율을 크게 개선할 수 있다.
핵심 요약
확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. 기존 캐싱은 특성을 재사용하고, 예측 방식은 건너뛴 단계의 특성을 외삽(extrapolation)하지만, 공간-주파수 성분이 잡음 제거 과정의 다양한 단계에서 서로 다르게 변한다는 점을 간과한다. 또한 잡음 제거는 비균등하게 진행되므로 같은 간격의 스텝도 실제로는 크기 다른 변화에 해당하는데, 이 불일치가 건너뛴 단계가 많아질수록 예측 오류를 증폭시킨다. 전체 요약 7문장 읽기 → 090 00:11 ▲ 138 · 댓글 75 C#이 WebAssembly에서 Rust 꺾고 최소 용량 달성 NetWasm은 C# 코드를 WebAssembly로 직접 컴파일하는 독립형 컴파일러, 런타임, SDK로, 데스크톱 CLR이나 Mono를 포함하지 않는다. 웹 · 프론트엔드 · C# now beats Rust on WASM size
Key Point WebAssembly 배포 시 C#이 Rust보다 더 작은 바이너리를 생성할 수 있으며, 기존 Blazor의 256배 크기 문제를 획기적으로 개선한다.
핵심 요약
NetWasm은 C# 코드를 WebAssembly로 직접 컴파일하는 독립형 컴파일러, 런타임, SDK로, 데스크톱 CLR이나 Mono를 포함하지 않는다. 같은 작업(42 출력)을 기준으로 NetWasm은 47,895바이트, Rust 1.95.0 크기 최적화 프로필은 53,635바이트로, NetWasm이 10.7% 더 작고 Brotli-11 압축 후 19.5% 더 작다. 두 결과 모두 WASI Preview 2 Component 형태의 독립형 바이너리이며 각 도구의 표준 빌드 방식을 사용하며, NetWasm 수치는 정확한 가비지 컬렉터를 포함한다. 전체 요약 13문장 읽기 → 091 21:11 당일 +215 DeepSeek Harness를 휴대폰에서 제어하는 DSH Pocket 전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 오픈소스 · 도구 · shaobeichen/dsh-pocket · JavaScript
Key Point DeepSeek Harness 사용자가 외출 중에도 전자 기기의 agent 작업을 실시간으로 모니터링하고 제어할 수 있는 표준 솔루션이 등장했으므로, 개발자 생산성 도구 사용자라면 즉시 설치 가치가 있다.
핵심 요약
전자 기기에 설치된 DeepSeek Harness를 휴대폰에서 실시간으로 접근·조작할 수 있는 npm 플러그인으로, 동일한 WiFi 네트워크의 휴대폰에서 QR 코드를 스캔하거나 공인망을 통해 4G 등 외부 네트워크에서도 접속 가능하다. 로컬 네트워크 모드는 설정 페이지에서 바로 사용 가능하며, 장치 IP를 자동 감지하고 WSL 환경에서 Windows 물리 네트워크 카드 IP를 자동으로 선택한다. 공인망 접근은 cloudflared 터널을 통해 작동하며, Cloudflare Tunnel Token과 도메인명을 설정해 고정된 공인 주소를 사용할 수 있는 '명명된 터널' 옵션을 제공한다. 전체 요약 12문장 읽기 → 092 18:11 새 버전 Vite 8.3.5 릴리스, 번들 맵핑과 HMR 안정성 개선 Vite 8.3.5가 릴리스되어 빌드 및 개발 서버 안정성을 크게 개선했습니다. 웹 · 프론트엔드 · vitejs/vite@v8.3.5
Key Point 청크 맵핑, HMR 전파, 소켓 처리 등 프로덕션 빌드와 개발 서버의 핵심 안정성이 16개 버그 수정으로 크게 향상되었습니다.
핵심 요약
Vite 8.3.5가 릴리스되어 빌드 및 개발 서버 안정성을 크게 개선했습니다. 청크 임포트 맵 누락 처리, 프리로드 의존성 해싱, 서버 origin 적용 등 빌드 단계의 9개 버그를 수정했습니다. HMR 전파 중단, 소켓 에러 처리, 베이스 경로 제거 로직 등 개발 서버의 6개 이슈를 해결했습니다. 전체 요약 7문장 읽기 → 093 18:11 ▲ 22 · 댓글 2 AI 에이전트가 자신의 인터페이스를 진화시킨다 기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. AI · 머신러닝 · Evolving Agent Interfaces
Key Point AI 에이전트가 직접 자신의 작업 인터페이스를 설계·최적화하면서 더 작은 모델로 기존의 고사양 모델을 능가하는 성과를 낸 것으로, 컴퓨터 사용 에이전트의 성능 향상 경로가 근본적으로 바뀔 수 있음을 보여준다.
핵심 요약
기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. 연구팀은 인터페이스 설계 자체를 에이전트의 능력으로 만들어야 한다고 주장하며 Agent S4를 제안했다. Agent S4는 메타 에이전트가 합성 훈련 작업에서 태스크 에이전트의 궤적을 분석하고, 성공 라벨 없이 인터페이스와 사용 지식을 자동으로 구축·수정하는 인터페이스 저장소를 관리한다. 전체 요약 8문장 읽기 → 094 18:11 ▲ 22 · 댓글 2 추론 모델의 병렬 수정 기법, Draft Refinement 제안 추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. AI · 머신러닝 · Breaking Diffusion: Parallel Reasoning with Draft Refinement
Key Point 추론 모델에서 토큰 단위 수정을 병렬로 처리하면서도 평가의 정확성을 높이는 새로운 메커니즘을 제시해, 복잡한 문제 해결에서 계산 효율과 정확도를 동시에 개선할 수 있음을 보여준다.
핵심 요약
추론 모델이 반복적으로 각 의사결정을 수정할 때, 개별적으로 타당한 토큰 업데이트가 전체 답변의 질을 보장하지 못한다는 문제를 제시한다. Draft Refinement Language Models(DRLMs)는 단일 denoiser를 사용해 병렬 수정안을 제안하고 후보 초안을 평가하는 방식을 도입했다. Denoiser는 균등하게 손상된 초안에서 모든 토큰을 복원하도록 학습되어 보존과 수리 능력을 모두 갖춘다. 전체 요약 8문장 읽기 → 095 18:11 ▲ 24 · 댓글 3 양자화와 추론으로 MoE 오프로딩 병목 해결한 Specter MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. AI · 머신러닝 · Specter: Fast MoE Inference via Quantization-Enabled Multi-Step Speculative Offloading
Key Point 메모리 제약이 있는 환경에서 MoE 모델 추론 속도를 1.5배 이상 개선할 수 있다는 것은 대형 모델을 일반 GPU에서 실행하려는 개발자들에게 직접 영향을 미친다.
핵심 요약
MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. Specter는 양자화된 경량 드래프트 모델을 기기에서 효율적으로 실행하면서도 전문가 활성화 패턴의 충실도를 유지한다. 드래프트 모델의 다단계 예측을 통해 향후 전문가 사용을 미리 파악하고, 런타임이 검증 전에 전문가 이동과 실행을 미리 조직할 수 있다. 전체 요약 5문장 읽기 → 096 18:11 ▲ 185 · 댓글 2 비디오 모델로 실시간 게임 세계 만든다 영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. AI · 머신러닝 · Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds
Key Point 비디오 생성 AI가 게임처럼 상호작용하는 실시간 환경으로 확장되는 전환점을 보여주며, 엔진과 렌더러 분리로 확장성과 성능을 동시에 확보한 방식이 앞으로의 AI 게임 개발 방향을 시사한다.
핵심 요약
영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. 경량 게임 엔진이 월드 상태와 인터랙션 규칙을 관리하고, 멀티모달 AI 코딩 에이전트가 플레이어의 자연어 입력을 게임 코드로 번역하며, 자동 회귀 비디오 모델 기반 렌더러가 저폴리 프록시를 상세한 영상으로 변환한다. 렌더러는 저폴리와 고충실도 영상 쌍으로 학습되었으며, 4프레임 단위로 1~2단계 노이징으로 작동하는 인과 생성기로 증류되어 추론을 최적화했다. 전체 요약 7문장 읽기 → 097 15:11 ▲ 115 · 댓글 3 작은 모델도 큰 모델 따라잡는다, '뇌-몸' 맞춤 진화 자동으로 개선되는 AI 에이전트(RSI)에서는 모델의 역량과 실행 환경(harness)이 함께 진화할 때 불일치 문제가 발생한다. AI · 머신러닝 · CoEvo-RSI: When Harnesses Evolve, Which Models Should Follow?
Key Point 작은 모델이 큰 모델을 이기는 핵심이 '역량과 실행 환경의 정렬'이라는 새로운 관점을 제시하며, 자원 제약이 있는 팀도 효율적인 에이전트를 만들 수 있는 길을 열어준다.
핵심 요약
자동으로 개선되는 AI 에이전트(RSI)에서는 모델의 역량과 실행 환경(harness)이 함께 진화할 때 불일치 문제가 발생한다. 진화 중인 harness가 모델이 학습하지 못한 행동을 요구하거나 기존 능력을 제한하는 '뇌-몸 불일치'를 해결하기 위해 CoEvo-RSI 프레임워크를 제시했다. 메타 에이전트가 과거 설계 아카이브에서 harness를 선택하고, 최적의 모델 체크포인트를 선택하거나 병합한 후 그에 맞춰 적응시킨다. 전체 요약 6문장 읽기 → 098 15:11 ▲ 60 · 댓글 2 로봇 AI의 행동 생성, 재활용으로 3배 빠르게 Vision-language-action (VLA) 모델은 가우시안 노이즈를 반복적으로 제거하며 행동 청크를 생성하지만, 일반적으로 짧은 접두사만 실행한 뒤 나머지 행동 꼬리(action tail)를 버리고 다시 생성한다. AI · 머신러닝 · VLA-Rolling: Fewer Denoising Steps, Better Control via Adaptive Action Reuse
Key Point 로봇 행동 생성 모델의 추론 속도를 대폭 개선하면서 정확도도 높이는 기법으로, 실시간 제어가 필요한 로봇 시스템의 실용성을 크게 향상시킬 수 있다.
핵심 요약
Vision-language-action (VLA) 모델은 가우시안 노이즈를 반복적으로 제거하며 행동 청크를 생성하지만, 일반적으로 짧은 접두사만 실행한 뒤 나머지 행동 꼬리(action tail)를 버리고 다시 생성한다. 연구팀은 버려진 행동 꼬리가 제거 과정의 진행 상황을 담고 있어 재활용 가능함을 발견했고, 10단계 가우시안 기준선과 동등하거나 더 나은 성능을 더 적은 제거 단계로 달성할 수 있음을 보였다. 최적 제거 예산(denoising budget)이 샘플마다 크게 달라지므로, 행동 꼬리 재활용은 업데이트된 환경에 맞게 적응해야 한다는 관찰에 따라 VLA-Rolling을 제안한다. 전체 요약 6문장 읽기 → 099 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 100 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 →