쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
36건 · "vLLM"조건 지우기 ×
001 18:11 새 버전 Transformers v5.21.1 릴리스, rope_scaling 버그 수정 Hugging Face Transformers 라이브러리 v5.21.1 패치 버전을 릴리스했다. 오픈소스 · 도구 · huggingface/transformers@v5.21.1
Key Point vLLM 등 Transformers를 의존하는 라이브러리의 원격 코드 로딩이 v5.21.0에서 깨졌으므로, 이미 업그레이드한 사용자는 즉시 패치버전으로 업데이트해야 한다.
핵심 요약
Hugging Face Transformers 라이브러리 v5.21.1 패치 버전을 릴리스했다. v5.21.0에서 rope_scaling setter 설정 과정에서 원격 코드 로딩이 손상되어 vLLM 호환성이 깨지는 이슈가 발생했다. 이번 패치에서 init 중에 rope_scaling을 할당하는 설정의 rope_scaling setter를 수정했다. 전체 요약 4문장 읽기 → 002 09:11 ▲ 106 · 댓글 17 엔비디아, 40개 언어 지원하는 오픈 음성인식 모델 공개 엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. AI · 머신러닝 · Nvidia Nemotron 3.5 Transcribe: open ASR for 40 languages
Key Point 음성-텍스트 변환이 대규모 언어모델의 다음 병목이 되는 시점에 40개 언어를 지원하고 프롬프트·미세조정으로 도메인 적응이 가능한 오픈 모델이 공개됨에 따라, 음성 애플리케이션 개발 환경이 크게 바뀐다.
핵심 요약
엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. 최대 1시간 길이 음성을 처리하고 최대 8명의 화자를 레이블링하며, 자연어 프롬프트로 출력을 제어할 수 있어 의료 받아쓰기·다국어 회의 등 도메인별 요구에 맞춘 결과를 얻을 수 있다. Hugging Face 오픈 ASR 리더보드 영어 부문에서 5.33% 평균 WER로 오픈 가중치 모델 중 1위, Artificial Analysis 레더보드에서 약 4B 활성 매개변수로 2.8% AA-WER을 달성해 파레토 경계에 위치한다. 전체 요약 12문장 읽기 → 003 18:11 ▲ 13 · 댓글 7 작은 오픈소스 모델, 실제 코딩 업무에 얼마나 써먹을까 벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. AI · 머신러닝 · Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
Key Point 오픈소스 코딩 모델의 실전 성능은 벤치마크와 크게 다르며, 직접 호출과 에이전트 위임 간 성공률 격차가 큼을 실측 데이터로 보여준다.
핵심 요약
벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. 저자가 2026년 7월부터 10월까지 수행한 엔지니어링 작업을 기반으로, vLLM, SGLang, llama.cpp, MLX 등 여러 모델 서빙 환경에서 같은 엔드포인트로 표시되는 모델들도 도구 호출 형식, 턴 제어, 컨텍스트 동작, 캐시 재사용, 신뢰성 면에서 차이를 보임을 기록했다. 4,165개의 코딩 에이전트 게이트웨이 턴, 623개의 디버그 작업, 고정된 Claude Opus 5.5 부모 모델과 숨겨진 동작 검증을 포함한 3개 위임 연구가 증거다. 전체 요약 10문장 읽기 → 004 15:11 ▲ 22 · 댓글 5 MoE 모델의 채널 선택, 보정 데이터 없이 가능 Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. AI · 머신러닝 · Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
Key Point 현재 MoE 모델 최적화의 표준인 보정 기반 임계값이 예산 보장과 성능 향상을 모두 충족하지 못하며, 보정 없는 top-k와 경량 리더로 더 안정적이고 빠른 디코딩을 달성할 수 있음을 보여준다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. 기존 방식은 오프라인 데이터로 보정한 임계값을 사용하지만, 임계값을 통과하는 채널 수는 입력마다 달라져 실제 읽기 예산이 불안정하다: Prox는 18% 읽기 예산으로 보정되었으나 실제로는 평균 12.9%만 읽는다. Top-k 방식은 각 토큰의 k개 최고점수 채널을 선택하며 보정 데이터가 필요 없다. 전체 요약 8문장 읽기 → 005 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 006 03:12 ▲ 118 · 댓글 62 vLLM에서 도구 호출 정확도를 100%로 높이는 방법 Kimi K2.6을 vLLM 0.28에서 제공할 때 도구 호출 스키마 정확도가 92%에 불과해 25회 중 2회 호출이 실패했다. 인프라 · 데브옵스 · Fixing Tool-Call Accuracy in vLLM
Key Point 오픈소스 추론 엔진의 기본 설정만으로는 도구 호출 정확도가 92%대에 머물러 에이전트 기반 애플리케이션의 품질을 심각하게 떨어뜨리는데, vLLM의 제약된 디코딩 기능으로 이를 100%로 보장할 수 있다는 실제 사례와 방법을 보여준다.
핵심 요약
Kimi K2.6을 vLLM 0.28에서 제공할 때 도구 호출 스키마 정확도가 92%에 불과해 25회 중 2회 호출이 실패했다. 에이전트 워크로드에서 도구 호출 오류가 쌓이면 올바르지 않은 맥락이 누적되어 결과 품질이 크게 떨어지고 재시도 비용이 증가한다. 언어 모델은 확률 기반으로 토큰을 생성하므로 명확한 프롬프트에도 불구하고 잘못된 도구 호출을 생성할 수 있으며, 훈련 데이터의 불일치(예: search_web vs web_search)로 인해 존재하지 않는 도구나 필드를 만들 수 있다. 전체 요약 7문장 읽기 → 007 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 008 21:11 당일 +181 팀의 모든 앱을 연결하는 AI 플랫폼 'Onyx' 오픈소스 공개 50개 이상의 애플리케이션에 연결해 팀의 지식을 색인화하고 검색할 수 있는 AI 컨텍스트 계층 Onyx를 오픈소스로 공개했다. AI · 머신러닝 · onyx-dot-app/onyx · Python
Key Point 조직 내부의 분산된 앱과 데이터를 하나의 AI 컨텍스트 층으로 통합하려는 팀들이 자체 호스팅으로 데이터 보호를 하면서 고급 AI 기능을 활용할 수 있게 된다.
핵심 요약
50개 이상의 애플리케이션에 연결해 팀의 지식을 색인화하고 검색할 수 있는 AI 컨텍스트 계층 Onyx를 오픈소스로 공개했다. LLM이 공개 정보뿐 아니라 팀 내부 정보도 활용할 수 있도록 하는 것을 목표로 하며, 자체 호스팅으로 데이터 주권을 보장한다. MCP 기반 검색이나 인덱스 없는 방식과 달리 Onyx는 내부 표현으로 지식을 구축해 낮은 지연시간과 비용으로 관련성 높은 컨텍스트를 제공한다. 전체 요약 10문장 읽기 → 009 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 → 010 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 011 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 012 09:11 ▲ 156 · 댓글 69 RTX Spark 노트북에 Arch Linux 깔아 ARM 성능 검증했다 마이크로소프트 계정 강제와 Windows 기타 불편함 때문에 ASUS ProArt P16 H7607BA-SE033W(128GB RAM, 6,144 CUDA 코어, 2TB SSD)에 Arch Linux ARM을 설치했다. 하드웨어 · 시스템 · Putting Linux on my RTX Spark laptop because I don't have a Microsoft account
Key Point Windows 의존성 없이 ARM 노트북의 전체 성능(CPU·메모리·GPU 추론)을 Linux에서 동일하게 재현할 수 있음을 구체적 수치로 입증해, 폐쇄형 OS에 갇히지 않고 오픈 모델을 로컬에서 실행하려는 개발자에게 실질적 대안을 제시한다.
핵심 요약
마이크로소프트 계정 강제와 Windows 기타 불편함 때문에 ASUS ProArt P16 H7607BA-SE033W(128GB RAM, 6,144 CUDA 코어, 2TB SSD)에 Arch Linux ARM을 설치했다. Arch Linux 패키지 유지보수자인 저자가 NVIDIA 커널 작업, ACPI 오버라이드, 펌웨어 추출을 통해 부팅 가능한 설정을 구성했으며, 키보드·오디오·디스플레이(3840×2400, 120Hz) 지원을 추가했다. CPU 성능 테스트에서 Linux 7-Zip 26.04는 Windows와 단일 스레드에서 거의 동등(±1%)하고, 20스레드에서는 압축 5%, 압축 해제 2.7% 더 빠른 결과를 기록했다. 전체 요약 8문장 읽기 → 013 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 014 15:11 ▲ 10 · 댓글 2 강화학습으로 추론을 최적화한 의사결정 AI 모델 공개 Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. AI · 머신러닝 · StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
Key Point 추론 비용을 크게 줄이면서도 정확도를 유지하는 강화학습 기법이 도입되어 실무 배포 시 비용 효율성이 개선된다.
핵심 요약
Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. Instant 모델은 양방향 주의 메커니즘으로 단일 패스 추론 속도를 유지하면서 정확도를 높이고, AutoThink 모델은 불확실한 결정에만 명시적 추론을 수행하고 확신 있는 경우는 직접 답한다. 3단계 훈련 파이프라인으로 공통 의사결정 능력을 먼저 확립한 뒤 두 모델 변형을 특화하고, 추론 지도학습과 강화학습으로 AutoThink에 추론 능력을 부여한다. 전체 요약 9문장 읽기 → 015 06:11 ▲ 443 · 댓글 269 메타, 816B 파라미터 오픈 모델 뮤즈 스파크 공개 메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. AI · 머신러닝 · Muse Spark Open
Key Point 오픈 웨이트 대형 모델을 처음으로 개인 데스크톱에서 네이티브로 실행할 수 있게 되면서, 클라우드 의존도를 줄이고 로컬에서 고급 AI 기능을 활용할 수 있는 새로운 가능성이 열렸다.
핵심 요약
메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. 모델은 총 816B 파라미터(활성 42B)를 가진 네이티브 멀티모달 모델로 1M 토큰 컨텍스트 윈도우를 지원한다. 처음으로 Apple M5 Ultra Mac Studio 2대에서 최신 MLX 프레임워크를 사용해 데스크톱에서 직접 실행 가능하다. 전체 요약 11문장 읽기 → 016 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 017 21:11 당일 +247 바이두, 원샷 긴 문서 인식 'Unlimited OCR' 공개 바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. AI · 머신러닝 · baidu/Unlimited-OCR · Python
Key Point 한 번의 입력으로 문서 전체를 처리하는 새로운 OCR 방식이 주목받으면서, 기존 다중 단계 파싱의 한계를 극복하는 기술이 실제로 작동하는 방식을 알 수 있습니다.
핵심 요약
바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. 한 번의 입력으로 긴 텍스트 구간을 파싱하는 'One-shot Long-horizon Parsing' 방식을 도입했다. Hugging Face, ModelScope, Baidu Cloud 등에서 모델과 데모를 제공하고 있다. 전체 요약 7문장 읽기 → 018 15:11 ▲ 150 · 댓글 67 Intel, 에이전트 AI 전용 D270 GPU 공개…최대 480GB LPDDR5X 메모리 인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. 하드웨어 · 시스템 · Intel D270 GPU AI Accelerator–Up to 480 GB LPDDR5X
Key Point 에이전트 AI 시대 장문맥·고동시성 추론의 메모리 병목을 겨냥한 표준 인프라 기반 GPU로, NVIDIA 중심 시장에 대안을 제시하는 시점의 신제품이다.
핵심 요약
인텔이 AI 추론 전용 데이터센터 GPU 'D270'을 발표했다. D270은 최대 480GB LPDDR5X 메모리, 32개 Xᵉ3P 코어, 256개 XMX 매트릭스 엔진을 탑재하고 350W 공기냉식으로 동작한다. 에이전트 AI 워크로드의 특징인 긴 컨텍스트, 다중 단계 작업, 프리필 중심 연산에 최적화됐다. 전체 요약 8문장 읽기 → 019 21:12 당일 +131 Rust로 만든 고성능 AI 코딩 에이전트 jcode 공개 GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. AI · 머신러닝 · 1jehuang/jcode · Rust
Key Point 메모리 사용량을 1/10 이하로 줄이고 응답 속도를 200배 이상 개선한 오픈소스 AI 에이전트가 나왔으므로, 로컬 개발 환경에서 가볍게 AI 코딩 어시스턴트를 운영하거나 대규모 멀티에이전트 시스템을 구축하려는 개발팀에게 중요한 선택지가 될 수 있다.
핵심 요약
GitHub Trending에 오른 jcode는 Rust로 작성된 고성능 AI 코딩 에이전트 프레임워크로, RAM 효율성과 응답 속도를 극도로 최적화했다. 단일 세션 메모리 사용량은 27.8MB(임베딩 비활성화)부터 167.1MB(활성화)로, Claude Code 386.6MB 대비 약 2~14배 적으며, 10개 세션 병렬 실행 시에도 260.8MB로 경쟁 제품 대비 압도적이다. 부팅부터 첫 프레임까지 14.0ms, 첫 입력까지 48.7ms로 다른 도구(Claude Code 3436.9ms)의 1/200~1/70 수준의 극도로 빠른 응답성을 제공한다. 전체 요약 10문장 읽기 → 020 21:11 당일 +114 텐센트, 33개 언어 지원하는 다중언어 번역 모델 공개 텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. AI · 머신러닝 · Tencent-Hunyuan/Hy-MT2 · Python
Key Point 번역 모델의 성능이 상용 API를 능가하는 수준에 도달했으며, 극저비트 양자화로 온디바이스 배포가 실질적으로 가능해졌다.
핵심 요약
텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. 1.8B 모델은 AngelSlim의 1.25비트 극저비트 양자화로 저장 크기를 440MB까지 줄이고 추론 속도를 1.5배 높였다. 평가 결과 7B와 30B-A3B 모델은 DeepSeek-V4-Pro, Kimi K2.6 같은 오픈소스 모델을 능가하며, 1.8B 모델도 마이크로소프트·더바오 등 상용 API를 전반적으로 능가한다. 전체 요약 9문장 읽기 → 021 21:11 ▲ 17 · 댓글 2 긴 맥락 LLM을 위한 스파스 추론 엔진 'SparseEngine' 공개 긴 상호작용 이력을 축적하는 LLM 에이전트는 KV-캐시 메모리와 어텐션 연산 부하가 증가하는 문제를 겪고 있다. AI · 머신러닝 · SparseEngine: Sparse-First Inference Engine
Key Point 긴 맥락 LLM 에이전트의 메모리 부하와 계산 비용을 획기적으로 줄이면서 기존 추론 엔진과 호환되는 첫 번째 스파스 우선 엔진으로, 실무 배포 환경에서 즉시 활용 가능한 성능 개선을 제공한다.
핵심 요약
긴 상호작용 이력을 축적하는 LLM 에이전트는 KV-캐시 메모리와 어텐션 연산 부하가 증가하는 문제를 겪고 있다. 기존 스파스 어텐션 방식들은 이질적인 캐시 표현과 워크플로우로 인해 기존 추론 엔진 통합이 어렵고, 특정 레이아웃이나 워크플로우만 지원한다. SparseEngine은 스파스 우선 설계의 추론 엔진으로, 공유된 생명주기 계약을 통해 각 방식이 KV 표현과 연산을 독립적으로 제어하면서도 공통 인프라와 상태 전환을 조율할 수 있다. 전체 요약 6문장 읽기 → 022 18:30 ▲ 13 · 댓글 4 MoE 모델 디코딩 성능 2배 근처로 높이는 프레임워크 Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. AI · 머신러닝 · SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
Key Point MoE 모델의 디코딩 병목을 해결하는 새로운 방식으로 정확도 손실을 최소화하면서 처리량을 획기적으로 높일 수 있다는 점이 중요하다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 토큰당 소수 전문가만 활성화하지만, 배치 디코딩에서는 거의 모든 전문가에 접근해야 해 전문가 가중치 트래픽이 주요 병목이 된다. 기존 전문가 가지치기(pruning)는 계산이 필요한 prefill 단계도 함께 가지쳐 모델 품질 저하에 비해 처리량 향상이 미미하다. SlimWise는 추론 각 단계별로 전문가 풀을 다르게 구성하는 서빙 프레임워크로, prefill은 전체 모델로 수행하고 decode는 가지친 모델을 사용한다. 전체 요약 6문장 읽기 → 023 03:11 ▲ 11 · 댓글 2 음성·영상 AI의 할루시네이션 문제, 질문 재라우팅으로 해결 음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. AI · 머신러닝 · Devils in Question Relay: Source-Conditioned Relay Steering to Mitigate Hallucinations in Audio-visual Large Language Models
Key Point 음성·영상을 함께 처리하는 AI 시스템에서 불필요한 정보로 인한 오답 문제를 진단하고 해결하는 구체적 방법이 제시되어, 멀티모달 모델의 신뢰성을 높이는 데 직접 적용 가능하다.
핵심 요약
음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. 연구팀이 경로 개입과 표현 분석을 통해 이 문제의 내부 메커니즘을 규명했다: 질문 상태가 필요한 모달리티의 증거뿐 아니라 간섭 신호도 함께 전달하며, 생성 단계보다는 질문 단계에서 간섭을 차단할 때 더 효과적이다. 이를 바탕으로 SECRET(SourcE-Conditioned RElay sTeering)이라는 훈련 불필요 방식을 제안했다: 서로 다른 모달리티 경로로 추출한 대조적 질문 표현을 이용해 원래 질문을 필요한 소스의 증거로 유도한다. 전체 요약 5문장 읽기 → 024 00:11 ▲ 160 · 댓글 91 독일의 주권형 AI, 78억 파라미터 콜리브리 공개 Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: Germany's new sovereign AI model Kolibri
Key Point EU AI 규정 준수, 데이터 독립성, 독일어 추론을 통합한 오픈웨이트 모델로 유럽 규제권 내 AI 자립이 기술적으로 가능함을 보여주며, 금융·공공·항공우주 등 데이터 민감 산업에 기존 대규모 모델 의존도를 낮힐 선택지를 제공한다.
핵심 요약
Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. 78.1억 개 파라미터 중 토큰당 3.46억 개(4.4%)만 활성화되며, 262,144 토큰 기본 문맥에서 최대 104만 8576 토큰까지 검증됐다. 독일 및 핀란드 인프라에서 768개 NVIDIA B200 GPU로 24조 토큰을 학습했으며, 독일 법률에 따라 구축돼 조직이 자체 서버에서 완전히 제어 가능하다. 전체 요약 12문장 읽기 → 025 06:11 ▲ 65 · 댓글 3 LLM 추론을 위한 '불일치 양자화', 프롬프트와 생성 단계별 최적화 프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. AI · 머신러닝 · Disaggregated Quantization: Specializing LLM Prefill and Decode
Key Point LLM 추론의 Prefill과 Decode 두 단계에 서로 다른 양자화 전략을 적용해 정확도 손실 없이 처리 속도(첫 토큰까지 1.78배 단축)와 메모리 효율을 동시에 개선하는 방법론이 공개됐다.
핵심 요약
프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. 연구진은 '불일치 양자화'(Disaggregated Quantization, DQ)를 제안했으며, 이는 두 단계별로 계산 형식·가중치·저장소 배치를 특화시킨다. Qwen 3과 Gemma 3에서 Decode 단계의 활성화 양자화를 제거하면 생성 작업의 정확성이 향상되고 추론 비용은 증가하지 않는다. 전체 요약 8문장 읽기 → 026 21:11 당일 +124 Neuro-sama 같은 AI 캐릭터를 직접 만드는 오픈소스 프로젝트 AIRI Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. AI · 머신러닝 · moeru-ai/airi · TypeScript
Key Point Neuro-sama 같은 AI 가상 캐릭터를 누구나 직접 구축할 수 있는 완전한 오픈소스 플랫폼이 나왔고, 게임 플레이부터 음성 채팅까지 놀라운 수준의 기능을 갖추고 있다.
핵심 요약
Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. 브라우저, macOS, Windows 데스크톱, 모바일 PWA 등 다양한 플랫폼에서 실시간 음성 채팅이 가능하며, Minecraft, Factorio, Kerbal Space Program 등 여러 게임을 플레이할 수 있다. WebGPU, WebAssembly, Web Workers 등 웹 기술로 그래픽과 레이아웃을 처리하면서도, NVIDIA CUDA와 Apple Metal을 통한 네이티브 추론으로 성능을 확보하는 하이브리드 아키텍처를 채택했다. 전체 요약 12문장 읽기 → 027 21:11 ▲ 102 · 댓글 42 LLM으로 Jev 수준의 고속 의사결정 모델 구축하기 GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. AI · 머신러닝 · Turning GLM-5.3-Flash into a Jev-like decision model
Key Point 일반 LLM을 구조화된 의사결정 모델로 탈바꿈시키는 프롬프트 기법이 전문 의사결정 모델과 실무 성능에서 동등하다는 것을 보여주므로, 고도량 의사결정 시스템 구축 시 모델 선택지와 비용-성능 트레이드오프 판단에 실질적 참고가 될 수 있다.
핵심 요약
GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. 기본 아이디어는 LLM의 확률 분포에서 옵션별 확률을 직접 읽는 것이다. 숫자로 인덱싱된 옵션 목록을 JSON으로 제시하고 프롬프트를 'choice_index:'로 끝내면, 모델이 첫 토큰에서 내놓는 확률 분포가 각 옵션의 신뢰도가 된다. 29개 공개 데이터셋(2~151개 옵션, 의도 라우팅·감정 분석·법률 문서 등 포함)을 벤치마킹한 결과, GLM-5.3-Flash와 Jev의 정확도 차이는 중앙값 0.7 포인트로 통계적으로 유의미하지 않았다. 전체 요약 12문장 읽기 → 028 22:45 당일 +276 NVIDIA Model Optimizer, 양자화·가지치기·증류 등 최적화 기법 통합 라이브러리 오픈소스화 NVIDIA Model Optimizer는 양자화, 가지치기(pruning), 신경망 구조 탐색(NAS), 증류, 추측 디코딩, 희소성 등 최신 모델 최적화 기법을 통합한 라이브러리다. AI · 머신러닝 · NVIDIA/Model-Optimizer · Python
Key Point DL 인퍼런스 배포 시 성능과 메모리 효율을 동시에 높이려는 개발자들에게 양자화, 가지치기, 증류 등을 통합 관리할 수 있는 공식 도구가 생겼고, 오픈소스로 누구나 기여 가능해졌다.
핵심 요약
NVIDIA Model Optimizer는 양자화, 가지치기(pruning), 신경망 구조 탐색(NAS), 증류, 추측 디코딩, 희소성 등 최신 모델 최적화 기법을 통합한 라이브러리다. Hugging Face, PyTorch, ONNX 모델을 입력받아 Python API로 최적화 기법들을 조합해 적용하고, 최적화된 양자화 체크포인트를 생성한다. 생성된 체크포인트는 TensorRT-LLM, vLLM, SGLang 등 인퍼런스 프레임워크에 바로 배포 가능하며, Megatron-Bridge 및 Hugging Face Accelerate와 통합돼 있다. 전체 요약 12문장 읽기 → 029 22:29 ▲ 140 · 댓글 118 AI 토큰 가격, 매년 수십 배 하락…계산 도구보다도 싸져 LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. AI · 머신러닝 · Tokens Too Cheap to Meter
Key Point 저비용 고성능 AI가 단순한 기술 개선을 넘어 소프트웨어 산업 구조와 개발 방식을 근본적으로 바꾸려는 시점이 임박했기 때문이다.
핵심 요약
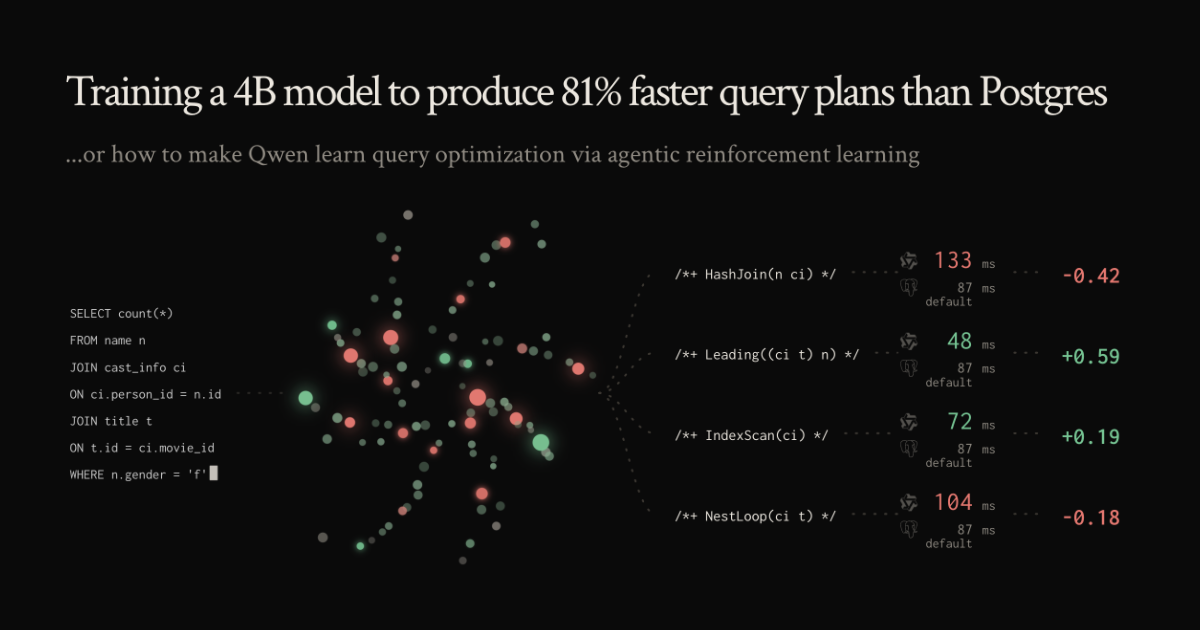
LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. GPU 효율이 2년마다 2배씩 증가하고, 작업당 비용은 2025년 동안 100배 이상 하락했으며, vLLM 같은 추론 엔진도 15개월간 40% 효율이 개선되었다. Mixture-of-Experts 모델 아키텍처로 매개변수 6B에서 0.8B로 줄이면서도 성능 유지 가능해졌고, Mamba 아키텍처는 메모리 필요량을 5배 이상 감소시켜 3~6년 내 지역 실행이 현실화될 전망이다. 전체 요약 8문장 읽기 → 030 06:10 ▲ 183 · 댓글 27 4B 모델로 PostgreSQL 쿼리 플랜 81% 성능 개선 연구자는 4B 파라미터 오픈웨이트 모델을 지도학습(SFT)과 강화학습(RL)으로 미세조정해 PostgreSQL 기본 쿼리 플랜을 능가하는 플랜을 생성하도록 훈련했다. AI · 머신러닝 · Training a 4B model to produce 81% faster query plans than Postgres
Key Point 쿼리 최적화라는 매우 어려운 데이터베이스 문제를 작은 규모의 LLM으로 해결 가능함을 실증함으로써, AI를 데이터베이스 성능 개선에 실무적으로 적용할 수 있는 방법을 제시한다.
핵심 요약
연구자는 4B 파라미터 오픈웨이트 모델을 지도학습(SFT)과 강화학습(RL)으로 미세조정해 PostgreSQL 기본 쿼리 플랜을 능가하는 플랜을 생성하도록 훈련했다. 113개의 조인 중심 쿼리에서 44.7% 레이턴시 감소를 달성했으며, 초기에 99개 쿼리를 실행할 수 없던 모델이 성공적으로 작동하게 되었다. 쿼리 최적화는 조인 순서 결정이 NP-하드 문제로 알려져 있을 정도로 어려우나, 실행 시간이라는 단일 목표로 LLM 학습을 최적화할 수 있음을 보여준다. 전체 요약 4문장 읽기 → 031 21:11 당일 +501 트랜스포머 생태계의 중심 - Hugging Face Transformers 라이브러리 Transformers는 NLP, 비전, 오디오, 비디오, 멀티모달 등 다양한 분야의 최신 머신러닝 모델을 정의하고 학습·추론하는 프레임워크입니다. AI · 머신러닝 · huggingface/transformers · Python
Key Point Transformers는 최신 AI 모델들의 표준 정의 기준이 되어 있으며, 기업과 개발자가 프로덕션 환경에서 모델을 활용할 때 필수 생태계입니다.
핵심 요약
Transformers는 NLP, 비전, 오디오, 비디오, 멀티모달 등 다양한 분야의 최신 머신러닝 모델을 정의하고 학습·추론하는 프레임워크입니다. 라이브러리가 정의한 모델은 Axolotl, Unsloth, DeepSpeed 등 대부분의 학습 프레임워크와 vLLM, SGLang, TGI 같은 추론 엔진에서 호환됩니다. Hugging Face Hub에 100만 개 이상의 사전학습 모델 체크포인트가 공개되어 있어 즉시 활용 가능합니다. 전체 요약 5문장 읽기 → 032 12:10 ▲ 103 · 댓글 51 LRU 캐시 정책, 기존 논문보다 더 견고했다 실제 Claude Code 세션 393개(요청 68,266건)와 Mooncake 요청 23,608건을 재현해 LRU를 이길 방법을 3가지로 시도했으나 모두 실패했다. 인프라 · 데브옵스 · LRU is harder to beat than the KV-cache papers suggest
Key Point 생성형 LLM 에이전트 서빙에서 캐시 정책을 최적화하려는 엔지니어들이 설계 선택을 할 때, 최근 학술 논문의 주장이 실제 프로덕션 워크로드에 얼마나 적용되는지 확인할 수 있다.
핵심 요약
실제 Claude Code 세션 393개(요청 68,266건)와 Mooncake 요청 23,608건을 재현해 LRU를 이길 방법을 3가지로 시도했으나 모두 실패했다. 용량 부족 상황에서 캐시 재계산의 주요 원인은 세션 만료(TTL)가 아니라 2초 간격의 도구 호출 루프였고, 5분 TTL은 실제로 발동되지 않았다. 재계산 토큰의 33.1%는 10초 이내 요청에서 발생했고, 5분 이상 대기 후 요청은 17.5%에 불과해 기존 논문의 핵심 가정이 실제 워크로드와 다르다. 전체 요약 5문장 읽기 → 033 12:10 ▲ 104 · 댓글 39 LiteLLM의 핵심 기능만 추린 경량 라이브러리 litelm 공개 LiteLLM의 라우팅·메시지 번역 기능을 약 2,900줄과 2개 의존성(openai, httpx)으로 구현한 경량 라이브러리 litelm이 공개됐다. AI · 머신러닝 · Litelm: LiteLLM Without the Bloat
Key Point 기존 LiteLLM의 100k+ 줄 코드 크기에 부담을 느끼거나 가벼운 LLM 통합을 원하는 개발자에게 핵심만 추린 대안을 제시한다.
핵심 요약
LiteLLM의 라우팅·메시지 번역 기능을 약 2,900줄과 2개 의존성(openai, httpx)으로 구현한 경량 라이브러리 litelm이 공개됐다. 프록시 서버, 캐싱, 비용 추적 등 100k+ 줄의 복잡한 기능을 제거하고 모델 라우팅, 메시지 변환, 스트리밍, 도구 사용, 임베딩만 제공한다. OpenAI 호환 엔드포인트로 19개 제공자(OpenAI, Anthropic, Groq, Mistral, xAI, Azure, Bedrock 등)를 지원하며 api_base로 로컬 vLLM·Ollama·LM Studio도 연결 가능하다. 전체 요약 5문장 읽기 → 034 11:10 당일 +262 논문 검색·분석하는 오픈소스 AI 리서치 에이전트 공개 Feynman은 자연어 질문으로 학술 논문을 검색·분석·평가할 수 있는 오픈소스 AI 리서치 에이전트다. AI · 머신러닝 · advaitpaliwal/feynman · TypeScript
Key Point 학술 논문 검색과 분석을 자동화하려는 연구자, 데이터 과학자, AI 에이전트 개발자에게 필수 도구가 될 수 있는 오픈소스 플랫폼이 등장했습니다.
핵심 요약
Feynman은 자연어 질문으로 학술 논문을 검색·분석·평가할 수 있는 오픈소스 AI 리서치 에이전트다. PaperRank 점수 매기기, DOI·arXiv·논문 제목으로 접근, 문헌 검토, 논문 대 코드베이스 감사 등 12개 이상의 슬래시 커맨드를 제공한다. 로컬 모델(LM Studio, Ollama, vLLM), 클라우드 프로바이더(OpenAI, OpenRouter, GitHub Copilot)를 지원하며, 스탠드얼론 설치 또는 npm으로 배포된다. 전체 요약 5문장 읽기 → 035 11:10 ▲ 143 · 댓글 53 vLLM이 AMD GPU에서 추측 디코딩 지원 vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. AI · 머신러닝 · Speculative Decoding in vLLM on AMD GPUs
Key Point LLM 추론 성능 최적화를 위한 주요 기법이 AMD GPU에서 실제 구현되어, 장기 생성 작업의 처리량 개선 가능성을 보여준다.
핵심 요약
vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. 추측 디코딩은 경량 드래프트 모듈이 여러 토큰을 먼저 제안하고 타겟 모델이 한 번에 검증하는 방식으로, 기존 자동회귀 디코딩보다 모델 통과 횟수를 줄인다. 표준 방식은 토큰 하나당 모델 실행 1회가 필요하지만, 추측 디코딩은 여러 드래프트 토큰이 검증을 통과하면 단일 모델 실행으로 여러 토큰을 커밋할 수 있다. 전체 요약 5문장 읽기 → 036 00:10 ▲ 15 · 댓글 3 알리바바 Qwen 3.8 27B 공개, 로컬 모델 최고 성능 Qwen3.8-27B-FP8은 오픈 가중치 모델로 HuggingFace Transformers, vLLM 등과 호환된다. AI · 머신러닝 · Qwen 3.8 27B is out: open weights, best local dense model yet
Key Point 로컬에서 구동 가능한 고성능 오픈소스 모델로, Hacker News 커뮤니티에서 배포 용이성과 벤치마크 성과에 주목받고 있다.
핵심 요약
Qwen3.8-27B-FP8은 오픈 가중치 모델로 HuggingFace Transformers, vLLM 등과 호환된다. 27B 매개변수 모델로 코딩, 에이전트 작업, 멀티모달 이해 능력을 갖추고 262K 네이티브 컨텍스트를 지원한다. 터미널 코딩 벤치마크 73.0점, SWE-bench Pro 61.7점 등 기존 모델을 능가하는 성능을 보인다.