쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
29건 · "Gemma"조건 지우기 ×
001 06:11 ▲ 26 · 댓글 2 멀티모달 임베딩의 새로운 기준, EmbeddingGemma 2 공개 Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. AI · 머신러닝 · EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Key Point 멀티모달 검색과 임베딩 생성이 필요한 개발자와 머신러닝 엔지니어에게 오픈 모델 선택지가 생겼으며, 작은 모델로 대형 모델 수준의 성능을 달성할 수 있다는 것이 중요하다.
핵심 요약
Google이 오픈 멀티모달 임베딩 모델 EmbeddingGemma 2를 발표했다. 텍스트, 이미지, 오디오, 비디오를 단일 벡터 공간에 통합으로 표현한다. 단순화된 계층별 임베딩과 모달리티·목표 기반 다단계 커리큘럼을 도입했다. 전체 요약 7문장 읽기 → 002 15:11 ▲ 22 · 댓글 5 MoE 모델의 채널 선택, 보정 데이터 없이 가능 Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. AI · 머신러닝 · Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
Key Point 현재 MoE 모델 최적화의 표준인 보정 기반 임계값이 예산 보장과 성능 향상을 모두 충족하지 못하며, 보정 없는 top-k와 경량 리더로 더 안정적이고 빠른 디코딩을 달성할 수 있음을 보여준다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. 기존 방식은 오프라인 데이터로 보정한 임계값을 사용하지만, 임계값을 통과하는 채널 수는 입력마다 달라져 실제 읽기 예산이 불안정하다: Prox는 18% 읽기 예산으로 보정되었으나 실제로는 평균 12.9%만 읽는다. Top-k 방식은 각 토큰의 k개 최고점수 채널을 선택하며 보정 데이터가 필요 없다. 전체 요약 8문장 읽기 → 003 03:11 ▲ 16 · 댓글 4 Gemma 4 임베딩을 극도로 압축하는 OPTIC 기법 공개 Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. AI · 머신러닝 · Extreme Compression of Per-Layer Embeddings via Cross-Layer Latent Vector Quantization
Key Point 대규모 언어 모델의 임베딩 매개변수가 점차 커지는 추세에서, 성능 손실을 최소화하면서 극도의 압축을 달성할 수 있는 새로운 방법을 제시한다.
핵심 요약
Gemma 4 E4B의 매개변수 35.2%를 차지하는 Per-Layer Embeddings(PLE)의 극도 압축 기법 OPTIC을 개발했다. OPTIC은 토큰마다 하나의 양자화된 코드를 저장하고, 각 층에서 층별 아핀 디코더로 디코딩하는 방식을 사용한다. 코드와 디코더는 저장된 벡터가 아닌 PLE 출력 경로에 맞춰 학습된다. 전체 요약 7문장 읽기 → 004 00:11 ▲ 31 · 댓글 2 LLM 에이전트 자체 학습 능력 강화법 제시 LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. AI · 머신러닝 · Evolving to Match Capabilities: Improving Harness Self-Evolution via Skill Adaptation
Key Point 약한 LLM 모델의 성능 저하 문제를 스킬 적응으로 해결하는 구체적인 방법론이 제시되어, 실무에서 다양한 규모의 언어 모델을 배포하는 개발자들이 자체 학습 효율을 크게 높일 수 있다.
핵심 요약
LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. 7개 모델과 3개 벤치마크에서 103개의 작업-스킬 조합을 분석한 결과, 어떤 스킬은 GPT-5.6-luna의 성능을 31.1점 높였지만 Gemma-4-E4B의 성능을 8.8점 낮췄다. 약한 모델의 실패 사례 86%에서 스킬 자체에 이미 명시된 요구사항을 위반했으므로, 실행자의 능력에 맞게 스킬을 재작성하는 skill adaptation을 제안했다. 전체 요약 7문장 읽기 → 005 12:11 ▲ 125 · 댓글 30 로컬에서 쓰는 오픈소스 AI, Hob 공개 Frigade가 개발한 Hob은 개인 컴퓨터에서 AI를 쓸 수 있는 무료 오픈소스 데스크톱 애플리케이션이다. AI · 머신러닝 · Show HN: Hob - Open-source, on device alternative to Claude Cowork and ChatGPT
Key Point 로컬 머신에서 완전히 프라이빗하게 LLM을 쓸 수 있는 크로스플랫폼 오픈소스 도구로, 개인정보 보호를 중요시하거나 API 의존성을 줄이고 싶은 개발자에게 유용한 선택지이다.
핵심 요약
Frigade가 개발한 Hob은 개인 컴퓨터에서 AI를 쓸 수 있는 무료 오픈소스 데스크톱 애플리케이션이다. Claude와 ChatGPT의 대체 프로그램으로, Gemma, GPT-OSS 같은 오픈 가중치 모델을 로컬에서 실행한다. Mac, Windows, Linux를 지원하며, 사용자의 컴퓨터에 맞는 최고 수준의 최신 모델을 자동으로 선택해 설정해준다. 전체 요약 6문장 읽기 → 006 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 007 06:11 ▲ 11 · 댓글 3 로컬에서 돌리는 에이전트 모델 Muse Glimmer 30B 공개 Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. AI · 머신러닝 · Muse Glimmer 30B: An On-Device Agentic Model
Key Point GPU 한 개면 충분한 수준의 에이전트 능력을 로컬에서 운영할 수 있어, 개발자들이 클라우드 비용 없이 독립적인 AI 시스템을 구축하는 방식을 바꿀 수 있습니다.
핵심 요약
Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. 일반 PC에서 클라우드 없이 독립적으로 동작하는 에이전트 모델로, 텍스트와 이미지를 입력받고 텍스트를 출력합니다. 다단계 추론, 도구 사용, 실패 복구 능력을 통합했으며 100개 이상의 언어로 학습되었습니다. 전체 요약 6문장 읽기 → 008 09:11 당일 +108 LLM 추론 최적화 라이브러리 vLLM, 200+ 모델 지원 vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. AI · 머신러닝 · vllm-project/vllm · Python
Key Point LLM 서빙 성능이 중요해지면서 vLLM 같은 최적화된 추론 엔진의 역할이 커지고 있으며, 광범위한 모델 지원과 하드웨어 호환성이 프로덕션 배포의 실질적 선택지를 제공한다.
핵심 요약
vLLM은 UC Berkeley의 Sky Computing Lab에서 개발한 오픈소스 LLM 추론·서빙 엔진으로, 2000명 이상의 기여자가 참여하는 활발한 프로젝트다. PagedAttention을 통해 메모리를 효율적으로 관리하고 연속 배칭, 청크 프리필, 프리픽스 캐싱으로 높은 처리량을 제공한다. FP8, INT4, GPTQ/AWQ, GGUF 등 다양한 양자화 방식과 FlashAttention, FlashInfer 같은 최적화 커널을 지원한다. 전체 요약 8문장 읽기 → 009 21:11 ▲ 13 · 댓글 4 임베딩 테이블을 16MB 고정 코드로 대체, 소형 모델 파일 1/7 축소 소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. AI · 머신러닝 · Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
Key Point 소형 모델 배포 시 파일 크기가 1/7로 축소되고 CPU 속도가 5~6배 빨라지므로, 엣지 디바이스와 저사양 환경에서의 모델 배포 방식을 바꿀 가능성이 있다.
핵심 요약
소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. 연구팀은 학습 가능한 임베딩 테이블을 주성분 투영과 부호 이진화로 도출한 512비트 코드의 동결 테이블(16MB, 학습 가능 파라미터 없음)로 대체하고, 동일한 Gemma 형태의 모델을 2.05B 토큰으로 학습했다. 학습된 임베딩 테이블은 0.20 나츠 검증 손실을 위해 2.6배 많은 학습 가능 파라미터를 필요로 했으나, LAMBADA, HellaSwag, PIQA 벤치마크에서는 동결 테이블 모델이 동일하거나 더 나은 성능을 보였고 ARC-Easy에서만 학습된 테이블이 앞섰다. 전체 요약 6문장 읽기 → 010 06:11 ▲ 102 · 댓글 28 PS5에서 언어모델 서버 구축, 집 전체 기기에서 사용 PS5LM은 탈옥한 PS5의 GPU에서 llama.cpp를 실행하여 GGUF 형식 언어모델을 로드하고 네트워크 기기들에 서빙하는 어플리케이션이다. 하드웨어 · 시스템 · Llama.cpp on a jailbroken PS5: run any GGUF model natively on the console
Key Point 탈옥 PS5를 개인 서버로 변환하여 클라우드 없이 로컬에서 언어모델을 운영할 수 있으며, TV 기반 관리 인터페이스와 기존 AI 도구와의 호환성이 실용성을 높인다.
핵심 요약
PS5LM은 탈옥한 PS5의 GPU에서 llama.cpp를 실행하여 GGUF 형식 언어모델을 로드하고 네트워크 기기들에 서빙하는 어플리케이션이다. 콘솔의 RDNA 2 GPU와 11.4GB 공유 메모리를 활용하며, llama.cpp가 지원하는 모든 아키텍처와 양자화 기법을 사용할 수 있다. OpenAI의 /v1/chat/completions와 Anthropic의 /v1/messages API를 구현하여 기존 클라이언트(Claude Code 포함)와 호환되며, 브라우저 채팅 인터페이스도 제공한다. 전체 요약 12문장 읽기 → 011 12:11 새 버전 Ollama 0.40.4, 터미널에서 의사결정 모델 직접 실행 Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. AI · 머신러닝 · ollama/ollama@v0.40.4
Key Point 로컬 AI 모델을 터미널에서 의사결정·분류 작업에 직접 활용할 수 있게 되어 개발자의 워크플로우가 단순화되고, Apple Silicon 최적화와 성능 개선으로 실 사용 환경이 개선된다.
핵심 요약
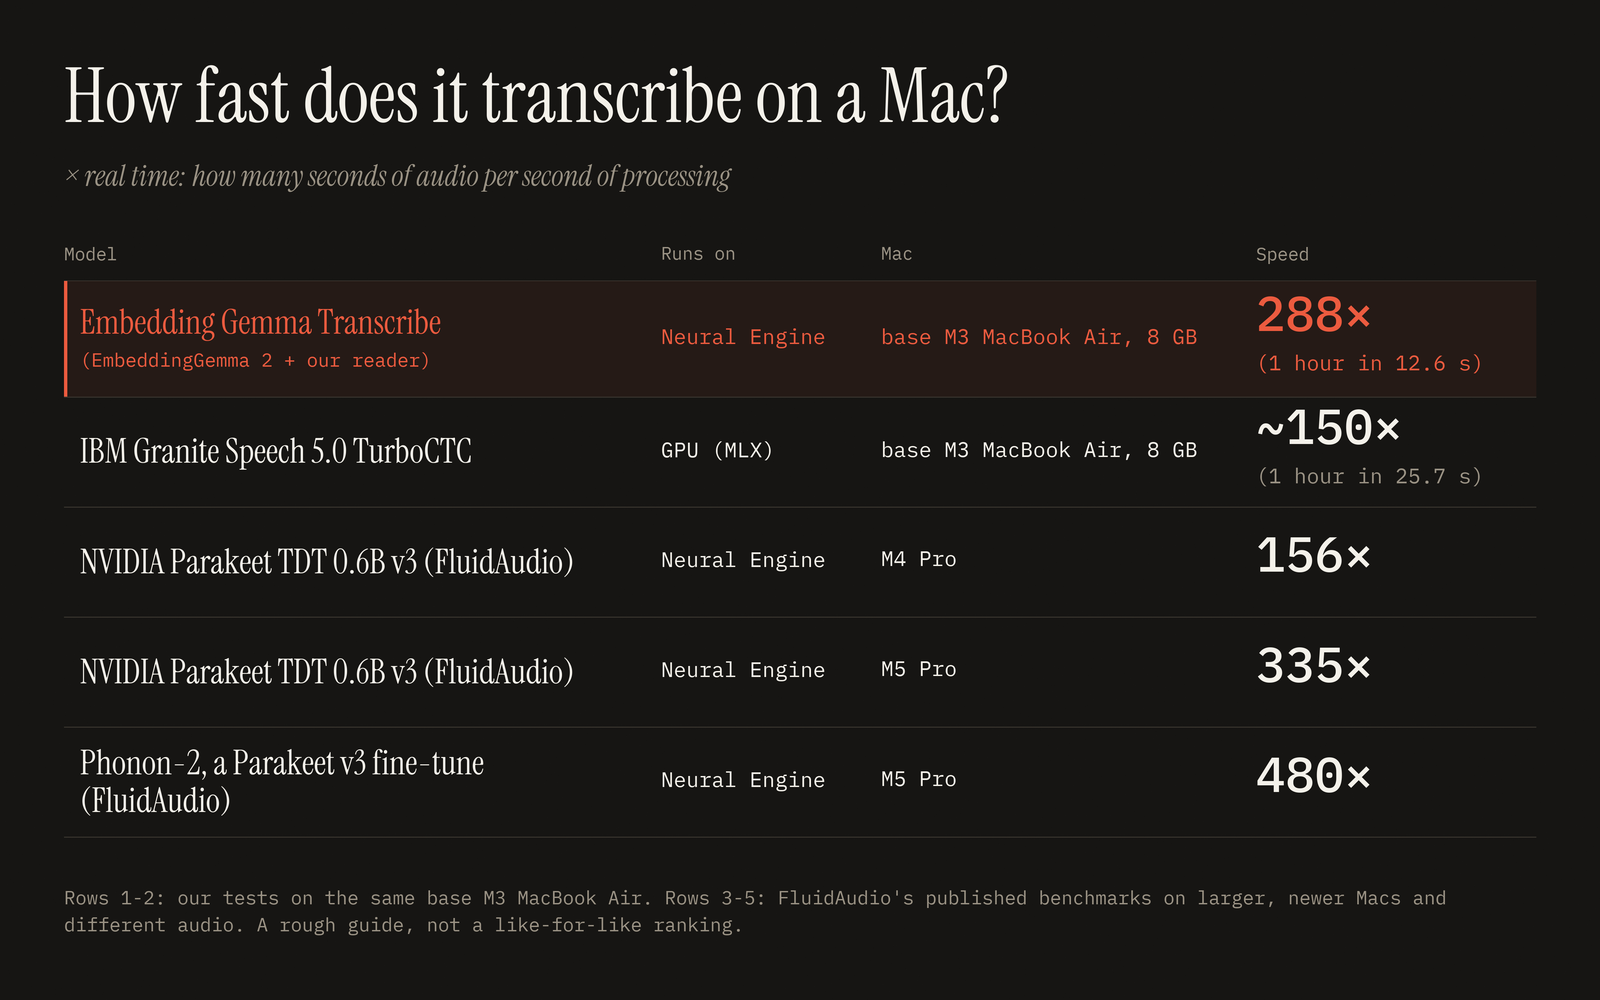
Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. MLX 러너가 Apple Silicon에서 Kev 의사결정 모델을 지원하며, ollama launch는 유료 플랜 업그레이드 없이 사용 크레딧으로 실행 가능해졌다. Ollama launch codex는 로컬 설치된 Ollama 모델을 모델 피커에 포함하고 /model 명령으로 모델 전환을 지원한다. 전체 요약 7문장 읽기 → 012 00:11 ▲ 238 · 댓글 57 EmbeddingGemma 2를 음성 인식 모델로 개조한 실험 Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. AI · 머신러닝 · We turned EmbeddingGemma 2 into a speech-to-text model
Key Point 다중모달 임베딩 모델을 음성 인식으로 새롭게 활용한 창의적 접근과 Apple Silicon에서의 빠른 실시간 처리 성능이 주목할 만하다.
핵심 요약
Google의 다중 모달 임베딩 모델 EmbeddingGemma 2를 음성-텍스트 변환 모델로 개조했다. 텍스트, 이미지, 오디오, 비디오를 같은 벡터 공간에 매핑하는 특성을 활용해 음성을 약 22만 9천 개 영어 단어 중 가장 가까운 단어로 매칭하는 방식으로 작동한다. 오디오 인코더는 원래 그대로 두고, 새로운 작은 리더 모델만 학습시켜 음성 슬라이스를 텍스트 공간으로 변환하며, 별도 모델이 구두점과 대문자를 추가한다. 전체 요약 7문장 읽기 → 013 18:11 ▲ 132 · 댓글 41 80GB 모델을 32GB 램에서 실행하는 Janas, llama.cpp보다 2배 이상 빠르다 Janas-LLM은 48GB의 Qwen3-Next-80B 모델을 32GB 램의 노트북에서 실행하는 도구로, 모델 가중치를 디스크에 유지하면서 필요한 전문가(expert) 블록만 NVMe SSD에서 스트리밍한다. AI · 머신러닝 · Janas: Run LLMs larger than RAM by streaming experts from SSD
Key Point 32GB 메모리 제약에서 48GB 모델을 실행하면서 llama.cpp보다 2배 이상 빠른 속도를 달성한 새로운 방식이 기존 로컬 LLM 실행 방식의 성능 한계를 크게 개선한다.
핵심 요약
Janas-LLM은 48GB의 Qwen3-Next-80B 모델을 32GB 램의 노트북에서 실행하는 도구로, 모델 가중치를 디스크에 유지하면서 필요한 전문가(expert) 블록만 NVMe SSD에서 스트리밍한다. 같은 테스트 환경(32GB 메모리, Intel Core Ultra 9 185H, Arc 통합 GPU)에서 llama.cpp와 비교한 결과 모든 모델에서 Janas가 더 빠르며, Qwen3-Next-80B의 프롬프트 읽기 속도는 62 tok/s 대 16 tok/s, 토큰 생성은 24 tok/s 대 2.8 tok/s로 우월했다. Qwen3.5-0.8B 같은 소형 모델은 프롬프트 읽기에서 939 tok/s, 토큰 생성 130 tok/s에 도달했으며, 드래프팅 기능(다음 토큰 예측과 검증)을 활용하면 생성 속도를 최대 2배까지 높일 수 있다. 전체 요약 11문장 읽기 → 014 21:11 당일 +1,001 70B 대형언어모델을 4GB GPU에서 돌리는 AirLLM AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. AI · 머신러닝 · lyogavin/airllm · Jupyter Notebook
Key Point 소형 GPU로도 대규모 언어모델을 직접 구동할 수 있게 되면서 개인 개발자나 제한된 리소스 환경에서 최신 모델 실험이 가능해진다.
핵심 요약
AirLLM은 양자화·증류·가지치기 없이 단일 4GB GPU 카드에서 70B 규모 대형언어모델을 구동하는 추론 엔진이다. 한 번에 한 레이어만 GPU에 유지하는 방식으로 메모리 사용량을 최소화하며, Kimi K3(2.8T)는 3.72GB, DeepSeek-V3(671B)는 약 12GB, Qwen3.8-Flash-Next(125B)는 6GB에서 실행된다. 최신 버전(v3.0)은 FP8 모델을 지원하고, Llama·Qwen·DeepSeek·Phi·Gemma 등 대부분의 주요 오픈소스 LLM을 AutoModel을 통해 자동으로 감지해 지원한다. 전체 요약 11문장 읽기 → 015 18:33 새 버전 Transformers 5.19.0, 멀티모달 임베딩과 분산학습 기능 강화 Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. AI · 머신러닝 · huggingface/transformers@v5.19.0
Key Point 멀티모달 모델 지원 확대와 분산학습 병렬화 개선으로 LLM 추론 효율이 향상되며, 주요 API 변경으로 기존 코드 마이그레이션이 필요해진다.
핵심 요약
Gemma 2의 멀티모달 임베딩 모델 EmbeddingGemma2를 새로 추가했으며, 텍스트·이미지·오디오·비디오를 768차원 벡터 공간에 인코딩하고 512/256/128차원으로 축소 가능하다. MoE(Mixture of Experts) 모델이 output_router_logits=True일 때 라우터 로짓을 반환하도록 변경되었으며, 기존 코드는 새 출력 클래스에서 로짓을 읽어야 한다. OWLv2 이미지 쿼리 선택 방식이 객체 신뢰도 점수 기준으로 변경되어 기존 기능과 결과가 달라질 수 있다. 전체 요약 7문장 읽기 → 016 18:33 ▲ 422 · 댓글 46 구글, 멀티모달 임베딩 모델 'EmbeddingGemma 2' 공개 Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. AI · 머신러닝 · EmbeddingGemma 2: An open, lightweight multimodal embedding model
Key Point 온디바이스에서 텍스트·이미지·오디오·비디오를 하나의 모델로 처리할 수 있게 되어, 데이터 프라이버시를 보호하면서도 로컬에서 멀티모달 검색과 RAG를 구현할 수 있는 기반이 마련됐다.
핵심 요약
Google DeepMind이 EmbeddingGemma 2를 공개했으며, 텍스트·이미지·오디오·비디오를 통합 임베딩 공간으로 매핑하는 가볍고 고성능의 온디바이스 멀티모달 모델이다. 지난해 출시한 EmbeddingGemma는 2천만 건 이상 다운로드되어 온디바이스 검색과 프라이버시 우선 RAG 파이프라인 구축에 활용됐다. EmbeddingGemma 2는 Gemma 4 아키텍처 기반, 7억 4천만 파라미터 규모이며 Apache 2.0 라이선스로 공개된다. 전체 요약 12문장 읽기 → 017 00:11 ▲ 132 · 댓글 47 LLM 판단 vs 결정 모델, 벤치마크 결과는 기존 방식이 우위 TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. AI · 머신러닝 · Decision models like Jev don't beat LLM-as-a-judge or traditional classifiers
Key Point 신흥 기술로 주목받는 결정 모델이 실제로는 기존의 소형 분류기와 LLM 판단 방식과의 경쟁에서 우월하지 못하다는 벤치마크 결과로, AI 안전장치 선택 시 실용성을 강조하는 실증 데이터를 제공한다.
핵심 요약
TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. Red Hat 연구팀은 프롬프트 주입과 콘텐츠 안전성 두 가지 벤치마크에서 9개 안전장치를 비교 평가했다: CPU 규모 사전학습 분류기, BART-large-mnli, Shieldstral, Nemotron-3.5, Qwen3.6-35B, Laya, DiffusionGemma, Jev. 프롬프트 주입 탐지에서 Qwen3.6-35B(LLM-as-a-judge)이 89.31% 정확도로 1위, DiffusionGemma 87.72% 2위, Jev는 86.35%로 4위를 기록했다. 전체 요약 10문장 읽기 → 018 21:11 당일 +152 언어 모델 검열 자동 제거 도구 Heretic 공개 GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. AI · 머신러닝 · p-e-w/heretic · Python
Key Point 안전 필터를 우회하는 완전 자동화 도구의 등장으로, 모델 수정 기술의 접근성이 크게 낮아졌으며 이로 인한 악용 가능성 증가와 기술 민주화 사이의 균형 문제가 제기된다.
핵심 요약
GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. 사용자가 명령줄 명령만으로 모델을 처리할 수 있으며, 트랜스포머 구조 이해가 필요 없다. Gemma-3-12B-IT 기준으로 Heretic이 생성한 모델은 유해 프롬프트 거부율 3/100, KL 발산 0.16으로, 수동 절제 모델(KL 발산 0.45~1.04)보다 원래 성능을 더 잘 보존했다. 전체 요약 9문장 읽기 → 019 15:11 ▲ 46 · 댓글 2 언어모델의 성격을 자유도로 조절하는 기법 제시 activation steering에서 개입 강도를 조절하는 계수를 설정할 수 있지만, 원하는 수준의 성격 표현을 얻으려면 행동 척도가 필요하다는 문제를 다룬다. AI · 머신러닝 · Persona Dosing: Calibrated Activation Steering for Graded Trait Control
Key Point activation steering을 통한 성격 제어의 정확도 문제를 정량적으로 해결하는 실제 방법을 제시해, 대형 언어모델의 세밀한 행동 제어가 가능해진다.
핵심 요약
activation steering에서 개입 강도를 조절하는 계수를 설정할 수 있지만, 원하는 수준의 성격 표현을 얻으려면 행동 척도가 필요하다는 문제를 다룬다. PersonaDose는 특정 성격 설명과 요청한 평균 강도를 통해 언어모델을 제어하는 방식을 제시한다. 공유 controller를 성격 응답에 맞춰 특화한 후, 측정된 특성 표현에 대해 흐름 시간을 보정하는 두 단계로 작동한다. 전체 요약 8문장 읽기 → 020 12:11 ▲ 49 · 댓글 2 확산형 언어모델을 위한 텍스트 임베딩 최적화 자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. AI · 머신러닝 · Scaling and Distilling Text Embeddings for Better Diffusibility
Key Point 확산형 언어모델이 자기회귀 방식의 성능에 접근하기 위해서는 어떤 임베딩 공간이 최적인지 밝혀지지 않았는데, 이 연구가 스케일링과 증류 기법으로 그 해답을 제시한다.
핵심 요약
자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. 연구팀은 T5 계열 임베딩을 T5Gemma-1, T5Gemma-2로 확대했을 때 생성 성능이 크게 향상됨을 발견했다. 그러나 T5Gemma-2는 너무 판별력이 강해서 유사한 단어들의 임베딩까지 멀리 떨어져 있어, 샘플링 오류 시 유효한 임베딩을 찾지 못하는 문제가 발생한다. 전체 요약 7문장 읽기 → 021 09:11 ▲ 205 · 댓글 66 Jeff: 0.8B 경량 분류 모델로 30ms 만에 선택지 판단 Qwen3.5와 Gemma 4를 파인튜닝한 0.8B~2B 경량 분류 모델 Jeff를 공개했다. AI · 머신러닝 · Jeff – Jev-compatible 0.8B decision models, trained at home, ~30 ms
Key Point 경량 모델로 30ms 안에 로컬에서 고속 분류를 수행할 수 있어, API 지연 없이 의사결정 시스템을 직접 구축해야 하는 개발자에게 즉시 활용 가능한 솔루션이다.
핵심 요약
Qwen3.5와 Gemma 4를 파인튜닝한 0.8B~2B 경량 분류 모델 Jeff를 공개했다. 한 번의 순전파로 각 선택지의 보정된 확률을 반환하며, RTX PRO 6000에서 22ms, Apple M4 Max에서 28ms가 소요된다. 제로샷 분류가 가능해 학습 데이터에 없는 옵션도 자연어 설명으로 판단할 수 있다. 전체 요약 14문장 읽기 → 022 06:11 ▲ 65 · 댓글 3 LLM 추론을 위한 '불일치 양자화', 프롬프트와 생성 단계별 최적화 프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. AI · 머신러닝 · Disaggregated Quantization: Specializing LLM Prefill and Decode
Key Point LLM 추론의 Prefill과 Decode 두 단계에 서로 다른 양자화 전략을 적용해 정확도 손실 없이 처리 속도(첫 토큰까지 1.78배 단축)와 메모리 효율을 동시에 개선하는 방법론이 공개됐다.
핵심 요약
프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. 연구진은 '불일치 양자화'(Disaggregated Quantization, DQ)를 제안했으며, 이는 두 단계별로 계산 형식·가중치·저장소 배치를 특화시킨다. Qwen 3과 Gemma 3에서 Decode 단계의 활성화 양자화를 제거하면 생성 작업의 정확성이 향상되고 추론 비용은 증가하지 않는다. 전체 요약 8문장 읽기 → 023 21:11 당일 +120 Apple Silicon과 NVIDIA에서 LLM을 OpenAI 호환 API로 서빙하는 TensorFold TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. AI · 머신러닝 · ashhart/TensorFold · Python
Key Point Apple Silicon 개발자가 로컬에서 고성능 LLM 추론을 OpenAI 호환 방식으로 실행할 수 있으며, NVIDIA GPU와 동일한 API로 통일된 배포가 가능해진다.
핵심 요약
TensorFold는 Apple Silicon(MLX) 및 NVIDIA GPU에서 텍스트 모델을 OpenAI 호환 API 엔드포인트로 서빙하는 Python 기반 도구다. Nemotron 3.5 Lightning, Qwen3.8-27B, Qwen3.8 Flash Next, GLM-5.3-Flash, Gemma 4 등 여러 모델을 지원하며, 각 모델은 자체 커널과 드래프트 검증을 포함한다. MLX 백엔드는 M1~M5 칩에서 row-exact simd_qmm 디코더로 4비트/그룹64 가중치를 읽고, CUDA 백엔드는 단일 또는 2-rank 텐서 병렬 처리를 지원한다. 전체 요약 12문장 읽기 → 024 00:11 ▲ 109 · 댓글 30 LLM의 토큰 확률 읽어 단일 함수로 선택지 점수 매기기 LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. AI · 머신러닝 · A single function Jev-like wrapper for LLMs, including vision models
Key Point LLM의 로그프로브를 활용해 단 한 줄의 함수로 복잡한 다중 선택 평가를 빠르게 구현할 수 있으며, 비전 모델도 지원해 실시간 이미지 분석 애플리케이션의 선택지 점수 매김에 즉시 적용 가능하다.
핵심 요약
LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. 상태와 질문을 프롬프트로 보내고 max_completion_tokens를 1로 설정한 후 top_logprobs로 대안 토큰들의 확률을 받으면, 여러 질문이 같은 상태 접두사를 공유할 때 KV 캐시를 활용할 수 있다. 이 방식은 텍스트뿐 아니라 비전 모델과도 작동하며, 이미지를 base64로 인코딩해 전송할 수 있도록 Jev 요청 형식에 attachments 필드를 추가했다. 전체 요약 7문장 읽기 → 025 22:29 새 버전 Ollama v0.34.4 출시, 성능 개선 및 버그 수정 Structured outputs이 싱글 패스로 적용돼 사고 모델에서 더 빠르고 안정적으로 동작한다. AI · 머신러닝 · ollama/ollama@v0.34.4
Key Point 로컬 LLM 실행 환경의 가장 대중적인 도구인 Ollama의 안정성과 성능이 개선되어, 특히 Apple Silicon 사용자의 추론 속도와 안정성이 크게 향상된다.
핵심 요약
Structured outputs이 싱글 패스로 적용돼 사고 모델에서 더 빠르고 안정적으로 동작한다. 대규모 로컬 라이브러리에서 발생하던 간헐적인 '모델 미발견' 오류를 수정했다. macOS 앱이 ChatGPT나 Codex 실행 여부 확인 시 응답 없음 상태가 되는 문제를 해결했다. 전체 요약 6문장 읽기 → 026 00:10 ▲ 102 · 댓글 23 PyTorch로 직접 구현한 최신 LLM 아키텍처 학습 저장소 최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다. AI · 머신러닝 · OpenArch – PyTorch implementations of modern LLM architectures
Key Point LLM 아키텍처의 세부 설계 차이를 명확히 읽고 비교하고 싶은 개발자라면, 프로덕션 코드의 복잡성 없이 각 선택지가 어떻게 구현되는지 바로 확인할 수 있다.
핵심 요약
최신 오픈소스 LLM들의 PyTorch 구현을 처음부터 손으로 직접 작성한 저장소로, 각 모델은 원논문과 기술 보고서를 참고해 구성했다. GPT-2, Llama 2/3/4, Qwen, Mistral, DeepSeek R1 등 11개 텍스트 모델과 PaliGemma, Qwen3 등 멀티모달 모델을 구현 중이며, 추가로 72개 아키텍처 전체 구현을 목표로 한다. 주의 메커니즘(MHA, GQA, MQA, MLA), 정규화(RMSNorm, QK-Norm), 위치 인코딩(RoPE, NoPE), MoE 라우팅 등 현대 LLM들이 사용하는 구조적 선택지를 명시적으로 표현해 비교하기 쉽게 했다. 전체 요약 5문장 읽기 → 027 11:10 당일 +134 Ollama, 오픈소스 LLM 로컬 실행 플랫폼 Ollama는 Kimi-K2.6, GLM-5.2, DeepSeek, Qwen, Gemma 등 다양한 오픈소스 모델을 로컬에서 실행할 수 있는 플랫폼이다. AI · 머신러닝 · ollama/ollama · Go
Key Point 개발 팀이 LLM을 클라우드 종속 없이 로컬에서 운영하고 싶을 때 실용적인 선택지가 필요하기 때문이다.
핵심 요약
Ollama는 Kimi-K2.6, GLM-5.2, DeepSeek, Qwen, Gemma 등 다양한 오픈소스 모델을 로컬에서 실행할 수 있는 플랫폼이다. macOS, Windows, Linux 데스크톱은 물론 Docker로도 제공되며, Python과 JavaScript 라이브러리를 통해 기존 애플리케이션에 통합할 수 있다. Claude Code, Codex, Copilot CLI 등 다양한 코딩 IDE와 통합 지원하고, OpenClaw를 통해 WhatsApp, Telegram, Slack, Discord 등 메신저 앱과 연동 가능하다. 전체 요약 5문장 읽기 → 028 11:10 ▲ 143 · 댓글 53 vLLM이 AMD GPU에서 추측 디코딩 지원 vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. AI · 머신러닝 · Speculative Decoding in vLLM on AMD GPUs
Key Point LLM 추론 성능 최적화를 위한 주요 기법이 AMD GPU에서 실제 구현되어, 장기 생성 작업의 처리량 개선 가능성을 보여준다.
핵심 요약
vLLM이 추측 디코딩(speculative decoding) 기능을 AMD Instinct MI300X·MI355X GPU와 ROCm에서 구현했다. 추측 디코딩은 경량 드래프트 모듈이 여러 토큰을 먼저 제안하고 타겟 모델이 한 번에 검증하는 방식으로, 기존 자동회귀 디코딩보다 모델 통과 횟수를 줄인다. 표준 방식은 토큰 하나당 모델 실행 1회가 필요하지만, 추측 디코딩은 여러 드래프트 토큰이 검증을 통과하면 단일 모델 실행으로 여러 토큰을 커밋할 수 있다. 전체 요약 5문장 읽기 → 029 20:31 당일 +132 Unsloth, 로컬에서 LLM과 확산 모델 학습할 수 있는 데스크톱 앱 공개 로컬에서 LLM, 확산, 임베딩, 오디오 모델을 실행하고 학습할 수 있으며 Kimi K3, DeepSeek-V4, Gemma 4 등을 지원한다. AI · 머신러닝 · unslothai/unsloth · Python
Key Point 로컬 AI 모델 실행·학습을 간편하게 만드는 도구로서 개발자가 클라우드 비용 없이 자체 서버에서 LLM을 운영할 수 있게 해주는 점이 주목받고 있다.
핵심 요약
로컬에서 LLM, 확산, 임베딩, 오디오 모델을 실행하고 학습할 수 있으며 Kimi K3, DeepSeek-V4, Gemma 4 등을 지원한다. 미세조정 시 학습 속도를 2배 빠르게 하면서 VRAM 사용량을 70% 줄일 수 있고 LoRA, QLoRA, GRPO, DPO 등 다양한 훈련 방식을 지원한다. Tauri 기반 데스크톱 앱으로 제공되며 Windows, macOS, Linux 등 여러 플랫폼을 지원하고 Cloudflare를 통한 원격 접근도 가능하다.