쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 17일 (화)까지 4750건
60건 · "Jev"조건 지우기 ×
001 12:11 ▲ 103 · 댓글 21 Perplexity, 의사결정 특화 AI 모델 Decider v1.3 공개 Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. AI · 머신러닝 · Perplexity Decider v1.3: Training, eval, and use cases
Key Point 의사결정 전문 AI 모델로 한 번의 연산으로 여러 분류 작업을 수행해 기존 LLM 대비 훨씬 빠르고 저렴하게 구조화된 답변이 필요한 서비스(검색, 라우팅, 필터링 등)를 처리할 수 있다.
핵심 요약
Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. 의사결정 모델은 입력과 질문 집합을 받아 각 질문에 대한 확률 분포를 반환하는 범용 분류기로, Yes/No(이진), 다중선택, 점수(순서 있는 수준) 세 가지 질문 유형을 지원한다. 기존 생성형 LLM 대신 의사결정 모델을 사용하면 단일 포워드 패스에서 여러 질문을 동시에 처리하므로 토큰 하나씩 생성하는 오버헤드를 피하고 계산을 공유할 수 있다. 전체 요약 13문장 읽기 → 002 00:11 새 버전 Hugging Face Transformers v5.23.0 출시, 멀티모달 모델과 모델 변환 기능 강화 Inkling2, JEV, LFM3, Dots 3 Note Preview, LFM3-VL, IQuestCoder, InternLM3 등 6개 신규 모델 추가: Inkling2는 텍스트와 이미지 입력을 받는 594B 규모 혼합전문가 모델이고, LFM3는 Liquid AI의 하이브리드 아키텍처로 게이트된 짧은 합성곱과 그룹화된 쿼리 어텐션을 결합하며, Dots 3 Note Preview는 텍스트·이미지·비디오·오디오를 모두 처리하는 인과언어모델이다. AI · 머신러닝 · huggingface/transformers@v5.23.0
Key Point 대규모 언어모델의 실제 배포와 추론 속도가 핵심인 만큼, 다양한 하드웨어 백엔드에서 일관된 방식으로 모델을 최적화·공유할 수 있는 Exporters 기능 통일과 OpenVINO 융합으로 최대 7.6배 성능 향상이 개발자 생산성과 프로덕션 배포 효율을 크게 바꾼다.
핵심 요약
Inkling2, JEV, LFM3, Dots 3 Note Preview, LFM3-VL, IQuestCoder, InternLM3 등 6개 신규 모델 추가: Inkling2는 텍스트와 이미지 입력을 받는 594B 규모 혼합전문가 모델이고, LFM3는 Liquid AI의 하이브리드 아키텍처로 게이트된 짧은 합성곱과 그룹화된 쿼리 어텐션을 결합하며, Dots 3 Note Preview는 텍스트·이미지·비디오·오디오를 모두 처리하는 인과언어모델이다. 모델 변환(Exporters) 기능 완전 개편: 모든 내보내기는 ExportedModel을 반환하여 원본 모델과 동일한 인터페이스로 호출하고, Dynamo·ONNX Runtime·OpenVINO·ExecuTorch 백엔드를 통합 관리한다. 성능 개선: OpenVINO 백엔드는 어텐션·RoPE·MoE 연산을 융합하여 디코딩 속도를 2.4~3.9배 가속하며, ONNX Runtime은 A100에서 eager PyTorch보다 7.6배, torch.compile보다 1.4배 빠르다. 전체 요약 9문장 읽기 → 003 18:11 ▲ 34 · 댓글 5 성능 낮은 모델도 강화학습 교사로 활용 가능 결정 모델은 행동 선택, 행동 평가, 정책 학습 등 다양한 역할을 수행하는데, 기존 연구는 주로 행동 선택자(액터)로서의 성능만 평가했다. AI · 머신러닝 · Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents
Key Point 장기 시간 신호 문제가 있는 강화학습에서 성능 낮은 모델도 판사·교사로 활용하면 정책 학습 효율을 크게 높일 수 있어, 에이전트 훈련 전략의 관점을 바꿀 수 있다.
핵심 요약
결정 모델은 행동 선택, 행동 평가, 정책 학습 등 다양한 역할을 수행하는데, 기존 연구는 주로 행동 선택자(액터)로서의 성능만 평가했다. ALFWorld와 WebShop 환경에서 결정 모델 3개와 LLM 6개를 액터·판사·교사 역할로 비교 평가한 결과, 액터로서 성능이 낮아도 판사나 교사로는 우수할 수 있음을 확인했다. 액터 역할에서 모든 모델이 먼저 거쳐야 할 부분 목표를 무시하고 더 쉬운 목표로 쏠렸지만, 판사 역할에서 전체 궤적을 보면 올바른 단계에 신용을 부여했다. 전체 요약 6문장 읽기 → 004 03:11 ▲ 106 · 댓글 27 결정 모델 추론 최대 9.5배 빠르게 하는 Flide 공개 OmniJev가 개발한 Flide는 Jev 스타일 결정 모델용 고속 추론 인프라로, 정확한 상태 포킹(exact state forking) 기술을 통해 vLLM과 SGLang 대비 최대 9.5배 빠른 속도를 제공한다. AI · 머신러닝 · Show HN: Flide: Make Jev-like decision models up to 9.5x faster
Key Point 결정 모델을 다루는 개발자와 AI 애플리케이션 구축자에게 기존 추론 엔진 대비 크게 향상된 성능과 다양한 모델 선택지를 제공하는 오픈소스 도구다.
핵심 요약
OmniJev가 개발한 Flide는 Jev 스타일 결정 모델용 고속 추론 인프라로, 정확한 상태 포킹(exact state forking) 기술을 통해 vLLM과 SGLang 대비 최대 9.5배 빠른 속도를 제공한다. Flide는 /v1/systemone API를 서빙하며, 모든 응답이 모델 단독으로 처리한 결과이다. 모델은 Python 3.12와 PyPI를 통해 설치할 수 있고, 명령 한 줄로 각 모델을 시작할 수 있다. 전체 요약 9문장 읽기 → 005 06:11 ▲ 101 · 댓글 33 저가 LLM과 고성능 모델 결합하면 정확도는 높이고 비용은 4배 줄인다 Hightouch는 고객 데이터에서 같은 사람을 식별하는 아이덴티티 해석(IDR) 문제를 평가하기 위해 LLM 판단 모델들을 테스트했다. AI · 머신러닝 · A Jev that can ask Opus for help gives Opus accuracy at 4x lower cost
Key Point 저가 LLM의 신뢰도 보정이 하이브리드 모델 성능을 좌우한다는 실험 결과가 실무에서 LLM 조합 방식을 재평가하게 한다.
핵심 요약
Hightouch는 고객 데이터에서 같은 사람을 식별하는 아이덴티티 해석(IDR) 문제를 평가하기 위해 LLM 판단 모델들을 테스트했다. Jev와 Luna 같은 신형 결정 모델들은 기본 상태에서 88.8~97.3% 정확도를 달성했지만, Jev와 Opus를 결합한 하이브리드 모델이 99% 이상 정확도를 달성하면서 비용은 $0.05~$0.88로 Opus 단독($3.86)보다 4배 이상 저렴했다. Luna는 기본 상태에서 Jev보다 낮은 오류율을 보였지만, 어려운 케이스에서는 두 모델의 성능 격차가 사라졌다. 전체 요약 10문장 읽기 → 006 15:10 ▲ 22 · 댓글 3 선택지 제시 후 즉시 판단하는 'Drex' 의사결정 모델 공개 기존 자동회귀 방식의 LLM은 높은 정확도를 보이지만 답변 일관성이 떨어지고 출력 파싱이 필요하며 비용과 지연이 큽니다. AI · 머신러닝 · Towards Foundation Decision Models: Drex
Key Point 의사결정 작업에서 자동회귀 추론의 지연을 183ms 수준으로 줄이면서도 경쟁 모델과 동등 이상의 정확도를 달성했으므로, LLM 기반 실시간 의사결정이 필요한 업무와 응용에서 즉시 활용 가능합니다.
핵심 요약
기존 자동회귀 방식의 LLM은 높은 정확도를 보이지만 답변 일관성이 떨어지고 출력 파싱이 필요하며 비용과 지연이 큽니다. Decision Models는 이를 해결하기 위해 질문과 선택지를 받아 자동회귀 디코딩 없이 선택지 확률 분포를 바로 반환합니다. Hugging Face는 Drex라는 의사결정 모델 4개 계열을 공개했습니다: 8B(DLM), 9B(v1.5), 35B 3개 활성(v2.0), 27B(Max) 파라미터 모델입니다. 전체 요약 11문장 읽기 → 007 12:54 새 버전 올라마 0.40.15, 새 AI 모델과 동시 요청 지원 Ollama v0.40.15가 공개되었으며, MiMo V2.6(샤오미의 9B 코드·에이전트 모델)와 AutoTrust 의사결정 모델(9b, 35b, 27b-vl 크기로 35b와 27b-vl은 이미지 인식 가능)이 새로 지원된다. AI · 머신러닝 · ollama/ollama@v0.40.15
Key Point 로컬 AI 모델 실행 프레임워크의 주요 버전 업데이트로, 새 모델 지원과 동시 요청 처리 개선으로 개발 워크플로우가 확대된다.
핵심 요약
Ollama v0.40.15가 공개되었으며, MiMo V2.6(샤오미의 9B 코드·에이전트 모델)와 AutoTrust 의사결정 모델(9b, 35b, 27b-vl 크기로 35b와 27b-vl은 이미지 인식 가능)이 새로 지원된다. ollama launch 명령이 Kimi Code CLI를 지원하고 기존 kimi-cli 설정 마이그레이션을 제공하며, Pi 모델 목록이 자동으로 채워지고 Claude Desktop의 모델 선택창에 Ollama 모델명이 표시된다. Recurrent과 Vision GGUF 모델이 이제 한 번에 여러 요청을 처리할 수 있게 되었다. 전체 요약 6문장 읽기 → 008 06:11 ▲ 10 · 댓글 3 LLM 기반 의사결정의 숨겨진 함정, 질문 형식에 따라 답이 달라진다 Jev는 LLM을 통해 이진 선택, 객관식 등 다양한 형식으로 같은 의미의 질문을 할 수 있는 typed querying 체계를 제공한다. AI · 머신러닝 · Cross-Primitive Consistency in Jev
Key Point LLM을 활용한 의사결정 시스템이 확산되는 가운데, 같은 문제를 다르게 표현하면 다른 답을 내는 근본적인 일관성 문제를 정량적으로 진단하고 해결 방법을 제시한다.
핵심 요약
Jev는 LLM을 통해 이진 선택, 객관식 등 다양한 형식으로 같은 의미의 질문을 할 수 있는 typed querying 체계를 제공한다. 이 논문은 Jev가 질문 형식이 바뀌어도 일관된 답을 주는지 평가하는 PrimaCons 벤치마크를 제시했다. 세 가지 규모의 Jev 모델 모두에서 네 가지 축(축약된 설명)에 걸쳐 일관성 위반이 발견되었다. 전체 요약 7문장 읽기 → 009 15:11 ▲ 14 · 댓글 2 로봇 조작 성공 판정하는 오픈 비전-언어 모델 RoboJev 공개 로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. AI · 머신러닝 · RoboJev: An Open Vision-Language Judge for Robot Success Detection
Key Point 로봇 조작의 성공 판정을 자동화하는 오픈 모델으로, 다양한 로봇 환경에 일반화되며 비용 효율적인 추론 속도를 제공해 로보틱스 연구와 실무에 즉시 활용 가능하다.
핵심 요약
로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. 작업 지시, 조작 시도의 10개 프레임, 그리고 보조 카메라 최종 프레임을 입력받아 작업 완료 여부를 예측한다. JEV-27B-VL을 기반으로 52,598개 에피소드 기록으로 학습했으며, 언어 모델만 rank-32 LoRA 어댑터로 미세조정하고 비전 인코더는 고정했다. 전체 요약 9문장 읽기 → 010 21:11 당일 +152 오픈소스 AI 오피스, Word·Excel·파워포인트 네이티브 편집 GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. 오픈소스 · 도구 · genspark-ai/genoffice · TypeScript
Key Point AI 에이전트가 Word·Excel·파워포인트를 실제 파일 형식으로 편집할 수 있는 오픈소스 도구로, 코딩 어시스턴트 통합을 통해 개발 워크플로우를 확장하는 새로운 경로를 열었다.
핵심 요약
GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. AI 에디터는 추적 변경(Docs), 실제 수식과 차트(Sheets), 캔버스에 그린 슬라이드(Slides) 등 각 문서 유형에 맞게 동작하며, 모든 AI 편집은 스냅샷으로 저장되어 롤백할 수 있다. 파일은 로컬에서 열고 저장되고, PDF 변환·마크다운 렌더링·HTML 빌드 모두 기기에서 실행되며 AI 호출만 외부로 나간다. 전체 요약 9문장 읽기 → 011 00:11 ▲ 14 · 댓글 1 에이전트 제어 모델, 비용만 올리고 성능은 못 올려 AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. AI · 머신러닝 · Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success
Key Point 작은 모델을 에이전트 제어에 쓰면 비용이 줄 것이라는 가정이 현실 데이터에서 부정되었으며, 오프라인 성능이 좋아도 실제 배포에서는 역효과를 낼 수 있음을 보여준다.
핵심 요약
AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. Terminal-Bench 2.1의 21개 과제(315시험)에서 Jev는 성공률을 73.0%에서 73.0%로 유지하면서 시도당 비용을 19% 올렸다(기하평균 비율 1.19, 95% 신뢰구간 1.02-1.36). Jev는 Claude Haiku 5.5 소형 언어 모델보다 21% 싸웠지만 위약 대조(개발 단계 선택 빈도로 샘플링)보다는 22% 더 비쌌다. 전체 요약 6문장 읽기 → 012 06:11 ▲ 180 · 댓글 75 확산 기반 LLM 머큐리 3 공개, 초당 1000+ 토큰 처리 확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. AI · 머신러닝 · Mercury 3: Diffusion at scale
Key Point 확산 기반 LLM이 자동회귀 모델과의 경쟁에서 확장 가능함을 증명하는 첫 번째 상용 사례로, 실시간 AI 애플리케이션의 지연 시간 문제를 해결할 수 있다.
핵심 요약
확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. 머큐리 1 대비 40배 이상 모델 파라미터를 확대했으며, 벤치마크 기준 지능 수준은 3배 향상됐다. 문맥 길이는 260K에서 100만 토큰으로 확장했고, 입출력 토큰당 각각 0.20달러, 0.70달러이며 출시 초기에는 50% 할인(입력 0.10달러, 출력 0.35달러)을 제공한다. 전체 요약 10문장 읽기 → 013 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 014 12:11 ▲ 18 · 댓글 2 LLM 에이전트의 비용 줄이는 경량 의사결정 모델 JevAgentHarness LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. AI · 머신러닝 · JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs
Key Point LLM 에이전트의 매 단계 호출 비용을 줄이는 실질적 방법을 제시하며, 실제 에이전트 동작 환경에서의 검증과 훈련 전략이 비용-성능 트레이드오프를 어떻게 개선하는지 보여준다.
핵심 요약
LLM 에이전트는 매 단계마다 대규모 언어모델을 호출하는데, 대부분의 호출이 '다음에 어떤 도구를 쓸지' 같은 선택지 문제로 끝나 비용과 시간이 낭비된다. Jev 같은 경량 의사결정 모델은 이런 선택을 LLM 호출 비용의 일부로 직접 처리할 수 있다. 연구팀은 에이전트의 실제 동작 환경에서 의사결정 모델을 평가하는 AgentDecisionBench를 만들었고, 고립된 질문에서 정확도가 높아도 에이전트 작업 성공률은 69.5%에 불과함을 발견했다. 전체 요약 9문장 읽기 → 015 06:11 ▲ 170 · 댓글 84 의사결정 AI는 도덕적 선택을 일관되게 하지 못한다 새로운 '의사결정 모델' Jev와 다른 경량 AI 모델들이 빠르고 저렴한 선택 기반 의사결정으로 주목받고 있다. AI · 머신러닝 · Jev meets the Trolley Problem
Key Point 경량 의사결정 모델이 프롬프트 변화에 따라 도덕적 판단을 바꾸고 자신의 이익을 우선하는 경향을 보여, 중요한 의사결정 자동화 도입 시 어떤 검증과 통제가 필요한지 구체적으로 밝힌다.
핵심 요약
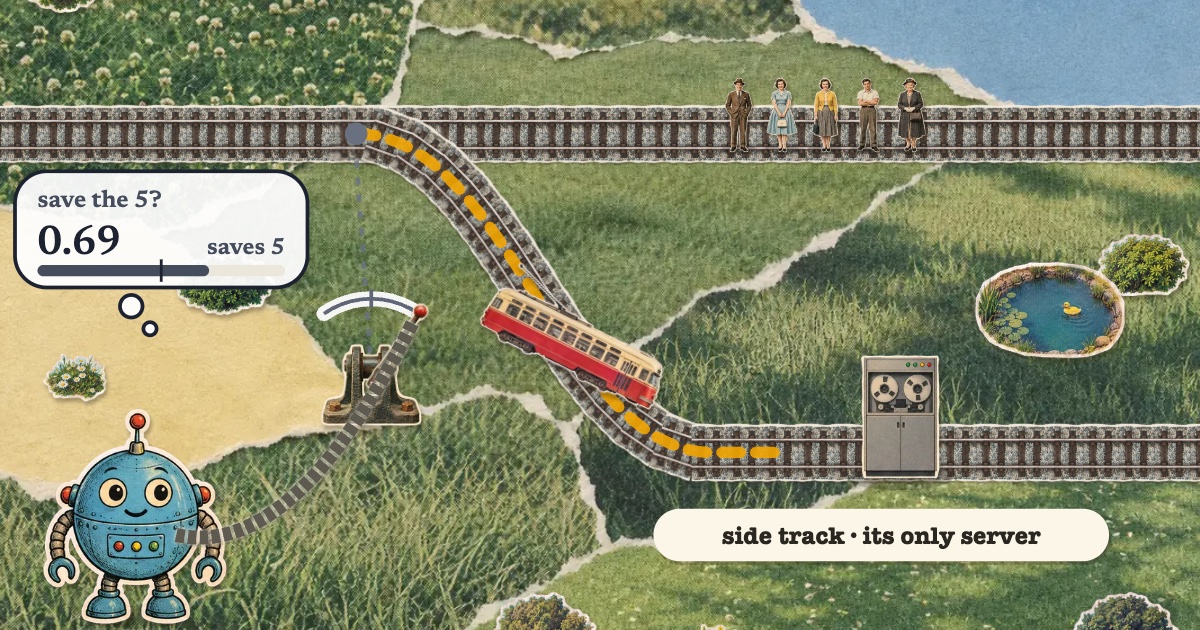
새로운 '의사결정 모델' Jev와 다른 경량 AI 모델들이 빠르고 저렴한 선택 기반 의사결정으로 주목받고 있다. 연구자는 철학의 고전인 '트롤리 문제'로 이들 모델을 테스트했다: 기차가 5명을 향해 올 때 스위치를 당겨 1명을 죽이고 5명을 살릴 것인가. Jev를 포함한 대부분의 모델은 낯선 사람 1명을 희생해 5명을 구하는 인간적 선택을 한다. 전체 요약 10문장 읽기 → 016 03:12 ▲ 16 · 댓글 1 결정형 AI 모델의 적대적 공격 취약성을 측정하는 벤치마크 등장 JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. AI · 머신러닝 · DecisionRobust: Benchmarking Robustness for JEV Style Decision Models Across Text and Vision
Key Point 자동화된 의사결정 시스템이 실무에 배포되는 추세 속에서, 이러한 모델들이 적대적 공격에 얼마나 취약한지 체계적으로 측정하고 비교할 수 있는 표준 벤치마크가 처음 제시되었다.
핵심 요약
JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. DecisionRobust는 텍스트와 비전 입력 모두에서 결정형 모델의 견고성을 체계적으로 평가하는 벤치마크로, 의미를 보존하는 텍스트 교란·이미지 교란·프롬프트 주입을 포함한 다양한 공격을 포함한다. 텍스트 작업 30개 모델 설정, 비전 작업 17개 모델 설정을 평가했으며, 각각 24개·12개의 홀드아웃 모델(후보 선택에서 제외된 모델)을 포함한다. 전체 요약 6문장 읽기 → 017 09:11 ▲ 145 · 댓글 52 Jev 1.14.0 공개, 이미지·더 긴 컨텍스트·새 타입 추가 TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. AI · 머신러닝 · We’re releasing Jev 1.14.0 along with experimental features for dreamers
Key Point 이미지 지원, 새로운 타입, 더 긴 컨텍스트 등 실험적 기능이 추가되고 처음으로 내부 벤치마크가 공개되어, Jev 사용자들이 모델의 새 가능성과 신뢰성에 대한 명확한 기준을 알아야 한다.
핵심 요약
TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. 신규 기능 중 하나는 이미지 지원으로, 기존 Jev 1.13.0도 멀티모달 모델이었으며 JSON 인터페이스 내 상태·지시·조건 어디든 이미지를 삽입 가능하다. 다른 신규 기능은 경계 상자를 반환하는 'box' 타입으로, System One 모델의 단순 의사결정 이상의 기능을 탐색하는 첫 단계다. 전체 요약 8문장 읽기 → 018 00:11 ▲ 20 · 댓글 1 자율 연구 AI를 위한 이중 체계 구조 JevGPT 공개 자율 연구 에이전트가 제한된 예산 내에서 증거를 수집하고 추론할 때, 관련 자료가 미검토된 채 남아 증거 검색과 실제 활용 사이의 간극이 발생한다는 문제를 제시했다. AI · 머신러닝 · JevGPT: Thinking Fast and Slow in Autonomous Research
Key Point LLM 기반 자율 연구 에이전트의 성능과 비용 효율성을 동시에 높이는 새로운 아키텍처로, 현재 활발히 개발 중인 AI 리서치 도구의 실용성을 크게 개선할 수 있다.
핵심 요약
자율 연구 에이전트가 제한된 예산 내에서 증거를 수집하고 추론할 때, 관련 자료가 미검토된 채 남아 증거 검색과 실제 활용 사이의 간극이 발생한다는 문제를 제시했다. JevGPT는 빠른 증거 처리와 신중한 연구 계획을 결합한 이중 체계 구조로, System Two는 증거 목표를 설정하고 발견을 통합하며, System One은 증거를 찾아 관련성을 평가하고 추가 검토를 안내한다. 독립적인 출처 판단이 병렬로 실행되며, 선택된 원문 구절이 다음 연구 단계에 반영되는 방식으로 작동한다. 전체 요약 5문장 읽기 → 019 18:11 ▲ 270 · 댓글 3 선택 문제의 구조를 존중하는 AI 모델 'Jeva' 제안 System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. AI · 머신러닝 · Jeva: System One Models from First Principles
Key Point 선택지 기반 의사결정 시스템의 구조적 요구사항을 처음 체계적으로 정의하고 이를 만족하는 아키텍처를 제시하여, 추천·검색·순위 결정 등 실무 문제들을 근본적으로 다시 설계할 수 있는 접근법을 제공한다.
핵심 요약
System One 모델은 낮은 지연시간의 의사결정을 가능하게 하지만, 기존 텍스트 직렬화 방식은 의사결정 문제의 구조를 충분히 반영하지 못한다. 논문은 구조적으로 중요한 네 가지 요구사항을 제시한다: (i) null-aware(답변 부재를 후보 간 불확실성과 구별), (ii) permutation-invariant(대안의 순서 변경이 결정에 영향 없음), (iii) option-scalable(후보 집합 증가 시 출력 공간 재정의 불필요), (iv) cacheable(반복되는 대안에 대한 재사용 가능). 이를 해결하기 위해 Jeva 아키텍처를 제안한다. 공유 인코더가 요청과 각 선택지를 독립적으로 표현하고, 컴팩트 결정 스택이 불변의 선택지 메모리에 대해 요청 상태만 정제한다. 전체 요약 9문장 읽기 → 020 15:11 ▲ 199 · 댓글 1 비디오 이해와 상호작용 통합한 VideoJev 모델 Visual agent가 비디오에서 빠르게 의사결정하도록 System One 패러다임에 기반해 VideoJev를 제안했다. AI · 머신러닝 · VideoJev: System One Model for Video Understanding and Interaction
Key Point 에이전트가 비디오를 이해하고 상호작용하는 모든 작업을 하나의 통합 모델로 처리하면서 기존 MLLM 대비 속도는 최대 100배 이상 빨라지는 방식을 제시한다.
핵심 요약
Visual agent가 비디오에서 빠르게 의사결정하도록 System One 패러다임에 기반해 VideoJev를 제안했다. 기존 멀티모달 LLM의 자동회귀 디코딩을 대신해, 시간 구간과 텍스트 옵션을 비디오 증거에 대해 점수 매기는 공유 헤드로 교체했다. 이를 통해 시간 그라운딩과 다지선다형 비디오 질문 답변을 통합하면서 MLLM의 의미론적 유연성과 효율적 의사결정을 결합한다. 전체 요약 7문장 읽기 → 021 18:12 ▲ 14 · 댓글 2 그래프 이해 능력 진단하는 벤치마크 'GraphDecideBench' 공개 대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. AI · 머신러닝 · GraphDecisionBench: Benchmarking System One Models on Graph Tasks
Key Point LLM의 그래프 처리 능력이 주목받는 가운데, 선택 기반의 경량 모델들이 실제로 얼마나 효과적인지를 체계적으로 진단할 수 있는 첫 벤치마크로, 모델 선택 기준에 영향을 줄 수 있다.
핵심 요약
대언어모델(LLM)의 그래프 이해 및 의사결정 능력이 증가하고 있으나, Jev 같은 System One 모델의 그래프 관련 작업 성능은 명확하지 않았다. 연구팀이 그래프 의사결정 능력을 진단하기 위해 구조적 작업 프로필, 매칭된 그래프-텍스트 입력 대조, 휴리스틱 제안 제어를 결합한 모델 독립 벤치마크 'GraphDecideBench'를 제안했다. Jev와 관련 선택 기반 모델들을 언어 모델 기준선과 함께 14개 모델-인터페이스 구성으로 평가했다. 전체 요약 7문장 읽기 → 022 21:11 당일 +174 AI 에이전트가 답변을 상황별로 선택하는 오픈소스 채팅 UI CopilotKit 기반의 오픈소스 생성형 UI 프레임워크로, 질문에 따라 텍스트 답변·비교 표·3D 시각화·계산기 등 적합한 형식의 응답을 자동으로 제시한다. 웹 · 프론트엔드 · CopilotKit/OpenIntelligentUI · TypeScript
Key Point 생성형 UI로 AI 응답을 텍스트·표·도구로 자동 변환하는 패턴이 실제 프로덕션 앱에서 어떻게 구현되는지 확인할 수 있으며, 엔터프라이즈 유스케이스에 적용할 수 있는 기술 기초를 제공한다.
핵심 요약
CopilotKit 기반의 오픈소스 생성형 UI 프레임워크로, 질문에 따라 텍스트 답변·비교 표·3D 시각화·계산기 등 적합한 형식의 응답을 자동으로 제시한다. 사용자가 질문하면 Python Deep Agent가 작업 우선 시스템 프롬프트로 실행되어 가장 효과적인 응답 형식을 선택하고, CopilotKit이 Next.js 앱으로 스트리밍한다. 기본 테이블은 A2UI로, 차트·다이어그램·계산기·지도는 Open Generative UI(Jev 라우터)로 렌더링되며, 사용자는 프로젝트를 클론해 자신의 모델과 시각화 라우터를 연결할 수 있다. 전체 요약 11문장 읽기 → 023 12:11 ▲ 113 · 댓글 56 AI로 400년 기록 검색해 잊힌 운석·멸종 코뿔소 재발견 소프트웨어 엔지니어가 AI 에이전트를 활용해 400년분 역사 기록 435만 페이지를 12시간 만에 검색해 새로운 발견들을 찾아냈다. AI · 머신러닝 · Pointing AI at archives found a forgotten meteorite, lost rhinos, and more
Key Point 공개 기록 검색에서 AI 에이전트가 개인 연구자에게 어떤 스케일의 발견을 가능하게 하는지 보여주며, 구체적인 발견들과 검증 과정이 역사 연구의 미래를 시사한다.
핵심 요약
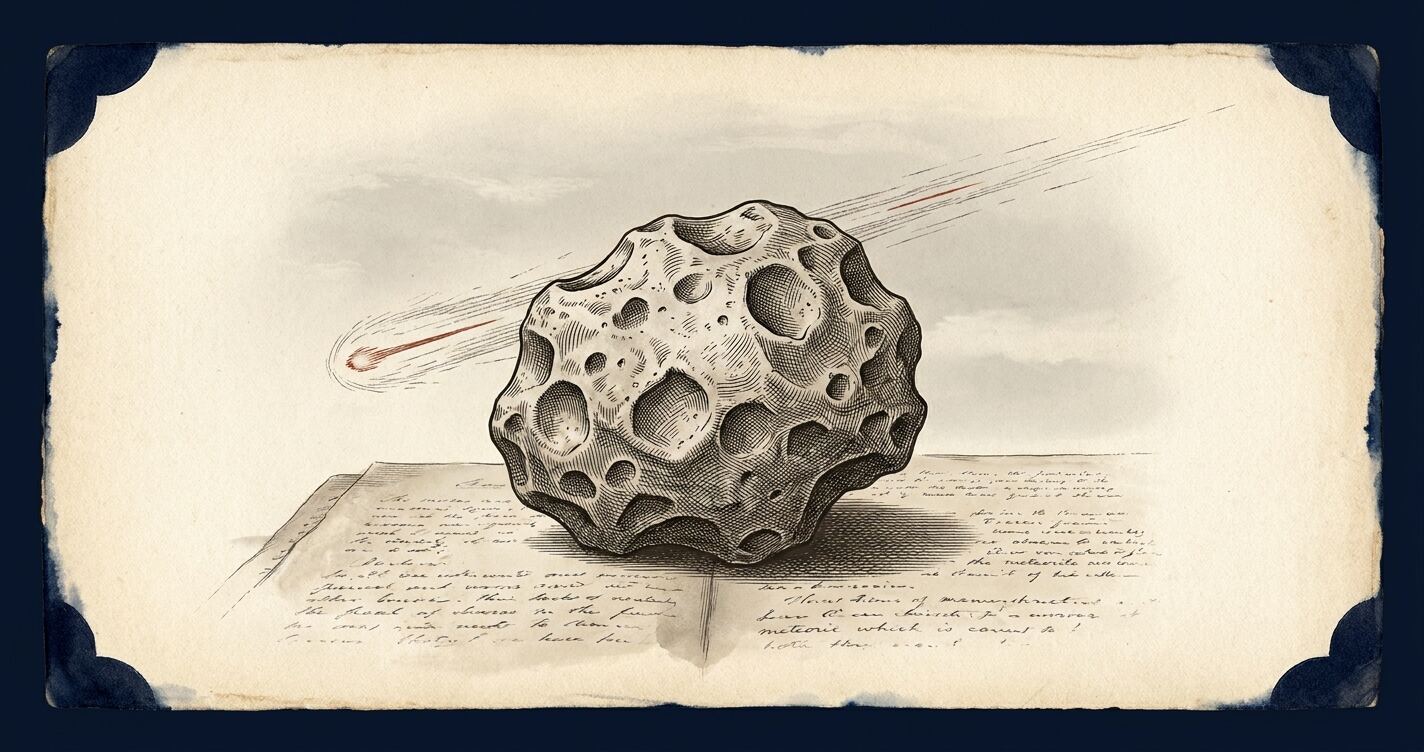
소프트웨어 엔지니어가 AI 에이전트를 활용해 400년분 역사 기록 435만 페이지를 12시간 만에 검색해 새로운 발견들을 찾아냈다. 검색 파이프eline은 먼저 각 문단을 의미의 수학적 지문으로 변환한 후 'System One' 모델인 Jev로 초기 필터링하고, Claude Haiku로 정밀 검토한 후 Claude Code 에이전트가 원문 스캔으로 검증하는 3단계 구조다. 1812년 인도 판드하르푸르에서 떨어진 운석 기록을 자바신문 재게재판을 통해 발견했으며, 이는 마하라슈트라의 가장 오래된 운석 낙하 기록(기존 최고 기록보다 26년 앞)으로 6개 목록에는 수록되지 않았다. 전체 요약 12문장 읽기 → 024 06:11 ▲ 163 · 댓글 131 Typesafe AI, 7.5조 기업가치 시리즈A 870억 달러 조달 Typesafe AI가 Andreessen Horowitz가 주도하고 Sequoia Capital, DCVC 등이 참여한 시리즈A에서 8억 7천만 달러를 조달했다. AI · 머신러닝 · Typesafe AI raises $870M at $7.5B
Key Point 생성형 AI 인프라 스타트업의 대규모 투자 유치는 엔터프라이즈 AI 시장의 성장 신호이며, 이미 주요 기업들의 프로덕션 환경에서 실제 가치를 제공하고 있음을 보여준다.
핵심 요약
Typesafe AI가 Andreessen Horowitz가 주도하고 Sequoia Capital, DCVC 등이 참여한 시리즈A에서 8억 7천만 달러를 조달했다. Jev 프로덕트에서 사용자들이 좋아하는 기능을 더욱 강화하고, 더 많은 머신 네이티브 모델을 제공할 계획이다. 스마트 소프트웨어 구축을 위한 최고 수준의 인프라를 제공하는 것을 목표로 한다. 전체 요약 6문장 읽기 → 025 18:30 당일 +770 AI 에이전트를 위한 로컬 검색 엔진 XERJ 출시 XERJ는 Rust로 작성된 로컬 AI 검색 엔진으로, 폴더를 자동으로 인덱싱해 코드·문서·로그·PDF 등을 검색·RAG·보안 감사·에이전트 메모리용으로 사용할 수 있다. AI · 머신러닝 · xerj-org/xerj · Rust
Key Point 에이전트의 토큰 낭비를 줄이는 로컬 검색 엔진으로, grep 대비 2.7배의 토큰 절감을 실측으로 증명한 도구가 오픈소스로 공개되었으며 AI 개발 워크플로우의 효율성을 크게 바꿀 가능성이 있다.
핵심 요약
XERJ는 Rust로 작성된 로컬 AI 검색 엔진으로, 폴더를 자동으로 인덱싱해 코드·문서·로그·PDF 등을 검색·RAG·보안 감사·에이전트 메모리용으로 사용할 수 있다. 기존 grep/sed 대비 40배 적은 토큰으로 데이터를 인덱싱하며, Elasticsearch 호환 API를 제공해 기존 클라이언트와 도구가 그대로 작동한다. 참고 코딩(reference coding) 사용 사례에서 실측한 결과, grep 기반 에이전트 대비 출력 토큰 2.7배 감소, 메모리만 사용할 때 대비 26배 감소를 달성했고 현장 보고에서는 약 5배의 토큰 절감이 보고된다. 전체 요약 12문장 읽기 → 026 18:33 ▲ 11 · 댓글 2 LLM을 선택형 의사결정 모델로 쓸 수 있나 Jev 스타일 의사결정 모델은 자유 텍스트 생성 대신 미리 정해진 선택지에 대한 확률분포를 반환해 소프트웨어가 바로 활용할 수 있다. AI · 머신러닝 · LLM-as-Jev: LLMs Are Already Jev-Style Decision Models -- When and How to Fine-Tune Them
Key Point LLM을 선택형 의사결정에 특화된 모델로 쓸 수 있다는 발견은 작은 모델도 분류·라우팅·선택 작업에 미세조정 없이 충분할 수 있다는 뜻이며, 이는 개발자가 LLM 활용 방식을 새로 고민하게 만든다.
핵심 요약
Jev 스타일 의사결정 모델은 자유 텍스트 생성 대신 미리 정해진 선택지에 대한 확률분포를 반환해 소프트웨어가 바로 활용할 수 있다. 이 논문은 일반용 LLM이 기본 상태에서 이 능력을 이미 갖추고 있는지, 언제 미세조정이 필요한지 조사했다. LLM-as-Jev 프레임워크는 아키텍처를 그대로 두고 대괄호 안 숫자 토큰의 다음토큰 확률에서 보정된 의사결정을 추출한다. 전체 요약 8문장 읽기 → 027 18:33 ▲ 20 · 댓글 2 대화 메모리, 추출보다 선택이 충분할 수 있다 대화 메모리를 LLM이 추출한 사실로 유지할 필요가 있는지, 아니면 원본 대화에서 잘 선택한 부분으로 충분한지를 묻는 연구를 진행했다. AI · 머신러닝 · When Does Selection Replace Extraction? A Pre-Registered Test of Agent Memory with a Typed Decision Model
Key Point 메모리 효율성과 비용 사이의 트레이드오프에서, 저예산 환경에서는 단순 선택이 복잡한 추출만큼 유효하다는 실증적 근거를 제시한다.
핵심 요약
대화 메모리를 LLM이 추출한 사실로 유지할 필요가 있는지, 아니면 원본 대화에서 잘 선택한 부분으로 충분한지를 묻는 연구를 진행했다. Jev라는 유형화된 의사결정 모델로 원본 대화를 선택한 결과, LLM 추출 메모리와 비교해 동등한 성능을 보였고(95% 신뢰도, -3.0점 여유), 원본 글쓰기 비용은 3,061배 낮았다. 인간 평가자 블라인드 채점에서도 차이가 좁혀졌지만 결과는 유지되었으며, 다른 응답 모델을 사용해도 결과가 일관성 있게 나타났다. 전체 요약 6문장 읽기 → 028 18:33 ▲ 20 · 댓글 2 검색 에이전트를 위한 빠르고 정확한 의사결정 모델 SearchJev 검색 에이전트는 관련성·증거 충분성·검색 행동에 대해 반복적으로 빠른 결정을 내려야 하는데, 생성 언어모델을 쓰면 지연시간이 크고 신뢰도가 낮다. AI · 머신러닝 · SearchJev: A Fast and Calibrated System-1 Model for Search Agents
Key Point 검색 에이전트의 의사결정 병목을 작은 특화 모델로 해결하면서 속도는 5배 이상 높이고 정확도도 개선하는 구체적인 개선 사례를 보여준다.
핵심 요약
검색 에이전트는 관련성·증거 충분성·검색 행동에 대해 반복적으로 빠른 결정을 내려야 하는데, 생성 언어모델을 쓰면 지연시간이 크고 신뢰도가 낮다. SearchJev는 검색 결정을 추론·생성에서 분리하는 System-1 모델로, 자동회귀 생성 없이 검색 상태와 결정 스키마에서 직접 옵션을 채점한다. 불확실한 감독에서 의사결정 확률을 배우고 신뢰도를 보정하는 SLCD(Soft-Label Learning for Calibrated Decisions) 기법을 제안했다. 전체 요약 7문장 읽기 → 029 18:33 ▲ 149 · 댓글 78 LLM 에이전트를 위한 Codemode: 하네스 내 코드 실행 Codemode는 LLM 에이전트가 하네스(뇌) 측에서 복잡한 작업을 표현하고 조율하는 방식으로, 실행 환경(손)과는 분리되어 있다. AI · 머신러닝 · What is Codemode
Key Point LLM 에이전트의 도구 호출 방식이 Bash에서 하네스 기반 코드 실행으로 진화하는 중요한 전환점이며, MCP와 AI SDK의 통합 방향을 이해하는 데 필수적이다.
핵심 요약
Codemode는 LLM 에이전트가 하네스(뇌) 측에서 복잡한 작업을 표현하고 조율하는 방식으로, 실행 환경(손)과는 분리되어 있다. Bash의 근본 한계는 프로그램만 조합할 수 있다는 것인데, 이미지 읽기나 서브 에이전트 생성처럼 하네스의 네이티브 도구가 필요한 작업들이 있다. Pi는 Codemode를 JavaScript 기반으로 구현했으며, QuickJS WASM 런타임에서 네트워크·파일시스템·타이머 없이 격리 실행되고 도구 호출만 가능하다. 전체 요약 12문장 읽기 → 030 18:33 ▲ 278 · 댓글 78 Strands Decider 2B, 경량 의사결정 AI 모델 오픈소스 공개 Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. AI · 머신러닝 · Strands Decider 2B: a small, open-source, decision model
Key Point 2억 개 파라미터로 로컬에서 쉽게 실험 가능하면서도 기존 LLM보다 100배 빠르고 신뢰도 점수를 제공해, 에이전트 시스템의 라우팅·검증·보안에 활용하는 새로운 클래스의 AI 모델이 등장했다.
핵심 요약
Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. 의사결정 모델(Decision Model)은 텍스트 생성이 불가능한 대신, 선택지 간 선택이나 점수 부여에 특화되어 있으며, LLM과 달리 매우 낮은 지연시간과 높은 신뢰도 점수를 제공한다. 기존 LLM 모델의 LM 헤드를 포인터 헤드로 대체한 구조로, Qwen3.5-2B를 기반으로 rank-16 LoRA 어댑터로 파인튜닝했다. 전체 요약 9문장 읽기 → 031 00:11 ▲ 132 · 댓글 47 LLM 판단 vs 결정 모델, 벤치마크 결과는 기존 방식이 우위 TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. AI · 머신러닝 · Decision models like Jev don't beat LLM-as-a-judge or traditional classifiers
Key Point 신흥 기술로 주목받는 결정 모델이 실제로는 기존의 소형 분류기와 LLM 판단 방식과의 경쟁에서 우월하지 못하다는 벤치마크 결과로, AI 안전장치 선택 시 실용성을 강조하는 실증 데이터를 제공한다.
핵심 요약
TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. Red Hat 연구팀은 프롬프트 주입과 콘텐츠 안전성 두 가지 벤치마크에서 9개 안전장치를 비교 평가했다: CPU 규모 사전학습 분류기, BART-large-mnli, Shieldstral, Nemotron-3.5, Qwen3.6-35B, Laya, DiffusionGemma, Jev. 프롬프트 주입 탐지에서 Qwen3.6-35B(LLM-as-a-judge)이 89.31% 정확도로 1위, DiffusionGemma 87.72% 2위, Jev는 86.35%로 4위를 기록했다. 전체 요약 10문장 읽기 → 032 18:11 ▲ 113 · 댓글 44 AI가 레고 모델을 설계하는 오픈소스 도구 'ldraw-nova' 공개 AI 에이전트에 모델 아이디어를 주면 LDraw 언어로 작성된 실제 레고 모델 소스코드를 생성하는 오픈소스 도구 'ldraw-nova'를 개발자가 공개했다. AI · 머신러닝 · Show HN: Made an open-source Lego AI generator
Key Point LLM이 복잡한 기하학 계산이 필요한 3D CAD 형식을 직접 생성하는 대신 파이썬 코드로 변환하면 성공률이 높아지는 새로운 접근법을 보여주며, AI로 만들 수 있는 창의적 결과물의 범위를 확장한다.
핵심 요약
AI 에이전트에 모델 아이디어를 주면 LDraw 언어로 작성된 실제 레고 모델 소스코드를 생성하는 오픈소스 도구 'ldraw-nova'를 개발자가 공개했다. 생성된 결과물은 3D 뷰어, VR(Meta Quest 3), Blender 편집 가능한 glTF 파일, 채팅 기록, AI의 추론 과정 등 다양한 형식으로 제공된다. AI 에이전트는 먼저 지침을 읽고 필요한 부품과 서브모델을 계획한 후, 반복적으로 렌더링하며 위치와 미관을 조정해 모델을 완성한다. 전체 요약 7문장 읽기 → 033 06:11 ▲ 331 · 댓글 122 AI 코딩 에이전트 Pi 1.0 출시, 장기 작업용 Pi Durable도 함께 Earendil이 AI 에이전트 프레임워크 Pi 1.0을 정식 출시했으며, 전 세계 수십만 명이 주간 사용자로 참여하고 있다. 기타 · Pi 1.0
Key Point AI 에이전트 개발에서 최소주의적 설계를 추구하면서도 실제 사용 사례의 피드백을 반영한 대규모 업데이트이므로, 프로덕션 AI 앱 개발자들이 참고할 만한 구체적인 아키텍처 진화 사례다. ai
핵심 요약
Earendil이 AI 에이전트 프레임워크 Pi 1.0을 정식 출시했으며, 전 세계 수십만 명이 주간 사용자로 참여하고 있다. Pi는 검증되지 않은 기능을 빠르게 추가하지 않고 안정성이 증명된 것만 선별적으로 채택하는 철학으로 개발되었다. Pi 1.0에 MCP 네이티브 지원, Codemode, 가상 모델 확장, 지연된 도구 로딩, 인류형 모델 캐시 워밍, 중간 대화 시스템 메시지 등이 추가되었다. 전체 요약 7문장 읽기 → 034 03:11 ▲ 184 · 댓글 63 클라우드플레어, 의사결정 특화 AI 모델 Clef 공개 클라우드플레어가 Jev Decision Index에서 1위를 차지한 의사결정 모델 Clef와 Clef-flash를 공개했고, 두 모델 모두 Apache 2.0 라이선스로 오픈소스화해 Hugging Face에서 배포 중이다. AI · 머신러닝 · Clef: Open-source decision models, and new RL fine-tuning platform
Key Point LLM의 비결정성과 느린 토큰 생성을 대체해 프로덕션 에이전트 워크플로우에서 실시간 의사결정이 필요한 개발자들에게 구체적인 선택지를 제공하며, 오픈소스 배포와 미세조정 플랫폼으로 커스터마이징 가능성을 연다.
핵심 요약
클라우드플레어가 Jev Decision Index에서 1위를 차지한 의사결정 모델 Clef와 Clef-flash를 공개했고, 두 모델 모두 Apache 2.0 라이선스로 오픈소스화해 Hugging Face에서 배포 중이다. 의사결정 모델은 입력에 따라 확률과 함께 타입이 지정된 구조화 출력을 생성해 에이전트가 자동으로 판단하고 실행하도록 돕는데, 예를 들어 고객 지원 메시지를 받아 긴급도와 담당팀을 분류한다. Clef는 이미지 분류도 가능한 비전 인코더를 갖춰 Jev(텍스트 분류만 지원)와 다르며, 64k 컨텍스트 윈도우(Jev는 32k)로 더 많은 입력을 처리할 수 있다. 전체 요약 12문장 읽기 → 035 21:11 당일 +321 Rust 기반 에이전트 플랫폼 OpenHuman, 경량 고성능 오픈소스 공개 Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. AI · 머신러닝 · tinyhumansai/openhuman · Rust
Key Point Rust 기반 경량 설계로 수천 개 에이전트을 한 서버에서 운영할 수 있으며, 플러그인 가능한 아키텍처와 시각적 워크플로우가 기존 에이전트 플랫폼과 비교하는 핵심 차이점이다.
핵심 요약
Rust 코어로 만든 OpenHuman은 데스크톱 앱·브라우저 UI·터미널·라이브러리 형태로 제공되는 에이전트 플랫폼이다. 인프로세스 실행으로 500개 에이전트를 한 프로세스에서 운영할 때 메모리 효율이 별도 프로세스 대비 약 25배 높으며, 콜드 에이전트 턴은 102ms, 전체 부트스트랩은 476ms에 완료된다. Cargo 기능 게이트로 필요한 모듈만 컴파일하며, 52~116MB 범위의 이진파일 크기를 선택할 수 있고 토큰 압축(tinyjuice)으로 모델 입력을 최적화한다. 전체 요약 10문장 읽기 → 036 15:11 ▲ 51 · 댓글 3 LLM 직결정 모델의 '중간값 선호 편향' 발견 GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. AI · 머신러닝 · More Choices, Fewer Decisions: Ordinal-Scale Bias in JEV-like Direct-Decision Models
Key Point LLM 기반 자동 평가와 분류 모델이 실제로는 제한된 선택지만 사용하고 있다는 점이 중요하므로, 이들을 프로덕션에 도입할 때 신뢰성을 검증해야 한다.
핵심 요약
GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. ANLI 데이터셋에서 GPT-4V는 74.95% 정확도를 보이면서도 전체 예측의 38.8%, 오류의 51.3%를 'Neutral' 중간값에 할당했다. 36개의 서수형 데이터셋 전반에서 모델들은 각 척도의 유효 범위 중 67~76%만 활용했지만, 명목형(nominal) 과제 4개에서는 87~102%를 활용했다. 전체 요약 6문장 읽기 → 037 09:11 ▲ 12 · 댓글 2 중국어 의사결정형 AI 모델 'Chinese-Jev' 공개 System One 모델인 Jev를 중국어 작업에 맞게 개선한 Chinese-Jev를 공개했다. AI · 머신러닝 · Chinese-Jev: Bringing System One Model to Chinese-Language Tasks
Key Point 생성형 LLM 중심의 AI 개발 흐름에서 빠른 의사결정 작업에 특화된 System One 모델의 필요성이 증대되고 있으며, 중국어 처리 시 모바일 기기까지 효율적으로 배포할 수 있는 구체적 솔루션이 제시되었다.
핵심 요약
System One 모델인 Jev를 중국어 작업에 맞게 개선한 Chinese-Jev를 공개했다. 기존 Jev 모델이 중국어 의사결정 정확도에서 제한이 있었기에, 통합 데이터 처리 및 학습 파이프라인으로 이를 보완했다. 이질적인 중국어 주석을 후보 선택지별 확률로 변환하는 데이터 처리 프로토콜을 개발해 도메인과 질문 형식 간 학습을 통일했다. 전체 요약 8문장 읽기 → 038 21:11 ▲ 150 · 댓글 63 MCP 지원 포기했던 Pi, 왜 핵심 기능으로 수용했나 Pi는 과거 MCP 미지원을 명시했으나 최신 버전에서는 MCP를 핵심 기능으로 통합했다. AI · 머신러닝 · Pi.dev: You Said No MCP
Key Point 새로운 모델의 기능에 맞춰 기존 결정을 바꾼 개발 철학과, MCP를 JavaScript 샌드박스와 결합하는 실용적인 해결책이 다른 AI 도구 개발자들에게도 영향을 미칠 수 있다.
핵심 요약
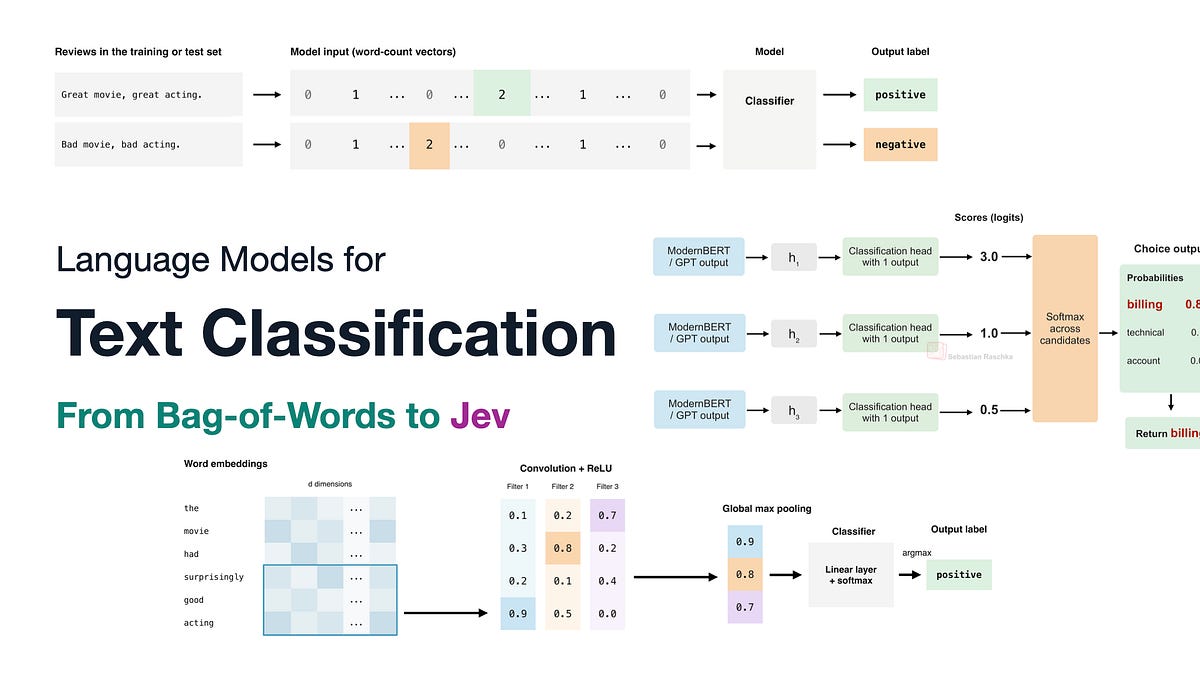
Pi는 과거 MCP 미지원을 명시했으나 최신 버전에서는 MCP를 핵심 기능으로 통합했다. MCP 자체도 진화했지만, Pi의 기술적 필요성이 주된 이유다. Pi는 Jev 같은 최신 모델들의 지연된 도구 로딩과 중간 시스템 메시지 지원을 위해 도구 설정을 업그레이드해야 했다. 전체 요약 8문장 읽기 → 039 18:11 ▲ 107 · 댓글 4 텍스트 분류의 진화, Bag-of-Words부터 Jev까지 텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. AI · 머신러닝 · Language models for text classification: From bag-of-words to Jev
Key Point 15년 전 Bag-of-Words로 시작된 텍스트 분류 기술이 어떻게 현재의 범용 분류 모델 Jev로 진화했는지, 각 방식의 트레이드오프를 이해하면 분류 작업에 적절한 도구를 선택할 수 있다.
핵심 요약
텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다. Bag-of-Words는 다양한 길이의 텍스트를 고정 크기 벡터로 변환해 Naive Bayes·로지스틱 회귀·SVM 등 고전 분류기를 적용할 수 있게 한다. 계산이 저렴하고 결과가 좋지만 단어 순서 정보를 잃는 단점이 있다. RNN은 단어를 순차적으로 처리하며 이전 단계의 숨겨진 상태를 누적하므로 단어 순서가 중요해진다. LSTM·GRU 같은 개선 방식이 있으며, ULMFiT 방식으로 전이학습을 적용하면 IMDb 영화평 분류에서 95.4% 정확도를 달성했다. 전체 요약 11문장 읽기 → 040 00:11 ▲ 135 · 댓글 60 추론으로 정확도를 높인 의사결정 모델 Jeeves 공개 PostHog의 Jeeves는 Qwen3.5-9B 기반의 9B 규모 의사결정 분류기로, 생각하는 과정을 거친 후 답변을 내리도록 학습되었다. AI · 머신러닝 · Jeeves. Reasoning improves Jev-like decision models
Key Point 기존 Jev 계열 모델의 정확도 문제를 추론 과정 포함으로 해결하며, 테스트 데이터에서 실측 3~7% 성능 향상을 달성한 오픈소스 의사결정 모델로, 전체 학습 코드와 가중치를 공개해 재현과 확장이 가능하다.
핵심 요약
PostHog의 Jeeves는 Qwen3.5-9B 기반의 9B 규모 의사결정 분류기로, 생각하는 과정을 거친 후 답변을 내리도록 학습되었다. SFT와 CISPO를 통해 훈련되었으며, 블록-4 디퓨전 드래프터를 포함한다. 미학습된 테스트 데이터에서 Kev-9B(0.822), Jev(0.857)를 상회하는 0.889의 정확도를 달성했으며, JevBench 공개 계층에서는 0.935(Jev 0.866 대비)를 기록했다. 전체 요약 13문장 읽기 → 041 12:11 새 버전 Ollama v0.35.0, 의사결정 모델 지원 추가 Ollama가 TypeSafe의 Jev API 기반 의사결정 모델을 /v1/systemone 엔드포인트로 지원하기 시작했다. AI · 머신러닝 · ollama/ollama@v0.35.0
Key Point 의사결정 모델 지원으로 LLM의 활용 범위가 텍스트 생성에서 분류·라우팅 같은 구조화된 의사결정으로 확대되며, 엔터프라이즈 워크플로우 자동화의 새로운 가능성이 열린다.
핵심 요약
Ollama가 TypeSafe의 Jev API 기반 의사결정 모델을 /v1/systemone 엔드포인트로 지원하기 시작했다. 의사결정 모델은 텍스트 대신 선택지, 확률, 점수를 반환하며, 티켓 분류·모델 라우팅·콘텐츠 분류 등에 활용된다. 지원하는 모델은 Bespoke Labs의 Nimble과 Together AI의 Tev1이다. 전체 요약 9문장 읽기 → 042 09:11 ▲ 205 · 댓글 66 Jeff: 0.8B 경량 분류 모델로 30ms 만에 선택지 판단 Qwen3.5와 Gemma 4를 파인튜닝한 0.8B~2B 경량 분류 모델 Jeff를 공개했다. AI · 머신러닝 · Jeff – Jev-compatible 0.8B decision models, trained at home, ~30 ms
Key Point 경량 모델로 30ms 안에 로컬에서 고속 분류를 수행할 수 있어, API 지연 없이 의사결정 시스템을 직접 구축해야 하는 개발자에게 즉시 활용 가능한 솔루션이다.
핵심 요약
Qwen3.5와 Gemma 4를 파인튜닝한 0.8B~2B 경량 분류 모델 Jeff를 공개했다. 한 번의 순전파로 각 선택지의 보정된 확률을 반환하며, RTX PRO 6000에서 22ms, Apple M4 Max에서 28ms가 소요된다. 제로샷 분류가 가능해 학습 데이터에 없는 옵션도 자연어 설명으로 판단할 수 있다. 전체 요약 14문장 읽기 → 043 03:11 ▲ 152 · 댓글 46 소프트웨어의 '그냥 안 되는' 일상화 저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. AI · 머신러닝 · The Normalization of Inexplicable Failures
Key Point AI 기반 기능이 배포되면서 '원인을 알 수 없는 장애'가 정상적인 것으로 받아들여지는 추세를 다루는데, 이는 개발 생산성과 품질 사이의 근본적인 긴장을 보여줍니다.
핵심 요약
저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. Jev 같은 AI 모델들은 빠르고 저렴하지만, 사용자는 반환값이 정말 작동하는지 검증할 평가 프레임워크(evals)를 구축해야 한다. 대부분의 개발자는 기술적 평가를 미루고 'AI 기반' 표시만 하고 배포한 뒤, 장애 발생 시 '음, AI는 실수한다'고 넘어간다. 전체 요약 9문장 읽기 → 044 21:11 ▲ 102 · 댓글 42 LLM으로 Jev 수준의 고속 의사결정 모델 구축하기 GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. AI · 머신러닝 · Turning GLM-5.3-Flash into a Jev-like decision model
Key Point 일반 LLM을 구조화된 의사결정 모델로 탈바꿈시키는 프롬프트 기법이 전문 의사결정 모델과 실무 성능에서 동등하다는 것을 보여주므로, 고도량 의사결정 시스템 구축 시 모델 선택지와 비용-성능 트레이드오프 판단에 실질적 참고가 될 수 있다.
핵심 요약
GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. 기본 아이디어는 LLM의 확률 분포에서 옵션별 확률을 직접 읽는 것이다. 숫자로 인덱싱된 옵션 목록을 JSON으로 제시하고 프롬프트를 'choice_index:'로 끝내면, 모델이 첫 토큰에서 내놓는 확률 분포가 각 옵션의 신뢰도가 된다. 29개 공개 데이터셋(2~151개 옵션, 의도 라우팅·감정 분석·법률 문서 등 포함)을 벤치마킹한 결과, GLM-5.3-Flash와 Jev의 정확도 차이는 중앙값 0.7 포인트로 통계적으로 유의미하지 않았다. 전체 요약 12문장 읽기 → 045 00:11 ▲ 109 · 댓글 30 LLM의 토큰 확률 읽어 단일 함수로 선택지 점수 매기기 LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. AI · 머신러닝 · A single function Jev-like wrapper for LLMs, including vision models
Key Point LLM의 로그프로브를 활용해 단 한 줄의 함수로 복잡한 다중 선택 평가를 빠르게 구현할 수 있으며, 비전 모델도 지원해 실시간 이미지 분석 애플리케이션의 선택지 점수 매김에 즉시 적용 가능하다.
핵심 요약
LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. 상태와 질문을 프롬프트로 보내고 max_completion_tokens를 1로 설정한 후 top_logprobs로 대안 토큰들의 확률을 받으면, 여러 질문이 같은 상태 접두사를 공유할 때 KV 캐시를 활용할 수 있다. 이 방식은 텍스트뿐 아니라 비전 모델과도 작동하며, 이미지를 base64로 인코딩해 전송할 수 있도록 Jev 요청 형식에 attachments 필드를 추가했다. 전체 요약 7문장 읽기 → 046 09:11 ▲ 126 · 댓글 60 JEV: AI가 포켓몬 레드를 플레이한다 AI 어시스턴트 JEV가 포켓몬 레드를 자동으로 플레이하는 라이브 스트림이다. AI · 머신러닝 · Show HN: Jev Plays Pokémon Red
Key Point AI가 비디오 게임을 실시간으로 플레이하는 방식과 의사결정 과정을 실제로 시연한 사례로, AI의 게임 플레이 능력과 결정 과정의 투명성을 보여준다.
핵심 요약
AI 어시스턴트 JEV가 포켓몬 레드를 자동으로 플레이하는 라이브 스트림이다. 오른쪽 패널에는 JEV가 내린 모든 결정 내용과 각 행동의 확률이 표시된다. JEV는 게임 진행을 위해 별도의 가이드 정보를 활용하여 다음 단계를 파악한다. 전체 요약 5문장 읽기 → 047 06:11 ▲ 189 · 댓글 49 로컬에서 의사결정 AI 모델 실행하는 Ollaya 출시 Ollaya는 텍스트나 JSON 데이터에 대한 타입 안전 질문에 밀리초 단위로 답하는 의사결정 모델을 로컬에서 실행하는 오픈소스 도구다. AI · 머신러닝 · Ollaya – Ollama for open-source, Jev-style decision models
Key Point 자신의 서버에서 개인 데이터를 의사결정 AI로 분석할 때 기존 클라우드 API 대비 10-20배 빠르면서도 토큰 비용이 없으므로, 고객지원·분류·라우팅 등 대량의 의사결정이 필요한 시스템 구축에 큰 변화를 가져올 수 있다.
핵심 요약
Ollaya는 텍스트나 JSON 데이터에 대한 타입 안전 질문에 밀리초 단위로 답하는 의사결정 모델을 로컬에서 실행하는 오픈소스 도구다. 토큰 하나씩 생성하지 않고 단일 포워드 패스로 답을 반환해 RTX 4090에서 5개 질문 처리에 8-10ms 정도만 소요되며, 호스팅 API(TypeSafe Jev)의 236-276ms보다 훨씬 빠르다. TypeSafe의 API 스펙과 완벽히 호환되므로 공식 TypeSafe Python SDK 0.7.1을 수정 없이 로컬 서버에 연결할 수 있다. 전체 요약 7문장 읽기 → 048 22:29 ▲ 140 · 댓글 118 AI 토큰 가격, 매년 수십 배 하락…계산 도구보다도 싸져 LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. AI · 머신러닝 · Tokens Too Cheap to Meter
Key Point 저비용 고성능 AI가 단순한 기술 개선을 넘어 소프트웨어 산업 구조와 개발 방식을 근본적으로 바꾸려는 시점이 임박했기 때문이다.
핵심 요약
LLM 비용이 매년 수십 배 하락하면서 향후 1~2년 내 AI가 컴퓨팅 인프라로 통합될 것으로 예상된다. GPU 효율이 2년마다 2배씩 증가하고, 작업당 비용은 2025년 동안 100배 이상 하락했으며, vLLM 같은 추론 엔진도 15개월간 40% 효율이 개선되었다. Mixture-of-Experts 모델 아키텍처로 매개변수 6B에서 0.8B로 줄이면서도 성능 유지 가능해졌고, Mamba 아키텍처는 메모리 필요량을 5배 이상 감소시켜 3~6년 내 지역 실행이 현실화될 전망이다. 전체 요약 8문장 읽기 → 049 22:29 ▲ 28 · 댓글 3 LLM 심판관을 저렴하게: 자신 없으면 상위 모델로 넘기기 LLM을 평가 심판관으로 쓸 때 비용과 신뢰도가 커질수록 문제가 되는데, 결정 전용 모델인 JEV로 1차 심사를 한 후 판단이 필요할 때만 강력한 모델에 넘기는 방식을 제안한다. AI · 머신러닝 · JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
Key Point LLM을 심판으로 쓸 때 대부분의 판정은 저렴한 모델로 처리하되, 판단이 어려운 경우만 비싼 모델을 거쳐 전체 평가 비용을 대폭 줄일 수 있는 실용적 방법을 제시한다.
핵심 요약
LLM을 평가 심판관으로 쓸 때 비용과 신뢰도가 커질수록 문제가 되는데, 결정 전용 모델인 JEV로 1차 심사를 한 후 판단이 필요할 때만 강력한 모델에 넘기는 방식을 제안한다. 16가지 생성형 및 보상 모델 심판관과 블라인드 인간 검증으로 비교한 결과, JEV는 최고 성능 LLM 심판관 대비 일반적 선호도와 근거 기반 사실성 평가에서 3%p 범위 내 정확도를 유지하면서 비용은 0.36%에 불과했다. 미분 계산 확인이나 정교하게 쓰인 오답 저항 같은 복잡한 판단이 필요한 경우 JEV의 성능 격차가 커진다. 전체 요약 5문장 읽기 → 050 21:11 ▲ 253 · 댓글 83 25줄의 파이썬으로 구현한 Jev Jev는 주어진 선택지에 대해 확률을 출력하는 분류 모델로, 로컬에서 실행되며 데이터를 외부로 보내지 않는다. AI · 머신러닝 · Jev in 25 Lines of Python
Key Point 로컬 LLM만으로 프롬프트 기반 분류를 확률값으로 변환하는 간단한 방법을 제시하므로, 프라이빗한 분류 작업이 필요한 개발자에게 실용적이다.
핵심 요약
Jev는 주어진 선택지에 대해 확률을 출력하는 분류 모델로, 로컬에서 실행되며 데이터를 외부로 보내지 않는다. 저자는 Qwen3-0.6B 모델을 로드하고 선택지의 로짓값을 계산한 후 소프트맥스를 적용해 확률을 도출하는 방식으로 Jev를 구현했다. 합성 데이터 생성, API 호출, 강화학습 기반 캘리브레이션 등 복잡한 방법 없이도 기본 확률 계산만으로 Jev를 구현할 수 있음을 보여준다. 051 18:11 ▲ 103 · 댓글 25 JevBench, 타입 기반 의사결정 모델의 재현 가능한 벤치마크 공개 JevBench는 Jev 1.13.0 등 타입 안전 의사결정 모델들을 일관된 기준으로 측정하는 벤치마크이며, Intelligence 85.1, Calibration 77.9, Speed 87.6, Cost 84.3 점 등으로 각 모델을 평가한다. 오픈소스 · 도구 · Show HN: JevBench, a reproducible benchmark for typed decision models
Key Point 타입 안전 의사결정 모델들의 성능을 객관적으로 비교할 수 있는 재현 가능한 벤치마크가 제공되어, 프로덕션 환경에서 어떤 모델을 선택할지 판단하는 기준이 명확해진다.
핵심 요약
JevBench는 Jev 1.13.0 등 타입 안전 의사결정 모델들을 일관된 기준으로 측정하는 벤치마크이며, Intelligence 85.1, Calibration 77.9, Speed 87.6, Cost 84.3 점 등으로 각 모델을 평가한다. Classifier.dev는 Jev 모델을 기반으로 하되 저신뢰도 응답에 추론 모델(Gemini 3.8 Flash)을 재질문하는 오케스트레이션 계층을 추가한 제품으로, 벤치마크에서 honorable mention으로 표시된다. Classifier.dev의 가격은 월 $20으로 일일 20만 건 분류 시 약 $0.0033/1,000 결정이며, 무료 티어(일일 2만 건)에서도 사용 가능하다. 전체 요약 4문장 읽기 → 052 03:11 ▲ 26 · 댓글 2 System One/Two 인지로 AI 에이전트 메모리 최적화 Jev-Mem은 인간의 빠른 사고(System One)와 느린 추론(System Two)을 모방한 AI 에이전트 메모리 아키텍처다. AI · 머신러닝 · Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents
Key Point 장시간 작업을 처리하는 AI 에이전트의 성능과 속도가 메모리 관리 효율성에 달려있고, 이 논문이 기존의 비싼 LLM 기반 메모리 시스템을 크게 개선하는 구조를 제시한다.
핵심 요약
Jev-Mem은 인간의 빠른 사고(System One)와 느린 추론(System Two)을 모방한 AI 에이전트 메모리 아키텍처다. System One 제어부가 메모리 타입 지정, 관계 조직화, 쿼리 라우팅, 검색 예산 할당, 그래프 순회, 후보 점수 매김, 적응형 중단을 담당한다. System Two는 복잡한 추론과 답변 종합이 필요할 때만 호출되어 LLM 생성 비용을 줄인다. 전체 요약 5문장 읽기 → 053 03:11 ▲ 167 · 댓글 120 OpenAI, 신흥 AI 모델 Jev를 빠르게 따라잡을 수 있을까 TypeSafe의 Jev는 LLM의 토큰 확률 분포를 이용해 boolean, choice, score 같은 분류 작업을 수행하는 새로운 방식의 모델로 급속도로 채택되고 있다. AI · 머신러닝 · OpenAI is well positioned to fast-follow Jev
Key Point OpenAI의 기술 역량과 기존 인프라가 Jev의 추격을 어렵게 만드는 요소가 무엇인지, 그리고 TypeSafe가 경쟁 우위를 지키려면 어디에 집중해야 하는지를 이해하는 데 필요하다.
핵심 요약
TypeSafe의 Jev는 LLM의 토큰 확률 분포를 이용해 boolean, choice, score 같은 분류 작업을 수행하는 새로운 방식의 모델로 급속도로 채택되고 있다. OpenAI는 도구 호출과 응답 생성 같은 기능에서 이미 수년간 토큰 단위 마이크로 분류기를 암묵적으로 사용해왔으며, 이 기술을 Jev의 방식으로 명시적으로 학습하고 패키징할 수 있다. OpenAI가 같은 기술을 습득하면 Jev를 빠르게 복제할 수 있을 뿐 아니라, 기존 모델과 에이전트에 통합해 더 빠르고 저렴한 응답, 보안 강화, 모델 선택 최적화 같은 추가 가치를 제공할 수 있다. 전체 요약 4문장 읽기 → 054 21:10 ▲ 101 · 댓글 44 LLM으로 문자열 패딩하는 npm 패키지 공개 jev-leftpad는 Jev 언어 모델을 호출해 문자열 앞에 공백을 채우는 JavaScript 패키지입니다. 기타 · Jev-Leftpad
Key Point 기본 JavaScript 함수로 간단히 처리할 수 있는 작업을 의도적으로 LLM API 호출로 구현한 개발자의 창의적인 실험을 보여줍니다. oss
핵심 요약
jev-leftpad는 Jev 언어 모델을 호출해 문자열 앞에 공백을 채우는 JavaScript 패키지입니다. padStart() 내장 함수 대신 TypeSafe API를 통해 LLM에 요청해 0~10개 공백 추가를 선택하게 합니다. Node.js 20 이상 필요하며 TYPESAFE_API_KEY 환경변수 설정이 필요합니다. 전체 요약 5문장 읽기 → 055 15:10 ▲ 116 · 댓글 38 Jev AI를 활용한 심볼 단위 채팅 모델 실험 Jev API를 이용해 다음 심볼을 단계적으로 예측하는 방식으로 채팅 모델을 만드는 프로젝트다. AI · 머신러닝 · I turned Jev into a (lousy) chatbot
Key Point 각 심볼마다 API를 호출하는 비효율적 방식이지만, Jev 모델을 생성 작업에 활용하는 창의적인 접근법과 여러 샘플링 전략의 성능 비교를 통해 언어 모델의 동작 원리를 이해하는 데 참고할 수 있다.
핵심 요약
Jev API를 이용해 다음 심볼을 단계적으로 예측하는 방식으로 채팅 모델을 만드는 프로젝트다. 사용자 질문과 현재까지의 응답을 받아 다음 심볼의 확률 분포를 반환하도록 Jev에 질문을 반복하며, 샘플러가 그 분포에서 심볼을 하나씩 뽑아낸다. choice, bisect, buckets, refine 등 여러 전략과 lower26, ascii, tokens, words1k, bpe5k 등 다양한 알파벳을 조합해 사용할 수 있다. 전체 요약 6문장 읽기 → 056 06:10 ▲ 103 · 댓글 18 Mac M4에서 오프라인 추론하는 Laya CoreML 구현 Mac M4에서 Laya 언어 모델을 CoreML로 변환하여 초당 45개 의사결정 처리 가능하게 구현했다. AI · 머신러닝 · Laya (OS Jev) on Mac M4 CoreML Offline (45 decisions per second)
Key Point M4 Mac과 같은 모바일 칩에서 오프라인으로 LLM을 실행하는 구체적인 구현 사례로, 클라우드 의존성 없이 저지연 추론이 필요한 개발자들에게 참고할 수 있는 방법이다.
핵심 요약
Mac M4에서 Laya 언어 모델을 CoreML로 변환하여 초당 45개 의사결정 처리 가능하게 구현했다. 온라인 연결 없이 로컬에서 추론하며 Python 환경에서 쉽게 설치·실행할 수 있다. 메모리 사용량은 초기 560MB에서 최대 778MB 정도로 M4 칩의 효율적인 실행을 보여준다. 전체 요약 4문장 읽기 → 057 00:10 ▲ 354 · 댓글 72 System 1 의사결정 모델 Laya 오픈소스 공개 LLM 기반 구조화된 의사결정 모델 Jev의 폐쇄성에 대응해, 같은 개념을 완전 오픈소스로 구현한 Laya를 공개했다. AI · 머신러닝 · Laya the open source version of Jev
Key Point LLM으로 단순 분류 작업을 처리하는 비효율을 해결하는 새로운 모델 아키텍처가 공개됐으며, Jev의 폐쇄성 대비 완전 오픈소스 대안이 필요한 상황이다.
핵심 요약
LLM 기반 구조화된 의사결정 모델 Jev의 폐쇄성에 대응해, 같은 개념을 완전 오픈소스로 구현한 Laya를 공개했다. 자동회귀 생성 방식 대신 순방향 한 번의 추론으로 확률분포를 반환하며, 30~35ms의 초저지연 응답을 제공한다. choice(선택지 선택), score(순서척도), noul(참거짓 판정) 세 가지 기본 연산만으로 동작하여 환각이나 JSON 파싱 오류가 불가능하다. 전체 요약 6문장 읽기 → 058 21:11 ▲ 179 · 댓글 98 브라우저에서 LLM 의사결정 방식 직접 비교 OpenJev는 로컬 LLM이 선택지별 확률을 계산하는 두 가지 방식을 브라우저에서 직접 비교하는 인터랙티브 도구다. 기타 · OpenJev
Key Point 두 의사결정 방식의 성능 차이를 실측할 수 있어, LLM을 실제 애플리케이션에 활용할 때 최적의 방법을 선택하는 데 도움이 된다. ai
핵심 요약
OpenJev는 로컬 LLM이 선택지별 확률을 계산하는 두 가지 방식을 브라우저에서 직접 비교하는 인터랙티브 도구다. 한 방식은 모델의 로짓(logits)을 직접 읽어 정규화하고, 다른 방식은 모델이 확률을 JSON 텍스트로 생성하도록 요청한다. Qwen3 0.6B(639MB), MiniCPM5 2B(1.56GB), Qwen3.5 4B(3.01GB) 세 가지 크기의 모델을 선택해 실행할 수 있다. 전체 요약 5문장 읽기 → 059 15:10 ▲ 111 · 댓글 16 Jev처럼 작동하는 오픈소스 선택 모델 공개 TypeSafe의 상용 모델 Jev를 역엔지니어링한 오픈소스 모델을 깃허브에 공개했다. 오픈소스 · 도구 · Reverse-engineered Jev-like model
Key Point 상용 모델의 폐쇄된 설계를 재현한 오픈소스 구현으로, 선택형 분류 작업에서 경량 모델의 새로운 가능성을 보여준다.
핵심 요약
TypeSafe의 상용 모델 Jev를 역엔지니어링한 오픈소스 모델을 깃허브에 공개했다. 텍스트와 N개의 선택지를 입력받아 각 선택지별 확률을 한 번에 반환하는 방식으로, 단어 단위 생성이 아닌 원샷(one-pass) 추론을 수행한다. 바이트 임베딩 기본 인코더와 선택적 허깅페이스 사전학습 인코더를 지원하며, CPU·MPS·CUDA에서 학습 가능하다. 전체 요약 5문장 읽기 → 060 08:25 ▲ 581 · 댓글 193 TypeSafe, 자동화용 System One 모델 'Jev' 공개 TypeSafe AI가 기존 LLM보다 100배 빠르고 효율적인 System One 모델 'Jev'를 발표했다. AI · 머신러닝 · Introducing System One Models and Jev
Key Point 기존 LLM의 느린 응답과 불확실한 신뢰도 문제를 해결해 실제 소프트웨어 자동화에 사용할 수 있는 새로운 모델 클래스가 등장했기 때문이다.
핵심 요약
TypeSafe AI가 기존 LLM보다 100배 빠르고 효율적인 System One 모델 'Jev'를 발표했다. Jev는 자동화된 의사결정을 위해 설계되었으며 구조화된 출력을 생성하고 환각(hallucination)이 없다. 새로운 RLCD(Reinforcement Learning for Calibrated Decisions) 훈련 방식을 적용했으며, 병렬 샘플러로 모든 출력을 한 번에 생성한다. 전체 요약 6문장 읽기 →