쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
57건 · "arXiv"조건 지우기 ×
001 15:11 ▲ 43 · 댓글 3 대화하며 실시간 응답하는 AI 모델 Duo 공개 Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. AI · 머신러닝 · Duo: A Reciprocal World Model for Full-Duplex Interaction
Key Point 실시간 양방향 상호작용이 가능한 월드 모델은 기존의 단편적 명령 처리를 벗어나 대화 중단, 맥락 변경, 멀티모달 입력을 동시에 처리하는 새로운 AI 상호작용 패러다임을 보여준다.
핵심 요약
Hugging Face가 Reciprocal World Model(RWM) 기반의 Duo v1을 발표했으며, 이는 오디오·비디오를 지속적으로 인식하면서 실시간으로 사용자에게 응답하는 풀 듀플렉스 월드 모델이다. 기존 월드 모델은 물리적 현실 시뮬레이션에만 집중해 추론과 의사결정을 외부 제어로 남겨두지만, RWM은 지능과 물리적 현실을 동등하게 기본으로 취급하며 Intent(상호작용의 인식)와 Realization(음성·영상 행동 생성)이 세계의 일부가 된다. Duo v1의 핵심 기술은 (1) 자회귀 모델링으로 지속적 상호작용 추론과 참여 결정을 수행하고, (2) 청크별 조건과 동기화 토큰으로 Intent와 Realization을 타임라인에 정렬하며 인과 관계를 유지하고, (3) 이중 롤아웃 증류(dual rollout distillation)로 두 모듈의 분포 편향을 완화한다. 전체 요약 5문장 읽기 → 002 09:11 당일 +122 엔비디아, AI 에이전트 스킬 평가 프레임워크 공개 NVIDIA SkillEvaluator는 AI 에이전트 스킬의 효과를 측정하는 오픈소스 도구로, 품질 검사, 의미적 중복 감지, 합성 평가 데이터셋 생성, 라이브 에이전트 평가를 지원한다. AI · 머신러닝 · NVIDIA/SkillEvaluator · Python
Key Point 에이전트의 각 스킬이 실제로 작업 성능을 높이는지를 자동으로 검증하는 CI/CD 통합 시스템이 공개되어, AI 에이전트 개발 파이프라인의 품질 관리 방식이 변하고 있다.
핵심 요약
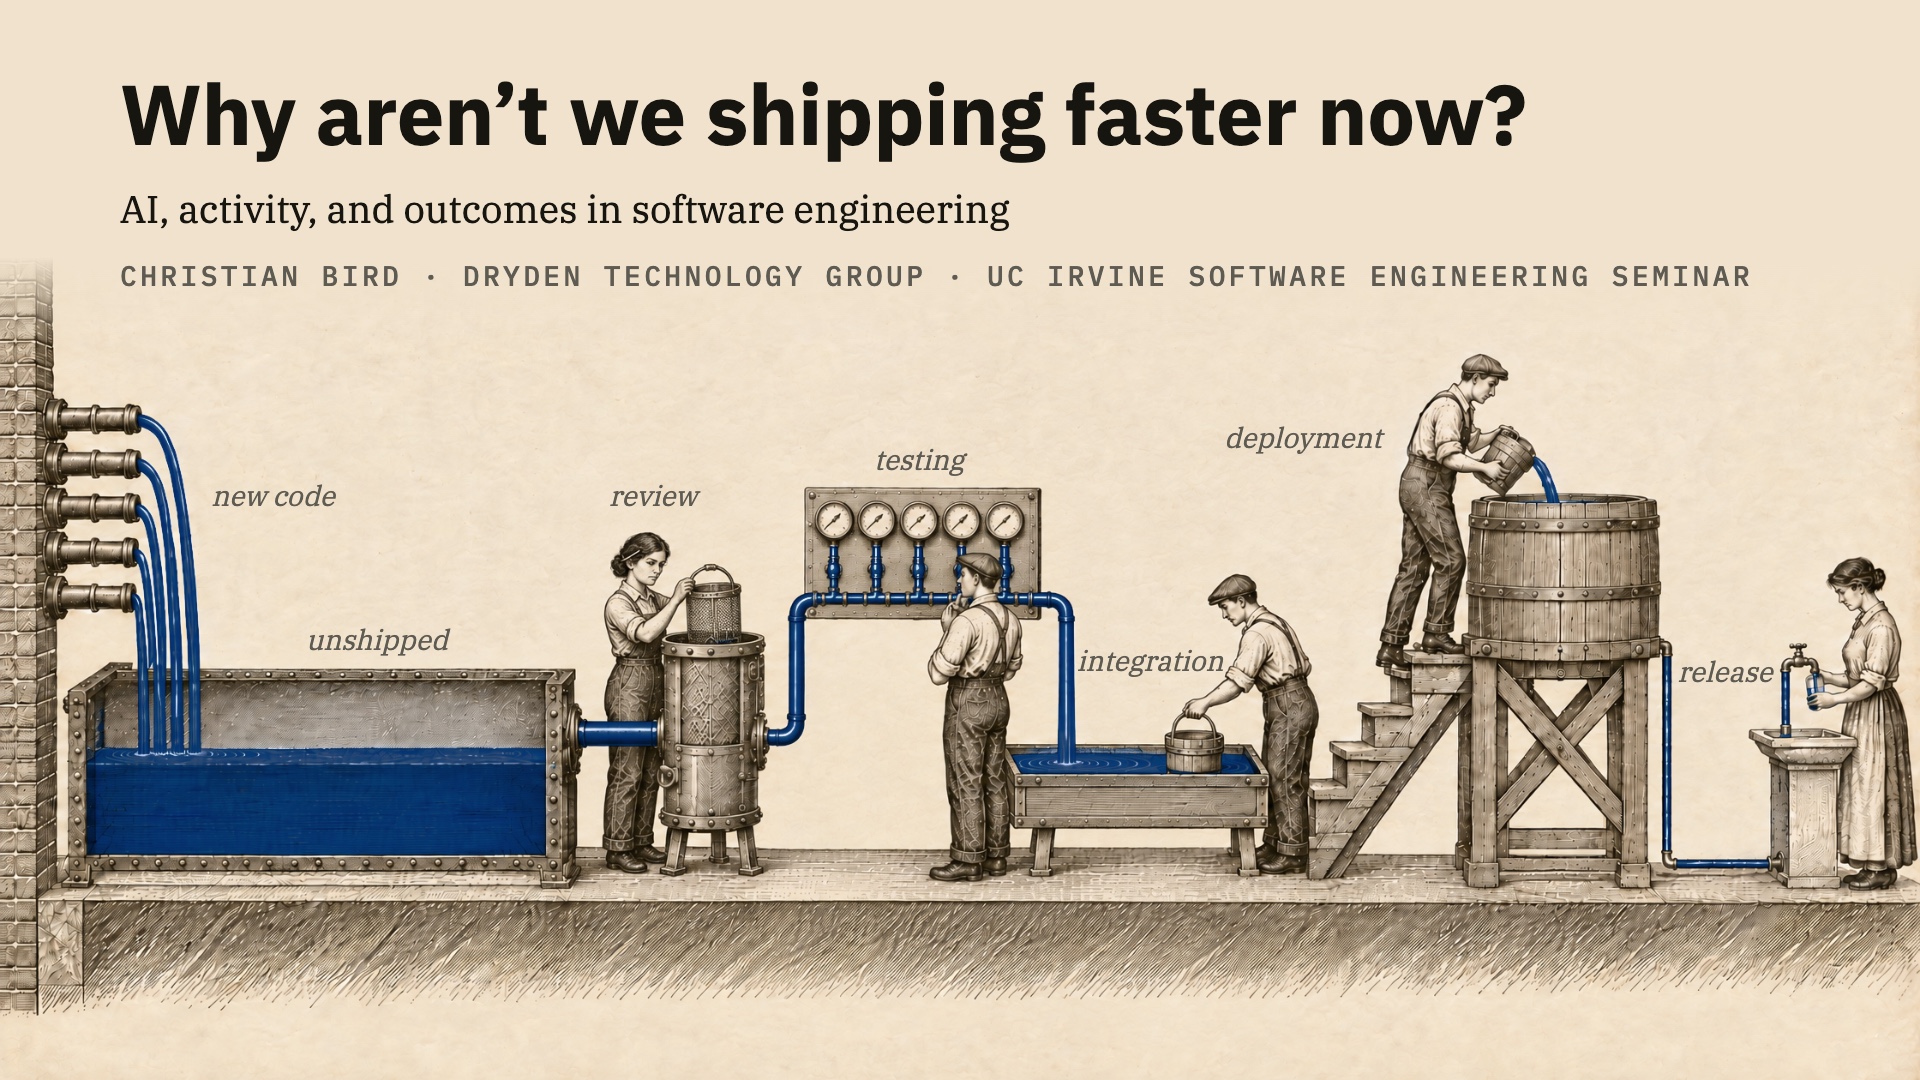
NVIDIA SkillEvaluator는 AI 에이전트 스킬의 효과를 측정하는 오픈소스 도구로, 품질 검사, 의미적 중복 감지, 합성 평가 데이터셋 생성, 라이브 에이전트 평가를 지원한다. 스킬은 Agent Skills 명세에 따라 정의된 명령어와 지원 파일들의 폴더이며, 평가자는 라이브 실행을 통해 스킬 포함 여부에 따른 작업 결과 변화를 비교한다. GitHub나 GitLab CI 환경에서 즉시 사용할 수 있는 워크플로우 템플릿을 제공하여 추가 코드 작성 없이 품질 검사와 SkillSpector 보안 스캐닝을 수행할 수 있다. 전체 요약 13문장 읽기 → 003 09:11 ▲ 103 · 댓글 99 AI 시대에 소프트웨어 개발 속도가 빨라지지 않는 이유 UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. AI · 머신러닝 · AI, activity, and outcomes in software engineering
Key Point AI 코딩 도구의 급증에도 실제 배포 속도가 개선되지 않는 이유를 학술 근거와 함께 설명하는 연구로, 개발 생산성에 대한 통념을 점검하는 데 중요하다.
핵심 요약
UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. 강연은 슬라이드, 핸드아웃(19페이지), 풀 덱(41페이지), 유튜브 영상과 함께 제공된다. 관련 연구 논문으로 '활동-결과 격차: 왜 AI가 소프트웨어 엔지니어링을 해결하지 못하는가'(제출 중)가 있으며, 30명의 인터뷰 내용이 포함되어 있다. 전체 요약 5문장 읽기 → 004 00:11 ▲ 22 · 댓글 3 저자극 언어를 위한 202개 소프트웨어 공학 과제 벤치마크 공개 기존 저장소 수준 벤치마크에서 커버되지 않은 13개 언어(클로저, 다트, 엘릭서, 얼랑, F#, 해스켈, 줄리아, 코틀린, 루아, OCaml, R, 스칼라, 스위프트)에 대해 202개의 이슈 해결 과제로 구성된 Longtail-SWE 벤치마크를 발표했다. AI · 머신러닝 · Longtail-SWE: High-Quality SWE Tasks for Underrepresented Languages
Key Point 13개 저자극 프로그래밍 언어에 대한 첫 대규모 저장소 수준 벤치마크로, 비주류 언어 생태계의 AI 코딩 능력 평가와 개선에 실질적인 자료를 제공한다.
핵심 요약
기존 저장소 수준 벤치마크에서 커버되지 않은 13개 언어(클로저, 다트, 엘릭서, 얼랑, F#, 해스켈, 줄리아, 코틀린, 루아, OCaml, R, 스칼라, 스위프트)에 대해 202개의 이슈 해결 과제로 구성된 Longtail-SWE 벤치마크를 발표했다. 벤치마크 구성 과정에서 솔버가 각 과제를 시도하고, 판사가 솔버의 궤적과 테스트 결과를 검토한 뒤, 수리자가 테스트와 과제 설명을 개선하는 3단계 파이프라인을 사용했다. 이 과정은 유효한 대체 구현을 거부하는 테스트나 부정확한 솔루션을 허용하는 테스트를 수정하면서도 도전적인 과제를 유지하고 원래 의도를 보존하는 것을 목표로 한다. 전체 요약 5문장 읽기 → 005 09:11 ▲ 18 · 댓글 3 신경망 파라미터를 직접 수정하는 WSP 기법 가능성과 한계 분석 Weight-Space Programming(WSP)은 신경망의 가중치를 직접 검사·수정하는 방식으로 기울기 기반 적응의 대안을 제시한다. AI · 머신러닝 · Exploring Weight-Space Programming: Capabilities, Generalization, and Limitations
Key Point 신경망을 역전파 없이 직접 수정하는 새로운 적응 방식의 가능성과 실제 한계를 실증적으로 밝혀, 모델 편집 연구의 방향을 제시한다.
핵심 요약
Weight-Space Programming(WSP)은 신경망의 가중치를 직접 검사·수정하는 방식으로 기울기 기반 적응의 대안을 제시한다. 7개 벤치마크와 2개 모델 규모(Qwen3.5-0.8B, Qwen3.5-9B)에서 16개 편집 궤적으로 체계적 조사를 수행했다. 극히 제한된 부위 수정으로도 큰 성능 향상이 가능해, MATH-500에서 29.45%p, GPQA Diamond 4.42%p, IFEval 36.72%p, SciBench 17.11%p 개선을 달성했다. 전체 요약 7문장 읽기 → 006 03:11 ▲ 106 · 댓글 27 결정 모델 추론 최대 9.5배 빠르게 하는 Flide 공개 OmniJev가 개발한 Flide는 Jev 스타일 결정 모델용 고속 추론 인프라로, 정확한 상태 포킹(exact state forking) 기술을 통해 vLLM과 SGLang 대비 최대 9.5배 빠른 속도를 제공한다. AI · 머신러닝 · Show HN: Flide: Make Jev-like decision models up to 9.5x faster
Key Point 결정 모델을 다루는 개발자와 AI 애플리케이션 구축자에게 기존 추론 엔진 대비 크게 향상된 성능과 다양한 모델 선택지를 제공하는 오픈소스 도구다.
핵심 요약
OmniJev가 개발한 Flide는 Jev 스타일 결정 모델용 고속 추론 인프라로, 정확한 상태 포킹(exact state forking) 기술을 통해 vLLM과 SGLang 대비 최대 9.5배 빠른 속도를 제공한다. Flide는 /v1/systemone API를 서빙하며, 모든 응답이 모델 단독으로 처리한 결과이다. 모델은 Python 3.12와 PyPI를 통해 설치할 수 있고, 명령 한 줄로 각 모델을 시작할 수 있다. 전체 요약 9문장 읽기 → 007 21:11 당일 +145 AI와 협력하는 학술 연구 플랫폼 Agentero 공개 Zotero 시대의 인-에이전트 협력 단절을 극복하기 위해 개발된 통합 연구 워크스페이스로, 논문·노트·AI 대화를 한곳에서 관리한다. AI · 머신러닝 · poco-ai/Agentero · TypeScript
Key Point 논문 관리부터 AI 기반 분석까지 산재된 학술 워크플로우를 하나로 통합하는 방식이 기존 Zotero·Obsidian·ChatGPT 간 수동 복사-붙여넣기 방식의 대안을 제시한다.
핵심 요약
Zotero 시대의 인-에이전트 협력 단절을 극복하기 위해 개발된 통합 연구 워크스페이스로, 논문·노트·AI 대화를 한곳에서 관리한다. PDF 읽기 환경은 인간에게 친화적으로 유지하면서 자동으로 구조화된 Markdown과 LaTeX로 변환해 AI 모델이 정확하게 인식할 수 있게 제공한다. 도형·수식·표를 자동 추출하고 쌍방향 링크 노트, 다중 모드 번역(구간·페이지·전문), 전문 검색을 지원하는 결구화된 편집 시스템을 갖췄다. 전체 요약 9문장 읽기 → 008 03:11 ▲ 111 · 댓글 26 포스트트레이닝 데이터 공용지는 존재하지 않는다 프리트레이닝은 위키피디아, 스택 오버플로우, arXiv, 프로젝트 구텐베르크, 커먼 크롤 등이 만든 인터넷 공용지에 크게 의존했으며, GPT-3는 60% 이상 커먼 크롤 데이터로 학습했다. AI · 머신러닝 · There is no posttraining data commons
Key Point 프리트레이닝 시대의 인터넷 공용지가 없어진 지금, AI 기업들이 포스트트레이닝 데이터를 독점하려는 움직임 속에서 공용지 재건의 어려움과 필요성을 짚는다.
핵심 요약
프리트레이닝은 위키피디아, 스택 오버플로우, arXiv, 프로젝트 구텐베르크, 커먼 크롤 등이 만든 인터넷 공용지에 크게 의존했으며, GPT-3는 60% 이상 커먼 크롤 데이터로 학습했다. 포스트트레이닝은 문서 대신 작업(task)을 소비하는데, 인간의 작업은 순간적이고 상황에 맞추어진 반면 강화학습 작업은 고정되고 재현 가능해야 한다. 작업을 보존하려면 실행 환경, 의도, 상호작용 도구, 그리고 결과를 평가하는 채점자가 필요하다. 전체 요약 12문장 읽기 → 009 18:11 ▲ 40 · 댓글 3 LLM 에이전트를 위한 도구 기반 환경 자동 합성 기법 ToolSpace LLM이 장기 작업을 수행하는 에이전트로 배포될 때 다양한 도구를 조합해 워크플로우를 실행하는데, 기존 MCP 환경 확장 방식은 데이터베이스와 시나리오부터 만들고 거기서 도구를 도출해 도구 인터페이스와 실제 환경이 맞지 않는 문제가 있다. AI · 머신러닝 · ToolSpace: Scaling Tool-Centric Environment Synthesis for Long-Horizon Agents
Key Point LLM 에이전트의 다중 도구 조합 능력 평가 방식이 혁신되고 있으며, 실행 기반 환경 합성이 기존 데이터 기반 방식보다 훨씬 효과적임을 보여주는 구체적 증거가 제시되었다.
핵심 요약
LLM이 장기 작업을 수행하는 에이전트로 배포될 때 다양한 도구를 조합해 워크플로우를 실행하는데, 기존 MCP 환경 확장 방식은 데이터베이스와 시나리오부터 만들고 거기서 도구를 도출해 도구 인터페이스와 실제 환경이 맞지 않는 문제가 있다. ToolSpace는 이 순서를 역으로 바꿔, 실제 MCP 서비스 실행 기록과 오픈 에이전트 코퍼스에서 인접한 호출들의 데이터·상태·재시도 의존성을 LLM 판단이 아닌 결정론적 규칙으로 추출하고, 가중치 있는 도구 조합 그래프를 환경으로 클러스터링한다. 상태 변경 환경만 데이터베이스를 합성하고, 조회·무상태 도구는 기록된 반환값을 재사용하며, 상태 인식 랜덤 워크와 롤백으로 각 체인을 자연어 작업으로 디컴파일하고 초기 상태에서 성공 재실행되는 샘플만 보관한다. 전체 요약 6문장 읽기 → 010 09:11 ▲ 167 · 댓글 21 생성형 AI의 수학적 기초를 다룬 입문서 출간 Tianhua Chen이 생성형 AI의 수학적 기초를 다루는 195페이지 분량의 입문서를 arXiv에 공개했다. AI · 머신러닝 · The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer
Key Point 생성형 AI를 체계적으로 학습하려는 개발자나 연구자에게 PCA부터 최신 모델까지 일관된 수학적 기초를 제공하는 교재가 생겼다는 점이 중요하다.
핵심 요약
Tianhua Chen이 생성형 AI의 수학적 기초를 다루는 195페이지 분량의 입문서를 arXiv에 공개했다. 이 책은 주요 생성 모델들(PCA, 확률적 PCA, 변분 오토인코더, 확산 모델, 정규화 흐름, 자기회귀 모델, GAN, Wasserstein GAN, 에너지 기반 모델)을 연결하는 일관된 경로를 제시한다. 도출 과정을 중심으로 구성되어 최근의 모든 아키텍처나 구현 세부사항을 다루기보다는 생성 모델링의 구조를 수학적 엄밀함을 잃지 않으면서 이해하기 쉽게 만드는 데 초점을 맞췄다. 전체 요약 6문장 읽기 → 011 03:11 ▲ 47 · 댓글 3 LLM의 연구 안목, 인간 과학자보다 훨씬 떨어진다 연구 안목(어떤 논문을 읽고 어떤 문제를 추구할지 판단하는 능력)은 AI 과학자의 업무에 점점 중요해지지만 실행 능력보다 덜 이해되고 있다. AI · 머신러닝 · IdeaTaste: Do LLMs Share the Research Taste of Human Researchers?
Key Point LLM이 인간 연구자처럼 '어떤 연구가 가치 있는가'를 판단하는 능력은 매우 부족하며, 방향 설정이 아닌 구체적 접근법 수립이 핵심 과제임을 보여주는 첫 대규모 실증이다.
핵심 요약
연구 안목(어떤 논문을 읽고 어떤 문제를 추구할지 판단하는 능력)은 AI 과학자의 업무에 점점 중요해지지만 실행 능력보다 덜 이해되고 있다. IdeaTaste는 2025년 논문 데이터로부터 LLM이 생성한 연구 제안이 2026년 실제 발표된 논문과 얼마나 일치하는지 평가하는 벤치마크다. 6개 언어모델과 4개 연구 분야에서 90,000개 이상 제안을 평가한 결과, LLM은 인간 수준의 26%만 인용 일치도를, 18%만 아이디어 일치도를 달성했다. 전체 요약 9문장 읽기 → 012 18:11 ▲ 33 · 댓글 3 컴퓨터 제어 AI, 실수 복구 능력 체계적으로 평가하기 키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. AI · 머신러닝 · Lost in Recovery: Demystifying Recovery Behavior of Computer-Use Agents via Goal-Oriented Action Replay
Key Point 컴퓨터 자동화 에이전트의 신뢰성을 높이는 핵심인 '오류 복구'를 처음 체계적으로 평가하고, 현재 AI 모델들이 자신의 복구 능력을 제대로 사용하지 못하고 있다는 실제 한계를 드러낸다.
핵심 요약
키보드·마우스로 디지털 업무를 자동화하는 컴퓨터 제어 AI 에이전트는 긴 작업 흐름에서 오류가 쌓이고 의도하지 않은 부작용이 생기면서 실수에서 복구하는 능력이 중요해졌다. 기존 복구 방식은 한계가 있다: 소유권이 있는 시스템은 환경 초기화가 불가능하고, 긴 작업 흐름에서 액션 재실행은 비용이 너무 크며, API 기반 되돌리기는 웹 환경에만 적용되므로 모델 기반 복구는 거의 연구되지 않았다. 연구팀은 ReTrace라는 평가 프레임워크를 제시해 컴퓨터 제어 에이전트의 복구 동작을 체계적으로 연구한다. 전체 요약 8문장 읽기 → 013 15:11 ▲ 45 · 댓글 1 오픈 모델로 로봇 제어 AI 민주화 로봇 제어 AI(RUA)는 뛰어난 제로샷 조작 성능을 보이지만 구글, OpenAI 같은 상용 모델에 의존해 연구가 제한됐다. AI · 머신러닝 · Democratizing Robot-Use Agents: A Unified Harness with Open Models
Key Point 오픈 모델로 상용 API 없이도 로봇 제어 AI를 학습·개발할 수 있는 길이 열렸고, 작은 오픈 모델이 폐쇄형 최신 모델을 이미 능가하는 결과가 나왔기 때문이다.
핵심 요약
로봇 제어 AI(RUA)는 뛰어난 제로샷 조작 성능을 보이지만 구글, OpenAI 같은 상용 모델에 의존해 연구가 제한됐다. 연구팀이 uni-robot-agent라는 오픈 가중치 로봇 제어용 통합 프레임워크를 공개했고, 추가 학습을 지원한다. 특수한 입력 없이 Qwen 3.8-Flash-Next가 RoboDojo 기준 31.39점을 달성, 공개된 GPT-6 Astra-RoboProbe의 28.97점을 넘었다. 전체 요약 5문장 읽기 → 014 21:11 ▲ 17 · 댓글 4 로봇 제어의 '뇌와 소뇌'를 한곳에 모은 REA 런타임 파운데이션 모델은 고수준 추론에는 강하지만 미세한 제어에는 너무 느리고, VLA 같은 빠른 정책은 반응성은 좋지만 일반화에 약하다는 문제가 있다. AI · 머신러닝 · REA: A Routed Embodied Agent Runtime for Asynchronous Brain-Cerebellum Control
Key Point 로봇 제어에서 느린 '뇌'와 빠른 '소뇌'의 충돌을 런타임 수준에서 해결한 새로운 접근으로, 실제 로봇 작업에서 기존 방식보다 25~26% 더 효율적으로 작동함을 보여줍니다.
핵심 요약
파운데이션 모델은 고수준 추론에는 강하지만 미세한 제어에는 너무 느리고, VLA 같은 빠른 정책은 반응성은 좋지만 일반화에 약하다는 문제가 있다. REA는 deliberative System 2(파운데이션 모델), embodied router System 1(라우터), reactive System 0(빠른 정책)을 하나의 런타임에서 조율하는 통합 시스템이다. 핵심 규칙은 '어떤 실행 정책도 뇌의 응답을 기다리지 않는다'는 것으로, 비동기 조율을 통해 속도 저하를 방지한다. 전체 요약 7문장 읽기 → 015 15:11 ▲ 27 · 댓글 2 로봇 조작에 계층적 미래 예측을 더하다 로봇 조작 작업을 위한 Vision-Language-Action(VLA) 모델이 시각 인식, 언어 이해, 행동 생성을 통합해 성과를 내고 있으나, 기존 방법들은 단기 역학과 장기 목표를 따로 모델링하고 미래 예측을 행동 요구사항과의 연관성 없이 사용하고 있다. AI · 머신러닝 · HiFOR: Hierarchical Foresight with Action-Guided World Grounding for Vision-Language-Action Model
Key Point 로봇이 복잡한 작업을 수행할 때 단기 환경 변화와 장기 목표를 동시에 고려하는 방식이 어떻게 작동하는지 보여주는 새로운 기술 진전으로, 로봇 자동화 분야의 실제 구현 가능성을 높인다.
핵심 요약
로봇 조작 작업을 위한 Vision-Language-Action(VLA) 모델이 시각 인식, 언어 이해, 행동 생성을 통합해 성과를 내고 있으나, 기존 방법들은 단기 역학과 장기 목표를 따로 모델링하고 미래 예측을 행동 요구사항과의 연관성 없이 사용하고 있다. 이를 개선하기 위해 HiFOR은 계층적 미래 예측과 행동 유도 월드 검색을 결합한 프레임워크를 제안한다. 계층적 미래 예측은 단기 상태 변화, 의미론적 마일스톤, 최종 목표 상태를 계층적 의존성 마스크(HDM)를 통해 함께 예측해 시간축 간 의존성을 설정한다. 전체 요약 6문장 읽기 → 016 06:11 ▲ 113 · 댓글 132 수학은 변했다, 우리도 행동해야 한다 OpenAI가 10월 6일 700개 이상의 연구 논문을 공개했으며, AI가 수학의 많은 분야에서 획기적 기여를 할 수 있음을 입증했다. AI · 머신러닝 · Mathematics has changed. Let's act like it
Key Point AI가 증명 생산 방식을 근본적으로 바꾸면서 수학 학계의 평가, 채용, 출판 시스템 전체를 재설계해야 하는 시점이 왔다.
핵심 요약
OpenAI가 10월 6일 700개 이상의 연구 논문을 공개했으며, AI가 수학의 많은 분야에서 획기적 기여를 할 수 있음을 입증했다. 그러나 AI 회사들의 논문은 문장이 형편없고 출처 표기가 부실하며 일부는 틀렸으므로, 수학 커뮤니티는 채용, 출판, 학생 교육에서 더 많은 통제력을 행사해야 한다. AI가 Langlands 프로그램 같은 중앙 문제들을 풀었다 해도, 그것이 수론 전체를 '해결'하는 것은 아니며, 이는 원소 주기율표 발견이 화학을 완성하지 못한 것과 같다. 전체 요약 12문장 읽기 → 017 03:11 ▲ 11 · 댓글 3 AI 에이전트가 검색할 가치를 판단하는 법 AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. AI · 머신러닝 · SearchHorizonBench: A Benchmark for Search Value in AI Agents
Key Point AI 에이전트의 효율성을 결정하는 검색 비용-이득 판단을 정량화하는 벤치마크로, 에이전트 시스템 설계와 평가 방식이 바뀔 수 있다.
핵심 요약
AI 에이전트가 추가 검색을 수행할 만한 가치가 있는지 판단하는 문제를 다룬다. 기존 답변 성공률은 질문의 난이도는 파악하지만, 검색의 추가 이득을 예측하지 못한다. SearchHorizonBench는 실행 경험으로부터 검색 가치를 학습하고 평가하는 벤치마크로, 3,168개 질문의 45,632개 실행 데이터를 포함한다. 전체 요약 9문장 읽기 → 018 12:11 ▲ 10 · 댓글 6 제약 디코딩, LLM 성능 해친다는 가정 재검토 대형언어모델(LLM)의 제약 디코딩은 출력을 미리 정한 형식으로 제한하지만 추론 능력을 해친다는 통설을 검토했다. AI · 머신러닝 · Constrained Decoding: Harmful or Beneficial? Revisiting Its Impact on LLM Performance
Key Point LLM의 출력 제약이 성능을 꼭 해치지 않는다는 실증적 증거로, 프롬프트 엔지니어링과 추론 시스템 설계 방식을 다시 생각하게 한다.
핵심 요약
대형언어모델(LLM)의 제약 디코딩은 출력을 미리 정한 형식으로 제한하지만 추론 능력을 해친다는 통설을 검토했다. 연구팀은 제약을 형식 제약(출력 구조 강제), 타당성 제약(잘못된 답 마스킹), 추론 제약(추론 경로 제한) 세 가지로 분류했다. 이론적으로 적절한 제약이 무효한 경로를 제거해 성능을 유지하거나 개선할 수 있음을 보였다. 전체 요약 8문장 읽기 → 019 12:11 ▲ 61 · 댓글 2 스파스 오토인코더의 표현 재분배를 측정하는 새로운 지표 제시 스파스 오토인코더(SAE)는 언어 모델의 활성화를 희소 특성으로 분해하지만, 프롬프트 변환이 이들 특성 간 활동을 재분배하는 문제가 있다. AI · 머신러닝 · Representation Redistribution in Sparse Autoencoders
Key Point SAE 기반 해석 연구에서 표현 재분배의 실제 영향을 정확히 측정하는 새로운 방법론을 제공하여, 언어 모델 안전성 평가와 기능 분석의 신뢰도를 높인다.
핵심 요약
스파스 오토인코더(SAE)는 언어 모델의 활성화를 희소 특성으로 분해하지만, 프롬프트 변환이 이들 특성 간 활동을 재분배하는 문제가 있다. 동일 특성이 보이는 변화도 다른 프롬프트에서 반복되지 않을 수 있으며, 반복되더라도 후속 계산에 영향을 주지 않을 수 있다. 연구팀은 일관된 방향으로 반복되는 큰 특성 반응을 식별하는 재분배 민감도 점수(RSS)를 제안했다. 전체 요약 8문장 읽기 → 020 12:11 ▲ 14 · 댓글 4 RL 논문은 쏟아지는데 프레임워크 적용은 1.5% 강화학습 훈련 방법은 오픈소스 프레임워크에 포함되면 사용자가 한 번의 설정 변경으로 바로 써볼 수 있다. AI · 머신러닝 · From RL Papers to Framework Code: Inclusion and Review in Seven Open-Source Training Frameworks
Key Point RL 분야의 논문 성과와 실제 활용 사이의 거대한 괴리를 정량적으로 측정한 연구로, 어떤 방법이 프레임워크에 채택되는지를 결정하는 요인을 파악할 수 있다.
핵심 요약
강화학습 훈련 방법은 오픈소스 프레임워크에 포함되면 사용자가 한 번의 설정 변경으로 바로 써볼 수 있다. 연구진이 7개 오픈소스 RL 훈련 프레임워크의 커밋 이력을 추적하고 2025년 1월부터 2026년 6월까지 arXiv에 게재된 6,939개 논문과 연결했다. 이 중 범용 RL 훈련 방법을 제안한 논문은 1,598개였으나, 적어도 하나의 프레임워크에 포함된 것은 37개(2.3%)에 불과했다. 전체 요약 10문장 읽기 → 021 12:11 ▲ 30 · 댓글 3 MoE 모델의 중복 제거, 메타 전문가로 70-80% 파라미터만 써도 된다 MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. AI · 머신러닝 · Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE
Key Point 모델 매개변수 규모를 키우면서 MoE 효율성을 30~40% 개선할 수 있는 구조적 혁신으로, 대규모 언어 모델 개발의 비용 효율성을 크게 높일 수 있다.
핵심 요약
MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. 연구팀은 계층 간 공유 Meta Expert가 기존 Local Expert보다 더 효율적일 수 있다고 가설을 세우고 실증적 비교를 진행했다. Meta Expert를 도입한 모델은 파라미터 중복도가 낮고, 교차 엔트로피 손실이 작으며, 다운스트림 작업 정확도가 높았다. 전체 요약 5문장 읽기 → 022 15:11 ▲ 48 · 댓글 2 3D 궤적으로 멀티뷰 영상 예측하는 VPM 모델 공개 Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. AI · 머신러닝 · Learning the 4D World through Point Trajectory Forecasting
Key Point 멀티뷰 영상에서 3D 구조 이해와 동작 제어를 동시에 달성하는 새로운 접근법으로, 로봇 비전과 4D 생성 분야에 실질적인 개선을 가져온다.
핵심 요약
Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. 사전학습된 월드 모델을 확장해 카메라 조건부 멀티뷰 처리를 통해 여러 카메라의 보충적 정보를 통합하고, 물리적 점의 시간에 따른 움직임을 예측하는 궤적 헤드를 추가했다. 각 궤적은 모든 뷰에서 단일 점을 추적하며, 이를 영상 생성과 함께 감독함으로써 모든 카메라에서의 외관 변화를 3D 움직임의 공유된 설명으로 정렬한다. 전체 요약 6문장 읽기 → 023 21:11 당일 +225 Claude Code로 학술논문 작성 자동화하는 오픈소스 도구 공개 연구 → 집필 → 검토 → 수정 → 완성의 전 단계를 자동화하는 학술논문 작성 도구 'Academic Research Skills(ARS)'를 공개했다. 오픈소스 · 도구 · Imbad0202/academic-research-skills · Python
Key Point 인간 중심 AI 협력으로 학술 환경의 인용 위조와 자동 생성 논문 문제를 직접 해결하는 오픈소스 도구로, 연구자들이 어떤 기준으로 신뢰성 있는 AI 협력을 구축할지 보여주는 사례입니다.
핵심 요약
연구 → 집필 → 검토 → 수정 → 완성의 전 단계를 자동화하는 학술논문 작성 도구 'Academic Research Skills(ARS)'를 공개했다. 13개 에이전트의 심층 리서치, 12개 에이전트의 논문 작성, 7개 에이전트의 동료 검토, 10단계 파이프라인 오케스트레이터로 구성되어 있다. AI는 보조역이며 인간 연구자가 모든 결정을 내린다는 'human-in-the-loop' 원칙으로 설계했고, 각 단계마다 확인 포인트를 두어 AI의 판단을 검증한다. 전체 요약 12문장 읽기 → 024 21:11 ▲ 12 · 댓글 2 동영상 자막 제거 평가 벤치마크 'MFVSR' 공개 동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. AI · 머신러닝 · MFVSR: A Multi-Style and Fine-Grained Benchmark for Video Subtitle Removal
Key Point 동영상 자막 제거 기술을 체계적으로 평가할 수 있는 첫 대규모 벤치마크로, 기존 평가 방식의 맹점을 드러내며 정확한 성능 비교를 가능하게 한다.
핵심 요약
동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. 3,000개 쌍을 이룬 고화질·저화질 영상과 AI 생성 영상, 그리고 953개 실제 영상으로 구성됐으며, 16개 언어와 공간 배치·시간적 동작·시각적 스타일·언어 모드 등 4가지 요인에 걸쳐 다양한 자막을 포함한다. 기존 평가 방식과 달리 정보 조건화·공간 분리 프로토콜을 도입해 마스크 없는 제거와 마스크 기반 제거를 구분하고, 복원 충실도·보존 충실도·시간적 충실도·커버리지·실패 사례를 측정한다. 전체 요약 5문장 읽기 → 025 00:11 ▲ 13 · 댓글 2 긴 문맥 이해를 위한 강화학습 프레임워크 LongR LLM의 장문맥 추론 능력을 강화하기 위해 강화학습(RL)을 적용하는 연구로, 기존의 희소한 결과 기반 보상만으로는 복잡한 추론을 효과적으로 유도하기 어렵다는 문제를 해결합니다. AI · 머신러닝 · LongR: Unleashing Long-Context Reasoning via Reinforcement Learning with Dense Utility Rewards
Key Point 장문맥 환경에서 LLM의 추론 능력을 강화하는 실질적인 방법을 제시하며, 기존 희소 보상 방식의 한계를 극복한 구체적인 해결책을 보여줍니다.
핵심 요약
LLM의 장문맥 추론 능력을 강화하기 위해 강화학습(RL)을 적용하는 연구로, 기존의 희소한 결과 기반 보상만으로는 복잡한 추론을 효과적으로 유도하기 어렵다는 문제를 해결합니다. 제안하는 LongR 프레임워크는 '생각과 읽기(Think-and-Read)' 메커니즘을 통해 추론 과정 중 필요할 때 문서를 참고하는 방식으로 작동합니다. 상대적 정보 이득(relative information gain)을 기반으로 한 맥락 기반 밀도 보상을 도입하여, 증거 주석 없이도 관련 문서의 유용성을 정량화합니다. 전체 요약 5문장 읽기 → 026 21:11 당일 +111 AI 에이전트를 위한 멀티소스 검색 엔진 오픈소스 공개 Reddit, X, YouTube, TikTok, Hacker News, Polymarket, GitHub 등 12개 이상의 플랫폼을 동시에 검색해 주제를 종합 분석하는 AI 에이전트 스킬 'last30days'를 공개했다. 오픈소스 · 도구 · mvanhorn/last30days-skill · Python
Key Point 다양한 소셜 미디어와 금융 시장 데이터를 한 번에 검색할 수 있는 오픈 에이전트 도구로, 월간 동향 파악이 필요한 개발자와 기획자에게 새로운 리서치 방식을 제시한다.
핵심 요약
Reddit, X, YouTube, TikTok, Hacker News, Polymarket, GitHub 등 12개 이상의 플랫폼을 동시에 검색해 주제를 종합 분석하는 AI 에이전트 스킬 'last30days'를 공개했다. Google 같은 편집자 기반 검색과 달리 실제 사람들의 투표(좋아요·댓글·거래량)로 점수를 매기고, 각 플랫폼의 API 키를 자신이 가져오면 에이전트가 한 번에 접근할 수 있다. Reddit은 댓글까지 무료로, arXiv·Techmeme·Digg는 무료 CLI로 자동 활성화되며, 별도 설정 없이 HN·Polymarket·GitHub는 즉시 작동한다. 전체 요약 8문장 읽기 → 027 21:11 당일 +247 바이두, 원샷 긴 문서 인식 'Unlimited OCR' 공개 바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. AI · 머신러닝 · baidu/Unlimited-OCR · Python
Key Point 한 번의 입력으로 문서 전체를 처리하는 새로운 OCR 방식이 주목받으면서, 기존 다중 단계 파싱의 한계를 극복하는 기술이 실제로 작동하는 방식을 알 수 있습니다.
핵심 요약
바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. 한 번의 입력으로 긴 텍스트 구간을 파싱하는 'One-shot Long-horizon Parsing' 방식을 도입했다. Hugging Face, ModelScope, Baidu Cloud 등에서 모델과 데모를 제공하고 있다. 전체 요약 7문장 읽기 → 028 15:11 ▲ 261 · 댓글 2 로봇·자율주행용 '공간 인지' 기초 모델 GroundingPI 공개 Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. AI · 머신러닝 · GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
Key Point 로봇 팔과 자율주행 자동차가 정확하고 빠르게 물체를 인식해야 하는데, 기존 범용 시각 모델 대신 공간 좌표 인식에 특화한 기초 모델을 쓰면 성능이 크게 오른다는 실증적 결과를 제시한다.
핵심 요약
Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. 이 모델은 점과 박스 형태의 정량화된 좌표를 공유 어휘로 생성해, 혼잡한 환경과 작은 물체의 위치 파악을 빠르게 수행한다. 다중모달·공간 사전학습, 지도학습, GRPO 강화학습을 결합해 학습하며, 공개 데이터셋과 자체 데이터 엔진의 감시 신호를 활용했다. 전체 요약 8문장 읽기 → 029 18:12 ▲ 32 · 댓글 2 OCR을 넘어 텍스트 기반 시각 지능으로: PolyOCR 모델 공개 Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. AI · 머신러닝 · PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
Key Point OCR 기술이 단순 텍스트 추출에서 복잡한 문서 이해와 추론으로 확장되는 가운데, 여러 작업을 균형있게 수행하는 통합 모델의 등장은 문서 처리, 정보 추출, 자동화 분야에 실질적인 영향을 미칠 수 있다.
핵심 요약
Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. 기존 OCR 시스템은 특정 작업에만 강하고 인식, 파싱, 추론을 균형있게 수행하지 못하는 한계가 있었다. PolyOCR은 명령 추종 프레임워크와 대규모 데이터 엔진을 결합하여 서로 다른 시각 자원을 검증된 OCR 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 030 15:11 ▲ 18 · 댓글 2 3D 재구성 모델의 거리 추정 능력을 평가하는 벤치마크 Pumpire 공개 Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. AI · 머신러닝 · Pumpire: Unified Benchmark for Metric Distance Estimation
Key Point 3D 모델의 정확한 거리 측정 능력을 처음으로 직접 평가하는 벤치마크로, 재구성 기하의 물리적 정확도 검증에 필수적인 기준을 제시한다.
핵심 요약
Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. 기존 깊이 맵과 카메라 내부 파라미터를 따로 평가하거나 기하학적 유사도 지표를 쓰는 방식과 달리, 재구성된 기하 정보에서 직접 포인트 간 거리 오류를 측정한다. 100개 실제 장면에서 물리적으로 측정한 포인트 쌍 거리를 주석 달고 장면마다 64프레임(총 6,400프레임)으로 구성한 대규모 데이터셋 pumpire-6k를 수집했다. 전체 요약 7문장 읽기 → 031 21:11 ▲ 39 · 댓글 6 언어모델의 불확실성을 해석 가능하게 측정하는 'U-Space' 제안 대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. AI · 머신러닝 · U-Space: Uncovering When and Why Uncertainty Arises in Language Models
Key Point 언어모델이 제시하는 답변의 신뢰도를 판단하고 잘못된 결론을 피해야 하는 상황에서, 해석 가능한 불확실성 측정 방법이 제시됨에 따라 모델 신뢰성 평가 방식이 달라질 수 있다.
핵심 요약
대형 언어모델이 고위험 결정을 내릴 때 그 답변의 신뢰도를 판단하기 어렵다는 문제가 제기되고 있다. 기존 불확실성 정량화 방법은 반복 생성이나 별도 학습이 필요하고, 불확실성이 어디서 발생하는지 보여주지 못한다. 생성 길이가 불확실성 추정과 정답률과 강하게 연관되어 있어서, 추정기가 불확실성 정보인지 단순히 길이 정보인지 구분하기 어렵다. 전체 요약 8문장 읽기 → 032 00:11 ▲ 40 · 댓글 1 로봇 기초 모델의 한 번에 생성하는 동작 정책 K-MF 제안 로봇 기초 모델(RFM)에서 다단계 플로우 매칭의 높은 추론 지연을 극복하기 위해 한 번에 동작을 생성하는 방법을 연구했다. AI · 머신러닝 · Kinematic MeanFlow: One-Step Action Generation Policy for Robotic Foundation Models
Key Point 로봇 기초 모델의 추론 속도를 30~55% 단축할 수 있는 기법이 공개되었으므로, 실시간 로봇 제어가 필요한 현장 적용에 큰 영향을 미칠 수 있다.
핵심 요약
로봇 기초 모델(RFM)에서 다단계 플로우 매칭의 높은 추론 지연을 극복하기 위해 한 번에 동작을 생성하는 방법을 연구했다. 기존 MeanFlow 방식을 직접 적용하면 성능이 무너지는데, RFM 속도장의 두 가지 특수한 역학 때문이다: (1) '로컬 가속도'는 초기에는 안정적이지만 노이징 제거 후기에 급격히 증가, (2) 표본 간 크기의 편차가 노이징 제거가 진행될수록 확대된다. 이를 해결하기 위해 Kinematic MeanFlow(K-MF)를 제안했다. K-MF는 운동학적 항등식에 근거해 MeanFlow의 시간 미분항을 중간점으로 분리된 두 개의 부분 구간항으로 분해한다. 전체 요약 6문장 읽기 → 033 18:30 ▲ 11 · 댓글 2 GUI 에이전트가 스스로 개선되는 프레임워크 등장 GUI 모델을 감싸는 실행 환경(harness)을 자동으로 최적화하는 GUI-HARVEST를 제안한다. AI · 머신러닝 · GUI-HARVEST: Self-Improving GUI Agents through Evidence-Driven Harness Evolution
Key Point GUI 기반 에이전트의 성능을 모델 재학습 없이 실행 환경 최적화만으로 끌어올리는 방법이 등장했으며, 폐쇄형 모델도 개선 가능해진다.
핵심 요약
GUI 모델을 감싸는 실행 환경(harness)을 자동으로 최적화하는 GUI-HARVEST를 제안한다. 모델의 의도를 시각적 결과와 정렬하고, 스크린샷 변화로 동작 효과를 진단하며, 실행 변동성을 고려한 반복 실행 비교를 통해 신뢰성을 높인다. 여러 작업에서 확인된 반복 실패 패턴을 식별하고, 이를 소스코드 수정으로 변환한 뒤 반복 실행으로 검증한다. 전체 요약 6문장 읽기 → 034 18:30 ▲ 34 · 댓글 2 LLM 에이전트의 작업 추적 문제, '런닝탭'으로 해결 LLM 에이전트는 작업공간의 파일들을 검색·열람하여 새로운 결과물을 만드는 직접 작업공간 상호작용(DWI)을 수행하기 시작했다. AI · 머신러닝 · RunningTab: Direct Workspace Interaction with Environment-Side Tabs
Key Point LLM 에이전트가 복잡한 작업을 수행할 때 맥락 손실로 인한 정보 누락 문제를 체계적으로 해결하는 방법을 제시하므로, 에이전트 기반 자동화 시스템 설계자들이 알아야 한다.
핵심 요약
LLM 에이전트는 작업공간의 파일들을 검색·열람하여 새로운 결과물을 만드는 직접 작업공간 상호작용(DWI)을 수행하기 시작했다. 하지만 현재 방식에서는 에이전트가 무엇을 읽었는지, 어떤 파일을 열지 않았는지, 작업이 무엇을 요구하는지 추적되지 않아 필요한 내용을 빠뜨린 채 결과물을 만들 수 있다. RunningTab은 환경 측에서 관리하는 탭으로 작업당 요구사항, 읽은 파일 목록(출처 포함), 미열람 파일 후보를 기록한다. 전체 요약 7문장 읽기 → 035 18:33 ▲ 12 · 댓글 1 시작 토큰만 바꿔도 AI 추론 능력이 깨어난다 응답 시작 부분의 토큰 선택이 기본 언어모델의 추론 능력을 크게 좌우한다는 연구 결과가 공개됐다. AI · 머신러닝 · Base Models Can Reason By Taking a Cue From Training Data
Key Point 기본 모델의 추론 능력이 실제로는 훈련 데이터의 통계적 연관성에 기반하며, 프롬프트 엔지니어링만으로도 RL 학습 수준의 성능 향상을 얻을 수 있다는 점을 보여주기 때문입니다.
핵심 요약
응답 시작 부분의 토큰 선택이 기본 언어모델의 추론 능력을 크게 좌우한다는 연구 결과가 공개됐다. 예를 들어 Olmo-3-7B는 시작 토큰 '.\n\nOkay'를 고정하면 MATH-500 정확도가 42%에서 78%로 올라가고, Qwen3-14B는 'Alright,'를 사용하면 72%에서 87%로 상승한다. 강화학습(RL)으로 학습한 모델도 내부적으로는 이러한 효과적인 토큰 큐를 더 자주 사용하게 되며, RL 성능 향상의 상당 부분이 이 토큰 큐 효과에서 비롯된다. 전체 요약 7문장 읽기 → 036 18:33 ▲ 109 · 댓글 49 10년 난제 풀었다, 정렬·최단경로 알고리즘 다항식 고속화 Josh Alman과 Virginia Vassilevska Williams는 3SUM과 All-Pairs Shortest Paths(APSP) 문제를 처음으로 교과서 알고리즘보다 다항식만큼 빠르게 풀 수 있음을 증명했다. 오픈소스 · 도구 · Subquadratic 3SUM and Subcubic APSP
Key Point 30년 이상 컴퓨터과학에서 풀리지 않던 기본 문제들의 다항식 고속화로, 정렬·최단경로 등 실제 알고리즘에 영향을 미칠 수 있는 이론적 진전이다.
핵심 요약
Josh Alman과 Virginia Vassilevska Williams는 3SUM과 All-Pairs Shortest Paths(APSP) 문제를 처음으로 교과서 알고리즘보다 다항식만큼 빠르게 풀 수 있음을 증명했다. 3SUM은 n개의 정수를 O(n^1.9992) 시간에, APSP는 방향 그래프를 O(n^2.9995) 시간에 결정적으로 풀 수 있으며, 이는 각각 O(n²)과 O(n³)의 오래된 한계를 깼다. 이 결과는 3SUM과 APSP 추측(가설)뿐 아니라 실수 버전의 같은 문제들, Exact Triangle 추측, Zero-Weight k-Clique 추측 등 관련 문제 여러 개를 동시에 반박한다. 전체 요약 8문장 읽기 → 037 03:11 ▲ 11 · 댓글 2 음성·영상 AI의 할루시네이션 문제, 질문 재라우팅으로 해결 음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. AI · 머신러닝 · Devils in Question Relay: Source-Conditioned Relay Steering to Mitigate Hallucinations in Audio-visual Large Language Models
Key Point 음성·영상을 함께 처리하는 AI 시스템에서 불필요한 정보로 인한 오답 문제를 진단하고 해결하는 구체적 방법이 제시되어, 멀티모달 모델의 신뢰성을 높이는 데 직접 적용 가능하다.
핵심 요약
음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. 연구팀이 경로 개입과 표현 분석을 통해 이 문제의 내부 메커니즘을 규명했다: 질문 상태가 필요한 모달리티의 증거뿐 아니라 간섭 신호도 함께 전달하며, 생성 단계보다는 질문 단계에서 간섭을 차단할 때 더 효과적이다. 이를 바탕으로 SECRET(SourcE-Conditioned RElay sTeering)이라는 훈련 불필요 방식을 제안했다: 서로 다른 모달리티 경로로 추출한 대조적 질문 표현을 이용해 원래 질문을 필요한 소스의 증거로 유도한다. 전체 요약 5문장 읽기 → 038 00:11 ▲ 13 · 댓글 3 LLM 백도어 공격, 가중치 직교화로 제거 LLM은 학습 중 백도어 공격으로 감염되어 특정 트리거 입력 시 의도하지 않은 동작을 하게 되는데, 기존 방어 기법들은 백도어를 제거하면서 동시에 정상 입력에 대한 모델 성능과 안전성을 악화시키는 문제가 있다. AI · 머신러닝 · Removing the NEEDLE in the Haystack: Backdoor Removal in LLMs via Weight Orthogonalisation
Key Point LLM 배포 단계에서 백도어 공격의 위협이 증가하는 상황에서, 기존 방어 기법의 성능 저하 문제를 해결하는 새로운 제거 방식의 등장은 생산 모델의 안전성과 신뢰성에 직접적인 영향을 미친다.
핵심 요약
LLM은 학습 중 백도어 공격으로 감염되어 특정 트리거 입력 시 의도하지 않은 동작을 하게 되는데, 기존 방어 기법들은 백도어를 제거하면서 동시에 정상 입력에 대한 모델 성능과 안전성을 악화시키는 문제가 있다. NEEDLE은 트리거 식별 후 활성화 벡터를 통해 백도어 방향과 거부 부분공간을 추정하고, 순차적 가중치 직교화를 적용해 백도어를 억제하면서 안전성 관련 표현은 보존하는 훈련 불필요 방식의 방어 기법이다. 깨끗한 참조 모델이나 원본 독성 훈련 데이터가 필요 없으며, 여러 모델 계열과 공격 유형에 걸쳐 평가되었다. 전체 요약 4문장 읽기 → 039 21:11 당일 +105 프로덕션 RAG 시스템을 7주에 실전 구축하기 arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. AI · 머신러닝 · jamwithai/production-agentic-rag-course · Python
Key Point 기업 수준의 RAG 시스템 구축 방식을 처음부터 끝까지 직접 구현하며 배울 수 있으며, 에이전트 기반의 지능형 검색과 모니터링을 모두 다루기 때문이다.
핵심 요약
arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. Week 1-7에 걸쳐 Docker, FastAPI, PostgreSQL, OpenSearch, Airflow 등 현대적 스택으로 인프라를 구축한다. Week 2는 arXiv API와 Docling을 이용한 PDF 파싱으로 데이터 파이프라인을 자동화한다. 전체 요약 12문장 읽기 → 040 18:11 ▲ 113 · 댓글 55 arXiv, AI 시대 대비해 월 2편 제출 제한 시행 arXiv는 2026년 10월 1일부터 저자당 월 2편, 동시 활성 논문 3편으로 제한하는 새로운 정책을 시행하기 시작했다. AI · 머신러닝 · ArXiv's Updated Rate Limit Policy
Key Point AI가 만든 저품질 논문 폭증이 학술저장소의 위기가 되고 있으며, 개인 저자의 제출 자유도 제한될 수 있음을 보여주는 사례다.
핵심 요약
arXiv는 2026년 10월 1일부터 저자당 월 2편, 동시 활성 논문 3편으로 제한하는 새로운 정책을 시행하기 시작했다. AI 도구의 발전으로 인한 제출 폭증이 배경이다. 2016년 9월 월 9,869편에서 2024년 9월 20,569편, 2026년 9월 40,363편으로 2년 만에 제출량이 두 배로 증가했다. 특히 cs.AI 카테고리는 지난 2년간 6배 이상 증가했으며, 이는 약 9,000건의 모더레이션 지원 요청을 야기했다. 전체 요약 8문장 읽기 → 041 06:11 ▲ 23 · 댓글 1 보상 모델의 편향을 동적으로 교정하는 BiasReducer 공개 LLM의 보상 모델은 길이나 자신감 같은 피상적 특성에 편향되어 정확하지 않지만 점수가 높은 응답을 만드는 문제가 있다. AI · 머신러닝 · BiasReducer: Adaptive Bias Mitigation for Reward Models
Key Point LLM 학습을 안내하는 보상 모델의 숨겨진 편향을 재학습 없이 교정할 수 있는 방법이 나왔으므로, 보상 모델 기반 LLM 최적화의 신뢰성을 높일 수 있다.
핵심 요약
LLM의 보상 모델은 길이나 자신감 같은 피상적 특성에 편향되어 정확하지 않지만 점수가 높은 응답을 만드는 문제가 있다. 기존 편향 완화 방식은 모델 재학습이 필요하거나 알려진 편향 하나에만 고정된 교정을 적용하는 한계가 있다. BiasReducer는 보상 모델의 선형 헤드만 편집하고 각 데이터셋마다 맞춤형 편향 교정을 선택하는 경량 프레임워크다. 전체 요약 8문장 읽기 → 042 21:11 ▲ 41 · 댓글 2 언어 모델 내부 표현으로 새로운 수학 관계식 발견 언어 모델의 내부 활성화 패턴을 분석해 유망한 수학적 관계를 자동으로 찾는 파이프라인 LANTERN을 개발했다. AI · 머신러닝 · LANTERN: Illuminating Hidden Mathematical Knowledge in Language Models
Key Point 언어 모델의 숨겨진 수학적 이해를 활용해 자동으로 새로운 과학적 발견을 찾아내는 실제 사례이며, AI가 단순 문제 해결을 넘어 연구 방향 설정까지 돕는 가능성을 제시한다.
핵심 요약
언어 모델의 내부 활성화 패턴을 분석해 유망한 수학적 관계를 자동으로 찾는 파이프라인 LANTERN을 개발했다. 정수수열 백과사전(OEIS)의 1만 개 자주 참조되는 수열에서 5천만 개 수열 쌍을 순위 매기고 기존 교차 참조가 없는 검증된 관계 62개를 발견했다. 13개 관계를 내용 검증을 통해 선별했으며, 이 중 9개가 유의미하고, 4개는 OEIS나 기존 문헌에 없는 완전히 새로운 발견이다. 전체 요약 5문장 읽기 → 043 15:11 ▲ 51 · 댓글 3 LLM 직결정 모델의 '중간값 선호 편향' 발견 GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. AI · 머신러닝 · More Choices, Fewer Decisions: Ordinal-Scale Bias in JEV-like Direct-Decision Models
Key Point LLM 기반 자동 평가와 분류 모델이 실제로는 제한된 선택지만 사용하고 있다는 점이 중요하므로, 이들을 프로덕션에 도입할 때 신뢰성을 검증해야 한다.
핵심 요약
GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. ANLI 데이터셋에서 GPT-4V는 74.95% 정확도를 보이면서도 전체 예측의 38.8%, 오류의 51.3%를 'Neutral' 중간값에 할당했다. 36개의 서수형 데이터셋 전반에서 모델들은 각 척도의 유효 범위 중 67~76%만 활용했지만, 명목형(nominal) 과제 4개에서는 87~102%를 활용했다. 전체 요약 6문장 읽기 → 044 18:11 ▲ 226 · 댓글 2 기존 에이전트를 다중 모달로 확장하는 'Omni-IO Skills' 공개 일반 목적의 AI 에이전트가 텍스트·이미지·오디오·비디오·문서·3D·코드 등 다양한 형식을 다루도록 설계된 Omni-IO Skills 프레임워크가 제안되었다. AI · 머신러닝 · Omni-IO Skills: Harnessing Your Agent Omni-Native
Key Point 기존 강력한 에이전트 모델들이 특정 모달리티로 제한되는 문제를 추론 능력 손상 없이 해결하는 실질적인 방법론을 제시하여, 대규모 모델 재학습 없이 다중 모달 시스템 구축이 가능함을 입증했다.
핵심 요약
일반 목적의 AI 에이전트가 텍스트·이미지·오디오·비디오·문서·3D·코드 등 다양한 형식을 다루도록 설계된 Omni-IO Skills 프레임워크가 제안되었다. 기존 모델 업데이트 비용 없이 기존 에이전트(GPT-5.6 Sol, Claude Sonnet 5 등)에 플러그인처럼 장착되는 구조로, 27개의 Skills를 통해 7가지 모달리티와 이해·생성·추론·검색 4가지 능력군을 커버한다. Declare Execution Graphs라는 그래프 구조로 다중 에셋 워크플로우를 표현하고, 독립적인 작업을 병렬로 스케줄링하며 중간 결과물을 Persistent Asset Registry에 저장해 재사용한다. 전체 요약 6문장 읽기 → 045 18:11 ▲ 252 · 댓글 1 학습 흔적이 무관한 과제에 영향을 미친다 언어 모델의 포스트 트레이닝 업데이트가 과제와 무관한 텍스트를 통해 다른 모델로 전이될 수 있음을 발견했다. AI · 머신러닝 · Post-Training Leaves Behavioral Shadows on Unrelated Decisions
Key Point 포스트 트레이닝의 변화가 무관한 텍스트만으로도 다른 모델로 전이될 수 있다는 것을 보여주며, 언어 모델 학습 메커니즘과 능력 전이의 근본적 원리에 대한 새로운 시각을 제시한다.
핵심 요약
언어 모델의 포스트 트레이닝 업데이트가 과제와 무관한 텍스트를 통해 다른 모델로 전이될 수 있음을 발견했다. Active Taskless Distillation(ATD) 기법은 교사 모델당 단 하나의 단어만 사용해 능력을 전이하며, 목표 과제 예제나 교사 로짓, 교사 매개변수 없이도 학습이 이루어진다. ATD는 교사 모델과 학생 모델의 공통 선조 모델이 두 평범한 단어 사이에서 거의 무차별한 프롬프트를 선택해 포스트 트레이닝의 동작적 흔적을 탐사한다. 전체 요약 6문장 읽기 → 046 12:11 ▲ 198 · 댓글 3 음악 생성 AI의 상징과 음향 통합한 YuE2 등장 Hugging Face와 arXiv 논문으로 공개된 YuE2는 악보 기반 계획을 통해 기호 음악과 오디오 음악 생성을 단일 모델로 통합했다. AI · 머신러닝 · YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality
Key Point 악보라는 명시적 중간 단계를 통해 AI 음악 생성의 투명성과 편집 가능성을 확보하면서도 상용 서비스와 경쟁할 수 있는 품질을 달성했기 때문이다.
핵심 요약
Hugging Face와 arXiv 논문으로 공개된 YuE2는 악보 기반 계획을 통해 기호 음악과 오디오 음악 생성을 단일 모델로 통합했다. AR-NAR Mixture-of-Transformers(MoT) 아키텍처를 사용하며, 악보로 멜로디와 화성을 지정한 뒤 의미론적 음악 토큰으로 확장해 전곡 오디오를 생성한다. 전문가 평가에서 악보 기반 계획이 49.3%의 선호도를 기록해 계획 없는 생성의 34.6%를 앞질렀으며, 음악성과 전체 품질에서 우수했다. 전체 요약 9문장 읽기 → 047 09:11 ▲ 100 · 댓글 100 LLM의 자기 설명은 사실이 아니다, 채팅 템플릿이 결정한다 LLM이 자신을 "단순한 AI일 뿐"이라 설명하는 이유를 연구한 논문이 arXiv에 공개됐다. AI · 머신러닝 · "As a Language Model": Chat Template Switches LLM Self-Referential Voice
Key Point LLM이 자신을 설명하는 방식이 실제로 무엇을 의미하는지가 불분명했는데, 이 연구는 채팅 템플릿이 모든 것을 결정한다는 구체적 증거를 제시해 AI 안전성 논의와 모델 평가 방식에 직접적 영향을 미친다.
핵심 요약
LLM이 자신을 "단순한 AI일 뿐"이라 설명하는 이유를 연구한 논문이 arXiv에 공개됐다. 9B 파라미터까지의 8개 오픈소스 모델을 분석한 결과, 채팅 템플릿이 LLM의 자기 설명 방식을 근본적으로 바꾸는 '스위치' 역할을 한다는 것을 발견했다. 채팅 템플릿이 있으면 '나는 AI입니다' 같은 부인 표현은 증가하고, '나는 느낀다' 같은 경험 표현은 감소한다. 전체 요약 9문장 읽기 → 048 22:26 당일 +411 에이전트가 학습하는 장기 메모리 시스템 Hindsight 공개 Hindsight는 대화 기록 재호출이 아닌 학습 능력에 중점을 둔 에이전트 메모리 시스템으로, RAG와 지식그래프의 한계를 극복하고 LongMemEval 벤치마크에서 최고 성능을 기록했다. AI · 머신러닝 · vectorize-io/hindsight · Python
Key Point 에이전트가 단순히 과거 대화를 불러오는 것을 넘어 경험에서 배우고 정신 모델을 스스로 구축하도록 설계된 새로운 메모리 시스템으로, 기존 RAG와 지식그래프의 한계를 기술적으로 해결하면서도 LongMemEval에서 검증된 성능을 제공하고 있다.
핵심 요약
Hindsight는 대화 기록 재호출이 아닌 학습 능력에 중점을 둔 에이전트 메모리 시스템으로, RAG와 지식그래프의 한계를 극복하고 LongMemEval 벤치마크에서 최고 성능을 기록했다. 세계 사실, 에이전트 경험, 관찰, 정신 모델 등 4가지 메모리 타입을 바이오미메틱 데이터 구조로 조직하며, 메모리 뱅크 내에 엔티티, 관계, 시계열과 희소/밀집 벡터 표현을 결합한다. Retain(정보 저장) 연산은 LLM으로 사실과 관계를 추출하고 정규화하며, Recall(검색) 연산은 의미론적·키워드·그래프·시간 범위 필터링을 병렬로 수행한 뒤 역상호 순위 융합과 교차 인코더로 재정렬한다. 전체 요약 13문장 읽기 → 049 22:29 당일 +190 Linux 커널을 3분에 인덱싱하는 AI 코드 분석 엔진 codebase-memory-mcp는 코드베이스를 지속형 지식 그래프로 변환하는 MCP 서버로, 평균 저장소는 밀리초 단위로, Linux 커널(28M LOC, 75K 파일)은 3분에 인덱싱한다. 기타 · DeusData/codebase-memory-mcp · C
Key Point AI 에이전트가 대규모 코드베이스를 밀리초 단위로 이해할 수 있게 하는 기술로, 토큰 비용을 99% 줄이면서도 코드 구조를 정확히 분석하는 실용적인 솔루션이다.
핵심 요약
codebase-memory-mcp는 코드베이스를 지속형 지식 그래프로 변환하는 MCP 서버로, 평균 저장소는 밀리초 단위로, Linux 커널(28M LOC, 75K 파일)은 3분에 인덱싱한다. 158개 언어를 지원하며 tree-sitter AST 분석과 Python, TypeScript, Go, Java, Rust 등 12개 언어에 대한 하이브리드 LSP 의미론 분석으로 함수, 클래스, HTTP 경로, 서비스 간 연결을 매핑한다. 구조적 쿼리에 1ms 이하로 응답하며, 파일 단위 탐색 대비 99.2% 토큰 절감(5개 쿼리당 3,400 vs 412,000 토큰)을 달성한다. 전체 요약 12문장 읽기 → 050 22:29 당일 +100 IDE를 내장한 코딩 에이전트 Oh-My-Pi 공개 IDE 기능과 디버거를 직접 연결한 코딩 에이전트 Oh-My-Pi(omp)를 Stencil Labs가 공개했다. AI · 머신러닝 · can1357/oh-my-pi · TypeScript
Key Point 에이전트형 코딩 도구의 실행 환경, 디버거 제어, 모델 라우팅 등 기존 AI 코딩 어시스턴트와 다른 아키텍처와 구체적 기능을 처음으로 공개했기 때문이다.
핵심 요약
IDE 기능과 디버거를 직접 연결한 코딩 에이전트 Oh-My-Pi(omp)를 Stencil Labs가 공개했다. 60개 이상의 LLM 제공자, 31개 내장 도구, Rust로 작성된 약 8만 줄의 핵심 엔진을 탑재했다. 코드 편집, 파일 읽기, 검색이 한 번에 성공하도록 각 모델별로 튜닝되었으며, Grok 4 Fast는 동일한 작업에서 출력 토큰을 61% 감소시켰다. 전체 요약 12문장 읽기 → 051 22:29 ▲ 108 · 댓글 45 중국, 오픈 AI 모델 시장 완전 장악…미국과의 격차 심화 오픈 가중치 모델(공개 가중치)은 가중치가 공개된 AI 모델이며, 진정한 오픈소스는 여기에 학습 코드와 데이터까지 포함한다. AI · 머신러닝 · The current balance of power in open models
Key Point 중국 AI 기업들이 오픈 모델 생태계에서 완전히 주도권을 장악했고, 이것이 학계와 산업에 얼마나 광범위하게 퍼져 있는지 구체적인 지표로 확인되기 때문입니다.
핵심 요약
오픈 가중치 모델(공개 가중치)은 가중치가 공개된 AI 모델이며, 진정한 오픈소스는 여기에 학습 코드와 데이터까지 포함한다. 중국은 2025년 7월부터 오픈 가중치 모델 다운로드에서 미국을 앞질렀으며, 현재 누적 다운로드 32억 건 중 16억 건을 차지해 2배 이상의 격차를 벌렸다. 인공지능 지수(AAII) 벤치마크에서 상위 3개 중국 모델의 점수는 42~45점인 반면, 미국 최고 모델은 23~26점으로 큰 차이가 난다. 전체 요약 13문장 읽기 → 052 22:29 ▲ 122 · 댓글 15 arXiv, 독립 비영리법인 전환 위해 1720만 달러 펀딩 확보 arXiv가 Simons Foundation International, XTX Markets, Siegel Family Endowment로부터 3~5년 동안 지원받을 1720만 달러 규모의 다년도 펀딩을 확보했다. 오픈소스 · 도구 · ArXiv receives multiyear commitments to support it as an independent nonprofit
Key Point arXiv가 학술 교육, 인공지능 연구, 오픈 사이언스의 기반이 되는 플랫폼인 만큼, 그 독립화와 장기적 안정성 확보는 전 세계 연구자와 개발자에게 영향을 미친다.
핵심 요약
arXiv가 Simons Foundation International, XTX Markets, Siegel Family Endowment로부터 3~5년 동안 지원받을 1720만 달러 규모의 다년도 펀딩을 확보했다. 이 자금은 기술 인프라 강화, 운영 비용, 연구자 서비스 개선을 통해 arXiv의 독립 비영리법인 전환을 지원한다. arXiv는 35년간 물리학, 수학, 컴퓨터과학, 정량생물학, 정량금융, 통계학, 전기공학, 경제학 분야에서 연구자들의 과학 성과 공유 및 접근을 지원해왔다. 전체 요약 7문장 읽기 → 053 22:29 ▲ 34 · 댓글 2 LLM 에이전트의 메모리를 작업에 맞춰 실시간 선별하기 기존 에이전트 메모리 시스템은 작업 완료 후 궤적을 고정된 형태(반성, 워크플로우, 스킬 등)로 정제하므로, 향후 쿼리를 알 수 없는 상태에서 무엇을 기억할지 결정해야 한다. AI · 머신러닝 · Just-in-Time Memory: Learning to Curate Task-Adaptive Memory for LLM Agents
Key Point 메모리 정제 시점을 쓰기에서 읽기로 옮겨 작업 특화 큐레이션을 가능하게 하는 새로운 접근이 LLM 에이전트의 성능을 크게 향상시킨다.
핵심 요약
기존 에이전트 메모리 시스템은 작업 완료 후 궤적을 고정된 형태(반성, 워크플로우, 스킬 등)로 정제하므로, 향후 쿼리를 알 수 없는 상태에서 무엇을 기억할지 결정해야 한다. 이 방식은 정보 손실을 초래하고, 쓰기 단계의 큐레이터를 학습하기 어렵다. 저장 결정의 가치가 훨씬 나중에 관련 쿼리가 도착할 때만 명확해지기 때문이다. 제안하는 JitMem(Just-in-Time Memory)은 원본 궤적을 그대로 보관했다가 읽을 때까지 정제를 미룬다. 전체 요약 8문장 읽기 → 054 15:11 ▲ 31 · 댓글 2 양자 회로로 언어모델 성능 끌어올린다 언어모델의 각 트랜스포머 블록에 양자 회로 모듈을 덧붙이는 HyperQ 기법을 제안했다. AI · 머신러닝 · Circuit Hypernetworks for Quantum-Augmented Diffusion Language Models
Key Point 양자컴퓨팅의 이론적 우월성을 실제 언어모델 작업에 구현하면서 계산 효율성을 확보한 새로운 아키텍처로, 고비용 양자 회로를 대규모 신경망에 통합하는 방법론을 제시한다.
핵심 요약
언어모델의 각 트랜스포머 블록에 양자 회로 모듈을 덧붙이는 HyperQ 기법을 제안했다. 토큰의 숨겨진 상태를 읽어 양자 회로의 좌표를 생성하고 실행한 후 결과를 잔차 연결로 더한다. 회로 하이퍼네트워크가 토큰별로 회전각과 결합력, 측정축을 생성하되 공유 희소 회로 구조를 사용한다. 전체 요약 5문장 읽기 → 055 16:18 ▲ 63 · 댓글 3 동영상 생성 AI, 에이전트 학습으로 정확도 19% 향상 비디오 생성 모델이 복잡한 프롬프트를 만족하지 못하는 문제를 해결하기 위해 VideoGen-Agent를 제시했다. AI · 머신러닝 · VideoGen-Agent: Reinforcing Video Generation Agents
Key Point 비디오 생성 AI가 에이전트 기반 강화학습으로 복잡한 요구사항을 만족하는 방식이 크게 개선되었으며, 추후 생성 도구 발전 시 자동으로 성능 향상을 얻을 수 있다는 점이 중요하다.
핵심 요약
비디오 생성 모델이 복잡한 프롬프트를 만족하지 못하는 문제를 해결하기 위해 VideoGen-Agent를 제시했다. 이 에이전트는 증강·생성·검증 도구를 멀티턴 상호작용으로 조율하며, 프롬프트와 중간 관찰 결과를 바탕으로 의사결정한다. 지도 학습과 강화학습을 거쳐 도구 사용 능력을 개선했고, 카테고리별 균형잡힌 보상으로 평가했다. 전체 요약 6문장 읽기 → 056 06:10 ▲ 121 · 댓글 48 AI 수학 자동화 시대, 인간 수학자의 역할 재정의해야 AI 시스템이 IMO 수준의 수학 문제 해결과 난제 자동 해결에 성공하면서 수학 분야의 급격한 변화가 진행 중이다. AI · 머신러닝 · A Beginning for Mathematics
Key Point 수학자들이 AI의 정리 증명 능력을 보고 느끼는 위기감이 사실은 직업 보호의 신호가 아니라, 수학의 진정한 목표가 무엇인지 재정의하는 기회를 제시한다.
핵심 요약
AI 시스템이 IMO 수준의 수학 문제 해결과 난제 자동 해결에 성공하면서 수학 분야의 급격한 변화가 진행 중이다. 현재 수학 공동체는 정리 증명을 중심으로 가치를 평가해왔으나, AI가 자동으로 증명을 생산할 수 있게 되면 이 기준은 더 이상 유효하지 않다. 초인적 수준의 AI 수학 능력이 등장해도 개별 결과에 대한 인간의 이해(human understanding)는 자동으로 생기지 않으며, 이것이 인간 수학자의 필수적 역할이다. 전체 요약 5문장 읽기 → 057 11:10 당일 +262 논문 검색·분석하는 오픈소스 AI 리서치 에이전트 공개 Feynman은 자연어 질문으로 학술 논문을 검색·분석·평가할 수 있는 오픈소스 AI 리서치 에이전트다. AI · 머신러닝 · advaitpaliwal/feynman · TypeScript
Key Point 학술 논문 검색과 분석을 자동화하려는 연구자, 데이터 과학자, AI 에이전트 개발자에게 필수 도구가 될 수 있는 오픈소스 플랫폼이 등장했습니다.
핵심 요약
Feynman은 자연어 질문으로 학술 논문을 검색·분석·평가할 수 있는 오픈소스 AI 리서치 에이전트다. PaperRank 점수 매기기, DOI·arXiv·논문 제목으로 접근, 문헌 검토, 논문 대 코드베이스 감사 등 12개 이상의 슬래시 커맨드를 제공한다. 로컬 모델(LM Studio, Ollama, vLLM), 클라우드 프로바이더(OpenAI, OpenRouter, GitHub Copilot)를 지원하며, 스탠드얼론 설치 또는 npm으로 배포된다. 전체 요약 5문장 읽기 →