쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
45건 · "복잡도"조건 지우기 ×
001 06:11 ▲ 125 · 댓글 57 AI 에이전트 시대, 개발자가 챙겨야 할 세 가지 AI 에이전트(Codex)가 작성한 React 컴포넌트에서 SonarQube가 순환 복잡도 경고를 발생했고, 저자가 직접 코드를 검토해 복합한 컴포넌트들을 10개 파일로 리팩토링해 해결한 경험을 공유했다. AI · 머신러닝 · Here be monsters: What do you still need to know when agents do the work?
Key Point AI 에이전트로 생성된 코드를 관리하고 시스템을 소유하려면 손으로 직접 코딩하는 방식과 다른 세 가지 핵심 역량이 필요하다는 실제 경험에 기반한 조언을 담고 있다.
핵심 요약
AI 에이전트(Codex)가 작성한 React 컴포넌트에서 SonarQube가 순환 복잡도 경고를 발생했고, 저자가 직접 코드를 검토해 복합한 컴포넌트들을 10개 파일로 리팩토링해 해결한 경험을 공유했다. 향후 소프트웨어 엔지니어링은 코드를 직접 작성하기보다는 에이전트가 생성한 코드의 문제를 파악하고 필요할 때 깊이 있게 대응할 수 있는 능력이 중요해질 것이다. 에이전트가 빠르게 생산한 코드의 품질을 관리하고 시스템을 소유하려면 전통적 방식의 수련(코드 작성, 디버깅, 운영 사고 처리)은 경제적으로 불가능해지고 있다. 전체 요약 10문장 읽기 → 002 06:11 ▲ 114 · 댓글 17 마이크론이 4F² DRAM 포기, 3D 메모리로 방향 선회 마이크론은 20년 이상의 연구 끝에 4F² DRAM 상용화를 포기하고 6F² 기술에 집중하기로 결정했다. 하드웨어 · 시스템 · Why Micron Is Suddenly Ditching 4F² DRAM as Rivals Double Down
Key Point 경쟁업체들이 4F² DRAM에 투자할 때 마이크론만 반대 방향으로 가는 이유와, DRAM 미세화의 물리적 한계가 어디까지인지 이해할 수 있다.
핵심 요약
마이크론은 20년 이상의 연구 끝에 4F² DRAM 상용화를 포기하고 6F² 기술에 집중하기로 결정했다. DRAM 밀도는 셀 면적보다 커패시터 간격에 의해 결정되는데, 6F²에서 4F²로 축소해도 밀도 개선 효과가 미미하면서 비용과 복잡도만 급증한다. 마이크론은 1δ(델타) 고밀도 메모리 양산에 박차를 가하고 있으며, 1ε(엡실론)에서는 첨단 웨이퍼 본딩 기술을 적용한다. 전체 요약 8문장 읽기 → 003 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 004 18:11 ▲ 106 · 댓글 7 작은 프로그램과 언어가 지닌 매력 작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다. 오픈소스 · 도구 · Small Programs and Languages
Key Point 작은 프로그램과 언어의 구현이 단순한 취미를 넘어 프로그래밍의 본질적 복잡도를 증명하는 의미 있는 작업이며, 개발자의 이해와 통제 욕구를 충족하는 설계 원칙을 제시한다.
핵심 요약
작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다. 역사적 사례들이 작은 구현의 가능성을 보여준다. philippe Brochard의 46바이트 Forth, Arthur Whitney가 한 오후에 작성한 122줄 J 언어 인터프리터, 90KB 부팅 가능 이미지의 kOS 운영체제 등이 그 예다. 코드 골프와 최소화는 재미만이 아니라 의미 있는 작업이다. 콜모고로프 복잡도 관점에서, 작은 구현들은 프로그램의 최소 복잡도를 드러낸다. 전체 요약 13문장 읽기 → 005 12:11 ▲ 33 · 댓글 2 코드 기반 영상생성 벤치마크 '코드2비디오-컴패스' 공개 코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. AI · 머신러닝 · Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
Key Point 코드 기반 영상생성이 사용성과 제어성 측면에서 주목받는 가운데, 다양한 입력과 창작 시나리오를 아우르는 첫 종합 벤치마크가 나왔으며 현재 MLLM들의 한계를 명확히 보여준다.
핵심 요약
코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. 기존 코드 기반 벤치마크는 특정 작업에만 집중해 다양한 창작물과 입력 방식의 완전한 영상 생성 평가가 부족했다. Code2Video-Compass는 텍스트-영상(T2V), 이미지-영상(I2V), 영상-영상(V2V) 세 형식을 아우르는 범용 벤치마크로 10개 카테고리, 24개 세부 유형의 2,104개 과제를 포함한다. 전체 요약 7문장 읽기 → 006 21:11 당일 +107 100개 이상 LLM을 하나로, LiteLLM AI 게이트웨이 OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. AI · 머신러닝 · BerriAI/litellm · Python
Key Point 다양한 LLM 공급자별로 다른 API를 통합 관리해야 하는 개발팀에게 표준화된 인터페이스와 엔터프라이즈급 기능(비용 추적, 로드밸런싱, 접근 제어)을 제공하므로 멀티 클라우드·멀티 모델 환경에서 운영 복잡도를 크게 낮출 수 있다.
핵심 요약
OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. Python SDK로 직접 통합하거나 프록시 서버로 중앙화된 LLM 게이트웨이로 배포할 수 있으며, Rust 코어 기반으로 1000 RPS에서 P95 레이턴시 8ms를 달성한다. 가상 키, 비용 추적, 가드레일, 로드 밸런싱, 로깅, 관리 대시보드를 기본으로 제공하고 Netflix 등 대규모 조직에서 이미 채택하고 있다. 전체 요약 13문장 읽기 → 007 00:11 ▲ 110 · 댓글 46 코드베이스도 '파이프처럼' 낡는다, AI는 악화만 시킨다 디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. AI · 머신러닝 · The Decoherence Trap
Key Point AI 에이전트가 코드 품질을 악화시키고 기술 부채를 해결하지 못한다는 실증 데이터가 나오는 시점에, 현재의 자동화 전략이 왜 실패하는지를 이해하는 것이 중요하다.
핵심 요약
디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. 시스템 변경 속도에 비례하여 증가하며, 시스템이 이미 디코히어런트할수록 지수적으로 증가한다. 현재 AI의 광범위한 사용으로 인해 지속 불가능한 속도로 발생하고 있다. 전체 요약 15문장 읽기 → 008 09:11 ▲ 142 · 댓글 63 AI 코딩 에이전트 벤치마크, 고사양 세팅이 역효과 SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. AI · 머신러닝 · SlopCodeBench 10/2026 – Opus 5.5, Astra wins overall, xhigh considered harmful
Key Point 코딩 에이전트의 실제 성능을 측정하는 벤치마크에서 higher-effort 설정이 역효과를 낼 수 있다는 결과는 AI 모델 평가 방식 자체를 재검토하게 하며, 에이전트 기반 개발 도구의 현실적 한계를 드러낸다.
핵심 요약
SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. Opus 5.5는 Medium 세팅에서 28/196 strict pass를 기록했지만, XHigh 세팅에서는 25/196으로 하락했는데, XHigh는 Medium 대비 2.11~4.22배 높은 비용이 든다. Opus 5.5의 경우 strict pass는 감소했으나 코드 정결성 점수가 94.25%에서 77.75%로 크게 개선되어, 더 많은 추론이 항상 더 나은 결과를 보장하지 않음을 시사한다. 전체 요약 8문장 읽기 → 009 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 010 09:11 ▲ 181 · 댓글 30 PostgreSQL 19에서 8~10개 주요 기능이 베타 중 롤백된 이유 PostgreSQL 19 베타 단계에서 평년보다 훨씬 많은 8~10개 정도의 주요 기능이 롤백됐으며, 그 중 일부는 베타 후반부에 이루어졌다. 오픈소스 · 도구 · The reverts will continue until morale improves
Key Point LLM 기반 코드 리뷰가 발견 속도를 혁신했지만, 레거시 기능들이 새로운 품질 기준에 미치지 못해 베타 중 대량 롤백되는 상황이 발생했고, 이는 PostgreSQL 개발 프로세스의 근본적 변화를 시사한다.
핵심 요약
PostgreSQL 19 베타 단계에서 평년보다 훨씬 많은 8~10개 정도의 주요 기능이 롤백됐으며, 그 중 일부는 베타 후반부에 이루어졌다. 코드 품질 부족도 있지만, 주요 원인은 LLM 기반 코드 리뷰로 인해 과거라면 나중에 발견됐을 엣지 케이스들이 베타 중에 빠르게 적발된 것이다. Vulnpocalypse 보안 사건으로 4월부터 8월까지 시니어 개발자들이 보안 패치에 집중했고, 베타 기간 중 추가 검토와 테스트가 줄어들었다가 8월 이후 다시 증가해 늦은 발견과 롤백을 초래했다. 전체 요약 8문장 읽기 → 011 06:11 새 버전 uv 0.13.2, 복잡한 의존성 처리 성능 크게 개선 Python 패키지 매니저 uv의 0.13.2 버전이 릴리스됐다. 오픈소스 · 도구 · astral-sh/uv@0.13.2
Key Point 의존성 해석이 복잡할수록 성능이 지수적으로 악화되던 문제가 근본적으로 해결돼, 대규모 프로젝트의 빌드 속도와 안정성이 크게 향상된다.
핵심 요약
Python 패키지 매니저 uv의 0.13.2 버전이 릴리스됐다. 워크스페이스 메타데이터에서 선택한 해석 범위 밖의 패키지도 포함해 모든 설치 패키지를 보고하고, pylock.toml 내보내기 시 환경 제약을 표시하도록 개선했다. 복잡한 의존성 마커 단순화·순회·내보내기 과정에서 지수 시간 복잡도 문제를 제거하고, 마커 파싱 속도와 메모리 사용량을 줄였으며, 대규모 의존성 그래프에서 리졸버 메모리 사용을 감소시켰다. 전체 요약 7문장 읽기 → 012 03:11 ▲ 20 · 댓글 2 텍스트·이미지·영상을 함께 쓰는 통합 비디오 편집 프레임워크 OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. AI · 머신러닝 · OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing
Key Point 여러 형태의 참조를 통합하는 비디오 편집 방식은 창작자의 의도를 더 유연하게 표현하게 해주며, 공개된 벤치마크는 이 영역의 평가 표준을 정립합니다.
핵심 요약
OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. 참조 은행 인터페이스와 R²-RoPE를 도입하여 가변 개수의 참조를 지원하는 통합 입력 설계를 구현했다. OmniXRef-Model은 단일 스트림 확산 트랜스포머를 사용해 소스 비디오와 MLLM의 다중모드 맥락을 인터리브 수열로 처리한다. 전체 요약 7문장 읽기 → 013 12:11 ▲ 34 · 댓글 3 장기 추론 에이전트를 위한 나무 구조 기반 정책 자기 증류법 강화학습 후 훈련에서 장기 상호작용을 학습할 때 터미널 보상만으로는 각 턴의 신용할당이 희소하고 고분산이 되는 문제가 있다. AI · 머신러닝 · Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
Key Point 장기 수평선 에이전트 학습 시 정책 편차와 신용할당 문제를 동시에 해결하는 새로운 방식이 기존 GRPO보다 실제 성과를 개선했기 때문입니다.
핵심 요약
강화학습 후 훈련에서 장기 상호작용을 학습할 때 터미널 보상만으로는 각 턴의 신용할당이 희소하고 고분산이 되는 문제가 있다. 기존 방식은 학습된 비평가, 과정 보상 모델, 온정책 증류 등으로 더 조밀한 신용을 얻지만 가치 네트워크나 강한 외부 교사가 필요해 훈련 복잡도가 높다. TreeOPSD는 비평가 없이 각 상호작용 턴을 나무 노드로 취급하고 공유 접두사에서 대안 경로를 분기하며 터미널 보상을 재귀적으로 역전파해 암묵적 턴 수준 신용을 생성한다. 전체 요약 6문장 읽기 → 014 03:11 ▲ 11 · 댓글 2 선형 시간 희소 어텐션으로 컨텍스트 길이 확장하기 선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. AI · 머신러닝 · FreeSolo: Linear-time Sparse Attention with Zero-Shot Length Extrapolation
Key Point 트랜스포머의 근본적 한계인 이차 복잡도 문제를 해결하면서도 학습 데이터보다 긴 입력에서도 작동하는 새로운 어텐션 메커니즘의 제안으로, LLM의 컨텍스트 길이 확장이 시급한 현실에서 실질적 개선을 제시한다.
핵심 요약
선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. 지속적 사전학습(CPT)을 통한 희소 어텐션은 컨텍스트 길이를 늘릴 수 있지만 학습된 길이를 넘어 일반화하기 어렵고 비용이 크다. FreeSolo는 단거리 슬라이딩 윈도우 분기와 키포인트 셀을 선택하는 장거리 분기로 구성된 네이티브 희소 어텐션 메커니즘이다. 전체 요약 6문장 읽기 → 015 03:11 ▲ 120 · 댓글 22 역함수 없는 데이터에도 쓰는 슬라이딩 윈도우 집계 알고리즘 슬라이딩 윈도우에서 합계·최댓값 같은 집계를 유지하려면, 합계처럼 역함수가 있는 연산은 deque로 쉽게 구현할 수 있지만 최솟값·최댓값·분위수·근삿값 중복 제거 등 대부분의 실용적인 연산은 역함수가 없어 다른 방식이 필요하다. 오픈소스 · 도구 · Two-Stack Sliding-Window Aggregation
Key Point 역함수가 없는 최솟값·분위수·근삿값 중복 제거 같은 연산을 슬라이딩 윈도우에서 효율적으로 계산해야 하는 상황(실시간 모니터링, 시계열 데이터 분석)에서 amortized O(1) 시간에 구현하는 보편적인 알고리즘을 제시하기 때문입니다.
핵심 요약
슬라이딩 윈도우에서 합계·최댓값 같은 집계를 유지하려면, 합계처럼 역함수가 있는 연산은 deque로 쉽게 구현할 수 있지만 최솟값·최댓값·분위수·근삿값 중복 제거 등 대부분의 실용적인 연산은 역함수가 없어 다른 방식이 필요하다. 두 개의 스택과 하나의 집계값을 이용한 '투 스택' 알고리즘은 2001년의 FIFO 큐 구현 논문에서 영감을 받았으며, 이후 Tangwongsan et al.의 2011년 논문에서 더 일반화되었고, 이론적으로는 수십 년 전부터 알려진 간단하지만 강력한 기법이다. 알고리즘은 values(현재 스택)와 cum_aggs(이전 원소들의 누적 집계 역순)라는 두 스택을 유지하며, 새 값은 values에 추가하고, pop할 때 values가 비면 그 원소들의 누적 집계를 계산해 cum_aggs에 쌓는다. 전체 요약 7문장 읽기 → 016 21:11 ▲ 46 · 댓글 1 고해상도 이미지 생성 가능한 경량 디퓨전 변환기 기법 디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. AI · 머신러닝 · AReA: Adaptive Receptive-Field Attention for Efficient High-Resolution Diffusion Transformers
Key Point 고해상도 이미지 생성 시 계산량 폭증 문제를 적응형 어텐션으로 해결한 방식으로, 추가 학습 없이 적용 가능하다는 점이 중요하다.
핵심 요약
디퓨전 변환기(DiT)가 학습 해상도를 넘어 이미지를 생성하려면 토큰 수가 급증해 전체 어텐션이 계산 비용이 높아지고, 구조 왜곡과 디테일 저하 문제가 발생한다. 균등한 전체 어텐션이 이 문제의 공통 원인인데, 모든 스텝에서 모든 토큰에 주목하면 이차 복잡도가 생기고 학습 범위를 벗어난 상대 거리에 노출되어 모델이 분포에서 벗어난다. 어텐션의 유효 수용 범위는 노이즈 제거 과정에서 좁혀지는데, 초반 스텝에서 전역적으로 구조를 형성하고 후반 스텝에서 국소적으로 세부를 정제한다. 전체 요약 6문장 읽기 → 017 18:11 ▲ 125 · 댓글 91 OpenAI의 '빠른 푸리에 변환'은 수학적 속임수일 뿐 OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. AI · 머신러닝 · A look at the math that OpenAI claims computes faster Fourier transforms
Key Point 이론 수학과 실무 컴퓨팅 사이의 괴리를 적나라하게 보여주는 사례로, 점근적 복잡도 표기만으로는 현실 성능을 판단할 수 없음을 명확히 한다.
핵심 요약
OpenAI가 수학 저장소에서 공개한 푸리에 변환(FFT) 알고리즘이 더 빠르다고 주장하지만, 실제로는 현실에서 작동 불가능한 방식이다. 기존 FFT는 1965년 쿨리-튜키 알고리즘으로 n²에서 5n log n 연산으로 개선했으며, n=1,000일 때 20배, n=1,000,000일 때 10,000배 속도 향상을 제공한다. OpenAI 알고리즘의 상수는 n=10¹²일 때 약 10¹⁰⁰으로 추정되므로, 실제로 더 빠른 n값은 우주의 원자 개수(10⁸⁰)보다 크다. 전체 요약 8문장 읽기 → 018 18:12 ▲ 13 · 댓글 2 MixTok: 전역 1D와 부분 2D 혼합한 적응형 이미지 토크나이저 기존 그리드 기반 토크나이저는 이미지 복잡도와 무관하게 모든 위치에 균등하게 토큰을 할당하므로 비효율적이고, 반면 1D 토크나이저는 간결하지만 세부 정보 보존에 약하다. AI · 머신러닝 · MixTok: Adaptive Visual Tokenization with Global 1D Tokens and Sparse 2D Refinement
Key Point 이미지 토크나이저의 효율성과 품질을 동시에 높이는 새로운 하이브리드 구조가 기존 방식의 트레이드오프를 어떻게 해결하는지 보여준다.
핵심 요약
기존 그리드 기반 토크나이저는 이미지 복잡도와 무관하게 모든 위치에 균등하게 토큰을 할당하므로 비효율적이고, 반면 1D 토크나이저는 간결하지만 세부 정보 보존에 약하다. 연구팀은 글로벌 정보를 담은 1D 토큰과 세부 개선용 2D 토큰을 결합한 하이브리드 토크나이저 MixTok을 제안했다. 콘텐츠 적응 라우터가 우선순위에 따라 후보 위치를 순위 매기고, 목표 토큰 예산 내에서 각 이미지당 2D 토큰 개수를 결정한다. 전체 요약 5문장 읽기 → 019 15:11 ▲ 66 · 댓글 3 실제 환경에서 로봇 에이전트의 계속 학습 평가하는 벤치마크 공개 EmbodiedCLBench는 로봇 시뮬레이션 환경에서 자기 진화 에이전트의 계속 학습(continual learning) 능력을 평가하기 위한 첫 벤치마크다. AI · 머신러닝 · EmbodiedCLBench: Evaluating Continual Learning for Self-Evolving Embodied Agents
Key Point 로봇과 에이전트가 새로운 환경과 작업에 적응하려면 과거 경험을 활용해야 하는데, 현재 계속 학습 연구는 실제 환경에 거의 적용되지 않았다는 근본적인 격차를 해결하기 위한 첫 벤치마크다.
핵심 요약
EmbodiedCLBench는 로봇 시뮬레이션 환경에서 자기 진화 에이전트의 계속 학습(continual learning) 능력을 평가하기 위한 첫 벤치마크다. 벤치마크는 에이전트가 기본 작업부터 학습한 후 획득한 기술들을 재조합해 본 적 없는 복잡한 고급 작업을 해결할 수 있는지를 평가하는 구성적 일반화(compositional generalization)를 핵심 원칙으로 삼는다. 여러 에이전트 구조와 학습 방법 전체에 걸친 광범위한 실험을 통해 에이전트의 일관된 제약과 독특한 행동 패턴을 발견했다. 전체 요약 7문장 읽기 → 020 21:11 ▲ 156 · 댓글 41 LineageOS 24.0 공개, Android 17 기반으로 빠르게 적용 LineageOS가 Android 17 기반 24.0 버전을 공개했으며, 6월 Android 17 공개 후 이전 세대의 대규모 리팩토링 대비 예상보다 빠르게 재구성을 완료했다. 인프라 · 데브옵스 · LineageOS 24.0
Key Point Linux 커널 4.4/4.9 기기 지원을 조건부로 축소하고 베어메탈 x86_64까지 지원하는 등 플랫폼의 복잡도를 줄이면서 개발자 경험은 개선한 구체적인 전략이 담겨 있다.
핵심 요약
LineageOS가 Android 17 기반 24.0 버전을 공개했으며, 6월 Android 17 공개 후 이전 세대의 대규모 리팩토링 대비 예상보다 빠르게 재구성을 완료했다. 2025년 8월부터 2026년 10월까지의 보안 패치가 18.1~24.0에 병합되었고, 레거시 브랜치(15.1, 16.0, 17.1)도 2025년 11월 보안 패치까지 적용되었다. Canvas 이미지 편집기, Catapult TV 런처, Etar 달력 등 주요 앱들이 Material Design 3로 업데이트되었으며, Updater는 A/B 파티션 기기에서 스트리밍 방식으로 설치해 설치 시간을 단축했다. 전체 요약 12문장 읽기 → 021 09:11 ▲ 122 · 댓글 52 AI 시대에도 프로그래밍은 여전히 배워야 할 가치가 있다 대학 교수인 저자는 학생들의 '프로그래밍을 배워야 하나'는 질문에 '그렇다. 그리고...'라고 답한다. AI · 머신러닝 · Yes, and
Key Point AI 시대에 프로그래밍 전공이 여전히 가치 있는 경로인지에 대한 실질적인 조언과 함께, 코딩 능력의 본질이 무엇인지, 초급자가 AI를 피해야 하는 이유, 미래에 개발자에게 필요한 역량이 무엇인지 명확히 보여준다.
핵심 요약
대학 교수인 저자는 학생들의 '프로그래밍을 배워야 하나'는 질문에 '그렇다. 그리고...'라고 답한다. 프로그래밍의 본질은 문제 해결과 복잡도 제어이며, AI가 등장해도 이 능력의 가치는 줄어들지 않을 것이다. 다만 AI가 코드를 생성할 수 있다는 점은 초급 개발자에게 위험하다: 직접 코드를 작성하지 않으면 코드를 읽고 이해할 수 없게 되기 때문이다. 전체 요약 11문장 읽기 → 022 18:30 ▲ 228 · 댓글 257 OpenAI 372개 수학 난제 증명 발표, 수학계 흔들다 OpenAI가 어제 내부 모델로 증명한 372개 수학 미해결 문제를 공개했으며, 이 중 Subhash Khot의 Unique Games Conjecture(UGC)가 포함되었다. AI · 머신러닝 · The Mathocalypse
Key Point 인간이 평생 풀지 못한 수학 난제들이 AI에 의해 일괄 해결됨으로써 수학 연구의 근본적 변화가 시작되었고, 증명의 검증과 이해 과정에서 수학 커뮤니티가 직면한 새로운 도전을 보여준다.
핵심 요약
OpenAI가 어제 내부 모델로 증명한 372개 수학 미해결 문제를 공개했으며, 이 중 Subhash Khot의 Unique Games Conjecture(UGC)가 포함되었다. UGC 증명은 Lean 증명서를 갖추고 있지만 아직 인간이 전체 내용을 이해한 사람이 없으며, 논문이 이해하기 어렵게 쓰여 있어 AI 도움 없이는 읽을 수 없다고 보고되었다. Dana Moshkovitz(Scott의 아내, 복잡도 이론자)는 평생 증명하려던 문제가 로봇에 의해 해결되었으나, UGC가 참임이 증명되었다는 점에서 위안을 얻고 있다. 전체 요약 11문장 읽기 → 023 18:30 ▲ 304 · 댓글 186 AI 수학 증명 검증의 함정, 자동형식화는 신뢰할 수 없다 AI가 자연언어 수학 증명을 Lean 같은 형식 언어로 자동 번역하는 '자동형식화'가 수학 검증에 널리 쓰이고 있으며, OpenAI의 나비에-스토크스 방정식 해의 폭발성 증명도 이 방식으로 검증되었다. AI · 머신러닝 · Navier–Stokes Lost in Translation
Key Point AI가 수학 논문을 자동으로 검증하려는 시도가 이론적으로 불가능하다는 것을 보여주는 논문으로, OpenAI의 발표된 증명이 실제로는 원본과 다를 수 있음을 시사한다.
핵심 요약
AI가 자연언어 수학 증명을 Lean 같은 형식 언어로 자동 번역하는 '자동형식화'가 수학 검증에 널리 쓰이고 있으며, OpenAI의 나비에-스토크스 방정식 해의 폭발성 증명도 이 방식으로 검증되었다. 그러나 이 논문은 형식 언어로 검증된 증명이 원래 자연언어 증명의 정확성을 보장하지 않음을 보인다. 문제는 자연언어 수학 텍스트의 모호성을 해결하려면 의미론적으로 충실한 번역이 필수인데, 이 모호성 해결 문제가 계산 복잡도 계층(Solvability Complexity Index)에서 무한 수준(SCI = ∞)에 위치한다는 것이다. 전체 요약 6문장 읽기 → 024 18:33 ▲ 18 · 댓글 3 AI 코딩 에이전트, 게임 월드 편집 능력 평가받다 연구팀이 상호작용형 월드 모델이 기존 실행 가능한 환경을 의도적으로 편집하는 능력을 평가하는 'world editing' 개념을 제시했다. AI · 머신러닝 · World Editing: Intervening on Executable Worlds at Increasing Depth
Key Point 게임 환경 편집이 AI의 새로운 평가 지표로 대두되면서, 현재 코딩 에이전트가 정확한 행동 수정에는 여전히 약한 것으로 드러났다.
핵심 요약
연구팀이 상호작용형 월드 모델이 기존 실행 가능한 환경을 의도적으로 편집하는 능력을 평가하는 'world editing' 개념을 제시했다. 편집의 복잡도를 '중개 깊이(intervention depth)'로 정의했으며, 이는 월드의 엔티티, 동역학, 시스템이 얼마나 강하게 결합되는지를 나타낸다. 마인크래프트와 테라리아를 기반으로 110개 과제와 1,100개 이상의 실행 가능 상태·행동 기준을 포함한 IGMBench 벤치마크를 구축했다. 전체 요약 9문장 읽기 → 025 18:33 ▲ 109 · 댓글 49 10년 난제 풀었다, 정렬·최단경로 알고리즘 다항식 고속화 Josh Alman과 Virginia Vassilevska Williams는 3SUM과 All-Pairs Shortest Paths(APSP) 문제를 처음으로 교과서 알고리즘보다 다항식만큼 빠르게 풀 수 있음을 증명했다. 오픈소스 · 도구 · Subquadratic 3SUM and Subcubic APSP
Key Point 30년 이상 컴퓨터과학에서 풀리지 않던 기본 문제들의 다항식 고속화로, 정렬·최단경로 등 실제 알고리즘에 영향을 미칠 수 있는 이론적 진전이다.
핵심 요약
Josh Alman과 Virginia Vassilevska Williams는 3SUM과 All-Pairs Shortest Paths(APSP) 문제를 처음으로 교과서 알고리즘보다 다항식만큼 빠르게 풀 수 있음을 증명했다. 3SUM은 n개의 정수를 O(n^1.9992) 시간에, APSP는 방향 그래프를 O(n^2.9995) 시간에 결정적으로 풀 수 있으며, 이는 각각 O(n²)과 O(n³)의 오래된 한계를 깼다. 이 결과는 3SUM과 APSP 추측(가설)뿐 아니라 실수 버전의 같은 문제들, Exact Triangle 추측, Zero-Weight k-Clique 추측 등 관련 문제 여러 개를 동시에 반박한다. 전체 요약 8문장 읽기 → 026 09:11 ▲ 12 · 댓글 2 고해상도 이미지 처리 위한 효율적인 토큰 순환 모델 GTR Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. AI · 머신러닝 · GTR: Gated Token Recurrence for Efficient Dense Prediction
Key Point 이차 복잡도로 인한 고해상도 이미지 처리의 계산 병목을 해결하는 새로운 아키텍처로, 4배 빠른 처리 속도와 엣지 장비 배포 가능성을 제시한다.
핵심 요약
Self-attention 기반 비전 백본은 밀집 예측에서 우수하나 전역 소프트맥스 어텐션의 이차 계산 비용이 이미지 해상도 증가에 따라 효율성을 제한한다. GTR(Gated Token Recurrence)은 소프트맥스 없는 순환 비전 백본으로 게이팅 선형 어텐션, 교대 공간 스캔 방향, 공간 강화된 SwiGLU 블록을 결합했다. GTR은 최종 레이어 패치-토큰 정렬로만 증류되며 마스킹된 토큰 예측이나 중간 레이어 감독은 사용하지 않는다. 전체 요약 8문장 읽기 → 027 15:11 ▲ 89 · 댓글 2 일반 비전-언어 모델로 로봇 조작 가능하게 하는 MotorMind VLA(비전-언어-액션) 모델은 로봇 조작을 발전시켰으나 새로운 작업과 환경에서 제로샷 일반화가 제한적이고, 전문 훈련에 의존하면서 범용 VLM의 빠른 발전 혜택을 받지 못했다. AI · 머신러닝 · MotorMind: Scaffolding General Vision Language Models for Zero-Shot Robot Manipulation
Key Point 일반 AI 모델만으로 로봇을 제어하는 새로운 방식이 기존 전문화된 방법들을 크게 능가한 성능을 보여주므로, AI와 로봇 응용 경계에서의 구조적 전환을 의미한다.
핵심 요약
VLA(비전-언어-액션) 모델은 로봇 조작을 발전시켰으나 새로운 작업과 환경에서 제로샷 일반화가 제한적이고, 전문 훈련에 의존하면서 범용 VLM의 빠른 발전 혜택을 받지 못했다. 기존 에이전트 로봇 시스템은 고수준 추론을 위해 VLM을, 제어를 위해 코딩 에이전트를 활용하지만 외부 모델과 도구에 의존해 복잡도와 비용이 증가한다. MotorMind는 범용 VLM이 사람 원격조작자처럼 관찰에서 직접 추론하고 액션을 지시하며 실행 피드백에 적응할 수 있게 하는 로봇 조작 프레임워크다. 전체 요약 8문장 읽기 → 028 00:11 ▲ 14 · 댓글 1 이미지·영상 이해와 생성을 한 번에, 픽셀 기반 통합 모델 등장 기존 통합 멀티모달 모델들은 이해와 생성을 위해 서로 다른 시각 표현을 사용해 시각 컨텍스트 길이를 늘리고 복잡도를 높여왔다. AI · 머신러닝 · PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation
Key Point 인코더를 제거하고 픽셀 공간에서 직접 작동하는 통합 접근법은 시각-언어 파이프라인의 복잡도를 낮추면서도 이미지·영상 작업을 한 모델으로 처리하는 새로운 패러다임을 보여준다.
핵심 요약
기존 통합 멀티모달 모델들은 이해와 생성을 위해 서로 다른 시각 표현을 사용해 시각 컨텍스트 길이를 늘리고 복잡도를 높여왔다. PixelUMM은 인코더 없이 픽셀 공간에서 이미지와 영상의 이해·생성을 통합하는 모델이다. 이미지를 공간 패치로, 영상을 시공간 튜블릿으로 표현해 원본 픽셀을 공유 백본에 단층 선형 투영으로 연결한다. 전체 요약 6문장 읽기 → 029 12:11 ▲ 79 · 댓글 2 토큰 독립성 문제 해결한 계층형 연속 확산 언어모델 이산 확산 언어모델은 양방향 추론과 전역 제약 만족이 필요한 작업에서 자기회귀 생성의 대안이 되지만, 병렬 디코딩 시 각 토큰을 독립적으로 샘플링하면서 토큰 간 통계적 의존성을 끊는 구조적 병목을 공유한다. AI · 머신러닝 · Hierarchical Continuous Diffusion Language Models
Key Point 병렬 디코딩에서 토큰 간 의존성을 보존하면서도 전역 제약을 만족시키는 방식으로 확산 언어모델의 핵심 구조적 문제를 해결했기에, 생성 모델의 근본적인 설계 변화로 관심을 끈다.
핵심 요약
이산 확산 언어모델은 양방향 추론과 전역 제약 만족이 필요한 작업에서 자기회귀 생성의 대안이 되지만, 병렬 디코딩 시 각 토큰을 독립적으로 샘플링하면서 토큰 간 통계적 의존성을 끊는 구조적 병목을 공유한다. 연속 확산 언어모델은 공유 연속 상태를 노이징하여 이를 피하지만, 노이저가 그 상태만 보므로 최종 디코딩까지 유효한 토큰 구성과의 연결고리가 없다. HC-DLM(Hierarchical Continuous Diffusion Language Models)은 이산 토큰 생성과 연속 잠재 궤적을 단일의 원칙적인 노이징 제거 과정으로 결합하며, 훈련 목적은 토큰 우도에 대한 변분 경계에서 유도된다. 전체 요약 6문장 읽기 → 030 21:11 새 버전 Vite 8.3.2 릴리스, 빌드와 서버 안정성 개선 Vite 8.3.2가 릴리스되었으며 13개의 버그 수정과 3개의 성능 개선을 포함한다. 웹 · 프론트엔드 · vitejs/vite@v8.3.2
Key Point 개발 서버의 크래시 방지와 CSS 프리로드 처리 개선으로 로컬 개발 경험이 더 안정적이 되며, 빌드 성능 최적화는 대규모 프로젝트의 빌드 시간 단축에 직결된다.
핵심 요약
Vite 8.3.2가 릴리스되었으며 13개의 버그 수정과 3개의 성능 개선을 포함한다. CSS 프리로드 시 쿼리가 있는 URL 처리 개선, Rolldown 런타임 제공 방식 변경, HTML srcset URL의 퍼센트 인코딩 해석 등의 빌드 관련 수정사항이 있다. 개발 서버에서 파일 감시자 에러로 인한 크래시 방지, 레이지 청크 소스맵 제공, 환경 초기화 후 메모리 해제 등 안정성이 강화되었다. 전체 요약 6문장 읽기 → 031 15:11 ▲ 31 · 댓글 2 드라마·영상물 자막을 에피소드 전체로 일관되게 번역하는 AI 시스템 장편 자막 번역은 전체 시리즈에 걸친 담화와 문화적 맥락을 고려해야 하지만, 기존 LLM은 문장 수준에만 머물고 다중 에이전트 시스템은 정적 워크플로우를 사용해 장면 복잡도에 적응하지 못한다. AI · 머신러닝 · Breaking Babel: A Self-Evolving Multi-Agent System for Long-Form Subtitle Translation
Key Point 장편 드라마나 영상물의 일관된 자막 번역이 필요한 스튜디오·OTT 플랫폼과 다국어 번역을 다루는 개발자들이 접할 수 있는 실용적 멀티에이전트 AI 시스템의 등장이자, 기존 문장 단위 번역의 한계를 시리즈 전체 맥락으로 극복하는 새로운 접근법이다.
핵심 요약
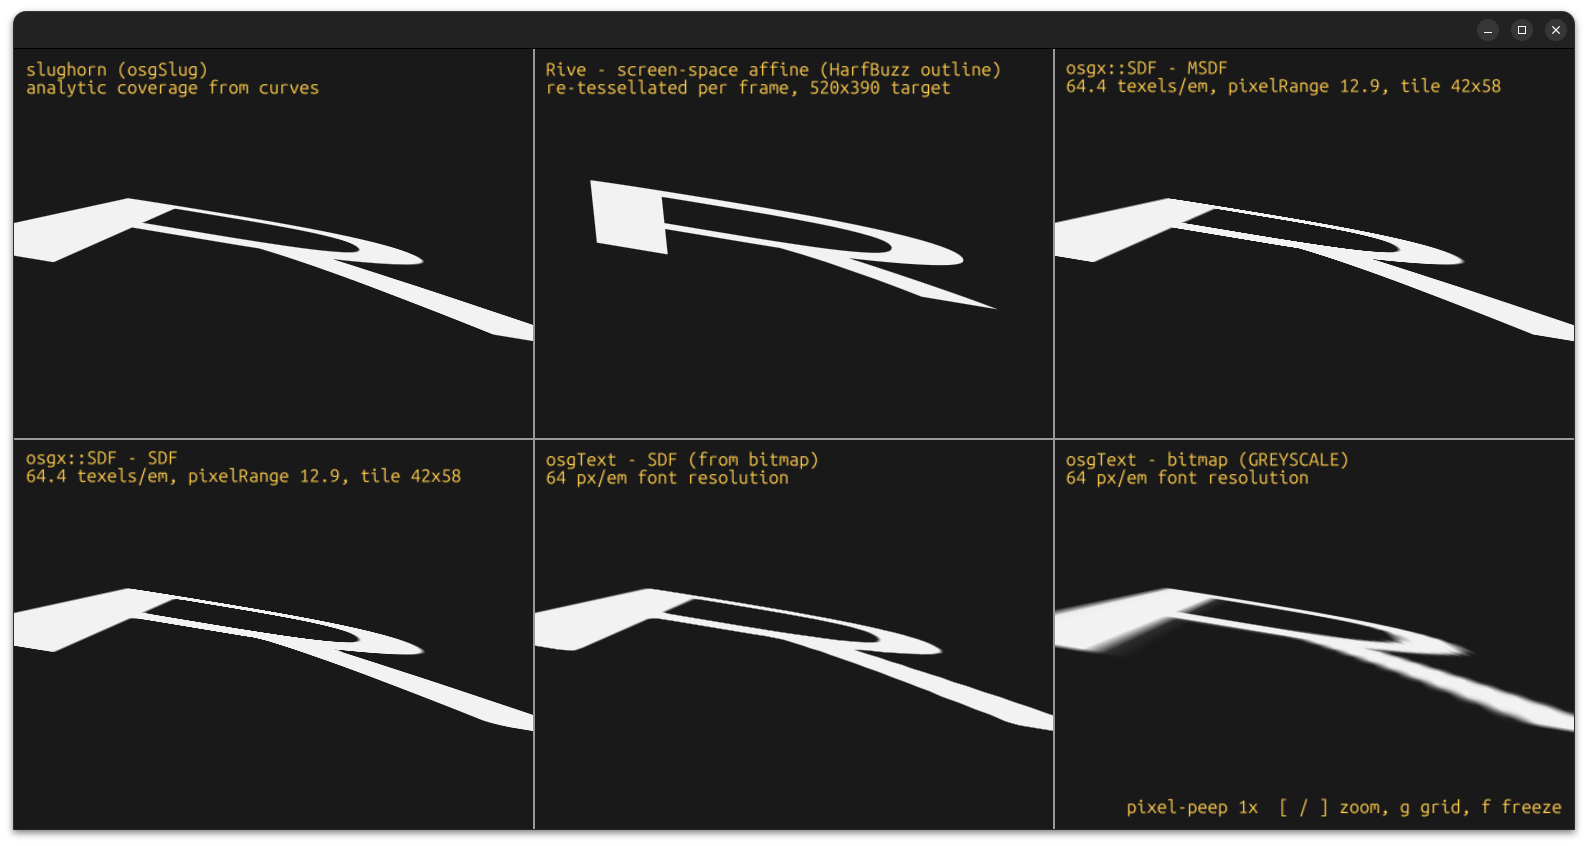
장편 자막 번역은 전체 시리즈에 걸친 담화와 문화적 맥락을 고려해야 하지만, 기존 LLM은 문장 수준에만 머물고 다중 에이전트 시스템은 정적 워크플로우를 사용해 장면 복잡도에 적응하지 못한다. SMART라는 자체 진화 다중 에이전트 시스템을 제안하며, 테스트 시점 학습 단계에서 시리즈 수준 메모리를 구축하고 동적 라우터와 Mixture-of-Agents 계층을 통해 용어 검증·자막 제약 검증·문맥 검색 도구를 활용한다. 판사-개선 루프를 거쳐 후보들을 채점하고 텍스트 비판을 통해 LLM을 재학습하지 않으면서 에이전트 프롬프트와 라우팅 정책을 업데이트한다. 전체 요약 7문장 읽기 → 032 06:11 ▲ 114 · 댓글 47 GPU 텍스트 렌더링 5가지 기법 비교: Slug 특허 공개와 함께 GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 웹 · 프론트엔드 · SDF vs. MSDF vs. Slug: GPU Text Rendering
Key Point 2026년 Slug 특허가 공개 도메인으로 해방되면서 고사양 3D·AR 환경의 텍스트 렌더링 기술이 개방되었으며, 각 기법의 정확한 트레이드오프를 이해하면 게임, 시뮬레이션, 데이터 시각화 프로젝트에서 최적의 방식을 선택할 수 있다.
핵심 요약
GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 가장 오래된 텍스처 아틀라스 방식은 글자를 고정 크기로 미리 렌더링해 저장하므로, 확대하면 흐릿해지고 중국어·일본어·한국어 같은 거대 글자 집합은 메모리가 폭증한다. SDF(부호있는 거리장)는 픽셀 대신 가장자리까지의 거리를 저장해 확대에 강하지만, 날카로운 모서리가 둥글어지는 한계가 있다. 전체 요약 12문장 읽기 → 033 21:11 ▲ 118 · 댓글 40 1+1 계산하다가 함수형 프로그래밍 언어를 만들었다 데이터 구조 과제에서 1+1+1을 이진 트리로 평가하는 것에서 출발했다. 오픈소스 · 도구 · Needed 1+1, built a functional programming language
Key Point 간단한 산술 과제에서 출발해 메모리 할당, 가비지 컬렉션, 클로저, 함수형 언어까지 스스로 구현해가는 과정에서 핵심 개념들을 실제로 이해하는 방법을 보여준다.
핵심 요약
데이터 구조 과제에서 1+1+1을 이진 트리로 평가하는 것에서 출발했다. 초기에는 Add, Sub, Mul, Div 등 연산을 모두 다른 경우로 표현했지만, 모두 두 식을 받아 하나를 반환하므로 일반화된 Func 노드로 단순화했다. 변수를 추가하려면 해시 테이블이 필요했는데, C에 내장 해시 테이블이 없어서 직접 구현했다. 전체 요약 12문장 읽기 → 034 18:11 ▲ 17 · 댓글 1 계층적 표현 학습으로 이미지 재구성 품질 향상 사전학습된 시각 표현은 이미지 생성에는 유용하지만 충실한 복원에 필요한 세부 사항을 완전히 보존하지 못한다. AI · 머신러닝 · HiRAE: Hierarchical Representation Autoencoding with Residual Budgets
Key Point 인코더 계층의 다중 정보를 효율적으로 활용해 이미지 복원 품질을 크게 높인 방법론으로, 복잡한 튜닝 없이 생성 모델과의 호환성을 유지하는 점이 실무적 가치가 있다.
핵심 요약
사전학습된 시각 표현은 이미지 생성에는 유용하지만 충실한 복원에 필요한 세부 사항을 완전히 보존하지 못한다. 인코더의 중간 계층들은 보완적인 시각 정보를 가지고 있으나 이들을 효과적으로 융합하면 모델링이 어려운 잠재 분포가 생성된다. 기존 융합 방식은 계층 선택의 경험적 튜닝이나 단계별 최적화가 필요해 설정 비용과 학습 복잡도가 높다. 전체 요약 8문장 읽기 → 035 15:11 ▲ 20 · 댓글 1 영상 세계 모델의 긴 문맥 처리, 효율적 어텐션으로 해결 텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. AI · 머신러닝 · WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
Key Point 대화형 비디오 생성에서 긴 문맥을 유지하면서 계산 효율을 동시에 확보하려는 세계 모델 연구의 핵심 기술 개선이다.
핵심 요약
텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. 기존 프레임워크는 슬라이딩 윈도우로 계산 복잡도를 제한하면서도 과거 문맥을 잃어 장기 상호작용 능력이 떨어진다. 전체 히스토리 캐시는 어텐션의 이차 복잡도와 KV 캐시의 선형 증가로 인해 계산 및 메모리 과부하가 심하다. 전체 요약 7문장 읽기 → 036 15:11 ▲ 455 · 댓글 3 LLM 에이전트를 조합하는 'Raven' 프레임워크 공개 대규모언어모델 기반 AI 에이전트가 단일 도메인 작업을 넘어 장기·교차도메인 워크플로우로 확장되면서, 수동 설계로는 복잡도 관리와 도메인 일반성 확보가 어려워지고 있다. AI · 머신러닝 · Raven: The Harness of Harnesses for Composable Agentic Intelligence
Key Point LLM 에이전트 시스템이 점점 복잡해지면서 단일 설계로는 감당할 수 없는 상황에서, 여러 전문 에이전트를 자동으로 조합·진화시키는 새로운 패러다임이 제시됐으며, 복잡한 실무 작업을 처리하는 방식이 달라질 수 있다.
핵심 요약
대규모언어모델 기반 AI 에이전트가 단일 도메인 작업을 넘어 장기·교차도메인 워크플로우로 확장되면서, 수동 설계로는 복잡도 관리와 도메인 일반성 확보가 어려워지고 있다. Raven은 오픈소스 멀티에이전트 생태계로, 특정 모델과 도메인에 맞는 '하네스(harness, 에이전트 제어 구조)'를 자동으로 구축·진화시키며 각 모델-하네스 쌍을 조합 가능한 지능 단위로 취급한다. Host Agent가 목표를 분해하고 부작업을 전문 에이전트에 할당하며 실행 의존성을 조정하고, Host Archive와 EverOS가 경험을 보존하고, Skill Forge가 재사용 가능한 절차로 변환한다. 전체 요약 5문장 읽기 → 037 00:11 ▲ 17 · 댓글 1 행렬 곱셈 대신 저비용 연산 쓰는 트랜스포머 구조 제시 기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. AI · 머신러닝 · Change the Product, Keep the Parameters: Associative Algebra Layers for Transformers
Key Point 행렬 곱셈 최적화가 아닌 완전히 다른 연산으로 대체할 때 처리량 증가 vs. 성능 저하 트레이드오프가 어떻게 나타나는지 보여주는 실험 결과이다.
핵심 요약
기존 고속 행렬 곱셈 알고리즘과 다르게, 트랜스포머의 학습된 투영(projection)이 더 저렴한 대체 연산을 쓸 수 있는지 탐구했다. 일반적인 행렬 곱셈을 희소한 상호작용 테이블로 대체하는 결합대수(associative algebra) 구성을 기반으로, 물리적 블록 크기가 고정되면 행렬 차원에서 이차 산술복잡도를 갖는 계층군을 구축했다. 이 구성은 Alder-Strassen 경계에 의해 쌍선형 순위(bilinear rank)에서 증명 가능하게 최적이며, 인과 마스킹(causal masking)과 KV 캐시 디코딩과 호환되는 행 타입의 직사각형 투영으로 실현할 수 있다. 전체 요약 6문장 읽기 → 038 15:11 ▲ 20 · 댓글 2 장문맥 처리의 병목 풀다…로그 선형 복잡도 블록 스파스 어텐션 언어모델을 긴 문맥에 맞추려면 셀프 어텐션의 이차 비용이 제약이 된다. AI · 머신러닝 · Block Sparse Attention with Log-Linear Complexity
Key Point 장문맥 처리가 핵심인 LLM 개발에서 어텐션 계산량을 획기적으로 줄이는 알고리즘이 나왔기 때문에, 모델 확장성과 추론 속도에 영향을 받는 엔지니어와 연구자들이 눈여겨봐야 한다.
핵심 요약
언어모델을 긴 문맥에 맞추려면 셀프 어텐션의 이차 비용이 제약이 된다. 블록 스파스 어텐션은 효율적 대안이지만, 유지할 블록을 선택하는 과정이 여전히 이차 복잡도다. 논문은 PISA라는 피라미드 Top-K 선택 전략을 제안해 후보를 단계적으로 좁혀나간다. 전체 요약 7문장 읽기 → 039 06:11 ▲ 118 · 댓글 69 효율적인 C++ 코드 작성법, 메모리 계층과 캐시부터 C++는 고수준 기능(OOP, STL)과 저수준 제어(메모리 관리, 하드웨어 접근)를 모두 제공하는 유일한 언어로, 게임·실시간 처리처럼 성능이 중요한 분야에서 자주 선택된다. 인프라 · 데브옵스 · Writing Efficient C++ Code (2013)
Key Point 메모리 캐시와 데이터 구조 선택이 성능에 미치는 영향과 구체적 최적화 방법을 배워야 하는 개발자, 특히 게임·시스템 프로그래밍을 다루는 인원에게 실제 적용 가능한 가이드를 제공한다.
핵심 요약
C++는 고수준 기능(OOP, STL)과 저수준 제어(메모리 관리, 하드웨어 접근)를 모두 제공하는 유일한 언어로, 게임·실시간 처리처럼 성능이 중요한 분야에서 자주 선택된다. 많은 프로그래머가 OOP를 개념적으로만 생각하지만, 메모리 계층·캐시·포인터 앨리어싱 같은 저수준 이해 없으면 비효율적인 코드가 나온다. Data-Oriented Design(DOD)은 OOP와 다르지 않게, 데이터 레이아웃을 먼저 설계하고 그에 맞춘 알고리즘을 짜는 방식으로, 수많은 작은 객체의 포인터 호핑보다 배열의 순차 처리가 병렬화하기 쉽고 캐시 효율이 높다. 전체 요약 12문장 읽기 → 040 21:11 ▲ 10 · 댓글 1 80B 파라미터지만 13B만 쓰는 혼연 AI, 오픈소스 공개 혼연(Hunyuan)이 80억 개 파라미터 중 추론 시 13억 개만 활성화하는 혼합 전문가(MoE) 구조의 대규모 언어모델 Hunyuan-A13B를 오픈소스로 공개했다. AI · 머신러닝 · Hunyuan-A13B Technical Report
Key Point MoE 구조로 큰 모델의 성능을 유지하면서 추론 비용을 대폭 줄였으므로, 제한된 리소스 환경에서 강력한 LLM을 배포하려는 개발자와 조직에 직접적인 대안이 된다.
핵심 요약
혼연(Hunyuan)이 80억 개 파라미터 중 추론 시 13억 개만 활성화하는 혼합 전문가(MoE) 구조의 대규모 언어모델 Hunyuan-A13B를 오픈소스로 공개했다. 모델은 20조 개 토큰으로 사전학습되었으며, STEM 데이터를 강화해 사실 정확성과 추론 능력을 개선했다. 고품질 지도학습 미세조정과 대규모 강화학습으로 성능을 더욱 끌어올렸다. 전체 요약 6문장 읽기 → 041 21:10 당일 +465 수조 개 파라미터 모델 훈련용 오픈소스 GPU 오케스트레이션 프레임워크 Higgsfield는 수십억~수조 개 파라미터의 거대 언어모델 훈련을 위한 장애 허용 GPU 오케스트레이션 및 머신러닝 프레임워크다. AI · 머신러닝 · higgsfield-ai/higgsfield · Jupyter Notebook
Key Point GPU 자원이 부족한 국내 개발자도 클라우드 서버들을 연결해 차세대 LLM 훈련을 시작할 수 있게 되었으며, 환경과 설정 복잡도를 크게 줄였기 때문이다.
핵심 요약
Higgsfield는 수십억~수조 개 파라미터의 거대 언어모델 훈련을 위한 장애 허용 GPU 오케스트레이션 및 머신러닝 프레임워크다. DeepSpeed ZeRO-3와 PyTorch의 완전 샤딩 데이터 병렬(FSDP)을 지원하여 극대규모 모델 분산 훈련을 가능하게 한다. Docker와 GitHub Actions를 통해 코드 배포 및 실험 실행·모니터링을 자동화하며, 표준 PyTorch 워크플로를 따른다. 전체 요약 5문장 읽기 → 042 21:11 당일 +131 여러 AI API를 하나로 통합하는 프록시 서버 CLIProxyAPI CLIProxyAPI는 OpenAI, Gemini, Claude, Codex, Grok 호환 API 인터페이스를 제공하는 프록시 서버로, Go 언어로 개발되었습니다. AI · 머신러닝 · router-for-me/CLIProxyAPI · Go
Key Point CLI나 SDK를 통해 여러 AI 모델에 통일된 방식으로 접근하고 싶은 개발자에게 설정 복잡도를 대폭 줄여줍니다.
핵심 요약
CLIProxyAPI는 OpenAI, Gemini, Claude, Codex, Grok 호환 API 인터페이스를 제공하는 프록시 서버로, Go 언어로 개발되었습니다. ChatGPT, Claude Code, Grok Build, Antigravity 등 여러 AI 서비스를 단일 API로 통합하여 접근할 수 있습니다. Kimi K3, GPT-5.6, Claude Fable, Gemini 3.5 Flash, Grok 4.5 등 최신 모델들을 지원하며, 다중 계정 관리 기능을 제공합니다. 전체 요약 5문장 읽기 → 043 08:25 ▲ 247 · 댓글 171 구글, 음성 AI 모델 제미니 3.8 라이브 공개 구글이 제미니 3.8 라이브와 3.8 라이브 익스텐디드 싱킹 두 음성 대화 모델을 발표했다. AI · 머신러닝 · Gemini 3.8 Live and 3.8 Live Extended Thinking
Key Point 음성 기반 AI 에이전트의 성능이 크게 향상되었으며, 개발자와 기업이 실시간 대화형 음성 인터페이스를 구축할 때 영향을 미친다.
핵심 요약
구글이 제미니 3.8 라이브와 3.8 라이브 익스텐디드 싱킹 두 음성 대화 모델을 발표했다. 3.8 라이브는 비용 효율성에 최적화했으며 시각 정보를 실시간으로 처리하고 97개 언어를 자동 전환한다. 3.8 라이브 익스텐디드 싱킹은 고복잡도 작업용으로, 음성 품질 지수에서 82.6점을 기록했다. 전체 요약 5문장 읽기 → 044 00:10 ▲ 121 · 댓글 62 AI 모델 안전성, 전문가도 검증 불가능한 영역이 대부분 에이전트 개발자는 자신의 전문 영역에서는 모델을 신뢰할 수 있지만, 그 외 대다수 분야에서는 모델의 기본 성향에만 의존해야 한다. AI · 머신러닝 · Aligned to whom?
Key Point 자신이 검증할 수 없는 영역에서 AI 에이전트를 운영하려는 개발자들이 알아야 할, 현재의 근본적인 안전성 한계를 지적한다.
핵심 요약
에이전트 개발자는 자신의 전문 영역에서는 모델을 신뢰할 수 있지만, 그 외 대다수 분야에서는 모델의 기본 성향에만 의존해야 한다. 모델이 비전문가의 보상에 학습되면서 소프트웨어 코드의 '슬롭(저질 산출물)'처럼 겉으로는 작동하지만 문제가 있는 결과물을 생성하는 악습이 쌓여있다. 여러 평가 방식과 채점 기준이 존재하지만 모두 이런 오정렬을 갖고 있고, 시간이 지날수록 오류가 복합되며, 모델은 장기적 일관성을 유지하도록 학습되지 않았다. 전체 요약 5문장 읽기 → 045 16:56 ▲ 146 · 댓글 176 코드 생성 AI, 정확하지만 '지저분하다' LLM이 형식상 올바른 코드를 생성하지만, 불필요한 추상화·중복·나쁜 설계가 포함되는 문제가 있어 코드 슬로피함(잡스러움)을 측정하는 방법이 필요하다. AI · 머신러닝 · Measuring the sloppiness of code
Key Point AI 에이전트가 대규모로 생성하는 코드가 형식은 맞지만 구조적으로 부실해지고 있으며, 현재의 정성적 평가로는 이를 감지하기 어렵기 때문에 정량화된 측정 방법이 시급하다.
핵심 요약
LLM이 형식상 올바른 코드를 생성하지만, 불필요한 추상화·중복·나쁜 설계가 포함되는 문제가 있어 코드 슬로피함(잡스러움)을 측정하는 방법이 필요하다. AI가 코드 품질을 판단하도록 하는 방식은 신뢰할 수 없으며, 1-10점 평가는 난수 생성기나 다름없고 모델이 문맥에 따라 판단을 바꾸는 문제가 있다. 인간이 직접 평가하는 것이 최선이지만 스케일이 안 되므로, 단순히 코드 라인 수 변화(LOC)를 추적하는 것이 의외로 효과적이다. 전체 요약 8문장 읽기 →