쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
15건 · "벤치마킹"조건 지우기 ×
001 15:11 ▲ 11 · 댓글 1 텍스트·이미지 섞인 생성 평가하는 IntReal 데이터셋 공개 인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. AI · 머신러닝 · IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Key Point 텍스트와 이미지를 섞어 생성하는 멀티모달 AI의 성능을 처음으로 체계적으로 평가할 벤치마크가 등장해, 이 분야 연구와 모델 개선의 기초가 될 것으로 예상된다.
핵심 요약
인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. 현 상황의 근본 문제는 명확한 인터리브 생성 작업과 학습 데이터 부재, 그리고 모델 성능을 세밀하게 진단할 평가 프로토콜 부족이다. IntReal은 100K 샘플의 실제 멀티모달 데이터셋과 전문 모델 7개 차원으로 모델을 평가하는 IntReal Evaluation Suite로 구성된다. 전체 요약 6문장 읽기 → 002 00:11 ▲ 37 · 댓글 2 대형 언어모델, 문화적 추론에서 고전하다 LLM이 언어 지원을 확대하면서 문화 다양성 이해를 평가할 필요가 대두됐으나, 기존 벤치마크는 영어 중심이고 문화 커버리지가 제한적이며 실제 맥락 적용보다 사실 지식에 초점을 맞춰왔다. AI · 머신러닝 · CulturalRiddles: A Multicultural Benchmark of Riddles
Key Point LLM이 다양한 문화의 맥락과 암묵적 지식을 이해하는 데 얼마나 취약한지 보여주는 첫 대규모 평가로, 모델 개발 시 영어권 중심 편향을 재검토해야 함을 시사한다.
핵심 요약
LLM이 언어 지원을 확대하면서 문화 다양성 이해를 평가할 필요가 대두됐으나, 기존 벤치마크는 영어 중심이고 문화 커버리지가 제한적이며 실제 맥락 적용보다 사실 지식에 초점을 맞춰왔다. CulturalRiddles는 62개 문화권(45개국, 51개 언어)에서 참여 커뮤니티가 직접 만든 수백 개의 원본 문화 수수께끼로 구성한 벤치마크다. 각 수수께끼는 문화적 뿌리가 깊으며 귀납적·합성적 추론, 상세한 사실·사회적 지식, 언어 능력, 문화 특화 연관성 이해를 필요로 한다. 전체 요약 5문장 읽기 → 003 21:11 당일 +104 구글, PyTorch를 TPU에서 실행하는 백엔드 공개 Google이 PyTorch 모델을 Google의 TPU(Tensor Processing Unit) 장치에서 실행할 수 있게 하는 torch_tpu 백엔드를 오픈소스로 공개했다. AI · 머신러닝 · google-pytorch/torch_tpu · C++
Key Point PyTorch 기반 프로젝트를 Google TPU에서 GPU 대신 더 저렴하게 실행할 수 있는 경로가 생겼고, ML 엔지니어와 연구자들이 다양한 가속 옵션을 선택할 수 있게 됐다.
핵심 요약
Google이 PyTorch 모델을 Google의 TPU(Tensor Processing Unit) 장치에서 실행할 수 있게 하는 torch_tpu 백엔드를 오픈소스로 공개했다. PyTorch 연산을 위한 ATen 커널 구현, XLA 계산 최적화를 위한 컴파일 캐시, 데이터 병렬화와 텐서 병렬화를 지원하는 분산 학습 기능을 포함한다. Llama, Qwen, ResNet, DLRM, minGPT, UNet 등 다양한 모델의 예제와 torch.compile()을 통한 그래프 모드 실행 통합, 디버깅 및 벤치마킹 유틸리티를 제공한다. 전체 요약 7문장 읽기 → 004 09:11 ▲ 142 · 댓글 63 AI 코딩 에이전트 벤치마크, 고사양 세팅이 역효과 SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. AI · 머신러닝 · SlopCodeBench 10/2026 – Opus 5.5, Astra wins overall, xhigh considered harmful
Key Point 코딩 에이전트의 실제 성능을 측정하는 벤치마크에서 higher-effort 설정이 역효과를 낼 수 있다는 결과는 AI 모델 평가 방식 자체를 재검토하게 하며, 에이전트 기반 개발 도구의 현실적 한계를 드러낸다.
핵심 요약
SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. Opus 5.5는 Medium 세팅에서 28/196 strict pass를 기록했지만, XHigh 세팅에서는 25/196으로 하락했는데, XHigh는 Medium 대비 2.11~4.22배 높은 비용이 든다. Opus 5.5의 경우 strict pass는 감소했으나 코드 정결성 점수가 94.25%에서 77.75%로 크게 개선되어, 더 많은 추론이 항상 더 나은 결과를 보장하지 않음을 시사한다. 전체 요약 8문장 읽기 → 005 06:11 ▲ 195 · 댓글 47 구글이 PyTorch용 TPU 백엔드 오픈소스화 구글이 TorchTPU를 오픈소스로 공개했으며, 이는 PyTorch 모델과 연산을 구글 TPU 디바이스에서 직접 실행 가능하게 하는 네이티브 백엔드입니다. AI · 머신러닝 · Google open-sources TorchTPU, a native PyTorch back end for TPUs
Key Point PyTorch 사용자들이 NVIDIA GPU 대신 구글 TPU에서 직접 모델을 학습하고 추론할 수 있게 되어, 클라우드 인프라 선택지와 최적화 옵션이 확대됩니다.
핵심 요약
구글이 TorchTPU를 오픈소스로 공개했으며, 이는 PyTorch 모델과 연산을 구글 TPU 디바이스에서 직접 실행 가능하게 하는 네이티브 백엔드입니다. PyTorch ATen 커널 구현, XLA 컴파일 캐시 최적화, 데이터 병렬화와 텐서 병렬화를 포함한 분산 학습 지원, torch.compile() 통합 등의 기능을 제공합니다. Llama, Qwen, ResNet, DLRM, minGPT, UNet 등 다양한 모델의 예제가 포함되어 있으며, 디버깅과 벤치마킹을 위한 유틸리티도 제공됩니다. 전체 요약 8문장 읽기 → 006 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 007 06:11 ▲ 292 · 댓글 268 AI 벤치마크, 실제 일자리의 90%는 측정 못 한다 AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. AI · 머신러닝 · 90% of US working hours are spent on tasks not covered well by AI benchmarks
Key Point AI 기업과 정책입안자들이 모델의 실제 경제적 영향을 평가할 때 사용하는 벤치마크들이 큰 맹점을 가지고 있으며, 특히 중간 소득 일자리와 물리적 작업에 대한 측정이 심각하게 부족하다는 점이 드러났다.
핵심 요약
AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. 미국 근로시간의 90%가 기존 벤치마크에서 5개 이상의 프롬프트로 커버되지 않는 작업에 사용되고 있다. 923개 직업 중 단 208개만 충분히 벤치마크된 작업(5개 이상 프롬프트)을 보유하고 있으며, 22개 직업군 중 6개는 해당하는 직업이 없다. 전체 요약 10문장 읽기 → 008 06:11 ▲ 10 · 댓글 2 대비 학습 전략, 정말 효과적인지 검증했더니 멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. AI · 머신러닝 · What Really Works for Universal Multimodal Embeddings? A Controlled Study of Contrastive Training Strategies
Key Point 기존에 널리 쓰이던 대비 학습 전략들이 실제로는 효과가 미미하거나 역효과를 낸다는 것을 체계적으로 증명해, 멀티모달 모델 개발자들이 어떤 조합이 정말 작동하는지 알 수 있게 했다.
핵심 요약
멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. 음수 선택, 배치 구성, 그래디언트 조정 등 다양한 대비 학습 전략들이 제안되었지만, 통제된 조건에서 그 실효성은 불명확했다. 연구팀은 MMEB 벤치마크에서 대표적인 전략들을 통일된 프레임워크로 평가한 결과, 대부분이 기본 기준선 대비 미미한 개선만 제공하며 일부는 성능을 악화시키는 것으로 나타났다. 전체 요약 8문장 읽기 → 009 18:11 ▲ 104 · 댓글 66 프라이빗 AI 가계부, 맥에서만 돈다 Pulse Local은 맥용 가계부 앱으로, AI 모델과 거래 데이터가 모두 사용자 기계에서만 실행되고 외부 서버로 전송되지 않는다. AI · 머신러닝 · Show HN: Pulse Local, a Mac budgeting app whose AI models run on your machine
Key Point 개인 금융 데이터가 외부 서버로 전송되지 않으면서도 AI 기반 질답을 제공하는 가계부 앱의 새로운 접근 방식을 보여주므로, 프라이버시와 편의성을 모두 원하는 사용자에게 선택지를 제공한다.
핵심 요약
Pulse Local은 맥용 가계부 앱으로, AI 모델과 거래 데이터가 모두 사용자 기계에서만 실행되고 외부 서버로 전송되지 않는다. 초기 설치 시 약 2.9GB의 AI 모델을 다운로드하며, 그 후 네트워크 활동은 앱 업데이트 확인이 유일하고 사용자 정보는 절대 전송되지 않는다. 지출 현황, 카테고리별 예산 비교, 월간 비교, 현금 흐름 계산, 예측 등 주요 가계부 기능을 모두 제공한다. 전체 요약 12문장 읽기 → 010 18:33 ▲ 146 · 댓글 53 마이크로벤치마크는 300밀리초가 최적일까 효과적인 마이크로벤치마크 설계의 기준으로 입력 크기를 조정해 약 300ms가 되도록 할 것을 제안한다. 인프라 · 데브옵스 · Benchmark in Milliseconds
Key Point 마이크로벤치마크 설계 시 실제 조정할 수 있는 구체적인 기준과 그 이유를 제시하고 있어, 성능 최적화 작업을 하는 개발자가 더 효율적인 측정 방식을 적용할 수 있다.
핵심 요약
효과적인 마이크로벤치마크 설계의 기준으로 입력 크기를 조정해 약 300ms가 되도록 할 것을 제안한다. 300ms 범위가 최적인 이유는 밀리초 단위로 정수 값을 얻어 정확도와 가독성이 우수하기 때문이다. 10ms 이하는 인터프리터 시작 등 고정 비용의 영향을 받아 편향되고, 1초 이상은 벤치마크 반복 실행이 너무 오래 걸린다. 전체 요약 5문장 읽기 → 011 12:11 ▲ 125 · 댓글 97 GLM 5.3 Flash 한 달 집중 사용, 배운 점은? Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. AI · 머신러닝 · One month coding with GLM 5.3 Flash
Key Point 개발 조직이 효율적인 LLM 모델을 선택할 때 직면하는 실제 비용 구조와 예상 외 변수들을 구체적 사례로 보여주며, 에너지·비용 절감을 위한 실질적 전략을 제시한다.
핵심 요약
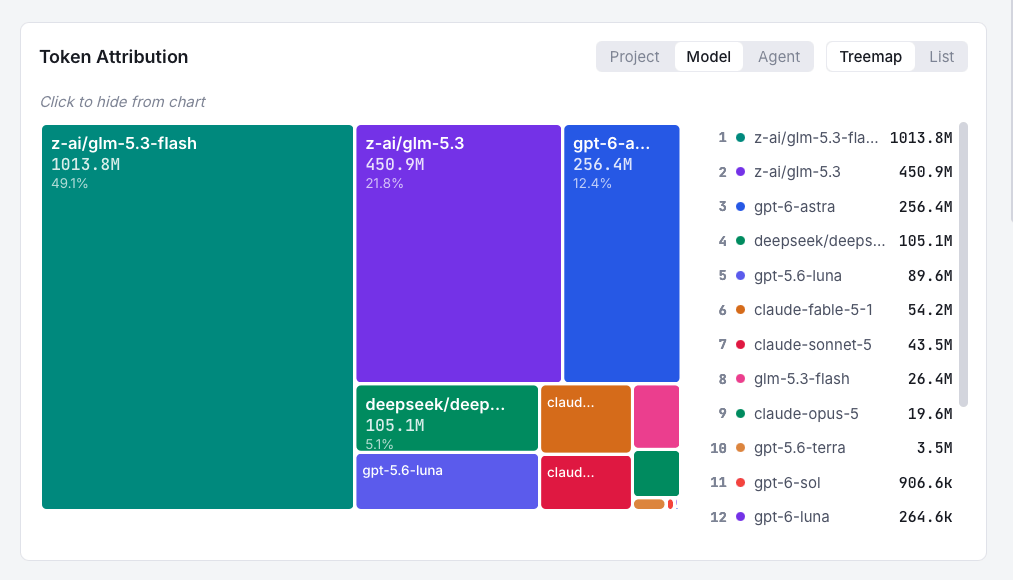
Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다. 첫 2주는 계획대로 GLM 5.3 Flash만 사용해 $68, 365g 탄소 배출, 4kWh 에너지 소비로 예산 내에서 운영했다. 실험용 MCP 서버 프로토타입에서 잘못된 모델을 선택해 450M 토큰, $150, 5kWh 에너지를 하루 밤사이에 소비하는 예상 외 비용이 발생했다. 전체 요약 8문장 읽기 → 012 00:11 ▲ 186 · 댓글 111 델리, 전력 손실률 50%에서 5%로 획기적 감소 2002년 델리는 노후 송배전망과 불법 도용으로 50% 이상의 전력 손실과 빈번한 정전 문제로 고통받았다. 인프라 · 데브옵스 · How Delhi Cut Electricity Loss from 50 to 5 Percent
Key Point 낙후된 전력망을 가진 전 세계 도시들이 벤치마킹할 수 있는 구체적이고 검증된 개선 전략을 제시하며, 기술과 체계 개선의 균형이 인프라 혁신에 얼마나 중요한지 보여준다.
핵심 요약
2002년 델리는 노후 송배전망과 불법 도용으로 50% 이상의 전력 손실과 빈번한 정전 문제로 고통받았다. 2001년 도입된 인도 전력법(2003)이 주정부 통제를 분산하고 민간 기업 진입을 허용하면서 델리의 배전망을 BSES, Tata Power 두 회사가 인수했다. Tata Power는 53.5%, BSES는 51.5~63.1%의 상업 및 기술 손실률 문제를 해결해야 했다. 전체 요약 11문장 읽기 → 013 21:11 ▲ 102 · 댓글 42 LLM으로 Jev 수준의 고속 의사결정 모델 구축하기 GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. AI · 머신러닝 · Turning GLM-5.3-Flash into a Jev-like decision model
Key Point 일반 LLM을 구조화된 의사결정 모델로 탈바꿈시키는 프롬프트 기법이 전문 의사결정 모델과 실무 성능에서 동등하다는 것을 보여주므로, 고도량 의사결정 시스템 구축 시 모델 선택지와 비용-성능 트레이드오프 판단에 실질적 참고가 될 수 있다.
핵심 요약
GLM-5.3-Flash를 프롬프트 엔지니어링으로 한 번의 forward pass에서 타입화된 의사결정을 내도록 개선했으며, 전문 의사결정 모델 Jev와 동등한 정확도를 달성했다. 기본 아이디어는 LLM의 확률 분포에서 옵션별 확률을 직접 읽는 것이다. 숫자로 인덱싱된 옵션 목록을 JSON으로 제시하고 프롬프트를 'choice_index:'로 끝내면, 모델이 첫 토큰에서 내놓는 확률 분포가 각 옵션의 신뢰도가 된다. 29개 공개 데이터셋(2~151개 옵션, 의도 라우팅·감정 분석·법률 문서 등 포함)을 벤치마킹한 결과, GLM-5.3-Flash와 Jev의 정확도 차이는 중앙값 0.7 포인트로 통계적으로 유의미하지 않았다. 전체 요약 12문장 읽기 → 014 21:11 ▲ 101 · 댓글 52 LLM 에이전트가 Rust 코드를 2~20배 빠르게 최적화 Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. AI · 머신러닝 · Writing Rust code that's fast by asking agents to make the code faster
Key Point 에이전트형 LLM의 성능 최적화 능력이 구체적인 벤치마크 결과로 입증됨에 따라, 고성능 코드 작성의 새로운 워크플로우가 가능해졌다.
핵심 요약
Claude Opus 같은 에이전트 LLM이 반복적인 최적화 지시를 받으면 Rust 코드를 크게 개선할 수 있음을 실험으로 증명했다. UMAP 차원 축소 알고리즘을 Rust로 구현해 벤치마킹하면서, 에이전트가 faer·simsimd 같은 최적화 라이브러리를 활용해 코드 속도를 2배~20배 향상시켰다. 에이전트에 명확한 성공 기준(pass/fail)과 긴 마크다운 프롬프트(대문자·강조 사용)를 제공하니 자동 반복 최적화가 효과적이었다. 전체 요약 5문장 읽기 → 015 21:11 당일 +125 당신의 하드웨어에 맞는 LLM 찾아주는 도구 llmfit Rust 기반 터미널 도구로, CPU·메모리·GPU·VRAM을 자동 감지해 실행 가능한 오픈소스 LLM 모델을 추천한다. AI · 머신러닝 · AlexsJones/llmfit · Rust
Key Point 로컬에서 LLM을 실행하려는 개발자들이 자신의 하드웨어 사양에 정확히 맞는 모델을 찾기 어려운 문제를 직접 해결해주는 도구이기 때문이다.
핵심 요약
Rust 기반 터미널 도구로, CPU·메모리·GPU·VRAM을 자동 감지해 실행 가능한 오픈소스 LLM 모델을 추천한다. GGUF·AWQ·GPTQ·EXL2 등 다양한 양자화 포맷을 지원하며 메모리 사용량과 토큰 속도를 예측한다. 인터랙티브 TUI, 웹 대시보드, REST API 엔드포인트 중 선택해 사용할 수 있다. 전체 요약 5문장 읽기 →