GLM 5.3 Flash 한 달 집중 사용, 배운 점은?
원제 One month coding with GLM 5.3 Flash
125 포인트댓글 97
Key Point
개발 조직이 효율적인 LLM 모델을 선택할 때 직면하는 실제 비용 구조와 예상 외 변수들을 구체적 사례로 보여주며, 에너지·비용 절감을 위한 실질적 전략을 제시한다.
핵심 요약
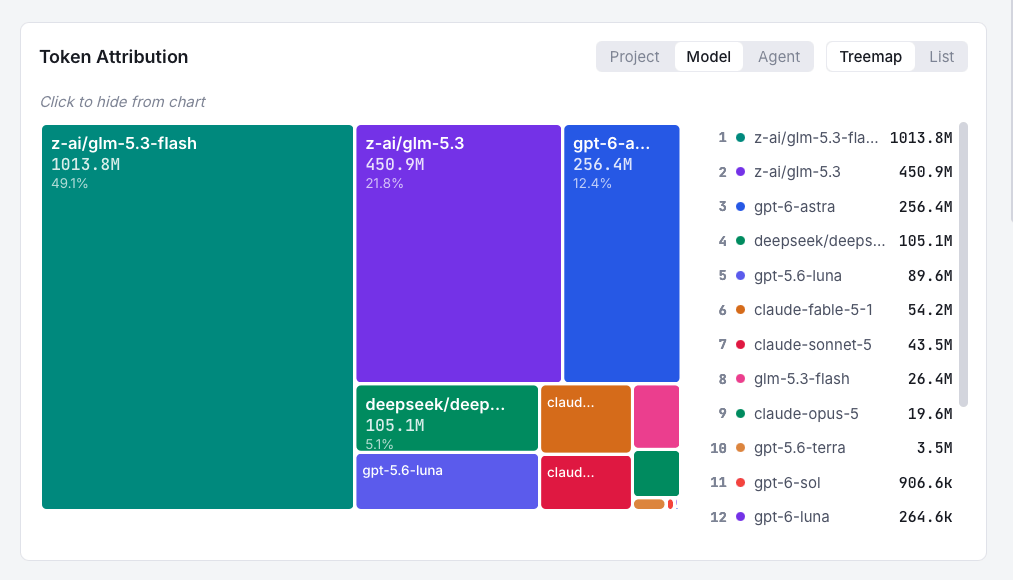
- Wagtail 팀이 9월 한 달간 GLM 5.3 Flash 모델만 사용하는 도전을 진행했으나, 총 2B 토큰 중 절반만 해당 모델로 처리했다.
- 첫 2주는 계획대로 GLM 5.3 Flash만 사용해 $68, 365g 탄소 배출, 4kWh 에너지 소비로 예산 내에서 운영했다.
- 실험용 MCP 서버 프로토타입에서 잘못된 모델을 선택해 450M 토큰, $150, 5kWh 에너지를 하루 밤사이에 소비하는 예상 외 비용이 발생했다.
- GLM 5.3 Flash의 인기로 인한 인프라 용량 부족으로 성능 저하가 발생해 DeepSeek V4.1 Flash, Qwen 3.8 Flash 등 다른 모델로 전환해야 했다.
- 각 모델의 성능을 벤치마킹하기 위해 실험 목적으로 다양한 모델을 계속 테스트해야 했는데, 이것이 추가 비용의 주요 원인이었다.
- 최종적으로 예상 대비 에너지 사용량이 3.5배(10kWh → 35kWh) 증가했지만, 모델 선택과 에이전트 기법에 대한 중요한 교훈을 얻었다.
- 다음 달 목표는 지속적인 로컬 사용량 측정, 실험 예산 수립, 멀티 에이전트 기법 개선, 더 효율적인 모델 개발에 집중하는 것이다.
- 실제 개발 업무에서는 저비용 Flash 계열 모델 1~2개에 집중하는 것이 충분히 실행 가능하며, AI 추론 업무의 대부분이 이런 효율적인 모델로 처리되어야 한다는 것이 목표다.