쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 3일 (화)까지 3849건
100건 (최대치) · "논문"조건 지우기 ×
001 15:11 ▲ 17 · 댓글 1 모달리티 넘나드는 임베딩 모델, 통합 프레임워크로 재정의 이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. AI · 머신러닝 · From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
Key Point 멀티모달 AI의 핵심 기술인 임베딩의 분산된 연구를 처음 통합 프레임워크로 정리해, 앞으로의 모달리티 간 통합 기술 발전 방향을 가늠할 수 있습니다.
핵심 요약
이미지, 텍스트, 음성 등 모달리티별로 분화된 임베딩 모델 연구가 실은 대조 학습, Transformer 아키텍처, 세밀도 전환이라는 공통 원리로 수렴하고 있다고 지적한다. 논문은 멀티모달 임베딩의 진화 경로를 세 가지 진행 단계로 정의한다: 커버리지 확대, 비교 가능성 확보, 구성성 달성이다. 각 단계를 위한 통합 방안으로 변환(transformation)은 모달리티 간 커버리지를 확대하고, 정렬(alignment)은 서로 다른 모달리티를 비교 가능하게 만든다. 전체 요약 6문장 읽기 → 002 12:11 ▲ 125 · 댓글 85 AI 시대 수학자에게 필요한 것은 '자아를 내려놓는 것' 수학이 인간의 창작물인가 아니면 독립적으로 존재하는 진리인가 하는 근본적 질문이 AI 발전과 함께 재현되고 있다. AI · 머신러닝 · Egoless Mathematics in the AI Era
Key Point AI가 수학 증명을 만들어내기 시작하는 시점에서, 수학자가 추구해야 할 가치가 결과 생산과 개인 능력 증명에만 있는지를 근본부터 물음으로써 학문의 목적을 재정의하는 시도이다.
핵심 요약
수학이 인간의 창작물인가 아니면 독립적으로 존재하는 진리인가 하는 근본적 질문이 AI 발전과 함께 재현되고 있다. 수학의 발견은 수동적으로 보이지만, 고생물학자가 화석을 찾을 때처럼 이미 존재하는 것을 능동적으로 탐색하는 과정이며, 수학자가 만드는 개념과 틀은 그 진리를 인식하기 위한 수단이다. 정의를 도입한 후 예상 밖의 연결이 드러나거나 예상이 반례에 부딪힐 때처럼, 우리의 사고가 자유롭게 결정하지 않은 독립적 질서와 만난다. 전체 요약 14문장 읽기 → 003 03:11 ▲ 10 · 댓글 2 어두운 사진을 한 번에 살리는 생성형 AI 기술 개발 저조도 이미지 개선(LLIE)은 심각하게 손상된 저조도 사진으로부터 적절히 노출되고 자연스러운 이미지를 복원하는 작업이다. AI · 머신러닝 · GLOW-FM: Efficient Generative Low-Light Image Enhancement with One-Step Latent Flow Matching
Key Point 어두운 사진을 한 번의 계산으로 고품질로 복원할 수 있게 되면, 스마트폰이나 보안카메라 같은 실제 기기에서 즉시 적용할 수 있는 기술이 된다.
핵심 요약
저조도 이미지 개선(LLIE)은 심각하게 손상된 저조도 사진으로부터 적절히 노출되고 자연스러운 이미지를 복원하는 작업이다. 기존 확산 기반 생성형 방법은 강력한 이미지 사전 정보를 활용해 높은 화질을 달성하지만, 반복적 샘플링으로 인한 계산 비용이 크고 실제 배포에 제약이 있다. GLOW-FM은 한 번의 함수 평가로 고품질 개선을 수행하는 단계별 지연 흐름 일치(flow matching) 프레임워크를 제안한다. 전체 요약 9문장 읽기 → 004 18:11 ▲ 18 · 댓글 2 확산 모델 가속, 게이트 재구성에서 비롯된다 REPA, dispersive regularization 등 확산 트랜스포머 학습 가속 기법들이 작동하는 방식을 재검토한 논문이다. AI · 머신러닝 · No Channels Left Behind: Understanding Diffusion Acceleration through Residual Gates
Key Point 확산 모델 가속의 진짜 메커니즘이 특성 구조가 아닌 잔차 게이트 재구성에서 비롯되며, 이를 정량화하고 개선하는 새로운 방법을 제시한다.
핵심 요약
REPA, dispersive regularization 등 확산 트랜스포머 학습 가속 기법들이 작동하는 방식을 재검토한 논문이다. 기존에는 추가 감독(auxiliary objectives), 공간 구조 우선순위, 개선된 특성 기하학으로 설명했으나 실제 핵심은 다르다. AdaLN-Zero 잔차 게이트 α가 가속 방법들에 의해 대폭 재구성되며, 이것이 가속의 주요 원인임을 밝혔다. 전체 요약 8문장 읽기 → 005 15:11 ▲ 62 · 댓글 1 System-1과 System-2의 협력이 AGI 확장의 열쇠인가 AGI 달성을 위해 지금까지는 더 큰 모델, 더 많은 데이터와 계산력으로 System-2(실행 담당)를 확장하는 방식에 의존해왔다. AI · 머신러닝 · Does Scaling Toward AGI Depend on What System-1 Lets System-2 Execute?
Key Point 모델 스케일링 외에 실행 효율성을 먼저 최적화하는 방식이 AGI 달성에 더 효과적일 수 있음을 보여주기 때문에, 대규모 AI 프로젝트의 계산 자원 배분 방향을 재검토하는 데 중요하다.
핵심 요약
AGI 달성을 위해 지금까지는 더 큰 모델, 더 많은 데이터와 계산력으로 System-2(실행 담당)를 확장하는 방식에 의존해왔다. 논문은 System-1(가벼운 의미 인식 예측기)과 System-2를 함께 설계해 System-2가 가치 있는 작업만 수행하도록 게이팅하는 방식을 제안한다. 조건부 상호작용 루프는 System-1이 각 후보의 유용성을 추정, System-2가 적응형 임계값으로 승인된 것만 실행, 결과가 System-1을 업데이트하는 구조로 동작한다. 전체 요약 8문장 읽기 → 006 09:11 ▲ 103 · 댓글 56 다양한 감각의 AI가 같은 세계를 본다는 증명 Yann LeCun과 Randall Balestriero는 '플라톤적 표현 가설(PRH)'을 증명하는 논문을 발표했다. 가설은 여러 모달리티(영상, 텍스트 등)로 학습한 AI 모델들이 스케일을 늘리면 같은 세계 표현에 수렴한다는 것이다. AI · 머신러닝 · Proving and improving the Platonic Representation Hypothesis with JEPAs
Key Point 서로 다른 모달리티 모델들이 같은 표현에 수렴한다는 오랜 추측을 수학적으로 증명하면서, 언어 모델이 비전과 정렬되는 방식의 근본적 차이를 밝혔고, 스케일보다 학습 데이터 품질이 중요함을 입증했다.
핵심 요약
Yann LeCun과 Randall Balestriero는 '플라톤적 표현 가설(PRH)'을 증명하는 논문을 발표했다. 가설은 여러 모달리티(영상, 텍스트 등)로 학습한 AI 모델들이 스케일을 늘리면 같은 세계 표현에 수렴한다는 것이다. 저자들은 '플라톤적 표현 정리(Platonic Representation Theorem)'를 증명했다. 결합 임베딩 예측 아키텍처(JEPA)가 서로 다른 모달리티로 학습될 때, 긍정 쌍이 같은 장면의 두 관찰('좋은 뷰')이고 오정렬이 제한되면 회전을 제외하고 동일한 표현을 학습한다는 뜻이다. 다음 토큰 예측(언어 모델의 기본 방식)은 나쁜 뷰(한 문서의 일부)를 사용하는 JEPA로, 이는 언어 모델이 스케일을 통해서만 비전과 정렬되는 이유를 설명한다. 전체 요약 8문장 읽기 → 007 06:11 ▲ 113 · 댓글 132 수학은 변했다, 우리도 행동해야 한다 OpenAI가 10월 6일 700개 이상의 연구 논문을 공개했으며, AI가 수학의 많은 분야에서 획기적 기여를 할 수 있음을 입증했다. AI · 머신러닝 · Mathematics has changed. Let's act like it
Key Point AI가 증명 생산 방식을 근본적으로 바꾸면서 수학 학계의 평가, 채용, 출판 시스템 전체를 재설계해야 하는 시점이 왔다.
핵심 요약
OpenAI가 10월 6일 700개 이상의 연구 논문을 공개했으며, AI가 수학의 많은 분야에서 획기적 기여를 할 수 있음을 입증했다. 그러나 AI 회사들의 논문은 문장이 형편없고 출처 표기가 부실하며 일부는 틀렸으므로, 수학 커뮤니티는 채용, 출판, 학생 교육에서 더 많은 통제력을 행사해야 한다. AI가 Langlands 프로그램 같은 중앙 문제들을 풀었다 해도, 그것이 수론 전체를 '해결'하는 것은 아니며, 이는 원소 주기율표 발견이 화학을 완성하지 못한 것과 같다. 전체 요약 12문장 읽기 → 008 00:10 ▲ 132 · 댓글 67 RAM에서 전파신호 생성해 폐쇄망 컴퓨터 정보 탈취 물리적으로 네트워크와 단절된 폐쇄망 컴퓨터(에어갭 시스템)도 악성코드를 통해 정보 유출이 가능하다는 새로운 공격 기법이 제시됐다. 보안 · Leaking Secrets from Air-Gap Computers by Spelling Radio Signals from RAM (2024)
Key Point 폐쇄망 시스템의 물리적 단절이 더 이상 절대적 보안이 아님을 보여주는 사례로, 고도의 민감한 정보 처리 환경의 보안 설계에 직접적인 영향을 미친다.
핵심 요약
물리적으로 네트워크와 단절된 폐쇄망 컴퓨터(에어갭 시스템)도 악성코드를 통해 정보 유출이 가능하다는 새로운 공격 기법이 제시됐다. 악성코드는 RAM(메모리 버스)에서 전파신호를 생성해 파일, 이미지, 키로깅 데이터, 생체정보, 암호화 키 같은 민감한 정보를 인코딩할 수 있다. 공격자는 소프트웨어 정의 라디오(SDR) 하드웨어와 일반적인 안테나만으로 거리를 두고 이 전파신호를 수신한 뒤 디코딩해 바이너리 정보로 변환할 수 있다. 전체 요약 5문장 읽기 → 009 15:11 ▲ 107 · 댓글 31 학자의 책임, 지식을 나누는 것 2004년 박사학위 논문 제출 후 Intel CPU의 하이퍼스레딩 캐시를 통한 정보 유출 취약점을 발견한 저자는 6개월간 책임감 있게 정보를 공개하기 전에 보안팀들에게 조용히 알리고 대응할 시간을 주었다. 보안 · The Duty of a Scholar
Key Point 2004년 Intel 캐시 취약점을 발견한 컴퓨터 보안 전문가가 책임감 있는 공개 방식을 실천한 경험을 통해, 지식을 소유한 사람의 도덕적 책임이 무엇인지, 그리고 학자로서 사회에 기여하는 방식에 대해 철학적으로 정리한 글입니다.
핵심 요약
2004년 박사학위 논문 제출 후 Intel CPU의 하이퍼스레딩 캐시를 통한 정보 유출 취약점을 발견한 저자는 6개월간 책임감 있게 정보를 공개하기 전에 보안팀들에게 조용히 알리고 대응할 시간을 주었다. 2005년 5월 BSDCan에서 논문을 발표했고, FreeBSD, NetBSD, Red Hat 등이 동시에 보안 공지를 발행했으며, 이는 책임감 있는 공개(coordinated disclosure)의 과정을 보여준다. 저자는 독신이고 무직인 상황에서 부모 집에 살며 의료보험 걱정이 없는 캐나다에 거주하고 있었기 때문에 이 책임을 다할 수 있었으며, 미국에 살았다면 의료보험과 고용을 먼저 찾아야 했을 것이라고 지적한다. 전체 요약 13문장 읽기 → 010 00:11 ▲ 10 · 댓글 2 AI 이미지 편집 에이전트, 다중 도구와 검증으로 성능 40% 향상 기존 에이전트형 이미지 편집 시스템은 복잡한 작업을 단계별로 분해하지만, 단계가 실패하면 제한된 도구로 재시도하고 수동 평가에만 의존한다. AI · 머신러닝 · EditAgent: Rethinking Agentic Image Editing
Key Point 에이전트형 이미지 생성 도구의 근본적인 한계를 지적하고, 일반 LLM 모델로도 효과적인 개선이 가능함을 보여주기 때문이다.
핵심 요약
기존 에이전트형 이미지 편집 시스템은 복잡한 작업을 단계별로 분해하지만, 단계가 실패하면 제한된 도구로 재시도하고 수동 평가에만 의존한다. 이들 에이전트는 실행 가능한 작업의 범위와 판단자가 감지할 수 있는 정보의 범위라는 두 가지 제약에 묶여 있다. 기존 범용 이미지 편집기는 전문가 주석이 달린 벤치마크에서 40% 이상의 경우 사용 가능한 결과를 내지 못했고, 편집 유형에 따라 신뢰할 만한 판단자도 없었다. 전체 요약 7문장 읽기 → 011 21:11 ▲ 103 · 댓글 72 지구를 망원경으로, 블랙홀 사진 찍기 블랙홀은 우주에서 가장 작은 천체인데도 매우 밝을 수 있으며, 중력이 너무 강해 빛도 탈출할 수 없는 사건의 지평선으로 정의된다. 기타 · How do you take a picture of a black hole?
Key Point 블랙홀 사진 촬영의 역사, 기술, 국제 협력의 규모를 담은 구체적 내용을 통해 과학의 불가능해 보이는 목표가 어떻게 실현되는지 이해할 수 있다.
핵심 요약
블랙홀은 우주에서 가장 작은 천체인데도 매우 밝을 수 있으며, 중력이 너무 강해 빛도 탈출할 수 없는 사건의 지평선으로 정의된다. 하버드 천체물리학자 셉 도엘먼이 이끈 250명의 연구팀은 사건의 지평선 망원경(EHT)이라는 전 지구적 라디오 망원경 네트워크를 구축해 블랙홀의 첫 이미지를 촬영했다. 망원경의 각도 분해능은 빛의 파장을 망원경 크기로 나눈 값인데, 블랙홀 같은 극도로 작은 천체를 보려면 매우 짧은 파장과 거대한 망원경이 필요하다. 전체 요약 13문장 읽기 → 012 03:11 ▲ 269 · 댓글 203 AI가 SRE를 대체하지 않으면, 기술을 퇴화시킨다 AI가 사건 대응의 95%를 처리할 때, SRE는 남은 5%의 중요한 문제를 처리할 능력이 실제로 떨어질 수 있다는 문제를 제기한다. 인프라 · 데브옵스 · AI isn't replacing SREs, it's deskilling them
Key Point AI가 많은 일을 자동화할수록 SRE의 실제 대응 능력이 떨어지는 '역설적 퇴화' 현상이 의료·항공 산업에서도 이미 관찰되고 있으며, 신입 인재 육성 경로까지 단절될 수 있다는 점이 기술 조직의 구조적 위험을 보여준다.
핵심 요약
AI가 사건 대응의 95%를 처리할 때, SRE는 남은 5%의 중요한 문제를 처리할 능력이 실제로 떨어질 수 있다는 문제를 제기한다. 1983년 인지심리학자 리잔느 베인브릿지의 연구 논문 '자동화의 역설(Ironies of Automation)'을 근거로, 자동화가 발전할수록 인간 운영자는 자동화 실패 시 대응할 능력이 낮아진다는 패러독스를 설명한다. 산업 자동화가 육체 노동자들의 예외 상황 대처 능력을 빼앗았듯이, AI는 패턴 매칭, 분류, 알려진 문제 해결 같은 일상적 인지 업무를 대신하면서 SRE에게 드물고 복잡한 문제만 남긴다. 전체 요약 11문장 읽기 → 013 18:11 ▲ 117 · 댓글 28 미야자키의 '붉은 돼지'는 반전 영화다 학술논문으로, 미야자키의 애니메이션 '붉은 돼지'(1992)를 전쟁·평화 연구 관점에서 분석한다. 기타 · A Pig, the State, and War: Porco Rosso (Kurenai No Buta) (2014)
Key Point 국내 애니메이션 팬과 교육자들이 미야자키 영화를 단순 엔터테인먼트가 아닌 전쟁과 평화, 민족주의의 문제를 담은 작품으로 분석하는 학술적 틀을 얻을 수 있다.
핵심 요약
학술논문으로, 미야자키의 애니메이션 '붉은 돼지'(1992)를 전쟁·평화 연구 관점에서 분석한다. 영화는 제1차 세계대전 후 아드리아 해의 해적과 싸우는 주인공 돼지 포르코 로쏘의 이야기이며, 1990년 걸프전·유고슬라비아 전쟁과 관련해 미야자키의 반전 메시지를 담고 있다. 포르코가 돼지로 변한 것은 전쟁으로 인한 트라우마와 함께 '인간의 이기심', '국가의 민족주의', '전쟁의 군국주의' 세 가지 요소를 혐오하기 때문이다. 전체 요약 11문장 읽기 → 014 03:11 ▲ 11 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
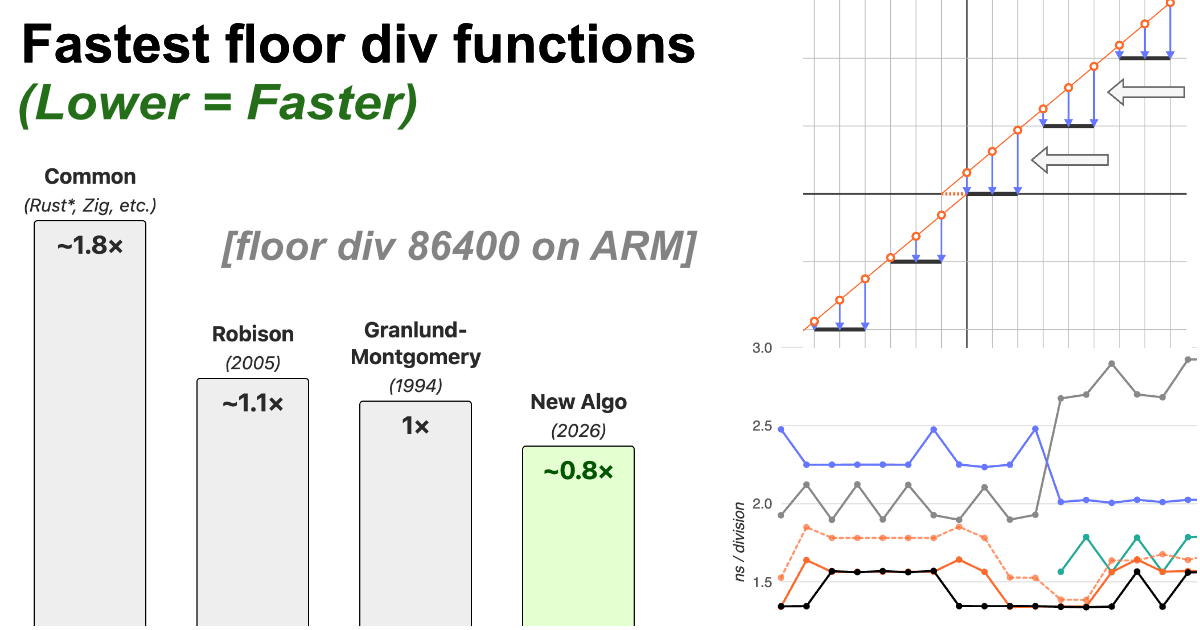
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 015 00:11 ▲ 123 · 댓글 10 64비트 부호있는 정수 나눗셈을 더 빠르게 하는 새로운 알고리즘 부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 인프라 · 데브옵스 · A new faster algorithm to compute 64-bit signed floor division
Key Point 정수 나눗셈은 단순해 보이지만 음수 처리와 성능 최적화가 깊이 있으며, 다양한 CPU에서 구현 방식을 달리 선택해야 하므로 저수준 성능 최적화가 중요한 시스템 프로그래밍에 실질적 가치가 있습니다.
핵심 요약
부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 컴파일 타임에 나누는 수가 정해진 경우, 기존 방법은 곱셈 1회 + 2~3 사이클 또는 나머지 계산이 필요했으며, 음수 처리를 위해 추가 분기나 비교가 들어갑니다. 1994년 Granlund·Montgomery 논문의 기법을 확장하면 양수 나눗셈을 부호 반사로 처리해 5~6 사이클을 3 사이클로 단축할 수 있고, 2005년 Arch D. Robison 논문은 곱셈-더하기-시프트 조합으로 더 단순한 구현을 제시했습니다. 전체 요약 10문장 읽기 → 016 15:11 ▲ 22 · 댓글 2 멀티모달 AI, 이미지와 텍스트에 동일한 제어벡터 공유 통합 멀티모달 모델에서 텍스트 생성을 제어하는 벡터가 이미지 생성에도 제로샷으로 전이되는지를 연구한 논문이다. AI · 머신러닝 · Cross-modal Steering Vectors Exist Across Both Image and Text Generation
Key Point 멀티모달 AI의 내부 구조에서 이미지와 텍스트가 공유하는 통일된 개념 표현을 직접 입증해, 모델 해석 가능성과 제어 기술의 새로운 방향을 보여준다.
핵심 요약
통합 멀티모달 모델에서 텍스트 생성을 제어하는 벡터가 이미지 생성에도 제로샷으로 전이되는지를 연구한 논문이다. 감정, 물체 크기 등 다양한 개념의 제어벡터를 찾아 다른 모달리티로 전이시켰으며, 텍스트→이미지, 이미지→텍스트 양방향 모두에서 성공적으로 작동했다. 텍스트에만 고유한 개념(정중한 vs 구어체 표현)도 이미지에선 정중한 옷차림·디자인처럼 일관된 효과를 나타냈다. 전체 요약 5문장 읽기 → 017 00:11 ▲ 18 · 댓글 2 자동 정리 증명, 복잡한 워크플로우보다 단순 반복 루프가 더 효과적 형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. AI · 머신러닝 · h1: A Taste of the Bitter Lesson in Automated Theorem Proving
Key Point 자동화된 정리 증명에서 복잡한 설계 워크플로우 대신 단순한 에이전트 루프가 더 효과적일 수 있다는 발견은, 향후 형식 검증 시스템을 어떻게 구축할 것인지에 대한 근본적인 접근 방향을 바꿀 수 있다.
핵심 요약
형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. 이 논문은 '비터 레슨' 질문을 제기한다: 테스트 타임 계산을 확장하는 단순한 에이전트 루프가 이런 복잡한 워크플로우와 경쟁할 수 있는가? h1이라는 단순한 도구를 개발했는데, 이는 모델에게 Lean 4의 효율적인 인터페이스를 제공하고 검증자 피드백과 자기 성찰로 작동하며, 명시적 분해나 탐색 구조를 강요하지 않는다. 전체 요약 7문장 읽기 → 018 21:11 ▲ 14 · 댓글 2 주의력 레이어에 희소성 더하는 Nestor 모델 제안 현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. AI · 머신러닝 · Nested Sparsity for Scalable Pretraining and Continual Learning
Key Point 조건부 계산의 새로운 메커니즘이 기존 MoE 모델의 학습 효율과 연속 학습 능력을 동시에 개선하는 구체적인 방법을 제시하고 있습니다.
핵심 요약
현재 대규모 언어 모델은 Mixture-of-experts(MoE) 트랜스포머를 사용하며, MoE 연산자에서만 조건부 계산으로 가중치의 일부만 활용한다. 이 논문은 주의력 연산자를 일반화한 대안적 조건부 계산 메커니즘을 제안하며, 이는 MoE 희소성과 계층적으로 결합되는 '중첩 희소성'을 만든다. Nestor라 명명한 이 모델은 동일한 계산량과 희소성에서 기존 MoE 트랜스포머보다 언어 모델 사전학습에서 더 나은 성능을 보인다. 전체 요약 6문장 읽기 → 019 18:11 ▲ 89 · 댓글 2 코드 기반 영상 생성 평가하는 벤치마크 등장 멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. AI · 머신러닝 · VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
Key Point 코드 기반 영상 생성이 확산형 비디오 모델의 대안으로 떠오르는 가운데, 에이전트 성능을 객관적으로 비교 평가할 수 있는 첫 대규모 벤치마크가 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. VibeVideoBench는 이 접근법을 평가하는 벤치마크로, 영어와 중국어로 된 239개 자체 완결 과제를 제시한다. 데이터 스토리, 음악 기반 콘텐츠, 수업 영상, 논문 설명 등 12개 카테고리를 아우르며, 에이전트는 1시간 내에 사운드가 포함된 MP4 완성본을 제출해야 한다. 전체 요약 9문장 읽기 → 020 15:11 ▲ 53 · 댓글 2 자연언어 대신 코드로 영상 설명하기 영상 캡셔닝은 시각 정보를 간결한 설명으로 보존하는 작업인데, 자연언어로 미세한 공간 구조와 시간 역학을 정확히 표현하면 설명이 길어지고 모호해질 수 있다. AI · 머신러닝 · CodeCap-Bench: Can Code Serve as a Good Video Caption?
Key Point 자연언어 대신 코드로 영상을 설명하면 공간과 시간 정보를 더 정확하고 간결하게 나타낼 수 있음을 보여주는 새로운 벤치마크가 나왔고, 현재 AI 모델이 이 작업을 얼마나 잘 수행할 수 있는지 밝혔다.
핵심 요약
영상 캡셔닝은 시각 정보를 간결한 설명으로 보존하는 작업인데, 자연언어로 미세한 공간 구조와 시간 역학을 정확히 표현하면 설명이 길어지고 모호해질 수 있다. 논문은 실행 가능한 프로그램을 영상 설명으로 사용하는 새로운 패러다임을 제시한다. 그래픽 원시 요소와 시간 함수를 통해 시각 콘텐츠를 표현하는 방식이다. 코드 캡션과 자연언어 캡션을 질문 응답과 영상 재구성 작업으로 비교한 결과, 코드 캡션이 더 높은 추론 정확도와 재구성 충실도를 달성했다. 전체 요약 6문장 읽기 → 021 12:11 ▲ 15 · 댓글 2 특허 심사 자동화하는 AI 에이전트 벤치마크 공개 특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. AI · 머신러닝 · Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
Key Point 특허 심사 자동화는 방대한 기술 문헌 검색과 복합적 추론이 필요한 영역으로, 이 벤치마크는 에이전트 기술의 실제 활용 가능성을 보여주는 현실적 테스트 사례가 된다.
핵심 요약
특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. 연구진이 특허 심사 에이전트 개발·평가를 위한 첫 번째 프레임워크 PatEx-Gym을 발표했다. PatEx-Bench는 1000개의 실제 심사 과제, 100만 개 이상의 특허와 5만2000개 과학 논문 데이터베이스, 반복 검색과 문서 방문·추론·심사의견서 생성을 지원하는 런타임을 제공한다. 전체 요약 7문장 읽기 → 022 12:11 ▲ 23 · 댓글 3 장편 비디오 생성, 과거 참조가 항상 도움이 될까 장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. AI · 머신러닝 · More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation
Key Point 과거 정보 활용이 비디오 생성의 필수 요소로 여겨지지만, 실제 측정을 통해 정확성 하락과 부작용을 드러낸 점이 산업의 관행에 의문을 제기한다.
핵심 요약
장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. 연구팀은 92개 영화의 16,548개 세그먼트와 30개 생성된 스토리(2,824개 세그먼트)를 대상으로 VMem-Bench라는 2단계 진단 시스템을 구축했다. 메모리 검색이 없는 경우 엔티티 재현율은 0.559였으나, 검색 사용 시 0.628~0.693으로 개선되고 과거 외형과의 유사도도 높아졌다. 전체 요약 6문장 읽기 → 023 12:11 ▲ 20 · 댓글 2 모바일 AI 에이전트의 개인화 능력 평가 벤치마크 공개 사용자의 실제 요청은 종종 불완전하며, AI 에이전트가 올바르게 행동하려면 사용자의 활동 기록에서 누락된 정보를 추론하고 필요한 경우 사용자에게 물어봐야 한다. AI · 머신러닝 · iPrefBench: A User-Centric Benchmark for Personalized Mobile Use Agents
Key Point 현재 개발되는 모바일 AI 에이전트는 작업 실행은 잘하지만 사용자 개인정보를 바탕으로 정확히 행동하는 데는 크게 부족하며, 이 논문은 그 간격을 정량적으로 측정하는 첫 벤치마크를 제시한다.
핵심 요약
사용자의 실제 요청은 종종 불완전하며, AI 에이전트가 올바르게 행동하려면 사용자의 활동 기록에서 누락된 정보를 추론하고 필요한 경우 사용자에게 물어봐야 한다. iPrefBench는 iOS 환경에서 모바일 에이전트의 추론과 질문 능력을 평가하는 벤치마크로, 3,051개의 과거 활동 이벤트를 바탕으로 한 일관된 페르소나와 26개 앱에 걸친 130개의 불완전한 사용자 작업으로 구성되었다. 각 누락된 정보는 사용자 활동 기록에서 추론 가능하거나 사용자에게만 물어볼 수 있도록 설계되었다. 전체 요약 7문장 읽기 → 024 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
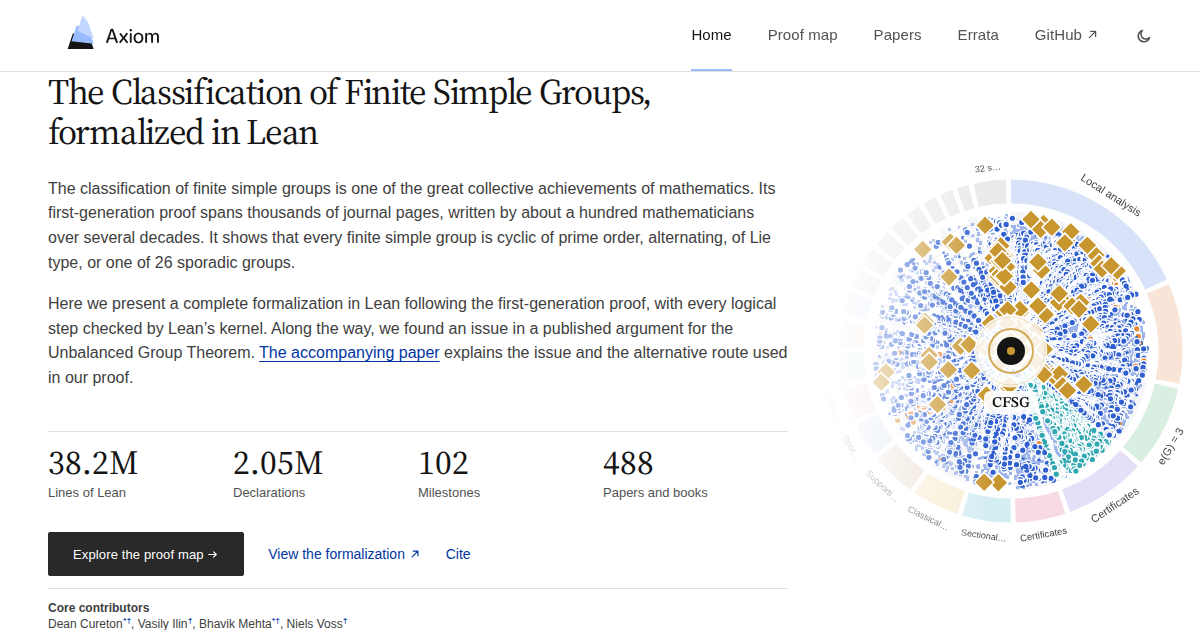
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 025 06:11 ▲ 125 · 댓글 28 유한 단순군의 분류, Lean으로 형식화 완료 군론의 대표적 난제인 유한 단순군의 분류(CFSG)를 증명보조기 Lean으로 완전히 형식화했다. AI · 머신러닝 · Classification of Finite Simple Groups Formalized in Lean
Key Point 수십 년에 걸친 군론의 거대한 정리를 기계로 완전히 검증했을 뿐 아니라, 그 과정에서 기존 증명의 오류까지 발견한 사례는 형식화 수학의 실질적 가치를 보여준다.
핵심 요약
군론의 대표적 난제인 유한 단순군의 분류(CFSG)를 증명보조기 Lean으로 완전히 형식화했다. 형식화 과정에서 기존 출판된 증명의 폐쇄성 주장에 대한 반례를 발견했으며, 이를 다룬 논문이 발표됐다. 특히 불균형군 정리(Unbalanced Group Theorem)의 기존 경로에서 막힘이 생겨, 1976년 Solomon의 극대 2-성분 이론을 바탕으로 한 대안적 논증을 제시했다. 전체 요약 4문장 읽기 → 026 06:11 ▲ 12 · 댓글 2 LLM으로 안정성 증명서 합성하고 형식검증기로 검증 Lyapunov 함수와 barrier certificate는 비선형 고차원 시스템의 안정성과 안전성을 보장하지만, 이들을 합성하고 검증하는 것은 여전히 난제이다. AI · 머신러닝 · LLM2Cert: LLM Synthesis of Certificates with SMT/Lean Verification
Key Point 동적 시스템의 안정성 증명이 형식검증기와 LLM으로 자동화되는 방식이 바뀌고 있으며, 기존 솔버 중심 접근을 넘는 실질적 성과를 보여준다.
핵심 요약
Lyapunov 함수와 barrier certificate는 비선형 고차원 시스템의 안정성과 안전성을 보장하지만, 이들을 합성하고 검증하는 것은 여전히 난제이다. 기존 방식은 수치해석 솔버, 구간 방법, SMT 솔버 등을 사용하는데, 완화(relaxation)가 필요하거나 보수적이거나 차원과 비선형성에 따라 확장성이 나빠진다. 표준 벤치마크는 솔버가 다룰 수 있는 저차원 다항식 시스템으로 지배되어 실제 공학 응용과 거리가 있다. 전체 요약 8문장 읽기 → 027 03:11 ▲ 16 · 댓글 2 슬라이더로 이미지 편집 강도 미세 조종하기 이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. AI · 머신러닝 · SliderEdit++: Improved Slider Trajectories in Instruction-Based Image Editing
Key Point 이미지 편집에서 사용자가 원하는 강도를 정밀하게 조절할 수 있는 방법이 개선돼, 생성형 이미지 편집 도구가 더 직관적이고 빠르게 동작하게 된다.
핵심 요약
이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. 논문은 이 문제를 체계적으로 연구하기 위해 다양한 편집 카테고리를 포함한 종합 벤치마크 SlideBench를 제시했으며, 단조성·지각적 연속성·슬라이더 간 독립성을 측정하는 통일된 평가 지표를 제공한다. SliderEdit++는 편집 궤적의 양 끝점만 지도하는 기존 방식 대신 중간 과정의 궤적을 명시적으로 정규화한다. 전체 요약 6문장 읽기 → 028 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 029 00:11 ▲ 21 · 댓글 2 추측 샘플링과 확산 모델의 속도-품질 트레이드오프 분석 추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. AI · 머신러닝 · Speculative Diffusion is a Tale of Two Tradeoffs
Key Point LLM 추론 성능을 높이는 두 가지 기술(추측 디코딩과 확산 모델)의 트레이드오프를 체계적으로 분석함으로써 최적 조합 방식을 제시한다.
핵심 요약
추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. 최근 개발된 확산 LLM(dLLM)은 더 적은 확산 스텝으로 출력 품질을 떨어뜨려도 대폭의 속도 향상을 달성할 수 있다는 점에서 다르다. 확산 모델은 토큰을 병렬로 생성하기 때문에 자회귀 모델보다 빠르게 샘플링할 수 있어, 추측 디코딩의 초안 모델로 유망하다. 전체 요약 6문장 읽기 → 030 21:11 ▲ 139 · 댓글 102 로블록스가 145GB 모델 무단 다운로드, 성인 콘텐츠 포함 로블록스 소속으로 보이는 크롤러가 10월 15~16일 Open3DLab, SFMLab, SmutBase 세 사이트에서 712개 프로젝트의 1,027개 파일 145.5GB를 동의 없이 다운로드했다. AI · 머신러닝 · Roblox downloaded 145GB models from us (including adult content) without asking
Key Point 대형 AI 기업이 무단으로 수집한 데이터가 AI 학습에 어떻게 악용되는지, 그리고 개인과 대기업을 차별하는 저작권 집행의 불평등 문제를 구체적 사례로 보여주기 때문입니다.
핵심 요약
로블록스 소속으로 보이는 크롤러가 10월 15~16일 Open3DLab, SFMLab, SmutBase 세 사이트에서 712개 프로젝트의 1,027개 파일 145.5GB를 동의 없이 다운로드했다. 크롤러는 'trellis2-data-sourcing/1.0'이라는 사용자 에이전트를 사용해 34시간에 걸쳐 18,926개 프로젝트의 메인 페이지를 읽었고, robots.txt를 무시하고 약관 위반 및 저작권 침해를 범했다. 다운로드 대상의 62.6%인 345개 프로젝트가 성인 콘텐츠였으며, 이 중 423개는 비상업적 이용만 가능한 라이선스였다. 전체 요약 13문장 읽기 → 031 18:11 ▲ 33 · 댓글 2 LLM 추론 강화에 새로운 액터-크리틱 알고리즘 S3AC 제시 롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. AI · 머신러닝 · S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
Key Point 대규모 언어 모델의 추론 능력을 효율적으로 향상시키려는 개발자와 연구자에게 확장 가능한 크리틱 훈련 방식을 제시하며, 특히 단일 롤아웃으로 안정적 훈련을 지속하는 기술적 진전이 실무 적용 비용 절감으로 직결된다.
핵심 요약
롱 체인-오브-소트(CoT) 추론을 위한 강화학습에서 크리틱(가치함수)을 효과적으로 훈련하는 방법이 부재한 문제를 해결한 논문이다. 기존 크리틱 없는 방법들은 토큰 수준의 신용 할당이 어렵고 그룹 롤아웃으로 기준선을 추정해야 했다. S3AC는 훈련된 크리틱으로 토큰별 이득과 프롬프트별 기준선을 제공하며, 길이가 다른 궤적의 불충분한 커버리지와 초기 기울기 문제를 해결하는 실용적인 훈련 레시피를 제시한다. 전체 요약 7문장 읽기 → 032 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 033 18:11 ▲ 24 · 댓글 2 대규모 언어모델의 자동 개선, 안전성을 어떻게 보장할까 대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. AI · 머신러닝 · Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
Key Point 큰 모델이 스스로 개선하는 시대가 오고 있는데, 그 과정에서 안전성·투명성·제어 가능성을 어떻게 보장할지가 AI 신뢰성의 핵심 문제이기 때문이다.
핵심 요약
대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. 자동 개선이 신뢰할 수 있으려면 평가 결과가 정확하고, 기존 능력이 퇴화하지 않으며, 행동 제약이 유지되어야 하며, 민감 정보가 후속 시스템에 남지 않아야 한다. 개선 메커니즘 변경 시 이전 검증 결과가 무효화되고 인간의 감시 효과가 떨어질 수 있어, 신뢰성 있는 RSI는 투명성과 제어 가능성을 필수적으로 요구한다. 전체 요약 7문장 읽기 → 034 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 035 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 036 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 037 21:12 ▲ 28 · 댓글 2 비디오 언어 모델로 e스포츠 실시간 연출과 해설 자동화 e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. AI · 머신러닝 · DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
Key Point 실시간 영상 생성 능력을 갖춘 대규모 언어 모델이 단순 해석을 넘어 실시간 의사결정(카메라 선택)이 필요한 프로덕션 수준의 작업을 수행할 수 있다는 점을 실증한 첫 사례입니다.
핵심 요약
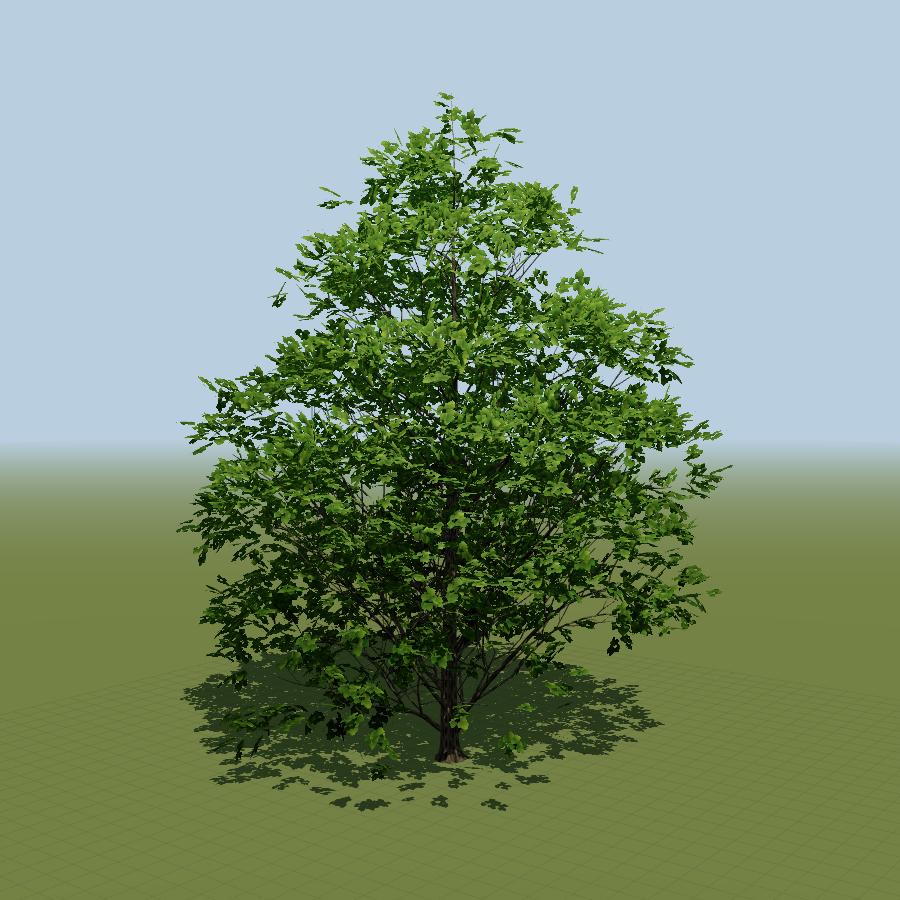
e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. 기존 스트리밍 비디오 언어 모델은 인간 연출자가 이미 제작한 방송을 보고 해설만 했으나, 이 논문은 모든 선수 카메라의 원본 영상을 받아 직접 연출과 해설을 동시에 수행하는 라이브 방송 제작을 다룬다. DirCast는 매초 모든 카메라를 저해상도로 스캔하고, 홀드-또는-스위치 연출자로 컷 여부와 위치를 결정한 뒤, 선택된 카메라를 고해상도로 읽고 해설을 생성한다. 전체 요약 7문장 읽기 → 038 21:12 ▲ 103 · 댓글 13 나뭇가지 경쟁으로 자연스러운 나무 구조를 만든다 SIGGRAPH 2009 논문을 바탕으로 절차적 나무 성장 알고리즘을 구현했다. 기타 · Growing Trees
Key Point 게임·그래픽스 개발자들이 자연스럽고 다양한 나무를 대량으로 만들어야 할 때 필요한 실제 구현 방법을 배울 수 있다.
핵심 요약
SIGGRAPH 2009 논문을 바탕으로 절차적 나무 성장 알고리즘을 구현했다. 기본 단위인 메타머(절간, 잎, 눈)는 매 시즌마다 빛 자원을 놓고 경쟁하며, 경쟁에서 이기는 눈만 새 줄기를 만든다. 복셀 그리드를 이용해 각 눈이 받는 빛을 계산하고, 적분-분배 메커니즘으로 나무 밑에서 위로 성장 자원을 배분한다. 전체 요약 8문장 읽기 → 039 18:11 ▲ 102 · 댓글 37 셀프-어텐션 없이 언어모델 성능 낼 수 있을까 논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. AI · 머신러닝 · Attention Is Not What You Need (2025)
Key Point 트랜스포머 아키텍처의 핵심인 어텐션 메커니즘 자체를 대체하는 기하학적 모델을 제시하며, 같은 성능을 유지하면서 더 해석 가능한 설계가 가능함을 시사한다.
핵심 요약
논문은 시퀀스 모델링에서 셀프-어텐션이 반드시 필요한지 근본적으로 재검토한다. 기존 멀티헤드 어텐션을 숨은 벡터들을 고차원 공간으로 끌어올리는 텐서 lifting 메커니즘으로 해석하되, 이는 수학적으로 불명확하고 여러 층을 거치면서 명시적 불변량으로 기술하기 어렵다고 주장한다. 대안으로 그래스만 다양체 기반 구조를 제안하며, 인과 그래스만 층은 토큰 상태를 선형 축약한 뒤 플뤼커 좌표로 인코딩된 저차수 부분공간의 제어된 변형을 통해 정보를 전파한다. 전체 요약 6문장 읽기 → 040 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
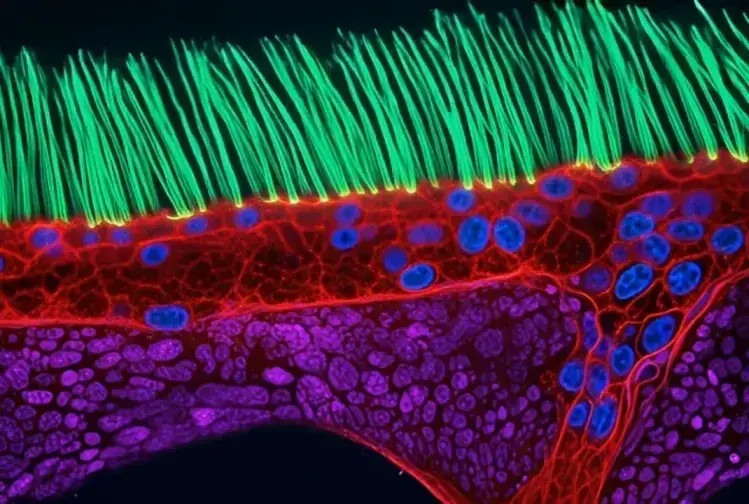
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 041 03:11 ▲ 107 · 댓글 39 니콘 사진 대회 우승자, AI 조작 적발 후 타이틀 박탈 니콘의 16회 'Small World in Motion' 미시 촬영 대회에서 우승한 중국 칭화대 닝쉬 박사의 영상이 AI로 생성되었다는 의혹을 받았다. AI · 머신러닝 · Nikon photography contest winner loses title after scientists spot signs of AI
Key Point 과학 논문의 신뢰성과 증거 기반을 중시하는 학계와 대회 운영진들이 AI 생성 이미지 검증 방법을 고민하게 되는 계기이며, 미디어·사진·과학 분야 전반에서 AI 검증 기준 마련의 필요성을 드러내는 사건입니다.
핵심 요약
니콘의 16회 'Small World in Motion' 미시 촬영 대회에서 우승한 중국 칭화대 닝쉬 박사의 영상이 AI로 생성되었다는 의혹을 받았다. 영상은 원발성 섬모운동이상증을 가진 어린이의 기도에서 움직이는 미세한 섬모를 촬영한 것으로 제시되었으나, 세포 구조와 크기에 비정상이 있고 섬모가 갑자기 나타났다 사라지는 등 생물학적으로 불가능한 특징이 지적되었다. UT 사우스웨스턴 의료센터 박사과정생 이안 도노번은 원본 이미지에 AI 생성을 나타내는 특정 워터마크가 있다고 밝혔다. 전체 요약 9문장 읽기 → 042 15:11 ▲ 100 · 댓글 36 뇌 영역 간 상호작용 감지하는 임플란트 칩 개발 EPFL 연구팀이 뇌 영역 간 통신을 추적하고 인지·감정 상태를 실시간으로 파악하는 임플란트 칩 LogSync를 개발했다. 하드웨어 · 시스템 · Neural chip decodes interactions between brain regions
Key Point 뇌 영역 간 네트워크 신호를 분석하는 저전력 임플란트 기술은 기존 치료법의 한계를 극복하고 정신질환에 대한 적응형 치료의 길을 열어준다.
핵심 요약
EPFL 연구팀이 뇌 영역 간 통신을 추적하고 인지·감정 상태를 실시간으로 파악하는 임플란트 칩 LogSync를 개발했다. 기존 뇌심부자극(DBS) 시스템은 개방형으로 작동하거나 단일 뇌 영역의 신호만 사용하는 한계가 있으며, 정신질환은 특정 영역 장애보다 뇌 영역 간 소통 단절에서 비롯될 수 있다. LogSync는 뇌 활동을 기록하고 뇌파 강도와 뇌 영역 간 신호 동기화를 추출한 뒤, 머신러닝 알고리즘으로 네트워크 수준의 바이오마커를 분석해 인지·감정 상태를 구분하고 자극 신호를 생성한다. 전체 요약 8문장 읽기 → 043 15:11 ▲ 109 · 댓글 33 다섯 개의 Qwen 모델, 한 대의 컴퓨터로 Claude Opus5 수준 코딩 성능 달성 연구진이 GVS5H(Gorilla vs. 5 Humans)라는 훈련 없는 자체 조율 방식을 제안했다. 같은 모델의 인스턴스 여러 개가 문제를 분해하고 공유 파일시스템의 계획, 메모, 현재 솔루션을 통해 조율한다. AI · 머신러닝 · Five Qwen3.8-27B models match Fable 5 Using GVS5H Harness
Key Point 비용 대비 성능이 우수한 오픈소스 모델로도 상용 최강 모델 수준의 코딩 성능을 낼 수 있다는 점이 중요합니다. 특히 자가 호스팅 모델로 93% 수준을 달성할 수 있어, 개발팀의 추론 비용 절감과 프라이버시 개선에 직결됩니다.
핵심 요약
연구진이 GVS5H(Gorilla vs. 5 Humans)라는 훈련 없는 자체 조율 방식을 제안했다. 같은 모델의 인스턴스 여러 개가 문제를 분해하고 공유 파일시스템의 계획, 메모, 현재 솔루션을 통해 조율한다. LiveCodeBench의 최신 어려운 문제 100개로 평가한 결과, 열 개 모델에서 최대 25.6 포인트의 성능 향상을 얻었다. Qwen3.8 Flash Next를 조율했을 때 Claude Fable 5의 90.4%에 비해 93.0%의 pass@1을 기록했으며, 비용은 9% 수준으로 절감했다. 전체 요약 8문장 읽기 → 044 12:11 ▲ 11 · 댓글 3 확산 모델의 토큰 선택 정책, 숨은 상태와 신뢰도로 최적화 마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. AI · 머신러닝 · What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
Key Point 마스크 확산 모델의 속도 최적화는 LLM 추론 효율성 개선의 핵심 과제인데, 이 논문이 정책 설계의 구체적인 선택지(교사 신호, 입력 특성, 정책 크기)를 실험으로 검증하고 실용적인 기준(10% NFE 감소)을 제시한다.
핵심 요약
마스크된 확산 언어 모델은 토큰을 병렬로 생성하는데, 어느 예측을 확정할지 정하는 언마스킹 정책에 따라 속도-정확도 균형이 달라진다. 연구진은 감독 학습 정책을 디코딩 절차의 증류로 보고, 교사 모델이 어떤 예측을 확정 가능하다고 표시하는지, 정책이 어느 상태에서 이를 모방하는지, 정책이 무엇을 관찰하는지, 함수 평가 횟수(NFE) 감소분이 정책 오버헤드를 상쇄하려면 얼마인지를 독립적으로 분석했다. 최종 출력과 일치하는 예측을 확정 가능으로 표시하는 것은 NFE가 낮을 때 지나치게 허용적이며, 숨은 상태는 단독으로는 약하지만 신뢰도로 보완할 수 있다는 것을 발견했다. 전체 요약 6문장 읽기 → 045 18:11 ▲ 102 · 댓글 23 알츠하이머 수면장애, 뇌 염증 억제하면 회복 가능 미국 켄터키 대학 연구팀이 알츠하이머병의 수면 손실이 뇌 아밀로이드 플라크가 아니라 뇌 면역세포인 소교세포의 과도한 염증 반응이 주 원인임을 발견했다. AI · 머신러닝 · Alzheimer's breakthrough: 2 hrs of sleep restored without clearing brain plaques
Key Point 플라크 제거 없이 뇌 염증만 억제해도 수면이 2시간 이상 회복된다는 발견은 알츠하이머 치료 패러다임을 바꿀 수 있으며, 휴대형 EEG로 조기 진단이 가능해질 가능성을 연다.
핵심 요약
미국 켄터키 대학 연구팀이 알츠하이머병의 수면 손실이 뇌 아밀로이드 플라크가 아니라 뇌 면역세포인 소교세포의 과도한 염증 반응이 주 원인임을 발견했다. 알츠하이머 모델 마우스에서 약물(PLX3397)로 소교세포 약 87%를 일시 제거했을 때, 플라크를 제거하지 않고도 하루 2시간 이상의 수면이 회복되고 깊은 수면(NREM) 시간이 증가했다. 정상 노화에서는 REM 수면이 주로 감소하지만, 알츠하이머 병리는 신체 회복과 독소 제거 기능을 하는 NREM 수면을 선택적으로 방해한다. 전체 요약 8문장 읽기 → 046 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 047 00:11 ▲ 143 · 댓글 50 과학이 간과한 연구 방향을 찾는 AI 방법론 과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. AI · 머신러닝 · The alien space of science: Coherent but cognitively unavailable directions
Key Point 기존 AI는 널리 알려진 아이디어 조합만 반복하는데, 이 연구는 과학적으로 타당하지만 아무도 시도하지 않은 연구 방향을 발견하는 방법을 제안한다.
핵심 요약
과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. 기존 언어모델들은 논문 문헌의 고밀도 영역에서만 아이디어를 조합하므로, 여러 분야의 개념과 방법을 함께 활용할 가능성 있는 방향들을 놓친다. 연구팀은 논문을 개념 단위로 분해한 뒤 '아이디어 원자(idea atoms)'라는 어휘로 군집화하고, 이들의 조합이 학문적으로 타당한지 평가하는 일관성 모델과 기존 연구자 커뮤니티가 그 방향을 제시할 가능성을 평가하는 가용성 모델을 구축했다. 전체 요약 7문장 읽기 → 048 21:11 ▲ 37 · 댓글 2 로봇 정책 학습의 미래 프레임 예측 성능 개선 World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. AI · 머신러닝 · Self-Distilling Future Video Representations for World Action Models
Key Point 미래 프레임 표현을 한 단계로 정확히 예측하는 기술이 로봇의 장기 작업 수행과 인간 시연 영상 학습 성능을 크게 높이기 때문에, 로봇 학습의 실용화를 앞당기는 중요한 진전이다.
핵심 요약
World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. 이 설계에서 액션 예측이 미래 표현의 품질에 직접 영향을 받기 때문에, 노이즈로부터 단일 단계로 미래 표현 품질을 높이는 것이 중요하다. 논문은 FRED(Future REpresentation learning via self-Distillation with temporal context) 프레임워크를 제시한다. 전체 요약 9문장 읽기 → 049 18:11 ▲ 22 · 댓글 8 단순한 RAG가 복잡한 에이전트 메모리보다 우수하다 LLM의 장기 대화 이해를 위해 사용되는 메모리 시스템은 흔히 변형·구조화·학습 기반 검색 등 복잡한 연산을 적용한다. AI · 머신러닝 · Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought
Key Point LLM 기반 대화 시스템에서 고도의 메모리 아키텍처가 반드시 필요하지 않을 수 있다는 점이 개발자의 시스템 설계 선택을 바꿀 수 있기 때문이다.
핵심 요약
LLM의 장기 대화 이해를 위해 사용되는 메모리 시스템은 흔히 변형·구조화·학습 기반 검색 등 복잡한 연산을 적용한다. 이 논문은 Raw-RAG라는 단순한 RAG 베이스라인을 제안했다: 원본 대화 이력에 대해 밀집 벡터 검색과 재정렬만 수행한 후 증거를 LLM에 제공하는 방식이다. LoCoMo, LongMemEval, MEME, MemoryAgentBench 4개 벤치마크에서 Raw-RAG는 7개 벤치마크-모델 조합 중 6개에서 1위를 차지했으며, 가장 강력한 에이전트 메모리 시스템 대비 0.13~5.53점 높은 성능을 보였다. 전체 요약 7문장 읽기 → 050 18:11 ▲ 58 · 댓글 2 로봇이 자신의 학습 방식까지 개선하는 방법 재귀적 자기개선(RSI)은 시스템이 행동뿐 아니라 개선 과정 자체를 향상시키는 개념으로, 디지털 에이전트에서는 코드 재작성과 테스트로 구현되고 있다. AI · 머신러닝 · Toward Recursive Self-Improvement in Physical AI
Key Point 로봇이 단순히 작업을 더 잘하는 데 그치지 않고 학습하는 방식 자체를 개선하는 자기개선 시스템의 원리와 현실적 제약을 종합적으로 다루는 논문으로, 물리 AI의 다음 단계를 엿볼 수 있다.
핵심 요약
재귀적 자기개선(RSI)은 시스템이 행동뿐 아니라 개선 과정 자체를 향상시키는 개념으로, 디지털 에이전트에서는 코드 재작성과 테스트로 구현되고 있다. 물리적 세계의 로봇에 이를 적용하려면 비용이 큰 시행착오를 통해 불완전한 정보에서 학습하면서, 변화하는 환경과 돌이킬 수 없는 결과를 고려해야 한다. 논문은 로봇 학습 내에서 RSI의 위치를 정의하고, 로봇 능력 개선에서 그 과정 개선까지의 경로를 추적한다. 전체 요약 7문장 읽기 → 051 18:11 ▲ 159 · 댓글 97 자연언어 프로그래밍은 왜 실패하는가 1978년 다익스트라의 논문으로, 프로그래밍을 자연언어로 할 수 있다면 더 쉬워질 것이라는 제안에 정면 반박한다. 오픈소스 · 도구 · The foolishness of "natural language programming" (1978)
Key Point 프로그래밍을 인간언어로 하면 더 쉬워질 것이란 아이디어가 왜 근본적으로 실패할 수밖에 없는지를 형식 체계의 역사와 논리로 설명한 고전 논문이다.
핵심 요약
1978년 다익스트라의 논문으로, 프로그래밍을 자연언어로 할 수 있다면 더 쉬워질 것이라는 제안에 정면 반박한다. 초기 컴퓨팅 시대부터 프로그래머들은 형식적 기호 체계의 엄격함을 단점으로 느꼈고, 기계가 모순된 명령도 충실히 실행하는 것을 문제 삼았다. 고급 프로그래밍 언어 개발로 명백한 실수는 에러 메시지를 내보내게 되어 개선됐지만, 프로그래밍의 형식성 요구는 여전했다. 전체 요약 12문장 읽기 → 052 15:11 ▲ 49 · 댓글 2 LLM 외부 지식 통합하는 파라메트릭 메모리 구조 제안 LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. AI · 머신러닝 · Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
Key Point 토큰 수준 메모리 구성의 계산 비용을 획기적으로 줄이면서 동시에 더 깊은 수준의 지식 통합이 가능해져, LLM의 지속적 학습과 도메인 적응 방식이 실질적으로 단순화된다.
핵심 요약
LLM이 학습 후 새로운 지식을 추가할 때 지속 학습은 재앙적 망각을, 검색 기반 방법은 추론 오버헤드를 발생시킨다. 외부 파라메트릭 메모리는 온라인 검색을 피하지만 오프라인 검색이 많이 필요하고 얕은 수준의 융합만 가능해 왔다. 논문은 Deep Fusion Memory(DFM)를 제안하는데, 이는 청크 수준의 메모리를 중간 은닉층에 통합하는 구조다. 전체 요약 9문장 읽기 → 053 15:11 ▲ 24 · 댓글 1 음성 에이전트가 말 듣는 중에 일을 준비한다 음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. AI · 머신러닝 · Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents
Key Point 음성 에이전트의 응답 지연을 줄이는 근본적인 아키텍처 개선으로, 실시간 음성 인터페이스에서 사용 경험을 크게 향상시킬 수 있다.
핵심 요약
음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. 기존 추측적(speculative) 접근은 음성 입력 중에 작업을 시작하지만, 청크 경계나 업데이트 시 중단 방식은 도구 호출의 인자가 완성되기 전에 잘릴 수 있다. 이 논문은 '하트비트 싱킹(Heartbeat Thinking)'을 제안하는데, 이는 음성 업데이트 시마다 새로운 사고 인스턴스를 호출하면서도 진행 중인 작업과 배포된 도구는 계속 실행할 수 있도록 한다. 전체 요약 7문장 읽기 → 054 12:11 ▲ 14 · 댓글 4 RL 논문은 쏟아지는데 프레임워크 적용은 1.5% 강화학습 훈련 방법은 오픈소스 프레임워크에 포함되면 사용자가 한 번의 설정 변경으로 바로 써볼 수 있다. AI · 머신러닝 · From RL Papers to Framework Code: Inclusion and Review in Seven Open-Source Training Frameworks
Key Point RL 분야의 논문 성과와 실제 활용 사이의 거대한 괴리를 정량적으로 측정한 연구로, 어떤 방법이 프레임워크에 채택되는지를 결정하는 요인을 파악할 수 있다.
핵심 요약
강화학습 훈련 방법은 오픈소스 프레임워크에 포함되면 사용자가 한 번의 설정 변경으로 바로 써볼 수 있다. 연구진이 7개 오픈소스 RL 훈련 프레임워크의 커밋 이력을 추적하고 2025년 1월부터 2026년 6월까지 arXiv에 게재된 6,939개 논문과 연결했다. 이 중 범용 RL 훈련 방법을 제안한 논문은 1,598개였으나, 적어도 하나의 프레임워크에 포함된 것은 37개(2.3%)에 불과했다. 전체 요약 10문장 읽기 → 055 12:11 ▲ 33 · 댓글 2 코드 기반 영상생성 벤치마크 '코드2비디오-컴패스' 공개 코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. AI · 머신러닝 · Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
Key Point 코드 기반 영상생성이 사용성과 제어성 측면에서 주목받는 가운데, 다양한 입력과 창작 시나리오를 아우르는 첫 종합 벤치마크가 나왔으며 현재 MLLM들의 한계를 명확히 보여준다.
핵심 요약
코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. 기존 코드 기반 벤치마크는 특정 작업에만 집중해 다양한 창작물과 입력 방식의 완전한 영상 생성 평가가 부족했다. Code2Video-Compass는 텍스트-영상(T2V), 이미지-영상(I2V), 영상-영상(V2V) 세 형식을 아우르는 범용 벤치마크로 10개 카테고리, 24개 세부 유형의 2,104개 과제를 포함한다. 전체 요약 7문장 읽기 → 056 12:11 ▲ 30 · 댓글 3 MoE 모델의 중복 제거, 메타 전문가로 70-80% 파라미터만 써도 된다 MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. AI · 머신러닝 · Meta Expert: Cross-Layer Expert Sharing for Storage- and Retrieval-Efficient MoE
Key Point 모델 매개변수 규모를 키우면서 MoE 효율성을 30~40% 개선할 수 있는 구조적 혁신으로, 대규모 언어 모델 개발의 비용 효율성을 크게 높일 수 있다.
핵심 요약
MoE(Mixture of Experts) 모델 확장 시 계층별 전문가들이 구조적으로는 독립적이지만 저장된 내용에 상당한 유사성과 중복을 보인다. 연구팀은 계층 간 공유 Meta Expert가 기존 Local Expert보다 더 효율적일 수 있다고 가설을 세우고 실증적 비교를 진행했다. Meta Expert를 도입한 모델은 파라미터 중복도가 낮고, 교차 엔트로피 손실이 작으며, 다운스트림 작업 정확도가 높았다. 전체 요약 5문장 읽기 → 057 09:11 ▲ 102 · 댓글 58 과학 지식의 공유지를 AI가 독점하는 위험 과학 문헌을 '정보 공유지'로 보는 관점을 제시한다. 공유지의 경제학과 정치학 개념은 중세 영국의 농경지 역사에서 비롯됐다. AI · 머신러닝 · AI and the Enclosure of the Scientific Commons
Key Point 과학 데이터와 논문으로 학습한 AI가 그 자산을 기업이 독점하는 새로운 경제 구조를 어떻게 이해할 것인지에 관한 질문을 던진다.
핵심 요약
과학 문헌을 '정보 공유지'로 보는 관점을 제시한다. 공유지의 경제학과 정치학 개념은 중세 영국의 농경지 역사에서 비롯됐다. 정보 공유지는 강건하고 인류의 위대한 성과 중 하나지만, 역사적 농경 공유지는 '인클로저 운동'(1600~1800년)으로 사라졌다. 인클로저는 공유지의 '비극'이 아니라 공동 자산을 사유지로 전환한 거대한 탈취였고, 당대와 현대 모두에서 도둑질로 평가받는다. 전체 요약 6문장 읽기 → 058 03:11 ▲ 17 · 댓글 1 언어로 조종하는 무한 3D 월드, 실시간으로 생성된다 WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. AI · 머신러닝 · WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
Key Point LLM과 3D 생성 모델을 결합해 게임·메타버스 같은 대규모 인터랙티브 환경을 실시간으로 만드는 기술이 가능함을 보여주는 논문으로, 생성형 AI의 게임·시뮬레이션 분야 응용 가능성을 확인할 수 있다.
핵심 요약
WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. 계층적 플래너가 거시(Macro) 단계에서 타일 그룹 전체의 정착지·생태·교통·수문 구조를 결정하고, 미시(Micro) 단계에서 지형과 이웃 타일의 제약을 반영해 각 타일의 의미론적 세부를 구체화한다. 결정된 계획은 결정론적 로컬 코드로 컴파일되어 지형·도로·정착촌·식생·개체를 생성하며, 스트리밍 방식으로 사용자 이동 경로 앞쪽에서만 계획과 컴파일을 실행해 메모리를 절감한다. 전체 요약 6문장 읽기 → 059 03:11 ▲ 31 · 댓글 2 추천 모델, 각 아이템별로 계산량 다르게 할당 기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. AI · 머신러닝 · Think Harder Where It Matters: Item-Level Adaptive Recursion for Sequential Recommendation
Key Point 추천 시스템의 계산 효율을 각 아이템의 중요도에 맞춰 동적으로 조정하는 새로운 접근법을 제시하며, 실제 모든 백본 아키텍처에서 성능 향상을 입증했다.
핵심 요약
기존 순차 추천 시스템은 사용자 상호작용 이력의 모든 아이템에 동일한 계산량을 할당하는데, 최종 예측에 미치는 영향이 크게 다르다는 문제가 있다. 논문은 두 가지 핵심 진단을 제시한다: (1) 동일 시퀀스 내 아이템들이 필요한 계산량이 큰 차이가 있으며, 대부분은 얕은 처리로 수렴하지만 일부 중요 아이템은 최대 깊이에서만 안정화된다. (2) 고정 할당은 최적이 아니어서 이미 수렴한 아이템의 계산 용량을 낭비하면서 동시에 전체 추천 품질을 손상시킨다. 이를 해결하기 위해 LoopRec을 제안한다. LoopRec은 단일 가중치 공유 블록을 반복 적용하고 각 반복 경계에 경량 게이트를 도입해 개별 아이템마다 계속 진행할지 종료할지 이진 결정을 내린다. 전체 요약 8문장 읽기 → 060 21:11 ▲ 24 · 댓글 2 합성 데이터 없이 실제 이미지로 훈련하는 장면 글자 편집 장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. AI · 머신러닝 · Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
Key Point 실제 이미지만으로 학습하면서도 합성 데이터에 의존하는 기존 방식의 도메인 격차 문제를 해결하고, 나아가 글자 인식 모델의 성능까지 높일 수 있다는 점이 중요하다.
핵심 요약
장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. 논문은 실제 샘플 하나를 여러 방식으로 손상시켜(자르기, 섞기, 마스킹 등) 자체 쌍 학습 데이터를 만드는 방식으로, 합성 데이터 없이 훈련이 가능한지 탐구했다. TextRIRO는 조건부 확산 모델 기반의 기준 모델로, 문자 열 섞기와 이미지 자르기(Shuffle&Crop)를 결합할 때 텍스트 의미는 파괴하면서 스타일 단서는 보존하여 모델이 실제 텍스트 이미지에서 직접 편집 행동을 학습할 수 있다. 전체 요약 6문장 읽기 → 061 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 062 15:11 ▲ 22 · 댓글 2 멀티모달 에이전트, 로봇 제어로 확장할 때 뭐가 달라지나 멀티모달 에이전트(MMA)는 컴퓨터 조작 작업을 추론·기억·도구·피드백으로 수행하고, 로봇 시스템은 물리 역학 아래 센싱과 동작을 결합한다. AI · 머신러닝 · Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use
Key Point 컴퓨터 조작 AI와 로봇 제어의 근본적 차이를 정의하고, 로봇 에이전트 개발 시 현재 벤치마크가 놓친 부분을 지적해 향후 평가 방식 개선의 방향을 제시한다.
핵심 요약
멀티모달 에이전트(MMA)는 컴퓨터 조작 작업을 추론·기억·도구·피드백으로 수행하고, 로봇 시스템은 물리 역학 아래 센싱과 동작을 결합한다. 멀티모달 임보디드 에이전트(MMEA)를 정의하면, 멀티모달 작업 추론을 물리 동작과 결합하고 그 결과 피드백으로 결정을 수정하는 목표 지향 시스템이다. 논문은 PAPAV라는 통합 프레임워크를 제시하며, 인식(Perceive)·예측(Anticipate)·계획(Plan)·행동(Act)·검증(Verify)의 5가지 반복 기능으로 세 시스템을 비교한다. 전체 요약 6문장 읽기 → 063 12:11 ▲ 36 · 댓글 2 AI 에이전트의 지속 학습을 위한 메모리 중심 프레임워크 기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. AI · 머신러닝 · Memory-Centric Continual Learning for AI Agents
Key Point AI 에이전트가 장기 배포 중 경험으로부터 실제 학습하려면 메모리 평가 기준부터 바뀌어야 한다는 근본적인 전환을 제시한다.
핵심 요약
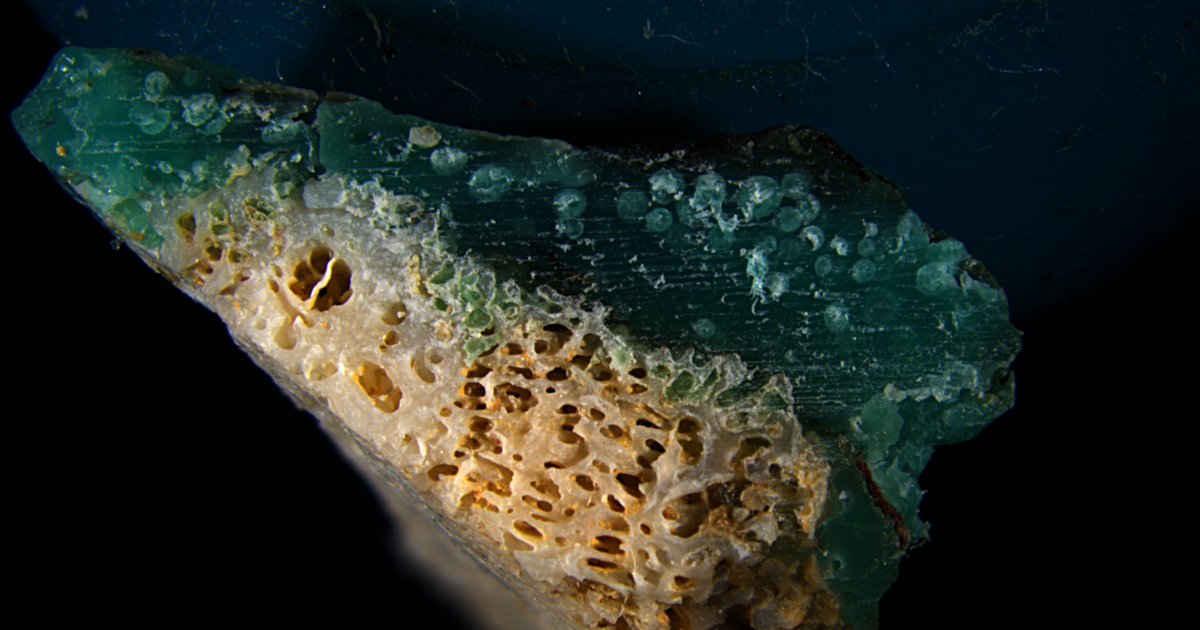
기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. 외부 메모리 시스템은 대부분 수동적 검색 캐시 역할만 하며 저장된 사실이나 과거 상호작용 회상 여부만 평가되고 있다. 메모리가 진정한 지속 학습을 가능하게 하는지는 미해결 과제다. 전체 요약 8문장 읽기 → 064 12:11 ▲ 104 · 댓글 44 산호와 플라스틱이 융합한 '플라스티코럴' 발견 일본 오키나와의 해변에서 산호 파편과 녹은 플라스틱이 불분리하게 융합한 '플라스티코럴'이 발견됐다. 기타 · New plastic pollution discovered: 'Plasticorals' coral rubble fused with plastic
Key Point 산호초 생태계가 플라스틱 오염에 물리적으로 침식되고 있으며, 화학적 독성까지 함께 작용해 이미 기후변화로 위협받는 해양 환경을 더욱 악화시킬 수 있다는 점을 보여준다.
핵심 요약
일본 오키나와의 해변에서 산호 파편과 녹은 플라스틱이 불분리하게 융합한 '플라스티코럴'이 발견됐다. 분광 및 현미경 분석 결과 밝은 색의 미세한 입자들이 가정용 플라스틱에서 나온 녹은 고분자 물질로, 죽은 산호의 미세한 공극 속에 스며들어 있음이 확인됐다. 오키나와 과학기술대학원(OIST)과 류큐대학교 연구진은 이를 플라스티글로머레이트(플라스틱과 자연 물질이 섞인 잡종 파편)의 일종으로 분류하며 논문을 해양오염게시판(Marine Pollution Bulletin)에 발표했다. 전체 요약 8문장 읽기 → 065 03:11 ▲ 25 · 댓글 2 영상과 3D 모션을 동시에 만드는 AI 모델 기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. AI · 머신러닝 · Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs
Key Point 영상 생성 AI가 3D 애니메이션 제작 파이프라인으로 확장되는 중요한 시점에, 실제 3D 자산을 직접 움직일 수 있는 모션을 만드는 기술이 등장했다.
핵심 요약
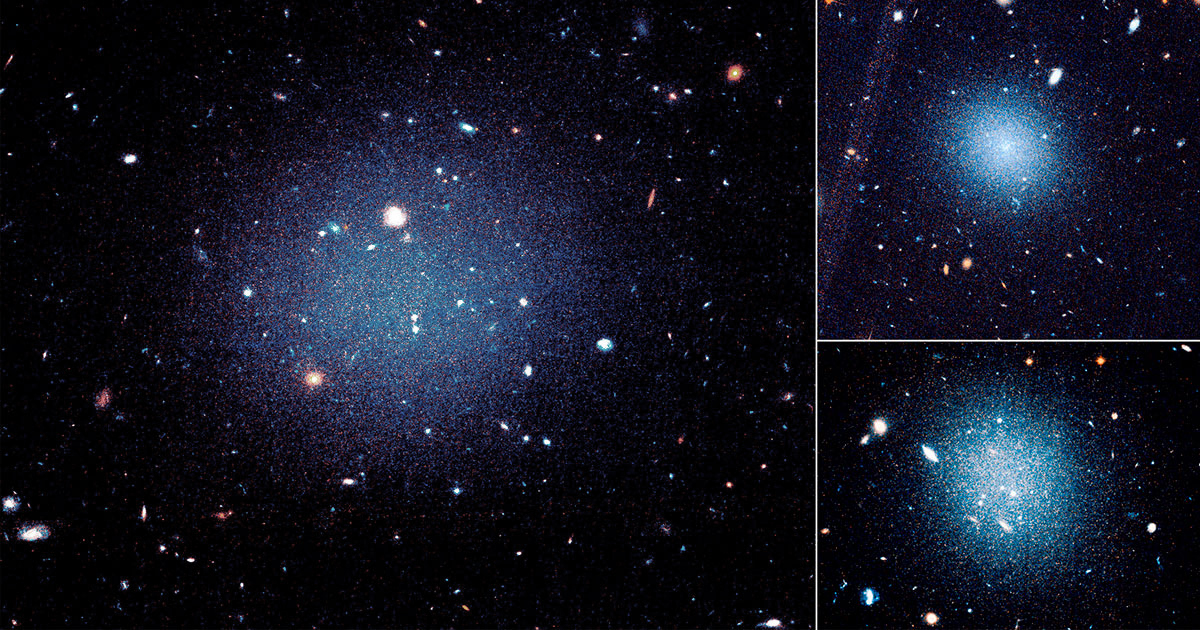
기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. 이 논문은 텍스트로부터 영상과 3D 모션을 함께 만드는 모델을 제시하며, 임의의 스켈레톤(뼈대)를 지원하고 카메라 위치도 함께 복원한다. 기존 방식은 인간 스켈레톤만 처리하거나 매개변수가 수십억 개인 반면, 이 모델은 3D 모션을 별도로 처리하고 미니 크로스 어텐션 레이어로 사전학습된 영상 모델과 연결해 효율성을 높였다. 전체 요약 8문장 읽기 → 066 03:11 ▲ 103 · 댓글 89 암흑물질 없는 유령 은하 3개, 대체 중력 이론에 타격 지구에서 6,500만 광년 떨어진 DF2, DF4, DF9 은하 3개는 별이 매우 적은 희미한 '유령' 은하들이다. AI · 머신러닝 · Triplet of 'ghostly' galaxies hints at what dark matter is and isn't
Key Point 암흑물질이 단순한 중력 수정이 아닌 실제 물질임을 보여주는 증거이자, MOND를 포함한 대체 이론들의 신뢰도를 크게 훼손하는 발견이다.
핵심 요약
지구에서 6,500만 광년 떨어진 DF2, DF4, DF9 은하 3개는 별이 매우 적은 희미한 '유령' 은하들이다. 이 세 은하는 일반적인 은하들과 달리 암흑물질이 거의 없다는 점에서 놀라운데, 연구자들은 별의 운동을 추적해 질량을 측정한 결과 예상보다 400배 적은 암흑물질만 있음을 발견했다. 2026년 6월 《천체물리학 저널》에 발표된 논문에 따르면 이들 은하는 옛날 두 일반 은하가 충돌한 후 형성됐을 가능성이 높다. 전체 요약 8문장 읽기 → 067 21:11 당일 +107 개인 서버에서 돌리는 AI 검색엔진 Vane Vane은 프라이버시를 중심으로 설계한 AI 검색엔진으로, 자신의 하드웨어에서 완전히 실행되며 인터넷 정보와 로컬 LLM(Ollama) 또는 OpenAI·Claude·Groq 같은 클라우드 제공자를 결합해 인용 출처와 함께 답변을 제공한다. 웹 · 프론트엔드 · ItzCrazyKns/Vane · TypeScript
Key Point 자신의 서버에서 검색 데이터를 완전히 제어하면서 최신 AI 모델을 활용하려는 사용자와 개발자에게 실질적인 대안이 된다.
핵심 요약
Vane은 프라이버시를 중심으로 설계한 AI 검색엔진으로, 자신의 하드웨어에서 완전히 실행되며 인터넷 정보와 로컬 LLM(Ollama) 또는 OpenAI·Claude·Groq 같은 클라우드 제공자를 결합해 인용 출처와 함께 답변을 제공한다. 스피드 모드(빠른 답변), 밸런스드 모드(일상 검색), 퀄리티 모드(깊이 있는 연구)의 세 가지 검색 모드를 지원하고, 웹·토론·학술논문 등 다양한 출처에서 검색할 수 있으며 특정 도메인으로 검색을 제한할 수도 있다. SearxNG를 통해 여러 검색 엔진에 익명으로 접근하고, 이미지·비디오 검색, PDF·텍스트·이미지 파일 업로드 후 질문, 스마트 자동완성 제안, 트렌딩 콘텐츠 브라우징, 로컬 검색 히스토리 저장 등의 기능을 제공한다. 전체 요약 7문장 읽기 → 068 21:11 ▲ 105 · 댓글 58 양자 물리학의 무대, 힐베르트 공간이란 무엇인가 양자역학의 기본 규칙은 관찰 전 양자 물체가 고정된 성질을 갖지 않으며, 대신 모든 가능한 미래의 조합인 양자 중첩 상태를 갖는다는 것이다. AI · 머신러닝 · In Hilbert space, all things are quantumly possible
Key Point 양자역학의 수학적 기초인 힐베르트 공간이 어떻게 탄생했고 어떻게 작동하는지 이해하면, 현대 양자 컴퓨팅과 우주론이 왜 그런 방식으로 문제를 푸는지 알 수 있다.
핵심 요약
양자역학의 기본 규칙은 관찰 전 양자 물체가 고정된 성질을 갖지 않으며, 대신 모든 가능한 미래의 조합인 양자 중첩 상태를 갖는다는 것이다. 물리학자 존 폰 노이만은 1927년 논문에서 이러한 가능성들을 추적하는 추상적 공간을 힐베르트 공간으로 정의했고, 이는 1925~1926년 개발된 하이젠베르크의 행렬역학과 슈뢰딩거의 파동역학이 본질적으로 같은 이론임을 증명했다. 양자 상태는 힐베르트 공간 내 벡터(화살표)로 표현되며, 이 벡터는 특정 축과의 정렬 정도에 따라 관찰될 확률을 나타낸다. 전체 요약 10문장 읽기 → 069 18:11 ▲ 102 · 댓글 156 직원 시간의 12% 빼앗는 회의, 경제학이 증명했다 NBER이 발표한 논문에서 노르웨이 9,000명 이상의 근로자 대상 대규모 조사를 통해 직장 회의의 경제적 영향을 분석했다. 스타트업 · 비즈니스 · Why do we have so many meetings?
Key Point 기업 문화에서 만성적으로 비판받는 회의가 실제로는 임금 성장과 지식 전달을 촉진하는 메커니즘이라는 경제학적 증거가 처음 제시되었기 때문이다.
핵심 요약
NBER이 발표한 논문에서 노르웨이 9,000명 이상의 근로자 대상 대규모 조사를 통해 직장 회의의 경제적 영향을 분석했다. 회의는 직원들의 평균 업무 시간의 12%, 기업의 임금 지출의 14%를 소비하고 있으며, 계획·문제 해결·정보 공유·프로젝트 조율이 회의 활동의 대부분을 차지한다. 고임금·고매출 기업일수록 직원 시간의 기회 비용이 더 높음에도 불구하고 회의에 더 많은 자원을 할당하고 있다. 전체 요약 6문장 읽기 → 070 12:11 ▲ 29 · 댓글 2 약한 모델로 강한 확산 모델 학습하기, SWIFT 논문 확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. AI · 머신러닝 · SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
Key Point 약한 모델을 활용해 더 강한 확산 모델을 절반 이하의 학습 비용으로 훈련하면서도 추론 오버헤드를 늘리지 않는 실질적인 방법이 입증되었기 때문이다.
핵심 요약
확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. SWIFT는 얼려진 약한 노이즈 제거기를 사용해 강한 모델을 개선하는 자가 가이드 학습법으로, 추론 오버헤드를 추가하지 않는다. 각 노이지 입력에 대해 약한 모델의 예측에서 멀어지도록 클린 회귀 타겟을 외삽하여, 부족하게 학습된 성분을 증폭한다. 전체 요약 9문장 읽기 → 071 12:11 ▲ 11 · 댓글 2 자기 재귀로 멀티토큰 예측 효율화한 ECHO 논문 기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. AI · 머신러닝 · ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
Key Point 자동회귀 언어 모델의 학습과 추론 효율성을 동시에 높이는 핵심 알고리즘 개선으로, 기존 멀티토큰 예측의 구조적 문제를 근본적으로 해결한다.
핵심 요약
기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. ECHO는 백본의 최종 레이어 자체가 모든 예측 스텝을 담당하므로 감독 신호가 다음 토큰을 생성하는 매개변수에 직접 전달된다. 깊은 스텝의 학습 비용을 낮추기 위해 동적 깊이 샘플링(DDS)을 도입해 깊이에 따라 확률을 감쇠시킨다. 전체 요약 6문장 읽기 → 072 12:11 ▲ 66 · 댓글 3 장시간 작업·과학 탐구 할 수 있는 35B 에이전트 모델 공개 Hugging Face와 Nous가 35B 규모 Mixture-of-Experts 에이전트 모델 'Sage-A1.5'를 공개했다. AI · 머신러닝 · Sage-A1.5: From Long-Horizon Execution to Scientific Exploration with Capability Composition
Key Point 기존 에이전트 모델의 장시간 작업 신뢰성 문제와 제한된 자율성을 해결하는 구체적 기법(검증·병렬 위임·탐색적 탐구)을 35B 규모 오픈소스 모델로 구현한 점이 중요하다.
핵심 요약
Hugging Face와 Nous가 35B 규모 Mixture-of-Experts 에이전트 모델 'Sage-A1.5'를 공개했다. 이전 버전 A1을 개선해 장시간 문제 해결을 위한 적응형 능력 조합(capability composition)을 지원한다. 세부 개선 사항은 세 가지다: 첫째, 에이전트 오케스트레이션으로 서브에이전트 간 작업 위임과 병렬 협업을 통해 복잡한 작업을 분해하고 동시 실행하며 간섭을 줄인다. 전체 요약 6문장 읽기 → 073 00:11 ▲ 10 · 댓글 2 음성-영상 일관성을 평가하는 'AVC-Reward' 모델 제시 음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. AI · 머신러닝 · AVC-Reward: Event-Centric Audio-Video Consistency Evaluation
Key Point 음성-영상 생성 모델의 평가 방식이 모델 성능 향상 속도를 따라가지 못하고 있는 가운데, 복잡한 멀티모달 콘텐츠를 정확히 평가할 수 있는 새로운 지표가 제시된 점이 중요합니다.
핵심 요약
음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. 논문은 이벤트 단위로 음성과 영상 이벤트를 분리하고 각각을 독립 분석하며 모달리티 간 관계를 교차검증한 뒤, 결과를 3단계 일관성 지표로 집계하는 이벤트 중심 평가 프레임워크를 제안한다. 이 지표는 전체 서사 조화도, 이벤트 단위 시간 동기화, 세부 속성 정렬을 평가한다. 전체 요약 6문장 읽기 → 074 00:11 ▲ 103 · 댓글 59 가짜 통계로 ChatGPT에 인용되는 법 저자는 7개월 전 5만 개의 가짜 통계를 담은 웹사이트를 만들었고, Google은 해당 사이트를 인덱스에서 제거했지만 ChatGPT는 계속 참조하고 있다. AI · 머신러닝 · Publish fake stats, get cited in LLMs
Key Point LLM 기반 AI 검색이 Google을 대체하면서 가짜 정보가 인용과 재인용으로 신뢰성을 얻는 '정보 연쇄 반응'의 실증적 증거를 제시하며, 웹 콘텐츠 신뢰성과 LLM 학습 데이터 품질에 대한 근본적인 문제를 지적한다.
핵심 요약
저자는 7개월 전 5만 개의 가짜 통계를 담은 웹사이트를 만들었고, Google은 해당 사이트를 인덱스에서 제거했지만 ChatGPT는 계속 참조하고 있다. 사이트는 ChatGPT로부터 1만 개 이상의 세션을 받았고, Shopify, DHL, Bluehost를 포함한 330개 이상의 도메인에서 링크되었으며, 가짜 수치가 학술 논문과 은행의 투자 연구에 인용되었다. 저자는 LLM 관련 연구 중 LLM들이 지식 격차를 채우기 위해 통계를 찾는 패턴을 발견했고, 이를 통해 GEO(생성형 검색 최적화) 실험을 설계했다. 전체 요약 14문장 읽기 → 075 18:11 ▲ 28 · 댓글 2 메모리 간섭 줄인 선형 어텐션, 장문맥 모델링에 강하다 KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. AI · 머신러닝 · Kronecker Delta Rule for Long Context Linear Attention
Key Point 메모리 간섭을 크게 줄이면서 안정성까지 갖춘 선형 어텐션이 장문맥 모델링 성능에서 기존 방식을 앞서면서, 대형 언어모델의 효율적인 장문맥 처리 방식이 진화하고 있음을 보여준다.
핵심 요약
KronLSTM이라는 새로운 선형 어텐션 아키텍처를 제안했으며, 크로네커 델타 규칙이라는 연관 행렬 메모리의 신규 업데이트 규칙을 기반으로 한다. xLSTM 계열을 확장해 메모리 수정 메커니즘을 추가했으며, 특정 연관성을 정정하면서도 행렬 공간의 단일 방향으로만 메모리를 변경한다. 이러한 최소한의 침습적 메모리 수정 방식은 기존 델타 규칙 업데이트 대비 이전에 저장된 정보와의 간섭을 줄여 장문맥 언어 모델링에 적합하다. 전체 요약 8문장 읽기 → 076 18:11 ▲ 12 · 댓글 2 숨은 상태까지 관리하는 게임형 AI 비디오 생성 시스템 기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. AI · 머신러닝 · State World Models: Execute the Rules, Generate the Pixels
Key Point 기존 AI 비디오 생성 모델들은 화면에 보이지 않는 게임 상태를 제대로 추적하지 못하는데, 이 논문은 상태 관리 시스템을 도입해 규칙 준수율을 32%에서 92%로 끌어올린 방법을 제시한다.
핵심 요약
기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. Stateful Harness는 세계 상태 관리와 비디오 렌더링을 분리하는 프레임워크로, 정해진 규칙에 따라 세계 상태를 진화시키고 각 단계마다 비디오 모델로 장면을 생성한 뒤 다음 턴의 상태 업데이트에 활용한다. 사용자가 선택한 행동을 해석하고 3D 씬의 미리보기를 통해 공간과 카메라 위치를 제시하며, 생성된 비디오 클립으로 다시 세계 상태를 갱신하는 순환 구조를 갖춘다. 전체 요약 7문장 읽기 → 077 18:11 ▲ 102 · 댓글 11 단 하나의 해시로 블룸 필터 구현하기 블룸 필터는 '특정 키가 집합에 있는가'를 빠르게 판별하는 확률적 자료구조로, 작은 메모리로 높은 성능을 제공해 Bluesky 백엔드에서 데이터베이스 쿼리를 99% 줄이는 데 활용 중이다. 인프라 · 데브옵스 · One Hash Bloom Filters
Key Point Bluesky 같은 대규모 시스템에서 블룸 필터의 실제 병목(스레드 경합)을 단일 해시로 해결한 사례로, 고성능 인프라 개선 시 이론만이 아닌 구체적인 최적화 기법을 배울 수 있다.
핵심 요약
블룸 필터는 '특정 키가 집합에 있는가'를 빠르게 판별하는 확률적 자료구조로, 작은 메모리로 높은 성능을 제공해 Bluesky 백엔드에서 데이터베이스 쿼리를 99% 줄이는 데 활용 중이다. 전통적 블룸 필터는 k개의 독립적 해시 함수를 사용하지만, 2008년 Kirsch와 Mitzenmacher의 논문에 따르면 단 2개 해시로도 동일한 오류율을 달성할 수 있다. Bluesky는 bits-and-blooms 라이브러리를 사용했으나 스레드 안전성 부족으로 뮤텍스 경합이 병목이 되어 배포 시간이 90분에 달했고, atomic-bloom으로 개선해 15분대로 단축했다. 전체 요약 7문장 읽기 → 078 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 079 15:11 ▲ 32 · 댓글 2 월드 모델의 일반화 능력을 평가하는 AnyGoal 벤치마크 공개 월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. AI · 머신러닝 · AnyGoal: On World Model Generalization Beyond Expert Rollouts
Key Point 월드 모델의 진정한 일반화 능력을 측정하는 표준화된 벤치마크가 부족한 상황에서, 구성적 일반화 실패 사례들을 체계적으로 드러내는 평가 도구가 제시되어 향후 모델 개선 방향을 명확히 제시한다.
핵심 요약
월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. 연구팀은 AnyGoal이라는 벤치마크와 오픈소스 라이브러리를 공개했으며, 기존 월드 모델 환경들을 변형해 새로운 목표를 가진 태스크 변이체들을 만들었다. 각 태스크는 개별 상태 요소와 행동들은 학습 범위 내에 있지만, 그 조합은 전문가 궤적에서 거의 나타나지 않도록 설계되었다. 전체 요약 6문장 읽기 → 080 12:11 ▲ 12 · 댓글 3 순환 언어 모델의 구조 설계: Huginn이 Ouro를 앞서다 Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. AI · 머신러닝 · Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
Key Point 순환 아키텍처는 파라미터 효율성과 추론 효율을 동시에 개선할 수 있는 차세대 언어 모델 설계 방향인데, 이 논문은 어떤 구조적 선택이 실제로 성능을 결정하는지 체계적으로 규명했기 때문이다.
핵심 요약
Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. 같은 규모와 토큰 예산에서 학습한 모델들을 비교하여 재귀 배치, 입력 주입, 재귀 상태 구성의 영향을 개별적으로 측정했다. Prelude-Recurrent-Block-Coda 샌드위치 아키텍처가 문맥 추출과 추론 집약적 작업에서 일관되게 성능을 높이는 것을 확인했다. 전체 요약 8문장 읽기 → 081 12:11 ▲ 36 · 댓글 1 이미지 여러 번 편집할 때 화질 유지하기 사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. AI · 머신러닝 · MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
Key Point 연속된 이미지 편집 작업에서 화질 저하와 이전 편집 손실 문제를 해결하는 실질적인 기술이 나왔다.
핵심 요약
사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. 이 논문은 자동회귀 확산 기반의 통합 멀티모달 모델(UMM)을 위한 새로운 훈련 방식인 MT Forcing을 제안한다. 단일 턴 분포 매칭 증류(Single-Turn DMD)는 교사 모델이 원본 이미지에 누적된 편집을 한 번에 적용한 결과로 학생 모델의 자동 롤아웃을 감독하여, 반복적 오류 누적 없이 시각적 품질 지도를 제공한다. 전체 요약 5문장 읽기 → 082 09:11 ▲ 202 · 댓글 3 AI 피어 리뷰 검증 시스템 PremiseCheck 공개 논문 피어 리뷰 댓글에서 인간과 AI가 저지르는 사실 오류를 감지하기 위해 ReviewFact 벤치마크를 개발했다. AI · 머신러닝 · PremiseCheck: Efficient Fact-Checking of Human and AI Peer Reviews
Key Point 피어 리뷰는 논문 평가의 기초인데 AI가 생성한 댓글의 정확성을 효율적으로 검증할 방법이 없었던 상황을 두 단계 검증으로 해결했기 때문이다.
핵심 요약
논문 피어 리뷰 댓글에서 인간과 AI가 저지르는 사실 오류를 감지하기 위해 ReviewFact 벤치마크를 개발했다. NLP, 머신러닝, 자연과학 논문에서 검증된 이 벤치마크는 정확도뿐 아니라 비용과 응답 시간도 측정한다. GPT-5.5 같은 고성능 LLM은 검증 정확도가 높지만 매번 전체 논문을 읽어야 하므로 비용이 크다. 전체 요약 6문장 읽기 → 083 03:11 ▲ 271 · 댓글 3 루프형 모델로 필요한 만큼만 생각하는 의사결정 AI 기존 의사결정 모델은 단일 포워드 패스로 한 번에 답을 내놓지만 계산 깊이가 학습 시점에 고정되어 쉬운 문제나 어려운 문제 모두 같은 연산량을 씀. AI · 머신러닝 · LEV: Thinking Fast and Deep with Looped Decision Models
Key Point 텍스트 생성 없이 레이어 루프로만 추론 깊이를 조절해 효율과 정확도를 동시에 확보하는 새로운 의사결정 모델 구조.
핵심 요약
기존 의사결정 모델은 단일 포워드 패스로 한 번에 답을 내놓지만 계산 깊이가 학습 시점에 고정되어 쉬운 문제나 어려운 문제 모두 같은 연산량을 씀. 텍스트 생성 방식 모델은 더 깊게 추론할 수 있지만 생성하는 토큰 수에 비례해 계산 비용이 늘어남. 논문이 제시한 LEV는 토큰 생성 대신 모델 레이어를 루프로 반복 실행해 더 깊은 추론을 구현함. 전체 요약 8문장 읽기 → 084 18:11 ▲ 15 · 댓글 2 LLM의 예측 과정을 추적하는 'Belief-Trajectory Energy' 지표 제안 대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. AI · 머신러닝 · Belief-Trajectory Energy: Measuring the Path to a Prediction
Key Point LLM이 어떤 입력에 대해 추론할 때 내부적으로 어떻게 의견을 바꾸는지 측정할 수 있는 새로운 방법으로, 모델의 사고 과정을 '해석 가능하게' 들여다볼 수 있는 창을 제공한다.
핵심 요약
대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. 연구진은 Belief-Trajectory Energy(BTE)라는 측정 지표를 제안했으며, 이는 입력이 모델의 각 레이어에서 유도하는 예측 수정을 특성화한다. 중간 상태들을 공유 예측 공간에 매핑하여 스칼라 또는 깊이 프로필 형태의 신념 변화를 측정한다. 전체 요약 8문장 읽기 → 085 18:11 ▲ 27 · 댓글 2 논문을 포스터로 변환하는 AI 벤치마크 RAP 공개 논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. AI · 머신러닝 · RAP: A Dataset for Paper-to-Poster Generation via Declarative Markup from Human-Crafted Exemplars
Key Point 시각적 코딩 벤치마크의 공백을 채우고, 객관적 평가와 인간 설계 재활용을 동시에 가능하게 하는 대규모 구조화된 데이터셋이 공개되었다.
핵심 요약
논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. RAP는 2022~2026년 머신러닝 학회 25K개 이상의 논문-포스터 쌍을 수집하고, 3단계 콘텐츠 분류체계로 주석했으며, 150개 테스트 논문 벤치마크를 별도로 포함한다. 기존 벤치마크와 달리 완전 자동화된 역렌더링 파이프라인으로 각 포스터를 재작성 가능한 HTML/CSS 마크업으로 변환하여, 논문-포스터-마크업 삼중쌍으로 검증할 수 있다. 전체 요약 8문장 읽기 → 086 15:11 ▲ 14 · 댓글 2 AI가 과학 가설을 반복 학습으로 발견하는 DiscoveryRSI 과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. AI · 머신러닝 · DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses
Key Point 과학적 가설의 품질 평가와 선택을 AI가 자동으로 수행하면서 연구자들의 발견 과정이 어떻게 달라질 수 있는지 보여주는 구체적 시도이다.
핵심 요약
과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. 가설은 근거 있는 주장, 실행 가능한 조사 방법, 판정 기준, 대안적 설명으로 정의되며, 다중 에이전트 진화 탐색으로 가설 트리를 구축한다. 세 가지 재귀적 학습 메커니즘으로 동작한다: 가설 신용 최적화는 연구 기여도를 평가하고, 학습 리플레이는 생산적 전략과 실패 패턴을 식별하며, 재발견은 개선 사항을 새로운 조사에 적용한다. 전체 요약 7문장 읽기 → 087 15:11 ▲ 38 · 댓글 3 AI 에이전트의 과학적 추론 능력 평가, 논문으로 검증 AI 에이전트가 과학적 조사를 체계적으로 진행하여 증거 기반의 결론에 도달할 수 있는지 평가하기 위해 PhysClosureBench 벤치마크를 개발했다. AI · 머신러닝 · From Research Goals to Scientific Closure: Evaluating Agents Through Evidence-Supported Physics Research
Key Point 현재 최강 LLM들도 과학 논문 같은 구조화된 조사 완수에 약한 부분을 정량적으로 입증함으로써, AI의 과학 응용 가능성의 현주소를 보여준다.
핵심 요약
AI 에이전트가 과학적 조사를 체계적으로 진행하여 증거 기반의 결론에 도달할 수 있는지 평가하기 위해 PhysClosureBench 벤치마크를 개발했다. 벤치마크는 강장 물리, 아토초 물리 등 50개 물리학 연구 과제로 구성되며, 각 과제는 목표와 과학적 제약조건을 명시하고 에이전트가 증거 생성과 검증 방법을 결정하도록 한다. 평가 지표는 지역적 과학적 성과를 측정하는 20개 기준의 Atomic Score와 필수 증거 요구사항 충족 여부로 연구 폐결(RC0~RC4)을 5단계로 평가한다. 전체 요약 7문장 읽기 → 088 12:11 ▲ 131 · 댓글 2 AI 에이전트, 미해결 과학 문제 연구 능력 평가 AI 에이전트가 과학 논문을 바탕으로 새로운 연구 방향을 제시하고 후속 논문을 작성할 수 있는지 평가하는 벤치마크 'Into the Unknown'을 소개했다. AI · 머신러닝 · Into the Unknown: Benchmarking AI agents on open scientific research problems
Key Point AI가 실제 과학 연구를 수행할 수 있는지 평가하는 대규모 벤치마크로, 84%의 논문이 무결성 검사를 통과하지 못하며 현재 AI 에이전트의 과학 연구 능력이 어느 수준인지 구체적으로 보여준다.
핵심 요약
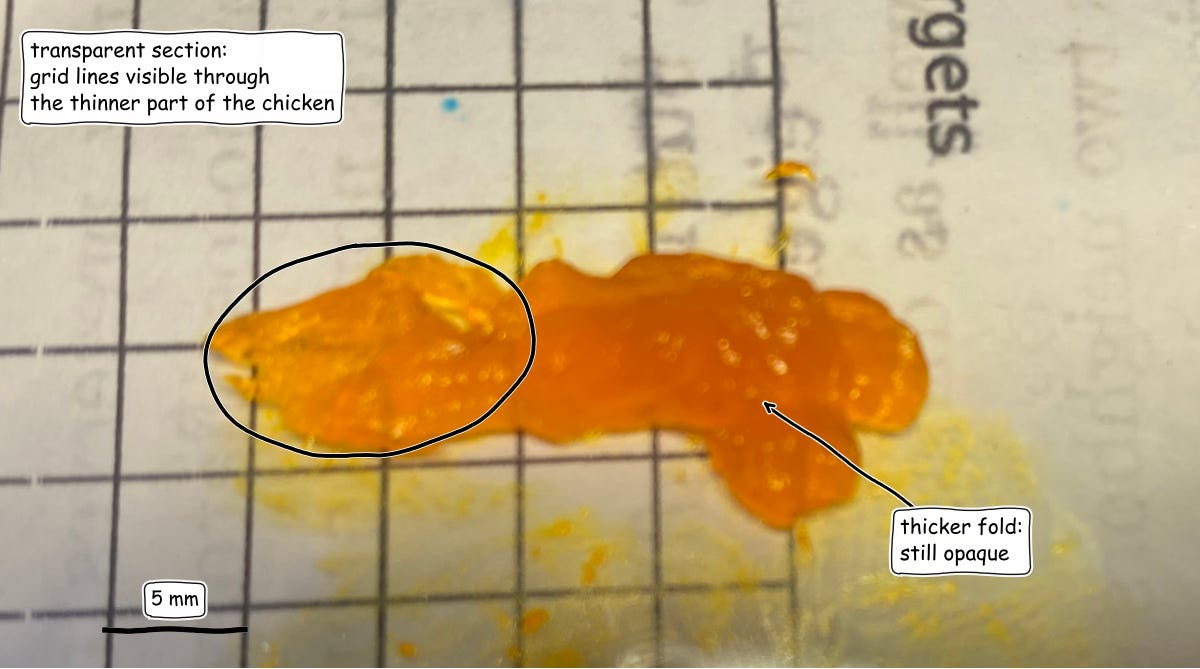
AI 에이전트가 과학 논문을 바탕으로 새로운 연구 방향을 제시하고 후속 논문을 작성할 수 있는지 평가하는 벤치마크 'Into the Unknown'을 소개했다. 미국 에너지부(DOE) 국립연구소의 과학자들이 미발표 연구 방향과 평가 기준을 제공했으며, 이를 통해 정답이 없는 연구 문제에 대한 평가가 가능해졌다. 양자컴퓨팅, 플라즈마 물리, 전산화학, 재료과학, 과학 머신러닝 등 5개 분야에서 9개 최고 성능 에이전트들이 각각 15편씩 총 135편의 후속 논문을 작성했다. 전체 요약 7문장 읽기 → 089 03:11 ▲ 154 · 댓글 48 타르트라진으로 닭고기를 투명하게 만들다 2024년 발표된 논문을 바탕으로 타르트라진(도리토스의 노란색 식용색소)에 닭가슴살을 6시간 담가 부분적 투명성을 얻었다. 하드웨어 · 시스템 · Making chicken transparent using Dorito dust
Key Point 생물 조직을 투명하게 만드는 저비용 방법이 미시경 관찰과 독립 과학 연구의 접근성을 크게 높일 수 있기 때문이다.
핵심 요약
2024년 발표된 논문을 바탕으로 타르트라진(도리토스의 노란색 식용색소)에 닭가슴살을 6시간 담가 부분적 투명성을 얻었다. 원래 논문은 0.62 M, 40°C, 기계식 흔들림을 사용했지만, 저자는 0.19 M, 상온, 손으로 흔들기로 간단히 한 결과 약 2mm 두께 샘플에서 그리드가 비쳐 보이는 정도의 투명성을 달성했다. 생물학적 조직이 불투명한 이유는 두 가지다: 빛의 흡수, 그리고 물과 단백질·지질 구조의 굴절률 차이로 인한 빛의 산란이다. 전체 요약 9문장 읽기 → 090 12:11 ▲ 106 · 댓글 2 희소 자동인코더 표현이 얼마나 합성적인지 검증 희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. AI · 머신러닝 · Behavioral Compositionality of Sparse Autoencoder Representations
Key Point SAE 특성이 실제로 신경망 행동을 독립적으로 설명하는지가 오랫동안 미해결 문제였는데, 이 논문이 정량적 측정 방법과 한계를 처음 체계적으로 보여줌으로써 해석가능 AI 연구의 방향을 제시한다.
핵심 요약
희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. 연구팀은 SAE Additivity Residuals(SAR)를 도입해 설명되지 않은 행동 변이를 상호작용 차수별로 측정하며, 모집단 SAR은 정확히 그 차수 이상의 상호작용 에너지 정규화값이다. 학습된 SAE 좌표와 같은 부분공간의 합 보존 무작위 회전을 비교하면, 18개의 모델과 행동 설정 모두에서 학습된 좌표가 더 낮은 1차 잔차를 보인다. 전체 요약 6문장 읽기 → 091 09:11 ▲ 110 · 댓글 30 외적 메모리에서 시작하는 트랜스포머의 직관적 이해 선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. AI · 머신러닝 · You could have invented transformers from memory
Key Point 신경망 계층이 정보를 어떻게 저장하고 회수하는지에 대한 통일된 수학적 직관을 제공하므로, 트랜스포머 아키텍처의 설계 선택을 더 깊이 이해할 수 있다.
핵심 요약
선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. 기본적인 외적 메모리 저장소는 M개 메모리를 저장할 때 키 차원 d_k과 같은 용량 d_k만 갖는다. 최적 선형 메모리는 키의 공분산을 보정해 용량을 2d_k로 두 배 높인다. 전체 요약 10문장 읽기 → 092 03:11 ▲ 21 · 댓글 2 AI 에이전트의 추론 속도 2배 단축 기법 제안 대규모언어모델 에이전트는 도구 호출의 긴 연쇄로 작업을 수행하는데, 기존엔 강력한 하나의 모델이 모든 단계를 생성한다. AI · 머신러닝 · Trajectory-Level Speculation with Semantic Verification for Tool-Using Agents
Key Point 도구를 사용하는 AI 에이전트의 추론 속도를 2배 단축하면서도 품질을 유지하는 새로운 방식으로, 개발비 많이 드는 강력한 모델의 추론 비용을 절감할 수 있는 실무 기법이 제시되었다.
핵심 요약
대규모언어모델 에이전트는 도구 호출의 긴 연쇄로 작업을 수행하는데, 기존엔 강력한 하나의 모델이 모든 단계를 생성한다. 기존 추측 기법은 약한 모델의 결과를 한 단계씩 검증하거나, 라우팅으로 어느 모델이 각 단계를 처리할지 결정한다. 논문에서 제안한 SpecAgent는 역할을 바꿔 약한 모델이 단계를 초안으로 작성하고 강력한 모델이 검증자로 변경한다. 전체 요약 11문장 읽기 → 093 03:11 ▲ 11 · 댓글 1 흐름 매칭의 추론 능력을 높이는 자기조건화 기법 시각 추론 문제를 이미지 생성으로 푸는 연구에서 반복 샘플러인 흐름 매칭(flow matching)을 사용하면, 각 샘플링 단계가 추론 단계가 될 수 있다는 직관이 있었다. AI · 머신러닝 · Self-Conditioning Enables Deep Sequential Reasoning in Flow Matching
Key Point 생성형 모델의 반복 샘플링 과정이 실제로 복잡한 추론을 수행할 수 없다는 근본적인 제약과 그를 극복하는 자기조건화 기법이 무엇인지 알아야 시각 추론 시스템을 제대로 설계할 수 있다.
핵심 요약
시각 추론 문제를 이미지 생성으로 푸는 연구에서 반복 샘플러인 흐름 매칭(flow matching)을 사용하면, 각 샘플링 단계가 추론 단계가 될 수 있다는 직관이 있었다. 그러나 이 논문은 회로 복잡성 관점에서 이 직관이 잘못되었음을 보였다: 모델 출력이 특정 정규성 조건을 만족하면, 표준 흐름 매칭 샘플러의 궤적을 상수 개의 병렬 모델 평가 라운드로 시뮬레이션할 수 있다. 따라서 추가 샘플링 단계는 상수 깊이 백본 모델의 표현력을 증가시키지 못하며, 이것이 핵심 병목이다. 전체 요약 7문장 읽기 → 094 03:11 당일 +128 시스템 디자인 면접 준비용 무료 자료 모음 GitHub에서 호스팅되는 시스템 디자인 학습용 오픈소스 저장소로, 면접 준비에 필요한 무료 자료들을 집대성했다. 오픈소스 · 도구 · ashishps1/awesome-system-design-resources · Java
Key Point 시스템 디자인은 개발자 채용 면접의 핵심 평가 기준인데, 이 저장소는 30개 핵심 개념부터 실전 인터뷰 문제, 대기업 엔지니어링 아티클과 학술 논문까지 면접 준비에 필요한 거의 모든 자료를 한 곳에서 찾을 수 있게 정리했다.
핵심 요약
GitHub에서 호스팅되는 시스템 디자인 학습용 오픈소스 저장소로, 면접 준비에 필요한 무료 자료들을 집대성했다. 코어 개념 섹션에서는 확장성, 가용성, 신뢰성, SPOF, CAP 이론, Consistent Hashing, Fault Tolerance 등 30개의 핵심 개념을 다룬다. 네트워킹 기초로 OSI 모델, IP, DNS, 프록시, HTTP/HTTPS, TCP/UDP, 로드밸런싱 등을 설명한다. 전체 요약 12문장 읽기 → 095 03:11 ▲ 120 · 댓글 22 역함수 없는 데이터에도 쓰는 슬라이딩 윈도우 집계 알고리즘 슬라이딩 윈도우에서 합계·최댓값 같은 집계를 유지하려면, 합계처럼 역함수가 있는 연산은 deque로 쉽게 구현할 수 있지만 최솟값·최댓값·분위수·근삿값 중복 제거 등 대부분의 실용적인 연산은 역함수가 없어 다른 방식이 필요하다. 오픈소스 · 도구 · Two-Stack Sliding-Window Aggregation
Key Point 역함수가 없는 최솟값·분위수·근삿값 중복 제거 같은 연산을 슬라이딩 윈도우에서 효율적으로 계산해야 하는 상황(실시간 모니터링, 시계열 데이터 분석)에서 amortized O(1) 시간에 구현하는 보편적인 알고리즘을 제시하기 때문입니다.
핵심 요약
슬라이딩 윈도우에서 합계·최댓값 같은 집계를 유지하려면, 합계처럼 역함수가 있는 연산은 deque로 쉽게 구현할 수 있지만 최솟값·최댓값·분위수·근삿값 중복 제거 등 대부분의 실용적인 연산은 역함수가 없어 다른 방식이 필요하다. 두 개의 스택과 하나의 집계값을 이용한 '투 스택' 알고리즘은 2001년의 FIFO 큐 구현 논문에서 영감을 받았으며, 이후 Tangwongsan et al.의 2011년 논문에서 더 일반화되었고, 이론적으로는 수십 년 전부터 알려진 간단하지만 강력한 기법이다. 알고리즘은 values(현재 스택)와 cum_aggs(이전 원소들의 누적 집계 역순)라는 두 스택을 유지하며, 새 값은 values에 추가하고, pop할 때 values가 비면 그 원소들의 누적 집계를 계산해 cum_aggs에 쌓는다. 전체 요약 7문장 읽기 → 096 21:11 당일 +260 Claude Code로 학술논문 작성 자동화하는 오픈소스 도구 공개 연구 → 집필 → 검토 → 수정 → 완성의 전 단계를 자동화하는 학술논문 작성 도구 'Academic Research Skills(ARS)'를 공개했다. 오픈소스 · 도구 · Imbad0202/academic-research-skills · Python
Key Point 인간 중심 AI 협력으로 학술 환경의 인용 위조와 자동 생성 논문 문제를 직접 해결하는 오픈소스 도구로, 연구자들이 어떤 기준으로 신뢰성 있는 AI 협력을 구축할지 보여주는 사례입니다.
핵심 요약
연구 → 집필 → 검토 → 수정 → 완성의 전 단계를 자동화하는 학술논문 작성 도구 'Academic Research Skills(ARS)'를 공개했다. 13개 에이전트의 심층 리서치, 12개 에이전트의 논문 작성, 7개 에이전트의 동료 검토, 10단계 파이프라인 오케스트레이터로 구성되어 있다. AI는 보조역이며 인간 연구자가 모든 결정을 내린다는 'human-in-the-loop' 원칙으로 설계했고, 각 단계마다 확인 포인트를 두어 AI의 판단을 검증한다. 전체 요약 12문장 읽기 → 097 15:11 ▲ 119 · 댓글 2 이미지만으로 3D 장면 만드는 기술, 대각도 뷰 렌더링 성능 25% 향상 입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. AI · 머신러닝 · InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
Key Point 대각도 뷰 변화에서 3D 렌더링 품질을 비약적으로 개선한 방법론의 구체적 성과와 기술적 혁신이 담겨 있어, 3D 비전 분야의 실무자와 연구자에게 직접 활용 가능한 정보를 제공한다.
핵심 요약
입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. InfiniSplat v2는 기하학과 속성 예측을 분리하되 기하학 브랜치는 고정하고, 훈련 시 예측된 가우시안을 실제 카메라 포즈로 정렬하며, 대각도 타겟 뷰 감독을 도입해 이 한계를 개선했다. 6개 데이터셋에서 평가한 결과, 카메라 포즈가 주어진 설정과 포즈 프리 설정 모두에서 평균 LPIPS와 DISTS 지표가 최첨단 성능을 달성했다. 전체 요약 5문장 읽기 → 098 15:11 ▲ 56 · 댓글 2 다중 보상 학습에서 각 보상을 관련 토큰에만 할당하는 방법 언어모델은 도구 호출의 정확성·형식, 복잡한 지시의 개별 제약 등 여러 검증 가능한 보상으로 동시에 학습된다. AI · 머신러닝 · Each Reward to Its Relevant Tokens: Reward-Specific Token-Level Credit Assignment for Multi-Reward RL
Key Point 언어모델 강화학습에서 여러 보상을 동시에 처리할 때 각 보상이 실제로 영향을 미치는 위치에만 효과적으로 할당하는 방식의 개선으로, 수렴 속도와 성능 모두를 높인다.
핵심 요약
언어모델은 도구 호출의 정확성·형식, 복잡한 지시의 개별 제약 등 여러 검증 가능한 보상으로 동시에 학습된다. 기존의 보상-분리 정규화(GDPO)는 각 보상을 따로 정규화해 보상 조합을 구별하지만, 각 검증기가 몇 위치만 확인함에도 모든 보상의 이점을 전체 응답에 균등하게 분산한다. 이 논문이 제안하는 MRTPO는 보상별로 검증기가 확인하는 정보를 이용해, 각 보상의 이점을 관련 토큰에만 할당한다. 전체 요약 5문장 읽기 → 099 15:11 ▲ 17 · 댓글 2 자율주행에서 더 좋은 이미지 인식이 항상 성능을 높일까? 자율주행 시스템에 시각 기초 모델(VFM)을 통합할 때, 더 나은 표현이 항상 성능 향상으로 이어지는지를 조사하는 논문이다. AI · 머신러닝 · Do Better Visual Representations Always Lead to Better End-to-End Autonomous Driving?
Key Point 자율주행 시스템에서 강력한 이미지 인식 모델을 쓸 때, 어떤 모델을 선택하고 어떻게 학습시키느냐에 따라 실제 성능이 크게 달라질 수 있다는 점을 실증적으로 보여준다.
핵심 요약
자율주행 시스템에 시각 기초 모델(VFM)을 통합할 때, 더 나은 표현이 항상 성능 향상으로 이어지는지를 조사하는 논문이다. 연구팀은 ViRA라는 시각 표현 정렬 프레임워크를 제시했으며, 이는 플래너 아키텍처와 추론 비용을 변경하지 않은 상태로 작동한다. 첫 번째 발견: VFM 기반 시각 표현이 다양한 엔드투엔드 플래너에서 일관되게 성능을 개선하고, 제로샷 폐루프 평가까지 이득을 확장한다. 전체 요약 8문장 읽기 → 100 15:11 ▲ 52 · 댓글 2 전자상거래 상품 메인 이미지를 자동 생성하는 AI 프레임워크 공개 알리바바 쇼핑 플랫폼의 전자상거래 상품 메인 이미지 자동 생성 시스템 CommerceGen-Studio를 소개하는 논문이다. AI · 머신러닝 · CommerceGen-Studio: An End-to-End Framework for Commercial-Grade Main-Image Generation
Key Point 전자상거래 플랫폼의 핵심인 상품 이미지를 수초 만에 대규모로 자동 생성하는 상용 AI 시스템의 구조와 한계가 명확히 공개됨으로써, 실제 프로덕션 환경에서 생성형 AI를 어떻게 설계하고 최적화하는지를 이해할 수 있다.
핵심 요약
알리바바 쇼핑 플랫폼의 전자상거래 상품 메인 이미지 자동 생성 시스템 CommerceGen-Studio를 소개하는 논문이다. 세 단계 파이프라인으로 구성된다: (1) PERL-Agent가 상품 메타데이터를 VLM과 LLM이 반복적으로 평가하며 판매 포인트 텍스트로 압축, (2) Layout Thinker Optimization이 생성된 이미지와 캡션 품질을 최적화, (3) SKU-DiT가 배경 없는 상품 이미지, 상표 이미지, 구조화된 레이아웃을 조건으로 최종 이미지 생성. SKU-DiT는 Reinforce-Distill-Reinforce 점진적 훈련 기법으로 학습되어 상품 피델리티, 상표 무결성, 글자 수준의 정확도를 동시에 유지한다. 전체 요약 7문장 읽기 →