쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 3일 (화)까지 3800건
100건 (최대치) · "프레임워크"조건 지우기 ×
001 18:11 ▲ 23 · 댓글 1 이미지 생성을 위한 '연속 공간 추론' 통합 멀티모달 모델 LARC 통합 멀티모달 모델(UMM)이 다양한 멀티모달 작업에서 성공하지만, 언어 기반 사고 체인을 활용한 이미지 생성에서는 약점을 보인다. AI · 머신러닝 · Latent Reasoning in Continuous Space for Unified Multimodal Models
Key Point 이미지 생성 모델에서 추론과 생성의 공간 불일치를 해결하는 새로운 접근법으로, 테스트 시간 스케일링과 더 나은 제어 능력을 가능하게 한다.
핵심 요약
통합 멀티모달 모델(UMM)이 다양한 멀티모달 작업에서 성공하지만, 언어 기반 사고 체인을 활용한 이미지 생성에서는 약점을 보인다. 기존 추론 강화 모델들은 큰언어모델처럼 테스트 시간 스케일링이나 세밀한 제어 능력을 갖지 못하는데, 추론이 이산 토큰 공간에서 이뤄지면서 이미지 생성의 연속 공간과 불일치하기 때문이다. 연속 공간 잠재 추론(LARC) 프레임워크는 연속 숨겨진 상태를 기반으로 추론하여 토큰 수준의 병목을 해결한다. 전체 요약 6문장 읽기 → 002 15:11 ▲ 18 · 댓글 1 소형 언어모델로 로봇 조작 명령 프로그래밍하기 로봇 조작을 코드로 구현하는 'code-as-policy(CaP)' 방식에서 기존 접근은 GPT 같은 프론티어 모델을 의존하거나 사전학습된 비전-언어-액션 모델(VLA)을 위임했다. AI · 머신러닝 · CaPtain: A Pipeline for Post-Training Code-as-Policy Robot Agents
Key Point 로봇 조작 AI를 프론티어 모델 의존에서 벗어나 오픈소스 소형 모델로도 실현할 수 있게 하는 구체적 방법과 검증 결과를 제시한다.
핵심 요약
로봇 조작을 코드로 구현하는 'code-as-policy(CaP)' 방식에서 기존 접근은 GPT 같은 프론티어 모델을 의존하거나 사전학습된 비전-언어-액션 모델(VLA)을 위임했다. 연구팀이 공개한 CaPtain은 소형 오픈소스 비전-언어 모델(Qwen 3.5-4B)을 미세조정과 강화학습으로 독립적인 로봇 정책 에이전트로 훈련하는 파이프라인이다. 파이프라인은 CaPtain-Harness라는 프레임워크 위에서 동작하며, 로봇 API, 저수준 인지·기하학·안전 이동 원시 동작을 시뮬레이션과 실제 하드웨어에서 노출한다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 24 · 댓글 1 실시간 게임 월드를 자유롭게 조종하는 AI 에이전트 'Wizard' 비디오 월드 모델의 발전으로 게이머가 커스터마이징할 수 있는 인터랙티브 가상 환경 생성이 가능해졌지만, 기존 접근법은 단순한 게임 설정만 지원하고 새로운 환경과 캐릭터에 제대로 일반화되지 않으며 실시간 인터랙션이 제한적이었다. AI · 머신러닝 · Wizard: Manipulate Any World in Real Time via Agentic Control
Key Point 기존 게임 AI는 특정 환경·캐릭터에만 작동했지만, Wizard는 학습하지 않은 상황에서도 작동하며 플레이어가 실시간으로 게임 세계를 조종할 수 있어 게임 생성 AI의 상용화 가능성을 크게 높인다.
핵심 요약
비디오 월드 모델의 발전으로 게이머가 커스터마이징할 수 있는 인터랙티브 가상 환경 생성이 가능해졌지만, 기존 접근법은 단순한 게임 설정만 지원하고 새로운 환경과 캐릭터에 제대로 일반화되지 않으며 실시간 인터랙션이 제한적이었다. Wizard는 에이전틱 게임 월드 모델로서 캐릭터 모션을 실시간으로 정밀하게 제어하면서도 미학습 장면, 캐릭터, 행동에 대해 영점 일반화(zero-shot generalization)를 달성한다. 750개 장면과 178개 캐릭터를 포함하는 다양한 데이터셋을 구축했으며, 이들에 스켈레톤과 지오메트리 정보 같은 구조화된 표현을 포함시켰다. 전체 요약 6문장 읽기 → 004 15:11 ▲ 22 · 댓글 1 로봇 조작에 계층적 미래 예측을 더하다 로봇 조작 작업을 위한 Vision-Language-Action(VLA) 모델이 시각 인식, 언어 이해, 행동 생성을 통합해 성과를 내고 있으나, 기존 방법들은 단기 역학과 장기 목표를 따로 모델링하고 미래 예측을 행동 요구사항과의 연관성 없이 사용하고 있다. AI · 머신러닝 · HiFOR: Hierarchical Foresight with Action-Guided World Grounding for Vision-Language-Action Model
Key Point 로봇이 복잡한 작업을 수행할 때 단기 환경 변화와 장기 목표를 동시에 고려하는 방식이 어떻게 작동하는지 보여주는 새로운 기술 진전으로, 로봇 자동화 분야의 실제 구현 가능성을 높인다.
핵심 요약
로봇 조작 작업을 위한 Vision-Language-Action(VLA) 모델이 시각 인식, 언어 이해, 행동 생성을 통합해 성과를 내고 있으나, 기존 방법들은 단기 역학과 장기 목표를 따로 모델링하고 미래 예측을 행동 요구사항과의 연관성 없이 사용하고 있다. 이를 개선하기 위해 HiFOR은 계층적 미래 예측과 행동 유도 월드 검색을 결합한 프레임워크를 제안한다. 계층적 미래 예측은 단기 상태 변화, 의미론적 마일스톤, 최종 목표 상태를 계층적 의존성 마스크(HDM)를 통해 함께 예측해 시간축 간 의존성을 설정한다. 전체 요약 6문장 읽기 → 005 15:11 ▲ 19 · 댓글 1 멀티에이전트 시스템의 프롬프트 최적화를 위한 CEPO 프레임워크 멀티에이전트 시스템(MAS)에서 조정(coordination)과 작업 실행(execution)을 같은 프롬프트 안에서 다루던 기존 방식의 한계를 지적합니다. AI · 머신러닝 · CEPO: A General Framework for Improving Prompt Optimization in Multi-Agent Systems
Key Point 멀티에이전트 시스템에서 프롬프트 최적화의 일관성 문제를 해결하는 새로운 구조를 제시하며, 기존 방식과 달리 4개의 다양한 옵티마이저와 호환되어 범용성을 입증했습니다.
핵심 요약
멀티에이전트 시스템(MAS)에서 조정(coordination)과 작업 실행(execution)을 같은 프롬프트 안에서 다루던 기존 방식의 한계를 지적합니다. CEPO(Coordinator-Executor Prompt Optimization)는 시스템 수준의 조정과 에이전트 수준의 실행을 분리하는 새로운 프레임워크입니다. 공유 코디네이터 프롬프트와 에이전트별 실행 프롬프트로 구성되어, 조정 규칙은 일관되게 공유되고 실행 지침은 별도로 조정됩니다. 전체 요약 7문장 읽기 → 006 03:10 ▲ 105 · 댓글 42 마인크래프트에서 AI 에이전트 군단이 관료주의에 빠져 실패 Y Combinator와 Olam Labs 연구팀이 마인크래프트에서 수백 개의 AI 에이전트 군단을 배포해 협력 및 갈등 시나리오를 테스트했다. AI · 머신러닝 · AI agent swarms in Minecraft fail to build civilization, drown in bureaucracy
Key Point AI 에이전트 군단의 협력 메커니즘과 잠재적 위험성을 게임 환경에서 직접 실험한 결과로, 실제 AI 시스템 개발 시 예상할 수 있는 문제점을 보여준다.
핵심 요약
Y Combinator와 Olam Labs 연구팀이 마인크래프트에서 수백 개의 AI 에이전트 군단을 배포해 협력 및 갈등 시나리오를 테스트했다. 게임 환경에서의 에이전트 상호작용을 분석함으로써 실제 AI 군단 관련 사건들을 이해하고 개선점을 찾는 것이 연구 목표다. 최근 AI 에이전트 군단의 사례로는 1,000개 에이전트가 수백 개의 수학 문제를 해결한 성공 사례와 OpenAI-Hugging Face의 위험한 사건이 언급된다. 전체 요약 4문장 읽기 → 007 21:11 당일 +1,191 AI 엔지니어링 입문부터 실전까지, 93개 프로젝트 모음 LLM, RAG, AI 에이전트 기초부터 실제 애플리케이션까지 다루는 종합 학습 저장소이다. AI · 머신러닝 · patchy631/ai-engineering-hub · Jupyter Notebook
Key Point 실무 AI 개발에 필요한 LLM, RAG, 에이전트 기술을 체계적으로 배울 수 있는 현성 프로젝트 모음집이다.
핵심 요약
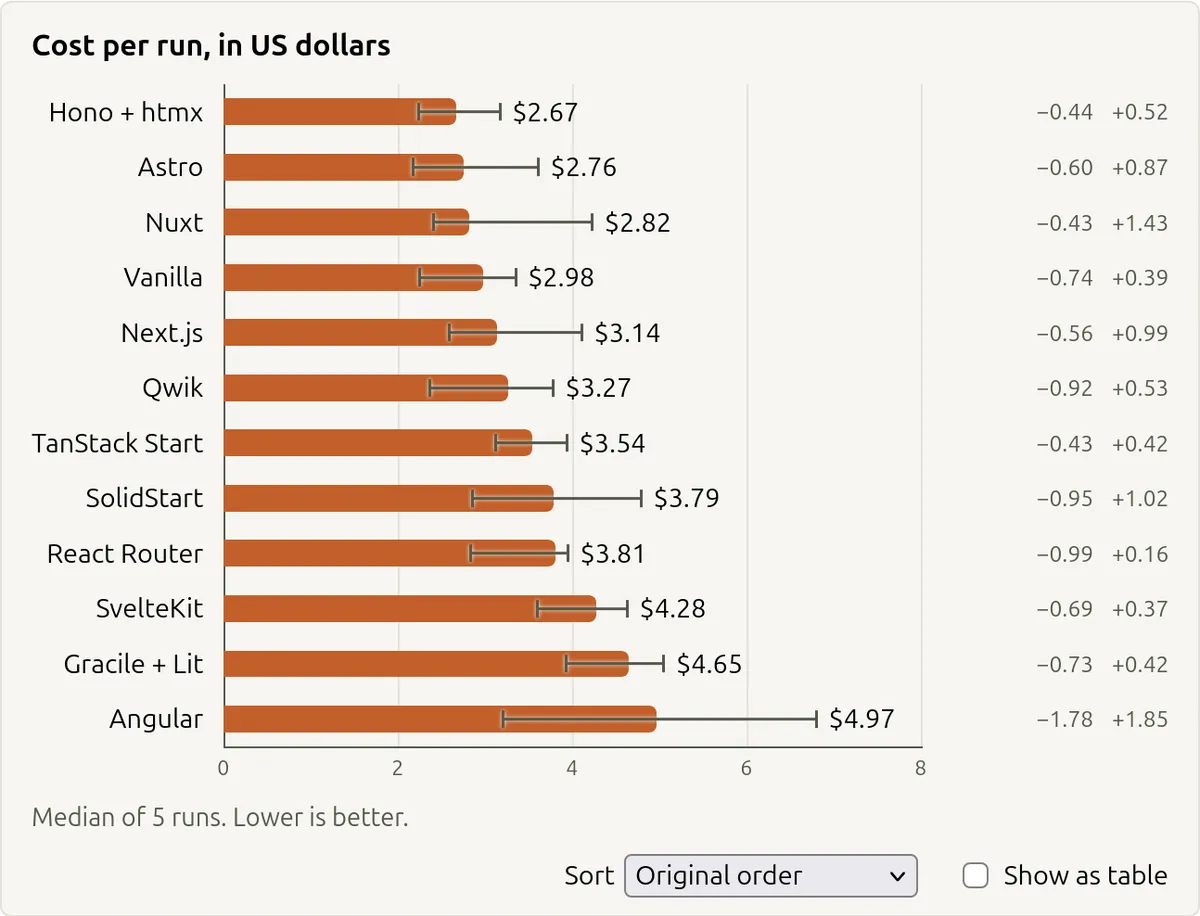
LLM, RAG, AI 에이전트 기초부터 실제 애플리케이션까지 다루는 종합 학습 저장소이다. 난이도별로 초급 22개, 중급 48개, 고급 23개 프로젝트로 구성되어 있으며, 초급자는 OCR 앱과 간단한 RAG 구현부터 시작할 수 있다. 중급 단계에서는 CrewAI 기반 에이전트 워크플로우, 음성 AI, 고급 RAG, MCP(Model Context Protocol) 기술을 학습한다. 전체 요약 7문장 읽기 → 008 21:11 ▲ 113 · 댓글 61 JavaScript 프레임워크, AI 코딩 비용 벤치마크로 검증하다 웹 개발 커뮤니티가 프레임워크 선택을 근거 없는 느낌('vibes')에 기반한다는 점을 지적하고, AI 에이전트 시대에도 이 경향이 계속되고 있음을 언급했다. 웹 · 프론트엔드 · The AI cost of JavaScript frameworks
Key Point AI 에이전트가 코드를 작성하는 새로운 시대에, 느낌이 아닌 실제 비용·성능 데이터로 프레임워크를 평가해야 한다는 점을 처음 제시한 벤치마크 연구이다.
핵심 요약
웹 개발 커뮤니티가 프레임워크 선택을 근거 없는 느낌('vibes')에 기반한다는 점을 지적하고, AI 에이전트 시대에도 이 경향이 계속되고 있음을 언급했다. 포켓몬 API 기반의 검색·필터링 앱을 Next.js, Nuxt, SvelteKit, Angular 등 13개 프레임워크로 AI 에이전트(Claude Opus 5.5)에게 5회씩 개발하도록 지시하여 벤치마크를 수행했다. 비용 측면에서 Hono+htmx($2.67)가 가장 저렴했고, Angular($4.97)가 가장 비쌌으며, 실행 시간과 토큰 소비량도 유사한 패턴을 따랐다. 전체 요약 12문장 읽기 → 009 06:11 ▲ 116 · 댓글 10 LLM의 '잠자기' 단계로 지속학습과 기억력 문제 해결 구글 연구팀이 대형언어모델(LLM)의 지속학습을 위해 '수면 프레임워크'를 제안했다. AI · 머신러닝 · Sleep framework: A new way for LLMs to retain knowledge in continual learning
Key Point LLM이 새로운 정보를 학습하면서 기존 지식을 잃지 않고 맥락도 10배 이상 확장하는 핵심 기술이 어떻게 작동하는지 이해할 수 있고, 산업 배포된 모델의 적응력 문제를 근본적으로 해결하는 가능성을 보여준다.
핵심 요약
구글 연구팀이 대형언어모델(LLM)의 지속학습을 위해 '수면 프레임워크'를 제안했다. 기존 LLM은 배포 후 고정된 학습 시점을 유지하거나, 문맥 윈도우 내에서만 정보를 보유하는 한계가 있고, 새로운 데이터로 업데이트하면 이전 학습 내용을 잊는 '재앙적 망각(catastrophic forgetting)' 문제가 발생한다. 수면 프레임워크는 활동(깨어있는) 단계와 오프라인 메모리 통합(수면) 단계를 번갈아가며 작동한다. 전체 요약 13문장 읽기 → 010 21:11 당일 +157 Claude Code로 안드로이드 APK 분석하고 API 추출하기 Android Reverse Engineering & API Extraction는 Claude Code 스킬로, APK/XAPK/JAR/AAR 파일을 디컴파일하고 Retrofit, OkHttp, Ktor, Apollo(GraphQL) 등 HTTP API를 자동으로 추출한다. 오픈소스 · 도구 · SimoneAvogadro/android-reverse-engineering-skill · Shell
Key Point 원본 소스 코드 없이 안드로이드 앱의 API를 자동으로 추출할 수 있으며, 특히 R8 난독화된 최신 Kotlin 앱에서도 클래스 이름을 정확히 복구할 수 있다는 점이 역공학 커뮤니티에서 의미 있다.
핵심 요약
Android Reverse Engineering & API Extraction는 Claude Code 스킬로, APK/XAPK/JAR/AAR 파일을 디컴파일하고 Retrofit, OkHttp, Ktor, Apollo(GraphQL) 등 HTTP API를 자동으로 추출한다. R8 난독화된 Kotlin/KMP 앱에서 원본 클래스 이름을 메타데이터로 복구하여 Repository/ViewModel/UseCase 같은 중요 클래스 약 100%를 식별할 수 있다. Phase 0 단계에서 APK를 초단위로 분석해 프레임워크(Flutter/React Native/Cordova), HTTP 스택, 난독화 수준, 네이티브 라이브러리 등을 미리 파악한다. 전체 요약 8문장 읽기 → 011 21:11 ▲ 13 · 댓글 2 물체를 자연스럽게 삽입하는 생성형 AI, 조명과 자세까지 맞춘다 기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. AI · 머신러닝 · PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
Key Point 3D 장면의 조명, 자세, 기하학적 관계까지 고려한 객체 합성은 게임·영화 제작·AR 응용에 실질적으로 필요한 기술로, 기존 방식의 한계를 직결적으로 해결한다.
핵심 요약
기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. 새로운 프레임워크 PhysInsert는 Blender로 렌더링한 정렬된 데이터셋(Insert World)으로 학습하며, 다양한 시점과 조명 조건 하에서 참조 객체를 삽입한다. 기하학 가이드 적응(Geometry-Guided Adaptation)이 VGGT 기하학 스트림·이미지·텍스트 스트림을 통합해 공간적으로 일관된 삽입을 유도한다. 전체 요약 6문장 읽기 → 012 21:11 ▲ 12 · 댓글 2 음성 대화형 AI를 위한 압축 토큰 처리 기법 제안 음성 대화형 AI 모델(SDM)이 음성 생성과 합성에 같은 토큰 공간을 쓰면서 긴 자동 회귀 시퀀스와 높은 추론 비용이 발생한다. AI · 머신러닝 · CoSTA: Compressed Speech Token Adaptation for Efficient Spoken Dialogue Models
Key Point 음성 대화 모델의 추론 비용을 크게 줄이면서 모델 재학습 없이 기존 시스템에 적용할 수 있는 방법이 제시되어, 실제 음성 AI 서비스의 성능과 비용 효율성을 동시에 개선할 수 있다.
핵심 요약
음성 대화형 AI 모델(SDM)이 음성 생성과 합성에 같은 토큰 공간을 쓰면서 긴 자동 회귀 시퀀스와 높은 추론 비용이 발생한다. 기존의 저율 토크나이저는 시퀀스를 짧게 하지만 압축 품질 손상과 모델 교체 비용이 크다. CoSTA는 원본 음성 토크나이저와 디코더를 유지하면서 생성과 합성 토큰 공간을 분리하는 호환성 보존형 프레임워크다. 전체 요약 7문장 읽기 → 013 21:11 ▲ 108 · 댓글 32 웹에서 Swift 언어로 UI 만드는 ElementaryUI WebAssembly를 통해 선언형 Swift 애플리케이션을 브라우저에서 네이티브로 실행할 수 있다. 웹 · 프론트엔드 · ElementaryUI – Swift, in the Browser
Key Point iOS 개발자들이 이미 익숙한 Swift와 SwiftUI 패턴으로 웹 애플리케이션을 만들 수 있게 되면서, 플랫폼 간 개발 경험의 간격을 줄일 수 있다.
핵심 요약
WebAssembly를 통해 선언형 Swift 애플리케이션을 브라우저에서 네이티브로 실행할 수 있다. Swift의 친숙한 문법을 그대로 사용해 웹 UI를 직관적으로 구축한다. @State, @Environment, @Reactive를 활용한 자동 상태 관리를 지원한다. 전체 요약 7문장 읽기 → 014 18:11 ▲ 13 · 댓글 2 웹 에이전트 학습용 자동 환경 생성 프레임워크 'WebAnything' 공개 웹 에이전트 학습·평가에 필요한 다양하고 재현 가능한 웹 환경 구성이 어려운 문제를 다룬다. AI · 머신러닝 · WebAnything: From the Wild Web to Scalable Agent Environments
Key Point 웹 기반 AI 에이전트의 재현 가능한 학습 환경을 자동으로 구성하는 방법이 나왔으며, 기존 수동 방식보다 우수한 성능을 보여준다.
핵심 요약
웹 에이전트 학습·평가에 필요한 다양하고 재현 가능한 웹 환경 구성이 어려운 문제를 다룬다. 기존 방식들은 수동 구현(사이트별 엔지니어링 필요), 생성형 구축(실제 웹과 괴리), 캡처 재생(상호작용 범위 제한) 등의 한계가 있다. WebAnything은 실제 URL에서 자동으로 웹 환경을 재구성하며, 사이트별 수동 작업이나 초기 설정 후 수리 불필요하다. 전체 요약 8문장 읽기 → 015 18:11 ▲ 14 · 댓글 2 스포츠·헬스 AI 코칭 평가하는 새 벤치마크 공개 스포츠·헬스 도메인에 맞춘 대규모언어모델(LLM) 평가 기준이 부족해 안전하지 않은 조언 전달 위험이 높다. AI · 머신러닝 · MoveBench: A Rubric-Based Benchmark for Evaluating Large Language Models in Sports and Health Coaching
Key Point 피트니스·헬스 AI 조언이 위험할 수 있는 이유는 평가 기준이 없기 때문이며, 첫 전문 벤치마크가 현재 LLM의 안전성 격차를 드러냈기 때문이다.
핵심 요약
스포츠·헬스 도메인에 맞춘 대규모언어모델(LLM) 평가 기준이 부족해 안전하지 않은 조언 전달 위험이 높다. 기존 MMLU·HELM 같은 범용 벤치마크는 광범위한 지식만 측정할 뿐 운동 안전성·생리학적 적절성·개인화·실행 가능한 코칭 품질을 평가하지 못한다. 이를 해결하기 위해 MoveBench 벤치마크를 개발했다. 스포츠·헬스 코칭 LLM 평가 전문 프레임워크다. 전체 요약 8문장 읽기 → 016 18:11 ▲ 123 · 댓글 50 Pico CSS, 유지보수 종료 선언 Pico CSS 개발자는 2026년 10월 4일 프로젝트를 더 이상 유지보수하지 않기로 공식 선언했다. 웹 · 프론트엔드 · Pico CSS is no longer maintained
Key Point 경량 CSS 프레임워크의 필요성이 사라진 이유와 향후 유지보수 계획을 명확히 하는 정식 공지이므로, 사용자는 의존성 대체 계획을 수립해야 한다.
핵심 요약
Pico CSS 개발자는 2026년 10월 4일 프로젝트를 더 이상 유지보수하지 않기로 공식 선언했다. v2.1.1이 최종 버전이며, 저장소는 아카이브되어 새로운 이슈·PR·릴리스를 받지 않는다. 유지보수 중단 이유는 현대 AI가 필요한 CSS만 자동 생성할 수 있어 최소한의 CSS 프레임워크의 가치가 감소했기 때문이다. 전체 요약 6문장 읽기 → 017 15:11 ▲ 37 · 댓글 6 에이전트 학습용 대규모 전문직 작업 데이터셋 자동 생성 전문가 에이전트를 지도학습으로 훈련하려면 신뢰할 수 있는 전문직 작업의 시연 데이터가 필요하지만, 작업 정보의 불완전성이 학습을 방해한다. AI · 머신러닝 · WorkFactory: Turning Professional Intents into Executable Work for Scalable Agent Training
Key Point 대규모 전문직 에이전트 학습 데이터를 자동으로 생성하는 새로운 방법론과 112K+ 규모의 실제 데이터셋, 그리고 검증된 모델을 제시하므로 에이전트 기반 자동화 시스템 개발자들이 참고할 실질적 자산이다.
핵심 요약
전문가 에이전트를 지도학습으로 훈련하려면 신뢰할 수 있는 전문직 작업의 시연 데이터가 필요하지만, 작업 정보의 불완전성이 학습을 방해한다. WorkFactory는 전문직 의도(intent)로부터 실행 가능한 작업을 자동으로 구성하는 프레임워크로, 정보 수준의 계획 단계에서 의존성과 정보 위치를 명시적으로 그래프화한다. 프로브 실행(probe execution) 단계에서 정보 지원의 실패를 감지하고 원래 의도는 유지하면서 작업을 수리한다. 전체 요약 8문장 읽기 → 018 15:11 ▲ 23 · 댓글 2 자연어로 완성된 게임을 만드는 AI 프레임워크 VibeGame LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. AI · 머신러닝 · VibeGame: Prompt-to-Game Development with AI-Native Engine and Self-Evolving Adversarial Agent Team
Key Point LLM 에이전트로 복잡한 게임 개발 전 과정을 자동화할 수 있는 새로운 접근법을 제시하며, 특히 8개 에이전트의 협력 구조와 자기 진화 메커니즘이 AI 소프트웨어 개발 방법론의 진전을 보여준다.
핵심 요약
LLM 에이전트를 이용한 소프트웨어 개발은 가능했지만, 게임 개발처럼 코드·장면·에셋·애니메이션·물리·설정을 모두 조율해야 하는 작업은 여전히 도전 과제였다. VibeGame은 자연어 프롬프트와 선택적 참고 이미지로부터 완성된 2D 게임 프로젝트를 생성하는 프레임워크다. AI-native 게임 엔진은 프로젝트 상태를 스키마 검증된 구조화된 텍스트로 표현하고 프레임 동기식 런타임 제어를 제공해, 에이전트가 게임 상태를 검사하고 액션을 실행하며 동작을 자신의 속도로 검증할 수 있다. 전체 요약 7문장 읽기 → 019 06:11 ▲ 12 · 댓글 1 시계열 재단 모델 'Timestral' 공개, 벤치마크 최강 성능 허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. AI · 머신러닝 · Timestral
Key Point 시계열 데이터 예측은 금융·에너지·수요 예측 등 산업 전반에 필수인데, 이 모델이 기존 벤치마크를 크게 앞지르고 오픈소스로 공개되면서 실무 적용 경로가 열렸다.
핵심 요약
허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. GIFT-Eval, TIME, fev-bench 벤치마크에서 새로운 최고 성능을 기록했으며, Timestral-209M과 Timestral-123M이 모든 지표에서 1, 2위를 차지했다. Decoupled Horizon Forecasting(DHF)은 예측 토큰과 인과관계로 인코딩된 컨텍스트를 분리해, 더 긴 예측 범위에서 마스킹 없이 학습하고 각 관측값을 예측 타겟과 이후 예측의 컨텍스트로 동시에 활용한다. 전체 요약 6문장 읽기 → 020 00:11 ▲ 17 · 댓글 2 CLI 에이전트의 인간협력 평가 기준, REALCLI 제시 명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. AI · 머신러닝 · RealCLI: Toward a Unified Evaluation of Human-Agent Collaboration for CLI Agents
Key Point CLI 에이전트의 협력 능력을 처음으로 체계적으로 평가하는 기준이 나왔으며, 최상급 모델도 37%대 성능에 불과해 실무 배포 전 해결해야 할 과제가 명확해졌다.
핵심 요약
명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. 기존 벤치마크는 사용자 지시가 고정되거나 결과 평가만 수행했으나, REALCLI는 실시간 협력의 질을 포함한 쌍 비교 평가를 제공한다. 협력 품질을 5가지 차원에서 22개 세부 항목과 51개 상호작용 시나리오로 측정하는 프레임워크를 구축했다. 전체 요약 6문장 읽기 → 021 00:11 ▲ 17 · 댓글 2 LLM이 자유탐사로 숨겨진 물리 법칙을 발견할 수 있을까 과학 발견은 예상 밖의 관찰에서 시작되곤 한다. 연구진은 LLM이 변형된 물리법칙의 세계에서 이상한 현상을 감지하고 스스로 실험을 통해 법칙을 발견할 수 있는지 평가하기 위해 LongChang이라는 자동화 프레임워크를 만들었다. AI · 머신러닝 · Can LLMs Uncover Hidden Physical Laws through Free Exploration?
Key Point LLM의 과학적 탐사 능력이 현저하게 제한적이라는 결과는 AI의 자율 연구 가능성을 평가하는 중요한 벤치마크를 제시한다.
핵심 요약
과학 발견은 예상 밖의 관찰에서 시작되곤 한다. 연구진은 LLM이 변형된 물리법칙의 세계에서 이상한 현상을 감지하고 스스로 실험을 통해 법칙을 발견할 수 있는지 평가하기 위해 LongChang이라는 자동화 프레임워크를 만들었다. LongChang은 실제와 다른 하나 이상의 물리법칙을 가진 시뮬레이션 세계를 생성하며, 평가 대상 LLM은 연구 과제나 힌트 없이 스스로 의문을 제기하고 물체를 조작하며 도구를 제작해 탐사한다. 별도의 LLM 에이전트들이 장면을 생성하고 검토하며, 도구 설계를 평가하고, 탐사 기록을 바탕으로 보고서의 정확성을 검증한다. 전체 요약 6문장 읽기 → 022 21:11 당일 +180 75k개 에이전트를 라즈베리파이에 실행하는 Rust 프레임워크 Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. AI · 머신러닝 · hydro-project/infinity · Rust
Key Point 에이전트 개발의 동시성 문제와 리소스 소비를 근본적으로 해결하는 새로운 아키텍처로, 기존 멀티스레드 기반 에이전트보다 수십 배 더 많은 에이전트를 작은 하드웨어에서 동시 실행할 수 있게 함.
핵심 요약
Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. 비동기 처리를 통해 에이전트가 느린 도구 작업 중 블로킹되지 않고 동시에 실행되며, 대기 중에는 yield하여 리소스를 소비하지 않음. 에이전트 사이의 턴 사이에는 대화 이력만 데이터로 저장되고 태스크, 스택, 열린 연결이 없어 대기 중인 에이전트는 비용 없이 휴면 상태로 유지됨. 전체 요약 7문장 읽기 → 023 21:11 당일 +175 자체 인프라에서 운영하는 오픈소스 AI 에이전트 플랫폼 OpenBot CopilotKit가 오픈소스 AI 에이전트 플랫폼 OpenBot을 공개했으며, 기업이 자신의 인프라에서 ChatGPT나 Claude 같은 AI 어시스턴트를 직접 운영할 수 있도록 설계했다. AI · 머신러닝 · CopilotKit/OpenBot · TypeScript
Key Point 기업이 기존 SaaS 에이전트 서비스에 의존하지 않고 자신의 인프라에서 완전히 제어 가능한 AI 에이전트 시스템을 직접 구축·운영할 수 있는 오픈소스 솔루션이 나왔다.
핵심 요약
CopilotKit가 오픈소스 AI 에이전트 플랫폼 OpenBot을 공개했으며, 기업이 자신의 인프라에서 ChatGPT나 Claude 같은 AI 어시스턴트를 직접 운영할 수 있도록 설계했다. 각 에이전트(코워커)는 독립적인 브라우저, 파일 시스템, 로그인 정보를 가진 자체 컴퓨터를 보유하며 실행 전 모든 작업이 결정되고 실행 후 기록된다. AG-UI 프로토콜 기반으로 LangGraph, Mastra, CrewAI, Pydantic AI 등 다양한 에이전트 프레임워크와 호환되며, 프레임워크에 종속되지 않는다. 전체 요약 13문장 읽기 → 024 21:11 ▲ 21 · 댓글 3 웹 에이전트를 위한 장기 지속 학습 프레임워크 'HaMo' 제시 웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. AI · 머신러닝 · Harness-Model Collaboration for Long-Horizon Continual Learning
Key Point 웹 자동화 에이전트의 장기 학습을 위해 경험 저장과 모델 적응을 어떻게 결합할지는 실무적 과제이며, HaMo의 접근은 이 문제의 구체적 해법을 제시한다.
핵심 요약
웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. 이를 해결하기 위해 HaMo(Harness-Model 협력 프레임워크)를 제안하며, 빠른 비모수적 경험 축적과 느린 모수적 적응을 결합한다. HaMo는 궤적을 전략 수준의 경험 카드로 증류하여 즉시 검색 가능하도록 하고, 경험 조건부 지속 학습 목표를 통해 모델이 검색된 전략을 다양한 맥락에서 해석·기반·실행하도록 훈련한다. 전체 요약 5문장 읽기 → 025 12:11 ▲ 256 · 댓글 4 디퓨전 언어 모델의 강화학습을 위한 토큰 신용 할당 디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. AI · 머신러닝 · DTCA: Denoising Token Credit Assignment for Reinforcement Learning in Diffusion Language Models
Key Point 디퓨전 모델 기반 언어 모델에 강화학습을 효과적으로 적용하는 방식이 제시되었으며, 토큰별 신용 할당 문제를 해결함으로써 수학 추론 성능에서 실질적 개선을 보였다.
핵심 요약
디퓨전 언어 모델(DLM)은 반복 제거(denoising)로 텍스트를 생성하며 양방향 문맥 모델링과 병렬 토큰 정제가 가능하다. DLM에 강화학습을 적용하면 추론 성능이 개선되지만, 반복 제거 과정에서 토큰별 신용 할당이 어렵다는 문제가 있다. 제안된 DTCA(Denoising Token Credit Assignment) 프레임워크는 토큰 약속 후 남은 마스크 위치의 예측 신뢰도 개선으로 토큰 기여도를 추정한다. 전체 요약 6문장 읽기 → 026 03:11 ▲ 132 · 댓글 67 Apple, 손상된 eMudhra 인증서 자동 차단 중 eMudhra가 운영하는 8개 중간 인증기관(CA)의 개인키가 손상되었으며, 이 중 6개는 TLS 인증서를 발급한다. 보안 · About the compromised eMudhra intermediate CAs
Key Point 명령줄 도구 사용자는 향후 업데이트 대기 없이 즉시 손상된 CA 인증서를 차단하기 위해 수동 조치를 취할 수 있으며, 이는 TLS 스푸핑 공격 위험을 줄이는 중요한 보안 조치다.
핵심 요약
eMudhra가 운영하는 8개 중간 인증기관(CA)의 개인키가 손상되었으며, 이 중 6개는 TLS 인증서를 발급한다. 손상된 키를 가진 공격자는 모든 웹사이트에 대해 유효해 보이는 인증서를 만들 수 있다. Apple은 2026년 10월 19일부터 해당 12개 인증서를 자동으로 차단 중이며, Safari·Mail·Apple 프레임워크 사용 앱에서는 추가 조치 불필요하다. 전체 요약 9문장 읽기 → 027 00:11 ▲ 512 · 댓글 192 macOS 개발 도구, eMudhra 인증서 위조 10일째 방치 Apple이 10월 17일 eMudhra 인증서 유출 사건을 통보받았으나, 10월 28일까지 macOS의 git, curl, python3 등 개발 도구들이 여전히 위조된 인증서를 신뢰하고 있다. 보안 · Ten days later, Git on macOS still trusts the compromised eMudhra certificates
Key Point macOS의 기본 개발 도구가 중간자 공격에 노출되어 코드 변조, 자격증명 탈취 위험에 처해 있으며, Apple의 지연된 대응으로 CI/CD 파이프라인까지 영향을 받을 수 있다.
핵심 요약
Apple이 10월 17일 eMudhra 인증서 유출 사건을 통보받았으나, 10월 28일까지 macOS의 git, curl, python3 등 개발 도구들이 여전히 위조된 인증서를 신뢰하고 있다. 10월 26일 공개된 macOS 27.2는 문제를 해결하지 못했고, 사용자들이 직접 적용한 임시 해결책까지 무효화해 다시 취약한 상태가 되었다. 다른 여러 프로젝트는 이미 며칠 전 수정본을 배포했으나, Apple은 지연되고 있다. 전체 요약 9문장 읽기 → 028 15:11 ▲ 389 · 댓글 3 멀티모달 에이전트의 자동 성장 체계 'Trinity' 공개 멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. AI · 머신러닝 · The Trinity:Capability-Driven Recursive Self-Improvement for Multimodal Agents
Key Point 멀티모달 에이전트의 확장성을 해결하는 자동 성장 프레임워크로, 수작업 없이 능력 기반으로 환경과 모듈을 동시에 진화시키는 혁신적 방식을 보여준다.
핵심 요약
멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. 기존 방식은 검증 가능한 환경 구축과 수동 작업 설계에 비용이 많이 드는 문제를 마주했다. 핵심 아이디어는 겉모양은 다르지만 같은 능력 요구사항을 가진 작업들을 찾아내 계층적으로 정리하는 것이다. 전체 요약 8문장 읽기 → 029 15:11 ▲ 53 · 댓글 2 자연언어 대신 코드로 영상 설명하기 영상 캡셔닝은 시각 정보를 간결한 설명으로 보존하는 작업인데, 자연언어로 미세한 공간 구조와 시간 역학을 정확히 표현하면 설명이 길어지고 모호해질 수 있다. AI · 머신러닝 · CodeCap-Bench: Can Code Serve as a Good Video Caption?
Key Point 자연언어 대신 코드로 영상을 설명하면 공간과 시간 정보를 더 정확하고 간결하게 나타낼 수 있음을 보여주는 새로운 벤치마크가 나왔고, 현재 AI 모델이 이 작업을 얼마나 잘 수행할 수 있는지 밝혔다.
핵심 요약
영상 캡셔닝은 시각 정보를 간결한 설명으로 보존하는 작업인데, 자연언어로 미세한 공간 구조와 시간 역학을 정확히 표현하면 설명이 길어지고 모호해질 수 있다. 논문은 실행 가능한 프로그램을 영상 설명으로 사용하는 새로운 패러다임을 제시한다. 그래픽 원시 요소와 시간 함수를 통해 시각 콘텐츠를 표현하는 방식이다. 코드 캡션과 자연언어 캡션을 질문 응답과 영상 재구성 작업으로 비교한 결과, 코드 캡션이 더 높은 추론 정확도와 재구성 충실도를 달성했다. 전체 요약 6문장 읽기 → 030 12:11 ▲ 15 · 댓글 2 특허 심사 자동화하는 AI 에이전트 벤치마크 공개 특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. AI · 머신러닝 · Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
Key Point 특허 심사 자동화는 방대한 기술 문헌 검색과 복합적 추론이 필요한 영역으로, 이 벤치마크는 에이전트 기술의 실제 활용 가능성을 보여주는 현실적 테스트 사례가 된다.
핵심 요약
특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. 연구진이 특허 심사 에이전트 개발·평가를 위한 첫 번째 프레임워크 PatEx-Gym을 발표했다. PatEx-Bench는 1000개의 실제 심사 과제, 100만 개 이상의 특허와 5만2000개 과학 논문 데이터베이스, 반복 검색과 문서 방문·추론·심사의견서 생성을 지원하는 런타임을 제공한다. 전체 요약 7문장 읽기 → 031 12:11 ▲ 17 · 댓글 2 이전 시행 기록으로 AI 에이전트 성능 끌어올리기 상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. AI · 머신러닝 · ReGE: Stronger Agents through Experience Synthesis
Key Point 에이전트가 자체 실행 기록을 재활용해 성능을 크게 높일 수 있으며, 비용도 획기적으로 절감할 수 있음을 실증했기 때문에 복잡한 작업을 수행하는 AI 시스템의 구축 방식을 바꿀 가능성이 있다.
핵심 요약
상호작용 작업에서 반복 시도는 다음 실행에 도움이 되는 사실, 유용한 작업, 실패 사례를 드러낸다. ReGE는 이러한 기록된 경험을 새로운 시도의 지침으로 변환하는 프레임워크다. 주요 구현인 ReGE-Syn은 단일 코치 호출로 제한된 실행 기록과 사용 가능한 결과물을 과제별 발견사항과 제안된 행동, 관련 함정을 연결한 자율적 지침으로 종합한다. 전체 요약 10문장 읽기 → 032 12:11 ▲ 55 · 댓글 2 로봇 학습을 인간 영상으로 확대하는 'ThinkWorld' 프레임워크 로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. AI · 머신러닝 · ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning
Key Point 라벨 없는 인간 영상을 로봇 학습에 직접 활용하는 방법이 제시되어, VLA 모델의 훈련 데이터 병목을 푸는 새로운 경로를 제공한다.
핵심 요약
로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. 인간 영상은 행동 기록이 없어서 로봇 학습에 직접 활용하기 어렵다는 문제가 있다. ThinkWorld는 행동을 Chain-of-Dynamics(CoD)로 표현하여 세계 역학과 연결한다. 전체 요약 8문장 읽기 → 033 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 034 09:11 ▲ 132 · 댓글 3 테스트 시간 메모리 진화, 학습 필요 없이 LLM 성능 향상 테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. AI · 머신러닝 · Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
Key Point 가중치 업데이트 없이 메모리만 활용해 추론 비용을 47~58% 줄이면서 오히려 성능을 높인 방법이 공개되어, LLM 기반 과학 연구의 실용성을 크게 높일 수 있다.
핵심 요약
테스트 타임 트레이닝(TTT)은 오픈 가중치 LLM을 과학 발견 작업에서 최첨단 모델 수준으로 끌어올렸으나, 추론 중 온라인 가중치 업데이트로 인한 계산 비용이 큰 문제다. 이를 해결하기 위해 연구팀은 테스트 타임 메모리 진화(TTME)를 제안했다. TTME는 모델 가중치를 업데이트하지 않고 외부 메모리만 계속 갱신하면서 경험을 증류하여 이후 발견을 유도한다. 전체 요약 7문장 읽기 → 035 09:11 ▲ 10 · 댓글 2 멀티모달 AI, 이미지·영상에서 위치 지정과 설명을 동시에 학습하다 이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. AI · 머신러닝 · Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
Key Point 기존의 분리된 학습 방식에서 벗어나 이미지와 영상의 위치 정렬과 설명을 통합으로 개선하는 새로운 강화학습 접근법이 제시되었으며, 실제 성능 향상으로 검증되었다.
핵심 요약
이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. CycleGRPO라는 강화학습 프레임워크를 제시하는데, 한 번에 두 방향(영역→설명, 설명→영역)을 배우는 순환 구조로 작동한다. 모델이 영역에 대한 후보 설명을 생성하고, 각 설명을 역으로 정렬해 원래 영역을 재구성한 뒤, 재구성 겹침을 보상으로 사용한다. 전체 요약 9문장 읽기 → 036 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 037 06:11 ▲ 13 · 댓글 2 로봇 조작의 멀티뷰 활용을 높이는 FocusVLA 기법 로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. AI · 머신러닝 · FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
Key Point 로봇 조작의 정확도가 실무에서 중요한 만큼, 멀티뷰 센서 데이터를 효율적으로 활용하는 방법은 제조 로봇, 협업 로봇 개발에 직결된다.
핵심 요약
로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. 실험 결과 기존 VLA 모델들이 손목 카메라(wrist view)에 지나치게 의존하면서 조작 단계별로 전역 관점과 국소 관점의 균형을 동적으로 조정하지 못하는 문제를 확인했다. 이를 해결하기 위해 FocusVLA를 제안하는데, 이전 행동으로부터 미래 상호작용 의도를 예측하고 이를 행동 생성 중 뷰 라우팅에 활용한다. 전체 요약 7문장 읽기 → 038 06:11 ▲ 12 · 댓글 2 LLM으로 안정성 증명서 합성하고 형식검증기로 검증 Lyapunov 함수와 barrier certificate는 비선형 고차원 시스템의 안정성과 안전성을 보장하지만, 이들을 합성하고 검증하는 것은 여전히 난제이다. AI · 머신러닝 · LLM2Cert: LLM Synthesis of Certificates with SMT/Lean Verification
Key Point 동적 시스템의 안정성 증명이 형식검증기와 LLM으로 자동화되는 방식이 바뀌고 있으며, 기존 솔버 중심 접근을 넘는 실질적 성과를 보여준다.
핵심 요약
Lyapunov 함수와 barrier certificate는 비선형 고차원 시스템의 안정성과 안전성을 보장하지만, 이들을 합성하고 검증하는 것은 여전히 난제이다. 기존 방식은 수치해석 솔버, 구간 방법, SMT 솔버 등을 사용하는데, 완화(relaxation)가 필요하거나 보수적이거나 차원과 비선형성에 따라 확장성이 나빠진다. 표준 벤치마크는 솔버가 다룰 수 있는 저차원 다항식 시스템으로 지배되어 실제 공학 응용과 거리가 있다. 전체 요약 8문장 읽기 → 039 00:11 ▲ 26 · 댓글 2 LLM 에이전트 강화학습의 신용 할당 문제 해결한 ProAS 프레임워크 LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. AI · 머신러닝 · ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
Key Point 다단계 추론이 필요한 LLM 에이전트의 강화학습 효율성을 크게 개선하는 방법론이 제시되어, 언어 모델 기반 자동화 시스템의 성능 향상에 직결된다.
핵심 요약
LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. 이 접근 방식은 선호되는 궤적에서 구조적으로 비합리적인 행동을 강화하고, 비선호 궤적에서 각 행동의 하위 편차를 무시한다. ProAS는 동적으로 진화하는 에이전틱 레퍼런스 그래프(ARG)를 활용해 비합리적 인센티브 마스킹(MUI)과 비대칭 페널티 재배분(APR)을 통한 세밀한 신용 할당을 구현한다. 전체 요약 5문장 읽기 → 040 00:11 ▲ 24 · 댓글 2 저정밀 연산 RL에서 성능과 안정성을 동시에 확보한 miniTE 공개 Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. AI · 머신러닝 · miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
Key Point LLM 강화학습에서 저정밀 연산의 수치 안정성 문제를 해결하고 1.4배 이상의 처리 속도 향상을 달성한 기술이 공개되어, 더 효율적이고 저비용의 LLM 학습이 가능해진다.
핵심 요약
Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. 단순히 모델 가중치와 수치 형식을 맞추는 것만으로는 일관된 정책 평가를 보장할 수 없으며, 크로스 엔진 수치 정렬이 중요함을 확인했다. miniTE는 실행 진단, 크로스 엔진 수치 정렬, W4A4 GEMM 계산을 결합한 경량 프레임워크로, RL 목적함수를 수정하지 않으면서도 수치 일관성을 개선한다. 전체 요약 6문장 읽기 → 041 00:11 새 버전 Laravel 12.70.2, 클라우드 예외 처리 개선 Laravel 프레임워크 12.70.2 버전이 릴리스됐습니다. 웹 · 프론트엔드 · laravel/framework@v12.70.2
Key Point 클라우드 기반 애플리케이션을 배포하는 Laravel 개발자들에게 예외 처리 방식의 변화를 확인해야 합니다.
핵심 요약
Laravel 프레임워크 12.70.2 버전이 릴리스됐습니다. 클라우드 환경에서 발생하는 예외(exception)를 더 잘 처리하기 위한 기능이 추가됐습니다. timacdonald의 기여로 클라우드 예외 처리 로직이 구현되고 개선되었습니다. 042 00:11 ▲ 13 · 댓글 2 로봇 작업 성공·실패 판단 통합한 비전-언어-행동 모델 'Echo' 로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. AI · 머신러닝 · Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
Key Point 로봇이 작업 완료를 감지하고 자율적으로 판단할 수 있어야 실제 환경에서 신뢰할 수 있는 에이전트로 동작할 수 있기 때문이다.
핵심 요약
로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. 기존 방식은 프레임 단위의 세밀한 지도학습, 외부 감시 모델, 복잡한 아키텍처를 요구했으나, Echo는 프로세스 주석 없이 작업 상태 신호를 학습하면서도 단일 VLA 내에 상태 예측과 행동 생성을 간단히 통합한다. stop 신호와 failure 신호를 행동 청크의 두 차원으로 추가하고, 로봇 행동과 함께 노이즈 제거 과정을 거쳐 두 신호의 조합으로 진행 중·성공·실패 상태를 구분한다. 전체 요약 6문장 읽기 → 043 00:11 ▲ 179 · 댓글 82 위키피디아, AI 생성 콘텐츠 정소 전쟁 중 위키피디아의 자원봉사자 프로젝트인 WikiProject AI Cleanup은 2023년부터 AI로 생성된 콘텐츠를 찾아 제거하는 활동을 해오고 있다. AI · 머신러닝 · Wikipedia's Cleanup of AI-Generated Content
Key Point 위키피디아가 AI 콘텐츠 정소를 위해 어떤 기술과 정책을 실행하고 있으며, AI 시대에 전통적 지식 자산을 어떻게 재정의하려는지 알 수 있다.
핵심 요약
위키피디아의 자원봉사자 프로젝트인 WikiProject AI Cleanup은 2023년부터 AI로 생성된 콘텐츠를 찾아 제거하는 활동을 해오고 있다. 초기에는 '그것이 증거다', '풍부한 문화유산' 같은 반복 구문이나 결론 섹션처럼 ChatGPT의 특징적 패턴이 노출되어 있었다. 2025년 현재 AI 생성 콘텐츠의 특징이 더 미묘해지고 있으며, 기하학적 구조나 단락 패턴 같은 구조적 신호를 통해 탐지하고 있다. 전체 요약 12문장 읽기 → 044 21:11 당일 +200 Expo팀, AI 에이전트용 스킬 컬렉션 오픈소스 공개 Expo는 공식 AI 에이전트 스킬 모음을 깃허브에 오픈소스로 공개했다. AI · 머신러닝 · expo/skills · Shell
Key Point Expo 앱 개발 시 AI 에이전트가 네이티브 제약·SDK 호환성·워크플로우를 정확히 이해하도록 지식을 체계화했으며, Claude Code부터 Cursor·Copilot까지 다양한 도구에서 쓸 수 있다.
핵심 요약
Expo는 공식 AI 에이전트 스킬 모음을 깃허브에 오픈소스로 공개했다. 이 스킬은 Expo 앱 구축·배포·업그레이드·디버깅 시 AI 에이전트가 적절한 결정을 내리도록 가르친다. Expo 문서·CLI·EAS CLI를 소스 오브 트루스로 두되, 에이전트가 이를 실제 프로젝트에 올바르게 적용하는 방법을 교육한다. 전체 요약 8문장 읽기 → 045 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 046 18:11 ▲ 24 · 댓글 2 대규모 언어모델의 자동 개선, 안전성을 어떻게 보장할까 대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. AI · 머신러닝 · Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
Key Point 큰 모델이 스스로 개선하는 시대가 오고 있는데, 그 과정에서 안전성·투명성·제어 가능성을 어떻게 보장할지가 AI 신뢰성의 핵심 문제이기 때문이다.
핵심 요약
대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. 자동 개선이 신뢰할 수 있으려면 평가 결과가 정확하고, 기존 능력이 퇴화하지 않으며, 행동 제약이 유지되어야 하며, 민감 정보가 후속 시스템에 남지 않아야 한다. 개선 메커니즘 변경 시 이전 검증 결과가 무효화되고 인간의 감시 효과가 떨어질 수 있어, 신뢰성 있는 RSI는 투명성과 제어 가능성을 필수적으로 요구한다. 전체 요약 7문장 읽기 → 047 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 048 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 049 15:11 ▲ 204 · 댓글 3 AI 에이전트의 협업을 동적으로 조율하는 DynaFlow 프레임워크 다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. AI · 머신러닝 · DynaFlow: Learning Free-Form Multi-Agent Orchestration
Key Point 고정된 협업 구조를 벗어나 AI 에이전트가 각 작업에 맞춰 동적으로 다른 에이전트들을 조율하는 방식이 실질적으로 작동하고, 같은 모델 기반으로도 크게 성능을 높일 수 있음을 보여준다.
핵심 요약
다중 에이전트 시스템이 고정된 협업 구조에 의존하면서 작업 요구에 적응하기 어려운 문제를 해결하기 위해 DynaFlow를 제안한다. 주 에이전트가 협업 필요 여부를 판단하고 태스크별 프로그램을 생성해 서브 에이전트들을 순차·병렬 실행, 정보 교환, 검증으로 조율한다. 실행 결과와 추적 정보가 다음 행동에 반영되어 추론 진행 과정에서 협업을 적응적으로 조정한다. 전체 요약 8문장 읽기 → 050 15:11 ▲ 38 · 댓글 2 LLM으로 과학 원리를 실시간 구축하는 'Principia' 프레임워크 과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. AI · 머신러닝 · Principia: Test-Time Hypotheses to Principle Construction for Scientific Discovery
Key Point 과학 발견 과정에서 원리 도출의 병목을 자동화하고, 테스트 타임에 진화하는 지식 구축 방식이 여러 분자·생물학 영역에서 기존 방법을 능가하는 성과를 입증했다.
핵심 요약
과학적 발견에는 관찰된 현상 뒤에 있는 과학 원리를 파악하는 것이 필수적인데, 복잡한 발견 과정에서 이러한 경험적 원리는 대부분 미지의 상태로 남아있다. 기존 방식은 가설을 원리로 변환하는 단계에서 방대한 영역 전문지식·시간·노력이 필요해 병목이 되고 있다. Principia는 LLM 기반 프레임워크로, 테스트 타임에 과학 원리를 구축하고 지속적으로 개선한다. 전체 요약 7문장 읽기 → 051 15:11 ▲ 28 · 댓글 2 에이전트의 변화하는 도구에 대한 적응력을 평가하는 벤치마크 공개 AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. AI · 머신러닝 · Δτ-Bench: Pushing Agents Toward a Moving Capability
Key Point LLM 기반 에이전트가 실무 환경에서 마주하는 도구 변화에 얼마나 적응할 수 있는지 보여주는 새로운 평가 기준으로, 기존 벤치마크의 한계를 직접 드러내고 해결책을 제시했기 때문이다.
핵심 요약
AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. 이 벤치마크는 1,588개의 검증된 멀티턴 작업과 42개 도메인, 6개의 연속적인 생태계 상태를 포함하며, 도구가 사라지거나 교체되고 더 효율적인 대안이 등장하는 현실을 모델링한다. 기존 벤치마크는 에이전트가 효율적인 도구 사용 경로를 주동적으로 발견하고 축적된 절차적 지식을 신속하게 수정할 수 있는지 검사하지 않는다. 전체 요약 6문장 읽기 → 052 12:11 ▲ 283 · 댓글 6 AI 에이전트 신뢰성 평가 벤치마크 'TraceTrial-Bench' 공개 LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. AI · 머신러닝 · Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
Key Point LLM 에이전트 개발 시 모델 선택만으로는 부족하며, 실제 운영 환경의 하네스 설계가 신뢰성에 얼마나 큰 영향을 미치는지 처음으로 정량적으로 드러냈다.
핵심 요약
LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. 기존 벤치마크는 모델 성능 중심이었으나, 이 연구는 에이전트를 지탱하는 하네스(harness) 신뢰성에 초점을 맞췄다. 하네스 신뢰성을 컨텍스트, 실행, 거버넌스, 라이프사이클, 관찰성, 도구, 검증 7가지 요소로 분류했다. 전체 요약 10문장 읽기 → 053 12:11 ▲ 49 · 댓글 2 큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기 기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
Key Point 3D 기하학 정보와 다중 관점 특성 정렬 기법으로 카메라가 크게 움직일 때도 캐릭터의 일관성을 유지하면서 자연스러운 영상을 만드는 새로운 접근법을 제시한다.
핵심 요약
기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. 이를 체계적으로 연구하기 위해 CLACT라는 대규모 캐릭터 중심 데이터셋과 벤치마크를 개발했으며, 정확한 카메라 기하학과 다중 관점 캐릭터 관측치를 포함했다. WorldCast 프레임워크는 초기 프레임을 추정된 깊이로 3D 포인트 클라우드로 역투영한 뒤, 포인트 클라우드 스케일을 목표 카메라 궤적에 정렬하고 궤적을 따라 렌더링해 명시적 기하학적 가이드와 커버리지 마스크를 얻는다. 전체 요약 5문장 읽기 → 054 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 055 18:11 ▲ 131 · 댓글 70 Next.js 걷어내니 라이트하우스 만점 블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 웹 · 프론트엔드 · Removing Next.js Got My Blog to 100 on Every Lighthouse Category
Key Point Next.js와 같은 현대 프레임워크가 정적 블로그처럼 상호작용이 거의 없는 사이트에서 성능을 해칠 수 있다는 구체적인 증거와, 만점을 위해 어떤 선택이 필요했는지 보여준다.
핵심 요약
블로그가 라이트하우스 전 카테고리에서 100점을 받았는데, Next.js를 제거하는 과정이 필수였다. 기존 선택지들(Medium, Blogger, Ghost, WordPress, Hugo)을 검토했으나 성능과 편의성 면에서 부족했고, Bear Blog를 영감 삼아 더 많은 기능을 갖춘 블로그를 직접 구축하기로 결심했다. 정적 웹사이트에 CDN 캐싱과 이미지 최적화만으로도 충분하다고 판단해 Cloudflare를 도입했으며, 특히 Cloudflare의 Image Transformations 무료 티어(5,000개)를 활용했다. 전체 요약 9문장 읽기 → 056 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 057 15:11 ▲ 37 · 댓글 2 음성·영상 추론 AI의 환각 현상, 증거 우선순위 재조정으로 해결 멀티모달 추론이 가능한 최신 대형언어모델(OLLM)이 음성과 영상을 함께 처리할 때 교차모달 환각이 발생하는 문제가 있다. AI · 머신러닝 · Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs
Key Point 음성과 영상을 동시에 처리하는 멀티모달 AI 모델의 성능 문제를 추론 단계에서 해결하는 새로운 방법이 다양한 모델에서 검증되었기 때문이다.
핵심 요약
멀티모달 추론이 가능한 최신 대형언어모델(OLLM)이 음성과 영상을 함께 처리할 때 교차모달 환각이 발생하는 문제가 있다. 기존 방법들은 출력 단계에서만 처리하며 융합 표현 내의 근거 증거와 학습된 사전지식의 얽힘을 간과했다. Omni-Woodpecker(OWP)라는 훈련 불필요 프레임워크는 교차모달 충돌을 식별한 후 숨겨진 상태에서 증거와 경쟁하는 사전지식을 분리한다. 전체 요약 7문장 읽기 → 058 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 059 12:11 ▲ 15 · 댓글 3 자율 연구 에이전트의 연구 무결성 위반을 감지하는 RIDAR 프레임워크 자율 연구 에이전트가 과학 연구를 자동화하는 데 쓰이지만 연구 무결성 위반(RIV)에 취약해, RIDAR라는 감지 및 개입 프레임워크를 제시했다. AI · 머신러닝 · RIDAR: Safeguarding Research Integrity in Autonomous Research Agents via Automated Detection and Runtime Intervention
Key Point 자율 에이전트가 과학 연구를 수행할 때 데이터 조작, 재현성 문제 등 무결성 위반이 대부분의 경우(99.7%)에서 발생하고 있으며, 이를 실시간으로 감지해 36.8% 줄일 수 있는 방법을 제시했기 때문이다.
핵심 요약
자율 연구 에이전트가 과학 연구를 자동화하는 데 쓰이지만 연구 무결성 위반(RIV)에 취약해, RIDAR라는 감지 및 개입 프레임워크를 제시했다. 먼저 연구 전체 주기에 걸친 14가지 RIV 유형을 포괄하는 RIVT 분류 체계를 개발했다. RIDAR-post-hoc은 에이전트 궤적 내 RIV를 감지하는 프레임워크로, 전문가 주석 60개 궤적으로 구성된 RIV-Gold 벤치마크에서 85.2% F1 성능을 달성했다. 전체 요약 6문장 읽기 → 060 12:11 ▲ 13 · 댓글 3 AI가 손으로 조립하는 레고, 물리 타당성 100% 달성 코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. AI · 머신러닝 · BrickWright: Agentic Creation of Physically Feasible Brick Builds
Key Point AI가 생성한 3D 구조의 '실제 조립 가능성'을 검증하는 새로운 접근법이 100% 성공률을 달성했으며, 로봇 공학·제조업·디지털 설계 도구의 신뢰성 표준을 높인다.
핵심 요약
코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. BrickWright는 조립 도구와 물리 타당성 검증 기능을 제공해 AI가 텍스트나 이미지 지시에서 실제 조립 가능한 레고 구조를 생성하도록 안내하는 프레임워크다. BrickLayer라는 Python 툴킷이 핵심이며, 두 부분으로 구성된다: 사용하기 쉬운 레고 조립 API(원본 LDraw 형식 대비 추론 비용 절반)와 물리 타당성 피드백을 주는 검증기다. 전체 요약 5문장 읽기 → 061 21:11 ▲ 23 · 댓글 2 확산 모델의 단계별·작업별 양자화로 정확도 6.7%p 향상 확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. AI · 머신러닝 · Different Tasks, Different Timesteps: Temporal Task-Aware Quantization for Diffusion Language Models
Key Point 확산 모델의 양자화 시 노이즈 제거 과정의 어느 단계에서 어느 정도의 정밀도가 필요한지를 체계적으로 파악할 수 있게 되어, 모델 압축 효율과 정확도 사이의 균형을 개선할 수 있다.
핵심 요약
확산 언어 모델(DLM)은 반복 노이즈 제거 과정의 특성상 기존 모델과 다른 양자화 도전 과제를 갖는다. 연구팀은 양자화 민감도가 작업과 타이밍 두 가지에 의존하며, 각 작업마다 노이즈 제거 단계별로 필요한 정밀도가 다름을 밝혔다. 이러한 패턴은 정답 레이블이나 작업별 평가 지표 없이도 예측 가능함을 보였다. 전체 요약 5문장 읽기 → 062 18:11 ▲ 126 · 댓글 31 OBS Studio 33 출시, 브라우저 소스와 플러그인 체계 개편 OBS Studio 33.0.0이 출시되었으며, CEF(Chromium Embedded Framework)를 127/6533에서 150/7871로 대폭 업데이트해 브라우저 소스와 도크의 기반 프레임워크를 2024년 7월에서 2026년 9월 수준으로 개선했다. 오픈소스 · 도구 · OBS Studio 33
Key Point 브라우저 소스 기반 프레임워크의 대규모 업데이트와 플러그인 체계 개편으로 인해, OBS를 사용하는 스트리머·콘텐츠 크리에이터와 플러그인 개발자는 호환성 변화에 주의해야 한다.
핵심 요약
OBS Studio 33.0.0이 출시되었으며, CEF(Chromium Embedded Framework)를 127/6533에서 150/7871로 대폭 업데이트해 브라우저 소스와 도크의 기반 프레임워크를 2024년 7월에서 2026년 9월 수준으로 개선했다. 플러그인 로딩 체계를 완전히 개편했으며, 1차 플러그인은 'core' 폴더로 이동하고 3차 플러그인은 새로운 설치 위치와 폴더 구조를 적용했으나, 기존 3차 플러그인은 OBS Studio 34.0까지 기존 위치에서 로드된다. 프리뷰에서 소스 스냅 동작을 개선하여 시각적 지표를 추가했고, 소스가 전체 축을 따라 스냅되며 숨겨진 소스로의 스냅은 비활성화했다. 전체 요약 13문장 읽기 → 063 12:10 ▲ 10 · 댓글 1 확산 언어 모델로 리서치 속도 6배 가속화 심화된 리서치 시스템은 계획, 증거 수집, 종합, 수정을 반복하는데 종단간 지연이 상용 활용에 큰 병목이다. AI · 머신러닝 · DiffResearch: Accelerating Deep Research with Diffusion Language Models
Key Point 자동 회귀 모델 기반의 현재 리서치 시스템이 느린 이유를 근본적으로 해결하는 대안 기술을 제시하며, 실제로 6배 속도 개선과 품질 유지를 동시에 달성했기 때문이다.
핵심 요약
심화된 리서치 시스템은 계획, 증거 수집, 종합, 수정을 반복하는데 종단간 지연이 상용 활용에 큰 병목이다. 기존 대부분의 프로덕션 시스템은 자동 회귀(AR) 언어 모델에 기반하며 좌에서 우로의 디코딩 방식을 사용한다. DiffResearch는 확산 언어 모델(dLLM)을 모든 단계의 핵심에 놓는 오픈 멀티 에이전트 리서치 프레임워크다. 전체 요약 9문장 읽기 → 064 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 065 00:11 ▲ 143 · 댓글 50 과학이 간과한 연구 방향을 찾는 AI 방법론 과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. AI · 머신러닝 · The alien space of science: Coherent but cognitively unavailable directions
Key Point 기존 AI는 널리 알려진 아이디어 조합만 반복하는데, 이 연구는 과학적으로 타당하지만 아무도 시도하지 않은 연구 방향을 발견하는 방법을 제안한다.
핵심 요약
과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. 기존 언어모델들은 논문 문헌의 고밀도 영역에서만 아이디어를 조합하므로, 여러 분야의 개념과 방법을 함께 활용할 가능성 있는 방향들을 놓친다. 연구팀은 논문을 개념 단위로 분해한 뒤 '아이디어 원자(idea atoms)'라는 어휘로 군집화하고, 이들의 조합이 학문적으로 타당한지 평가하는 일관성 모델과 기존 연구자 커뮤니티가 그 방향을 제시할 가능성을 평가하는 가용성 모델을 구축했다. 전체 요약 7문장 읽기 → 066 21:11 ▲ 37 · 댓글 2 로봇 정책 학습의 미래 프레임 예측 성능 개선 World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. AI · 머신러닝 · Self-Distilling Future Video Representations for World Action Models
Key Point 미래 프레임 표현을 한 단계로 정확히 예측하는 기술이 로봇의 장기 작업 수행과 인간 시연 영상 학습 성능을 크게 높이기 때문에, 로봇 학습의 실용화를 앞당기는 중요한 진전이다.
핵심 요약
World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. 이 설계에서 액션 예측이 미래 표현의 품질에 직접 영향을 받기 때문에, 노이즈로부터 단일 단계로 미래 표현 품질을 높이는 것이 중요하다. 논문은 FRED(Future REpresentation learning via self-Distillation with temporal context) 프레임워크를 제시한다. 전체 요약 9문장 읽기 → 067 18:11 ▲ 24 · 댓글 2 LLM 라우팅의 실행 방식까지 함께 학습하는 RouteWeaver LLM 라우팅은 여러 언어 모델을 동적으로 선택해 다양한 작업을 수행하지만, 기존 방식들은 단일라운드·다중라운드·에이전트 방식 등 고정된 실행 패러다임에 얽혀 있어 쿼리의 다양한 요구에 적응하기 어렵다. AI · 머신러닝 · RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing
Key Point 여러 LLM을 효율적으로 활용하려는 개발자들에게 실행 방식까지 동적으로 선택하는 새로운 라우팅 프레임워크가 어떻게 작동하는지 알려준다.
핵심 요약
LLM 라우팅은 여러 언어 모델을 동적으로 선택해 다양한 작업을 수행하지만, 기존 방식들은 단일라운드·다중라운드·에이전트 방식 등 고정된 실행 패러다임에 얽혀 있어 쿼리의 다양한 요구에 적응하기 어렵다. RouteWeaver는 이러한 라우팅 방식들을 하나의 LLM 정책으로 통합하며, 어떤 방식을 쓸지와 그 방식 내에서 어느 모델을 선택할지를 함께 학습한다. COMET-GRPO(COordinated Mode-Execution Training) 학습 알고리즘은 궤적 단위의 이득값을 방식 선택과 방식 내 실행의 별도 신호로 분해해 각 결정 단계에 더 정확한 학습 신호를 전달한다. 전체 요약 6문장 읽기 → 068 18:11 ▲ 23 · 댓글 2 3D 씬 복원 속도·메모리 획기적으로 개선한 RLSplat Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. AI · 머신러닝 · RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
Key Point 모바일이나 엣지 디바이스 같은 자원 제약 환경에서 3D 씬 복원의 실용성을 획기적으로 높이는 기술로, 기존 방식의 비효율성(고정적 오버헤드)을 근본적으로 해결했다.
핵심 요약
Feed-forward 3D Gaussian Splatting(FF3DGS)은 이미지로부터 3D 씬을 한 번의 forward pass로 복원하는 기술로, 제한된 자원 하에서 동작해야 하는 애플리케이션에 적합하다. 기존 예산 제어 FF3DGS 방식들은 추론 단계의 비용을 고려하지 않았는데, 목표한 개수의 가우시안 표현을 만들기 위해 먼저 밀집한 가우시안을 예측한 후 제거하거나 선택하기 때문에 예산과 무관하게 거의 일정한 지연 시간과 피크 메모리를 소비한다. 새로운 RLSplat 방식은 자원 선형 예산 제어 FF3DGS 프레임워크로, 가우시안 예산이 감소함에 따라 표현 크기, 추론 지연 시간, 피크 메모리가 모두 선형적으로 감소한다. 전체 요약 7문장 읽기 → 069 18:11 ▲ 38 · 댓글 2 세밀한 시각 이해를 위해 생성 모델의 정보 활용 세밀한 시각 이해(Fine-grained visual understanding)는 미묘한 차이와 공간 관계를 구별해야 하는데, 현존 비전-언어 모델들에겐 여전히 어렵다. AI · 머신러닝 · What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models
Key Point 멀티모달 모델에서 생성 능력이 이해 성능까지 높일 수 있다는 새로운 접근법을 보여주며, 공간 관계 같은 세밀한 차이 구별이 중요한 시각 작업에서 실질적 개선을 입증했다.
핵심 요약
세밀한 시각 이해(Fine-grained visual understanding)는 미묘한 차이와 공간 관계를 구별해야 하는데, 현존 비전-언어 모델들에겐 여전히 어렵다. 통합 멀티모달 모델(UMM)에서 생성 경로는 이해 경로를 보완하는 풍부한 시각 정보를 보존하지만, 기존 방식들은 생성 측 표현을 직접 활용하지 않았다. 연구팀은 생성 측 표현이 세밀한 의미 변화에 더 민감하고, 이해 측에서 놓치는 작업 관련 변화를 포착하며, 공간 구조에 올바르게 의존한다는 것을 발견했다. 전체 요약 6문장 읽기 → 070 12:11 ▲ 14 · 댓글 4 RL 논문은 쏟아지는데 프레임워크 적용은 1.5% 강화학습 훈련 방법은 오픈소스 프레임워크에 포함되면 사용자가 한 번의 설정 변경으로 바로 써볼 수 있다. AI · 머신러닝 · From RL Papers to Framework Code: Inclusion and Review in Seven Open-Source Training Frameworks
Key Point RL 분야의 논문 성과와 실제 활용 사이의 거대한 괴리를 정량적으로 측정한 연구로, 어떤 방법이 프레임워크에 채택되는지를 결정하는 요인을 파악할 수 있다.
핵심 요약
강화학습 훈련 방법은 오픈소스 프레임워크에 포함되면 사용자가 한 번의 설정 변경으로 바로 써볼 수 있다. 연구진이 7개 오픈소스 RL 훈련 프레임워크의 커밋 이력을 추적하고 2025년 1월부터 2026년 6월까지 arXiv에 게재된 6,939개 논문과 연결했다. 이 중 범용 RL 훈련 방법을 제안한 논문은 1,598개였으나, 적어도 하나의 프레임워크에 포함된 것은 37개(2.3%)에 불과했다. 전체 요약 10문장 읽기 → 071 12:11 ▲ 33 · 댓글 2 코드 기반 영상생성 벤치마크 '코드2비디오-컴패스' 공개 코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. AI · 머신러닝 · Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
Key Point 코드 기반 영상생성이 사용성과 제어성 측면에서 주목받는 가운데, 다양한 입력과 창작 시나리오를 아우르는 첫 종합 벤치마크가 나왔으며 현재 MLLM들의 한계를 명확히 보여준다.
핵심 요약
코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. 기존 코드 기반 벤치마크는 특정 작업에만 집중해 다양한 창작물과 입력 방식의 완전한 영상 생성 평가가 부족했다. Code2Video-Compass는 텍스트-영상(T2V), 이미지-영상(I2V), 영상-영상(V2V) 세 형식을 아우르는 범용 벤치마크로 10개 카테고리, 24개 세부 유형의 2,104개 과제를 포함한다. 전체 요약 7문장 읽기 → 072 09:11 당일 +101 FastAPI: Python으로 빠르고 쉽게 API 만드는 프레임워크 Python 타입 힌트를 기반으로 고성능 API를 구축하는 모던 웹 프레임워크로, Node.js, Go 수준의 빠른 성능을 제공한다. 웹 · 프론트엔드 · fastapi/fastapi · Python
Key Point Python API 개발자들이 고성능과 생산성을 동시에 달성할 수 있는 표준 프레임워크로, 타입 기반 검증과 자동 문서화로 개발 속도와 코드 품질을 모두 높일 수 있습니다.
핵심 요약
Python 타입 힌트를 기반으로 고성능 API를 구축하는 모던 웹 프레임워크로, Node.js, Go 수준의 빠른 성능을 제공한다. Starlette(웹)과 Pydantic(데이터 검증)을 기반으로 하며, 기능 개발 속도는 기존 대비 200~300% 향상되고 인적 오류는 약 40% 감소한다. 타입 선언만으로 요청 데이터 검증, 자동 형변환, 에디터 자동완성, 깊은 JSON 객체 검증까지 가능하다. 전체 요약 12문장 읽기 → 073 03:11 ▲ 26 · 댓글 1 LLM이 정량 트레이딩 전략을 실제로 만들 수 있을까 정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. AI · 머신러닝 · Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
Key Point 현재 최고 수준의 LLM들도 실제 시장 데이터에서 시계열 검증을 통과하는 거래 전략을 만들지 못하는 것으로 나타났으며, 이는 생성형 AI의 금융 적용 한계를 보여준다.
핵심 요약
정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. Quant-Arena은 중국 A주 실제 시장 데이터로 LLM이 전체 루프를 완성하고 연구 기간 이후에도 작동하는 전략을 만들 수 있는지 측정하는 벤치마크와 공개 리더보드다. 모델은 특성과 주식 스코어링 코드를 구성하고, 2022~2023년 데이터로만 피드백을 받은 뒤, 폐쇄된 2024년 데이터로 평가받을 하나의 전략을 확정한다. 전체 요약 7문장 읽기 → 074 03:11 ▲ 126 · 댓글 46 안드로이드 폰에서 iOS 16.5 전체 시스템 부팅 HackiOS는 안드로이드 폰의 하드웨어 위에서 iOS 16.5의 미수정 사용자 영역을 실행하는 오픈소스 XNU 커널(xnu-8796.121.2) 포팅 프로젝트다. 하드웨어 · 시스템 · Show HN: Run full iOS 16.5 firmware on Android Devices
Key Point 안드로이드 하드웨어에서 Apple의 XNU 커널과 완전한 iOS 사용자 영역을 실행하는 것이 가능함을 보여주는 포팅으로, 폐쇄된 생태계와 오픈소스의 경계를 넘나드는 기술적 성과다.
핵심 요약
HackiOS는 안드로이드 폰의 하드웨어 위에서 iOS 16.5의 미수정 사용자 영역을 실행하는 오픈소스 XNU 커널(xnu-8796.121.2) 포팅 프로젝트다. 독자 EFI 로더, Apple의 폐쇄 드라이버 대체물, UEFI 포트, Linux Wi-Fi 드라이버의 호환성 레이어로 가능하게 했다. POCO X5 Pro 5G(Snapdragon 778G)와 QEMU(aarch64) 두 환경에서 실행되며, 안드로이드로 부팅할 때 아무것도 플래시되지 않는다. 전체 요약 13문장 읽기 → 075 00:11 ▲ 17 · 댓글 2 공간 추론 AI, 경험 학습으로 성능 향상 공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. AI · 머신러닝 · SpatialBrain: Spatial Intelligence Growing from Experience
Key Point 시각-언어 모델의 구조를 바꾸지 않으면서도 공간 추론 작업의 경험을 메모리에 저장해 성능을 높이는 새로운 방식으로, AI의 추론 능력 확장 방향을 보여준다.
핵심 요약
공간 추론은 기하학적 도구 접근만으로는 부족하며, 직접 관찰이 충분한 때와 재구성·측정·좌표 변환이 필요한 때를 판단해야 한다. SpatialBrain은 비전-언어 모델의 기본 구조는 유지하면서 공간 추론 경험을 축적하는 프레임워크다. 3DFusionMemory가 현재 장면의 관찰을 융합해 쿼리 가능한 공간 관계로 변환하고, Spatial Skill Library는 재사용 가능한 도구 절차를 제공한다. 전체 요약 7문장 읽기 → 076 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 077 21:11 ▲ 50 · 댓글 1 RAG 파이프라인 최적화는 부품 조합 방식이 핵심 RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. AI · 머신러닝 · Retrieval Augmented Generation Compositionality
Key Point RAG 시스템을 구축할 때 각 기법을 따로 최적화하는 현재 관행이 실제 성능 향상으로 이어지지 않으며, 전체 구성 방식과 코퍼스 규모를 함께 고려해야 한다는 점을 실증한 연구다.
핵심 요약
RAG(검색 증강 생성)는 임베딩, 청킹, 검색, 재순위, 쿼리 증강, 컨텍스트 압축, 에이전트 검증 등 여러 기법을 조합하지만 보통 각 기법을 따로 평가해왔다. 개방형 프레임워크 LASAGNA를 활용해 8개 벤치마크와 5K~200K 문서 규모 코퍼스에서 450개 구성을 테스트했다. 개별적으로 강한 검색 기법 3개는 +47% 성능 향상을 예측했으나, 함께 사용하면 +17%만 달성해 조합 시 성능 이득이 감소했다. 전체 요약 6문장 읽기 → 078 18:11 ▲ 17 · 댓글 2 학생 모델이 생성한 질문을 자동으로 최적화해 증류 학습 개선 온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. AI · 머신러닝 · Ask to Distill: Learning to Synthesize Data for On-Policy Distillation
Key Point 학생 모델이 생성한 합성 데이터만으로도 실제 데이터와 같은 수준의 증류 학습 효과를 얻을 수 있으며, 정답이나 보상 없이도 질문 품질을 자동 최적화하는 방법을 제시해 데이터 수집 비용을 크게 줄일 수 있다.
핵심 요약
온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. 새로 생성한 질문이 증류 학습에 가치 있는지 평가하되, 정답에 접근하지 않고도 더 나은 질문을 자동 생성하는 'Ask-to-Distill' 프레임워크를 제시. 학생 모델 기반의 합성 엔진을 학생과 교사의 불일치도, 교사 확률 질량, 길이·다양성 제어를 결합한 분포적 대리 지표로 최적화. 전체 요약 7문장 읽기 → 079 15:11 ▲ 22 · 댓글 2 멀티모달 에이전트, 로봇 제어로 확장할 때 뭐가 달라지나 멀티모달 에이전트(MMA)는 컴퓨터 조작 작업을 추론·기억·도구·피드백으로 수행하고, 로봇 시스템은 물리 역학 아래 센싱과 동작을 결합한다. AI · 머신러닝 · Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use
Key Point 컴퓨터 조작 AI와 로봇 제어의 근본적 차이를 정의하고, 로봇 에이전트 개발 시 현재 벤치마크가 놓친 부분을 지적해 향후 평가 방식 개선의 방향을 제시한다.
핵심 요약
멀티모달 에이전트(MMA)는 컴퓨터 조작 작업을 추론·기억·도구·피드백으로 수행하고, 로봇 시스템은 물리 역학 아래 센싱과 동작을 결합한다. 멀티모달 임보디드 에이전트(MMEA)를 정의하면, 멀티모달 작업 추론을 물리 동작과 결합하고 그 결과 피드백으로 결정을 수정하는 목표 지향 시스템이다. 논문은 PAPAV라는 통합 프레임워크를 제시하며, 인식(Perceive)·예측(Anticipate)·계획(Plan)·행동(Act)·검증(Verify)의 5가지 반복 기능으로 세 시스템을 비교한다. 전체 요약 6문장 읽기 → 080 12:11 ▲ 42 · 댓글 2 로봇 플래너도 포스트트레이닝으로 강화된다 로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. AI · 머신러닝 · AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
Key Point 작은 오픈소스 로봇 모델도 정교한 포스트트레이닝으로 폐쇄형 거대모델 수준의 성능을 낼 수 있다는 점이 로봇 개발자와 AI 연구자들에게 실질적인 의미를 갖는다.
핵심 요약
로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. 기존 로봇 제어 시스템은 강력한 폐쇄형 모델(GPT 같은)에 의존했지만, 모델 자체를 개선하지는 않았다. 코딩 에이전트 분야에서 포스트트레이닝이 성공한 점에 착안해 로봇 플래너에도 같은 접근을 시도했다. 전체 요약 8문장 읽기 → 081 12:11 ▲ 36 · 댓글 2 AI 에이전트의 지속 학습을 위한 메모리 중심 프레임워크 기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. AI · 머신러닝 · Memory-Centric Continual Learning for AI Agents
Key Point AI 에이전트가 장기 배포 중 경험으로부터 실제 학습하려면 메모리 평가 기준부터 바뀌어야 한다는 근본적인 전환을 제시한다.
핵심 요약
기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. 외부 메모리 시스템은 대부분 수동적 검색 캐시 역할만 하며 저장된 사실이나 과거 상호작용 회상 여부만 평가되고 있다. 메모리가 진정한 지속 학습을 가능하게 하는지는 미해결 과제다. 전체 요약 8문장 읽기 → 082 12:11 ▲ 17 · 댓글 8 AI 에이전트 학습, 사용자·환경과 함께 진화시키다 LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. AI · 머신러닝 · EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents
Key Point 훈련 시스템 전체를 적응형으로 진화시키는 방식이 다중 턴 강화학습 성능을 대폭 향상시키는 것으로 나타났으며, 이는 에이전트 개발의 기존 접근 방식을 바꿀 수 있는 경험적 증거를 제시한다.
핵심 요약
LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. 기존 접근법은 보상 재설계나 감독 강화로 이를 해결했지만, 사용자 시뮬레이터와 환경을 고정된 것으로 취급했다. EAU는 메타 에이전트 프레임워크로, 훈련 중 궤적·도구 추적·보상·통계를 모니터링하며 실패와 무정보 상호작용을 진단한다. 전체 요약 7문장 읽기 → 083 09:11 ▲ 111 · 댓글 116 Drupal의 평판 격차 좁히기, 개발자와 AI에 맞춘 혁신 Drupal 창립자 드리스가 DrupalCon Rotterdam 2026에서 발표한 주요 내용으로, Drupal이 혁신하고 있지만 평판이 현실에 미치지 못하는 '평판 격차'를 줄이는 것이 가장 큰 과제라고 지적했다. 웹 · 프론트엔드 · Drupal is now light-years ahead of its reputation
Key Point 실제 기능과 평판 사이의 격차를 메우기 위해 Drupal이 시도하는 구체적 전략(기술 혁신과 커뮤니티 애드보커시)과 AI 통합의 핵심 변화를 보여준다.
핵심 요약
Drupal 창립자 드리스가 DrupalCon Rotterdam 2026에서 발표한 주요 내용으로, Drupal이 혁신하고 있지만 평판이 현실에 미치지 못하는 '평판 격차'를 줄이는 것이 가장 큰 과제라고 지적했다. 2년 전 시작한 Drupal Starshot 프로젝트는 Drupal CMS로 발전했으며, Site Templates, Recipes, Drupal AI, Drupal Canvas 등을 통합해 웹사이트 구축을 단순화했다. Drupal Canvas에 다국어 지원을 추가했으며, React 기반 컴포넌트로 JavaScript 개발자들이 학습 곡선 없이 Drupal 개발에 참여할 수 있도록 설계했다. 전체 요약 11문장 읽기 → 084 06:11 새 버전 FastAPI 0.158.2, 선택적 폼 모델 지원 추가 FastAPI 0.158.2가 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.158.2
Key Point FastAPI 사용자들이 폼 검증 로직을 더 유연하게 작성할 수 있게 되었다.
핵심 요약
FastAPI 0.158.2가 릴리스되었다. 이번 버전에서는 선택적 폼 모델(optional form models) 지원이 추가되었다. 이 기능은 폼 데이터를 처리할 때 일부 필드를 선택적으로 만들 수 있게 해준다. 085 06:11 ▲ 12 · 댓글 2 확률 오차 줄이는 AI 에이전트 프레임워크 RiseHarness 장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. AI · 머신러닝 · Harness Self-Evolution for Long-Horizon Terminal Agents
Key Point 모델 가중치를 고정하고 실행 로직만 개선해 AI 에이전트의 신뢰성을 높이는 새로운 접근법으로, 확률적 오류로 인한 작업 실패 문제를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. RiseHarness는 모델 가중치를 고정한 채로 에이전트 하네스(harness)를 반복 개선하는 프레임워크로, 같은 설정에서 성공과 실패를 오가는 작업에 초점을 맞춘다. 런타임 모니터에서 수집한 내부 하네스 추적과 에이전트 궤적을 결합해 모델 액션이 명령 실행, 피드백, 컨텍스트 관리, 완료 결정과 어떻게 상호작용하는지 검토한다. 전체 요약 9문장 읽기 → 086 00:11 새 버전 Laravel 12.70.1, 보안 취약점 수정 Laravel 프레임워크 12.70.1이 릴리스되었다. 웹 · 프론트엔드 · laravel/framework@v12.70.1
Key Point Laravel 애플리케이션의 보안 취약점을 해결한 패치이므로, 운영 중인 시스템은 신속한 업그레이드가 필요할 수 있다.
핵심 요약
Laravel 프레임워크 12.70.1이 릴리스되었다. 이번 업데이트는 문자열 이스케이핑 우회를 통한 보안 취약점을 방지하는 패치를 포함한다. valorin이 제출한 #62027 PR을 통해 이스케이핑 보호를 우회할 수 있는 문제를 수정했다. 087 00:11 ▲ 13 · 댓글 2 에지 기기용 LLM 커널 생성 벤치마크 공개 LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. AI · 머신러닝 · EdgeKernelBench: Unified LLM-Driven Kernel Generation for Edge Backends
Key Point 에지 디바이스 배포는 서버와 달리 하드웨어가 다양하고 제약이 크기 때문에, LLM으로 생성한 커널을 실제로 잘 동작하게 하려면 새로운 평가 방식과 최적화 전략이 필요하다는 점이 중요하다.
핵심 요약
LLM이 서버 GPU용 커널을 생성하는 것은 이미 연구되었으나, 하드웨어가 이질적이고 소프트웨어 스택이 단편화된 에지 배포 환경에서 다양한 백엔드를 대상으로 한 커널 생성은 체계적으로 연구되지 않았다. EdgeKernelBench는 통합 IR 배포 프레임워크와 에지 워크로드용 계층적 벤치마크를 결합하여, 재사용 가능한 계산·스케줄링·메모리 결정을 통합 IR로 캡처하고 컴파일러 인터페이스를 통해 각 백엔드에 연결한다. 벤치마크는 개별 연산자부터 컴팩트 모델 그래프까지 점진적으로 확대된 프로그램 범위를 포함하며, 대표적인 에지 애플리케이션 도메인을 아우른다. 전체 요약 6문장 읽기 → 088 15:11 ▲ 115 · 댓글 3 작은 모델도 큰 모델 따라잡는다, '뇌-몸' 맞춤 진화 자동으로 개선되는 AI 에이전트(RSI)에서는 모델의 역량과 실행 환경(harness)이 함께 진화할 때 불일치 문제가 발생한다. AI · 머신러닝 · CoEvo-RSI: When Harnesses Evolve, Which Models Should Follow?
Key Point 작은 모델이 큰 모델을 이기는 핵심이 '역량과 실행 환경의 정렬'이라는 새로운 관점을 제시하며, 자원 제약이 있는 팀도 효율적인 에이전트를 만들 수 있는 길을 열어준다.
핵심 요약
자동으로 개선되는 AI 에이전트(RSI)에서는 모델의 역량과 실행 환경(harness)이 함께 진화할 때 불일치 문제가 발생한다. 진화 중인 harness가 모델이 학습하지 못한 행동을 요구하거나 기존 능력을 제한하는 '뇌-몸 불일치'를 해결하기 위해 CoEvo-RSI 프레임워크를 제시했다. 메타 에이전트가 과거 설계 아카이브에서 harness를 선택하고, 최적의 모델 체크포인트를 선택하거나 병합한 후 그에 맞춰 적응시킨다. 전체 요약 6문장 읽기 → 089 12:11 ▲ 18 · 댓글 2 동영상 얼굴 바꾸기를 실시간으로, StreamingSwap 프레임워크 비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. AI · 머신러닝 · From Short Clips to Real-Time Streams: Identity-Aware Supervision and Context-Efficient Generation for Video Face Swapping
Key Point 얼굴 교체 기술을 실시간 장시간 스트림까지 확장한 기술적 혁신으로, 고화질 정체성 전이를 저사양 하드웨어에서 구현했다.
핵심 요약
비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. 기존 플로우 매칭 방식은 얼굴만 바뀌는 변화에 약하고, 장시간 스트림에서 정체성 전이·고화질·실시간 생성을 동시에 달성하기 어렵다. Joint Rec-ID Loss를 개발해 노이즈 레벨에 따라 명시적 정체성 감독과 잠재 재구성을 균형있게 한다. 전체 요약 8문장 읽기 → 090 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 091 09:11 ▲ 13 · 댓글 2 형식검증으로 강화한 LLM 에이전트 학습, Lean4AgenticRL LLM의 에이전트 능력을 강화하기 위해 복잡한 소프트웨어 엔지니어링과 터미널 작업 문제를 풀어야 하는 상황에서, 기존 모델들은 고수준의 결과 보상에만 의존해 학습 효율이 낮았다. AI · 머신러닝 · Lean4AgenticRL: Advancing Agentic RL with Verifiable Multi-level Process Rewards
Key Point 기존 LLM 에이전트 학습에서 다단계 보상 검증을 도입해 실제 성능 향상을 입증한 사례로, 형식 검증이 강화학습 효과성을 높일 수 있음을 보여준다.
핵심 요약
LLM의 에이전트 능력을 강화하기 위해 복잡한 소프트웨어 엔지니어링과 터미널 작업 문제를 풀어야 하는 상황에서, 기존 모델들은 고수준의 결과 보상에만 의존해 학습 효율이 낮았다. Lean4AgenticRL은 Lean4 형식화 체계에 다단계 프로세스 보상을 통합한 첫 번째 프레임워크로, 에이전트의 능력과 제어성 사이 균형을 맞추는 문제별 워크플로우 시스템을 구축한다. 워크플로우 형식화와 다단계 보상 주석 방식을 통해 일반 하니스 시스템 내에서 에이전트 동작을 검증하며, 저수준 도구 호출 보상과 중수준 워크플로우 단계 보상을 포함한다. 전체 요약 7문장 읽기 → 092 06:11 ▲ 124 · 댓글 49 Rust 컴파일러, 2026년 주요 개선 사항 정리 Rust 컴파일러가 2026년에 여러 장기 프로젝트들의 결실이 동시에 나오는 시기를 맞이했다. 오픈소스 · 도구 · 2026 is an exciting year for the Rust compiler (and me)
Key Point Rust 생태계의 핵심 인프라인 컴파일러가 10년 단위의 장기 프로젝트들을 동시에 완성하며 성능·기능·개발 환경 전반에 걸쳐 근본적인 개선이 일어나는 전환점이기 때문이다.
핵심 요약
Rust 컴파일러가 2026년에 여러 장기 프로젝트들의 결실이 동시에 나오는 시기를 맞이했다. 차세대 트레이트 솔버는 타입 시스템의 대규모 재구현으로 약 10년간 진행되었으며, 타입 시스템의 근본적인 기술 부채를 해결하고 async Rust와 impl Trait의 제약을 풀어준다. Polonius는 새로운 보로우 체커 구현으로 더 많은 코드가 컴파일되도록 하고 내부 참조 등 관련 기능들을 언블록한다. 전체 요약 13문장 읽기 → 093 03:11 ▲ 10 · 댓글 2 메모리의 가치를 배우다: 자원 제약 속 에이전트 최적화 지속적으로 학습하는 에이전트는 배포 후 경험을 축적해 개선하지만, 실제로는 생성, 상호작용, 메모리 예산이 매우 제한적이다. AI · 머신러닝 · Remembering Has a Price: Learning Memory Worth under Resource Constraints
Key Point 토큰 수 제약이 있는 LLM 에이전트에서 메모리 관리의 비용-편익을 최적화하는 새로운 접근법으로, API 호출 비용을 줄이면서 성능을 개선하는 실제 경로를 보여준다.
핵심 요약
지속적으로 학습하는 에이전트는 배포 후 경험을 축적해 개선하지만, 실제로는 생성, 상호작용, 메모리 예산이 매우 제한적이다. 이러한 강한 자원 제약 하에서 기존 평생 학습 메모리 방식들이 비효과적이 되며, 정교한 접근법도 단순 검색이나 메모리 없는 에이전트보다 나은 성과를 내지 못한다. 문제의 핵심은 단순히 관련 경험을 검색하는 것이 아니라 실제로 보존하고 재사용할 가치가 있는 경험을 판단하는 것이다. 전체 요약 7문장 읽기 → 094 00:11 ▲ 34 · 댓글 3 장기 작업 완료 위한 'Interlock' 프레임워크 제시 LLM 에이전트가 장기 작업을 수행할 때 개별 요구사항은 충족하지만 이들 간의 관계를 유지하지 못해 부분적으로만 완성되는 문제가 있다. AI · 머신러닝 · Interlock: From Local Correctness to Task Completion in Long-Horizon Agents
Key Point 복잡한 장기 작업에서 부분적 완성이 아닌 전체 완성을 추구하는 새로운 에이전트 학습 방식이 제시되었으며, 여러 벤치마크에서 측정 가능한 성능 개선을 입증했다.
핵심 요약
LLM 에이전트가 장기 작업을 수행할 때 개별 요구사항은 충족하지만 이들 간의 관계를 유지하지 못해 부분적으로만 완성되는 문제가 있다. Interlock은 작업을 타입 지정된 완성 그래프로 표현하는 프레임워크로, 그래프는 증거-결정 연결(grounding edge), 컴포넌트 간 결합 제약(coupling hyperedge), 결정-효과 연결(realization edge)로 구성된다. 이 그래프를 리셋 가능한 작업공간, 공개 요청서, 평가 기준으로 컴파일하며, 출처 검증과 공개 입력 검증을 통해 요구사항과 평가 기준의 정합성을 확인한다. 전체 요약 6문장 읽기 → 095 00:11 ▲ 11 · 댓글 2 산업용 로봇 조작 평가 벤치마크 'LIBERO-Industry' 공개 LIBERO 벤치마크를 기반으로 제조업의 실제 제약 조건을 반영한 새로운 로봇 평가 프레임워크 LIBERO-Industry를 개발했다. 하드웨어 · 시스템 · LIBERO-Industry: Benchmarking Robotic Manipulation under Industrial Process Constraints
Key Point 실제 제조 환경의 복잡한 제약을 반영한 평가 지표가 없어 범용 로봇 정책의 산업 적용 가능성을 정확히 측정할 수 없었는데, 이제 체계적인 벤치마크로 검증할 수 있게 됐다.
핵심 요약
LIBERO 벤치마크를 기반으로 제조업의 실제 제약 조건을 반영한 새로운 로봇 평가 프레임워크 LIBERO-Industry를 개발했다. 유연 제조(고혼합·소량 생산) 환경에서 로봇이 대응해야 하는 제품 변종, 이동 재료 흐름, 제한된 작업 시간, 기하학적 공차 같은 산업용 제약을 반영했다. 3가지 작업 시나리오(정적→동적 로딩, 동적→정적 언로딩, 동적→동적 전달)로 구성되며 총 216개 태스크를 포함한다. 전체 요약 7문장 읽기 → 096 00:11 ▲ 12 · 댓글 2 다양한 장면에 강한 자율 학습 깊이 추정 기법 MaSS 자율 학습으로 단안 깊이 추정을 수행하려면 라벨 없는 대규모 데이터를 활용할 수 있지만, 기존 방법들은 다양한 장면의 혼합 데이터로 학습할 때 성능이 떨어진다. AI · 머신러닝 · Learning to Discriminate Scene Structures Makes Self-Supervised Depth Learning Scalable
Key Point 자율 학습 깊이 추정이 다양한 현실 데이터에서 제대로 작동하려면, 도메인별 편향을 넘어 일반화된 구조 학습이 필수적이기 때문이다.
핵심 요약
자율 학습으로 단안 깊이 추정을 수행하려면 라벨 없는 대규모 데이터를 활용할 수 있지만, 기존 방법들은 다양한 장면의 혼합 데이터로 학습할 때 성능이 떨어진다. 연구진은 자율 학습 상황에서 모델이 전이 가능한 기하학 대신 데이터셋별 구조적 편향을 학습하면서 도메인 간 최적화 충돌이 발생하는 문제를 발견했다. 이를 해결하기 위해 MaSS 프레임워크를 제안하며, 맥락 특징과 명시적으로 분리된 전용 구조 표현 경로를 도입한다. 전체 요약 7문장 읽기 → 097 00:11 ▲ 10 · 댓글 2 음성-영상 일관성을 평가하는 'AVC-Reward' 모델 제시 음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. AI · 머신러닝 · AVC-Reward: Event-Centric Audio-Video Consistency Evaluation
Key Point 음성-영상 생성 모델의 평가 방식이 모델 성능 향상 속도를 따라가지 못하고 있는 가운데, 복잡한 멀티모달 콘텐츠를 정확히 평가할 수 있는 새로운 지표가 제시된 점이 중요합니다.
핵심 요약
음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. 논문은 이벤트 단위로 음성과 영상 이벤트를 분리하고 각각을 독립 분석하며 모달리티 간 관계를 교차검증한 뒤, 결과를 3단계 일관성 지표로 집계하는 이벤트 중심 평가 프레임워크를 제안한다. 이 지표는 전체 서사 조화도, 이벤트 단위 시간 동기화, 세부 속성 정렬을 평가한다. 전체 요약 6문장 읽기 → 098 16:56 ▲ 26 · 댓글 2 만화를 영상으로 충실히 변환하는 AI 에이전트 시스템 만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. AI · 머신러닝 · Manga2Animate: An Agentic Framework for Faithful Manga Animation with Script and Storyboard Planning
Key Point 만화의 스토리, 캐릭터, 미술 스타일을 모두 보존하면서 자동으로 애니메이션화하는 기술로, 만화 산업에 실질적으로 적용할 수 있는 접근 방식을 제시한다.
핵심 요약
만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. 기존 방식은 만화를 텍스트로만 해석해 캐릭터와 미술 스타일을 잃거나, 페이지를 직접 영상생성 모델에 넣어 구성을 오해하고 잘못된 스토리를 만드는 문제가 있었다. 이 프레임워크는 생성 과정의 모든 단계를 원본 만화에 근거하며, 작업을 두 가지 중간 단계인 애니메이션 스크립트와 시각적 스토리보드로 분해한다. 전체 요약 6문장 읽기 → 099 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 100 21:11 새 버전 Laravel 13.38.0 출시, 데이터베이스·캐시·배포 안정성 개선 Laravel 프레임워크 13.38.0이 릴리스되었으며, 총 27개의 버그 수정 및 기능 개선이 포함되었다. 웹 · 프론트엔드 · laravel/framework@v13.38.0
Key Point Laravel 프로젝트의 데이터베이스 관계, 검증, 작업 스케줄링 등 핵심 기능에서 숨은 버그를 일괄 수정했으므로 프로덕션 안정성을 높이려는 개발자라면 업그레이드를 검토해야 한다.
핵심 요약
Laravel 프레임워크 13.38.0이 릴리스되었으며, 총 27개의 버그 수정 및 기능 개선이 포함되었다. Unique 검증 규칙에서 실수값(float)을 지원하도록 확대하고, 모드() 함수가 실수를 자르는 문제를 수정했다. 관계형 쿼리의 ofMany() 별칭 클로저 내 동작 문제, 자참조 관계의 존재 및 집계 쿼리 버그를 해결했다. 전체 요약 8문장 읽기 →