쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 11월 17일 (화)까지4750건
5건 · "전이학습"조건 지우기 ×
001▲ 55 · 댓글 2로봇 학습을 인간 영상으로 확대하는 'ThinkWorld' 프레임워크로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다.AI · 머신러닝 · ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning

Key Point라벨 없는 인간 영상을 로봇 학습에 직접 활용하는 방법이 제시되어, VLA 모델의 훈련 데이터 병목을 푸는 새로운 경로를 제공한다.
핵심 요약
- 로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다.
- 인간 영상은 행동 기록이 없어서 로봇 학습에 직접 활용하기 어렵다는 문제가 있다.
- ThinkWorld는 행동을 Chain-of-Dynamics(CoD)로 표현하여 세계 역학과 연결한다.
전체 요약 8문장 읽기 →AI · 머신러닝 · ACCRUE: Continual Off-Policy Reinforcement Learning for Robot Foundation Models

Key Point로봇이 새로운 작업을 배우면서 기존 능력을 유지해야 한다는 실제 배포 문제를 오프폴리시 RL로 해결했으며, 31~68% 훈련 시간 단축으로 실용성을 입증했습니다.
핵심 요약
- 로봇 기초모델(RFM)의 강화학습 미세조정은 데모 이상의 성능을 낼 수 있지만, 실제 배포에는 새 작업을 효율적으로 학습하면서 기존 능력을 잃지 않아야 한다.
- 기존 지속학습 RL 방식은 온폴리시 업데이트로 잊음 현상을 줄이지만 전이학습이 제한적이고, 오프폴리시 방식은 단일 작업 샘플 효율은 높이지만 작업 간 지속성 문제를 해결하지 못한다.
- ACCRUE는 경량 액터-크리틱 네트워크를 작업 간에 보존하는 오프폴리시 RL 프레임워크로, 각 단계가 이전 RL에서 습득한 행동과 가치 지식을 재사용한다.
전체 요약 6문장 읽기 →AI · 머신러닝 · EVOKE: Eliciting World Knowledge in Agents for Transferable Decision-Making

Key PointLLM 에이전트가 새로운 환경에 적응하지 못하는 근본 원인을 진단하고, 추가 훈련 없이 기존 지식을 활용하는 훈련 기법을 제안하는 것이 개발자들의 실제 배포 문제를 해결하기 때문입니다.
핵심 요약
- LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다.
- 기존 세계 모델 학습 방식은 미래 관찰을 예측하도록 훈련하지만 추가 학습 비용이 들고 예측 오류가 누적된다.
- 디지털 환경에서 작동하는 LLM 에이전트는 사전 훈련 과정에서 이미 상당한 세계 지식을 내재화하고 있어, 새로 습득하기보다 끌어내는 것이 핵심이다.
전체 요약 9문장 읽기 →AI · 머신러닝 · Language models for text classification: From bag-of-words to Jev
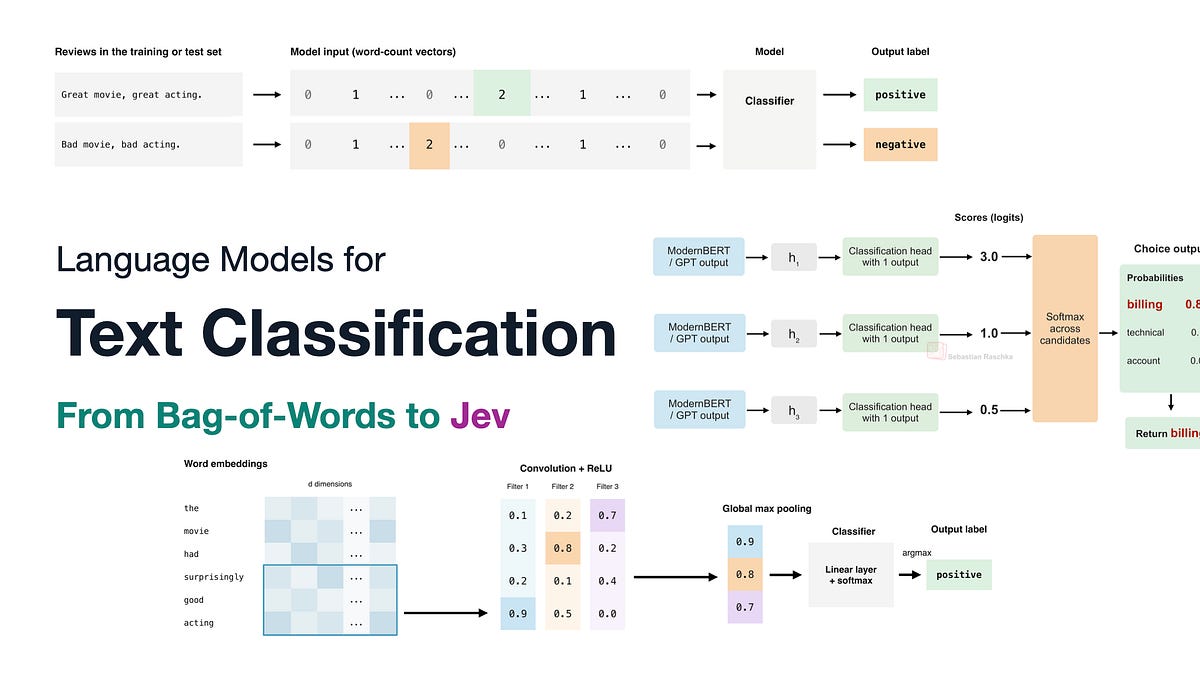
Key Point15년 전 Bag-of-Words로 시작된 텍스트 분류 기술이 어떻게 현재의 범용 분류 모델 Jev로 진화했는지, 각 방식의 트레이드오프를 이해하면 분류 작업에 적절한 도구를 선택할 수 있다.
핵심 요약
- 텍스트 분류 기술의 역사를 Bag-of-Words부터 최근 Jev AI까지 추적하는 기술 가이드로, 각 방식의 작동 원리와 성능을 비교한다.
- Bag-of-Words는 다양한 길이의 텍스트를 고정 크기 벡터로 변환해 Naive Bayes·로지스틱 회귀·SVM 등 고전 분류기를 적용할 수 있게 한다. 계산이 저렴하고 결과가 좋지만 단어 순서 정보를 잃는 단점이 있다.
- RNN은 단어를 순차적으로 처리하며 이전 단계의 숨겨진 상태를 누적하므로 단어 순서가 중요해진다. LSTM·GRU 같은 개선 방식이 있으며, ULMFiT 방식으로 전이학습을 적용하면 IMDb 영화평 분류에서 95.4% 정확도를 달성했다.
전체 요약 11문장 읽기 →AI · 머신러닝 · OmniTaskonomy: When Does Visual Generation Improve Visual Understanding?

Key Point어떤 생성 과제가 어떤 이해 능력을 향상시키는지 체계적으로 규명하면, 멀티모달 모델 학습의 효율성을 크게 높일 수 있기 때문입니다.
핵심 요약
- 이미지 생성(I2I) 작업으로 학습하면 기하학, 공간 관계, 객체 인식 능력 같은 풍부한 지각 능력을 얻을 수 있지만, 시각 이해 능력 향상에 어떻게 도움이 되는지는 명확하지 않았다.
- 연구진은 같은 문제를 다양한 출력 형태로 표현하는 이미지-이미지(I2I) 생성 과제와 이미지-텍스트(I2T) 이해 과제의 짝을 만들어 비교했다.
- 올바른 학습 방식으로 I2I 학습을 진행하면 I2T 성능이 향상되며, I2I 학습 데이터가 많을수록 개선 폭이 크다.
전체 요약 8문장 읽기 →