쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
6건 · "소프트웨어공학"조건 지우기 ×
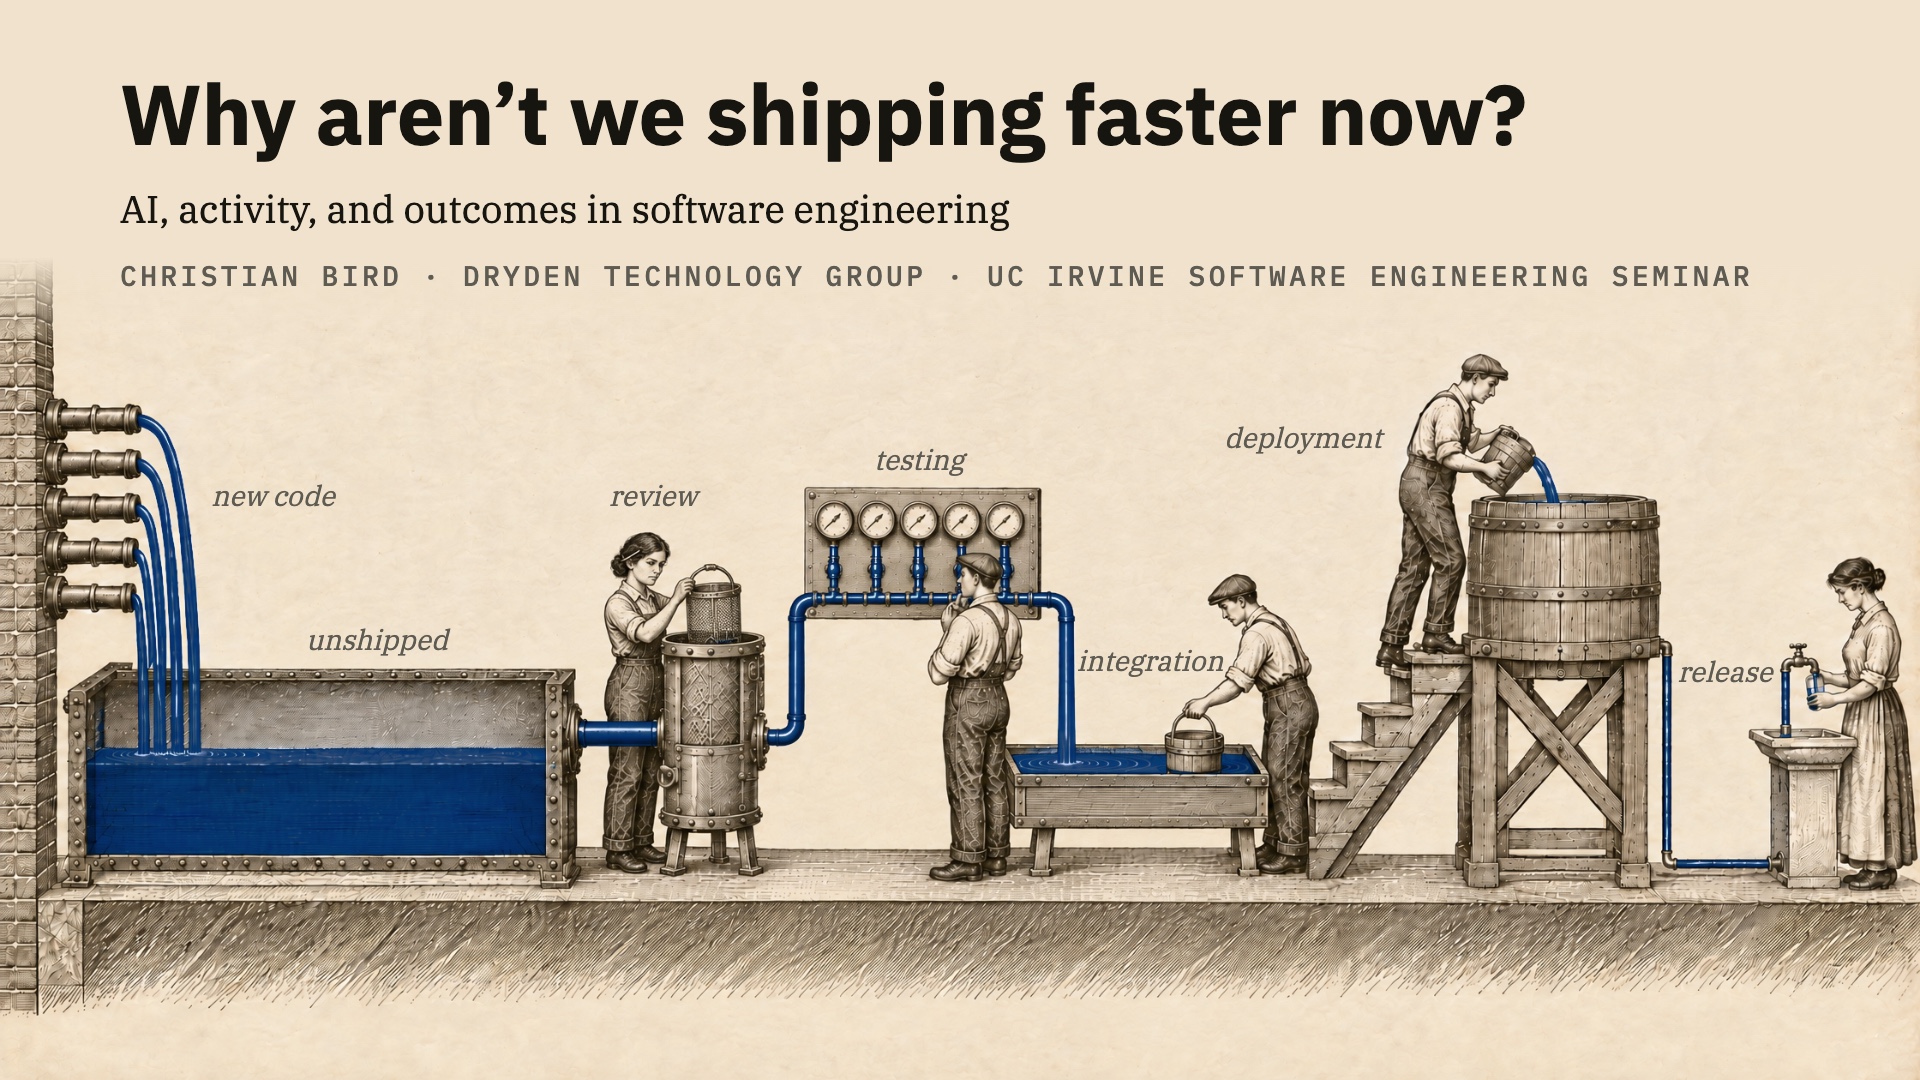
001 09:11 ▲ 103 · 댓글 99 AI 시대에 소프트웨어 개발 속도가 빨라지지 않는 이유 UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. AI · 머신러닝 · AI, activity, and outcomes in software engineering
Key Point AI 코딩 도구의 급증에도 실제 배포 속도가 개선되지 않는 이유를 학술 근거와 함께 설명하는 연구로, 개발 생산성에 대한 통념을 점검하는 데 중요하다.
핵심 요약
UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. 강연은 슬라이드, 핸드아웃(19페이지), 풀 덱(41페이지), 유튜브 영상과 함께 제공된다. 관련 연구 논문으로 '활동-결과 격차: 왜 AI가 소프트웨어 엔지니어링을 해결하지 못하는가'(제출 중)가 있으며, 30명의 인터뷰 내용이 포함되어 있다. 전체 요약 5문장 읽기 → 002 15:11 ▲ 206 · 댓글 2 코딩 에이전트는 요구사항을 제대로 충족할까? 소프트웨어 개발이 AI 코딩 에이전트에 위임되면서, 요구사항을 정확히 구현하는지 검증하는 벤치마크의 필요성이 제기됐다. AI · 머신러닝 · AgentSWE: Can Coding Agents Build the Agent You Actually Want?
Key Point 코딩 에이전트가 프로덕션 소프트웨어를 직접 구축하기 시작한 만큼, 요구사항을 정확히 충족하는지 검증하는 벤치마크 부재가 실제 문제였기 때문이다.
핵심 요약
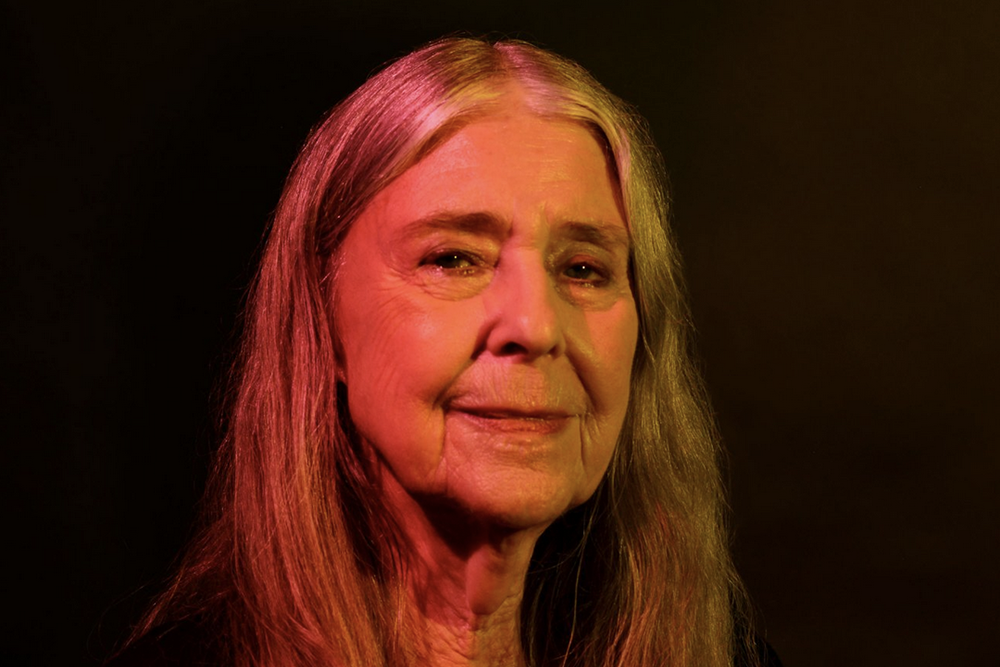
소프트웨어 개발이 AI 코딩 에이전트에 위임되면서, 요구사항을 정확히 구현하는지 검증하는 벤치마크의 필요성이 제기됐다. AgentSWE 벤치마크는 에이전트 개발의 세 단계를 평가한다: 자연어 요구사항으로부터 완전한 에이전트 작성, 기존 에이전트 코드 수정, 측정 가능한 목표로의 최적화. 각 25개 작업은 시험이 아닌 '의뢰' 형태로, 빌더가 제시된 사례로 반복 개선하면 평가자가 감춰진 사례로 검증한다. 전체 요약 8문장 읽기 → 003 18:25 ▲ 1,461 · 댓글 161 아폴로 달착륙을 이끈 소프트웨어 공학자 마거릿 해밀턴 별세 MIT에서 20년 이상 근무한 컴퓨터 과학자 마거릿 해밀턴이 9월 30일 90세로 별세했다. 기타 · Margaret Hamilton has died
Key Point 아폴로 달착륙을 가능하게 한 소프트웨어 엔지니어링의 개척자이자 현대 개발 관행의 기초를 마련한 인물의 업적과 삶을 정리한 추모 기사로, IT 역사에서의 그녀의 역할을 재조명한다.
핵심 요약
MIT에서 20년 이상 근무한 컴퓨터 과학자 마거릿 해밀턴이 9월 30일 90세로 별세했다. 해밀턴은 NASA 아폴로 프로그램의 온보드 비행 소프트웨어 개발팀을 이끌었으며, 130편 이상의 논문을 저술해 소프트웨어 엔지니어링을 독립적 학문으로 정립하는 데 기여했다. 1959년 MIT 기상부서에서 날씨 예측 소프트웨어로 경력을 시작했으며, 1961년 미국 최초 방어 시스템인 SAGE 프로젝트에 참여해 소프트웨어 신뢰성에 관심을 갖기 시작했다. 전체 요약 10문장 읽기 → 004 06:11 ▲ 160 · 댓글 46 Reflection, 501B 파라미터 오픈소스 모델 'Beam' 공개 Reflection이 오픈가중치 희소 혼합전문가(MoE) 모델인 Beam을 발표했다. 총 501억 개 파라미터 중 23억 개만 활성화되며, 코딩·추론·에이전트 작업에 최적화됐다. AI · 머신러닝 · Beam: Reflection's 501B open-weight model
Key Point 고효율 오픈소스 에이전트 모델이 공개되며, 특히 추론 효율에서 훨씬 큰 모델과 경쟁할 수 있다는 점이 엔터프라이즈 코딩 워크로드에 미치는 영향이 크다.
핵심 요약
Reflection이 오픈가중치 희소 혼합전문가(MoE) 모델인 Beam을 발표했다. 총 501억 개 파라미터 중 23억 개만 활성화되며, 코딩·추론·에이전트 작업에 최적화됐다. Beam은 웹과 라이선스 데이터셋의 23.8조 개 토큰으로 사전학습되었으며, 10.5K NVIDIA GB300 GPU에서 4주간 RL을 실행해 1억 개 이상의 롤아웃을 생성했다. 코딩·에이전트 작업에서 GLM 5.2와 경쟁력 있는 성능을 보이며, Qwen 3.8-Max에 근접한다. 특히 추론 효율에서 우위가 있어 GLM 5.2 대비 3~4배 적은 계산량으로 유사한 추론 능력을 제공한다. 전체 요약 12문장 읽기 → 005 00:11 ▲ 120 · 댓글 106 AI가 코딩을 완전히 해결했다는 주장은 착각이다 LLM이 코드 작성에 능하다는 주장은 소프트웨어 개발의 본질을 오해한 것이다. 코드 생성 비용이 낮아졌지만, 실제 비용의 대부분은 유지보수, 신뢰성, 보안, 확장성 같은 비기능 요구사항에서 나온다. AI · 머신러닝 · Coding Is Not Solved
Key Point AI 기반 개발로 인해 대규모 레이오프를 단행한 기업들이 품질 저하와 책임 회피의 딜레마에 직면한 가운데, 전문가가 제시하는 LLM의 근본적 한계와 산업별 필요성의 차이를 정리한 글이다.
핵심 요약
LLM이 코드 작성에 능하다는 주장은 소프트웨어 개발의 본질을 오해한 것이다. 코드 생성 비용이 낮아졌지만, 실제 비용의 대부분은 유지보수, 신뢰성, 보안, 확장성 같은 비기능 요구사항에서 나온다. 의료, 금융, 자동차, 방위, 발전소, 항공 등 실수의 대가가 큰 산업에서는 낮은 위험 허용도가 필요하며, 이런 분야에서는 책임감 있는 엔지니어가 필수다. AI는 책임을 질 수 없다. AI는 결과에 따른 처벌, 감옥, 벌금을 받지 않으므로 진정한 책임성을 가질 수 없고, 제어 불가능한 것에는 책임을 질 수 없다는 원칙이 핵심이다. 전체 요약 11문장 읽기 → 006 03:11 ▲ 152 · 댓글 46 소프트웨어의 '그냥 안 되는' 일상화 저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. AI · 머신러닝 · The Normalization of Inexplicable Failures
Key Point AI 기반 기능이 배포되면서 '원인을 알 수 없는 장애'가 정상적인 것으로 받아들여지는 추세를 다루는데, 이는 개발 생산성과 품질 사이의 근본적인 긴장을 보여줍니다.
핵심 요약
저자는 문제의 원인을 추적할 수 없는 오류가 정상화되는 현상을 우려하고 있다. Jev 같은 AI 모델들은 빠르고 저렴하지만, 사용자는 반환값이 정말 작동하는지 검증할 평가 프레임워크(evals)를 구축해야 한다. 대부분의 개발자는 기술적 평가를 미루고 'AI 기반' 표시만 하고 배포한 뒤, 장애 발생 시 '음, AI는 실수한다'고 넘어간다. 전체 요약 9문장 읽기 →