001 18:11 ▲ 60 · 댓글 2 이산 토큰, 연속 표현 수준의 시각 정보 담을 수 있을까 이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. AI · 머신러닝 · Can Discrete Tokens Serve as Semantically Lossless Representations of Visual Signals?
Key Point 이산 토큰 기반 시각 표현이 그동안 한계로 간주해온 의미 손실 문제를 실질적으로 극복했으며, 멀티모달 기초 모델의 구조 선택에 영향을 미칠 가능성이 있다.
핵심 요약
이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. 기존 가정과 달리, 양자화 오류 크기와 의미 손실 사이에는 신뢰성 있는 상관관계가 없으며, 오류가 크더라도 더 나은 이해 성능을 낼 수 있다. 이산 토큰의 실질적인 비트 예산이 다운스트림 성능의 주요 결정 요소로 나타났으며, 기존 양자화기는 코드북이 증가할수록 의미 정보 기여도가 감소해 포화 현상이 발생한다. 전체 요약 8문장 읽기 → 002 12:11 ▲ 29 · 댓글 2 0.8B 모델 OvisOCR3, 문서 인식부터 표 재구성까지 한 번에 문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. AI · 머신러닝 · OvisOCR3 Technical Report
Key Point 작은 0.8B 모델로 5개 OCR 작업을 한 번에 처리하며 전문가 모델들을 능가하는 방법론이 효율적인 문서 자동화를 필요로 하는 기업 시스템에 직접 활용될 가능성이 높다.
핵심 요약
문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. 실제 및 합성 데이터로 사전 학습한 뒤, 서로 다른 데이터량과 응답 길이를 가진 작업 간 감독을 균형 잡기 위해 도메인 균형 중간 학습을 적용했다. 5개의 도메인별 4B 교사 모델에서 지식을 전이하는 다중 교사 정책상 증류(multi-teacher on-policy distillation)를 거친 뒤, 도메인별 보상을 사용한 혼합 작업 강화 학습을 수행했다. 전체 요약 8문장 읽기 → 003 09:11 ▲ 118 · 댓글 38 코드를 "강하게" 만드는 철학적 디버거 출시 Nietzschian Debugger는 버그를 수정해주는 대신 질문으로 근본 원인을 찾도록 유도하는 CLI 도구다. 기타 · Nietzschian Debugger
Key Point AI가 답을 주는 시대에 오히려 질문으로 개발자를 단련하는 역발상의 도구가 나왔으며, 디버깅 스킬 추적과 코드 읽기 기능으로 실용성을 갖췄다.
핵심 요약
Nietzschian Debugger는 버그를 수정해주는 대신 질문으로 근본 원인을 찾도록 유도하는 CLI 도구다. ChatGPT처럼 답을 제시하지 않고, 개발자의 가정에 의문을 제기하고 피하고 있는 증거를 직면하게 한다. socrates(온화함), nietzsche(직설적), zarathustra(가혹함) 3단계 강도를 지원하며, 사용자 수준과 선호도에 맞춰 선택할 수 있다. 전체 요약 7문장 읽기 → 005 18:11 ▲ 126 · 댓글 29 완전 로컬 처리 PDF 도구 PaperPilot 공개 Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. AI · 머신러닝 · PaperPilot – Zero-Cloud, Pure-Rust PDF Engine with WASM and MCP
Key Point AI 에이전트에 PDF 처리 기능을 안전하게 통합할 수 있는 방법이 생겼고, 클라우드 전송 없이 로컬에서만 동작해 데이터 프라이버시를 보장한다.
핵심 요약
Rust로 작성된 PDF 및 문서 도구 PaperPilot이 오픈소스로 공개되었다. 클라우드 없이 순수 로컬에서 동작하며 파일이 머신을 떠나지 않는다. Claude Desktop, Cursor 등 MCP 클라이언트에 플러그인으로 제공되어 AI 에이전트가 PDF 병합, 분할, OCR, 압축을 수행할 수 있다. CLI, 브라우저(WASM), Tauri 기반 데스크톱 앱, localhost REST API 등 5가지 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 006 21:11 당일 +110 AI를 위한 PDF 파서, 접근성 자동화까지 지원 OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 오픈소스 · 도구 · opendataloader-project/opendataloader-pdf · Java
Key Point LLM 기반 애플리케이션의 문서 처리 성능을 크게 좌우하는 PDF 파싱 도구이면서 동시에 전 세계 규제 대상이 되고 있는 PDF 접근성 자동화를 오픈소스로 제공하는 점이 의미 있다.
핵심 요약
OpenDataLoader PDF는 PDF를 구조화된 데이터로 변환하는 오픈소스 파서로, RAG/LLM 파이프라인용으로 최적화됐다. 200개 실제 PDF로 벤치마크한 결과 전체 정확도 0.907(표 추출 0.928)로 기존 도구 중 1위이며, 하이브리드 모드에서 복잡한 테이블·수식·차트를 AI로 처리한다. 로컬 모드는 결정적(deterministic) 출력으로 0.015초/페이지 속도, 하이브리드 모드는 0.463초/페이지로 처리하며 Python·Node.js·Java SDK를 제공한다. 전체 요약 8문장 읽기 → 007 18:11 ▲ 243 · 댓글 2 객체부터 픽셀까지, 시각-언어 모델의 정밀 인식 통합 웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. AI · 머신러닝 · WeVisOne-VL: Unified Visual Perception from Objects to Pixels
Key Point 기존 비전-언어 모델들의 가장 큰 약점인 세밀한 시각 인식 신뢰성을 단일 모델로 해결하는 방법을 제시하여, VLM 기반 시스템의 실제 배포 가능성을 높였다.
핵심 요약
웨이신(WeChat) 팀이 WeVisOne-VL이라는 새로운 비전-언어 모델을 공개했으며, 객체 수준과 픽셀 수준의 시각 인식을 구조화된 토큰 예측으로 통합한다. 모델은 물체 탐지, 참조 위치파악, 개수 세기, OCR, 분할, 매팅 등 여러 시각 작업을 지원하며, 점과 상자부터 마스크와 알파 매트까지 사용자가 원하는 수준의 위치 파악을 가능하게 한다. 가벼운 픽셀 디코더를 특수 토큰을 통해 VLM에 통합하여 인스턴스 수준의 픽셀 출력을 생성한다. 전체 요약 6문장 읽기 → 008 15:11 ▲ 24 · 댓글 1 음성 에이전트가 말 듣는 중에 일을 준비한다 음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. AI · 머신러닝 · Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents
Key Point 음성 에이전트의 응답 지연을 줄이는 근본적인 아키텍처 개선으로, 실시간 음성 인터페이스에서 사용 경험을 크게 향상시킬 수 있다.
핵심 요약
음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. 기존 추측적(speculative) 접근은 음성 입력 중에 작업을 시작하지만, 청크 경계나 업데이트 시 중단 방식은 도구 호출의 인자가 완성되기 전에 잘릴 수 있다. 이 논문은 '하트비트 싱킹(Heartbeat Thinking)'을 제안하는데, 이는 음성 업데이트 시마다 새로운 사고 인스턴스를 호출하면서도 진행 중인 작업과 배포된 도구는 계속 실행할 수 있도록 한다. 전체 요약 7문장 읽기 → 009 12:11 ▲ 47 · 댓글 2 LLM 에이전트가 스킬을 배우고 다시 쓰게 하는 대화형 학습법 에이전트 스킬은 LLM 에이전트가 한 세션에서 배운 작업 지식을 다른 작업에 재사용하게 하는 기능이지만, 한 번의 성공으로는 절차의 모든 사용 조건을 검증하기 어렵다. AI · 머신러닝 · Socratic Skill Learning: Interleaving Teaching and Practice for Transferable Agent Skills
Key Point LLM 에이전트가 작업별 스킬을 효과적으로 학습하고 재사용하는 방법이 개발되면서, 생성형 AI의 작업 자동화 능력이 실무 환경으로 한 걸음 더 나아갔다.
핵심 요약
에이전트 스킬은 LLM 에이전트가 한 세션에서 배운 작업 지식을 다른 작업에 재사용하게 하는 기능이지만, 한 번의 성공으로는 절차의 모든 사용 조건을 검증하기 어렵다. Socratic Skill Learning(SSL)은 전문가 교수(Educator)와 학생(Student)을 짝지어, 학생이 환경을 직접 조작하고 제안받은 절차를 스스로 검증·수정하며 스킬을 작성하도록 한다. 연구팀은 35개 작업 계열과 408개 실행 가능한 사례로 구성된 SkillTransferBench를 만들어 스킬 재사용을 평가했다. 전체 요약 8문장 읽기 → 010 18:11 ▲ 13 · 댓글 2 자막·로고 자동 제거하는 AI 모델과 벤치마크 공개 비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. AI · 머신러닝 · DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
Key Point 비디오 편집·정제 작업의 자동화를 가능하게 하는 새로운 방법론과 평가 기준이 제시되었기 때문입니다.
핵심 요약
비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. 기존 방식은 시간 정보 활용이나 조건부 생성을 썼지만 잔여 오버레이를 남기고 장면 구조를 왜곡할 수 있었다. DeOverlay라는 소스 앵커드 플로우 모델을 제안하는데, 소스 잠재 표현에서 고정된 가이던스로 깨끗한 영상을 복원한다. 전체 요약 11문장 읽기 → 011 21:11 당일 +338 자연어로 안드로이드 테스트 자동화를 가능하게 하는 구글 ARTEMIS 구글이 공개한 ARTEMIS는 자연어 지시를 안드로이드 기기의 실제 자동화 작업으로 변환하는 AI 보조 도구이다. AI · 머신러닝 · google/artemis · Python
Key Point AI 코딩 어시스턴트가 실제 안드로이드 기기를 자동으로 제어하고 테스트하는 방식이 크게 바뀔 수 있기 때문이다.
핵심 요약
구글이 공개한 ARTEMIS는 자연어 지시를 안드로이드 기기의 실제 자동화 작업으로 변환하는 AI 보조 도구이다. Antigravity, Codex, Claude Code 등 AI 코딩 어시스턴트와 seamless하게 통합되며, AndroidWorld 벤치마크에서 99% 이상의 성공률을 달성한다. 접근성 계층과 OCR, 시각 모델을 결합하여 캐시, Compose, Flutter 인터페이스 같은 커스텀 UI도 정확히 찾는다. 전체 요약 12문장 읽기 → 012 12:11 ▲ 140 · 댓글 82 E Ink 컬러 전자잉크 '칼레이도 4' 출시 E Ink가 최신 컬러 전자종이 플랫폼 '칼레이도 4'를 공개했으며, 한뭉 기술의 M10C II 스마트 노트가 탑재한 첫 제품이다. 하드웨어 · 시스템 · E Ink Kaleido 4
Key Point 컬러 전자종이 기술이 가독성과 색감 표현을 크게 개선해 전자책 리더를 넘어 업무·교육 도구로 확대되는 구체적인 사양과 성능 개선을 보여준다.
핵심 요약
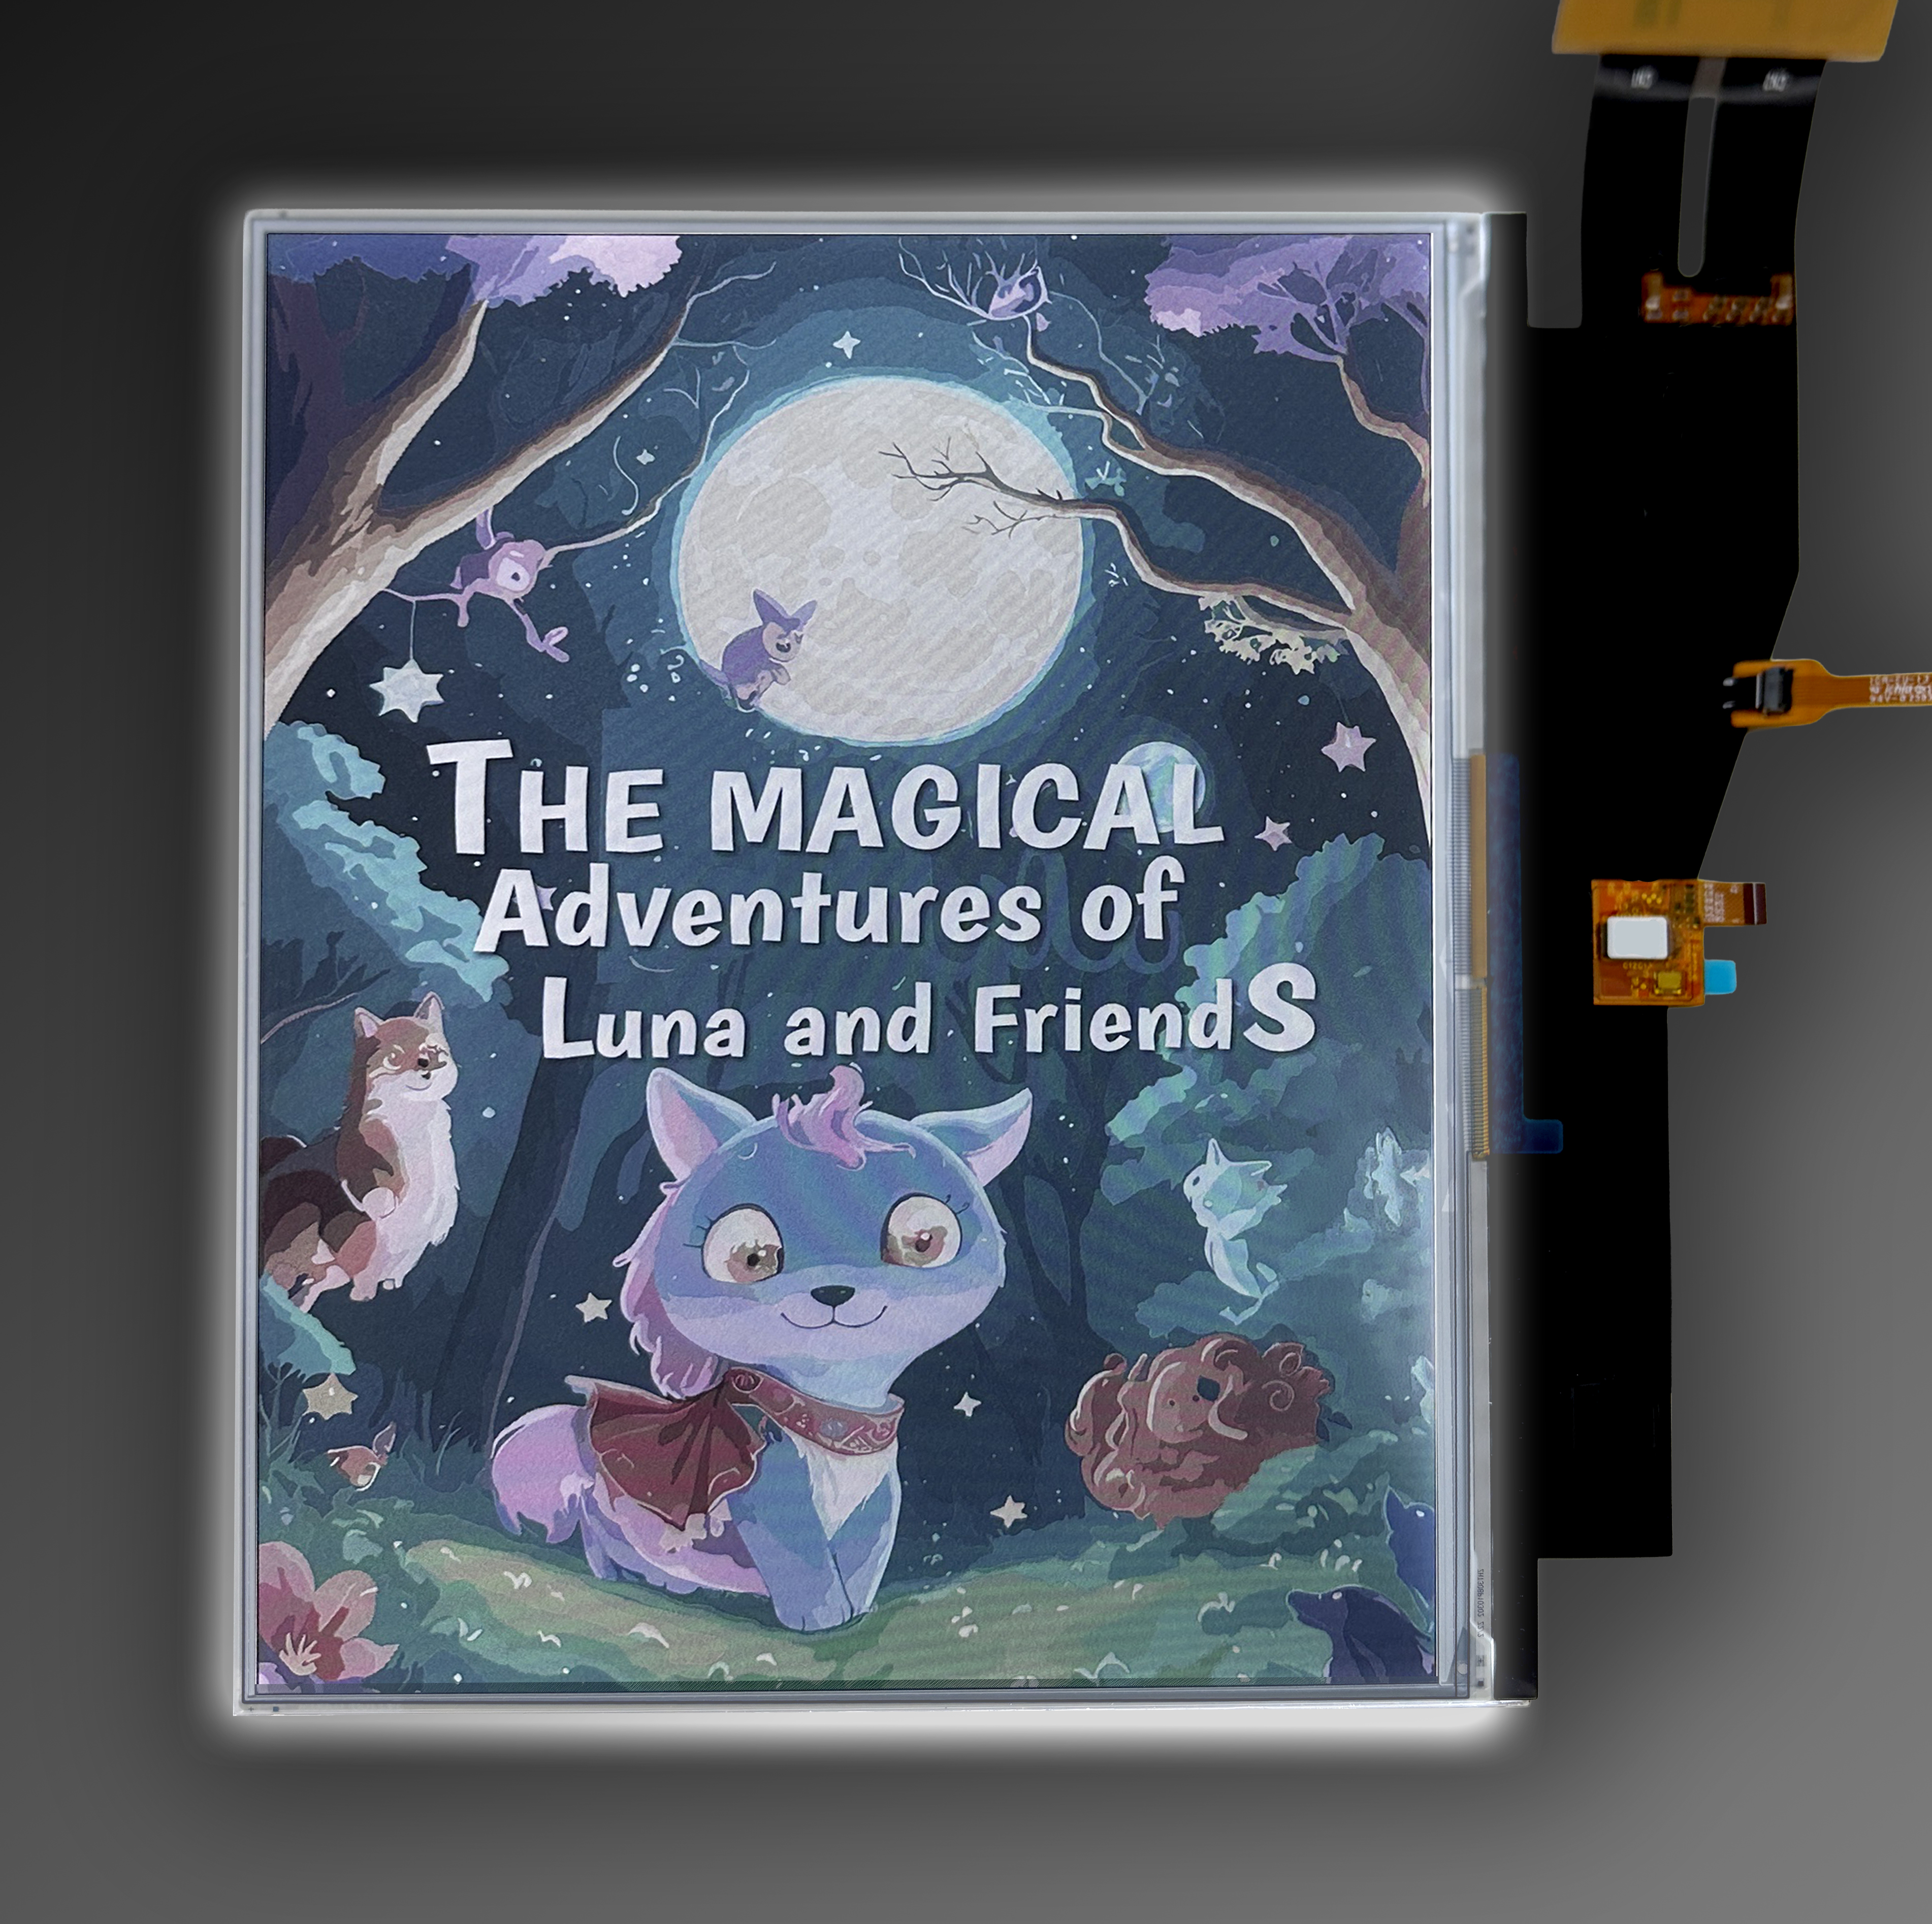
E Ink가 최신 컬러 전자종이 플랫폼 '칼레이도 4'를 공개했으며, 한뭉 기술의 M10C II 스마트 노트가 탑재한 첫 제품이다. 칼레이도 4는 색감 범위를 40K 이상으로 2배 확대하고, 백색 반사율을 15% 높였으며, 명암비를 50% 개선했다. 새로운 알고리즘으로 초당 18프레임(FPS)의 동영상 재생을 지원하며, 텍스트뿐 아니라 이미지·차트·프레젠테이션·동영상을 선명하게 표시할 수 있다. 전체 요약 7문장 읽기 → 014 03:12 ▲ 12 · 댓글 2 AI가 생성한 이미지의 글자 오류, 효율적으로 고쳐낸다 생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. AI · 머신러닝 · Efficient Scene-Text Refinement via Pixel-Space Grouped Image Generation
Key Point AI가 만든 이미지의 텍스트 오류를 효율적으로 고칠 수 있는 방법이 나왔으며, 기존 방식 대비 정확도가 2배 이상 높아서 생성 이미지의 실용성이 크게 개선될 수 있다.
핵심 요약
생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. 기존 VAE 기반 방식은 재구성 과정에서 글자의 세밀한 획을 잃고, 전체 이미지 편집은 배경색을 왜곡하는 한계를 갖는다. PixText는 장면의 텍스트 보정을 픽셀 공간의 그룹화된 이미지 생성으로 정의하며, 원본 이미지를 조건으로 목표 영역만 생성하고 편집되지 않은 부분을 보존한다. 전체 요약 7문장 읽기 → 015 21:11 당일 +100 만화 자동 번역 도구 Koharu, Rust로 완전 로컬 실행 Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 오픈소스 · 도구 · koharu-rs/koharu · Rust
Key Point 완전 로컬 실행 만화 번역 자동화 도구로, 프라이버시 우려 없이 복잡한 시각 처리와 자연어 처리를 통합하는 오픈소스 솔루션을 원하는 사용자에게 선택지가 생겼다.
핵심 요약
Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 객체 검출, OCR, 인페인팅, LLM을 조합해 만화 번역 프로세스를 자동화하며, 래스터 이미지·압축 아카이브·PDF를 모두 지원한다. 텍스트 영역과 말풍선, 정리 영역을 감지·분할하고 대사·캡션·일반 텍스트에 대한 다중모드 OCR을 수행한다. 전체 요약 10문장 읽기 → 016 21:11 당일 +161 에이전트가 휴대폰을 제어하는 Phone Harness Claude Code나 Codex 같은 에이전트가 실제 휴대폰을 원격 제어할 수 있는 오픈소스 도구로, iPhone과 Android를 모두 지원한다. AI · 머신러닝 · ShawnPana/phone-harness · Python
Key Point AI 에이전트가 실제 휴대폰을 제어할 수 있는 실용적인 도구가 나왔으며, jailbreak나 복잡한 설정 없이 iPhone·Android 모두 지원하고 클라우드 폰도 렌트할 수 있어 자동화 테스트와 에이전트 통합의 새로운 가능성을 열고 있다.
핵심 요약
Claude Code나 Codex 같은 에이전트가 실제 휴대폰을 원격 제어할 수 있는 오픈소스 도구로, iPhone과 Android를 모두 지원한다. iPhone은 Mac의 iPhone 미러링 윈도우를 통해, Android는 adb(Android Debug Bridge)로 macOS·Linux·Windows에서 제어 가능하며, 폰에 아무것도 설치할 필요가 없다. 에이전트는 화면을 보고 탭·스와이프·타이핑으로 조작할 수 있으며, Apple의 Vision 프레임워크가 OCR을 수행해 텍스트를 인식한다. 전체 요약 8문장 읽기 → 017 21:11 당일 +247 바이두, 원샷 긴 문서 인식 'Unlimited OCR' 공개 바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. AI · 머신러닝 · baidu/Unlimited-OCR · Python
Key Point 한 번의 입력으로 문서 전체를 처리하는 새로운 OCR 방식이 주목받으면서, 기존 다중 단계 파싱의 한계를 극복하는 기술이 실제로 작동하는 방식을 알 수 있습니다.
핵심 요약
바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. 한 번의 입력으로 긴 텍스트 구간을 파싱하는 'One-shot Long-horizon Parsing' 방식을 도입했다. Hugging Face, ModelScope, Baidu Cloud 등에서 모델과 데모를 제공하고 있다. 전체 요약 7문장 읽기 → 018 15:11 ▲ 261 · 댓글 2 로봇·자율주행용 '공간 인지' 기초 모델 GroundingPI 공개 Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. AI · 머신러닝 · GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
Key Point 로봇 팔과 자율주행 자동차가 정확하고 빠르게 물체를 인식해야 하는데, 기존 범용 시각 모델 대신 공간 좌표 인식에 특화한 기초 모델을 쓰면 성능이 크게 오른다는 실증적 결과를 제시한다.
핵심 요약
Hugging Face와 arXiv의 공동 발표로, GroundingPI라는 40억 개 파라미터 크기의 기초 모델을 소개한다. 이 모델은 점과 박스 형태의 정량화된 좌표를 공유 어휘로 생성해, 혼잡한 환경과 작은 물체의 위치 파악을 빠르게 수행한다. 다중모달·공간 사전학습, 지도학습, GRPO 강화학습을 결합해 학습하며, 공개 데이터셋과 자체 데이터 엔진의 감시 신호를 활용했다. 전체 요약 8문장 읽기 → 019 21:12 당일 +919 로컬·클라우드 AI 모델 한곳에서 관리하는 오픈소스 UI Open WebUI는 Ollama, OpenAI 호환 API 등 다양한 AI 모델을 지원하는 자체 호스팅 AI 플랫폼이며, 완전 오프라인 운영이 가능합니다. AI · 머신러닝 · open-webui/open-webui · Python
Key Point 로컬 모델부터 클라우드 API까지 통합 관리하면서 엔터프라이즈급 보안(LDAP/SSO/SCIM), 팀 협업 기능, RAG, 에이전트 실행 환경을 모두 지원해 온프레미스 AI 플랫폼을 자체 구축하려는 팀에게 필수 선택지입니다.
핵심 요약
Open WebUI는 Ollama, OpenAI 호환 API 등 다양한 AI 모델을 지원하는 자체 호스팅 AI 플랫폼이며, 완전 오프라인 운영이 가능합니다. 플러그인(필터, 액션, 파이프, 도구, 스킬)을 통해 MCP, MCPO, OpenAPI 도구 서버 연결로 맞춤 통합을 구축할 수 있으며, 역할 기반 접근 제어(RBAC)와 사용자 그룹으로 세밀한 권한 관리가 가능합니다. Open Terminal을 통해 AI 에이전트가 터미널과 파일시스템에 접근해 다단계 작업을 실행할 수 있으며, 엔터프라이즈 버전인 Terminals는 사용자별 격리 컨테이너, 리소스 제한, 네트워크 규칙을 제공합니다. 전체 요약 12문장 읽기 → 020 18:12 ▲ 32 · 댓글 2 OCR을 넘어 텍스트 기반 시각 지능으로: PolyOCR 모델 공개 Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. AI · 머신러닝 · PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
Key Point OCR 기술이 단순 텍스트 추출에서 복잡한 문서 이해와 추론으로 확장되는 가운데, 여러 작업을 균형있게 수행하는 통합 모델의 등장은 문서 처리, 정보 추출, 자동화 분야에 실질적인 영향을 미칠 수 있다.
핵심 요약
Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. 기존 OCR 시스템은 특정 작업에만 강하고 인식, 파싱, 추론을 균형있게 수행하지 못하는 한계가 있었다. PolyOCR은 명령 추종 프레임워크와 대규모 데이터 엔진을 결합하여 서로 다른 시각 자원을 검증된 OCR 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 021 15:13 ▲ 47 · 댓글 6 로봇이 시각 데모로 과제를 배우는 ICL 프레임워크 공개 로봇 인콘텍스트 학습(ICL)은 시각 데모로부터 작업을 추론·실행하는 패러다임인데, 시각 데모가 동작 궤적·물체 의미·조작 가능성·공간 관계·작업 목표를 동시에 전달하면서 로봇이 실제로 무엇을 따라야 하는지 불명확한 문제가 있었다. AI · 머신러닝 · In-context Robot Learning Made Simple: A Democratized Recipe for Manipulation Tasks
Key Point 로봇 조작 학습의 실용화를 막던 문제 정의 부재를 해결하고, 대규모 학습 없이도 작동하는 재현 가능한 오픈소스 방식을 제시한 점이 의미있다.
핵심 요약
로봇 인콘텍스트 학습(ICL)은 시각 데모로부터 작업을 추론·실행하는 패러다임인데, 시각 데모가 동작 궤적·물체 의미·조작 가능성·공간 관계·작업 목표를 동시에 전달하면서 로봇이 실제로 무엇을 따라야 하는지 불명확한 문제가 있었다. 연구팀은 로봇 ICL의 명확한 문제 정의를 제시하고 근본적인 프롬프트 모호성을 해결했다. 비전 프롬프트 인코더와 저비용 데이터 수집 프로토콜을 갖춘 미니멀한 프레임워크 SimpleICL을 개발했다. 전체 요약 6문장 읽기 → 022 18:30 ▲ 155 · 댓글 115 전 세계 절반이 소셜미디어가 민주주의 해친다고 본다 피유 리서치센터가 2026년 2월~5월 36개국 4만2151명을 대상으로 조사한 결과, 소셜미디어가 민주주의에 미치는 영향에 대해 국가마다 다른 인식을 보였다. 기타 · Across the Globe, People Increasingly Say Social Media Is Harming Democracy
Key Point 부자 나라에서는 소셜미디어 비판이 심화되는 반면, 전 세계적으로는 정보 접근과 민주 참여의 이점도 크다는 이중적 평가가 정책 입안자들에게 중요한 맥락을 제공한다.
핵심 요약
피유 리서치센터가 2026년 2월~5월 36개국 4만2151명을 대상으로 조사한 결과, 소셜미디어가 민주주의에 미치는 영향에 대해 국가마다 다른 인식을 보였다. 미국을 포함한 선진국에서는 부정적 평가가 높아서, 미국(64%), 독일(61%), 프랑스(65%), 네덜란드(70%)에서 절반 이상이 '나쁜 영향'이라고 답했다. 2022~2023년 대비 독일, 일본, 헝가리, 폴란드, 인도네시아, 네덜란드, 스웨덴 등에서 부정적 견해가 통계적으로 유의미하게 증가했다. 전체 요약 10문장 읽기 → 023 18:33 당일 +118 포토샵 호환 이미지 에디터 포토스위트, Rust로 완성 Rust 기반 데스크톱 이미지 에디터 PhotoSuite는 클래식 Photoshop의 동작 방식을 충실히 재현하면서 PSD/PSB 파일을 네이티브로 지원한다. 오픈소스 · 도구 · eolix/photosuite · Rust
Key Point Photoshop의 작동 방식과 PSD 호환성을 Rust로 재현한 완전한 데스크톱 에디터로, 디자이너가 익숙한 인터페이스와 도구로 PSD 파일을 자유롭게 편집할 수 있는 대안을 제공한다.
핵심 요약
Rust 기반 데스크톱 이미지 에디터 PhotoSuite는 클래식 Photoshop의 동작 방식을 충실히 재현하면서 PSD/PSB 파일을 네이티브로 지원한다. Open-source PhotoCraft 엔진(MIT OR Apache-2.0)을 기반으로 하며, 문서 모델, PSD 읽기·쓰기, 합성 및 명령 시스템이 기초를 이루고 있다. Photoshop-PhotoSuite PSD 양방향 변환을 모두 지원할 목표로 진행 중이며, 모든 효과와 Smart Objects/필터를 포함한다. 전체 요약 13문장 읽기 → 024 06:11 ▲ 121 · 댓글 59 macOS 사진·영상을 AI로 검색하는 로컬 앱 SCM 공개 SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. AI · 머신러닝 · Show HN: AI search for every photo and every frame of video on macOS
Key Point AI 검색이 클라우드 없이 로컬에서만 작동하므로 개인 사진·영상의 프라이버시를 완전히 보호하면서도 의미 기반·음성·텍스트 검색을 한 번에 제공하는 방식이 다르다.
핵심 요약
SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. 자연언어로 기억을 설명하면 CLIP 등 로컬 비전 모델이 검색하고, 영상은 장면 단위로 분할·임베딩되어 정확한 타임코드로 이동할 수 있다. 5가지 검색 모드를 지원한다: 의미 기반 이미지 검색(Files), 영상의 특정 장면 검색(Scenes), 이미지의 OCR 텍스트 검색(OCR), Whisper를 이용한 영상 음성 검색(Dialogue), 추출된 대사·OCR·파일명을 근거로 답변하는 로컬 LLM 챗(Ask). 전체 요약 13문장 읽기 → 025 06:11 ▲ 102 · 댓글 16 비디오게임 역사재단, 잡지 5000권 넘기며 일본어 자료 추가 비디오게임역사재단이 디지털 아카이브에 5000권 이상의 게임 잡지를 등재해 약 60만 페이지(선반 100피트 상당)를 보유하게 됐으며, 1981~2026년 46년간의 게임 역사를 아우른다. 오픈소스 · 도구 · VGHF Digital Archive passes 5000 magazines. Here's what's next
Key Point 게임사 연구를 위한 국제적 아카이브 구축의 진전 상황과 일본어 자료 추가라는 새로운 기술적 도전을 다루고 있어, 게임 역사 연구와 아카이브 기술에 관심 있는 개발자들이 알아야 할 소식입니다.
핵심 요약
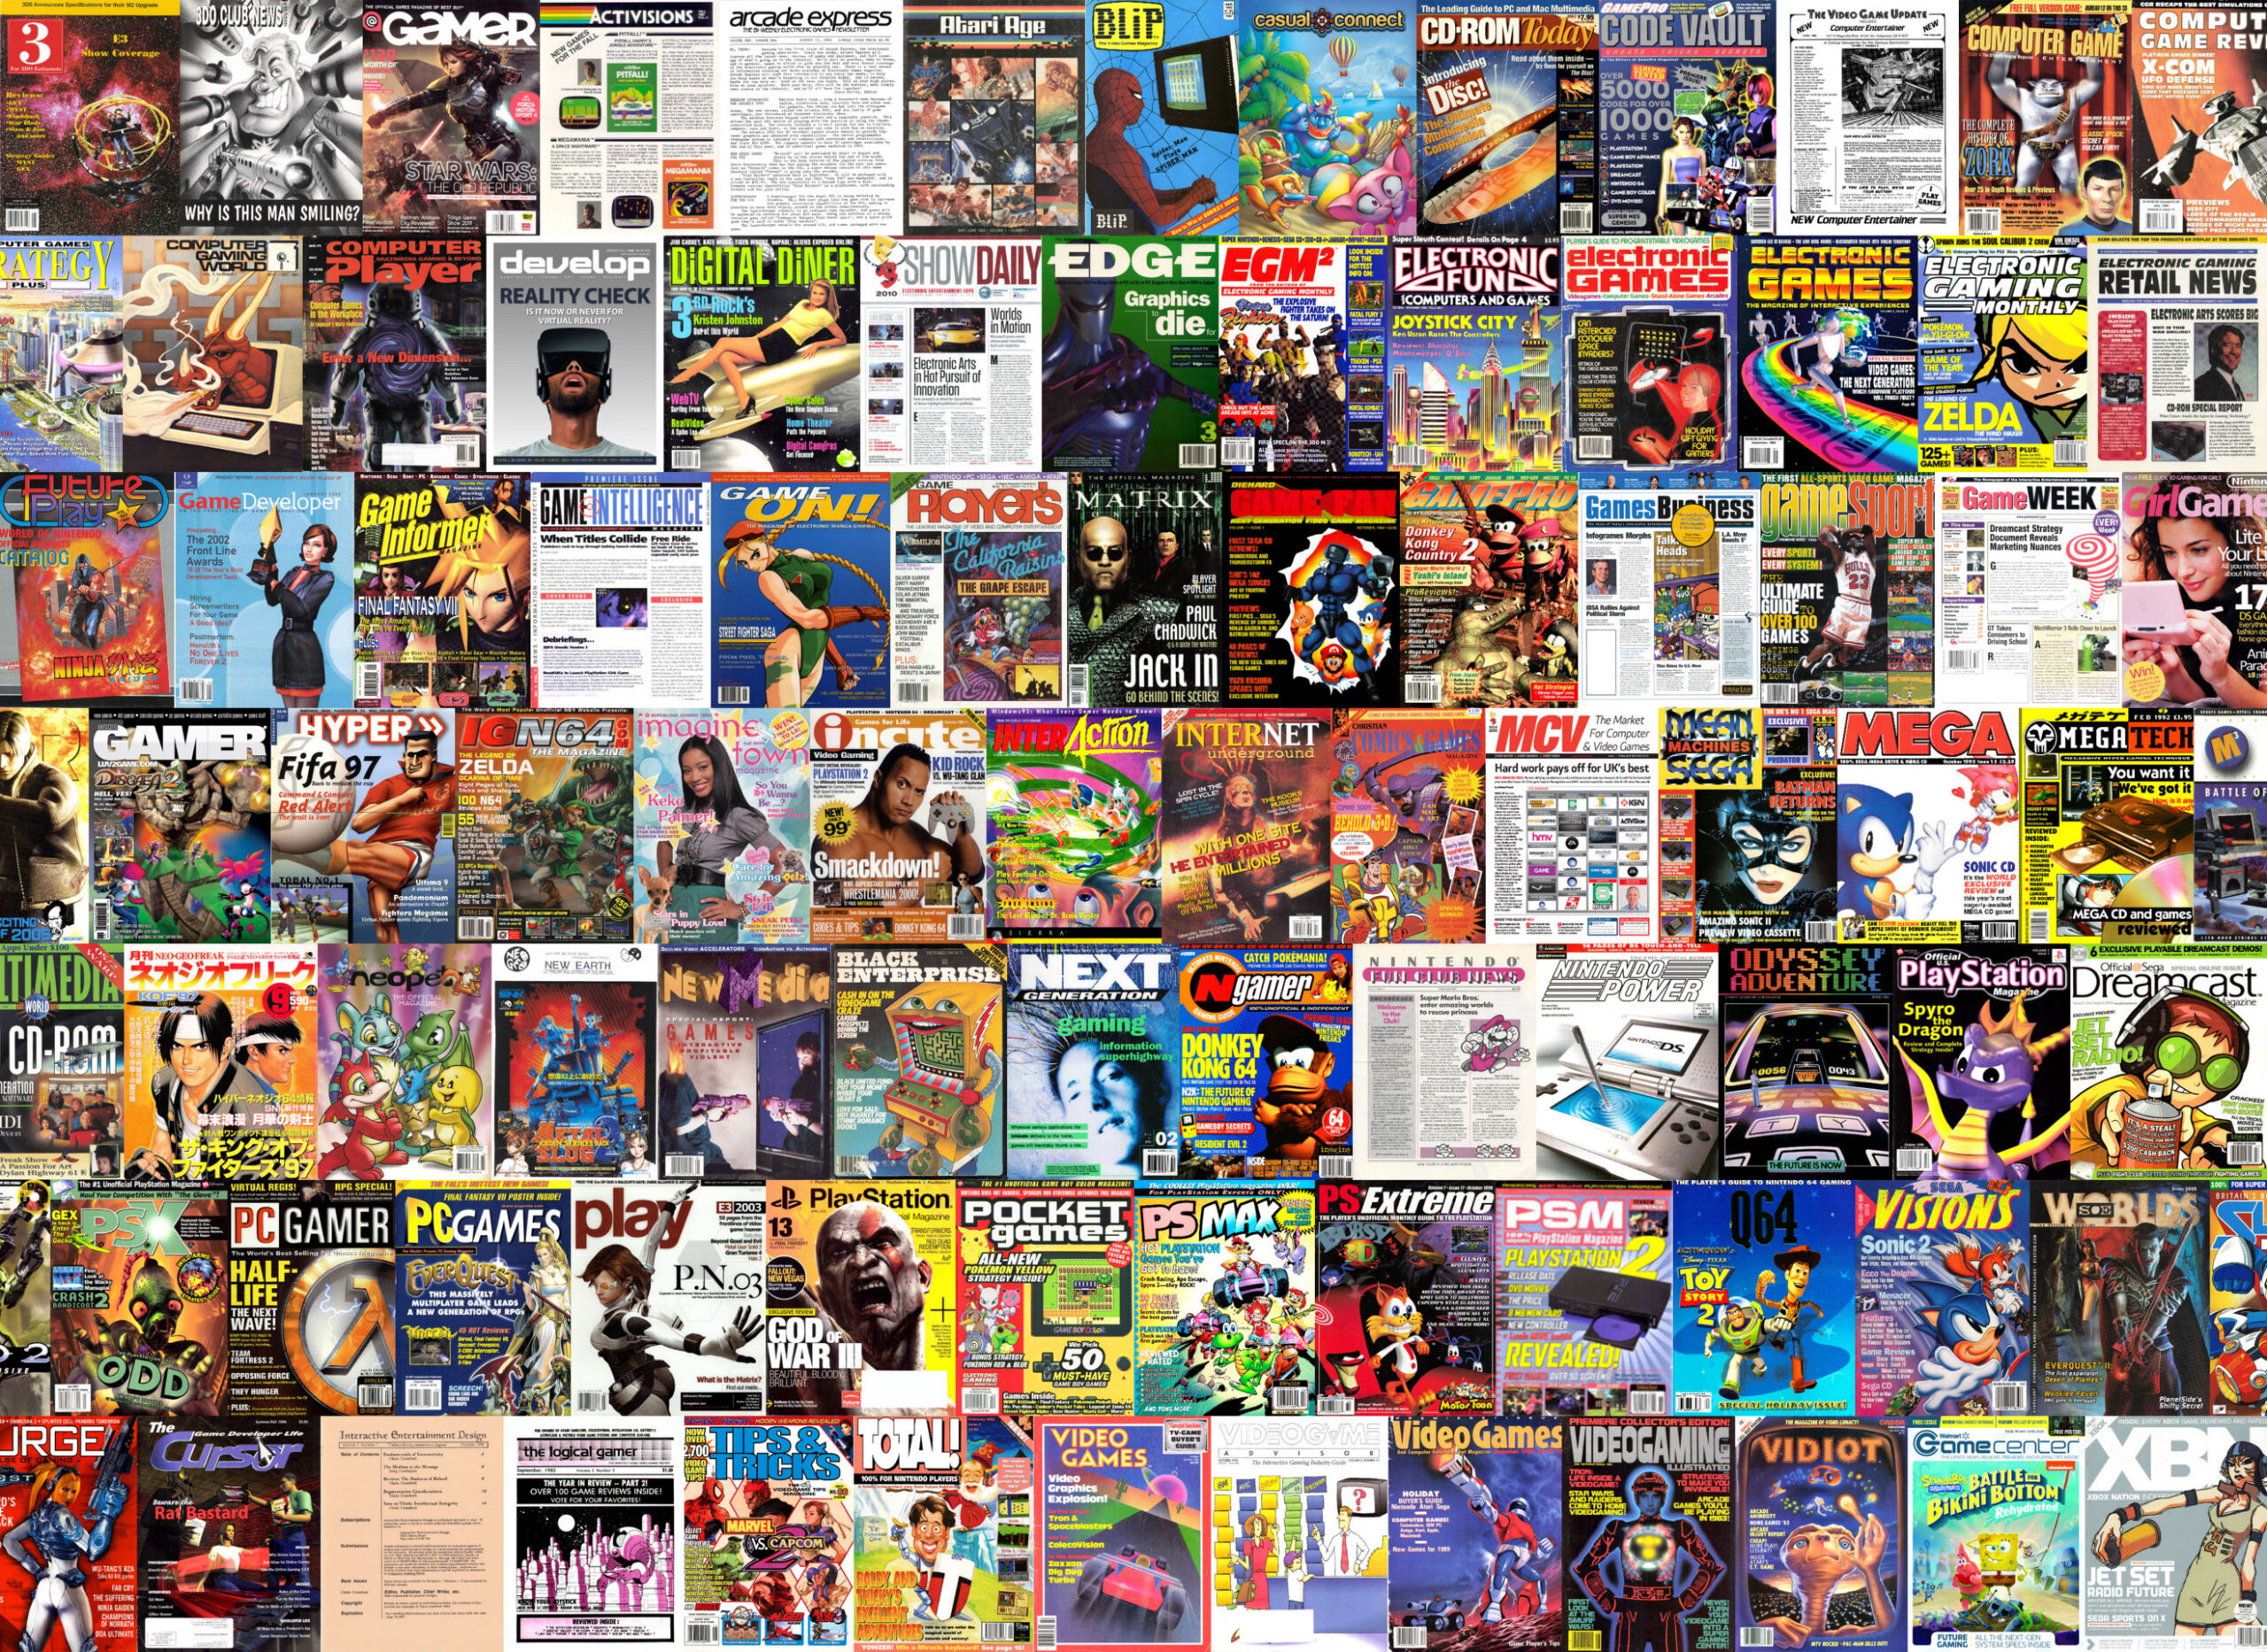
비디오게임역사재단이 디지털 아카이브에 5000권 이상의 게임 잡지를 등재해 약 60만 페이지(선반 100피트 상당)를 보유하게 됐으며, 1981~2026년 46년간의 게임 역사를 아우른다. 작년 런칭 당시 1500권으로 시작한 컬렉션이 1년 반 만에 3배 이상 증가했으며, 이는 커뮤니티 스캔 프로젝트와의 협력으로 가능했다(VGHF가 1/3, 외부 단체가 2/3 담당). 아카이브는 위키피디아에서 절판된 게임 잡지의 선호 참고자료가 되어 500개 이상의 인용을 받았다. 전체 요약 9문장 읽기 → 026 21:11 당일 +477 벡터DB 없이 추론으로 문서를 읽는 RAG, PageIndex PageIndex는 벡터 인덱스 대신 계층 구조의 트리 인덱스를 만들고, LLM의 추론으로 그 트리를 탐색하는 벡터리스 RAG 엔진이다. AI · 머신러닝 · VectifyAI/PageIndex · Python
Key Point 벡터DB에 의존하지 않고 LLM의 추론으로 문서를 검색하는 새로운 RAG 방식이, 복잡한 전문 문서에서 기존 벡터 검색보다 훨씬 높은 정확도(98.7%)와 낮은 비용(2~16배 절감)을 달성했기 때문이다.
핵심 요약
PageIndex는 벡터 인덱스 대신 계층 구조의 트리 인덱스를 만들고, LLM의 추론으로 그 트리를 탐색하는 벡터리스 RAG 엔진이다. 벡터 RAG는 의미적 유사성으로 검색하지만, 유사성이 반드시 관련성을 의미하지 않는다. PageIndex는 문맥 이해, 도메인 전문성, 다단계 추론이 필요한 금융보고서나 법률 문서에서 더 정확한 관련 정보를 찾는다. 인덱싱은 문서마다 트리 구조를 생성하고, 검색은 LLM이 그 트리를 추론하며 탐색하는 두 단계로 진행된다. 전체 요약 12문장 읽기 → 027 21:11 당일 +148 스크린샷·이미지 뷰어 Snow Apps 오픈소스 공개 Snow Shot과 Snow Image Viewer 애플리케이션의 소스 코드를 C++로 공개했다. 오픈소스 · 도구 · mg-chao/snow-apps · C++
Key Point 스크린샷 캡처와 이미지 처리 도구의 전체 소스가 오픈소스로 공개되어, 개발자들이 직접 검토·확장·기여할 수 있게 되었다.
핵심 요약
Snow Shot과 Snow Image Viewer 애플리케이션의 소스 코드를 C++로 공개했다. Windows에서는 공식 릴리스 페이지 또는 WinGet 커뮤니티 저장소에서 설치 가능하며 오프라인 x64 패키지와 기본 OCR 리소스가 포함된다. macOS 버전은 Apple Silicon Mac에서 macOS 15 이상에서 Homebrew를 통해 설치할 수 있으며, 로컬 서명 ID를 재사용하고 Keychain 접근 및 macOS 개인정보 보호 권한을 요청할 수 있다. 전체 요약 5문장 읽기 → 028 18:11 ▲ 42 · 댓글 3 다국어 텍스트 인식에 최적화된 MoE 아키텍처 다국어 OCR의 문제점을 해결하기 위해 script-aware Mixture-of-Experts(ScriptMoE) 아키텍처를 제안했다. AI · 머신러닝 · All-in-One Multilingual Scene Text Recognition with Script-aware Mixture-of-Experts
Key Point 언어별 별도 모델 배포 비용과 복잡성 없이 실무 OCR 성능을 크게 개선하는 실용적 기술로, 다국어 텍스트 인식이 필요한 개발자들이 주목할 만하다.
핵심 요약
다국어 OCR의 문제점을 해결하기 위해 script-aware Mixture-of-Experts(ScriptMoE) 아키텍처를 제안했다. TextMuSS-10M이라는 10개 문자 체계와 229개 언어를 포함한 대규모 합성 텍스트 데이터셋을 구축했다. ScriptMoE는 단일 비전 인코더와 이미지별 라우터가 상위 2개의 문자 체계 전문 모듈로 분배하는 희소 MoE 블록으로 구성된다. 전체 요약 5문장 읽기 → 030 21:10 당일 +310 알리바바가 공개한 AI 코드 리뷰 도구, 정밀성 높이고 비용은 1/9로 알리바바의 내부 코드 리뷰 시스템을 오픈소스화한 OpenCodeReview는 Git diff를 읽어 LLM에 보낸 뒤 라인 단위 정밀한 피드백을 생성한다. AI · 머신러닝 · alibaba/open-code-review · Go
Key Point 자체 검증 벤치마크에서 일반 LLM 대비 정밀도는 높이면서 API 비용을 획기적으로 줄인 실용적 코드 리뷰 솔루션이 공개되었기 때문입니다.
핵심 요약
알리바바의 내부 코드 리뷰 시스템을 오픈소스화한 OpenCodeReview는 Git diff를 읽어 LLM에 보낸 뒤 라인 단위 정밀한 피드백을 생성한다. deterministic 파이프라인과 LLM Agent를 결합한 하이브리드 구조로, 파일 선택·번들링·규칙 매칭을 엔지니어링 로직으로 보장하면서 동적 판단은 Agent에 맡긴다. NPE, 스레드 안전성, XSS, SQL 인젝션 등 다국어 룰셋을 내장하고 OpenAI와 Anthropic 모델을 모두 지원한다. 전체 요약 5문장 읽기 → 031 08:12 당일 +188 마이크로소프트의 MarkItDown, 각종 문서를 마크다운으로 변환 마이크로소프트가 공개한 Python 유틸리티로, PDF·파워포인트·워드·엑셀·이미지·오디오·HTML 등 다양한 파일을 마크다운 형식으로 변환한다. AI · 머신러닝 · microsoft/markitdown · Python
Key Point LLM 기반 애플리케이션에서 다양한 형식의 문서를 처리해야 할 때, 마크다운으로의 표준화된 변환 방식을 제시하는 도구가 등장했으므로.
핵심 요약
마이크로소프트가 공개한 Python 유틸리티로, PDF·파워포인트·워드·엑셀·이미지·오디오·HTML 등 다양한 파일을 마크다운 형식으로 변환한다. 제목, 리스트, 표, 링크 등 문서 구조를 마크다운으로 보존하도록 설계되었으며, LLM과 텍스트 분석 파이프라인에서 사용하기 위한 목적이다. 마크다운은 LLM이 기본적으로 이해하고 토큰 효율도 높기 때문에, GPT-4o 같은 주류 언어모델과의 호환성이 우수하다. 전체 요약 6문장 읽기 → 032 00:10 ▲ 392 · 댓글 156 미스트랄 OCR 4.1 공개, 문서 AI 스택 강화 미스트랄이 문서 AI 스택을 지원하는 최신 OCR 서비스 OCR 4.1을 공개했다. AI · 머신러닝 · Mistral OCR 4.1
Key Point 개발자 커뮤니티에서 높은 인기를 기록한 미스트랄의 새로운 OCR 모델 공개로, 문서 처리 자동화 기능의 개선이 주목받고 있다.
핵심 요약
미스트랄이 문서 AI 스택을 지원하는 최신 OCR 서비스 OCR 4.1을 공개했다. 문단 수준의 바운딩 박스 추출, 구조화된 블록 레이블, 블록 수준의 신뢰도 점수를 기본 지원한다. 가격은 1000페이지당 4달러, 주석이 포함된 페이지는 1000페이지당 5달러이다.