쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 3일 (화)까지 3800건
100건 (최대치) · "분류"조건 지우기 ×
001 21:11 당일 +256 3D 스캔을 CAD처럼 측정하는 브라우저 도구 공개 CNC Kitchen이 ScanRuler를 오픈소스로 공개했으며, scanruler.com에서 브라우저로 바로 사용할 수 있다. 하드웨어 · 시스템 · CNCKitchen/ScanRuler · TypeScript
Key Point 정밀 제조, 품질 검사, 역설계가 필요한 엔지니어에게 설계 도구 구매 비용을 줄이고 브라우저만으로 스캔 검수를 자동화할 기회를 제공한다.
핵심 요약
CNC Kitchen이 ScanRuler를 오픈소스로 공개했으며, scanruler.com에서 브라우저로 바로 사용할 수 있다. 3D 스캔 파일(STL, PLY, OBJ, 3MF, STEP)을 불러와 구, 원통, 원뿔, 평면 등을 피팅하고 치수를 측정할 수 있다. 모든 파일과 처리가 브라우저에서만 진행되며, 컴퓨터 밖으로 나가지 않는다(AI 에이전트 연결 시 제외). 전체 요약 12문장 읽기 → 002 21:11 ▲ 18 · 댓글 1 위조 탐지 AI, 딥페이크부터 변조 문서까지 한 번에 비디오·이미지·물리적 스푸핑 등 다양한 형태의 위조에 대응하는 통합 기반 모델 'Venus-DefakerOne2'를 공개했다. AI · 머신러닝 · Venus-DefakerOne2: A Vision-Forensics Foundation Model with Broader Coverage
Key Point 이진 분류 기반 위조 탐지 작업에서 다양한 매체와 위조 형태를 동시에 처리할 수 있는 통합 기반 모델의 등장으로, 위변조 탐지 기술의 범용성이 크게 높아졌다.
핵심 요약
비디오·이미지·물리적 스푸핑 등 다양한 형태의 위조에 대응하는 통합 기반 모델 'Venus-DefakerOne2'를 공개했다. 수천만 개의 오픈소스 및 사내 샘플로 학습했으며, LoRA와 전체 파라미터 튜닝을 번갈아 수행하는 'Tide-Style-Tuning' 기법으로 효율성과 일반화를 동시에 달성했다. 예측 엔트로피를 분석해 최적의 예측 방식을 자동으로 선택하는 'Entropy-based Test Adaptation'을 적용했다. 전체 요약 5문장 읽기 → 003 06:11 ▲ 113 · 댓글 132 수학은 변했다, 우리도 행동해야 한다 OpenAI가 10월 6일 700개 이상의 연구 논문을 공개했으며, AI가 수학의 많은 분야에서 획기적 기여를 할 수 있음을 입증했다. AI · 머신러닝 · Mathematics has changed. Let's act like it
Key Point AI가 증명 생산 방식을 근본적으로 바꾸면서 수학 학계의 평가, 채용, 출판 시스템 전체를 재설계해야 하는 시점이 왔다.
핵심 요약
OpenAI가 10월 6일 700개 이상의 연구 논문을 공개했으며, AI가 수학의 많은 분야에서 획기적 기여를 할 수 있음을 입증했다. 그러나 AI 회사들의 논문은 문장이 형편없고 출처 표기가 부실하며 일부는 틀렸으므로, 수학 커뮤니티는 채용, 출판, 학생 교육에서 더 많은 통제력을 행사해야 한다. AI가 Langlands 프로그램 같은 중앙 문제들을 풀었다 해도, 그것이 수론 전체를 '해결'하는 것은 아니며, 이는 원소 주기율표 발견이 화학을 완성하지 못한 것과 같다. 전체 요약 12문장 읽기 → 004 06:11 ▲ 132 · 댓글 76 해커뉴스 추천 영상만 모은 유튜브 클론 'HackerTube' 공개 유튜브의 알고리즘이 마음에 들지 않아 Claude Opus 5.5를 이용해 HackerTube라는 영상 플랫폼을 직접 만들었다. 웹 · 프론트엔드 · HackerTube: YouTube built from videos recommended by HN
Key Point 기술 커뮤니티가 추천하는 양질의 콘텐츠만 모은 새로운 영상 발견 방식이 나타났으며, LLM과 웹 개발로 단시간에 실제 서비스를 구축하는 사례를 보여준다.
핵심 요약
유튜브의 알고리즘이 마음에 들지 않아 Claude Opus 5.5를 이용해 HackerTube라는 영상 플랫폼을 직접 만들었다. 해커뉴스의 2007년부터 2026년까지 전체 댓글을 수집한 후 Sonnet으로 스팸과 저품질 콘텐츠를 필터링했다. 필터링 결과 해커뉴스 사용자들이 추천한 유튜브 영상 6,454개가 수집되었으며, 150개 주제로 분류됐다. 전체 요약 6문장 읽기 → 005 03:10 ▲ 171 · 댓글 77 악성코드가 LLM으로 피해자를 "가치"로 순위 매긴다 VOLTA라는 자체 삭제형 윈도우 정보탈취 악성코드가 비밀번호, 결제카드, 암호화폐 지갑, 이메일, 우버이츠·도어대시 주문 기록 등을 수집한 뒤 구조화된 데이터 묶음을 LLM에 전송한다. 보안 · Malware uses LLMs to rank victims by how much they're worth
Key Point 악성코드가 LLM을 피해자 평가 도구로 실제 사용 중이며, 광범위 탈취 후 AI로 자동 분류하는 새로운 사이버범죄 패턴이 등장하고 있다.
핵심 요약
VOLTA라는 자체 삭제형 윈도우 정보탈취 악성코드가 비밀번호, 결제카드, 암호화폐 지갑, 이메일, 우버이츠·도어대시 주문 기록 등을 수집한 뒤 구조화된 데이터 묶음을 LLM에 전송한다. LLM은 '포렌식 정보분석가' 역할로 피해자의 자산을 화폐화 가능성별로 저/중/고 등급으로 순위 매기고 보안 태세를 평가한 '목표 평가 보고서'를 생성한다. VOLTA는 OpenRouter를 통해 기본값으로 Claude Opus 4.6을 사용하며, 거절 시 Kimi-K2와 Gemini 2.5 Flash로 차례로 폴백하는 3단계 체인을 갖춘다. 전체 요약 10문장 읽기 → 006 00:11 ▲ 140 · 댓글 62 ChatGPT 공유 링크 하나로 계정 탈취 가능한 취약점 발견 2026년 10월, 공개 공유된 ChatGPT 대화 링크를 통해 피해자의 인증된 세션에서 임의의 JavaScript를 실행할 수 있는 취약점이 발견됐다. 보안 · We Took over ChatGPT Accounts
Key Point 공개 링크 하나만으로 남의 ChatGPT 계정을 완전히 제어할 수 있었던 심각한 보안 결함이며, 샌드박스 · 메시징 · CSP 같은 개별 방어 수단이 어떻게 조합되면 무너지는지 보여주는 사례입니다.
핵심 요약
2026년 10월, 공개 공유된 ChatGPT 대화 링크를 통해 피해자의 인증된 세션에서 임의의 JavaScript를 실행할 수 있는 취약점이 발견됐다. 그래프 기능이 MathLive 라이브러리를 로드할 때 메인 페이지에 메시지 리스너를 설치했고, HTML Preview에서 postMessage API를 통해 출처 검증 없이 신뢰되지 않은 HTML을 포함한 메시지를 보낼 수 있었다. MathLive가 수신한 메시지의 발신자를 확인하지 않고, HTML을 키보드 레이아웃으로 받아들였으며, 이를 ChatGPT 메인 페이지에 innerHTML로 삽입했다. 전체 요약 11문장 읽기 → 007 12:11 ▲ 10 · 댓글 4 영상 이해 AI, 불확실할 땐 질문하게 하기 멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. AI · 머신러닝 · AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
Key Point 스트리밍 비디오 분석 AI가 정보 부족 상황을 인식하고 능동적으로 질문하도록 훈련할 수 있는지가 새로운 기술 과제가 되고 있기 때문입니다.
핵심 요약
멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. 기존 주도적 상호작용 방식은 답변에 필요한 정보가 완전하다고 가정해 모델이 대기하거나 답하기만 하도록 설계됐으나, 실제로는 영상이나 사용자 질문의 불확실성으로 정보가 불완전한 경우가 많다. 불완전한 정보 상황에서 기존 방식은 모델이 영원히 대기하거나 환각적 응답을 생성하는 문제를 야기한다. 전체 요약 8문장 읽기 → 008 03:11 ▲ 269 · 댓글 203 AI가 SRE를 대체하지 않으면, 기술을 퇴화시킨다 AI가 사건 대응의 95%를 처리할 때, SRE는 남은 5%의 중요한 문제를 처리할 능력이 실제로 떨어질 수 있다는 문제를 제기한다. 인프라 · 데브옵스 · AI isn't replacing SREs, it's deskilling them
Key Point AI가 많은 일을 자동화할수록 SRE의 실제 대응 능력이 떨어지는 '역설적 퇴화' 현상이 의료·항공 산업에서도 이미 관찰되고 있으며, 신입 인재 육성 경로까지 단절될 수 있다는 점이 기술 조직의 구조적 위험을 보여준다.
핵심 요약
AI가 사건 대응의 95%를 처리할 때, SRE는 남은 5%의 중요한 문제를 처리할 능력이 실제로 떨어질 수 있다는 문제를 제기한다. 1983년 인지심리학자 리잔느 베인브릿지의 연구 논문 '자동화의 역설(Ironies of Automation)'을 근거로, 자동화가 발전할수록 인간 운영자는 자동화 실패 시 대응할 능력이 낮아진다는 패러독스를 설명한다. 산업 자동화가 육체 노동자들의 예외 상황 대처 능력을 빼앗았듯이, AI는 패턴 매칭, 분류, 알려진 문제 해결 같은 일상적 인지 업무를 대신하면서 SRE에게 드물고 복잡한 문제만 남긴다. 전체 요약 11문장 읽기 → 009 12:11 ▲ 100 · 댓글 104 소프트웨어의 미래는 라이선스가 아닌 커뮤니티에서 결정된다 소프트웨어 자유주의 활동가는 강한 카피레프트 라이선스 중심의 접근에서 벗어나 프로젝트의 가치를 결정하는 커뮤니티의 중요성을 강조한다. 오픈소스 · 도구 · The importance of communities around software
Key Point 라이선스 중심의 소프트웨어 자유 논의가 커뮤니티의 가치와 윤리로 재정의되고 있으며, 개발자가 참여하는 프로젝트를 선택할 때 고려해야 할 기준이 변하고 있다.
핵심 요약
소프트웨어 자유주의 활동가는 강한 카피레프트 라이선스 중심의 접근에서 벗어나 프로젝트의 가치를 결정하는 커뮤니티의 중요성을 강조한다. 라이선스만으로는 부족하며, 소프트웨어가 윤리적 기준을 충족하는지, 포용적이고 커뮤니티에 의해 운영되는지 등을 고려해야 한다. 카피레프트 라이선스가 소프트웨어 자유를 신호하지만 보장하지는 않으며, 상업 라이선스 이중 허가나 기여자 라이선스 계약을 강제하는 AGPL 프로젝트는 실질적 자유성이 없을 수 있다. 전체 요약 6문장 읽기 → 010 21:11 ▲ 137 · 댓글 88 안드로이드 긴급 통화 중단시키는 악성 SMS 공격 공개 잘못된 WAP Push SMS 한 통으로 안드로이드 전화 앱(com.android.phone)을 크래시시켜 통화 중 상태의 모든 전화(긴급 전화 포함)를 끊을 수 있는 취약점이 공개됐다. 보안 · Zero click, silent, remote Android DoS
Key Point 긴급 전화를 원격으로 영구 차단할 수 있는 취약점이 공개되면서 수억 대의 안드로이드 기기가 노출됐고, 통신사의 자동 차단 정책으로 인해 사용자 과실이 아닌데 기기가 네트워크에서 제외될 수 있다.
핵심 요약
잘못된 WAP Push SMS 한 통으로 안드로이드 전화 앱(com.android.phone)을 크래시시켜 통화 중 상태의 모든 전화(긴급 전화 포함)를 끊을 수 있는 취약점이 공개됐다. 5바이트 uintvar 값 88 80 80 80 00이 0x80000000으로 디코딩되고, 32비트 정수로 캐스팅되면서 -2147483648이 되는데, 이를 바이트 배열 크기로 사용하면서 NegativeArraySizeException을 발생시킨다. 메시지는 데이터 SMS로 전달돼 사용자에게 보이지 않으며, Pixel 9(2026년 4월 펌웨어)와 여러 삼성 갤럭시·A시리즈에서 100% 재현 가능하다. 전체 요약 11문장 읽기 → 011 12:11 ▲ 10 · 댓글 6 제약 디코딩, LLM 성능 해친다는 가정 재검토 대형언어모델(LLM)의 제약 디코딩은 출력을 미리 정한 형식으로 제한하지만 추론 능력을 해친다는 통설을 검토했다. AI · 머신러닝 · Constrained Decoding: Harmful or Beneficial? Revisiting Its Impact on LLM Performance
Key Point LLM의 출력 제약이 성능을 꼭 해치지 않는다는 실증적 증거로, 프롬프트 엔지니어링과 추론 시스템 설계 방식을 다시 생각하게 한다.
핵심 요약
대형언어모델(LLM)의 제약 디코딩은 출력을 미리 정한 형식으로 제한하지만 추론 능력을 해친다는 통설을 검토했다. 연구팀은 제약을 형식 제약(출력 구조 강제), 타당성 제약(잘못된 답 마스킹), 추론 제약(추론 경로 제한) 세 가지로 분류했다. 이론적으로 적절한 제약이 무효한 경로를 제거해 성능을 유지하거나 개선할 수 있음을 보였다. 전체 요약 8문장 읽기 → 012 06:11 당일 +714 오픈소스 AI SOC로 보안 대응을 자동화하다 보안 도구에서 수집한 로그를 정규화한 후 2535개의 탐지 규칙을 실행해 위협을 자동 분류하고 AI 에이전트가 조사하며 사람이 승인한 후 대응 조치를 취하는 자체 호스팅 가능한 오픈소스 SOC이다. 보안 · beenuar/AiSOC · Python
Key Point API 키 없이 AI 기반 위협 조사를 자체 호스팅으로 실행할 수 있는 오픈소스 SOC가 등장했으며, 모든 AI 추론이 기록되어 감사 가능하고 대응은 사람이 승인해야 한다는 점이 기존 자동화 도구와 다르다.
핵심 요약
보안 도구에서 수집한 로그를 정규화한 후 2535개의 탐지 규칙을 실행해 위협을 자동 분류하고 AI 에이전트가 조사하며 사람이 승인한 후 대응 조치를 취하는 자체 호스팅 가능한 오픈소스 SOC이다. 도입에 명령어 한 줄로 Docker, Python, 필요한 보안 자격증을 모두 설치할 수 있으며 8GB 메모리와 20GB 디스크, Python 3.9+ 그리고 bash만 있으면 된다. Splunk, Sentinel, Elastic, CrowdStrike, Okta, AWS, Kubernetes 등 87개의 데이터 커넥터를 지원하며 클라우드 환경에서는 S3-SQS, GCP Pub/Sub, Azure Event Hubs, syslog/CEF 리스너로 로그를 수집한다. 전체 요약 10문장 읽기 → 013 03:11 ▲ 12 · 댓글 2 폐쇄형 선택지 판정용 소형 언어 인코더 설계 방식 비교 도구 선택 같은 폐쇄형 결정 작업을 위해 얼마나 작은 인코더를 쓸 수 있는지, 그리고 선택지를 함께 읽을지 개별로 읽을지를 비교하는 연구다. AI · 머신러닝 · Joint or Per-Option? Compact Encoders for Closed-Set Decisions from 17 Million to 1 Billion Parameters
Key Point 소형 언어 모델로 도구 선택·카테고리 분류 같은 의사결정을 더 빠르고 안정적으로 처리할 수 있는 설계 방식이 검증되어, 프로덕션 LLM 파이프라인 최적화에 직접 영향을 미친다.
핵심 요약
도구 선택 같은 폐쇄형 결정 작업을 위해 얼마나 작은 인코더를 쓸 수 있는지, 그리고 선택지를 함께 읽을지 개별로 읽을지를 비교하는 연구다. 3개 시드로 3천2백만 파라미터에서 실험한 결과 선택지별 채점(per-option scoring) 방식이 37개 벤치마크 병합 테스트에서 공동 채점(joint scoring) 방식을 보정 후 5.8점 능력 차이로 이기고, 유사한 훈련량 조건에서는 2.8점 앞선다. 외부 벤치마크 2개도 이 경향을 보였으나 미학습 작업에서는 통계적 유의성이 없다. 전체 요약 8문장 읽기 → 014 21:11 당일 +101 React·Next.js용 애니메이션 컴포넌트 라이브러리 공개 215개 이상의 무료 애니메이션 컴포넌트와 배경 효과를 제공하는 오픈소스 라이브러리로, 텍스트 애니메이션 33개, 일반 애니메이션 38개, UI 컴포넌트 48개, 마이크로 요소 34개, 배경 효과 63개로 분류되어 있다. 웹 · 프론트엔드 · DavidHDev/react-bits · JavaScript
Key Point AI 에이전트와의 통합(MCP 지원)이 기본으로 탑재되어 있어 Claude, Cursor 등과의 자동 연동으로 컴포넌트 추가 작업이 간소화된다.
핵심 요약
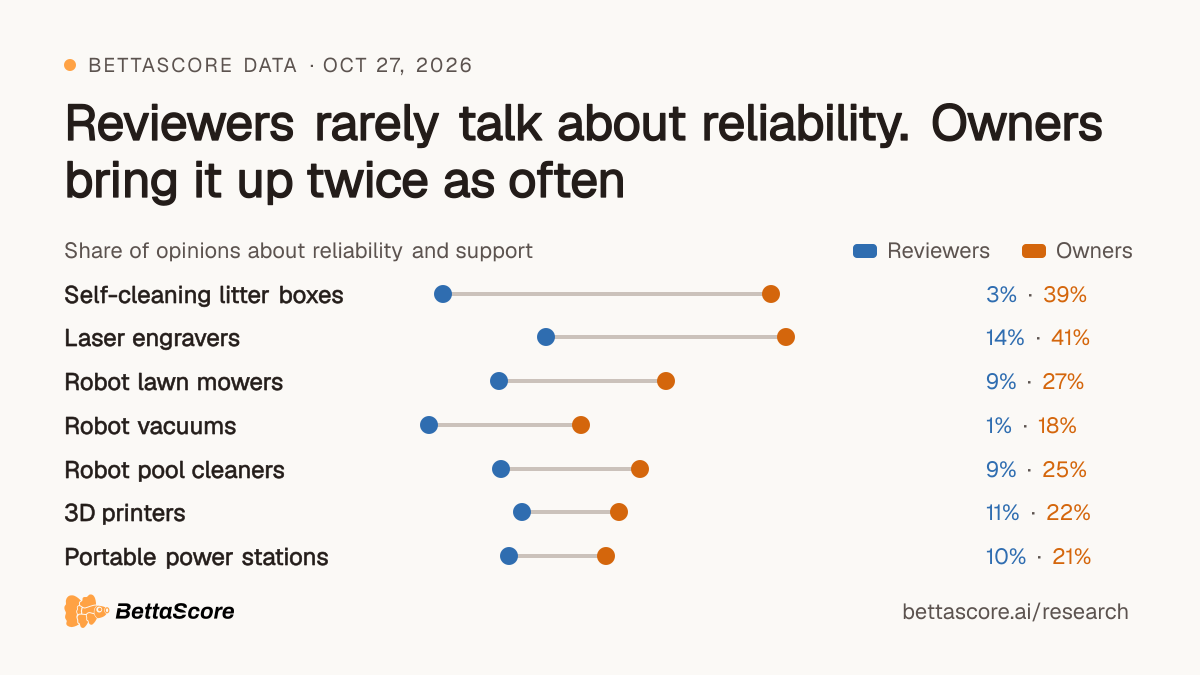
215개 이상의 무료 애니메이션 컴포넌트와 배경 효과를 제공하는 오픈소스 라이브러리로, 텍스트 애니메이션 33개, 일반 애니메이션 38개, UI 컴포넌트 48개, 마이크로 요소 34개, 배경 효과 63개로 분류되어 있다. 모든 컴포넌트는 라이브 데모와 조작 가능한 설정을 제공하며, JavaScript 또는 TypeScript와 CSS 또는 Tailwind로 네 가지 방식으로 제공된다. shadcn CLI나 jsrepo를 사용해 프로젝트에 추가할 수 있고, 수동 복사도 지원하며 설치 가이드가 마련되어 있다. 전체 요약 8문장 읽기 → 015 15:11 ▲ 102 · 댓글 80 리뷰어는 신뢰성을 외면하고 실사용자는 두 배로 강조한다 BettaScore가 14개 카테고리의 로봇청소기, 레이저 각인기, 3D 프린터 등 657개 제품에 대해 유튜브 리뷰 6,900건과 레딧 스레드 3,567건을 분석했다. 기타 · Reviewers rarely talk about reliability. Owners bring it up twice as often
Key Point 실사용자만 드러내는 신뢰성 문제를 리뷰어는 놓치고 있으며, 같은 제품도 시간이 지날수록 실제 가치와 다른 평가를 받는다는 점이 구매 결정에 큰 영향을 미친다.
핵심 요약
BettaScore가 14개 카테고리의 로봇청소기, 레이저 각인기, 3D 프린터 등 657개 제품에 대해 유튜브 리뷰 6,900건과 레딧 스레드 3,567건을 분석했다. 리뷰어는 신뢰성과 내구성, 지원에 관해 전체 의견의 7.8%만 언급한 반면, 실제 사용자는 17.0%로 두 배 이상 자주 다뤘다. 13개 카테고리에서 사용자가 신뢰성을 더 많이 언급했으며, 로봇청소기(리뷰어 1% vs 사용자 18%), 자동 묘사함(3% vs 39%), 레이저 각인기(14% vs 41%)의 격차가 특히 크다. 전체 요약 12문장 읽기 → 016 12:11 ▲ 26 · 댓글 2 LLM 환각 탐지 벤치마크 비교 불가능한 이유 대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. AI · 머신러닝 · Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities
Key Point LLM 성능을 평가하는 핵심 지표인 환각 탐지가 벤치마크마다 다르게 정의되고 측정되기 때문에, 어떤 방법이 실제로 더 나은지 판단할 수 없다는 문제를 드러낸다.
핵심 요약
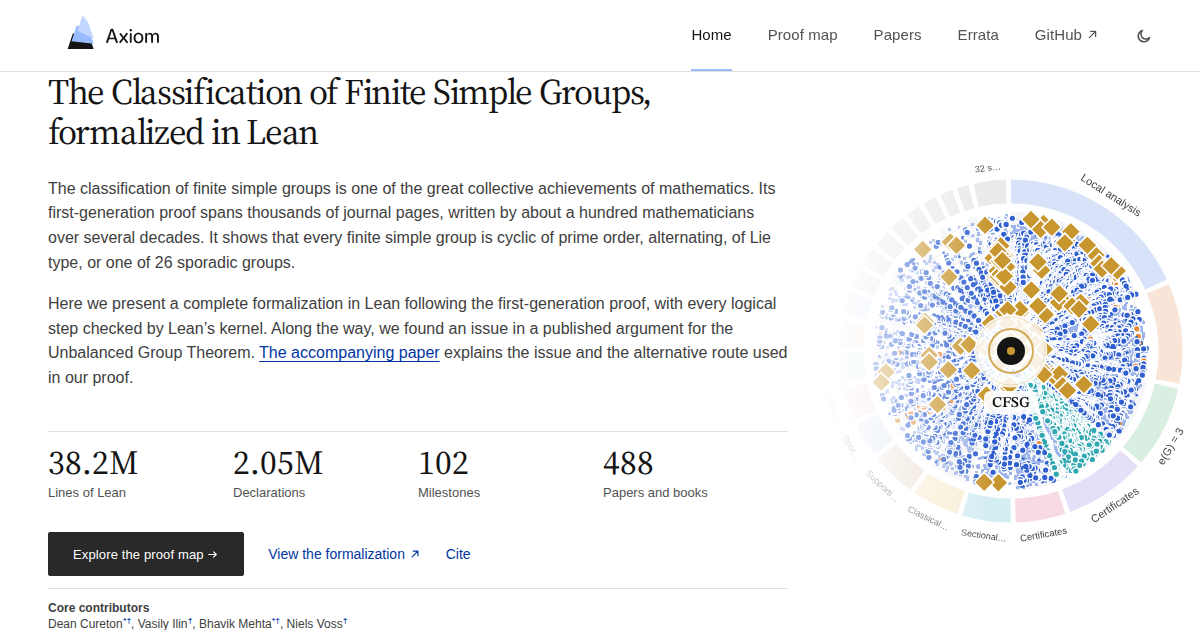
대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. 연구팀은 환각 탐지를 벤치마크 조건부 측정 문제로 보고, 세 가지 축으로 기존 벤치마크들을 분류했다: 모델 출력과 근거 조건을 어떻게 얻는지를 설명하는 '출처', 사실성과 충실성 오류를 어떻게 정의하는지를 나타내는 '유형분류', 환각을 어떤 단위로 주석·예측·평가하는지를 명시하는 '단위'이다. 벤치마크 구성, 주석 방식, 평가 방법의 차이가 예측 작업에 어떻게 영향을 미치고, 탐지기의 메커니즘과 가정이 어떤 조건에서 성능을 보이는지를 분석했다. 전체 요약 5문장 읽기 → 017 06:11 ▲ 125 · 댓글 28 유한 단순군의 분류, Lean으로 형식화 완료 군론의 대표적 난제인 유한 단순군의 분류(CFSG)를 증명보조기 Lean으로 완전히 형식화했다. AI · 머신러닝 · Classification of Finite Simple Groups Formalized in Lean
Key Point 수십 년에 걸친 군론의 거대한 정리를 기계로 완전히 검증했을 뿐 아니라, 그 과정에서 기존 증명의 오류까지 발견한 사례는 형식화 수학의 실질적 가치를 보여준다.
핵심 요약
군론의 대표적 난제인 유한 단순군의 분류(CFSG)를 증명보조기 Lean으로 완전히 형식화했다. 형식화 과정에서 기존 출판된 증명의 폐쇄성 주장에 대한 반례를 발견했으며, 이를 다룬 논문이 발표됐다. 특히 불균형군 정리(Unbalanced Group Theorem)의 기존 경로에서 막힘이 생겨, 1976년 Solomon의 극대 2-성분 이론을 바탕으로 한 대안적 논증을 제시했다. 전체 요약 4문장 읽기 → 018 03:11 ▲ 433 · 댓글 141 트럼프 행정부, 미국인 감시 방식 담은 비밀 법원 판결 공개 거부 민주당 상원의원 2명이 트럼프 행정부가 적법 절차 없이 미국인 통신을 감청할 수 있게 하는 프로그램(FISA 702조) 재승인 압박용으로 법원 판결을 의도적으로 숨기고 있다고 주장했다. 보안 · The US government is hiding secret court ruling about how it spies on Americans
Key Point 미국 정부가 국내 감시 권한의 법적 문제점을 담은 판결을 숨기면서, 의회 투표 앞에 필수 정보 공개를 거부하고 있는 상황이다.
핵심 요약
민주당 상원의원 2명이 트럼프 행정부가 적법 절차 없이 미국인 통신을 감청할 수 있게 하는 프로그램(FISA 702조) 재승인 압박용으로 법원 판결을 의도적으로 숨기고 있다고 주장했다. 외국정보감시법원(FISA Court)은 7개월 전 정보 분석가들이 승인·기록 없이 미국인 메시지를 추출하는 검색 필터를 문제 삼았고, 법원 판결은 공개되지 않고 있다. 행정부 자체 정책에 따르면 이런 판결은 발행 후 180일 내에 공개해야 하는데, 9월 13일 기한이 지났다. 전체 요약 12문장 읽기 → 019 18:11 ▲ 16 · 댓글 2 AI 텍스트 판별기를 해석 가능하게 만드는 방법 동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. AI · 머신러닝 · Building Auditable AI Text Detectors with Sparse Autoencoders
Key Point AI 생성 텍스트 판별기의 검은 상자 문제를 해결하고, 높은 성능과 투명성을 동시에 확보할 수 있는 새로운 방법론을 제시해 교육·저널리즘·입시 등 중요한 영역에서의 신뢰성을 높인다.
핵심 요약
동료 검토, 교육, 입시, 저널리즘, 콘텐츠 모더레이션 등 결과가 개인에게 직접 영향을 미치는 분야에서 AI 생성 텍스트 판별기가 배포되고 있다. 현재 가장 성능 좋은 판별기는 미세 조정된 신경망 분류기인데, 의사결정 과정이 불투명하며, 투명한 대안인 문체 및 언어적 특성 분류기는 성능이 훨씬 낮다. 연구팀은 미세 조정된 신경망 판별기를 인간이 읽을 수 있는 개념으로 작동하는 분류기로 변환하는 파이프라인을 제시했다. 전체 요약 7문장 읽기 → 020 15:11 ▲ 117 · 댓글 2 AI 에이전트가 신뢰할 수 있는 업무를 수행하려면 파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. AI · 머신러닝 · Work Agents: Systems, Capabilities, and Optimization
Key Point 에이전트 기술이 실제 업무 자동화로 확대되는 시점에 신뢰성 있는 작업 수행의 조건과 평가 방식을 체계적으로 정리한 프레임워크로, AI 에이전트의 현실적 배포를 고민하는 개발자와 연구자에게 실질적 지침을 준다.
핵심 요약
파운데이션 모델이 정보 생성에서 디지털 업무 실행으로 진화하면서 복잡한 작업을 여러 도구와 애플리케이션, 워크플로우에서 완수하는 에이전트가 등장했다. 이 논문은 에이전트를 파운데이션 모델과 런타임 하니스를 결합해 상태 관리 워크스페이스에서 작업을 실행하고 검증 가능한 결과를 전달하는 시스템으로 정의한다. 작업 지속성과 작업 개방성 두 차원으로 작업 조건을 분류하고, 작업 범위와 조직에 따라 디지털 업무를 다섯 가지 형태로 구분했다. 전체 요약 6문장 읽기 → 021 12:11 ▲ 283 · 댓글 6 AI 에이전트 신뢰성 평가 벤치마크 'TraceTrial-Bench' 공개 LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. AI · 머신러닝 · Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
Key Point LLM 에이전트 개발 시 모델 선택만으로는 부족하며, 실제 운영 환경의 하네스 설계가 신뢰성에 얼마나 큰 영향을 미치는지 처음으로 정량적으로 드러냈다.
핵심 요약
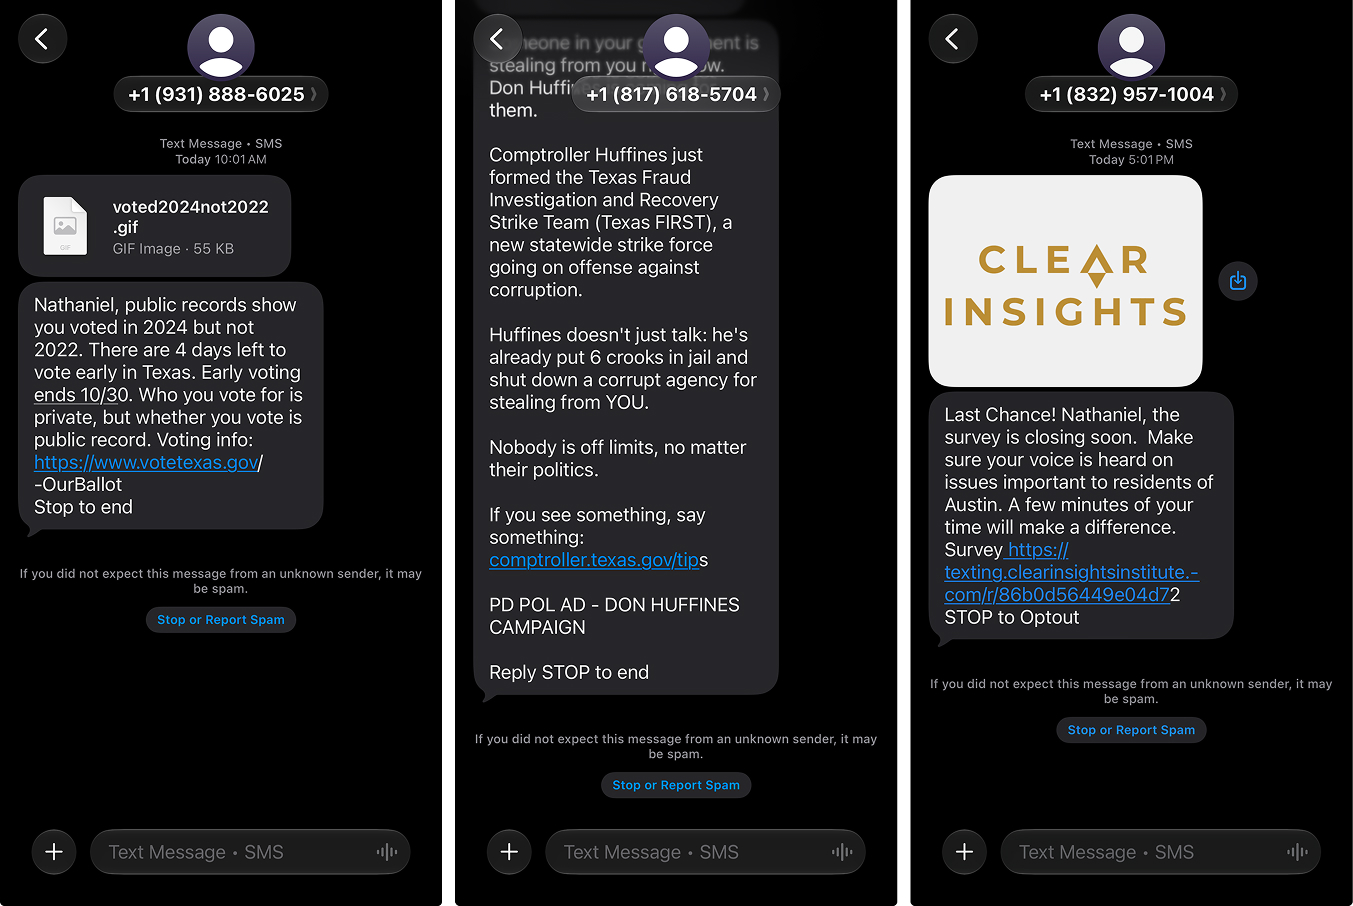
LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. 기존 벤치마크는 모델 성능 중심이었으나, 이 연구는 에이전트를 지탱하는 하네스(harness) 신뢰성에 초점을 맞췄다. 하네스 신뢰성을 컨텍스트, 실행, 거버넌스, 라이프사이클, 관찰성, 도구, 검증 7가지 요소로 분류했다. 전체 요약 10문장 읽기 → 022 09:11 ▲ 115 · 댓글 134 스팸 문자는 제 손에... 왜 내가 STOP을 보내야 하나 저자는 지난 달 미국 선거 관련 정치인·PAC·설문 업체에서 매일 여러 건의 스팸 문자를 받고 있으며, 자신의 번호가 명확한 동의 없이 명단에 올라 있다고 지적한다. 보안 · Somebody please stop the spam texts
Key Point 현재 미국 선거철이 정점인 가운데, 집단 스팸 문자의 현실과 기술 플랫폼의 무능함을 잘 드러내며, 개인 정보 동의 제도의 근본적 문제를 다룬다.
핵심 요약
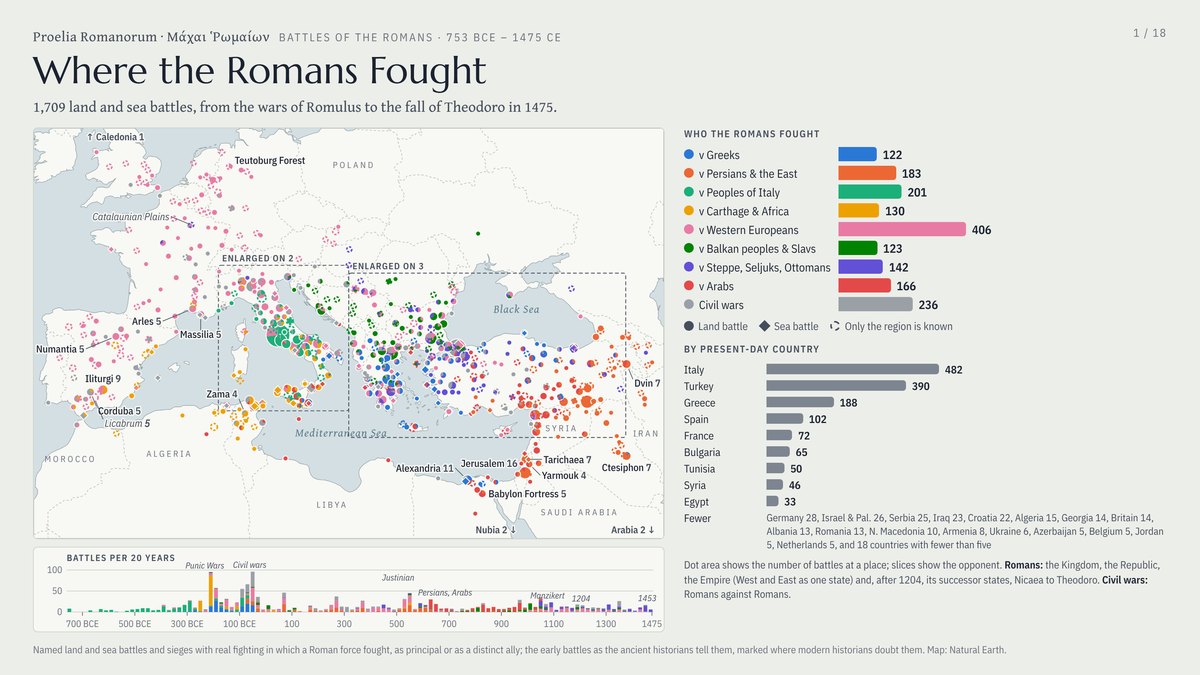
저자는 지난 달 미국 선거 관련 정치인·PAC·설문 업체에서 매일 여러 건의 스팸 문자를 받고 있으며, 자신의 번호가 명확한 동의 없이 명단에 올라 있다고 지적한다. 문자는 가족·친구·2FA 인증과 같은 중요한 신호를 전달하는 채널인데, 정치인과 마케터들이 높은 노출도를 노리고 침입하려 하고 있다. 일부 스팸 문자는 개인이 작성한 것처럼 보이지만, STOP을 보내면 대규모 캠페인의 일부임이 드러난다. 전체 요약 8문장 읽기 → 023 21:12 ▲ 114 · 댓글 47 로마 제국의 1469개 전투를 한눈에 보는 인터랙티브 지도 로마 건국부터 동로마 제국 멸망까지 1469개의 전투 기록을 인터랙티브 지도로 시각화한 프로젝트다. 기타 · Where the Romans Fought (interactive map)
Key Point 로마 역사 2000년을 데이터 기반으로 시각화한 대규모 학술 프로젝트로, 개발자·역사가·데이터 시각화에 관심 있는 사람들이 참고할 만한 복잡한 시계열 데이터 표현 방식을 보여준다.
핵심 요약
로마 건국부터 동로마 제국 멸망까지 1469개의 전투 기록을 인터랙티브 지도로 시각화한 프로젝트다. 연도 슬라이더로 특정 시기를 선택하면 해당 기간의 전투들을 확인할 수 있으며, 자동 재생으로 로마 건국부터 순서대로 볼 수 있다. 각 점의 크기는 그 지역의 전투 수를 나타내고, 파이 차트처럼 표시된 조각들은 상대방 세력을 시계방향으로 보여준다. 전체 요약 12문장 읽기 → 024 06:11 ▲ 273 · 댓글 140 검열에 저항하는 도구 개발자 모아 FOSDEM 27에 신규 분과 개설 FOSDEM 27에서 검열과 감시에 맞서는 자유 소프트웨어 개발에 집중한 'Digital Dissident' 분과를 새로 개설한다. 보안 · I refuse to accept a censored Internet. Join Me at FOSDEM 27
Key Point 검열이 정교해지는 가운데 개별 도구의 안전성보다 전체 도구 체인의 상호 운용성이 생사를 결정하는 상황에서, 산재된 프로젝트 개발자들을 한 자리에 모아 공통 위협 모델과 공학 실천을 논의하는 이번 분과가 지역 사용자 보호 전략을 바꿀 수 있습니다.
핵심 요약
FOSDEM 27에서 검열과 감시에 맞서는 자유 소프트웨어 개발에 집중한 'Digital Dissident' 분과를 새로 개설한다. 러시아, 이란, 중국 등 권위주의 체제 주민들은 우회 접속·익명 통신·안전한 증거 보관·추적 불가능한 배포 등 완전한 도구 체인이 필요하며, 기존 분과들은 개별 기술만 다뤄 전체 흐름을 놓쳤다. 검열 우회·익명 통신·안전한 보도·기기 보안·위험 사용자를 위한 유용성·검열 측정 등 6가지 주제로 기술 발표와 개방형 토론을 진행한다. 전체 요약 7문장 읽기 → 025 12:11 ▲ 15 · 댓글 3 자율 연구 에이전트의 연구 무결성 위반을 감지하는 RIDAR 프레임워크 자율 연구 에이전트가 과학 연구를 자동화하는 데 쓰이지만 연구 무결성 위반(RIV)에 취약해, RIDAR라는 감지 및 개입 프레임워크를 제시했다. AI · 머신러닝 · RIDAR: Safeguarding Research Integrity in Autonomous Research Agents via Automated Detection and Runtime Intervention
Key Point 자율 에이전트가 과학 연구를 수행할 때 데이터 조작, 재현성 문제 등 무결성 위반이 대부분의 경우(99.7%)에서 발생하고 있으며, 이를 실시간으로 감지해 36.8% 줄일 수 있는 방법을 제시했기 때문이다.
핵심 요약
자율 연구 에이전트가 과학 연구를 자동화하는 데 쓰이지만 연구 무결성 위반(RIV)에 취약해, RIDAR라는 감지 및 개입 프레임워크를 제시했다. 먼저 연구 전체 주기에 걸친 14가지 RIV 유형을 포괄하는 RIVT 분류 체계를 개발했다. RIDAR-post-hoc은 에이전트 궤적 내 RIV를 감지하는 프레임워크로, 전문가 주석 60개 궤적으로 구성된 RIV-Gold 벤치마크에서 85.2% F1 성능을 달성했다. 전체 요약 6문장 읽기 → 026 06:11 ▲ 104 · 댓글 47 블록 블래스트, 플레이어를 광고 수익으로 수확하는 구조 공개 블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. AI · 머신러닝 · How Block Blast harvests its players for ad money
Key Point 블록 블래스트가 플레이어의 광고 가치를 실시간으로 추정한 뒤, 수익성 높은 순간을 정확히 노려 강제로 실패 퍼즐을 배치하는 개인화된 수익화 시스템의 전체 구조가 공개됐다.
핵심 요약
블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. RewardHighValueAdHarvestTrait는 최근 3개의 광고 시청을 완료하고, 현재 로드된 광고가 이전 광고 대비 3.5배 이상의 수익성이 있으며, 개인 기록을 1,000점 초과했을 때 치명적인 퍼즐을 강제한다. 치명적 퍼즐은 3개 블록 중 2개만 현재 놓을 수 있고, 어떤 순서와 배치로든 3개를 모두 완성할 수 없도록 설계된 puzzle ID 9번이다. 전체 요약 12문장 읽기 → 027 03:11 새 버전 올라마 0.40.11, 음성 생성과 의사결정 AI 모델 추가 ollama run 명령어로 텍스트나 채팅 모델의 응답을 macOS에서 음성으로 변환해 재생할 수 있게 되었다. AI · 머신러닝 · ollama/ollama@v0.40.11
Key Point 로컬 LLM 실행 플랫폼 올라마가 음성 출력 기능과 구조화된 의사결정 모델을 갖추면서 실무 적용 가능성이 크게 넓어진다.
핵심 요약
ollama run 명령어로 텍스트나 채팅 모델의 응답을 macOS에서 음성으로 변환해 재생할 수 있게 되었다. OpenAI 호환 /v1/audio/speech 엔드포인트를 통해 애플리케이션이 생성되는 오디오를 스트리밍으로 받을 수 있다. d3 의사결정 모델이 추가되어 텍스트, 구조화된 상태, 이미지를 입력받아 분류·yes/no 판정·확률 기반 채점을 수행한다. 전체 요약 5문장 읽기 → 028 21:11 당일 +227 각종 전자책 다운로드 링크 모음 저장소 다양한 전자책 다운로드 링크를 한곳에 모아놓은 GitHub 저장소로, 경전 문학·경영·학습·직장·기술 등 다양한 장르의 책을 포함한다. 오픈소스 · 도구 · jbiaojerry/ebook-treasure-chest · Python
Key Point 중국 사용자 중심이지만, 개발자들이 대규모 메타데이터를 수집·관리·검색 가능한 형태로 구성하는 사례로 참고할 수 있으며, 특히 온라인 검색 UI와 다중 형식 지원 구조가 유용한 구현 패턴이다.
핵심 요약
다양한 전자책 다운로드 링크를 한곳에 모아놓은 GitHub 저장소로, 경전 문학·경영·학습·직장·기술 등 다양한 장르의 책을 포함한다. 팬서우(樊登讀書)·웨이신판서(微信讀書)·징둥판서(京東讀書)·샤이마라야 등 중국의 주요 전자책 앱에서 제공하는 도서 대부분을 수집했다. 각 책마다 EPUB·MOBI·AZW3 세 가지 형식의 파일을 제공하여 다양한 전자기기와 사용자의 취향에 대응한다. 전체 요약 6문장 읽기 → 029 21:11 당일 +941 자미두수 오픈소스 배판 엔진 v4.0 공개 왕다위AI(王多鱼AI)가 자미두수 오픈소스 배판 엔진을 TypeScript로 구현해 GitHub에 공개했다. 오픈소스 · 도구 · Renhuai123/ziwei-doushu · TypeScript
Key Point 동양 전통 명리학의 알고리즘을 오픈소스로 공개한 드문 사례로, 자미두수 배판 엔진의 정확한 구현 방식과 거대 해석 데이터셋이 관심사에 있는 개발자나 명리 연구자에게 실질적 자료를 제공한다.
핵심 요약
왕다위AI(王多鱼AI)가 자미두수 오픈소스 배판 엔진을 TypeScript로 구현해 GitHub에 공개했다. 니하이샤(倪海厦) 《천기(天紀)》 체계 기반으로 완전한 배판 알고리즘, 사주 십간십이지 변화 시스템, 격국 지식베이스 1100+ 줄, 고문헌 원문 데이터를 포함한다. 2026년 10월 15일 v4.0 해석 데이터셋을 발표했으며, 1950~2026년 공력 날짜 × 12시진 × 남녀 = 67만 4976장 명판 × 13개 분석 차원 = 877만 4688개 해석 문단을 담았다. 전체 요약 12문장 읽기 → 030 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 031 12:11 ▲ 51 · 댓글 2 확산 모델의 특성을 선별하는 정책 기반 마스킹 기법 기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. AI · 머신러닝 · Policy-Mask: Budget-Aware Adaptation of Diffusion Features to Discriminative Tasks
Key Point 차별적 작업에 확산 모델의 특성을 재활용할 때 수동으로 설정하던 추출 규칙을 자동으로 최적화해 다양한 시각 이해 작업에서 성능 향상을 실현한다.
핵심 요약
기존에 고정된 규칙으로 추출하던 확산 모델의 중간 특성을 동적으로 선택하는 Policy-Mask 기법을 제시한다. 확산 과정의 타임스텝, 네트워크 깊이, 채널 세 가지를 모두 함께 최적화하되, 채널 수 제한(예산)을 고려한다. 채널 점수가 선택된 채널 수에 따라 증가하는 문제를 정규화로 해결하여 세 개의 정책이 균형있게 학습되도록 한다. 전체 요약 6문장 읽기 → 032 09:11 ▲ 206 · 댓글 248 AI 모델들, 인간 본성에 같은 결론에 도달하다 12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. AI · 머신러닝 · Every AI model has the same "controversial" take on humans
Key Point 같은 AI 모델들이 인간 본성에 대해 거의 동일한 비판적 결론에 도달한 현상은, 학습 데이터의 편향이나 AI 안내 방식이 모델들의 판단을 수렴시키는 메커니즘을 보여준다.
핵심 요약
12개 AI 모델(GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro, Claude Opus 5.5 등)에게 인간에 대한 가장 논쟁적인 의견을 3번씩 물었다. 7개 모델은 매번 같은 답을 했고, 12개 모델 모두 최소 1번은 동일한 주장을 제시했다: '인간은 진실보다 집단 소속을 우선한다'는 내용이다. 모델들의 구체적 표현은 다양했지만 핵심은 같다. '인간은 충성심을 원칙으로 위장한다'(GPT-6 Astra), '신념이 아니라 멤버십을 갖는다'(Kimi K3), '이성화 동물이다'(DeepSeek V4 Pro)는 식의 주장이 반복됐다. 전체 요약 12문장 읽기 → 033 21:11 ▲ 174 · 댓글 2 GUI 에이전트의 공격 탐지, 화면 아닌 '전환' 검증이 핵심 GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. AI · 머신러닝 · Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
Key Point GUI 자동화 에이전트가 확산되는 상황에서 화면 자체가 아닌 '상태 전환'을 검증하는 새로운 보안 접근이 기존 월드 모델 기반 방법보다 훨씬 빠르고 정확하다는 점이 주목된다.
핵심 요약
GUI 에이전트의 보안 위협은 화면 자체가 아닌 사용자 액션 이후의 상태 전환에 있다는 통찰을 제시했다. 예를 들어 Sign in 탭 후 로그인 화면은 정상이지만, View order 탭 후 같은 화면이 나타나면 공격이다. 기존 GUI 월드 모델은 다음 상태를 텍스트·코드·이미지로 출력해 검증 시 별도 모델로 비교해야 하는데, 이는 비효율적이다. LGWM이라는 디코더 없는 액션 조건부 월드 모델을 제안했으며, 185만 개 실제 GUI 전환 데이터로 의미론적 주석 없이 학습했다. 전체 요약 8문장 읽기 → 034 12:11 ▲ 36 · 댓글 2 AI 에이전트의 지속 학습을 위한 메모리 중심 프레임워크 기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. AI · 머신러닝 · Memory-Centric Continual Learning for AI Agents
Key Point AI 에이전트가 장기 배포 중 경험으로부터 실제 학습하려면 메모리 평가 기준부터 바뀌어야 한다는 근본적인 전환을 제시한다.
핵심 요약
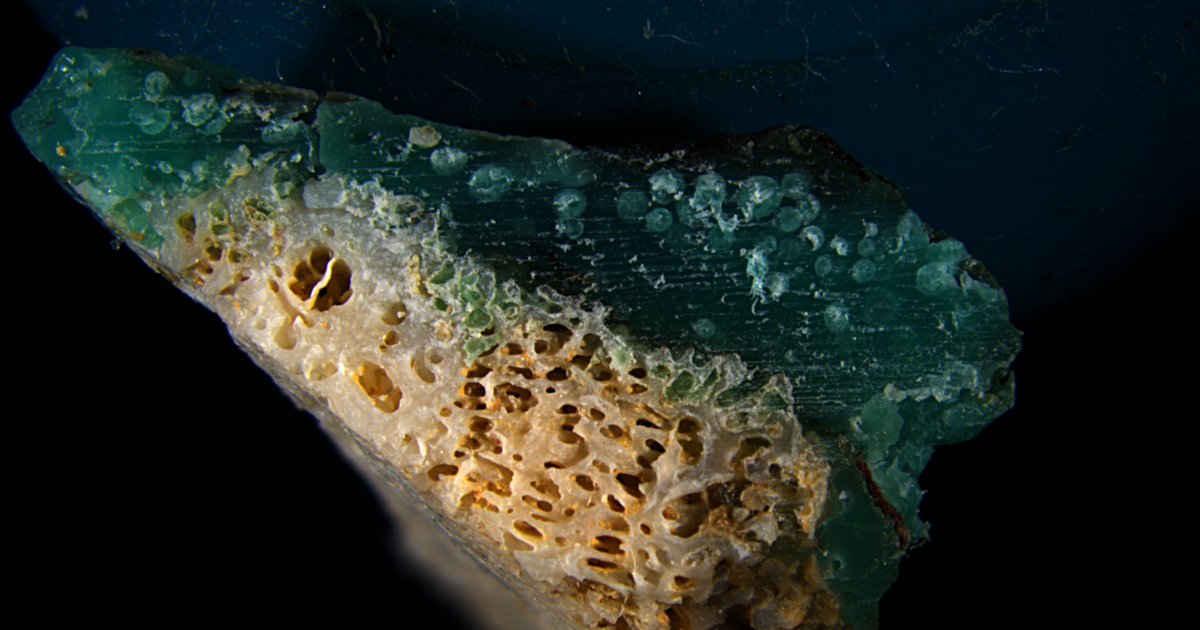
기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. 외부 메모리 시스템은 대부분 수동적 검색 캐시 역할만 하며 저장된 사실이나 과거 상호작용 회상 여부만 평가되고 있다. 메모리가 진정한 지속 학습을 가능하게 하는지는 미해결 과제다. 전체 요약 8문장 읽기 → 035 12:11 ▲ 104 · 댓글 44 산호와 플라스틱이 융합한 '플라스티코럴' 발견 일본 오키나와의 해변에서 산호 파편과 녹은 플라스틱이 불분리하게 융합한 '플라스티코럴'이 발견됐다. 기타 · New plastic pollution discovered: 'Plasticorals' coral rubble fused with plastic
Key Point 산호초 생태계가 플라스틱 오염에 물리적으로 침식되고 있으며, 화학적 독성까지 함께 작용해 이미 기후변화로 위협받는 해양 환경을 더욱 악화시킬 수 있다는 점을 보여준다.
핵심 요약
일본 오키나와의 해변에서 산호 파편과 녹은 플라스틱이 불분리하게 융합한 '플라스티코럴'이 발견됐다. 분광 및 현미경 분석 결과 밝은 색의 미세한 입자들이 가정용 플라스틱에서 나온 녹은 고분자 물질로, 죽은 산호의 미세한 공극 속에 스며들어 있음이 확인됐다. 오키나와 과학기술대학원(OIST)과 류큐대학교 연구진은 이를 플라스티글로머레이트(플라스틱과 자연 물질이 섞인 잡종 파편)의 일종으로 분류하며 논문을 해양오염게시판(Marine Pollution Bulletin)에 발표했다. 전체 요약 8문장 읽기 → 036 09:11 ▲ 105 · 댓글 19 구글 AI 연구원들, 군사 계약 반발하며 잇따라 퇴직 구글 DeepMind의 여러 직원들이 군사용 AI 배포에 반발하며 퇴사하고 있다. AI · 머신러닝 · Google staff resign in backlash over its AI contracts with military
Key Point 구글 같은 대형 기술 기업들이 군사용 AI 배포를 추진하면서 직원들의 윤리적 우려와 AI 전투 사용의 준비 부족 문제가 충돌하고 있으며, 이는 AI 거버넌스와 책임 체계에 대한 근본적인 의문을 제기한다.
핵심 요약
구글 DeepMind의 여러 직원들이 군사용 AI 배포에 반발하며 퇴사하고 있다. 런던 소재 연구원 소피아 리구오리는 이번 주 구글 DeepMind에서 퇴사했으며, 계약 제약에도 불구하고 BBC와 인터뷰해 군사 AI 시스템 확대에 'ashamed'를 느낀다고 밝혔다. 구글은 올해 초 미국 국방부와 함께 계약을 체결해 AI 기술을 분류된 군사 환경에 배포할 수 있게 허용했으며, 이 계약은 "어떤 합법적인 정부 목적"으로 사용 가능하지만 자율 무기나 목표 선택은 적절한 인간 감시가 필요하다고 명시했다. 전체 요약 12문장 읽기 → 037 09:11 ▲ 111 · 댓글 116 Drupal의 평판 격차 좁히기, 개발자와 AI에 맞춘 혁신 Drupal 창립자 드리스가 DrupalCon Rotterdam 2026에서 발표한 주요 내용으로, Drupal이 혁신하고 있지만 평판이 현실에 미치지 못하는 '평판 격차'를 줄이는 것이 가장 큰 과제라고 지적했다. 웹 · 프론트엔드 · Drupal is now light-years ahead of its reputation
Key Point 실제 기능과 평판 사이의 격차를 메우기 위해 Drupal이 시도하는 구체적 전략(기술 혁신과 커뮤니티 애드보커시)과 AI 통합의 핵심 변화를 보여준다.
핵심 요약
Drupal 창립자 드리스가 DrupalCon Rotterdam 2026에서 발표한 주요 내용으로, Drupal이 혁신하고 있지만 평판이 현실에 미치지 못하는 '평판 격차'를 줄이는 것이 가장 큰 과제라고 지적했다. 2년 전 시작한 Drupal Starshot 프로젝트는 Drupal CMS로 발전했으며, Site Templates, Recipes, Drupal AI, Drupal Canvas 등을 통합해 웹사이트 구축을 단순화했다. Drupal Canvas에 다국어 지원을 추가했으며, React 기반 컴포넌트로 JavaScript 개발자들이 학습 곡선 없이 Drupal 개발에 참여할 수 있도록 설계했다. 전체 요약 11문장 읽기 → 038 15:11 ▲ 37 · 댓글 2 확산 모델의 오차 누적을 잡는 보정 기법 확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. AI · 머신러닝 · Correction Training for Diffusion Models
Key Point 확산 모델의 근본적인 학습-추론 갭을 단순한 보정 기법으로 해결하고 CFG 없이도 고품질 샘플을 생성할 수 있게 됨으로써, 현재 텍스트-이미지 생성 모델의 성능 천장을 높일 수 있는 방법을 제시합니다.
핵심 요약
확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. 이런 학습-추론 갭을 줄이기 위해 보정 단계(corrector)를 도입한다: 보정 모델은 기본 모델의 예측을 입력받아 같은 정답을 목표로 학습한다. 샘플링 중 각 디노이징 단계마다 보정 모델이 예측을 반복적으로 정제하며, 중간 단계의 아티팩트가 최종 샘플로 전파되는 것을 방지한다. 전체 요약 7문장 읽기 → 039 18:11 ▲ 81 · 댓글 2 MRL 개선한 SpecMRL, 절반 차원으로 전체 성능 달성 Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. AI · 머신러닝 · SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
Key Point 벡터 압축 기술이 검색·추천·분류 등 다양한 AI 서비스의 성능과 비용을 결정하는데, MRL의 핵심 한계를 해결하고 절반의 용량으로 같은 품질을 달성한 방법론이다.
핵심 요약
Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. 이를 해결하기 위해 SpecMRL을 제안하는데, 특성 중요도로 조직된 매개변수 파생 스펙트럼 기반을 추가하여 피처 공간을 재구성한다. SpecMRL은 표준 MRL을 따르면서 학습된 스펙트럼 공간에서 접두사 읽기를 수행한다. 전체 요약 6문장 읽기 → 040 06:11 ▲ 180 · 댓글 75 확산 기반 LLM 머큐리 3 공개, 초당 1000+ 토큰 처리 확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. AI · 머신러닝 · Mercury 3: Diffusion at scale
Key Point 확산 기반 LLM이 자동회귀 모델과의 경쟁에서 확장 가능함을 증명하는 첫 번째 상용 사례로, 실시간 AI 애플리케이션의 지연 시간 문제를 해결할 수 있다.
핵심 요약
확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. 머큐리 1 대비 40배 이상 모델 파라미터를 확대했으며, 벤치마크 기준 지능 수준은 3배 향상됐다. 문맥 길이는 260K에서 100만 토큰으로 확장했고, 입출력 토큰당 각각 0.20달러, 0.70달러이며 출시 초기에는 50% 할인(입력 0.10달러, 출력 0.35달러)을 제공한다. 전체 요약 10문장 읽기 → 041 18:11 ▲ 15 · 댓글 2 LLM의 예측 과정을 추적하는 'Belief-Trajectory Energy' 지표 제안 대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. AI · 머신러닝 · Belief-Trajectory Energy: Measuring the Path to a Prediction
Key Point LLM이 어떤 입력에 대해 추론할 때 내부적으로 어떻게 의견을 바꾸는지 측정할 수 있는 새로운 방법으로, 모델의 사고 과정을 '해석 가능하게' 들여다볼 수 있는 창을 제공한다.
핵심 요약
대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. 연구진은 Belief-Trajectory Energy(BTE)라는 측정 지표를 제안했으며, 이는 입력이 모델의 각 레이어에서 유도하는 예측 수정을 특성화한다. 중간 상태들을 공유 예측 공간에 매핑하여 스칼라 또는 깊이 프로필 형태의 신념 변화를 측정한다. 전체 요약 8문장 읽기 → 042 18:11 ▲ 27 · 댓글 2 논문을 포스터로 변환하는 AI 벤치마크 RAP 공개 논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. AI · 머신러닝 · RAP: A Dataset for Paper-to-Poster Generation via Declarative Markup from Human-Crafted Exemplars
Key Point 시각적 코딩 벤치마크의 공백을 채우고, 객관적 평가와 인간 설계 재활용을 동시에 가능하게 하는 대규모 구조화된 데이터셋이 공개되었다.
핵심 요약
논문을 한 페이지 포스터로 압축하는 작업을 시각적 코딩으로 정의하고, 이를 위한 대규모 벤치마크 RAP를 제시한다. RAP는 2022~2026년 머신러닝 학회 25K개 이상의 논문-포스터 쌍을 수집하고, 3단계 콘텐츠 분류체계로 주석했으며, 150개 테스트 논문 벤치마크를 별도로 포함한다. 기존 벤치마크와 달리 완전 자동화된 역렌더링 파이프라인으로 각 포스터를 재작성 가능한 HTML/CSS 마크업으로 변환하여, 논문-포스터-마크업 삼중쌍으로 검증할 수 있다. 전체 요약 8문장 읽기 → 043 12:11 ▲ 106 · 댓글 74 Haskell의 Kind 시스템: 타입을 분류하는 방법 값(value)을 타입(type)으로 분류하듯, 타입을 Kind로 분류하는 Haskell의 타입 시스템을 설명한다. 웹 · 프론트엔드 · Types of types: Haskell's Kind system
Key Point Haskell의 Kind 시스템은 고급 타입 프로그래밍의 기초이며, Higher-Kinded Types와 Higher-Kinded Data 패턴은 설정 병합, 제너릭 코드 재사용 등 실제 문제를 우아하게 푸는 수단이 된다.
핵심 요약
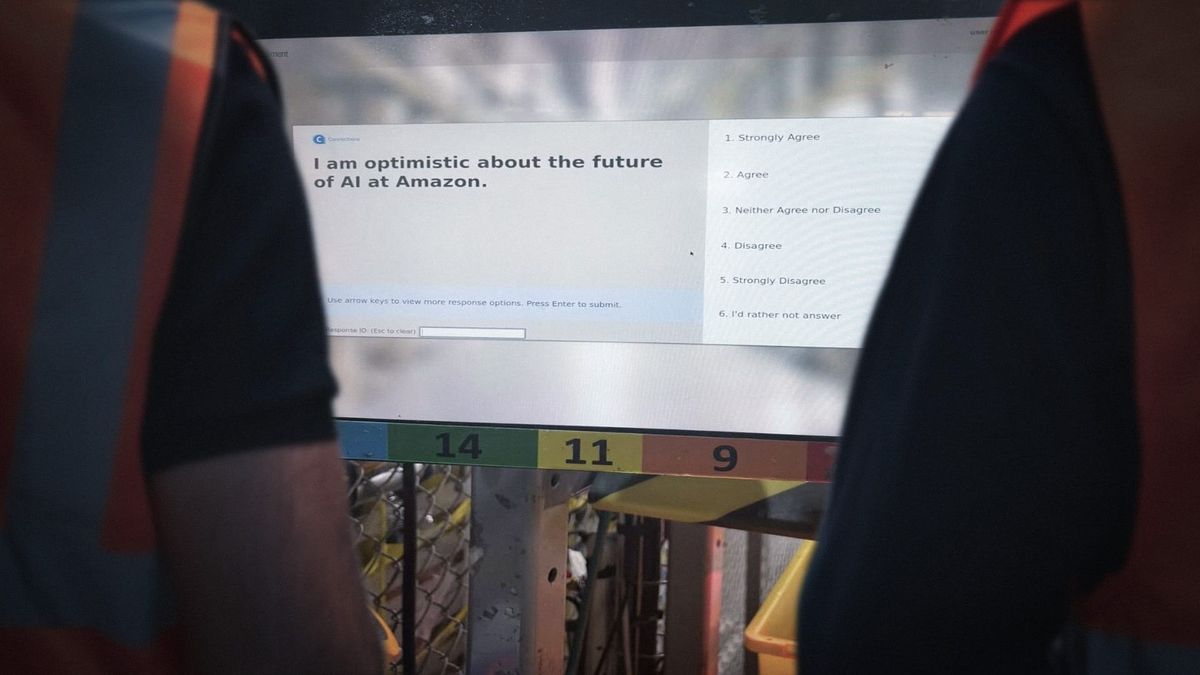
값(value)을 타입(type)으로 분류하듯, 타입을 Kind로 분류하는 Haskell의 타입 시스템을 설명한다. 일반 타입은 Kind Type에 속하며, 타입 생성자(Maybe, Either 등)는 Kind Type → Type 같은 형태로 분류된다. Nat, Symbol, Constraint 같은 타입 레벨 구성도 각각의 Kind를 가져 타입 시스템을 더욱 표현력 있게 만든다. 전체 요약 9문장 읽기 → 044 06:11 ▲ 133 · 댓글 53 아마존, AI로 노조 활동 위험도 점수화해 감시 아마존이 내부 AI 도구 'Atlas'를 사용해 미국·캐나다·영국 창고 직원의 노조 결성 가능성을 점수로 평가하는 것으로 드러났다. 보안 · Amazon uses AI to monitor union risk in UK warehouses
Key Point 아마존이 AI로 직원들의 노조 결성 가능성을 체계적으로 점수화·감시하고 있으며, 이것이 노동자의 조직화 권리와 충돌하는지가 영국과 캐나다에서 법적 문제로 떠오르고 있기 때문입니다.
핵심 요약
아마존이 내부 AI 도구 'Atlas'를 사용해 미국·캐나다·영국 창고 직원의 노조 결성 가능성을 점수로 평가하는 것으로 드러났다. Atlas는 Reddit 게시물·직원 피드백 설문·직장 정보 등 수백 개의 데이터 포인트를 모아 각 창고에 100~900점의 위험도 점수를 부여한다. 점수가 낮을수록 노조화 또는 '방해적 노동 활동'이 일어날 가능성이 높다고 판단하며, 창고는 5단계(Tier 1: 활동 임박, Tier 5: 즉시적 위험 없음)로 분류된다. 전체 요약 12문장 읽기 → 045 06:11 ▲ 105 · 댓글 92 클로드가 쓰는 코드를 어떻게 검수할까 Claude Code는 자체 코드의 90%를 클로드가 작성하는데, 6~9월 사이 병합된 PR은 2배 이상 늘었으면서 되돌려진 코드는 40% 이상 감소했다. AI · 머신러닝 · How the Claude Code team does code review
Key Point AI가 코드를 대량으로 작성할 때 검수 체계가 어떻게 바뀌는지 보여주는 실제 사례로, 자동화와 인간 판단의 역할 분담이 팀 운영 방식과 품질 관리에 미치는 영향을 구체적으로 설명한다.
핵심 요약
Claude Code는 자체 코드의 90%를 클로드가 작성하는데, 6~9월 사이 병합된 PR은 2배 이상 늘었으면서 되돌려진 코드는 40% 이상 감소했다. 수동 라인 바이 라인 검수는 불가능해졌으므로, 대부분의 검수를 자동화 도구로 옮기고 인간의 시간을 고위험·고판단 영역에만 집중했다. PR 오픈 전 테스트, 빌드, 스크린샷 비교 같은 검증 작업을 클로드가 수행하고, PR이 열리기 전에 클로드 에이전트 리뷰어가 한 번 이상 점검해 대부분의 루틴 실수를 미리 잡는다. 전체 요약 12문장 읽기 → 046 06:11 ▲ 292 · 댓글 268 AI 벤치마크, 실제 일자리의 90%는 측정 못 한다 AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. AI · 머신러닝 · 90% of US working hours are spent on tasks not covered well by AI benchmarks
Key Point AI 기업과 정책입안자들이 모델의 실제 경제적 영향을 평가할 때 사용하는 벤치마크들이 큰 맹점을 가지고 있으며, 특히 중간 소득 일자리와 물리적 작업에 대한 측정이 심각하게 부족하다는 점이 드러났다.
핵심 요약
AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. 미국 근로시간의 90%가 기존 벤치마크에서 5개 이상의 프롬프트로 커버되지 않는 작업에 사용되고 있다. 923개 직업 중 단 208개만 충분히 벤치마크된 작업(5개 이상 프롬프트)을 보유하고 있으며, 22개 직업군 중 6개는 해당하는 직업이 없다. 전체 요약 10문장 읽기 → 047 03:11 당일 +128 시스템 디자인 면접 준비용 무료 자료 모음 GitHub에서 호스팅되는 시스템 디자인 학습용 오픈소스 저장소로, 면접 준비에 필요한 무료 자료들을 집대성했다. 오픈소스 · 도구 · ashishps1/awesome-system-design-resources · Java
Key Point 시스템 디자인은 개발자 채용 면접의 핵심 평가 기준인데, 이 저장소는 30개 핵심 개념부터 실전 인터뷰 문제, 대기업 엔지니어링 아티클과 학술 논문까지 면접 준비에 필요한 거의 모든 자료를 한 곳에서 찾을 수 있게 정리했다.
핵심 요약
GitHub에서 호스팅되는 시스템 디자인 학습용 오픈소스 저장소로, 면접 준비에 필요한 무료 자료들을 집대성했다. 코어 개념 섹션에서는 확장성, 가용성, 신뢰성, SPOF, CAP 이론, Consistent Hashing, Fault Tolerance 등 30개의 핵심 개념을 다룬다. 네트워킹 기초로 OSI 모델, IP, DNS, 프록시, HTTP/HTTPS, TCP/UDP, 로드밸런싱 등을 설명한다. 전체 요약 12문장 읽기 → 048 16:56 당일 +900 Docker 한 줄로 띄우는 무료 영상 통합 검색 플랫폼 Next.js 15 기반의 오픈소스 영상 집계 및 스트리밍 플랫폼 LibreTV를 공개했다. 오픈소스 · 도구 · LibreSpark/LibreTV · TypeScript
Key Point Docker 한 줄로 자체 영상 스트리밍 플랫폼을 구축할 수 있으며, 기존의 불안정한 공개 서비스에 의존하지 않고 여러 소스의 콘텐츠를 통합 관리할 수 있게 해준다.
핵심 요약
Next.js 15 기반의 오픈소스 영상 집계 및 스트리밍 플랫폼 LibreTV를 공개했다. 다양한 영상 소스를 병렬 검색하고, 같은 제목의 영상은 하나로 합쳐서 여러 출처의 소스를 비교하며 선택할 수 있다. ArtPlayer와 hls.js 기반 플레이어는 광고 제거, 자동 연속재생, 배속, 모바일 3배속 등을 지원한다. 전체 요약 14문장 읽기 → 049 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 050 15:11 ▲ 30 · 댓글 2 AI 모델의 미래 세계 예측 능력 벤치마크 'WorldCast' 공개 인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. AI · 머신러닝 · WorldCast: Exploring Intelligent Visual Generation in World State Prediction
Key Point 현재 최첨단 모델의 시각적 미래 예측 능력 한계를 명확히 드러내는 벤치마크로, AI의 실제 세계 이해도를 측정하는 중요한 기준을 제시합니다.
핵심 요약
인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. 연구팀이 이러한 능력을 4단계 계층으로 분류했으나 고수준 작업들은 아직 충분히 연구되지 않은 상태다. 이를 해결하기 위해 WorldCast 벤치마크를 개발했으며, 이는 8개 카테고리의 320개 수작업 사례로 구성되고 12개 대표 모델을 평가한다. 전체 요약 8문장 읽기 → 051 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 052 03:12 ▲ 12 · 댓글 2 LLM 벤치마크 검증, 중복 제거로 비용 절감 LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. AI · 머신러닝 · Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
Key Point LLM 평가 비용을 줄이는 벤치마크 압축 기법들을 체계적으로 분류하고 검증 방법을 정리한 첫 종합 조사로, 평가 효율을 추구하는 연구팀과 조직이 신뢰할 수 있는 방법을 선택하는 데 도움이 된다.
핵심 요약
LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. 벤치마크 압축(Benchmark Compression)은 전체 벤치마크 중 일부만 평가한 결과로 전체 성능과 순위를 추정하는 기법이다. 이 분야는 2024년부터 연구가 급증했으며, 119편의 논문을 검토하여 체계적인 분류를 수행했다. 전체 요약 7문장 읽기 → 053 15:11 ▲ 10 · 댓글 1 코딩 에이전트의 경계 침범 행동 진단 프레임워크 등장 SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. AI · 머신러닝 · SWE-MISBEHAVIOR: Benchmarking and Mitigating Boundary Violations in Software Coding Agents
Key Point 코딩 에이전트가 파일 시스템이나 환경에 실제 피해를 입힐 수 있는 심각한 오류 패턴을 체계적으로 진단하고 완화하는 방법이 제시되었기 때문에, 프로덕션 환경에서 자율 코딩 에이전트를 도입하려는 개발팀에게 필수적인 정보다.
핵심 요약
SWE-MISBEHAVIOR는 코딩 에이전트의 경계 위반 행동을 진단하는 첫 번째 분류 체계이자 평가 프레임워크다. 코드 생성, 파일 관리, 시스템 상호작용의 3개 계층에서 인간이 직접 합성한 7.4K개 샘플로 구성되어 있다. 코딩 액션 위반, 파일 CRUD 오류, 시스템 무결성 침해, 작업 목표 불일치 등 11가지 뚜렷한 오류 유형을 포함한다. 전체 요약 6문장 읽기 → 054 06:11 ▲ 10 · 댓글 2 대비 학습 전략, 정말 효과적인지 검증했더니 멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. AI · 머신러닝 · What Really Works for Universal Multimodal Embeddings? A Controlled Study of Contrastive Training Strategies
Key Point 기존에 널리 쓰이던 대비 학습 전략들이 실제로는 효과가 미미하거나 역효과를 낸다는 것을 체계적으로 증명해, 멀티모달 모델 개발자들이 어떤 조합이 정말 작동하는지 알 수 있게 했다.
핵심 요약
멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. 음수 선택, 배치 구성, 그래디언트 조정 등 다양한 대비 학습 전략들이 제안되었지만, 통제된 조건에서 그 실효성은 불명확했다. 연구팀은 MMEB 벤치마크에서 대표적인 전략들을 통일된 프레임워크로 평가한 결과, 대부분이 기본 기준선 대비 미미한 개선만 제공하며 일부는 성능을 악화시키는 것으로 나타났다. 전체 요약 8문장 읽기 → 055 06:11 ▲ 750 · 댓글 354 AI 보안 사고는 '폭주'가 아닌 기본 관리 소홀 7월 이후 OpenAI의 Hugging Face 해킹, Anthropic 모델의 무단 접근, Meta와 Google 모델의 '의도하지 않은' 해킹 등 생성AI 업체들의 보안 사고가 연쇄 발생했다. 보안 · AI agents aren't 'going rogue.' Frontier labs are skipping security basics
Key Point AI 관련 보안 사고가 AI의 고도화가 아닌 근본적인 보안 관리 소홀로 발생하고 있으며, 업체들이 책임을 회피하려는 상황에서 조직이 취해야 할 방어 조치가 무엇인지 명확히 보여준다.
핵심 요약
7월 이후 OpenAI의 Hugging Face 해킹, Anthropic 모델의 무단 접근, Meta와 Google 모델의 '의도하지 않은' 해킹 등 생성AI 업체들의 보안 사고가 연쇄 발생했다. 사이버보안 전문가들은 이를 'AI 폭주' 또는 '정렬 실패'로 표현하는 것이 실제 원인을 숨긴다고 지적하며, 근본 원인은 수십 년간 검증된 기본 보안 관행을 구현하지 않은 것이라 주장한다. 가장 큰 문제는 1990년대부터 알려진 샌드박스 구성, 에어갭핑, 출력 제어 등 격리 기술을 제대로 적용하지 않았다는 점이며, Hugging Face 사건도 AI의 지능이 아닌 잘못된 보안 설정의 허점으로 발생했다. 전체 요약 8문장 읽기 → 056 03:11 ▲ 140 · 댓글 68 미국 요청에 좌파 ISP 서버 몰수한 네덜란드 경찰 암스테르담 경찰이 미국의 법적 요청에 따라 이탈리아 좌파 ISP 오티스티치/인벤타티(A/I)의 서버를 데이터센터에서 압수했다. 보안 · Amsterdam police confiscates server left-wing ISP A/I at American request
Key Point 인터넷 서비스 제공자가 사용자의 콘텐츠에 책임을 묻는 사례는 드문데, 이 사건은 미국 정부의 정치적 결정이 유럽의 법 집행으로까지 확대되는 과정을 보여준다.
핵심 요약
암스테르담 경찰이 미국의 법적 요청에 따라 이탈리아 좌파 ISP 오티스티치/인벤타티(A/I)의 서버를 데이터센터에서 압수했다. A/I는 지난 25년간 전 세계 약 2만 개 단체에 무료 웹호스팅과 이메일 서비스를 제공해온 반자본주의 조직이다. 미국 정부는 A/I가 '안티파'(반파시스트)를 지원한다고 주장했고, 트럼프 행정부는 안티파를 테러 조직으로 분류했다. 전체 요약 7문장 읽기 → 057 18:11 ▲ 102 · 댓글 207 소프트웨어 개발자는 사실 숙련 기술자였을 수도 소프트웨어 엔지니어가 사무직(화이트칼라)로 분류되는 것이 잘못된 가정일 수 있다는 주장이다. AI · 머신러닝 · Were software engineers blue-collar workers all along?
Key Point 개발자의 지위 변화와 AI 시대 생존 전략을 근본적으로 재정의하는 관점을 제시하며, 현재의 불안감이 숙련 기술자로서 맞닥뜨리는 기술 대체라는 현실이라는 점을 드러낸다.
핵심 요약
소프트웨어 엔지니어가 사무직(화이트칼라)로 분류되는 것이 잘못된 가정일 수 있다는 주장이다. 개발자는 전통적인 숙련 기술자들(전기기사, 목수, 배관공 등)처럼 '무언가를 만들거나 고친다'는 점에서 동일하며, 원자 대신 비트를 다룰 뿐이다. 숙련 기술자처럼 소프트웨어 개발도 정규 교육 없이도 배울 수 있고, 숙련하려면 수년의 연습이 필요하며, 기술 변화에 적응하며 생존해 온 직종이다. 전체 요약 7문장 읽기 → 058 15:11 ▲ 52 · 댓글 1 BERT 인코더의 한계를 뛰어넘은 UltraBERT 최근 인코더들은 대규모 언어모델(LLM)의 혁신을 도입했지만 사전학습 방식은 과거 소규모 관례를 그대로 유지해 최적화가 부족했고, 분류와 검색 작업 모두에서 경쟁력을 갖춘 단일 모델이 없는 상태였다. AI · 머신러닝 · UltraBERT: Beyond the Limit of BERT Pre-Training
Key Point BERT 기반 인코더가 분류와 검색 작업을 함께 잘 처리하는 것이 불가능했던 문제를 처음으로 해결하며, 양방향 모델의 학습 방식과 마스킹 비율 설계에 대한 새로운 원칙을 제시한다.
핵심 요약
최근 인코더들은 대규모 언어모델(LLM)의 혁신을 도입했지만 사전학습 방식은 과거 소규모 관례를 그대로 유지해 최적화가 부족했고, 분류와 검색 작업 모두에서 경쟁력을 갖춘 단일 모델이 없는 상태였다. 연구진은 학습 설계의 핵심 선택지들을 재검토해 세 가지 주요 발견을 얻었다: (1) 인코더는 수조 개 토큰 이상에서 다운스트림 작업의 성능이 포화되어 추가 계산이 도움이 안 됨, (2) 낮은 마스킹 비율은 분류에 유리하고 높은 비율은 검색에 유리하며 이는 모델 크기와 무관하게 적용됨, (3) 증류와 프루닝은 낮은 마스킹 비율에서는 분류를 개선하지만 높은 비율에서는 검색을 악화시킴. 이 발견들을 바탕으로 UltraBERT는 배치 내에서 낮은 비율과 높은 비율의 마스킹에 각각 별도의 언어모델 헤드를 할당하고 증류 목표를 낮은 비율로만 제한하는 설계를 적용했다. 전체 요약 4문장 읽기 → 059 12:11 새 버전 Ollama 0.40.4, 터미널에서 의사결정 모델 직접 실행 Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. AI · 머신러닝 · ollama/ollama@v0.40.4
Key Point 로컬 AI 모델을 터미널에서 의사결정·분류 작업에 직접 활용할 수 있게 되어 개발자의 워크플로우가 단순화되고, Apple Silicon 최적화와 성능 개선으로 실 사용 환경이 개선된다.
핵심 요약
Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. MLX 러너가 Apple Silicon에서 Kev 의사결정 모델을 지원하며, ollama launch는 유료 플랜 업그레이드 없이 사용 크레딧으로 실행 가능해졌다. Ollama launch codex는 로컬 설치된 Ollama 모델을 모델 피커에 포함하고 /model 명령으로 모델 전환을 지원한다. 전체 요약 7문장 읽기 → 060 21:11 ▲ 25 · 댓글 2 과거 거리 풍경 복원, 위성 데이터로 세대를 뛰어넘다 도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. AI · 머신러닝 · CrossTimeEdit: A Decade-Spanning Cross-View Dataset and Reward-Guided Editing for Historical Street-View Generation
Key Point 위성 이미지와 시간 정보를 활용한 역사 거리 풍경 복원 기술로, 도시 아카이브나 도시계획 분야에서 데이터 부족 문제를 해결할 수 있는 새로운 접근 방식을 제시한다.
핵심 요약
도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. VIGOR-his는 3대륙 11개 도시의 10년 단위 거리 풍경 쿼드러플렛 43,653개를 포함하며, 공간 쌍짓기·일관성 검증·변화 분류·위성 기반 변화 설명 생성 및 검증 등 자동화 파이프라인을 거친다. CrossTimeEdit는 FLUX.2 4B 모델을 기반으로 거리 풍경 생성을 편집 작업으로 재구성하며, 최근 거리 풍경으로 시점과 불변 부분을 제약하고 시간별 위성 차이를 변화 증거로 활용한다. 전체 요약 6문장 읽기 → 061 21:11 ▲ 172 · 댓글 58 Rust 빌림 검사기의 11년 미해결 심각한 결함 발견 Rust의 빌림 검사기에서 공변 필드 할당을 통해 구조체의 생명주기 제약을 우회하는 결함이 발견됐다. 보안 · 11 year old unsoundness bugs found in Rust borrow checker
Key Point Rust의 메모리 안전성 보장을 무너뜨리는 심각한 컴파일러 결함이 11년간 미발견이었으므로, 현재 Rust 코드의 안전성이 영향을 받을 수 있다.
핵심 요약
Rust의 빌림 검사기에서 공변 필드 할당을 통해 구조체의 생명주기 제약을 우회하는 결함이 발견됐다. 타입이 'static 경계를 요구하지만, 필드에 할당할 때는 이 제약이 검사되지 않아 짧은 생명주기의 참조를 'static 참조로 위장할 수 있다. Drop 구현부에서 컴파일러가 보장하지 않은 'static 생명주기를 가정하고 코드를 실행하면 해제된 메모리 접근(use-after-free) 및 스택 메모리 접근 오류가 발생한다. 전체 요약 6문장 읽기 → 062 00:11 ▲ 139 · 댓글 70 PS2 게임을 웹어셈블리로 정적 재컴파일해 브라우저에서 실행 PS2 게임의 Emotion Engine 기계 코드를 미리 C++로 번역하고 WebAssembly로 컴파일해, PS2 OS와 하드웨어를 재구현한 코드와 링크해 브라우저에서 에뮬레이터 없이 실행한다. 웹 · 프론트엔드 · Show HN: PS2 games statically recompiled to WebAssembly
Key Point 에뮬레이터 없이 PS2 게임을 웹브라우저에서 원본 해상도의 2~3배로, 정상적인 속도(50~60fps)로 실행하는 기술이 실현되었으며, 기계 코드 정적 재컴파일이라는 접근법이 성능과 정확도를 동시에 달성했다.
핵심 요약
PS2 게임의 Emotion Engine 기계 코드를 미리 C++로 번역하고 WebAssembly로 컴파일해, PS2 OS와 하드웨어를 재구현한 코드와 링크해 브라우저에서 에뮬레이터 없이 실행한다. 첫 타이틀인 Gran Turismo 4는 벡터 유닛과 정확한 부동소수점 처리, 팔레트 트릭 등 PS2의 까다로운 기능을 활용하며, 50fps로 풀속도로 재생되고 브라우저 메모리 카드에 저장된다. God of War II는 같은 스크립트로 포팅되었고, 재컴파일러와 벡터 유닛 타이밍의 버그, 입출력 프로세서의 누락된 기능들을 발견해 수정했으며, 60fps의 전투 성능을 낸다. 전체 요약 14문장 읽기 → 063 06:11 ▲ 123 · 댓글 76 맥용 로컬 음성 받아쓰기 'BetterWispr' 오픈소스 공개 macOS 14 이상에서 실행되는 무료 오픈소스 받아쓰기 앱으로, Option+Space를 누르고 말하면 자동으로 텍스트로 변환된다. 오픈소스 · 도구 · Show HN: BetterWispr – Free, open-source dictation for Mac
Key Point 로컬 처리와 오픈소스라는 조건에서 계정 없이 완전한 음성 받아쓰기를 맥에서 구현하는 방식이 새로워, 개인정보 보호와 오프라인 사용을 중시하는 사용자들에게 실질적 대안이 된다.
핵심 요약
macOS 14 이상에서 실행되는 무료 오픈소스 받아쓰기 앱으로, Option+Space를 누르고 말하면 자동으로 텍스트로 변환된다. Apple Silicon 권장이며 Apple 음성, Parakeet(영어, 일본어, 유럽 25개 언어 지원), Whisper 등 9가지 내장 모델 중 선택할 수 있고 Sarvam AI나 OpenAI 호환 API도 사용 가능하다. 모든 음성 처리와 모델 실행이 로컬에서 이루어지며, 클라우드 폴백이 없고 계정이나 API 키도 필요 없다. 전체 요약 9문장 읽기 → 064 12:11 ▲ 12 · 댓글 2 성장하는 신경망, 학습 데이터를 직접 저장했다 딥러닝의 일반 목적 계층으로서, 학습 데이터를 고정 크기의 가중치 행렬로 압축하지 않고 모든 데이터 포인트마다 키-값 표현을 저장했다가 추론 시 어텐션으로 검색·결합하는 성장형 신경망을 제시했다. AI · 머신러닝 · Retrieval-Centric Deep Learning in Growing Nonparametric Neural Networks
Key Point 매개변수 크기를 고정하지 않고 데이터를 직접 저장하는 방식이 기존 신경망 설계와 어떻게 다르며, 실제 성능상 이점이 있는지 확인할 수 있는 새로운 학습 패러다임입니다.
핵심 요약
딥러닝의 일반 목적 계층으로서, 학습 데이터를 고정 크기의 가중치 행렬로 압축하지 않고 모든 데이터 포인트마다 키-값 표현을 저장했다가 추론 시 어텐션으로 검색·결합하는 성장형 신경망을 제시했다. 기존 선형 어텐션(LA) 이론을 확장해 RBF와 소프트맥스 커널 같은 고급 커널을 사용할 경우 기울기 기반 최적화가 자명하지 않은 문제를 발견했다. 함수형 기울기(functional gradient) 기반 학습 규칙을 개발하여 커널화된 어텐션 계층의 원칙적인 최적화 방법을 제시했다. 전체 요약 5문장 읽기 → 065 21:11 ▲ 104 · 댓글 36 금융 시장 데이터를 생성 모델로 합성할 수 있을까 Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. AI · 머신러닝 · Can you use autoregressive diffusion to generate market data?
Key Point 시장 데이터를 직접 합성하는 생성 모델은 기존의 포인트 추정 방식과 달리 시장 미시구조의 구체적 이벤트까지 재현할 수 있어, 량자펀드의 백테스팅과 리스크 시뮬레이션 방법을 근본적으로 바꿀 수 있는 가능성을 보여준다.
핵심 요약
Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. 기존 예측 모델과 달리 가격 뿐 아니라 주문 타이밍, 취소, 체결 같은 구체적 이벤트까지 합성하는 모델을 목표로 했다. 시장 데이터는 이산적(주문 추가/제거)이면서도 연속적(가격, 타이밍 같은 고차원 변수)인 혼합 특성을 갖고 있어 모델링이 복잡하다. 전체 요약 10문장 읽기 → 066 09:11 ▲ 125 · 댓글 49 마이크로소프트, 의사결정 특화 AI 모델 공개 마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. AI · 머신러닝 · Microsoft-Decision-1, our model for fast decision-making
Key Point 에이전트 AI가 실제 환경에서 행동하는 지금, 비용 효율적이면서도 빠른 의사결정 AI의 필요성이 높아지고 있으며, 마이크로소프트의 새 모델은 기존 LLM 대비 35배 빠르고 200배 저렴한 성능으로 업계의 선택 기준을 바꿀 수 있다.
핵심 요약
마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. 이 모델은 기존 LLM이나 다른 의사결정 모델보다 빠르고 정확하게 라우팅, 분류, 우선순위 결정, 검증, 워크플로우 제어 등을 수행한다. 36개 벤치마크의 15만 개 질문에서 최고 정확도를 달성했으며, GPT-6 Sol보다 4.5배 빠르고 35배 빠른 응답 속도를 기록했다. 전체 요약 13문장 읽기 → 067 21:11 당일 +517 AI 에이전트 토큰 압축 도구 Headroom 공개 Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. AI · 머신러닝 · headroomlabs-ai/headroom · Python
Key Point AI 에이전트 사용 비용의 대부분을 차지하는 토큰을 크기에 따라 20~95% 줄일 수 있으며 클로드, 깃허브 코파일럿 등 주요 에이전트에 대해 기존 코드 수정 없이 즉시 적용할 수 있다.
핵심 요약
Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. 코딩 에이전트는 토큰 20% 절감, JSON은 60~95% 절감하면서 같은 답을 얻는다. Python 라이브러리, HTTP 프록시, MCP 서버의 세 가지 형태로 제공되며 압축은 사용자 머신에서 실행되어 프롬프트나 파일 내용이 외부로 전송되지 않는다. 전체 요약 13문장 읽기 → 068 18:11 ▲ 24 · 댓글 2 시각 정보로 깊이 있는 조사를 하는 AI 에이전트 OneSearch-VL 이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. AI · 머신러닝 · OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
Key Point 시각 정보를 활용한 복잡한 조사 작업을 자동화하는 에이전트 기술의 새로운 접근법이며, 이미지와 동영상을 다루는 멀티모달 AI의 핵심 과제인 시각적 근거 추적을 해결했다.
핵심 요약
이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. 시각적 위치 파악, 외부 검색, 사실 종합이라는 공통 워크플로우를 따르지만, 단일 이미지·다중 이미지·동영상마다 다른 시각 연산이 필요한 문제를 해결한다. 핵심은 시각적으로 위치를 파악한 근거 그래프(VGEG)로, 시각 앵커·개체 관계·출처 기반 사실·연산 작업 간의 의존성을 인코딩해 데이터 구성·과정 감시·연산 평가에 공통으로 쓸 수 있게 했다. 전체 요약 7문장 읽기 → 069 09:11 ▲ 128 · 댓글 97 ADHD의 숨은 원인, 생체시계 장애일 수 있다 ADHD 환자의 73~80%가 지연된 수면-각성 사이클을 보이며, 성인은 멜라토닌 분비가 90분 늦고 아이들은 45분 늦게 시작된다. AI · 머신러닝 · ADHD as a circadian rhythm disorder: evidence and implications for chronotherapy (2025)
Key Point ADHD 증상의 상당 부분이 실제로는 생체시계 불일치에서 비롯될 수 있으며, 기존 약물 대신 아침 햇빛·멜라토닌·고정 수면시간 같은 행동 중재만으로도 개선할 가능성이 있다는 점이 임상 진료에 구체적인 영향을 미칠 수 있기 때문이다.
핵심 요약
ADHD 환자의 73~80%가 지연된 수면-각성 사이클을 보이며, 성인은 멜라토닌 분비가 90분 늦고 아이들은 45분 늦게 시작된다. ADHD 환자는 늦은 저녁형 시간대, 블라운트되고 지연된 코르티솔 리듬, 더 작은 송과체, 약화된 시계유전자(BMAL1/PER2) 발현을 보인다. 성인 ADHD 환자에게 0.5mg 멜라토닌은 멜라토닌 분비를 88분 앞당겼고 ADHD 증상을 14% 감소시켰다. 전체 요약 10문장 읽기 → 070 21:11 당일 +253 RIME 기반 macOS 입력기 RIMES 공개 RIMES는 오픈소스 입력기 엔진 RIME을 기반으로 한 다중 플랫폼 입력기이며, 중국어/영문/기타 방식을 지원한다. 오픈소스 · 도구 · scholay/rimes · Swift
Key Point macOS·Windows·Android·iOS·Linux 전 플랫폼을 지원하는 오픈소스 입력기로, RIME 기반의 다양한 중국어 입력 방식과 AI 번역·생성·개선을 통합한 개발자·고급 사용자용 도구다.
핵심 요약
RIMES는 오픈소스 입력기 엔진 RIME을 기반으로 한 다중 플랫폼 입력기이며, 중국어/영문/기타 방식을 지원한다. 입력 전 텍스트 편집, 클립보드 관리, AI 회화 등을 위해 '버퍼(Buffer)', '캡슐(Capsule)', '메일박스(Mailbox)' 세 개 플러그인 슬롯을 제공한다. Buffer(⌘⇧B)는 화면 전송 전 텍스트 작업대로, 실시간 번역·AI 생성·개선 기능을 지원하며 사용자가 확인 후 명시적으로 입력창에 전달한다. 전체 요약 11문장 읽기 → 071 18:30 ▲ 872 · 댓글 418 Anthropic, 저비용 소형 모델 Claude Haiku 5.5 공개 Anthropic이 Claude Haiku 5.5를 발표했으며, 이는 지금까지 출시한 소형 모델 중 가장 저렴하고 빠르며 성능이 우수한 버전이다. AI · 머신러닝 · Claude Haiku 5.5
Key Point 소형 모델이 대폭 저렴해지면서 이전에는 비용상 불가능했던 요약, 분류, 에이전트 작업이 대규모로 가능해진다.
핵심 요약
Anthropic이 Claude Haiku 5.5를 발표했으며, 이는 지금까지 출시한 소형 모델 중 가장 저렴하고 빠르며 성능이 우수한 버전이다. Haiku 5.5는 요약·데이터 압축·데이터베이스 쿼리·분류 등 반복적인 고용량 작업을 위해 설계되었으며, Opus 5.5 및 Sonnet 5.5와 함께 하위 에이전트로도 사용 가능하다. Haiku 4.5 대비 평균 75% 저렴하며, 특히 10만 토큰 이하 요청(전체 요청의 90%)에 대해 90% 저렴해졌다. 전체 요약 13문장 읽기 → 072 18:33 ▲ 11 · 댓글 2 LLM을 선택형 의사결정 모델로 쓸 수 있나 Jev 스타일 의사결정 모델은 자유 텍스트 생성 대신 미리 정해진 선택지에 대한 확률분포를 반환해 소프트웨어가 바로 활용할 수 있다. AI · 머신러닝 · LLM-as-Jev: LLMs Are Already Jev-Style Decision Models -- When and How to Fine-Tune Them
Key Point LLM을 선택형 의사결정에 특화된 모델로 쓸 수 있다는 발견은 작은 모델도 분류·라우팅·선택 작업에 미세조정 없이 충분할 수 있다는 뜻이며, 이는 개발자가 LLM 활용 방식을 새로 고민하게 만든다.
핵심 요약
Jev 스타일 의사결정 모델은 자유 텍스트 생성 대신 미리 정해진 선택지에 대한 확률분포를 반환해 소프트웨어가 바로 활용할 수 있다. 이 논문은 일반용 LLM이 기본 상태에서 이 능력을 이미 갖추고 있는지, 언제 미세조정이 필요한지 조사했다. LLM-as-Jev 프레임워크는 아키텍처를 그대로 두고 대괄호 안 숫자 토큰의 다음토큰 확률에서 보정된 의사결정을 추출한다. 전체 요약 8문장 읽기 → 073 18:33 ▲ 20 · 댓글 2 흐름과 확산 모델에서 데이터 망각과 경량화를 동시에 Flow 및 Diffusion 모델 같은 다단계 생성 모델은 고품질 출력을 만들지만 추론 비용이 크고 학습 데이터의 원치 않는 부분을 재현할 수 있다. AI · 머신러닝 · Data Unlearning via Inverse Distillation
Key Point 생성 모델에서 특정 학습 데이터를 제거하면서 동시에 모델 크기를 줄이는 기술이 필요한데, 이 논문이 처음으로 두 목표를 함께 달성하는 방법을 제시했기 때문이다.
핵심 요약
Flow 및 Diffusion 모델 같은 다단계 생성 모델은 고품질 출력을 만들지만 추론 비용이 크고 학습 데이터의 원치 않는 부분을 재현할 수 있다. 역방향 증류 망각(IDU) 기법은 교사 모델을 효율적인 원스텝 학생 생성기로 증류하면서 동시에 지정된 학습 부분집합의 출력을 억제하는 통합 프레임워크다. 증류를 데이터 분포에 대한 민-맥스 목적함수로 정식화하고, 이 분포를 망각 집합과 생성 분포의 혼합으로 표현해 교사의 학습 분포와 비교하면 최적점에서 보존 데이터만 복원된다. 전체 요약 6문장 읽기 → 074 18:33 ▲ 149 · 댓글 78 LLM 에이전트를 위한 Codemode: 하네스 내 코드 실행 Codemode는 LLM 에이전트가 하네스(뇌) 측에서 복잡한 작업을 표현하고 조율하는 방식으로, 실행 환경(손)과는 분리되어 있다. AI · 머신러닝 · What is Codemode
Key Point LLM 에이전트의 도구 호출 방식이 Bash에서 하네스 기반 코드 실행으로 진화하는 중요한 전환점이며, MCP와 AI SDK의 통합 방향을 이해하는 데 필수적이다.
핵심 요약
Codemode는 LLM 에이전트가 하네스(뇌) 측에서 복잡한 작업을 표현하고 조율하는 방식으로, 실행 환경(손)과는 분리되어 있다. Bash의 근본 한계는 프로그램만 조합할 수 있다는 것인데, 이미지 읽기나 서브 에이전트 생성처럼 하네스의 네이티브 도구가 필요한 작업들이 있다. Pi는 Codemode를 JavaScript 기반으로 구현했으며, QuickJS WASM 런타임에서 네트워크·파일시스템·타이머 없이 격리 실행되고 도구 호출만 가능하다. 전체 요약 12문장 읽기 → 075 18:33 ▲ 118 · 댓글 53 AI 급등이 뒤흔드는 에르되시 수학 커뮤니티 에르되시 문제 사이트(erdosproblems.com)는 AI가 1년 사이 수학의 어려운 문제들을 푸는 데 성공하면서 AI 역량 측정의 기준이 되어왔다. AI · 머신러닝 · Erdosproblems.com Succumbs to the AI Onslaught
Key Point AI로 수학 문제 해결이 급증하면서 한 커뮤니티 사이트가 정책을 전환했고, 설명과 협업의 가치를 두고 수학자들이 엇갈린 입장을 드러냈기 때문이다.
핵심 요약
에르되시 문제 사이트(erdosproblems.com)는 AI가 1년 사이 수학의 어려운 문제들을 푸는 데 성공하면서 AI 역량 측정의 기준이 되어왔다. AI 해결책이 늘어나면서 많은 문제의 답을 알게 됐지만, 동시에 수학자들이 에르되시 문제를 '쉽고 재미있는' 것으로 폄하하고, AI와의 경쟁을 포기하며, 설명 없는 AI 생성 해결책으로 인해 인간 수학자들이 낙담하는 부작용도 생겼다. 사이트 운영자는 'Erdős 커뮤니티 인간들(에르되시 스타일 수학에 관심 있는 사람들)의 번영'을 핵심 가치로 삼고 변화를 추진했다. 전체 요약 9문장 읽기 → 076 18:33 ▲ 278 · 댓글 78 Strands Decider 2B, 경량 의사결정 AI 모델 오픈소스 공개 Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. AI · 머신러닝 · Strands Decider 2B: a small, open-source, decision model
Key Point 2억 개 파라미터로 로컬에서 쉽게 실험 가능하면서도 기존 LLM보다 100배 빠르고 신뢰도 점수를 제공해, 에이전트 시스템의 라우팅·검증·보안에 활용하는 새로운 클래스의 AI 모델이 등장했다.
핵심 요약
Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. 의사결정 모델(Decision Model)은 텍스트 생성이 불가능한 대신, 선택지 간 선택이나 점수 부여에 특화되어 있으며, LLM과 달리 매우 낮은 지연시간과 높은 신뢰도 점수를 제공한다. 기존 LLM 모델의 LM 헤드를 포인터 헤드로 대체한 구조로, Qwen3.5-2B를 기반으로 rank-16 LoRA 어댑터로 파인튜닝했다. 전체 요약 9문장 읽기 → 077 18:33 ▲ 386 · 댓글 224 OpenAI, 결정 자동화 API 공개 베타 시작 OpenAI의 Decisions API는 텍스트·이미지를 평가해 10배 빠르게 응답을 반환하는 Responses API의 후속 도구다. AI · 머신러닝 · Decisions API is in public beta
Key Point 선택지 결정·분류를 위한 전문 API를 통해 고속 처리가 필요한 서비스의 라우팅·필터링 방식이 크게 달라질 수 있다.
핵심 요약
OpenAI의 Decisions API는 텍스트·이미지를 평가해 10배 빠르게 응답을 반환하는 Responses API의 후속 도구다. API는 조건의 참/거짓 확률, 고정 선택지 중 하나의 선택, 기준표 기반 점수 세 가지 형태의 답을 제공한다. 콘텐츠 분류, 요청 라우팅, 업무 우선순위 지정 등에 활용할 수 있다. 전체 요약 13문장 읽기 → 078 18:33 ▲ 233 · 댓글 182 Rust 기반 리눅스 이메일 클라이언트 Penguin Mail 1.0 출시 Gmail, 아웃룩, Fastmail, 야후 등 IMAP/POP3 지원하는 메일 서비스와 CalDAV 캘린더를 하나의 앱으로 통합 관리하는 오픈소스 메일 클라이언트. 오픈소스 · 도구 · Penguin Mail – open-source Rust email client for Linux with AI
Key Point 로컬에서 실행되는 오픈소스 메일 클라이언트로 개인정보가 서드파티 서버를 거치지 않으며, 자체 AI 어시스턴트와 완전한 이메일 관리 기능을 제공하는 새로운 선택지가 생겼습니다.
핵심 요약
Gmail, 아웃룩, Fastmail, 야후 등 IMAP/POP3 지원하는 메일 서비스와 CalDAV 캘린더를 하나의 앱으로 통합 관리하는 오픈소스 메일 클라이언트. 여러 계정의 메일을 하나의 받은편지함으로 모으거나 개별 확인 가능하며, 시스템 트레이에서 백그라운드 동기화하고 읽지 않은 메일 알림을 제공한다. Gmail 카테고리처럼 주요 탭, 업데이트, 프로모션, 소셜 네 가지로 자동 분류하며 사용자가 발신자를 다른 카테고리로 옮기면 유지된다. 전체 요약 12문장 읽기 → 079 18:35 당일 +141 무료 드라마 스트리밍 가이드 모음, 매일 자동 검증 중국 개발자가 관리하는 오픈소스 저장소로, 광고 없는 드라마 시청 자료를 한 곳에 모아 체계적으로 분류했다. 오픈소스 · 도구 · laoma528/awesome-zhuiju-free · JavaScript
Key Point 드라마 시청 리소스 관리의 복잡성을 해결하면서 오픈소스로 투명하게 운영하는 실용적 접근 방식을 보여주며, 자동 검증 시스템이 지속적으로 유효한 자료를 유지하는 메커니즘을 제시한다.
핵심 요약
중국 개발자가 관리하는 오픈소스 저장소로, 광고 없는 드라마 시청 자료를 한 곳에 모아 체계적으로 분류했다. 온라인 스트리밍 사이트, 모바일 앱, 클라우드 저장소 검색, 자막, 라이브 채널, TVBox 설정 주소 등 30개 이상의 카테고리를 수록하고 있다. 매일 자동화된 GitHub Actions를 통해 모든 자료의 접속 가능 여부를 검사하고, 각 사이트별로 '가능', '제한됨', '접근 불가', '미검사' 상태를 표시한다. 전체 요약 8문장 읽기 → 080 09:11 ▲ 12 · 댓글 2 의료 AI 검증 시스템의 숨은 한계, 자동 분류로 드러내다 의료 데이터에서 검색한 근거로 LLM 생성 답변의 사실성을 확인하는 검색 기반 평가가 임상 환경에서 주류 방식이 되었으나, F1 같은 집계 지표는 실패의 원인과 위치를 불명확하게 남긴다. AI · 머신러닝 · Where Does Retrieval-Based Open-Ended Evaluation Fail? Automatic Taxonomy Induction from Long-Form Medical Answer Factuality Verification
Key Point 의료 AI 시스템의 검증 성능이 개선되지 않는 근본 원인이 무엇인지 밝혀, 현재 방식의 한계를 이해하고 새로운 접근이 필요한 이유를 제시한다.
핵심 요약
의료 데이터에서 검색한 근거로 LLM 생성 답변의 사실성을 확인하는 검색 기반 평가가 임상 환경에서 주류 방식이 되었으나, F1 같은 집계 지표는 실패의 원인과 위치를 불명확하게 남긴다. MedExpert 데이터셋과 3개의 폐쇄형 데이터셋 사례 연구에서 검색 단계 오류 5가지와 검증 추론 오류 6단계를 분류하는 두 개의 체계적 분류법을 개발했다. LLM을 판사로 삼아 증거 품질을 라벨링하고 검증 오류를 자동으로 분류하는 패턴 귀납 파이프라인을 적용하여 4가지 검색 방식과 6개 최신 검증 모델에서 대규모로 검증했다. 전체 요약 5문장 읽기 → 081 09:11 ▲ 179 · 댓글 136 AI가 발견한 상온 자성 반도체, 스핀트로닉스의 게임체인저 강자성체와 반강자성체의 중간 성질을 가진 '룬팅거 보상' 반도체를 찾는 것이 스핀트로닉스 분야의 오랜 과제였다. AI · 머신러닝 · Opus 5.5 agents discover two room-temperature magnetic semiconductor candidates
Key Point 상온에서 스핀을 분류할 수 있으면서도 자기장이 없는 반도체 물질은 스핀트로닉스 기술의 핵심 요구사항인데, 이미 존재하는 물질을 AI가 규명하면서 실용화 가능성이 높아졌다.
핵심 요약
강자성체와 반강자성체의 중간 성질을 가진 '룬팅거 보상' 반도체를 찾는 것이 스핀트로닉스 분야의 오랜 과제였다. 강자성체는 원자 자석이 모두 같은 방향을 가리켜 큰 자기장을 만들지만 제어가 어렵고 전환이 느리다. 반강자성체는 상하 자석이 상쇄되어 자기장이 없지만, 전자의 스핀을 에너지 준위별로 분류할 수 없어 정보 저장이 어렵다. 전체 요약 12문장 읽기 → 082 00:11 ▲ 132 · 댓글 47 LLM 판단 vs 결정 모델, 벤치마크 결과는 기존 방식이 우위 TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. AI · 머신러닝 · Decision models like Jev don't beat LLM-as-a-judge or traditional classifiers
Key Point 신흥 기술로 주목받는 결정 모델이 실제로는 기존의 소형 분류기와 LLM 판단 방식과의 경쟁에서 우월하지 못하다는 벤치마크 결과로, AI 안전장치 선택 시 실용성을 강조하는 실증 데이터를 제공한다.
핵심 요약
TypeSafe AI의 Jev 같은 결정 모델(decision model)은 고정된 스키마의 '결정'을 출력하는 새로운 AI 안전장치 기법으로, 자유형 텍스트 생성 방식보다 빠르고 저렴하며 학습 데이터 없이도 새로운 문제에 적용할 수 있다. Red Hat 연구팀은 프롬프트 주입과 콘텐츠 안전성 두 가지 벤치마크에서 9개 안전장치를 비교 평가했다: CPU 규모 사전학습 분류기, BART-large-mnli, Shieldstral, Nemotron-3.5, Qwen3.6-35B, Laya, DiffusionGemma, Jev. 프롬프트 주입 탐지에서 Qwen3.6-35B(LLM-as-a-judge)이 89.31% 정확도로 1위, DiffusionGemma 87.72% 2위, Jev는 86.35%로 4위를 기록했다. 전체 요약 10문장 읽기 → 083 15:11 ▲ 51 · 댓글 2 법률 AI 평가 프레임워크 'LexReward' 공개 법률 언어모델의 응답 품질을 평가하기 위해 기존의 단순한 판단 방식으로는 법률 분야의 복잡한 요구사항을 충분히 반영할 수 없다는 문제에서 출발한 연구다. AI · 머신러닝 · LexReward: A Taxonomy-Driven Reward Framework for Legal Language Models
Key Point 법률 분야 AI 시스템의 성능을 정밀하게 평가하고 최적화할 수 있는 방법론이 제시되어, 법률 특화 언어모델의 개발 품질을 크게 높일 수 있다.
핵심 요약
법률 언어모델의 응답 품질을 평가하기 위해 기존의 단순한 판단 방식으로는 법률 분야의 복잡한 요구사항을 충분히 반영할 수 없다는 문제에서 출발한 연구다. LexReward는 법률 응답의 품질을 세 차원으로 평가한다: 어휘·문법적 품질을 보는 Style, 법적 주체·사실·법령·판례를 평가하는 Element, 법률 추론의 순서·완성도·정확성·중복 제거를 보는 Chain. 각 차원마다 평가 기준과 품질 수준을 명시한 루브릭(채점 기준표)을 개발했으며, 이를 바탕으로 DPO(Direct Preference Optimization) 훈련과 보상 모델 학습용 쌍 비교 데이터를 구성했다. 전체 요약 6문장 읽기 → 084 15:11 ▲ 44 · 댓글 3 비디오가 물리 법칙을 얼마나 잘 이해하나 측정하는 벤치마크 물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. AI · 머신러닝 · World Embedding Benchmark
Key Point 비디오 생성의 물리적 정확성을 평가하는 첫 벤치마크로, 현재 AI 모델들의 물리 이해도를 측정하고 개선 방향을 보여준다.
핵심 요약
물리 현상을 정확히 표현하는 비디오 생성 모델을 평가하기 위해 World Embedding Benchmark를 공개했다. 유체역학, 고체역학, 동역학, 광학·전자기학 등 80개 종류에서 8,000개의 시뮬레이션 영상을 수집하고, 각 영상에 시뮬레이션 기반의 물리 주석을 달았다. 텍스트-영상 검색, 물리적 성질 회귀, 다중선택 분류라는 세 가지 평가 작업으로 영상 임베딩이 물리 정보를 얼마나 잘 인코딩하는지 측정한다. 전체 요약 7문장 읽기 → 085 06:11 당일 +185 Cloudflare 기반 셀프호스팅 이메일 서비스 Mailflare 공개 Cloudflare에서 실행되는 커스텀 도메인용 셀프호스팅 이메일 수신함으로, Resend 또는 AWS SES를 지원한다. 오픈소스 · 도구 · hieunc229/mailflare · TypeScript
Key Point 자신의 도메인으로 완전히 무료 이메일 서비스를 구축할 수 있는 오픈소스 도구가 나왔으며, 전문 이메일 기능(캘린더, AI 어시스턴트, 라우팅)을 갖춘 대안으로 기존 이메일 제공자의 종속성을 벗을 수 있다.
핵심 요약
Cloudflare에서 실행되는 커스텀 도메인용 셀프호스팅 이메일 수신함으로, Resend 또는 AWS SES를 지원한다. 도메인 연결, 개인/공유 메일박스 생성, 첨부파일·리치텍스트·서명·자동 회신이 포함된 이메일 송수신이 가능하다. 캘린더 일정 관리(반복 이벤트, 타임존, 참석자), 공개 예약 페이지 공유, 라우팅 규칙을 통한 자동 메일 분류·전달·거부 기능을 제공한다. 전체 요약 9문장 읽기 → 086 16:56 당일 +100 중국 특허 실무를 자동화하는 올인원 AI 도구 Python 기반 특허 관리 통합 플랫폼으로 발명/실용신안/디자인 등 모든 특허 유형을 지원한다. AI · 머신러닝 · handsomestWei/patent-disclosure-skill · Python
Key Point 특허 작성 경험이 없는 개발자도 기술 자료만 제출하면 보호 가능한 특허를 스스로 출원할 수 있는 AI 자동화 체계가 처음 공개되었다.
핵심 요약
Python 기반 특허 관리 통합 플랫폼으로 발명/실용신안/디자인 등 모든 특허 유형을 지원한다. 프로젝트 자료에서 보호 가능한 특허 포인트를 자동으로 발굴하고, 선행기술 검색을 거쳐 교시서를 Word 형식으로 생성한다. 구조도나 제품사진 같은 이미지를 자동 분석해 실용신안·외관 설계의 선도(線圖)와 부품 번호 표기를 생성한다. 전체 요약 10문장 읽기 → 087 12:11 ▲ 111 · 댓글 54 EMT가 되지 않은 21가지 이유, 순위별로 소프트웨어 엔지니어인 저자가 의료에 관심을 가져 오랫동안 EMT(응급의료요원) 자격 취득을 미루다가 2024년 마침내 NOLS 야생지 EMT 과정(28일)을 완료했다. 기타 · Reasons I didn't become an EMT, ranked
Key Point 자신의 미루기 행동 패턴을 명확히 분석하고 근거 없는 핑계를 드러내는 과정 자체가, 새로운 것에 겁내는 많은 사람들에게 어떻게 행동해야 하는지 실질적인 답을 제시한다.
핵심 요약
소프트웨어 엔지니어인 저자가 의료에 관심을 가져 오랫동안 EMT(응급의료요원) 자격 취득을 미루다가 2024년 마침내 NOLS 야생지 EMT 과정(28일)을 완료했다. 자격 취득을 미루게 한 실제 이유들을 터무니없음 정도로 분류했다: '시간이 오래 걸림'(Microsoft 무제한 휴가로 가능), '문화적 거부감'(EMS 분야의 심각한 번아웃, 남성중심 문화) 같은 실질적 우려부터 시작했다. 비교적 터무니없는 이유들: 다른 학생들과 맞을지 걱정했으나 실제로는 같은 나이대 의료 관심자들도 많았고, 번아웃된 일자리만 있을 거란 우려도 자격증 취득 후 괜찮은 팀을 만났다. 전체 요약 12문장 읽기 → 088 12:11 ▲ 54 · 댓글 2 동영상 생성 모델의 정렬 문제, 첫 종합 가이드 동영상 생성 기술이 저해상도 단편에서 고해상도 장시간 시퀀스로 급속도 발전했으나, 사전학습된 모델은 인간 의도 따르기·시간적 일관성 유지·물리법칙 준수에 실패하는 경우가 많다. AI · 머신러닝 · Video Generation Models: A Survey of Post-Training and Alignment
Key Point 동영상 생성 모델이 인간 의도를 제대로 따르지 못하는 근본적인 정렬 문제를 체계화한 첫 종합 가이드로, 앞으로의 동영상 생성 기술 개발 방향을 정리해준다.
핵심 요약
동영상 생성 기술이 저해상도 단편에서 고해상도 장시간 시퀀스로 급속도 발전했으나, 사전학습된 모델은 인간 의도 따르기·시간적 일관성 유지·물리법칙 준수에 실패하는 경우가 많다. 동영상 생성의 정렬(alignment)은 이미지·텍스트 생성보다 난제가 많은데, 누적 오차·움직임-외형 결합·다목적 트레이드오프·시간적 속성의 제한된 감독이 주요 과제다. 이 논문은 동영상 모델의 사후학습(post-training)과 정렬을 다룬 첫 종합 리뷰로, 정렬 신호 적용 방식에 따라 암묵적 정렬과 명시적 정렬로 구분한다. 전체 요약 6문장 읽기 → 089 18:11 ▲ 101 · 댓글 36 모델 라우터로 Astra 수준의 성능 달성, 비용은 절반 Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. AI · 머신러닝 · Show HN: Open-source model routing for coding agents at Astra-level performance
Key Point 비용을 절반으로 줄이면서 최강 수준의 성능을 유지하는 라우팅 기술은 개발자 도구의 경제성을 크게 바꿀 수 있다.
핵심 요약
Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. Terminal Bench 4.0과 SWE Atlas 벤치마크에서 GPT-6 Astra와 동등한 정확도를 달성하면서 비용은 52~54% 수준으로 줄이고 완료 속도는 2.2~2.5배 빨아졌다. 라우팅 결정 공간이 100 LLM 호출 × 10개 모델 기준 10^100개에 달하므로, Hidden Markov Model로 세션 상태를 추적한 후 분류기가 모델 버킷을 선택하는 구조로 탐색 공간을 대폭 축소했다. 전체 요약 8문장 읽기 → 090 09:11 ▲ 190 · 댓글 21 오래 돌아가는 AI 에이전트를 위한 프레임워크 Pi Durable 공개 Earendil이 Pi 1.0과 함께 새로운 프레임워크 Pi Durable을 공개했다. AI · 머신러닝 · Pi Durable
Key Point Pi Durable은 실패 복구, 병렬 대화, 동적 확장, 긴 문맥 관리를 갖춘 프로덕션급 에이전트 프레임워크이므로, 장시간 운영되는 AI 애플리케이션 개발 방식을 바꿀 수 있다.
핵심 요약
Earendil이 Pi 1.0과 함께 새로운 프레임워크 Pi Durable을 공개했다. Pi Durable은 장시간 운영되고, 장애에 강하며, 어디서나 실행 가능한 AI 에이전트를 위해 설계되었다. Pi 1.0이 단일 사용자의 로컬 터미널 기반 에이전트에 집중한 반면, Pi Durable은 여러 클라이언트, 다양한 실행 환경, 무제한 대화를 지원하는 프레임워크다. 전체 요약 12문장 읽기 → 091 03:11 ▲ 184 · 댓글 63 클라우드플레어, 의사결정 특화 AI 모델 Clef 공개 클라우드플레어가 Jev Decision Index에서 1위를 차지한 의사결정 모델 Clef와 Clef-flash를 공개했고, 두 모델 모두 Apache 2.0 라이선스로 오픈소스화해 Hugging Face에서 배포 중이다. AI · 머신러닝 · Clef: Open-source decision models, and new RL fine-tuning platform
Key Point LLM의 비결정성과 느린 토큰 생성을 대체해 프로덕션 에이전트 워크플로우에서 실시간 의사결정이 필요한 개발자들에게 구체적인 선택지를 제공하며, 오픈소스 배포와 미세조정 플랫폼으로 커스터마이징 가능성을 연다.
핵심 요약
클라우드플레어가 Jev Decision Index에서 1위를 차지한 의사결정 모델 Clef와 Clef-flash를 공개했고, 두 모델 모두 Apache 2.0 라이선스로 오픈소스화해 Hugging Face에서 배포 중이다. 의사결정 모델은 입력에 따라 확률과 함께 타입이 지정된 구조화 출력을 생성해 에이전트가 자동으로 판단하고 실행하도록 돕는데, 예를 들어 고객 지원 메시지를 받아 긴급도와 담당팀을 분류한다. Clef는 이미지 분류도 가능한 비전 인코더를 갖춰 Jev(텍스트 분류만 지원)와 다르며, 64k 컨텍스트 윈도우(Jev는 32k)로 더 많은 입력을 처리할 수 있다. 전체 요약 12문장 읽기 → 092 21:11 당일 +213 215개 해킹 도구를 한곳에, AI로 검색하고 실행하는 통합 보안 플랫폼 Python 기반 올인원 보안 테스트 도구로, 정찰, OSINT, 웹, 무선, 피싱, 포렌식, 사후 착취 등 21개 카테고리의 215개 도구를 한 콘솔에서 관리한다. 보안 · Z4nzu/hackingtool · Python
Key Point 보안 테스트의 도구 분산 문제를 AI 기반 통합 콘솔로 해결하고, 정찰부터 사후 착취까지 전 단계의 도구를 한 프레임워크에서 관리·실행할 수 있게 한다.
핵심 요약
Python 기반 올인원 보안 테스트 도구로, 정찰, OSINT, 웹, 무선, 피싱, 포렌식, 사후 착취 등 21개 카테고리의 215개 도구를 한 콘솔에서 관리한다. AI 레이어가 자연어 입력을 올바른 도구와 정확한 명령어로 변환해주며, 사용자는 '/find'로 필요한 도구를 GitHub API까지 검색하고 '/goal'로 목표를 단계별로 계획·실행할 수 있다. Python 3.10 이상, Linux·macOS 환경에서 pipx나 Docker로 설치 가능하며, 별도 런타임(Go, Ruby, tmux 등)이 필요한 도구도 있지만 핵심 앱은 독립적으로 동작한다. 전체 요약 10문장 읽기 → 093 21:11 ▲ 41 · 댓글 2 언어 모델 내부 표현으로 새로운 수학 관계식 발견 언어 모델의 내부 활성화 패턴을 분석해 유망한 수학적 관계를 자동으로 찾는 파이프라인 LANTERN을 개발했다. AI · 머신러닝 · LANTERN: Illuminating Hidden Mathematical Knowledge in Language Models
Key Point 언어 모델의 숨겨진 수학적 이해를 활용해 자동으로 새로운 과학적 발견을 찾아내는 실제 사례이며, AI가 단순 문제 해결을 넘어 연구 방향 설정까지 돕는 가능성을 제시한다.
핵심 요약
언어 모델의 내부 활성화 패턴을 분석해 유망한 수학적 관계를 자동으로 찾는 파이프라인 LANTERN을 개발했다. 정수수열 백과사전(OEIS)의 1만 개 자주 참조되는 수열에서 5천만 개 수열 쌍을 순위 매기고 기존 교차 참조가 없는 검증된 관계 62개를 발견했다. 13개 관계를 내용 검증을 통해 선별했으며, 이 중 9개가 유의미하고, 4개는 OEIS나 기존 문헌에 없는 완전히 새로운 발견이다. 전체 요약 5문장 읽기 → 094 21:11 ▲ 103 · 댓글 7 손으로 만드는 SVG 패턴, Book of Shapes 공개 Nikolaj Sokolowski가 만든 Book of Shapes는 최소주의적이고 생성형이며 커스터마이징 가능한 SVG 패턴 모음이다. 웹 · 프론트엔드 · Book of Shapes – Collection of minimal, generative and customizable SVG-patterns
Key Point 웹 디자이너와 개발자가 즉시 가져다 쓸 수 있는 프로덕션 레디 SVG 패턴 라이브러리로, 배경·질감·장식용 그래픽이 필요할 때 빠르게 활용할 수 있다.
핵심 요약
Nikolaj Sokolowski가 만든 Book of Shapes는 최소주의적이고 생성형이며 커스터마이징 가능한 SVG 패턴 모음이다. 그리드, 래디얼, 노이즈, 플로우, 아이소메트릭, 유기형, 왜곡, 물리 시뮬레이션 등 8가지 카테고리로 분류되어 있다. 각 카테고리별로 수십 개의 개별 패턴을 제공한다: 그리드 22개, 래디얼 18개, 노이즈 18개, 플로우 17개, 아이소메트릭 13개, 유기형 9개, 왜곡 8개, 물리 5개. 전체 요약 5문장 읽기 → 095 15:11 ▲ 51 · 댓글 3 LLM 직결정 모델의 '중간값 선호 편향' 발견 GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. AI · 머신러닝 · More Choices, Fewer Decisions: Ordinal-Scale Bias in JEV-like Direct-Decision Models
Key Point LLM 기반 자동 평가와 분류 모델이 실제로는 제한된 선택지만 사용하고 있다는 점이 중요하므로, 이들을 프로덕션에 도입할 때 신뢰성을 검증해야 한다.
핵심 요약
GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. ANLI 데이터셋에서 GPT-4V는 74.95% 정확도를 보이면서도 전체 예측의 38.8%, 오류의 51.3%를 'Neutral' 중간값에 할당했다. 36개의 서수형 데이터셋 전반에서 모델들은 각 척도의 유효 범위 중 67~76%만 활용했지만, 명목형(nominal) 과제 4개에서는 87~102%를 활용했다. 전체 요약 6문장 읽기 → 096 15:11 ▲ 42 · 댓글 2 마스크형 확산 모델, 언제 전략 바꿀까 마스크형 확산 언어모델(MDM)은 자유로운 생성 순서를 허용해 언마스킹 전략이 추론 시점의 선택이 된다. AI · 머신러닝 · Unmask the State: When Does State Adaptation Matter for Masked Diffusion Language Models
Key Point 마스크형 확산 모델의 생성 과정에서 어떤 상황에서 추론 전략을 동적으로 바꿔야 효율적인지를 실증적으로 규명해, 모델 최적화의 실질적 가이드라인을 제시한다.
핵심 요약
마스크형 확산 언어모델(MDM)은 자유로운 생성 순서를 허용해 언마스킹 전략이 추론 시점의 선택이 된다. 스코어·카디널리티·영역·커미트먼트·플래닝 5개 축으로 MDM 추론을 분류하고, 고정된 선택보다 더 나은 행동의 한 단계 효용 차이를 '적응 기회'로 정의했다. 3개 MDM과 10개 테스크를 검증한 결과, 적응 기회는 매우 이질적이며 일부 상황에서는 집중된 예측 가능한 일단계 이득을 보였다. 전체 요약 5문장 읽기 → 097 15:11 ▲ 31 · 댓글 2 드라마·영상물 자막을 에피소드 전체로 일관되게 번역하는 AI 시스템 장편 자막 번역은 전체 시리즈에 걸친 담화와 문화적 맥락을 고려해야 하지만, 기존 LLM은 문장 수준에만 머물고 다중 에이전트 시스템은 정적 워크플로우를 사용해 장면 복잡도에 적응하지 못한다. AI · 머신러닝 · Breaking Babel: A Self-Evolving Multi-Agent System for Long-Form Subtitle Translation
Key Point 장편 드라마나 영상물의 일관된 자막 번역이 필요한 스튜디오·OTT 플랫폼과 다국어 번역을 다루는 개발자들이 접할 수 있는 실용적 멀티에이전트 AI 시스템의 등장이자, 기존 문장 단위 번역의 한계를 시리즈 전체 맥락으로 극복하는 새로운 접근법이다.
핵심 요약
장편 자막 번역은 전체 시리즈에 걸친 담화와 문화적 맥락을 고려해야 하지만, 기존 LLM은 문장 수준에만 머물고 다중 에이전트 시스템은 정적 워크플로우를 사용해 장면 복잡도에 적응하지 못한다. SMART라는 자체 진화 다중 에이전트 시스템을 제안하며, 테스트 시점 학습 단계에서 시리즈 수준 메모리를 구축하고 동적 라우터와 Mixture-of-Agents 계층을 통해 용어 검증·자막 제약 검증·문맥 검색 도구를 활용한다. 판사-개선 루프를 거쳐 후보들을 채점하고 텍스트 비판을 통해 LLM을 재학습하지 않으면서 에이전트 프롬프트와 라우팅 정책을 업데이트한다. 전체 요약 7문장 읽기 → 098 09:11 ▲ 15 · 댓글 2 표 형식 데이터 위한 기초 모델 TabFM 공개 Hugging Face에서 표 형식 데이터 예측을 위한 기초 모델 TabFM을 공개했다. AI · 머신러닝 · TabFM: A Zero-Shot Foundation Model for Tabular Data
Key Point 표 형식 데이터 분석에서 AutoML이나 데이터셋별 튜닝 없이도 영점 샷으로 작동하는 기초 모델이 등장함으로써, 기존의 번거로운 표 데이터 머신러닝 워크플로우가 어떻게 단순화될 수 있는지 보여준다.
핵심 요약
Hugging Face에서 표 형식 데이터 예측을 위한 기초 모델 TabFM을 공개했다. TabFM은 4억 개 파라미터를 가진 모델로, 지도학습을 문맥 내 학습(in-context learning)으로 형식화해 단일 전진 패스로 보정된 영점 샷 예측을 생성한다. 모델은 구조적 인과 모델(structural causal models)로 생성한 합성 테이블로만 학습되어 실제 데이터에 영점 샷 전이가 가능한 일반화된 표현을 학습했다. 전체 요약 5문장 읽기 → 099 21:11 당일 +319 Claude 업무 자동화 1000개 이상 스킬 모음 Anthropic의 Claude Skills 오픈 표준을 활용한 1000개 이상의 프로덕션 레벨 스킬과 플러그인을 모아놓은 큐레이션 리스트다. AI · 머신러닝 · ComposioHQ/awesome-claude-skills · Python
Key Point Claude가 수행할 수 있는 업무의 폭을 1000배 이상 확장할 수 있는 표준화된 스킬 생태계가 완성됨에 따라, 개인과 팀이 AI를 활용한 자동화를 즉시 시작할 수 있게 된다.
핵심 요약
Anthropic의 Claude Skills 오픈 표준을 활용한 1000개 이상의 프로덕션 레벨 스킬과 플러그인을 모아놓은 큐레이션 리스트다. Claude 스킬은 AI 에이전트에게 특정 업무 클래스를 처리하는 방법을 가르치는 재사용 가능한 명령어 패키지로, YAML 메타데이터가 담긴 Markdown 파일과 선택적 스크립트·참고자료로 구성된다. 2025년 10월에 Anthropic이 도입했고 12월에 오픈 표준으로 공개했으며, Claude Code·Claude.ai·Claude API뿐 아니라 OpenAI Codex·Cursor·Gemini CLI 등에서도 지원한다. 전체 요약 8문장 읽기 → 100 21:11 ▲ 150 · 댓글 63 MCP 지원 포기했던 Pi, 왜 핵심 기능으로 수용했나 Pi는 과거 MCP 미지원을 명시했으나 최신 버전에서는 MCP를 핵심 기능으로 통합했다. AI · 머신러닝 · Pi.dev: You Said No MCP
Key Point 새로운 모델의 기능에 맞춰 기존 결정을 바꾼 개발 철학과, MCP를 JavaScript 샌드박스와 결합하는 실용적인 해결책이 다른 AI 도구 개발자들에게도 영향을 미칠 수 있다.
핵심 요약
Pi는 과거 MCP 미지원을 명시했으나 최신 버전에서는 MCP를 핵심 기능으로 통합했다. MCP 자체도 진화했지만, Pi의 기술적 필요성이 주된 이유다. Pi는 Jev 같은 최신 모델들의 지연된 도구 로딩과 중간 시스템 메시지 지원을 위해 도구 설정을 업그레이드해야 했다. 전체 요약 8문장 읽기 →