쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
16건 · "음성인식"조건 지우기 ×
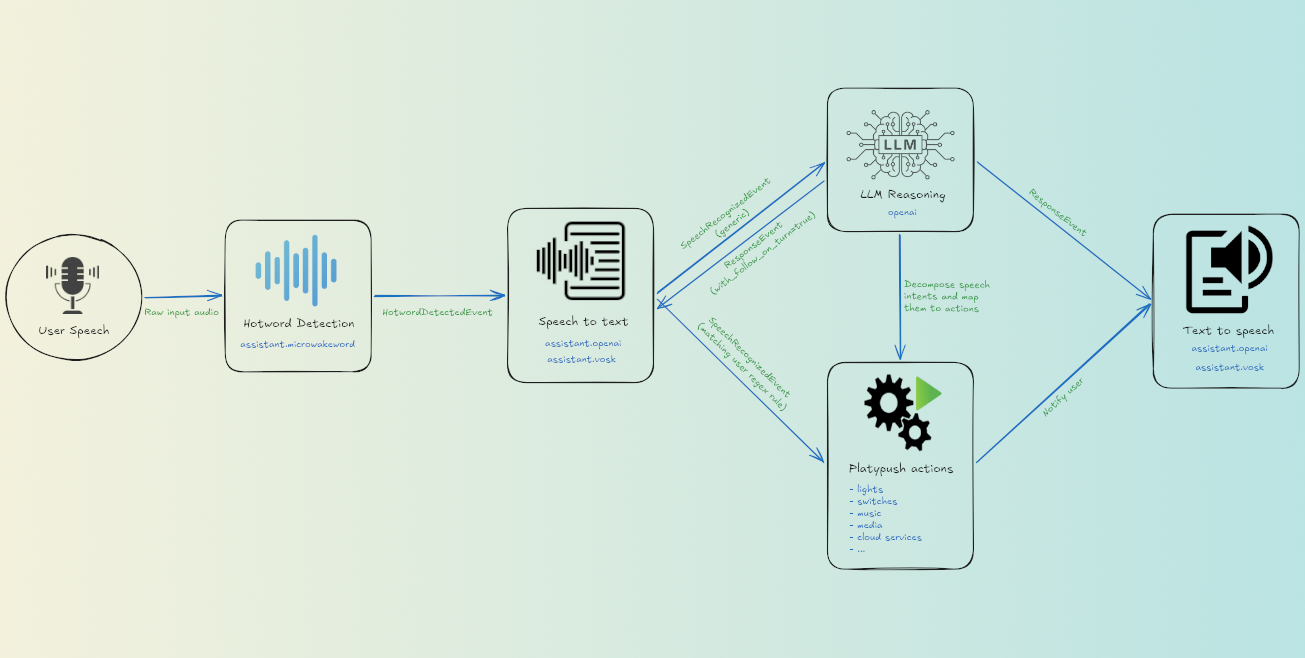
001 18:11 ▲ 107 · 댓글 17 자체 음성어시스턴트를 더 똑똑하게: 엔진 교체기 Platypush 음성어시스턴트 파이프라인을 재구축하면서 openwakeword에서 microWakeWord로 전환했다. 오픈소스 · 도구 · Rebuilding my local voice assistant pipeline
Key Point 자체 호스팅 음성어시스턴트가 상용 제품만큼 신뢰할 수 없었던 문제를 엔진 교체와 알고리즘 개선으로 얼마나 해결할 수 있는지 보여주고, 각 컴포넌트의 구체적인 성능 개선(대화 종료 시간 1/4-1/6로 단축) 과정을 공유한다.
핵심 요약
Platypush 음성어시스턴트 파이프라인을 재구축하면서 openwakeword에서 microWakeWord로 전환했다. openWakeWord는 2023년 모델로 오래되어 위양성(배경 소음 감지)과 위음성(가까울 때만 감지) 문제가 많았다. microWakeWord는 ESPHome과 Home Assistant Voice가 사용하며 모델이 적극 유지보수되고, 패키지에 사전학습 모델(okay_nabu, hey_jarvis, hey_mycroft, alexa)이 포함된다. 전체 요약 13문장 읽기 → 002 00:11 ▲ 11 · 댓글 2 화자 수 제한 없는 실시간 회의 음성 분리 기술 기존 신경망 기반 음성 분리 모델들(Streaming Sortformer, Nemotron-3)은 고정된 수의 출력 슬롯을 가져 미리 정한 수의 화자만 인식할 수 있다는 한계가 있었다. AI · 머신러닝 · eDIAR: Training-Free Open-Speaker Streaming Diarization for Long Meetings and Large Archives via e-means
Key Point 회의실 모임에서 몇 명이 참석할지 미리 알 수 없는 상황에서, 기존 고정 슬롯 방식을 완전히 벗어나 무제한의 화자를 실시간으로 인식할 수 있는 첫 실용적 솔루션이다.
핵심 요약
기존 신경망 기반 음성 분리 모델들(Streaming Sortformer, Nemotron-3)은 고정된 수의 출력 슬롯을 가져 미리 정한 수의 화자만 인식할 수 있다는 한계가 있었다. eDIAR은 재학습 없이 슬롯 수 제한을 제거한 훈련 자유 방식의 음성 분리 시스템이다. 슬롯 헤드가 활성 화자와 음성 겹침을 결정하고, 모든 슬롯이 사용된 후 e-means 알고리즘으로 하나의 슬롯 내에서 화자 임베딩을 클러스터링한다. 전체 요약 9문장 읽기 → 003 18:11 ▲ 90 · 댓글 2 스트리밍 음성인식 중 한 번 출력한 텍스트는 절대 수정 안 함 네이즈 유다오가 Confucius4-R2T2라는 스트리밍 음성인식 모델을 공개했으며, 이 모델은 한 번 생성한 텍스트를 절대 수정하지 않으면서도 높은 정확도와 낮은 지연시간을 유지한다. AI · 머신러닝 · Confucius4-R2T2: A Stable-Prefix Streaming ASR Model for Real Real-Time Transcription
Key Point 실시간 번역·음성 에이전트 같은 애플리케이션에서 텍스트 수정으로 인한 오작동을 원천 차단하는 새로운 기술 접근 방식을 보여준다.
핵심 요약
네이즈 유다오가 Confucius4-R2T2라는 스트리밍 음성인식 모델을 공개했으며, 이 모델은 한 번 생성한 텍스트를 절대 수정하지 않으면서도 높은 정확도와 낮은 지연시간을 유지한다. 기존 스트리밍 음성인식 모델은 토큰을 생성한 후 나중에 수정하곤 하는데, 이는 번역기나 음성 에이전트 같은 머신이 잘못된 작업을 수행하게 한다. R2T2는 Qwen3-ASR-1.7B를 중국어와 영어 1,500시간 음성으로 후학습하되, 사전학습된 음성 인코더와 프로젝터는 동결해서 개발했다. 전체 요약 8문장 읽기 → 004 18:15 스타 1,714 Cicada, 모든 화상회의에서 실시간 다언어 자막과 회의록 생성 Cicada(知了)는 Zoom, 플리소우, 텐센트 회의, X Spaces, YouTube 라이브 등 모든 화상회의와 스트림에서 실시간 다국어 자막, 번역, 구조화된 회의록을 생성하는 무료 오픈소스 도구다. 오픈소스 · 도구 · wquguru/cicada · Swift
Key Point 다중 플랫폼에서 로컬 프라이버시를 보존하면서 무료로 회의 실시간 번역·기록 기능을 제공해, 국제 화상회의나 팀 협업 시 언어 장벽을 없앨 수 있다.
핵심 요약
Cicada(知了)는 Zoom, 플리소우, 텐센트 회의, X Spaces, YouTube 라이브 등 모든 화상회의와 스트림에서 실시간 다국어 자막, 번역, 구조화된 회의록을 생성하는 무료 오픈소스 도구다. Mac(Apple 칩 / Intel), Windows, Linux, Android 플랫폼 모두 지원하며, Mac은 공식 다운로드 페이지와 GitHub Releases에서 설치 가능하다. Apple 칩 Mac에서는 음성 인식·언어 인식·음성 인식 및 회의 녹음이 모두 로컬에서 완료되고, 텍스트만 번역 및 회의록 작성을 위해 외부로 전송된다. 전체 요약 12문장 읽기 → 005 21:11 당일 +174 로컬 음성 받아쓰기 도구 Hex 공개, macOS·Windows·Linux 지원 Rust로 만든 로컬 우선 음성 받아쓰기 도구 Hex를 macOS, Windows, Linux에서 사용 가능하게 공개했다. 오픈소스 · 도구 · anomalyco/hex · Rust
Key Point 클라우드 의존도 없이 로컬에서만 동작하는 다중 플랫폼 음성 받아쓰기 도구의 공개로, 프라이버시를 중시하는 개발자와 사용자에게 새로운 대안을 제공한다.
핵심 요약
Rust로 만든 로컬 우선 음성 받아쓰기 도구 Hex를 macOS, Windows, Linux에서 사용 가능하게 공개했다. macOS 15 이상 Apple silicon Mac에서 단축키를 누르고 말한 후 놓으면 로컬에서 받아써 현재 앱에 붙여넣는다. 온디바이스 음성 모델을 설치 중에 다운로드하며 OpenAI나 클라우드 서비스 없이도 동작한다. 전체 요약 12문장 읽기 → 006 09:11 ▲ 106 · 댓글 17 엔비디아, 40개 언어 지원하는 오픈 음성인식 모델 공개 엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. AI · 머신러닝 · Nvidia Nemotron 3.5 Transcribe: open ASR for 40 languages
Key Point 음성-텍스트 변환이 대규모 언어모델의 다음 병목이 되는 시점에 40개 언어를 지원하고 프롬프트·미세조정으로 도메인 적응이 가능한 오픈 모델이 공개됨에 따라, 음성 애플리케이션 개발 환경이 크게 바뀐다.
핵심 요약
엔비디아가 Nemotron 3.5 Transcribe 모델을 공개했으며, 40개 언어 음성을 텍스트로 변환하고 31개 언어 간 번역, 13개 언어의 화자 구분을 모두 하나의 체크포인트에서 수행한다. 최대 1시간 길이 음성을 처리하고 최대 8명의 화자를 레이블링하며, 자연어 프롬프트로 출력을 제어할 수 있어 의료 받아쓰기·다국어 회의 등 도메인별 요구에 맞춘 결과를 얻을 수 있다. Hugging Face 오픈 ASR 리더보드 영어 부문에서 5.33% 평균 WER로 오픈 가중치 모델 중 1위, Artificial Analysis 레더보드에서 약 4B 활성 매개변수로 2.8% AA-WER을 달성해 파레토 경계에 위치한다. 전체 요약 12문장 읽기 → 007 15:11 ▲ 24 · 댓글 1 음성 에이전트가 말 듣는 중에 일을 준비한다 음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. AI · 머신러닝 · Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents
Key Point 음성 에이전트의 응답 지연을 줄이는 근본적인 아키텍처 개선으로, 실시간 음성 인터페이스에서 사용 경험을 크게 향상시킬 수 있다.
핵심 요약
음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. 기존 추측적(speculative) 접근은 음성 입력 중에 작업을 시작하지만, 청크 경계나 업데이트 시 중단 방식은 도구 호출의 인자가 완성되기 전에 잘릴 수 있다. 이 논문은 '하트비트 싱킹(Heartbeat Thinking)'을 제안하는데, 이는 음성 업데이트 시마다 새로운 사고 인스턴스를 호출하면서도 진행 중인 작업과 배포된 도구는 계속 실행할 수 있도록 한다. 전체 요약 7문장 읽기 → 008 00:11 ▲ 31 · 댓글 1 알리바바 Qwen-Audio-3.1-ASR, 화자 식별과 음성 분석 강화 알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. AI · 머신러닝 · Qwen-Audio-3.1-ASR Technical Report
Key Point 음성 인식이 단순 전사를 넘어 화자 식별, 음악·음성 분석까지 통합하는 추세를 보여주며, 다양한 배포 환경을 지원하는 확장성이 실무 적용의 핵심이다.
핵심 요약
알리바바의 Qwen-Audio-3.1-ASR은 이전 버전의 음성 인식을 개선하고 화자 분리 전사, 일반 오디오 이해 기능을 추가한 오디오-언어 모델 제품군이다. 30개 언어와 16개 중국 방언을 지원하며, 이전 발화 맥락 반영, 계층형 핫워드 커스터마이징, 자동 전사 보정 등 명령 제어 기능을 제공한다. 화자 분리 ASR은 화자 레이블, 타임스탐프, 인식된 텍스트를 포함한 구조화된 출력을 생성하며, 턴 전체에 걸쳐 일관된 화자 레이블을 유지하고 겹치는 음성을 표현한다. 전체 요약 6문장 읽기 → 009 06:11 ▲ 123 · 댓글 76 맥용 로컬 음성 받아쓰기 'BetterWispr' 오픈소스 공개 macOS 14 이상에서 실행되는 무료 오픈소스 받아쓰기 앱으로, Option+Space를 누르고 말하면 자동으로 텍스트로 변환된다. 오픈소스 · 도구 · Show HN: BetterWispr – Free, open-source dictation for Mac
Key Point 로컬 처리와 오픈소스라는 조건에서 계정 없이 완전한 음성 받아쓰기를 맥에서 구현하는 방식이 새로워, 개인정보 보호와 오프라인 사용을 중시하는 사용자들에게 실질적 대안이 된다.
핵심 요약
macOS 14 이상에서 실행되는 무료 오픈소스 받아쓰기 앱으로, Option+Space를 누르고 말하면 자동으로 텍스트로 변환된다. Apple Silicon 권장이며 Apple 음성, Parakeet(영어, 일본어, 유럽 25개 언어 지원), Whisper 등 9가지 내장 모델 중 선택할 수 있고 Sarvam AI나 OpenAI 호환 API도 사용 가능하다. 모든 음성 처리와 모델 실행이 로컬에서 이루어지며, 클라우드 폴백이 없고 계정이나 API 키도 필요 없다. 전체 요약 9문장 읽기 → 010 09:11 ▲ 10 · 댓글 2 음악 악보 변환 AI, 합성 데이터로 정확도 대폭 향상 음성을 악보로 변환하려면 리듬, 화성, 멜로디, 형식을 일관성 있게 이해해야 하는데 주석이 달린 녹음 부족과 부분 예측 오류 누적이 난제였다. AI · 머신러닝 · SheetSage2: Coherent Lead-Sheet Transcription with Synthetic Supervision
Key Point 음악 악보 자동 변환의 핵심 문제(학습 데이터 부족과 음악적 일관성)를 합성 데이터와 구조화된 디코딩으로 해결한 방법론이 멀티태스크 모델에서 전문 모델을 능가하는 성능을 입증했다.
핵심 요약
음성을 악보로 변환하려면 리듬, 화성, 멜로디, 형식을 일관성 있게 이해해야 하는데 주석이 달린 녹음 부족과 부분 예측 오류 누적이 난제였다. SheetSage2는 합성 데이터, 구조화된 디코딩, 자기회귀 증류를 통합한 음악 변환 모델로, MIDI를 음성으로 렌더링한 합성 데이터로 대규모 학습을 가능하게 한다. 작업별 구조화된 디코더가 음악 정보와 시간 의존성을 통합해 일관성 있는 악보를 생성한다. 전체 요약 6문장 읽기 → 011 06:11 ▲ 341 · 댓글 79 16.9MB 경량 음성인식 모델 Whistle 공개 Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. AI · 머신러닝 · Whistle: Speech to Text in 16.9 MB
Key Point 극도로 경량화한 음성인식 모델로 온디바이스 처리가 가능해져, 엣지 환경에서 사용할 수 있는 선택지가 생겼다.
핵심 요약
Cactus Compute가 모바일, 웨어러블, 로봇, 스마트홈, 자동차, 마이크로컨트롤러용 음성인식 모델 Whistle을 공개했다. Whistle은 16.9MB 단일 파일로, CPU에서 의존성 없이 작동하며 기존 Needle 엔진과 같은 C++ 컨테이너에서 동작한다. 7개 언어(영어, 독일어, 프랑스어, 스페인어, 이탈리아어, 네덜란드어, 폴란드어) 지원하며, 최대 30초 음성을 온디바이스에서 처리한다. 전체 요약 12문장 읽기 → 012 00:11 ▲ 15 · 댓글 3 오디오와 비디오를 선택적으로 검색하는 추론 AI Omni-LLM을 기반으로 한 OmniSeek은 긴 오디오-비주얼 시퀀스를 통째로 처리하지 않고, 필요한 증거만 동적으로 선택해 검색하는 다중 턴 추론 에이전트이다. AI · 머신러닝 · OmniSeek: Native Tool Integration for Multi-turn Audio-Visual Reasoning
Key Point 더 긴 멀티미디어 콘텐츠를 효율적으로 분석하고 필요한 부분만 집중하는 AI의 접근 방식이 어떻게 작동하는지 보여주기 때문이다.
핵심 요약
Omni-LLM을 기반으로 한 OmniSeek은 긴 오디오-비주얼 시퀀스를 통째로 처리하지 않고, 필요한 증거만 동적으로 선택해 검색하는 다중 턴 추론 에이전트이다. 모델은 언제 보고 언제 들을지, 어느 시간 구간을 살펴볼지를 스스로 결정하며, 검색한 원본 오디오나 비주얼 세그먼트를 다시 컨텍스트에 추가해 다음 단계 추론을 지원한다. 이 능력을 학습시키기 위해 교차 모달리티 증거를 포함한 다중 홉 사고의 연쇄 궤적 17만 개(OmniTraj-170K)로 구성된 데이터셋을 합성했다. 전체 요약 5문장 읽기 → 013 21:11 당일 +257 완전 오프라인 음성 인식, 오픈소스 Handy 공개 OpenAI의 Whisper 모델을 기반으로 완전 로컬에서 동작하는 크로스플랫폼 음성-텍스트 변환 애플리케이션 Handy를 오픈소스로 공개했다. 오픈소스 · 도구 · cjpais/Handy · Rust
Key Point 클라우드 전송 없이 완전히 로컬에서 동작하는 오픈소스 음성 인식 도구로, 개인정보 보호를 중시하거나 오프라인 환경에서 음성 입력이 필요한 개발자와 사용자에게 실질적인 선택지가 된다.
핵심 요약
OpenAI의 Whisper 모델을 기반으로 완전 로컬에서 동작하는 크로스플랫폼 음성-텍스트 변환 애플리케이션 Handy를 오픈소스로 공개했다. 단축키를 누르고 말하면 음성이 텍스트로 변환되어 현재 활성 창의 텍스트 필드에 자동으로 입력되며, 음성 데이터가 외부로 전송되지 않는다. Whisper(Small/Medium/Turbo/Large) 또는 CPU 최적화된 Parakeet V3 모델 중 선택 가능하며, GPU 가속을 지원한다. 전체 요약 12문장 읽기 → 014 16:56 당일 +689 AI가 영상의 핵심만 자동으로 잘라주는 오픈소스 도구 비디오 링크 하나를 입력하고 플랫폼을 선택하면 자동으로 쇼츠 형식의 영상을 생성하는 오픈소스 도구 AutoClip을 공개했다. AI · 머신러닝 · zhouxiaoka/autoclip · Python
Key Point 긴 영상에서 플랫폼별 숏폼 콘텐츠를 자동으로 만드는 도구로, 팟캐스트·인터뷰 크리에이터나 마케팅팀이 수작업 편집 시간을 대폭 줄일 수 있다.
핵심 요약
비디오 링크 하나를 입력하고 플랫폼을 선택하면 자동으로 쇼츠 형식의 영상을 생성하는 오픈소스 도구 AutoClip을 공개했다. 긴 영상에서 AI가 하이라이트 장면을 감지해 자동으로 자르고, 자막과 발행 문안까지 함께 만든다. 틱톡, 유튜브 쇼츠, 인스타그램 릴스, 더우인, 샤오훙수, B스탠, 유튜브 등 8개 플랫폼의 화면 비율과 길이 요구사항에 맞춰 최대 10개 영상을 자동 생성한다. 전체 요약 10문장 읽기 → 015 21:11 당일 +592 라즈베리파이 E-ink 화면에 새 울음소리 인식해 1800년대 삽화로 표시 라즈베리파이와 E-ink 디스플레이를 활용한 새 감지 프레임 프로젝트로, 마이크를 통해 새 울음소리를 실시간 감지합니다. 하드웨어 · 시스템 · arnegiacomo/fugleramme · Python
Key Point 로컬 AI와 공개 도메인 삽화를 활용해 정원의 실시간 새 종을 감지·시각화하는 하드웨어 프로젝트로, 개발자가 자신의 창문에서 라이브 운영하며 관련 프로젝트들과 차별화된 예술성을 제시합니다.
핵심 요약
라즈베리파이와 E-ink 디스플레이를 활용한 새 감지 프레임 프로젝트로, 마이크를 통해 새 울음소리를 실시간 감지합니다. BirdNET-Go 음성 분류기로 인식한 새 종을 수동으로 자르고 손보정한 1800년대 자연사 삽화 800여 컷과 매칭해 표시합니다. 모든 처리가 로컬에서 이루어지며, 변화가 있을 때만 화면을 새로 그려 전력을 절약합니다. 전체 요약 5문장 읽기 → 016 03:10 ▲ 296 · 댓글 81 온디바이스 AI 모델 플랫폼 Desert Ant Labs 출범 유럽 AI 스타트업 Desert Ant Labs가 스마트폰·태블릿에서 직접 실행되는 경량 전문화 모델 18개를 공개했다. AI · 머신러닝 · Desert Ant Labs: local, fast models that run on device
Key Point 온디바이스 AI의 경제성이 바뀌고 있다. 클라우드 추론 비용이 없으면 개발자들은 모든 사용자 입력마다 모델을 실행할 수 있게 되고, 기존 클라우드 API 중심의 제품 설계 방식이 근본적으로 흔들린다.
핵심 요약
유럽 AI 스타트업 Desert Ant Labs가 스마트폰·태블릿에서 직접 실행되는 경량 전문화 모델 18개를 공개했다. 음성인식(Voz), 오디오 품질 개선(Clear), 개인정보 마스킹(Redact) 등 각 작업별로 최적화된 모델들로, 모두 밀리초 단위 응답 시간을 제공한다. Voz는 Whisper보다 4.7배 빠르고, Clear는 5분 음성을 1초에 처리하며, Redact는 12MB 크기로 GLiNER-PII(2.3GB)와 유사한 정확도를 낸다. 전체 요약 5문장 읽기 →