쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
14건 · "클러스터링"조건 지우기 ×
001 06:11 ▲ 113 · 댓글 29 Lonewolf 0.3 공개, Rust 기반 XMPP 서버에 페더레이션 추가 Rust로 작성된 단독형 XMPP 서버 Lonewolf 0.3이 발표되었으며, 가장 큰 변화는 페더레이션 지원으로 사용자들이 다른 XMPP 서버의 사람들과 메시지·상태·명단 구독을 주고받을 수 있게 되었다. 오픈소스 · 도구 · Lonewolf 0.3 – A standalone XMPP server written in Rust
Key Point Rust 기반 XMPP 서버가 페더레이션을 지원하면서 자체 인프라 구축이나 메시징 시스템 운영을 고려하는 개발자들에게 실질적인 선택지가 생겼다.
핵심 요약
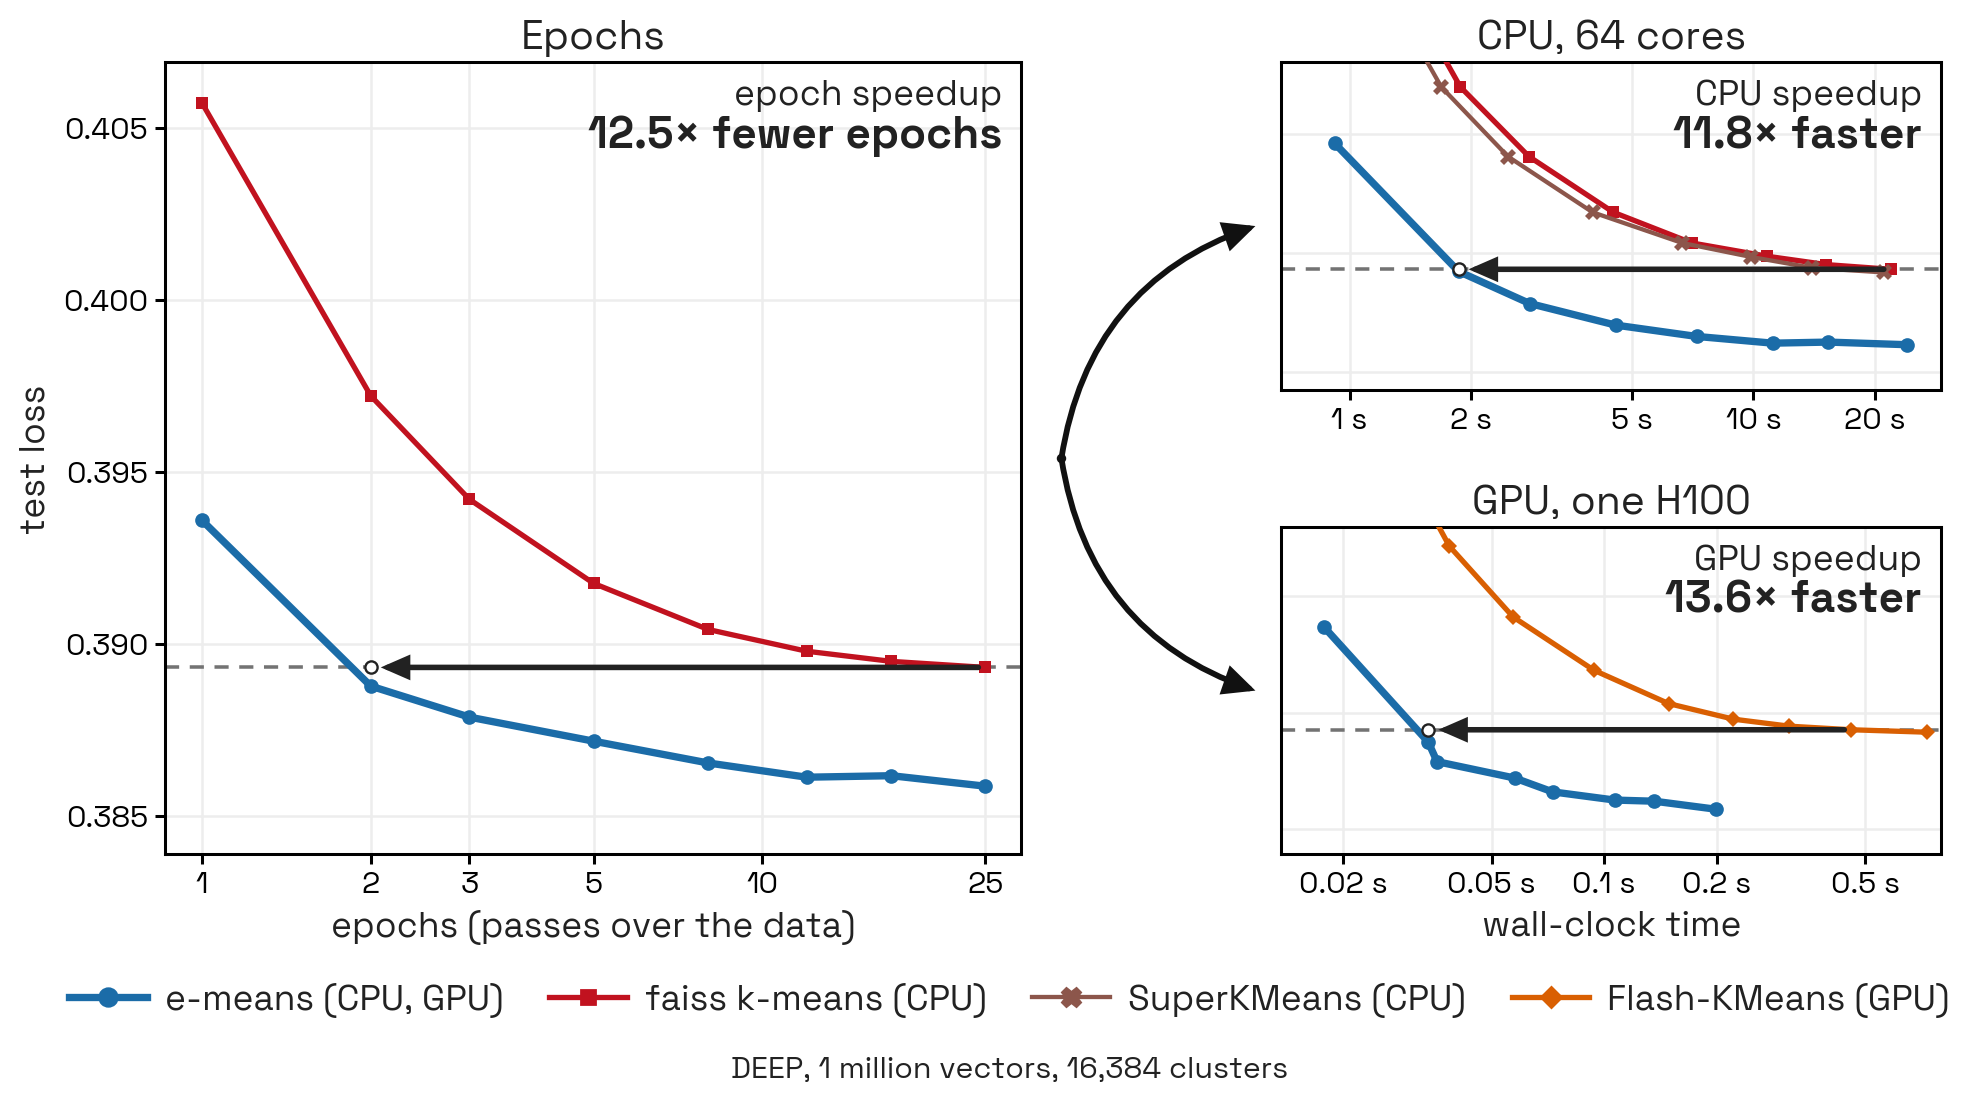
Rust로 작성된 단독형 XMPP 서버 Lonewolf 0.3이 발표되었으며, 가장 큰 변화는 페더레이션 지원으로 사용자들이 다른 XMPP 서버의 사람들과 메시지·상태·명단 구독을 주고받을 수 있게 되었다. 페더레이션은 호스트가 인증서와 공개 DNS 이름을 가지면 별도 설정 없이 기본 활성화되며, 서버 간 인증은 인증서 기반이고 SASL EXTERNAL을 지원하는 상대방이 필요하다. XEP-0288을 통해 양방향 페더레이션이 단일 연결로 공유되고, XEP-0478로 서버들이 스탠자 크기와 유휴 제한을 사전 공유한다. 전체 요약 12문장 읽기 → 002 21:11 ▲ 11 · 댓글 3 K-means보다 10배 빠른 클러스터링 알고리즘 'e-means' 공개 Lloyd's k-means를 개선한 새로운 클러스터링 알고리즘 e-means를 제안했다. AI · 머신러닝 · e-means: outperforming k-means (in one-tenth the epochs)
Key Point 대규모 임베딩 데이터 클러스터링 속도가 근본적으로 빨라져서, 검색·양자화·데이터 큐레이션 등 실무에서 k-means을 쓰는 작업들의 처리 시간을 획기적으로 단축할 수 있다.
핵심 요약
Lloyd's k-means를 개선한 새로운 클러스터링 알고리즘 e-means를 제안했다. 지수이동평균(exponential moving average) 최적화 절차와 미니배치 업데이트를 사용하며, 딥러닝 기반 인프라를 활용한다. 감쇠율(decay rate)과 배치 크기가 최종 성능에 미치는 영향에 대한 스케일링 법칙을 수립해 하이퍼파라미터 튜닝 없이 다양한 문제 크기에 적용 가능한 공식을 도출했다. 전체 요약 6문장 읽기 → 003 09:11 당일 +111 Meta의 고효율 벡터 유사도 검색 라이브러리 Faiss Meta의 Fundamental AI Research 팀이 개발한 고밀도 벡터의 유사도 검색과 클러스터링을 위한 C++ 라이브러리다. AI · 머신러닝 · facebookresearch/faiss · C++
Key Point 대규모 벡터 기반 검색 시스템을 구축하는 개발자와 연구자에게 필수적인 프로덕션급 도구로, GPU 가속을 통해 실시간 유사도 검색 성능을 대폭 향상시킬 수 있다.
핵심 요약
Meta의 Fundamental AI Research 팀이 개발한 고밀도 벡터의 유사도 검색과 클러스터링을 위한 C++ 라이브러리다. RAM에 맞지 않는 대규모 벡터 집합도 처리 가능하며, L2 거리나 내적, 코사인 유사도로 벡터를 비교한다. 이진 벡터와 압축 양자화 코드 기반 방식은 원본 벡터를 저장하지 않고 수십억 개 벡터를 단일 서버 메모리에서 확장 가능하다. 전체 요약 10문장 읽기 → 004 09:11 ▲ 135 · 댓글 24 애플, RAG 검색 속도 최대 11배 개선하는 신경망 기법 공개 추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. AI · 머신러닝 · Faster Retrieval for Better, More Efficient RAG
Key Point RAG 기반 AI 애플리케이션의 검색 속도가 최대 11배 개선되면 응답 시간 단축과 인프라 비용 절감이 직결되므로, 대규모 검색 시스템을 운영 중인 개발팀과 MLOps 담당자에게 즉시 실무 적용 가능한 최신 최적화 기법이다.
핵심 요약
추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. 기존 방법들은 클러스터링과 양자화로 속도를 높이지만 쿼리 분포를 무시하고, RAG에서는 사용자 질문(쿼리)과 문서(키)의 특성이 크게 달라 최적이 아니다. 애플 연구팀은 ICML 2026에서 쿼리별 라우팅을 학습하는 소형 신경망 두 가지를 제시했다: SupportNet은 각 클러스터별 지원함수(support function)를 학습해 라우팅 정확도를 높이고, KeyNet은 쿼리를 최적 키로 직접 변환해 기존 인덱스와 결합한다. 전체 요약 8문장 읽기 → 005 06:11 ▲ 115 · 댓글 4 로이드 알고리즘 10배 빠른 k-means 최적화 알고리즘 공개 Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. AI · 머신러닝 · E-means: 10x faster k-means at equal loss
Key Point 클러스터링은 벡터 양자화, 이미지 압축, 추천 시스템 등에 널리 쓰이는데, Lloyd 알고리즘이 표준이었던 상황에서 10배 빠르면서도 손실이 더 낮은 새 방식이 나왔으므로 기술 선택에 직결되는 소식이다.
핵심 요약
Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. e-means는 25 에포크에서 Lloyd가 도달하는 손실 수준에 1.2~3 에포크 안에 도달하며, 지스푸(Flash-KMeans) 대비 GPU에서 10~45배, Faiss 대비 CPU에서 8~15배 월클록 속도 개선을 실현했다. 핵심은 지수 이동 평균(exponential moving average)을 사용한 미니배치 업데이트로, 최신 할당(recent assignment)에 가중치를 두면서 과거 오래된 정보는 α 비율로 서서히 잊도록 설계했다. 전체 요약 10문장 읽기 → 006 18:11 ▲ 44 · 댓글 1 멀티태스크 이미지 생성 모델 'WeLM-Image' 공개, 단일 GPU 최적화 WeLM-Image는 텍스트-이미지 생성, 명령어 기반 편집, 다중 참조 합성을 통합한 멀티모달 기초 모델이다. AI · 머신러닝 · WeLM-Image: A Unified Image Generation Model towards Visual Intelligence
Key Point 단일 GPU에서 텍스트 생성·이미지 편집·참조 합성을 모두 수행하는 통합 모델이 나왔으며, 기존 오픈소스 경쟁 모델보다 벤치마크에서 앞선 성능을 보여준다.
핵심 요약
WeLM-Image는 텍스트-이미지 생성, 명령어 기반 편집, 다중 참조 합성을 통합한 멀티모달 기초 모델이다. 위챗 대규모 소비자 애플리케이션을 위해 단일 GPU 배포용으로 설계되었으며, 텍스트·참조 이미지·타겟 잠재변수를 하나의 인터리빙 시퀀스로 처리한다. Mixture-of-Transformers(MoT) 백본이 공유 어텐션과 독립적 이해·생성 파라미터를 결합하여 최적화 간섭을 제한한다. 전체 요약 9문장 읽기 → 007 18:11 ▲ 40 · 댓글 3 LLM 에이전트를 위한 도구 기반 환경 자동 합성 기법 ToolSpace LLM이 장기 작업을 수행하는 에이전트로 배포될 때 다양한 도구를 조합해 워크플로우를 실행하는데, 기존 MCP 환경 확장 방식은 데이터베이스와 시나리오부터 만들고 거기서 도구를 도출해 도구 인터페이스와 실제 환경이 맞지 않는 문제가 있다. AI · 머신러닝 · ToolSpace: Scaling Tool-Centric Environment Synthesis for Long-Horizon Agents
Key Point LLM 에이전트의 다중 도구 조합 능력 평가 방식이 혁신되고 있으며, 실행 기반 환경 합성이 기존 데이터 기반 방식보다 훨씬 효과적임을 보여주는 구체적 증거가 제시되었다.
핵심 요약
LLM이 장기 작업을 수행하는 에이전트로 배포될 때 다양한 도구를 조합해 워크플로우를 실행하는데, 기존 MCP 환경 확장 방식은 데이터베이스와 시나리오부터 만들고 거기서 도구를 도출해 도구 인터페이스와 실제 환경이 맞지 않는 문제가 있다. ToolSpace는 이 순서를 역으로 바꿔, 실제 MCP 서비스 실행 기록과 오픈 에이전트 코퍼스에서 인접한 호출들의 데이터·상태·재시도 의존성을 LLM 판단이 아닌 결정론적 규칙으로 추출하고, 가중치 있는 도구 조합 그래프를 환경으로 클러스터링한다. 상태 변경 환경만 데이터베이스를 합성하고, 조회·무상태 도구는 기록된 반환값을 재사용하며, 상태 인식 랜덤 워크와 롤백으로 각 체인을 자연어 작업으로 디컴파일하고 초기 상태에서 성공 재실행되는 샘플만 보관한다. 전체 요약 6문장 읽기 → 008 09:11 ▲ 117 · 댓글 14 넷핵 노움 광산의 던전 생성 알고리즘 넷핵의 노움 광산 던전은 셀룰러 오토마타를 이용해 유기적인 동굴 느낌을 만든다. 오픈소스 · 도구 · Dungeon Generation in the Gnomish Mines of NetHack
Key Point 인디게임부터 AAA까지 활용되는 절차적 생성 기법의 가장 오래되고 검증된 예시를 실전 코드 수준으로 분해한 글이라, 게임 개발자나 알고리즘 공부하는 개발자라면 실제 구현의 작은 결정(언버퍼링, 4번의 패스, 각 패스의 임계값)이 왜 필요했는지 이해할 수 있기 때문입니다.
핵심 요약
넷핵의 노움 광산 던전은 셀룰러 오토마타를 이용해 유기적인 동굴 느낌을 만든다. 생성 과정은 전체 셀의 40%를 무작위로 바닥으로 설정한 뒤 4번의 셀룰러 오토마타 패스를 거친다. 1패스는 언버퍼 방식으로 작동하며, 각 셀을 인접한 바닥 타일 개수에 따라 바닥 또는 암석으로 클러스터링한다(0-2개는 암석, 3-4개는 유지, 5-8개는 바닥). 전체 요약 6문장 읽기 → 009 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 010 21:11 ▲ 104 · 댓글 36 금융 시장 데이터를 생성 모델로 합성할 수 있을까 Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. AI · 머신러닝 · Can you use autoregressive diffusion to generate market data?
Key Point 시장 데이터를 직접 합성하는 생성 모델은 기존의 포인트 추정 방식과 달리 시장 미시구조의 구체적 이벤트까지 재현할 수 있어, 량자펀드의 백테스팅과 리스크 시뮬레이션 방법을 근본적으로 바꿀 수 있는 가능성을 보여준다.
핵심 요약
Jane Street 인턴이 자기회귀 확산 모델을 사용해 미국 주식 시장 데이터의 주문장 이벤트를 생성하는 생성 모델을 만들었다. 기존 예측 모델과 달리 가격 뿐 아니라 주문 타이밍, 취소, 체결 같은 구체적 이벤트까지 합성하는 모델을 목표로 했다. 시장 데이터는 이산적(주문 추가/제거)이면서도 연속적(가격, 타이밍 같은 고차원 변수)인 혼합 특성을 갖고 있어 모델링이 복잡하다. 전체 요약 10문장 읽기 → 011 09:11 ▲ 13 · 댓글 2 비디오 생성 AI의 메모리 병목 풀다, 시간일관성 있는 2비트 양자화 비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. AI · 머신러닝 · QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for Video World Models
Key Point 비디오 생성 모델의 메모리 병목을 풀 수 있는 새로운 양자화 방식이 제시됐으며, 기존 방법과 다른 각도로 주의 집중 메커니즘을 보존하는 전략이 핵심이다.
핵심 요약
비디오 월드 모델은 생성 과정에서 KV 캐시를 저장해 장시간 시간적 일관성을 유지하지만, 늘어나는 캐시가 배포의 주요 병목이 되어 저비트 양자화 연구가 필요한 상황이다. 기존 2비트 KV 캐시 양자화 방식들은 VBench에서 거의 무손실 성능을 보이지만, 비디오 월드 모델에 적용하면 시간적 깜빡임과 시각적 품질 저하가 심각하게 발생한다. Key 양자화가 Value보다 재구성 오류는 작지만 예상과 달리 출력 품질 저하를 더 크게 야기한다는 점을 발견했고, 이는 Key 섭동이 주의 집중(attention) 로짓을 변화시켜 쿼리가 선택하는 시간-공간 토큰을 이동시키기 때문이다. 전체 요약 7문장 읽기 → 012 21:11 ▲ 47 · 댓글 1 장시간 영상 생성 모델에 공간 기억 지능 더하다 장시간 영상 생성과 월드 모델은 사용자 행동과 과거 기억을 바탕으로 미래 관측치를 예측해 상호작용 가능한 엔터테인먼트와 embodied simulation을 실현했으나, 메모리 길이가 길어지고 구조가 복잡해질수록 장거리 공간 맥락 관리가 어려워진다. AI · 머신러닝 · Spatial Memory Intelligence: Endowing World Models with Understanding-Driven Long-Term Memory
Key Point MLLM의 공간 이해 능력을 처음으로 체계적으로 메모리 관리에 적용해 장시간 영상 생성의 근본적인 한계를 푸는 새로운 접근이다.
핵심 요약
장시간 영상 생성과 월드 모델은 사용자 행동과 과거 기억을 바탕으로 미래 관측치를 예측해 상호작용 가능한 엔터테인먼트와 embodied simulation을 실현했으나, 메모리 길이가 길어지고 구조가 복잡해질수록 장거리 공간 맥락 관리가 어려워진다. Spatial Memory Intelligence(SMI)는 다중모드 대규모 언어 모델(MLLM)의 공간 추론 능력을 활용해 장시간 영상 월드 모델의 메모리 관리를 체계화한 첫 프레임워크다. SMI는 공간 클러스터링, 클러스터 내 스파시피케이션, 행동 기반 검색, 신뢰도 기반 필터링 4개의 조정된 원자 연산을 도입한다. 전체 요약 4문장 읽기 → 013 22:26 당일 +122 로컬 저장소 기반 사진 관리 앱 Lap 공개 오픈소스 데스크톱 사진 관리자 Lap을 macOS, Windows, Linux에서 다운로드할 수 있다. 오픈소스 · 도구 · julyx10/lap · Vue
Key Point 클라우드 의존 없이 로컬에서만 동작하는 오픈소스 사진 관리자가 필요한 사용자에게, AI 검색·얼굴 인식·대규모 라이브러리 지원 등 엔터프라이즈급 기능을 무료로 제공한다.
핵심 요약
오픈소스 데스크톱 사진 관리자 Lap을 macOS, Windows, Linux에서 다운로드할 수 있다. 클라우드 업로드 없이 로컬 디스크에만 저장하며, 기존 폴더 구조 그대로 작업하는 폴더 우선 워크플로우를 제공한다. 로컬 AI 검색, 얼굴 인식 클러스터링, 유사도 검색, 50개 이상 언어의 다국어 검색을 지원한다. 전체 요약 11문장 읽기 → 014 15:10 ▲ 306 · 댓글 23 D2의 자동 레이아웃 알고리즘 TALA, 오픈소스 공개 Terrastruct의 TALA(자동 레이아웃 알고리즘)가 D2와 같은 MPL-2.0 라이선스로 오픈소스 공개됐다. 오픈소스 · 도구 · TALA Is Open-Source
Key Point 소프트웨어 아키텍처 다이어그램 작성 시 직교 레이아웃 방식의 새로운 선택지가 생겼으며, 특히 AI와 함께 사용할 때 좌표 고정 기능이 유용해 다양한 설계 워크플로우를 가능하게 한다.
핵심 요약
Terrastruct의 TALA(자동 레이아웃 알고리즘)가 D2와 같은 MPL-2.0 라이선스로 오픈소스 공개됐다. 건축 다이어그램을 염두에 둔 직교 레이아웃 엔진으로, 화이트보드 스타일의 다이어그램을 우선하며 DAG 기반 레이아웃과 다르게 한 방향으로 성장하지 않는다. 대칭성, 노드 클러스터링, 흐름 등 여러 심미적 요소를 고려해 다이어그램을 생성한다. 전체 요약 6문장 읽기 →