쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
3건 · "FAISS"조건 지우기 ×
001 09:11 당일 +111 Meta의 고효율 벡터 유사도 검색 라이브러리 Faiss Meta의 Fundamental AI Research 팀이 개발한 고밀도 벡터의 유사도 검색과 클러스터링을 위한 C++ 라이브러리다. AI · 머신러닝 · facebookresearch/faiss · C++
Key Point 대규모 벡터 기반 검색 시스템을 구축하는 개발자와 연구자에게 필수적인 프로덕션급 도구로, GPU 가속을 통해 실시간 유사도 검색 성능을 대폭 향상시킬 수 있다.
핵심 요약
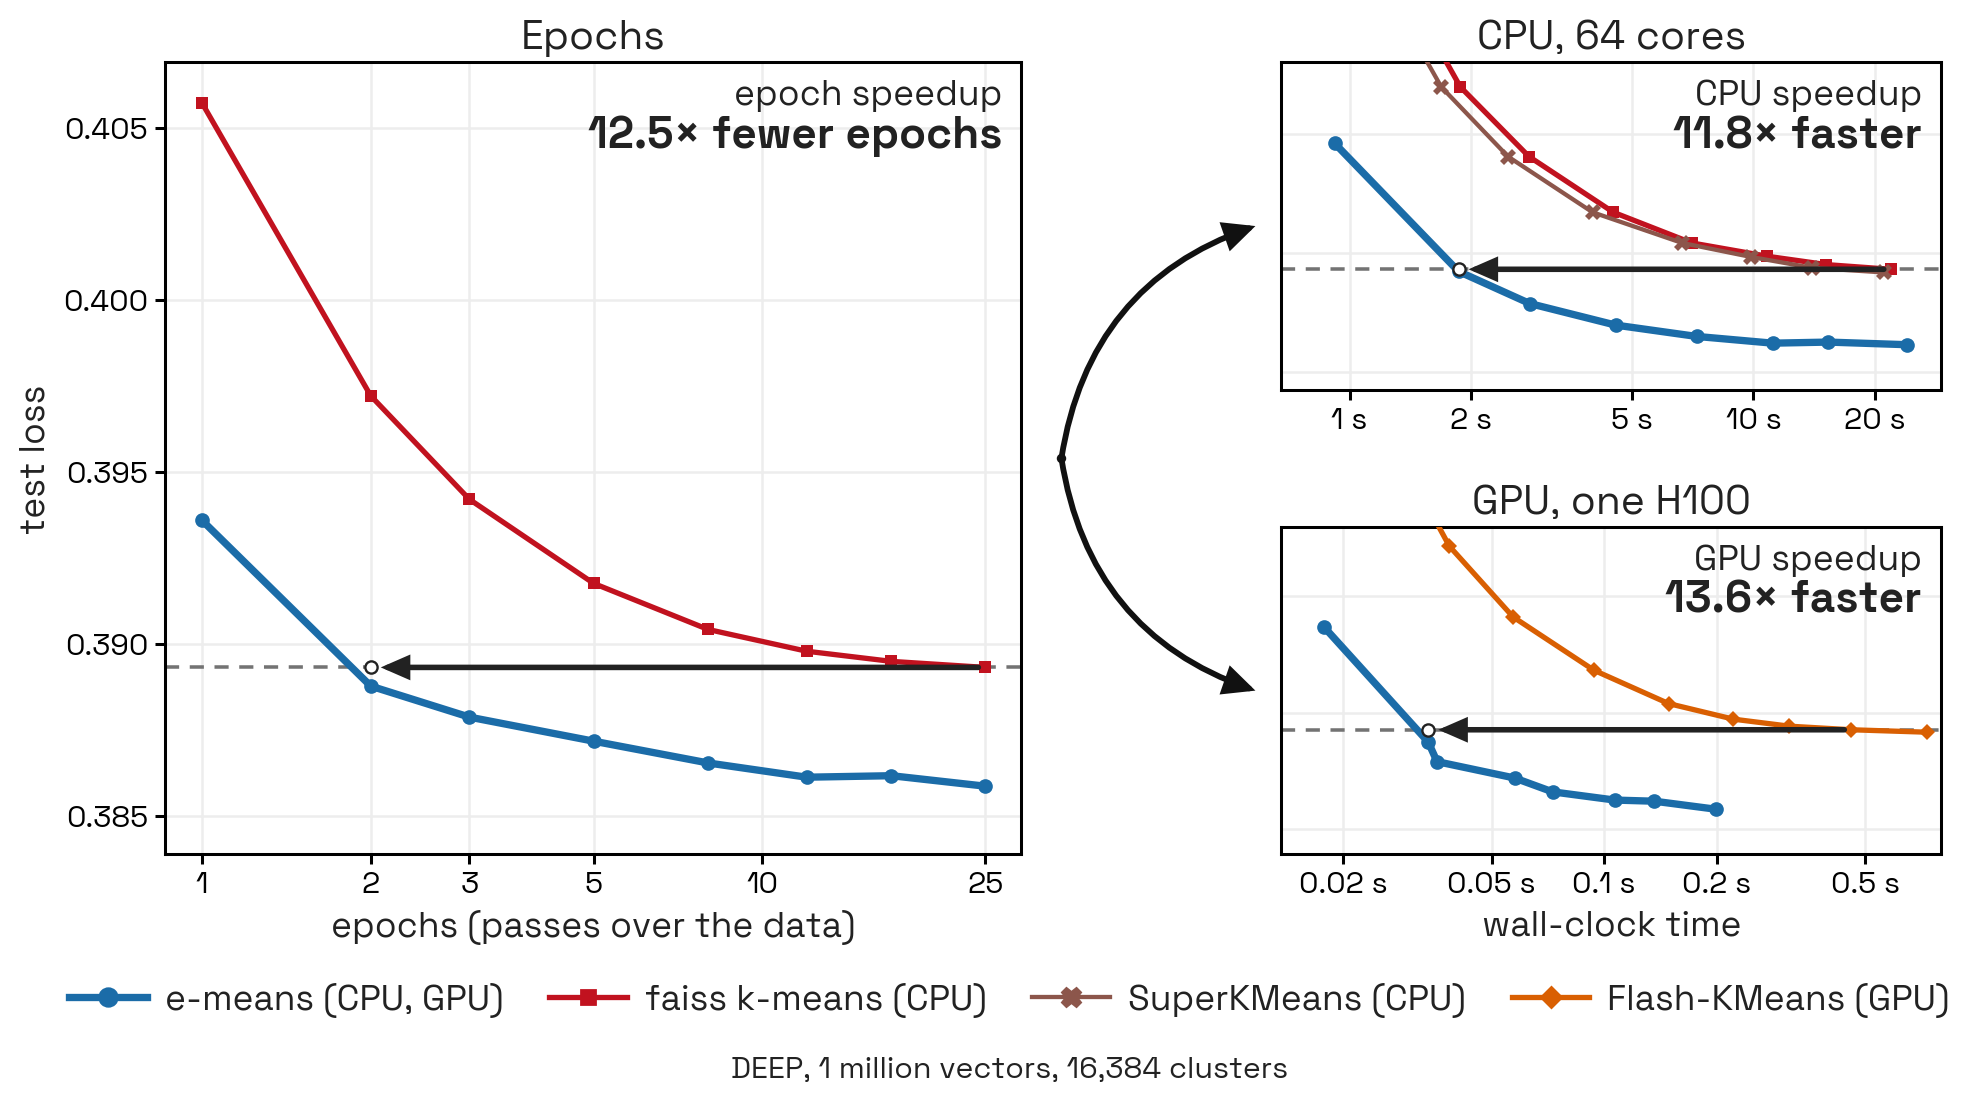
Meta의 Fundamental AI Research 팀이 개발한 고밀도 벡터의 유사도 검색과 클러스터링을 위한 C++ 라이브러리다. RAM에 맞지 않는 대규모 벡터 집합도 처리 가능하며, L2 거리나 내적, 코사인 유사도로 벡터를 비교한다. 이진 벡터와 압축 양자화 코드 기반 방식은 원본 벡터를 저장하지 않고 수십억 개 벡터를 단일 서버 메모리에서 확장 가능하다. 전체 요약 10문장 읽기 → 002 06:11 ▲ 115 · 댓글 4 로이드 알고리즘 10배 빠른 k-means 최적화 알고리즘 공개 Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. AI · 머신러닝 · E-means: 10x faster k-means at equal loss
Key Point 클러스터링은 벡터 양자화, 이미지 압축, 추천 시스템 등에 널리 쓰이는데, Lloyd 알고리즘이 표준이었던 상황에서 10배 빠르면서도 손실이 더 낮은 새 방식이 나왔으므로 기술 선택에 직결되는 소식이다.
핵심 요약
Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. e-means는 25 에포크에서 Lloyd가 도달하는 손실 수준에 1.2~3 에포크 안에 도달하며, 지스푸(Flash-KMeans) 대비 GPU에서 10~45배, Faiss 대비 CPU에서 8~15배 월클록 속도 개선을 실현했다. 핵심은 지수 이동 평균(exponential moving average)을 사용한 미니배치 업데이트로, 최신 할당(recent assignment)에 가중치를 두면서 과거 오래된 정보는 α 비율로 서서히 잊도록 설계했다. 전체 요약 10문장 읽기 → 003 21:11 당일 +115 메모리 4분의 1만 써도 FAISS보다 빠른 벡터 검색 엔진 Google의 TurboQuant 알고리즘 기반 Rust 벡터 인덱스로, Python 바인딩을 제공한다. AI · 머신러닝 · RyanCodrai/turbovec · Rust
Key Point 벡터 데이터베이스의 메모리 사용과 검색 성능은 RAG 시스템의 핵심이므로, 기존 방식 대비 4배 더 효율적이면서 더 빠른 솔루션의 등장은 프로덕션 환경 선택에 직접 영향을 미친다.
핵심 요약
Google의 TurboQuant 알고리즘 기반 Rust 벡터 인덱스로, Python 바인딩을 제공한다. 1,000만 문서 기준 float32 31GB가 4GB로 압축되며 FAISS IndexPQFastScan보다 빠른 검색 속도를 낸다. 온라인 인제스트 지원으로 훈련 단계 없이 벡터를 바로 색인하고, 증분 저장으로 변경분만 동기화한다. 전체 요약 6문장 읽기 →