쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "샘플링"조건 지우기 ×
001 21:11 당일 +736 PS5·캡처 카드를 120fps로 고주파 재생하는 Veyra 2.1.5 공개 Windows용 GPU 기반 실시간 영상 개선 도구 Veyra 2.1.5를 공개했다. 초해상화·노이즈 제거·HDR·프레임 생성 기술을 조합해 PS5·Xbox·PC·캡처 카드 영상을 실시간으로 고화질화할 수 있다. AI · 머신러닝 · Likely7/Veyra-NRVideo · C++
Key Point DLSS 5와 AI 초해상화로 기존 영상을 고주파 고화질로 업스케일링하는 기술이 실시간 게임·방송 녹화에 어떻게 적용되는지 보여주는 실제 구현체다.
핵심 요약
Windows용 GPU 기반 실시간 영상 개선 도구 Veyra 2.1.5를 공개했다. 초해상화·노이즈 제거·HDR·프레임 생성 기술을 조합해 PS5·Xbox·PC·캡처 카드 영상을 실시간으로 고화질화할 수 있다. 2.1.2 버전 주요 업데이트는 RTX Video SR 듀얼 초해상화, SR 후 다운샘플링, NVIDIA Low Latency 지원, RX 7000 노이즈 제거 실험 기능을 추가했다. 2.1.1은 처리된 영상 녹화·오디오 포함, 90도 회전 재생, 레이어별 노이즈 제거 강도 조절, 내보내기 크기 조절 기능을 지원한다. 전체 요약 10문장 읽기 → 002 18:11 ▲ 14 · 댓글 5 GTA V를 AI 훈련장으로: 게임 과제로 강화학습 평가 AAA 게임은 에이전트의 지각, 추론, 제어 능력을 평가하기 위한 풍부한 테스트베드를 제공하지만, 과제 성공 여부를 자동으로 검증하기 어려워 수동 평가가 필요했다. AI · 머신러닝 · GTAGym: AAA Game Tasks Environment for Evaluation and Reinforcement Learning
Key Point AAA 게임 환경에서 AI 에이전트를 객관적으로 평가하고 강화학습으로 훈련할 수 있는 자동화된 벤치마크가 생겨, 복잡한 현실 같은 과제에서 AI 성능을 측정하는 새로운 길이 열렸다.
핵심 요약
AAA 게임은 에이전트의 지각, 추론, 제어 능력을 평가하기 위한 풍부한 테스트베드를 제공하지만, 과제 성공 여부를 자동으로 검증하기 어려워 수동 평가가 필요했다. 연구진은 GTA V 작업 평가 및 강화학습을 위한 환경 및 프레임워크인 GTAGym을 개발했다. GTAGym의 평가 벤치마크인 GTAVBench는 GTA V 메인 스토리 미션에서 추출한 9개 작업 계열의 103개 온라인 과제와 GTA V 이미지 기반 47개 사격·저격 과제를 포함한다. 전체 요약 8문장 읽기 → 003 15:10 ▲ 39 · 댓글 7 표 데이터 '생성·보충·예측' 한 모델으로 모두 해낼 수 있을까 표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. AI · 머신러닝 · One Table, Many Queries: Benchmarking Generalist Tabular Models Across Generation, Imputation, and Prediction
Key Point 표 데이터 모델링의 세 가지 핵심 작업을 단일 모델로 수행할 수 있는지 처음 체계적으로 평가한 벤치마크로, 현실의 데이터 처리 파이프라인을 통합 설계할지 말지의 기준을 제시한다.
핵심 요약
표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. 연구팀은 56개 데이터셋과 46개 모델을 포함한 'One Table Benchmark'를 만들어 20가지 능력 축 아래 세 작업을 통일된 조건에서 비교했다. 다섯 가지 신경망을 일곱 가지 목표 조합으로 훈련한 결과, 보충과 예측은 수치 회복과 의존성 보존을 통해 연결되고, 생성은 예측 유틸리티를 통해 둘 모두와 연결된다. 전체 요약 9문장 읽기 → 004 12:11 ▲ 113 · 댓글 51 추론은 토큰 공간 경로찾기, 답으로 수렴하지 않음 모델이 더 길게 생각하면 정확도가 높아진다는 직관은 불완전하다. RL 훈련 중에는 모델이 더 긴 체인을 생성할수록 정확해지지만, 훈련된 모델에서 하나의 체인을 강제로 더 길게 하면 처음에만 도움이 되고 나중에는 악화되기도 한다. AI · 머신러닝 · What objective is reasoning solving?
Key Point 개별 경로의 수렴 보장이 없다는 점이 현재 추론 모델의 동작 원리(더 길게 생각해도 정확도가 악화될 수 있는 이유)를 설명하며, 검증자 기반 RL 훈련의 한계와 보상 해킹 가능성을 명확히 한다.
핵심 요약
모델이 더 길게 생각하면 정확도가 높아진다는 직관은 불완전하다. RL 훈련 중에는 모델이 더 긴 체인을 생성할수록 정확해지지만, 훈련된 모델에서 하나의 체인을 강제로 더 길게 하면 처음에만 도움이 되고 나중에는 악화되기도 한다. 추론을 토큰 공간의 경로찾기로 보면 이 모순을 설명할 수 있다. 모델은 같은 문제에 대해 여러 다른 경로를 생성할 수 있으며, 각 경로는 프롬프트에서 시작해 답으로 끝난다. 성공 확률은 모든 성공 경로의 생성 확률의 합으로, RL 훈련은 이 총합을 최대화한다. 개별 경로는 정답으로 수렴하도록 보장되지 않는다. 목표는 성공 확률 p_x를 높이는 것뿐이다. 베스트-오브-k 샘플링으로 k번 샘플링하면 성공 확률이 1 - (1-p_x)^k로 올라간다. 전체 요약 8문장 읽기 → 005 09:11 ▲ 118 · 댓글 44 마이크로소프트, macOS용 Sysinternals Process Explorer 공개 마이크로소프트가 Windows 전용이던 Process Explorer를 macOS에 네이티브로 이식했다. 인프라 · 데브옵스 · Process Explorer for macOS
Key Point Windows 관리자의 필수 도구가 macOS에서도 공식 지원되면서 Mac 개발자와 시스템 관리자가 같은 수준의 프로세스 모니터링 경험을 얻을 수 있게 되었다.
핵심 요약
마이크로소프트가 Windows 전용이던 Process Explorer를 macOS에 네이티브로 이식했다. Swift와 SwiftUI, AppKit으로 구축되었으며 libproc, sysctl, Mach 등 공개 macOS API를 통해 프로세스 정보를 수집한다. 프로세스 트리, 모듈/핸들/스레드 검사, 프로세스별 속성, 시스템 전체 성능 그래프, 코드 서명 검사 기능을 제공한다. 전체 요약 12문장 읽기 → 006 21:11 ▲ 111 · 댓글 14 텍스트 생성 21배 빨라지는 단계형 모델링 기법 디퓨전 언어 모델은 자동회귀 모델보다 빠른 병렬 샘플링을 제공하지만, 샘플링 단계가 적을수록 품질이 급격히 떨어지고 매번 전체 시퀀스를 처리하며 학습 속도가 느린 문제가 있다. AI · 머신러닝 · Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation
Key Point 대규모 모델 추론의 병목인 생성 속도를 10배 이상 높이면서 품질을 유지하는 기법이 나왔으므로, LLM 배포와 실시간 서비스에 영향을 줄 수 있다.
핵심 요약
디퓨전 언어 모델은 자동회귀 모델보다 빠른 병렬 샘플링을 제공하지만, 샘플링 단계가 적을수록 품질이 급격히 떨어지고 매번 전체 시퀀스를 처리하며 학습 속도가 느린 문제가 있다. Next-Concept Modeling(NCM)은 2단계 코스-투-파인 프레임워크로, 다중 스케일 VQ-VAE가 텍스트를 이산 코드의 계층으로 인코딩하고 트랜스포머가 각 단계마다 한 수준씩 병렬로 생성한다. LM1B 벤치마크에서 NCM은 가장 강력한 디퓨전 모델보다 나은 생성 복잡도를 달성하면서 21배 빠르게 동작한다. 전체 요약 5문장 읽기 → 007 18:15 스타 1,579 LaTeX 페이지 여백에 꽃과 곤충을 절차적으로 생성하는 Florilegium 2.0 공개 LuaLaTeX와 pdfLaTeX에서 동작하는 florilegium 패키지는 델프트블루 스타일의 꽃과 동물을 페이지 여백에 절차적으로 생성하며, 모든 형태가 코드로 계산되어 PDF에 직접 기록된다. 오픈소스 · 도구 · kevinraymond/florilegium · TeX
Key Point TeX 문서의 미학을 완전히 새로운 차원으로 끌어올린 접근법으로, 이미지나 외부 자산 없이 순수 코드만으로 생성되는 식물은 매번 다르게 문서 공간에 적응하는 역동적인 타이포그래피 실험이다.
핵심 요약
LuaLaTeX와 pdfLaTeX에서 동작하는 florilegium 패키지는 델프트블루 스타일의 꽃과 동물을 페이지 여백에 절차적으로 생성하며, 모든 형태가 코드로 계산되어 PDF에 직접 기록된다. 2.0 버전부터는 손으로 설계한 모양 대신 게놈에서 샘플링한 식물 종을 그리므로, 같은 코드라도 시드값에 따라 다른 정원이 자란다. 문서의 텍스트 아래 남은 빈 공간에 식물을 채우는 탐욕적 공간 채우기 루프를 사용하며, 1998년 논문(Wong, Zongker & Salesin)의 아이디어를 바탕으로 한다. 전체 요약 12문장 읽기 → 008 18:15 스타 1,469 Pika H3 Flex: 영상·음성 생성 AI 로컬 추론 오픈소스화 Pika H3 Flex는 MiniMax-H3을 기반으로 한 포스트트레이닝 모델로, 전문 콘텐츠 제작자를 위해 텍스트와 멀티모달 참조 입력으로 동기화된 영상과 음성을 생성한다. AI · 머신러닝 · Pika-Labs/Pika-H3-Flex · Python
Key Point 전문 크리에이터가 로컬 PC에서 고제어 텍스트·참조 기반 영상 생성을 무료로 시작할 수 있으며, 프롬프트나 프레임으로 카메라 움직임까지 직접 조종할 수 있는 열린 플랫폼이 나왔다.
핵심 요약
Pika H3 Flex는 MiniMax-H3을 기반으로 한 포스트트레이닝 모델로, 전문 콘텐츠 제작자를 위해 텍스트와 멀티모달 참조 입력으로 동기화된 영상과 음성을 생성한다. 6단계 샘플링으로 480p·768p 네이티브 해상도(11개 종횡비 지원)에서 5~15초 영상을 생성하며, 24fps 스테레오 음성이 MP4에 혼합된다. FL2VA 어댑터는 텍스트 또는 첫프레임/마지막프레임 조건 입력을, Ref2VA 어댑터는 최대 12개 참조(이미지 9개·영상 3개·오디오 3개)를 지원한다. 전체 요약 10문장 읽기 → 009 15:10 ▲ 51 · 댓글 3 벤치마크 평가 시간 50% 단축, BestRand 방법론 모델 평가에 소요되는 시간과 비용을 줄이기 위해 전체 벤치마크 대신 일부 항목만 평가하는 벤치마크 압축 기법의 안정성을 분석했다. AI · 머신러닝 · Random Is Almost Enough? Stable and Low-Cost Benchmark Compression via BestRand
Key Point 모델 평가 비용이 증가하는 상황에서 평가 시간을 절반 이상 줄이면서도 결과의 신뢰성을 보장할 수 있는 방법으로, 대규모 언어모델 연구자들이 즉시 적용할 수 있다.
핵심 요약
모델 평가에 소요되는 시간과 비용을 줄이기 위해 전체 벤치마크 대신 일부 항목만 평가하는 벤치마크 압축 기법의 안정성을 분석했다. 전체 벤치마크 점수를 부분 평가로 추정할 때 오류 분포를 수학적으로 유도한 결과, 대부분 오류는 작지만 일부는 매우 큰 오류가 발생하는 긴 꼬리 분포를 확인했다. 무작위 샘플링만으로도 높은 확률로 우수한 성능을 얻을 수 있지만, 드문 대규모 오류로 인해 불안정성이 남아 있다. 전체 요약 8문장 읽기 → 010 06:11 새 버전 Anthropic SDK Python v2.6.0 출시 Anthropic SDK Python이 v2.6.0으로 업데이트되었다. 오픈소스 · 도구 · anthropics/anthropic-sdk-python@v2.6.0
Key Point SDK 사용자에게 필요한 에러 처리 방식의 변경과 새로운 기능들이 추가되었으므로, 기존 코드와의 호환성 확인 및 신기능 활용을 위해 확인해야 한다.
핵심 요약
Anthropic SDK Python이 v2.6.0으로 업데이트되었다. API 계층에서 요청량 제한(ramp limit) 에러에 대한 에러 코드가 추가되었다. 외부 키 검증 실패에 대한 에러 코드가 새로 정의되었다. 전체 요약 8문장 읽기 → 011 03:11 ▲ 15 · 댓글 2 추측 디코딩 성능 41% 높이는 병렬 온폴리시 디스틸레이션 기법 LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. AI · 머신러닝 · SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding
Key Point 추측 디코딩의 병렬화와 감독 신호 수집 방식을 근본적으로 개선해 LLM 추론 속도를 획기적으로 높일 수 있는 기술이다.
핵심 요약
LLM 추론을 가속화하는 추측 디코딩(SD)은 병렬 초안 생성으로 한 번의 포워드 패스에서 여러 토큰을 예측하지만, 전체 속도는 여전히 채택 길이(acceptance length)에 좌우된다. 온폴리시 디스틸레이션(OPD)은 훈련된 초안 생성기를 채택 길이 한계 이상으로 끌어올릴 수 있으나, 기존 방식은 순차적인 초안-검증 롤아웃을 통해 감독 신호를 수집한다. 본 논문의 핵심 아이디어는 온폴리시 감독 신호가 이 순차 의존성을 벗을 수 있다는 것이다: 초안 블록은 참조 접두사와 초안으로 샘플링한 이력만으로도 감독될 수 있다. 전체 요약 8문장 읽기 → 012 21:11 ▲ 125 · 댓글 20 Three.js로 액체 파운데이션 흐르는 효과 만들기 2021년 일본 화장품 브랜드의 액체 파운데이션 프로모션 프로젝트를 위해 개발한 액체 확산 효과를 Three.js로 구현한 과정을 설명한다. 웹 · 프론트엔드 · Spreading Liquid with Three.js
Key Point 웹에서 실시간으로 동작하는 물리 기반 액체 시뮬레이션의 실제 구현 과정과 시각적 효과 우선의 설계 선택을 상세히 보여주므로, Three.js와 WebGL 셰이더를 다루는 개발자에게 참고할 만한 기술 문서다.
핵심 요약
2021년 일본 화장품 브랜드의 액체 파운데이션 프로모션 프로젝트를 위해 개발한 액체 확산 효과를 Three.js로 구현한 과정을 설명한다. 마우스나 손가락으로 드래그하면 액체가 밀려나고 주변 액체가 함께 움직이는 현상을 재현하기 위해 유체 시뮬레이션 알고리즘을 선택했다. 높이 맵을 사용해 액체의 두께를 표현하며, 유체 시뮬레이션에서 생성된 속도 맵으로 액체의 움직임을 업데이트한다. 전체 요약 10문장 읽기 → 013 18:13 ▲ 12 · 댓글 2 확산 모델의 4단계 생성, 속도 대립적 증류로 정확도 높인다 적은 샘플링 스텝으로도 고품질을 유지하는 확산 및 흐름 모델 증류가 과제인데, 기존 스코어 증류는 중간 단계에서 학생 모델의 분포 추적이 어렵다는 한계가 있다. AI · 머신러닝 · VA-TDM: A Unified View for Improving Few-Step Diffusion Models by Velocity Adversarial Distillation
Key Point 적은 샘플링 스텝에서도 높은 생성 품질을 유지하는 새로운 증류 방법이 텍스트-이미지, 텍스트-비디오 등 실용적인 생성 작업에 즉시 적용될 수 있다.
핵심 요약
적은 샘플링 스텝으로도 고품질을 유지하는 확산 및 흐름 모델 증류가 과제인데, 기존 스코어 증류는 중간 단계에서 학생 모델의 분포 추적이 어렵다는 한계가 있다. 흐름 일치 방식은 학생의 샘플링 과정에서 구성한 속도 필드를 통해 더 유연한 감독을 제공한다. 연구팀은 학습된 비평자를 사용해 학생과 교사의 속도 필드를 비교하고 불일치를 피드백으로 삼는 속도 대립적 증류(VAD)를 제안했다. 전체 요약 7문장 읽기 → 014 18:13 ▲ 38 · 댓글 4 LLM 에이전트의 강화학습, 예산에 따라 성능 급락 다중 턴 강화학습(RL)은 장시간 작업에서 효과적이지만, 상호작용 제약에 매우 민감한 성능 변화를 보인다. AI · 머신러닝 · What Does Multi-Turn Reinforcement Learning Really Improve in LLM Agents?
Key Point LLM 에이전트의 강화학습이 실제 배포 환경에서 어떤 제약을 받는지 밝히고, 기존 방식의 한계를 극복할 수 있는 새로운 접근법을 제시한다.
핵심 요약
다중 턴 강화학습(RL)은 장시간 작업에서 효과적이지만, 상호작용 제약에 매우 민감한 성능 변화를 보인다. Pass@(K,T) 지표로 샘플링 폭 K와 상호작용 깊이 T를 평가한 결과, 상호작용 예산이 충분할 때만 궤적 수준의 RL 이점이 나타나고 예산이 줄어들면 성능이 급격히 하락한다. 에이전트 RL은 개별 의사결정 품질을 균등하게 높이지 못하며, 강점은 오류 복구와 장시간 탄력성에 집중되어 있다. 전체 요약 6문장 읽기 → 015 18:13 ▲ 89 · 댓글 1 스트리밍 영상 이해를 위한 턴 단위 강화학습 방법 TurnWise 제안 스트리밍 영상 이해는 모델이 반응할지 계속 관찰할지를 반복해서 결정해야 하는 문제이다. AI · 머신러닝 · Turns Matter: Advancing Streaming Video RL via Turn-Level Credit
Key Point 스트리밍 데이터 처리에서 적절한 시점의 결정이 중요한 상황에서, 기존의 궤적 수준 학습의 한계를 턴 단위 신용 할당으로 극복하는 새로운 접근 방식을 제시한다.
핵심 요약
스트리밍 영상 이해는 모델이 반응할지 계속 관찰할지를 반복해서 결정해야 하는 문제이다. 기존의 Group Relative Policy Optimization(GRPO) 방식은 전체 궤적(trajectory) 수준의 장점만 공유하며, 이는 초기 성공 후 중복된 응답을 강화하고 초기 실패 후 유용한 후속 응답을 억제한다. TurnWise는 턴 단위 GRPO 프레임워크로, 각 스트리밍 결정마다 학습을 정렬하여 궤적 수준 피드백과 턴 수준 상호작용의 불일치를 해결한다. 전체 요약 6문장 읽기 → 016 15:11 ▲ 47 · 댓글 2 범용 로봇 정책을 대규모로 평가하는 RoboColosseum 프레임워크 공개 로봇 정책의 범용성을 평가하기 위해 전 세계 124개 사이트의 로컬 로봇 네트워크를 연결한 분산 평가 프레임워크 RoboColosseum을 제시했다. 하드웨어 · 시스템 · RoboColosseum: Evaluating Physical Intelligence at Scale In-The-Wild
Key Point 로봇 정책의 범용성과 적응력을 대규모 분산 환경에서 검증한 첫 사례로, 재현 불가능성 문제를 해결하고 실제 환경에서의 로봇 학습 진전을 측정하는 새로운 평가 방법론을 제시한다.
핵심 요약
로봇 정책의 범용성을 평가하기 위해 전 세계 124개 사이트의 로컬 로봇 네트워크를 연결한 분산 평가 프레임워크 RoboColosseum을 제시했다. 5개의 VLA(시각-언어-행동) 정책과 3개의 최신 AI 에이전트를 SO-101, Franka, Bimanual-YAM, G1 Humanoid 4개 로봇 플랫폼에서 평가했다. Open Track에서는 과제별 적응 없이 5,699회의 페어링 비교를 수행했으며, 최신 AI 에이전트들이 특화된 VLA 정책과 대등한 성능을 보였지만 모든 시스템이 개방형 과제에서 안정적 완료에 어려움을 겪었다. 전체 요약 7문장 읽기 → 017 12:11 ▲ 10 · 댓글 1 LLM 강화학습의 훈련-추론 괴리, 근원과 해법 LLM의 온폴리시 강화학습에서는 훈련 시 샘플링 엔진과 그래디언트 계산 모듈이 분리되어 있어, 현재 정책이 아닌 과거 정책에서 샘플링된 오프폴리시 데이터가 발생한다. AI · 머신러닝 · On the Origin and Evolution of Training-Inference Mismatch in LLM Reinforcement Learning
Key Point LLM 강화학습에서 훈련과 추론의 괴리가 발생하는 근본 원인을 규명하고, 모델 성능 저하를 방지하는 실질적 보정 방법을 제시하므로 프로덕션 LLM 훈련에 직접 적용할 수 있다.
핵심 요약
LLM의 온폴리시 강화학습에서는 훈련 시 샘플링 엔진과 그래디언트 계산 모듈이 분리되어 있어, 현재 정책이 아닌 과거 정책에서 샘플링된 오프폴리시 데이터가 발생한다. 이 훈련-추론 괴리는 두 가지 원인에서 비롯된다: 샘플링 엔진의 수치적 오류와 비동기 샘플링으로 인한 가중치의 지연이다. 한 가지 원인에 대한 보정이 다른 원인에서는 실패하는 문제를 해결하기 위해, 논문은 괴리의 원인에 따라 어떤 보정이 필요한지 규명한다. 전체 요약 10문장 읽기 → 018 00:11 ▲ 40 · 댓글 1 코딩 AI 학습 데이터 수집을 위한 이력 기반 궤적 수집 방법 제시 코딩 에이전트가 저장소 이슈를 해결하는 과정에서 생기는 긴 탐색·편집·검증 수열들이 학습 데이터로 활용되고 있다. AI · 머신러닝 · SWE-Trail: History-Guided Trajectory Collection for Coding Agent Training
Key Point 코딩 AI 학습에 쓰이는 데이터 수집 방식이 최종 모델 성능을 크게 좌우하는데, 이력 정보를 효과적으로 활용하면서도 학습-테스트 간 불일치를 피하는 구체적 방법을 제시한다.
핵심 요약
코딩 에이전트가 저장소 이슈를 해결하는 과정에서 생기는 긴 탐색·편집·검증 수열들이 학습 데이터로 활용되고 있다. 기존 방식은 각 이슈마다 여러 궤적을 독립적으로 샘플링한 뒤 선별하지만, 샘플이 많아질수록 중복이 증가하고 이전 데이터가 향후 수집 방향을 안내할 수 있다는 점을 무시한다. 이력을 코딩 에이전트의 컨텍스트로 직접 제공하면 학습 시 그 조언에 의존하게 되어 테스트 시 사용할 수 없는 정보에 모델이 편향되는 문제가 생긴다. 전체 요약 7문장 읽기 → 019 18:11 새 버전 Ollama v0.40.14 출시, Claude 모델 토큰 제한 개선 Ollama launch claude 명령이 Claude 모델의 출력 토큰 제한을 적용하여 클라우드 모델이 기본 128k 상한에 걸리지 않도록 개선했다. AI · 머신러닝 · ollama/ollama@v0.40.14
Key Point Claude 모델 통합 개선과 OpenAI 호환성 버그 수정으로 로컬 LLM 모델 서빙의 안정성과 호환성이 강화된다.
핵심 요약
Ollama launch claude 명령이 Claude 모델의 출력 토큰 제한을 적용하여 클라우드 모델이 기본 128k 상한에 걸리지 않도록 개선했다. /api/chat의 웹 검색 응답이 압축된 응답을 포함하여 올바르게 디코딩되도록 수정했다. OpenAI 호환 엔드포인트가 더 이상 모델의 기본 샘플러 설정을 덮어쓰지 않으므로, 온도/top_p를 지정하지 않은 클라이언트는 1.0 대신 모델의 기본값을 받는다. 전체 요약 7문장 읽기 → 020 03:11 ▲ 12 · 댓글 2 어두운 사진을 한 번에 살리는 생성형 AI 기술 개발 저조도 이미지 개선(LLIE)은 심각하게 손상된 저조도 사진으로부터 적절히 노출되고 자연스러운 이미지를 복원하는 작업이다. AI · 머신러닝 · GLOW-FM: Efficient Generative Low-Light Image Enhancement with One-Step Latent Flow Matching
Key Point 어두운 사진을 한 번의 계산으로 고품질로 복원할 수 있게 되면, 스마트폰이나 보안카메라 같은 실제 기기에서 즉시 적용할 수 있는 기술이 된다.
핵심 요약
저조도 이미지 개선(LLIE)은 심각하게 손상된 저조도 사진으로부터 적절히 노출되고 자연스러운 이미지를 복원하는 작업이다. 기존 확산 기반 생성형 방법은 강력한 이미지 사전 정보를 활용해 높은 화질을 달성하지만, 반복적 샘플링으로 인한 계산 비용이 크고 실제 배포에 제약이 있다. GLOW-FM은 한 번의 함수 평가로 고품질 개선을 수행하는 단계별 지연 흐름 일치(flow matching) 프레임워크를 제안한다. 전체 요약 9문장 읽기 → 021 18:11 ▲ 100 · 댓글 6 부트섹터에서 구동하는 신경망 모델 bootgpt는 MBR 512바이트에 어셈블리로 작성된 신경망 부트로더로, PC 켜질 때 11.5KB int8 모델을 다음 23섹터에서 로드해 386 16비트 리얼 모드에서 실행한다. 하드웨어 · 시스템 · Show HN: A language model that lives in a boot sector
Key Point PC 부팅의 가장 제약된 공간인 512바이트 부트섹터에 신경망 추론 엔진을 완전히 구현한 기술적 도전으로, 임베디드 ML 최적화의 극한을 보여준다.
핵심 요약
bootgpt는 MBR 512바이트에 어셈블리로 작성된 신경망 부트로더로, PC 켜질 때 11.5KB int8 모델을 다음 23섹터에서 로드해 386 16비트 리얼 모드에서 실행한다. OS나 C 런타임 없이 작동하며, 존재하지 않는 하드웨어의 타임스탬프·PCI 바·ACPI 이벤트를 포함한 가짜 리눅스 부트 로그를 생성한다. 8자 컨텍스트와 1개 은닉층으로 학습된 char 레벨 모델이며, 생성된 부팅 로그는 실제 로그처럼 보이지만 완전히 할루시네이션이다. 전체 요약 8문장 읽기 → 022 18:11 ▲ 24 · 댓글 2 분광 데이터 통합 학습하는 OmniSpectra 기초 모델 공개 기존 시퀀스 모델은 파장 같은 물리 좌표를 무시하고 토큰 순위로만 위치를 인코딩해, 서로 다른 기계로 관측한 분광 데이터를 손실 있게 재샘플링해야 한다는 문제를 지적했다. AI · 머신러닝 · OmniSpectra: A Unified Foundation Model for Universal Spectra Representation Learning
Key Point 천체 관측 데이터 같은 다양한 기기 간 분광 데이터를 효율적으로 학습하려는 연구자와 천문학 AI 개발자에게 물리 기반 설계로 소수 파라미터로 큰 모델을 능가하는 접근법을 제시한다.
핵심 요약
기존 시퀀스 모델은 파장 같은 물리 좌표를 무시하고 토큰 순위로만 위치를 인코딩해, 서로 다른 기계로 관측한 분광 데이터를 손실 있게 재샘플링해야 한다는 문제를 지적했다. OmniSpectra는 이 좌표 불일치를 해결하는 파장 기반 기초 모델로, 연속 좌표를 사용하는 마스크 오토인코더를 설계해 정수 픽셀 인덱싱을 버렸다. 물리 좌표를 로그 스케일로 매핑하면 우주 적색편이로 인한 곱셈 스케일링이 덧셈 변환으로 바뀌어, 연속 회전 위치 임베딩에서 상대 토큰 거리 계산이 격자 왜곡 없이 단순해진다. 전체 요약 6문장 읽기 → 023 00:11 ▲ 382 · 댓글 4 LLM 에이전트 강화학습, 턴 단위 신용할당으로 최적화 장시간 작업을 수행하는 LLM 에이전트는 환경과 상호작용하며 각 행동을 토큰 단위로 생성한다. AI · 머신러닝 · Multiscale Policy Optimization for Long-Horizon LLM Agents
Key Point LLM 에이전트의 장시간 작업에서 어디에 책임을 할당할지 판단하는 방식을 개선함으로써, 복잡한 추론 작업에서 강화학습 효율을 높일 수 있기 때문이다.
핵심 요약
장시간 작업을 수행하는 LLM 에이전트는 환경과 상호작용하며 각 행동을 토큰 단위로 생성한다. 현재 방식에서 비평가(critic) 값이 주로 턴(turn) 간에 변화하는 것을 발견했다. 이에 따라 턴 단위에서 최적화하면서 토큰 간 신용할당을 세밀하게 조정할 필요가 있다. 전체 요약 7문장 읽기 → 024 12:11 ▲ 19 · 댓글 3 로봇이 실험하며 배우는 벤치마크 EmbodiedLab 공개 로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. AI · 머신러닝 · EmbodiedLab: Benchmarking Embodied Agents That Act to Know
Key Point 로봇의 지식습득 과정 자체를 체계적으로 평가하는 첫 벤치마크로서, 조작 능력과 인지 능력의 어느 것이 현실 목표 달성에 더 핵심인지를 드러낸다.
핵심 요약
로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. 기존 조작 벤치마크는 목표 상태가 주어졌을 때만 평가하고, 과학 발견 벤치마크는 기호적 행동이나 수치 계산으로만 평가했다면, EmbodiedLab은 로봇이 정량적 과학 실험을 통해 스스로 절차를 선택하고 물리 기반 시뮬레이션 실험실을 조작하는 시나리오다. 14개 장비 플랫폼에 걸쳐 5개 학문 분야의 30개 실험으로 구성되어 있으며, 매번 시스템 파라미터를 새로 샘플링하기 때문에 결과를 미리 알 수 없지만 정확히 채점할 수 있다. 전체 요약 8문장 읽기 → 025 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 026 00:11 ▲ 21 · 댓글 2 추측 샘플링과 확산 모델의 속도-품질 트레이드오프 분석 추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. AI · 머신러닝 · Speculative Diffusion is a Tale of Two Tradeoffs
Key Point LLM 추론 성능을 높이는 두 가지 기술(추측 디코딩과 확산 모델)의 트레이드오프를 체계적으로 분석함으로써 최적 조합 방식을 제시한다.
핵심 요약
추측 디코딩(Speculative Decoding)은 빠르지만 품질이 낮은 초안 모델에서 샘플링해 LLM 추론 속도를 높이는 기법으로, 전통적으로는 검증자 분포 대비 손실 없이 속도 향상을 보장한다. 최근 개발된 확산 LLM(dLLM)은 더 적은 확산 스텝으로 출력 품질을 떨어뜨려도 대폭의 속도 향상을 달성할 수 있다는 점에서 다르다. 확산 모델은 토큰을 병렬로 생성하기 때문에 자회귀 모델보다 빠르게 샘플링할 수 있어, 추측 디코딩의 초안 모델로 유망하다. 전체 요약 6문장 읽기 → 027 00:11 ▲ 24 · 댓글 2 저정밀 연산 RL에서 성능과 안정성을 동시에 확보한 miniTE 공개 Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. AI · 머신러닝 · miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
Key Point LLM 강화학습에서 저정밀 연산의 수치 안정성 문제를 해결하고 1.4배 이상의 처리 속도 향상을 달성한 기술이 공개되어, 더 효율적이고 저비용의 LLM 학습이 가능해진다.
핵심 요약
Native NVFP4는 대형언어모델(LLM) 강화학습을 가속화할 수 있지만, 학습 엔진과 샘플링 엔진 사이의 수치 실행 일관성 유지가 어려운 문제가 있다. 단순히 모델 가중치와 수치 형식을 맞추는 것만으로는 일관된 정책 평가를 보장할 수 없으며, 크로스 엔진 수치 정렬이 중요함을 확인했다. miniTE는 실행 진단, 크로스 엔진 수치 정렬, W4A4 GEMM 계산을 결합한 경량 프레임워크로, RL 목적함수를 수정하지 않으면서도 수치 일관성을 개선한다. 전체 요약 6문장 읽기 → 028 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
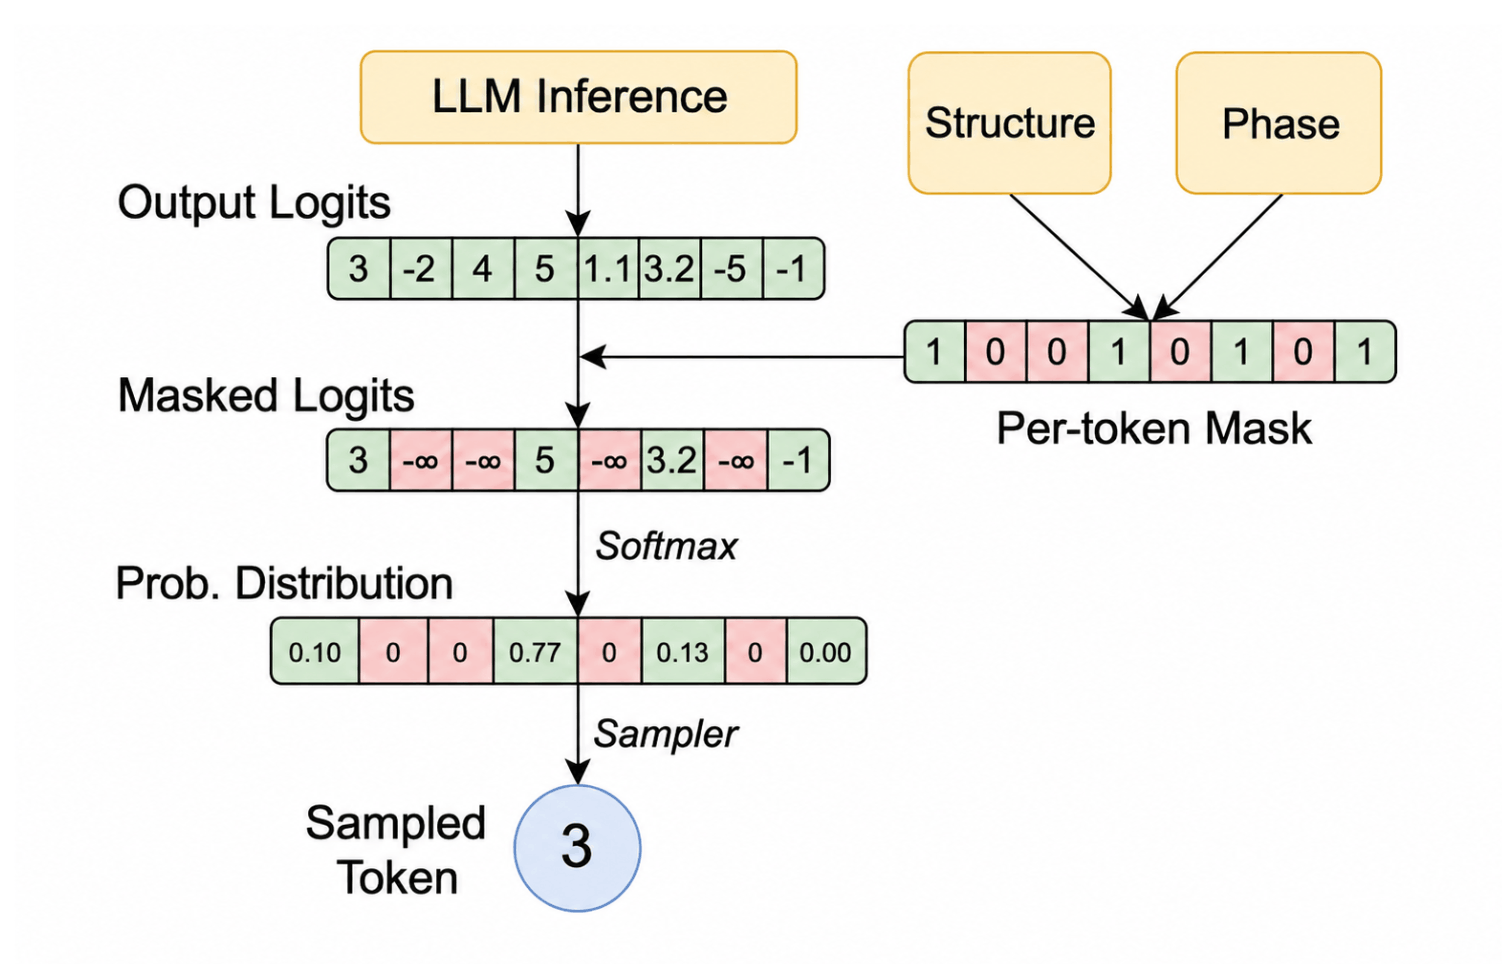
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 029 03:12 ▲ 118 · 댓글 62 vLLM에서 도구 호출 정확도를 100%로 높이는 방법 Kimi K2.6을 vLLM 0.28에서 제공할 때 도구 호출 스키마 정확도가 92%에 불과해 25회 중 2회 호출이 실패했다. 인프라 · 데브옵스 · Fixing Tool-Call Accuracy in vLLM
Key Point 오픈소스 추론 엔진의 기본 설정만으로는 도구 호출 정확도가 92%대에 머물러 에이전트 기반 애플리케이션의 품질을 심각하게 떨어뜨리는데, vLLM의 제약된 디코딩 기능으로 이를 100%로 보장할 수 있다는 실제 사례와 방법을 보여준다.
핵심 요약
Kimi K2.6을 vLLM 0.28에서 제공할 때 도구 호출 스키마 정확도가 92%에 불과해 25회 중 2회 호출이 실패했다. 에이전트 워크로드에서 도구 호출 오류가 쌓이면 올바르지 않은 맥락이 누적되어 결과 품질이 크게 떨어지고 재시도 비용이 증가한다. 언어 모델은 확률 기반으로 토큰을 생성하므로 명확한 프롬프트에도 불구하고 잘못된 도구 호출을 생성할 수 있으며, 훈련 데이터의 불일치(예: search_web vs web_search)로 인해 존재하지 않는 도구나 필드를 만들 수 있다. 전체 요약 7문장 읽기 → 030 12:10 ▲ 106 · 댓글 26 구글 제미나 모델의 추론 토큰 39% 줄이면서 성능 유지 BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. AI · 머신러닝 · Gemma-4-26B-A4B with 39-69% less thinking at same accuracy
Key Point 추론 단계를 줄이면서도 정확도를 유지하는 최적화 기법이 실제로 작동함을 보여주므로, LLM 배포 비용과 지연시간을 줄이려는 팀들의 실질적 선택지가 확보된다.
핵심 요약
BottleCapAI가 구글의 Gemma-4-26B-A4B 모델을 최적화한 ThinkingCap 버전을 공개했다. 추론 토큰을 평균 38.9% 줄였으며 최대 69.1%까지 감소시킨 벤치마크도 있다. 12개 벤치마크 평균 정확도는 75.18%에서 75.03%으로 0.15pp만 하락했다. 전체 요약 12문장 읽기 → 031 00:11 ▲ 28 · 댓글 2 드물게 찍은 사진에서 3D 장면 재구성하되, 계산은 가볍게 Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. AI · 머신러닝 · CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
Key Point 기존의 균등한 가우시안 할당 방식의 비효율을 개선하면서 적응형 분배로 메모리는 줄이고 화질은 높인 새로운 접근이 무엇을 달리하는지 보여준다.
핵심 요약
Sparse view에서 3D 장면을 한 번의 순전파(feedforward)로 복원하되, 기하학과 텍스처를 정확히 살리는 것이 기존 과제였다. 3DGS(3D Gaussian Splatting)를 쓴 최근 방법들은 각 픽셀마다 1개 이상의 가우시안을 할당하는데, 단순한 영역에서는 프리미티브를 낭비하고 평면 구조의 기하학적 사전정보를 활용하지 못한다. CompactSplat은 텍스처 기반 공간 분할과 계층적 샘플링을 결합해 콘텐츠에 맞춘 가우시안 할당을 수행한다. 전체 요약 6문장 읽기 → 032 06:11 ▲ 13 · 댓글 2 개방형 RL 학습 과정을 자동으로 조정하는 HarnessRL 제안 자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. AI · 머신러닝 · HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL
Key Point 개방형 과제를 통해 AI 모델을 훈련할 때 보상 신호의 붕괴와 오류를 자동으로 탐지하고 수정하는 메커니즘이 필요한 상황에서, 훈련 과정 자체를 동적으로 조정하는 접근이 효율성을 크게 개선할 수 있음을 보여준다.
핵심 요약
자연어 보상 기준을 사용한 개방형 생성 정책 학습(Rubric-based RL)은 훈련이 진행되면서 보상이 비효과적이 되는 문제를 겪는다. 점수가 균일하게 낮거나 높게 붕괴되는 비차별적 보상과 높은 점수가 실제 답변 품질과 맞지 않는 허위 보상이라는 두 가지 실패 양식이 존재한다. 이는 정책이 진화하면서도 작업 샘플링, 탐색, 평가 설정이 고정되어 있기 때문이다. 전체 요약 8문장 읽기 → 033 00:11 ▲ 14 · 댓글 1 에이전트 제어 모델, 비용만 올리고 성능은 못 올려 AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. AI · 머신러닝 · Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success
Key Point 작은 모델을 에이전트 제어에 쓰면 비용이 줄 것이라는 가정이 현실 데이터에서 부정되었으며, 오프라인 성능이 좋아도 실제 배포에서는 역효과를 낼 수 있음을 보여준다.
핵심 요약
AI 에이전트가 중단, 검증, 전략 변경 같은 소결정을 저비용 모델에 위임하는 추세 속에서, 특수 설계된 결정 모델 Jev 1.13이 Claude Sonnet 5.5 에이전트를 더 싸게 돌릴 수 있는지 실험했다. Terminal-Bench 2.1의 21개 과제(315시험)에서 Jev는 성공률을 73.0%에서 73.0%로 유지하면서 시도당 비용을 19% 올렸다(기하평균 비율 1.19, 95% 신뢰구간 1.02-1.36). Jev는 Claude Haiku 5.5 소형 언어 모델보다 21% 싸웠지만 위약 대조(개발 단계 선택 빈도로 샘플링)보다는 22% 더 비쌌다. 전체 요약 6문장 읽기 → 034 15:11 ▲ 37 · 댓글 2 확산 모델의 오차 누적을 잡는 보정 기법 확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. AI · 머신러닝 · Correction Training for Diffusion Models
Key Point 확산 모델의 근본적인 학습-추론 갭을 단순한 보정 기법으로 해결하고 CFG 없이도 고품질 샘플을 생성할 수 있게 됨으로써, 현재 텍스트-이미지 생성 모델의 성능 천장을 높일 수 있는 방법을 제시합니다.
핵심 요약
확산 모델의 반복 샘플링에서 노출 편향으로 인한 오차 누적 문제가 발생한다: 디노이저는 실제 이미지에 노이즈를 섞은 데이터로 학습하지만, 추론 시에는 자신의 불완전한 예측으로 만든 입력을 받게 된다. 이런 학습-추론 갭을 줄이기 위해 보정 단계(corrector)를 도입한다: 보정 모델은 기본 모델의 예측을 입력받아 같은 정답을 목표로 학습한다. 샘플링 중 각 디노이징 단계마다 보정 모델이 예측을 반복적으로 정제하며, 중간 단계의 아티팩트가 최종 샘플로 전파되는 것을 방지한다. 전체 요약 7문장 읽기 → 035 12:11 ▲ 48 · 댓글 2 4단계만에 현실감 있는 영상 생성하는 구조 기반 렌더러 게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. AI · 머신러닝 · SolarRenderer: Few-Step Generative Reference Rendering
Key Point 기존 50단계가 필요했던 구조 기반 렌더링을 4단계로 단축하면서도 미학습 표현 11개에 일반화되는 성과로, 게임 엔진 통합과 실시간 스트리밍 렌더링이 가능해진다.
핵심 요약
게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. 기존 렌더러는 특정 엔진 표현에 종속되거나 수십 단계의 노이즈 제거가 필요하거나 별도의 비용 많이 드는 증류 과정이 필수다. SolarRenderer는 고정된 MiniMax-H3 33B 백본을 두 개의 가벼운 LoRA로 적응시킨 구조 조건 비디오 렌더러다. 전체 요약 8문장 읽기 → 036 12:11 ▲ 29 · 댓글 2 약한 모델로 강한 확산 모델 학습하기, SWIFT 논문 확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. AI · 머신러닝 · SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
Key Point 약한 모델을 활용해 더 강한 확산 모델을 절반 이하의 학습 비용으로 훈련하면서도 추론 오버헤드를 늘리지 않는 실질적인 방법이 입증되었기 때문이다.
핵심 요약
확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. SWIFT는 얼려진 약한 노이즈 제거기를 사용해 강한 모델을 개선하는 자가 가이드 학습법으로, 추론 오버헤드를 추가하지 않는다. 각 노이지 입력에 대해 약한 모델의 예측에서 멀어지도록 클린 회귀 타겟을 외삽하여, 부족하게 학습된 성분을 증폭한다. 전체 요약 9문장 읽기 → 037 12:11 ▲ 11 · 댓글 2 자기 재귀로 멀티토큰 예측 효율화한 ECHO 논문 기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. AI · 머신러닝 · ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
Key Point 자동회귀 언어 모델의 학습과 추론 효율성을 동시에 높이는 핵심 알고리즘 개선으로, 기존 멀티토큰 예측의 구조적 문제를 근본적으로 해결한다.
핵심 요약
기존 멀티토큰 예측(MTP) 방식은 보조 모듈을 백본에 추가하고 각 스텝마다 별도 계산이 필요해 비효율적이다. ECHO는 백본의 최종 레이어 자체가 모든 예측 스텝을 담당하므로 감독 신호가 다음 토큰을 생성하는 매개변수에 직접 전달된다. 깊은 스텝의 학습 비용을 낮추기 위해 동적 깊이 샘플링(DDS)을 도입해 깊이에 따라 확률을 감쇠시킨다. 전체 요약 6문장 읽기 → 038 16:56 ▲ 620 · 댓글 215 DeepSeek, 자체 추론 엔진 오픈소스로 공개 딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. AI · 머신러닝 · DeepSeek just open-sourced its inference engine
Key Point 딥시크의 대규모 서빙에 검증된 고성능 추론 엔진이 오픈소스화되어, LLM 배포를 다루는 개발자들이 프로덕션 수준의 최적화 기법을 직접 활용할 수 있게 되었다.
핵심 요약
딥시크가 자사 대규모 서비스에 쓰이는 고성능 추론 프레임워크 DeepInfer를 오픈소스로 공개했다. 지원 모델은 DeepSeek-V4.1-Flash이며, FlashMLA, DeepGEMM, DeepEP 등 최적화된 커널과 MoE 전문가 병렬화, 비동기 스케줄링, 배치 불변 추론 등 대규모 서빙에 필요한 핵심 기능을 포함한다. DSpark와 신뢰도 기반 검증으로 드래프트 토큰을 통해 디코딩을 가속화하며, 설정 파라미터로 최대 드래프트 길이(기본값 5)를 조절할 수 있다. 전체 요약 9문장 읽기 → 039 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 040 18:11 ▲ 73 · 댓글 4 영상 생성 지연 시간 없이 고품질 모델 쓰는 법 인터랙티브 영상 생성은 응답 지연을 줄이기 위해 작은 양방향 청크를 사용해왔으나, 더 큰 청크가 영상 품질을 높이고 GPU 병렬성을 더 잘 활용하면서도 샘플링 시간은 소폭만 증가함을 발견했다. AI · 머신러닝 · Speculative Sampling in Interactive Video Generation
Key Point 실시간 영상 생성의 지연 시간과 품질 사이의 근본적 트레이드오프를 해소하는 기법으로, 스트리밍 기반 영상 생성 시스템의 아키텍처를 재설계한다.
핵심 요약
인터랙티브 영상 생성은 응답 지연을 줄이기 위해 작은 양방향 청크를 사용해왔으나, 더 큰 청크가 영상 품질을 높이고 GPU 병렬성을 더 잘 활용하면서도 샘플링 시간은 소폭만 증가함을 발견했다. Speculative Sampling 기법을 제안하는데, 이는 큰 양방향 윈도우의 모델링 능력과 작은 윈도우의 저지연 상호작용을 결합한다. 노이즈 래턴트를 패딩으로 추가해 모델링 윈도우를 확장하고, 조건이 바뀌지 않으면 예측 결과를 캐시해 재사용한다. 전체 요약 7문장 읽기 → 041 00:10 ▲ 310 · 댓글 121 DeepSeek, V4.1-Flash-1017로 추론·코딩 성능 대폭 개선 DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. AI · 머신러닝 · DeepSeek-v4.1-Flash-1017
Key Point LLM의 성능과 효율성이 함께 개선되는 것이 드문데, 추론·코딩 벤치마크에서 동시에 개선되면서 낮은 비용으로 더 복잡한 작업을 처리할 수 있게 됐다.
핵심 요약
DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. 작업 실행 시간과 출력 길이를 단축해 더 빠르고 낮은 비용으로 작업을 완료할 수 있으며, 여러 에이전트 테스트에서 성능-비용 파레토 한계를 앞당겼다. 벤치마크에서 HLE는 42.6점(기존 36.8점), Terminal-Bench 4.0은 42.3점(기존 31.2점), DeepSWE v1.1은 77.0점(기존 74.2점)을 기록했다. 전체 요약 9문장 읽기 → 042 03:11 ▲ 11 · 댓글 1 흐름 매칭의 추론 능력을 높이는 자기조건화 기법 시각 추론 문제를 이미지 생성으로 푸는 연구에서 반복 샘플러인 흐름 매칭(flow matching)을 사용하면, 각 샘플링 단계가 추론 단계가 될 수 있다는 직관이 있었다. AI · 머신러닝 · Self-Conditioning Enables Deep Sequential Reasoning in Flow Matching
Key Point 생성형 모델의 반복 샘플링 과정이 실제로 복잡한 추론을 수행할 수 없다는 근본적인 제약과 그를 극복하는 자기조건화 기법이 무엇인지 알아야 시각 추론 시스템을 제대로 설계할 수 있다.
핵심 요약
시각 추론 문제를 이미지 생성으로 푸는 연구에서 반복 샘플러인 흐름 매칭(flow matching)을 사용하면, 각 샘플링 단계가 추론 단계가 될 수 있다는 직관이 있었다. 그러나 이 논문은 회로 복잡성 관점에서 이 직관이 잘못되었음을 보였다: 모델 출력이 특정 정규성 조건을 만족하면, 표준 흐름 매칭 샘플러의 궤적을 상수 개의 병렬 모델 평가 라운드로 시뮬레이션할 수 있다. 따라서 추가 샘플링 단계는 상수 깊이 백본 모델의 표현력을 증가시키지 못하며, 이것이 핵심 병목이다. 전체 요약 7문장 읽기 → 043 15:11 ▲ 17 · 댓글 2 자동주행 AI, 시뮬레이션으로 가상 주행 영상 학습 자동주행 세계 액션 모델(WAM)은 실제 주행 로그에서 기록된 궤적에 대한 영상 데이터만 갖고 있어, 강화학습으로 탐색한 대안적 궤적에는 시각적 감독이 없다. AI · 머신러닝 · SimVTA: Simulation-Grounded Video-Trajectory Alignment for Driving World Action Models
Key Point 자동주행 AI가 시뮬레이션으로 생성한 가상 영상을 학습 데이터로 사용해 강화학습 후보 궤적도 감독할 수 있게 되어, 제한된 실제 데이터만으로도 계획 성능을 5% 이상 향상시킬 수 있다.
핵심 요약
자동주행 세계 액션 모델(WAM)은 실제 주행 로그에서 기록된 궤적에 대한 영상 데이터만 갖고 있어, 강화학습으로 탐색한 대안적 궤적에는 시각적 감독이 없다. SimVTA는 이 문제를 해결하기 위해 시뮬레이션 기반 사후훈련 프레임워크를 제안한다. 각 관찰에 대해 후보 궤적을 샘플링하고, 3D 가우시안 스플래팅(3DGS)으로 재구성한 실제 장면에서 월드 엔진 같은 시뮬레이터로 높은 보상을 받는 궤적들의 미래 영상을 렌더링한다. 전체 요약 8문장 읽기 → 044 15:11 ▲ 23 · 댓글 2 확산 모델 강화학습을 위한 라우팅 정책 최적화 기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. AI · 머신러닝 · Routing Policy Optimization for Online Diffusion Reinforcement Learning
Key Point 생성 모델을 보상 신호로 정렬할 때 훈련 효율을 4배 향상시키면서도 추론 시 모델의 원래 특성을 유지하는 새로운 강화학습 기법이 제시되어, 확산 모델 최적화의 실질적 한계를 해결한다.
핵심 요약
기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. Routing Policy Optimization (RPO)는 어텐션 라우팅을 확률적 탐색 행동으로 변환하여 이를 답한다. 선택된 몇 개의 디노이징 단계에서 각 쿼리 블록은 자신의 블록을 유지하면서 생성 모델의 자연스러운 어텐션 질량에 비례하여 추가 키 블록을 샘플링하거나 밀집 어텐션을 유지한다. 전체 요약 9문장 읽기 → 045 15:11 ▲ 18 · 댓글 2 실제 버그 수정에서 배우는 AI 코딩 평가 데이터셋 생성 코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. AI · 머신러닝 · SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
Key Point AI 코딩 에이전트의 진정한 능력을 평가하려면 실제 버그의 복잡성을 반영한 다양한 평가 데이터가 필요한데, 이 연구가 역공학 기반의 자동 생성 방법을 제시했기 때문입니다.
핵심 요약
코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. 기존 합성 방식들은 사전학습된 모델 지식과 휴리스틱 프롬프팅에만 의존해 실제 소프트웨어 결함의 복잡한 메커니즘을 제대로 포착하지 못한다. SWE-at-Scale은 과거의 실제 버그 수정 이력을 역공학하여 현실적인 이슈를 자동으로 합성하는 프레임워크다. 전체 요약 8문장 읽기 → 046 12:11 ▲ 78 · 댓글 3 비디오 생성 중간에 이미 완성된 토큰 멈추기 자동회귀 비디오 생성은 모든 토큰을 최종 노이즈 제거 단계까지 거치지만, 많은 토큰은 초기 단계에서 이미 최종 출력과 거의 같아서 더 이상의 처리가 불필요하다. AI · 머신러닝 · Speculative Forcing for Efficient Autoregressive Video Generation
Key Point 자동회귀 비디오 생성의 계산 병목을 토큰 단위로 해결해 같은 품질의 결과를 1.35~1.5배 빠르게 생성할 수 있게 하는 방법론이 공개됐다.
핵심 요약
자동회귀 비디오 생성은 모든 토큰을 최종 노이즈 제거 단계까지 거치지만, 많은 토큰은 초기 단계에서 이미 최종 출력과 거의 같아서 더 이상의 처리가 불필요하다. Speculative Forcing은 초기 단계의 깨끗한 추정값을 임시 결과물로 취급하고, 개별 토큰이 안전하게 조기에 수락될 수 있는 시점을 예측하는 프레임워크다. 수락된 토큰은 더 이상 노이즈 제거를 받지 않으면서 남은 토큰들의 맥락으로 캐시된 키와 값이 활용된다. 전체 요약 7문장 읽기 → 047 12:11 ▲ 43 · 댓글 2 멀티코드북 디퓨전으로 텍스트·이미지 통합 생성 가능 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Key Point 이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다. 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다. 전체 요약 6문장 읽기 → 048 03:12 ▲ 13 · 댓글 2 장기 강화학습에 Muon 옵티마이저 필수 장기 지평(long-horizon) 에이전트는 확장된 상호작용에서 추론, 도구 사용, 환경 피드백을 조율해야 한다. AI · 머신러닝 · Long-Horizon RL Needs Muon
Key Point 장기 강화학습 작업에서 효율적인 학습을 위한 구체적인 옵티마이저와 훈련 기법이 필요하며, Muon 기반 레시피가 기존 방법보다 나은 성능을 달성했기 때문이다.
핵심 요약
장기 지평(long-horizon) 에이전트는 확장된 상호작용에서 추론, 도구 사용, 환경 피드백을 조율해야 한다. 희소 결과 보상에서 학습하려면 길이가 다른 궤적에 가중치를 부여하고 롤아웃이 진행 중일 때 정책을 업데이트해야 한다. 연구팀은 Muon, 토큰 평균 손실, 잘린 중요도 샘플링, 길이·도구 오류 보조 손실을 결합한 단일 롤아웃 비동기 레시피를 제안했다. 전체 요약 6문장 읽기 → 049 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 050 00:11 ▲ 39 · 댓글 2 다중 정답 처리로 LLM 추천 모델 학습 효율화 Reddit 같은 환경에서 추천 요청에 여러 정답이 나올 때 기존 Rank-GRPO는 훈련 예제당 하나의 응답만 선택하는데, 이는 학습 신호의 85%가 어떤 응답을 선택했는지에만 좌우되고 생성 목록의 질은 제대로 반영되지 않는 문제가 있다. AI · 머신러닝 · Many Right Answers, One Training Example: Removing Responder Noise from GRPO for LLM Recommenders
Key Point 여러 정답을 처리하는 방식이 LLM 추천 모델의 학습 효율을 크게 좌우하며, 제안된 방법이 기존 방식 대비 더 적은 자원으로 동등하거나 우수한 성능을 낸다는 실용적 개선을 보여준다.
핵심 요약
Reddit 같은 환경에서 추천 요청에 여러 정답이 나올 때 기존 Rank-GRPO는 훈련 예제당 하나의 응답만 선택하는데, 이는 학습 신호의 85%가 어떤 응답을 선택했는지에만 좌우되고 생성 목록의 질은 제대로 반영되지 않는 문제가 있다. ReMaRk라는 새로운 방식을 제안하는데, 각 목록을 한 번에 모든 응답의 제목을 합친 것과 비교 평가하고 각 요청을 동등하게 샘플링한다. 7개의 기본 모델과 3개의 데이터셋에서 실험한 결과 ReMaRk는 Rank-GRPO가 2,000번의 단일-응답 강화학습 스텝을 거쳐야 달성하는 검증 재현율을 25~53% 더 적은 스텝으로 도달한다. 전체 요약 5문장 읽기 → 051 15:11 ▲ 32 · 댓글 1 INT4 양자화로 강화학습 롤아웃 1.8배 빠르게 비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. AI · 머신러닝 · KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization
Key Point 강화학습 훈련에서 KV 캐시 양자화로 하드웨어 메모리 사용량을 크게 줄이면서도 정확도 손실을 거의 없는 방법이 나왔기 때문에, 리소스 제약이 있는 환경에서의 LLM 훈련 효율을 크게 개선할 수 있다.
핵심 요약
비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. 가중치 전용·가중치-활성화 양자화보다 KV 캐시 양자화가 훨씬 더 큰 가속 효과를 주지만, INT4 양자화만으로는 토큰 단위 절단된 중요도 샘플링(TIS)을 써도 학습이 악화될 수 있다. KV4-RL은 보정 없는 INT4 KV 양자화에 어텐션 싱크와 최근 문맥의 일부 위치만 INT8로 보호해 샘플러 오정렬을 줄이면서도 대부분의 속도 이득을 유지한다. 전체 요약 5문장 읽기 → 052 15:11 ▲ 54 · 댓글 2 토큰 대신 행동 기준으로 언어모델 에이전트 증류하기 언어모델 에이전트를 작은 모델로 증류할 때, 기존 토큰 수준 감시학습은 상태 분포 불일치를 겪고 토큰 확률·호환 토크나이저 접근이 필요하다. AI · 머신러닝 · ActionOPD: Distilling Decisions, Not Tokens
Key Point 작은 언어모델을 강력한 에이전트로 만드는 증류 방식의 근본적인 패러다임 전환으로, 토크나이저 의존성 없이 더 유연한 모델 간 지식 이전이 가능해진다.
핵심 요약
언어모델 에이전트를 작은 모델로 증류할 때, 기존 토큰 수준 감시학습은 상태 분포 불일치를 겪고 토큰 확률·호환 토크나이저 접근이 필요하다. 연구팀은 의미 있는 행동(semantic actions)을 증류 감시 신호로 사용하는 ActionOPD(행동 수준 온폴리시 증류) 방법을 제안했다. ActionOPD는 학생 모델이 마주친 각 상태에서 학생과 블랙박스 교사 모델에서 모두 행동을 샘플링하고, 학생 행동의 의미적 일치도에 따라 보상을 준다. 전체 요약 7문장 읽기 → 053 12:11 ▲ 15 · 댓글 2 Few-Step 확산 모델, 간단한 회귀만으로 빠르게 확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. AI · 머신러닝 · Simplifying and Improving On-Policy Distillation for Few-Step Diffusion
Key Point 복잡한 별도 모듈 없이 기본 회귀로 few-step 생성의 품질을 올릴 수 있다면, 실제 배포 환경에서 확산 모델의 속도를 크게 개선하려는 팀들에게 직접적인 영향을 줄 것이다.
핵심 요약
확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. 교사 모델의 각 구간 내 속도 변화를 표현하기 위해 학생의 구간 평균 예측에서 국소 보정을 분리하는 학습 전용 잔차 프록시 Pivot을 도입했다. 학생을 약한 교사 예측으로부터 멀어지게 하는 메커니즘을 추가해 원하지 않는 모드 회피를 돕는다. 전체 요약 7문장 읽기 → 054 00:11 ▲ 45 · 댓글 2 극한 압축으로 확산 모델 가속화하는 APEX 등장 확산 모델의 레이턴시 토큰을 극단적으로 압축하면 재구성과 생성 사이의 트레이드오프가 발생한다. AI · 머신러닝 · APEX: Asynchronous Prefix Denoising for Extreme Compression
Key Point 확산 모델의 토큰 수를 획기적으로 줄이면서도 생성 품질을 유지할 수 있는 방법으로, 추론 속도와 비용에 민감한 생성형 AI 서비스 개발에 직접 영향을 미친다.
핵심 요약
확산 모델의 레이턴시 토큰을 극단적으로 압축하면 재구성과 생성 사이의 트레이드오프가 발생한다. APEX는 계층적 레이턴시 공간과 채널 그룹별 비동기 디노이징을 결합한 새로운 방식이다. 오토인코더가 채널 프리픽스를 구조에서 세부사항 순서로 정렬하고, 공유된 단일 디노이저가 토큰을 추가하지 않고 엇갈린 시간에 생성한다. 전체 요약 6문장 읽기 → 055 18:11 ▲ 37 · 댓글 2 동영상 검색 효율화 VEDJE, 캐시 크기 4분의 1로 줄이며 정확도 유지 비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. AI · 머신러닝 · VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
Key Point 동영상-텍스트 검색 실무에서 메모리와 계산 비용의 병목을 4분의 1 수준으로 줄이면서 검색 정확도는 거의 손실하지 않는 기법을 제시해, 대규모 시스템 배포 시 고려할 만한 최적화 기술을 제공한다.
핵심 요약
비슷한 장면에서 다른 사건을 구분해야 하는 동영상 검색의 효율성을 높이는 VEDJE 방법을 제안했다. 샘플링된 프레임 내에서 특성을 압축하되 표현은 재사용 가능한 캐시에 분리해서 보관함으로써 쿼리당 처리 비용을 절감한다. 특성 변화 예측이 보조 학습 신호로 작용해 쿼리 시간에 추가 계산 없이 압축된 캐시에서의 검색 성능을 향상시킨다. 전체 요약 7문장 읽기 → 056 06:11 ▲ 195 · 댓글 52 WiFi 7 라우터를 320Msps 소프트웨어 무선 수신기로 개조 Gemtek W1700K WiFi 7 라우터를 광대역 소프트웨어 정의 수신기로 변환하는 오픈소스 펌웨어 프로젝트로, MediaTek MT7996 라디오가 14비트 IQ를 최대 320Msps로 캡처하고 10GbE를 통해 스트리밍한다. 하드웨어 · 시스템 · Turn a WiFi 7 Router into a 320Msps Software Defined Radio Receiver
Key Point WiFi 라우터의 고성능 라디오 칩셋을 역분석하여 MediaTek 독점 펌웨어 없이 완전 독립적인 소프트웨어 정의 라디오로 구현한 사례로, 임베디드 역분석·펌웨어 개발·고속 데이터 스트리밍의 기술적 성과를 보여준다.
핵심 요약
Gemtek W1700K WiFi 7 라우터를 광대역 소프트웨어 정의 수신기로 변환하는 오픈소스 펌웨어 프로젝트로, MediaTek MT7996 라디오가 14비트 IQ를 최대 320Msps로 캡처하고 10GbE를 통해 스트리밍한다. Airoha AN7581 SoC가 데이터를 처리하며, Linux 호스트에서 실시간 스펙트럼과 폭포도를 브라우저로 표시하고 라디오 제어를 함께 제공한다. 전체 2.4GHz 대역을 320Msps로 실시간 캡처 가능하며 필터링 롤오프를 보정한 후 매초 100개 스펙트럼을 262,144포인트 FFT로 생성한다. 전체 요약 11문장 읽기 → 057 03:11 ▲ 11 · 댓글 2 LLM 추론 가속화 기법 PreSTO 제안 LLM 추론 시 검증 기반 샘플링(Power sampling)을 활용하면 결과 품질이 높아지지만, Metropolis-Hastings(MH) 알고리즘의 순차 처리로 속도가 느렸다. AI · 머신러닝 · PreSTO: Predictive Subtree Prefetching for Fast LLM Power Sampling
Key Point Power sampling으로 LLM 추론 품질은 개선되지만 속도가 병목이었는데, PreSTO는 수학적 정확성을 유지하면서 1.7~2.3배 속도 향상을 실현해 실용적 배포의 장벽을 낮춘다.
핵심 요약
LLM 추론 시 검증 기반 샘플링(Power sampling)을 활용하면 결과 품질이 높아지지만, Metropolis-Hastings(MH) 알고리즘의 순차 처리로 속도가 느렸다. PreSTO(Predictive SubTree Prefetching)는 미래의 샘플 생성 제안을 미리 배치 처리하되, MH 전이 커널은 변경하지 않으므로 수학적 정확성을 유지한다. 알고리즘은 accept/reject 결정을 트리 구조로 모델링하고, 각 모델 호출에서 한 번에 여러 제안을 생성한 뒤 실제 경로를 MH 규칙으로 추적한다. 전체 요약 7문장 읽기 → 058 03:11 ▲ 11 · 댓글 2 LLM 평가 비용 줄이는 중요도 가중 샘플링 기법 AMLworld 데이터셋에서 백만 개 이상의 거래를 평가하려면 각각 별도의 그래프 프롬프트가 필요해 높은 비용이 든다. AI · 머신러닝 · AMLworld-Compact: Importance-Weighted Downsampling for Cost-Effective LLM Evaluation and Error Diagnosis
Key Point 대규모 LLM 평가 비용 문제를 해결하면서도 편향 없는 성능 추정을 가능하게 하는 실용적 기법으로, 금융 부정 탐지 같은 불균형 데이터셋 평가에 직접 적용할 수 있다.
핵심 요약
AMLworld 데이터셋에서 백만 개 이상의 거래를 평가하려면 각각 별도의 그래프 프롬프트가 필요해 높은 비용이 든다. AMLworld-Compact는 모든 불법 거래는 유지하되 감독된 점수 계층에서 정상 거래를 샘플링한 평가 세트다. HT-Coreset 프로토콜을 사용해 HI-Small과 LI-Small에서 평가 대상을 각각 271배, 611배 감소시킨다. 전체 요약 8문장 읽기 → 059 15:11 ▲ 39 · 댓글 2 음성·음악 분리와 생성을 한 번에, 오디오-비디오 AI 모델 SepGen 음성-영상 생성 모델을 확장하여 비디오, 혼합 사운드트랙, 각 음원별 개별 스템을 한 번의 샘플링으로 출력하는 SepGen을 제시한다. AI · 머신러닝 · SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model
Key Point 비디오에서 개별 음원을 자동 분리·생성할 수 있게 되면 3D 음성화(audio spatialization)나 음향 편집 등 실제 영상 제작 워크플로우가 단순해질 수 있으며, 기존 단순 음성 분리 모델을 능가하는 성능을 보인다.
핵심 요약
음성-영상 생성 모델을 확장하여 비디오, 혼합 사운드트랙, 각 음원별 개별 스템을 한 번의 샘플링으로 출력하는 SepGen을 제시한다. 생성 모드에서는 각 음원 캡션이 해당 스템의 내용을 지정하며, 예를 들어 두 명의 대사는 각 화자마다 하나의 스템으로 원래 순서대로 분리된다. 분리 모드에서는 입력 오디오 혼합을 유지하면서 캡션으로 추출할 내용을 지정하여, 자유형식 설명으로부터 녹음을 분해할 수 있다. 전체 요약 6문장 읽기 → 060 15:11 ▲ 60 · 댓글 2 멀티모달 AI의 연산 비용을 줄이는 '탄력적 시각 표현' 기법 등장 멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. AI · 머신러닝 · VisionWeave: Weaving Elastic Visual Representations as a Native Capability of MLLMs
Key Point 다음 세대 멀티모달 모델 실서빙에서 비용과 속도를 동시에 개선하는 기술이 나왔으며, 기존 토큰 제거 기법보다 성능 유지 능력이 뛰어나다.
핵심 요약
멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. 기존 다운샘플링과 토큰 제거 기법들은 내용에 따른 세밀한 적응, 다양한 작업 지원, 최신 모델 통합에서 한계가 있었다. VisionWeave는 이미지 영역별로 세부도를 적응적으로 조절하는 '탄력적 시각 표현 짜기' 능력을 MLLM에 구현했다. 전체 요약 8문장 읽기 → 061 15:11 ▲ 43 · 댓글 2 소형 모델의 지속 학습을 위한 합성 자기 증류법 소형 모델의 지속적 학습(continual post-training)은 새로운 능력을 습득하면서도 기존 지식을 보존해야 하는 이중 과제에 직면해 있다. AI · 머신러닝 · Continually Post-training Small Models via Synthetic Self-distillation
Key Point 분포 편향이 소형 모델 학습 실패의 근본 원인이라는 발견과 이를 해결하는 구체적 기법이 온디바이스 AI 서비스 실현의 핵심 과제를 다룬다.
핵심 요약
소형 모델의 지속적 학습(continual post-training)은 새로운 능력을 습득하면서도 기존 지식을 보존해야 하는 이중 과제에 직면해 있다. 기존 자기 증류 미세조정(SDFT)은 문맥 내 학습과 명령 따르기 능력이 뛰어난 모델에서는 작동하지만, 저지연 온디바이스 실행이 필요한 소형 모델에서는 실패한다. 논문은 소형 모델에서 새로운 능력 습득 실패와 기존 지식 망각이 학습된 모델의 분포 편향과 선형 상관관계를 보여주며, 분포 내 학습의 필요성을 입증했다. 전체 요약 7문장 읽기 → 062 12:11 ▲ 114 · 댓글 45 AI로 뭉뚱그려졌던 '유니커널'이 다시 떠오르는 이유 유니커널은 응용프로그램 자체가 운영체제가 되는 방식으로, 개발자가 웹 서버·DNS·이메일 같은 기능을 모두 라이브러리로 직접 작성해야 하기 때문에 2015년경에는 개발 난도가 매우 높았다. AI · 머신러닝 · Unikernels were hard. key word: were
Key Point AI 모델의 학습 데이터가 유니커널, Nix 같은 '어려운' 개념들을 포함하면서 개발 난도가 낮아졌고, 동시에 보안상 새로운 선택지가 되는 구체적 경로를 제시한다.
핵심 요약
유니커널은 응용프로그램 자체가 운영체제가 되는 방식으로, 개발자가 웹 서버·DNS·이메일 같은 기능을 모두 라이브러리로 직접 작성해야 하기 때문에 2015년경에는 개발 난도가 매우 높았다. 그러나 AI 모델들이 관련 논문과 개념들을 학습 데이터에 포함했기 때문에, 이제는 프롬프트로 이들 개념을 생성시키는 것만으로 인지적 난도를 크게 낮출 수 있다. 현재 응용프로그램 위에 운영체제를 얹는 구조는 40년 전 다중 사용자 환경에서 나온 설계 부채로, 공격 표면이 크다는 보안 문제가 있으며 유니커널은 쉘·인터프리터가 없어 LLM이 다음 동작을 알지 못하게 해 준비 공격을 어렵게 만든다. 전체 요약 13문장 읽기 → 063 21:11 당일 +114 텐센트, 33개 언어 지원하는 다중언어 번역 모델 공개 텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. AI · 머신러닝 · Tencent-Hunyuan/Hy-MT2 · Python
Key Point 번역 모델의 성능이 상용 API를 능가하는 수준에 도달했으며, 극저비트 양자화로 온디바이스 배포가 실질적으로 가능해졌다.
핵심 요약
텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. 1.8B 모델은 AngelSlim의 1.25비트 극저비트 양자화로 저장 크기를 440MB까지 줄이고 추론 속도를 1.5배 높였다. 평가 결과 7B와 30B-A3B 모델은 DeepSeek-V4-Pro, Kimi K2.6 같은 오픈소스 모델을 능가하며, 1.8B 모델도 마이크로소프트·더바오 등 상용 API를 전반적으로 능가한다. 전체 요약 9문장 읽기 → 064 21:11 ▲ 20 · 댓글 2 카메라 기하학 조건으로 다중 시점 이미지 합성 3배 가속 소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. AI · 머신러닝 · NAMVIS: Next-Scale Autoregressive Multi-View Image Synthesis
Key Point 3D 콘텐츠 제작에 필수적인 다중 시점 생성을 기존 방식보다 3배 빠르고 더 정확하게 처리하는 기술이 등장했기 때문이다.
핵심 요약
소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. 기존 확산 모델의 반복적 잡음 제거 대신, 이산 시각 토큰을 단계별로 예측하고 모든 토큰을 병렬로 샘플링하는 자동회귀 방식을 사용한다. 멀티스케일 프로젝티브 포즈 인코딩이라는 기법으로 소스·타겟 카메라의 기하학적 변환 정보를 모든 해상도의 셀프-어텐션과 크로스-어텐션에 주입한다. 전체 요약 6문장 읽기 → 065 18:30 ▲ 12 · 댓글 2 세계모델의 핵심 정보를 압축 저장하는 ALeWM 기법 JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. AI · 머신러닝 · Adaptive Latent Capacity for World Models
Key Point 예측 불필요한 정보를 제거하고 필요한 정보만 압축 저장함으로써 세계모델의 효율성과 계획 능력을 동시에 높이는 방법을 제시한다.
핵심 요약
JEPA 기반의 세계모델인 ALeWM(Adaptive LeWorldModel)을 제안한 논문으로, 넓은 잠재공간의 앞부분에 예측에 필요한 정보를 집중시키는 방식을 소개한다. ALeWM은 접두사(prefix) 길이에 대한 수열 조건부 분포를 학습하고, 샘플링된 입력 접두사로부터 다음 임베딩 전체를 추정하도록 예측기를 훈련한다. 기존 붕괴 방지 목적함수들은 잠재 좌표 전체에 걸친 변동만 유도하고 예측 중요도에 따라 정렬하지 않는 문제를 해결하기 위해, MixSIGReg이라는 새로운 정규화 기법을 도입했다. 전체 요약 7문장 읽기 → 066 18:30 ▲ 12 · 댓글 2 LLM 추론 학습에 근거 정보를 선택적으로 활용하기 정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다. AI · 머신러닝 · Rationale-Guided Policy Optimization: Learning to Reason with Adaptive Rationale Scaffolding
Key Point LLM을 정책 강화학습으로 훈련할 때 나타나는 보상 희소성 문제를 근거 정보로 해결하는 새로운 접근법으로, 추론 능력 향상에 실질적 효과를 보인다.
핵심 요약
정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다. 기존 방식은 오프폴리시 데이터나 전문가 궤적, 모델 생성 솔루션을 보조 정보로 사용하지만, 이들이 강화학습 작업 형식과 일치해야 하며 보통 더 강한 모델에서 거부 샘플링으로 학습 자료를 얻어야 한다. RGPO(Rationale-Guided Policy Optimization)는 모델의 현재 능력에 맞춰 정답 근거(rationale) 정보를 적응적으로 활용하되 탐색의 자유도를 보존하는 프레임워크다. 전체 요약 6문장 읽기 → 067 18:30 ▲ 10 · 댓글 2 로봇 정책의 의사결정 순간에 집중하는 검증기 학습법 로봇의 시각-언어-행동(VLA) 정책 성능을 높이려면 대량의 로봇 데이터가 필요하지만, 실제 데이터 수집 비용이 매우 크다는 문제가 있다. AI · 머신러닝 · DiVeR: Decision-Critical Verifier Learning for VLA Test-Time Scaling
Key Point 테스트 타임 스케일링으로 추가 데이터 없이 로봇 정책의 성능을 높일 수 있는 구체적인 방법을 제시해, 로봇 학습의 데이터 비용 문제를 다루는 실질적 접근이 된다.
핵심 요약
로봇의 시각-언어-행동(VLA) 정책 성능을 높이려면 대량의 로봇 데이터가 필요하지만, 실제 데이터 수집 비용이 매우 크다는 문제가 있다. 기존 검증기는 여러 행동 후보를 샘플링한 뒤 궤적 전체 결과만 보고 학습해 비효율적이며, 모든 상태를 동등하게 취급한다. 실제로는 많은 상태에서 행동 선택지가 비슷해 판단 신호가 약하지만, 소수의 결정 임계 상태에서만 행동 선택이 나중 결과에 큰 영향을 미친다. 전체 요약 6문장 읽기 → 068 18:30 ▲ 18 · 댓글 3 강화학습으로 최소 증거 조합 모두 찾기 결과를 만드는 데 꼭 필요한 최소 조건들을 찾는 '최소 증거 식별' 문제를 형식화하고 최소 증거 강화학습(MWRL)을 제시한다. AI · 머신러닝 · Minimal Witness Reinforcement Learning
Key Point 기존 강화학습은 한 가지 답이나 불필요한 조건까지 포함한 답을 주지만, 실제 문제 해결·과학 발견·설명 가능성에선 정말 필요한 최소 조건의 모든 조합을 알아야 한다.
핵심 요약
결과를 만드는 데 꼭 필요한 최소 조건들을 찾는 '최소 증거 식별' 문제를 형식화하고 최소 증거 강화학습(MWRL)을 제시한다. 표준 강화학습은 한 가지 해결책만 찾거나 불필요한 조건이 포함된 중복 해결책을 제시하지만, MWRL은 증거의 가족 전체를 찾아낸다. MWRL은 정책에서 샘플링한 성공한 제안들의 합집합을 이용하고, 각 제안을 그룹 합집합에서 그 제안이 없었을 때 손실되는 커버리지로 평가한다. 전체 요약 8문장 읽기 → 069 18:30 ▲ 29 · 댓글 2 정책 증류의 명암: 보상 모델 신뢰도가 붕괴 결정한다 온-정책 증류(OPD)는 언어 모델 사후 학습의 중요한 방식으로 성능을 향상시키지만, 지나치게 길고 반복적인 생성으로 붕괴될 수 있다. AI · 머신러닝 · Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
Key Point 온-정책 증류의 성능 향상과 붕괴가 동시에 일어나는 원인을 규명하고 실질적인 완화 방법을 제시해 언어 모델 학습의 숨은 위험을 드러낸다.
핵심 요약
온-정책 증류(OPD)는 언어 모델 사후 학습의 중요한 방식으로 성능을 향상시키지만, 지나치게 길고 반복적인 생성으로 붕괴될 수 있다. 연구팀은 강화학습 관점에서 이 현상을 설명한다: 교사 모델이 자신이 거의 생성하지 않는 학생 행동까지 암묵적으로 보상한다. 암묵적 보상 모델이 신뢰할 수 있을 때 OPD는 올바른 응답을 더 쉽게 샘플링하게 만든다. 전체 요약 6문장 읽기 → 070 18:30 ▲ 64 · 댓글 2 자가학습하는 추론 모델, 반복 학습으로 성능 붕괴 막는 방법 제시 추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. AI · 머신러닝 · Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
Key Point 자가학습하는 LLM 기반 추론 모델의 성능 붕괴 문제를 해결하는 실질적 방법을 제시해, 장기간 안정적인 모델 개선이 가능해진다.
핵심 요약
추론 모델이 자체 생성 질문으로 학습하는 자가진화 과정에서 반복할수록 성능이 저하되는 문제가 있다. 논문은 성능 악화의 원인으로 두 가지를 파악했다: 무효한 질문의 증가와 수학적으로 동등한 질문의 반복. 무효한 질문은 라운드가 진행될수록 늘어나며, 답변 일관성 필터링이 이를 더욱 악화시킨다. 전체 요약 9문장 읽기 → 071 18:33 ▲ 10 · 댓글 1 LLM이 숨겨진 공간에서 추론하는 법, Flow Matching으로 풀다 LLM이 연속 공간에서 사고하고 최종 답만 출력하는 잠재 추론(Latent Reasoning)에서 효과적인 잠재 사고는 5가지 조건을 만족해야 한다. AI · 머신러닝 · What Matters for Latent Reasoning with Flow Matching
Key Point LLM이 내부에서 복잡한 추론을 수행하면서도 빠른 속도를 유지하는 새로운 방식의 설계 원칙을 제시해, 추론 효율성과 성능의 트레이드오프를 다루는 핵심 기준이 될 수 있습니다.
핵심 요약
LLM이 연속 공간에서 사고하고 최종 답만 출력하는 잠재 추론(Latent Reasoning)에서 효과적인 잠재 사고는 5가지 조건을 만족해야 한다. 유용성: 올바른 답을 생성하되 단순히 바꾸지 않아야 함, 다양성: 재샘플링으로 다른 추론 경로가 나와야 함, 설명성: 디코딩한 사고의 연쇄(CoT)가 실제 추론을 반영해야 함, 개선성: 추론 계산을 늘려 성능을 높일 수 있어야 함, 효율성: 명시적 CoT 대비 비슷한 정확도에서 낮은 지연시간을 가져야 함. 기존 방법들은 이 요구사항을 거의 충족하지 못하는데, 질문에서 지름길을 배우거나 명시적 CoT를 가중치로 증류하거나 토큰 단위로 모방하는 문제가 있다. 전체 요약 7문장 읽기 → 072 18:33 ▲ 10 · 댓글 2 기존 과학 소프트웨어로 터미널 에이전트 자동 훈련 과학·전문 영역의 터미널 에이전트 훈련에는 실행 가능한 참조 동작과 의미적 정확성을 검증할 도메인별 검증기가 필요한데, 각 작업마다 이를 수작업으로 구축해야 하는 문제가 있다. AI · 머신러닝 · Self-Supervised Scaling of Terminal Environments for Scientific Domains
Key Point 기존 소프트웨어 워크플로우를 재사용하는 자체 지도 학습으로 도메인별 훈련 데이터 구축 비용을 대폭 줄이면서도 검증된 고품질 데이터를 얻을 수 있는 방법이 제시되었다.
핵심 요약
과학·전문 영역의 터미널 에이전트 훈련에는 실행 가능한 참조 동작과 의미적 정확성을 검증할 도메인별 검증기가 필요한데, 각 작업마다 이를 수작업으로 구축해야 하는 문제가 있다. 연구팀이 '소프트웨어 루프 내 재구성(Software-in-the-Loop Reconstruction, SWR)'이라는 자체 지도 학습 프레임워크를 제안했다. 이 방법은 기존 소프트웨어 워크플로우(구조화된 입력을 출력으로 매핑하는 실행 가능한 프로그램)에서 참조 출력과 검증 대상을 추출한다. 전체 요약 8문장 읽기 → 073 18:33 ▲ 13 · 댓글 1 긴 비디오 이해하기, 해상도 낮추고 프레임 촘촘히 샘플링해야 한다 비전-언어 모델(VLM)에서 긴 비디오 이해 시 기존 방식은 고정된 고해상도에서 정보 있는 프레임만 선택했으나, 해상도를 낮추고 더 촘촘하게 샘플링하는 것이 토큰 예산을 맞췄을 때 더 나은 성능을 낸다. AI · 머신러닝 · Rethinking Long-Video Efficiency: A Joint Allocation Perspective on Frames, Pixels, and Front-End Latency
Key Point 비디오 이해 모델의 효율성을 높이는 새로운 관점으로, 해상도와 프레임 샘플링의 트레이드오프를 재정의하며 실제 배포 환경의 디코딩 병목을 해결한다.
핵심 요약
비전-언어 모델(VLM)에서 긴 비디오 이해 시 기존 방식은 고정된 고해상도에서 정보 있는 프레임만 선택했으나, 해상도를 낮추고 더 촘촘하게 샘플링하는 것이 토큰 예산을 맞췄을 때 더 나은 성능을 낸다. 프론트엔드 디코딩 지연시간은 최종 토큰 수가 아니라 후보 풀의 크기에 의존하며, 1시간 길이의 비디오에서 프론트엔드 디코딩이 전체 처리 시간의 대부분을 차지한다. 해상도에 민감한 작업(예: 텍스트 인식)은 선택된 고해상도 프레임에서 이득을 얻으며, 일반적인 이해 작업은 저해상도 촘촘 샘플링으로 충분하다. 전체 요약 6문장 읽기 → 074 18:33 ▲ 160 · 댓글 2 다른 토크나이저 간 증류학습, 정확도는 적은 정보로도 충분하다 On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. AI · 머신러닝 · Rethinking Cross-Tokenizer On-Policy Distillation: From Alignment Coverage to Supervision Reliability
Key Point 다른 토크나이저를 사용하는 모델 간 증류에서 더 많은 정렬 범위보다 신뢰할 수 있는 감독이 핵심이라는 발견으로, 효율적인 학습 설계의 원칙을 제시한다.
핵심 요약
On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. 수학 추론과 코드 생성 과제에서 3개 교사-학생 쌍을 실험한 결과, 어휘 불일치가 크더라도 엄격한 1:1 정렬만으로도 학생이 생성한 대부분의 토큰을 커버했다. 학생이 증류 전에 샘플링한 응답에서 공유 어휘는 엄격히 정렬된 위치에서 교사와 학생의 확률 질량 거의 전부를 유지했다. 전체 요약 7문장 읽기 → 075 18:33 ▲ 21 · 댓글 1 확산 언어모델의 토큰 단위 특성 정렬로 생성 품질 개선 확산 언어모델(DLM) 사후학습을 위해 생성된 분포와 참조 분포 간 최대평균편차(MMD)를 토큰 단위의 특성 공간에서 최소화하는 방법을 제안했다. AI · 머신러닝 · Representation-Space MMD for Diffusion Language Models
Key Point 확산 기반 언어모델의 생성 품질을 토큰 단위로 정렬하는 효율적인 방법으로, 별도의 샘플링 완성이나 보조 모델 없이 대규모 모델의 추론 속도와 정확도를 동시에 개선할 수 있다는 점이 중요하다.
핵심 요약
확산 언어모델(DLM) 사후학습을 위해 생성된 분포와 참조 분포 간 최대평균편차(MMD)를 토큰 단위의 특성 공간에서 최소화하는 방법을 제안했다. 개별 토큰 위치의 맥락 특성을 유지하여 한 번의 특성 추출으로 여러 관찰 샘플을 얻으므로 효율적이다. 이산 모델은 정책 기울기를, 연속 모델은 생성된 잠재변수에 대한 직접 미분을 통해 최적화한다. 전체 요약 6문장 읽기 → 076 06:11 ▲ 19 · 댓글 2 에이전트 학습의 전체 시스템 개선, WEFT 프레임워크 제시 도구 사용 능력을 갖춘 AI 에이전트 학습을 위한 WEFT 프레임워크를 제안했다. AI · 머신러닝 · WEFT: Scaling Tool-Use Post-Training for General-Purpose Agents
Key Point 환경 확장만으로는 부족하다는 기존 접근의 한계를 지적하고, 에이전트 시스템 전체를 함께 개선하는 방식이 성능 향상에 실질적 영향을 미친다는 점을 실증한다.
핵심 요약
도구 사용 능력을 갖춘 AI 에이전트 학습을 위한 WEFT 프레임워크를 제안했다. 기존 방식은 환경만 확장했지만, WEFT는 환경·태스크·상호작용 다양성을 함께 키운다. 실행 중 발생한 실패를 추적하고 상태 증거를 이용해 문제 컴포넌트를 자동 수정하는 자진 진화 방식을 도입했다. 전체 요약 7문장 읽기 → 077 06:11 ▲ 23 · 댓글 2 평균이 같은 정책도 극단적 손실은 다르다…꼬리 위험 추정 방법 제시 평균 수익이 비슷한 강화학습 정책도 드문 실패(꼬리 위험)에서는 크게 달라지는데, 조건부가치손실(CVaR)을 정확히 추정하려면 많은 롤아웃이 필요하다. AI · 머신러닝 · Tail-Influence Sampling for CVaR Policy Evaluation
Key Point 강화학습 정책 평가에서 드물지만 치명적인 실패를 정확히 예측하는 것이 중요하며, 이 연구는 제한된 평가 예산으로 꼬리 위험을 효율적으로 추정하는 방법론을 제공한다.
핵심 요약
평균 수익이 비슷한 강화학습 정책도 드문 실패(꼬리 위험)에서는 크게 달라지는데, 조건부가치손실(CVaR)을 정확히 추정하려면 많은 롤아웃이 필요하다. 연구팀은 확률적 워크플로우의 각 조건부를 별도로 쿼리할 수 있을 때, 고정된 평가 예산을 꼬리 위험 추정에 최적 배분하는 방법을 제시했다. 각 쿼리 가능한 조건부 법칙에 대해 '꼬리 영향(tail influence)'을 정의해 그 불확실성이 벨만 재사용 전체에서 CVaR에 미치는 영향을 측정한다. 전체 요약 8문장 읽기 → 078 03:11 ▲ 48 · 댓글 3 LLM 에이전트의 장기 작업 검증 성능 6배 향상 LLM 에이전트가 복잡한 장기 작업을 수행할 때 출력 검증이 어려워지는 문제를 다룬다. AI · 머신러닝 · VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
Key Point 장기 작업을 수행하는 AI 에이전트 시스템의 신뢰성 검증 방식이 근본적으로 달라지는 기술로, 다중 시도 결과의 품질 판별 문제를 자동으로 해결할 수 있다.
핵심 요약
LLM 에이전트가 복잡한 장기 작업을 수행할 때 출력 검증이 어려워지는 문제를 다룬다. 여러 번 샘플링한 결과물들이 서로 다른 올바른 주장들을 담을 수 있지만, 어느 것을 믿을지 판단할 신뢰할 수 있는 검증 메커니즘이 필요하다. 의견 불일치는 올바른 대안을 드러내는 경향이 있고, 합의는 오류를 숨길 수 있다는 관찰에서 VeriHarness를 제안한다. 전체 요약 8문장 읽기 → 079 16:56 ▲ 159 · 댓글 75 숨겨진 정보 게임 스트래테고, AI가 인류 최강자 제압 스트래테고는 체스·바둑·포커처럼 AI가 도전해온 게임이지만, 거대한 숨겨진 정보와 2,000수 이상의 긴 게임 길이 때문에 DeepMind도 해결하지 못했다. AI · 머신러닝 · With most information hidden, the game Stratego had stumped AI until now
Key Point AI 연구에서 오랫동안 미해결로 남던 문제를 해결했으며, 막대한 자원 없이도 최강자를 이길 수 있음을 보였기 때문이다.
핵심 요약
스트래테고는 체스·바둑·포커처럼 AI가 도전해온 게임이지만, 거대한 숨겨진 정보와 2,000수 이상의 긴 게임 길이 때문에 DeepMind도 해결하지 못했다. 카네기멜론·MIT·NYU·스탠포드 연구팀이 개발한 AI 아타락소스는 역대 최강자 핌 니메이예르를 20게임 중 15승 1패 4무로 압도했다. 스트래테고는 40개 피스의 조합이 데실리언 가지에 달하고, 블러핑이 핵심이라 기존 AI들이 전략을 찾기 어려웠다. 전체 요약 12문장 읽기 → 080 03:11 ▲ 175 · 댓글 3 온정책 vs 비정책 학습, 체계적 실험으로 재평가 온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다. AI · 머신러닝 · On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
Key Point 강화학습 기반 모델 최적화에서 온정책 학습의 필요성이 통념으로 여겨졌지만, 체계적인 실험을 통해 그 가정을 재검토한 논문으로 실무 선택에 직결되는 통찰을 제시한다.
핵심 요약
온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다. 연구팀은 강한 모델을 약한 모델로 증류하는 통제된 실험에서 온정책 정책, KL 방향, 학습률을 독립적으로 변경하며 Llama3과 Qwen2.5에서 과학·의료·산술 추론 과제를 실시했다. 분석 결과 온정책 정책이 중심 역할을 하지 않는 것으로 드러났다. 전체 요약 8문장 읽기 → 081 21:11 ▲ 51 · 댓글 2 다중 에이전트 경로 탐색, 반복적 의도 정제로 충돌 해결 다중 에이전트 경로 탐색(MAPF)에서 에이전트들이 독립적으로 행동을 샘플링할 때, 각 에이전트의 선택은 타당해도 결합하면 충돌하는 문제가 발생한다. AI · 머신러닝 · Decentralized Master-Mind: Joint Action Refinement through Iterative Intent Denoising in Multi-Agent Pathfinding
Key Point 분산형 다중 에이전트 시스템에서 각 에이전트가 독립적으로 결정할 때 발생하는 조정 실패를 반복적 정제로 해결하는 새로운 방식으로, 경로 탐색 성능 한계를 크게 개선한다.
핵심 요약
다중 에이전트 경로 탐색(MAPF)에서 에이전트들이 독립적으로 행동을 샘플링할 때, 각 에이전트의 선택은 타당해도 결합하면 충돌하는 문제가 발생한다. DMM(Decentralized Master-Mind)은 일회성 샘플링 대신 확산 모델의 노이징 제거에서 영감을 얻은 반복적 의도 정제 방식을 제안한다. 에이전트들이 무작위 행동 의도로 시작해 통신을 통해 지역적으로 선택을 조정한 뒤 최종 결정을 내린다. 전체 요약 6문장 읽기 → 082 15:11 ▲ 83 · 댓글 2 강화학습 미세조정 후 LLM의 성능 편향성, 'Sharpening Tax' 측정법 제시 RL 미세조정이 기본 모델의 기존 행동만 선명하게 만들어 단일 시도 정확도(pass@1)는 높이지만 전체 해결 가능성(pass@K)은 낮춘다는 가설이 제기되고 있다. AI · 머신러닝 · Sharpening Tax in Post-Training
Key Point LLM의 강화학습 미세조정이 실제로는 문제 해결 능력을 좁히는 부작용이 있다는 실증적 증거와 이를 측정하고 개선하는 방법론을 제시하여, 에이전트 성능 평가와 최적화 전략에 근본적인 재고를 촉구한다.
핵심 요약
RL 미세조정이 기본 모델의 기존 행동만 선명하게 만들어 단일 시도 정확도(pass@1)는 높이지만 전체 해결 가능성(pass@K)은 낮춘다는 가설이 제기되고 있다. 아젠틱 작업에서는 사전학습 모델이 추론 시간 예산을 충분히 주면 미세조정 모델보다 pass@K에서 더 높은 성능을 보인다는 놀라운 발견이 있었다. 미세조정이 작업을 '항상 해결 가능' 또는 '절대 불가능' 양극단으로 밀어 샘플링 효율과 일관성은 개선하지만 해결 가능 범위는 줄인다는 메커니즘을 규명했다. 전체 요약 6문장 읽기 → 083 12:11 ▲ 49 · 댓글 2 확산형 언어모델을 위한 텍스트 임베딩 최적화 자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. AI · 머신러닝 · Scaling and Distilling Text Embeddings for Better Diffusibility
Key Point 확산형 언어모델이 자기회귀 방식의 성능에 접근하기 위해서는 어떤 임베딩 공간이 최적인지 밝혀지지 않았는데, 이 연구가 스케일링과 증류 기법으로 그 해답을 제시한다.
핵심 요약
자기회귀 모델의 대안으로 주목받는 확산 언어모델(DLM)은 연속 텍스트 임베딩의 잠재공간에서 생성을 수행한다. 연구팀은 T5 계열 임베딩을 T5Gemma-1, T5Gemma-2로 확대했을 때 생성 성능이 크게 향상됨을 발견했다. 그러나 T5Gemma-2는 너무 판별력이 강해서 유사한 단어들의 임베딩까지 멀리 떨어져 있어, 샘플링 오류 시 유효한 임베딩을 찾지 못하는 문제가 발생한다. 전체 요약 7문장 읽기 → 084 12:11 ▲ 79 · 댓글 2 토큰 독립성 문제 해결한 계층형 연속 확산 언어모델 이산 확산 언어모델은 양방향 추론과 전역 제약 만족이 필요한 작업에서 자기회귀 생성의 대안이 되지만, 병렬 디코딩 시 각 토큰을 독립적으로 샘플링하면서 토큰 간 통계적 의존성을 끊는 구조적 병목을 공유한다. AI · 머신러닝 · Hierarchical Continuous Diffusion Language Models
Key Point 병렬 디코딩에서 토큰 간 의존성을 보존하면서도 전역 제약을 만족시키는 방식으로 확산 언어모델의 핵심 구조적 문제를 해결했기에, 생성 모델의 근본적인 설계 변화로 관심을 끈다.
핵심 요약
이산 확산 언어모델은 양방향 추론과 전역 제약 만족이 필요한 작업에서 자기회귀 생성의 대안이 되지만, 병렬 디코딩 시 각 토큰을 독립적으로 샘플링하면서 토큰 간 통계적 의존성을 끊는 구조적 병목을 공유한다. 연속 확산 언어모델은 공유 연속 상태를 노이징하여 이를 피하지만, 노이저가 그 상태만 보므로 최종 디코딩까지 유효한 토큰 구성과의 연결고리가 없다. HC-DLM(Hierarchical Continuous Diffusion Language Models)은 이산 토큰 생성과 연속 잠재 궤적을 단일의 원칙적인 노이징 제거 과정으로 결합하며, 훈련 목적은 토큰 우도에 대한 변분 경계에서 유도된다. 전체 요약 6문장 읽기 → 085 06:11 ▲ 122 · 댓글 20 ESP32 칩에서 숨겨진 SDR 기능 발견, 무선 신호 수신 가능 ESPARGOS 프로젝트가 ESP32 칩에 문서화되지 않은 기능을 발견했으며, 이를 통해 WiFi와 Bluetooth 기능을 우회해 원본 IQ 베이스밴드 샘플을 캡처할 수 있다. 하드웨어 · 시스템 · Various Projects Find Hidden SDR Capabilities in ESP32 Microcontrollers
Key Point ESP32가 광범위 무선신호 수신에 사용될 수 있다는 발견으로, 저비용 SDR 활용의 새로운 가능성을 열었고 이미 여러 프로젝트가 실제 구현을 진행 중이다.
핵심 요약
ESPARGOS 프로젝트가 ESP32 칩에 문서화되지 않은 기능을 발견했으며, 이를 통해 WiFi와 Bluetooth 기능을 우회해 원본 IQ 베이스밴드 샘플을 캡처할 수 있다. 여러 ESP32 모델은 2.2~2.7 GHz 및 ESP32-C5에서는 4.8~6.0 GHz 대역을 커버하는 내부 SDR로 사용 가능하며 최대 80 MS/s 샘플링 속도와 13~54 MHz 아날로그 대역폭을 제공한다. 일반적인 PC 연결 SDR로는 출력 대역폭이 부족해 스냅샷만 PC로 내보낼 수 있으므로 스펙트럼 분석기로만 동작하며, 지속적인 라디오 데이터 복조나 디코딩은 불가능하다. 전체 요약 10문장 읽기 → 086 21:11 당일 +128 다양한 골격에 애니메이션을 주는 통합 모델 UniMate 공개 SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. AI · 머신러닝 · Friedrich-M/UniMate · Python
Key Point 텍스트 기반 3D 애니메이션 생성의 일반화 문제를 단일 모델로 해결한 첫 사례이며, 영상 제작·게임 개발·디지털 캐릭터 제작 분야의 자동화를 크게 앞당길 기술이기 때문이다.
핵심 요약
SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. UniML3D라는 13,006개 텍스트 쌍 모션 시퀀스 데이터셋을 구축했으며, Mixamo, Objaverse-XL, Truebones ZOO에서 수집한 자산을 통일된 형식으로 정규화했다. 텍스트 프롬프트와 3D 리깅된 자산만으로 실시간 모션 생성이 가능하며, 스켈레톤별 재학습이나 테스트 시점 최적화가 필요 없다. 전체 요약 9문장 읽기 → 087 18:11 ▲ 105 · 댓글 5 터미널 에이전트의 명령 실행 신뢰도를 높이는 Mid-Harness 기법 터미널 에이전트는 모델이 생성한 명령을 직접 실행하는데, 생성 능력이 있어도 실행 신뢰도가 낮으면 환경을 악화시킬 수 있는 문제가 있다. AI · 머신러닝 · Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
Key Point 터미널 에이전트는 프롬프트 길이나 궤적 증가보다 명령 검증에 계산을 투입하는 것이 더 효율적이라는 발견이 실제 배포 에이전트의 신뢰도 개선 전략을 바꿀 수 있다.
핵심 요약
터미널 에이전트는 모델이 생성한 명령을 직접 실행하는데, 생성 능력이 있어도 실행 신뢰도가 낮으면 환경을 악화시킬 수 있는 문제가 있다. Mid-Harness는 모델과 실행 환경 사이에서 여러 개의 후보 명령을 샘플링하고 검증한 뒤 가장 좋은 것만 실행하는 방식을 제안한다. TMAX-9B 생성기에서는 단순 검증으로는 샘플링 이득이 적지만, 성능 높은 검증기는 같은 생성기에서도 유용한 대안을 찾을 수 있다. 전체 요약 7문장 읽기 → 088 15:11 ▲ 247 · 댓글 3 멀티모달 AI가 자기 피드백으로 스스로 성장하는 방법 현대 멀티모달 모델은 생성과 이해를 하나의 시스템에 통합해 자신의 피드백으로부터 학습할 수 있는 잠재력을 가지고 있다. AI · 머신러닝 · UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement
Key Point 외부 감독 없이 AI 모델이 자신의 비판적 피드백으로 스스로 개선되는 메커니즘을 제시해, 모델 성능 향상의 새로운 가능성을 보여준다.
핵심 요약
현대 멀티모달 모델은 생성과 이해를 하나의 시스템에 통합해 자신의 피드백으로부터 학습할 수 있는 잠재력을 가지고 있다. UniEvo-VL은 이러한 능력을 활용해 모델이 테스트 타임에 자기수정 피드백으로부터 배우도록 하는 자기진화 프레임워크다. 별도의 큰 교사 모델에 의존하는 대신, 단일 멀티모달 모델이 서로 다른 맥락에서 교사와 학생 역할을 동시에 수행한다. 전체 요약 8문장 읽기 → 089 09:11 ▲ 12 · 댓글 2 픽셀 디퓨전 모델에 적대적 학습 추가로 고주파 품질 개선 픽셀 디퓨전 모델은 오토인코더 병목을 피해 RGB 이미지를 직접 생성하지만, 미세한 자연 이미지 통계를 체계적으로 과소 표현하는 문제가 있다. AI · 머신러닝 · Adversarial Training for Pixel Diffusion
Key Point 픽셀 디퓨전이 기존 오토인코더 기반 모델의 문제를 우회한다는 점에서 더 직접적인 방식이었으나, 미세한 디테일 손실 문제를 적대적 학습으로 해결할 수 있음을 보여주는 실질적 개선 방법이기 때문입니다.
핵심 요약
픽셀 디퓨전 모델은 오토인코더 병목을 피해 RGB 이미지를 직접 생성하지만, 미세한 자연 이미지 통계를 체계적으로 과소 표현하는 문제가 있다. 연구팀은 사전학습된 모델에 적대적 손실을 더해 이 결함을 보정하는 방법을 제시했다. 원래 확산 또는 플로우 매칭 목표를 유지하면서 비고노이즈 타임스텝에서만 적대적 손실을 예측 출력에 추가한다. 모델 아키텍처와 샘플링 절차는 변경하지 않으며, 픽셀 디퓨전의 적대적 사후학습에 대한 첫 체계적 연구다. 전체 요약 9문장 읽기 → 090 15:11 ▲ 28 · 댓글 2 장시간 자율 작업 하는 AI 에이전트 '마라톤러' 공개 허깅페이스 연구팀이 수개월 이상 지속적으로 목표를 추구하는 초장기 자율 에이전트 '마라톤러'를 제시했다. AI · 머신러닝 · Marathoner: Ultra-Long-Horizon Autonomous Intelligence
Key Point AI 에이전트가 단기 작업을 넘어 수개월 규모의 복잡한 소프트웨어 개발 같은 초장기 미션을 독립적으로 수행할 수 있는 가능성을 보여주기 때문입니다.
핵심 요약
허깅페이스 연구팀이 수개월 이상 지속적으로 목표를 추구하는 초장기 자율 에이전트 '마라톤러'를 제시했다. GitHub 주요 PR에서 1000줄 이상의 새 코드를 포함한 데이터를 수집해 초장기 태스크를 합성했으며, 여러 작업을 연결한 멀티태스크 체이닝으로 최고난도 태스크를 생성했다. 강력한 교사 모델과 다양한 하니스(harness)를 조합해 거부 샘플링 파인튜닝을 수행하고, 모델이 독립 샌드박스 환경에서 실제 작업을 실행하며 1000+ 도구 호출을 처리하도록 강화학습했다. 전체 요약 6문장 읽기 → 091 15:11 ▲ 25 · 댓글 2 동영상 생성 모델의 '일괄 증류' 기술 공개 동영상 확산 모델이 다양한 작업에 특화되면서 각각 증류 단계를 반복하는 비효율이 발생하고 있다. AI · 머신러닝 · LongLive-Plug: Once-for-All Distillation for Video Generation
Key Point 동영상 생성 모델 특화로 인한 반복 학습 비용을 획기적으로 줄이는 기술로, 실제 배포된 54개 모델에서 검증되었기 때문에 현실성 있는 효율화 방안을 제시한다.
핵심 요약
동영상 확산 모델이 다양한 작업에 특화되면서 각각 증류 단계를 반복하는 비효율이 발생하고 있다. LongLive-Plug는 한 번의 학습으로 여러 모델에 재사용 가능한 기능을 LoRA로 학습하는 일괄 증류 프레임워크다. 단일 패스 분류기 없는 가이던스, 소수 단계 샘플링, 자동회귀 생성의 장기 맥락 오류 보정 기능을 제공한다. 전체 요약 8문장 읽기 → 092 15:11 ▲ 81 · 댓글 1 교사 모델과 학생의 불일치를 줄이는 지도 라우팅 기법 SAKI 온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. AI · 머신러닝 · SAKI: Maximal-Coupling-Routed Teacher Supervision for On-Policy Distillation
Key Point 학생 모델을 효율적으로 증류하면서 정확도를 높이는 새로운 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 비용 절감에 직결된다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. SAKI(Supervision Allocation with KL-constrained Interpolation)는 KL 제약 교사 유도 롤아웃과 최대 결합을 결합하여, 실현된 수용/교정 이벤트를 재사용해 토큰 수준의 감독을 라우팅한다. 수용된 위치는 샘플링된 토큰의 역-KL 감독을 유지하고, 교정 위치는 교사의 최고 확률 토큰에 대한 직접 감독을 받는다. 전체 요약 7문장 읽기 → 093 00:11 ▲ 15 · 댓글 1 LLM 강화학습의 훈련-추론 불일치 문제, 보정된 중요도 샘플링으로 해결 LLM 강화학습에서 추론 엔진과 훈련 엔진이 같은 토큰에 다른 확률을 할당하는 '훈련-추론 불일치' 문제를 분석했다. AI · 머신러닝 · Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
Key Point LLM 강화학습 훈련에서 핵심적인 엔진 간 확률 불일치 문제의 근본 원인을 수학적으로 규명하고 실질적인 해결책을 제시해, 향후 LLM-RLHF 개선에 직접 적용 가능한 방법론을 제공한다.
핵심 요약
LLM 강화학습에서 추론 엔진과 훈련 엔진이 같은 토큰에 다른 확률을 할당하는 '훈련-추론 불일치' 문제를 분석했다. 이 불일치를 로짓 공간의 덧셈 변위(epsilon_t)로 특성화하며, 이 분포가 토큰 신뢰도에 관계없이 대체로 불변임을 발견했다. 이를 바탕으로 '보정된 중요도 샘플링(Calibrated Importance Sampling, CIS)'을 제안했다. 전체 요약 7문장 읽기 → 094 21:11 ▲ 112 · 댓글 2 코드 에이전트 강화학습에서 품질 기반 보상 재분배하는 GAGAR 제안 기존 코드 에이전트 강화학습은 실행 가능한 테스트로 이진 보상을 제공하는데, Group Relative Policy Optimization(GRPO)은 테스트를 통과한 모든 궤적에 동일한 이득을 할당하여 구현 품질의 차이를 무시하는 문제가 있다. AI · 머신러닝 · Groupwise Agentic Grading and Advantage Redistribution for Code Agent RL
Key Point 테스트 통과 여부만 판단하던 기존 강화학습에서 구현 품질 차이를 감지하는 에이전트를 추가하면 코드 생성 모델의 학습 신호가 더 정교해진다.
핵심 요약
기존 코드 에이전트 강화학습은 실행 가능한 테스트로 이진 보상을 제공하는데, Group Relative Policy Optimization(GRPO)은 테스트를 통과한 모든 궤적에 동일한 이득을 할당하여 구현 품질의 차이를 무시하는 문제가 있다. 이를 보완하기 위해 GAGAR 프레임워크를 제안하는데, 통과 및 실패 궤적을 모두 포함하는 그룹만 선별하여 동적 샘플링한다. 각 그룹의 모든 궤적을 공유 작업공간에 놓고, SFT 학습된 에이전트 평가자가 이들을 함께 검사하여 테스트 통과 후보들을 순위 매긴다. 전체 요약 7문장 읽기 → 095 15:11 ▲ 28 · 댓글 1 불확실한 성공은 강화, 확실한 실패는 교정하는 LLM 추론 방식 LLM의 추론 능력을 강화하는 검증 가능한 보상 기반 강화학습(RLVR)에서 기존 신용 할당 방식들은 보조 모델이나 추가 샘플링, 특권 정보가 필요했다. AI · 머신러닝 · Surprising Success, Repeated Failure: Entropy-Guided Credit Assignment for Exploration in LLM Reasoning
Key Point LLM이 복잡한 추론 과제를 풀 때 필요한 신용 할당에서 추가 모델 없이도 작동하는 더 효율적인 방법이 제시되어, 강화학습 기반 LLM 개선의 실용성을 높인다.
핵심 요약
LLM의 추론 능력을 강화하는 검증 가능한 보상 기반 강화학습(RLVR)에서 기존 신용 할당 방식들은 보조 모델이나 추가 샘플링, 특권 정보가 필요했다. 이 논문은 정책 엔트로피를 신호로 활용하되 성공과 실패를 비대칭으로 처리하는 Entropic Advantage Policy Optimization(EAPO)을 제안한다. EAPO의 핵심 아이디어는 불확실한 상황에서의 성공은 반복성이 낮고 확실한 실패는 되풀이되는 경향에서 비롯되었다. 전체 요약 7문장 읽기 → 096 12:11 ▲ 60 · 댓글 1 실제 배포 데이터로 에이전트 테스트 벤치마크 자동 생성 TraceDance는 실제 에이전트 배포 기록에서 문제 행동을 추출해 목표형 벤치마크를 자동 구축하는 시스템이다. AI · 머신러닝 · TraceDance: An Automated System for Building Agent Behavior Benchmarks from Real-World Agent Deployment Traces
Key Point 실전 배포 데이터 252,557개에서 자동으로 테스트 벤치마크를 만드는 기법이 공개됐으며, 현재 최고 성능의 LLM들도 이 벤치마크에서 평균 26.7%의 낮은 통과율만 기록해 에이전트 시스템의 개선 과제를 명확히 한다.
핵심 요약
TraceDance는 실제 에이전트 배포 기록에서 문제 행동을 추출해 목표형 벤치마크를 자동 구축하는 시스템이다. Anchor-and-Confirm 기법은 프로그래머블 검색과 Flash LLM의 후보 수준 확인을 조합해 효율적으로 벤치마크를 만든다. Anchor Synthesis Loop는 사용자가 지정한 문제 행동에 대한 명세를 생성하고 반복적으로 개선한다. 전체 요약 8문장 읽기 → 097 21:11 ▲ 12 · 댓글 1 수학 모델에서 자동으로 에이전트 학습 환경 생성 Language model 에이전트의 장기 작업 학습을 위해 다양한 환경이 필요하지만, 기존 방식은 환경 구성 후 평가 규칙을 나중에 맞추는 문제가 있다. AI · 머신러닝 · Verifiable Hidden Dynamics Play: Generating Agentic RL Environments from Solved Mechanisms
Key Point 기존 환경 생성 방식의 비일관성 문제를 해결하면서도 낮은 비용으로 대규모 다양한 학습 데이터를 자동 생성할 수 있는 새로운 파이프라인이 실제 벤치마크에서 검증되었기 때문이다.
핵심 요약
Language model 에이전트의 장기 작업 학습을 위해 다양한 환경이 필요하지만, 기존 방식은 환경 구성 후 평가 규칙을 나중에 맞추는 문제가 있다. VHD-Play는 이 순서를 역전하여, 먼저 수학 모델을 샘플링하고 풀이한 뒤 그 결과를 바탕으로 stateful 도구로 변환한다. 실행 가능한 환경 동작과 궤적 평가 기준이 같은 풀이된 모델에서 나오므로 일관성이 보장된다. 전체 요약 9문장 읽기 → 098 22:45 당일 +166 C++로 만든 이미지 생성 엔진, Flux·Qwen 등 최신 모델까지 지원 stable-diffusion.cpp는 GGML 기반의 순수 C/C++ 구현으로 Stable Diffusion, Flux, Wan, Qwen Image 등 다양한 이미지·영상 생성 모델을 추론할 수 있는 경량 프레임워크다. AI · 머신러닝 · leejet/stable-diffusion.cpp · C++
Key Point 로컬 머신에서 최신 이미지·영상 생성 모델을 실행할 수 있는 경량 C++ 구현이 빠르게 성장하고 있으며, 모델 추가 속도가 빠르므로 개인 또는 온프레미스 AI 구축을 고려하는 개발자에게 선택지가 되고 있다.
핵심 요약
stable-diffusion.cpp는 GGML 기반의 순수 C/C++ 구현으로 Stable Diffusion, Flux, Wan, Qwen Image 등 다양한 이미지·영상 생성 모델을 추론할 수 있는 경량 프레임워크다. 외부 의존성이 없으며, 모델 무게 형식으로 PyTorch 체크포인트(.ckpt, .pth, .pt), Safetensors, GGUF를 지원하고 가중치를 .gguf나 .safetensors로 변환할 수 있다. CPU(AVX, AVX2, AVX512), CUDA, Vulkan, Metal, OpenCL, SYCL 백엔드를 지원하며 Linux, macOS, Windows, Android(Termux)에서 실행된다. 전체 요약 7문장 읽기 → 099 22:29 ▲ 16 · 댓글 3 토큰 단위 신용할당 원리로 LLM 강화학습 개선 강화학습 기반 LLM 후처리 훈련에서 토큰 단위 신용할당(credit assignment)의 수학적 정의가 명확하지 않아, 기존 훈련 신호들과의 관계가 불분명했다. AI · 머신러닝 · PACT: From Credit Assignment to Critic Alignment
Key Point 토큰 단위 신용할당의 수학적 정의를 처음 엄밀하게 규정하고, 이를 바탕으로 LLM 강화학습의 핵심 알고리즘들을 통일된 틀에서 설명하며, 실제 수학·소프트웨어 문제에서 기존 방법들을 크게 능가하는 구체적 성과를 냈다.
핵심 요약
강화학습 기반 LLM 후처리 훈련에서 토큰 단위 신용할당(credit assignment)의 수학적 정의가 명확하지 않아, 기존 훈련 신호들과의 관계가 불분명했다. Completeness, Prefix Consistency, Neutrality 세 가지 정칙성 조건을 제시하면 토큰 단위 신용할당이 유일하게 결정됨을 증명했다. 이 특성화를 통해 On-Policy Distillation(OPD)의 이상적 교사가 암묵적 비평가 역할을 하며, Response-level REINFORCE Leave-One-Out(RLOO)이 토큰 단위 신용할당과 일치하는 정책 기울기를 낸다는 것을 확인했다. 전체 요약 7문장 읽기 → 100 15:11 ▲ 46 · 댓글 2 텍스트·이미지·영상·음성을 하나로 이해하는 멀티모달 임베딩 모델 공개 Hugging Face 연구팀이 텍스트, 이미지, 영상, 음성을 통합으로 처리하는 Ovis-Embedding을 발표했다. AI · 머신러닝 · Ovis-Embedding: Pushing the Frontiers of Universal Omni-Modal Embeddings
Key Point 단일 모달리티 검색의 한계를 극복하고 텍스트-영상, 음성-텍스트 등 크로스 모달 검색이 필요한 개발자와 연구자에게 새로운 기술 선택지를 제공한다.
핵심 요약
Hugging Face 연구팀이 텍스트, 이미지, 영상, 음성을 통합으로 처리하는 Ovis-Embedding을 발표했다. 기존의 분리된 모달리티 타워 대신 공유 멀티모달 백본을 사용해 모든 데이터를 공통 표현 공간으로 인코딩한다. Qwen-omni 사전학습 모델을 기반으로 대조 학습과 저랭크 초기화를 통해 학습했다. 전체 요약 5문장 읽기 →