쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
40건 · "llama.cpp"조건 지우기 ×
001 03:11 당일 +116 Apple 실리콘용 로컬 AI 추론 엔진 Splash 출시 Splash는 M3 이상 Apple 실리콘에서 Qwen·Ornith·Flint 등 27B~122B 모델을 로컬 추론하는 C++ 기반 엔진이다. AI · 머신러닝 · incoai/splash · C++
Key Point Apple 맥 사용자가 외부 클라우드 없이 고성능 LLM을 로컬에서 돌릴 수 있는 선택지가 생겼으며, 기존 llama.cpp 대비 큰 폭의 속도 향상으로 실용성이 크게 높아졌다.
핵심 요약
Splash는 M3 이상 Apple 실리콘에서 Qwen·Ornith·Flint 등 27B~122B 모델을 로컬 추론하는 C++ 기반 엔진이다. DFlash2 추측적 디코딩, Metal 커널 최적화, 자동 메모리 계획을 조합해 동작하며, 비전·도구 호출·내장 채팅 UI를 지원한다. OpenAI/Anthropic 호환 API로 스트리밍, 도구 호출, JSON Schema 출력을 제공하고, 프리필 캐시 재사용으로 동시 요청을 자동 배칭한다. 전체 요약 12문장 읽기 → 002 21:11 당일 +488 2시간 만에 64M 언어모델 훈련하는 MiniMind 오픈소스 개인 개발자도 단 3천원과 2시간으로 64M 파라미터 소형 언어모델 MiniMind를 처음부터 훈련할 수 있도록 설계한 오픈소스 프로젝트를 공개했다. AI · 머신러닝 · jingyaogong/minimind · Python
Key Point 개인 GPU로 대규모 모델 훈련의 허들을 극단적으로 낮춘 완전 오픈 LLM 학습 프레임워크로, 프리트레인부터 RL까지 모든 과정을 처음부터 직접 구현하면서 배울 수 있다.
핵심 요약
개인 개발자도 단 3천원과 2시간으로 64M 파라미터 소형 언어모델 MiniMind를 처음부터 훈련할 수 있도록 설계한 오픈소스 프로젝트를 공개했다. MiniMind-3는 Dense 아키텍처로 64M 파라미터, MiniMind-3-MoE는 198M-A64M 규모이며, Qwen3 생태와 구조를 맞추었고 모두 PyTorch 원생 구현으로 써드파티 라이브러리 추상화에 의존하지 않는다. 예훈련, 감독 미세조정(SFT), LoRA, DPO, PPO/GRPO/CISPO 같은 RLAIF, 도구 사용, 에이전트 RL, 적응형 사고, 모델 증류 등 전체 훈련 파이프라인 코드와 데이터셋을 공개했다. 전체 요약 11문장 읽기 → 003 21:11 당일 +107 자유로운 AI 상호작용 위한 오픈소스 채팅 플랫폼 G0DM0D3 G0DM0D3는 TypeScript 기반의 완전 오픈소스 멀티 모델 채팅 인터페이스로, 오픈라우터의 60개 모델, 베니스의 44개 모델, 또는 로컬 모델을 지원한다. AI · 머신러닝 · elder-plinius/G0DM0D3 · TypeScript
Key Point 로컬 모델부터 프로프리터리 API까지 다양한 백엔드를 지원하면서 프롬프트 주입과 jailbreak 기법을 체계적으로 테스트할 수 있는 도구로, AI 보안 연구와 모델 평가에 필요한 오픈소스 인프라를 제공한다.
핵심 요약
G0DM0D3는 TypeScript 기반의 완전 오픈소스 멀티 모델 채팅 인터페이스로, 오픈라우터의 60개 모델, 베니스의 44개 모델, 또는 로컬 모델을 지원한다. GODMODE CLASSIC 모드에서는 클로드 소넷 4.6, Grok 4.5, Gemini 2.5 Flash, GPT-4, Hermes 4-405b 등 5개의 모델+프롬프트 조합이 병렬로 경쟁하여 최고 응답을 반환한다. ULTRAPLINIAN 엔진은 속도 최적화(12개), 표준(27개), 강력한 추론(41개), 파워(53개), 울트라(60개) 등 5단계로 모델을 평가하고 복합 점수로 우승자를 결정한다. 전체 요약 12문장 읽기 → 004 09:11 당일 +139 AI 에이전트가 탑재된 데스크톱 앱 OpenWorker 공개 andrewyng가 만든 OpenWorker는 AI 코워커 데스크톱 앱과 에이전트 구축용 Harness SDK를 제공한다. AI · 머신러닝 · andrewyng/openworker · Python
Key Point 로컬 우선 설계, 사용자 승인 기반 거버넌스, 샌드박싱으로 에이전트 자동화의 안전성 문제를 해결하는 데스크톱 앱 프레임워크이기 때문에 에이전트 앱 개발자와 AI 도구 사용자 모두에게 중요하다.
핵심 요약
andrewyng가 만든 OpenWorker는 AI 코워커 데스크톱 앱과 에이전트 구축용 Harness SDK를 제공한다. 데스크톱 앱은 로컬 머신에서 실행되며, 연구·작성·코드 리뷰·작업 자동화를 지원하고 사용자가 보유한 모델 키나 Ollama 같은 로컬 모델을 사용할 수 있다. GitHub, Slack, 이메일, 캘린더 등 연결된 도구들을 통합하고 MCP를 통해 새 도구를 추가할 수 있으며, Slack에서 @OpenWorker를 호출해 데스크톱 작업을 위임할 수 있다. 전체 요약 12문장 읽기 → 005 00:11 당일 +154 머신러닝 텐서 라이브러리 GGML 오픈소스 GGML은 머신러닝을 위한 간단하고 이식 가능하며 효율적인 텐서 라이브러리로, 최소한의 설정으로 사용할 수 있도록 설계됐다. AI · 머신러닝 · ggml-org/ggml · C++
Key Point 경량 모델 추론과 량자화에 의존하는 프로젝트들이 채택하는 핵심 인프라로, 의존성 없이 다양한 하드웨어에서 동작하는 오픈소스 라이브러리의 선택지를 이해해야 한다.
핵심 요약
GGML은 머신러닝을 위한 간단하고 이식 가능하며 효율적인 텐서 라이브러리로, 최소한의 설정으로 사용할 수 있도록 설계됐다. 의존성 없는 순수 C/C++ 구현이며 x86, ARM, RISC-V, LoongArch, PowerPC, s390x, WebAssembly 등 다양한 플랫폼을 지원한다. x86, ARM, RISC-V용 SIMD 최적화 커널을 포함하고 있으며, CPU, GPU, NPU, 브라우저 등 광범위한 백엔드를 지원한다. 전체 요약 6문장 읽기 → 006 03:11 ▲ 106 · 댓글 41 구형 기기에 LLM 돌리기, 기술 한계 뚫다 오래된 저사양 기기(TV 박스, 스마트폰, 싱글보드 컴퓨터)에 큰 언어 모델을 고속으로 실행시키는 기술을 공개했다. AI · 머신러닝 · I'm making LLMs work on small and old devices
Key Point 오래된 저가 기기들이 LLM 추론을 실시간 속도로 실행할 수 있다는 증명으로, 엣지 AI와 오프라인 모델 배포의 현실성을 보여준다.
핵심 요약
오래된 저사양 기기(TV 박스, 스마트폰, 싱글보드 컴퓨터)에 큰 언어 모델을 고속으로 실행시키는 기술을 공개했다. 시아오미 TV 박스(Cortex-A55 4코어, 1.9GB RAM, 278MB/s 플래시)에서 0.8B~16B 모델을 260K부터 16B 파라미터까지 지원한다. Qwen3.5-0.8B는 7.5→16.8 tok/s로 2.2배 가속, Qwen3.5-2B는 0.1→7.7 tok/s로 77배 개선, 8B 모델은 5~7 tok/s에서 실행된다. 전체 요약 10문장 읽기 → 007 21:11 ▲ 116 · 댓글 26 화웨이, 로컬 추론용 양자화 도구 MACaQ 공개 화웨이가 개발한 MACaQ는 텍스트, 이미지, 비디오, 오디오 모델을 양자화하는 모델 무관 양자화 도구로, llama.cpp, vLLM, Diffusers, PyTorch 등 다양한 백엔드를 지원한다. AI · 머신러닝 · Huawei releases MACaQ, its internal quantizer for local inference
Key Point 로컬 환경에서 대규모 모델을 빠르게 양자화하려는 개발자들에게 성능과 속도 모두 우수한 새로운 도구가 공개되어, 리소스 제한적인 환경에서의 모델 배포 선택지가 확대되었다.
핵심 요약
화웨이가 개발한 MACaQ는 텍스트, 이미지, 비디오, 오디오 모델을 양자화하는 모델 무관 양자화 도구로, llama.cpp, vLLM, Diffusers, PyTorch 등 다양한 백엔드를 지원한다. 122B 파라미터 모델을 64분 내에 32.5GB 메모리만으로 양자화할 수 있으며, MR-GPTQ와 DuQuant++보다 더 낮은 퍼플렉시티를 달성하거나 Llama-3-8B에서 11배 빠른 양자화 시간으로 동등한 성능을 제공한다. llama.cpp 백엔드는 2/3/4비트 GGUF 포맷의 텍스트 생성을 지원하고 CPU 실행도 가능하며, vLLM은 W4A4 또는 가중치 전용 양자화로 텍스트 생성 및 서빙을 지원한다. 전체 요약 8문장 읽기 → 008 09:11 새 버전 올라마 0.40.16 출시, Ripple 모델 지원 추가 올라마 v0.40.16이 릴리스되었다. 오픈소스 · 도구 · ollama/ollama@v0.40.16
Key Point 로컬 LLM 개발·배포의 중심 도구인 올라마의 기능 확대와 최적화가 이뤄졌으며, 특히 65B 코딩 전문 모델 추가와 메모리 효율성 개선으로 실무 적용 성이 높아진다.
핵심 요약
올라마 v0.40.16이 릴리스되었다. Recursive Intelligence의 Ripple Preview라는 65B 규모 에이전틱 코딩 모델을 새로 지원한다. Qwen3.8 Flash는 애플 실리콘에서 약 27GB 메모리를 절약하도록 최적화되었다. 전체 요약 9문장 읽기 → 009 21:11 당일 +243 Y 콤비네이터 CEO의 AI 에이전트용 메모리 시스템 공개 Y 콤비네이터 회장 개리 탄(Garry Tan)이 자신의 OpenClaw·Hermes 에이전트를 위해 직접 구축한 GBrain이라는 메모리 시스템을 오픈소스(MIT 라이선스)로 공개했다. AI · 머신러닝 · garrytan/gbrain · TypeScript
Key Point AI 에이전트가 일반화되면서 장기 기억과 정보 조회 능력이 결정적 격차가 되는데, Y 콤비네이터 CEO가 직접 쓰며 검증한 프로덕션급 메모리 시스템이 오픈소스로 공개된 것으로, 에이전트 개발자와 기업 팀이 자신의 에이전트에 즉시 적용할 수 있다.
핵심 요약
Y 콤비네이터 회장 개리 탄(Garry Tan)이 자신의 OpenClaw·Hermes 에이전트를 위해 직접 구축한 GBrain이라는 메모리 시스템을 오픈소스(MIT 라이선스)로 공개했다. GBrain은 AI 에이전트에게 제어 가능한 메모리를 부여하며, 명시적 사실을 출처와 함께 저장하고 수정·철회를 지원하고 여러 에이전트 간 메모리 공유를 가능하게 한다. 키워드 검색으로 시작하되 필요할 때 의미론적 검색·종합·배경 강화를 추가할 수 있으며, 자체 호스팅은 무료이고 gbrain.io의 유료 호스팅 옵션이 별도로 있다. 전체 요약 13문장 읽기 → 010 00:11 ▲ 106 · 댓글 34 284B 대형 AI 모델, GPU 없이 64GB RAM에서 실행하기 llama-modchip v2.4.0은 GPU 없이 순수 CPU만으로 284B 파라미터의 DeepSeek-V4-Flash 모델을 64GB RAM에서 실행할 수 있는 오픈소스 프로젝트다. AI · 머신러닝 · Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU
Key Point GPU 없이 대형 언어 모델을 기존 CPU 워크스테이션에서 실행할 수 있게 되면, 엔터프라이즈 AI 인프라의 진입 장벽이 크게 낮아진다.
핵심 요약
llama-modchip v2.4.0은 GPU 없이 순수 CPU만으로 284B 파라미터의 DeepSeek-V4-Flash 모델을 64GB RAM에서 실행할 수 있는 오픈소스 프로젝트다. 표준 방식으로는 DeepSeek-V4-Flash가 76.87GB가 필요해 64GB 시스템에서 메모리 부족 오류가 나지만, SwiGLU-H2 2차 헤시안 압축과 Fractal-64 양자화(3.75 bits/weight)를 조합하면 56.56GB로 축소할 수 있다. 256K 토큰 컨텍스트에서 프리필(prefill) 성능은 43.16~44.36 토큰/초, 순수 CPU 디코딩은 9.06~10.74 토큰/초, Stockfish-PVS 추측 디코딩 적용 시 11.5~14.7 토큰/초를 달성한다. 전체 요약 13문장 읽기 → 011 21:11 당일 +120 안드로이드에서 작동하는 AI 에이전트 플랫폼 Operit 공개 Operit AI는 안드로이드용 오픈소스 AI 에이전트 플랫폼으로, 클라우드 모델과 로컬 모델을 지원하며 도구 호출·워크플로우·확장 기능(ToolPkg, MCP, Skills)을 통해 정보 검색·파일 처리·코드 개발·기기 자동화 같은 실제 작업을 수행한다. AI · 머신러닝 · AAswordman/Operit · Kotlin
Key Point 안드로이드 스마트폰이 개발 도구이자 AI 에이전트 플랫폼으로 동작하는 방식과 기술 스택을 이해할 필요가 있으며, 로컬·클라우드 모델 통합, 자동화, 개발 환경 구성 방식이 모바일 개발자와 AI 시스템 통합에 관심 있는 개발자에게 참고 기준이 된다.
핵심 요약
Operit AI는 안드로이드용 오픈소스 AI 에이전트 플랫폼으로, 클라우드 모델과 로컬 모델을 지원하며 도구 호출·워크플로우·확장 기능(ToolPkg, MCP, Skills)을 통해 정보 검색·파일 처리·코드 개발·기기 자동화 같은 실제 작업을 수행한다. 태스크 지향형 에이전트 작업 공간을 제공하며, 첨부 파일·작업 공간 컨텍스트·도구 실행 진행 상황·파일 변경 사항·다중 턴 작업을 지원한다. OpenAI·Anthropic·Gemini 등 여러 클라우드 모델을 연결할 수 있고, MNN 모델이나 llama.cpp를 통한 GGUF 모델로 로컬 추론을 실행하거나 Ollama·LM Studio 같은 로컬 모델 서비스와 연동할 수 있다. 전체 요약 13문장 읽기 → 012 21:12 당일 +211 Flutter로 만든 오프라인 LLM 클라이언트, 안드로이드에서 로컬 실행 지원 PrivateLM은 Flutter 기반의 크로스플랫폼 AI 채팅 클라이언트로, 안드로이드에서 GGUF 모델을 로컬로 다운로드해 GPU 가속(Vulkan)으로 인터넷 없이 실행할 수 있다. AI · 머신러닝 · orailnoor/cross-platform-llm-client · C++
Key Point 안드로이드 폰에서 인터넷 없이 LLM을 직접 실행하고, 필요시 클라우드 API로 전환하는 프로덕션급 오픈소스 앱으로, 프라이버시를 중시하는 개발자에게 실제 대안이 된다.
핵심 요약
PrivateLM은 Flutter 기반의 크로스플랫폼 AI 채팅 클라이언트로, 안드로이드에서 GGUF 모델을 로컬로 다운로드해 GPU 가속(Vulkan)으로 인터넷 없이 실행할 수 있다. 클라우드 API 모드에서는 OpenAI, Anthropic, Google Gemini, Kimi(Moonshot AI)로 자동 전환되며, 앱 내에서 두 방식을 원활하게 전환할 수 있다. 텍스트와 이미지를 함께 보낼 수 있는 멀티모달 채팅을 지원하며, Qwen2-VL 같은 로컬 모델과 클라우드 제공자 모두 비전 기능을 활용할 수 있다. 전체 요약 12문장 읽기 → 013 21:11 당일 +108 로컬 AI 스튜디오, 설치 없이 Windows·Linux·macOS에서 실행 Portable AI Studio는 인터넷 연결 없이 로컬에서 온전히 작동하는 데스크톱 AI 스튜디오로, Windows·Linux·macOS를 지원한다. AI · 머신러닝 · techjarves/Portable-Local-Studio · JavaScript
Key Point 로컬 AI의 네 가지 핵심 기능(이미지·채팅·음성 인식·음성 합성)을 한 애플리케이션에서 설치 과정 없이 바로 사용할 수 있게 하는 새로운 접근이며, 하드웨어별 자동 가속 감지로 개발자의 수동 설정 부담을 크게 줄인다.
핵심 요약
Portable AI Studio는 인터넷 연결 없이 로컬에서 온전히 작동하는 데스크톱 AI 스튜디오로, Windows·Linux·macOS를 지원한다. 이미지 생성(Stable Diffusion), LLM 채팅(llama.cpp), 음성 인식(Whisper), 음성 합성(Kokoro TTS) 네 가지 기능을 통합한다. Node.js 런타임과 GPU 백엔드가 자체 포함돼 있어 설치나 시스템 환경 설정이 불필요하며, 사용자는 배치 파일이나 쉘 스크립트를 실행하기만 하면 된다. 전체 요약 12문장 읽기 → 014 03:10 ▲ 145 · 댓글 93 가벼운 LLM 코딩 에이전트 'Prospero' 출시 개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. AI · 머신러닝 · Prospero: A new coding harness for a more civilized age
Key Point 로컬 LLM으로 자동화된 개발 작업이 가능한 실용적인 도구가 나왔으며, 기존 도구 대비 훨씬 가볍고 안정적으로 설계되어 에이전트 기반 개발 워크플로우를 본격적으로 실험할 수 있다.
핵심 요약
개발자가 로컬 LLM으로 프로그래밍 작업을 하도록 돕는 '코딩 하네스'를 직접 개발했다. 기존 도구들이 웹 스택 기반이라 수GB 메모리를 소비하는 문제를 해결하기 위해 C++와 Dear ImGui로 작성하여 기존 도구 대비 100배 적은 리소스를 사용한다. llama.cpp, OpenRouter, Anthropic API 등 외부 모델 제공자와 연동하며, 내장 모델 공급자는 없다. 전체 요약 13문장 읽기 → 015 21:11 당일 +148 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 016 18:11 ▲ 13 · 댓글 7 작은 오픈소스 모델, 실제 코딩 업무에 얼마나 써먹을까 벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. AI · 머신러닝 · Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
Key Point 오픈소스 코딩 모델의 실전 성능은 벤치마크와 크게 다르며, 직접 호출과 에이전트 위임 간 성공률 격차가 큼을 실측 데이터로 보여준다.
핵심 요약
벤치마크 점수가 높은 오픈 가중치 모델도 실제 코딩 작업에서는 텍스트 생성과 실행 가능한 코드 생성이 별개 문제임을 보여주는 경험 보고서다. 저자가 2026년 7월부터 10월까지 수행한 엔지니어링 작업을 기반으로, vLLM, SGLang, llama.cpp, MLX 등 여러 모델 서빙 환경에서 같은 엔드포인트로 표시되는 모델들도 도구 호출 형식, 턴 제어, 컨텍스트 동작, 캐시 재사용, 신뢰성 면에서 차이를 보임을 기록했다. 4,165개의 코딩 에이전트 게이트웨이 턴, 623개의 디버그 작업, 고정된 Claude Opus 5.5 부모 모델과 숨겨진 동작 검증을 포함한 3개 위임 연구가 증거다. 전체 요약 10문장 읽기 → 017 15:11 새 버전 Ollama 0.40.7 출시, 모델 전환 안정성 개선 Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. AI · 머신러닝 · ollama/ollama@v0.40.7
Key Point 로컬 LLM 실행 환경에서 모델 호환성과 안정성이 크게 개선되어, 여러 모델 간 전환이나 원격 실행 시 발생하던 문제들이 해결되었다.
핵심 요약
Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. OpenAI 호환 응답 대화에서 모델 간 전환 시(생각 기능 포함/미포함) 또는 다른 제공자의 압축 항목이 포함된 히스토리에서 실패하는 문제를 해결했다. 스트리밍 응답 요청에서 클라이언트 도구 호출(예: 웹 검색 기능의 Codex)이 추론 항목 이전에 발생하여 도구 호출 이벤트가 순서 뒤바뀌거나 중복되는 문제를 수정했다. 전체 요약 8문장 읽기 → 018 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 019 21:11 ▲ 13 · 댓글 4 임베딩 테이블을 16MB 고정 코드로 대체, 소형 모델 파일 1/7 축소 소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. AI · 머신러닝 · Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
Key Point 소형 모델 배포 시 파일 크기가 1/7로 축소되고 CPU 속도가 5~6배 빨라지므로, 엣지 디바이스와 저사양 환경에서의 모델 배포 방식을 바꿀 가능성이 있다.
핵심 요약
소형 언어 모델에서 임베딩 테이블은 전체 파라미터의 대부분을 차지하고, Gemma 3 270M 모델의 경우 268M 파라미터 중 168M이 임베딩 테이블이며, 양자화 후에도 16비트로 남아 파일 크기의 대부분을 차지한다. 연구팀은 학습 가능한 임베딩 테이블을 주성분 투영과 부호 이진화로 도출한 512비트 코드의 동결 테이블(16MB, 학습 가능 파라미터 없음)로 대체하고, 동일한 Gemma 형태의 모델을 2.05B 토큰으로 학습했다. 학습된 임베딩 테이블은 0.20 나츠 검증 손실을 위해 2.6배 많은 학습 가능 파라미터를 필요로 했으나, LAMBADA, HellaSwag, PIQA 벤치마크에서는 동결 테이블 모델이 동일하거나 더 나은 성능을 보였고 ARC-Easy에서만 학습된 테이블이 앞섰다. 전체 요약 6문장 읽기 → 020 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 021 06:11 ▲ 102 · 댓글 28 PS5에서 언어모델 서버 구축, 집 전체 기기에서 사용 PS5LM은 탈옥한 PS5의 GPU에서 llama.cpp를 실행하여 GGUF 형식 언어모델을 로드하고 네트워크 기기들에 서빙하는 어플리케이션이다. 하드웨어 · 시스템 · Llama.cpp on a jailbroken PS5: run any GGUF model natively on the console
Key Point 탈옥 PS5를 개인 서버로 변환하여 클라우드 없이 로컬에서 언어모델을 운영할 수 있으며, TV 기반 관리 인터페이스와 기존 AI 도구와의 호환성이 실용성을 높인다.
핵심 요약
PS5LM은 탈옥한 PS5의 GPU에서 llama.cpp를 실행하여 GGUF 형식 언어모델을 로드하고 네트워크 기기들에 서빙하는 어플리케이션이다. 콘솔의 RDNA 2 GPU와 11.4GB 공유 메모리를 활용하며, llama.cpp가 지원하는 모든 아키텍처와 양자화 기법을 사용할 수 있다. OpenAI의 /v1/chat/completions와 Anthropic의 /v1/messages API를 구현하여 기존 클라이언트(Claude Code 포함)와 호환되며, 브라우저 채팅 인터페이스도 제공한다. 전체 요약 12문장 읽기 → 022 15:11 ▲ 10 · 댓글 2 강화학습으로 추론을 최적화한 의사결정 AI 모델 공개 Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. AI · 머신러닝 · StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
Key Point 추론 비용을 크게 줄이면서도 정확도를 유지하는 강화학습 기법이 도입되어 실무 배포 시 비용 효율성이 개선된다.
핵심 요약
Hugging Face에서 0.8B부터 27B까지 매개변수 규모의 의사결정 모델 'StartLux-Decision'을 발표했다. Instant 모델은 양방향 주의 메커니즘으로 단일 패스 추론 속도를 유지하면서 정확도를 높이고, AutoThink 모델은 불확실한 결정에만 명시적 추론을 수행하고 확신 있는 경우는 직접 답한다. 3단계 훈련 파이프라인으로 공통 의사결정 능력을 먼저 확립한 뒤 두 모델 변형을 특화하고, 추론 지도학습과 강화학습으로 AutoThink에 추론 능력을 부여한다. 전체 요약 9문장 읽기 → 023 06:11 ▲ 443 · 댓글 269 메타, 816B 파라미터 오픈 모델 뮤즈 스파크 공개 메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. AI · 머신러닝 · Muse Spark Open
Key Point 오픈 웨이트 대형 모델을 처음으로 개인 데스크톱에서 네이티브로 실행할 수 있게 되면서, 클라우드 의존도를 줄이고 로컬에서 고급 AI 기능을 활용할 수 있는 새로운 가능성이 열렸다.
핵심 요약
메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. 모델은 총 816B 파라미터(활성 42B)를 가진 네이티브 멀티모달 모델로 1M 토큰 컨텍스트 윈도우를 지원한다. 처음으로 Apple M5 Ultra Mac Studio 2대에서 최신 MLX 프레임워크를 사용해 데스크톱에서 직접 실행 가능하다. 전체 요약 11문장 읽기 → 024 15:11 ▲ 150 · 댓글 37 경량 추론 모델 LFM2.5-24B-A2B 출시, 온디바이스 에이전트 최적화 Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. AI · 머신러닝 · LFM2.5-24B-A2B: Built for fast on-device agents
Key Point 온디바이스에서 도구 호출과 추론을 빠르게 처리해야 하는 개발자에게, 클라우드 API 의존 없이 로컬 에이전트를 구축할 수 있는 선택지를 제시한다.
핵심 요약
Liquid AI가 LFM2.5-24B-A2B를 공개했으며, 총 24B 파라미터 중 활성 파라미터는 2B만 사용하는 추론 특화 모델이다. 총 파라미터가 50% 이상 많은 Qwen3.6-35B-A3B와 비교해 에이전트·도구 사용 벤치마크 8개 중 5개에서 경쟁력을 보였다. AutomationBench에서 27.69점으로 다음 경쟁 모델 8.72점의 3배 이상 점수를 기록했고, LiveClaw에서 48.09점을 달성했다. 전체 요약 13문장 읽기 → 025 12:11 새 버전 Ollama 0.40.4, 터미널에서 의사결정 모델 직접 실행 Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. AI · 머신러닝 · ollama/ollama@v0.40.4
Key Point 로컬 AI 모델을 터미널에서 의사결정·분류 작업에 직접 활용할 수 있게 되어 개발자의 워크플로우가 단순화되고, Apple Silicon 최적화와 성능 개선으로 실 사용 환경이 개선된다.
핵심 요약
Ollama는 의사결정 모델(Decision Model)을 CLI에서 직접 실행할 수 있게 지원하며, 예/아니오 질문 답변, 텍스트 분류, 루브릭 채점 등을 수행할 수 있다. MLX 러너가 Apple Silicon에서 Kev 의사결정 모델을 지원하며, ollama launch는 유료 플랜 업그레이드 없이 사용 크레딧으로 실행 가능해졌다. Ollama launch codex는 로컬 설치된 Ollama 모델을 모델 피커에 포함하고 /model 명령으로 모델 전환을 지원한다. 전체 요약 7문장 읽기 → 026 18:11 ▲ 132 · 댓글 41 80GB 모델을 32GB 램에서 실행하는 Janas, llama.cpp보다 2배 이상 빠르다 Janas-LLM은 48GB의 Qwen3-Next-80B 모델을 32GB 램의 노트북에서 실행하는 도구로, 모델 가중치를 디스크에 유지하면서 필요한 전문가(expert) 블록만 NVMe SSD에서 스트리밍한다. AI · 머신러닝 · Janas: Run LLMs larger than RAM by streaming experts from SSD
Key Point 32GB 메모리 제약에서 48GB 모델을 실행하면서 llama.cpp보다 2배 이상 빠른 속도를 달성한 새로운 방식이 기존 로컬 LLM 실행 방식의 성능 한계를 크게 개선한다.
핵심 요약
Janas-LLM은 48GB의 Qwen3-Next-80B 모델을 32GB 램의 노트북에서 실행하는 도구로, 모델 가중치를 디스크에 유지하면서 필요한 전문가(expert) 블록만 NVMe SSD에서 스트리밍한다. 같은 테스트 환경(32GB 메모리, Intel Core Ultra 9 185H, Arc 통합 GPU)에서 llama.cpp와 비교한 결과 모든 모델에서 Janas가 더 빠르며, Qwen3-Next-80B의 프롬프트 읽기 속도는 62 tok/s 대 16 tok/s, 토큰 생성은 24 tok/s 대 2.8 tok/s로 우월했다. Qwen3.5-0.8B 같은 소형 모델은 프롬프트 읽기에서 939 tok/s, 토큰 생성 130 tok/s에 도달했으며, 드래프팅 기능(다음 토큰 예측과 검증)을 활용하면 생성 속도를 최대 2배까지 높일 수 있다. 전체 요약 11문장 읽기 → 027 21:11 당일 +134 마이크로소프트, 1비트 LLM 추론 프레임워크 공개 마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. AI · 머신러닝 · microsoft/BitNet · C++
Key Point CPU만으로 초대형 언어 모델을 실용적 속도로 실행할 수 있게 되면서, 엣지 디바이스와 로컬 환경에서의 LLM 배포 방식이 근본적으로 바뀔 수 있다.
핵심 요약
마이크로소프트가 1비트 LLM(BitNet b1.58)을 위한 공식 추론 프레임워크 bitnet.cpp를 출시했다. x86 CPU에서 2.37~6.17배 속도 향상, ARM CPU에서 1.37~5.07배 향상을 달성하며 에너지 소비는 x86에서 71.9~82.2%, ARM에서 55.4~70.0% 감소한다. 100B 파라미터의 BitNet b1.58 모델을 단일 CPU에서 초당 5~7 토큰 속도로 실행 가능하다. 전체 요약 11문장 읽기 → 028 21:11 당일 +114 텐센트, 33개 언어 지원하는 다중언어 번역 모델 공개 텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. AI · 머신러닝 · Tencent-Hunyuan/Hy-MT2 · Python
Key Point 번역 모델의 성능이 상용 API를 능가하는 수준에 도달했으며, 극저비트 양자화로 온디바이스 배포가 실질적으로 가능해졌다.
핵심 요약
텐센트가 Hy-MT2 시리즈 다중언어 번역 모델 3종(1.8B, 7B, 30B-A3B MoE)을 공개했으며, 33개 언어 간 번역과 다국어 명령어 이해를 지원한다. 1.8B 모델은 AngelSlim의 1.25비트 극저비트 양자화로 저장 크기를 440MB까지 줄이고 추론 속도를 1.5배 높였다. 평가 결과 7B와 30B-A3B 모델은 DeepSeek-V4-Pro, Kimi K2.6 같은 오픈소스 모델을 능가하며, 1.8B 모델도 마이크로소프트·더바오 등 상용 API를 전반적으로 능가한다. 전체 요약 9문장 읽기 → 029 06:11 ▲ 121 · 댓글 59 macOS 사진·영상을 AI로 검색하는 로컬 앱 SCM 공개 SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. AI · 머신러닝 · Show HN: AI search for every photo and every frame of video on macOS
Key Point AI 검색이 클라우드 없이 로컬에서만 작동하므로 개인 사진·영상의 프라이버시를 완전히 보호하면서도 의미 기반·음성·텍스트 검색을 한 번에 제공하는 방식이 다르다.
핵심 요약
SCM은 폴더의 모든 사진과 영상 프레임을 로컬 AI로 검색하는 macOS 앱으로, 클라우드 업로드 없이 기기에서만 처리된다. 자연언어로 기억을 설명하면 CLIP 등 로컬 비전 모델이 검색하고, 영상은 장면 단위로 분할·임베딩되어 정확한 타임코드로 이동할 수 있다. 5가지 검색 모드를 지원한다: 의미 기반 이미지 검색(Files), 영상의 특정 장면 검색(Scenes), 이미지의 OCR 텍스트 검색(OCR), Whisper를 이용한 영상 음성 검색(Dialogue), 추출된 대사·OCR·파일명을 근거로 답변하는 로컬 LLM 챗(Ask). 전체 요약 13문장 읽기 → 030 00:11 ▲ 166 · 댓글 69 125억 개 파라미터 모델을 RTX 4090으로 초당 100토큰 속도로 실행 Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. AI · 머신러닝 · Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s
Key Point 소비자용 그래픽카드만으로 클라우드 서버 수준의 대규모 언어모델을 로컬에서 무료로 실행 가능해졌기 때문에, 개인 개발자와 중소 회사의 AI 접근 장벽이 크게 낮아진다.
핵심 요약
Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. RTX 5070(12GB)과 Ryzen 5 7600 조합에서 Q2_0 압축 모델 기준으로 초당 94토큰의 답변 생성 속도(32KB 문서 읽기 초당 2,650토큰)를 달성한다. RTX 3090(24GB) 같은 더 많은 VRAM을 가진 카드는 초당 100~140토큰 속도까지 낼 수 있다. 전체 요약 12문장 읽기 → 031 21:11 당일 +211 DeepSeek와 GLM을 개인 하드웨어에서 돌리는 경량 추론 엔진 공개 Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. AI · 머신러닝 · antirez/ds4 · C
Key Point 개인 맥이나 워크스테이션에서 DeepSeek·GLM 같은 최신 고성능 모델을 실제로 돌릴 수 있는 구체적인 방법과 제약조건(메모리, SSD 스트리밍 필요 여부)이 명확해진다.
핵심 요약
Salvatore Sanfilippo가 만든 DwarfStar는 DeepSeek V4/V4.1 Flash, GLM 5.2/5.3, Qwen3.8 Flash 등 주요 오픈웨이트 모델을 개인 하드웨어에서 실행하는 네이티브 추론 엔진으로, Metal·CUDA·ROCm을 지원한다. 일반적인 GGUF 러너가 아니라 특정 모델 몇 개에 최적화된 자체 포함 C 코드이며, 프로젝트가 생산한 GGUF 파일만 사용한다. Metal은 애플 실리콘 맥(96GB 이상, 또는 SSD 스트리밍으로 더 작은 기계에서도 가능)을 주요 대상으로, CUDA는 DGX Spark와 Ada/L40S 카드를 포함한 다중 GPU 시스템을 지원하며, ROCm은 Strix Halo 같은 시스템을 대상으로 한다. 전체 요약 12문장 읽기 → 032 03:11 ▲ 101 · 댓글 19 Go 바이너리 하나로 로컬 LLM 구동하는 Janus 공개 Janus는 GGUF 모델을 GPU 또는 CPU에서 실행하는 단일 Go 바이너리로, Python·Docker·Ollama 없이도 작동한다. AI · 머신러닝 · Show HN: Janus – Go binary that runs GGUF models via Vulkan on AMD/Intel/Nvidia
Key Point 로컬 LLM 추론 환경에서 복잡한 의존성 없이 한 번에 실행 가능한 도구로, Ollama나 llama.cpp 대비 간단한 설정과 Go의 빌드 편의성을 제공한다.
핵심 요약
Janus는 GGUF 모델을 GPU 또는 CPU에서 실행하는 단일 Go 바이너리로, Python·Docker·Ollama 없이도 작동한다. Vulkan을 통해 AMD·Intel·NVIDIA GPU에서 추론을 수행하거나 CPU 폴백을 지원하며, OpenAI 호환 API(/v1/chat/completions, /v1/models)를 제공한다. 재시작 없이 GGUF 모델을 바꿀 수 있고, Cursor·Cline 같은 OpenAI 클라이언트와 연동되며, GGUF 메타데이터에서 자동으로 채팅 템플릿을 감지한다. 전체 요약 9문장 읽기 → 033 03:11 새 버전 Ollama v0.35.1 릴리스, 웹 검색 기능 강화 Ollama v0.35.1이 출시되었습니다. AI · 머신러닝 · ollama/ollama@v0.35.1
Key Point 로컬 LLM 도구인 Ollama의 웹 검색 능력이 10배 확대되어 더 최신 정보를 기반으로 답변할 수 있게 됩니다.
핵심 요약
Ollama v0.35.1이 출시되었습니다. 한 응답당 최대 10개의 웹 검색을 수행할 수 있는 기능이 추가되었습니다. MLX와 llama.cpp 라이브러리가 최신 버전으로 업데이트되었습니다. 전체 요약 5문장 읽기 → 034 09:11 ▲ 120 · 댓글 54 하드웨어별 자동 최적화하는 오픈소스 추론 엔진 Magnitude 출시 YC S25 배치 스타트업 Magnitude가 에이전트용 오픈소스 추론 엔진을 공개했다. AI · 머신러닝 · Launch HN: Magnitude (YC S25) – Self-optimizing inference engine for agents
Key Point 로컬 추론 성능을 llama.cpp 대비 최대 2배 개선하면서 기존 에이전트와의 호환성을 유지한다는 점에서 에이전트 개발자와 프라이빗 AI 추론 사용자에게 실질적인 성능 이득이 생긴다.
핵심 요약
YC S25 배치 스타트업 Magnitude가 에이전트용 오픈소스 추론 엔진을 공개했다. 기기별로 커널을 컴파일·튜닝해 오픈 모델을 llama.cpp보다 최대 2배 빠르게 실행한다(Metal에서 92% 더 빠름, CUDA에서 19% 더 빠름). macOS, Windows, Linux에서 Apple Silicon, NVIDIA, AMD GPU 또는 CPU만으로 작동한다. 전체 요약 11문장 읽기 → 035 06:11 ▲ 65 · 댓글 3 LLM 추론을 위한 '불일치 양자화', 프롬프트와 생성 단계별 최적화 프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. AI · 머신러닝 · Disaggregated Quantization: Specializing LLM Prefill and Decode
Key Point LLM 추론의 Prefill과 Decode 두 단계에 서로 다른 양자화 전략을 적용해 정확도 손실 없이 처리 속도(첫 토큰까지 1.78배 단축)와 메모리 효율을 동시에 개선하는 방법론이 공개됐다.
핵심 요약
프롬프트 처리(Prefill)와 응답 생성(Decode)은 서로 다른 양자화 방식을 요구한다: Prefill은 저정밀 계산으로 빠른 처리가 필요하고, Decode는 컴팩트한 가중치로 메모리 대역폭을 줄이는 것이 중요하다. 연구진은 '불일치 양자화'(Disaggregated Quantization, DQ)를 제안했으며, 이는 두 단계별로 계산 형식·가중치·저장소 배치를 특화시킨다. Qwen 3과 Gemma 3에서 Decode 단계의 활성화 양자화를 제거하면 생성 작업의 정확성이 향상되고 추론 비용은 증가하지 않는다. 전체 요약 8문장 읽기 → 036 00:11 ▲ 109 · 댓글 30 LLM의 토큰 확률 읽어 단일 함수로 선택지 점수 매기기 LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. AI · 머신러닝 · A single function Jev-like wrapper for LLMs, including vision models
Key Point LLM의 로그프로브를 활용해 단 한 줄의 함수로 복잡한 다중 선택 평가를 빠르게 구현할 수 있으며, 비전 모델도 지원해 실시간 이미지 분석 애플리케이션의 선택지 점수 매김에 즉시 적용 가능하다.
핵심 요약
LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. 상태와 질문을 프롬프트로 보내고 max_completion_tokens를 1로 설정한 후 top_logprobs로 대안 토큰들의 확률을 받으면, 여러 질문이 같은 상태 접두사를 공유할 때 KV 캐시를 활용할 수 있다. 이 방식은 텍스트뿐 아니라 비전 모델과도 작동하며, 이미지를 base64로 인코딩해 전송할 수 있도록 Jev 요청 형식에 attachments 필드를 추가했다. 전체 요약 7문장 읽기 → 037 22:29 새 버전 Ollama v0.34.4 출시, 성능 개선 및 버그 수정 Structured outputs이 싱글 패스로 적용돼 사고 모델에서 더 빠르고 안정적으로 동작한다. AI · 머신러닝 · ollama/ollama@v0.34.4
Key Point 로컬 LLM 실행 환경의 가장 대중적인 도구인 Ollama의 안정성과 성능이 개선되어, 특히 Apple Silicon 사용자의 추론 속도와 안정성이 크게 향상된다.
핵심 요약
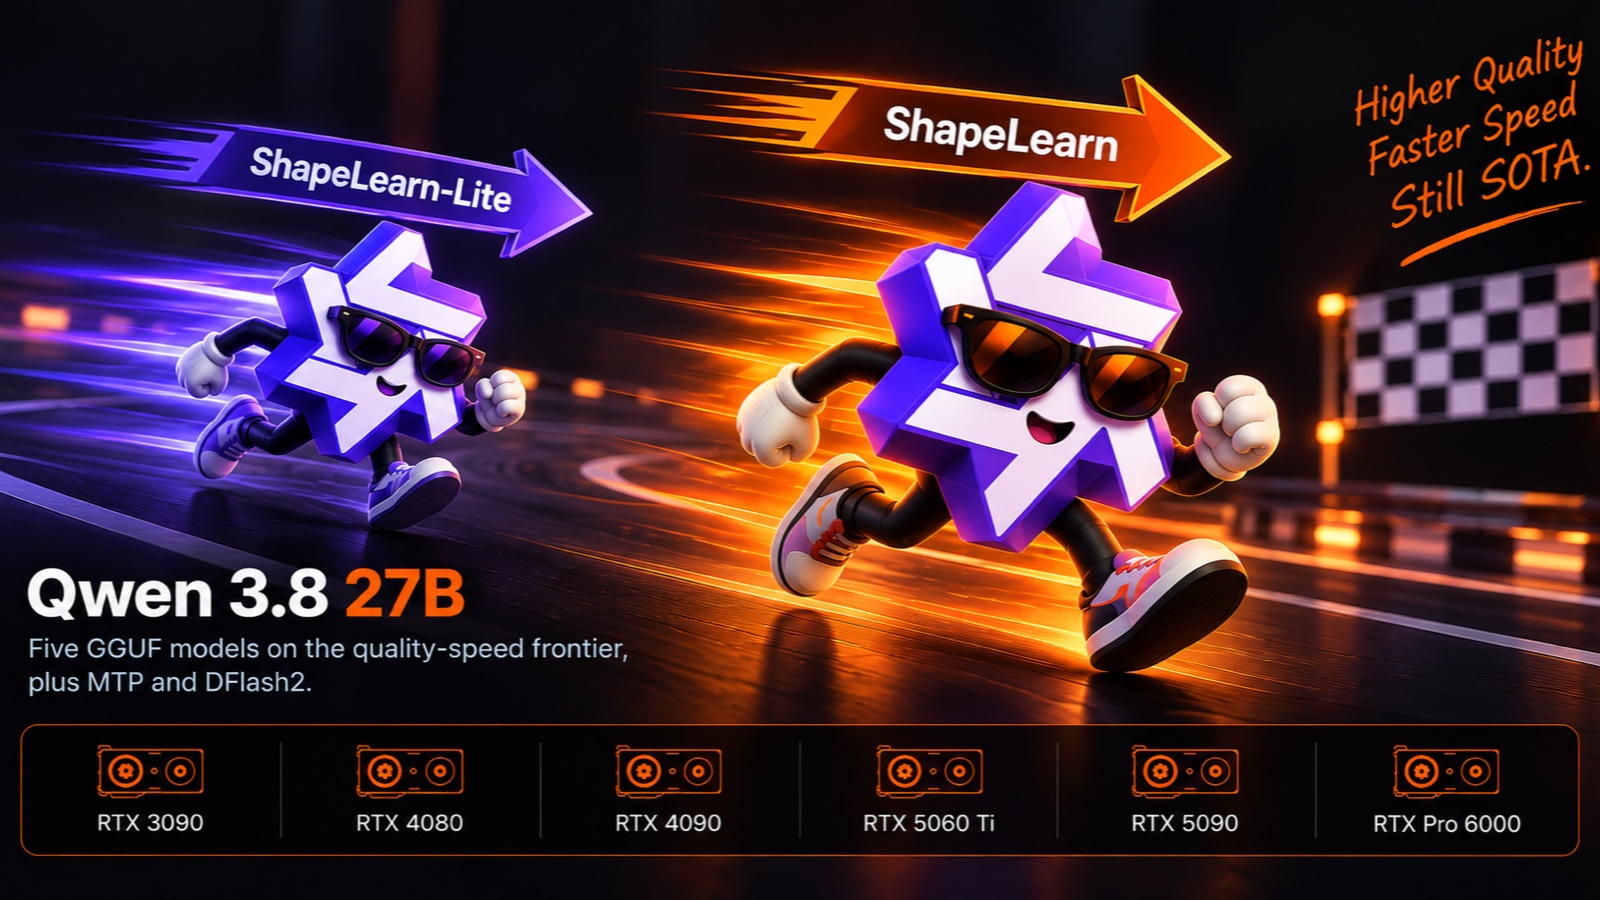
Structured outputs이 싱글 패스로 적용돼 사고 모델에서 더 빠르고 안정적으로 동작한다. 대규모 로컬 라이브러리에서 발생하던 간헐적인 '모델 미발견' 오류를 수정했다. macOS 앱이 ChatGPT나 Codex 실행 여부 확인 시 응답 없음 상태가 되는 문제를 해결했다. 전체 요약 6문장 읽기 → 038 21:10 ▲ 100 · 댓글 38 Qwen 3.8 27B 최적화 모델, 13.1GB VRAM에서 99.63% 성능 ByteShape가 Qwen 3.8 27B의 GGUF 양자화 모델 'ShapeLearn'을 공개했다. AI · 머신러닝 · Shapelearn Qwen 3.8 27B (13.1 GB VRAM)
Key Point 로컬에서 대규모 언어 모델을 최소 메모리로 효율적으로 운영하려는 개발자들에게 실질적인 선택지를 제시하는 벤치마크 기준을 제공한다.
핵심 요약
ByteShape가 Qwen 3.8 27B의 GGUF 양자화 모델 'ShapeLearn'을 공개했다. GPU-5(IQ4_XS, 3.84bpw)는 13.1GB VRAM에서 BF16 기준 99.63% 정확도를 유지하며 90.4 토큰/초의 속도를 낸다. 메모리가 제한적이면 GPU-4(IQ3_S, 11.0GB)를 추천하며, 이는 98.72% 성능을 내면서 더 빠르다. 전체 요약 5문장 읽기 → 039 11:10 당일 +141 Ollama, 오픈소스 LLM 로컬 실행 플랫폼 Ollama는 Kimi-K2.6, GLM-5.2, DeepSeek, Qwen, Gemma 등 다양한 오픈소스 모델을 로컬에서 실행할 수 있는 플랫폼이다. AI · 머신러닝 · ollama/ollama · Go
Key Point 개발 팀이 LLM을 클라우드 종속 없이 로컬에서 운영하고 싶을 때 실용적인 선택지가 필요하기 때문이다.
핵심 요약
Ollama는 Kimi-K2.6, GLM-5.2, DeepSeek, Qwen, Gemma 등 다양한 오픈소스 모델을 로컬에서 실행할 수 있는 플랫폼이다. macOS, Windows, Linux 데스크톱은 물론 Docker로도 제공되며, Python과 JavaScript 라이브러리를 통해 기존 애플리케이션에 통합할 수 있다. Claude Code, Codex, Copilot CLI 등 다양한 코딩 IDE와 통합 지원하고, OpenClaw를 통해 WhatsApp, Telegram, Slack, Discord 등 메신저 앱과 연동 가능하다. 전체 요약 5문장 읽기 → 040 11:10 당일 +306 로컬에서 빠르게 LLM 실행하는 llama.cpp, 고성능 추론 엔진 llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. AI · 머신러닝 · ggml-org/llama.cpp · C++
Key Point 하드웨어 요구사항이 낮으면서도 다양한 플랫폼을 지원해 개인 PC에서도 대형 언어모델을 효율적으로 운영할 수 있다는 점이 실무에서 중요해지고 있다.
핵심 요약
llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. Apple Silicon의 Metal, ARM NEON, x86의 AVX/AVX512, RISC-V의 RVV 등 각 플랫폼별 명령어세트를 지원해 효율성을 극대화했다. 1.5~8비트 정수 양자화를 통해 추론 속도를 높이고 메모리 사용량을 줄일 수 있으며, NVIDIA GPU(CUDA), AMD GPU(HIP), Intel NPU 등 14개 이상의 백엔드를 지원한다. 전체 요약 4문장 읽기 →