쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 3일 (화)까지 3800건
16건 · "부동소수점"조건 지우기 ×
001 06:11 ▲ 131 · 댓글 66 Jepsen이 ParticleDB 1.1.4를 분석, 96개 결함 발견 Orkes가 개발한 ParticleDB는 SQL, 키-밸류, 벡터 검색, 라이브 분석을 하나의 엔진에 통합한 데이터베이스로, Postgres와 Redis 프로토콜을 지원하며 Rust로 작성되었다. 인프라 · 데브옵스 · Jepsen: ParticleDB 1.1.4
Key Point ParticleDB가 Postgres 호환성을 표방하며 프로덕션 배포 중임에도 기본적인 트랜잭션 격리, 제약 조건 강제, WHERE 절 평가 같은 핵심 SQL 기능에서 광범위한 결함을 가지고 있어, 현재의 신뢰성 수준을 평가해야 한다.
핵심 요약
Orkes가 개발한 ParticleDB는 SQL, 키-밸류, 벡터 검색, 라이브 분석을 하나의 엔진에 통합한 데이터베이스로, Postgres와 Redis 프로토콜을 지원하며 Rust로 작성되었다. Jepsen은 ParticleDB 1.1.4~1.1.18.11.rc-22를 테스트하여 96개의 결함을 발견했으며, 공식 TLA+ 증명이 불가능하고 트랜잭션 격리 수준 설정이 제대로 작동하지 않음을 지적했다. 성능 문제로 table-2pl 모드에서 대부분의 트랜잭션이 10~30초 지연되었고, 신비한 충돌로 인해 수백~수천 초 후 오류 메시지 없이 죽었다. 전체 요약 8문장 읽기 → 002 18:11 ▲ 106 · 댓글 34 인텔 8087의 부동소수점 덧셈·뺄셈 마이크로코드 분석 1980년 인텔이 IBM PC 시스템의 부동소수점 연산을 약 100배 빠르게 만든 8087 칩을 출시했으며, 이 글은 칩을 직접 분해해 덧셈과 뺄셈 구현 방식을 설명한다. 하드웨어 · 시스템 · The Intel 8087 chip: floating-point addition and subtraction
Key Point 1980년대 칩 설계의 정수 가산기·비트 시프터 같은 전용 회로와 마이크로코드 최적화가 어떻게 부동소수점 연산 속도를 100배 향상시켰는지 보여주며, 현대 CPU의 부동소수점 처리 기초를 이해할 수 있다.
핵심 요약
1980년 인텔이 IBM PC 시스템의 부동소수점 연산을 약 100배 빠르게 만든 8087 칩을 출시했으며, 이 글은 칩을 직접 분해해 덧셈과 뺄셈 구현 방식을 설명한다. 8087은 부동소수점 수를 '부호 × 유효숫자 × 2^지수' 형태로 표현하며, 덧셈과 뺄셈을 위해 먼저 두 수의 소수점을 정렬한 후 정수 연산을 수행하고 결과를 정규화해야 한다. 칩 내부에는 80비트 임시 실수 형식(15비트 지수, 64비트 유효숫자)을 저장하는 8개의 스택 레지스터와, 덧셈·뺄셈·곱셈·나눗셈에 사용되는 69비트 정수 가산기, 임의 비트 수로 빠르게 시프트 가능한 비트 시프터, 선행 영 비트 카운팅 회로 등이 있다. 전체 요약 12문장 읽기 → 003 03:11 ▲ 120 · 댓글 22 역함수 없는 데이터에도 쓰는 슬라이딩 윈도우 집계 알고리즘 슬라이딩 윈도우에서 합계·최댓값 같은 집계를 유지하려면, 합계처럼 역함수가 있는 연산은 deque로 쉽게 구현할 수 있지만 최솟값·최댓값·분위수·근삿값 중복 제거 등 대부분의 실용적인 연산은 역함수가 없어 다른 방식이 필요하다. 오픈소스 · 도구 · Two-Stack Sliding-Window Aggregation
Key Point 역함수가 없는 최솟값·분위수·근삿값 중복 제거 같은 연산을 슬라이딩 윈도우에서 효율적으로 계산해야 하는 상황(실시간 모니터링, 시계열 데이터 분석)에서 amortized O(1) 시간에 구현하는 보편적인 알고리즘을 제시하기 때문입니다.
핵심 요약
슬라이딩 윈도우에서 합계·최댓값 같은 집계를 유지하려면, 합계처럼 역함수가 있는 연산은 deque로 쉽게 구현할 수 있지만 최솟값·최댓값·분위수·근삿값 중복 제거 등 대부분의 실용적인 연산은 역함수가 없어 다른 방식이 필요하다. 두 개의 스택과 하나의 집계값을 이용한 '투 스택' 알고리즘은 2001년의 FIFO 큐 구현 논문에서 영감을 받았으며, 이후 Tangwongsan et al.의 2011년 논문에서 더 일반화되었고, 이론적으로는 수십 년 전부터 알려진 간단하지만 강력한 기법이다. 알고리즘은 values(현재 스택)와 cum_aggs(이전 원소들의 누적 집계 역순)라는 두 스택을 유지하며, 새 값은 values에 추가하고, pop할 때 values가 비면 그 원소들의 누적 집계를 계산해 cum_aggs에 쌓는다. 전체 요약 7문장 읽기 → 004 00:11 새 버전 FastAPI 0.143.3, JSONL과 SSE 스트림 부동소수점 직렬화 수정 FastAPI 0.143.3이 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.143.3
Key Point 스트리밍 응답이나 고급 데이터 직렬화를 다루는 FastAPI 사용자는 부동소수점 에러로 인한 예외 상황을 해결할 수 있다.
핵심 요약
FastAPI 0.143.3이 릴리스되었다. JSONL과 SSE 스트림에서 무한대(Infinity)나 NaN 같은 비한정(non-finite) 부동소수점 값의 직렬화 문제를 수정했다. 마크다운 문서의 Python 형식을 Ruff로 업데이트했다. 005 00:11 ▲ 119 · 댓글 85 표준 C는 존재하지 않는다 GCC와 Clang은 표준 C와 실제 동작이 다른 여러 비표준 확장을 기본으로 지원하며, 실무에서 쓰이는 C는 표준 명세와 멀어지고 있다. 기타 · Your C is not standard C
Key Point 업계 표준인 GCC/Clang이 C 표준을 준수하지 않으면서, 실무 개발자들은 부지불식간에 비표준 코드를 작성하고 있기 때문이다.
핵심 요약
GCC와 Clang은 표준 C와 실제 동작이 다른 여러 비표준 확장을 기본으로 지원하며, 실무에서 쓰이는 C는 표준 명세와 멀어지고 있다. asm 키워드를 표준 C에서는 예약어로 취급하지 않아 유효한 식별자로 쓸 수 있지만, GCC와 Clang은 기본적으로 이를 확장 키워드로 인식한다. 표준은 FLT_ROUNDS 매크로가 실행 중에 fesetround() 함수로 변경된 부동소수점 반올림 모드를 반영해야 한다고 명시하지만, GCC는 항상 1(nearest)로 고정값을 제공한다. 전체 요약 7문장 읽기 → 006 12:11 ▲ 133 · 댓글 13 인텔 매뉴얼에만 있는 유령 명령어 vfmaddrnd231pd vfmaddrnd231pd는 FMA 명령어 세트에 속한 것으로 문서화된 x86 부동소수점 명령어로, 명령어별로 반올림 모드를 제어할 수 있다는 점이 일반적인 전역 반올림 모드와 다르다. 하드웨어 · 시스템 · Who is vfmaddrnd231pd?
Key Point 인텔 매뉴얼에 실존하는 명령어로 기록되어 있지만 실제 CPU에서는 작동하지 않고 도구도 지원하지 않는 미스터리 상황을 통해 소프트웨어 문서화의 허점을 드러낸다.
핵심 요약
vfmaddrnd231pd는 FMA 명령어 세트에 속한 것으로 문서화된 x86 부동소수점 명령어로, 명령어별로 반올림 모드를 제어할 수 있다는 점이 일반적인 전역 반올림 모드와 다르다. 이 명령어는 FMA로 더하기·뺄셈·곱셈을 에뮬레이트할 수 있어, AVX-512 없이도 제어 가능한 반올림을 구현해 반올림에 의존하는 알고리즘의 성능을 크게 높일 수 있어야 한다. 그러나 GNU 어셈블러가 이 명령어를 인식하지 못하고, Intel C/C++ 컴파일러 인트린식 _mm_fmaddround_pd와 _mm256_fmaddround_pd가 Clang과 ICC 모두에서 빠져 있다. 전체 요약 7문장 읽기 → 007 00:11 ▲ 139 · 댓글 70 PS2 게임을 웹어셈블리로 정적 재컴파일해 브라우저에서 실행 PS2 게임의 Emotion Engine 기계 코드를 미리 C++로 번역하고 WebAssembly로 컴파일해, PS2 OS와 하드웨어를 재구현한 코드와 링크해 브라우저에서 에뮬레이터 없이 실행한다. 웹 · 프론트엔드 · Show HN: PS2 games statically recompiled to WebAssembly
Key Point 에뮬레이터 없이 PS2 게임을 웹브라우저에서 원본 해상도의 2~3배로, 정상적인 속도(50~60fps)로 실행하는 기술이 실현되었으며, 기계 코드 정적 재컴파일이라는 접근법이 성능과 정확도를 동시에 달성했다.
핵심 요약
PS2 게임의 Emotion Engine 기계 코드를 미리 C++로 번역하고 WebAssembly로 컴파일해, PS2 OS와 하드웨어를 재구현한 코드와 링크해 브라우저에서 에뮬레이터 없이 실행한다. 첫 타이틀인 Gran Turismo 4는 벡터 유닛과 정확한 부동소수점 처리, 팔레트 트릭 등 PS2의 까다로운 기능을 활용하며, 50fps로 풀속도로 재생되고 브라우저 메모리 카드에 저장된다. God of War II는 같은 스크립트로 포팅되었고, 재컴파일러와 벡터 유닛 타이밍의 버그, 입출력 프로세서의 누락된 기능들을 발견해 수정했으며, 60fps의 전투 성능을 낸다. 전체 요약 14문장 읽기 → 008 06:11 ▲ 107 · 댓글 23 TLA+로 검증할 수 있는 것과 없는 것 AI 안전을 TLA+ 형식검증으로 완전히 해결할 수 있다는 기대가 커지고 있지만, 실제 한계가 크다. AI · 머신러닝 · What TLA+ can and can't check
Key Point TLA+로 AI 시스템 검증을 완벽히 해결할 수 있다는 기대가 커지고 있는데, 형식화 불가능한 성질, 다중 단계 속성, 행동 수열 비교 같은 근본적 한계를 알아야 현실적 기대를 조정할 수 있다.
핵심 요약
AI 안전을 TLA+ 형식검증으로 완전히 해결할 수 있다는 기대가 커지고 있지만, 실제 한계가 크다. TLA+는 시스템을 상태 수열로 나누고, 각 상태에서 불린 식을 표현하며 항상(always), 다음(prime), 결국(eventually) 같은 시간논리 연산자로 성질을 정의한다. 불변식(invariants)과 안전 성질(safety properties)은 TLA+의 가장 기본적인 검증 대상이며, 생생성 성질(liveness properties)은 좋은 일이 언젠가 일어남을 보장한다. 전체 요약 11문장 읽기 → 009 00:11 ▲ 128 · 댓글 64 Neural Amp Modeler 돌리는 오픈소스 기타 이펙터 페달 Waveshare ESP32-S3-Touch-AMOLED-2.06 보드 위에 구축한 스탠드얼론 기타 앰프이자 이펙터 페달 CoyoPedal을 공개했다. 하드웨어 · 시스템 · Guitar amp and effects pedal built on the Waveshare ESP32-S3-Touch-AMOLED-2.06
Key Point ESP32 임베디드 기기에서 Neural Amp Modeler 같은 복잡한 ML 모델을 실시간 처리하고 웹에서도 재현하는 기술 구현이 핵심인데, 풀스택 오픈소스 프로젝트의 완성도와 확장 가능성을 보여주는 사례다.
핵심 요약
Waveshare ESP32-S3-Touch-AMOLED-2.06 보드 위에 구축한 스탠드얼론 기타 앰프이자 이펙터 페달 CoyoPedal을 공개했다. ESP32-S3에서 Neural Amp Modeler A2 캡처를 실시간 처리하고, USB 호스트로 클래스 준수 오디오 인터페이스를 구동하며, TSX로 작성하고 C++로 컴파일한 터치스크린 UI를 갖춘다. 동일 펌웨어가 화면이 없는 bare ESP32-S3에서도 구동되며, BOOT 버튼이 풋스위치로 작동한다. 전체 요약 15문장 읽기 → 010 12:11 ▲ 102 · 댓글 21 2026년 러스트 SIMD 생태계 완전 가이드 SIMD는 단일 명령으로 여러 데이터를 처리하는 기술로, 최신 x86 CPU는 512비트 벡터에서 f64 연산 시 이론상 8배, u8 연산 시 64배 성능향상을 제공한다. 웹 · 프론트엔드 · The state of SIMD in Rust in 2026
Key Point x86/ARM/WebAssembly의 SIMD 확장 명령어가 다르고 호환성 문제가 크며, 러스트 생태계의 5가지 주요 SIMD 라이브러리(std::simd, fearless_simd, wide, pulp, macerator)가 각각 다른 장단점을 제공하므로 용도에 맞는 선택이 중요하다.
핵심 요약
SIMD는 단일 명령으로 여러 데이터를 처리하는 기술로, 최신 x86 CPU는 512비트 벡터에서 f64 연산 시 이론상 8배, u8 연산 시 64배 성능향상을 제공한다. x86은 SSE2, SSE4.x, AVX, AVX2, AVX-512 등 여러 SIMD 확장명령어가 있어 CPU 호환성 문제가 발생하며, ARM은 NEON을 64비트에 필수화했고 WebAssembly는 128비트 확장을 제공한다. x86 바이너리 호환성을 위해 함수 멀티버전화(서로 다른 CPU 기능별로 같은 함수를 여러 번 컴파일)가 필요하며, ARM과 WebAssembly는 이 문제가 없다. 전체 요약 14문장 읽기 → 011 03:11 ▲ 106 · 댓글 11 Intel 8087의 탄젠트 계산, CORDIC과 다항식의 결합 1980년 Intel 8087 칩의 탄젠트 명령어(FPTAN) 알고리즘을 역공학으로 분석한 글로, 8086 대비 90마이크로초 vs 13,000마이크로초의 극적인 성능 향상을 달성한 메커니즘을 설명한다. 하드웨어 · 시스템 · Reverse-engineering the Intel 8087's tangent algorithm: more than CORDIC
Key Point 정수 시대 최고 성능의 부동소수점 칩이 어떻게 극복할 수 없어 보이던 성능 한계를 넘었는지 하드웨어 레벨에서 역공학한 분석으로, 현대 칩 설계가 해결하는 문제들의 근원을 보여준다.
핵심 요약
1980년 Intel 8087 칩의 탄젠트 명령어(FPTAN) 알고리즘을 역공학으로 분석한 글로, 8086 대비 90마이크로초 vs 13,000마이크로초의 극적인 성능 향상을 달성한 메커니즘을 설명한다. 8087은 CORDIC(좌표 회전 디지털 컴퓨터) 알고리즘과 Padé 근사 다항식을 결합했으며, 이는 1950년대 B-58 Hustler 폭격기 항법 컴퓨터를 위해 개발된 CORDIC을 16비트 정확도까지만 적용하고 나머지 각도는 다항식으로 처리하는 방식이다. CORDIC은 삼각함수를 특수 각도(arctan(2^-n))의 조합으로 분해한 뒤 회전 행렬을 적용하는데, 시프트와 덧셈만으로 계산할 수 있어 하드웨어 친화적이며 각 반복마다 1비트의 정확도를 얻는다. 전체 요약 12문장 읽기 → 012 03:10 ▲ 100 · 댓글 33 1995년 16비트 게임 Stars! 64비트 환경에서 즐기는 법 1995년 출시된 16비트 Windows 3.1 게임 Stars! 4X를 현대 64비트 윈도우에서 실행하기 위해 커스텀 80286 에뮬레이터와 Win16-Win32 브릿지를 탑재한 Stars!VM을 개발했다. 오픈소스 · 도구 · A custom virtual machine for the Stars 4X game
Key Point 현대 OS에서 실행 불가능한 레트로 게임을 실행 가능하게 하는 에뮬레이션 기술의 실제 구현 사례로, 레지스터 수준의 정밀성 유지, AI 통합, 성능 최적화 기법을 보여준다.
핵심 요약
1995년 출시된 16비트 Windows 3.1 게임 Stars! 4X를 현대 64비트 윈도우에서 실행하기 위해 커스텀 80286 에뮬레이터와 Win16-Win32 브릿지를 탑재한 Stars!VM을 개발했다. 정식 게임 파일을 압축해 EXE에 내장했으므로 다운로드나 추가 설정 없이 즉시 실행할 수 있으며, 원본처럼 보이지만 현대적 파일 선택기와 4K 스케일링이 지원된다. 에뮬레이터는 x87 부동소수점 연산을 호스트 하드웨어에서 직접 수행하고, AI 에이전트가 게임 UI를 조작할 수 있도록 Model Context Protocol(MCP) 인터페이스를 제공한다. 전체 요약 6문장 읽기 → 013 09:10 ▲ 102 · 댓글 18 Voronoi 셰이더 크로스 플랫폼 버그, 부동소수점 연산이 범인 음악 영상 배경용 Voronoi 다이어그램 셰이더를 구현했으나, RTX 4070 윈도우 PC에서만 애니메이션에 끊김 현상이 발생했다. 하드웨어 · 시스템 · When the fractional part of a float fixes your shader
Key Point GPU 모델별로 다른 부동소수점 연산 결과가 셰이더 컴파일을 타게 되면서 발생하는 크로스 플랫폼 버그의 사례를 보여주며, 그래픽 프로그래머가 겪을 수 있는 재현 어려운 문제의 디버깅 방법을 제시한다.
핵심 요약
음악 영상 배경용 Voronoi 다이어그램 셰이더를 구현했으나, RTX 4070 윈도우 PC에서만 애니메이션에 끊김 현상이 발생했다. 노이즈 함수가 호출되는 부분에서 문제가 발생했으며, 인텔 통합 GPU와 RTX 2070에서는 정상 작동했으나 RTX 4070에서만 버그가 나타났다. 원인은 셰이더 컴파일 과정에서 노이즈 함수 입력값의 부동소수점 연산 결과가 기기별로 다르게 최적화되면서 발생한 수치 오류로 추정된다. 전체 요약 4문장 읽기 → 014 18:10 ▲ 123 · 댓글 31 90년대 3D 그래픽 칩을 FPGA로 재현하다 작성자가 FPGA에서 1990년대 3dfx Voodoo Graphics를 SystemVerilog로 구현한 zSST를 개발했다. 하드웨어 · 시스템 · Recreating Voodoo Graphics and a Late-1990s Gaming PC on an FPGA
Key Point PC 게이밍 역사의 분기점이던 Voodoo 칩의 내부 구조를 재구현한 기술적 성과로, 하드웨어 아키텍처와 고정 파이프라인 설계의 실제 작동 원리를 보여주는 사례다.
핵심 요약
작성자가 FPGA에서 1990년대 3dfx Voodoo Graphics를 SystemVerilog로 구현한 zSST를 개발했다. z486 CPU와 함께 Xilinx KV260 보드에서 DOS PC 환경을 완성해 Tomb Raider를 원본 3dfx 렌더러로 구동한다. zSST는 텍스처 필터링, 미맵, 깊이/알파 테스트, 안개, 블렌딩, 디더링 등 Voodoo의 주요 기능을 지원한다. 전체 요약 6문장 읽기 → 015 15:10 ▲ 100 · 댓글 32 1980년대 Intel 8087 칩의 마이크로코드 역공학 프로젝트 Intel 8087 부동소수점 코프로세서는 1980년 출시되어 현대 컴퓨터의 부동소수점 표준이 되었으며, IBM PC에 설치되어 연산 속도를 최대 100배 향상시켰다. 하드웨어 · 시스템 · Microcode in Intel's 8087 floating-point chip: the scale instruction
Key Point 부동소수점 연산의 표준이 된 40년 전 칩의 내부 회로를 물리적으로 역공학하는 과정이 기술사와 아키텍처 이해에 어떻게 기여하는지 보여준다.
핵심 요약
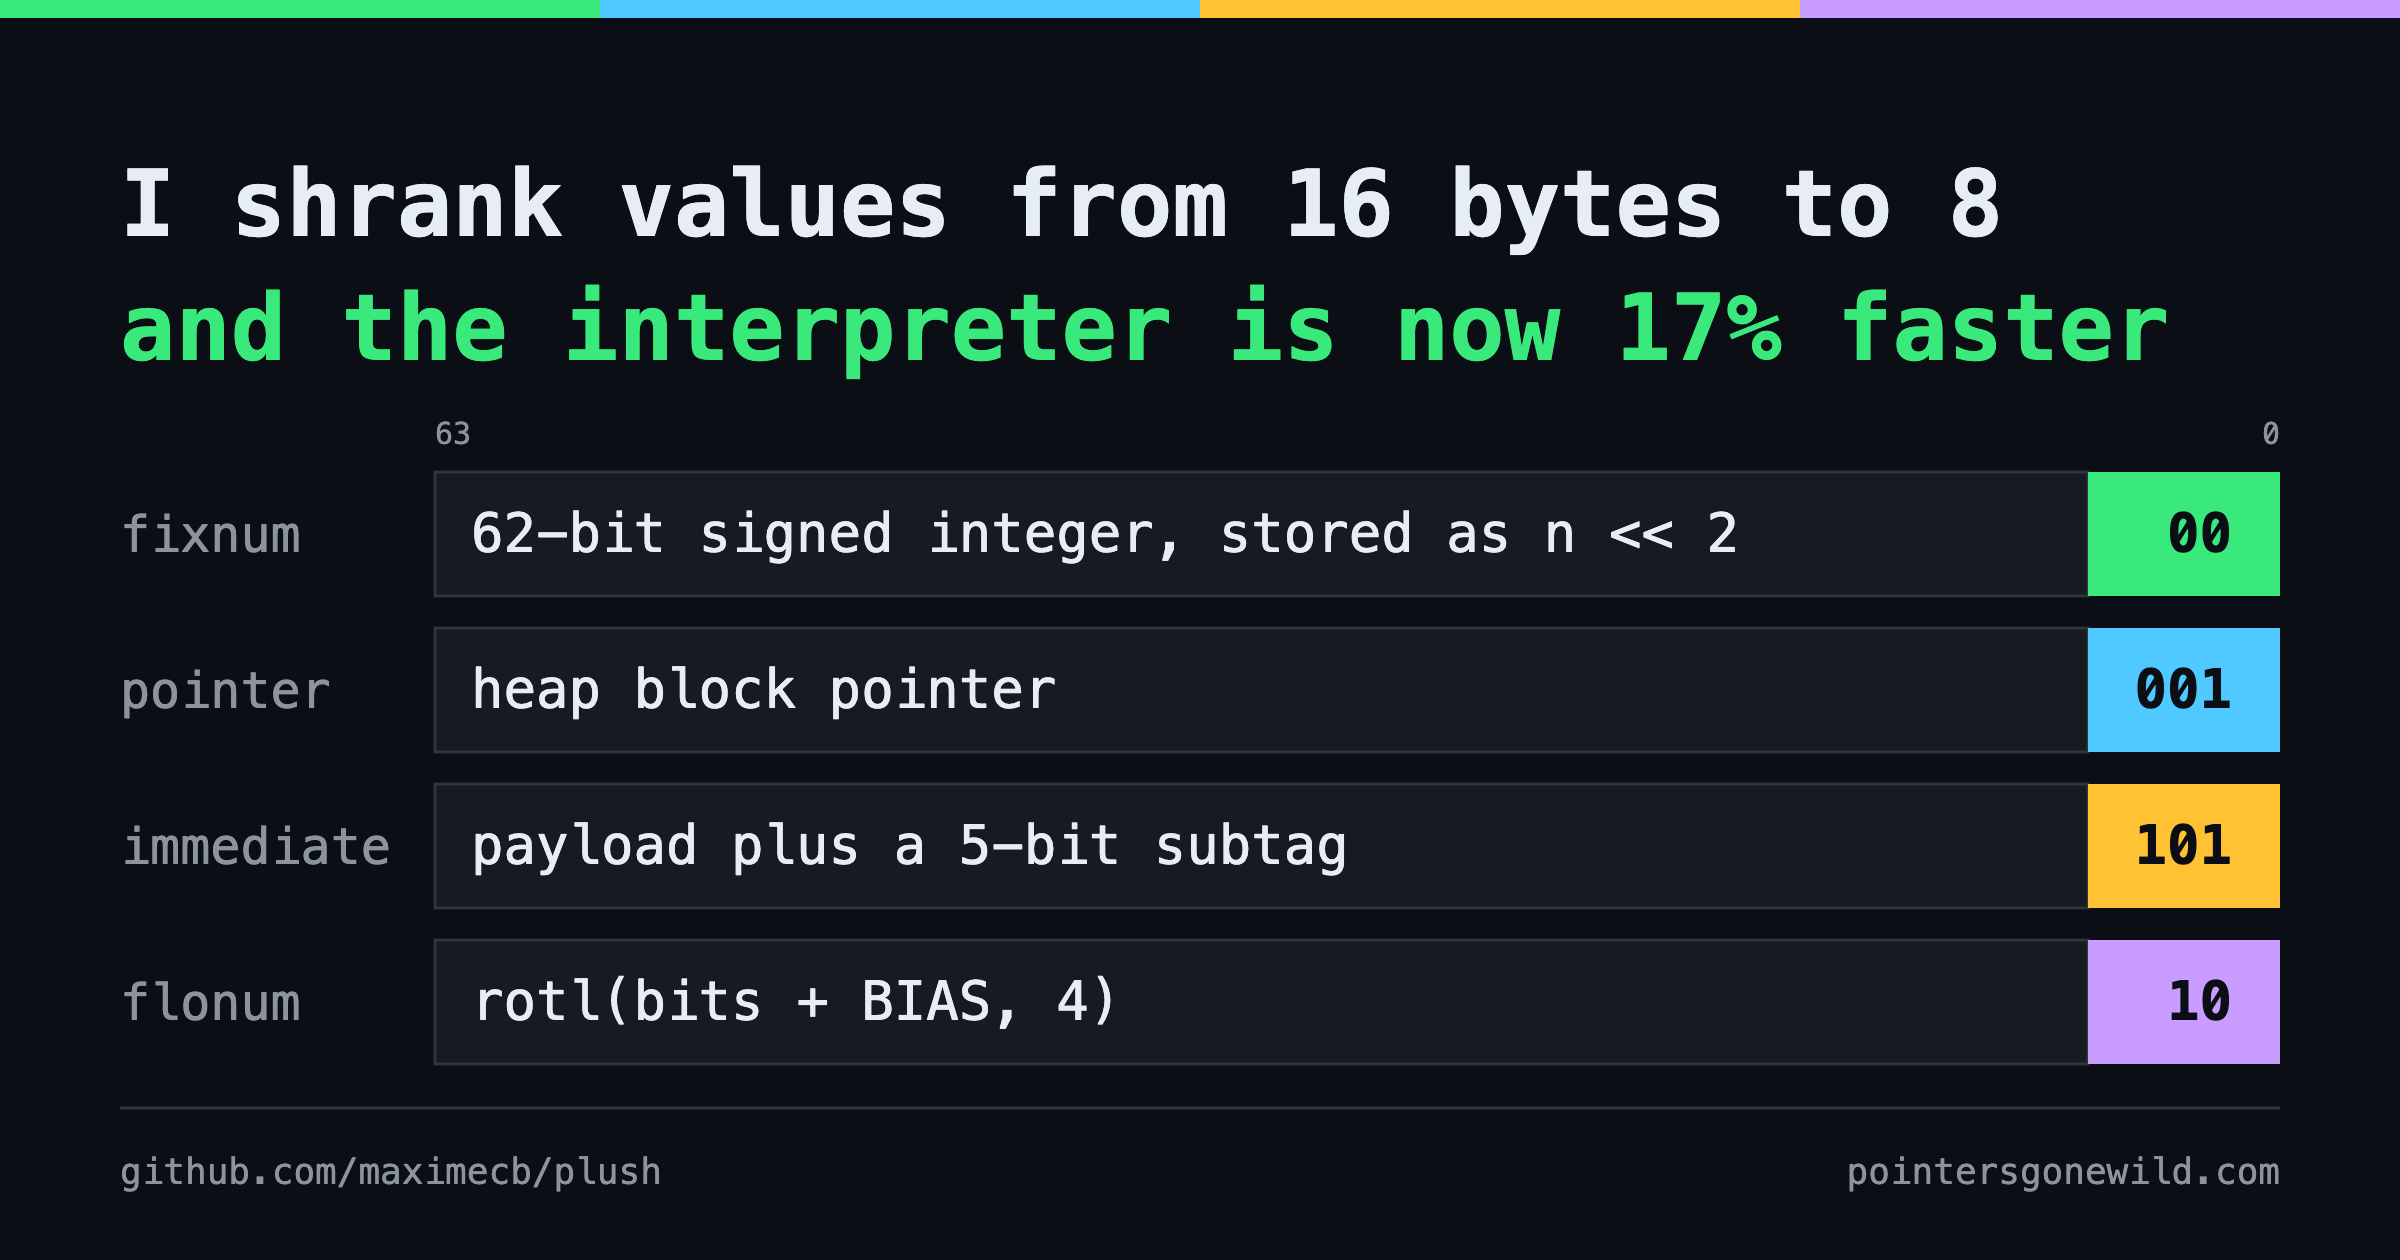
Intel 8087 부동소수점 코프로세서는 1980년 출시되어 현대 컴퓨터의 부동소수점 표준이 되었으며, IBM PC에 설치되어 연산 속도를 최대 100배 향상시켰다. Opcode Collective는 8087의 마이크로코드를 역공학하고 있으며, FSCALE(부동소수점 스케일) 명령어를 분석했다. FSCALE은 2의 거듭제곱으로 숫자를 스케일링하는 명령어이며, 곱셈보다 훨씬 빠르게 동작한다. 전체 요약 6문장 읽기 → 016 15:10 ▲ 116 · 댓글 44 Rust 동적 언어 인터프리터, 64비트 값 표현으로 17% 성능 향상 Plush 언어 인터프리터의 Value 타입을 Rust 태그 열거형(16바이트)에서 64비트 단일 워드로 변경했다. 인프라 · 데브옵스 · Replacing a Rust Enum with a 64-Bit Word Made My Interpreter 17% Faster
Key Point 메모리 구조 최적화만으로 메모리 낭비를 50% 줄이면서 오히려 성능을 높인 저수준 인터프리터 튜닝 기법이 실제로 작동하는 방식을 보여준다.
핵심 요약
Plush 언어 인터프리터의 Value 타입을 Rust 태그 열거형(16바이트)에서 64비트 단일 워드로 변경했다. 메모리 정렬로 인한 낭비를 제거하고 저비트 태깅 기법을 사용해 각 값을 64비트 이내로 압축했다. 힙 객체 주소는 8바이트 정렬되어 최하위 3비트가 항상 0이고, 정수는 최하위 2비트를 차용해 태그를 내장했다. 전체 요약 6문장 읽기 →