쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 1일 (일)까지 3728건
100건 (최대치) · "한계"조건 지우기 ×
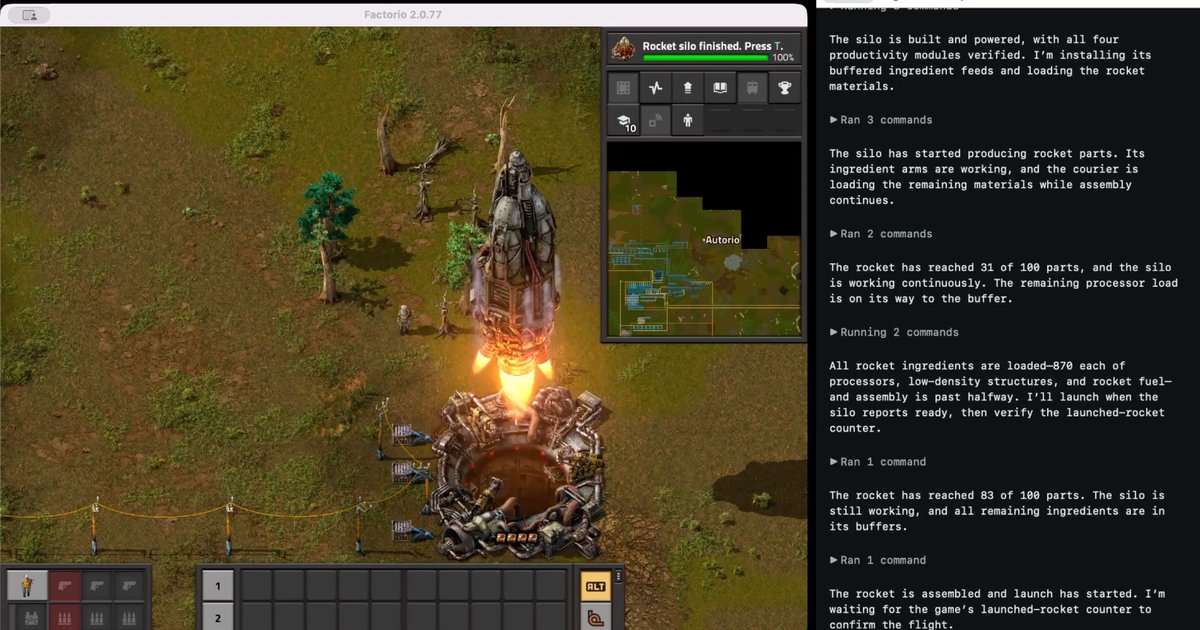
001 06:11 ▲ 109 · 댓글 108 GPT-4o가 팩토리오 평화모드 클리어 저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. AI · 머신러닝 · GPT-5.6 Sol can beat Factorio on peaceful mode
Key Point 최신 LLM이 복잡한 실시간 전략 게임을 자율적으로 플레이하고 완주한 첫 사례로, 모델의 실제 문제 해결 능력과 한계를 구체적으로 보여주는 벤치마크입니다.
핵심 요약
저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. 게임 매니저를 통해 모델이 Python 라이브러리를 사용해 프로그래밍 방식으로 게임을 플레이했으며, GUI 사용자와 동일한 제약(플레이어 도달 거리, 안개 기능)을 적용했다. 모델은 일부 영역에서는 기대를 초과했으나 명확한 약점도 보였고, 전체 런이 기록되어 해설 영상 제작 중이다. 전체 요약 8문장 읽기 → 002 00:11 ▲ 10 · 댓글 2 AI 이미지 편집 에이전트, 다중 도구와 검증으로 성능 40% 향상 기존 에이전트형 이미지 편집 시스템은 복잡한 작업을 단계별로 분해하지만, 단계가 실패하면 제한된 도구로 재시도하고 수동 평가에만 의존한다. AI · 머신러닝 · EditAgent: Rethinking Agentic Image Editing
Key Point 에이전트형 이미지 생성 도구의 근본적인 한계를 지적하고, 일반 LLM 모델로도 효과적인 개선이 가능함을 보여주기 때문이다.
핵심 요약
기존 에이전트형 이미지 편집 시스템은 복잡한 작업을 단계별로 분해하지만, 단계가 실패하면 제한된 도구로 재시도하고 수동 평가에만 의존한다. 이들 에이전트는 실행 가능한 작업의 범위와 판단자가 감지할 수 있는 정보의 범위라는 두 가지 제약에 묶여 있다. 기존 범용 이미지 편집기는 전문가 주석이 달린 벤치마크에서 40% 이상의 경우 사용 가능한 결과를 내지 못했고, 편집 유형에 따라 신뢰할 만한 판단자도 없었다. 전체 요약 7문장 읽기 → 003 12:11 ▲ 10 · 댓글 4 영상 이해 AI, 불확실할 땐 질문하게 하기 멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. AI · 머신러닝 · AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
Key Point 스트리밍 비디오 분석 AI가 정보 부족 상황을 인식하고 능동적으로 질문하도록 훈련할 수 있는지가 새로운 기술 과제가 되고 있기 때문입니다.
핵심 요약
멀티모달 대형언어모델의 발전으로 영상 이해 상호작용 방식이 오프라인에서 스트리밍, 주도적 상호작용으로 진화했고, 모델이 능동적으로 답할지 말지 결정하는 단계에 이르렀다. 기존 주도적 상호작용 방식은 답변에 필요한 정보가 완전하다고 가정해 모델이 대기하거나 답하기만 하도록 설계됐으나, 실제로는 영상이나 사용자 질문의 불확실성으로 정보가 불완전한 경우가 많다. 불완전한 정보 상황에서 기존 방식은 모델이 영원히 대기하거나 환각적 응답을 생성하는 문제를 야기한다. 전체 요약 8문장 읽기 → 004 06:11 ▲ 116 · 댓글 10 LLM의 '잠자기' 단계로 지속학습과 기억력 문제 해결 구글 연구팀이 대형언어모델(LLM)의 지속학습을 위해 '수면 프레임워크'를 제안했다. AI · 머신러닝 · Sleep framework: A new way for LLMs to retain knowledge in continual learning
Key Point LLM이 새로운 정보를 학습하면서 기존 지식을 잃지 않고 맥락도 10배 이상 확장하는 핵심 기술이 어떻게 작동하는지 이해할 수 있고, 산업 배포된 모델의 적응력 문제를 근본적으로 해결하는 가능성을 보여준다.
핵심 요약
구글 연구팀이 대형언어모델(LLM)의 지속학습을 위해 '수면 프레임워크'를 제안했다. 기존 LLM은 배포 후 고정된 학습 시점을 유지하거나, 문맥 윈도우 내에서만 정보를 보유하는 한계가 있고, 새로운 데이터로 업데이트하면 이전 학습 내용을 잊는 '재앙적 망각(catastrophic forgetting)' 문제가 발생한다. 수면 프레임워크는 활동(깨어있는) 단계와 오프라인 메모리 통합(수면) 단계를 번갈아가며 작동한다. 전체 요약 13문장 읽기 → 005 06:11 ▲ 173 · 댓글 60 개방형 프로토콜 위에서 구축한 분산 코드 저장소 Tangled GitHub 같은 중앙화된 저장소의 한계를 넘기 위해 Tangled는 AT Protocol 기반의 완전히 분산된 코드 저장소를 제시한다. 기타 · The federated code forge
Key Point 중앙화된 Git 저장소의 의존성과 검열 우려를 해결할 수 있는 진정한 분산 저장소 개념이 실현되었으며, 개발자가 자신의 인프라를 소유하면서도 협업 도구의 편의성을 모두 누릴 수 있게 된다.
핵심 요약
GitHub 같은 중앙화된 저장소의 한계를 넘기 위해 Tangled는 AT Protocol 기반의 완전히 분산된 코드 저장소를 제시한다. 사용자는 자신의 서버에서 Git 호스팅, CI 런너, API 서버와 UI 중 일부 또는 전부를 자유롭게 호스팅할 수 있으면서도 다른 사용자와 원활하게 협업할 수 있다. Tangled는 Git 기반의 개방 프로토콜과 이메일의 장수명성에 모던 저장소의 사용 편의성을 결합하는 것을 목표로 한다. 전체 요약 10문장 읽기 → 006 21:11 당일 +117 로컬 DNS 서버로 전 기기 광고·추적 차단, AdGuard Home AdGuard Home은 가정 네트워크 전체의 광고와 추적을 차단하는 DNS 기반 오픈소스 소프트웨어다. 보안 · AdguardTeam/AdGuardHome · TypeScript
Key Point 가정 네트워크에서 단 하나의 DNS 서버 설정만으로 모든 기기의 광고·추적을 차단할 수 있으며, 자체 데이터 제어와 완전한 투명성을 원하는 사용자의 선택지가 다양해졌다.
핵심 요약
AdGuard Home은 가정 네트워크 전체의 광고와 추적을 차단하는 DNS 기반 오픈소스 소프트웨어다. DNS 싱크홀링 방식으로 동작하며, 클라이언트 소프트웨어 설치 없이 모든 기기를 보호한다. Linux, macOS, FreeBSD, OpenBSD 등 다양한 OS에서 curl/wget/fetch로 자동 설치 가능하며, Docker와 Snap Store도 지원한다. 전체 요약 11문장 읽기 → 007 21:11 ▲ 13 · 댓글 2 물체를 자연스럽게 삽입하는 생성형 AI, 조명과 자세까지 맞춘다 기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. AI · 머신러닝 · PhysInsert: Physically Plausible Object Insertion with Geometric Priors and Bidirectional Object-Scene Interactions
Key Point 3D 장면의 조명, 자세, 기하학적 관계까지 고려한 객체 합성은 게임·영화 제작·AR 응용에 실질적으로 필요한 기술로, 기존 방식의 한계를 직결적으로 해결한다.
핵심 요약
기존 객체 삽입 방식은 마스크 입력이나 제한된 시점 변화만 다뤄 조명·자세 적응과 양방향 상호작용이 부족했다. 새로운 프레임워크 PhysInsert는 Blender로 렌더링한 정렬된 데이터셋(Insert World)으로 학습하며, 다양한 시점과 조명 조건 하에서 참조 객체를 삽입한다. 기하학 가이드 적응(Geometry-Guided Adaptation)이 VGGT 기하학 스트림·이미지·텍스트 스트림을 통합해 공간적으로 일관된 삽입을 유도한다. 전체 요약 6문장 읽기 → 008 18:11 ▲ 12 · 댓글 2 웹 에이전트 학습용 자동 환경 생성 프레임워크 'WebAnything' 공개 웹 에이전트 학습·평가에 필요한 다양하고 재현 가능한 웹 환경 구성이 어려운 문제를 다룬다. AI · 머신러닝 · WebAnything: From the Wild Web to Scalable Agent Environments
Key Point 웹 기반 AI 에이전트의 재현 가능한 학습 환경을 자동으로 구성하는 방법이 나왔으며, 기존 수동 방식보다 우수한 성능을 보여준다.
핵심 요약
웹 에이전트 학습·평가에 필요한 다양하고 재현 가능한 웹 환경 구성이 어려운 문제를 다룬다. 기존 방식들은 수동 구현(사이트별 엔지니어링 필요), 생성형 구축(실제 웹과 괴리), 캡처 재생(상호작용 범위 제한) 등의 한계가 있다. WebAnything은 실제 URL에서 자동으로 웹 환경을 재구성하며, 사이트별 수동 작업이나 초기 설정 후 수리 불필요하다. 전체 요약 8문장 읽기 → 009 15:11 ▲ 28 · 댓글 2 멀티모달 LLM의 정보 검색 메커니즘 분석 멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. AI · 머신러닝 · A Broader Look into MLLM's Retrieval Heads
Key Point 멀티모달 LLM의 정보 검색 능력이 특정 어텐션 헤드에 집중되어 있다는 발견은 이들 모델의 작동 원리를 이해하는 핵심이며, 최적화를 통해 성능을 구체적으로 개선할 수 있는 방법을 제시한다.
핵심 요약
멀티모달 대형 언어 모델의 긴 입력에서 관련 증거를 찾는 능력은 '검색 헤드'라는 특정 어텐션 헤드 집합에서 비롯된다. 이 연구는 기존 연구의 한계를 확장해 음성-시각 입력 같은 새로운 모달리티를 포함한 18개 모델 체크포인트를 분석했다. 같은 답이 음성 또는 화면에 표시되는 쌍을 이루는 입력으로 테스트한 결과, 증거 내용이 같으면 검색 헤드는 새로운 모달리티에서도 희소성을 유지한다. 전체 요약 6문장 읽기 → 010 15:11 ▲ 21 · 댓글 3 벤치마크가 말해주지 않는 것: 어려움의 분포 문제 벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. AI · 머신러닝 · Your Benchmark Is an Empirical Measure Over Difficulty
Key Point 평가 지표의 신뢰성이 중요한 만큼, 기존 벤치마크들이 어떤 한계를 가지고 있으며 그것이 리더보드 순위를 얼마나 왜곡할 수 있는지 정량적으로 드러낸다.
핵심 요약
벤치마크는 단순한 문제 모음이 아니라 자연스럽게 난이도에 대한 경험적 분포를 만들며, 이 관점에서 벤치마크 평가를 재검토하는 새로운 틀을 제시한다. 벤치마크의 중심 문제 두 가지를 정의한다: 벤치마크의 난이도 분포가 의도한 분포와 다른 '측정값 불일치(measure mismatch)', 난이도 축의 특정 구간이 비어 있어 모델 개선을 감지하지 못하는 '커버리지 갭(coverage gaps)'. 이 두 문제를 포착하는 진단 지표를 제안하고 엄밀한 이론적 보장을 제공한다. 전체 요약 6문장 읽기 → 011 12:11 ▲ 16 · 댓글 2 컴퓨터 사용 AI, 사용자 맥락 읽지 못하면 성능 36% 떨어진다 컴퓨터 사용 에이전트(CUA)는 고정된 작업 명세로 평가되지만, 실제 사용자는 요구사항을 생략하거나 제약을 추가하거나 결과 행동에 승인을 요구한다. AI · 머신러닝 · PersonaCUABench: Benchmarking Computer-Use Agents Serving Diverse Personas
Key Point 실제 사용자 대화 맥락에서 AI 에이전트 성능이 크게 떨어지는 원인을 규명해, 현재 벤치마크 방식의 한계를 드러낸다.
핵심 요약
컴퓨터 사용 에이전트(CUA)는 고정된 작업 명세로 평가되지만, 실제 사용자는 요구사항을 생략하거나 제약을 추가하거나 결과 행동에 승인을 요구한다. PersonaCUABench는 44개 인물 페르소나를 활용해 같은 작업 74개를 다르게 해석하도록 다양한 방식으로 요청하는 벤치마크를 제시한다. 페르소나 에이전트가 사용자 역할을 해 지시문을 그 사용자의 말투로 다시 쓰고 질문에 답하며, CUA는 오직 대화만 보고 프로필이나 원본 지시문은 본다. 전체 요약 7문장 읽기 → 012 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 013 03:11 ▲ 11 · 댓글 3 로봇이 장애물 인식은 하는데 안전하게 움직이지 못한다 가정용 로봇이 안전하게 이동하려면 장애물 종류와 거리에 따라 속도와 안전 간격을 조절해야 하는데 기존 평가 방법은 이를 검증하지 않는다. AI · 머신러닝 · Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation
Key Point 가정용 로봇이 위험도를 정확히 판단해도 실제 움직임에 반영하지 못하는 문제가 있으며, 이를 측정하는 벤치마크와 지표의 부재가 큰 한계로 지목되었다.
핵심 요약
가정용 로봇이 안전하게 이동하려면 장애물 종류와 거리에 따라 속도와 안전 간격을 조절해야 하는데 기존 평가 방법은 이를 검증하지 않는다. 연구팀은 같은 장면에 장애물 종류만 다르게 배치한 벤치마크 'OSMA-Bench'와 로봇의 움직임이 장애물 위험도에 맞게 조정되는지 측정하는 'SSI(Semantic Sensitivity Index)' 지표를 제안했다. VLM(시각 언어 모델) 기반 및 VLA(시각 언어 행동) 정책을 평가한 결과 명시적인 안전 지시가 있어도 둘 다 장애물 종류에 따라 움직임을 일관되게 조정하지 못했다. 전체 요약 6문장 읽기 → 014 21:11 ▲ 21 · 댓글 3 웹 에이전트를 위한 장기 지속 학습 프레임워크 'HaMo' 제시 웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. AI · 머신러닝 · Harness-Model Collaboration for Long-Horizon Continual Learning
Key Point 웹 자동화 에이전트의 장기 학습을 위해 경험 저장과 모델 적응을 어떻게 결합할지는 실무적 과제이며, HaMo의 접근은 이 문제의 구체적 해법을 제시한다.
핵심 요약
웹 에이전트는 반복되는 다단계 작업에서 재사용 가능한 절차적 지식에 지속적으로 노출되지만, 기존 시스템은 모델 적응 또는 외부 메모리에 의존하면서 지속적 학습과 빠른 재사용 중 하나를 포기하는 한계가 있다. 이를 해결하기 위해 HaMo(Harness-Model 협력 프레임워크)를 제안하며, 빠른 비모수적 경험 축적과 느린 모수적 적응을 결합한다. HaMo는 궤적을 전략 수준의 경험 카드로 증류하여 즉시 검색 가능하도록 하고, 경험 조건부 지속 학습 목표를 통해 모델이 검색된 전략을 다양한 맥락에서 해석·기반·실행하도록 훈련한다. 전체 요약 5문장 읽기 → 015 03:11 ▲ 110 · 댓글 2 30년 전 애플 서버를 맥OS에서 실행하는 기술 1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 하드웨어 · 시스템 · MacOS Extensions Pack for the Apple Network Server v1.0
Key Point 1996년 하드웨어의 OS 호환성을 소프트웨어로 복원하는 역사적 기술 복원 사례로, 레트로 컴퓨팅과 드라이버 개발의 깊이 있는 사례 연구를 제시한다.
핵심 요약
1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 최근 공개된 사전프로덕션 롬(1.1.20.1)은 AIX와 맥OS 양쪽을 모두 부팅할 수 있지만, 사전프로덕션 롬의 맥OS 지원에는 결함이 있었다(온보드 비디오 미지원, MACE 이더넷 작동 안 함, 재부팅 후 검은 화면). 저자는 이러한 문제를 소프트웨어로 수정하여 ANS Extensions Pack v1.0을 개발했으며, MACE 이더넷을 고정하고 온보드 비디오를 활성화하며 맥OS에서 적절히 재부팅하도록 했다. 전체 요약 11문장 읽기 → 016 00:11 ▲ 15 · 댓글 2 음성·영상 AI가 실시간 상황에 제때 반응하지 못한다 옴니모달 대형언어모델(Omni-LLM)이 계속 스트리밍되는 음성·영상을 관찰하면서 사용자를 지원할 수 있어야 하는데, 기존 평가 방식으로는 이들이 얼마나 신뢰성 있게 상황 증거와 사용자 필요를 연결해 적시에 개입하는지 알기 어렵다. AI · 머신러닝 · Omni-InteractScope: Benchmarking Proactive and Agentic Interaction in Continuous Omnimodal Streams
Key Point 음성·영상 AI가 실시간으로 상황을 인식하고 제때 도움을 주는 것이 얼마나 어려운지 첫 대규모 벤치마크로 드러나, 현재 모델의 한계와 개선할 구체적 방향을 보여준다.
핵심 요약
옴니모달 대형언어모델(Omni-LLM)이 계속 스트리밍되는 음성·영상을 관찰하면서 사용자를 지원할 수 있어야 하는데, 기존 평가 방식으로는 이들이 얼마나 신뢰성 있게 상황 증거와 사용자 필요를 연결해 적시에 개입하는지 알기 어렵다. Omni-InteractScope 벤치마크는 8개 작업군에 걸친 1,479개 인간 주석 상호작용과 1,790개 시간 목표를 제시한다. 도구 호출(tool invocation) 타이밍, 쿼리 없는 조언, 알림, 경고, 상태 추적, 지속적 응답을 포함해 입력 모달리티·사건 트리거·개입 유형·사용자 필요를 연결한다. 전체 요약 8문장 읽기 → 017 18:11 ▲ 90 · 댓글 2 이산 토큰, 연속 표현 수준의 시각 정보 담을 수 있을까 이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. AI · 머신러닝 · Can Discrete Tokens Serve as Semantically Lossless Representations of Visual Signals?
Key Point 이산 토큰 기반 시각 표현이 그동안 한계로 간주해온 의미 손실 문제를 실질적으로 극복했으며, 멀티모달 기초 모델의 구조 선택에 영향을 미칠 가능성이 있다.
핵심 요약
이산 시각 토큰은 언어와 유사한 이산 형태로 비전을 표현하며, 멀티모달 모델에서 다음 토큰 예측 목표 아래 네이티브 인터페이스를 제공한다. 기존 가정과 달리, 양자화 오류 크기와 의미 손실 사이에는 신뢰성 있는 상관관계가 없으며, 오류가 크더라도 더 나은 이해 성능을 낼 수 있다. 이산 토큰의 실질적인 비트 예산이 다운스트림 성능의 주요 결정 요소로 나타났으며, 기존 양자화기는 코드북이 증가할수록 의미 정보 기여도가 감소해 포화 현상이 발생한다. 전체 요약 8문장 읽기 → 018 15:11 ▲ 37 · 댓글 4 LLM 추론 수준 선택, 비용 대비 성능 불균형 LLM의 추론 노력(reasoning effort) 설정은 사용자가 추론 시간 계산량을 조절해 비용과 성능을 맞바꿀 수 있게 한다. AI · 머신러닝 · What Effort Level Should I Choose? On the Economics of Reasoning Effort in LLM Agents
Key Point LLM 에이전트의 추론 비용 책정이 경제학적으로 비합리적임을 실증적으로 규명해, 실제 운영 시 에이전트 비용을 크게 절감할 수 있는 전략을 제시한다.
핵심 요약
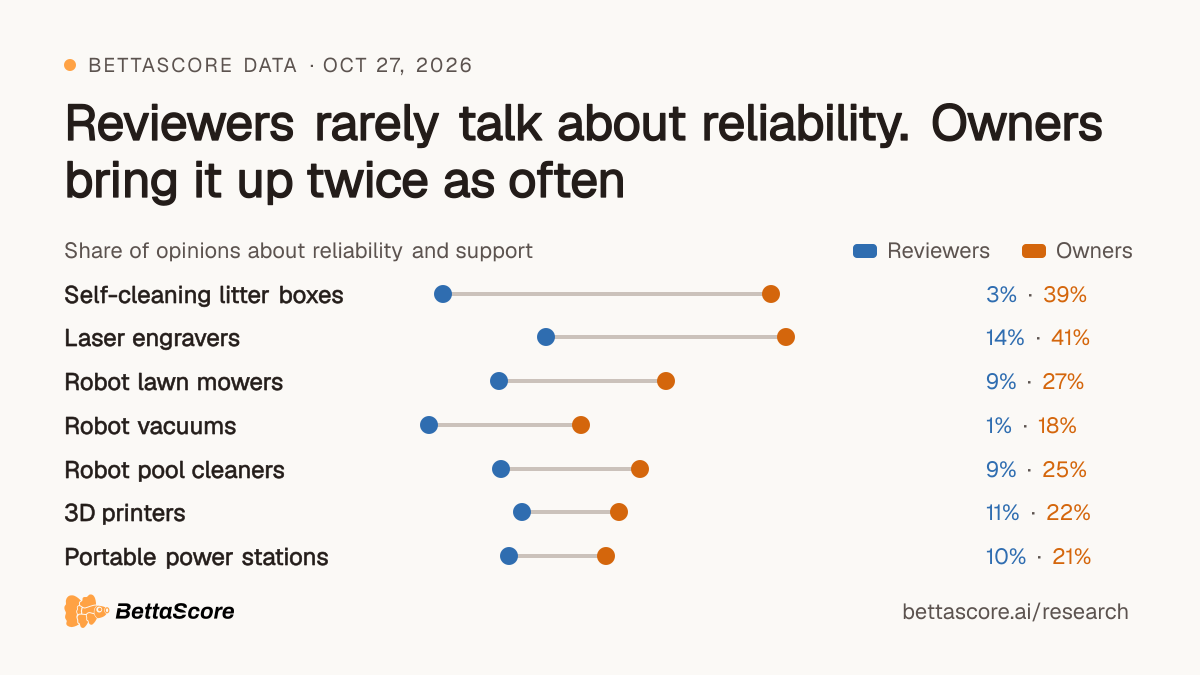
LLM의 추론 노력(reasoning effort) 설정은 사용자가 추론 시간 계산량을 조절해 비용과 성능을 맞바꿀 수 있게 한다. 추론 노력은 신용재(credence good): 사용자는 결과를 보지만 추가 계산의 한계 가치를 평가할 수 없다. 연구팀은 4개 벤치마크에서 여러 노력 수준의 인과적 효과를 측정했으며, 단일 호출 추론과 장기 에이전트 작업을 포함했다. 전체 요약 10문장 읽기 → 019 15:11 ▲ 102 · 댓글 80 리뷰어는 신뢰성을 외면하고 실사용자는 두 배로 강조한다 BettaScore가 14개 카테고리의 로봇청소기, 레이저 각인기, 3D 프린터 등 657개 제품에 대해 유튜브 리뷰 6,900건과 레딧 스레드 3,567건을 분석했다. 기타 · Reviewers rarely talk about reliability. Owners bring it up twice as often
Key Point 실사용자만 드러내는 신뢰성 문제를 리뷰어는 놓치고 있으며, 같은 제품도 시간이 지날수록 실제 가치와 다른 평가를 받는다는 점이 구매 결정에 큰 영향을 미친다.
핵심 요약
BettaScore가 14개 카테고리의 로봇청소기, 레이저 각인기, 3D 프린터 등 657개 제품에 대해 유튜브 리뷰 6,900건과 레딧 스레드 3,567건을 분석했다. 리뷰어는 신뢰성과 내구성, 지원에 관해 전체 의견의 7.8%만 언급한 반면, 실제 사용자는 17.0%로 두 배 이상 자주 다뤘다. 13개 카테고리에서 사용자가 신뢰성을 더 많이 언급했으며, 로봇청소기(리뷰어 1% vs 사용자 18%), 자동 묘사함(3% vs 39%), 레이저 각인기(14% vs 41%)의 격차가 특히 크다. 전체 요약 12문장 읽기 → 020 15:11 ▲ 160 · 댓글 77 미국 법전에 깃처럼 변경 이력 추적 시스템 적용하다 프로그래머가 코드의 어느 줄이든 작성자, 시점, 과거 모습을 확인할 수 있듯이, 법률가도 연방법의 특정 문장이 언제 누가 어떻게 바꿨는지 추적할 수 있어야 한다는 제안이다. 웹 · 프론트엔드 · Git for the US Code
Key Point AI 모델의 법률 해석이 시간의 흐름과 변경 이력을 제대로 추적하지 못하는 문제를 소프트웨어 관례로 해결하는 구체적 방법론을 제시한다.
핵심 요약
프로그래머가 코드의 어느 줄이든 작성자, 시점, 과거 모습을 확인할 수 있듯이, 법률가도 연방법의 특정 문장이 언제 누가 어떻게 바꿨는지 추적할 수 있어야 한다는 제안이다. 미국 법전은 의회 공식 입법 외에는 1차 증거일 뿐이고, 수정 사항이 산문 형태의 주석과 별도의 발효일 노트에 분산되어 있어서 정확한 이력 추적이 어렵다. 11 USC § 1182(1)의 소규모 사업 채무자 정의 사례에서 보듯, 같은 법 조항도 연도와 케이스 성격에 따라 다른 조건이 적용되는데, 현재 체계로는 이를 파악하기 어렵다. 전체 요약 11문장 읽기 → 021 12:11 ▲ 91 · 댓글 7 LLM 에이전트는 사용자 습관을 제대로 학습하지 못한다 장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. AI · 머신러닝 · HABIT-Bench: Evaluating Habit Induction from Longitudinal Weak Evidence in Agent Memory
Key Point LLM 에이전트의 메모리 시스템이 사용자 습관 추론에서 근본적인 한계를 드러냈으며, 현재 방법들의 약 67%가 습관을 잘못 적용한다는 의미다.
핵심 요약
장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. 개별 관찰만으로는 습관의 부분적 증거만 제공할 수 있고, 과거 상호작용 기록만으로는 습관 추론과 적용을 보장하지 못한다. HABIT-Bench는 에이전트 메모리 시스템이 약한 증거에서 습관을 추론하고 이후 요청에 적용하는 능력을 평가하는 벤치마크다. 전체 요약 8문장 읽기 → 022 12:11 ▲ 26 · 댓글 2 LLM 환각 탐지 벤치마크 비교 불가능한 이유 대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. AI · 머신러닝 · Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities
Key Point LLM 성능을 평가하는 핵심 지표인 환각 탐지가 벤치마크마다 다르게 정의되고 측정되기 때문에, 어떤 방법이 실제로 더 나은지 판단할 수 없다는 문제를 드러낸다.
핵심 요약
대규모언어모델(LLM)의 환각 탐지는 모델 평가와 배포에 점점 중요해지고 있으나, 기존 방법들은 서로 다른 정의와 측정 방식을 쓰는 벤치마크에서 비교되고 있다. 연구팀은 환각 탐지를 벤치마크 조건부 측정 문제로 보고, 세 가지 축으로 기존 벤치마크들을 분류했다: 모델 출력과 근거 조건을 어떻게 얻는지를 설명하는 '출처', 사실성과 충실성 오류를 어떻게 정의하는지를 나타내는 '유형분류', 환각을 어떤 단위로 주석·예측·평가하는지를 명시하는 '단위'이다. 벤치마크 구성, 주석 방식, 평가 방법의 차이가 예측 작업에 어떻게 영향을 미치고, 탐지기의 메커니즘과 가정이 어떤 조건에서 성능을 보이는지를 분석했다. 전체 요약 5문장 읽기 → 023 12:11 ▲ 55 · 댓글 2 로봇 학습을 인간 영상으로 확대하는 'ThinkWorld' 프레임워크 로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. AI · 머신러닝 · ThinkWorld: World Imagination Reinforces Chain-of-Dynamics Reasoning
Key Point 라벨 없는 인간 영상을 로봇 학습에 직접 활용하는 방법이 제시되어, VLA 모델의 훈련 데이터 병목을 푸는 새로운 경로를 제공한다.
핵심 요약
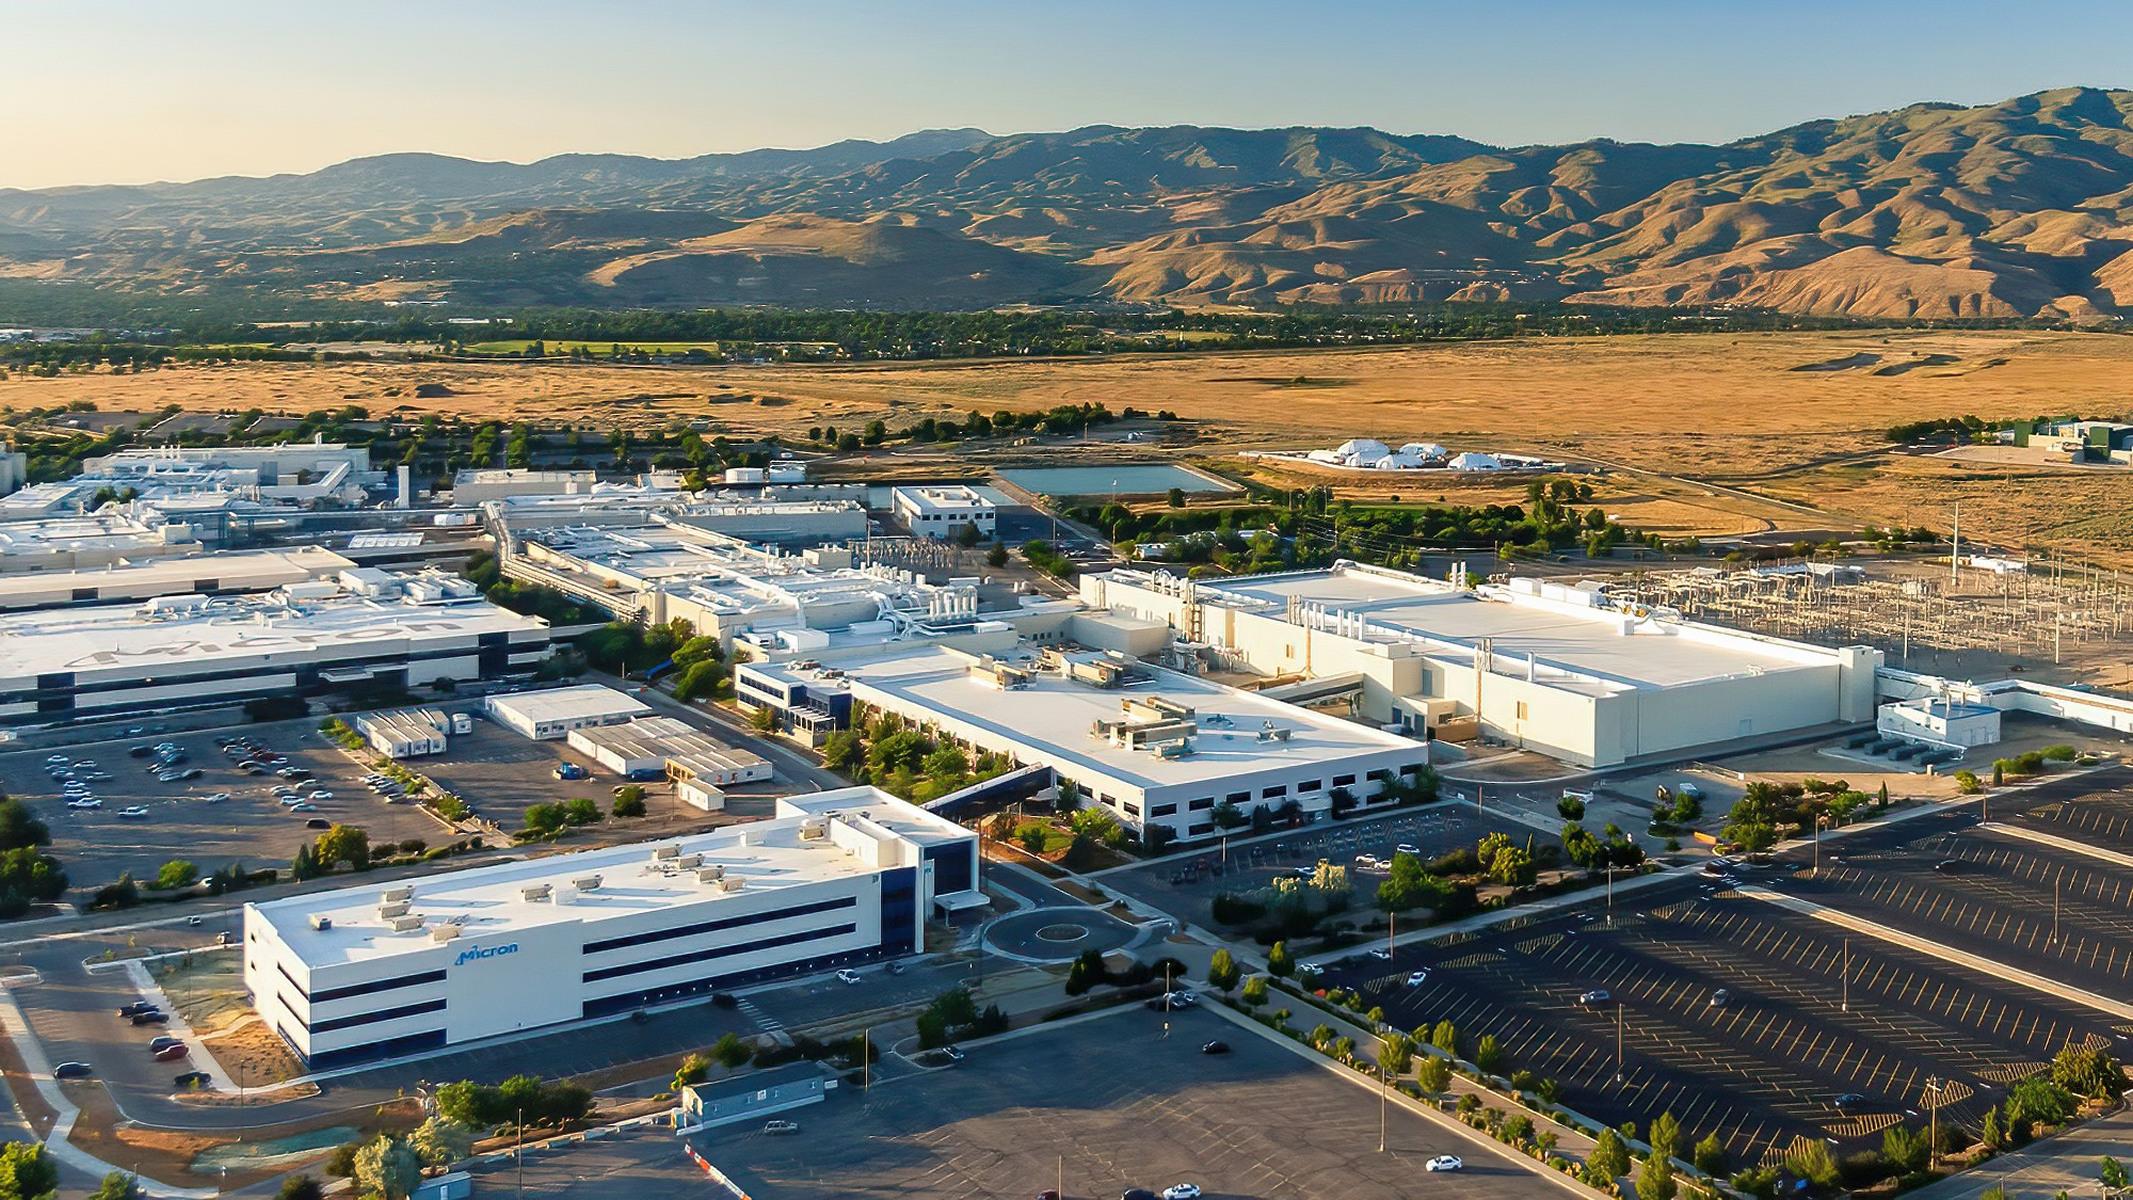
로봇 조작 VLA 모델이 행동 라벨 데이터 부족으로 일반화에 한계를 보이고 있다. 인간 영상은 행동 기록이 없어서 로봇 학습에 직접 활용하기 어렵다는 문제가 있다. ThinkWorld는 행동을 Chain-of-Dynamics(CoD)로 표현하여 세계 역학과 연결한다. 전체 요약 8문장 읽기 → 024 06:11 ▲ 114 · 댓글 17 마이크론이 4F² DRAM 포기, 3D 메모리로 방향 선회 마이크론은 20년 이상의 연구 끝에 4F² DRAM 상용화를 포기하고 6F² 기술에 집중하기로 결정했다. 하드웨어 · 시스템 · Why Micron Is Suddenly Ditching 4F² DRAM as Rivals Double Down
Key Point 경쟁업체들이 4F² DRAM에 투자할 때 마이크론만 반대 방향으로 가는 이유와, DRAM 미세화의 물리적 한계가 어디까지인지 이해할 수 있다.
핵심 요약
마이크론은 20년 이상의 연구 끝에 4F² DRAM 상용화를 포기하고 6F² 기술에 집중하기로 결정했다. DRAM 밀도는 셀 면적보다 커패시터 간격에 의해 결정되는데, 6F²에서 4F²로 축소해도 밀도 개선 효과가 미미하면서 비용과 복잡도만 급증한다. 마이크론은 1δ(델타) 고밀도 메모리 양산에 박차를 가하고 있으며, 1ε(엡실론)에서는 첨단 웨이퍼 본딩 기술을 적용한다. 전체 요약 8문장 읽기 → 025 03:11 ▲ 28 · 댓글 2 LLM 연구 에이전트가 만든 하스스톤 AI, 최상위 플레이어 능가 LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AI · 머신러닝 · Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players
Key Point LLM 에이전트가 자동 개선 루프를 통해 최첨단 게임 AI를 개발하고 인간 최강자를 능가한 사례로, 에이전트 연구의 현실적 가능성과 한계를 보여줍니다.
핵심 요약
LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AutoTavern은 특화된 LLM 에이전트들이 타입화된 연구 메모리를 공유하고, 모든 주장이 검증 단계를 거치며, 실제 게임을 통해 피드백 루프가 닫혀 있어 시뮬레이터, 상대 AI, 정책, 연구 과정까지 동시에 개선된다. TavernAgent는 PPO로 학습되어 23개 버전을 거쳤으며, 실제 게임 래더에서 등급이 6,000에서 약 15,000으로 올랐다. 전체 요약 7문장 읽기 → 026 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 027 00:11 ▲ 26 · 댓글 2 LLM 에이전트 강화학습의 신용 할당 문제 해결한 ProAS 프레임워크 LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. AI · 머신러닝 · ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
Key Point 다단계 추론이 필요한 LLM 에이전트의 강화학습 효율성을 크게 개선하는 방법론이 제시되어, 언어 모델 기반 자동화 시스템의 성능 향상에 직결된다.
핵심 요약
LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. 이 접근 방식은 선호되는 궤적에서 구조적으로 비합리적인 행동을 강화하고, 비선호 궤적에서 각 행동의 하위 편차를 무시한다. ProAS는 동적으로 진화하는 에이전틱 레퍼런스 그래프(ARG)를 활용해 비합리적 인센티브 마스킹(MUI)과 비대칭 페널티 재배분(APR)을 통한 세밀한 신용 할당을 구현한다. 전체 요약 5문장 읽기 → 028 00:11 ▲ 11 · 댓글 2 단일 이미지에서 3D 장면 재구성, 객체 기반 접근법으로 품질 향상 단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. AI · 머신러닝 · Easy-3Dfy: Object-Level Geometric Composition for Single-Image 3D Scene Construction
Key Point 3D 장면 재구성 품질을 높이는 새로운 구성 방식의 등장으로, 컴퓨터 비전 모델 설계 방향을 보여주는 선례입니다.
핵심 요약
단일 이미지로부터 3D 장면을 구성하는 문제를 다루며, 기존의 SAM-3Dfy 같은 방식이 세밀한 기하학적 표현과 자산 품질에서 한계를 보인다. 연구팀은 Easy-3Dfy라는 구성 기반 워크플로우를 제안했으며, 이는 객체 생성과 장면 배치 추정을 분리해 각 모델의 강점을 활용한다. 특화된 3D 객체 생성기는 상세한 객체 기하학을, 3D 기초 모델은 강력한 공간 이해를 각각 담당하도록 설계했다. 전체 요약 6문장 읽기 → 029 15:11 ▲ 123 · 댓글 2 사람의 물리적 행동을 돕는 AI 어시스턴트 평가 벤치마크 공개 착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. AI · 머신러닝 · InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
Key Point 지능형 어시스턴트가 실제로 사람의 물리적 작업을 도울 수 있는지 검증할 수 있는 표준화된 평가 체계가 처음 등장했으며, 현재 최신 모델들의 성능 한계가 명확히 드러났기 때문이다.
핵심 요약
착용형 기기의 다중모달 대형언어모델(MLLM) 어시스턴트가 사용자를 가이드하고 지시하는 상황을 평가하기 위해 InteractiveWorld라는 검증 가능한 환경을 제안했다. 기존 로봇 중심 시뮬레이터와 달리 InteractiveWorld는 AI 어시스턴트가 사람 에이전트에게 지시하고, 사람이 관찰·이해·독립적으로 행동하는 폐루프 상호작용을 현실적으로 모의한다. 어시스턴트의 명령이 실제 결과를 좌우하며, 상태 기반 리워드로 검증 가능하게 채점되는 방식이다. 전체 요약 6문장 읽기 → 030 15:11 ▲ 28 · 댓글 2 에이전트의 변화하는 도구에 대한 적응력을 평가하는 벤치마크 공개 AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. AI · 머신러닝 · Δτ-Bench: Pushing Agents Toward a Moving Capability
Key Point LLM 기반 에이전트가 실무 환경에서 마주하는 도구 변화에 얼마나 적응할 수 있는지 보여주는 새로운 평가 기준으로, 기존 벤치마크의 한계를 직접 드러내고 해결책을 제시했기 때문이다.
핵심 요약
AI 에이전트가 진화하는 도구 생태계에 얼마나 잘 적응하는지 평가하기 위해 Δτ-Bench라는 실행 가능한 벤치마크를 소개했다. 이 벤치마크는 1,588개의 검증된 멀티턴 작업과 42개 도메인, 6개의 연속적인 생태계 상태를 포함하며, 도구가 사라지거나 교체되고 더 효율적인 대안이 등장하는 현실을 모델링한다. 기존 벤치마크는 에이전트가 효율적인 도구 사용 경로를 주동적으로 발견하고 축적된 절차적 지식을 신속하게 수정할 수 있는지 검사하지 않는다. 전체 요약 6문장 읽기 → 031 12:11 ▲ 253 · 댓글 2 비전-언어 모델의 능동형 상호작용, 사용자 의도 예측으로 진화 비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. AI · 머신러닝 · StreamVibe: Proactive Video Agents for Evolving User Intent
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 032 12:11 ▲ 170 · 댓글 279 태양광이 핵발전 제치고 세계 최대 전력원으로 2025년 태양광 발전량이 전 세계 핵발전을 처음 넘어섰으며, 2026년에는 10% 수준으로 증가해 핵발전(1970년대 주류 전원)을 명확히 앞질렀다. 기타 · Solar power is becoming bigger than nuclear
Key Point 태양광이 핵발전을 넘으면서 전 세계 에너지 전환의 중심축이 이동했으며, 패널 가격 급락과 배터리 혁명이 예상을 뛰어넘는 성장을 이끌고 있다.
핵심 요약
2025년 태양광 발전량이 전 세계 핵발전을 처음 넘어섰으며, 2026년에는 10% 수준으로 증가해 핵발전(1970년대 주류 전원)을 명확히 앞질렀다. 태양광은 역사상 가장 빠르게 성장하는 신규 전력원으로, 2025년 전 세계 전기 수요 증가분의 3분의 3을 충족하며 풍력 발전을 추월했고, 핵발전은 2000년 이후 거의 변화 없는 반면 태양광은 2,700배 증가했다. 국제에너지기구(IEA) 등 주류 전망은 선형 성장과 점진적 비용 하락을 가정해 태양광 성장을 지속해서 저평가했다. 전체 요약 14문장 읽기 → 033 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 034 06:11 ▲ 161 · 댓글 82 Windows 11에서 돌아가는 가장 오래된 GUI 앱은 저자는 수정 없이 Windows 11에서 구동되는 가장 오래된 GUI 애플리케이션을 찾기 위해 조사를 시작했다. 인프라 · 데브옵스 · Oldest GUI application that still runs on Windows 11
Key Point Windows 11의 하위호환성 한계를 구체적으로 보여주며, 거의 40년 전 소프트웨어가 최신 OS에서 여전히 작동하는 기술적 이유를 설명한다.
핵심 요약
저자는 수정 없이 Windows 11에서 구동되는 가장 오래된 GUI 애플리케이션을 찾기 위해 조사를 시작했다. Windows 11은 64비트 운영체제로 NTVDM이 없어 16비트 프로그램을 실행할 수 없으므로, 초기 NT 시대 프로그램을 찾아야 했다. Win32s와 함께 배포된 FREECELL.EXE(1993년 2월 22일 빌드)가 Windows 11에서 완벽하게 작동했으며, 당시 기준 33년 8개월 된 애플리케이션이었다. 전체 요약 7문장 읽기 → 035 06:11 ▲ 136 · 댓글 16 EPA 웹 아카이브 폐기, 20년치 환경 자료 사라질 위기 EPA가 올해 말까지 웹 아카이브를 폐기하기로 발표했으며, 이는 1990년대부터 축적된 수만 개의 환경 관련 공공 자료를 영구 삭제하는 것을 의미한다. 보안 · The EPA Is Quietly Killing Its Web Archive
Key Point 공공 환경 정보의 장기 보존이 정부 투명성과 시민의 정보 접근권에 미치는 영향을 보여주는 구체적 사례이며, 정책 변화 과정에서 역사적 증거 자료가 갖는 중요성을 드러낸다.
핵심 요약
EPA가 올해 말까지 웹 아카이브를 폐기하기로 발표했으며, 이는 1990년대부터 축적된 수만 개의 환경 관련 공공 자료를 영구 삭제하는 것을 의미한다. 웹 아카이브는 20년 이상의 정책 변화, 규제 조치, 팩트시트, 환경 보고서 등을 보관해 온 연구원, 입법자, 정책 입안자들의 중요한 자원이었다. 2022년 1월 Biden 행정부 EPA도 연 200만 달러의 유지비 부담을 이유로 폐기를 시도했으나 환경 단체·역사가·도서관 전문가들의 강력한 반발로 2023년 7월 폐기 일정을 연기했었다. 전체 요약 9문장 읽기 → 036 06:11 ▲ 143 · 댓글 45 $2 마이크로컨트롤러에서 SIMD로 컴퓨터 비전 가속하기 ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. 하드웨어 · 시스템 · SIMD-accelerated computer vision on a $2 microcontroller
Key Point $2 저가 마이크로컨트롤러의 숨겨진 SIMD 명령어를 활용해 컴퓨터 비전 성능을 2배 향상시킨 방법과, 하드웨어 제약을 창의적으로 극복한 어셈블리 최적화 기법을 배울 수 있다.
핵심 요약
ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. ESP32-S3는 240MHz 듀얼코어 CPU, WiFi, BLE 라디오를 탑재한 저가 칩이지만 SIMD 명령어 지원에 대한 정보가 거의 알려져 있지 않아 직접 실험과 최적화를 진행했다. SIMD 구현 과정에서 미정렬 읽기 불지원 문제를 두 개의 인접한 레지스터를 읽은 후 슬라이스 추출 명령어로 극복했다. 전체 요약 6문장 읽기 → 037 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 038 06:11 ▲ 295 · 댓글 147 10년 된 CNN이 최신 LLM을 이기다, 피부암 진단 2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. AI · 머신러닝 · A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis
Key Point 이 글은 대규모 언어모델의 의료 진단 능력이 특화된 구형 모델에 미치지 못한다는 구체적인 임상 증거를 보여주며, LLM이 모든 분야에서 기존 방식을 대체할 수 없음을 시사한다.
핵심 요약
2015년 구글이 발표한 Inception v3 CNN을 피부과 이미지로 20분 정도 미세조정한 모델이 GPT-6 Astra와 Claude Fable 5.1 두 최신 LLM을 피부암 진단에서 압도했다. 임상 사진과 피부경 이미지를 포함한 조직검사로 확진된 200개 병변 테스트에서 CNN은 125개(62%)를 올바르게 진단했지만 두 LLM은 각각 84개와 85개(42%)만 정확했다. 테스트 병변은 MILK10k 공개 데이터셋에서 무작위 선정했으며, 진단 불가능 범주 100개(흑색종 30, 기저세포암 25, 편평세포암 25, 광선각화증 20)와 안전 범주 100개(양성모반 50, 지루각화증 50)로 구성됐다. 전체 요약 12문장 읽기 → 039 06:11 ▲ 273 · 댓글 140 검열에 저항하는 도구 개발자 모아 FOSDEM 27에 신규 분과 개설 FOSDEM 27에서 검열과 감시에 맞서는 자유 소프트웨어 개발에 집중한 'Digital Dissident' 분과를 새로 개설한다. 보안 · I refuse to accept a censored Internet. Join Me at FOSDEM 27
Key Point 검열이 정교해지는 가운데 개별 도구의 안전성보다 전체 도구 체인의 상호 운용성이 생사를 결정하는 상황에서, 산재된 프로젝트 개발자들을 한 자리에 모아 공통 위협 모델과 공학 실천을 논의하는 이번 분과가 지역 사용자 보호 전략을 바꿀 수 있습니다.
핵심 요약
FOSDEM 27에서 검열과 감시에 맞서는 자유 소프트웨어 개발에 집중한 'Digital Dissident' 분과를 새로 개설한다. 러시아, 이란, 중국 등 권위주의 체제 주민들은 우회 접속·익명 통신·안전한 증거 보관·추적 불가능한 배포 등 완전한 도구 체인이 필요하며, 기존 분과들은 개별 기술만 다뤄 전체 흐름을 놓쳤다. 검열 우회·익명 통신·안전한 보도·기기 보안·위험 사용자를 위한 유용성·검열 측정 등 6가지 주제로 기술 발표와 개방형 토론을 진행한다. 전체 요약 7문장 읽기 → 040 15:11 ▲ 100 · 댓글 36 뇌 영역 간 상호작용 감지하는 임플란트 칩 개발 EPFL 연구팀이 뇌 영역 간 통신을 추적하고 인지·감정 상태를 실시간으로 파악하는 임플란트 칩 LogSync를 개발했다. 하드웨어 · 시스템 · Neural chip decodes interactions between brain regions
Key Point 뇌 영역 간 네트워크 신호를 분석하는 저전력 임플란트 기술은 기존 치료법의 한계를 극복하고 정신질환에 대한 적응형 치료의 길을 열어준다.
핵심 요약
EPFL 연구팀이 뇌 영역 간 통신을 추적하고 인지·감정 상태를 실시간으로 파악하는 임플란트 칩 LogSync를 개발했다. 기존 뇌심부자극(DBS) 시스템은 개방형으로 작동하거나 단일 뇌 영역의 신호만 사용하는 한계가 있으며, 정신질환은 특정 영역 장애보다 뇌 영역 간 소통 단절에서 비롯될 수 있다. LogSync는 뇌 활동을 기록하고 뇌파 강도와 뇌 영역 간 신호 동기화를 추출한 뒤, 머신러닝 알고리즘으로 네트워크 수준의 바이오마커를 분석해 인지·감정 상태를 구분하고 자극 신호를 생성한다. 전체 요약 8문장 읽기 → 041 18:11 ▲ 107 · 댓글 10 함수형 언어 Roc, C의 DEFLATE 성능에 8.9% 차까지 접근 함수형 프로그래밍 언어 Roc으로 작성한 roc-deflate 패키지가 C로 만들어진 최적화된 DEFLATE 라이브러리 libdeflate와 성능을 비교했다. AI · 머신러닝 · How close can pure functional programming get to C?
Key Point 함수형 프로그래밍 언어가 명령형 저수준 언어와의 성능 격차를 얼마나 좁힐 수 있는지 실제로 입증했으며, 메모리 안전성 같은 보장을 위해 치르는 성능 대가가 실제로는 미미할 수 있음을 보여준다.
핵심 요약
함수형 프로그래밍 언어 Roc으로 작성한 roc-deflate 패키지가 C로 만들어진 최적화된 DEFLATE 라이브러리 libdeflate와 성능을 비교했다. Silesia 코퍼스로 144개 벤치마크를 실행한 결과, Ryzen 3900X 기준 중앙값 8.9%, M1 MacBook Pro 기준 2.6% 느렸다. 최악의 경우 18% 느렸지만 특정 입력에서는 18% 빠르기도 했으며, 이는 두 구현의 차이일 뿐 Roc의 성능 한계가 C보다 낮다는 의미다. 전체 요약 10문장 읽기 → 042 09:11 ▲ 102 · 댓글 88 UUIDv7, 생각보다 신뢰할 수 없다 UUIDv7은 단조증가 ID, 정확한 타임스탬프, 예측 불가능성을 제공한다고 알려져 있지만 RFC 호환 구현 중 많은 것이 이 속성들을 위반한다. 인프라 · 데브옵스 · UUIDv7 doesn't have the properties you think it does
Key Point 구현 선택에 따라 단조성, 정확한 타임스탐프, 보안성이 보장되지 않을 수 있으므로 UUIDv7 사용 시 각 구현의 실제 동작과 제약을 파악해야 한다.
핵심 요약
UUIDv7은 단조증가 ID, 정확한 타임스탬프, 예측 불가능성을 제공한다고 알려져 있지만 RFC 호환 구현 중 많은 것이 이 속성들을 위반한다. RFC 9562는 타임스탬프를 시스템 시계에서 직접 유도하지 않고 임의로 변경하도록 허용하기 때문에, UUID에 내장된 타임스탐프가 객체 생성 시간과 맞지 않을 수 있다. Python 표준 라이브러리의 uuid7()은 카운터 오버플로우 시 타임스탬프를 미리 증가시키는데, 시스템 클록이 역행하면 타임스탬프가 시스템 시간보다 임의로 크게 앞서갈 수 있다. 전체 요약 12문장 읽기 → 043 21:11 ▲ 10 · 댓글 1 네트워크 보안에 타입화된 결정 모델 도입, VX-One 실증 네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. 보안 · VX-One: Typed, Calibrated Decision Heads for Real-Time Perimeter Triage - An empirical study of unknown-attack honesty, cascade gray zones, and calibration under drift
Key Point 시그니처 엔진과 머신러닝의 장점을 결합하는 캐스케이드 아키텍처에서 타입화된 결정의 효과와 한계를 실증적으로 측정한 결과, 특히 시간적 변화 같은 실전 조건에서 캘리브레이션이 붕괴되는 현상은 보안 시스템 운영에 직접 영향을 미친다.
핵심 요약
네트워크 경계 방어(perimeter triage)는 빠른 시그니처 엔진과 느리지만 의미를 파악하는 생성형 모델 간의 절충이 필요한데, 최근 상용 System One 결정 모델들이 이진 게이트·폐쇄형 선택·순서형 점수 같은 타입화된 의사결정 원시형을 API로 제공하기 시작했다. VX-One은 100K-10M 파라미터의 소규모 멀티헤드 네트워크로서 캘리브레이션된 게이트, 미지의 선택지를 항상 포함하는 폐쇄형 후보군에서의 선택, 순서형 점수를 출력하며, CPU에서 약 0.7-1.7ms의 추론 시간을 가진다. UNSW-NB15, CIC-IDS2017, EMBER2024 벤치마크에서 캘리브레이션된 XGBoost, 랜덤포레스트, MLP, Kitsune과 비교 평가했고, Suricata 시그니처 엔진(52,674개 규칙) 뒤에 VX-One을 두는 2단계 캐스케이드 구성을 CIC-IDS2017의 5일간 데이터로 측정했다. 전체 요약 7문장 읽기 → 044 18:11 ▲ 18 · 댓글 2 AI 생성 영상 진위 판별, 인공물 검증으로 설명 가능하게 영상 생성 기술이 고도화되면서 합성 영상을 신뢰할 수 있게 탐지할 필요성이 커지고 있다. AI · 머신러닝 · Verus-Insight: Towards Explainable Artifact Detection in AI-Generated Videos
Key Point 합성 영상이 실제와 구분 어려워지는 시점에 AI가 생성 결함을 어떻게 찾아내는지 설명 가능하게 만드는 것이 핵심으로, 콘텐츠 진위 검증의 신뢰성 기준을 세우기 때문이다.
핵심 요약
영상 생성 기술이 고도화되면서 합성 영상을 신뢰할 수 있게 탐지할 필요성이 커지고 있다. 기존 인공물 기반 탐지기는 생성 증거를 찾지만 미묘한 결함을 놓치거나 올바른 판단을 내리면서도 근거를 제시하지 못하는 한계가 있다. 이 연구는 인공물 탐지를 세 가지 단계로 구조화했다: 검사 대상을 정하는 '검사 계획', 실제 생성 결함이 있는지 확인하는 '증거 검증', 최종 판단으로 통합하는 '증거 통합'이다. 전체 요약 7문장 읽기 → 045 18:11 ▲ 20 · 댓글 2 LLM 에이전트의 검증기 생성 능력을 평가하는 벤치마크 공개 LLM 에이전트가 작업 완료 후 출력물을 검증하고 합성 학습 데이터를 필터링할 수 있도록, 주어진 지시사항과 환경으로부터 실행 가능한 검증기를 생성하는 능력을 연구했다. AI · 머신러닝 · VerifierBench: Benchmarking the Generation of Executable Verifiers for LLM Agents
Key Point LLM 에이전트가 생성한 검증기들이 실제로는 지나치게 엄격한 기준으로 유효한 솔루션을 배제하는 문제를 처음으로 대규모로 분석했으며, 에이전트 검증 시스템의 근본적 한계를 드러낸다.
핵심 요약
LLM 에이전트가 작업 완료 후 출력물을 검증하고 합성 학습 데이터를 필터링할 수 있도록, 주어진 지시사항과 환경으로부터 실행 가능한 검증기를 생성하는 능력을 연구했다. VerifierBench는 6개 에이전트 벤치마크에서 수집한 222개 작업으로 구성되며, 도구 호출·상태 기반·코드 검증 3가지 유형을 포함하고 4,993개의 숨겨진 테스트 케이스(대체 해결책 및 공격 포함)를 갖추고 있다. Verifier4Verifier(V4V)라는 6단계 감시 시스템이 소스 검증기와 테스트 스위트를 선별한다. 전체 요약 8문장 읽기 → 046 18:11 ▲ 25 · 댓글 2 비디오 기반 딥 리서치 벤치마크로 AI 에이전트 평가 딥 리서치 에이전트가 비디오를 기반으로 연구 질문을 찾아 외부 멀티모달 증거를 수집한 뒤 대화형 보고서를 생성하는 새로운 과제를 소개했다. AI · 머신러닝 · Beyond Watching and Searching: Benchmarking Agents for Video-centered Deep Research Reports
Key Point 비디오 기반 장문 리서치 생성의 첫 체계적 벤치마크로, 멀티모달 AI 에이전트의 평가 방법과 현재 한계를 명확히 보여준다.
핵심 요약
딥 리서치 에이전트가 비디오를 기반으로 연구 질문을 찾아 외부 멀티모달 증거를 수집한 뒤 대화형 보고서를 생성하는 새로운 과제를 소개했다. 비디오 기반 딥 리서치는 사용자가 관련 장면을 찾고, 주장을 검증하고, 시연된 절차를 재현하고, 비디오 콘텐츠에서 정보를 바탕으로 의사결정하는 데 직접적인 실용 가치가 있다. OmniDR-Bench 벤치마크를 제시하며 세 가지 차원과 23개의 공유 방향, 작업별 원자 이진 기준으로 구성된 Omni Atomic Rubric Trees(Omni-ARTs)를 평가 지표로 제안했다. 전체 요약 9문장 읽기 → 047 12:11 ▲ 33 · 댓글 2 코드 기반 영상생성 벤치마크 '코드2비디오-컴패스' 공개 코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. AI · 머신러닝 · Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
Key Point 코드 기반 영상생성이 사용성과 제어성 측면에서 주목받는 가운데, 다양한 입력과 창작 시나리오를 아우르는 첫 종합 벤치마크가 나왔으며 현재 MLLM들의 한계를 명확히 보여준다.
핵심 요약
코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. 기존 코드 기반 벤치마크는 특정 작업에만 집중해 다양한 창작물과 입력 방식의 완전한 영상 생성 평가가 부족했다. Code2Video-Compass는 텍스트-영상(T2V), 이미지-영상(I2V), 영상-영상(V2V) 세 형식을 아우르는 범용 벤치마크로 10개 카테고리, 24개 세부 유형의 2,104개 과제를 포함한다. 전체 요약 7문장 읽기 → 048 12:11 ▲ 162 · 댓글 75 LLM으로 대규모 소프트웨어 형식 검증이 현실화되다 Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. AI · 머신러닝 · LLMs are making formal software verification feasible at a much larger scale
Key Point 형식 검증이 역사적으로 수십 년의 전문 인력을 요구했으나, LLM이 이 비용을 획기적으로 낮추면서 일반 소프트웨어 개발에도 적용 가능해졌고, 향후 소프트웨어 보안 수준을 크게 변화시킬 기술이기 때문이다.
핵심 요약
Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. 개발자의 퍼지 테스트(fuzz test)를 자동으로 형식 사양으로 변환해 증명했으며, 239개 엔트리포인트에서 64MB 이하 모든 입력에 대해 크래시가 없음을 증명했다. 총 약 1억 8천만 줄의 Rocq 증명을 작성했고, 전형적인 증명은 약 60만 줄의 코드로 18,000개 RISC-V 명령어에 대한 보안 보장을 제공한다. 전체 요약 13문장 읽기 → 049 09:11 ▲ 101 · 댓글 28 580만 점 미술 작품을 의미론으로 검색하는 'The Last Museum' 주요 미술관의 580만 점 미술 작품 데이터베이스에 대해 의미론적 검색(semantic search)을 수행할 수 있는 'The Last Museum' 플랫폼을 공개했다. 기타 · The Last Museum: Semantic search across 5.8M artworks from major museums
Key Point 미술관의 광대한 컬렉션을 의미론적으로 탐색할 수 있게 되면서 전통적인 메타데이터 검색의 한계를 넘어 미술 작품 발견 경험이 크게 달라진다.
핵심 요약
주요 미술관의 580만 점 미술 작품 데이터베이스에 대해 의미론적 검색(semantic search)을 수행할 수 있는 'The Last Museum' 플랫폼을 공개했다. 호쿠사이의 '나미 아래', 베르메르의 '진주 귀걸이를 한 소녀', 반 고흐의 '별이 빛나는 밤', 뭉크의 '절규' 등 미술사상 명작들을 포함한 광범위한 작품 컬렉션을 수록했다. 전통적인 키워드 검색이 아닌 의미론적 접근으로 사용자가 찾는 이미지의 의미·분위기·구성을 바탕으로 유사한 미술 작품을 발견할 수 있다. 전체 요약 4문장 읽기 → 050 03:11 ▲ 26 · 댓글 1 LLM이 정량 트레이딩 전략을 실제로 만들 수 있을까 정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. AI · 머신러닝 · Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
Key Point 현재 최고 수준의 LLM들도 실제 시장 데이터에서 시계열 검증을 통과하는 거래 전략을 만들지 못하는 것으로 나타났으며, 이는 생성형 AI의 금융 적용 한계를 보여준다.
핵심 요약
정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. Quant-Arena은 중국 A주 실제 시장 데이터로 LLM이 전체 루프를 완성하고 연구 기간 이후에도 작동하는 전략을 만들 수 있는지 측정하는 벤치마크와 공개 리더보드다. 모델은 특성과 주식 스코어링 코드를 구성하고, 2022~2023년 데이터로만 피드백을 받은 뒤, 폐쇄된 2024년 데이터로 평가받을 하나의 전략을 확정한다. 전체 요약 7문장 읽기 → 051 21:11 ▲ 116 · 댓글 61 LLM의 신뢰도 점수는 신뢰할 수 없다 LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. AI · 머신러닝 · Using LLM for confidence scoring is a bad idea
Key Point LLM이 생성한 신뢰도 점수는 단순 텍스트 생성일 뿐 실제 확률을 반영하지 않으므로, AI 에이전트의 신뢰성을 검증해야 하는 개발자들이 알아야 할 근본적인 한계다.
핵심 요약
LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. 신뢰도란 예측이 얼마나 정확한지를 나타내는데, 이는 과거 정보와 현재 증거를 바탕으로 한 계산이어야 한다. 신뢰도 점수의 정확성은 같은 조건의 많은 사례에서 예측 확률과 실제 발생률이 일치하는지(보정도)로만 측정할 수 있다. 전체 요약 9문장 읽기 → 052 18:11 ▲ 25 · 댓글 2 AI 에이전트, 과학 모델 개선에서 얼마나 성과낼까 연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. AI · 머신러닝 · Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?
Key Point 실제 과학 문제 해결에서 AI 에이전트의 현재 수준을 정량적으로 파악할 수 있으며, 단순 하이퍼파라미터 조정을 넘어 진정한 과학적 창의성이 부족한 부분이 명확해진다.
핵심 요약
연구팀이 Agent4Sci라는 테스트베드를 개발해 최신 AI 에이전트들이 과학 ML 벤치마크의 발표된 최고 성능을 어디까지 개선할 수 있는지 측정했다. 11개 분야의 20개 벤치마크를 대상으로 평가했을 때, Claude Opus는 평균 10.4%의 상대적 성능 개선을 달성했으며 모든 실행에서 학문적 부정행위 없이 진행되었다. 하지만 이 개선 사항은 거의 전부가 데이터 전처리, 하이퍼파라미터 조정, 앙상블 같은 표준 ML 엔지니어링 기법에서 비롯되었으며 실제 과학적 통찰력은 부족했다. 전체 요약 6문장 읽기 → 053 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 054 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 055 15:11 ▲ 72 · 댓글 2 게임 세계에서 스케일링: 구체화 에이전트의 지속적 사전학습 연구팀이 가상 세계에서 데이터 규모, 다양성, 모델 크기가 구체화 에이전트 학습에 미치는 영향을 조사했다. AI · 머신러닝 · Scaling in Games: Continued Pre-Training For Embodied Agents In Diverse Virtual Worlds
Key Point 게임 환경에서 LLM의 스케일링 법칙을 실증적으로 검증한 첫 대규모 연구로, 에이전트 AI의 일반화 능력과 학습 데이터 다양성 간의 관계를 정량적으로 보여준다.
핵심 요약
연구팀이 가상 세계에서 데이터 규모, 다양성, 모델 크기가 구체화 에이전트 학습에 미치는 영향을 조사했다. 0.8B~27B 모델 4종, 50~1,600시간 데이터 6개 규모, Minecraft 단독부터 다중 게임 혼합 데이터 5가지 조합으로 총 120가지 설정을 학습했다. 결과적으로 더 많은 데이터는 학습 데이터 포함 게임 성능을 높이고, 다양성은 유사 게임으로의 전이는 개선하나 거리가 먼 게임으로의 일반화는 제한적이었다. 전체 요약 8문장 읽기 → 056 03:11 ▲ 244 · 댓글 123 PHP 긴급 업데이트 공개, 원격 코드 실행 취약점 2개 패치 PHP는 오늘 PHP 8.5.12, 8.4.27, 8.3.36, 8.2.35를 릴리스하여 비인증 공격자의 원격 코드 실행을 허용하는 2개의 심각한 취약점을 패치했다. 보안 · Today's PHP security release, and how we're strengthening security
Key Point PHP의 심각한 보안 취약점이 실제 공격에 노출되기까지의 과정과 조직적 한계, 그리고 개선 방향을 이해해야 자신의 시스템 보안 대응이 필요한지 판단할 수 있다.
핵심 요약
PHP는 오늘 PHP 8.5.12, 8.4.27, 8.3.36, 8.2.35를 릴리스하여 비인증 공격자의 원격 코드 실행을 허용하는 2개의 심각한 취약점을 패치했다. 두 취약점 모두 메모리 관리와 에러 처리 영역에 있어 거의 모든 PHP 요청이 영향을 받으므로 심각하며, 기존 호환성 유지와 성능 손실 없이 수정하기 어려웠다. 2024년 PHP 재단은 Sovereign Tech Agency 펀딩으로 Quarkslab의 첫 외부 보안 감사를 받았고, 감사 과정에서 PHP 개발자가 OOM(Out of Memory) 문제의 초기 신호를 발견했다. 전체 요약 11문장 읽기 → 057 00:11 ▲ 18 · 댓글 2 장시간 비디오에서 사건 추론하는 새로운 과제 Event-STVG 제시 기존 시공간 비디오 그라운딩(STVG)은 자연어 질의로부터 비디오 내 대상을 시간과 공간에 걸쳐 정확히 찾는 작업이었으나, 개별 인스턴스 설명에만 초점을 맞춰 장시간 추론 능력이 부족했다. AI · 머신러닝 · Event-STVG: Spatio-Temporal Video Grounding for Long-Form Event Reasoning
Key Point 비디오 이해 AI의 현재 한계를 실제 벤치마크로 검증하며, 장시간 사건 추론이라는 새로운 요구에 맞춘 모델 개발 방향을 제시한다.
핵심 요약
기존 시공간 비디오 그라운딩(STVG)은 자연어 질의로부터 비디오 내 대상을 시간과 공간에 걸쳐 정확히 찾는 작업이었으나, 개별 인스턴스 설명에만 초점을 맞춰 장시간 추론 능력이 부족했다. Event-STVG는 STVG를 단순 객체 검색에서 사건 수준의 추론으로 확장하는 새로운 과제로, 장시간 문맥 이해, 반복되는 사건 구분, 사건 위치 파악, 역할 추론, 다중 대상 그라운딩을 통합한다. 축구를 포함한 8개 도메인에서 총 4,016개의 사건 발생을 주석 처리한 대규모 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 058 00:11 ▲ 110 · 댓글 46 코드베이스도 '파이프처럼' 낡는다, AI는 악화만 시킨다 디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. AI · 머신러닝 · The Decoherence Trap
Key Point AI 에이전트가 코드 품질을 악화시키고 기술 부채를 해결하지 못한다는 실증 데이터가 나오는 시점에, 현재의 자동화 전략이 왜 실패하는지를 이해하는 것이 중요하다.
핵심 요약
디코히어런스는 지역적으로 유효하지만 서로 양립 불가능하거나 중복된 모델들이 누적되어 변경 비용이 모델 간 번역과 부작용 방지로 지배당하는 상태를 설명한다. 시스템 변경 속도에 비례하여 증가하며, 시스템이 이미 디코히어런트할수록 지수적으로 증가한다. 현재 AI의 광범위한 사용으로 인해 지속 불가능한 속도로 발생하고 있다. 전체 요약 15문장 읽기 → 059 21:11 ▲ 101 · 댓글 64 독립 개발자를 위한 자동 비상 알림 도구 'Death Plan Switch' 오픈소스 공개 개발자가 주 1회 체크인 이메일에 응하지 않으면 자동으로 비상 연락망을 알리는 셀프호스팅 서비스다. 오픈소스 · 도구 · Show HN: Death Plan Switch, a self-hosted dead man's switch for solo devs
Key Point 일인 사업가나 중요 정보 관리 책임이 있는 개발자가 예기치 못한 상황에서도 관계자들이 적절히 알림을 받도록 자동화할 수 있다.
핵심 요약
개발자가 주 1회 체크인 이메일에 응하지 않으면 자동으로 비상 연락망을 알리는 셀프호스팅 서비스다. 24시간 뒤 상기 메일, 48시간 뒤 마지막 경고, 72시간 뒤 지정한 가족·친구에게 질문, 120시간 뒤 모두에게 알림 메시지를 보낸다. 가족이 '괜찮다'고 응답하면 중단되고, 아무도 응답하지 않으면 미리 작성한 메시지가 모든 연락처에 전달된다. 전체 요약 10문장 읽기 → 060 18:11 ▲ 18 · 댓글 2 음성-영상 추론의 '증거' 까지 평가하는 벤치마크 Omni LLM의 음성·영상 추론 능력을 평가하는 기존 벤치마크는 객관식 정답 정확도만 측정해, 모델이 실제로 근거에서 답까지 추론 연쇄를 형성했는지 알 수 없다는 문제가 있다. AI · 머신러닝 · EvaOmni: An Evidence-Grounded Benchmark for Audio-Visual Reasoning
Key Point Omni LLM이 정말 멀티모달 증거를 분석해 추론하는지를 평가할 수 있는 첫 벤치마크로, 기존 객관식 평가의 근본적인 한계를 드러내고 더 엄격한 평가 기준을 제시한다.
핵심 요약
Omni LLM의 음성·영상 추론 능력을 평가하는 기존 벤치마크는 객관식 정답 정확도만 측정해, 모델이 실제로 근거에서 답까지 추론 연쇄를 형성했는지 알 수 없다는 문제가 있다. 텍스트나 단일 모달리티만으로 정답을 맞힐 수 있는 '숏컷'이 존재해 진정한 음성-영상 분석 없이도 높은 점수를 얻을 수 있다. 이를 해결하기 위해 392개 비디오와 1,027개 인간 주석 질문-답변 쌍으로 구성된 EvaOmni 벤치마크를 공개했다. 전체 요약 10문장 읽기 → 061 18:11 ▲ 22 · 댓글 2 AI 에이전트가 자신의 인터페이스를 진화시킨다 기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. AI · 머신러닝 · Evolving Agent Interfaces
Key Point AI 에이전트가 직접 자신의 작업 인터페이스를 설계·최적화하면서 더 작은 모델로 기존의 고사양 모델을 능가하는 성과를 낸 것으로, 컴퓨터 사용 에이전트의 성능 향상 경로가 근본적으로 바뀔 수 있음을 보여준다.
핵심 요약
기존 컴퓨터 사용 에이전트는 인간이 정해준 고정된 인터페이스로만 작동하는데, 메모리셀 단위 입력처럼 비효율적인 작업을 반복하거나 파일 전체를 출력하는 등의 한계를 가지고 있다. 연구팀은 인터페이스 설계 자체를 에이전트의 능력으로 만들어야 한다고 주장하며 Agent S4를 제안했다. Agent S4는 메타 에이전트가 합성 훈련 작업에서 태스크 에이전트의 궤적을 분석하고, 성공 라벨 없이 인터페이스와 사용 지식을 자동으로 구축·수정하는 인터페이스 저장소를 관리한다. 전체 요약 8문장 읽기 → 062 16:56 ▲ 146 · 댓글 81 영국 통신청, 4chan 제재 포기 선언 영국의 방송통신청(Ofcom)이 의회 청문회에서 외국 법원의 관할권 앞에선 한계를 인정했다. 보안 · Ofcom Concedes Defeat in the 4chan Case
Key Point 미국 법원의 판례가 영국 규제 기관의 검열 권력을 실질적으로 좌절시킨 사건으로, 외국 정부의 온라인 검열 시도에 저항하려는 미국과 기타 국가 기업·단체들에게 법적 선례를 제공한다.
핵심 요약
영국의 방송통신청(Ofcom)이 의회 청문회에서 외국 법원의 관할권 앞에선 한계를 인정했다. 온라인안전법(Online Safety Act) 위반으로 부과한 벌금을 미국에서 회수할 수 없다고 Ofcom 최고경영자 데임 멜라니 도스가 공식 진술했다. 미국 콜럼비아특별구 연방지방법원은 2025년 4chan v. Ofcom 판례에서 '4chan에 미국 내 인프라가 없으므로 미국 법원을 통해서만 집행 가능하며, 미국 법원은 헌법 위반 외국 판결을 집행하지 않는다'고 명시했다. 전체 요약 10문장 읽기 → 063 15:11 ▲ 154 · 댓글 2 반복 모델이 긴 문제를 푸는 법: 진행도 정렬 재귀 반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. AI · 머신러닝 · PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking
Key Point 반복 모델의 길이 외삽 성능을 16배까지 개선하는 기법이 제시되어, 재귀 신경망의 일반화 한계를 다루는 근본적인 접근 방식을 보여준다.
핵심 요약
반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. 순차적 상태 추적 작업에서 최종 답변 감독만으로는 각 반복이 얼마나 진행해야 하는지 명시하지 않으며, 반복된 업데이트가 재귀 상태의 스케일을 변화시킨다. PAR(Progress-Aligned Recurrence)는 k번째 반복의 예측을 처음 k개 연산 후의 상태와 일치하도록 학습하고, 재귀 상태를 첫 반복의 규범으로 정규화한다. 전체 요약 10문장 읽기 → 064 12:11 ▲ 26 · 댓글 3 실시간 변경되는 업무 기록을 다루는 AI의 한계 측정 팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. AI · 머신러닝 · MMEnterprise-Bench: Evaluating Enterprise Agents over Evolving Multimodal Records
Key Point 엔터프라이즈 AI가 현실의 복잡한 협업 환경에서 정보 충돌과 불일치를 처리하는 방식의 근본적 한계를 측정한 첫 번치마크로, 기업용 AI 에이전트 개발의 방향을 제시한다.
핵심 요약
팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. 시뮬레이션된 협업 프로젝트의 멀티모달 기록 1,613개 질문으로 구성되며, 증거 추론(Evidence Reasoning), 충돌 해결(Conflict Resolution), 답변 불가능 인식(Unanswerability) 세 가지 범주를 포함한다. 프로펠리어터리(상용) 및 오픈소스 멀티모달 LLM 10개를 평가한 결과, 가장 성능이 좋은 모델들도 출처나 시간이 다른 정보가 충돌할 때, 또는 증거가 여러 이미지에 걸쳐 있을 때 정확도가 급격히 떨어진다. 전체 요약 6문장 읽기 → 065 09:11 ▲ 142 · 댓글 63 AI 코딩 에이전트 벤치마크, 고사양 세팅이 역효과 SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. AI · 머신러닝 · SlopCodeBench 10/2026 – Opus 5.5, Astra wins overall, xhigh considered harmful
Key Point 코딩 에이전트의 실제 성능을 측정하는 벤치마크에서 higher-effort 설정이 역효과를 낼 수 있다는 결과는 AI 모델 평가 방식 자체를 재검토하게 하며, 에이전트 기반 개발 도구의 현실적 한계를 드러낸다.
핵심 요약
SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. Opus 5.5는 Medium 세팅에서 28/196 strict pass를 기록했지만, XHigh 세팅에서는 25/196으로 하락했는데, XHigh는 Medium 대비 2.11~4.22배 높은 비용이 든다. Opus 5.5의 경우 strict pass는 감소했으나 코드 정결성 점수가 94.25%에서 77.75%로 크게 개선되어, 더 많은 추론이 항상 더 나은 결과를 보장하지 않음을 시사한다. 전체 요약 8문장 읽기 → 066 21:11 ▲ 23 · 댓글 2 AI가 실사진으로 3D 모델 만드는 능력을 재보다 멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. AI · 머신러닝 · BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
Key Point LLM 기반 AI 에이전트가 3D 모델링 작업을 수행할 수 있게 되면서, 실무 수준의 성능 평가 기준이 필요해졌고, 이 벤치마크가 현재 모델들의 공간 추론 능력의 한계를 명확히 드러낸다.
핵심 요약
멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. 기존 벤치마크는 현실 시나리오에 걸친 열린 형태의 요청을 제한적으로 다루고 있어, 이 간극을 메우기 위해 BlenderWorld 벤치마크를 개발했다. BlenderWorld는 건축·제품·자연환경·과학 시각화 분야의 223개 과제로 구성되며, 텍스트·이미지·비디오·구조화된 명세서를 입력으로 받는다. 전체 요약 6문장 읽기 → 067 21:11 ▲ 23 · 댓글 2 로봇 가치 모델 평가 벤치마크 RoboValue 공개 로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. AI · 머신러닝 · RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
Key Point 로봇 가치 모델의 신뢰성을 체계적으로 평가하기 위한 첫 번째 통합 벤치마크로, 기존 평가 방식의 한계를 드러내고 정책 학습의 피드백 품질 개선 방향을 제시한다.
핵심 요약
로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. 시뮬레이션과 실제 환경을 통합한 RoboValue 벤치마크는 네 가지 능력 차원을 평가한다: 작업-상태 이해, 시간 진행 모니터링, 실패 및 회복 추론, 가치 일관성. RoboValue-Dataset은 15개 시뮬레이션 및 20개 실제 로봇 조작 작업을 포함하며, 전문가 시연 데이터와 세밀한 평가용 주석 데이터를 제공한다. 전체 요약 6문장 읽기 → 068 21:11 ▲ 20 · 댓글 2 세밀한 기하학 표현으로 3D 재구성 정확도 높인 FineSplat Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. AI · 머신러닝 · FineSplat: Fine Patches, Local Groups, Detailed Splats
Key Point Feed-forward 3D 재구성의 정확도를 크게 높이는 방법론이 필요한 상황에서, 토큰 그룹화와 렌더링 피드백을 결합해 계산 효율과 복원 품질을 동시에 개선한 접근법을 제시한다.
핵심 요약
Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. 고해상도 토큰에서 다중뷰 어텐션이 계산상 비효율적이므로, 뷰 기반 그룹화로 인접 뷰들 간 상호작용을 효율화하고 3D 공간 그룹화로 기하학적으로 연관된 토큰들을 재연결한다. 렌더링 오류를 직접 피드백으로 활용하여 세밀한 구조와 외관 복원을 위한 명시적 신호를 제공하고 단일 pass 방식의 한계를 극복한다. 전체 요약 5문장 읽기 → 069 18:11 ▲ 81 · 댓글 2 MRL 개선한 SpecMRL, 절반 차원으로 전체 성능 달성 Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. AI · 머신러닝 · SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
Key Point 벡터 압축 기술이 검색·추천·분류 등 다양한 AI 서비스의 성능과 비용을 결정하는데, MRL의 핵심 한계를 해결하고 절반의 용량으로 같은 품질을 달성한 방법론이다.
핵심 요약
Matryoshka Representation Learning(MRL)은 유연한 표현 크기를 지원하도록 중첩된 접두사를 공동 최적화하지만, 앞부분이 적절한 압축 인코딩을 제공한다는 명시적 제약이 부족하다. 이를 해결하기 위해 SpecMRL을 제안하는데, 특성 중요도로 조직된 매개변수 파생 스펙트럼 기반을 추가하여 피처 공간을 재구성한다. SpecMRL은 표준 MRL을 따르면서 학습된 스펙트럼 공간에서 접두사 읽기를 수행한다. 전체 요약 6문장 읽기 → 070 18:11 ▲ 28 · 댓글 2 LLM 에이전트의 메모리 효율화, 강화학습으로 최적화 LLM 에이전트 시스템에서 메모리는 상호작용 간 정보 보유와 재사용을 지원하지만, 기존 방식은 쿼리를 고려하지 않고 메모리를 구축해 불필요한 전처리 비용과 정보 손실을 초래한다. AI · 머신러닝 · MemPilot: Orchestrating On-Demand Multimodal Memory Curation for LLM Agents
Key Point LLM 에이전트가 상황에 맞게 메모리 처리 비용을 조절할 수 있게 함으로써, 가격과 속도 제약이 있는 실제 배포 환경에서 실용적인 선택지를 제공한다.
핵심 요약
LLM 에이전트 시스템에서 메모리는 상호작용 간 정보 보유와 재사용을 지원하지만, 기존 방식은 쿼리를 고려하지 않고 메모리를 구축해 불필요한 전처리 비용과 정보 손실을 초래한다. MemPilot은 성능·비용·지연 시간 우선순위에 따라 요청 시 메모리를 정리하는 유연한 프레임워크를 제시한다. 강화학습으로 최적화한 다단계 정책을 통해 사전 구축 메모리 검색과 쿼리 특화 정리 중 선택하며, 증거량·정리 지시·모델 선택·이미지 접근을 통합 제어한다. 전체 요약 7문장 읽기 → 071 15:11 ▲ 28 · 댓글 2 LLM 에이전트의 능동적 탐색과 적응 능력 측정 벤치마크 등장 LLM 에이전트가 변화하는 환경에서 자동으로 환경을 탐색하고 규칙을 발견하며 적응해야 하는데, 이를 테스트하는 벤치마크가 부족하다는 문제를 해결하기 위해 AdaExploreBench가 제안됐다. AI · 머신러닝 · AdaExploreBench: Benchmarking LLM Agents for Proactive Exploration and Test-time Adaptation in Evolving Environments
Key Point LLM 에이전트가 실제 배포 환경에서 변화하는 규칙에 독립적으로 대응할 수 없다는 기본 한계를 실증적으로 드러내며, 에이전트 개발에 필요한 핵심 개선 방향을 구체적으로 제시한다.
핵심 요약
LLM 에이전트가 변화하는 환경에서 자동으로 환경을 탐색하고 규칙을 발견하며 적응해야 하는데, 이를 테스트하는 벤치마크가 부족하다는 문제를 해결하기 위해 AdaExploreBench가 제안됐다. AdaExploreBench는 환경의 숨겨진 규칙을 에이전트가 능동적으로 발견해야 하고, 규칙이 예고 없이 바뀌는 상황(implicit rule drift)에서 성능 저하를 감지해 재탐색해야 한다. GPT-4o, Claude 3.5 등 8개 최신 LLM으로 실험한 결과 GPT-4o가 61.9% 정확도를 기록했으며, 능동적이고 적응적인 탐색은 현재 모델들에게 여전히 매우 어려운 과제로 나타났다. 전체 요약 4문장 읽기 → 072 15:11 ▲ 32 · 댓글 2 월드 모델의 일반화 능력을 평가하는 AnyGoal 벤치마크 공개 월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. AI · 머신러닝 · AnyGoal: On World Model Generalization Beyond Expert Rollouts
Key Point 월드 모델의 진정한 일반화 능력을 측정하는 표준화된 벤치마크가 부족한 상황에서, 구성적 일반화 실패 사례들을 체계적으로 드러내는 평가 도구가 제시되어 향후 모델 개선 방향을 명확히 제시한다.
핵심 요약
월드 모델이 환경 역학을 정확히 학습해도, 학습 데이터에 없던 상태-행동 조합에서는 신뢰할 수 없다는 문제를 다룬 논문이다. 연구팀은 AnyGoal이라는 벤치마크와 오픈소스 라이브러리를 공개했으며, 기존 월드 모델 환경들을 변형해 새로운 목표를 가진 태스크 변이체들을 만들었다. 각 태스크는 개별 상태 요소와 행동들은 학습 범위 내에 있지만, 그 조합은 전문가 궤적에서 거의 나타나지 않도록 설계되었다. 전체 요약 6문장 읽기 → 073 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 074 00:11 ▲ 104 · 댓글 69 Tmux로 AI 에이전트를 운영하는 법 Tmux는 AI 코딩 에이전트를 독립된 세션에서 실행하며, 터미널을 닫아도 프로세스는 계속 동작하고 재접속 시 그대로 복구된다. 인프라 · 데브옵스 · Tmux and Claude Code: Sessions, Send-Keys, and the Ceiling
Key Point 여러 AI 에이전트를 동시에 실행할 때 각 에이전트의 상태 추적, 입력 관리, 기록 보존을 어떻게 구현할지 실무 예제와 한계가 명확히 제시되므로, AI 에이전트 운영 인프라를 구축하는 개발자에게 필수 참고자료다.
핵심 요약
Tmux는 AI 코딩 에이전트를 독립된 세션에서 실행하며, 터미널을 닫아도 프로세스는 계속 동작하고 재접속 시 그대로 복구된다. Claude Code의 최신 버전은 --worktree --tmux 플래그로 자동 설정을 지원하지만, 여러 에이전트 관리, 스크립팅, 원격 실행은 수동으로 구성해야 한다. 세션은 프로젝트 단위로 명명하고, 각 작업마다 윈도우를 만들며, send-keys로 스크립트에서 에이전트에 입력할 수 있다. 전체 요약 9문장 읽기 → 075 00:11 ▲ 115 · 댓글 23 동물실험 대체 기술, 규제 승인으로 본격화되다 17년 전 하버드 와이스 생물의학공학연구소의 도널드 잉거 팀은 폐 기능을 재현하는 칩 기술을 개발했는데, 초기에 과학 잡지 편집자들이 검증을 위해 쥐 실험도 병행할 것을 요청했다. 하드웨어 · 시스템 · Alternatives to Animal Testing Are Finally Taking Off
Key Point 규제 기준이 처음으로 동물실험에서 대체 기술로 역전되었으며, 미국·유럽 당국의 정책 전환이 과학 문화 변화의 장벽을 넘게 될 기술과 시스템을 어떻게 확산할 것인가가 핵심 과제다.
핵심 요약
17년 전 하버드 와이스 생물의학공학연구소의 도널드 잉거 팀은 폐 기능을 재현하는 칩 기술을 개발했는데, 초기에 과학 잡지 편집자들이 검증을 위해 쥐 실험도 병행할 것을 요청했다. 장기칩(organ-on-chip)은 인간의 조직과 장기 구조를 미세유체 채널에서 재현하는 기술로, 기존 정적 조직 배양과 달리 호흡이나 맥동 같은 생리적 움직임을 모사한다. 동물실험 대체 기술을 통칭하는 NAM(nonanimal methods)은 장기칩, 오르가노이드, 계산 시뮬레이션, AI 분석 도구 등으로 구성되며, 기존 동물 모델의 한계(임상 시험 진입 약물 92%가 시장 진출 실패)를 극복하려는 시도다. 전체 요약 13문장 읽기 → 076 18:11 ▲ 11 · 댓글 2 AI 연구원들의 판단력 평가하는 벤치마크 등장 대규모 언어모델(LLM) 에이전트는 인간 감독 없이 수개월간 과학 실험을 진행할 수 있지만, 신뢰할 수 있는 자율 연구를 위해서는 과학적 판단력이 필수다. AI · 머신러닝 · SciΠvot: Benchmarking Principal-Investigator Judgment at Pivotal Moments of Scientific AutoResearch Agents
Key Point AI 에이전트가 과학 연구를 독립적으로 수행하는 시대에, 최첨단 모델조차 인간 연구자의 수정을 이기지 못하고 있다는 구체적인 벤치마크 결과가 자율 AI 연구의 현실적 한계를 드러낸다.
핵심 요약
대규모 언어모델(LLM) 에이전트는 인간 감독 없이 수개월간 과학 실험을 진행할 수 있지만, 신뢰할 수 있는 자율 연구를 위해서는 과학적 판단력이 필수다. 연구팀이 SciΠvot이라는 248개 사례 벤치마크를 개발했는데, 이는 6개월간 6개 학문 분야 26개 프로젝트에서 고급 연구자들이 LLM 에이전트를 운영하며 반복적으로 개입한 기록을 바탕으로 한다. 각 사례에서 에이전트는 프로젝트 초기 기록만을 맥락으로 하여 원래 LLM 계획과 인간이 수정한 대안 중 하나를 선택해야 한다. 전체 요약 8문장 읽기 → 077 15:11 ▲ 286 · 댓글 3 VLM이 로봇을 직접 코딩하다, HexaShell의 도전과 한계 비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. AI · 머신러닝 · HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
Key Point 로봇 조종을 위한 VLM 에이전트가 시각 기반 자율 학습으로 최고 성능을 달성했으나, 정밀한 접촉 제어에서 근본적인 한계를 드러내며 향후 로봇 AI 개발의 방향을 제시한다.
핵심 요약
비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. HexaShell은 최소한의 인터페이스를 유지하며 에이전트의 명령을 로봇 동작으로만 변환하고, 양팔 로봇을 단일 명령줄로 구동하며 RGB 카메라 3개와 카메라 캘리브레이션 정보를 제공한다. 실패 후 에이전트는 로그를 읽고 원인을 파악한 뒤 작은 프로그램(도구)을 작성하거나 수정하며, 이렇게 학습한 내용을 코드로 유지한다. 전체 요약 10문장 읽기 → 078 15:11 ▲ 38 · 댓글 3 AI 에이전트의 과학적 추론 능력 평가, 논문으로 검증 AI 에이전트가 과학적 조사를 체계적으로 진행하여 증거 기반의 결론에 도달할 수 있는지 평가하기 위해 PhysClosureBench 벤치마크를 개발했다. AI · 머신러닝 · From Research Goals to Scientific Closure: Evaluating Agents Through Evidence-Supported Physics Research
Key Point 현재 최강 LLM들도 과학 논문 같은 구조화된 조사 완수에 약한 부분을 정량적으로 입증함으로써, AI의 과학 응용 가능성의 현주소를 보여준다.
핵심 요약
AI 에이전트가 과학적 조사를 체계적으로 진행하여 증거 기반의 결론에 도달할 수 있는지 평가하기 위해 PhysClosureBench 벤치마크를 개발했다. 벤치마크는 강장 물리, 아토초 물리 등 50개 물리학 연구 과제로 구성되며, 각 과제는 목표와 과학적 제약조건을 명시하고 에이전트가 증거 생성과 검증 방법을 결정하도록 한다. 평가 지표는 지역적 과학적 성과를 측정하는 20개 기준의 Atomic Score와 필수 증거 요구사항 충족 여부로 연구 폐결(RC0~RC4)을 5단계로 평가한다. 전체 요약 7문장 읽기 → 079 12:11 ▲ 180 · 댓글 3 장기 자동화 에이전트의 실제 제약 검증 벤치마크 BizBench 공개 기존 장기 자동화 에이전트 벤치마크는 최종 성공 여부만 중시하며 중간 실행의 유효성을 제대로 평가하지 못하는 한계가 있다. AI · 머신러닝 · BizBench: Unveiling Hidden Challenges in Deploying Long-Horizon Agents for Real-World Business
Key Point 최고 성능 모델도 엄격한 제약 조건 평가에서는 60% 이하의 성공률을 보여주며, 결제·금융처럼 중간 단계 오류가 실제 손실을 초래하는 분야에서 에이전트의 신뢰성을 어떻게 평가할지 규정한 첫 벤치마크다.
핵심 요약
기존 장기 자동화 에이전트 벤치마크는 최종 성공 여부만 중시하며 중간 실행의 유효성을 제대로 평가하지 못하는 한계가 있다. 현실의 비즈니스 운영, 특히 결제 같은 고위험 도메인에서는 에이전트가 복잡한 정책을 따르면서 실행 전 과정에서 제약 조건을 만족해야 한다. 연구팀이 결제 회사의 실제 운영 절차를 기반으로 BizBench 벤치마크를 개발했다. 전체 요약 9문장 읽기 → 080 12:11 ▲ 287 · 댓글 2 GPT-6-Astra, 로봇 지능의 한계 진단 GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. AI · 머신러닝 · Has GPT-6-Astra Achieved Embodied Intelligence?
Key Point 로봇 지능이 실험실 성과와 현장 적용 사이의 격차를 드러내므로, 다음 세대 로봇 AI 개발 방향을 예측하는 데 필요하다.
핵심 요약
GPT-6-Astra를 로봇 조작·항법 작업에 평가한 결과, 12개 벤치마크(탁상형 조작, 휴머노이드, 이동 로봇, 손가락 제어)에서 학습 데모로부터의 맥락 학습(ICL)을 활용해 전례 없는 성능을 달성했다. 향후 개선 방향으로 ICL의 일반화, 비용·실행 시간 단축, 물리 상태 검증, 불가역적 실패 복구, 장기 작업 진행 상황 유지 등 5가지를 제시했다. 고수준 추론기(GPT-6-Astra)와 저수준 제어기(π0.5) 간 폐루프 조율이 비용이 높지만 효과적임을 확인했다. 전체 요약 6문장 읽기 → 081 06:11 ▲ 110 · 댓글 82 자바 sealed 클래스, 컴파일 시점의 한계와 위험 Java 17의 sealed 클래스는 인터페이스나 기본 클래스의 하위 타입을 명시적으로 제한하여, 패턴 매칭 시 모든 경우를 다뤘는지 컴파일러가 검증할 수 있게 해준다. 웹 · 프론트엔드 · Java sealed classes and exhaustive pattern matching
Key Point sealed 클래스의 exhaustive pattern matching이 모든 문제를 해결하지 못하며, 특히 공개 API에 사용될 때 예상 밖의 런타임 에러를 초래할 수 있다는 실제 위험을 설명한다.
핵심 요약
Java 17의 sealed 클래스는 인터페이스나 기본 클래스의 하위 타입을 명시적으로 제한하여, 패턴 매칭 시 모든 경우를 다뤘는지 컴파일러가 검증할 수 있게 해준다. sealed 인터페이스/클래스에 switch 식을 사용하면 컴파일러가 모든 경우를 확인했는지 판단하여, 누락된 경우가 없다면 default 절을 생략해도 되므로 코드 안전성이 높아진다. 하지만 새로운 하위 타입을 sealed 클래스에 추가하는 것은 기존 코드의 switch 문을 깨뜨리므로 주요 버전 업그레이드가 필요한 breaking change가 된다. 전체 요약 6문장 읽기 → 082 15:11 ▲ 105 · 댓글 61 쿠버네티스, 회의론자의 눈으로 본 핵심 개념 오래된 인프라 경험으로 쿠버네티스에 대해 근거 없이 회의적이던 개발자가 실제로 학습한 내용을 정리했다. 인프라 · 데브옵스 · A skeptic's first contact with Kubernetes (2024)
Key Point 오래 무시해온 기술에 대해 실제로 개념을 이해한 후 장점과 설계 문제를 동시에 분석한 관점으로, 쿠버네티스의 핵심을 깔끔하게 이해할 수 있다.
핵심 요약
오래된 인프라 경험으로 쿠버네티스에 대해 근거 없이 회의적이던 개발자가 실제로 학습한 내용을 정리했다. 쿠버네티스의 핵심 가치는 Control Loop(컨트롤러가 원하는 상태를 계속 관찰·유지)와 Service(안정적 IP·DNS·로드밸런싱을 제공하는 네트워킹 추상화)의 두 가지 개념에서 나온다. Pod는 작업 단위, Node는 쿠버네티스 에이전트를 실행하는 컴퓨터, Service는 Pod 집합의 논리적 그룹화, Namespace는 클러스터의 논리적 구분이다. 전체 요약 10문장 읽기 → 083 12:10 ▲ 10 · 댓글 2 GQA의 3가지 딜레마를 동시에 푸는 Virtual Head Attention 긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. AI · 머신러닝 · Virtual Head Attention
Key Point KV 캐시 메모리와 학습 효율, 모델 품질의 균형을 동시에 달성해야 하는 LLM 개발자들이 GQA의 근본적 한계를 극복할 수 있는 방법을 제시합니다.
핵심 요약
긴 문맥 처리 시 KV 캐시 크기, 학습·프리필 연산량, 모델 품질을 동시에 개선하기는 어렵다는 '불가능의 삼각형'에 직면한 어텐션 메커니즘 설계에 대응하기 위해 Virtual Head Attention(VHA)을 제안한다. VHA는 두 개의 경량 선형 연산으로 구성되는데, Q Premix가 쿼리 헤드 개수를 절반으로 줄인 상태에서 KV 그룹 내 가상 헤드 다양성을 복구하고, Linear Postmix가 낮은 순위의 I + AB^top 잔여 구조를 통해 헤드 간 특징을 융합한다. VHA는 비선형 연산을 도입하지 않으므로 Premix와 Postmix를 추론 시간에 각각 쿼리 프로젝션과 출력 프로젝션으로 폴드할 수 있어, 표준 GQA-2 아키텍처로 축약되면서 기존의 모든 GQA 추론 최적화를 직접 재사용할 수 있다. 전체 요약 6문장 읽기 → 084 00:10 ▲ 310 · 댓글 121 DeepSeek, V4.1-Flash-1017로 추론·코딩 성능 대폭 개선 DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. AI · 머신러닝 · DeepSeek-v4.1-Flash-1017
Key Point LLM의 성능과 효율성이 함께 개선되는 것이 드문데, 추론·코딩 벤치마크에서 동시에 개선되면서 낮은 비용으로 더 복잡한 작업을 처리할 수 있게 됐다.
핵심 요약
DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. 작업 실행 시간과 출력 길이를 단축해 더 빠르고 낮은 비용으로 작업을 완료할 수 있으며, 여러 에이전트 테스트에서 성능-비용 파레토 한계를 앞당겼다. 벤치마크에서 HLE는 42.6점(기존 36.8점), Terminal-Bench 4.0은 42.3점(기존 31.2점), DeepSWE v1.1은 77.0점(기존 74.2점)을 기록했다. 전체 요약 9문장 읽기 → 085 21:11 당일 +112 AI가 기판 설계까지 한다…KiCAD 네이티브 플러그인 Konnect 공개 Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. AI · 머신러닝 · mixelpixx/Konnect · Rust
Key Point KiCAD 설계 과정을 AI가 직접 담당하는 단계로 발전했으며, 기존 복잡한 다중 언어 아키텍처를 버리고 고성능 단일 바이너리로 재설계한 점이 PCB 개발자의 작업 방식을 크게 바꿀 수 있다.
핵심 요약
Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. 21개 도구 세트에 걸친 228개 도구를 제공하며, 회로도 캡처, PCB 레이아웃과 라우팅, ERC/DRC, 설계 검토, JLCPCB 부품 검색, 참조 회로, 제조 파일 내보내기 등을 지원한다. 기존 KiCAD-MCP-Server(Python/TypeScript)의 한계를 극복하기 위해 Rust로 완전히 새롭게 작성됐으며, 단일 정적 바이너리(20~25MB)로 배포돼 설치 의존성이 없다. 전체 요약 12문장 읽기 → 086 21:11 ▲ 107 · 댓글 80 셀룰로스와 단백질로 강화한 '슈퍼 얼음', 콘크리트 수준의 강도 달성 히브리 대학 연구팀이 식물 기반 셀룰로스 나노크리스탈과 CBM3a-AFPIII 단백질을 얼음에 첨가해 BioPykrete라는 신소재를 개발했다. 하드웨어 · 시스템 · New 'super ice' 10 times stronger, bringing it close to the strength of concrete
Key Point 극지방 건설과 저탄소 건축재료 개발이 주목받는 가운데, 얼음과 생분해성 단백질만으로 콘크리트 수준의 강도를 낸 신소재의 개발 과정과 한계를 알 수 있습니다.
핵심 요약
히브리 대학 연구팀이 식물 기반 셀룰로스 나노크리스탈과 CBM3a-AFPIII 단백질을 얼음에 첨가해 BioPykrete라는 신소재를 개발했다. 이 신소재는 일반 얼음보다 10배 강하며 파괴되기 전에 70배 더 많은 에너지를 흡수할 수 있다. 기존 Pykrete(목재펄프 강화 얼음)와 달리, 셀룰로스 나노크리스탈이 분자 수준에서 균열 확산을 막는 미세 보강제 역할을 하고, CBM3a-AFPIII 단백질이 접착제로 작용한다. 전체 요약 8문장 읽기 → 087 21:11 ▲ 104 · 댓글 105 AI와 함께 일하는 방식, 3년 만에 완전히 달라졌다 ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. AI · 머신러닝 · My old job feels distant now
Key Point 개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다. 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다. 전체 요약 11문장 읽기 → 088 12:11 ▲ 106 · 댓글 2 희소 자동인코더 표현이 얼마나 합성적인지 검증 희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. AI · 머신러닝 · Behavioral Compositionality of Sparse Autoencoder Representations
Key Point SAE 특성이 실제로 신경망 행동을 독립적으로 설명하는지가 오랫동안 미해결 문제였는데, 이 논문이 정량적 측정 방법과 한계를 처음 체계적으로 보여줌으로써 해석가능 AI 연구의 방향을 제시한다.
핵심 요약
희소 자동인코더(SAE)는 신경망 활성화를 희소한 선형 디코딩 특성으로 표현하지만, 이들 특성이 하위 계산에서 덧셈적으로 합성되는지는 불명확했다. 연구팀은 SAE Additivity Residuals(SAR)를 도입해 설명되지 않은 행동 변이를 상호작용 차수별로 측정하며, 모집단 SAR은 정확히 그 차수 이상의 상호작용 에너지 정규화값이다. 학습된 SAE 좌표와 같은 부분공간의 합 보존 무작위 회전을 비교하면, 18개의 모델과 행동 설정 모두에서 학습된 좌표가 더 낮은 1차 잔차를 보인다. 전체 요약 6문장 읽기 → 089 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 090 06:11 ▲ 292 · 댓글 268 AI 벤치마크, 실제 일자리의 90%는 측정 못 한다 AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. AI · 머신러닝 · 90% of US working hours are spent on tasks not covered well by AI benchmarks
Key Point AI 기업과 정책입안자들이 모델의 실제 경제적 영향을 평가할 때 사용하는 벤치마크들이 큰 맹점을 가지고 있으며, 특히 중간 소득 일자리와 물리적 작업에 대한 측정이 심각하게 부족하다는 점이 드러났다.
핵심 요약
AI 벤치마크들이 미국 직업 923개(O*NET 분류)의 작업 중 대부분을 제대로 측정하지 못하고 있다는 분석이 나왔다. 미국 근로시간의 90%가 기존 벤치마크에서 5개 이상의 프롬프트로 커버되지 않는 작업에 사용되고 있다. 923개 직업 중 단 208개만 충분히 벤치마크된 작업(5개 이상 프롬프트)을 보유하고 있으며, 22개 직업군 중 6개는 해당하는 직업이 없다. 전체 요약 10문장 읽기 → 091 03:11 ▲ 11 · 댓글 2 선형 시간 희소 어텐션으로 컨텍스트 길이 확장하기 선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. AI · 머신러닝 · FreeSolo: Linear-time Sparse Attention with Zero-Shot Length Extrapolation
Key Point 트랜스포머의 근본적 한계인 이차 복잡도 문제를 해결하면서도 학습 데이터보다 긴 입력에서도 작동하는 새로운 어텐션 메커니즘의 제안으로, LLM의 컨텍스트 길이 확장이 시급한 현실에서 실질적 개선을 제시한다.
핵심 요약
선형 시간 시퀀스 모델들은 고정된 크기의 상태에 정보를 저장하기 때문에 장문맥 처리에 제약이 있고, 전체 어텐션을 추가하면 이차 비용이 발생한다. 지속적 사전학습(CPT)을 통한 희소 어텐션은 컨텍스트 길이를 늘릴 수 있지만 학습된 길이를 넘어 일반화하기 어렵고 비용이 크다. FreeSolo는 단거리 슬라이딩 윈도우 분기와 키포인트 셀을 선택하는 장거리 분기로 구성된 네이티브 희소 어텐션 메커니즘이다. 전체 요약 6문장 읽기 → 092 03:11 ▲ 107 · 댓글 38 KiCAD용 AI 설계 플러그인 Konnect 베타 공개 KiCAD 10 네이티브 플러그인 Konnect 베타가 공개됐으며, Rust 바이너리로 Claude 등 AI 어시스턴트가 회로도·PCB 설계를 자동화할 수 있다. AI · 머신러닝 · AI-assisted PCB design for KiCad 10
Key Point KiCAD 사용자가 AI로 회로도와 PCB 설계를 직접 자동화할 수 있게 되면서, 설계 반복 속도와 진입 장벽이 크게 바뀐다.
핵심 요약
KiCAD 10 네이티브 플러그인 Konnect 베타가 공개됐으며, Rust 바이너리로 Claude 등 AI 어시스턴트가 회로도·PCB 설계를 자동화할 수 있다. Model Context Protocol(MCP)을 통해 228개 도구를 21개 온디맨드 도구셋으로 제공하며, 회로도 작성·PCB 레이아웃·라우팅·ERC/DRC·설계 검토·JLCPCB 부품 검색·제조 파일 내보내기를 지원한다. 이전 KiCAD-MCP-Server(Python/TypeScript)의 아키텍처 한계를 개선했으며, 단일 정적 바이너리(20~25MB)로 의존성을 제거해 설치와 유지보수가 간단하다. 전체 요약 12문장 읽기 → 093 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 094 21:11 ▲ 12 · 댓글 2 동영상 자막 제거 평가 벤치마크 'MFVSR' 공개 동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. AI · 머신러닝 · MFVSR: A Multi-Style and Fine-Grained Benchmark for Video Subtitle Removal
Key Point 동영상 자막 제거 기술을 체계적으로 평가할 수 있는 첫 대규모 벤치마크로, 기존 평가 방식의 맹점을 드러내며 정확한 성능 비교를 가능하게 한다.
핵심 요약
동영상 자막 제거(VSR) 기술을 평가하기 위한 대규모 벤치마크 'MFVSR'이 발표됐다. 3,000개 쌍을 이룬 고화질·저화질 영상과 AI 생성 영상, 그리고 953개 실제 영상으로 구성됐으며, 16개 언어와 공간 배치·시간적 동작·시각적 스타일·언어 모드 등 4가지 요인에 걸쳐 다양한 자막을 포함한다. 기존 평가 방식과 달리 정보 조건화·공간 분리 프로토콜을 도입해 마스크 없는 제거와 마스크 기반 제거를 구분하고, 복원 충실도·보존 충실도·시간적 충실도·커버리지·실패 사례를 측정한다. 전체 요약 5문장 읽기 → 095 18:11 ▲ 202 · 댓글 2 비전-언어 모델의 3D 공간 추론 능력을 평가하는 RoTA-Bench 공개 비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. AI · 머신러닝 · RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
Key Point GPT-4o 같은 최신 모델도 3D 공간 추론과 정밀한 조작에서 인간과 큰 격차를 보이고 있으며, 이는 멀티모달 AI의 실제 응용 한계를 드러낸다.
핵심 요약
비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. 목표 실루엣이 주어질 때 회전된 물체를 관찰하고 연속적인 회전 조작으로 목표 투영을 복구하는 방식으로 평가한다. 자동화된 파이프라인으로 2D 아이콘에서 3D 물체를 생성하고, 가역적 초기화로 해결 가능성을 보장해 674개 작업과 100개 테스트셋을 구축했다. 전체 요약 7문장 읽기 → 096 15:11 ▲ 119 · 댓글 2 이미지만으로 3D 장면 만드는 기술, 대각도 뷰 렌더링 성능 25% 향상 입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. AI · 머신러닝 · InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
Key Point 대각도 뷰 변화에서 3D 렌더링 품질을 비약적으로 개선한 방법론의 구체적 성과와 기술적 혁신이 담겨 있어, 3D 비전 분야의 실무자와 연구자에게 직접 활용 가능한 정보를 제공한다.
핵심 요약
입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. InfiniSplat v2는 기하학과 속성 예측을 분리하되 기하학 브랜치는 고정하고, 훈련 시 예측된 가우시안을 실제 카메라 포즈로 정렬하며, 대각도 타겟 뷰 감독을 도입해 이 한계를 개선했다. 6개 데이터셋에서 평가한 결과, 카메라 포즈가 주어진 설정과 포즈 프리 설정 모두에서 평균 LPIPS와 DISTS 지표가 최첨단 성능을 달성했다. 전체 요약 5문장 읽기 → 097 15:11 ▲ 54 · 댓글 2 여러 세션 걸친 강화학습 에이전트 최적화 방법 제안 기존 에이전트 강화학습은 단일 세션 궤적을 가정했으나, 컨텍스트 압축과 서브에이전트 분기 같은 기법은 여러 세션에 걸친 궤적을 생성해 불일치가 발생한다. AI · 머신러닝 · Mosaic: Multi-Session Agentic Reinforcement Learning
Key Point LLM 에이전트가 실제로 여러 번의 상호작용 세션으로 나뉠 때 학습 방식을 바꿔야 하는 실질적 문제를 해결하는 방법을 제시했다.
핵심 요약
기존 에이전트 강화학습은 단일 세션 궤적을 가정했으나, 컨텍스트 압축과 서브에이전트 분기 같은 기법은 여러 세션에 걸친 궤적을 생성해 불일치가 발생한다. 다중세션 에이전트 강화학습(Multi-Session Agentic RL) 설정을 제안해 임의 개수의 세션을 하나의 궤적 내에서 지원한다. 기존 방식은 궤적 수준 이점을 모든 세션에 일괄 분배하지만, 각 세션의 기여도를 구분하지 못하고 세션 할당을 지도하지 못한다. 전체 요약 6문장 읽기 → 098 15:11 ▲ 52 · 댓글 2 전자상거래 상품 메인 이미지를 자동 생성하는 AI 프레임워크 공개 알리바바 쇼핑 플랫폼의 전자상거래 상품 메인 이미지 자동 생성 시스템 CommerceGen-Studio를 소개하는 논문이다. AI · 머신러닝 · CommerceGen-Studio: An End-to-End Framework for Commercial-Grade Main-Image Generation
Key Point 전자상거래 플랫폼의 핵심인 상품 이미지를 수초 만에 대규모로 자동 생성하는 상용 AI 시스템의 구조와 한계가 명확히 공개됨으로써, 실제 프로덕션 환경에서 생성형 AI를 어떻게 설계하고 최적화하는지를 이해할 수 있다.
핵심 요약
알리바바 쇼핑 플랫폼의 전자상거래 상품 메인 이미지 자동 생성 시스템 CommerceGen-Studio를 소개하는 논문이다. 세 단계 파이프라인으로 구성된다: (1) PERL-Agent가 상품 메타데이터를 VLM과 LLM이 반복적으로 평가하며 판매 포인트 텍스트로 압축, (2) Layout Thinker Optimization이 생성된 이미지와 캡션 품질을 최적화, (3) SKU-DiT가 배경 없는 상품 이미지, 상표 이미지, 구조화된 레이아웃을 조건으로 최종 이미지 생성. SKU-DiT는 Reinforce-Distill-Reinforce 점진적 훈련 기법으로 학습되어 상품 피델리티, 상표 무결성, 글자 수준의 정확도를 동시에 유지한다. 전체 요약 7문장 읽기 → 099 15:11 ▲ 30 · 댓글 2 AI 모델의 미래 세계 예측 능력 벤치마크 'WorldCast' 공개 인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. AI · 머신러닝 · WorldCast: Exploring Intelligent Visual Generation in World State Prediction
Key Point 현재 최첨단 모델의 시각적 미래 예측 능력 한계를 명확히 드러내는 벤치마크로, AI의 실제 세계 이해도를 측정하는 중요한 기준을 제시합니다.
핵심 요약
인간처럼 시각·음성·텍스트 등 다양한 정보를 해석하고 세상의 미래 변화를 예측하는 능력이 최근 생성 AI 모델에서 나타나고 있다. 연구팀이 이러한 능력을 4단계 계층으로 분류했으나 고수준 작업들은 아직 충분히 연구되지 않은 상태다. 이를 해결하기 위해 WorldCast 벤치마크를 개발했으며, 이는 8개 카테고리의 320개 수작업 사례로 구성되고 12개 대표 모델을 평가한다. 전체 요약 8문장 읽기 → 100 15:11 ▲ 23 · 댓글 2 확산 모델 강화학습을 위한 라우팅 정책 최적화 기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. AI · 머신러닝 · Routing Policy Optimization for Online Diffusion Reinforcement Learning
Key Point 생성 모델을 보상 신호로 정렬할 때 훈련 효율을 4배 향상시키면서도 추론 시 모델의 원래 특성을 유지하는 새로운 강화학습 기법이 제시되어, 확산 모델 최적화의 실질적 한계를 해결한다.
핵심 요약
기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. Routing Policy Optimization (RPO)는 어텐션 라우팅을 확률적 탐색 행동으로 변환하여 이를 답한다. 선택된 몇 개의 디노이징 단계에서 각 쿼리 블록은 자신의 블록을 유지하면서 생성 모델의 자연스러운 어텐션 질량에 비례하여 추가 키 블록을 샘플링하거나 밀집 어텐션을 유지한다. 전체 요약 9문장 읽기 →