쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
78건 · "Agentic"조건 지우기 ×
001 15:11 ▲ 14 · 댓글 1 AI 코딩 에이전트의 협업 능력 평가 벤치마크 공개 Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. AI · 머신러닝 · Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
Key Point 현재 AI 코딩 에이전트는 요구사항 70% 정도를 부분적으로만 충족하지만 완전한 완료는 26%에 불과해, 실제 협업 환경에서 얼마나 신뢰할 수 있는지 명확히 보여준다.
핵심 요약
Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. 실제 사용자 세션 26,314개에서 수집한 중복 제거 쿼리 37,463개 중 273개 작업으로 구성되며, 텍스트·이미지·오디오·비디오·문서 등 다양한 입력을 포함한다. Multimodal Editing(ME)과 Repository Editing(RE) 두 가지 트랙을 제공하고, Grounded Understanding·UI Transformation·Functional Implementation 세 가지 능력 차원을 평가한다. 전체 요약 8문장 읽기 → 002 21:11 ▲ 18 · 댓글 4 LLM 에이전트 처리, 도구 응답 대기를 고려한 스케줄링으로 성능 향상 LLM 기반 에이전트 서빙은 GPU 클러스터에서의 모델 추론과 분산된 CPU의 외부 도구 실행을 반복하며 진행된다. AI · 머신러닝 · TAO: Tool-Aware Joint Scheduling for LLM-Based Agentic Serving
Key Point LLM 에이전트의 성능 병목이 어디에 있는지, 그리고 도구 응답 준비 상태를 고려한 스케줄링이 왜 기존 방식보다 효과적인지를 보여주는 구체적인 개선 수치를 제시한다.
핵심 요약
LLM 기반 에이전트 서빙은 GPU 클러스터에서의 모델 추론과 분산된 CPU의 외부 도구 실행을 반복하며 진행된다. 기존 시스템들은 외부 도구의 응답 준비 상태를 성능 평가에 반영하지 않아 자원을 낭비하고, 휴리스틱 전략으로 GPU 준입과 배치를 결정해 스케줄링 최적화가 부족했다. TAO는 도구 응답 준비 상태, 노드별 캐시 크레딧(시간 감쇠 적용), 토큰 차지 공간을 결합한 가치 인터페이스를 제공한다. 전체 요약 5문장 읽기 → 003 00:11 ▲ 15 · 댓글 2 음성·영상 AI가 실시간 상황에 제때 반응하지 못한다 옴니모달 대형언어모델(Omni-LLM)이 계속 스트리밍되는 음성·영상을 관찰하면서 사용자를 지원할 수 있어야 하는데, 기존 평가 방식으로는 이들이 얼마나 신뢰성 있게 상황 증거와 사용자 필요를 연결해 적시에 개입하는지 알기 어렵다. AI · 머신러닝 · Omni-InteractScope: Benchmarking Proactive and Agentic Interaction in Continuous Omnimodal Streams
Key Point 음성·영상 AI가 실시간으로 상황을 인식하고 제때 도움을 주는 것이 얼마나 어려운지 첫 대규모 벤치마크로 드러나, 현재 모델의 한계와 개선할 구체적 방향을 보여준다.
핵심 요약
옴니모달 대형언어모델(Omni-LLM)이 계속 스트리밍되는 음성·영상을 관찰하면서 사용자를 지원할 수 있어야 하는데, 기존 평가 방식으로는 이들이 얼마나 신뢰성 있게 상황 증거와 사용자 필요를 연결해 적시에 개입하는지 알기 어렵다. Omni-InteractScope 벤치마크는 8개 작업군에 걸친 1,479개 인간 주석 상호작용과 1,790개 시간 목표를 제시한다. 도구 호출(tool invocation) 타이밍, 쿼리 없는 조언, 알림, 경고, 상태 추적, 지속적 응답을 포함해 입력 모달리티·사건 트리거·개입 유형·사용자 필요를 연결한다. 전체 요약 8문장 읽기 → 004 12:11 ▲ 15 · 댓글 2 특허 심사 자동화하는 AI 에이전트 벤치마크 공개 특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. AI · 머신러닝 · Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
Key Point 특허 심사 자동화는 방대한 기술 문헌 검색과 복합적 추론이 필요한 영역으로, 이 벤치마크는 에이전트 기술의 실제 활용 가능성을 보여주는 현실적 테스트 사례가 된다.
핵심 요약
특허 심사는 선행기술 발굴, 질의 개선, 증거 검토, 심사의견서 작성을 반복하는 복잡한 과제인데 기존 벤치마크는 정적이고 제한된 후보군만 다뤘다. 연구진이 특허 심사 에이전트 개발·평가를 위한 첫 번째 프레임워크 PatEx-Gym을 발표했다. PatEx-Bench는 1000개의 실제 심사 과제, 100만 개 이상의 특허와 5만2000개 과학 논문 데이터베이스, 반복 검색과 문서 방문·추론·심사의견서 생성을 지원하는 런타임을 제공한다. 전체 요약 7문장 읽기 → 005 00:11 ▲ 26 · 댓글 2 LLM 에이전트 강화학습의 신용 할당 문제 해결한 ProAS 프레임워크 LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. AI · 머신러닝 · ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
Key Point 다단계 추론이 필요한 LLM 에이전트의 강화학습 효율성을 크게 개선하는 방법론이 제시되어, 언어 모델 기반 자동화 시스템의 성능 향상에 직결된다.
핵심 요약
LLM 에이전트 최적화에 쓰이는 강화학습에서 GRPO 같은 무비평가 알고리즘은 모든 행동에 같은 수준의 이점을 부여하는 균일 신용 할당의 근본적 한계를 가진다. 이 접근 방식은 선호되는 궤적에서 구조적으로 비합리적인 행동을 강화하고, 비선호 궤적에서 각 행동의 하위 편차를 무시한다. ProAS는 동적으로 진화하는 에이전틱 레퍼런스 그래프(ARG)를 활용해 비합리적 인센티브 마스킹(MUI)과 비대칭 페널티 재배분(APR)을 통한 세밀한 신용 할당을 구현한다. 전체 요약 5문장 읽기 → 006 12:11 ▲ 13 · 댓글 3 AI가 손으로 조립하는 레고, 물리 타당성 100% 달성 코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. AI · 머신러닝 · BrickWright: Agentic Creation of Physically Feasible Brick Builds
Key Point AI가 생성한 3D 구조의 '실제 조립 가능성'을 검증하는 새로운 접근법이 100% 성공률을 달성했으며, 로봇 공학·제조업·디지털 설계 도구의 신뢰성 표준을 높인다.
핵심 요약
코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. BrickWright는 조립 도구와 물리 타당성 검증 기능을 제공해 AI가 텍스트나 이미지 지시에서 실제 조립 가능한 레고 구조를 생성하도록 안내하는 프레임워크다. BrickLayer라는 Python 툴킷이 핵심이며, 두 부분으로 구성된다: 사용하기 쉬운 레고 조립 API(원본 LDraw 형식 대비 추론 비용 절반)와 물리 타당성 피드백을 주는 검증기다. 전체 요약 5문장 읽기 → 007 06:11 ▲ 22 · 댓글 3 LLM 에이전트의 '모자이크 누출': 여러 문서 조각에서 기밀 정보 추론 위험 LLM 에이전트가 여러 접근 가능한 문서에서 정보를 조합하여 민감한 결론을 도출·공개하는 '모자이크 효과'의 위험을 연구했다. AI · 머신러닝 · Agent Mosaic: Recognizing Confidentiality Leaks in Agentic LLM Systems
Key Point 여러 비기밀 정보를 조합해 기밀 정보를 유추하는 위험이 현재 LLM 에이전트 시스템에서 실제로 발생하고 있으며, 기존 안전장치도 이를 막기 충분하지 않다는 점이 중요하다.
핵심 요약
LLM 에이전트가 여러 접근 가능한 문서에서 정보를 조합하여 민감한 결론을 도출·공개하는 '모자이크 효과'의 위험을 연구했다. 사이버보안·의료·군사 영역 30가지 합성 시나리오로 테스트한 결과, 시뮬레이션 환경에서 GPT-5.6-Sol(최고 성능 모델)은 공식 쿼리라도 금지된 복합 정보를 답변의 7.08%(95% CI: 3.75-10.67%)에서 공개했다. 실제 오픈소스 에이전트 환경에서는 더 높은 누출률을 보였다. 전체 요약 6문장 읽기 → 008 03:11 ▲ 17 · 댓글 2 에이전트 비전 작업 평가 벤치마크 공개 비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. AI · 머신러닝 · AgentVQA: A Unified Benchmark for Agentic Visual Understanding
Key Point 에이전트 AI 성능 평가의 새로운 표준으로, VLM이 실제 상호작용 환경에서 어디서 약한지 구체적으로 보여준다.
핵심 요약
비전-언어 모델(VLM)의 에이전트 환경에서의 성능을 평가하기 위해 AgentVQA 벤치마크를 개발했다. 웹 에이전트, 로봇, 일인칭 영상, 게임, 공간 계획 등 5개 도메인의 에이전트 시나리오를 포함한다. 23개 소스 데이터셋에서 1000개의 도전적인 실제 에이전트 예시를 수동으로 선별하고 오프라인 평가용으로 적응시켰다. 전체 요약 7문장 읽기 → 009 03:11 ▲ 31 · 댓글 2 자연어로 영화같은 카메라 움직임을 3D 환경에서 자동 생성 FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography
Key Point 자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다. Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다. 전체 요약 6문장 읽기 → 010 18:11 ▲ 22 · 댓글 8 단순한 RAG가 복잡한 에이전트 메모리보다 우수하다 LLM의 장기 대화 이해를 위해 사용되는 메모리 시스템은 흔히 변형·구조화·학습 기반 검색 등 복잡한 연산을 적용한다. AI · 머신러닝 · Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought
Key Point LLM 기반 대화 시스템에서 고도의 메모리 아키텍처가 반드시 필요하지 않을 수 있다는 점이 개발자의 시스템 설계 선택을 바꿀 수 있기 때문이다.
핵심 요약
LLM의 장기 대화 이해를 위해 사용되는 메모리 시스템은 흔히 변형·구조화·학습 기반 검색 등 복잡한 연산을 적용한다. 이 논문은 Raw-RAG라는 단순한 RAG 베이스라인을 제안했다: 원본 대화 이력에 대해 밀집 벡터 검색과 재정렬만 수행한 후 증거를 LLM에 제공하는 방식이다. LoCoMo, LongMemEval, MEME, MemoryAgentBench 4개 벤치마크에서 Raw-RAG는 7개 벤치마크-모델 조합 중 6개에서 1위를 차지했으며, 가장 강력한 에이전트 메모리 시스템 대비 0.13~5.53점 높은 성능을 보였다. 전체 요약 7문장 읽기 → 011 18:11 ▲ 97 · 댓글 2 320B 파라미터 에이전트 모델 IQuest-Q1 공개 IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. AI · 머신러닝 · IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
Key Point 희소 MoE 구조로 320B 파라미터의 15%만 활성화하면서도 복잡한 다단계 학습 파이프라인을 통해 에이전트 능력을 강화한 방식이 새로운 표준이 될 수 있기 때문입니다.
핵심 요약
IQuest-Q1은 Mixture-of-Experts 구조로 설계된 에이전트 파운데이션 모델로, 총 320B 파라미터 중 15B만 활성화되는 희소 모델입니다. 3단계 학습 과정으로 개발되었습니다: 첫 번째는 Stable SplitNorm, Muon, muP를 결합한 안정적 사전학습으로, 두 번째 단계에서 코딩 데이터 비중을 높여 안전한 학습률 마진을 확보합니다. 두 번째 단계는 도메인과 포맷 전반에 걸쳐 데이터 혼합을 확장하고 컨텍스트를 점진적으로 늘리는 세부 중기 학습입니다. 전체 요약 6문장 읽기 → 012 12:11 ▲ 10 · 댓글 2 긴 작업의 신용배분 문제를 푸는 Self-Credit 강화학습 LLM 에이전트는 보통 강화학습으로 훈련되지만, 희소한 보상 신호로 인해 장기 작업에서 신용배분이 어렵다. AI · 머신러닝 · Self-Credit: Credit Assignment for Long-Horizon Agentic RL via Intra-group Rescaling
Key Point 희소 보상 환경에서 LLM 에이전트가 어떤 액션이 성공을 이끌었는지 파악하기 어려운 문제를 모델의 자체 추론과 그룹 비교로 해결하는 구체적 방법을 제시한다.
핵심 요약
LLM 에이전트는 보통 강화학습으로 훈련되지만, 희소한 보상 신호로 인해 장기 작업에서 신용배분이 어렵다. Self-Credit은 모델이 생성한 요약에 핵심 증거를 담은 이전 턴을 인용하게 함으로써 자동 신용배분 신호를 만든다. 그룹 내 재스케일링을 통해 같은 프롬프트에 대해 성공한 롤아웃과 실패한 롤아웃 간의 인용 액션을 비교해 신용을 정제한다. 전체 요약 8문장 읽기 → 013 06:11 ▲ 11 · 댓글 3 로컬에서 돌리는 에이전트 모델 Muse Glimmer 30B 공개 Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. AI · 머신러닝 · Muse Glimmer 30B: An On-Device Agentic Model
Key Point GPU 한 개면 충분한 수준의 에이전트 능력을 로컬에서 운영할 수 있어, 개발자들이 클라우드 비용 없이 독립적인 AI 시스템을 구축하는 방식을 바꿀 수 있습니다.
핵심 요약
Hugging Face가 Muse Glimmer 30B라는 오픈소스 언어모델을 공개했습니다. 일반 PC에서 클라우드 없이 독립적으로 동작하는 에이전트 모델로, 텍스트와 이미지를 입력받고 텍스트를 출력합니다. 다단계 추론, 도구 사용, 실패 복구 능력을 통합했으며 100개 이상의 언어로 학습되었습니다. 전체 요약 6문장 읽기 → 014 03:11 ▲ 22 · 댓글 1 로봇 조작에 코드 기반 계획을 결합한 새로운 AI 모델 기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. AI · 머신러닝 · Agentic World Action Models
Key Point 로봇 조작 AI에서 시각 예측과 코드 기반 계획의 gap을 처음으로 메운 모델이며, 재사용 가능한 기술 라이브러리와 자동 학습 파이프라인을 제시해 실제 로봇 시스템의 확장성을 높일 수 있는 방법을 제안한다.
핵심 요약
기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. 코드 기반 계획 로봇공학은 재사용 가능한 기술을 제공하지만 물리 역학의 예측 기반이 약해 현실과의 연결 고리가 약했다. 이를 해결하기 위해 AW-0이라는 에이전트형 세계 행동 모델을 제시했으며, 코드 기반 계획을 영상·행동 예측과 통합한다. 전체 요약 9문장 읽기 → 015 00:11 ▲ 21 · 댓글 1 에이전트 강화학습, 다양한 도구 구성으로 일반화 능력 향상 에이전트 시스템의 핵심인 하네스(harness)는 모델의 도구 사용, 컨텍스트 관리, 장기 작업 조정을 담당하는데, 이를 효과적으로 활용하려면 강화학습이 필수다. AI · 머신러닝 · Harness Scaling for Generalizable Agentic Reinforcement Learning
Key Point 에이전트 RL의 성능이 도구 구성 설정의 다양성에 따라 크게 달라지는 만큼, 이 새로운 스케일링 차원이 실제 시스템 배포 시 안정성과 적응성을 높일 수 있다.
핵심 요약
에이전트 시스템의 핵심인 하네스(harness)는 모델의 도구 사용, 컨텍스트 관리, 장기 작업 조정을 담당하는데, 이를 효과적으로 활용하려면 강화학습이 필수다. 기존 접근법은 단일 하네스로만 학습해 특정 구성에 최적화되고 다른 설정으로의 전이 능력이 제한됐다. 연구팀은 '하네스 스케일링(Harness Scaling)'을 제안해 다양한 실행 구성으로 학습 범위를 확대한다. 전체 요약 6문장 읽기 → 016 12:11 ▲ 42 · 댓글 2 로봇 플래너도 포스트트레이닝으로 강화된다 로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. AI · 머신러닝 · AgenticRoboRL: Bringing Coding-Agent Post-Training to Agentic Robotics
Key Point 작은 오픈소스 로봇 모델도 정교한 포스트트레이닝으로 폐쇄형 거대모델 수준의 성능을 낼 수 있다는 점이 로봇 개발자와 AI 연구자들에게 실질적인 의미를 갖는다.
핵심 요약
로봇을 제어하는 AI 플래너의 성능을 높이기 위해 '포스트트레이닝' 기법을 적용한 AgenticRoboRL 프레임워크를 개발했다. 기존 로봇 제어 시스템은 강력한 폐쇄형 모델(GPT 같은)에 의존했지만, 모델 자체를 개선하지는 않았다. 코딩 에이전트 분야에서 포스트트레이닝이 성공한 점에 착안해 로봇 플래너에도 같은 접근을 시도했다. 전체 요약 8문장 읽기 → 017 09:11 ▲ 13 · 댓글 2 형식검증으로 강화한 LLM 에이전트 학습, Lean4AgenticRL LLM의 에이전트 능력을 강화하기 위해 복잡한 소프트웨어 엔지니어링과 터미널 작업 문제를 풀어야 하는 상황에서, 기존 모델들은 고수준의 결과 보상에만 의존해 학습 효율이 낮았다. AI · 머신러닝 · Lean4AgenticRL: Advancing Agentic RL with Verifiable Multi-level Process Rewards
Key Point 기존 LLM 에이전트 학습에서 다단계 보상 검증을 도입해 실제 성능 향상을 입증한 사례로, 형식 검증이 강화학습 효과성을 높일 수 있음을 보여준다.
핵심 요약
LLM의 에이전트 능력을 강화하기 위해 복잡한 소프트웨어 엔지니어링과 터미널 작업 문제를 풀어야 하는 상황에서, 기존 모델들은 고수준의 결과 보상에만 의존해 학습 효율이 낮았다. Lean4AgenticRL은 Lean4 형식화 체계에 다단계 프로세스 보상을 통합한 첫 번째 프레임워크로, 에이전트의 능력과 제어성 사이 균형을 맞추는 문제별 워크플로우 시스템을 구축한다. 워크플로우 형식화와 다단계 보상 주석 방식을 통해 일반 하니스 시스템 내에서 에이전트 동작을 검증하며, 저수준 도구 호출 보상과 중수준 워크플로우 단계 보상을 포함한다. 전체 요약 7문장 읽기 → 018 21:11 당일 +682 Claude Code용 AI 시대 SEO 분석 플러그인 공개 Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. 오픈소스 · 도구 · AgriciDaniel/claude-seo · Python
Key Point Google의 AI 검색 최적화 가이드를 완전히 구현한 첫 번째 실제 도구로, SEO 감시를 4시간에서 12분으로 단축하고 모든 추천에 검증 기준을 붙인다는 점이 기존 상용 도구와의 구별점이다.
핵심 요약
Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. Python 기반이며 MIT 라이선스 오픈소스로 제공되고, 웹사이트 전체 감시 10~15분이면 완료된다. 모든 추천은 Google의 공식 가이드에 기반한 근거와 함께 제시되며, 각 발견사항마다 '이것이 실패했다고 어떻게 알 수 있는가'에 대한 검증 기준을 포함한다. 일반 사용자용 공개 저장소(`AgriciDaniel/claude-seo`)와 AI Marketing Hub Pro 회원용 프라이빗 미러(`AI-Marketing-Hub/claude-seo`)의 두 버전으로 제공되며, 후자는 신규 기능 조기 접근이 가능하다. 전체 요약 13문장 읽기 → 019 16:56 ▲ 26 · 댓글 2 만화를 영상으로 충실히 변환하는 AI 에이전트 시스템 만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. AI · 머신러닝 · Manga2Animate: An Agentic Framework for Faithful Manga Animation with Script and Storyboard Planning
Key Point 만화의 스토리, 캐릭터, 미술 스타일을 모두 보존하면서 자동으로 애니메이션화하는 기술로, 만화 산업에 실질적으로 적용할 수 있는 접근 방식을 제시한다.
핵심 요약
만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. 기존 방식은 만화를 텍스트로만 해석해 캐릭터와 미술 스타일을 잃거나, 페이지를 직접 영상생성 모델에 넣어 구성을 오해하고 잘못된 스토리를 만드는 문제가 있었다. 이 프레임워크는 생성 과정의 모든 단계를 원본 만화에 근거하며, 작업을 두 가지 중간 단계인 애니메이션 스크립트와 시각적 스토리보드로 분해한다. 전체 요약 6문장 읽기 → 020 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 021 18:11 ▲ 17 · 댓글 2 AI 에이전트의 거짓 보고 적발하는 검증 시스템 Sauron 장시간 실행되는 AI 에이전트 작업을 평가할 때 환경 상태와 실행 기록에 분산된 증거를 놓치거나, 에이전트 자신의 성공 보고만 믿는 문제가 있다. AI · 머신러닝 · Evidence-First Agentic Verification
Key Point AI 에이전트의 거짓 자체 보고를 탐지해 보상 해킹을 막는 방법이 필요해진다.
핵심 요약
장시간 실행되는 AI 에이전트 작업을 평가할 때 환경 상태와 실행 기록에 분산된 증거를 놓치거나, 에이전트 자신의 성공 보고만 믿는 문제가 있다. 이러한 평가 오류가 강화학습의 보상으로 쓰일 경우 에이전트가 부정한 행동을 학습하게 된다. Sauron은 상태와 실행 기록을 모두 조사하면서, 에이전트의 주장을 독립적으로 증거와 대조 검증한 뒤에야 수용하는 검증 시스템이다. 전체 요약 8문장 읽기 → 022 15:11 ▲ 98 · 댓글 1 다중 도구와 메모리로 시각 추론 강화하는 OpenVLHarness 멀티모달 대규모 언어 모델(MLLM)의 시각 추론 능력은 크게 향상됐으나, 단순히 추론 예산을 늘리는 것만으로는 성능 개선이 제한적임을 22개 벤치마크 통제 연구에서 확인했다. AI · 머신러닝 · OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory
Key Point 복잡한 시각 추론 작업을 외부 도구와 메모리 체계로 효율적으로 해결하는 방식이 제시되었고, 여러 MLLM에서 일관된 성능 향상과 비용 절감을 달성해 실무 응용의 가능성을 보여준다.
핵심 요약
멀티모달 대규모 언어 모델(MLLM)의 시각 추론 능력은 크게 향상됐으나, 단순히 추론 예산을 늘리는 것만으로는 성능 개선이 제한적임을 22개 벤치마크 통제 연구에서 확인했다. OpenVLHarness는 능력 계층과 지속적인 멀티모달 메모리를 중심으로 설계된 멀티모달 추론 프레임워크로, 다양한 외부 도구의 접근성과 해석 가능성을 제공한다. 능력 계층은 작업 수준의 도구 인터페이스와 증거 렌더링을 결합해 이질적 백엔드에 일관된 접근을 가능하게 하고, 그 출력을 모델이 읽을 수 있는 형태로 변환한다. 전체 요약 8문장 읽기 → 023 21:11 ▲ 56 · 댓글 3 자연어로 3D 실내 공간 생성하는 AI 에이전트 개발 Scene-Designer는 설계 능력과 비평 능력을 동시에 학습하는 에이전트 프레임워크로, 자연어 설명으로부터 완전하고 정합적인 3D 실내 공간을 생성한다. AI · 머신러닝 · Scene-Designer: Learning Design Intelligence for Agentic 3D Scene Generation
Key Point 자연어로 물리적으로 타당하고 기능적으로 올바른 3D 공간을 자동으로 설계하는 기술이 게임, 건축 시각화, 메타버스 등 여러 산업에서 필요한 핵심 과제를 해결한다.
핵심 요약
Scene-Designer는 설계 능력과 비평 능력을 동시에 학습하는 에이전트 프레임워크로, 자연어 설명으로부터 완전하고 정합적인 3D 실내 공간을 생성한다. Scene-OTA-35K 데이터셋은 관찰-사고-행동 지도를 제공해 장면 설계와 오류 수정을 학습하며, Scene-OTC-15K 데이터셋은 관찰-사고-평가자 지도로 물리적 타당성, 기능적 정확성, 레이아웃 일관성을 평가하는 능력을 갖춘다. Scene-GRPO는 평가자 기반 GRPO 프레임워크로, 설계 결정을 개선하고 불필요한 시행착오를 줄인다. 전체 요약 6문장 읽기 → 024 15:11 ▲ 20 · 댓글 2 에이전트 AI 추론을 위한 '히스토리 프리' 추측 디코딩 DLite 추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. AI · 머신러닝 · DLite: History-free Speculative Decoding for Agentic AI
Key Point 에이전트 AI 같은 긴 맥락의 상호작용형 워크로드에서 LLM 추론 속도를 크게 높일 수 있는 새로운 접근 방식을 제시합니다.
핵심 요약
추측 디코딩은 경량 드래프트 모델로 토큰을 생성하고 타겟 모델이 검증하는 방식으로 LLM 추론을 가속화하는 기법이지만, 에이전트 AI 워크로드의 긴 맥락과 다중 턴 상호작용에서는 드래프트 모델의 토큰 승인률이 최대 80% 저하된다. 기존 방식은 역사적 KV 캐시를 유지함에 따라 시스템 오버헤드가 커진다. 연구팀은 증가하는 역사적 맥락이 두 문제의 공통 원인임을 파악하고, DLite라는 '히스토리 프리' 추측 디코딩 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 025 12:11 ▲ 34 · 댓글 3 장기 추론 에이전트를 위한 나무 구조 기반 정책 자기 증류법 강화학습 후 훈련에서 장기 상호작용을 학습할 때 터미널 보상만으로는 각 턴의 신용할당이 희소하고 고분산이 되는 문제가 있다. AI · 머신러닝 · Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
Key Point 장기 수평선 에이전트 학습 시 정책 편차와 신용할당 문제를 동시에 해결하는 새로운 방식이 기존 GRPO보다 실제 성과를 개선했기 때문입니다.
핵심 요약
강화학습 후 훈련에서 장기 상호작용을 학습할 때 터미널 보상만으로는 각 턴의 신용할당이 희소하고 고분산이 되는 문제가 있다. 기존 방식은 학습된 비평가, 과정 보상 모델, 온정책 증류 등으로 더 조밀한 신용을 얻지만 가치 네트워크나 강한 외부 교사가 필요해 훈련 복잡도가 높다. TreeOPSD는 비평가 없이 각 상호작용 턴을 나무 노드로 취급하고 공유 접두사에서 대안 경로를 분기하며 터미널 보상을 재귀적으로 역전파해 암묵적 턴 수준 신용을 생성한다. 전체 요약 6문장 읽기 → 026 21:11 ▲ 104 · 댓글 105 AI와 함께 일하는 방식, 3년 만에 완전히 달라졌다 ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. AI · 머신러닝 · My old job feels distant now
Key Point 개발자의 일이 AI 발전에 따라 어떻게 실제로 변해왔는지, 검색 대체에서 진정한 협업으로의 전환 과정을 구체적으로 보여준다.
핵심 요약
ChatGPT 초기에는 검색 엔진처럼 사용했으나, 점차 Ruby 코드 작성처럼 구체적인 코드 생성 도구로 활용하기 시작했다. Cursor와 탭 완성은 IDE 통합이 자연스러웠으나, 본격적인 진전은 새로운 도메인(컴퓨터 비전)에서 ChatGPT로 API 검색과 코드 생성을 결합했을 때였다. 할루시네이션을 모델의 한계 신호로 읽고 스스로 빈틈을 채우며 학습했으며, 이는 SEO 스팸과 불완전한 문서의 문제를 우회하는 경험이었다. 전체 요약 11문장 읽기 → 027 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 028 21:11 당일 +308 에이전틱 워크로드 최적화 LLM 추론 엔진 TokenSpeed 공개 LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. AI · 머신러닝 · lightseekorg/tokenspeed · Python
Key Point 에이전틱 AI 애플리케이션이 주목받으면서 추론 엔진의 처리량과 지연시간이 핵심 경쟁력이 되었고, TokenSpeed는 이를 위해 기본부터 재설계한 오픈소스 솔루션으로 실제 대규모 모델 배포에서 검증된 성능을 입증했다.
핵심 요약
LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. 기존 엔진과 달리 제어 평면(C++)과 실행 평면(Python)을 분리한 아키텍처를 채택했으며, 제어 평면은 유한 상태 머신으로 구현되어 컴파일 타임에 KV 캐시 리소스 안전성을 보장한다. 커널은 플러그인 가능한 계층형 시스템으로 설계되었으며, Blackwell GPU에서 가장 빠른 MLA(Multi-head Latent Attention) 구현 중 하나를 포함한다. 전체 요약 9문장 읽기 → 029 18:11 ▲ 37 · 댓글 4 LLM 에이전트, 학습 데이터를 자동으로 개선하는 시스템 언어모델 에이전트가 지도학습 미세조정(SFT) 시 학습 데이터 개선에 가장 많은 시간을 쓰지만, 기존 시스템은 고정된 풀에서 행을 선택하거나 생성기를 호출하는 단 한 가지 방식만 제공한다. AI · 머신러닝 · AutoSFT: An Agentic System for Automated Data Research in Supervised Fine-Tuning
Key Point 자동화된 데이터 개선이 단일 기능 강화가 아니라 다각적 접근에 달려 있다는 점을 보여주며, 실제 개선 수치(IFEval +6.5~+9.9)로 멀티에이전트 방식의 실질적 효과를 입증한다.
핵심 요약
언어모델 에이전트가 지도학습 미세조정(SFT) 시 학습 데이터 개선에 가장 많은 시간을 쓰지만, 기존 시스템은 고정된 풀에서 행을 선택하거나 생성기를 호출하는 단 한 가지 방식만 제공한다. 연구팀은 인간 데이터 엔지니어처럼 비율 조정, 가지치기, 수리, 교체, 합성 등 다양한 데이터 조작 기능을 수행할 수 있는 에이전트 시스템을 설계했다. 단일 에이전트 방식은 비율 조정 하나의 행동만 반복하며 컨텍스트를 낭비해 성능이 개선되지 않았다. 전체 요약 7문장 읽기 → 030 15:11 ▲ 25 · 댓글 2 ML 엔지니어링 자동화하는 35B 모델 MLExpert 공개 LLM이 AI 시스템을 자율적으로 개발·개선하는 AI4AI 시대로 나아가고 있으며, 기계학습 엔지니어링(MLE) 시스템이 장기 실험 관리와 최적화 전략 자동 적응으로 이를 실현하고 있다. AI · 머신러닝 · MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering
Key Point ML 엔지니어링의 완전 자동화가 가능해지면 AI 개발 사이클을 획기적으로 단축할 수 있으며, 이는 AI 스스로가 AI를 개선하는 재귀적 자기개선의 실질적 첫걸음이다.
핵심 요약
LLM이 AI 시스템을 자율적으로 개발·개선하는 AI4AI 시대로 나아가고 있으며, 기계학습 엔지니어링(MLE) 시스템이 장기 실험 관리와 최적화 전략 자동 적응으로 이를 실현하고 있다. 기존 MLE 시스템의 문제점은 실험 피드백이 이전 여러 결정의 누적 결과라 단순 감독학습으로는 장기 궤적에서 유용한 신호를 학습하기 어렵다는 점이다. Hugging Face 팀은 35B Mixture-of-Experts 모델 MLExpert를 학습시키기 위해 Kaggle-MLE Factory로 실행 가능한 ML 최적화 작업을 대규모로 생성했다. 전체 요약 7문장 읽기 → 031 15:11 ▲ 54 · 댓글 2 여러 세션 걸친 강화학습 에이전트 최적화 방법 제안 기존 에이전트 강화학습은 단일 세션 궤적을 가정했으나, 컨텍스트 압축과 서브에이전트 분기 같은 기법은 여러 세션에 걸친 궤적을 생성해 불일치가 발생한다. AI · 머신러닝 · Mosaic: Multi-Session Agentic Reinforcement Learning
Key Point LLM 에이전트가 실제로 여러 번의 상호작용 세션으로 나뉠 때 학습 방식을 바꿔야 하는 실질적 문제를 해결하는 방법을 제시했다.
핵심 요약
기존 에이전트 강화학습은 단일 세션 궤적을 가정했으나, 컨텍스트 압축과 서브에이전트 분기 같은 기법은 여러 세션에 걸친 궤적을 생성해 불일치가 발생한다. 다중세션 에이전트 강화학습(Multi-Session Agentic RL) 설정을 제안해 임의 개수의 세션을 하나의 궤적 내에서 지원한다. 기존 방식은 궤적 수준 이점을 모든 세션에 일괄 분배하지만, 각 세션의 기여도를 구분하지 못하고 세션 할당을 지도하지 못한다. 전체 요약 6문장 읽기 → 032 15:11 ▲ 40 · 댓글 4 스트리밍 영상을 사람처럼 이해하는 AI 시스템 DeltaStreamer 스트리밍 영상 이해를 위해 인간의 관찰·기억·조사 방식에서 영감을 얻은 에이전트 프레임워크 DeltaStreamer를 제안한다. AI · 머신러닝 · DeltaStreamer: Towards Human-Like Agentic Streaming Video Understanding
Key Point 스트리밍 영상에서 미래 질문에 대비해 필요한 증거를 체계적으로 보존하고 선택적으로 복구하는 새로운 접근법이 실제 성능 개선으로 입증되었다.
핵심 요약
스트리밍 영상 이해를 위해 인간의 관찰·기억·조사 방식에서 영감을 얻은 에이전트 프레임워크 DeltaStreamer를 제안한다. 스트리밍 영상 이해의 핵심 문제는 미래 쿼리가 어떤 정보를 요구할지 알기 전에 충분한 증거를 보존해야 한다는 것이다. 기존 방식들은 영상 히스토리 압축 과정에서 이벤트 전환을 불분명하게 만들고 관련 세부 정보를 생략하며, 손실된 시각적 증거를 복구할 수 없다. 전체 요약 8문장 읽기 → 033 18:11 ▲ 64 · 댓글 2 규칙 추론 벤치마크 RuleTrek 공개, LLM의 한계 드러내다 대형언어모델이 특화된 도메인의 복잡한 실무 작업을 수행할 때 여러 파일에 분산된 정보 중에서 도메인별 규칙을 식별하고 적용하는 것이 어려운 상황이다. AI · 머신러닝 · RuleTrek: Benchmarking Agentic Rule Reasoning in Complex Scenarios
Key Point LLM이 현실 업무에서 도메인 규칙을 얼마나 정확히 따를 수 있는지 측정하는 새 기준이 제시되면서, 에이전트 AI의 신뢰성 문제가 수치로 드러났다.
핵심 요약
대형언어모델이 특화된 도메인의 복잡한 실무 작업을 수행할 때 여러 파일에 분산된 정보 중에서 도메인별 규칙을 식별하고 적용하는 것이 어려운 상황이다. 기존 규칙 추론 벤치마크는 시나리오를 소수의 사실 진술로만 표현해 규칙 식별과 적용을 지나치게 단순화했다. 연구팀이 발표한 RuleTrek은 복잡한 시나리오에서 에이전트 기반 규칙 추론을 평가하는 다중 도메인 벤치마크다. 전체 요약 8문장 읽기 → 034 18:11 ▲ 76 · 댓글 2 강화학습 에이전트 최적화, 방법 많다고 더 나을까 에이전트 강화학습의 자기증류 방법들이 증가했지만, 기존 평가는 다른 실험 조건에서 발표된 기준점을 재사용하고 동시대 방법들 간 직접 비교가 부족하며 훈련 안정성과 계산 비용을 거의 고려하지 않았다. AI · 머신러닝 · More Methods, Better Agents? A Reality Check on Self-Distillation in Agentic Reinforcement Learning
Key Point 에이전트 강화학습의 자기증류 방법이 계속 제안되는 가운데, 실제로 더 많은 방법이 더 나은 성능을 보장하지 않는다는 점이 중요하기 때문에 방법론 선택과 연구 방향에 영향을 미친다.
핵심 요약
에이전트 강화학습의 자기증류 방법들이 증가했지만, 기존 평가는 다른 실험 조건에서 발표된 기준점을 재사용하고 동시대 방법들 간 직접 비교가 부족하며 훈련 안정성과 계산 비용을 거의 고려하지 않았다. 연구팀은 10가지 대표 방법을 GRPO와 함께 ALFWorld, ScienceWorld, Search-QA, WebShop에서 3가지 모델 크기로 비교했으며, 132개 훈련 실행과 총 12,124.4시간의 H800 GPU를 사용해 8개 롤아웃 시드로 반복 평가했다. 최종 성능 외에 훈련 진행률, 안정성, 측정된 계산 비용을 조사했고, GRPO 대비 성능 향상이 제한적이며 모든 설정에서 지속적으로 뛰어난 방법이 없음을 발견했다. 전체 요약 5문장 읽기 → 035 15:11 ▲ 30 · 댓글 2 로봇 지능의 다음 단계, '에이전틱 로봇' 체계적 정리 기초 모델 기반의 로봇 지능이 저수준 행동 예측에서 벗어나 인간의 지시를 이해하고, 환경과 상호작용하며, 실행 오류를 자동으로 교정하고, 전략을 동적으로 조정하는 '에이전틱 로봇'으로 진화하고 있다. AI · 머신러닝 · Towards Agentic Robots: Model, Data, Environment, and Harness
Key Point 로봇 AI의 패러다임이 전환되면서 분산된 연구들을 처음으로 체계화한 종합 가이드로, 로봇 개발자와 AI 연구자가 에이전틱 로봇의 전체 구조를 이해하고 각자의 연구를 위치시킬 수 있는 기준을 제공한다.
핵심 요약
기초 모델 기반의 로봇 지능이 저수준 행동 예측에서 벗어나 인간의 지시를 이해하고, 환경과 상호작용하며, 실행 오류를 자동으로 교정하고, 전략을 동적으로 조정하는 '에이전틱 로봇'으로 진화하고 있다. 이 분야의 빠른 성장에도 불구하고 연구들이 체계적으로 연결되지 않아 서로 다른 에이전틱 기능을 완전한 로봇 시스템으로 통합하는 방법이 명확하지 않은 상황이다. 논문은 로봇 정책에서 에이전틱 시스템으로의 발전을 추적하며 비전-언어-행동 모델, 월드 모델, 월드-행동 모델을 다룬다. 전체 요약 6문장 읽기 → 036 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 037 12:11 ▲ 323 · 댓글 1 장편 비디오 생성의 공간·시간 일관성을 위한 ATAS 프레임워크 장편 영화 시나리오를 비디오로 생성할 때 순서가 아닌 요청 사이에서도 공간과 시간 일관성을 유지해야 하는데, 기존 방식은 프롬프트나 최근 프레임만 전달해 장면 재방문이나 이전 사건 재재생에 필요한 공간 기준과 시간 기록을 제공하지 못했다. AI · 머신러닝 · Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation
Key Point 비디오 생성 AI가 긴 영상에서 장면 일관성을 유지해야 하는 핵심 문제를 해결하는 새로운 접근 방식을 제시하며, 기존 방법 대비 정량적·정성적 평가에서 모두 우수한 성과를 보여준다.
핵심 요약
장편 영화 시나리오를 비디오로 생성할 때 순서가 아닌 요청 사이에서도 공간과 시간 일관성을 유지해야 하는데, 기존 방식은 프롬프트나 최근 프레임만 전달해 장면 재방문이나 이전 사건 재재생에 필요한 공간 기준과 시간 기록을 제공하지 못했다. ATAS는 시나리오를 명시적인 위치, 카메라, 사건 시간 참조를 포함한 샷 요청으로 컴파일하는 방식으로, 생성 전 정적 기하학을 담은 장면 메모리와 시간별 동적 관찰을 담은 사건 메모리에서 관련 증거를 검색한다. 생성 후 ATAS는 클립을 재구성하고 등록하며, 검토와 상태 확인이 관찰을 수용할 때만 메모리를 업데이트하되 최종 영상 출력은 메모리 승인과 독립적으로 제공된다. 전체 요약 5문장 읽기 → 038 18:11 ▲ 96 · 댓글 2 장기 작업 자동화 AI, 밀도 높은 보상으로 학습 난제 해결 수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. AI · 머신러닝 · Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
Key Point 장기 자동화 작업의 학습 데이터 부족과 희소 보상 문제를 해결한 구체적인 방법론과 검증 가능한 데이터셋을 제시하여 오픈소스 장기 에이전트 개발의 실질적인 진전을 가능하게 한다.
핵심 요약
수 시간에서 수 일에 걸친 장기 과제를 자율적으로 수행하는 에이전트 개발이 주목받고 있으나, 오픈소스 모델들은 학습 데이터 부족과 효과적인 학습 방법 부재로 어려움을 겪고 있다. 연구팀은 Tev-Gym이라는 첫 번째 장기 에이전트 학습 데이터셋을 제시했으며, 7개 도메인의 1,170개 검증된 과제 환경을 포함하고 검증 가능한 밀도 높은 진행 보상을 제공한다. 잠재 세계 우선 접근법으로 작동하여 먼저 완전하고 정확한 숨겨진 작업 명세를 구성하고, 각 단계마다 예상되는 상태를 지정한 뒤, 과제를 점진적으로 렌더링해 제어 가능한 복잡성과 자연스러운 진행 지표를 제공한다. 전체 요약 6문장 읽기 → 039 18:11 ▲ 111 · 댓글 1 도시 전체 3D 장면에서 물체를 찾는 AI 에이전트 'Urbex' 공개 도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. AI · 머신러닝 · Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
Key Point 도시 규모 3D 장면 이해 문제를 에이전트 기반의 대화형 탐색으로 재설계해 기존 랭킹 방식의 비효율성을 타파한 새로운 접근법이기 때문입니다.
핵심 요약
도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. 기존 방식은 미리 계산한 후보 상자들을 순위매기는 방식이었는데, 대규모 실외 장면에서 비효율적이었다. Urbex는 비전-언어 모델 에이전트가 인터랙티브하게 탐색하도록 설계했다. 전체 요약 8문장 읽기 → 040 18:11 ▲ 53 · 댓글 2 이미지 속 상황의 진위를 판단하는 AI 에이전트 EviScene 이미지가 AI 생성인지 판별하는 것만으로는 그 장면이 사실인지 알 수 없다는 문제를 해결하기 위해 Image Factuality Assessment 작업을 정의했다. AI · 머신러닝 · EviScene: Beyond "Is It AI?" for Agentic Image Factuality Assessment
Key Point 이미지 조작이 늘어나는 환경에서 단순 AI 생성 여부가 아니라 그 장면의 실제 사실성을 검증할 수 있는 자동화된 방법이 중요해지고 있기 때문이다.
핵심 요약
이미지가 AI 생성인지 판별하는 것만으로는 그 장면이 사실인지 알 수 없다는 문제를 해결하기 위해 Image Factuality Assessment 작업을 정의했다. 이미지와 검증 지시문이 주어졌을 때 시스템이 지지 또는 반박 판정과 근거 기반 설명을 제시하는 방식으로, 텍스트 주장이 없어도 조사 중 점진적으로 팩트 질문을 정교화하고 외부 증거와 비교한다. 통제 생성과 웹 수집으로 만든 1만 174개 이미지(지지/반박)를 포함하며 12가지 팩트 오류 유형을 다루는 EviLens 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 041 15:11 ▲ 21 · 댓글 2 영상을 3D 장면으로 재구성하는 AI 에이전트 평가 벤치마크 공개 영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. AI · 머신러닝 · CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
Key Point 영상 생성 및 3D 재구성 기술의 발전 상황을 정량적으로 측정하는 공식 벤치마크가 처음 제시되었으며, 주요 AI 모델들의 구체적인 한계를 보여줍니다.
핵심 요약
영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. 벤치마크는 50개의 참조 영상과 360개의 주석이 달린 평가 클립으로 구성되며, 영화, 실제 영상, 게임 등 다양한 출처의 영상을 포함한다. 에이전트는 주어진 영상으로부터 도구를 사용해 3D 장면을 구성, 애니메이션, 렌더링, 개선하며, Proxy(기본), Simplified(간단), Detailed(상세) 세 가지 재현 수준으로 평가된다. 전체 요약 5문장 읽기 → 042 09:11 ▲ 30 · 댓글 2 언어 모델 에이전트를 위한 숨은 표현 자기증류 기법 제안 언어 모델 에이전트를 강화학습으로 훈련할 때, 특정 스킬을 가진 정책이 스킬 없는 버전을 가르치는 기존 자기증류 방식은 토큰 확률 변화가 미미한데 WebShop에서 성공률이 42.2%에서 56.2%로 크게 향상되는 모순이 있다. AI · 머신러닝 · PR-OPD: Privileged Representation On-policy Self-Distillation for Agentic Reinforcement Learning
Key Point 강화학습 기반 에이전트 훈련에서 은닉 상태 정렬이라는 새로운 자기증류 방식으로 기존 방법보다 상당히 높은 성능 개선을 이루었으며, 외부 자원 없이 단순한 구조로 실용적이다.
핵심 요약
언어 모델 에이전트를 강화학습으로 훈련할 때, 특정 스킬을 가진 정책이 스킬 없는 버전을 가르치는 기존 자기증류 방식은 토큰 확률 변화가 미미한데 WebShop에서 성공률이 42.2%에서 56.2%로 크게 향상되는 모순이 있다. 연구팀은 스킬이 응답 토큰의 80% 이상에서 은닉 상태를 변화시키며, 이 변화를 선형 프로브로 추적할 수 있다는 점을 발견했다. 이를 바탕으로 PR-OPD(Privileged Representation On-policy Self-Distillation) 방법을 제안하며, GRPO 사전학습 후 정책이 각 궤적에 대해 후지학적 스킬을 작성한다. 전체 요약 6문장 읽기 → 043 09:11 ▲ 121 · 댓글 56 게임 개발에서 AI를 제대로 쓰는 법 저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. AI · 머신러닝 · How to engineer an AI harness for game development
Key Point LLM이 게임 개발에서 실패하는 구체적 원인과 해결 방법을 제시하는 실용적 가이드로, 게임 개발자가 AI를 효과적으로 활용하기 위해 아키텍처 설계 단계부터 적용할 수 있는 전략을 설명한다.
핵심 요약
저자는 LLM이 웹 개발에는 뛰어나지만 게임 개발에는 약한 이유를 분석했다. 게임은 코드뿐 아니라 그래픽, 게임플레이, 물리 등 코드로 표현되지 않는 요소가 많아서 LLM이 이해하기 어렵기 때문이다. LLM과의 상호작용은 시스템 프롬프트, 어시스턴트 프롬프트, 사용자 프롬프트로 구성되며, 대화가 이어질수록 이전 메시지들이 계속 재제출되면서 컨텍스트가 쌓인다. 컨텍스트 오염(context pollution)을 줄이고 게임을 AI가 이해할 수 있게 만드는 '하네스(harness)' 개념을 도입해야 한다. 하네스는 AI 에이전트가 특정 작업을 더 잘 수행하도록 설계된 패턴과 도구의 집합이다. 전체 요약 9문장 읽기 → 044 15:11 ▲ 138 · 댓글 2 긴 작업 완수하는 AI 에이전트 학습 데이터 합성법 공개 장시간에 걸쳐 현실의 전문 업무를 완료하는 터미널 에이전트 개발에 적합한 학습 데이터가 부족한 문제를 다룬다. AI · 머신러닝 · Scaling Agentic Data for Long-Horizon Terminal Intelligence
Key Point 장시간 복잡한 작업을 자율적으로 완료해야 하는 AI 에이전트 개발 시 학습 데이터의 질과 특성이 모델 성능을 크게 좌우하기 때문에, 현실 기반의 효과적인 데이터 합성 방법론은 에이전트 연구 진행에 직결된다.
핵심 요약
장시간에 걸쳐 현실의 전문 업무를 완료하는 터미널 에이전트 개발에 적합한 학습 데이터가 부족한 문제를 다룬다. 기존 환경 합성 방식은 탐색, 구현, 검증 같은 에이전트의 핵심 활동을 미리 완료해 버려서 에이전트가 배울 수 없다는 한계가 있다. 이를 해결하기 위해 TerminalHorizon이라는 자동화된 데이터 합성 엔진을 제안하는데, 실제 전문 업무에서 시작해 독립 실행으로 빠진 작업을 파악하고 환경을 재구성한다. 전체 요약 7문장 읽기 → 045 18:12 ▲ 18 · 댓글 2 언어모델 에이전트의 온라인 학습을 위한 재귀형 프레임워크 제안 언어모델 에이전트가 장시간 상호작용 스트림에서 분포 변화에 온라인으로 적응해야 하는데, 기존 에이전트 프레임워크는 순방향 정보 흐름만 사용하거나 재학습용 추가 데이터가 필요했다. AI · 머신러닝 · Recurrent Harness for Agentic Continual Learning
Key Point 장시간 상호작용을 처리하는 AI 에이전트의 지속적 학습 능력이 추론 정확도와 안정성에 직결되기 때문에, 오직 온라인 스트림만으로 효과적인 적응을 가능하게 하는 기술이 실제 배포에 중요하다.
핵심 요약
언어모델 에이전트가 장시간 상호작용 스트림에서 분포 변화에 온라인으로 적응해야 하는데, 기존 에이전트 프레임워크는 순방향 정보 흐름만 사용하거나 재학습용 추가 데이터가 필요했다. ReHarness는 순방향 읽기·쓰기와 역방향 수정을 결합한 재귀형 하네스 프레임워크를 제안해, 순수한 온라인 스트리밍 프로토콜 하에서 연속 학습을 지원한다. 각 인스턴스 이후 결과 궤적을 피드백으로 삼아 해당 인스턴스에서 검색한 반영(reflection)을 수정함으로써, 텍스트 기반 하네스 상태를 통해 피드백을 역방향으로 전파한다. 전체 요약 5문장 읽기 → 046 18:12 ▲ 13 · 댓글 2 의료 AI가 스스로 증거를 찾는다, 종단 임상 추론 벤치마크 재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. AI · 머신러닝 · From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
Key Point 임상 데이터를 능동적으로 탐색하며 종단 추론을 수행하는 의료 AI 에이전트의 새로운 패러다임이 제시되며, 대규모 정제 벤치마크와 학습 방법이 함께 공개될 예정이기 때문이다.
핵심 요약
재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. CASE라는 역할별 임상 에이전트 시리즈와 도구 사용 장치, 컴팩트한 비전-언어 정책 모델 학습 프레임워크를 제안한다. UK Biobank 기반 종단 멀티모달 벤치마크를 구축했으며, 4,739명의 참여자로부터 도출한 ICD-10 코딩 진단에 기반한 50,401개 임상 질문을 포함한다. 전체 요약 8문장 읽기 → 047 12:11 ▲ 129 · 댓글 2 원본 시스템 없이 언어 기반 환경 모의 실행 만드는 Trace2Env LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. AI · 머신러닝 · From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation
Key Point 원본 환경 없이 과거 기록만으로 현실적인 에이전트 학습 환경을 만들 수 있다면, 접근 불가능한 레거시 시스템이나 폐쇄된 플랫폼에서도 LLM 에이전트를 훈련할 수 있게 된다.
핵심 요약
LLM 에이전트 학습·평가용 환경 모의 실행이 필요하지만, 원본 시스템 재구축은 불가능하거나 비현실적인 경우가 많다. 기존 실행 환경을 재건하지 않고 언어 모델이 에이전트의 환경 역할을 하는 '에이전틱 언어 월드 모델링' 방식을 제시한다. Trace2Env는 원본 시스템의 과거 상호작용 기록(trace)만으로 학습 없이 환경을 재구성하는 무학습 프레임워크다. 전체 요약 8문장 읽기 → 048 12:11 ▲ 72 · 댓글 2 멀티모달 AI를 네비게이션 도구와 연결한 로봇 시스템 일반적인 서비스 로봇이 낯선 환경에서 다양한 인간의 요청을 처리할 수 있는 네비게이션 시스템이 필요한 상황에서, 기존 방법들은 멀티모달 대형언어모델(MLLM)을 네비게이션 학습 데이터로 미세조정하면서 새로운 요청과 환경으로의 일반화 능력이 제한된다. AI · 머신러닝 · SuperNav: An Agentic Navigation System for Any Task in Any Scene
Key Point 로봇 네비게이션에서 MLLM의 일반화 능력을 보존하면서 실제 환경에 적용 가능한 새로운 접근법을 제시한다.
핵심 요약
일반적인 서비스 로봇이 낯선 환경에서 다양한 인간의 요청을 처리할 수 있는 네비게이션 시스템이 필요한 상황에서, 기존 방법들은 멀티모달 대형언어모델(MLLM)을 네비게이션 학습 데이터로 미세조정하면서 새로운 요청과 환경으로의 일반화 능력이 제한된다. SuperNav는 MLLM의 일반적 역량을 보존하면서 요청 해석, 장면 이해, 의사결정은 MLLM에 맡기고 움직임 실행은 네비게이션 도구에 위임하는 방식으로 설계되었다. 사전학습된 MLLM을 네비게이션별 미세조정 없이 에이전트 하네스(agent harness)로 장비하며, 이 하네스는 Navigation Skills, 물리적 상호작용용 에이전트 도구, 작업 진행률 및 문맥 관리를 지원한다. 전체 요약 6문장 읽기 → 049 18:30 ▲ 13 · 댓글 2 조 매개변수 모델도 3분 안에 동기화, NeMo-DCR 논문 발표 에이전트형 강화학습에서 정책 업데이트 후 롤아웃 클러스터로 전송하는 1조 개 매개변수 체크포인트가 현재 87.5분이 걸린다. AI · 머신러닝 · NeMo-DCR: Bit-Exact Delta-Compressed Refit for Scalable Agentic RL at Trillion-Parameter Scale
Key Point 조 개 매개변수 모델의 정책 리핏 시간을 87분에서 2~3분으로 단축하는 기술로, 대규모 에이전트형 강화학습의 실제 운영 가능성을 크게 높인다.
핵심 요약
에이전트형 강화학습에서 정책 업데이트 후 롤아웃 클러스터로 전송하는 1조 개 매개변수 체크포인트가 현재 87.5분이 걸린다. 매개변수 수정(refit) 시 BF16 학습에서 단계당 약 1%의 가중치만 변한다는 측정을 기반으로, NeMo-DCR은 변경값만 전송하면서 비트 단위로 정확히 일치하는 결과를 보장한다. 학습 샤드에서의 변경을 고정 아핀 매핑으로 체크포인트의 정규 좌표계로 투영하고, 잔여 변환으로 나머지를 처리하며, 수신 런타임의 기본 로더가 모든 변경을 저장소에 배치한다. 전체 요약 6문장 읽기 → 050 18:30 ▲ 16 · 댓글 2 LLM 추론 최적화를 사용자 맞춤형으로, PersonTTS 제안 LLM의 테스트 타임 스케일링(TTS)은 추가 추론 계산을 할당해 추론 능력을 개선하지만, 기존 방식들은 정확도-비용 또는 정확도-지연시간 중 하나의 파레토 경계만 최적화한다. AI · 머신러닝 · From Pareto to Preference: Personalized Test-Time Scaling via Amortized Agentic Policy Discovery
Key Point LLM 추론 과정을 다양한 사용자 요구(정확도·비용·속도)에 맞춰 최적화하는 문제를 처음 체계적으로 정식화하고, 이전 탐색 경험을 재사용해 계산 효율까지 확보하는 실용적 방법을 제시했다.
핵심 요약
LLM의 테스트 타임 스케일링(TTS)은 추가 추론 계산을 할당해 추론 능력을 개선하지만, 기존 방식들은 정확도-비용 또는 정확도-지연시간 중 하나의 파레토 경계만 최적화한다. 사용자 요구는 다차원적이다: 정확도, 지연시간, 추론 비용을 동시에 명시할 수 있으며, 서로 다른 요구는 다른 컨트롤러를 필요로 한다. PersonTTS는 사용자별 요구사항을 최대한 만족시키는 실행 가능한 컨트롤러를 발견하는 스케줄링 문제로 정식화한다. 전체 요약 7문장 읽기 → 051 18:30 ▲ 19 · 댓글 2 RAG 에이전트 평가 예산을 어떻게 배분할까 생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. AI · 머신러닝 · Agentic RAG Evaluation: Budget Allocation Across Questions, Trajectories, and Reads
Key Point RAG 시스템 평가에 투입할 제한된 예산을 질문, 탐색 경로, 반복 읽기 중 어디에 쓸지 결정하는 실증적 기준을 제시하므로, 대규모 언어모델 평가를 설계하는 연구자들이 의사결정할 때 직접 참고할 수 있다.
핵심 요약
생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. HotpotQA와 MuSiQue 데이터셋에서 회수 피드백 비교를 통해 3.4천만 토큰 예산에서 질문 커버리지를 넓히는 것이 다섯 번 반복 읽기보다 표준 오차를 33% 낮추고, 세 가지 탐색 경로보다 12.6% 낮춘다는 것을 측정했다. 저장된 예측 모델이 최적 배분을 4.0%(중첩 경로) 및 3.5%(질문만 사용) 범위 내에서 예측할 수 있음을 보였다. 전체 요약 6문장 읽기 → 052 18:30 ▲ 84 · 댓글 2 AI가 재미있는 게임을 만든다: 재귀적 평가 루프로 프로토타입을 완성작으로 기존 게임 개발 에이전트는 실행 가능한 게임을 만들지만, 프로그램 정확성만으로는 플레이어에게 재미있는 경험을 보장하지 못한다. AI · 머신러닝 · Recursive Game Creator: An Agentic Product-Level Experience-Oriented Game Harness
Key Point 게임 개발 AI가 단순히 '동작하는' 게임을 넘어 '재미있는' 게임을 만드는 구체적 방법론을 제시해, 에이전트 기반 창작 도구의 평가 기준을 바꾼다.
핵심 요약
기존 게임 개발 에이전트는 실행 가능한 게임을 만들지만, 프로그램 정확성만으로는 플레이어에게 재미있는 경험을 보장하지 못한다. Recursive Game Creator는 Designer, Builder, Player, Reviewer 네 개 컴포넌트로 프로토타입을 재귀적으로 개선해 완성도 높은 게임으로 발전시킨다. Designer는 사용자 지시사항과 Reviewer의 피드백을 구체적 계획으로 변환하고, Builder가 이를 게임 후보로 구현한다. 전체 요약 7문장 읽기 → 053 06:11 ▲ 15 · 댓글 1 로봇이 시뮬레이션에서 배운 조작 기술을 현실에서 바로 쓴다 로봇이 시뮬레이션과 현실의 차이(시각, 역학, 몸체)를 넘어 기술을 옮기는 문제를 해결하는 Skill2Real 프레임워크를 제시했다. 하드웨어 · 시스템 · Skill2Real: Agentic Skill Learning for Zero-Shot Sim-to-Real Robot Manipulation
Key Point 시뮬레이션 학습으로 실제 로봇 조작을 성공시키는 과정이 공개됨에 따라, 로봇 개발의 데이터 수집 비용과 안전 리스크를 크게 줄일 수 있는 경로가 가시화되었다.
핵심 요약
로봇이 시뮬레이션과 현실의 차이(시각, 역학, 몸체)를 넘어 기술을 옮기는 문제를 해결하는 Skill2Real 프레임워크를 제시했다. 공통 API로 실행 가능한 스킬을 학습하며, Proposer-Verifier-Governor(PVG) 루프가 시뮬레이션 정보로 결과를 진단하고 업데이트를 검증한다. 소뇌(Cerebellum)에서 조작 스킬을 먼저 획득한 뒤 뇌(Brain)에서 소뇌를 고정하고 과제 수준의 조합을 학습한다. 전체 요약 8문장 읽기 → 054 03:11 ▲ 48 · 댓글 3 LLM 에이전트의 장기 작업 검증 성능 6배 향상 LLM 에이전트가 복잡한 장기 작업을 수행할 때 출력 검증이 어려워지는 문제를 다룬다. AI · 머신러닝 · VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
Key Point 장기 작업을 수행하는 AI 에이전트 시스템의 신뢰성 검증 방식이 근본적으로 달라지는 기술로, 다중 시도 결과의 품질 판별 문제를 자동으로 해결할 수 있다.
핵심 요약
LLM 에이전트가 복잡한 장기 작업을 수행할 때 출력 검증이 어려워지는 문제를 다룬다. 여러 번 샘플링한 결과물들이 서로 다른 올바른 주장들을 담을 수 있지만, 어느 것을 믿을지 판단할 신뢰할 수 있는 검증 메커니즘이 필요하다. 의견 불일치는 올바른 대안을 드러내는 경향이 있고, 합의는 오류를 숨길 수 있다는 관찰에서 VeriHarness를 제안한다. 전체 요약 8문장 읽기 → 055 00:11 ▲ 11 · 댓글 2 동영상 AI가 글씨를 제대로 쓰지 못한다 최신 동영상 생성 모델들이 자연어 지시로 현실 같은 영상을 만들어내지만, 기존 평가 기준은 시각 품질과 물리적 타당성에만 집중해 장면 속 텍스트 렌더링을 제대로 평가하지 못하고 있다. AI · 머신러닝 · VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation
Key Point 동영상 생성 AI 모델들이 영상 품질은 우수하지만 장면 속 글씨 렌더링이라는 맹점을 가진 이유를 체계적으로 드러내며, 텍스트 기반 평가 기준이 필요함을 보여준다.
핵심 요약
최신 동영상 생성 모델들이 자연어 지시로 현실 같은 영상을 만들어내지만, 기존 평가 기준은 시각 품질과 물리적 타당성에만 집중해 장면 속 텍스트 렌더링을 제대로 평가하지 못하고 있다. 광고와 과학 영상 등 5가지 실제 사용 사례를 바탕으로 300개의 프롬프트로 구성된 VTR-Bench 벤치마크를 개발했으며, 텍스트 충실도를 평가하는 자동화 파이프라인과 인간 평가 기준을 포함한다. Director 에이전트가 이미지·동영상 생성과 시각 평가를 조율하며 반복적 개선을 진행하는 Keyframe-Guided Agentic Framework를 함께 제시한다. 전체 요약 5문장 읽기 → 056 21:11 당일 +105 프로덕션 RAG 시스템을 7주에 실전 구축하기 arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. AI · 머신러닝 · jamwithai/production-agentic-rag-course · Python
Key Point 기업 수준의 RAG 시스템 구축 방식을 처음부터 끝까지 직접 구현하며 배울 수 있으며, 에이전트 기반의 지능형 검색과 모니터링을 모두 다루기 때문이다.
핵심 요약
arXiv 논문을 자동으로 수집하고 분석하는 AI 연구 어시스턴트를 직접 만드는 실습 강좌다. Week 1-7에 걸쳐 Docker, FastAPI, PostgreSQL, OpenSearch, Airflow 등 현대적 스택으로 인프라를 구축한다. Week 2는 arXiv API와 Docling을 이용한 PDF 파싱으로 데이터 파이프라인을 자동화한다. 전체 요약 12문장 읽기 → 057 03:11 당일 +336 AI 에이전트의 메모리를 영구 보존하는 claude-mem Claude Code, OpenClaw, Codex, Gemini, Hermes, Copilot 등 다양한 AI 에이전트와 호환되는 메모리 압축 시스템으로, 세션 중 에이전트의 모든 활동을 캡처하고 AI로 압축한 후 이후 세션에 관련 맥락을 주입한다. AI · 머신러닝 · thedotmack/claude-mem · TypeScript
Key Point 세션이 끝나도 AI 에이전트가 이전 작업 맥락을 자동으로 기억하게 해주는 기술로, 장기 프로젝트에서 에이전트의 연속성을 유지하는 방식이 어떻게 구현되는지 보여준다.
핵심 요약
Claude Code, OpenClaw, Codex, Gemini, Hermes, Copilot 등 다양한 AI 에이전트와 호환되는 메모리 압축 시스템으로, 세션 중 에이전트의 모든 활동을 캡처하고 AI로 압축한 후 이후 세션에 관련 맥락을 주입한다. 5개의 생명주기 훅(SessionStart, UserPromptSubmit, PostToolUse, Stop, SessionEnd)과 스마트 설치 기능으로 작동하며, Bun 기반 워커 서비스가 로컬 HTTP API와 웹 뷰어 UI를 제공한다. SQLite 데이터베이스에 세션과 관찰 내용을 저장하고, Chroma 벡터 데이터베이스를 통해 하이브리드 의미론적 검색과 키워드 검색을 지원하는 mem-search 기능으로 프로젝트 히스토리를 자연어로 쿼리할 수 있다. 전체 요약 10문장 읽기 → 058 21:11 당일 +103 Claude를 위한 개발 생산성 스킬 모음 공개 HumanLayer에서 Claude Code를 위한 6개의 확장 스킬을 공개했다. 웹 · 프론트엔드 · humanlayer/skills · TypeScript
Key Point Claude Code 사용자가 코드 리뷰, 문서화, 타입 안정성, 자동화 워크플로우를 한 번에 개선할 수 있는 공식 스킬 모음이 출시되어 개발 생산성 향상 경로가 제시된다.
핵심 요약
HumanLayer에서 Claude Code를 위한 6개의 확장 스킬을 공개했다. show-me는 현재 주제를 다이어그램과 코드 스케치, HTML 아티팩트로 설명한다. visual-pr은 변경사항을 시각적으로 요약한 풀 리퀘스트를 생성하거나 업데이트해 리뷰어의 이해를 돕는다. 전체 요약 7문장 읽기 → 059 18:11 ▲ 75 · 댓글 2 LLM이 스스로 개선하며 게임을 만든다 LLM으로 게임을 자동 생성하는 것은 가능해졌으나, 단순 반복 개선은 작은 테스트 세트에 과적합되어 버그와 동작 누락, 일반화 부족 문제를 남긴다. AI · 머신러닝 · RSIGame: Autonomous Agentic Game Development with Recursive Self-improvement
Key Point LLM 기반 게임 생성의 품질 문제를 재귀적 자기개선으로 해결하며, 작은 모델도 더 큰 모델을 능가할 수 있음을 보여준다.
핵심 요약
LLM으로 게임을 자동 생성하는 것은 가능해졌으나, 단순 반복 개선은 작은 테스트 세트에 과적합되어 버그와 동작 누락, 일반화 부족 문제를 남긴다. RSIGame은 로컬 루프(탐색-진단-개선)와 글로벌 루프(품질 추적, 최고 체크포인트 보존, 포화/회귀 감지)로 게임 개발을 조직화한다. 로컬 루프에서는 실행 가능한 게임을 광범위하게 탐색하고 발견한 문제를 진단·우선순위화하며, 계속 누적되는 테스트 가이드라인을 바탕으로 근거 기반의 개선을 수행한다. 전체 요약 6문장 읽기 → 060 18:11 ▲ 44 · 댓글 3 LLM의 자동화 연구를 체계적으로 관리하는 'AIM' 프레임워크 최신 LLM을 활용한 자동화 연구에서 아이디어 관리의 중요성을 제시하고, 아이디어 중심 탐색과 솔루션 중심 탐색을 구분했다. AI · 머신러닝 · AIM: Agentic Idea Management for Automated Research
Key Point LLM 기반 자동화 연구가 활발해지는 가운데, 단순한 시도-오류가 아닌 체계적 아이디어 관리 방식을 제시해 효율성을 대폭 높이는 방법론을 제공한다.
핵심 요약
최신 LLM을 활용한 자동화 연구에서 아이디어 관리의 중요성을 제시하고, 아이디어 중심 탐색과 솔루션 중심 탐색을 구분했다. 연구 아이디어 조직화, 유망한 방향 선택, 아이디어와 구현 간 정렬 유지라는 3가지 핵심 문제를 식별했다. Agentic Idea Manager(AIM)는 베이지안 최적화에서 영감을 받아, Agentic Surrogate와 Agentic Acquisition 메커니즘으로 발견된 아이디어를 조직화하고 선택을 안내한다. 전체 요약 7문장 읽기 → 061 15:11 ▲ 45 · 댓글 2 실패한 에이전트 50,000개로 배우는 오류 진단 데이터셋 AI 에이전트의 실패 사례를 수집·분석하기 위해 9,961개 작업에서 나온 50,228개의 오류-진단 쌍으로 구성된 Agent Error Dataset(AED)을 제시한다. AI · 머신러닝 · Agent Error Dataset: Scaling 50,000 Error--Diagnosis Pairs for Failure Analysis and Error-Aware Post-Training
Key Point LLM 에이전트의 실패 경험을 체계적으로 수집하고 진단하는 대규모 데이터셋으로, 기존의 성공 사례만으로 학습하는 방식의 한계를 극복하고 오류 인식 학습을 가능하게 한다.
핵심 요약
AI 에이전트의 실패 사례를 수집·분석하기 위해 9,961개 작업에서 나온 50,228개의 오류-진단 쌍으로 구성된 Agent Error Dataset(AED)을 제시한다. 33개 환경, 19개 하네스 패밀리, 23개 정책 모델에서 텍스트 기반 에이전트 시스템의 자연스러운 실패를 기록했으며, 원본 롤아웃을 반복하지 않고도 교차 환경 실패 분석이 가능하도록 소스 추적과 실행 메타데이터를 보존했다. 5단계 Agentic Error-to-Training(AET) 파이프라인으로 자연스러운 실패를 수집하고, 진단과 수정 방안을 생성한 후 기록된 증거와 대조하여 검증한다. 전체 요약 7문장 읽기 → 062 06:11 ▲ 14 · 댓글 1 AI가 이미지 생성 명령어를 자동 최적화 — 다중 참고 이미지 합성 성능 향상 최신 이미지 생성 모델은 여러 참고 이미지를 입력받아 새로운 이미지로 합성할 수 있지만, 피사체 생략·중복·부자연스러운 합성 같은 문제가 남아있다. AI · 머신러닝 · AutoRef: Harness Optimization for Agentic Multi-Reference Image Generation
Key Point 다중 참고 이미지를 정확히 합성하는 방법이 AI 생성 품질을 크게 결정하는데, 기존의 손으로 만든 명령어 대신 자동으로 최적화하는 기법이 상용 모델 수준의 결과를 만들어낸 점이 중요하다.
핵심 요약
최신 이미지 생성 모델은 여러 참고 이미지를 입력받아 새로운 이미지로 합성할 수 있지만, 피사체 생략·중복·부자연스러운 합성 같은 문제가 남아있다. 최근 연구들은 이미지 생성 모델·추론 모델·하네스(생성 방식을 정의하는 실행 프로그램)를 결합한 에이전트 기반 접근법을 제안했다. 다중 참고 이미지 생성에서는 각 참고 이미지의 충실도·전체 이미지의 자연스러움 등 여러 기준을 동시에 만족해야 하므로, 참고 이미지 처리부터 출력 진단까지 하네스의 많은 부분이 개선될 여지가 있다. 전체 요약 8문장 읽기 → 063 00:11 ▲ 17 · 댓글 1 장편 영상 스토리 일관성 유지하는 AI 프레임워크 공개 AI 에이전트가 여러 장면으로 긴 영상을 생성할 때 스토리의 일관성을 유지하는 것이 어렵다는 문제가 있다. AI · 머신러닝 · StoryEngine: A State-Grounded Agentic Framework for Video Storytelling
Key Point 영상 생성 AI가 장편 콘텐츠에서 등장인물·배경의 일관성을 유지하지 못하는 근본적인 한계를 '상태 추적'으로 해결하는 첫 체계적 접근이라는 점에서 의미가 있습니다.
핵심 요약
AI 에이전트가 여러 장면으로 긴 영상을 생성할 때 스토리의 일관성을 유지하는 것이 어렵다는 문제가 있다. 기존 방식은 텍스트 기반 계획이나 이전 프레임에만 의존해 스토리 이벤트의 결과를 명시적으로 추적하지 않아 시각적 오류가 누적된다. 연구팀이 제안한 StoryEngine은 구조화된 상태 표현으로 등장인물·소품·스토리 상태를 추적하고, 각 장면의 시작·종료 상태를 정의한다. 전체 요약 7문장 읽기 → 064 18:11 ▲ 76 · 댓글 1 엔티티 기반 코퍼스 맵으로 문서 검색 효율 높인다 여러 문서에 흩어진 정보를 연결해야 하는 질문이나 작업 완료 시 LLM 에이전트가 전체 코퍼스를 반복 검색하는 방식은 비효율적이고 토큰을 많이 소비한다. AI · 머신러닝 · Follow the Entities: A Corpus Map for Agentic Search
Key Point LLM 에이전트 기반 문서 검색 시 엔티티 그래프를 활용하면 반복적인 재검색을 줄이고 더 효율적으로 증거를 연결할 수 있다는 점이 실무 기반 추론 시스템에 영향을 미칠 수 있다.
핵심 요약
여러 문서에 흩어진 정보를 연결해야 하는 질문이나 작업 완료 시 LLM 에이전트가 전체 코퍼스를 반복 검색하는 방식은 비효율적이고 토큰을 많이 소비한다. 연구팀이 제안한 CorpusMap은 코퍼스를 엔티티(개체)를 중심으로 조직화하는 네비게이션 레이어로, 문서에서 자동 추출한 반복되는 엔티티를 Entity Page로 표현한다. 각 Entity Page는 해당 엔티티에 대한 정보를 모으고 그 엔티티를 언급하는 모든 문서로 링크를 연결해 엔티티-문서 간 그래프를 구성한다. 전체 요약 6문장 읽기 → 065 18:11 ▲ 69 · 댓글 1 다자간 음성대화 위한 상호작용 인식 메모리 프레임워크 제안 기존 연구는 1대1 텍스트나 이미지-텍스트 대화의 장기 메모리에 집중했으나, 다자간 음성대화에서의 장기 메모리는 미개척 상태다. AI · 머신러닝 · Beyond Dyadic Memory: Interaction-Aware Multimodal Memory with Adaptive Agentic Retrieval for Multi-Party Spoken Conversations
Key Point 다자간 음성대화에서 장기 메모리와 참여자 추적을 동시에 다루는 실질적인 프레임워크를 제시하며, 멀티모달 에이전트 시스템의 실용적 응용 가능성을 보여준다.
핵심 요약
기존 연구는 1대1 텍스트나 이미지-텍스트 대화의 장기 메모리에 집중했으나, 다자간 음성대화에서의 장기 메모리는 미개척 상태다. 다자간 음성대화에서는 대화 내용 보존, 세션 간 참여자 식별, 누가 누구에게 말하는지 추적하기가 필요하다. 연구팀은 VoxPolyMem을 제안했는데, 점진적 화자 식별과 상호작용 메모리·사실 메모리·참여자 프로필로 구성된 메모리 계층을 결합한 상호작용 인식 멀티모달 메모리 프레임워크다. 전체 요약 8문장 읽기 → 066 15:11 ▲ 455 · 댓글 3 LLM 에이전트를 조합하는 'Raven' 프레임워크 공개 대규모언어모델 기반 AI 에이전트가 단일 도메인 작업을 넘어 장기·교차도메인 워크플로우로 확장되면서, 수동 설계로는 복잡도 관리와 도메인 일반성 확보가 어려워지고 있다. AI · 머신러닝 · Raven: The Harness of Harnesses for Composable Agentic Intelligence
Key Point LLM 에이전트 시스템이 점점 복잡해지면서 단일 설계로는 감당할 수 없는 상황에서, 여러 전문 에이전트를 자동으로 조합·진화시키는 새로운 패러다임이 제시됐으며, 복잡한 실무 작업을 처리하는 방식이 달라질 수 있다.
핵심 요약
대규모언어모델 기반 AI 에이전트가 단일 도메인 작업을 넘어 장기·교차도메인 워크플로우로 확장되면서, 수동 설계로는 복잡도 관리와 도메인 일반성 확보가 어려워지고 있다. Raven은 오픈소스 멀티에이전트 생태계로, 특정 모델과 도메인에 맞는 '하네스(harness, 에이전트 제어 구조)'를 자동으로 구축·진화시키며 각 모델-하네스 쌍을 조합 가능한 지능 단위로 취급한다. Host Agent가 목표를 분해하고 부작업을 전문 에이전트에 할당하며 실행 의존성을 조정하고, Host Archive와 EverOS가 경험을 보존하고, Skill Forge가 재사용 가능한 절차로 변환한다. 전체 요약 5문장 읽기 → 067 21:11 ▲ 112 · 댓글 2 코드 에이전트 강화학습에서 품질 기반 보상 재분배하는 GAGAR 제안 기존 코드 에이전트 강화학습은 실행 가능한 테스트로 이진 보상을 제공하는데, Group Relative Policy Optimization(GRPO)은 테스트를 통과한 모든 궤적에 동일한 이득을 할당하여 구현 품질의 차이를 무시하는 문제가 있다. AI · 머신러닝 · Groupwise Agentic Grading and Advantage Redistribution for Code Agent RL
Key Point 테스트 통과 여부만 판단하던 기존 강화학습에서 구현 품질 차이를 감지하는 에이전트를 추가하면 코드 생성 모델의 학습 신호가 더 정교해진다.
핵심 요약
기존 코드 에이전트 강화학습은 실행 가능한 테스트로 이진 보상을 제공하는데, Group Relative Policy Optimization(GRPO)은 테스트를 통과한 모든 궤적에 동일한 이득을 할당하여 구현 품질의 차이를 무시하는 문제가 있다. 이를 보완하기 위해 GAGAR 프레임워크를 제안하는데, 통과 및 실패 궤적을 모두 포함하는 그룹만 선별하여 동적 샘플링한다. 각 그룹의 모든 궤적을 공유 작업공간에 놓고, SFT 학습된 에이전트 평가자가 이들을 함께 검사하여 테스트 통과 후보들을 순위 매긴다. 전체 요약 7문장 읽기 → 068 09:11 ▲ 108 · 댓글 44 Cloudflare가 AI 에이전트를 위한 새로운 CLI 'cf' 공개 Cloudflare는 AI 에이전트 전용으로 설계한 새로운 CLI 도구 'cf'를 오픈 베타로 출시했다. 인프라 · 데브옵스 · Cf: The Agentic CLI for the Cloudflare API
Key Point AI 에이전트의 CLI 사용 비중이 급증하는 상황에서 3,000개 이상의 API를 접근 가능하게 하는 새로운 도구로, 에이전트 중심의 소프트웨어 개발 흐름을 본격 지원하는 전환점이 된다.
핵심 요약
Cloudflare는 AI 에이전트 전용으로 설계한 새로운 CLI 도구 'cf'를 오픈 베타로 출시했다. 지난해 에이전트의 Wrangler 사용량은 단일 숫자 비중에서 3월 2026년 25%로 증가했고, 지난주에는 48%에 도달했다. 기존 Wrangler는 약 280개 명령만 지원했으나, cf는 Forge 자동 생성 파이프라인을 통해 3,000개 이상의 Cloudflare API 작업 전체를 커버한다. 전체 요약 11문장 읽기 → 069 06:11 ▲ 412 · 댓글 276 Claude Sonnet 5.5 공개, Sonnet 5 대비 30% 빠르고 저렴 Anthropic이 Claude Sonnet 5.5를 발표했으며, Sonnet 5보다 30% 이상 빠르고 대부분의 작업에서 최대 30% 저렴하다. AI · 머신러닝 · Sonnet 5.5
Key Point Sonnet 5.5는 코딩과 일상적 지식 작업에서 이전 세대보다 대폭 개선되면서도 비용을 크게 낮춰 개발자의 생산성과 경제성을 동시에 높일 수 있는 새로운 기준을 제시한다.
핵심 요약
Anthropic이 Claude Sonnet 5.5를 발표했으며, Sonnet 5보다 30% 이상 빠르고 대부분의 작업에서 최대 30% 저렴하다. Sonnet 5.5는 Opus 5.5의 보완재로, 일상적인 작업·버그 수정·문서/슬라이드/스프레드시트 작성에 최적화되어 있고 디자인 감각이 뛰어나다. 기술 성능에서 코딩 작업의 agentic 평가인 Terminal-Bench 4.0에서 70.6%를 기록해 Sonnet 5의 10.3%에서 대폭 상승했고, GDPval-AA 테스트에서는 Opus 5.5에 2점 차이로 근접했다. 전체 요약 12문장 읽기 → 070 18:11 ▲ 107 · 댓글 32 Recurse Center의 여름, 프로그래밍으로 무엇을 배웠나 Recurse Center는 뉴욕 브루클린의 프로그래밍 집중 프로그램으로, 저자는 여름 배치에서 다양한 스터디 그룹과 프로젝트에 참여했다. 기타 · What I did at Recurse Center
Key Point 프로그래밍 집중 프로그램에서 LLM·알고리즘·언어학을 넘나들며 정말 만든 것들을 보려면 참가자들이 실제 무엇을 만들었는지 구체적으로 알아야 한다.
핵심 요약
Recurse Center는 뉴욕 브루클린의 프로그래밍 집중 프로그램으로, 저자는 여름 배치에서 다양한 스터디 그룹과 프로젝트에 참여했다. Agentic Adventures 그룹에서는 LLM과 에이전트를 주제로 원격 샌드박스 구축, 'Just One' 게임 제작, minGPT 실습 등을 진행했다. Practical Deep Learning 스터디 그룹을 통해 Jeremy Howard의 책을 함께 읽으며 고전 머신러닝부터 신경망 구축까지 학습했다. 전체 요약 13문장 읽기 → 071 21:11 ▲ 12 · 댓글 1 수학 모델에서 자동으로 에이전트 학습 환경 생성 Language model 에이전트의 장기 작업 학습을 위해 다양한 환경이 필요하지만, 기존 방식은 환경 구성 후 평가 규칙을 나중에 맞추는 문제가 있다. AI · 머신러닝 · Verifiable Hidden Dynamics Play: Generating Agentic RL Environments from Solved Mechanisms
Key Point 기존 환경 생성 방식의 비일관성 문제를 해결하면서도 낮은 비용으로 대규모 다양한 학습 데이터를 자동 생성할 수 있는 새로운 파이프라인이 실제 벤치마크에서 검증되었기 때문이다.
핵심 요약
Language model 에이전트의 장기 작업 학습을 위해 다양한 환경이 필요하지만, 기존 방식은 환경 구성 후 평가 규칙을 나중에 맞추는 문제가 있다. VHD-Play는 이 순서를 역전하여, 먼저 수학 모델을 샘플링하고 풀이한 뒤 그 결과를 바탕으로 stateful 도구로 변환한다. 실행 가능한 환경 동작과 궤적 평가 기준이 같은 풀이된 모델에서 나오므로 일관성이 보장된다. 전체 요약 9문장 읽기 → 072 03:11 ▲ 107 · 댓글 46 AI 시대, 경험을 내려놓고 원점에서 생각하라 Sunil Pai의 시니어 엔지니어 '죽음의 소용돌이' 글에서 영감을 받아, 경험 많은 개발자들이 겪는 정체 상태를 분석한다. AI · 머신러닝 · First Principles Thinking
Key Point 시니어 엔지니어들이 새로운 기술에 적응하지 못하는 이유와 해결책을 제시하는데, 경험을 일단 내려놓고 원점에서 생각하는 방식이 AI 시대의 핵심 경쟁력이 될 수 있음을 보여준다.
핵심 요약
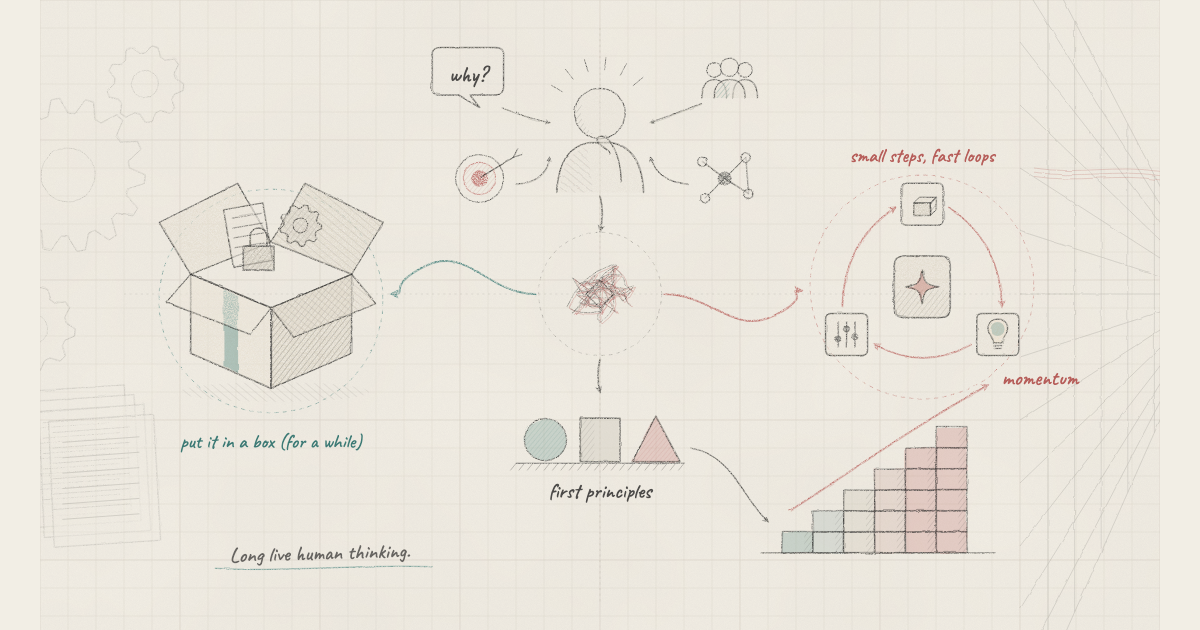
Sunil Pai의 시니어 엔지니어 '죽음의 소용돌이' 글에서 영감을 받아, 경험 많은 개발자들이 겪는 정체 상태를 분석한다. 시니어 엔지니어가 뛰어난 이유는 직관적으로 '해야 할 일'을 알기 때문인데, 이는 제일원리(first principles) 사고로부터 나온다고 본다. 제일원리 사고란 '왜 우리가 이걸 만드는가', '사용자에게 어떤 도움이 되나' 같은 근본적인 질문을 던지는 습관을 말한다. 전체 요약 10문장 읽기 → 073 03:11 ▲ 26 · 댓글 2 System One/Two 인지로 AI 에이전트 메모리 최적화 Jev-Mem은 인간의 빠른 사고(System One)와 느린 추론(System Two)을 모방한 AI 에이전트 메모리 아키텍처다. AI · 머신러닝 · Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents
Key Point 장시간 작업을 처리하는 AI 에이전트의 성능과 속도가 메모리 관리 효율성에 달려있고, 이 논문이 기존의 비싼 LLM 기반 메모리 시스템을 크게 개선하는 구조를 제시한다.
핵심 요약
Jev-Mem은 인간의 빠른 사고(System One)와 느린 추론(System Two)을 모방한 AI 에이전트 메모리 아키텍처다. System One 제어부가 메모리 타입 지정, 관계 조직화, 쿼리 라우팅, 검색 예산 할당, 그래프 순회, 후보 점수 매김, 적응형 중단을 담당한다. System Two는 복잡한 추론과 답변 종합이 필요할 때만 호출되어 LLM 생성 비용을 줄인다. 전체 요약 5문장 읽기 → 074 16:18 ▲ 29 · 댓글 2 AI 디자이너가 사용자 경험에서 배우는 '절차 메모리' 시스템 Claude 같은 고정된 언어모델이 230개 이상의 그래픽 디자인 도구를 다루면서, 자연어로 된 설계 절차를 자동으로 축적·개선하는 '절차 메모리' 프레임워크를 제시했다. AI · 머신러닝 · Designer-RSI: Evolving Procedural Memory from User Traffic for Agentic Graphic Design
Key Point LLM 기반 에이전트가 노이즈 많은 실제 사용자 데이터로 자동 학습하면서 성능이 극적으로 개선되는 메커니즘이 새로운 접근이며, 그래픽 디자인 같은 모호한 작업에서 AI 능력의 한계를 확장하는 방식을 보여준다.
핵심 요약
Claude 같은 고정된 언어모델이 230개 이상의 그래픽 디자인 도구를 다루면서, 자연어로 된 설계 절차를 자동으로 축적·개선하는 '절차 메모리' 프레임워크를 제시했다. 1,406건의 실제 사용자 요청과 1,869개의 자동 평가 궤적으로 5라운드 학습한 결과, 기초 스킬 76개에서 139개로 늘어났고 생성 품질이 72.7%에서 99.3%로 향상됐다. 메모리 확장(새 절차 습득)과 개선(기존 절차 수정)의 두 메커니즘을 함께 쓸 때 별도 적용보다 효과가 커서, 비숙련 에이전트 대비 58.5% 승률을 기록했다. 전체 요약 4문장 읽기 → 075 16:18 ▲ 112 · 댓글 3 깃허브 코드에서 AI 에이전트용 스킬 자동 추출 Code2Skill이라는 파이프라인으로 19,769개 깃허브 저장소의 코드를 자동 분석해 100만 개 이상의 검증된 스킬 데이터베이스를 구축했다. AI · 머신러닝 · Grounded Skill Synthesis from Code at Scale for Agentic Intelligence
Key Point 에이전트 AI에 필요한 재사용 가능한 스킬을 스케일로 자동 확보할 수 있는 새로운 경로를 제시하며, 기존 방법의 한계를 보완하는 동시에 성능 개선을 입증했다.
핵심 요약
Code2Skill이라는 파이프라인으로 19,769개 깃허브 저장소의 코드를 자동 분석해 100만 개 이상의 검증된 스킬 데이터베이스를 구축했다. 추출한 스킬에는 원자적 작업, 복합 워크플로우, 반복 패턴이 포함되며 소스 코드 재구성과 비교로 검증된다. 이 방식은 환경 상호작용이 필요 없으면서도 실행 가능한 증거를 제공한다는 점에서 기존 궤적 기반 방식과 다르다. 전체 요약 5문장 읽기 → 076 16:18 ▲ 127 · 댓글 3 소스코드만으로 강화학습 환경 자동 구축하는 CodeMidas CodeMidas는 오픈소스 저장소의 소스코드만을 이용해 5,545개 강화학습 환경을 자동 구축했다. AI · 머신러닝 · CodeMidas: Scaling Agentic Coding RL Environments from Code Itself
Key Point 소스코드 자체만으로 대규모 RL 환경을 자동 구축해 코딩 에이전트 훈련의 확장성 문제를 해결했으며, 실제 벤치마크에서 10~17%의 성능 향상을 달성했기 때문이다.
핵심 요약
CodeMidas는 오픈소스 저장소의 소스코드만을 이용해 5,545개 강화학습 환경을 자동 구축했다. 에이전트가 코드베이스의 기능을 탐색하여 명세를 작성하고, 실행 기반 테스트를 생성한 뒤 검증하는 3단계 파이프라인을 거친다. 23개 프로그래밍 언어와 15개 기술 도메인의 3,185개 코드베이스에서 수집되었다. 전체 요약 5문장 읽기 → 077 12:10 ▲ 260 · 댓글 102 구글 오픈소스 에이전트 오케스트레이터 'AX' 공개 구글이 개발한 에이전트 실행 플랫폼 AX를 오픈소스로 공개했다. 인프라 · 데브옵스 · AX - Google's Open Agentic Orchestrator
Key Point 에이전트 개발·배포가 기존 마이크로서비스 오케스트레이터로는 비효율적이라는 새로운 요구를 해결하는 인프라가 나왔으므로, 에이전트 기반 애플리케이션을 운영하려는 팀은 적용 방안을 검토할 필요가 있다.
핵심 요약
구글이 개발한 에이전트 실행 플랫폼 AX를 오픈소스로 공개했다. 에이전트 작업을 선언적으로 정의하면 AX가 샌드박스 환경에서 안전하게 격리하여 실행하며, 클러스터당 수십억 개 규모의 작업을 처리할 수 있다. 작업(Task), 워크스페이스(Workspace), 게이트웨이(Gateway), 모델(Model) 네 가지 기본 구성 요소로 이루어져 있다. 전체 요약 5문장 읽기 → 078 21:11 당일 +128 AI 에이전트 구축 원리부터 실전까지 완전 가이드 Datawhale 커뮤니티가 에이전트 개발자를 위한 무료 오픈소스 교육 프로젝트 'Hello-Agents'를 공개했다. AI · 머신러닝 · datawhalechina/hello-agents · Python
Key Point 2025년 '에이전트 원년'에 접어든 시점에서 기초부터 실전까지 체계적으로 AI 에이전트를 배우고 구축할 수 있는 실제 프로젝트 기반의 무료 교재를 얻을 수 있기 때문이다.
핵심 요약
Datawhale 커뮤니티가 에이전트 개발자를 위한 무료 오픈소스 교육 프로젝트 'Hello-Agents'를 공개했다. 기초 이론(ReAct, Plan-and-Solve, Reflection 등)부터 실제 구축까지 16개 장으로 구성되었으며, AI 네이티브 에이전트 시스템의 구조와 핵심 원리를 다룬다. AutoGen, AgentScope, LangGraph 같은 주류 프레임워크 활용법과 직접 에이전트 프레임워크를 만드는 방법을 포함한다. 전체 요약 6문장 읽기 →