001 03:11 ▲ 138 · 댓글 58 H.264가 영상을 300배 줄이는 방법 H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. 웹 · 프론트엔드 · H.264 Is Magic (2016)
Key Point 화소당 수십 바이트를 필요로 하는 영상 데이터를 수백 배 이상 압축하는 구조를 이해하면, 인터넷 동영상이 실시간 재생되고 드론과 보안카메라가 원활하게 작동하는 이유를 알 수 있다.
핵심 요약
H.264는 영상 압축 코덱으로 인터넷 영상, 블루레이, 핸드폰, 보안카메라 등 거의 모든 곳에서 쓰인다. 압축 없이 저장하면 1080p 60Hz 영상이 초당 370MB 이상 용량을 차지해 실용적이지 않다. H.264의 핵심은 손실 압축(lossy compression)으로, 중요하지 않은 부분의 정보를 버린다. PNG처럼 모든 정보를 유지하는 무손실 압축과 달리, H.264는 사람이 감지하기 어려운 세부사항을 제거한다. 양자화(quantization)라는 기법으로 영상을 주파수 영역으로 변환하고, 고주파 성분(세밀한 디테일)을 마스킹해 제거하면 사람 눈에 거의 띄지 않으면서도 용량을 극도로 줄일 수 있다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 49 · 댓글 2 3D 기하정보로 다각도 영상 생성, OmniShowcase 공개 참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. AI · 머신러닝 · OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
Key Point 참조 이미지에서 3D 기하정보를 명시적으로 활용해 다각도 영상 생성 시 피사체 일관성을 크게 개선하는 방식으로, 멀티뷰 조건부 영상 생성의 핵심 과제를 해결한다.
핵심 요약
참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. 기존 단일 이미지 기반 방식을 개선하기 위해 최근 방법들은 다중 시점 참조 이미지를 사용하지만, 이들을 연결하는 3D 구조를 명시적으로 정의하지 않으며 학습 데이터가 시점 변화에서 동일한 3D 피사체를 보장하지 못한다. OmniShowcase는 자동화된 데이터 합성 파이프라인과 기하 조건화 방식 두 가지로 구성된다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 14 · 댓글 2 로봇 조작 성공 판정하는 오픈 비전-언어 모델 RoboJev 공개 로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. AI · 머신러닝 · RoboJev: An Open Vision-Language Judge for Robot Success Detection
Key Point 로봇 조작의 성공 판정을 자동화하는 오픈 모델으로, 다양한 로봇 환경에 일반화되며 비용 효율적인 추론 속도를 제공해 로보틱스 연구와 실무에 즉시 활용 가능하다.
핵심 요약
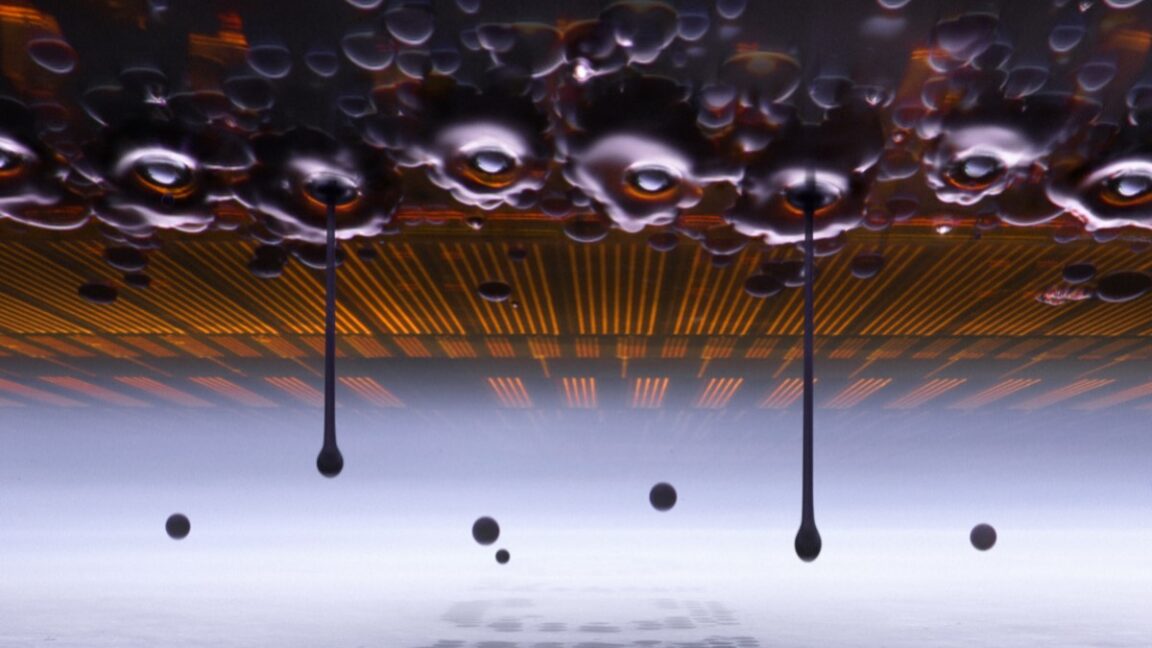
로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. 작업 지시, 조작 시도의 10개 프레임, 그리고 보조 카메라 최종 프레임을 입력받아 작업 완료 여부를 예측한다. JEV-27B-VL을 기반으로 52,598개 에피소드 기록으로 학습했으며, 언어 모델만 rank-32 LoRA 어댑터로 미세조정하고 비전 인코더는 고정했다. 전체 요약 9문장 읽기 → 004 15:11 ▲ 158 · 댓글 24 25세 독일 사진작가, 잉크젯 프린터의 미시 세계 포착으로 니콘 공모전 우승 25세 독일 실험 사진작가 올레 비엘펠트가 69개국 1,802개 작품을 제치고 2026 니콘 스몰월드 현미경 사진 공모전 우승작을 차지했다. 하드웨어 · 시스템 · Ink droplets in motion snag top prize in Nikon Small World contest
Key Point 현미경 사진에서 고속 현상을 포착하기 위해 프린터 자체를 개조한 창의적 해결책과 저비용 자작 장비의 효율성이 과학적 도구의 창의적 활용을 보여준다.
핵심 요약
25세 독일 실험 사진작가 올레 비엘펠트가 69개국 1,802개 작품을 제치고 2026 니콘 스몰월드 현미경 사진 공모전 우승작을 차지했다. 우승작은 잉크젯 프린터가 종이에 잉크 방울을 분사하는 순간을 현미경으로 포착한 이미지다. 비엘펠트는 코로나19 락다운 중 부모님 다락에서 발견한 오래된 현미경으로 시작해 튜브와 나무로 어댑터를 만들어 아버지 카메라에 연결하고 독학했다. 전체 요약 7문장 읽기 → 005 12:11 ▲ 30 · 댓글 3 로봇 조작 모델을 키우다, 영상에서 추출한 3D 행동으로 로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. AI · 머신러닝 · RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
Key Point 로봇 학습 데이터의 부족 문제를 해결하는 새로운 방법론으로, 일반 영상에서 로봇이 학습할 수 있는 신호를 뽑아낼 수 있음을 시사한다.
핵심 요약
로봇 비전-언어-행동(VLA) 모델을 확장하려면 행동 레이블이 붙은 학습 데이터가 부족하고, 로봇마다 제어 방식이 다르다는 제약이 있다. RynnVLA-Latent는 이를 해결하기 위해 사람, 로봇, 시뮬레이션 영상을 로봇 정책 사전학습용 감독 신호로 바꾼다. 핵심은 RynnLAM으로, 시각 전환(visual transition)에서 실제 로봇 제어 없이 3D 기반 잠재 행동을 학습한다. 전체 요약 10문장 읽기 → 006 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 007 12:11 ▲ 19 · 댓글 3 로봇이 실험하며 배우는 벤치마크 EmbodiedLab 공개 로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. AI · 머신러닝 · EmbodiedLab: Benchmarking Embodied Agents That Act to Know
Key Point 로봇의 지식습득 과정 자체를 체계적으로 평가하는 첫 벤치마크로서, 조작 능력과 인지 능력의 어느 것이 현실 목표 달성에 더 핵심인지를 드러낸다.
핵심 요약
로봇 에이전트가 물리 법칙 발견이나 목표 달성을 위해 직접 행동하면서 배우는 '행동을 통한 지식습득(act to know)' 문제를 다루는 벤치마크 EmbodiedLab을 개발했다. 기존 조작 벤치마크는 목표 상태가 주어졌을 때만 평가하고, 과학 발견 벤치마크는 기호적 행동이나 수치 계산으로만 평가했다면, EmbodiedLab은 로봇이 정량적 과학 실험을 통해 스스로 절차를 선택하고 물리 기반 시뮬레이션 실험실을 조작하는 시나리오다. 14개 장비 플랫폼에 걸쳐 5개 학문 분야의 30개 실험으로 구성되어 있으며, 매번 시스템 파라미터를 새로 샘플링하기 때문에 결과를 미리 알 수 없지만 정확히 채점할 수 있다. 전체 요약 8문장 읽기 → 008 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 009 06:11 ▲ 13 · 댓글 2 로봇 조작의 멀티뷰 활용을 높이는 FocusVLA 기법 로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. AI · 머신러닝 · FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
Key Point 로봇 조작의 정확도가 실무에서 중요한 만큼, 멀티뷰 센서 데이터를 효율적으로 활용하는 방법은 제조 로봇, 협업 로봇 개발에 직결된다.
핵심 요약
로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. 실험 결과 기존 VLA 모델들이 손목 카메라(wrist view)에 지나치게 의존하면서 조작 단계별로 전역 관점과 국소 관점의 균형을 동적으로 조정하지 못하는 문제를 확인했다. 이를 해결하기 위해 FocusVLA를 제안하는데, 이전 행동으로부터 미래 상호작용 의도를 예측하고 이를 행동 생성 중 뷰 라우팅에 활용한다. 전체 요약 7문장 읽기 → 010 06:11 ▲ 187 · 댓글 204 M6 칩 탑재한 신형 14인치 맥북프로 발표 애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point M6 칩은 AI 연산 성능을 획기적으로 개선했으며, 24시간 배터리는 맥북 사상 최장 수명이다. 프롬프트 처리 속도 1.3배 향상과 AI 워크로드 전반의 대폭 개선으로, AI 개발자와 크리에이터들의 로컬 LLM 실행 환경이 크게 달라진다.
핵심 요약
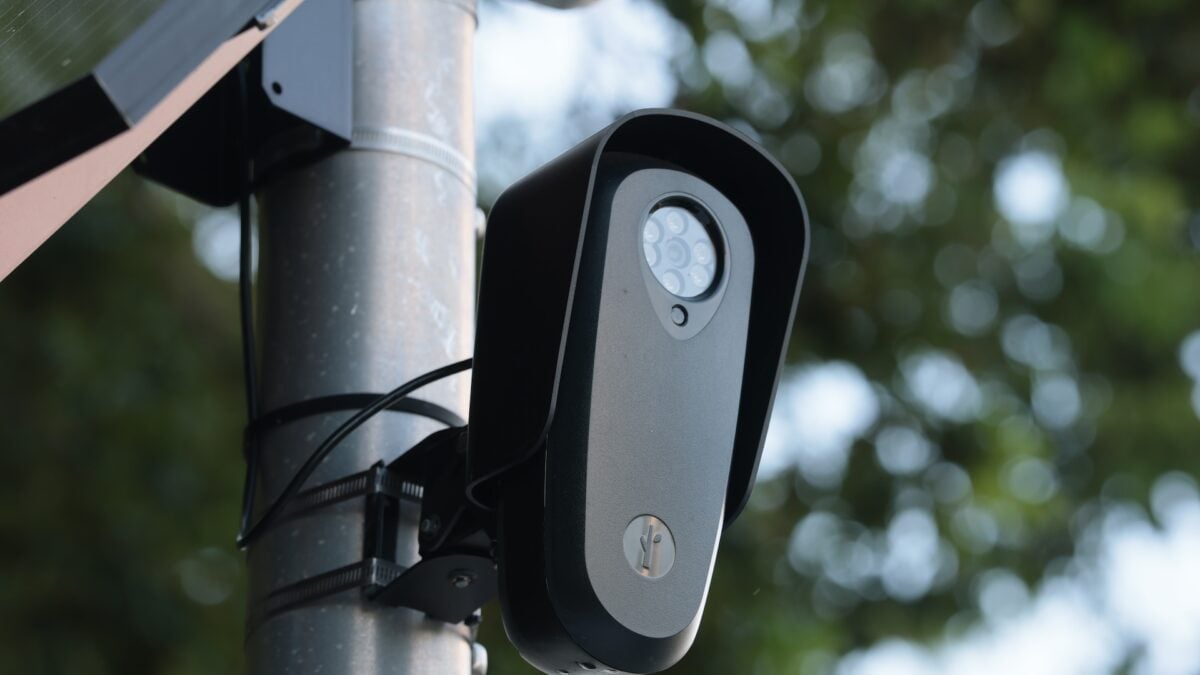
애플이 M6 칩을 탑재한 14인치 맥북프로를 발표했다. 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진을 갖췄다. M5 대비 그래픽 성능 30%, AI 워크로드 성능 25% 향상됐다. M1 대비로는 그래픽 11배, AI 성능 13배 빨라졌다. 시간당 첫 토큰(time to first token) 생성 성능은 M5 대비 1.3배, M1 대비 13배 빠르며, 뉴럴 엔진은 M5보다 1.9배 빠른 이미지 생성·초해상화 처리가 가능하다. 전체 요약 12문장 읽기 → 011 03:11 ▲ 130 · 댓글 55 경찰의 AI 번호판 인식, 범죄 적발 넘어 운전 패턴 감시 단계로 경찰이 자동 번호판 인식(ALPR) 기술과 AI를 이용해 구체적인 범죄 혐의 없이 '의심스러운' 운전 패턴을 이유로 운전자를 제지하고 있다. 보안 · Police Are Using AI to Pull over Drivers for 'Suspicious' Behavior
Key Point 운전자들의 일상적 이동이 영장 없이 감시·기록되고 범죄 혐의 없이 경찰 제지의 근거가 되는 실태를 다룬 기사이며, 경찰의 AI 감시 권한 확대와 시민 사생활 침해 사이의 갈등이 현실화되고 있다.
핵심 요약
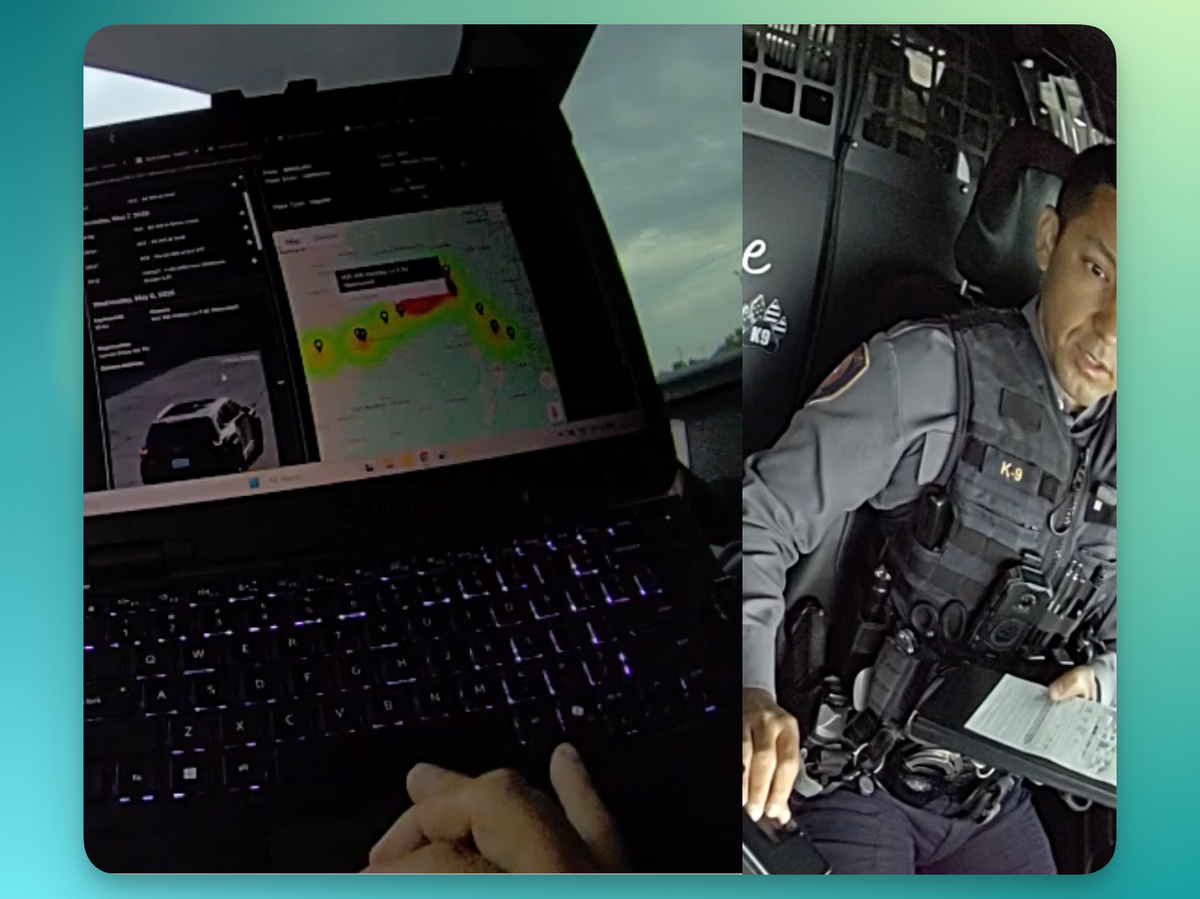
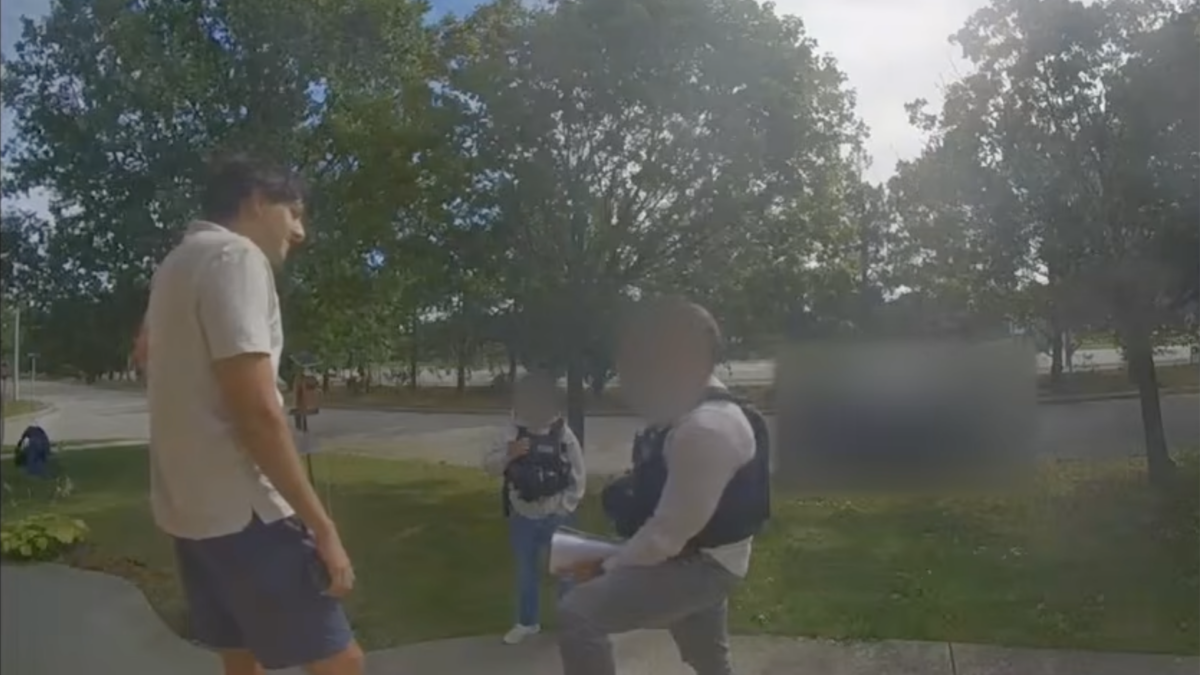
경찰이 자동 번호판 인식(ALPR) 기술과 AI를 이용해 구체적인 범죄 혐의 없이 '의심스러운' 운전 패턴을 이유로 운전자를 제지하고 있다. 버지니아 주 20대 여성 그레이스 놀즈는 9월 로드트립 중 좌측 차선 운전 시간이 길다는 이유로 FBI 요원에게 제지당했고, 자신의 번호판이 의심스러운 이동 패턴으로 플래그되었다고 들었다. FBI 요원은 고속도로 표지판 위의 카메라를 포함해 '카메라가 어디에나 있다'고 설명했으며, 그의 컴퓨터에서 놀즈의 위치 데이터와 번호판 사진을 보여줬다. 전체 요약 9문장 읽기 → 012 03:11 ▲ 186 · 댓글 227 애플, M6 칩 탑재 신형 iMac 공개 애플이 M6 칩을 탑재한 신형 iMac을 발표했으며, 10월 28일 오전 10시 10분(PT)부터 예약 시작, 11월 6일부터 판매 개시한다. 하드웨어 · 시스템 · New iMac with M6
Key Point M6 칩과 AI 기능이 강화된 신형 iMac이 출시되면서, 기존 인텔 기반 맥 사용자들의 업그레이드 선택지가 명확해진다.
핵심 요약
애플이 M6 칩을 탑재한 신형 iMac을 발표했으며, 10월 28일 오전 10시 10분(PT)부터 예약 시작, 11월 6일부터 판매 개시한다. M6는 듀얼 16코어 뉴럴 엔진을 처음 탑재했으며, 인텔 기반 iMac 대비 최대 18배 빠르고 M4 대비 온디바이스 AI 성능이 5배 향상됐다. 24인치 4.5K 레티나 디스플레이는 500니트 밝기로 기존 24인치 올인원 PC 대비 5배 해상도와 70% 향상된 밝기를 제공한다. 전체 요약 14문장 읽기 → 014 21:11 ▲ 43 · 댓글 2 장편 비디오도 정확히 3D 복원하는 계층 포즈 그래프 딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. AI · 머신러닝 · HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
Key Point 긴 비디오의 3D 복원에서 지역 최적화와 전역 일관성 사이의 근본적 트레이드오프를 계층 구조로 해결한 방법으로, 자율주행·로봇·공간 매핑 등 실제 응용에서 필요한 기술이다.
핵심 요약
딥러닝 모델로 짧은 비디오에서 카메라 움직임과 3D 기하를 정확히 추정할 수 있지만, 수천 개 프레임의 긴 영상은 계산량과 메모리 문제로 겹치는 청크(chunk) 단위로 나눠 처리해야 한다. 이 방식은 각 청크마다 독립적인 3D 복원을 만들어 좌표계가 일치하지 않고 카메라 위치가 중복으로 추정되는 문제가 발생한다. 인접한 청크와 멀리 떨어진 재방문 지점에서의 제약 조건을 전파해 전역 일관성을 맞춰야 하는데, 이는 포즈 그래프 최적화로 자연스럽게 해결된다. 전체 요약 6문장 읽기 → 015 12:11 ▲ 27 · 댓글 2 동영상 세계 모델을 명시적 토큰으로 제어하는 'World-in-Context' Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. AI · 머신러닝 · World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Key Point 비디오 생성 모델에서 시점과 동작 제어를 명시적 토큰으로 통일한 새로운 접근이 기존 대형 모델(22B)과 같은 성능을 훨씬 작은 모델(5B)에서 달성하는 방식의 전환을 보여준다.
핵심 요약
Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. World-in-Context는 In-Context Conditioning(ICC) 방식으로 시점, 동작, 카메라 제어를 명시적 토큰으로 통일하고 Self-Attention 공간에 직접 포함시킨다. 명시적 시점 토큰은 충돌하는 역학을 분리하고 단일 시점 데이터에서 시점 전환을 창발적으로 가능케 하며, 동작과 카메라는 각각 지역적 반응성과 전역적 안정성을 보완한다. 전체 요약 6문장 읽기 → 016 12:11 ▲ 49 · 댓글 2 큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기 기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
Key Point 3D 기하학 정보와 다중 관점 특성 정렬 기법으로 카메라가 크게 움직일 때도 캐릭터의 일관성을 유지하면서 자연스러운 영상을 만드는 새로운 접근법을 제시한다.
핵심 요약
기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. 이를 체계적으로 연구하기 위해 CLACT라는 대규모 캐릭터 중심 데이터셋과 벤치마크를 개발했으며, 정확한 카메라 기하학과 다중 관점 캐릭터 관측치를 포함했다. WorldCast 프레임워크는 초기 프레임을 추정된 깊이로 3D 포인트 클라우드로 역투영한 뒤, 포인트 클라우드 스케일을 목표 카메라 궤적에 정렬하고 궤적을 따라 렌더링해 명시적 기하학적 가이드와 커버리지 마스크를 얻는다. 전체 요약 5문장 읽기 → 017 06:11 ▲ 160 · 댓글 87 플록 CEO, 경찰 회의서 "회사 비판은 가짜"라고 주장 자동 번호판 인식(ALPR) 회사 플록의 CEO 개릿 랭글리가 경찰 회의에서 녹음된 음성에서 회사에 대한 전국적 반발이 실제가 아니라고 주장했다. 보안 · In Leaked Audio, Flock CEO Tells Cops Backlash to the Company Isn't Real
Key Point 경찰의 광범위한 감시 도구를 둘러싼 근거 없는 주장과 투명성 부재가 미국의 법 집행 정책에 미치는 영향을 보여준다.
핵심 요약
자동 번호판 인식(ALPR) 회사 플록의 CEO 개릿 랭글리가 경찰 회의에서 녹음된 음성에서 회사에 대한 전국적 반발이 실제가 아니라고 주장했다. 랭글리는 소셜미디어의 플록 비판 게시물의 95%가 감소했으며, 우크라이나가 러시아 데이터센터를 폭격한 후 일주일 만에 50% 떨어졌다고 주장했고, 이를 러시아 봇 활동이 감소한 증거로 제시했다. 그는 반발이 중국의 지시를 받는 극좌 네트워크에서 비롯되었다는 근거 없는 주장도 반복했다. 전체 요약 9문장 읽기 → 018 03:12 ▲ 110 · 댓글 107 애플, 신형 아이패드 미니 공개…OLED 화면과 AI 성능 대폭 강화 애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 하드웨어 · 시스템 · The new iPad mini
Key Point 신형 아이패드 미니는 OLED 디스플레이, A20 Pro의 4.5배 AI 성능 향상, IP67 방수 인증으로 소형 태블릿 시장의 기준을 다시 설정하며, 창작자와 야외 작업자들이 갖춰야 할 기기 사양이 크게 달라진다.
핵심 요약
애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 두께 5.4mm로 이전 세대 대비 더 얇고 가벼워졌으며, 베젤이 24% 줄어든 상태에서 디스플레이 크기를 8.5인치로 확대했다. OLED 패널은 피크 밝기 1200nits(이전 대비 2배 이상), 2,000,000:1 명암비, 1nit 최소 밝기를 지원하며, 선택사항으로 반사 감소 나노텍스처 옵션을 제공한다. 전체 요약 14문장 읽기 → 019 21:12 ▲ 28 · 댓글 2 비디오 언어 모델로 e스포츠 실시간 연출과 해설 자동화 e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. AI · 머신러닝 · DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
Key Point 실시간 영상 생성 능력을 갖춘 대규모 언어 모델이 단순 해석을 넘어 실시간 의사결정(카메라 선택)이 필요한 프로덕션 수준의 작업을 수행할 수 있다는 점을 실증한 첫 사례입니다.
핵심 요약
e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. 기존 스트리밍 비디오 언어 모델은 인간 연출자가 이미 제작한 방송을 보고 해설만 했으나, 이 논문은 모든 선수 카메라의 원본 영상을 받아 직접 연출과 해설을 동시에 수행하는 라이브 방송 제작을 다룬다. DirCast는 매초 모든 카메라를 저해상도로 스캔하고, 홀드-또는-스위치 연출자로 컷 여부와 위치를 결정한 뒤, 선택된 카메라를 고해상도로 읽고 해설을 생성한다. 전체 요약 7문장 읽기 → 020 18:11 ▲ 120 · 댓글 79 애플 폴딩폰, 분해 테스트 공개 애플의 폴딩 아이폰 '듀오(Duo)'를 아이픽스잇이 완전 분해했다. 일부 사용자는 개봉 직후부터 화면 손상을 보고했으며, 보증 기간 외 화면 손상 수리비는 999달러다. 하드웨어 · 시스템 · iPhone Duo Teardown
Key Point 폴딩폰이 초기 수리성 평가를 받는 것은 드문데, 애플의 첫 번째 폴딩 시도가 실제로 어떤 구조를 가졌는지, 그리고 왜 초기 불량이 발생했는지를 기술 증거로 밝혀낸 정밀한 분석이다. 특히 999달러의 수리비 책정 이유를 엔지니어링 관점에서 이해할 수 있다.
핵심 요약
애플의 폴딩 아이폰 '듀오(Duo)'를 아이픽스잇이 완전 분해했다. 일부 사용자는 개봉 직후부터 화면 손상을 보고했으며, 보증 기간 외 화면 손상 수리비는 999달러다. 듀오의 내부 디스플레이는 나노텍스처 코팅으로 주름을 숨긴다. 미세한 돌기가 빛을 산란시켜 반사를 부드럽게 하는데, 코팅을 제거하면 주름이 다른 폴딩폰보다 더 잘 보인다. 일부 서브픽셀이 타원형이며 방향이 다르게 배치되어 있다. 애플 특허에 따르면 이는 기하학적 디더링으로 회절 아티팩트를 줄이는 기술이다. 전체 요약 12문장 읽기 → 021 15:11 ▲ 103 · 댓글 20 보안 연구자가 Flock 카메라 170만 대 위치 공개 프로톤(Proton)이 Flock 번호판 인식 카메라 위치를 검색할 수 있는 지도를 공개했다. 보안 · Proton Flock Camera Map
Key Point 경찰의 감시 데이터 오용 사례가 잇따르는 가운데, 실제 설치된 Flock 카메라가 공식 발표보다 훨씬 많으며 주민들이 자신의 지역 감시 현황을 직접 확인할 수 있게 되었다.
핵심 요약
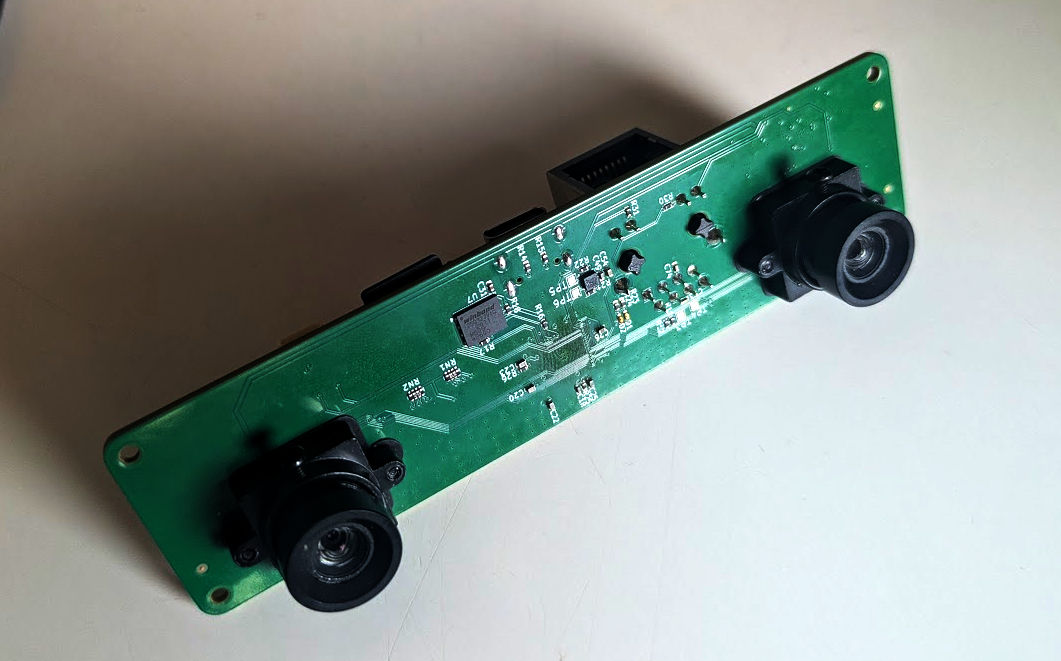
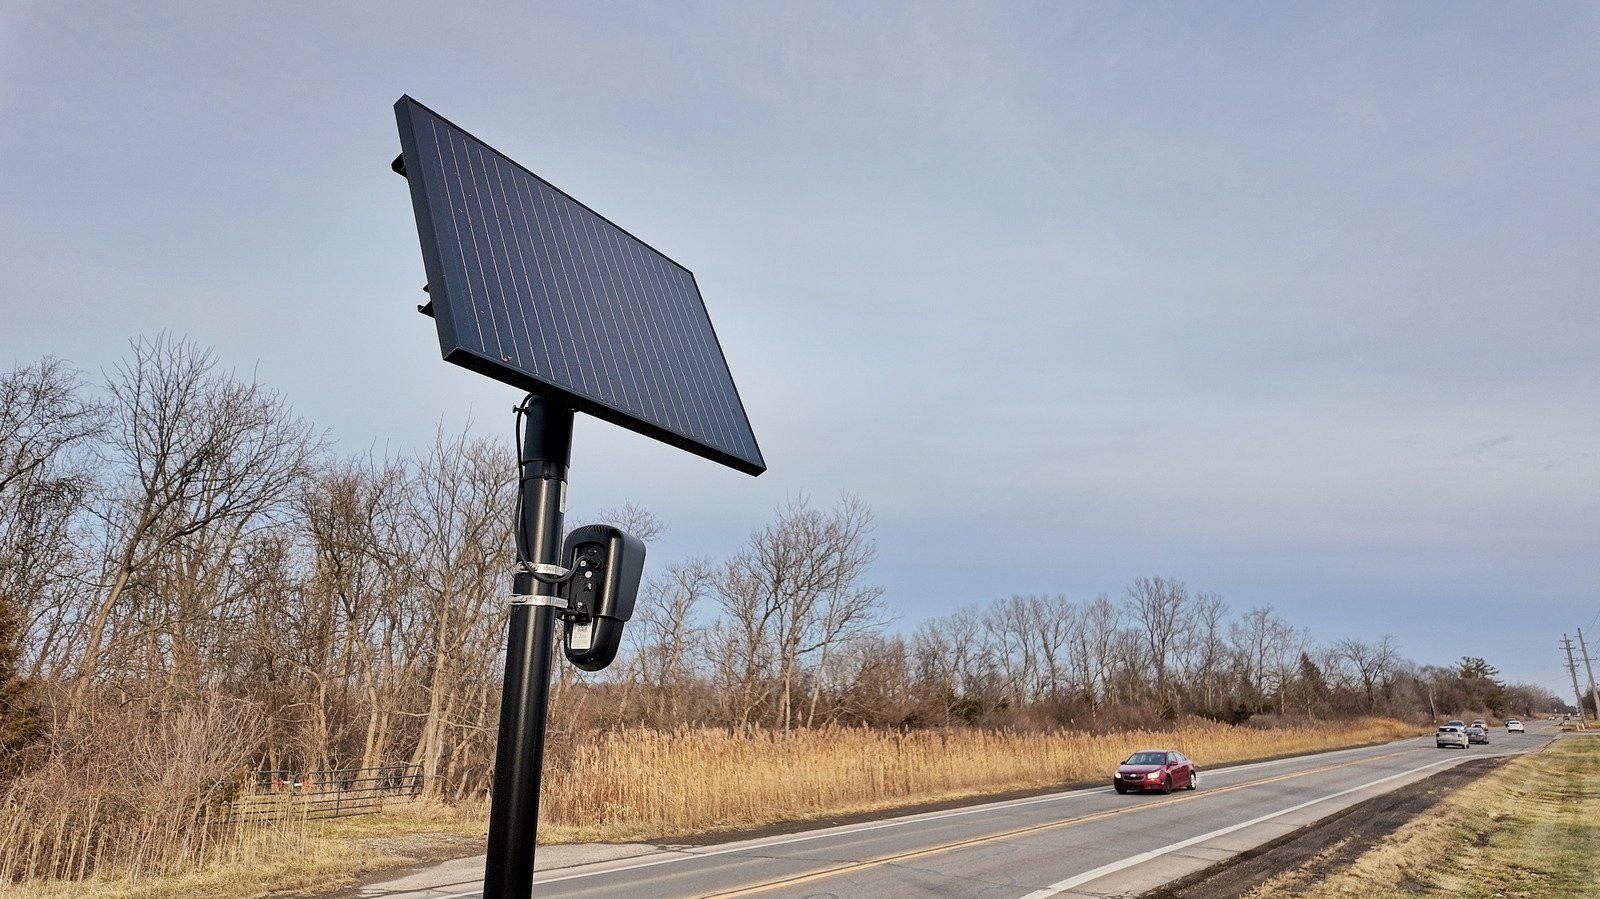
프로톤(Proton)이 Flock 번호판 인식 카메라 위치를 검색할 수 있는 지도를 공개했다. Flock 카메라는 모든 차량을 촬영해 번호판과 시간, 위치를 기록하며, 차량 특징 기능으로 모델·색상·흠집 등도 저장한다. 이 데이터는 Flock 클라우드에 저장되어 경찰이 검색하고 여러 지역 기관에 공유할 수 있으며, 월 200억 건 이상의 기록을 49개 주에서 처리한다. 전체 요약 6문장 읽기 → 022 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 023 18:11 ▲ 11 · 댓글 1 자율주행 카메라 영상으로 3D 인식·재구성 일괄 처리 Foundation4D Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. AI · 머신러닝 · Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
Key Point 자율주행 단일 모델로 깊이·객체감지·공간점유까지 동시에 처리하고 이를 장면 재구성까지 연결하는 통합 파이프라인이 등장했으며, 라이다 없이도 상용 벤치마크에서 경쟁 방식을 앞도는 성능을 보였다.
핵심 요약
Foundation4D는 다중 카메라 주행 영상으로부터 깊이 추정, 3D 객체 감지, 의미론적 점유격자(occupancy), 가우시안 재구성을 모두 수행하는 통합 신경망 모델이다. 공유 백본은 인수분해 시공간 어텐션(factorized spatiotemporal attention)으로 여러 카메라의 관측값과 시간 정보를 효율적으로 결합한다. 비디오 추론 파이프라인은 포즈 그래프 최적화로 카메라 궤적을 개선하고 입력 윈도우 전체에서 객체 추적을 조합한다. 전체 요약 7문장 읽기 → 024 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 026 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 027 03:11 ▲ 31 · 댓글 2 자연어로 영화같은 카메라 움직임을 3D 환경에서 자동 생성 FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography
Key Point 자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다. Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다. 전체 요약 6문장 읽기 → 028 21:11 당일 +599 강화학습으로 움직이는 오리 로봇, 마이크로덕 공개 폴렌 로보틱스가 높이 약 25cm, 무게 800g의 양다리 오리 로봇 마이크로덕의 제어 소프트웨어를 공개했다. 하드웨어 · 시스템 · pollen-robotics/microduck · Rust
Key Point 강화학습으로 훈련된 신경망 정책을 탑재한 로봇의 전체 소프트웨어 아키텍처와 개발 방식을 공개함으로써, 소형 이족 보행 로봇의 제어·배포·업그레이드 파이프라인을 어떻게 구현할 수 있는지 보여준다.
핵심 요약
폴렌 로보틱스가 높이 약 25cm, 무게 800g의 양다리 오리 로봇 마이크로덕의 제어 소프트웨어를 공개했다. Rockchip RK3566 프로세서 위에서 15개 서보 모터를 제어하는 50Hz 제어 루프를 포함하며, 라디오·카메라·자동 업데이트 시스템 등 완전한 로봇 운영 체계를 담고 있다. 행동 정책은 MuJoCo 시뮬레이터와 PPO 강화학습, 시뮬레이션 투 리얼(sim2real) 기법으로 훈련한 후 ONNX 형식으로 변환되어 로봇에 로드된다. 전체 요약 8문장 읽기 → 029 15:11 ▲ 173 · 댓글 2 영화 같은 영상 생성, MLLM 정보를 제대로 활용하는 학습법 제안 영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. AI · 머신러닝 · Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation
Key Point 비디오 확산 모델이 MLLM의 정보를 무시하는 근본 문제를 해결함으로써 멀티모달 정보 기반의 영상 생성 품질을 크게 향상시키는 방법론을 제시합니다.
핵심 요약
영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. 멀티모달 대형언어모델(MLLM)이 유용한 선행 정보를 제공하지만, 비디오 확산 트랜스포머(DiT)가 직접 조건화 경로로 이를 우회하거나 충분히 활용하지 못한다. 연구팀은 요소 인식 예측 학습(FAPL)을 제안해 MLLM 잠재값을 유효하게 활용하는 것을 전제로 설정했다. 전체 요약 8문장 읽기 → 030 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 031 18:11 ▲ 160 · 댓글 3 VLM이 3D 공간을 독립적으로 탐색 매핑할 수 있나 비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. AI · 머신러닝 · SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
Key Point VLM이 공간 지능 구성 능력을 갖췄는지 체계적으로 측정하기 위한 벤치마크이며, 최첨단 모델도 정밀한 3D 매핑에서 심각한 한계를 보이고 있기 때문이다.
핵심 요약
비전-언어 모델(VLM) 에이전트가 자율적 탐색을 통해 정확한 3D 맵을 구성할 수 있는지 평가하는 벤치마크 SpatialScout을 제시했다. 80개 실내 장면과 3,140개 목표 객체로 구성되며, 에이전트는 카메라를 조종해 장면을 탐색하고 공유 좌표계에서 객체 중심을 추정해야 한다. 시점 선택, 교차 뷰 연관성 파악, 기하학적 추정, 맵 수정을 조율하면서 제한된 상호작용 예산 내에서 작업을 수행한다. 전체 요약 7문장 읽기 → 032 03:11 ▲ 25 · 댓글 2 영상과 3D 모션을 동시에 만드는 AI 모델 기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. AI · 머신러닝 · Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs
Key Point 영상 생성 AI가 3D 애니메이션 제작 파이프라인으로 확장되는 중요한 시점에, 실제 3D 자산을 직접 움직일 수 있는 모션을 만드는 기술이 등장했다.
핵심 요약
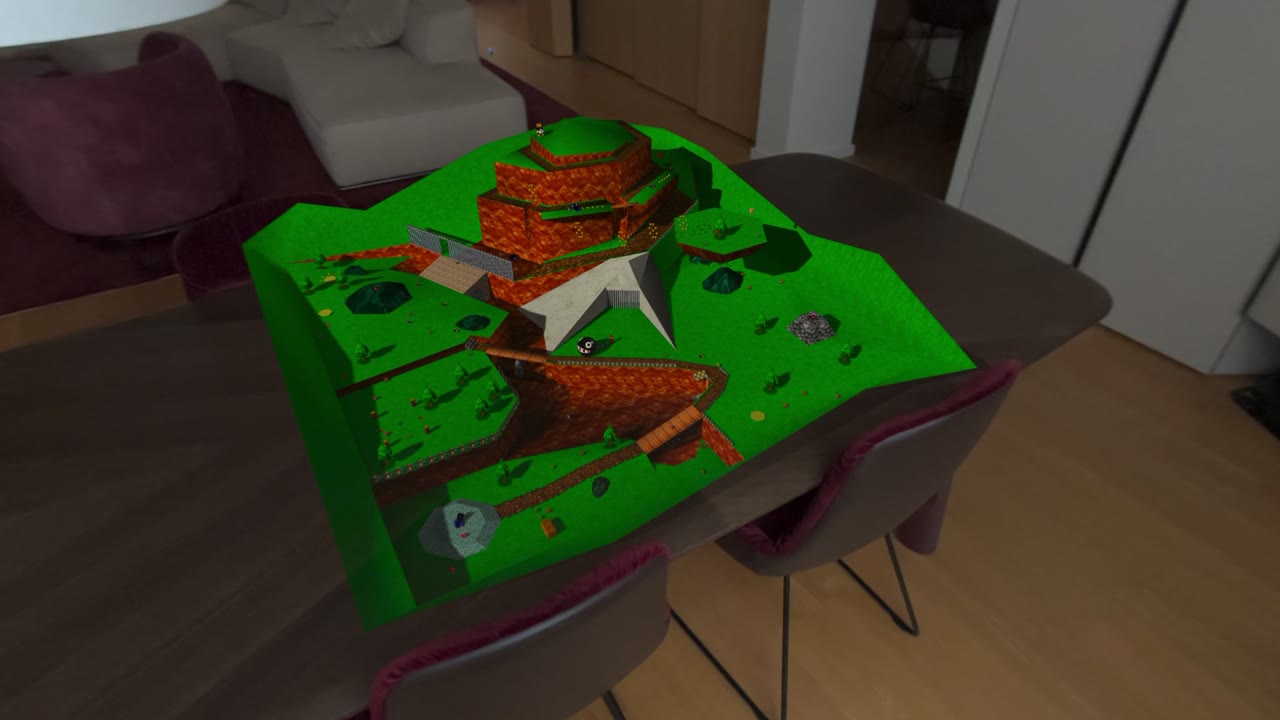
기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. 이 논문은 텍스트로부터 영상과 3D 모션을 함께 만드는 모델을 제시하며, 임의의 스켈레톤(뼈대)를 지원하고 카메라 위치도 함께 복원한다. 기존 방식은 인간 스켈레톤만 처리하거나 매개변수가 수십억 개인 반면, 이 모델은 3D 모션을 별도로 처리하고 미니 크로스 어텐션 레이어로 사전학습된 영상 모델과 연결해 효율성을 높였다. 전체 요약 8문장 읽기 → 033 03:11 ▲ 154 · 댓글 58 슈퍼마리오 64, 애플 비전 프로의 입체 모형으로 부활 슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 하드웨어 · 시스템 · Way to Play Super Mario 64: On Apple Vision Pro
Key Point 클래식 게임의 현대적 재해석과 저작권 정책의 대비: 커뮤니티 창작물이 기술적으로 얼마나 진화했는지, 그리고 업체별 대응이 얼마나 다른지 보여준다.
핵심 요약
슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 사용자가 카메라 역할을 하므로 모형에 가까이 다가가 자세히 보거나 마리오를 여러 각도에서 관찰할 수 있으며, 타이틀 화면에서 손가락으로 마리오의 얼굴을 직접 움직일 수 있다. 이 프로젝트는 SM64 역공학 프로젝트와 sm64coopdx 게임 코드, SM64 Reloaded와 Render96의 고해상도 텍스처, Render96 모델과 SwagSkeleton95 교체 모델 등 여러 기존 오픈소스 프로젝트를 기반으로 구축되었다. 전체 요약 4문장 읽기 → 034 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 035 15:11 ▲ 48 · 댓글 2 3D 궤적으로 멀티뷰 영상 예측하는 VPM 모델 공개 Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. AI · 머신러닝 · Learning the 4D World through Point Trajectory Forecasting
Key Point 멀티뷰 영상에서 3D 구조 이해와 동작 제어를 동시에 달성하는 새로운 접근법으로, 로봇 비전과 4D 생성 분야에 실질적인 개선을 가져온다.
핵심 요약
Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. 사전학습된 월드 모델을 확장해 카메라 조건부 멀티뷰 처리를 통해 여러 카메라의 보충적 정보를 통합하고, 물리적 점의 시간에 따른 움직임을 예측하는 궤적 헤드를 추가했다. 각 궤적은 모든 뷰에서 단일 점을 추적하며, 이를 영상 생성과 함께 감독함으로써 모든 카메라에서의 외관 변화를 3D 움직임의 공유된 설명으로 정렬한다. 전체 요약 6문장 읽기 → 036 12:11 ▲ 48 · 댓글 2 4단계만에 현실감 있는 영상 생성하는 구조 기반 렌더러 게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. AI · 머신러닝 · SolarRenderer: Few-Step Generative Reference Rendering
Key Point 기존 50단계가 필요했던 구조 기반 렌더링을 4단계로 단축하면서도 미학습 표현 11개에 일반화되는 성과로, 게임 엔진 통합과 실시간 스트리밍 렌더링이 가능해진다.
핵심 요약
게임 엔진이나 코딩 에이전트가 장면의 레이아웃, 모션, 카메라를 지정하지만 이를 사실적인 영상으로 변환하려면 구조를 따르면서 외형을 채우는 렌더러가 필요하다. 기존 렌더러는 특정 엔진 표현에 종속되거나 수십 단계의 노이즈 제거가 필요하거나 별도의 비용 많이 드는 증류 과정이 필수다. SolarRenderer는 고정된 MiniMax-H3 33B 백본을 두 개의 가벼운 LoRA로 적응시킨 구조 조건 비디오 렌더러다. 전체 요약 8문장 읽기 → 037 03:11 ▲ 103 · 댓글 33 밥 크링글리와의 30년, 실리콘밸리의 천재 이야기꾼 저자는 1996년 박사과정 중 자신의 자바 책을 극찬하는 밥 크링글리의 전화를 받았는데, 당시 시장에 나온 자바 책은 7권이 아니었고 자신의 책도 2번째였다. 기타 · My Friend Bob Cringely
Key Point 크링글리의 부음을 추도하며 그와 30년을 함께한 인생의 순간들을 담은 개인적 기록으로, 기술 칼럼니스트로서의 통찰력보다는 카리스마로 사람들을 매료시킨 인물상을 그려낸다.
핵심 요약
저자는 1996년 박사과정 중 자신의 자바 책을 극찬하는 밥 크링글리의 전화를 받았는데, 당시 시장에 나온 자바 책은 7권이 아니었고 자신의 책도 2번째였다. 크링글리는 저자가 외로운 프로그래머이면서 컴퓨터 관련 성취에 갈증을 느낄 거라는 심리를 정확히 읽고 있었고, 자바 프로그래밍 경험이 있냐고 묻자 저자는 거짓으로 '있다'고 답했다. 크링글리는 이들을 고용해 '프론토'라는 시스템을 개발하게 했는데, 이는 인터넷 연결이 유휴 상태일 때 잡지를 자동으로 다운로드한 뒤 새벽 2시에 프린터로 출력하는 출판 유통 시스템이었다. 전체 요약 11문장 읽기 → 038 21:11 ▲ 16 · 댓글 2 짧은 영상으로 장시간 예측하는 세계 모델 훈련법 스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. AI · 머신러닝 · Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
Key Point 짧은 영상만으로 학습한 생성 모델이 장기간 예측에서 표류하는 근본적 문제를 해결하는 새로운 훈련 방식으로, 비용 높은 교사 모델 없이도 안정적인 장시간 롤아웃을 만들 수 있다.
핵심 요약
스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. 기존 방식은 분포 일치 증류(DMD)로 모델 자신의 예측을 다시 훈련하지만, 외부 교사는 행동을 모르고 내부 교사도 같은 문제로 고통받는다. 프레셰 거리(Fréchet Distance)를 활용한 프레셰 포싱(Fréchet Forcing) 기법을 제안한다: 생성적 앵커링은 실제 데이터로 끝나는 자체 생성 이력에 플로우 매칭 손실을 적용하고, 문맥 충실도는 각 클립의 자유 롤아웃 통계와 실제 통계 간 거리를 계산해 장면 일관성을 유지하며, 현실성 일치는 고정된 지각 공간에서 생성 프레임과 실제 프레임 간 거리를 측정한다. 전체 요약 5문장 읽기 → 039 18:11 ▲ 12 · 댓글 2 숨은 상태까지 관리하는 게임형 AI 비디오 생성 시스템 기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. AI · 머신러닝 · State World Models: Execute the Rules, Generate the Pixels
Key Point 기존 AI 비디오 생성 모델들은 화면에 보이지 않는 게임 상태를 제대로 추적하지 못하는데, 이 논문은 상태 관리 시스템을 도입해 규칙 준수율을 32%에서 92%로 끌어올린 방법을 제시한다.
핵심 요약
기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. Stateful Harness는 세계 상태 관리와 비디오 렌더링을 분리하는 프레임워크로, 정해진 규칙에 따라 세계 상태를 진화시키고 각 단계마다 비디오 모델로 장면을 생성한 뒤 다음 턴의 상태 업데이트에 활용한다. 사용자가 선택한 행동을 해석하고 3D 씬의 미리보기를 통해 공간과 카메라 위치를 제시하며, 생성된 비디오 클립으로 다시 세계 상태를 갱신하는 순환 구조를 갖춘다. 전체 요약 7문장 읽기 → 040 15:11 ▲ 155 · 댓글 3 인간의 경험에서 배우는 홀리스틱 세계 이해 시스템 머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. AI · 머신러닝 · Holi-World: Building Holistic World Intelligence from Human-Ego Experience
Key Point 인간의 일상 영상에서 자동으로 학습 데이터를 만들어 세계 이해 AI를 훈련하는 새로운 방식을 제시해, 값비싼 수동 주석을 줄이면서 지각 AI의 실용적 확장을 가능하게 한다.
핵심 요약
머신러닝 커뮤니티가 인간의 일인칭 시점 영상 데이터를 활용해 세상을 이해하는 방법을 개발하고 있다. HOLI-WORLD는 카메라 캡처·세계 표현·자동 데이터 구성·모델 학습·평가를 통합하는 생태계로, 수동 주석 의존성을 줄인다. HOLIWORLD-Foundry는 정적·동적 인식을 결합해 장면 구조·물체 상태·상호작용 이력을 자동으로 연결하는 '세계 기록'을 구성한다. 전체 요약 8문장 읽기 → 041 15:11 ▲ 161 · 댓글 2 1인칭 영상에서 손·물체·공간을 동시에 복원하는 모델 공개 1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. AI · 머신러닝 · EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience
Key Point 손과 물체, 카메라와 장면을 동시에 일관성 있게 복원하는 것은 1인칭 AR, 로봇 조작, 활동 인식 등 여러 분야의 핵심 과제인데, 이 논문이 기존보다 훨씬 큰 규모의 정렬된 데이터셋과 상당히 개선된 모델을 공개했기 때문이다.
핵심 요약
1인칭 시점 영상에서 카메라 움직임, 주변 기하학, 손-물체 상호작용을 일관성 있게 복원하려면 개별 3D 요소들이 함께 정렬되어야 하는데, 기존 방법과 데이터셋은 이를 충분히 지원하지 못하고 있다. EgoXperience는 데이터 수집, 자동 주석, 통합 모델링, 벤치마킹을 통해 이 문제를 해결하는 전체 스택 패러다임을 제시한다. 핵심 도구인 EgoX-Engine은 기하학적으로 검증된 물체 추적과 SLAM 기반 월드 정렬을 결합하여 카메라, 장면, 손, 물체에 대한 일관성 있는 감독 신호를 생성한다. 전체 요약 6문장 읽기 → 042 15:11 ▲ 84 · 댓글 2 언어 명령에 따라 장면을 탐색하는 로봇, 인터넷 영상으로 학습시키다 언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. AI · 머신러닝 · ScaleNav: Scalable Internet Video Pretraining for Language-Conditioned Local Navigation
Key Point 시뮬레이션 데이터의 현실성 문제를 극복하면서도 현실 데이터 수집 비용을 줄이는 새로운 접근법으로, 로봇 네비게이션의 실용성을 높일 수 있는 기술이기 때문이다.
핵심 요약
언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. 기존 방식은 로봇 실제 데이터 수집이 비싸고 시뮬레이션 데이터는 현실 적응 격차(sim-to-real gap)가 있는 문제가 있었다. ScaleNav는 인터넷의 1인칭 관점 영상에서 학습하여 카메라가 목표에 접근할 때 시각 정보가 어떻게 변하는지 파악한다. 전체 요약 6문장 읽기 → 043 03:11 ▲ 20 · 댓글 2 텍스트·이미지·영상을 함께 쓰는 통합 비디오 편집 프레임워크 OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. AI · 머신러닝 · OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing
Key Point 여러 형태의 참조를 통합하는 비디오 편집 방식은 창작자의 의도를 더 유연하게 표현하게 해주며, 공개된 벤치마크는 이 영역의 평가 표준을 정립합니다.
핵심 요약
OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. 참조 은행 인터페이스와 R²-RoPE를 도입하여 가변 개수의 참조를 지원하는 통합 입력 설계를 구현했다. OmniXRef-Model은 단일 스트림 확산 트랜스포머를 사용해 소스 비디오와 MLLM의 다중모드 맥락을 인터리브 수열로 처리한다. 전체 요약 7문장 읽기 → 044 00:11 ▲ 103 · 댓글 32 로봇 학습, 데이터 대량 수집 시대 열리다 AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. AI · 머신러닝 · How to Train Your Robot
Key Point 로봇 AI가 대규모 데이터 학습 시대로 접어드는 가운데, 어디서 그 데이터를 구할 것인가가 로봇 공학의 핵심 병목이 되고 있기 때문이다.
핵심 요약
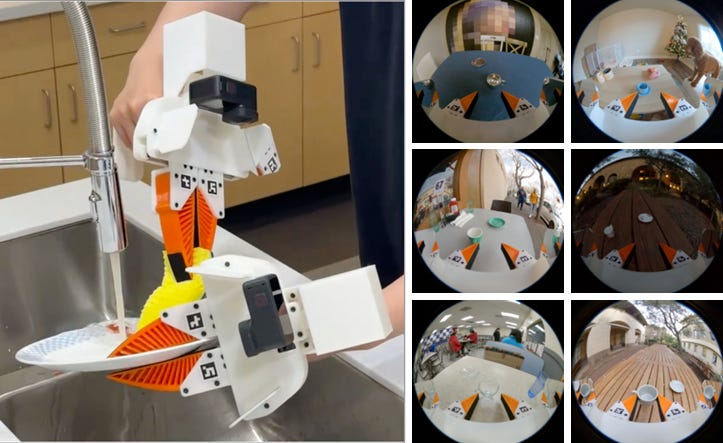
AI 발전의 핵심은 대규모 데이터 학습이며, 이제 로봇 분야도 같은 원리를 따르고 있다. LLM 학습에 사용된 기존 텍스트 데이터와 달리, 로봇용 훈련 데이터는 새롭게 수집해야 하는 상황이다. 원격 조종(텔레오퍼레이션)은 데이터 질이 높지만 비용이 많이 들고 확장이 어렵다는 문제가 있다. 전체 요약 12문장 읽기 → 045 18:11 ▲ 107 · 댓글 47 경찰의 자동번호판 카메라 수사, 연방판사가 위헌 판결 연방판사가 자동번호판 인식(ALPR) 시스템 Flock을 이용한 수사를 '위헌 영장 없는 수색'이자 '무차별 대량감시'로 판결했고 제4수정헌법 위반이라고 명시했다. 보안 · Footage of the Flock search that a judge ruled was uncosntitutional
Key Point 경찰이 일상적인 주간 이동 정보를 대량감시 시스템으로 캡처해 수사 근거로 삼는 관행이 연방법원에서 처음 위헌 판결을 받았으며, ALPR 시스템의 광범위한 추적 능력과 경찰의 자의적 운용 방식을 드러냈다.
핵심 요약
연방판사가 자동번호판 인식(ALPR) 시스템 Flock을 이용한 수사를 '위헌 영장 없는 수색'이자 '무차별 대량감시'로 판결했고 제4수정헌법 위반이라고 명시했다. 오클라호마 경찰관 프레디 알라니즈는 캘리포니아 번호판을 본 이유만으로 멜리사 카일의 자동차를 정차시킨 후 Flock과 모토로라 ALPR 시스템에서 그녀의 이동 경로를 검색했다. 바디캠 영상은 알라니즈가 차량을 정차시키기 전부터 노트북으로 Flock을 검색했으며, '캘리포니아에 다녀온 사람들은 마약을 운반한다'는 직관에 의존했음을 보여준다. 전체 요약 9문장 읽기 → 046 15:11 ▲ 286 · 댓글 3 VLM이 로봇을 직접 코딩하다, HexaShell의 도전과 한계 비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. AI · 머신러닝 · HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
Key Point 로봇 조종을 위한 VLM 에이전트가 시각 기반 자율 학습으로 최고 성능을 달성했으나, 정밀한 접촉 제어에서 근본적인 한계를 드러내며 향후 로봇 AI 개발의 방향을 제시한다.
핵심 요약
비전 언어 모델(VLM) 기반 에이전트가 로봇 조종에서 학습된 정책과 경쟁할 수 있는 수준에 도달했으며, 연구팀은 코딩 에이전트가 로봇을 제어할 때 어디까지 갈 수 있는지 검증하는 HexaShell 시스템을 개발했다. HexaShell은 최소한의 인터페이스를 유지하며 에이전트의 명령을 로봇 동작으로만 변환하고, 양팔 로봇을 단일 명령줄로 구동하며 RGB 카메라 3개와 카메라 캘리브레이션 정보를 제공한다. 실패 후 에이전트는 로그를 읽고 원인을 파악한 뒤 작은 프로그램(도구)을 작성하거나 수정하며, 이렇게 학습한 내용을 코드로 유지한다. 전체 요약 10문장 읽기 → 047 03:11 ▲ 130 · 댓글 10 마이크로 단위 3D 정밀 제어, 오픈소스로 누구나 만든다 오픈소스 마이크로 매니퓰레이터 프로젝트는 저가의 3축 XYZ 모션 제어 플랫폼으로 50nm 단위 정밀도를 달성하며 광학 정렬, 전자 부품 검사, 현미경 응용에 사용된다. 하드웨어 · 시스템 · Open MicroManipulator – A sub-micrometer 3D motion control plattform
Key Point 저비용으로 마이크로미터 단위 정밀도를 필요로 하는 광학, 전자공학, 미세 조작 작업을 독립적으로 구축할 수 있는 완전 오픈소스 솔루션이며, 세부 설계, 펌웨어, 제어 소프트웨어가 모두 공개되어 커스터마이징과 학습에 활용할 수 있다.
핵심 요약
오픈소스 마이크로 매니퓰레이터 프로젝트는 저가의 3축 XYZ 모션 제어 플랫폼으로 50nm 단위 정밀도를 달성하며 광학 정렬, 전자 부품 검사, 현미경 응용에 사용된다. 평행 운동학 구조와 미니어처 볼 조인트로 기계적 강성을 확보하고, 30kHz 폐루프 제어 스테핑 모터와 자성 기어링을 통해 저가 로터리 인코더 해상도를 30배 향상시킨다. USB 시리얼 인터페이스로 G-Code 명령을 지원하며 모션 플래닝 스택과 선형보간으로 부드럽고 정확한 경로 추종을 구현한다. 전체 요약 12문장 읽기 → 048 18:11 ▲ 125 · 댓글 121 엘리자베스 홈스 다큐가 관객을 '속이는 방식' 엘리자베스 홈스를 다룬 신작 다큐 '유 캔 씨 에브리싱'은 표면적으로는 그녀의 기만을 보여주지만, 동시에 관객을 기만하는 방식으로 작동한다는 비평이다. 기타 · How the Elizabeth Holmes documentary “You Can See Everything” is deceiving
Key Point 영상과 편집이 의견 형성에 미치는 강력한 영향을 보여주는 사례로, 정보 소비자가 객관적 사실보다 내러티브 틀에 얼마나 쉽게 흔들리는지 인식해야 할 필요가 있다.
핵심 요약
엘리자베스 홈스를 다룬 신작 다큐 '유 캔 씨 에브리싱'은 표면적으로는 그녀의 기만을 보여주지만, 동시에 관객을 기만하는 방식으로 작동한다는 비평이다. 홈스는 환자 사기 4개 혐의에서는 무죄를 받았지만, 7억 달러 이상을 투자한 투자자들을 의도적으로 기만했다는 이유로 감옥에 있다는 중요한 사실이 대중 담론에서 누락되어 있다. 감독 랜스 오펜하임과 네이선 필더는 카메라 앵글, 클로즈업, 편집, 정보 공개 순서 등을 활용해 관객의 감정을 조종하고 자신들의 내러티브 틀에 맞춰 홈스에 대한 평가를 반복적으로 바꾸게 한다. 전체 요약 6문장 읽기 → 049 09:11 ▲ 111 · 댓글 11 ESP32를 브라우저에서 돌린다, Rust 에뮬레이터 Rust로 작성한 ESP32 에뮬레이터 esp32sim이 공개됐으며, Xtensa(ESP32, S3)와 RISC-V(C3, C6) 아키텍처 네 가지 SoC를 명령어 수준에서 에뮬레이션한다. 하드웨어 · 시스템 · Show HN: Esp32sim – Run ESP32 firmware in the browser
Key Point 실제 ROM과 부트로더로 부팅하는 완전 에뮬레이터이면서 WebAssembly로 브라우저에서 즉시 실행 가능해, ESP32 개발과 테스트 방식을 근본적으로 바꿀 수 있다.
핵심 요약
Rust로 작성한 ESP32 에뮬레이터 esp32sim이 공개됐으며, Xtensa(ESP32, S3)와 RISC-V(C3, C6) 아키텍처 네 가지 SoC를 명령어 수준에서 에뮬레이션한다. 실제 마스크 ROM, 2단계 부트로더, 미수정 애플리케이션 이미지로 부팅하며, 클라우드나 계정 없이 완전히 로컬에서 실행된다(MIT 라이선스). ESP32는 GPIO, UART, 타이머 지원, ESP32-S3는 ST7789 디스플레이와 버튼을 갖춘 LilyGO TTGO T-Display 보드 지원, ESP32-C3과 C6도 각각 FreeRTOS까지 부팅한다. 전체 요약 12문장 읽기 → 050 03:11 ▲ 190 · 댓글 26 맵퀘스트, 실시간 감시카메라 위치 표시 기능 추가 맵퀘스트가 야외 감시카메라와 번호판 인식기(ANPR) 위치를 표시하는 새로운 레이어를 앱에 추가했다. 웹 · 프론트엔드 · MapQuest will now show you where Flock cameras are in your neighborhood
Key Point 감시카메라 위치를 지도 앱에서 직접 확인할 수 있게 되면서 개인정보보호 관심층과 커뮤니티 감시에 관심 있는 사용자들에게 실질적인 정보 접근 수단을 제공하게 된다.
핵심 요약
맵퀘스트가 야외 감시카메라와 번호판 인식기(ANPR) 위치를 표시하는 새로운 레이어를 앱에 추가했다. 표시되는 카메라 제품은 Flock을 비롯해 Motorola Solutions(Vigilant), Genetec, Axis Communications, Axon, Leonardo(ELSAG), Neology, Rekor, PlateSmart, Ubicquia, Verkada 등 10여 업체 제품이다. 새 레이어는 기존의 교통상황과 사건 표시 옵션과 함께 앱 내에서 쉽게 찾을 수 있도록 배치됐다. 전체 요약 5문장 읽기 → 051 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 052 15:11 ▲ 119 · 댓글 2 이미지만으로 3D 장면 만드는 기술, 대각도 뷰 렌더링 성능 25% 향상 입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. AI · 머신러닝 · InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
Key Point 대각도 뷰 변화에서 3D 렌더링 품질을 비약적으로 개선한 방법론의 구체적 성과와 기술적 혁신이 담겨 있어, 3D 비전 분야의 실무자와 연구자에게 직접 활용 가능한 정보를 제공한다.
핵심 요약
입력 이미지만으로 3D 장면을 직접 구축하는 피드포워드 가우시안 재구성 기술에서 큰 시점 변화 하에서 높은 품질의 렌더링을 위해 가우시안 속성을 학습하기 어려운 문제를 지적했다. InfiniSplat v2는 기하학과 속성 예측을 분리하되 기하학 브랜치는 고정하고, 훈련 시 예측된 가우시안을 실제 카메라 포즈로 정렬하며, 대각도 타겟 뷰 감독을 도입해 이 한계를 개선했다. 6개 데이터셋에서 평가한 결과, 카메라 포즈가 주어진 설정과 포즈 프리 설정 모두에서 평균 LPIPS와 DISTS 지표가 최첨단 성능을 달성했다. 전체 요약 5문장 읽기 → 053 15:11 ▲ 16 · 댓글 2 단안 카메라 영상에서 인물 추적 시 발생하는 스케일 미스매치 문제 해결 단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. AI · 머신러닝 · A Diagnostic Study of World-Space Human Recovery Under High Camera Dynamics
Key Point 빠르게 움직이는 카메라가 있는 실제 방송 환경에서 인물 3D 복원 기술의 정확도를 크게 떨어뜨리는 스케일 미스매치 문제와 그 원인, 그리고 간단한 해결책을 제시한다.
핵심 요약
단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. 연구팀이 K-Pop 스트레스 테스트를 도입했는데, 이는 빠르고 큰 카메라 움직임과 복잡한 다중 인물 안무를 결합한 방송 댄스 영상들이다. 기존 최고 성능 방법들은 이 영상에서 프레임별로는 그럴듯한 메시를 생성하지만, 월드 좌표계 상의 인물 궤적은 실제 무대 위치에서 크게 벗어난다. 전체 요약 7문장 읽기 → 054 15:11 ▲ 18 · 댓글 2 비디오 월드 모델의 KV 캐시 병목 해결하는 Velox 비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. AI · 머신러닝 · Velox: Spatial Memory Makes World Models Efficient
Key Point 비디오 기반 상호작용형 시뮬레이션에서 반응 속도가 중요한데, 기존 방식은 생성 길이가 늘어날수록 지수적으로 느려지는 메모리 병목이 있기 때문이다.
핵심 요약
비디오 월드 모델은 액션과 카메라 움직임으로 장시간의 시각적 생성물을 만들지만, KV 캐시가 계속 커져 뒷부분 청크 생성이 느려지는 문제가 있다. Velox는 학습 없이 작동하는 어텐션 라우터로, 스트리밍 기하학으로부터 카메라 frustum slab 대응을 이용해 영역 수준의 컨텍스트를 선택한다. 과거 블록을 깊이 간격이 있는 frustum slab으로 표현하고, 현재 블록의 깊이는 recency-priority multiwarp를 통해 구한다. 전체 요약 8문장 읽기 → 055 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 056 12:11 ▲ 78 · 댓글 3 비디오 생성 중간에 이미 완성된 토큰 멈추기 자동회귀 비디오 생성은 모든 토큰을 최종 노이즈 제거 단계까지 거치지만, 많은 토큰은 초기 단계에서 이미 최종 출력과 거의 같아서 더 이상의 처리가 불필요하다. AI · 머신러닝 · Speculative Forcing for Efficient Autoregressive Video Generation
Key Point 자동회귀 비디오 생성의 계산 병목을 토큰 단위로 해결해 같은 품질의 결과를 1.35~1.5배 빠르게 생성할 수 있게 하는 방법론이 공개됐다.
핵심 요약
자동회귀 비디오 생성은 모든 토큰을 최종 노이즈 제거 단계까지 거치지만, 많은 토큰은 초기 단계에서 이미 최종 출력과 거의 같아서 더 이상의 처리가 불필요하다. Speculative Forcing은 초기 단계의 깨끗한 추정값을 임시 결과물로 취급하고, 개별 토큰이 안전하게 조기에 수락될 수 있는 시점을 예측하는 프레임워크다. 수락된 토큰은 더 이상 노이즈 제거를 받지 않으면서 남은 토큰들의 맥락으로 캐시된 키와 값이 활용된다. 전체 요약 7문장 읽기 → 057 12:11 ▲ 31 · 댓글 2 생성 비디오의 3D 일관성을 평가하는 벤치마크 'Orbia' 공개 생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. AI · 머신러닝 · Orbia: Do Generated Videos Form a Consistent 3D World?
Key Point 생성 AI 비디오 모델이 시각적으로는 그럴듯하지만 기하학적으로 일관된 3D 세계를 구성하지 못하는 근본적 문제를 첫 체계적으로 평가할 수 있게 해준다.
핵심 요약
생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. 기존 벤치마크는 선별된 기하학적 성질만 테스트하거나 비전-언어 모델로 모호하게 일관성을 판단했으나, Orbia는 3D 일관성을 포괄적으로 측정한다. 입력 보존, 생성 콘텐츠 지속성, 3D 자체 일관성 세 가지 차원으로 평가를 구성했다. 전체 요약 8문장 읽기 → 058 12:11 ▲ 128 · 댓글 113 AI로 리눅스 드라이버 없는 하드웨어를 역공학했다 저자가 구형 필름 스캐너 Plustek 8200i를 구입했으나 칩셋이 변경되어 리눅스 드라이버가 없었고, Claude AI의 도움을 받아 드라이버 작성에 시도했으나 오래 진전이 없었다. 하드웨어 · 시스템 · Using AI to reverse engineer hardware
Key Point 문서화되지 않은 하드웨어의 드라이버 작성이라는 골치 아픈 작업을 AI가 크게 단축시켰으며, 저자가 공개한 hw-harness 도구로 누구나 같은 방식을 시도할 수 있게 되었다.
핵심 요약
저자가 구형 필름 스캐너 Plustek 8200i를 구입했으나 칩셋이 변경되어 리눅스 드라이버가 없었고, Claude AI의 도움을 받아 드라이버 작성에 시도했으나 오래 진전이 없었다. Tom Crider가 AI 에이전트로 마우스 드라이버를 수정한 사례에서 영감을 받아, Claude에게 Windows 가상머신을 제어해 USB 데이터를 캡처하도록 설정했다. 스캐너의 Windows 드라이버 출력과 Linux 드라이버 출력을 비교하는 능력이 결정적이었고, 며칠 내에 적외선 스캔 지원이 포함된 작동하는 SANE 드라이버를 완성했다. 전체 요약 13문장 읽기 → 059 09:11 ▲ 203 · 댓글 105 16GB로 28개 서비스 운영하는 방법 저자는 인도에서의 저렴한 스트리밍 비용 이후 서방 가격 책정을 거부하고, 자녀의 무제한 추천 알고리즘으로부터 보호하기 위해 스트리밍 서비스를 중단했다. 인프라 · 데브옵스 · What I Self-Host
Key Point 작은 하드웨어로 수십 개 서비스를 효율적으로 자체 호스팅하려는 개발자들에게 실제 운영 구성, 도구 선택 원칙, 구체적 성능 수치를 제시한다.
핵심 요약
저자는 인도에서의 저렴한 스트리밍 비용 이후 서방 가격 책정을 거부하고, 자녀의 무제한 추천 알고리즘으로부터 보호하기 위해 스트리밍 서비스를 중단했다. Jellyfin을 기점으로 클라우드 서비스 의존도를 줄이기로 결심했으며, ISP의 CGNAT 제약으로 IPv6 VPN만 공개하고 내부 서비스는 인터넷에 노출하지 않는 정책을 유지했다. 단일 Go 바이너리 선호, Docker 대신 Podman/systemd 활용 등 운영 간편성을 우선으로 서비스를 선택했다. 전체 요약 9문장 읽기 → 060 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 061 21:11 당일 +161 에이전트가 휴대폰을 제어하는 Phone Harness Claude Code나 Codex 같은 에이전트가 실제 휴대폰을 원격 제어할 수 있는 오픈소스 도구로, iPhone과 Android를 모두 지원한다. AI · 머신러닝 · ShawnPana/phone-harness · Python
Key Point AI 에이전트가 실제 휴대폰을 제어할 수 있는 실용적인 도구가 나왔으며, jailbreak나 복잡한 설정 없이 iPhone·Android 모두 지원하고 클라우드 폰도 렌트할 수 있어 자동화 테스트와 에이전트 통합의 새로운 가능성을 열고 있다.
핵심 요약
Claude Code나 Codex 같은 에이전트가 실제 휴대폰을 원격 제어할 수 있는 오픈소스 도구로, iPhone과 Android를 모두 지원한다. iPhone은 Mac의 iPhone 미러링 윈도우를 통해, Android는 adb(Android Debug Bridge)로 macOS·Linux·Windows에서 제어 가능하며, 폰에 아무것도 설치할 필요가 없다. 에이전트는 화면을 보고 탭·스와이프·타이핑으로 조작할 수 있으며, Apple의 Vision 프레임워크가 OCR을 수행해 텍스트를 인식한다. 전체 요약 8문장 읽기 → 062 12:11 ▲ 323 · 댓글 1 장편 비디오 생성의 공간·시간 일관성을 위한 ATAS 프레임워크 장편 영화 시나리오를 비디오로 생성할 때 순서가 아닌 요청 사이에서도 공간과 시간 일관성을 유지해야 하는데, 기존 방식은 프롬프트나 최근 프레임만 전달해 장면 재방문이나 이전 사건 재재생에 필요한 공간 기준과 시간 기록을 제공하지 못했다. AI · 머신러닝 · Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation
Key Point 비디오 생성 AI가 긴 영상에서 장면 일관성을 유지해야 하는 핵심 문제를 해결하는 새로운 접근 방식을 제시하며, 기존 방법 대비 정량적·정성적 평가에서 모두 우수한 성과를 보여준다.
핵심 요약
장편 영화 시나리오를 비디오로 생성할 때 순서가 아닌 요청 사이에서도 공간과 시간 일관성을 유지해야 하는데, 기존 방식은 프롬프트나 최근 프레임만 전달해 장면 재방문이나 이전 사건 재재생에 필요한 공간 기준과 시간 기록을 제공하지 못했다. ATAS는 시나리오를 명시적인 위치, 카메라, 사건 시간 참조를 포함한 샷 요청으로 컴파일하는 방식으로, 생성 전 정적 기하학을 담은 장면 메모리와 시간별 동적 관찰을 담은 사건 메모리에서 관련 증거를 검색한다. 생성 후 ATAS는 클립을 재구성하고 등록하며, 검토와 상태 확인이 관찰을 수용할 때만 메모리를 업데이트하되 최종 영상 출력은 메모리 승인과 독립적으로 제공된다. 전체 요약 5문장 읽기 → 063 00:11 ▲ 10 · 댓글 2 생성형 AI로 대규모 3D 장면 완전 복원 실현 다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. AI · 머신러닝 · WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
Key Point 완전하고 일관된 대규모 3D 장면 복원이 가능해져 가상현실·영상 제작·로봇 환경 인식 등 다양한 분야에서 활용될 수 있게 된다.
핵심 요약
다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. 입력 이미지로부터 추정한 포인트 클라우드와 카메라 포즈를 전역 스캐폴드로 사용하고, 이를 겹치는 공간 블록으로 분할하여 처리한다. 3D 생성 모델 TRELLIS.2를 개선한 재구성 기반 조건화 아키텍처로 각 블록을 로컬 포인트 클라우드와 해당 이미지로부터 생성하며, 구조·기하·PBR 재료를 출력한다. 전체 요약 6문장 읽기 → 064 18:11 ▲ 18 · 댓글 1 4D 생성 영상의 기하학적 일관성을 높이는 GeoFix 논문 공개 비디오 확산 모델을 4D 생성의 기초로 사용할 때 생성된 영상이 기하학적 일관성을 잘 유지하지 못하는 문제가 있다. AI · 머신러닝 · GeoFix: Geometry Fixing for 4D Consistent Generation
Key Point 비디오 확산 모델 기반 4D 콘텐츠 생성이 점점 실용화되는 가운데, 기하학적 정확성을 유지하면서도 시각 품질을 보존하는 균형의 문제를 해결하는 방법론을 제시하고 있다.
핵심 요약
비디오 확산 모델을 4D 생성의 기초로 사용할 때 생성된 영상이 기하학적 일관성을 잘 유지하지 못하는 문제가 있다. 기존 방법은 기하학적 보상을 설계해 사후 학습하지만 텍스처와 세부 디테일이 저하되어 추가 외형 보상과 신중한 보상 조정이 필요했다. GeoFix는 단일 기하학적 보상으로 기하학적 일관성과 시각적 품질을 동시에 개선하는 통합 프레임워크로, 학습 및 추론 시간 모두에 적용 가능하다. 전체 요약 7문장 읽기 → 065 15:11 ▲ 21 · 댓글 2 영상을 3D 장면으로 재구성하는 AI 에이전트 평가 벤치마크 공개 영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. AI · 머신러닝 · CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
Key Point 영상 생성 및 3D 재구성 기술의 발전 상황을 정량적으로 측정하는 공식 벤치마크가 처음 제시되었으며, 주요 AI 모델들의 구체적인 한계를 보여줍니다.
핵심 요약
영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. 벤치마크는 50개의 참조 영상과 360개의 주석이 달린 평가 클립으로 구성되며, 영화, 실제 영상, 게임 등 다양한 출처의 영상을 포함한다. 에이전트는 주어진 영상으로부터 도구를 사용해 3D 장면을 구성, 애니메이션, 렌더링, 개선하며, Proxy(기본), Simplified(간단), Detailed(상세) 세 가지 재현 수준으로 평가된다. 전체 요약 5문장 읽기 → 066 15:11 ▲ 56 · 댓글 2 다중 플레이어 게임 세계를 효율적으로 생성하는 계층 통신 모델 다중 플레이어 인터랙티브 월드 모델은 여러 플레이어의 관점에서 공유 환경을 시뮬레이션해야 하지만, 플레이어 수가 증가할 때 강건한 생성을 유지하기 어렵다. AI · 머신러닝 · Multics: Generative Multi-Player World Model with Hierarchical Communication
Key Point 게임·메타버스 개발에서 많은 플레이어를 효율적으로 처리하는 영상 생성 기술의 확장성 문제를 푼 방법으로, 재학습 없이 여러 규모에 대응하고 계산 비용을 줄일 수 있다.
핵심 요약
다중 플레이어 인터랙티브 월드 모델은 여러 플레이어의 관점에서 공유 환경을 시뮬레이션해야 하지만, 플레이어 수가 증가할 때 강건한 생성을 유지하기 어렵다. 기존 방식(Solaris의 완전 연결 통신)은 플레이어 수에 따라 주의 비용이 이차적으로 증가하고, 중앙식 접근법(γ-World)은 공유 표현에서 무관한 이벤트 간 간섭 문제가 있다. Multics는 플레이어·그룹·전역 레벨에서 정보 교환을 구조화하는 계층 통신으로 이를 해결한다. 전체 요약 9문장 읽기 → 067 09:11 ▲ 351 · 댓글 322 OpenAI 엔지니어, 임원진 회의실 도청 혐의로 체포 OpenAI 임원진이 사용하는 회의실에 녹음 장치를 숨긴 혐의로 사우디 국적의 엔지니어 Abdulrahman Alfozan(35)이 체포되어 연방법원에 출두했으며, 2025년 7월부터 OpenAI에서 근무해온 것으로 확인됐다. 보안 · OpenAI engineer arrested in bugging of executive conference room
Key Point OpenAI 같은 주요 AI 회사의 보안 사건이 구체적으로 어떤 방식으로 일어나는지, 엔지니어 자격의 내부자가 얼마나 정교한 도구와 계획으로 기술 정보에 접근하려 했는지 보여주는 사건입니다.
핵심 요약
OpenAI 임원진이 사용하는 회의실에 녹음 장치를 숨긴 혐의로 사우디 국적의 엔지니어 Abdulrahman Alfozan(35)이 체포되어 연방법원에 출두했으며, 2025년 7월부터 OpenAI에서 근무해온 것으로 확인됐다. 9월 30일 발견된 녹음 장치는 회의실 TV 뒤 USB 포트에 꽂혀 있었고 화장지로 위장되어 있었으며, 9월 28일경 설치된 것으로 추정되고 내용이 암호화되어 있었다. 감시 카메라 영상에 따르면 Alfozan은 설치 전 여러 차례 해당 회의실 근처에서 포착되었으나 그는 이 회의실에 들어갈 권한이 없었고, 회의실에서는 독점 연구, 제품 계획, 정부 관계 등 기밀 정보가 다뤄져 왔다. 전체 요약 12문장 읽기 → 068 06:11 ▲ 146 · 댓글 39 로봇 물리 제어 위해 특화된 제미니 4 아르곤 공개 구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. AI · 머신러닝 · Gemini 4 Argon for Robotics
Key Point 3D 물리 환경에서 로봇 제어·시뮬레이션·코드 생성을 통합적으로 처리하는 AI 모델의 등장으로, 로봇공학 개발의 전체 워크플로우가 단순화될 수 있는 전환점이 될 수 있다.
핵심 요약
구글이 로봇공학 전문 대규모 언어 모델 제미니 4 아르곤을 발표했다. 아르곤은 ERQA 벤치마크에서 순수 추론으로 87% 점수를 달성해 다른 모든 경쟁 모델을 능가한다. 보스턴 다이나믹스 스팟 로봇 제어, 로봇팔 조작 작업, 3D 환경 내 물체 배열 등 로봇공학 전주기에 적용 가능하다. 전체 요약 12문장 읽기 → 069 03:11 ▲ 164 · 댓글 327 애플, AI 기능 강화한 새 Apple TV 4K 공개 애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. AI · 머신러닝 · New Apple TV 4K
Key Point 애플의 주요 가정용 기기에 생성형 AI 기능이 본격 적용되는 사례로, 음성 인터페이스와 홈 자동화가 어떻게 진화하고 있는지 보여준다.
핵심 요약
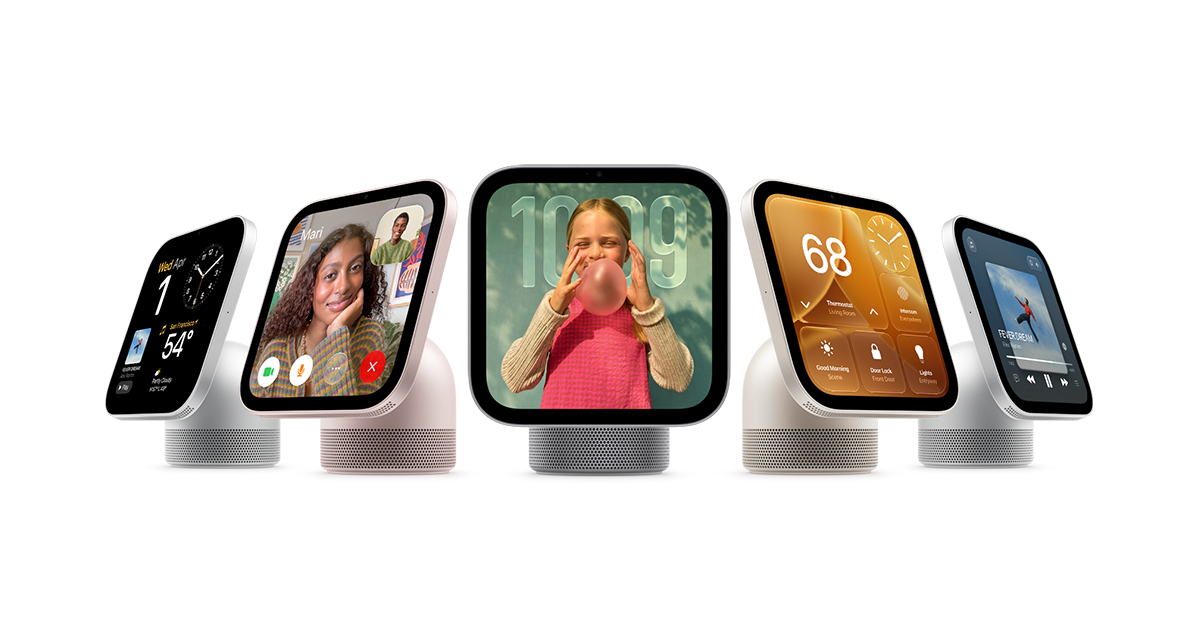
애플이 10월 13일 차세대 Apple TV 4K(4세대)를 발표했으며, 11월 13일부터 판매된다. 신형 기기는 Siri AI를 탑재해 사용자가 영화·드라마를 찾고 발견하는 경험을 전체 화면 대화형 인터페이스로 제공한다. Siri AI는 애플 인텔리전스 기반으로 더 강력해졌으며, 개인 맥락을 이해해 '알린다가 추천한 쇼 재생'처럼 기기 간 요청을 처리할 수 있다. 전체 요약 13문장 읽기 → 070 00:11 ▲ 236 · 댓글 268 애플, 스마트홈 허브 'HomeView' 11월 13일 출시 애플이 7인치 액정 레티나 디스플레이를 갖춘 스마트홈 허브 'HomeView'를 11월 13일부터 선주문 받으며 A18칩을 탑재했다. 하드웨어 · 시스템 · Apple HomeView
Key Point HomeView는 프라이버시 보호와 다중 사용자 지원을 강조한 애플의 스마트홈 허브로, 기존 제품과 달리 Secure Enclave를 통해 개인 데이터가 OS에 노출되지 않으며 최대 6명의 사용자를 분리해 관리할 수 있다는 점이 핵심이다.
핵심 요약
애플이 7인치 액정 레티나 디스플레이를 갖춘 스마트홈 허브 'HomeView'를 11월 13일부터 선주문 받으며 A18칩을 탑재했다. HomeView는 최대 6명까지 인식해 각 사용자별 맞춤형 경험을 제공하고, 개별 사용자의 개인 정보는 분리·보호된다. Apple Intelligence 기반 Siri AI가 내장되어 있으며, 개인 맥락·세계 지식·자연스러운 대화 형식으로 음성 어시스턴트 역할을 한다. 전체 요약 13문장 읽기 → 071 21:11 당일 +119 MCP 기반 AI 음성 대화 로봇, ESP32에서 구동 XiaoZhi는 Qwen/DeepSeek 같은 대형 언어모델을 활용한 음성 대화 AI 로봇으로, MCP 프로토콜을 통해 다중 단말 제어를 지원한다. 하드웨어 · 시스템 · 78/xiaozhi-esp32 · C++
Key Point ESP32 기반 오픈소스 음성 AI 로봇으로 Qwen/DeepSeek 같은 최신 대형언어모델을 임베디드 환경에서 구현하는 방식과 138개 보드 변형으로의 확장성을 보여준다.
핵심 요약
XiaoZhi는 Qwen/DeepSeek 같은 대형 언어모델을 활용한 음성 대화 AI 로봇으로, MCP 프로토콜을 통해 다중 단말 제어를 지원한다. Wi-Fi, 유선 이더넷, USB RNDIS, Cat.1 4G 등 다양한 네트워킹을 지원하며 보드에 따라 Wi-Fi와 4G 사이 전환이 가능하다. ESP-SR을 활용한 오프라인 음성 웨이크업, WebSocket과 MQTT+UDP 두 가지 통신 방식, Opus 음성 스트리밍, AEC 지원 기기의 실시간 전이중 상호작용을 제공한다. 전체 요약 12문장 읽기 → 072 03:11 ▲ 162 · 댓글 60 슈퍼마리오64 개발 비하인드 - 닌텐도 코더 긱스 고다드 인터뷰 2001년 닌텐도 코더 긱스 고다드의 미발표 인터뷰로, 슈퍼마리오64 개발 당시의 뒷이야기를 담은 자료이다. 하드웨어 · 시스템 · The Making Of Super Mario 64 – full Giles Goddard interview (2001)
Key Point 슈퍼마리오64가 3D 게임 설계와 게임플레이 튜닝을 어떻게 했는지 개발자 직접 증언으로 보여주며, 현대 3D 게임의 기초가 된 기술 결정들을 구체적으로 공개한다.
핵심 요약
2001년 닌텐도 코더 긱스 고다드의 미발표 인터뷰로, 슈퍼마리오64 개발 당시의 뒷이야기를 담은 자료이다. 마리오 팀은 약 15명 규모로 젤다 시간의 오카리나 제작팀보다 훨씬 작았으며, 닌텐도 내 아티스트와 프로그래머는 분리되어 있었다. N64 에뮬레이터 없이 SGI Onyx에서 GL 프로그래밍으로 시작했고, 6개월간 컨트롤러가 없어 개조된 세가 조이패드를 사용했다. 전체 요약 13문장 읽기 → 073 18:12 ▲ 139 · 댓글 2 로봇 팔이 던져진 상자를 받는다 - 시각·반사·전신제어 동시에 인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. AI · 머신러닝 · Reflex: Visually Grounded Reactive Humanoid Control
Key Point 시각 피드백 기반의 실시간 전신 제어라는 난제를 단계별 학습으로 풀었고, 실제 로봇에서 인간 수준의 반사 동작 구현에 가까워지고 있습니다.
핵심 요약
인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. Reflex는 던져진 상자 잡기를 목표로 전신 제어·물체 동역학 예측·시각 인지 세 가지 능력을 단계별로 학습하는 프레임워크다. 첫 번째 단계에서는 강화학습으로 상태 기반 전신 잡기 정책을 학습하고, 두 번째는 불완전하고 지연된 관찰에서 움직이는 상자의 동역학을 추론하며, 세 번째는 RGB-D 카메라로부터 직접 동역학을 복원한다. 전체 요약 6문장 읽기 → 074 18:12 ▲ 138 · 댓글 142 리눅스 폰, 안드로이드·iOS 독점에 맞서 준비 중 5년 전 리베렐 Librem 5와 PinePhone 출시 이후 리눅스 폰은 침체기를 겪었다. 하드웨어 · 시스템 · Will Linux phones become a viable alternative to the Android/iOS duopoly?
Key Point 리눅스 폰이 해결할 수 없던 기술적 장벽(SoC 성능, 배터리, 카메라)을 RK3588S로 넘어설 수 있게 되었고, 구글의 안드로이드 부트로더 잠금 강화로 대안을 찾는 사용자가 늘어날 가능성이 생겼습니다.
핵심 요약
5년 전 리베렐 Librem 5와 PinePhone 출시 이후 리눅스 폰은 침체기를 겪었다. 당시 약한 SoC 성능, 하드웨어 드라이버 부족, 미숙한 모바일 UI, 배터리 문제 등이 주요 원인이었다. 2022년 발표된 Rockchip RK3588S가 게임을 바꿨다: Cortex-A76 4개 + A55 4개, Mali-G610 그래픽스로 처음으로 실용적인 성능을 제공한다. 전체 요약 14문장 읽기 → 075 18:11 ▲ 144 · 댓글 34 숨겨진 카메라도 20m 거리서 적발, 전자파로 감지하는 기술 등장 중국 대학 연구팀이 무선·유선·오프라인 방식 모든 종류의 몰래카메라를 탐지·위치추적하는 'ESauron' 시스템을 개발했다. 보안 · Eye of Sauron: Long-Range Hidden Spy Camera Detection
Key Point 기존의 육안 검사나 신호 감지 방식과 달리 메모리 전자파를 이용한 새로운 탐지법이 모든 종류의 카메라에 작동하며, 상당한 거리에서도 효과적이라는 점이 중요하다.
핵심 요약
중국 대학 연구팀이 무선·유선·오프라인 방식 모든 종류의 몰래카메라를 탐지·위치추적하는 'ESauron' 시스템을 개발했다. 몰래카메라는 영상을 처리하는 과정에서 메모리 읽기·쓰기를 수행하는데, 이때 발생하는 전자파(EMR)를 감지하는 방식이다. 메모리 클록이 작동 부하에 따라 전압 조절기의 활동을 증가시키면서 변동하는 전류가 흐르고, 이것이 시계 주파수 대역의 전자파를 방출한다. 전체 요약 7문장 읽기 → 076 15:11 ▲ 18 · 댓글 2 3D 재구성 모델의 거리 추정 능력을 평가하는 벤치마크 Pumpire 공개 Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. AI · 머신러닝 · Pumpire: Unified Benchmark for Metric Distance Estimation
Key Point 3D 모델의 정확한 거리 측정 능력을 처음으로 직접 평가하는 벤치마크로, 재구성 기하의 물리적 정확도 검증에 필수적인 기준을 제시한다.
핵심 요약
Pumpire는 이미지와 비디오 기반 3D 파운데이션 모델의 포인트 간 거리 추정 능력을 통합 평가하는 벤치마크다. 기존 깊이 맵과 카메라 내부 파라미터를 따로 평가하거나 기하학적 유사도 지표를 쓰는 방식과 달리, 재구성된 기하 정보에서 직접 포인트 간 거리 오류를 측정한다. 100개 실제 장면에서 물리적으로 측정한 포인트 쌍 거리를 주석 달고 장면마다 64프레임(총 6,400프레임)으로 구성한 대규모 데이터셋 pumpire-6k를 수집했다. 전체 요약 7문장 읽기 → 077 09:11 ▲ 357 · 댓글 190 유튜버가 경찰 차량 추적 카메라 제작 후 경찰 방문받아 경찰은 자동 번호판 인식(ALPR) 카메라를 시민 감시에 사용하지만, 자신들이 같은 기술로 감시받는 것에는 거부감을 보이고 있다. 보안 · YouTuber Says Cops Visited Him After He Built a Flock-Style Camera to Track Cops
Key Point 경찰이 시민 감시 도구로 쓰는 기술이 자신들에게 향할 때 즉시 문제를 제기하는 이중성을 직접 보여주며, ALPR 기술의 권력 불균형 문제를 구체화한다.
핵심 요약
경찰은 자동 번호판 인식(ALPR) 카메라를 시민 감시에 사용하지만, 자신들이 같은 기술로 감시받는 것에는 거부감을 보이고 있다. Flock 등의 ALPR 기술은 최근 몇 년간 급속히 확산되었으며, 전 파트너 스토킹, 이민자 괴롭힘, 무고한 사람들의 삶 파괴 등 데이터 오용 사례가 잇따르고 있다. 캐나다 소프트웨어 엔지니어이자 유튜버 앤서니 시스틸리는 최근 경찰 차량만 추적하도록 설정한 개인용 ALPR 카메라를 제작해 TikTok에 영상을 올렸다. 전체 요약 6문장 읽기 → 078 09:11 ▲ 147 · 댓글 19 월레이스와 그로밋, 혼자서 90%를 만들다 1989년 11월 브리스톨 애니메이션 페스티벌에서 닉 파크의 '월레이스와 그로밋: 달나라 여행'이 처음 공개되었으며, 이 작품은 BAFTA를 수상하고 이후 애니메이션에 거대한 영향을 끼쳤다. 기타 · 'Wallace and Gromit,' 90% Alone
Key Point 개인 혼자의 7년 노력이 세계 애니메이션의 미학을 바꿔놓은 사례와 함께, 현대 애니메이션 산업이 잃어가는 현장 학습 전통을 회복하려는 움직임을 함께 다룬다.
핵심 요약
1989년 11월 브리스톨 애니메이션 페스티벌에서 닉 파크의 '월레이스와 그로밋: 달나라 여행'이 처음 공개되었으며, 이 작품은 BAFTA를 수상하고 이후 애니메이션에 거대한 영향을 끼쳤다. 닉 파크는 1982년부터 시작한 이 졸업작품에서 개인적으로 90% 이상을 직접 제작했으며, 초기 예산 부족으로 인해 대부분 혼자 작업해야 했다. 파크는 어릴 때부터 부모의 8mm 카메라로 애니메이션을 만들며 수십 년간 영화, 스톱모션, 만화 등 다양한 매체를 연구하며 기초를 다졌다. 전체 요약 12문장 읽기 → 079 06:11 ▲ 19 · 댓글 2 로봇이 직접 짜는 코드, VLM 없이도 작동한다 로봇의 세계를 튜링 머신으로 보고, 상태 변화와 정책을 코드로만 표현하는 COAP(Code-Only-as-Policy) 방식을 제안했다. AI · 머신러닝 · Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
Key Point 로봇이 대규모 언어 모델 없이 명시적인 코드로만 작동하면서 70% 이상의 성공률을 보인 새로운 접근법이기에, 로봇 자동화와 에이전트 개발의 패러다임 변화를 보여준다.
핵심 요약
로봇의 세계를 튜링 머신으로 보고, 상태 변화와 정책을 코드로만 표현하는 COAP(Code-Only-as-Policy) 방식을 제안했다. 카메라 이미지와 로봇 센서 데이터에서 상태를 명시적으로 추출·추적하며, 실행 시점에 VLM이나 VLA 모델 없이 코드만으로 의사결정을 수행한다. COAP의 장점은 세 가지다: 상태를 코드 변수로 명확히 저장할 수 있고, 제어 가능하고 빠르고 비용이 낮으며, 에러에서도 유연하게 복구한다. 전체 요약 8문장 읽기 → 080 21:11 당일 +362 스트리밍 3D 재구성 모델 LingBot-Map 공개 Robbyant 팀이 실시간 3D 재구성을 위한 피드포워드 3D 기초 모델 LingBot-Map을 공개했다. AI · 머신러닝 · Robbyant/lingbot-map · Python
Key Point 실시간 카메라 입력으로 고품질 3D 장면을 20 FPS 이상 처리할 수 있는 스트리밍 재구성 모델로, SLAM 및 3D 비전 분야에서 새로운 효율성 기준을 제시한다.
핵심 요약
Robbyant 팀이 실시간 3D 재구성을 위한 피드포워드 3D 기초 모델 LingBot-Map을 공개했다. Geometric Context Transformer 아키텍처를 통해 좌표 정렬, 기하 신호, 드리프트 보정을 단일 스트리밍 프레임워크로 통합했으며, 앵커 컨텍스트, 포즈 참조 윈도우, 궤적 메모리를 활용한다. 518×378 해상도에서 10,000프레임 이상의 긴 시퀀스에 대해 초당 약 20프레임 속도로 안정적인 추론이 가능한 고효율 스트리밍 추론을 제공한다. 전체 요약 12문장 읽기 → 081 15:13 ▲ 24 · 댓글 3 깊이 추정 없이 카메라 관점 변환 비디오 생성 외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. AI · 머신러닝 · LEGO: A Lifting-Free Approach for Exocentric-to-Egocentric Video Generation
Key Point 깊이 추정 단계를 제거하면서도 비디오 생성 품질을 높이는 새로운 접근법으로, 구조 정렬과 세부 복원의 역할 분담 방식이 확산 모델의 특성과 어떻게 부합하는지 보여준다.
핵심 요약
외중심 카메라(제3자 관점) 영상 하나로부터 자아중심 카메라(1인칭 관점) 비디오를 생성하는 것은 두 카메라의 겹치는 영역이 거의 없어 어려운 문제다. 기존 최첨단 방식은 깊이를 추정해 포인트 클라우드로 변환한 후 자아중심 카메라 관점에서 재렌더링하고, 이를 비디오 확산 모델의 조건으로 사용한다. 그러나 이 결정론적 매핑은 각 픽셀을 한 위치에만 할당하므로 깊이 오류가 콘텐츠 배치 오류로 전파되고, 텍스처는 보존되지만 정확도가 떨어진다. 전체 요약 9문장 읽기 → 083 21:11 당일 +196 영상 자동 생성, 이제 AI 편집기에 장착한다 Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. AI · 머신러닝 · Vincentwei1021/video-shotcraft · TypeScript
Key Point AI가 제품 영상을 완전 자동으로 제작하고 웹에서 바로 편집할 수 있는 프로덕션 도구가 오픈소스로 공개됐으며, 기업 마케팅 영상 제작 방식이 크게 바뀔 가능성을 보여준다.
핵심 요약
Claude Code나 Codex용 AI 에이전트 스킬로, 제품 스크린샷과 설명을 입력하면 Remotion 기반 영상을 자동 제작하는 도구다. 152장의 샷 레시피 카드, 214개 모션 프리뷰, 9가지 필름 테마(Ink Press, Modern Light, Midnight 등)를 제공한다. 스토리보딩, 2.5D 카메라 움직임, 비트 싱크 컷, 영화급 음향 설계가 자동으로 적용되며, 템플릿은 36.2초 1920×1080 30fps 완성본으로 검증됐다. 전체 요약 11문장 읽기 → 084 21:11 ▲ 20 · 댓글 2 카메라 기하학 조건으로 다중 시점 이미지 합성 3배 가속 소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. AI · 머신러닝 · NAMVIS: Next-Scale Autoregressive Multi-View Image Synthesis
Key Point 3D 콘텐츠 제작에 필수적인 다중 시점 생성을 기존 방식보다 3배 빠르고 더 정확하게 처리하는 기술이 등장했기 때문이다.
핵심 요약
소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. 기존 확산 모델의 반복적 잡음 제거 대신, 이산 시각 토큰을 단계별로 예측하고 모든 토큰을 병렬로 샘플링하는 자동회귀 방식을 사용한다. 멀티스케일 프로젝티브 포즈 인코딩이라는 기법으로 소스·타겟 카메라의 기하학적 변환 정보를 모든 해상도의 셀프-어텐션과 크로스-어텐션에 주입한다. 전체 요약 6문장 읽기 → 085 18:30 ▲ 19 · 댓글 1 영상 기초 모델, 손 추적과 촉각 정보까지 동시 추정 동영상 기초 모델을 기반으로 단일 카메라 영상에서 손 포즈와 촉각 정보를 함께 추정하는 RLHND를 제안했다. AI · 머신러닝 · RLHND: Video Foundation Models as Physically Grounded Hand Trackers for Robot Learning
Key Point 로봇이 인간 영상으로부터 학습할 때 물리적으로 일관된 손 움직임과 접촉 정보가 필요한데, 기존 추적기는 이를 정확히 추정하지 못했습니다. 이 연구는 단일 카메라 영상에서 포즈와 촉각을 동시에 추정함으로써 인간-로봇 모방 학습의 데이터 품질을 크게 개선합니다.
핵심 요약
동영상 기초 모델을 기반으로 단일 카메라 영상에서 손 포즈와 촉각 정보를 함께 추정하는 RLHND를 제안했다. 사전 학습된 Cosmos 3 비디오 확산 모델을 결정론적 특성 추출기로 변환하여 손 움직임과 손-물체 상호작용에 대한 학습된 사전 정보를 추적에 적용한다. 포즈 추정 시 해부학적으로 타당한 관절각도를 예측하고, 동일 영상 또는 같은 배우가 촬영한 영상에서 일관된 손 모양을 유지하도록 선택적 컨디셔닝을 지원한다. 전체 요약 7문장 읽기 → 086 18:30 ▲ 31 · 댓글 2 멀티모달 AI 에이전트, 로봇 제어는 여전히 어렵다 Hugging Face와 연구팀이 로봇 제어 능력을 평가하는 벤치마크 'RobotWorld'를 공개했다. AI · 머신러닝 · RobotWorld: Benchmarking Multimodal Agents for Robot Use Across Diverse Tasks and Embodiments
Key Point 최고 성능의 멀티모달 AI도 로봇 제어에서 단편적 성공에 그치며 작업 완료로 이어지지 않는 구조적 한계를 보여주는 결과물로, 현재 생성 AI의 물리 세계 응용 가능성을 재평가하는 데 필수적이다.
핵심 요약
Hugging Face와 연구팀이 로봇 제어 능력을 평가하는 벤치마크 'RobotWorld'를 공개했다. 조작, 이동 조작, 보행, 운전, 비행 제어 등 84개 작업으로 구성되며, 명시적 상호작용 예산과 성공 판정 기준을 제공한다. Claude Astra, Claude Opus 5.5 등 주요 멀티모달 에이전트를 테스트한 결과, 이미지 분할, 카메라 보정, 공간 추정 등 정교한 인식 및 제어 워크플로우를 구축할 수 있음을 확인했다. 전체 요약 7문장 읽기 → 087 18:33 ▲ 13 · 댓글 2 VLA 모델의 지름길 학습 끊기, 섭동 훈련으로 Vision-Language-Action(VLA) 정책은 작업 결정에 필요한 핵심 증거를 무시하고도 복잡한 과제를 완료할 수 있는데, 시각 정보, 언어, 동작의 '모달리티 지름길(shortcut)'에 의존하기 때문이다. AI · 머신러닝 · PerturBot: Breaking Shortcut Priors in Vision-Language-Action Models with Perturbative Training
Key Point 로봇이 실제 작업의 핵심 근거 없이도 지름길 패턴으로 행동을 결정하는 근본 문제를 진단하고 훈련 시점에 해결하는 방법론을 제시한다.
핵심 요약
Vision-Language-Action(VLA) 정책은 작업 결정에 필요한 핵심 증거를 무시하고도 복잡한 과제를 완료할 수 있는데, 시각 정보, 언어, 동작의 '모달리티 지름길(shortcut)'에 의존하기 때문이다. 지름길의 예: 손목 카메라 근처의 물체가 지시된 대상을 밀어낼 수 있고, 훈련 과정에서 동사가 바뀌어도 익숙한 명사가 같은 동작을 유발하며, 빈 손가락이 움직여도 물체를 집어올릴 수 있다. 더 많은 훈련 데이터도 작업 성공률은 올리되 이 지름길을 온전히 해결하지 못하는 문제가 있다. 전체 요약 8문장 읽기 → 088 18:33 ▲ 27 · 댓글 2 인간 영상에서 로봇 정책 학습, 스펙트럼 분석으로 동작 전이 로봇 조작 정책 학습에는 대규모 실제 상호작용 데이터가 필요한데, 시연 수집이 비용이 크고 확장이 어렵다는 문제가 있다. AI · 머신러닝 · World Action Learning via Interaction-Centric Spectral Latent Guidance
Key Point 로봇 학습 데이터 수집 비용을 획기적으로 줄일 수 있는 기술로, 인간 동영상 활용이라는 실질적인 해결책을 제시하고 있다.
핵심 요약
로봇 조작 정책 학습에는 대규모 실제 상호작용 데이터가 필요한데, 시연 수집이 비용이 크고 확장이 어렵다는 문제가 있다. 1인칭 카메라 영상은 풍부한 인간 상호작용 경험을 담고 있지만, 프레임 재구성으로 추론한 동작이 카메라 움직임 같은 노이즈에 지배당하고 인간과 로봇의 시간 역학이 다르다는 두 가지 어려움이 있다. WING(World Action Learning via INteraction-Centric Spectral Latent Guidance) 프레임워크는 1인칭 영상의 상호작용 지식을 로봇 정책으로 전이한다. 전체 요약 7문장 읽기 → 089 18:33 당일 +161 로지텍 주변기기용 오픈소스 설정 도구 OpenLogi 출시 Rust로 만든 OpenLogi는 로지텍 Options+를 대체하는 로컬 우선 오픈소스 도구로, 계정 없이 마우스·키보드·웹캠 설정을 관리한다. 오픈소스 · 도구 · AprilNEA/OpenLogi · Rust
Key Point 로지텍 기기 사용자가 광범위한 커스터마이징을 계정이나 원격 추적 없이 로컬에서 할 수 있는 방법이 생겼으며, 특히 Linux 사용자에게는 공식 지원이 부족한 로지텍 소프트웨어의 실질적 대안이 된다.
핵심 요약
Rust로 만든 OpenLogi는 로지텍 Options+를 대체하는 로컬 우선 오픈소스 도구로, 계정 없이 마우스·키보드·웹캠 설정을 관리한다. HID++와 UVC를 통해 버튼 재맵핑, DPI 제어, SmartShift 휠 설정 등 로지텍 기기의 전체 기능을 지원한다. macOS, Linux, Windows를 모두 지원하며, Linux는 1등급 플랫폼으로 취급되고 웹캠 기능은 플러그앤플레이로 작동한다. 전체 요약 9문장 읽기 → 090 18:33 당일 +118 구글 없는 지도 앱 Vela, 오픈 데이터로 턴바이턴 네비게이션 Android 용 탈구글(degoogled) 지도·네비게이션 앱인 Vela는 Google Play Services 없이 작동하며, Kotlin으로 작성되었다. 오픈소스 · 도구 · PimpinPumpkin/Vela · Kotlin
Key Point Google Play Services 없이 작동하면서 실시간 트래픽과 장소 정보를 제공하는 오픈소스 지도 앱으로, 프라이버시를 우선하는 개발자와 GrapheneOS 사용자에게 실용적인 대안을 제시한다.
핵심 요약
Android 용 탈구글(degoogled) 지도·네비게이션 앱인 Vela는 Google Play Services 없이 작동하며, Kotlin으로 작성되었다. 지도 기본층은 OpenStreetMap 기반 오픈 벡터타일이고, 장소 데이터는 Overture Maps와 AllThePlaces를 사용해 저장소의 타일에 내장되어 스트리밍된다. 지도 브라우징·검색·경로 지정 시 구글에 전송되는 정보를 세밀하게 제어한다: 지도 팬·줌은 구글에 전혀 안 보내고, 경로는 시작점·종점 좌표만 익명으로 전송되며, 트래픽 재확인은 설정으로 끌 수 있다. 전체 요약 14문장 읽기 → 091 18:33 ▲ 109 · 댓글 97 AI와 공개 데이터로 조지아주 투표 비밀 침해 가능함을 입증 투표 기계의 알고리즘 설계 결함으로 인해 2022년 공개된 보안 취약점이 4년이 지난 2026년 조지아주 5월 예비선거에서도 여전히 악용 가능한 상태로 남아 있다. 보안 · An algorithmic failure beneath the secret ballot
Key Point AI 도구의 민주화가 투표 비밀 침해라는 심각한 보안 결함을 누구나 악용할 수 있게 만들었으며, 기술적 복잡성이 더 이상 보호막이 아니라는 점을 보여준다.
핵심 요약
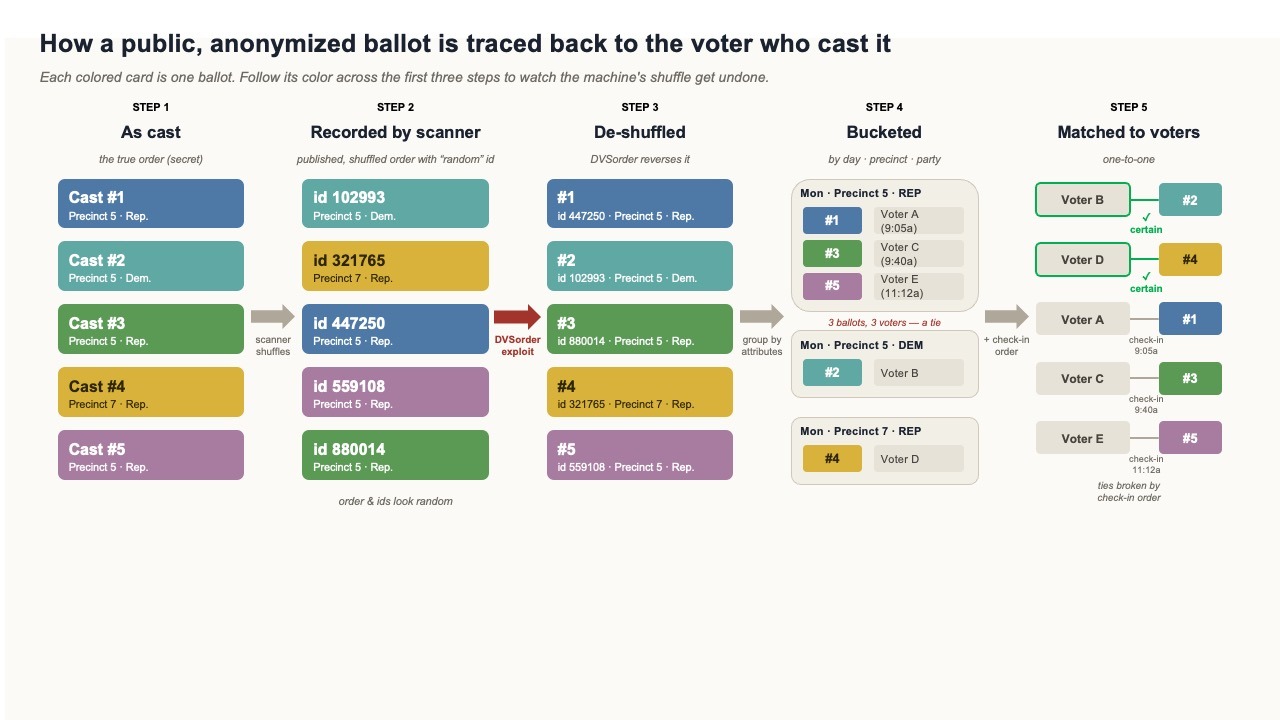
투표 기계의 알고리즘 설계 결함으로 인해 2022년 공개된 보안 취약점이 4년이 지난 2026년 조지아주 5월 예비선거에서도 여전히 악용 가능한 상태로 남아 있다. 투표 기계는 익명성을 위해 전자 투표 기록을 무작위로 섞지만, 사용된 난수 생성 알고리즘이 결정론적이고 역으로 추적 가능해 투표 순서를 정확히 복원할 수 있다. 연구자는 ChatGPT 같은 대형 언어 모델 기반의 AI 코딩 에이전트에 취약점 논문을 제시하고 단 20달러를 지불해 몇 시간 안에 조지아주 139개 카운티 중 114개에서 투표 순서 추적 코드를 자동으로 생성했다. 전체 요약 10문장 읽기 → 092 18:33 ▲ 130 · 댓글 65 Tapo 라이브러리가 TP-Link의 TPAP 프로토콜 지원 TP-Link Tapo 장치용 비공식 Rust/Python 클라이언트 라이브러리 tapo v0.11.1이 TPAP 프로토콜을 지원하면서, 앱의 '타사 호환성' 스위치를 끌 수 있게 됐다. 오픈소스 · 도구 · Tapo (Rust/Python library) now speaks TP-Link's TPAP protocol
Key Point 스위치를 끄고도 장치를 제어할 수 있게 되면서 Home Assistant 같은 타사 홈 오토메이션 플랫폼 사용자가 TP-Link의 강제 제약을 우회할 수 있게 됐다.
핵심 요약
TP-Link Tapo 장치용 비공식 Rust/Python 클라이언트 라이브러리 tapo v0.11.1이 TPAP 프로토콜을 지원하면서, 앱의 '타사 호환성' 스위치를 끌 수 있게 됐다. TP-Link는 펌웨어 1.4.0 이후 이 스위치를 기본적으로 꺼두어, 사용자가 직접 켜지 않으면 타사 클라이언트가 접속할 수 없게 만들었다. KLAP 프로토콜은 해시 기반 인증으로 녹화된 로그인 기록만으로 오프라인 비밀번호 추측 공격이 가능한 반면, TPAP는 RFC 9383의 SPAKE2+ 방식을 써서 해당 장치와 직접 시도해야만 테스트할 수 있다. 전체 요약 9문장 읽기 → 093 18:35 ▲ 206 · 댓글 35 경찰 ALPR 카메라 공개 자료 청구에 억대 요금 부과하는 미국 도시들 Flock 카메라 사용 현황 공개 청구에 대해 미국 도시들이 과도한 요금을 부과하고 있다. 포트워스 인근 노스리치랜드힐스는 한 단체에 약 234만 달러를 요구했으며, 휴스턴 KPRC는 12만 1천 달러 견적을 받았고, 200여 기관 중 일부는 무료로 제공하는 등 부과 기준이 일관되지 않다. 보안 · Texas city demands $2M for public records on Flock usage
Key Point 경찰이 자동 번호판 인식 카메라로 광범위한 감시를 하는 가운데, 공개 청구에 막대한 요금을 부과해 투명성을 차단하려는 움직임이 커지고 있기 때문이다.
핵심 요약
Flock 카메라 사용 현황 공개 청구에 대해 미국 도시들이 과도한 요금을 부과하고 있다. 포트워스 인근 노스리치랜드힐스는 한 단체에 약 234만 달러를 요구했으며, 휴스턴 KPRC는 12만 1천 달러 견적을 받았고, 200여 기관 중 일부는 무료로 제공하는 등 부과 기준이 일관되지 않다. 경찰의 Flock ALPR(자동 번호판 인식) 카메라 남용 적발이 늘고 있다. 텍사스 경찰관 자카리 앤서니 클라인은 공식 정보 오용 혐의 100건으로 유죄를 인정했으며, 이는 공개 기록 청구를 통해 적발되자 텍사스 주지사 그렉 애벗이 Flock 자금 중단과 허가 중단을 결정했다. 오클라호마의 한 연방 판사는 경찰이 캘리포니아 번호판만으로 Flock 데이터베이스를 검색한 것이 헌법 수정 4조 위배라고 판결했다. 판사는 Flock의 ALPR 기술이 '광범위한 무차별 감시 체계'라고 지적했으며, 매달 10만 건 이상의 영장 없는 검색이 발생 중이다. 전체 요약 6문장 읽기 → 094 03:11 ▲ 32 · 댓글 2 영상과 소리를 함께 생성하는 실시간 세계 모델 HelixWorld 기존 세계 모델은 영상만 렌더링했지만, HelixWorld는 사용자 상호작용 하에서 카메라 관점의 영상과 공간 입체음향이 함께 진화하는 실시간 오디오-비주얼 세계 모델이다. AI · 머신러닝 · HelixWorld: A Real-time Interactive Audio-Visual World Model
Key Point 기존의 침묵한 세계 모델에 처음으로 실시간 공간 음향을 추가하여, 메타버스·게임 엔진·3D 시뮬레이션에서 멀티센서 상호작용의 새로운 기준을 제시한다.
핵심 요약
기존 세계 모델은 영상만 렌더링했지만, HelixWorld는 사용자 상호작용 하에서 카메라 관점의 영상과 공간 입체음향이 함께 진화하는 실시간 오디오-비주얼 세계 모델이다. 진정한 입체 음향과 카메라 메트릭 포즈를 갖춘 고충실도 공간 오디오-비주얼 데이터셋을 구축하고, 6-DoF 카메라 궤적과 사용자 액션을 조건으로 하는 양방향 교사 모델을 사전학습했다. 저지연 인과적 상호작용을 위해 온라인 궤적 증류 손실을 통해 교사 모델을 소수 단계의 스트리밍 학생 모델로 증류하여, 단일 GPU에서 초당 24 프레임의 드리프트 없는 오디오-비주얼 롤아웃을 유지한다. 전체 요약 5문장 읽기 → 095 00:11 ▲ 103 · 댓글 69 AI로 자동화한 필름 사진 스캔 워크플로우 35mm 필름 사진 작업 흐름을 자동화한 개인 프로젝트로, 롤당 36장을 처리하는 데 평균 4시간 걸리던 수동 작업을 개선했다. AI · 머신러닝 · Automating my 35mm film scanning pipeline
Key Point 필름 사진 애호가가 수동 스캔 작업의 번거로움을 AI와 자동화로 극복한 실제 사례로, 크리에이티브 워크플로우에 LLM과 비전 모델을 실용적으로 활용하는 방법을 보여준다.
핵심 요약
35mm 필름 사진 작업 흐름을 자동화한 개인 프로젝트로, 롤당 36장을 처리하는 데 평균 4시간 걸리던 수동 작업을 개선했다. Claude AI를 스캐너에 직접 제어시키려 했으나 SANE 드라이버를 통해 스캔 방향을 잘못 설정해 스캐너 기어 메커니즘을 손상시켰고, 수리 후 기존 VueScan 소프트웨어를 유지하기로 결정했다. numpy를 이용한 음화 변환으로 필름 밀도를 측정해 36장의 색감을 일관되게 유지하며, 빈 필름 슬롯을 색감 기준점으로 삼아 자동 색보정을 수행한다. 전체 요약 8문장 읽기 → 096 21:11 당일 +2,909 아티스트를 위한 AI 창작 IDE, ArtCraft 오픈소스 공개 Rust로 만든 ArtCraft는 아티스트, 디자이너, 영화 제작자를 위한 AI 이미지·비디오 창작 도구로, 정확하고 반복 가능한 결과를 위해 프롬프트 기반 생성 대신 시각적 크래프팅을 강조한다. AI · 머신러닝 · storytold/artcraft · Rust
Key Point Rust 오픈소스로 공개되는 전문 창작 도구로, 프롬프트만으로는 어려운 정밀한 구성·반복 가능성·캐릭터 일관성을 필요로 하는 아티스트와 영상 제작자에게 직접적인 영향을 미친다.
핵심 요약
Rust로 만든 ArtCraft는 아티스트, 디자이너, 영화 제작자를 위한 AI 이미지·비디오 창작 도구로, 정확하고 반복 가능한 결과를 위해 프롬프트 기반 생성 대신 시각적 크래프팅을 강조한다. 2D 캔버스 합성, 3D 씬 제작, 캐릭터 포징, 배경 제거, 이미지 투 3D 메시 등 8가지 주요 크래프팅 기능을 제공하여 최종 생성 전에 장면을 사전에 구성할 수 있다. Image to Location 기능으로 일관된 환경에 가상 배우를 배치하고 같은 공간에서 여러 샷을 계획할 수 있으며, 3D 킷배싱과 캐릭터 아이덴티티 전이로 카메라 각도와 객체 배치를 정밀하게 제어한다. 전체 요약 7문장 읽기 → 097 09:11 ▲ 205 · 댓글 113 미 연방 판사, Flock의 무분별한 감시 비판…증거 배제 판결 오클라호마 툴사 지역 연방 판사가 영장 없이 Flock Safety를 사용한 경찰을 위헌 판결했다. 보안 · Federal judge calls Flock 'indiscriminate mass surveillance'
Key Point 자동 번호판 인식 기술의 가장 큰 지지자인 Flock이 처음으로 미 연방법원에서 위헌 판정을 받았으며, 여러 정부 기관이 동시에 사용 중단을 결정하는 정책적 전환점이 벌어지고 있다.
핵심 요약
오클라호마 툴사 지역 연방 판사가 영장 없이 Flock Safety를 사용한 경찰을 위헌 판결했다. 판사는 경찰이 여성의 번호판을 검색할 '명백한 이유'가 없었고, 캘리포니아 면허라는 사실만으로 검색했다고 지적했다. Flock 검색 이후 발견된 메스암페타민 91파운드를 포함한 모든 증거를 '독의 나무의 열매'로 판단해 배제했다. 전체 요약 9문장 읽기 → 098 00:11 ▲ 11 · 댓글 2 월드 모델이 컨텍스트 창 제약을 넘다 스트리밍 월드 모델이 같은 장소를 반복 방문할 때 일관되게 렌더링하려면 두 번의 방문을 모두 담은 학습 샘플이 필요한데, 이는 종종 수분에 걸쳐 있어 전체 구간에 대한 조밀한 어텐션 계산이 이차 비용을 초래한다. AI · 머신러닝 · Memorizon: Training World Models Beyond Their Context Window
Key Point 컨텍스트 윈도우 제약으로 인한 월드 모델의 장기 기억 문제를 검색 기반 메모리 뱅크로 해결하는 기법으로, 계산 효율을 유지하면서 재방문 일관성을 크게 개선한다.
핵심 요약
스트리밍 월드 모델이 같은 장소를 반복 방문할 때 일관되게 렌더링하려면 두 번의 방문을 모두 담은 학습 샘플이 필요한데, 이는 종종 수분에 걸쳐 있어 전체 구간에 대한 조밀한 어텐션 계산이 이차 비용을 초래한다. Memorizon은 이 문제를 해결하기 위해 장기 감독과 어텐션을 분리했다: 긴 시간 폭은 감독에는 필요하지만 어텐션에는 불필요하며, 두 방문이 그 사이의 모든 프레임 없이 순전파를 공유할 수 있다. 학습 샘플은 임의의 길이의 시간 폭을 다루지만 마지막 k개 청크에서만 점수를 매기며, 각 청크는 카메라 공시성(camera co-visibility)으로 상위 K개 잠재변수를 검색한다. 전체 요약 7문장 읽기 → 099 00:11 ▲ 11 · 댓글 2 카메라 재방문 장면 재현하는 스트리밍 비디오 세계모델 LOCI 카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. AI · 머신러닝 · LOCI: Spatial Linear Memory for Streaming World Models
Key Point 비디오 세계모델이 카메라 재방문 시 과거 장면을 정확히 재현하면서도 메모리를 효율적으로 사용하는 구조의 필요성이 커지고 있기 때문이다.
핵심 요약
카메라가 이전에 관찰한 영역을 다시 방문할 때 비디오 세계모델이 그 장면을 정확히 재현해야 하는데, 과거 관찰을 기억하면서도 현재 시점에 맞는 정보를 검색하는 것이 핵심 과제다. 기존 방식의 한계: 키-밸류 캐시는 시각적 세부사항을 잘 보존하지만 비디오 길이가 길어질수록 메모리가 증가하고, 순환 메모리는 메모리 효율적이지만 역사를 고정 크기 상태로 압축해 개별 과거 관찰에 직접 접근 불가능하다. LOCI는 두 표현 방식을 모두 유지하는 하이브리드 공간 메모리 구조로, 트랜스포머 블록의 절반에서는 키-밸류 캐시로 과거 관찰을 유지하고, 나머지 절반에서는 현재 청크에만 제한하면서 순환 선형 주의 메모리를 보완한다. 전체 요약 8문장 읽기 → 100 00:11 ▲ 53 · 댓글 2 로봇 손가락 제어 보상 함수를 테스트 중에 진화시켜 새 작업 수행 휴머노이드 로봇이 학습 과정 없이 테스트 시점에 새로운 작업을 수행하도록 하는 InterEvolve 기법을 제시했다. AI · 머신러닝 · InterEvolve: Test-Time Evolution of Reward Programs for Humanoid Loco-Manipulation
Key Point 재학습 없이 이미 학습된 로봇의 역량을 새로운 작업에 활용하는 방법을 구체적으로 제시해, 실제 로봇 개발에서 배포 후 신속한 작업 확장이 가능해진다.
핵심 요약
휴머노이드 로봇이 학습 과정 없이 테스트 시점에 새로운 작업을 수행하도록 하는 InterEvolve 기법을 제시했다. 핵심은 광범위하게 학습된 컨트롤러가 새 작업에 필요한 역량을 이미 대부분 갖고 있으며, 계획과 제어 사이의 적절한 인터페이스로 그 역량을 접근 가능하게 만드는 것이다. 객체 인식 순전파-역전파 행동 기초 모델(object-aware FB behavioral foundation model)을 개발해 동결된 신체 모델 위에서 객체 잔차를 통해 새로운 보상을 조작 행동으로 변환한다. 전체 요약 8문장 읽기 →