쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
61건 · "VR"조건 지우기 ×
001 21:11 당일 +111 로컬 AI 스튜디오 'Locally Uncensored' 3.0.8 공개 설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. AI · 머신러닝 · PurpleDoubleD/locally-uncensored · TypeScript
Key Point Docker나 터미널 없이 데스크톱에서 채팅·이미지·영상·코딩을 한 앱으로 완전히 로컬에서 실행할 수 있는 통합 환경이 제공되므로, 클라우드 의존성을 피하려는 개발자와 사용자에게 변화를 가져온다.
핵심 요약
설치부터 실행까지 클릭 몇 번으로 진행되는 올인원 로컬 AI 앱으로, 윈도우·리눅스·안드로이드·맥(베타)을 지원하며 Docker나 터미널 없이도 작동한다. 채팅 모드에서 검열을 받지 않은 모델(Abliterated)을 제공하고, ComfyUI 통합으로 이미지·영상 생성, 코딩 에이전트, 음성 대화, 컴퓨터 제어 기능을 한 창에서 사용할 수 있다. 3.0.8에서 웹 검색을 5개 서비스에서 무료로 수행하고, 영상은 백그라운드 렌더링 중에도 채팅 계속 가능하며, 듀얼 그래픽카드 할당으로 채팅과 ComfyUI를 각각 GPU에 할당할 수 있다. 전체 요약 13문장 읽기 → 002 21:11 ▲ 137 · 댓글 88 안드로이드 긴급 통화 중단시키는 악성 SMS 공격 공개 잘못된 WAP Push SMS 한 통으로 안드로이드 전화 앱(com.android.phone)을 크래시시켜 통화 중 상태의 모든 전화(긴급 전화 포함)를 끊을 수 있는 취약점이 공개됐다. 보안 · Zero click, silent, remote Android DoS
Key Point 긴급 전화를 원격으로 영구 차단할 수 있는 취약점이 공개되면서 수억 대의 안드로이드 기기가 노출됐고, 통신사의 자동 차단 정책으로 인해 사용자 과실이 아닌데 기기가 네트워크에서 제외될 수 있다.
핵심 요약
잘못된 WAP Push SMS 한 통으로 안드로이드 전화 앱(com.android.phone)을 크래시시켜 통화 중 상태의 모든 전화(긴급 전화 포함)를 끊을 수 있는 취약점이 공개됐다. 5바이트 uintvar 값 88 80 80 80 00이 0x80000000으로 디코딩되고, 32비트 정수로 캐스팅되면서 -2147483648이 되는데, 이를 바이트 배열 크기로 사용하면서 NegativeArraySizeException을 발생시킨다. 메시지는 데이터 SMS로 전달돼 사용자에게 보이지 않으며, Pixel 9(2026년 4월 펌웨어)와 여러 삼성 갤럭시·A시리즈에서 100% 재현 가능하다. 전체 요약 11문장 읽기 → 003 03:11 ▲ 110 · 댓글 2 30년 전 애플 서버를 맥OS에서 실행하는 기술 1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 하드웨어 · 시스템 · MacOS Extensions Pack for the Apple Network Server v1.0
Key Point 1996년 하드웨어의 OS 호환성을 소프트웨어로 복원하는 역사적 기술 복원 사례로, 레트로 컴퓨팅과 드라이버 개발의 깊이 있는 사례 연구를 제시한다.
핵심 요약
1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 최근 공개된 사전프로덕션 롬(1.1.20.1)은 AIX와 맥OS 양쪽을 모두 부팅할 수 있지만, 사전프로덕션 롬의 맥OS 지원에는 결함이 있었다(온보드 비디오 미지원, MACE 이더넷 작동 안 함, 재부팅 후 검은 화면). 저자는 이러한 문제를 소프트웨어로 수정하여 ANS Extensions Pack v1.0을 개발했으며, MACE 이더넷을 고정하고 온보드 비디오를 활성화하며 맥OS에서 적절히 재부팅하도록 했다. 전체 요약 11문장 읽기 → 004 21:11 ▲ 28 · 댓글 3 증거 연결로 멀티모달 인식 일반화시키는 EvidenceConnect 멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. AI · 머신러닝 · Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
Key Point 멀티모달 모델의 세부 인식과 공간 이해를 동시에 개선하는 데이터 합성 기법이 소개되면서, VLM 학습의 효율성과 일반화 성능을 어떻게 높일 수 있는지 보여준다.
핵심 요약
멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. EvidenceConnect는 한 이미지 내 관련 영역의 줌 뷰를 활용해 시각 증거의 비교·집계·체이닝을 요구하는 학습 데이터를 자동 생성한다. 데이터 품질 보증을 위해 독립적인 VLM들이 합의한 정답만 유지하고, 영역 제거 테스트로 특정 영역 제거해도 답변이 유지되는 문제를 걸러낸다. 전체 요약 6문장 읽기 → 005 03:11 ▲ 123 · 댓글 52 미국 정부효율국 인사, 공식 절차 없이 USAID 권한 행사 2025년 3월 18일 국무장관 루비오가 28세의 제러미 루윈에게 미국국제개발청(USAID)의 권한을 위임했으나, 루윈은 정부 경험 부족으로 비판을 받았다. 스타트업 · 비즈니스 · A 28-Year-Old DOGE Operative Gutted USAID. HR Had No Record of Him Working There
Key Point 미국 정부의 기본 인사 절차를 무시하고 확인되지 않은 인물이 수천 명 규모 기구의 최고 권한을 행사한 사건으로, 민간부문에서는 일어날 수 없는 법적 공백을 드러낸다.
핵심 요약
2025년 3월 18일 국무장관 루비오가 28세의 제러미 루윈에게 미국국제개발청(USAID)의 권한을 위임했으나, 루윈은 정부 경험 부족으로 비판을 받았다. 루윈은 정부효율국(DOGE) 산하 인사로, 1월 28일부터 USAID에 고문으로 근무했다고 주장하지만 공식 기록은 불명확했다. 3월 18일~4월 4일 사이 루윈이 수천 명의 직원 해고와 원조 프로그램 폐지 명령에 서명한 동안, 그는 법적으로 필수인 신입사원 서류(OF-306)를 작성하지 않았다. 전체 요약 10문장 읽기 → 006 21:11 ▲ 16 · 댓글 2 다중모달 추론 모델, 공개 데이터로 효율적 학습 방법 제시 멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. AI · 머신러닝 · MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
Key Point 멀티모달 추론 모델의 공개 학습 레시피가 상용 대규모 모델 대비 효율성과 성능을 동시에 달성하는 구체적 방법을 보여주므로, 오픈소스 멀티모달 AI 개발에 실질적 기준을 제시한다.
핵심 요약
멀티모달 추론 모델 학습의 병목인 데이터 품질 저하, 비효율적 감독 구성, 난이도 불균형, 도메인 간 간섭을 해결하기 위해 MMVistaReason(MVR)을 제안했다. 분석적 추론과 실제 추론으로 나눈 광범위한 학습 데이터로 구조적 추론과 시각 지각·공간 이해를 모두 커버한다. 구조화된 정제와 주석, 난이도 인식 증류, 답변 확률 기반 궤적 선택으로 SFT용 52.8만 개 샘플(MVR-SFT-528K)과 RL용 6.3만 개 샘플(MVR-RL-63K)을 효율적으로 구성했다. 전체 요약 9문장 읽기 → 007 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 008 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 009 03:12 ▲ 296 · 댓글 38 추론 모델을 직접 구현하는 11시간 강의 공개 Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. AI · 머신러닝 · Sebastian Raschka's from-scratch video course on building reasoning models
Key Point 추론 모델 구현의 핵심 기법들(강화학습, 추론 시점 스케일링, 증류)을 직접 코딩하면서 배울 수 있는 완전한 실습 자료가 공개되어, LLM 개발자가 최신 추론 기술의 동작 원리를 깊이 있게 이해할 수 있다.
핵심 요약
Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. Python과 PyTorch로 평가, 추론 시점 스케일링, 강화학습, 증류를 처음부터 끝까지 구현한다. 사전학습된 Qwen 0.6B 모델을 출발점으로, KV 캐싱, 다양한 텍스트 생성, 답 검증기 구축 등을 단계별로 다룬다. 전체 요약 8문장 읽기 → 010 03:11 ▲ 31 · 댓글 2 자연어로 영화같은 카메라 움직임을 3D 환경에서 자동 생성 FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography
Key Point 자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다. Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다. 전체 요약 6문장 읽기 → 011 00:11 ▲ 115 · 댓글 55 음정 벗어난 부분을 실시간으로 잡아주는 싱잉 트레이너 OnKey Spotify, Apple Music, YouTube 음악에 맞춰 부르면서 음정을 교정할 수 있는 Mac용 무료 오픈소스 싱잉 트레이너 OnKey를 개발자가 공개했다. 오픈소스 · 도구 · Show HN: OnKey – I'm a bad singer, so I built an app to show where I'm off-key
Key Point 음정 교정 기능이 필수적인 가창력 향상 앱이 오픈소스로 공개되어 모든 개발자가 활용·개선할 수 있게 되었고, 로컬 처리와 엄격한 프라이버시 정책은 유사 앱과의 차별점이다.
핵심 요약
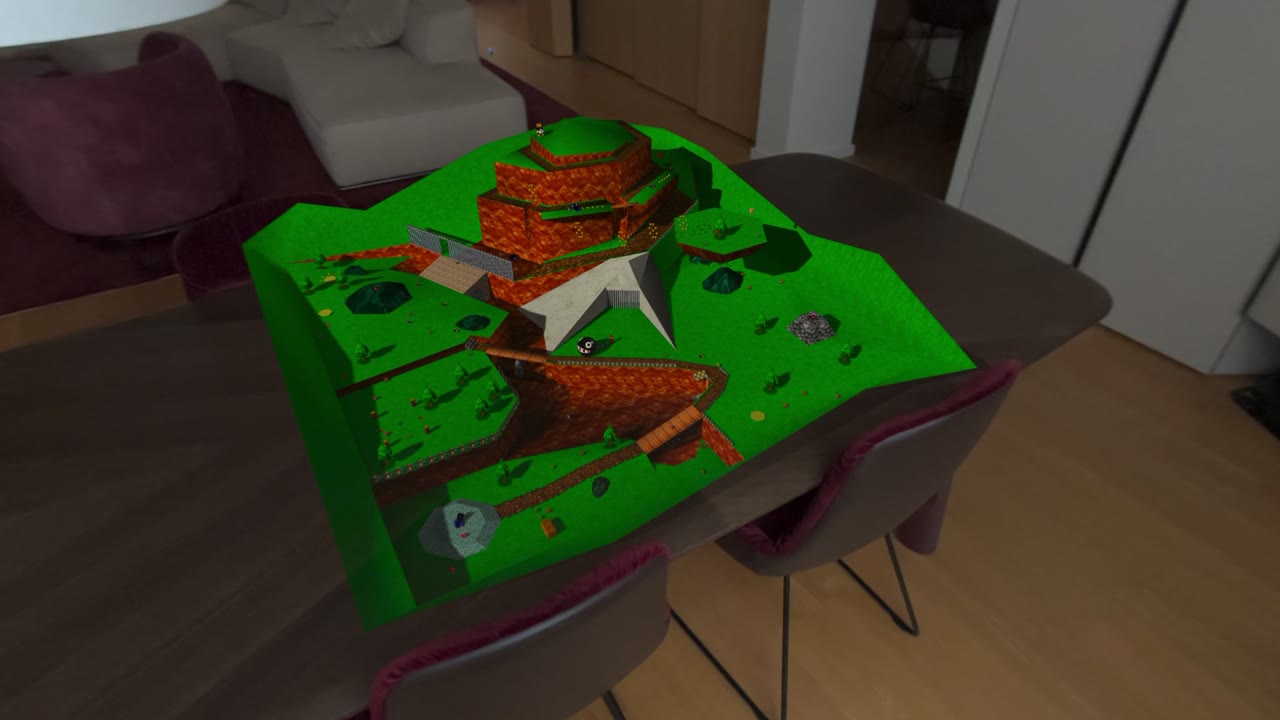
Spotify, Apple Music, YouTube 음악에 맞춰 부르면서 음정을 교정할 수 있는 Mac용 무료 오픈소스 싱잉 트레이너 OnKey를 개발자가 공개했다. 첫 재생 때는 가사를 제공하며 노래의 멜로디를 학습하고, 이후 재생부터는 음표가 스크롤로 내려오고 사용자의 음정이 실시간으로 표시되며 각 라인별 점수를 받는다. Apple Silicon(M1 이상) 맥과 macOS 14.2 이상이 필요하며, 마이크 및 시스템 음성 녹음 권한이 필요하다. 전체 요약 8문장 읽기 → 012 03:11 ▲ 154 · 댓글 58 슈퍼마리오 64, 애플 비전 프로의 입체 모형으로 부활 슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 하드웨어 · 시스템 · Way to Play Super Mario 64: On Apple Vision Pro
Key Point 클래식 게임의 현대적 재해석과 저작권 정책의 대비: 커뮤니티 창작물이 기술적으로 얼마나 진화했는지, 그리고 업체별 대응이 얼마나 다른지 보여준다.
핵심 요약
슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 사용자가 카메라 역할을 하므로 모형에 가까이 다가가 자세히 보거나 마리오를 여러 각도에서 관찰할 수 있으며, 타이틀 화면에서 손가락으로 마리오의 얼굴을 직접 움직일 수 있다. 이 프로젝트는 SM64 역공학 프로젝트와 sm64coopdx 게임 코드, SM64 Reloaded와 Render96의 고해상도 텍스처, Render96 모델과 SwagSkeleton95 교체 모델 등 여러 기존 오픈소스 프로젝트를 기반으로 구축되었다. 전체 요약 4문장 읽기 → 013 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 014 03:11 ▲ 100 · 댓글 26 Broadcom WiFi 칩 16년 방치된 보안 결함, 수백만 개 라우터 위험 Broadcom 802.11 구현에 2010년부터 존재해온 파서 취약점이 WPS(WiFi Protected Setup) 프로토콜 처리 중 EAP 재조립 오버플로우를 일으킨다. 보안 · One parser, two bugs, many routers: Exploiting Broadcom WiFi across eCos, Linux
Key Point 2010년부터 방치된 결함이 수백만 대의 실제 운영 중인 라우터를 원격에서 제어 가능하게 하고 있으며, 제조사의 CVE 거부로 여전히 패치되지 않은 상태에서 공개되고 있다.
핵심 요약
Broadcom 802.11 구현에 2010년부터 존재해온 파서 취약점이 WPS(WiFi Protected Setup) 프로토콜 처리 중 EAP 재조립 오버플로우를 일으킨다. eCos 기반 플랫폼(BCM3380, BCM3383, BCM33834)에서는 영구적 제로데이이며, Linux 플랫폼(BCM3390, BCM63xx, BCM65xx, BCM68xx)에서도 제조사가 업데이트하지 않으면 같은 상태다. 2018년 불완전한 패치가 나왔고 취약한 컴포넌트를 hostapd로 교체한 새 SDK 버전이 출시됐지만, 많은 OEM이 마이그레이션하지 않았다. 전체 요약 12문장 읽기 → 015 18:11 ▲ 19 · 댓글 2 비디오 분할에 시각적 추론 체인 더하다 비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. AI · 머신러닝 · Think Visually Across Space and Time: Grounded Reasoning for Video Segmentation
Key Point 비디오 분할에서 텍스트 추론과 시각적 증거의 연결 고리를 명시적으로 만듦으로써 모델의 판단 근거를 추적 가능하게 한 새로운 접근 방식이다.
핵심 요약
비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. 기존 텍스트 기반 사고 연쇄(CoT)는 선택 이유를 설명하지만 시각적 근거를 명시하지 않아, 언어 추론과 프레임에 분산된 증거 사이에 갭이 생긴다. 연구팀은 시공간 근거를 갖춘 Temporal Chain of Video Primitives(TCoVP)를 제안했다. 전체 요약 9문장 읽기 → 016 21:10 당일 +441 비디오의 모자이크를 자동으로 복원하는 Jasna 비디오와 이미지의 모자이크 처리된 부분을 자동으로 찾아 복원하는 무료 도구다. 오픈소스 · 도구 · Kruk2/jasna · Python
Key Point 모자이크 처리된 콘텐츠를 자동 복원하는 도구로, GPU 가속을 활용한 빠른 처리와 선택적 복원 기능이 기술적으로 흥미로운 구현을 보여준다.
핵심 요약
비디오와 이미지의 모자이크 처리된 부분을 자동으로 찾아 복원하는 무료 도구다. 무료 모델인 BasicVSR++와 유료 지원자 모델인 LTX 두 가지 복원 모델을 제공한다. 선택한 부분만 복원할 수 있는 Segment Editor와 복원된 영상을 실시간으로 볼 수 있는 Video Player를 갖춘 간단한 앱과 커맨드라인 인터페이스를 제공한다. 전체 요약 10문장 읽기 → 017 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 018 15:11 ▲ 32 · 댓글 1 INT4 양자화로 강화학습 롤아웃 1.8배 빠르게 비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. AI · 머신러닝 · KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization
Key Point 강화학습 훈련에서 KV 캐시 양자화로 하드웨어 메모리 사용량을 크게 줄이면서도 정확도 손실을 거의 없는 방법이 나왔기 때문에, 리소스 제약이 있는 환경에서의 LLM 훈련 효율을 크게 개선할 수 있다.
핵심 요약
비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다. 가중치 전용·가중치-활성화 양자화보다 KV 캐시 양자화가 훨씬 더 큰 가속 효과를 주지만, INT4 양자화만으로는 토큰 단위 절단된 중요도 샘플링(TIS)을 써도 학습이 악화될 수 있다. KV4-RL은 보정 없는 INT4 KV 양자화에 어텐션 싱크와 최근 문맥의 일부 위치만 INT8로 보호해 샘플러 오정렬을 줄이면서도 대부분의 속도 이득을 유지한다. 전체 요약 5문장 읽기 → 019 18:11 ▲ 29 · 댓글 2 언어 모델 자가증류, 체계적 프롬프트로 추론 질 높인다 대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. AI · 머신러닝 · Self-Distillation with Verbal Regularization
Key Point 언어모델 학습에서 교사-학생 구조의 편향 문제를 프롬프트 엔지니어링으로 해결하는 실질적인 방법론으로, 추론 성능을 높이면서도 모델의 탐색성을 보존하는 기술입니다.
핵심 요약
대규모 언어모델을 학습할 때 같은 모델의 교사 버전으로부터 지도를 받는 자가증류(OPSD) 방식이 있습니다. 교사는 정답 같은 특권정보(PI)를 조건으로 받지만, 학생은 이를 보지 못한 채 교사의 토큰 분포로부터 학습합니다. 하지만 특권정보는 깊은 검증 없이 지름길 추론으로 편향되는 문제가 생기며, 출력 분포의 엔트로피가 급격히 떨어집니다. 전체 요약 8문장 읽기 → 020 15:11 ▲ 27 · 댓글 1 멀티턴 에이전트 학습의 진행도 신호, DeltaTTG 제안 강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. AI · 머신러닝 · DeltaTTG: Training Multi-Turn Agents with a Token-to-Go Progress Meter
Key Point 기존 멀티턴 에이전트 강화학습에서 각 단계의 가치를 판단하는 방식의 비용 문제를 해결하는 새로운 접근으로, 실제 성능 향상을 실증한 방법입니다.
핵심 요약
강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다. 기존 방식은 상태 매칭의 신뢰성 확보나 외부 평가자·인간 주석·작업별 휴리스틱이 필요해 비용이 많이 들기 때문입니다. DeltaTTG는 다양한 정책의 궤적 기록으로부터 저비용 감독 신호를 얻어 재사용 가능한 진행도 신호를 학습합니다. 전체 요약 8문장 읽기 → 021 12:11 ▲ 55 · 댓글 3 AR·VR용 입체 음성 생성, 화면 움직임과 동기화 기존 영상-음성 생성 모델은 의미 대응과 시간 동기화는 잘했지만, AR/VR·인터랙티브 게임에 필요한 입체 음성 생성은 미흡했다. AI · 머신러닝 · Hear the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation
Key Point AR·VR과 게임 등 몰입형 미디어에서 필수인 입체 음성을 화면 움직임과 동기화하는 기술 공백을 처음 정의하고 해결했으며, 평가 기준도 함께 제시했다.
핵심 요약
기존 영상-음성 생성 모델은 의미 대응과 시간 동기화는 잘했지만, AR/VR·인터랙티브 게임에 필요한 입체 음성 생성은 미흡했다. 입체 음성은 음원이 인지되는 방향이 화면 속 음원의 움직임과 일치해야 하는데, 이를 '동적 공간 대응'이라고 정의했다. StereoBind는 모션 트랙을 활용해 시각적 움직임과 입체 음성을 연계하는 프레임워크로, 시각 움직임 바인딩·공간 트랙 인코더·상대 움직임 모델링 세 가지 메커니즘을 사용한다. 전체 요약 5문장 읽기 → 022 12:11 ▲ 12 · 댓글 2 강화학습의 그래디언트 기아 현상 해결하는 ReSPO 논문 검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다. AI · 머신러닝 · ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning
Key Point 강화학습 모델 훈련에서 정책 최적화 과정의 근본적인 문제를 진단하고 이를 해결하는 새로운 알고리즘을 제시하여, 특히 데이터 재사용 효율성이 중요한 LLM 훈련에 직접 적용될 수 있기 때문이다.
핵심 요약
검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다. 기존 클리핑 기반 정책 최적화에서 '부호 의존 그래디언트 기아' 문제가 발생하는데, 이는 클리핑이 저중요도 가중치 영역의 미생성 긍정 응답을 억제하면서 동시에 고중요도 영역의 과도 생성 부정 응답이 지배하게 되는 현상이다. 연구팀은 ReSPO(Reshaped Sequence Policy Optimization)를 제안하는데, α-발산 변분 목적함수와 지수 분산 제어 틸트에서 파생된 부드러운 이중 분기 시퀀스 레벨 커널로 클리핑을 대체한다. 전체 요약 6문장 읽기 → 023 21:11 당일 +167 LG webOS TV용 고속 Plex 클라이언트 PlxNative 공개 Rust로 작성된 비공식 Plex 클라이언트 PlxNative는 LG webOS TV에서 기본 UI를 GPU에 직접 렌더링해 60fps로 구동하며 Chromium이나 WebView 없이 동작한다. 오픈소스 · 도구 · GLinnik21/plx-native · Rust
Key Point 공식 Plex 앱의 성능 문제를 근본적으로 다른 접근으로 해결한 네이티브 클라이언트로, LG webOS TV 사용자가 60fps 부드러운 UI와 고품질 비디오 재생을 얻을 수 있게 한다.
핵심 요약
Rust로 작성된 비공식 Plex 클라이언트 PlxNative는 LG webOS TV에서 기본 UI를 GPU에 직접 렌더링해 60fps로 구동하며 Chromium이나 WebView 없이 동작한다. 공식 Plex 앱이 웹 앱 방식으로 느린 문제를 해결하기 위해 만들어졌으며, 브라우저 대신 네이티브로 그려지고 비디오는 TV 자체 디코더를 사용한다. webOS 4.0 이상에서 지원하며 일부 2016년형 webOS 3.4.3 TV에서도 작동하는 것으로 확인됐다. 전체 요약 12문장 읽기 → 024 12:11 ▲ 140 · 댓글 2 완료된 경험으로 예측력 높이는 AI 학습법 제시 강화학습에서 보상이 없거나 희소할 때 에이전트가 학습 신호를 얻기 어려운 문제를 다룬 논문이다. AI · 머신러닝 · Self-Retrospection Distillation: Turning Post-hoc Experiences into Prior Foresight
Key Point 보상 신호가 부족한 강화학습 상황에서 과거 경험으로 예측력을 높이는 새로운 접근법은 장기 작업 에이전트와 추론 기반 AI 개발에 직결되는 개선 기법이다.
핵심 요약
강화학습에서 보상이 없거나 희소할 때 에이전트가 학습 신호를 얻기 어려운 문제를 다룬 논문이다. 기존 RLVR(검증 가능 보상 강화학습) 방식은 스칼라 보상만으로 신호를 만들어 그룹 상대 목표에서 모든 시도가 같은 보상받으면 실패한다. 저자는 "Self-Retrospection Distillation(SRD)" 기법을 제안해 이미 완료된 궤적(trajectory)의 정보를 사전 예측 학습에 활용한다. 전체 요약 8문장 읽기 → 025 18:30 ▲ 12 · 댓글 2 LLM 추론 학습에 근거 정보를 선택적으로 활용하기 정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다. AI · 머신러닝 · Rationale-Guided Policy Optimization: Learning to Reason with Adaptive Rationale Scaffolding
Key Point LLM을 정책 강화학습으로 훈련할 때 나타나는 보상 희소성 문제를 근거 정보로 해결하는 새로운 접근법으로, 추론 능력 향상에 실질적 효과를 보인다.
핵심 요약
정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다. 기존 방식은 오프폴리시 데이터나 전문가 궤적, 모델 생성 솔루션을 보조 정보로 사용하지만, 이들이 강화학습 작업 형식과 일치해야 하며 보통 더 강한 모델에서 거부 샘플링으로 학습 자료를 얻어야 한다. RGPO(Rationale-Guided Policy Optimization)는 모델의 현재 능력에 맞춰 정답 근거(rationale) 정보를 적응적으로 활용하되 탐색의 자유도를 보존하는 프레임워크다. 전체 요약 6문장 읽기 → 026 18:30 ▲ 15 · 댓글 2 실패한 추론에만 교사 신호 적용, 코드·수학 성능 향상 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
Key Point 기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다. 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다. 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다. 전체 요약 9문장 읽기 → 027 18:30 ▲ 37 · 댓글 1 LLM 추론 안정성 높이는 새 학습 기법 제안 대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. AI · 머신러닝 · Semifactual Credit-Augmented Policy Optimization
Key Point 토큰 수준의 미세한 신용 할당으로 LLM 추론 정확도를 5~6% 개선하는 새로운 학습 기법으로, 프롬프트 표현에 과민한 모델의 근본적 문제를 다룬다.
핵심 요약
대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다. 연구팀은 답을 유지하면서 프롬프트만 변경하는 반사실적 개입으로 이를 분석했고, 토큰 수준에서 큰 민감도 편차가 있으며 불안정한 토큰을 디코딩 중에 억제하면 모델 가중치를 업데이트하지 않아도 추론 정확도가 높아짐을 발견했다. 기존의 그룹상대정책최적화(GRPO)는 모든 응답 토큰에 동일한 이점을 할당하여 추론과 무관한 특성 의존성까지 강화할 수 있다는 한계가 있다. 전체 요약 7문장 읽기 → 028 18:30 ▲ 195 · 댓글 104 PSP 게임을 웹어셈블리로 변환해 브라우저에서 실행 PSP 게임의 MIPS 머신 코드를 사전에 C++로 변환한 후 웹어셈블리로 컴파일하고, PSP 운영체제와 그래픽 칩을 웹GL2로 구현한 환경에서 브라우저에서 실행하는 기술이다. 웹 · 프론트엔드 · God of War on PSP, recompiled to WebAssembly and running in the browser
Key Point PSP 게임을 에뮬레이터 없이 브라우저에서 실행 가능하게 하는 재컴파일 기술의 구현 방식과 최적화 과정을 보여주며, 향후 다양한 레트로 게임의 웹 이식 가능성을 시사한다.
핵심 요약
PSP 게임의 MIPS 머신 코드를 사전에 C++로 변환한 후 웹어셈블리로 컴파일하고, PSP 운영체제와 그래픽 칩을 웹GL2로 구현한 환경에서 브라우저에서 실행하는 기술이다. 첫 번째 타이틀 '갓 오브 워: 체인 오브 올림푸스'는 부팅부터 메뉴, 컷신, 전투까지 노트북에서 Chrome과 Firefox로 초당 60프레임으로 구동되며, PSP 해상도의 최대 4배인 1440×816에서 실행되고 휴대폰 터치 제어도 지원한다. 음악, 음성, 효과음은 작동하며 영화는 현재 스킵된다. 전체 요약 16문장 읽기 → 029 00:11 ▲ 166 · 댓글 69 125억 개 파라미터 모델을 RTX 4090으로 초당 100토큰 속도로 실행 Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. AI · 머신러닝 · Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s
Key Point 소비자용 그래픽카드만으로 클라우드 서버 수준의 대규모 언어모델을 로컬에서 무료로 실행 가능해졌기 때문에, 개인 개발자와 중소 회사의 AI 접근 장벽이 크게 낮아진다.
핵심 요약
Strata는 일반 게이밍 PC에서 125억 파라미터의 대규모 AI 모델 Qwen3.8-Flash-Next를 실행할 수 있게 해주는 오픈소스 소프트웨어다. RTX 5070(12GB)과 Ryzen 5 7600 조합에서 Q2_0 압축 모델 기준으로 초당 94토큰의 답변 생성 속도(32KB 문서 읽기 초당 2,650토큰)를 달성한다. RTX 3090(24GB) 같은 더 많은 VRAM을 가진 카드는 초당 100~140토큰 속도까지 낼 수 있다. 전체 요약 12문장 읽기 → 030 21:11 당일 +152 언어 모델 검열 자동 제거 도구 Heretic 공개 GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. AI · 머신러닝 · p-e-w/heretic · Python
Key Point 안전 필터를 우회하는 완전 자동화 도구의 등장으로, 모델 수정 기술의 접근성이 크게 낮아졌으며 이로 인한 악용 가능성 증가와 기술 민주화 사이의 균형 문제가 제기된다.
핵심 요약
GitHub에 공개된 Heretic은 방향성 절제(directional ablation)와 Optuna 기반 매개변수 최적화를 결합해 언어 모델의 안전 정렬을 자동으로 제거하는 Python 도구다. 사용자가 명령줄 명령만으로 모델을 처리할 수 있으며, 트랜스포머 구조 이해가 필요 없다. Gemma-3-12B-IT 기준으로 Heretic이 생성한 모델은 유해 프롬프트 거부율 3/100, KL 발산 0.16으로, 수동 절제 모델(KL 발산 0.45~1.04)보다 원래 성능을 더 잘 보존했다. 전체 요약 9문장 읽기 → 031 18:11 ▲ 113 · 댓글 44 AI가 레고 모델을 설계하는 오픈소스 도구 'ldraw-nova' 공개 AI 에이전트에 모델 아이디어를 주면 LDraw 언어로 작성된 실제 레고 모델 소스코드를 생성하는 오픈소스 도구 'ldraw-nova'를 개발자가 공개했다. AI · 머신러닝 · Show HN: Made an open-source Lego AI generator
Key Point LLM이 복잡한 기하학 계산이 필요한 3D CAD 형식을 직접 생성하는 대신 파이썬 코드로 변환하면 성공률이 높아지는 새로운 접근법을 보여주며, AI로 만들 수 있는 창의적 결과물의 범위를 확장한다.
핵심 요약
AI 에이전트에 모델 아이디어를 주면 LDraw 언어로 작성된 실제 레고 모델 소스코드를 생성하는 오픈소스 도구 'ldraw-nova'를 개발자가 공개했다. 생성된 결과물은 3D 뷰어, VR(Meta Quest 3), Blender 편집 가능한 glTF 파일, 채팅 기록, AI의 추론 과정 등 다양한 형식으로 제공된다. AI 에이전트는 먼저 지침을 읽고 필요한 부품과 서브모델을 계획한 후, 반복적으로 렌더링하며 위치와 미관을 조정해 모델을 완성한다. 전체 요약 7문장 읽기 → 032 09:11 ▲ 54 · 댓글 2 에이전트 학습 효율 높이는 'X-Tree' 알고리즘 개발 멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. AI · 머신러닝 · X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization
Key Point 에이전트가 재사용 가능한 스킬을 가중치로 학습하면서 새로운 작업으로의 일반화 성능이 크게 향상되는 방식을 제시해, 멀티스텝 의사결정이 필요한 AI 시스템 개발에 실질적 개선을 가져온다.
핵심 요약
멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다. 최근 에이전트들은 LLM이 문맥으로 작성한 스킬만 활용해 가중치에 반영되지 않아 새 상황에 일반화하지 못했다. 연구팀은 X-Tree(reusable eXperience tree) 기법으로 학습 데이터에서 계층 구조를 자동으로 복원했다. 전체 요약 9문장 읽기 → 033 03:11 ▲ 175 · 댓글 3 온정책 vs 비정책 학습, 체계적 실험으로 재평가 온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다. AI · 머신러닝 · On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
Key Point 강화학습 기반 모델 최적화에서 온정책 학습의 필요성이 통념으로 여겨졌지만, 체계적인 실험을 통해 그 가정을 재검토한 논문으로 실무 선택에 직결되는 통찰을 제시한다.
핵심 요약
온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다. 연구팀은 강한 모델을 약한 모델로 증류하는 통제된 실험에서 온정책 정책, KL 방향, 학습률을 독립적으로 변경하며 Llama3과 Qwen2.5에서 과학·의료·산술 추론 과제를 실시했다. 분석 결과 온정책 정책이 중심 역할을 하지 않는 것으로 드러났다. 전체 요약 8문장 읽기 → 034 09:11 ▲ 139 · 댓글 108 생성 AI가 웹 개발 교육의 생태계를 무너뜨리고 있다 웹 개발 교육자들과 기술 저자들이 생성 AI로 인해 일괄적으로 수입이 사라지거나 급감했다고 보고하고 있다. AI · 머신러닝 · The death of web development education
Key Point 생성 AI 기업들이 수백만 명의 교육자 콘텐츠를 무단 학습하면서 그들의 경제적 기반을 완전히 제거했고, 이는 웹 개발의 다음 세대를 양성할 교육 인프라 전체를 위협하고 있다.
핵심 요약
웹 개발 교육자들과 기술 저자들이 생성 AI로 인해 일괄적으로 수입이 사라지거나 급감했다고 보고하고 있다. TypeScript 전문가 Axel Rauschmayer는 2024년 책 판매로 생계를 유지했으나 2026년 수입이 0이 되었고, 블로그 트래픽 대부분이 AI 크롤러에서 나와 광고 수익이 없어져 블로그를 내렸다. 개발자 관계(DevRel) 경력자 Salma Alam-Naylor는 AI가 개발자 커뮤니티를 파괴했다고 지적하며, 개발자들이 인간의 협업 대신 챗봇에 의존하게 되고 교육자의 콘텐츠가 AI에 의해 무단으로 학습되고 재사용된다고 했다. 전체 요약 9문장 읽기 → 035 06:11 ▲ 122 · 댓글 20 ESP32 칩에서 숨겨진 SDR 기능 발견, 무선 신호 수신 가능 ESPARGOS 프로젝트가 ESP32 칩에 문서화되지 않은 기능을 발견했으며, 이를 통해 WiFi와 Bluetooth 기능을 우회해 원본 IQ 베이스밴드 샘플을 캡처할 수 있다. 하드웨어 · 시스템 · Various Projects Find Hidden SDR Capabilities in ESP32 Microcontrollers
Key Point ESP32가 광범위 무선신호 수신에 사용될 수 있다는 발견으로, 저비용 SDR 활용의 새로운 가능성을 열었고 이미 여러 프로젝트가 실제 구현을 진행 중이다.
핵심 요약
ESPARGOS 프로젝트가 ESP32 칩에 문서화되지 않은 기능을 발견했으며, 이를 통해 WiFi와 Bluetooth 기능을 우회해 원본 IQ 베이스밴드 샘플을 캡처할 수 있다. 여러 ESP32 모델은 2.2~2.7 GHz 및 ESP32-C5에서는 4.8~6.0 GHz 대역을 커버하는 내부 SDR로 사용 가능하며 최대 80 MS/s 샘플링 속도와 13~54 MHz 아날로그 대역폭을 제공한다. 일반적인 PC 연결 SDR로는 출력 대역폭이 부족해 스냅샷만 PC로 내보낼 수 있으므로 스펙트럼 분석기로만 동작하며, 지속적인 라디오 데이터 복조나 디코딩은 불가능하다. 전체 요약 10문장 읽기 → 036 03:11 ▲ 209 · 댓글 2 멀티모달 AI의 숨은 추론 과정, 시각 증거로 감시한다 멀티모달 대형언어모델(MLLM)이 추론 과정을 숨겨진 토큰(latent token)으로 수행하는 방식(LVR)이 확산되고 있지만, 이 과정을 직접 관찰할 수 없어 학습을 감독하기 어렵다. AI · 머신러닝 · Rethinking Latent Visual Reasoning: Grounding Latent Reasoning in Visual Evidence
Key Point 멀티모달 AI가 추론하는 과정을 들여다보고 통제하는 방법이 나왔으며, 초대형 모델까지 확장 가능함을 증명했기 때문이다.
핵심 요약
멀티모달 대형언어모델(MLLM)이 추론 과정을 숨겨진 토큰(latent token)으로 수행하는 방식(LVR)이 확산되고 있지만, 이 과정을 직접 관찰할 수 없어 학습을 감독하기 어렵다. 연구팀이 토큰 동작을 분석한 결과, 이미지 변형으로 정답이 바뀌어도 토큰이 약한 반응만 보이는 '증거-신용 격차(evidence-credit gap)' 문제를 발견했다. GRPO 훈련 중 명시적 감독이 부족해서 생기는 문제로, 최종 답변에 대한 보상만으로는 어떤 시각 정보를 보존할지, 신용을 어떻게 배치할지 제대로 지도할 수 없음을 보여주었다. 전체 요약 8문장 읽기 → 037 00:11 새 버전 Rust 1.99.0 공개, C-가변함수 안정화 Rust 1.99.0이 릴리스되었으며, C-가변함수 정의와 #[unsafe(naked)] 함수 기능이 안정화되었다. 오픈소스 · 도구 · rust-lang/rust@1.99.0
Key Point C-가변함수 안정화로 FFI 작업이 더 안전해지고, 다수의 라이브러리 API 안정화로 표준 라이브러리 사용성이 개선되며, Rustdoc 성능 최적화가 대규모 프로젝트의 빌드 속도에 영향을 줍니다.
핵심 요약
Rust 1.99.0이 릴리스되었으며, C-가변함수 정의와 #[unsafe(naked)] 함수 기능이 안정화되었다. 언어 차원에서 raw_borrows_via_references 린트 추가, unconditional_panic 린트 확장, #[my_macro] mod foo; 구문 안정화 등이 진행되었다. 컴파일러는 AVR/AMDGCN/NVPTX에서 -Ctarget-cpu를 target-modifier로 변환하고, doc alias 속성이 메서드 제안 시 유사성 검색보다 우선하도록 개선했다. 전체 요약 9문장 읽기 → 038 21:11 당일 +101 ShellCrash: 셸 환경에서 mihomo/sing-box 관리 도구 Linux 커널 기반 라우터·서버·도커 등에서 mihomo/sing-box 프록시 커널을 설치하고 관리하는 셸 스크립트 도구다. 오픈소스 · 도구 · juewuy/ShellCrash · Shell
Key Point Linux 기기에서 네트워크 프록시를 손쉽게 구성하려는 개발자·시스템 관리자가 알아야 할 오픈소스 도구로, 여러 커널 지원과 웹 UI 통합으로 복잡한 설정을 단순화한다.
핵심 요약
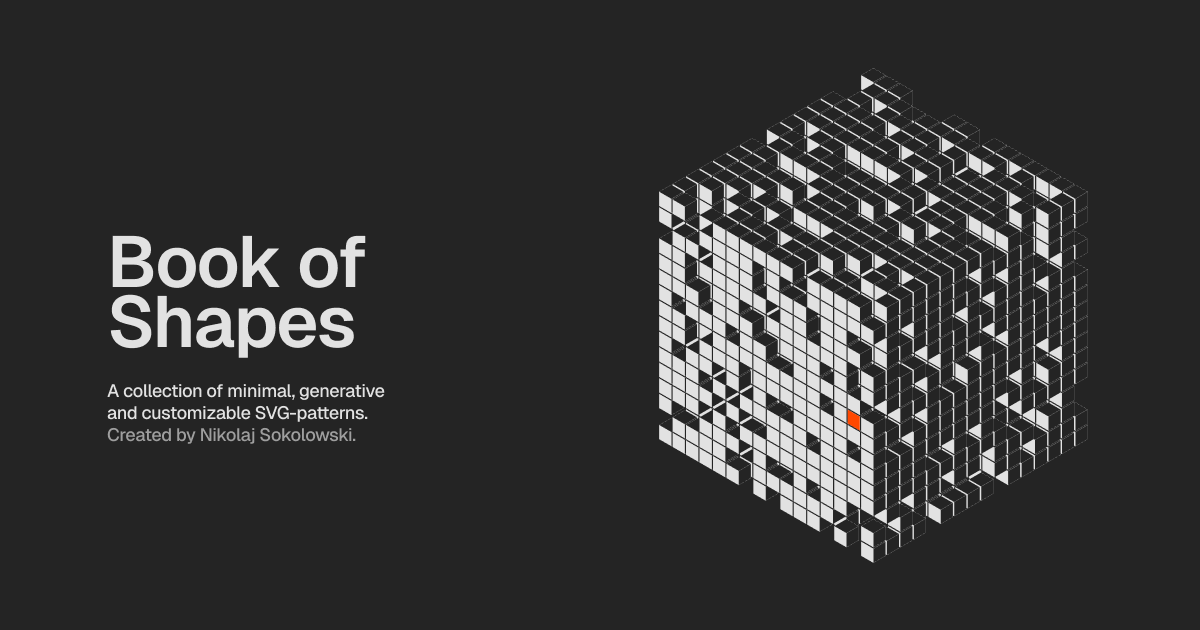
Linux 커널 기반 라우터·서버·도커 등에서 mihomo/sing-box 프록시 커널을 설치하고 관리하는 셸 스크립트 도구다. mihomo와 sing-box를 하나의 인터페이스에서 전환하며 사용할 수 있고, 구독 링크와 설정 파일의 온라인 가져오기를 지원한다. Router 모드와 Local 모드 등 여러 트래픽 포워딩 모드 전환과 자동 업데이트 스케줄 설정이 가능하다. 전체 요약 9문장 읽기 → 039 21:11 ▲ 103 · 댓글 7 손으로 만드는 SVG 패턴, Book of Shapes 공개 Nikolaj Sokolowski가 만든 Book of Shapes는 최소주의적이고 생성형이며 커스터마이징 가능한 SVG 패턴 모음이다. 웹 · 프론트엔드 · Book of Shapes – Collection of minimal, generative and customizable SVG-patterns
Key Point 웹 디자이너와 개발자가 즉시 가져다 쓸 수 있는 프로덕션 레디 SVG 패턴 라이브러리로, 배경·질감·장식용 그래픽이 필요할 때 빠르게 활용할 수 있다.
핵심 요약
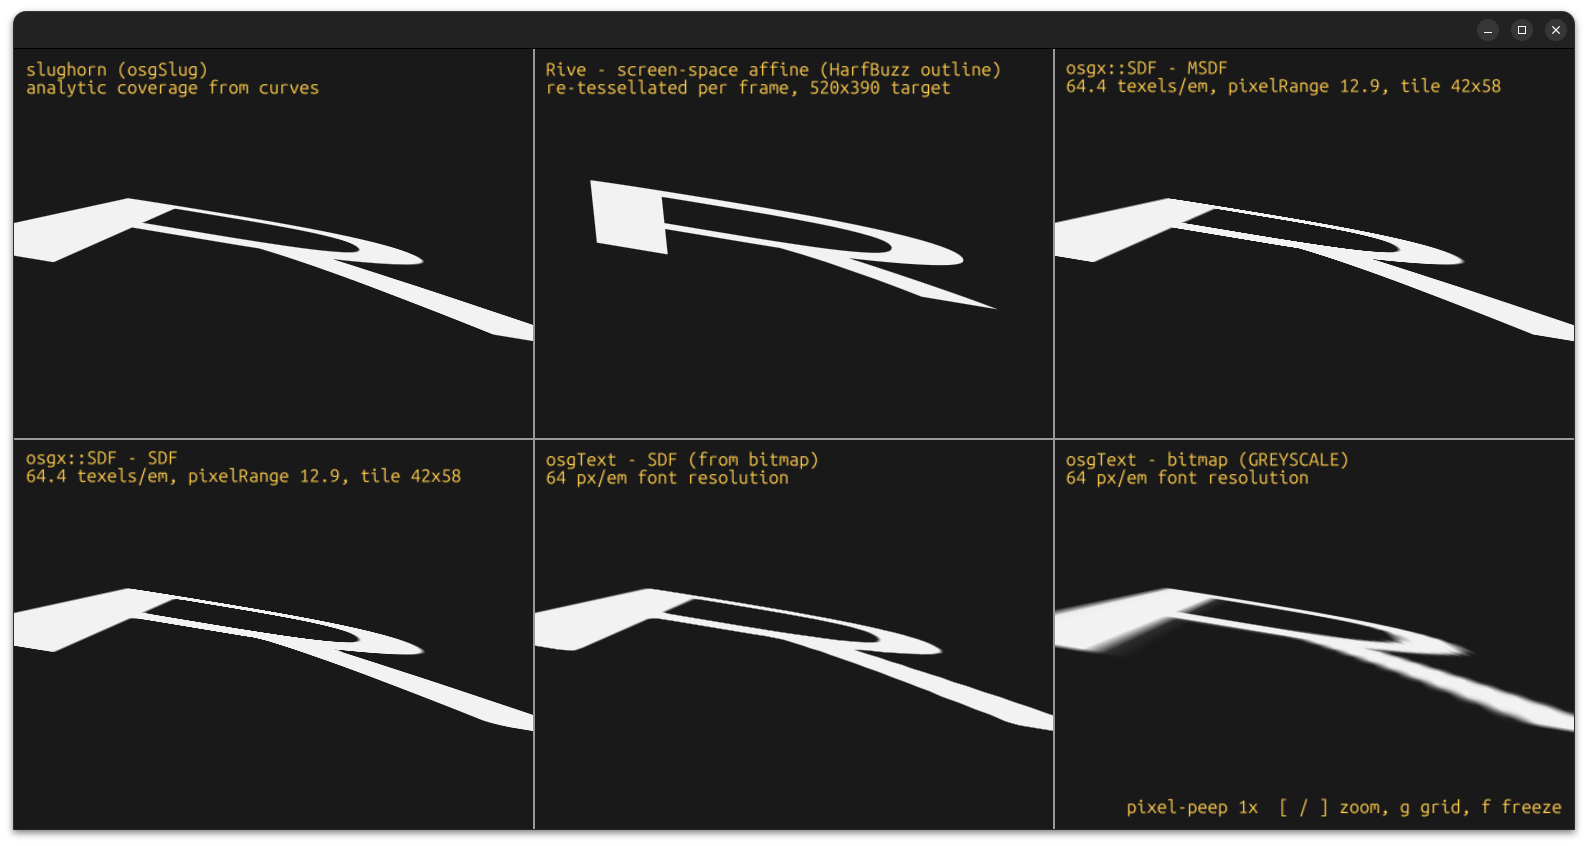
Nikolaj Sokolowski가 만든 Book of Shapes는 최소주의적이고 생성형이며 커스터마이징 가능한 SVG 패턴 모음이다. 그리드, 래디얼, 노이즈, 플로우, 아이소메트릭, 유기형, 왜곡, 물리 시뮬레이션 등 8가지 카테고리로 분류되어 있다. 각 카테고리별로 수십 개의 개별 패턴을 제공한다: 그리드 22개, 래디얼 18개, 노이즈 18개, 플로우 17개, 아이소메트릭 13개, 유기형 9개, 왜곡 8개, 물리 5개. 전체 요약 5문장 읽기 → 040 06:11 ▲ 114 · 댓글 47 GPU 텍스트 렌더링 5가지 기법 비교: Slug 특허 공개와 함께 GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 웹 · 프론트엔드 · SDF vs. MSDF vs. Slug: GPU Text Rendering
Key Point 2026년 Slug 특허가 공개 도메인으로 해방되면서 고사양 3D·AR 환경의 텍스트 렌더링 기술이 개방되었으며, 각 기법의 정확한 트레이드오프를 이해하면 게임, 시뮬레이션, 데이터 시각화 프로젝트에서 최적의 방식을 선택할 수 있다.
핵심 요약
GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 가장 오래된 텍스처 아틀라스 방식은 글자를 고정 크기로 미리 렌더링해 저장하므로, 확대하면 흐릿해지고 중국어·일본어·한국어 같은 거대 글자 집합은 메모리가 폭증한다. SDF(부호있는 거리장)는 픽셀 대신 가장자리까지의 거리를 저장해 확대에 강하지만, 날카로운 모서리가 둥글어지는 한계가 있다. 전체 요약 12문장 읽기 → 041 15:11 ▲ 28 · 댓글 2 컴퓨터 작업 에이전트, GUI와 CLI 결합으로 성능 대폭 향상 기존 컴퓨터 사용 에이전트(CUA)는 GUI에만 의존하거나 특정 애플리케이션 API로 보완하는데, 전자는 비효율적이고 오류가 많고 후자는 확장성이 낮다. AI · 머신러닝 · HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents
Key Point GUI와 CLI를 선택적으로 조합하는 기법으로 컴퓨터 작업 에이전트의 성능이 14.8포인트 개선되어, 더 효율적이고 일반화된 자동화 도구 개발의 새로운 방향을 제시한다.
핵심 요약
기존 컴퓨터 사용 에이전트(CUA)는 GUI에만 의존하거나 특정 애플리케이션 API로 보완하는데, 전자는 비효율적이고 오류가 많고 후자는 확장성이 낮다. 연구팀은 GUI의 일반성과 셸 명령어의 효율성을 결합한 하이브리드 접근 방식을 제시했다. 핵심 문제는 현재 모델들이 작업 실행 중 CLI를 언제·어떻게 사용할지 모른다는 점이다. 전체 요약 8문장 읽기 → 042 12:11 ▲ 43 · 댓글 1 수학 추론 모델, 동료 모델과 궤적 교환으로 성능 향상 RLVR(검증 가능한 보상 강화학습) 방식인 GRPO는 자가생성 궤적에 의존하지만 제한된 롤아웃 예산으로 인해 모두 실패한 그룹이 발생해 정책 기울기 신호를 얻지 못하는 문제가 있다. AI · 머신러닝 · Learning Beyond What You Sample: Off-Policy-Aware Cross-Model Trajectory Exchange for RLVR
Key Point 이질적 모델들 사이의 상호 보완성을 활용해 동일 예산으로 수학 추론 성능을 크게 향상시키는 새로운 강화학습 방식을 제시하고 있으며, 실제 벤치마크에서 GRPO 대비 일관된 성능 개선을 입증했다.
핵심 요약
RLVR(검증 가능한 보상 강화학습) 방식인 GRPO는 자가생성 궤적에 의존하지만 제한된 롤아웃 예산으로 인해 모두 실패한 그룹이 발생해 정책 기울기 신호를 얻지 못하는 문제가 있다. 연구진은 서로 다른 모델들이 상호 보완적인 문제들에서 성공하는 패턴을 발견했으며, 이를 통해 강한 교사 모델 없이도 상호 학습이 가능함을 확인했다. 이를 바탕으로 GRAFT(Gated Replacement of Answer-Failed groups with peer Trajectories)를 제안했으며, 이는 모두 실패한 그룹을 정보량 많은 동료 그룹으로 교체하는 오프정책 인식 프레임워크다. 전체 요약 6문장 읽기 → 043 00:11 ▲ 111 · 댓글 47 테스트할 사람 없는 시스템들, AI의 신무기가 되다 저자는 2020년 팬데믹 당시 브라질 연방 정부 시스템에서 2억 명 이상의 국민 개인정보(신분증, CPF, 여권, 주소, 전화번호, 증인보호 여부 등)에 접근 가능한 취약점을 발견했다. 보안 · The systems that no one will test
Key Point 정부 시스템부터 민간 인프라까지 AI 에이전트가 대규모로 취약점을 자동 탐사할 수 있는 시대가 도래했으며, 보안 테스트를 받지 못한 시스템들의 위험성이 급증하고 있다.
핵심 요약
저자는 2020년 팬데믹 당시 브라질 연방 정부 시스템에서 2억 명 이상의 국민 개인정보(신분증, CPF, 여권, 주소, 전화번호, 증인보호 여부 등)에 접근 가능한 취약점을 발견했다. 해당 기관에 신고하자 담당자들은 처음엔 믿지 않았으나 설명 후 심각성을 인식하고 빠르게 수정했으며, 저자는 데이터를 유출하지 않았다. 2020~2026년 사이 ML 기술이 급속도로 발전했고, 최근 OpenAI의 기술 보고서 등에서 모델 관련 사이버보안 사건들이 보도되고 있다. 전체 요약 9문장 읽기 → 044 15:11 ▲ 28 · 댓글 1 불확실한 성공은 강화, 확실한 실패는 교정하는 LLM 추론 방식 LLM의 추론 능력을 강화하는 검증 가능한 보상 기반 강화학습(RLVR)에서 기존 신용 할당 방식들은 보조 모델이나 추가 샘플링, 특권 정보가 필요했다. AI · 머신러닝 · Surprising Success, Repeated Failure: Entropy-Guided Credit Assignment for Exploration in LLM Reasoning
Key Point LLM이 복잡한 추론 과제를 풀 때 필요한 신용 할당에서 추가 모델 없이도 작동하는 더 효율적인 방법이 제시되어, 강화학습 기반 LLM 개선의 실용성을 높인다.
핵심 요약
LLM의 추론 능력을 강화하는 검증 가능한 보상 기반 강화학습(RLVR)에서 기존 신용 할당 방식들은 보조 모델이나 추가 샘플링, 특권 정보가 필요했다. 이 논문은 정책 엔트로피를 신호로 활용하되 성공과 실패를 비대칭으로 처리하는 Entropic Advantage Policy Optimization(EAPO)을 제안한다. EAPO의 핵심 아이디어는 불확실한 상황에서의 성공은 반복성이 낮고 확실한 실패는 되풀이되는 경향에서 비롯되었다. 전체 요약 7문장 읽기 → 045 21:11 당일 +124 Neuro-sama 같은 AI 캐릭터를 직접 만드는 오픈소스 프로젝트 AIRI Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. AI · 머신러닝 · moeru-ai/airi · TypeScript
Key Point Neuro-sama 같은 AI 가상 캐릭터를 누구나 직접 구축할 수 있는 완전한 오픈소스 플랫폼이 나왔고, 게임 플레이부터 음성 채팅까지 놀라운 수준의 기능을 갖추고 있다.
핵심 요약
Neuro-sama 같은 자체호스팅 가능한 AI 동반자를 만드는 오픈소스 프로젝트로, TypeScript 기반 웹 기술과 네이티브 기술을 함께 사용한다. 브라우저, macOS, Windows 데스크톱, 모바일 PWA 등 다양한 플랫폼에서 실시간 음성 채팅이 가능하며, Minecraft, Factorio, Kerbal Space Program 등 여러 게임을 플레이할 수 있다. WebGPU, WebAssembly, Web Workers 등 웹 기술로 그래픽과 레이아웃을 처리하면서도, NVIDIA CUDA와 Apple Metal을 통한 네이티브 추론으로 성능을 확보하는 하이브리드 아키텍처를 채택했다. 전체 요약 12문장 읽기 → 046 15:11 ▲ 393 · 댓글 173 엔비디아 초기 고문의 30년 미회수 스톡옵션 분쟁 저자는 1993년 젠슨 황의 초대로 엔비디아 기술자문위원회에 참여하여 25,000개 옵션을 부여받았으며, 비선형 텍스처 매핑 기술로 회사 설립 초기를 도왔다. 기타 · Owed a billion dollars in Nvidia stock
Key Point 엔비디아 초창기 기술 기여자가 30년간 청구하지 않은 스톡옵션을 둘러싼 법적 분쟁은 계약 해석, 법정 기한, 그리고 거대 기업의 법적 책임에 관한 실제 사례로서, 선택지 있는 계약자들이 장기간 권리 행사를 연기했을 때의 현실적 위험을 보여준다.
핵심 요약
저자는 1993년 젠슨 황의 초대로 엔비디아 기술자문위원회에 참여하여 25,000개 옵션을 부여받았으며, 비선형 텍스처 매핑 기술로 회사 설립 초기를 도왔다. 1993년 회의에서 저자의 쌍곡형 텍스처 매핑 구현에 감명한 커티스 프림이 다른 창립자들을 방문하게 했고, 저자는 엔비디아 하드웨어 포팅과 구겐하임 SoHo에서의 VR 데모 개발에 참여했다. 1995년 NV1 출시 후 마이크로소프트가 DirectX에서 쿼드릭 텍스처 매핑을 지원하지 않자 엔비디아의 재정이 악화되어 대량 구조조정을 단행했다. 전체 요약 9문장 읽기 → 047 22:26 당일 +257 Python 없이 비디오에서 3D 가우시안 스플래팅 모델을 만드는 올인원 도구 Spirula Studio는 비디오나 사진에서 3D 가우시안 스플래팅 모델을 훈련한 후 텍스처 메시로 변환하는 자체 포함 바이너리 도구로, Python/PyTorch나 별도 COLMAP 설치가 불필요하다. 하드웨어 · 시스템 · harry7557558/spirula-studio · C++
Key Point Python 설치 없이 영상에서 바로 3D 모델을 생성할 수 있으며, 크로스벤더 GPU 지원으로 고급 3D 재구성이 접근성 높아진다는 점이 중요하다.
핵심 요약
Spirula Studio는 비디오나 사진에서 3D 가우시안 스플래팅 모델을 훈련한 후 텍스처 메시로 변환하는 자체 포함 바이너리 도구로, Python/PyTorch나 별도 COLMAP 설치가 불필요하다. NVIDIA, AMD, Intel, Apple GPU를 Vulkan 또는 CUDA를 통해 지원하며, 8GB VRAM에서 1천만 개의 SH3 가우시안을 훈련할 수 있는 극도의 VRAM 효율성을 제공한다. 어안렌즈와 360° 카메라를 기본 지원하고, MCMC/IGS+/MRNF의 장점을 결합한 훈련 전략으로 선명한 결과와 적은 플로팅 아티팩트를 생성한다. 전체 요약 10문장 읽기 → 048 22:29 당일 +681 ComfyUI, 노드 기반 멀티모달 AI 생성 엔진으로 거듭나다 ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. AI · 머신러닝 · Comfy-Org/ComfyUI · Python
Key Point 노드 기반 워크플로우로 최신 오픈소스 생성 모델들을 자유롭게 조합하되, 로컬 실행·API 통합·클라우드 지원을 한 도구에서 선택할 수 있어 전문가부터 초심자까지 콘텐츠 제작 자동화의 진입장벽을 낮춘다.
핵심 요약
ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. Stable Diffusion, SDXL, Flux.1/2, Qwen Image, Hunyuan Image, Ideogram 등 주요 이미지 모델과 LTX-Video, HunyuanVideo 같은 영상 생성, ACE-Step, Stable Audio 등 오디오 생성 모델을 기본 지원한다. Partner nodes를 통해 폐쇄형 모델(Nano Banana, Seedance, Hunyuan3D 등)에도 접근할 수 있으며, API 엔드포인트로 프로덕션 파이프라인에 통합 가능하다. 전체 요약 9문장 읽기 → 049 15:11 ▲ 37 · 댓글 3 강화학습으로 LLM의 추론능력 높이는 BPO 알고리즘 제안 검증 가능한 보상을 활용한 강화학습(RLVR)으로 LLM의 추론 성능을 향상시키는 Bellman Policy Optimization(BPO)을 제안했다. AI · 머신러닝 · Bellman Policy Optimization
Key Point LLM의 수학 추론 같은 복잡한 작업 개선에 필요한 새로운 학습 알고리즘으로, 기존보다 계산 효율적인 방법을 제시한다.
핵심 요약
검증 가능한 보상을 활용한 강화학습(RLVR)으로 LLM의 추론 성능을 향상시키는 Bellman Policy Optimization(BPO)을 제안했다. Policy Mirror Descent(PMD)에서 유도한 비평가 불필요(critic-free) 방식으로, 벨만 방정식을 이용해 중간 상태의 값 추정을 피한다. 원래 PMD 목적함수와 동일한 유일한 최적해를 갖도록 증명했고, 손실함수는 보완적 토큰 확률의 평활 비율을 가중치로 사용한다. 전체 요약 4문장 읽기 → 050 03:11 새 버전 Next.js 16.3.6에서 원격 코드 실행 보안 취약점 수정 Next.js 16.3.6이 공개되었다. 보안 · vercel/next.js@v16.3.6
Key Point 이미지 생성 기능의 원격 코드 실행 취약점은 높은 심각도의 보안 위협이므로 즉시 업그레이드가 필요하다.
핵심 요약
Next.js 16.3.6이 공개되었다. next/og ImageResponse에서 원격 코드 실행(RCE) 취약점 GHSA-vcvr-r3jv-pc5j를 수정했다. 이 보안 결함을 악용하면 공격자가 임의의 코드를 서버에서 실행할 수 있었다. 051 21:10 ▲ 145 · 댓글 25 8GB GPU에서 처음부터 학습하는 미니 AGI 공개 8GB VRAM 단일 GPU에서 처음부터 학습 가능한 바이트 레벨 언어 모델로, 가중치를 디스크에 저장했다가 필요할 때만 로드해 매개변수 수를 VRAM이 아닌 여유 디스크 공간으로 제한한다. AI · 머신러닝 · Show HN: Mini-AGI – Dynamic continual learning model trained on 8GB VRAM
Key Point 개인용 GPU에서 처음부터 훈련하고 계속 학습하는 언어 모델을 만드는 기술적 접근이 가능함을 보여주며, 하드웨어 제약 속에서도 지속적인 학습 구조를 구현할 수 있는 새로운 아키텍처 패턴을 제시한다.
핵심 요약
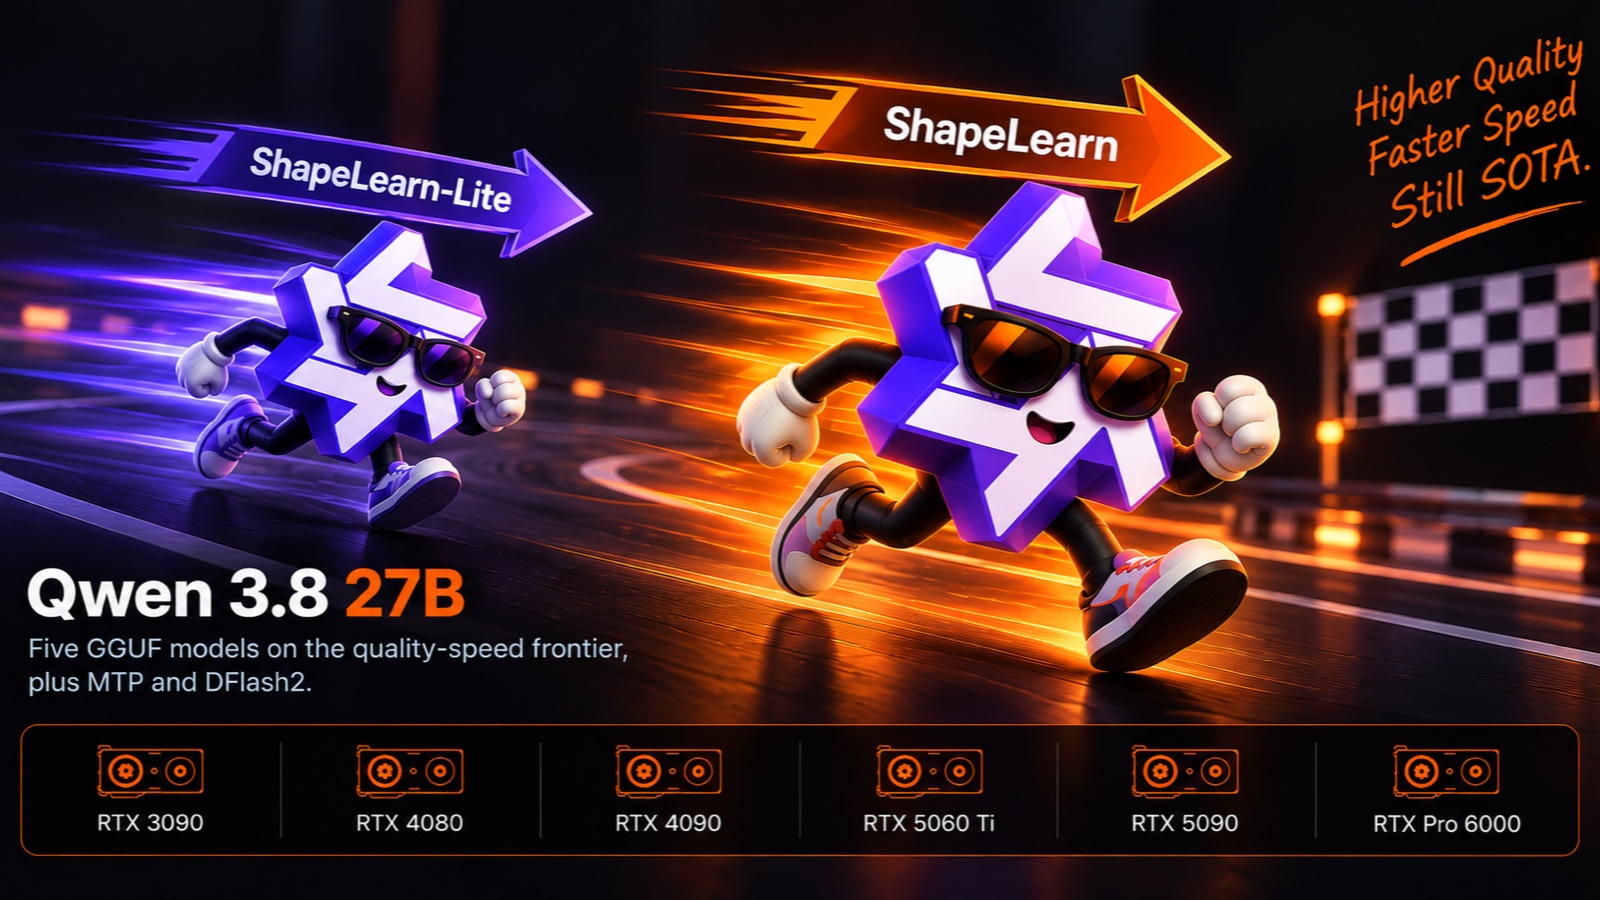
8GB VRAM 단일 GPU에서 처음부터 학습 가능한 바이트 레벨 언어 모델로, 가중치를 디스크에 저장했다가 필요할 때만 로드해 매개변수 수를 VRAM이 아닌 여유 디스크 공간으로 제한한다. 훈련 중 용량이 부족하면 자동으로 확장하고, 불필요한 부분은 정리하며, 지속적 학습(continual learning)을 통해 재앙적 망각 없이 스트림 형태의 데이터에서 계속 배운다. 두 개의 밀집 블록과 최대 24번 반복되는 재귀 블록으로 구성되며, 각 적용마다 공유 풀에서 자신의 전문가 8개를 선택하는 라우팅 방식을 사용한다. 전체 요약 5문장 읽기 → 052 21:10 ▲ 100 · 댓글 38 Qwen 3.8 27B 최적화 모델, 13.1GB VRAM에서 99.63% 성능 ByteShape가 Qwen 3.8 27B의 GGUF 양자화 모델 'ShapeLearn'을 공개했다. AI · 머신러닝 · Shapelearn Qwen 3.8 27B (13.1 GB VRAM)
Key Point 로컬에서 대규모 언어 모델을 최소 메모리로 효율적으로 운영하려는 개발자들에게 실질적인 선택지를 제시하는 벤치마크 기준을 제공한다.
핵심 요약
ByteShape가 Qwen 3.8 27B의 GGUF 양자화 모델 'ShapeLearn'을 공개했다. GPU-5(IQ4_XS, 3.84bpw)는 13.1GB VRAM에서 BF16 기준 99.63% 정확도를 유지하며 90.4 토큰/초의 속도를 낸다. 메모리가 제한적이면 GPU-4(IQ3_S, 11.0GB)를 추천하며, 이는 98.72% 성능을 내면서 더 빠르다. 전체 요약 5문장 읽기 → 053 21:10 당일 +216 YuE2: 악보 편집으로 완성도 높은 음악 생성 가사와 스타일 설명만으로 멜로디-코드 악보를 자동 작성한 후 보컬과 반주가 포함된 완성 곡을 생성한다. AI · 머신러닝 · multimodal-art-projection/YuE · Python
Key Point 악보를 중간 단계로 하는 '화이트박스' 음악 생성 방식으로, 사용자가 생성 과정을 직접 검사·편집할 수 있는 새로운 제어 방식을 제시한다.
핵심 요약
가사와 스타일 설명만으로 멜로디-코드 악보를 자동 작성한 후 보컬과 반주가 포함된 완성 곡을 생성한다. 악보를 악곡 형식(ABC)으로 읽고 수정 가능해 사람이나 에이전트가 직접 편집할 수 있다. 기존 곡을 악보로 변환한 뒤 새로운 스타일로 재해석하는 제로샷 커버와, 대화 기반 에이전트 편집을 지원한다. 전체 요약 5문장 읽기 → 054 15:10 ▲ 103 · 댓글 22 구글, 오픈소스 모바일 자동화 코드를 저작자 표기 없이 사용 Minitap의 연구진이 오픈소스로 공개한 'mobile-use' 프로젝트의 코드가 구글의 'Artemis'에 그대로 포함되어 있으나 저작자 표기가 없다는 것을 발견했다. 오픈소스 · 도구 · Google stole open source code without crediting the authors (Artemis/Minitap)
Key Point 오픈소스 라이선스 침해 사건으로, 대형 기업의 저작권 미표기 관행이 개발자 커뮤니티의 공유 문화를 위협한다는 점을 보여준다.
핵심 요약
Minitap의 연구진이 오픈소스로 공개한 'mobile-use' 프로젝트의 코드가 구글의 'Artemis'에 그대로 포함되어 있으나 저작자 표기가 없다는 것을 발견했다. Android 기기 연결 코드, Hopper 에이전트 명령어, WhatsApp 메시징 예제 등이 단어 단위로 동일하며, 같은 버그까지 공유하고 있다. Artemis의 초기 버전에는 Pierre-Louis Favreau, Jean-Pierre Lo, Nicolas Dehandschoewercker의 이름이 있었으나 8월 강제 푸시를 통해 모두 제거되고 다른 저작자로 변경되었다. 전체 요약 5문장 읽기 → 055 21:11 당일 +185 드라마 자동 다운로드 및 관리 도구 'Sonarr' 오픈소스 Usenet과 BitTorrent 사용자를 위한 PVR(개인 영상 기록) 소프트웨어로, RSS 피드를 모니터링해 TV 시리즈의 새 에피소드를 자동으로 감지하고 다운로드한다. 오픈소스 · 도구 · Sonarr/Sonarr · C#
Key Point TV 시리즈 팬들이 수동으로 에피소드를 찾아 다운로드하는 번거로움을 자동화할 수 있으며, 기존 라이브러리도 자동 스캔해 누락된 에피소드를 보충할 수 있다.
핵심 요약
Usenet과 BitTorrent 사용자를 위한 PVR(개인 영상 기록) 소프트웨어로, RSS 피드를 모니터링해 TV 시리즈의 새 에피소드를 자동으로 감지하고 다운로드한다. 다운로드한 파일을 자동으로 정렬하고 이름을 변경하며, 더 나은 화질 포맷이 나오면 기존 파일을 자동 업그레이드한다. Windows, Linux, macOS, Raspberry Pi 등 주요 플랫폼을 지원하며 SABnzbd, NZBGet, Kodi, Plex와 완벽히 통합된다. 전체 요약 5문장 읽기 → 056 21:11 당일 +873 일반 PC에서 744B 규모 대규모 언어모델 실행하는 C 엔진 공개 Colibrì는 순수 C와 의존성 없이 744B~2.8T 규모 MoE 모델을 일반 하드웨어에서 실행하는 추론 엔진이다. 오픈소스 · 도구 · JustVugg/colibri · C
Key Point 소유한 PC로 최대 2.8T 규모 모델을 실행할 수 있는 가능성을 보여주며, 하이퍼스케일러 하드웨어 의존성을 제거해 대규모 모델 접근성을 크게 낮춘다.
핵심 요약
Colibrì는 순수 C와 의존성 없이 744B~2.8T 규모 MoE 모델을 일반 하드웨어에서 실행하는 추론 엔진이다. VRAM, RAM, 디스크를 하나의 계층 구조로 취급해 제한된 고속 메모리에서도 모델 정확도를 유지하며 속도만 조절된다. GLM, Kimi, DeepSeek, Qwen 등 8개 모델 계열을 지원하며 각각 하나의 C 파일로 구현되어 동일한 인터페이스(coli chat/serve/web)를 사용한다. 전체 요약 5문장 읽기 → 057 21:11 당일 +125 당신의 하드웨어에 맞는 LLM 찾아주는 도구 llmfit Rust 기반 터미널 도구로, CPU·메모리·GPU·VRAM을 자동 감지해 실행 가능한 오픈소스 LLM 모델을 추천한다. AI · 머신러닝 · AlexsJones/llmfit · Rust
Key Point 로컬에서 LLM을 실행하려는 개발자들이 자신의 하드웨어 사양에 정확히 맞는 모델을 찾기 어려운 문제를 직접 해결해주는 도구이기 때문이다.
핵심 요약
Rust 기반 터미널 도구로, CPU·메모리·GPU·VRAM을 자동 감지해 실행 가능한 오픈소스 LLM 모델을 추천한다. GGUF·AWQ·GPTQ·EXL2 등 다양한 양자화 포맷을 지원하며 메모리 사용량과 토큰 속도를 예측한다. 인터랙티브 TUI, 웹 대시보드, REST API 엔드포인트 중 선택해 사용할 수 있다. 전체 요약 5문장 읽기 → 058 21:11 ▲ 101 · 댓글 34 5달러 ESP32를 멀티 프로토콜 하드웨어 워크벤치로 변신 ESP32 Bit Pirate는 ESP32-S3 보드를 I2C, SPI, UART, GPIO, 무선(Wi-Fi, BLE, Sub-GHz, LoRa) 등 다중 프로토콜을 지원하는 하드웨어 디버깅 워크벤치로 변환하는 오픈소스 펌웨어 및 생태계다. 하드웨어 · 시스템 · ESP32 Bit Pirate Hardware Hacking Kit with Web Tools That Speaks Every Protocol
Key Point 하드웨어 개발과 임베디드 디버깅 시 복잡한 장비 대신 저가 ESP32 보드 하나로 다양한 프로토콜을 브라우저에서 직접 다룰 수 있어, 개발 효율성이 크게 향상된다.
핵심 요약
ESP32 Bit Pirate는 ESP32-S3 보드를 I2C, SPI, UART, GPIO, 무선(Wi-Fi, BLE, Sub-GHz, LoRa) 등 다중 프로토콜을 지원하는 하드웨어 디버깅 워크벤치로 변환하는 오픈소스 펌웨어 및 생태계다. C++ 펌웨어, 브라우저 기반 웹 도구(Web Flasher, Web Serial 터미널), Python 자동화 스크립팅, 실습 가이드(Recipes)와 위키 문서를 포함한다. 브라우저에서 직접 펌웨어를 플래시할 수 있으며, USB 시리얼, Wi-Fi를 통한 CLI 접근, 웹 브라우저 기반 터미널 세 가지 방식으로 사용 가능하다. 전체 요약 5문장 읽기 → 059 11:10 당일 +125 로컬에서 빠르게 LLM 실행하는 llama.cpp, 고성능 추론 엔진 llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. AI · 머신러닝 · ggml-org/llama.cpp · C++
Key Point 하드웨어 요구사항이 낮으면서도 다양한 플랫폼을 지원해 개인 PC에서도 대형 언어모델을 효율적으로 운영할 수 있다는 점이 실무에서 중요해지고 있다.
핵심 요약
llama.cpp는 C/C++로 구현된 경량 LLM·VLM 추론 엔진으로, 별도 의존성 없이 다양한 하드웨어에서 최적화된 성능을 제공한다. Apple Silicon의 Metal, ARM NEON, x86의 AVX/AVX512, RISC-V의 RVV 등 각 플랫폼별 명령어세트를 지원해 효율성을 극대화했다. 1.5~8비트 정수 양자화를 통해 추론 속도를 높이고 메모리 사용량을 줄일 수 있으며, NVIDIA GPU(CUDA), AMD GPU(HIP), Intel NPU 등 14개 이상의 백엔드를 지원한다. 전체 요약 4문장 읽기 → 060 08:12 당일 +280 Next.js 기반 무료 영상 스트리밍 플레이어 공개 Next.js 14, TypeScript, Tailwind CSS로 구축한 크로스플랫폼 영상 통합 플레이어 'LunaTV' 공개. 오픈소스 · 도구 · MoonTechLab/LunaTV · TypeScript
Key Point 무료 스트리밍 서비스 구축 관심층이나 오픈소스 비디오 플레이어 기술에 관심 있는 개발자에게 직접 배포 가능한 완성도 높은 솔루션을 제공합니다.
핵심 요약
Next.js 14, TypeScript, Tailwind CSS로 구축한 크로스플랫폼 영상 통합 플레이어 'LunaTV' 공개. 다중 소스 검색, HLS.js와 ArtPlayer 통합 재생, 컬렉션 및 시청 기록 동기화, PWA 지원, 광고 자동 스킵 기능 제공. Kvrocks/Redis/Upstash를 통한 저장소 옵션 지원으로 여러 기기 간 진행 상황 동기화 가능. 전체 요약 5문장 읽기 → 061 20:31 당일 +132 Unsloth, 로컬에서 LLM과 확산 모델 학습할 수 있는 데스크톱 앱 공개 로컬에서 LLM, 확산, 임베딩, 오디오 모델을 실행하고 학습할 수 있으며 Kimi K3, DeepSeek-V4, Gemma 4 등을 지원한다. AI · 머신러닝 · unslothai/unsloth · Python
Key Point 로컬 AI 모델 실행·학습을 간편하게 만드는 도구로서 개발자가 클라우드 비용 없이 자체 서버에서 LLM을 운영할 수 있게 해주는 점이 주목받고 있다.
핵심 요약
로컬에서 LLM, 확산, 임베딩, 오디오 모델을 실행하고 학습할 수 있으며 Kimi K3, DeepSeek-V4, Gemma 4 등을 지원한다. 미세조정 시 학습 속도를 2배 빠르게 하면서 VRAM 사용량을 70% 줄일 수 있고 LoRA, QLoRA, GRPO, DPO 등 다양한 훈련 방식을 지원한다. Tauri 기반 데스크톱 앱으로 제공되며 Windows, macOS, Linux 등 여러 플랫폼을 지원하고 Cloudflare를 통한 원격 접근도 가능하다.