쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 11월 16일 (월)까지4683건
18건 · "RLVR"조건 지우기 ×
001▲ 11 · 댓글 2루프 구조 언어 모델 Dory1.0-4B 공개, 작은 규모로 더 큰 모델 능력 구현Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다.AI · 머신러닝 · Dory1.0-4B: A Looped Normalized-GPT

Key Point작은 규모 모델이 루프 구조를 통해 더 큰 모델 수준의 성능을 달성할 수 있다는 것을 보여주며, 토큰 생성 효율과 메모리 사용 최적화 방식이 에지 디바이스와 추론 비용 절감에 영향을 미친다.
핵심 요약
- Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다.
- 정규화 Transformer 기반으로 입력 블록, 공유 루프 블록, 출력 블록으로 구성하며, 추론 시 루프 블록을 가변 횟수로 반복 실행할 수 있다.
- 6조 개 토큰으로 사전 학습했으며, 초기 4.5조 토큰은 NVFP4 양자화로 학습했고 이후 컨텍스트 길이를 256K로 확장했다.
전체 요약 9문장 읽기 →AI · 머신러닝 · Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception

Key Point멀티모달 모델의 세부 인식과 공간 이해를 동시에 개선하는 데이터 합성 기법이 소개되면서, VLM 학습의 효율성과 일반화 성능을 어떻게 높일 수 있는지 보여준다.
핵심 요약
- 멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다.
- EvidenceConnect는 한 이미지 내 관련 영역의 줌 뷰를 활용해 시각 증거의 비교·집계·체이닝을 요구하는 학습 데이터를 자동 생성한다.
- 데이터 품질 보증을 위해 독립적인 VLM들이 합의한 정답만 유지하고, 영역 제거 테스트로 특정 영역 제거해도 답변이 유지되는 문제를 걸러낸다.
전체 요약 6문장 읽기 →AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization

Key Point언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
- 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다.
- 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다.
- 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다.
전체 요약 8문장 읽기 →AI · 머신러닝 · Sebastian Raschka's from-scratch video course on building reasoning models
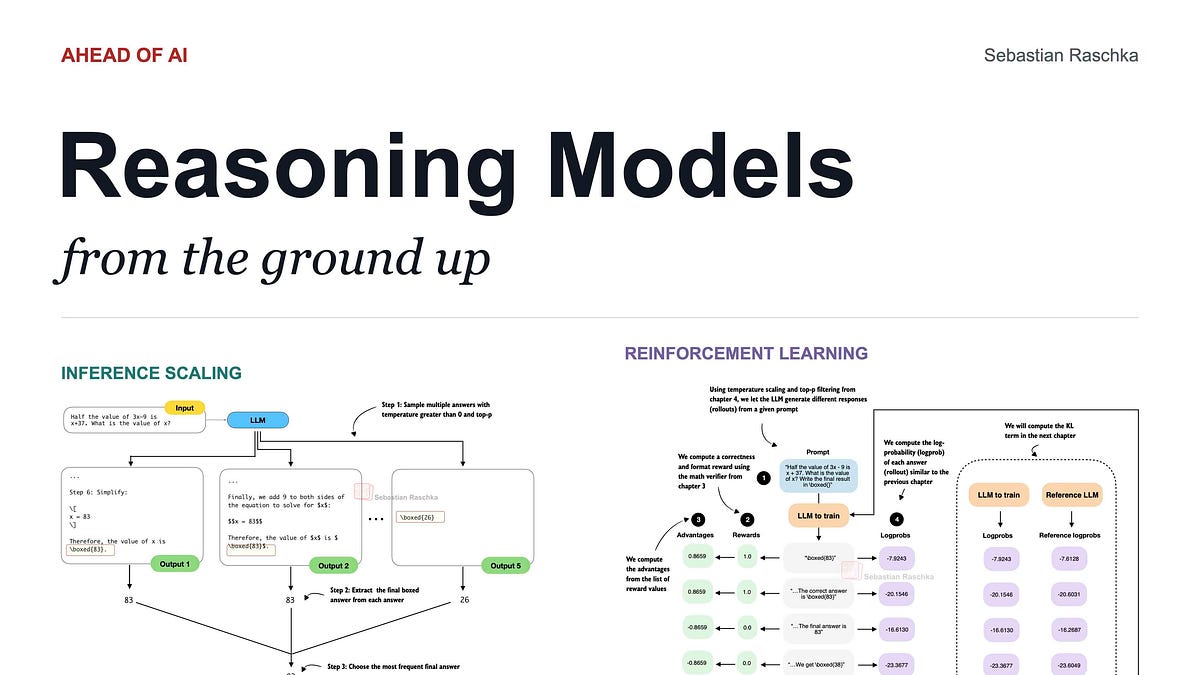
Key Point추론 모델 구현의 핵심 기법들(강화학습, 추론 시점 스케일링, 증류)을 직접 코딩하면서 배울 수 있는 완전한 실습 자료가 공개되어, LLM 개발자가 최신 추론 기술의 동작 원리를 깊이 있게 이해할 수 있다.
핵심 요약
- Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다.
- Python과 PyTorch로 평가, 추론 시점 스케일링, 강화학습, 증류를 처음부터 끝까지 구현한다.
- 사전학습된 Qwen 0.6B 모델을 출발점으로, KV 캐싱, 다양한 텍스트 생성, 답 검증기 구축 등을 단계별로 다룬다.
전체 요약 8문장 읽기 →AI · 머신러닝 · KV4-RL: Unlocking Faster Asynchronous Rollouts for RLVR with INT4 KV Cache Quantization

Key Point강화학습 훈련에서 KV 캐시 양자화로 하드웨어 메모리 사용량을 크게 줄이면서도 정확도 손실을 거의 없는 방법이 나왔기 때문에, 리소스 제약이 있는 환경에서의 LLM 훈련 효율을 크게 개선할 수 있다.
핵심 요약
- 비동기 롤아웃은 긴 생성 작업 중 미활용을 줄여 검증 가능한 보상(RLVR) 강화학습의 효율성을 높이지만, 맥락 처리가 적은 디코딩 단계에 집중되면서 KV 캐시 작업 부하가 증가한다.
- 가중치 전용·가중치-활성화 양자화보다 KV 캐시 양자화가 훨씬 더 큰 가속 효과를 주지만, INT4 양자화만으로는 토큰 단위 절단된 중요도 샘플링(TIS)을 써도 학습이 악화될 수 있다.
- KV4-RL은 보정 없는 INT4 KV 양자화에 어텐션 싱크와 최근 문맥의 일부 위치만 INT8로 보호해 샘플러 오정렬을 줄이면서도 대부분의 속도 이득을 유지한다.
전체 요약 5문장 읽기 →AI · 머신러닝 · DeltaTTG: Training Multi-Turn Agents with a Token-to-Go Progress Meter

Key Point기존 멀티턴 에이전트 강화학습에서 각 단계의 가치를 판단하는 방식의 비용 문제를 해결하는 새로운 접근으로, 실제 성능 향상을 실증한 방법입니다.
핵심 요약
- 강화학습에서 검증 가능한 보상(RLVR)으로 멀티턴 에이전트를 학습할 때 최종 보상만으로는 각 단계의 품질을 판단하기 어려운 문제를 다룬 논문입니다.
- 기존 방식은 상태 매칭의 신뢰성 확보나 외부 평가자·인간 주석·작업별 휴리스틱이 필요해 비용이 많이 들기 때문입니다.
- DeltaTTG는 다양한 정책의 궤적 기록으로부터 저비용 감독 신호를 얻어 재사용 가능한 진행도 신호를 학습합니다.
전체 요약 8문장 읽기 →AI · 머신러닝 · ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning

Key Point강화학습 모델 훈련에서 정책 최적화 과정의 근본적인 문제를 진단하고 이를 해결하는 새로운 알고리즘을 제시하여, 특히 데이터 재사용 효율성이 중요한 LLM 훈련에 직접 적용될 수 있기 때문이다.
핵심 요약
- 검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다.
- 기존 클리핑 기반 정책 최적화에서 '부호 의존 그래디언트 기아' 문제가 발생하는데, 이는 클리핑이 저중요도 가중치 영역의 미생성 긍정 응답을 억제하면서 동시에 고중요도 영역의 과도 생성 부정 응답이 지배하게 되는 현상이다.
- 연구팀은 ReSPO(Reshaped Sequence Policy Optimization)를 제안하는데, α-발산 변분 목적함수와 지수 분산 제어 틸트에서 파생된 부드러운 이중 분기 시퀀스 레벨 커널로 클리핑을 대체한다.
전체 요약 6문장 읽기 →AI · 머신러닝 · Self-Retrospection Distillation: Turning Post-hoc Experiences into Prior Foresight

Key Point보상 신호가 부족한 강화학습 상황에서 과거 경험으로 예측력을 높이는 새로운 접근법은 장기 작업 에이전트와 추론 기반 AI 개발에 직결되는 개선 기법이다.
핵심 요약
- 강화학습에서 보상이 없거나 희소할 때 에이전트가 학습 신호를 얻기 어려운 문제를 다룬 논문이다.
- 기존 RLVR(검증 가능 보상 강화학습) 방식은 스칼라 보상만으로 신호를 만들어 그룹 상대 목표에서 모든 시도가 같은 보상받으면 실패한다.
- 저자는 "Self-Retrospection Distillation(SRD)" 기법을 제안해 이미 완료된 궤적(trajectory)의 정보를 사전 예측 학습에 활용한다.
전체 요약 8문장 읽기 →AI · 머신러닝 · Rationale-Guided Policy Optimization: Learning to Reason with Adaptive Rationale Scaffolding

Key PointLLM을 정책 강화학습으로 훈련할 때 나타나는 보상 희소성 문제를 근거 정보로 해결하는 새로운 접근법으로, 추론 능력 향상에 실질적 효과를 보인다.
핵심 요약
- 정책 강화학습으로 대형언어모델의 추론 능력을 높이려는 시도가 늘고 있으나, 어려운 문제에서 올바른 궤적을 발견하지 못할 때 보상 신호가 드물어서 학습이 정체하는 문제가 있다.
- 기존 방식은 오프폴리시 데이터나 전문가 궤적, 모델 생성 솔루션을 보조 정보로 사용하지만, 이들이 강화학습 작업 형식과 일치해야 하며 보통 더 강한 모델에서 거부 샘플링으로 학습 자료를 얻어야 한다.
- RGPO(Rationale-Guided Policy Optimization)는 모델의 현재 능력에 맞춰 정답 근거(rationale) 정보를 적응적으로 활용하되 탐색의 자유도를 보존하는 프레임워크다.
전체 요약 6문장 읽기 →AI · 머신러닝 · DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation

Key Point기존 증류와 강화학습의 한계를 동시에 해결하는 방법으로, 작은 언어모델(0.6B~1.7B)의 코딩·수학 추론 성능을 실질적으로 향상시키는 기법입니다.
핵심 요약
- 온-폴리시 증류(OPD)는 대형 언어모델의 학생 모델이 자신이 생성한 결과로 학습하는 방식으로 널리 쓰이지만, 토큰 수준의 국소적 최적화만 하고 전체 추론의 질을 고려하지 않습니다.
- 보상 기반 강화학습(RLVR, 특히 GRPO)은 전체 결과 수준의 지도를 제공하지만 희소 보상으로 인해 신용 할당이 입자합니다.
- 연구진은 두 방식의 한계를 분석했습니다: OPD는 밀집된 국소 신호를 주지만 정답률과 약하게 연관되고, GRPO는 작업 성공을 포착하되 토큰별 신용 할당이 정교하지 못합니다.
전체 요약 9문장 읽기 →AI · 머신러닝 · Semifactual Credit-Augmented Policy Optimization

Key Point토큰 수준의 미세한 신용 할당으로 LLM 추론 정확도를 5~6% 개선하는 새로운 학습 기법으로, 프롬프트 표현에 과민한 모델의 근본적 문제를 다룬다.
핵심 요약
- 대규모 언어모델의 추론 능력을 개선하는 검증 가능한 보상 강화학습(RLVR)이 있지만, 모델의 예측이 문제와 무관한 프롬프트 표현에 민감하게 반응하는 문제가 있다.
- 연구팀은 답을 유지하면서 프롬프트만 변경하는 반사실적 개입으로 이를 분석했고, 토큰 수준에서 큰 민감도 편차가 있으며 불안정한 토큰을 디코딩 중에 억제하면 모델 가중치를 업데이트하지 않아도 추론 정확도가 높아짐을 발견했다.
- 기존의 그룹상대정책최적화(GRPO)는 모든 응답 토큰에 동일한 이점을 할당하여 추론과 무관한 특성 의존성까지 강화할 수 있다는 한계가 있다.
전체 요약 7문장 읽기 →AI · 머신러닝 · X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization

Key Point에이전트가 재사용 가능한 스킬을 가중치로 학습하면서 새로운 작업으로의 일반화 성능이 크게 향상되는 방식을 제시해, 멀티스텝 의사결정이 필요한 AI 시스템 개발에 실질적 개선을 가져온다.
핵심 요약
- 멀티스텝 에이전트를 학습할 때 기존 방식은 모든 액션 토큰을 동등하게 취급해 반복되는 부분 절차를 놓쳤다.
- 최근 에이전트들은 LLM이 문맥으로 작성한 스킬만 활용해 가중치에 반영되지 않아 새 상황에 일반화하지 못했다.
- 연구팀은 X-Tree(reusable eXperience tree) 기법으로 학습 데이터에서 계층 구조를 자동으로 복원했다.
전체 요약 9문장 읽기 →AI · 머신러닝 · On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics

Key Point강화학습 기반 모델 최적화에서 온정책 학습의 필요성이 통념으로 여겨졌지만, 체계적인 실험을 통해 그 가정을 재검토한 논문으로 실무 선택에 직결되는 통찰을 제시한다.
핵심 요약
- 온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다.
- 연구팀은 강한 모델을 약한 모델로 증류하는 통제된 실험에서 온정책 정책, KL 방향, 학습률을 독립적으로 변경하며 Llama3과 Qwen2.5에서 과학·의료·산술 추론 과제를 실시했다.
- 분석 결과 온정책 정책이 중심 역할을 하지 않는 것으로 드러났다.
전체 요약 8문장 읽기 →AI · 머신러닝 · HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents

Key PointGUI와 CLI를 선택적으로 조합하는 기법으로 컴퓨터 작업 에이전트의 성능이 14.8포인트 개선되어, 더 효율적이고 일반화된 자동화 도구 개발의 새로운 방향을 제시한다.
핵심 요약
- 기존 컴퓨터 사용 에이전트(CUA)는 GUI에만 의존하거나 특정 애플리케이션 API로 보완하는데, 전자는 비효율적이고 오류가 많고 후자는 확장성이 낮다.
- 연구팀은 GUI의 일반성과 셸 명령어의 효율성을 결합한 하이브리드 접근 방식을 제시했다.
- 핵심 문제는 현재 모델들이 작업 실행 중 CLI를 언제·어떻게 사용할지 모른다는 점이다.
전체 요약 8문장 읽기 →AI · 머신러닝 · Learning Beyond What You Sample: Off-Policy-Aware Cross-Model Trajectory Exchange for RLVR

Key Point이질적 모델들 사이의 상호 보완성을 활용해 동일 예산으로 수학 추론 성능을 크게 향상시키는 새로운 강화학습 방식을 제시하고 있으며, 실제 벤치마크에서 GRPO 대비 일관된 성능 개선을 입증했다.
핵심 요약
- RLVR(검증 가능한 보상 강화학습) 방식인 GRPO는 자가생성 궤적에 의존하지만 제한된 롤아웃 예산으로 인해 모두 실패한 그룹이 발생해 정책 기울기 신호를 얻지 못하는 문제가 있다.
- 연구진은 서로 다른 모델들이 상호 보완적인 문제들에서 성공하는 패턴을 발견했으며, 이를 통해 강한 교사 모델 없이도 상호 학습이 가능함을 확인했다.
- 이를 바탕으로 GRAFT(Gated Replacement of Answer-Failed groups with peer Trajectories)를 제안했으며, 이는 모두 실패한 그룹을 정보량 많은 동료 그룹으로 교체하는 오프정책 인식 프레임워크다.
전체 요약 6문장 읽기 →보안 · The systems that no one will test
Key Point정부 시스템부터 민간 인프라까지 AI 에이전트가 대규모로 취약점을 자동 탐사할 수 있는 시대가 도래했으며, 보안 테스트를 받지 못한 시스템들의 위험성이 급증하고 있다.
핵심 요약
- 저자는 2020년 팬데믹 당시 브라질 연방 정부 시스템에서 2억 명 이상의 국민 개인정보(신분증, CPF, 여권, 주소, 전화번호, 증인보호 여부 등)에 접근 가능한 취약점을 발견했다.
- 해당 기관에 신고하자 담당자들은 처음엔 믿지 않았으나 설명 후 심각성을 인식하고 빠르게 수정했으며, 저자는 데이터를 유출하지 않았다.
- 2020~2026년 사이 ML 기술이 급속도로 발전했고, 최근 OpenAI의 기술 보고서 등에서 모델 관련 사이버보안 사건들이 보도되고 있다.
전체 요약 9문장 읽기 →AI · 머신러닝 · Surprising Success, Repeated Failure: Entropy-Guided Credit Assignment for Exploration in LLM Reasoning

Key PointLLM이 복잡한 추론 과제를 풀 때 필요한 신용 할당에서 추가 모델 없이도 작동하는 더 효율적인 방법이 제시되어, 강화학습 기반 LLM 개선의 실용성을 높인다.
핵심 요약
- LLM의 추론 능력을 강화하는 검증 가능한 보상 기반 강화학습(RLVR)에서 기존 신용 할당 방식들은 보조 모델이나 추가 샘플링, 특권 정보가 필요했다.
- 이 논문은 정책 엔트로피를 신호로 활용하되 성공과 실패를 비대칭으로 처리하는 Entropic Advantage Policy Optimization(EAPO)을 제안한다.
- EAPO의 핵심 아이디어는 불확실한 상황에서의 성공은 반복성이 낮고 확실한 실패는 되풀이되는 경향에서 비롯되었다.
전체 요약 7문장 읽기 →AI · 머신러닝 · Bellman Policy Optimization

Key PointLLM의 수학 추론 같은 복잡한 작업 개선에 필요한 새로운 학습 알고리즘으로, 기존보다 계산 효율적인 방법을 제시한다.
핵심 요약
- 검증 가능한 보상을 활용한 강화학습(RLVR)으로 LLM의 추론 성능을 향상시키는 Bellman Policy Optimization(BPO)을 제안했다.
- Policy Mirror Descent(PMD)에서 유도한 비평가 불필요(critic-free) 방식으로, 벨만 방정식을 이용해 중간 상태의 값 추정을 피한다.
- 원래 PMD 목적함수와 동일한 유일한 최적해를 갖도록 증명했고, 손실함수는 보완적 토큰 확률의 평활 비율을 가중치로 사용한다.
전체 요약 4문장 읽기 →