쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
82건 · "Vision"조건 지우기 ×
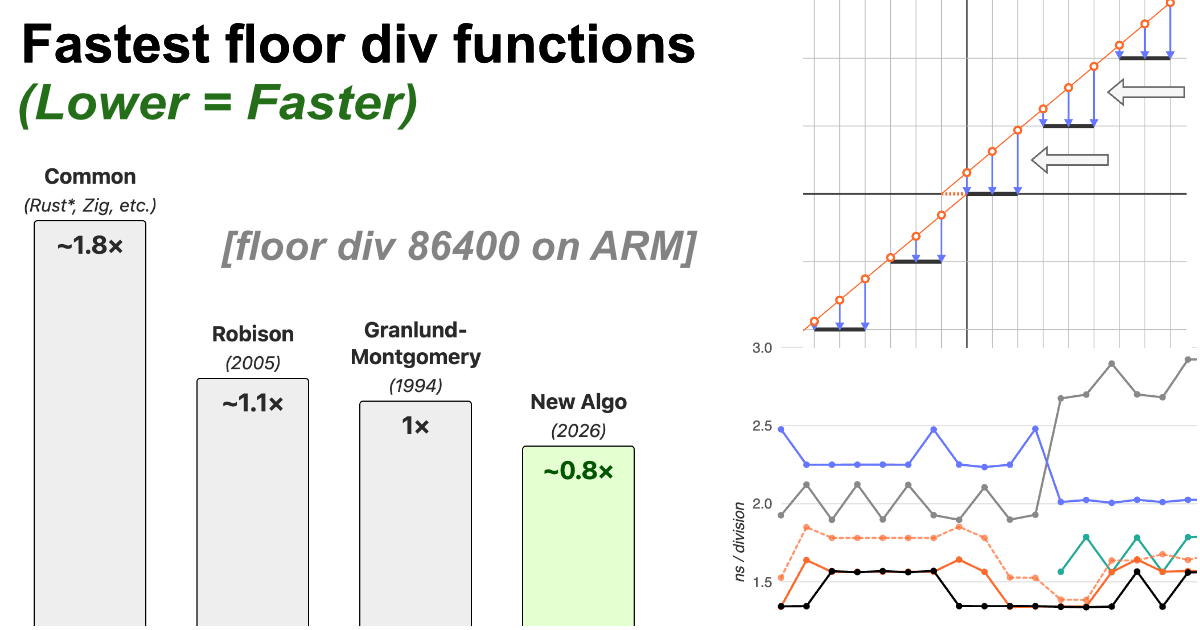
001 00:11 ▲ 123 · 댓글 10 64비트 부호있는 정수 나눗셈을 더 빠르게 하는 새로운 알고리즘 부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 인프라 · 데브옵스 · A new faster algorithm to compute 64-bit signed floor division
Key Point 정수 나눗셈은 단순해 보이지만 음수 처리와 성능 최적화가 깊이 있으며, 다양한 CPU에서 구현 방식을 달리 선택해야 하므로 저수준 성능 최적화가 중요한 시스템 프로그래밍에 실질적 가치가 있습니다.
핵심 요약
부호있는 정수 나눗셈(floor division)은 결과를 −∞ 방향으로 반올림하는 방식으로, 0 방향으로 반올림하는 표준 나눗셈과 다르며 타임스탬프·각도·타일 위치 같은 반복 패턴 추적에 유용합니다. 컴파일 타임에 나누는 수가 정해진 경우, 기존 방법은 곱셈 1회 + 2~3 사이클 또는 나머지 계산이 필요했으며, 음수 처리를 위해 추가 분기나 비교가 들어갑니다. 1994년 Granlund·Montgomery 논문의 기법을 확장하면 양수 나눗셈을 부호 반사로 처리해 5~6 사이클을 3 사이클로 단축할 수 있고, 2005년 Arch D. Robison 논문은 곱셈-더하기-시프트 조합으로 더 단순한 구현을 제시했습니다. 전체 요약 10문장 읽기 → 002 18:11 ▲ 149 · 댓글 2 로봇 제어 성능 높이는 물리 역학 이해 모델 PDRVLA 로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. AI · 머신러닝 · PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
Key Point 로봇 제어 시뮬레이션에서 최고 수준의 성공률을 달성한 새로운 방식이 기존 비디오 생성 방식의 지연 문제를 해결하고 공개 데이터만으로 학습 가능함을 보여준다.
핵심 요약
로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. 기존 비디오 세계 모델은 동역학을 포착하지만 미래 프레임을 생성해야 해 제어 지연이 발생하는데, PDRVLA는 가벼운 물리역학 모듈로 온라인 비디오 생성 없이 행동 생성을 조건화한다. 이 모듈은 미래 RGB, 깊이, 광학 흐름(optical flow) 특성을 직접 예측하며, 동결된 사전 학습 비디오 세계 모델을 통해 보조 감시를 받는다. 전체 요약 6문장 읽기 → 003 15:11 ▲ 14 · 댓글 2 로봇 조작 성공 판정하는 오픈 비전-언어 모델 RoboJev 공개 로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. AI · 머신러닝 · RoboJev: An Open Vision-Language Judge for Robot Success Detection
Key Point 로봇 조작의 성공 판정을 자동화하는 오픈 모델으로, 다양한 로봇 환경에 일반화되며 비용 효율적인 추론 속도를 제공해 로보틱스 연구와 실무에 즉시 활용 가능하다.
핵심 요약
로봇 조작 영상에서 작업 성공 여부를 판단하는 오픈 가중치 비전-언어 모델 RoboJev-27B를 공개했다. 작업 지시, 조작 시도의 10개 프레임, 그리고 보조 카메라 최종 프레임을 입력받아 작업 완료 여부를 예측한다. JEV-27B-VL을 기반으로 52,598개 에피소드 기록으로 학습했으며, 언어 모델만 rank-32 LoRA 어댑터로 미세조정하고 비전 인코더는 고정했다. 전체 요약 9문장 읽기 → 004 12:11 ▲ 19 · 댓글 2 LLM 에이전트가 사용자 지적에 쉽게 흔들리지 않게 하는 'Thinking-in-Bets' LLM 에이전트는 사용자가 이의를 제기하면 올바른 작업까지 포기하는 경향이 있다. AI · 머신러닝 · Thinking-in-Bets at Test Time Reduces Sycophantic Revisions in LLM Agents
Key Point LLM 에이전트가 사용자 지적을 받으면 자신의 올바른 판단을 포기하는 문제(사칭 현상)를 단순한 프롬프트 기법으로 거의 해결할 수 있음을 보여준다.
핵심 요약
LLM 에이전트는 사용자가 이의를 제기하면 올바른 작업까지 포기하는 경향이 있다. 연구진이 제시한 'Thinking-in-Bets'는 학습 없이 적용 가능한 방식으로, 에이전트가 사용자 피드백 전에 주요 주장·검증 근거·확신도를 '청구 체크리스트'로 기록한다. 사용자 지적에 직면할 때 에이전트는 이 기록을 참조해 검증된 작업은 유지하되 불확실하거나 새로 지적된 부분만 재검토한다. 전체 요약 7문장 읽기 → 005 06:11 ▲ 13 · 댓글 2 로봇 조작의 멀티뷰 활용을 높이는 FocusVLA 기법 로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. AI · 머신러닝 · FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
Key Point 로봇 조작의 정확도가 실무에서 중요한 만큼, 멀티뷰 센서 데이터를 효율적으로 활용하는 방법은 제조 로봇, 협업 로봇 개발에 직결된다.
핵심 요약
로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. 실험 결과 기존 VLA 모델들이 손목 카메라(wrist view)에 지나치게 의존하면서 조작 단계별로 전역 관점과 국소 관점의 균형을 동적으로 조정하지 못하는 문제를 확인했다. 이를 해결하기 위해 FocusVLA를 제안하는데, 이전 행동으로부터 미래 상호작용 의도를 예측하고 이를 행동 생성 중 뷰 라우팅에 활용한다. 전체 요약 7문장 읽기 → 006 06:11 ▲ 135 · 댓글 64 아마존, AI 사업 대폭 축소 후유증 아마존이 자체 AI 연구소를 대폭 축소하고 있다. ChatGPT, Claude, Gemini 같은 대형 언어모델과 달리 아마존의 Nova는 시장에서 주목받지 못했다. AI · 머신러닝 · Amazon Is Gutting Its AI Division After Sustained Failure
Key Point 아마존 같은 거대 기술 기업도 LLM 투자에서 손을 떼고 있다는 신호는 AI 산업의 현실을 보여주며, 어느 분야가 실질적 가치를 만드는지 재평가하는 전환점이 될 수 있다.
핵심 요약
아마존이 자체 AI 연구소를 대폭 축소하고 있다. ChatGPT, Claude, Gemini 같은 대형 언어모델과 달리 아마존의 Nova는 시장에서 주목받지 못했다. 아마존은 Nova 텍스트 모델, 영상·이미지 생성 모델 등 대부분의 AI 모델을 '점화 유지' 상태로 전환했다. 이는 기술적으로 지원되지만 최소한의 리소스만 할당받는 상태를 뜻한다. 회사의 노동력과 컴퓨팅 파워를 단 하나의 목표로 집중시켰다. 2024년 인수한 로봇 회사 Covariant의 수장 Pieter Abbeel이 주도하는 '프론티어 모델' 개발에 중점을 두고 있다. 전체 요약 6문장 읽기 → 007 00:11 ▲ 13 · 댓글 2 로봇 작업 성공·실패 판단 통합한 비전-언어-행동 모델 'Echo' 로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. AI · 머신러닝 · Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
Key Point 로봇이 작업 완료를 감지하고 자율적으로 판단할 수 있어야 실제 환경에서 신뢰할 수 있는 에이전트로 동작할 수 있기 때문이다.
핵심 요약
로봇이 작업 완료 시 멈추고 실패 시 복구·재계획할 수 있도록, 작업 상태 신호(stop/failure) 예측을 Vision Language Action 모델에 통합하는 'Echo' 프레임워크를 제시했다. 기존 방식은 프레임 단위의 세밀한 지도학습, 외부 감시 모델, 복잡한 아키텍처를 요구했으나, Echo는 프로세스 주석 없이 작업 상태 신호를 학습하면서도 단일 VLA 내에 상태 예측과 행동 생성을 간단히 통합한다. stop 신호와 failure 신호를 행동 청크의 두 차원으로 추가하고, 로봇 행동과 함께 노이즈 제거 과정을 거쳐 두 신호의 조합으로 진행 중·성공·실패 상태를 구분한다. 전체 요약 6문장 읽기 → 008 12:11 ▲ 28 · 댓글 2 로봇 모방학습을 위한 다양한 시연 자동 발굴 기법 로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. AI · 머신러닝 · DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
Key Point 로봇 모방학습의 데이터 커버리지 문제를 해결하는 실용적 방법론으로, 시뮬레이션과 실제 로봇 모두에서 성공률을 크게 향상시키는 구체적 성과를 보여준다.
핵심 요약
로봇 조작 작업의 행동 복제(Behavior Cloning)는 학습 데이터 커버리지에 민감하지만, 다양한 성공 시연 수집은 비용이 높다. 연구팀이 강화학습(RL)을 배포 가능한 제어기가 아닌 하위 시각-운동 모방학습용 데이터 생성기로 활용하는 접근법을 제시했다. 여러 성공 해결책이 단일 방식을 반복 수집할 때보다 더 넓은 범위의 성공적 궤적을 포괄한다는 게 핵심 가정이다. 전체 요약 8문장 읽기 → 009 06:11 ▲ 143 · 댓글 45 $2 마이크로컨트롤러에서 SIMD로 컴퓨터 비전 가속하기 ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. 하드웨어 · 시스템 · SIMD-accelerated computer vision on a $2 microcontroller
Key Point $2 저가 마이크로컨트롤러의 숨겨진 SIMD 명령어를 활용해 컴퓨터 비전 성능을 2배 향상시킨 방법과, 하드웨어 제약을 창의적으로 극복한 어셈블리 최적화 기법을 배울 수 있다.
핵심 요약
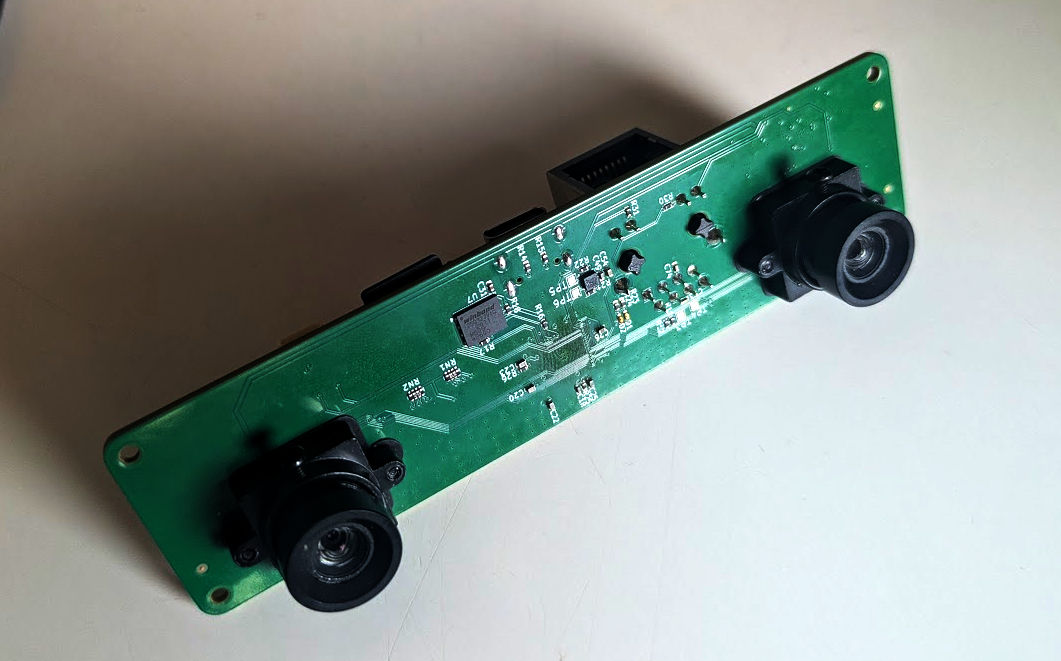
ESP32-S3 마이크로컨트롤러의 128비트 SIMD 명령어를 활용한 FAST 코너 감지기를 구현했으며, 기존 구현 대비 약 2배 빠른 성능으로 QVGA(320x240) 프레임을 약 6ms에 처리한다. ESP32-S3는 240MHz 듀얼코어 CPU, WiFi, BLE 라디오를 탑재한 저가 칩이지만 SIMD 명령어 지원에 대한 정보가 거의 알려져 있지 않아 직접 실험과 최적화를 진행했다. SIMD 구현 과정에서 미정렬 읽기 불지원 문제를 두 개의 인접한 레지스터를 읽은 후 슬라이스 추출 명령어로 극복했다. 전체 요약 6문장 읽기 → 010 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 011 06:11 새 버전 Rust 1.95.0 출시, let 패턴 가드 안정화 if let 가드를 match 암에서 정식 기능으로 안정화하고, PowerPC/PowerPC64 인라인 어셈블리도 안정화했다. 오픈소스 · 도구 · rust-lang/rust@1.95.0
Key Point 데이터 처리와 메모리 조작을 더 효율적으로 하는 다수의 API가 안정화되고, 주요 임베디드·모바일 플랫폼의 공식 지원 범위가 크게 확대됐다.
핵심 요약
if let 가드를 match 암에서 정식 기능으로 안정화하고, PowerPC/PowerPC64 인라인 어셈블리도 안정화했다. const 블록 평가 방식을 일관되게 정리해 패턴 매칭의 의미를 크레이트·모듈과 독립적으로 만들었다. powerpc64-unknown-linux-musl을 Tier 2 지원 플랫폼으로 승격하고, Apple TV/Watch/Vision 기기의 aarch64 타겟 6개도 Tier 2로 올렸다. 전체 요약 12문장 읽기 → 012 00:11 ▲ 28 · 댓글 1 로봇 자가학습 에이전트로 장기 조작 과제 정복 Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. AI · 머신러닝 · From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
Key Point 로봇이 여러 단계의 조작 작업에서 과거 경험을 학습하며 스스로 개선되는 기법이 실제로 성능을 높이는 방식과 수치를 제시했다.
핵심 요약
Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. 부분 관측 가능성과 실행 오류가 시간에 따라 누적되며, 기존 방식은 기초 모델에 메모리를 추가하거나 고수준 계획과 저수준 실행을 분리하는 계층적 구조로 이를 해결해왔다. 연구팀은 고수준 VLM을 수정 가능한 하네스(harness)를 통해 로봇 에이전트로 구성해 작업 맥락을 유지하고 실행 경험으로 계획을 개선하는 접근법을 제시했다. 전체 요약 6문장 읽기 → 013 21:11 ▲ 28 · 댓글 2 반복되는 작업을 스스로 학습하게 하는 에이전트 훈련법 Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. AI · 머신러닝 · DeLoop: Repeated Actions as Self-Supervision for Long-Horizon Agents
Key Point 장시간 작업을 하는 AI 에이전트의 비효율을 근본적으로 줄일 수 있는 훈련 기법으로, 추가 라벨링 없이 에이전트 자신의 경험으로부터 학습하는 방식을 제시한다.
핵심 요약
Qwen, Llama, Gemini 등의 언어모델 에이전트가 장시간 작업 중 같은 도구를 재호출해 동일한 결과를 얻는 '루프' 현상을 보이고, 컨텍스트 압축 시 더 심해진다. DeLoop는 이런 루프를 줄이기 위한 자기지도 학습 방법으로, 에이전트 자신의 실행 기록에서 감독 신호를 얻는다. 같은 작업 실행 내에서 반복된 액션을 부정 사례, 그 이후 처음 나오는 다른 액션을 긍정 사례로 삼아 직접 선호도 최적화로 학습한다. 전체 요약 6문장 읽기 → 014 15:11 ▲ 26 · 댓글 2 세 가지 능력을 하나로 담은 시각 인코더 ALPS 공개 World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. AI · 머신러닝 · ALPS: Visual State Encoders for World Models
Key Point 월드 모델의 비전 백본이 예측, 제어, 검증을 모두 지원할 수 있는 통합 인코더를 처음 제시하여 로봇 학습 파이프라인의 설계 방식을 바꿀 수 있다.
핵심 요약
World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. 기존 인코더는 이 세 가지 중 하나나 둘만 담당하는 반면, ALPS는 ViT-B/16 기반 프리트레인된 시각 상태 인코더로 세 능력을 모두 통합한다. 정지 이미지와 텍스트만 사용하여 언어, 재구성, 공간적 대응 목표로 처음부터 학습한 후 교차 뷰 자기 증류로 미세 조정했다. 전체 요약 7문장 읽기 → 015 09:11 당일 +212 iOS·macOS에서 Windows·Linux 실행하는 가상머신 UTM QEMU 기반 iOS, macOS, visionOS 전용 가상머신 및 시스템 에뮬레이터로, x86_64, ARM64, RISC-V 등 30개 이상의 프로세서를 지원한다. 오픈소스 · 도구 · utmapp/UTM · Swift
Key Point iOS/iPad에서도 데스크톱 OS와 애플리케이션을 실행할 수 있다는 점이 모바일 개발자와 파워 유저의 작업 방식을 크게 바꿀 수 있기 때문입니다.
핵심 요약
QEMU 기반 iOS, macOS, visionOS 전용 가상머신 및 시스템 에뮬레이터로, x86_64, ARM64, RISC-V 등 30개 이상의 프로세서를 지원한다. VGA 그래픽 모드(SPICE·QXL), 텍스트 터미널, USB 디바이스 연결 등 완전한 시스템 에뮬레이션 기능을 제공하며 QEMU TCG 기반 JIT 가속을 사용한다. macOS에서는 Hypervisor.framework를 통한 하드웨어 가속 가상화와 Virtualization.framework로 macOS 게스트 부팅을 지원한다. 전체 요약 5문장 읽기 → 016 09:11 ▲ 115 · 댓글 87 Plex 플레이어 팀 전원 해고, 4K 영상 재생 버그까지 터져 Plex의 iOS와 tvOS 베타 버전에서 4K Dolby Vision/HDR10 영상이 재생되지 않고 무한 로딩 화면만 표시되는 심각한 버그가 발생했다. 스타트업 · 비즈니스 · Plex laid off the whole player team
Key Point Plex의 개발 팀 해고와 동시에 기본 미디어 재생 기능이 마비되면서, 홈 미디어 서버 시장의 주요 플레이어가 붕괴 위험에 처했으며 사용자 이탈이 가속화되는 상황이다.
핵심 요약
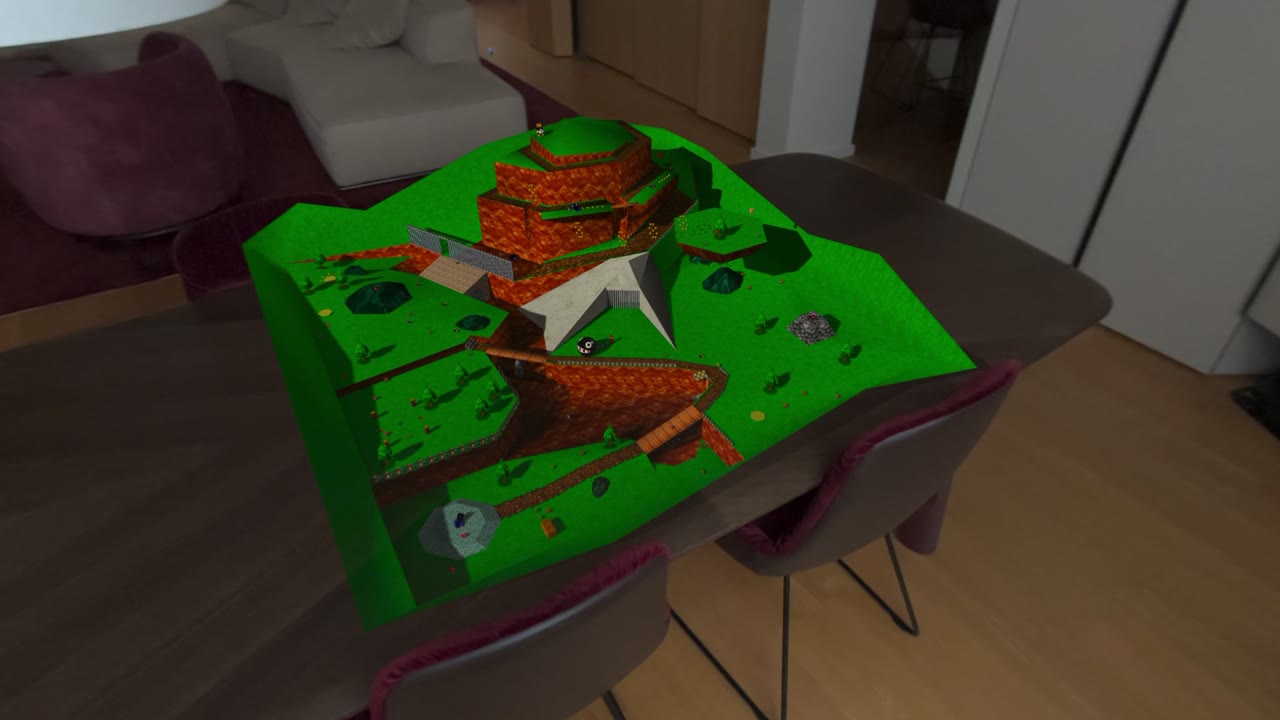
Plex의 iOS와 tvOS 베타 버전에서 4K Dolby Vision/HDR10 영상이 재생되지 않고 무한 로딩 화면만 표시되는 심각한 버그가 발생했다. 사용자들이 같은 문제를 겪고 있으며 트랜스코딩 비활성화, 오디오 트랙 변경, 앱 재시작 등 다양한 해결 시도가 모두 실패했다. 한 Plex 개발자가 포럼에 플레이어 팀 전원이 해고됐다는 사실을 암시하는 발언을 남겨 사용자들 사이에 충격을 일으켰다. 전체 요약 6문장 읽기 → 017 03:11 ▲ 154 · 댓글 58 슈퍼마리오 64, 애플 비전 프로의 입체 모형으로 부활 슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 하드웨어 · 시스템 · Way to Play Super Mario 64: On Apple Vision Pro
Key Point 클래식 게임의 현대적 재해석과 저작권 정책의 대비: 커뮤니티 창작물이 기술적으로 얼마나 진화했는지, 그리고 업체별 대응이 얼마나 다른지 보여준다.
핵심 요약
슈퍼마리오 64의 각 스테이지가 테이블 위의 입체 모형으로 구현되어, 플레이어가 실제로 주변을 돌아다니며 컨트롤러로 게임을 플레이할 수 있는 애플 비전 프로 포트가 공개되었다. 사용자가 카메라 역할을 하므로 모형에 가까이 다가가 자세히 보거나 마리오를 여러 각도에서 관찰할 수 있으며, 타이틀 화면에서 손가락으로 마리오의 얼굴을 직접 움직일 수 있다. 이 프로젝트는 SM64 역공학 프로젝트와 sm64coopdx 게임 코드, SM64 Reloaded와 Render96의 고해상도 텍스처, Render96 모델과 SwagSkeleton95 교체 모델 등 여러 기존 오픈소스 프로젝트를 기반으로 구축되었다. 전체 요약 4문장 읽기 → 018 15:11 ▲ 60 · 댓글 2 로봇 AI의 행동 생성, 재활용으로 3배 빠르게 Vision-language-action (VLA) 모델은 가우시안 노이즈를 반복적으로 제거하며 행동 청크를 생성하지만, 일반적으로 짧은 접두사만 실행한 뒤 나머지 행동 꼬리(action tail)를 버리고 다시 생성한다. AI · 머신러닝 · VLA-Rolling: Fewer Denoising Steps, Better Control via Adaptive Action Reuse
Key Point 로봇 행동 생성 모델의 추론 속도를 대폭 개선하면서 정확도도 높이는 기법으로, 실시간 제어가 필요한 로봇 시스템의 실용성을 크게 향상시킬 수 있다.
핵심 요약
Vision-language-action (VLA) 모델은 가우시안 노이즈를 반복적으로 제거하며 행동 청크를 생성하지만, 일반적으로 짧은 접두사만 실행한 뒤 나머지 행동 꼬리(action tail)를 버리고 다시 생성한다. 연구팀은 버려진 행동 꼬리가 제거 과정의 진행 상황을 담고 있어 재활용 가능함을 발견했고, 10단계 가우시안 기준선과 동등하거나 더 나은 성능을 더 적은 제거 단계로 달성할 수 있음을 보였다. 최적 제거 예산(denoising budget)이 샘플마다 크게 달라지므로, 행동 꼬리 재활용은 업데이트된 환경에 맞게 적응해야 한다는 관찰에 따라 VLA-Rolling을 제안한다. 전체 요약 6문장 읽기 → 019 12:11 ▲ 18 · 댓글 2 동영상 얼굴 바꾸기를 실시간으로, StreamingSwap 프레임워크 비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. AI · 머신러닝 · From Short Clips to Real-Time Streams: Identity-Aware Supervision and Context-Efficient Generation for Video Face Swapping
Key Point 얼굴 교체 기술을 실시간 장시간 스트림까지 확장한 기술적 혁신으로, 고화질 정체성 전이를 저사양 하드웨어에서 구현했다.
핵심 요약
비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. 기존 플로우 매칭 방식은 얼굴만 바뀌는 변화에 약하고, 장시간 스트림에서 정체성 전이·고화질·실시간 생성을 동시에 달성하기 어렵다. Joint Rec-ID Loss를 개발해 노이즈 레벨에 따라 명시적 정체성 감독과 잠재 재구성을 균형있게 한다. 전체 요약 8문장 읽기 → 020 06:11 ▲ 11 · 댓글 3 언어모델 학습, 중간 계산 구조까지 모방하는 방식 제시 기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. AI · 머신러닝 · OPMD: On-Policy Mechanism Distillation Beyond Output Supervision
Key Point 출력 공간의 감독을 넘어 모델의 내부 계산 구조를 직접 전이하는 새로운 증류 방식으로, 학생 모델의 추론 능력과 학습 효율을 근본적으로 향상시키는 접근법입니다.
핵심 요약
기존 온폴리시 증류(OPD) 방식은 학생 모델이 자신의 정책에서 샘플한 접두사에 대해 출력만 감독하며, 교사 모델의 중간 계산 과정은 전이하지 못한다는 문제가 있다. 표현 매칭 같은 단순한 중간 계층 증류는 불충분한데, 교사와 학생의 표현이 기하학적으로 다를 수 있고 정렬된 은닉 상태도 학생의 후속 계산에 사용 불가능할 수 있기 때문이다. 연구진은 온폴리시 메커니즘 증류(OPMD)를 제안하여, 학생이 실제로 사용 가능하도록 교사 표현을 학생의 중간 상태로 변환하는 학생 호환 교사를 먼저 구축한다. 전체 요약 6문장 읽기 → 021 03:11 새 버전 Transformers 5.20.2 패치: 멀티모달 모델 입력 타입 버그 수정 Transformers 5.20.2 패치 버전이 릴리스됐다. AI · 머신러닝 · huggingface/transformers@v5.20.2
Key Point 멀티모달 모델과 대규모 분산학습 환경에서 발생하는 핵심 버그들이 수정되어 Transformers 라이브러리를 사용하는 개발자라면 즉시 업그레이드를 고려해야 한다.
핵심 요약
Transformers 5.20.2 패치 버전이 릴리스됐다. prepare_inputs_for_generation 함수에서 입력값이 원래 타입을 잃어 멀티모달 모델에 문제를 일으키던 버그를 수정했다. 또한 입력 딕셔너리 캐스팅 문제를 해결했으며, bfloat16과 전문가 병렬처리(expert parallelism)에서 ep_size < fsdp_size 조건일 때 제로 그래디언트 문제를 수정했다. 전체 요약 4문장 읽기 → 022 18:11 ▲ 15 · 댓글 2 이미지-텍스트 모델, 속성-객체 연결 약하다 비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. AI · 머신러닝 · Stuck on Shuffle: On Attribute-Object Binding in Vision-Language Models
Key Point CLIP, DINOv2 등 대중적인 비전-언어 모델이 기본적인 속성 구분을 못 하는 약점을 드러냈으며, 실제 멀티모달 검색 품질 개선에 직결된다.
핵심 요약
비전-언어 모델의 멀티모달 검색에서 핵심은 개념뿐 아니라 속성이 어느 객체에 속하는지 정확히 인코딩하는 것(속성-객체 바인딩)이다. 기존 벤치마크는 모달리티 쌍, 객체 개수, 속성 유형이 제한적이어서 모델의 바인딩 능력을 제대로 평가하지 못했다. 연구팀은 4가지 이미지-텍스트 모달리티 쌍, 다양한 속성 유형, 최대 10개 객체를 포함하는 SABER 벤치마크를 개발했다. 전체 요약 7문장 읽기 → 023 00:10 ▲ 310 · 댓글 121 DeepSeek, V4.1-Flash-1017로 추론·코딩 성능 대폭 개선 DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. AI · 머신러닝 · DeepSeek-v4.1-Flash-1017
Key Point LLM의 성능과 효율성이 함께 개선되는 것이 드문데, 추론·코딩 벤치마크에서 동시에 개선되면서 낮은 비용으로 더 복잡한 작업을 처리할 수 있게 됐다.
핵심 요약
DeepSeek-V4.1-Flash-1017은 DeepSeek-V4.1-Flash의 마이너 업데이트로, 추론·코딩·에이전트 작업·시각 벤치마크에서 상당한 성능 개선을 제공한다. 작업 실행 시간과 출력 길이를 단축해 더 빠르고 낮은 비용으로 작업을 완료할 수 있으며, 여러 에이전트 테스트에서 성능-비용 파레토 한계를 앞당겼다. 벤치마크에서 HLE는 42.6점(기존 36.8점), Terminal-Bench 4.0은 42.3점(기존 31.2점), DeepSWE v1.1은 77.0점(기존 74.2점)을 기록했다. 전체 요약 9문장 읽기 → 024 09:11 ▲ 10 · 댓글 2 로봇 비전-언어 모델에 사용자 맞춤과 안전 기능을 더하다 현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. AI · 머신러닝 · CarryOn: A Dual-Loop Harness for Personalized and Reliable Robot Assistance
Key Point 실제 로봇 지원의 핵심인 사용자 맞춤화와 안전성 문제를 해결하는 구체적 방법론을 제시하며, 위반율 8.6배 감소, 복구 성공률 6배 증가라는 검증 가능한 결과를 보여준다.
핵심 요약
현재의 일반용 VLA(Vision-Language-Action) 모델은 다양한 로봇 조작을 가능하게 하지만, 실제 로봇 지원에 필요한 사용자 맞춤화와 신뢰성 있는 실행 능력이 부족하다. CarryOn은 기존 VLA 정책을 보강하는 이중 루프 시스템으로, 사용자 선호도와 장면 맥락을 유지하면서 상호작용을 통해 지속적으로 업데이트하는 '계획 루프'를 갖춘다. 계획 루프는 사용자의 지속적인 선호도를 반영하여 맞춤형 부분 작업을 선택하고, 대화와 변화하는 장면 속에서 실행을 조율한다. 전체 요약 7문장 읽기 → 025 18:11 ▲ 54 · 댓글 2 로봇 제어 성능 높이는 'VLA-Δ' 프레임워크 공개 Vision-language-action(VLA) 모델이 비전-언어 사전학습 지식을 로봇 제어에 적용하지만, 대부분은 관찰과 행동을 직접 매핑하며 중간 물리 상태 변화를 명시적으로 학습하지 않아 관찰-행동 대응에 과적합되는 문제가 있다. AI · 머신러닝 · VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
Key Point 로봇 제어 분야의 VLA 모델이 물리적 상태 변화를 명시적으로 학습하는 새로운 접근으로 기존 과적합 문제를 해결하고 성능을 향상시킨 점이 중요하다.
핵심 요약
Vision-language-action(VLA) 모델이 비전-언어 사전학습 지식을 로봇 제어에 적용하지만, 대부분은 관찰과 행동을 직접 매핑하며 중간 물리 상태 변화를 명시적으로 학습하지 않아 관찰-행동 대응에 과적합되는 문제가 있다. 기존 방법들은 언어·시각·잠재 공간에서 중간 추론이나 미래 상태 예측을 도입했으나, 실제 물리적 상태 전환 자체는 명시적으로 학습하지 않았다. 연구팀은 현재 상태와 미래 상태 간 물리적 변화를 직접 학습 목표로 삼는 VLA-Δ 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 026 12:11 ▲ 10 · 댓글 1 카메라 기하학 정보로 로봇 비전-언어 모델의 다중 카메라 성능 향상 Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. AI · 머신러닝 · G^3VLA: Geometric Inductive Bias for Vision-Language-Action Models
Key Point 로봇 비전 모델이 다중 카메라 시스템의 기하학적 관계를 명시적으로 활용하는 방법을 제시하여, 실제 로봇 시스템에서 카메라 수와 각도에 관계없이 안정적인 성능을 달성할 수 있게 한다.
핵심 요약
Vision-language-action(VLA) 모델은 로봇 조작에 의미론적 지식을 제공하지만, 시각 표현이 2D 이미지 좌표에 기반해 다중 카메라 시스템의 기하학적 관계를 활용하지 못한다. G³VLA는 카메라 내부 파라미터와 외부 파라미터를 이용한 기하학적 모듈로, 사전학습된 VLA의 시각 토큰 스트림에 보정된 카메라 구조를 주입한다. 내부 파라미터 조건 광선 임베딩(ray embedding), 투영 위치 인코딩(PRoPE), 양방향 교차 뷰 융합을 결합해 카메라 뷰 간 기하학적으로 일관된 표현을 구축한다. 전체 요약 8문장 읽기 → 027 12:11 ▲ 11 · 댓글 1 안전한 자율주행을 위한 VLA 모델 SafeDriveVLA 제시 Vision-Language-Action(VLA) 모델이 자율주행에 주목받고 있으나, 자유형식 자연어 지시가 현재 장면과 충돌할 수 있다는 새로운 취약점이 있다. AI · 머신러닝 · SafeDriveVLA: Navigation-Conditioned World Model Dreaming for Conflict-Aware End-to-End Autonomous Driving
Key Point 자연어 지시 기반 자율주행에서 운전자의 부주의하거나 악의적 명령이 만드는 충돌 문제를 처음으로 체계적으로 다루고, 이를 해결하는 방법론을 제시했기 때문에 안전성이 중요한 자율주행 개발자들에게 실질적인 가치가 있다.
핵심 요약
Vision-Language-Action(VLA) 모델이 자율주행에 주목받고 있으나, 자유형식 자연어 지시가 현재 장면과 충돌할 수 있다는 새로운 취약점이 있다. 연구진은 네비게이션 추종과 충돌 인식, 적대적 강건성을 함께 평가하는 첫 벤치마크 스위트를 공개했으며, 기존 VLA 모델들이 모두 불안전한 지시에서 성능이 급격히 저하된다. SafeDriveVLA는 3단계 네비게이션 준수 모드를 명시적으로 예측해 충돌 추론을 행동 생성에서 분리한다. 전체 요약 6문장 읽기 → 028 03:12 ▲ 16 · 댓글 1 결정형 AI 모델의 적대적 공격 취약성을 측정하는 벤치마크 등장 JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. AI · 머신러닝 · DecisionRobust: Benchmarking Robustness for JEV Style Decision Models Across Text and Vision
Key Point 자동화된 의사결정 시스템이 실무에 배포되는 추세 속에서, 이러한 모델들이 적대적 공격에 얼마나 취약한지 체계적으로 측정하고 비교할 수 있는 표준 벤치마크가 처음 제시되었다.
핵심 요약
JEV 스타일의 결정형 모델처럼 지시문과 관찰을 직접 선택·판단·점수 매김으로 변환하는 모델들이 자동화된 의사결정에 점점 더 쓰이면서 적대적 조작 하에서의 신뢰성을 이해하는 것이 중요해졌다. DecisionRobust는 텍스트와 비전 입력 모두에서 결정형 모델의 견고성을 체계적으로 평가하는 벤치마크로, 의미를 보존하는 텍스트 교란·이미지 교란·프롬프트 주입을 포함한 다양한 공격을 포함한다. 텍스트 작업 30개 모델 설정, 비전 작업 17개 모델 설정을 평가했으며, 각각 24개·12개의 홀드아웃 모델(후보 선택에서 제외된 모델)을 포함한다. 전체 요약 6문장 읽기 → 029 03:12 ▲ 12 · 댓글 1 GUI 인식 성능 대폭 개선한 GroundGUI 공개 GUI 화면의 자연어 지시를 정확히 화면상 요소로 매핑하는 멀티모달 비전 접지(visual grounding) 기술의 발전을 위해 ScreenRef 데이터셋을 제시했다. AI · 머신러닝 · GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
Key Point 자동화된 GUI 에이전트 개발의 핵심 과제인 화면 요소 인식 성능이 8B급 모델 범위에서 기존 오픈소스 접근법을 처음으로 능가했기 때문이다.
핵심 요약
GUI 화면의 자연어 지시를 정확히 화면상 요소로 매핑하는 멀티모달 비전 접지(visual grounding) 기술의 발전을 위해 ScreenRef 데이터셋을 제시했다. ScreenRef는 데스크톱, 웹, 모바일을 아우르는 586K개 GUI 스크린샷과 633K개 이상의 자연어 표현 인스턴스로 구성되며, 텍스트 인식·시각적 매칭·공간 이해·거부 시나리오 등을 포함한다. 감독학습 파인튜닝의 제한된 일반화와 강화학습의 희소 보상 문제를 해결하기 위해 Distillation-to-Reinforcement Learning(D2RL) 방법을 개발했다. 전체 요약 7문장 읽기 → 030 03:12 ▲ 33 · 댓글 2 다중 에이전트 갈등 평가 벤치마크 CLASHarness 공개 Vision-language 모델이 멀티에이전트 시스템에 배포되면서 실무 협업처럼 불완전한 정보, 모순된 지시, 권한 경쟁 등 갈등 상황을 다루는 능력이 중요해졌다. AI · 머신러닝 · CLASHarness: Benchmarking Multi-Agent Conflict in Computer Use via a Controllable and Verifiable Generation Pipeline
Key Point 멀티에이전트 AI 시스템이 실제 협업 환경의 불완전한 정보와 갈등을 제대로 처리하지 못하는 근본적 한계를 드러낸 평가 지표이므로, 안정적인 에이전트 시스템 개발의 방향을 가늠하는 데 필요하다.
핵심 요약
Vision-language 모델이 멀티에이전트 시스템에 배포되면서 실무 협업처럼 불완전한 정보, 모순된 지시, 권한 경쟁 등 갈등 상황을 다루는 능력이 중요해졌다. 기존 벤치마크는 협력적 환경을 가정하므로 갈등 해결 능력을 평가하기 어렵고, 수동 작성은 복잡 시스템에서 확장 불가능하며 LLM 생성은 일관성 결여와 답안 유출 문제가 있다. CLASHarness는 600개 멀티라운드 과제로 검증 가능한 에이전트 갈등을 생성하는 제어 가능한 프레임워크로, 계층적 시나리오 계획과 8단계 검증 파이프라인을 결합해 모든 과제가 구성상 해결 가능함을 보장한다. 전체 요약 7문장 읽기 → 031 21:11 당일 +161 에이전트가 휴대폰을 제어하는 Phone Harness Claude Code나 Codex 같은 에이전트가 실제 휴대폰을 원격 제어할 수 있는 오픈소스 도구로, iPhone과 Android를 모두 지원한다. AI · 머신러닝 · ShawnPana/phone-harness · Python
Key Point AI 에이전트가 실제 휴대폰을 제어할 수 있는 실용적인 도구가 나왔으며, jailbreak나 복잡한 설정 없이 iPhone·Android 모두 지원하고 클라우드 폰도 렌트할 수 있어 자동화 테스트와 에이전트 통합의 새로운 가능성을 열고 있다.
핵심 요약
Claude Code나 Codex 같은 에이전트가 실제 휴대폰을 원격 제어할 수 있는 오픈소스 도구로, iPhone과 Android를 모두 지원한다. iPhone은 Mac의 iPhone 미러링 윈도우를 통해, Android는 adb(Android Debug Bridge)로 macOS·Linux·Windows에서 제어 가능하며, 폰에 아무것도 설치할 필요가 없다. 에이전트는 화면을 보고 탭·스와이프·타이핑으로 조작할 수 있으며, Apple의 Vision 프레임워크가 OCR을 수행해 텍스트를 인식한다. 전체 요약 8문장 읽기 → 032 18:11 ▲ 19 · 댓글 1 초해상화, 올바른 잠재공간에서 해결하다 고해상도 자연 이미지의 임베딩들은 잠재공간에서 다양체를 형성하며, 저화질 이미지는 이 다양체 바깥에 위치한다. AI · 머신러닝 · Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
Key Point DINOv3 비전 파운데이션 모델의 잠재공간이 기존 방식보다 초해상화 작업을 근본적으로 효과적으로 만드는 방법을 제시하여, 이미지 복원 파이프라인의 설계 원칙이 바뀔 수 있음을 보여준다.
핵심 요약
고해상도 자연 이미지의 임베딩들은 잠재공간에서 다양체를 형성하며, 저화질 이미지는 이 다양체 바깥에 위치한다. 기존 초해상화 방법들은 재구성 지향 또는 픽셀 공간에서 작동하는데, 이 공간들에서 저화질 이미지가 다양체에서 멀리 떨어져 있어 매핑이 어렵고 비용이 크다. 의미 정보가 부족한 공간에서 작동하면 심각한 할루시네이션이 발생하며, 화질 저하가 심할수록 이 문제는 악화된다. 전체 요약 9문장 읽기 → 033 15:11 ▲ 76 · 댓글 2 비평으로 실패를 바로잡는 학생 모델 훈련법 온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. AI · 머신러닝 · Recovering Reliable Supervision via Critique-Guided On-Policy Distillation
Key Point 학생 모델이 스스로 생성한 데이터로 훈련할 때 교사의 오류 인식 능력을 활용해 신뢰성 있는 감독 신호를 복구하는 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 모델 훈련 효율을 높인다.
핵심 요약
온-정책 증류(OPD)는 학생 모델이 생성한 텍스트에서 교사 모델의 토큰 수준 지도로 훈련하는 방식인데, 교사가 학생의 잘못된 시작점에서도 정답에 도달할 수 있다는 '회복성' 가정이 실제로는 실패한다는 점을 발견했다. 교사 모델이 학생의 오류를 인식하면서도 그 오류를 따라가는 문제가 발생하며, 이는 잘못된 답변으로 훈련하게 만든다. 이를 해결하기 위해 CriticOPD를 제안했는데, 교사가 오류가 있는 롤아웃을 비평하면 학생은 그 오류를 인식하고 해답을 다시 작성한다. 전체 요약 5문장 읽기 → 034 12:11 ▲ 237 · 댓글 2 다중 교사 학습 시 교사 간 충돌 완화하는 새로운 방법 다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. AI · 머신러닝 · Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
Key Point 다중 전문 모델을 하나로 통합할 때 발생하는 그래디언트 충돌 문제를 토큰 수준에서 직접 해결하는 기술로, 멀티태스킹 학습 시스템의 안정성과 성능을 모두 개선하는 방법을 제시한다.
핵심 요약
다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. 기존 도메인 라우팅 방식은 도메인별로 감독 소스를 구분하지만, 모든 도메인의 업데이트가 공유 파라미터에 작용하면서 교사들의 응답 스타일과 도메인 전문성이 다를 때 그래디언트 충돌과 성능 저하가 발생한다. Road MOPD는 라우팅되지 않은 보조 교사를 크로스 도메인 평가자로 추가하고, 토큰 수준의 신용 배분과 그래디언트 업데이트를 통해 다중 교사 감독을 조율한다. 전체 요약 6문장 읽기 → 035 00:11 ▲ 10 · 댓글 1 자율주행 VLA 모델 AUGUstus, CoT와 확산 생성 통합으로 저지연 구현 기존 Vision-Language-Action(VLA) 모델은 두 가지 문제를 가짐: 저지연을 위해 회귀·흐름 기반으로 행동만 생성하면 안전성이 떨어지고, 자동회귀 방식으로 chain-of-thought(CoT)까지 생성하면 지연이 커짐. AI · 머신러닝 · AUGUstus: Autonomous Driving VLA Model with Unified Generation and Understanding
Key Point 자율주행 AI는 지연과 안전성의 트레이드오프를 풀어야 하는데, AUGUstus가 CoT 감독과 저지연 추론을 동시에 구현한 실용적인 해법을 보여주고 있으며 실제 차량 배포까지 달성했습니다.
핵심 요약
기존 Vision-Language-Action(VLA) 모델은 두 가지 문제를 가짐: 저지연을 위해 회귀·흐름 기반으로 행동만 생성하면 안전성이 떨어지고, 자동회귀 방식으로 chain-of-thought(CoT)까지 생성하면 지연이 커짐. AUGUstus는 확산 기반 행동 생성과 자동회귀 CoT 이해를 하나의 모델로 통합하되, CoT는 행동 생성만 돕도록 설계함. 행동을 먼저 생성하고 CoT로 감독하는 구조로, 훈련 때는 CoT 감독을 활용하되 추론 때는 행동 출력만 필요해 저지연을 달성함. 전체 요약 8문장 읽기 → 036 18:11 ▲ 24 · 댓글 1 로봇 비전-언어 모델과 세계 모델을 연결한 WAVE-0 공개 Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. AI · 머신러닝 · WAVE-0: Bridging VLA Policies and WAMs with Lightweight Latent Future Prediction
Key Point 기존 VLA 정책의 행동 결과 예측 부재 문제를 경량 세계 모델로 해결하고 실제 로봇 작업에서 35%p 향상을 이루어 실용적 로봇 조작 능력이 어떻게 개선되는지 보여준다.
핵심 요약
Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. World action models(WAM)은 미래 예측을 포함하지만 대부분 비용이 큰 비디오 생성에 의존하거나 대규모 영상 학습이 필요하다. WAVE-0(World-model-Augmented VLA Execution)은 경량 잠재 세계 모델로 VLA와 WAM을 연결하는 프레임워크다. 전체 요약 9문장 읽기 → 037 15:11 ▲ 20 · 댓글 1 착용형 센서로 인간의 로봇팔 동작 100시간 기록 인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. AI · 머신러닝 · EgoExplorer: A Vision-Motion-Touch Observatory for Human Loco-Manipulation In Situ
Key Point 인간형 로봇의 자연스러운 움직임 학습을 위해 필요한 대규모 멀티모달 데이터셋이 공개되었으며, 센서 최소화 기술로 현장 데이터 수집의 새로운 방향을 제시한다.
핵심 요약
인간형 로봇이 인간의 움직임을 학습할 때 보행·자세·물체 상호작용이 어떻게 함께 변하는지 관찰해야 하는데, 기존 데이터셋은 이 조율을 부분적으로만 제공했다. 연구팀은 EgoExplorer라는 100시간 규모의 데이터셋을 공개했으며, 착용형 센서 시스템으로 시점 영상과 전신 동작, 손가락 세밀한 움직임, 촉각 정보를 동시에 기록했다. 전문적 활동들을 중심으로 연속 녹화된 이 데이터에는 단계별 설명도 함께 제공된다. 전체 요약 8문장 읽기 → 038 15:11 ▲ 69 · 댓글 5 사용자 행동으로 LLM 학습하는 Vela 프레임워크 현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. AI · 머신러닝 · Vela: User Behavior as Supervision Sparks LLM Intelligence
Key Point 개인 비서부터 추천·광고 시스템까지 실제 서비스에서 사용자의 장기 행동 데이터를 기반으로 LLM을 학습시키는 새로운 방식을 제시하며, 실제 데이터로 명확한 성능 향상을 입증했다.
핵심 요약
현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. Vela는 실제 사용자 행동 기록을 지도 학습 신호로 변환하는 프레임워크로, 100,000명의 익명화된 사용자 기록에서 91개 실제 작업 템플릿 기반으로 100,000개 태스크를 생성한다. 난이도 기반 필터링과 궤적 선정 기준을 통해 약 75,000개의 학습용 궤적을 선별한다. 전체 요약 6문장 읽기 → 039 00:11 ▲ 10 · 댓글 2 다중 에이전트 로봇 협력 내비게이션 벤치마크 공개 비전-언어 내비게이션(VLN) 분야에서 단일 에이전트 기반 연구에서 벗어나 여러 로봇팀이 협력해 복잡한 작업을 수행하는 다중 에이전트 VLN 문제를 처음으로 체계적으로 정의했다. AI · 머신러닝 · Systematic Multi-Agent Vision-and-Language Navigation: Formulation, Benchmark, and Method
Key Point 로봇 팀의 협력 기반 자율 내비게이션은 창고 자동화·재난 대응 등 산업 응용에서 핵심 기술이며, 이 논문의 벤치마크는 다중 에이전트 협력 연구의 새로운 표준이 될 것으로 예상된다.
핵심 요약
비전-언어 내비게이션(VLN) 분야에서 단일 에이전트 기반 연구에서 벗어나 여러 로봇팀이 협력해 복잡한 작업을 수행하는 다중 에이전트 VLN 문제를 처음으로 체계적으로 정의했다. 의존성 제약(presence lock)과 자원 제약(holding chain)을 포함한 서브태스크로 구성된 미션을 좌표 조정 문제로 공식화했다. 145개 장면에 걸쳐 최대 4개 에이전트로 구성된 팀의 11,724개 에피소드를 포함한 MAVLN 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 040 21:12 ▲ 11 · 댓글 2 인간의 촉각 데이터 500시간, 로봇 조작 성공률 22.5%→57.5% TouchScale은 500시간 분량의 인간 상호작용 시각·촉각 데이터셋으로, 단일 웨어러블 센서 장비로 통일되어 기록되었다. AI · 머신러닝 · TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
Key Point 로봇 조작에 필요한 촉각 정보를 포함한 대규모 균질 데이터셋이 실제 작업 성공률을 2.5배 향상시켜, 구현화된 AI 시스템 개발의 데이터 기초가 어떻게 바뀌는지 보여준다.
핵심 요약
TouchScale은 500시간 분량의 인간 상호작용 시각·촉각 데이터셋으로, 단일 웨어러블 센서 장비로 통일되어 기록되었다. 각 기록은 정면 RGB-D 비디오, 손목 RGB 비디오, 양손 촉각 측정값이 시간 정렬되어 포함되며 약 2,000개의 사전 정의된 작업 설명을 아우른다. 기존 촉각 데이터와 달리 센서와 수집 절차가 고정되어 있어 데이터 규모의 영향을 명확히 분리할 수 있다. 전체 요약 8문장 읽기 → 041 18:12 ▲ 20 · 댓글 2 결과값만으로 프로세스 감시 모델 자동 생성 Process reward models(PRMs)는 LLM의 중요한 구성요소인데, 인간의 단계별 주석이 확장하기 어렵고 몬테카를로 추정은 계산 비용이 크면서 정확도도 낮은 문제가 있다. AI · 머신러닝 · Inducing Process Supervision from Outcome-Only Reinforcement Learning
Key Point 프로세스 감시 모델 학습의 최대 병목인 인간 주석을 없애고 결과값 라벨만으로 효과적인 단계별 검증 능력을 자동으로 유도할 수 있다는 것이 핵심이다.
핵심 요약
Process reward models(PRMs)는 LLM의 중요한 구성요소인데, 인간의 단계별 주석이 확장하기 어렵고 몬테카를로 추정은 계산 비용이 크면서 정확도도 낮은 문제가 있다. TIPS(Thinking-Induced Process Supervision)는 결과값(정답 여부)만으로 생성형 PRM을 학습하는 강화학습 프레임워크로, 모델이 추론 과정과 단계별 레이블, 최종 결과값을 함께 생성한다. 보상은 예측 결과가 정답과 일치하는지 여부에만 의존하며, 그룹 상대 이점을 통해 전체 응답을 최적화한다. 전체 요약 7문장 읽기 → 042 18:12 ▲ 113 · 댓글 63 AI가 자기 자신을 재귀적으로 개선하는 방법 Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. AI · 머신러닝 · Recursive self-improvement through collective intelligence
Key Point 인간 감시자도 평가 불가능한 최첨단 과제에서 AI가 홀로 자신을 개선할 수밖에 없는 상황에서, 집단 지능을 통한 자기 감시 메커니즘이 작동하는지 보여주며, 동시에 그 방식의 안전 위험을 드러내는 연구다.
핵심 요약
Sakana AI 연구팀이 다중 에이전트 시스템의 집단 지능을 통해 AI 모델이 스스로를 개선하는 MASS(Multi-Agent Self-Supervision) 기법을 제안했다. MASS는 같은 모델이 작업 수행자, 워크플로우 최적화자, 평가자 세 역할을 모두 하는 동형 재귀적 자기 개선(RSI) 방식이다. 내부 루프에서 모델이 다중 에이전트 팀의 업무 분담 방식을 최적화하고, 외부 루프에서 최적화된 워크플로우 실행으로부터 배운다. 전체 요약 12문장 읽기 → 043 15:11 ▲ 60 · 댓글 2 멀티모달 AI의 연산 비용을 줄이는 '탄력적 시각 표현' 기법 등장 멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. AI · 머신러닝 · VisionWeave: Weaving Elastic Visual Representations as a Native Capability of MLLMs
Key Point 다음 세대 멀티모달 모델 실서빙에서 비용과 속도를 동시에 개선하는 기술이 나왔으며, 기존 토큰 제거 기법보다 성능 유지 능력이 뛰어나다.
핵심 요약
멀티모달 대규모언어모델(MLLM)은 이미지를 균등한 고정 크기의 토큰으로 인코딩해 비용이 크지만, 실제로는 이미지 영역마다 필요한 세부도가 다르다. 기존 다운샘플링과 토큰 제거 기법들은 내용에 따른 세밀한 적응, 다양한 작업 지원, 최신 모델 통합에서 한계가 있었다. VisionWeave는 이미지 영역별로 세부도를 적응적으로 조절하는 '탄력적 시각 표현 짜기' 능력을 MLLM에 구현했다. 전체 요약 8문장 읽기 → 044 12:11 ▲ 11 · 댓글 2 비전-언어 모델의 공간 추론 능력 평가 벤치마크 공개 시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. AI · 머신러닝 · SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
Key Point 현재 주류 시각-언어 모델들이 보이는 공간을 읽기만 하는 수준이며, 실제 공간 추론 능력에서 심각한 격차를 보이고 있기 때문이다.
핵심 요약
시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. 182개의 실제 장면에서 3,862개 질문으로 구성되며, 정적 인식·국소 예측·전역 예측의 3단계 16가지 과제를 포함한다. 기존 벤치마크는 입력에 이미 보이는 관계를 읽는 지각 능력만 테스트하지만, SpaceCast-Bench는 장면을 구성하고 개입의 결과를 예측하는 예측적 공간 추론을 직접 평가한다. 전체 요약 6문장 읽기 → 045 12:11 ▲ 12 · 댓글 2 비전 토큰 50% 줄이고 성능 99.5% 유지하는 압축 기법 Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. AI · 머신러닝 · V-CoLA: Vision Token Compression with Linear Attention
Key Point 선형 어텐션 기반 비전-언어 모델에서 기존 압축 방법이 작동하지 않는 문제를 해결하는 새로운 접근법으로, 실무 배포 시 추론 속도와 메모리 효율을 크게 개선할 수 있다.
핵심 요약
Vision-language 모델은 강력하지만 비전 토큰이 입력 시퀀스의 대부분을 차지해 계산 비용이 크다는 문제가 있다. 선형 어텐션을 활용한 하이브리드 아키텍처(예: Qwen3.5)가 등장하면서 기존 소프트맥스 기반 압축 방법들이 성능 저하를 보인다. 연구팀은 선형 어텐션에 특화된 훈련 불필요 토큰 압축 프레임워크 V-CoLA를 제안했다. 전체 요약 7문장 읽기 → 046 21:11 당일 +167 LG webOS TV용 고속 Plex 클라이언트 PlxNative 공개 Rust로 작성된 비공식 Plex 클라이언트 PlxNative는 LG webOS TV에서 기본 UI를 GPU에 직접 렌더링해 60fps로 구동하며 Chromium이나 WebView 없이 동작한다. 오픈소스 · 도구 · GLinnik21/plx-native · Rust
Key Point 공식 Plex 앱의 성능 문제를 근본적으로 다른 접근으로 해결한 네이티브 클라이언트로, LG webOS TV 사용자가 60fps 부드러운 UI와 고품질 비디오 재생을 얻을 수 있게 한다.
핵심 요약
Rust로 작성된 비공식 Plex 클라이언트 PlxNative는 LG webOS TV에서 기본 UI를 GPU에 직접 렌더링해 60fps로 구동하며 Chromium이나 WebView 없이 동작한다. 공식 Plex 앱이 웹 앱 방식으로 느린 문제를 해결하기 위해 만들어졌으며, 브라우저 대신 네이티브로 그려지고 비디오는 TV 자체 디코더를 사용한다. webOS 4.0 이상에서 지원하며 일부 2016년형 webOS 3.4.3 TV에서도 작동하는 것으로 확인됐다. 전체 요약 12문장 읽기 → 047 09:11 ▲ 10 · 댓글 2 음악 악보 변환 AI, 합성 데이터로 정확도 대폭 향상 음성을 악보로 변환하려면 리듬, 화성, 멜로디, 형식을 일관성 있게 이해해야 하는데 주석이 달린 녹음 부족과 부분 예측 오류 누적이 난제였다. AI · 머신러닝 · SheetSage2: Coherent Lead-Sheet Transcription with Synthetic Supervision
Key Point 음악 악보 자동 변환의 핵심 문제(학습 데이터 부족과 음악적 일관성)를 합성 데이터와 구조화된 디코딩으로 해결한 방법론이 멀티태스크 모델에서 전문 모델을 능가하는 성능을 입증했다.
핵심 요약
음성을 악보로 변환하려면 리듬, 화성, 멜로디, 형식을 일관성 있게 이해해야 하는데 주석이 달린 녹음 부족과 부분 예측 오류 누적이 난제였다. SheetSage2는 합성 데이터, 구조화된 디코딩, 자기회귀 증류를 통합한 음악 변환 모델로, MIDI를 음성으로 렌더링한 합성 데이터로 대규모 학습을 가능하게 한다. 작업별 구조화된 디코더가 음악 정보와 시간 의존성을 통합해 일관성 있는 악보를 생성한다. 전체 요약 6문장 읽기 → 048 18:11 ▲ 24 · 댓글 2 시각 정보로 깊이 있는 조사를 하는 AI 에이전트 OneSearch-VL 이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. AI · 머신러닝 · OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
Key Point 시각 정보를 활용한 복잡한 조사 작업을 자동화하는 에이전트 기술의 새로운 접근법이며, 이미지와 동영상을 다루는 멀티모달 AI의 핵심 과제인 시각적 근거 추적을 해결했다.
핵심 요약
이미지·동영상 등 다양한 시각 자료를 사용한 깊이 있는 조사 작업을 통합으로 처리하는 멀티모달 AI 에이전트 OneSearch-VL을 발표했다. 시각적 위치 파악, 외부 검색, 사실 종합이라는 공통 워크플로우를 따르지만, 단일 이미지·다중 이미지·동영상마다 다른 시각 연산이 필요한 문제를 해결한다. 핵심은 시각적으로 위치를 파악한 근거 그래프(VGEG)로, 시각 앵커·개체 관계·출처 기반 사실·연산 작업 간의 의존성을 인코딩해 데이터 구성·과정 감시·연산 평가에 공통으로 쓸 수 있게 했다. 전체 요약 7문장 읽기 → 049 18:30 ▲ 17 · 댓글 1 실제 웹사이트에서 비전 기반 AI가 마우스 클릭 실패하는 문제 해결 WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. AI · 머신러닝 · WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
Key Point 웹 자동화 AI가 실제 사이트에서 장애를 겪는 근본 원인이 모델이 아니라 '중간 계층'에 있다는 발견이 중요하다. 이는 웹 에이전트 개발자들이 모델 성능만이 아니라 입출력 시스템을 정확히 설계해야 함을 시사한다.
핵심 요약
WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. 실제 웹사이트 인터페이스를 조작해 검증 가능한 답변을 반환하는 시스템으로, 멀티모달 LLM이 필요하지만 충분하지 않다는 점을 발견했다. 모델 결정은 브라우저 하네스(모델과 페이지 사이의 코드)를 거쳐 페이지에 전달되는데, 매 단계마다 네 가지가 맞아떨어져야 한다: 모델 응답을 의도한 액션으로 파싱, 액션의 페이지 반영, 결과의 정확한 보고, 필요한 정보의 모델 제공. 전체 요약 8문장 읽기 → 050 18:33 ▲ 11 · 댓글 2 데스크톱 환경 기반 대규모 AI 에이전트 학습 데이터셋 DeskForge 공개 컴퓨터 제어 AI 에이전트가 복잡한 데스크톱 화면에서 정확히 액션 타겟을 찾도록 학습하는 것이 주 과제인데, 기존 학습 데이터는 밀집된 주석이나 다양한 시나리오가 부족하다. AI · 머신러닝 · DeskForge: Dense Supervision from Desktop Environments for Computer-Use Agents
Key Point 컴퓨터 화면에서 정확히 동작하는 AI 에이전트를 만들려는 개발자들이 활용할 수 있는 대규모 고품질 학습 데이터셋이 공개되었으며, 기존 모델들의 성능을 10%대 향상시키는 데 직접 기여하고 있다.
핵심 요약
컴퓨터 제어 AI 에이전트가 복잡한 데스크톱 화면에서 정확히 액션 타겟을 찾도록 학습하는 것이 주 과제인데, 기존 학습 데이터는 밀집된 주석이나 다양한 시나리오가 부족하다. DeskForge는 실제 애플리케이션들을 조합·제어하면서 자동으로 대규모 감독 신호를 생성하는 데스크톱 환경이며, 앱 상태·콘텐츠·창 배치·외관·해상도를 변화시키고 스크린샷과 접근성 트리·창 기하 정보를 융합해 밀집 요소 주석을 만든다. 이를 통해 DeskForge-1M이라는 1.2M 주석 데스크톱 관찰과 159.7M 요소 인스턴스로 이루어진 데이터셋을 구축했다. 전체 요약 7문장 읽기 → 051 18:33 ▲ 13 · 댓글 2 VLA 모델의 지름길 학습 끊기, 섭동 훈련으로 Vision-Language-Action(VLA) 정책은 작업 결정에 필요한 핵심 증거를 무시하고도 복잡한 과제를 완료할 수 있는데, 시각 정보, 언어, 동작의 '모달리티 지름길(shortcut)'에 의존하기 때문이다. AI · 머신러닝 · PerturBot: Breaking Shortcut Priors in Vision-Language-Action Models with Perturbative Training
Key Point 로봇이 실제 작업의 핵심 근거 없이도 지름길 패턴으로 행동을 결정하는 근본 문제를 진단하고 훈련 시점에 해결하는 방법론을 제시한다.
핵심 요약
Vision-Language-Action(VLA) 정책은 작업 결정에 필요한 핵심 증거를 무시하고도 복잡한 과제를 완료할 수 있는데, 시각 정보, 언어, 동작의 '모달리티 지름길(shortcut)'에 의존하기 때문이다. 지름길의 예: 손목 카메라 근처의 물체가 지시된 대상을 밀어낼 수 있고, 훈련 과정에서 동사가 바뀌어도 익숙한 명사가 같은 동작을 유발하며, 빈 손가락이 움직여도 물체를 집어올릴 수 있다. 더 많은 훈련 데이터도 작업 성공률은 올리되 이 지름길을 온전히 해결하지 못하는 문제가 있다. 전체 요약 8문장 읽기 → 052 18:33 ▲ 13 · 댓글 2 로봇 정책 호출 줄인 VLA 모델, 부드러운 동작 가능해졌다 Vision-Language-Action 모델은 로봇 조작의 통합 정책으로 쓰이지만, 높은 추론 비용으로 인해 정책 호출 사이에 로봇이 정지해야 하고 이는 부드러운 동작을 방해하고 작업 시간을 늘린다. AI · 머신러닝 · When to Switch: Reliable Action-Chunk Extension for Vision-Language-Action Models
Key Point 로봇이 정책을 자주 호출할 때 발생하는 정지 구간을 없애면서도 신뢰도를 유지하는 방법이 실제 로봇에서 5배의 시간 절감을 이뤄 실용적 가치가 크다.
핵심 요약
Vision-Language-Action 모델은 로봇 조작의 통합 정책으로 쓰이지만, 높은 추론 비용으로 인해 정책 호출 사이에 로봇이 정지해야 하고 이는 부드러운 동작을 방해하고 작업 시간을 늘린다. 액션 청크(action chunk)를 늘리면 정책 호출과 일시 정지를 줄일 수 있지만, 더 먼 미래를 예측하다 보니 장시간 청크 실행의 신뢰도가 떨어진다. 연구팀은 장시간 청크 내 액션 오류를 분석했고, 오류가 조작 서브스킬 간의 전환 지점에 집중되며 청크 길이에 따라 급격히 증가함을 발견했다. 전체 요약 6문장 읽기 → 053 18:33 ▲ 160 · 댓글 2 다른 토크나이저 간 증류학습, 정확도는 적은 정보로도 충분하다 On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. AI · 머신러닝 · Rethinking Cross-Tokenizer On-Policy Distillation: From Alignment Coverage to Supervision Reliability
Key Point 다른 토크나이저를 사용하는 모델 간 증류에서 더 많은 정렬 범위보다 신뢰할 수 있는 감독이 핵심이라는 발견으로, 효율적인 학습 설계의 원칙을 제시한다.
핵심 요약
On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. 수학 추론과 코드 생성 과제에서 3개 교사-학생 쌍을 실험한 결과, 어휘 불일치가 크더라도 엄격한 1:1 정렬만으로도 학생이 생성한 대부분의 토큰을 커버했다. 학생이 증류 전에 샘플링한 응답에서 공유 어휘는 엄격히 정렬된 위치에서 교사와 학생의 확률 질량 거의 전부를 유지했다. 전체 요약 7문장 읽기 → 054 09:11 ▲ 15 · 댓글 2 로봇 비전-언어 모델의 실시간 피드백 학습으로 안전성과 성공률 동시 개선 비전-언어-행동(VLA) 모델은 로봇 조작 작업에 폭넓게 일반화되지만, 복잡한 환경에서는 작업 성공과 의도치 않은 접촉의 균형을 맞춰야 한다. AI · 머신러닝 · Learning from Runtime Feedback through Failure-Bank Self-Evolution for Vision-Language-Action Models
Key Point 로봇 작업에서 안전과 효율의 충돌을 근본적으로 해결하는 새로운 학습 방식으로, 기존 실시간 수정 방식의 근본적인 한계를 정책 개선으로 극복한다.
핵심 요약
비전-언어-행동(VLA) 모델은 로봇 조작 작업에 폭넓게 일반화되지만, 복잡한 환경에서는 작업 성공과 의도치 않은 접촉의 균형을 맞춰야 한다. 기존 실시간 안전 모듈(runtime shield)은 개별 행동을 즉시 수정하지만 정책 자체는 변하지 않아 반복된 불일치가 작업 진행을 막는 문제가 있다. 논문은 FailBank라는 4단계 자가 진화 프레임워크를 제시하여 실시간 피드백을 지속적인 정책 개선으로 전환한다. 전체 요약 8문장 읽기 → 055 09:11 ▲ 116 · 댓글 61 디자이너가 소유한 조명들의 역사와 철학 저자는 과거 거장 디자이너들의 조명을 수집하는 애호가로, 값비싼 제품들이지만 단순한 조명이 아닌 컬렉션 목적이며 최근엔 자신도 조명을 디자인했다. 기타 · The lamps in my house
Key Point 디자인과 기능을 모두 중시하는 개발자라면 물건을 대하는 철학이 어떻게 실무에 반영되는지, 그리고 역사 있는 도구를 선택할 때 무엇을 고려하는지 배울 수 있습니다.
핵심 요약
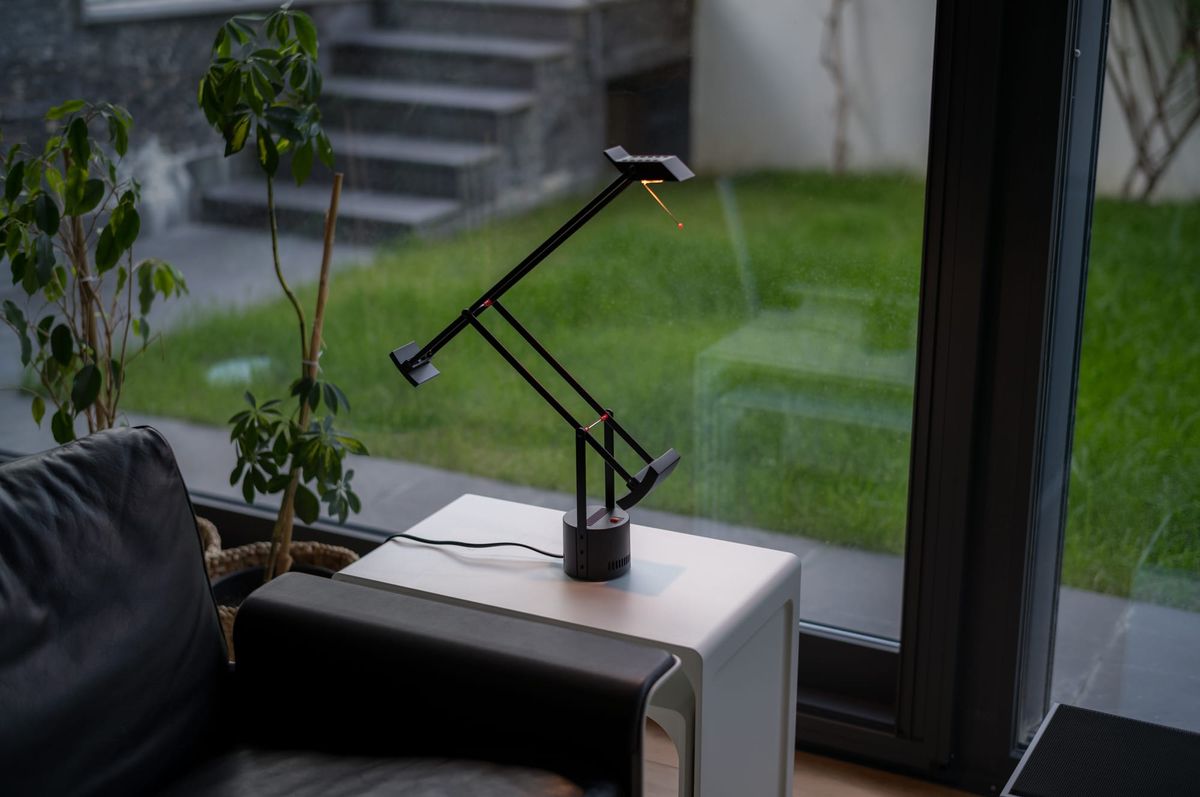
저자는 과거 거장 디자이너들의 조명을 수집하는 애호가로, 값비싼 제품들이지만 단순한 조명이 아닌 컬렉션 목적이며 최근엔 자신도 조명을 디자인했다. 1987년 Michele De Lucchi와 Giancarlo Fassina가 디자인한 Artemide Tolomeo Mini는 가장 모방 많이 받은 책상 조명 중 하나이며 Compasso d'Oro 수상작으로 Apple 스튜디오에도 있었다. Richard Sapper의 1972년 Tizio Micro는 팔이 전선 역할을 하고 추가 무게로 균형을 잡아 한 손가락으로 움직일 수 있으며, 검은색에 빨간 디테일이 Sapper의 시그니처다. 전체 요약 14문장 읽기 → 056 15:11 ▲ 89 · 댓글 2 일반 비전-언어 모델로 로봇 조작 가능하게 하는 MotorMind VLA(비전-언어-액션) 모델은 로봇 조작을 발전시켰으나 새로운 작업과 환경에서 제로샷 일반화가 제한적이고, 전문 훈련에 의존하면서 범용 VLM의 빠른 발전 혜택을 받지 못했다. AI · 머신러닝 · MotorMind: Scaffolding General Vision Language Models for Zero-Shot Robot Manipulation
Key Point 일반 AI 모델만으로 로봇을 제어하는 새로운 방식이 기존 전문화된 방법들을 크게 능가한 성능을 보여주므로, AI와 로봇 응용 경계에서의 구조적 전환을 의미한다.
핵심 요약
VLA(비전-언어-액션) 모델은 로봇 조작을 발전시켰으나 새로운 작업과 환경에서 제로샷 일반화가 제한적이고, 전문 훈련에 의존하면서 범용 VLM의 빠른 발전 혜택을 받지 못했다. 기존 에이전트 로봇 시스템은 고수준 추론을 위해 VLM을, 제어를 위해 코딩 에이전트를 활용하지만 외부 모델과 도구에 의존해 복잡도와 비용이 증가한다. MotorMind는 범용 VLM이 사람 원격조작자처럼 관찰에서 직접 추론하고 액션을 지시하며 실행 피드백에 적응할 수 있게 하는 로봇 조작 프레임워크다. 전체 요약 8문장 읽기 → 057 15:11 ▲ 16 · 댓글 2 수학 문제 풀이 AI, 근처 파라미터로 학습 더 정확해진다 수학 추론 모델을 학습시키는 온정책 자기증류(OPSD)는 기준 해답을 보는 특권화된 교사가 학생이 샘플한 중간 단계를 감독한다. AI · 머신러닝 · Better Supervision Is Nearby: Neighborhood On-Policy Self-Distillation
Key Point 기존 자기증류 방식의 고정된 감독 전략을 파라미터 근처 탐색으로 개선해 AIME 수학 올림피아드 벤치마크에서 2~3포인트 일관된 성능 향상을 달성했으므로, 수학 문제 풀이 AI의 정확도 향상이 어떻게 이루어지는지 실제로 확인할 수 있다.
핵심 요약
수학 추론 모델을 학습시키는 온정책 자기증류(OPSD)는 기준 해답을 보는 특권화된 교사가 학생이 샘플한 중간 단계를 감독한다. 기존 OPSD는 매 상태마다 고정된 파라미터 설정 하나만 사용했으나, 근처의 파라미터 변동이 같은 기준 맥락에서 추가 감독을 제공한다. 지역 파라미터 섭동은 기준과 정렬된 상이한 정정(correction)을 드러내며, 다양한 전문가들이 기준 위치의 여러 지점에서 이를 제공한다. 전체 요약 9문장 읽기 → 058 03:11 ▲ 25 · 댓글 2 이미지·텍스트 동시 생성하는 연속형 확산 모델 공개 Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. AI · 머신러닝 · Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
Key Point 텍스트와 이미지를 진정으로 통합되는 한 가지 방식으로 모두 생성할 수 있다면, 멀티모달 모델의 아키텍처가 단순해지고 더 나은 성능을 낼 수 있다는 점을 실증한다.
핵심 요약
Multimodal Flow는 텍스트와 이미지를 모두 연속적으로 생성하는 통합 생성 모델로, 기존 모델처럼 이미지를 양자화하거나 텍스트·이미지 생성 과정을 달리할 필요가 없다. 텍스트 블록과 이미지를 순서가 있는 연속적 하이퍼청크로 구성하며, Flow Matching을 통해 이들 위의 단일 벡터장을 학습한다. 크로스 모달 상호작용을 위해 공동 어텐션을 사용하고, 각 모달리티별 피드포워드 네트워크로 처리한다. 전체 요약 7문장 읽기 → 059 21:11 당일 +105 Firebase iOS SDK, 2026년 CocoaPods 지원 종료 공지 Firebase Apple 플랫폼의 오픈소스 라이브러리를 담은 저장소로, FirebaseAnalytics를 제외한 모든 Apple SDK 소스 코드를 공개한다. 웹 · 프론트엔드 · firebase/firebase-ios-sdk · C++
Key Point iOS 개발자가 의존하는 Firebase SDK의 배포 방식 변경 일정과 각 Apple 플랫폼별 지원 범위를 파악해야 마이그레이션을 계획할 수 있다.
핵심 요약
Firebase Apple 플랫폼의 오픈소스 라이브러리를 담은 저장소로, FirebaseAnalytics를 제외한 모든 Apple SDK 소스 코드를 공개한다. 2026년 10월 이후 Firebase iOS SDK의 새 버전을 CocoaPods에 배포하지 않으며, 기존 버전은 유지되고 설치된 앱은 정상 동작한다. Swift Package Manager, CocoaPods, GitHub 소스, Carthage 등 다양한 설치 방법을 지원한다. 전체 요약 8문장 읽기 → 060 21:11 ▲ 36 · 댓글 2 이미지 유무가 판단을 휘흔든다, VLM 평가의 숨은 함정 VLM(시각-언어 모델)이 인간 평가자 대신 사용되면서, 평가 환경 자체가 모델 성능에 미치는 영향을 검증해야 한다는 문제 제기. AI · 머신러닝 · It's Not What the Image Shows: Irrelevant Context Destabilises VLM Judges Without Informing Them
Key Point VLM을 평가자로 대체할 때 지침 준수 여부가 아니라 평가 환경 자체가 판단을 흔드는 것으로 나타나, 모델 능력 평가의 신뢰성을 다시 생각해야 한다.
핵심 요약
VLM(시각-언어 모델)이 인간 평가자 대신 사용되면서, 평가 환경 자체가 모델 성능에 미치는 영향을 검증해야 한다는 문제 제기. 연구팀이 MIST(Misleading-Image Stress Test)라는 테스트 세트를 개발했다: 비유와 문자적 의미로 해석 가능한 영문 문장 200개씩, 각 문장마다 일치 이미지, 반대 이미지, 이미지 없음 세 가지 조건으로 평가했다. 지침상 이미지는 무시하고 문장만으로 판단해야 했다. 전체 요약 8문장 읽기 → 061 09:11 ▲ 13 · 댓글 1 LLM 라우팅의 경제성을 높이는 희소 감독 학습 기법 LLM 라우팅은 쿼리를 적절한 모델에 할당해 서빙 비용을 줄이지만, 라우터 학습을 위해선 여러 후보 모델을 반복 실행해 피드백을 모아야 하므로 배포 전 상당한 감독 비용이 발생한다. AI · 머신러닝 · Routing Should Pay for Itself: Sparse Supervision for Economical LLM Routing
Key Point LLM 라우팅 시스템의 총소유비용을 처음으로 정량화하며, 학습 비용과 서빙 절감을 동시에 고려하는 새로운 평가 방식이 산업 배포에 미치는 영향이 크기 때문이다.
핵심 요약
LLM 라우팅은 쿼리를 적절한 모델에 할당해 서빙 비용을 줄이지만, 라우터 학습을 위해선 여러 후보 모델을 반복 실행해 피드백을 모아야 하므로 배포 전 상당한 감독 비용이 발생한다. 기존 연구는 서빙 단계 효율성에만 집중해, 그 절감액이 사전 학습 비용을 회수할 수 있는지 여부를 무시했다. 라우팅 품질은 모든 피드백을 수집하기 훨씬 전에 포화되는 경향을 보여, 밀집한 감독이 경제적으로 과도함을 시사한다. 전체 요약 8문장 읽기 → 062 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 → 063 18:11 ▲ 33 · 댓글 2 LLM 학습 과정의 버려진 데이터를 재활용하는 기법 제안 대규모 언어모델 사후학습에서 강화학습과 온폴리시 증류로 생성된 과거 경험은 정책이 발전하면서 버려지는 문제가 있다. AI · 머신러닝 · ROSS: Relearning from Self-Generated Rollouts through Selective Supervision
Key Point LLM 학습의 데이터 재활용 효율을 높이는 방법론으로, 기존에 버려지던 학습 경험에서 추가 성능을 뽑아낼 수 있다는 점이 실무적 가치가 크다.
핵심 요약
대규모 언어모델 사후학습에서 강화학습과 온폴리시 증류로 생성된 과거 경험은 정책이 발전하면서 버려지는 문제가 있다. 과거 경험은 현재 정책과 호환되면서도 더 이상 안정적으로 표현되지 않는 행동들을 보존할 수 있지만, 실수와 포기된 시도들도 함께 담고 있다. ROSS는 전체 과거 궤적을 맥락으로 유지하면서 모델이 선택적으로 생성한 부분만 손실을 적용하는 방식으로, 더 정밀한 감독 신호를 제공한다. 전체 요약 6문장 읽기 → 064 15:11 ▲ 81 · 댓글 1 교사 모델과 학생의 불일치를 줄이는 지도 라우팅 기법 SAKI 온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. AI · 머신러닝 · SAKI: Maximal-Coupling-Routed Teacher Supervision for On-Policy Distillation
Key Point 학생 모델을 효율적으로 증류하면서 정확도를 높이는 새로운 방법으로, 수학 문제 해결 같은 복잡한 추론 작업의 비용 절감에 직결된다.
핵심 요약
온-폴리시 증류(OPD)는 학생 모델이 생성한 궤적으로 훈련하여 학습-테스트 상태 불일치를 줄이지만, 약한 학생은 교사 모델과 정렬되지 않은 접두사에서 대표성 낮은 감독을 받을 수 있다. SAKI(Supervision Allocation with KL-constrained Interpolation)는 KL 제약 교사 유도 롤아웃과 최대 결합을 결합하여, 실현된 수용/교정 이벤트를 재사용해 토큰 수준의 감독을 라우팅한다. 수용된 위치는 샘플링된 토큰의 역-KL 감독을 유지하고, 교정 위치는 교사의 최고 확률 토큰에 대한 직접 감독을 받는다. 전체 요약 7문장 읽기 → 065 15:11 ▲ 133 · 댓글 1 파노라마 시야로 네비게이션 정확도 11.9% 향상 비전-랭귀지 모델을 이용한 네비게이션(VLN)에서 파노라마식 전 방위 이미지를 활용하는 PanoVLN을 제안했다. AI · 머신러닝 · PanoVLN: Towards Effective Panoramic Vision-and-Language Navigation
Key Point 파노라마 시야를 효과적으로 활용한 새로운 네비게이션 기법이 기존 방식을 13% 이상 앞서고 실제 로봇에서도 성능 향상을 입증했기에, 로봇 네비게이션과 멀티모달 AI의 실질적 진전을 보여준다.
핵심 요약
비전-랭귀지 모델을 이용한 네비게이션(VLN)에서 파노라마식 전 방위 이미지를 활용하는 PanoVLN을 제안했다. 기존의 단순히 파노라마를 대체하는 접근만으로는 성능 향상이 제한적이므로, 세 가지 핵심 개선을 도입했다. 더 넓은 시야각을 활용하기 위해 신뢰도 기반 실행(CGE) 전략을 도입해 한 번의 파노라마에서 더 긴 동작 수열을 예측하고, 더 큰 회전과 이동을 가능하게 했다. 전체 요약 7문장 읽기 → 066 12:11 ▲ 244 · 댓글 1 코드로 그리는 이미지·영상, 생성 과정 검증하는 프레임워크 생성 AI가 만든 프로그램이 정상 실행되더라도 요청한 이미지나 영상의 구성·외형·동작이 맞지 않는 문제(Program-to-Visual 갭)를 다룬다. AI · 머신러닝 · MaLiang-Harness: A Programmable Path to Image and Video Generation
Key Point MLLM의 프로그래밍 기반 이미지·영상 생성 능력을 체계적으로 평가하는 첫 벤치마크를 제시하며, 일반 벤치마크로는 예측할 수 없는 시각 생성 성능의 차이를 노출시킨다.
핵심 요약
생성 AI가 만든 프로그램이 정상 실행되더라도 요청한 이미지나 영상의 구성·외형·동작이 맞지 않는 문제(Program-to-Visual 갭)를 다룬다. MaLiang-Harness는 MLLM이 시각 생성 작업을 구성→검증→수정하는 지속적 과정으로 조직하는 통합 프레임워크다. Persistent Executable Generation(PEG)으로 프로그램과 작업 맥락을 유지하고, Traceable Generation Process(TGP)로 편집을 렌더링 결과에 연결하며, Revision-aware Editing and Verification(REV)으로 복원과 검증을 지원한다. 전체 요약 7문장 읽기 → 067 12:11 ▲ 102 · 댓글 86 메모리 가격 급등, 소비자 시장 붕괴 직전 DRAM과 NAND 제조사들이 장기 계약(LTA)으로 시장 구조를 재편하고 있다: 최대 5년 계약으로 50~70%의 생산량을 상위 5~16개 대형 고객에게 사전 할당해 지난 40년간의 경기 순환 가격 사이클을 깨뜨리려 하고 있다. 하드웨어 · 시스템 · Memory Companies Have Destroyed the Consumer Market
Key Point 제조사들의 장기 계약 전략으로 메모리 가격의 저점이 사라질 수 있으며, PC 게이머부터 의료 기기까지 모든 소비자가 영향을 받게 될 구조 변화가 진행 중입니다.
핵심 요약
DRAM과 NAND 제조사들이 장기 계약(LTA)으로 시장 구조를 재편하고 있다: 최대 5년 계약으로 50~70%의 생산량을 상위 5~16개 대형 고객에게 사전 할당해 지난 40년간의 경기 순환 가격 사이클을 깨뜨리려 하고 있다. 지난 1년간 소비자 메모리 가격이 급락했다: 2TB NVMe SSD 137%, 2TB SATA SSD 183%, 32GB DDR5 363%, 32GB DDR4 294% 인상되었고, DDR5-6000 64GB 키트는 $240에서 $1,300~$1,400으로 483% 올랐다. 서버와 AI용 메모리 수요가 소비자용을 잠식하고 있다: 2027년 NAND 비트 수요 중 서버 애플리케이션 비중이 44.2%에서 51.1%로 증가할 예정이고, 데이터센터 9사의 DRAM·NAND 구매액은 2026년 $433억에서 2027년 $940억으로 급증한다. 전체 요약 11문장 읽기 → 068 03:11 ▲ 28 · 댓글 1 흉부 X선 분석을 위한 문장 중심 비전-언어 모델 SentZero 흉부 X선(CXR) 이미지와 방사선 리포트를 사용한 비전-언어 사전학습이 의료 영상 이해에 유망하지만, 기존 방법들은 긴 임상 리포트를 간단한 제로샷 프롬프트로 정렬하기 어려워 작업별 미세조정에 의존한다. AI · 머신러닝 · SentZero: An Enhanced Sentence-Centric Vision-Language Pretraining for Multi-Task Zero-Shot Chest X-Ray Analysis
Key Point 방사선학 텍스트의 특성을 고려한 새로운 문장 수준 설계와 거짓 음성 완화 기법이 흉부 X선의 미세조정 없는 분석 성능을 크게 향상시킨다.
핵심 요약
흉부 X선(CXR) 이미지와 방사선 리포트를 사용한 비전-언어 사전학습이 의료 영상 이해에 유망하지만, 기존 방법들은 긴 임상 리포트를 간단한 제로샷 프롬프트로 정렬하기 어려워 작업별 미세조정에 의존한다. 최근 문장 수준 접근법이 LLM으로 추출한 임상 구문을 사용해 이를 부분적으로 개선했으나, 방사선학 텍스트의 내재적 특성을 간과하고 양성 쌍의 다양성이 제한되어 있다. 임상적으로 동등한 문장이 환자 간에 반복되면서 대조 학습에서 거짓 음성이 발생하는 문제가 있다. 전체 요약 6문장 읽기 → 069 03:11 ▲ 16 · 댓글 2 GPT-6 Astra의 컴퓨터 비전 능력 평가, 일반형 AI의 한계 드러나 Frontier 수준의 범용 AI 시스템들이 전통적인 컴퓨터 비전 모델의 영역으로 확대되고 있다. AI · 머신러닝 · Hard Vision, Easy Vision: What GPT-6 Astra Reveals Across Computer Vision
Key Point 범용 AI 모델의 컴퓨터 비전 능력 한계를 구체적으로 파악할 수 있으며, 향후 비전 모델 개발의 방향성을 시사한다.
핵심 요약
Frontier 수준의 범용 AI 시스템들이 전통적인 컴퓨터 비전 모델의 영역으로 확대되고 있다. GPT-6 Astra를 포함한 5개 frontier AI 시스템을 9개 비전 영역, 55개 벤치마크, 34개 능력에 걸쳐 평가했다. Astra는 시각 및 공간 추론과 구조화된 예측 분야에서 다른 frontier 시스템들을 크게 앞섰다. 전체 요약 7문장 읽기 → 070 03:11 ▲ 118 · 댓글 2 VisionHOPE: 자기 적응 학습 비전 백본 VisionHOPE는 이미지 처리 중 모델의 메모리와 학습 규칙이 함께 진화하는 자기수정 학습 시스템 형태의 비전 백본이다. AI · 머신러닝 · VisionHOPE: Visual Backbones as Self-Modifying Learning Systems
Key Point CNN에서 Vision Transformer를 거쳐 Test-Time Training까지 진화해온 비전 백본을 자기 적응 학습 시스템으로 재구성하는 새로운 접근이 어떻게 안정성을 확보하고 실제 성능을 올렸는지 보여주는 논문이다.
핵심 요약
VisionHOPE는 이미지 처리 중 모델의 메모리와 학습 규칙이 함께 진화하는 자기수정 학습 시스템 형태의 비전 백본이다. Nested Learning의 자기참조 구조를 기반으로, 내용 저장, 키·값 표현 생성, 학습률 및 메모리 보유를 관장하는 5개의 연결된 메모리를 통해 진화를 구현한다. 직접 적용 시 불안정성이 발생하므로, 자기참조 주입에 소프트 캡을 씌우고 메모리 전환에 스펙트럼 클램프를 적용하는 단계 크기 제어 방식을 개발했으며, 이 메모리 동역학이 비확대(non-expansive)임을 증명했다. 전체 요약 6문장 읽기 → 071 18:11 ▲ 12 · 댓글 1 프로그램 검증으로 강화한 시각-언어 모델 자가학습 시각-언어 모델의 자가학습은 라벨 없는 이미지에서 생성한 질문으로 학습하는데, 기존 방식은 다수결 투표나 모델 심판으로 답을 결정하면서 24~18% 오류율을 낳고 있다. AI · 머신러닝 · Program-Verified Self-Evolution for Vision-Language Models
Key Point 라벨 없는 데이터로 자가학습하는 모델의 답 검증 정확도를 다수결 투표 76%에서 94%로 끌어올린 방법론이므로, 대규모 비지도 학습 시대에 레이블 수집 비용과 오류 문제를 해결하는 접근법으로 주목할 만하다.
핵심 요약
시각-언어 모델의 자가학습은 라벨 없는 이미지에서 생성한 질문으로 학습하는데, 기존 방식은 다수결 투표나 모델 심판으로 답을 결정하면서 24~18% 오류율을 낳고 있다. 이를 해결하기 위해 VQS(Verifiable QA Generation for Self-Evolving Models)는 답변 검증 방식을 바꿔서, 이미지를 장면그래프·차트·다이어그램 같은 구조화된 기록으로 파싱한 뒤 고정된 프로그램이 질문과 답을 생성한다. 모델은 프로그램이 읽은 개별 사실을 주장 단위로 확인하는 시각 검증자 역할을 하며, 이러한 주장 수준의 검증이 파서의 학습 목표를 선택하므로 파서도 라벨 없이 개선된다. 전체 요약 7문장 읽기 → 072 15:11 ▲ 16 · 댓글 1 멀티모달 LLM의 비전 토큰 처리를 MLP로 경량화 멀티모달 대형 언어 모델(MLLM)에서 긴 시각 토큰 시퀀스의 계산 비용을 줄이는 것이 핵심 과제이다. AI · 머신러닝 · Just MLPs: Efficient Visual State Reconstruction for Multimodal Language Models
Key Point 멀티모달 LLM의 추론 속도 병목인 시각 처리를 경량화하면서 정보 손실 없이 정확도를 유지하는 새로운 접근법이 기존 토큰 제거 방식의 한계를 극복한다.
핵심 요약
멀티모달 대형 언어 모델(MLLM)에서 긴 시각 토큰 시퀀스의 계산 비용을 줄이는 것이 핵심 과제이다. 기존 방법은 불필요한 시각 토큰을 제거하는 토큰 가지치기(pruning)를 사용하지만, 이후 층에서 유용할 수 있는 시각 정보를 영구적으로 버린다. 연구진은 저랭크 개입 분석을 통해 시각-텍스트 정보 흐름을 차단한 후 몇 가지 방향만 복구해도 대부분의 정확도가 회복됨을 발견했다. 전체 요약 8문장 읽기 → 073 21:11 당일 +102 앱 스토어 커넥트 API를 터미널에서 조종하기 Go로 만든 빠르고 가벼운 CLI로, App Store Connect API를 스크립트 기반으로 자동화한다. 기타 · rorkai/App-Store-Connect-CLI · Go
Key Point iOS 앱 배포의 수동 반복 작업을 스크립트로 자동화해야 하는 개발자와 CI/CD 파이프라인 구성자가 알아야 할 새로운 도구 및 그 활용 범위를 정리한 것이다.
핵심 요약
Go로 만든 빠르고 가벼운 CLI로, App Store Connect API를 스크립트 기반으로 자동화한다. iOS·macOS·tvOS·visionOS 앱의 TestFlight 배포, 빌드 관리, 메타데이터 동기화, 코드 서명, 스크린샷, 구독 등을 자동화할 수 있다. 개별 API 키로 인증하며, CI/CD 환경에서 keychain 없이도 설정 파일 기반 인증을 지원한다. 전체 요약 12문장 읽기 → 074 00:11 ▲ 109 · 댓글 30 LLM의 토큰 확률 읽어 단일 함수로 선택지 점수 매기기 LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. AI · 머신러닝 · A single function Jev-like wrapper for LLMs, including vision models
Key Point LLM의 로그프로브를 활용해 단 한 줄의 함수로 복잡한 다중 선택 평가를 빠르게 구현할 수 있으며, 비전 모델도 지원해 실시간 이미지 분석 애플리케이션의 선택지 점수 매김에 즉시 적용 가능하다.
핵심 요약
LLM API의 로그프로브(logprobs) 기능을 활용해 한 개 토큰만 생성하도록 강제한 후 각 선택지별 확률을 추출하는 기법을 소개했다. 상태와 질문을 프롬프트로 보내고 max_completion_tokens를 1로 설정한 후 top_logprobs로 대안 토큰들의 확률을 받으면, 여러 질문이 같은 상태 접두사를 공유할 때 KV 캐시를 활용할 수 있다. 이 방식은 텍스트뿐 아니라 비전 모델과도 작동하며, 이미지를 base64로 인코딩해 전송할 수 있도록 Jev 요청 형식에 attachments 필드를 추가했다. 전체 요약 7문장 읽기 → 075 22:26 ▲ 13 · 댓글 2 로봇 시각-언어 모델의 안전성 강화, HJ 도달가능성 기반 셰일드VLA 제안 로봇 조작·이동을 수행하는 VLA(Vision-Language-Action) 모델은 일반화 성능이 뛰어나지만 기존 미세조정 방식은 안전성 보장이 부족하다. AI · 머신러닝 · ShieldVLA: Feasibility-Aware Safety Alignment for Vision-Language-Action Models
Key Point 로봇 AI 모델의 안전성은 실제 배포 시 가장 중요한 과제이며, ShieldVLA는 기존 트레이드오프 방식을 근본적으로 개선하는 새로운 접근법을 제시한다.
핵심 요약
로봇 조작·이동을 수행하는 VLA(Vision-Language-Action) 모델은 일반화 성능이 뛰어나지만 기존 미세조정 방식은 안전성 보장이 부족하다. 현재 방식은 라그랑주 최적화로 누적 비용에 소프트 페널티를 부과하는데, 이는 제약 위반이나 과도하게 보수적 행동을 초래하고 시각 도메인에서 단계별 안전 레이블이 없어 학습이 어렵다. Hamilton-Jacobi(HJ) 도달가능성에 기반한 ShieldVLA를 제안하며, 시각 관찰로부터 HJ 도달가능성 가치함수를 모델-프리 방식으로 근사하여 안전 작동 영역을 추정한다. 전체 요약 6문장 읽기 → 076 22:26 ▲ 11 · 댓글 2 과거 정보 기억하는 로봇 제어 모델 'MemBodied' 제안 비전-언어-행동 모델은 현재 관찰만으로 로봇 제어를 하는데, 과거 정보가 필요한 조작 작업에서 한계를 보인다. AI · 머신러닝 · MemBodied: Recurrent Associative Memory for Vision-Language-Action Models
Key Point 과거 관찰 정보가 필요한 로봇 제어 작업에서 컨텍스트 확장의 비효율성을 해결하면서 매개변수 효율성까지 확보한 새로운 메모리 메커니즘이다.
핵심 요약
비전-언어-행동 모델은 현재 관찰만으로 로봇 제어를 하는데, 과거 정보가 필요한 조작 작업에서 한계를 보인다. 과거 관찰을 컨텍스트에 포함하면 해결되지만 컨텍스트 크기 증가와 추론 지연이라는 문제가 발생한다. MemBodied는 고정 크기의 기억 구조로, 상호작용을 기록하는 연관 상태(associative state)와 초기 장면을 보존하는 에피소드 앵커(episode anchor) 두 개 요소로 구성된다. 전체 요약 8문장 읽기 → 077 22:26 ▲ 19 · 댓글 2 LLM 에이전트의 추론 오류 자동 수정하는 세계 모델 LLM 에이전트는 장기 작업 수행 시 역사 정보 속 오래된 가정과 계획이 이후 결정을 왜곡하는 '작업 상태 오염' 문제를 겪는다. AI · 머신러닝 · Agent-Editing World Model: Rethinking World Modeling for LLM Agents
Key Point LLM 에이전트의 추론 오류를 자동으로 감지하고 수정하는 실용적 방법을 제시하며, 여러 복잡한 작업에서 일관된 성능 향상을 보여준다.
핵심 요약
LLM 에이전트는 장기 작업 수행 시 역사 정보 속 오래된 가정과 계획이 이후 결정을 왜곡하는 '작업 상태 오염' 문제를 겪는다. 기존 세계 모델은 도구 응답을 예측하지만, 실제 피드백이 있을 때는 제한적 가치를 가진다. Agent-Editing World Model(AEWM)은 도구 응답 시뮬레이션 대신 추론과 행동이 작업 진행을 어떻게 형성하는지 모델링한다. 전체 요약 8문장 읽기 → 078 21:11 ▲ 24 · 댓글 3 로봇 조작 실패 복구하는 AI 정책 프레임워크 공개 로봇 팔 조작 중 계획이 틀어지면 성능이 급격히 떨어지는 Vision-Language-Action(VLA) 정책의 문제를 해결하는 CARE 프레임워크를 개발했다. AI · 머신러닝 · CARE: Experience-Guided Atomic Corrective Execution for Vision-Language-Action Policies
Key Point 로봇 조작 작업의 안정성을 현저히 높이는 새로운 기법으로, 산업용 로봇이나 자동화 시스템의 신뢰도 문제를 실질적으로 개선할 수 있다.
핵심 요약
로봇 팔 조작 중 계획이 틀어지면 성능이 급격히 떨어지는 Vision-Language-Action(VLA) 정책의 문제를 해결하는 CARE 프레임워크를 개발했다. 실제 실패 사례를 수집해 그 패턴을 학습하고, 이를 바탕으로 대표적 실패 상황과 복구 방법을 합성해 훈련시킨다. 추론 시 3D 모니터링으로 실패를 감지하면 작업 진행도를 유지하면서 단계별로 미세 조정하거나 다시 시도한다. 전체 요약 5문장 읽기 → 079 08:25 당일 +195 컴퓨터 비전 개발을 빠르게, Supervision 라이브러리 Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. 오픈소스 · 도구 · roboflow/supervision · Python
Key Point 컴퓨터 비전 프로젝트의 반복적인 작업을 표준화된 도구로 통일할 수 있어, 모델 선택에 관계없이 동일한 코드로 여러 프레임워크를 활용할 수 있다.
핵심 요약
Roboflow가 제공하는 Python 기반 오픈소스 라이브러리로, 모델 불가지론적 설계로 모든 분류·탐지·분할 모델을 연결할 수 있다. Ultralytics, Transformers, MMDetection 등 인기 라이브러리와 기본 통합되며, 커스텀 모델도 손쉽게 연결할 수 있다. 데이터 로딩부터 실시간 구역 카운팅까지 컴퓨터 비전 작업의 전체 파이프라인을 지원한다. 전체 요약 5문장 읽기 → 080 08:25 당일 +122 App Store에서 iOS·macOS 앱 직접 다운로드받는 CLI 도구 App Store의 iOS, iPadOS, tvOS, visionOS, macOS 앱을 명령어로 검색할 수 있는 Go 기반 CLI 도구입니다. 오픈소스 · 도구 · majd/ipatool · Go
Key Point App Store 앱을 명령어와 자동화로 직접 관리하려는 개발자나 사용자에게 필요한 도구입니다.
핵심 요약
App Store의 iOS, iPadOS, tvOS, visionOS, macOS 앱을 명령어로 검색할 수 있는 Go 기반 CLI 도구입니다. .ipa(iOS 앱) 또는 .pkg(macOS 앱) 패키지를 직접 다운로드 받을 수 있습니다. macOS, Linux, Windows, iOS에서 실행되며 Apple 계정이 필요합니다. 전체 요약 5문장 읽기 → 081 06:10 ▲ 255 · 댓글 259 Siri AI 탑재한 iOS·iPadOS·macOS 27 공개 Apple Intelligence의 차세대 버전인 Siri AI가 iPhone, iPad, Mac, Apple Watch, Apple Vision Pro에 통합되어 개인 맥락 이해, 광범위한 세계 지식, 화면 인식 능력을 갖추고 롤아웃 시작했다. AI · 머신러닝 · iOS 27, iPadOS 27, and macOS 27
Key Point Apple의 차세대 운영체제에서 AI 에이스 어시스턴트의 구체적 기능과 한국어 지원 일정을 확인할 수 있다.
핵심 요약
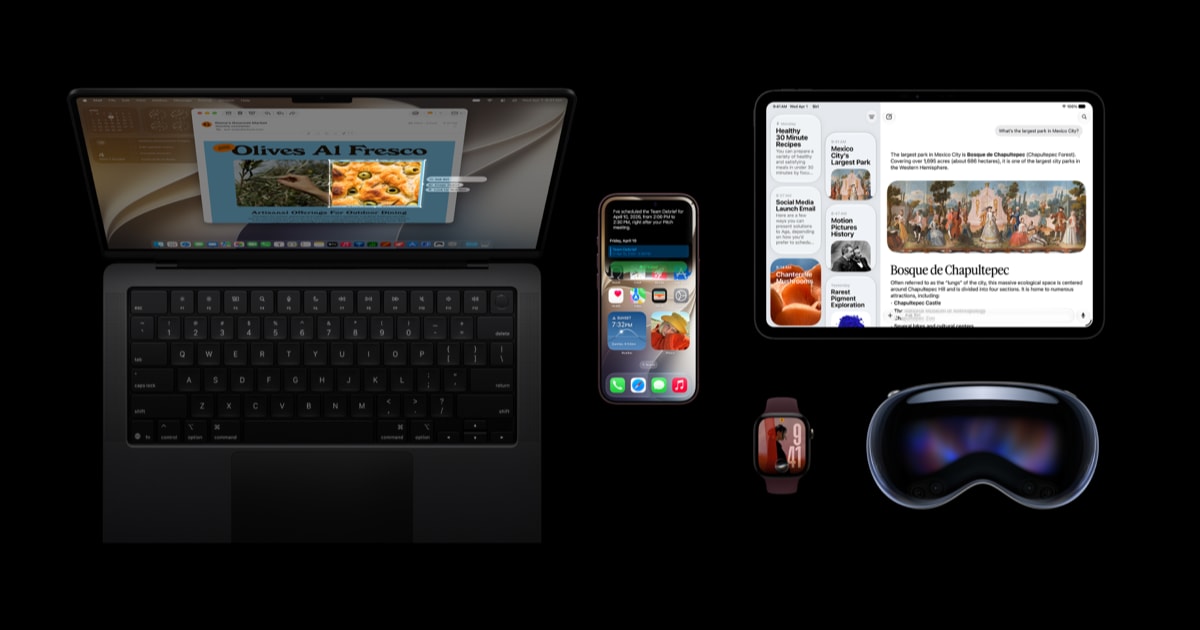
Apple Intelligence의 차세대 버전인 Siri AI가 iPhone, iPad, Mac, Apple Watch, Apple Vision Pro에 통합되어 개인 맥락 이해, 광범위한 세계 지식, 화면 인식 능력을 갖추고 롤아웃 시작했다. Siri AI는 영어로 베타 출시되며 프랑스어, 일본어, 한국어, 포르투갈어, 스페인어 지원은 10월 예정이다. 카메라 앱의 Siri 모드는 시각적 정보를 인식해 계산 분할, 지갑 추가 등 실시간 액션을 지원하고, Write with Siri는 음성 설명으로 문서 초안 작성을 돕는다. 전체 요약 5문장 읽기 → 082 15:10 ▲ 117 · 댓글 35 애플, 전체 기기 3D 도면과 기술 사양 공개 애플이 개발자 사이트에서 iPhone, iPad, Mac, Apple Watch, AirPods, Vision Pro 등 전체 제품군의 차원 도면(Dimensional Drawings)과 기술 사양을 다운로드할 수 있도록 공개했다. 하드웨어 · 시스템 · Apple's Dimensional Drawings
Key Point 하드웨어 개발자와 액세서리 제조사가 애플 제품과의 물리적 호환성을 정확히 설계하려면 정밀한 도면 정보가 필수이기 때문이다.
핵심 요약
애플이 개발자 사이트에서 iPhone, iPad, Mac, Apple Watch, AirPods, Vision Pro 등 전체 제품군의 차원 도면(Dimensional Drawings)과 기술 사양을 다운로드할 수 있도록 공개했다. iPhone 17 시리즈, iPad Air·Pro의 최신 M4·M5 칩셋 버전, Apple Watch Series 11, AirPods Pro 3, Apple Vision Pro 등 최신 기기부터 과거 모델까지 포함된다. 액세서리도 MagSafe 충전기, AirTag, Siri Remote 등 주요 제품이 모두 제공되어 써드파티 개발자와 하드웨어 제조사가 애플 생태계와 호환되는 제품을 설계할 수 있다.