쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "연구"조건 지우기 ×
001 09:11 ▲ 110 · 댓글 29 LLM의 내부 상태 지도: 수천 개 대화의 벡터 풍경 Qwen 3.1-1.7B 모델의 residual stream(중앙 공유 작업 공간)에서 수천 개 대화의 내부 표현을 시각화한 대화형 지도를 구축했다. AI · 머신러닝 · What thousands of conversations look like inside a language model
Key Point LLM이 대화를 처리할 때 내부 벡터 공간에서 어떤 구조를 형성하는지, 다국어와 코드가 어떻게 배치되는지 구체적으로 보여줌으로써 모델의 표현 방식과 한계를 이해할 수 있다.
핵심 요약
Qwen 3.1-1.7B 모델의 residual stream(중앙 공유 작업 공간)에서 수천 개 대화의 내부 표현을 시각화한 대화형 지도를 구축했다. 100개 주제에 걸친 영어·중국어·독일어·크로아티아어 문답 900개와 Python 코딩 예제 90개를 처리해 각 토큰 위치의 2,048차원 벡터를 기록하고 3차원 공간으로 투영했다. 각 토큰은 임베딩 테이블에서 시작 벡터를 받아 모델의 레이어들이 문맥에 따라 변환하는데, 최종 토큰 상태들을 연결한 선은 각 대화의 경로를 나타낸다. 전체 요약 11문장 읽기 → 002 09:11 ▲ 101 · 댓글 26 생명의 기원, 화학 너머 생물학을 찾다 생명의 기원을 설명하려는 과학자들은 지난 수십 년간 RNA, 대사, 지질 등 어떤 분자가 먼저 나타났는지를 두고 격렬히 논쟁했다. 기타 · The Evolving Story of How Chemistry Became Biology
Key Point 생명의 기원이라는 수십 년 묵은 논쟁이 학제 간 협력으로 전환되고 있으며, 동시에 LUCA 같은 핵심 개념을 둘러싼 우리의 이해가 급속히 진화하고 있기 때문이다.
핵심 요약
생명의 기원을 설명하려는 과학자들은 지난 수십 년간 RNA, 대사, 지질 등 어떤 분자가 먼저 나타났는지를 두고 격렬히 논쟁했다. 1952년 스탠리 밀러가 수행한 유명한 실험은 원시 지구 조건에서 아미노산 같은 생명의 구성 요소가 형성될 수 있음을 보였다. 이후 DNA의 구조 발견으로 유전 분자의 중요성이 부각되면서 필드는 '단일 분자 기원설'을 중심으로 분화했다: RNA 세계, 대사 우선 세계, 지질 세계, 단백질 세계 등이 경쟁했다. 전체 요약 8문장 읽기 → 003 06:11 ▲ 100 · 댓글 44 다트머스 수학 박사 과정, 올해 신입생 모집 중단 다트머스 가우리니 대학원 수학 박사 과정이 2027-2028학년도 신입생 모집을 중단했다. 기타 · Dartmouth (Guarini) will not admit math PhD cohort this year
Key Point 대학 규모 경영난이 대학원 프로그램 폐지·축소로 이어지는 추세를 보여주며, 학부생의 고급 교과목 접근성 악화와 연쇄 효과를 드러낸다.
핵심 요약
다트머스 가우리니 대학원 수학 박사 과정이 2027-2028학년도 신입생 모집을 중단했다. 가우리니 학장 캐리 콜라는 11월 10일 성명서에서 '예술과학부 학과 평가 진행' 중이라며 모집 재개 시점을 명확히 하지 않았다. 수학과 교수 피터 윙클러가 반발했으며, 일반 교직원 회의(11월 9일)에서 여러 교수가 중단 결정에 우려를 제기했다. 전체 요약 9문장 읽기 → 004 00:11 당일 +127 LLM 시대 인프라 설계의 첫 걸음, 공개 교과서 LLM 추론과 훈련 시스템을 하드웨어 제약과 모델 구조에서 출발해 정량적으로 설계하는 방법을 다룬 오픈소스 교과서를 공개했다. AI · 머신러닝 · bojieli/ai-infra-book · Python
Key Point 대규모 언어 모델을 실제로 배포할 때 지연 시간과 비용이 몇 배 차이나는 원인을 하드웨어와 시스템 설계에서 찾고 정량적으로 분석하는 방법을 배울 수 있다.
핵심 요약
LLM 추론과 훈련 시스템을 하드웨어 제약과 모델 구조에서 출발해 정량적으로 설계하는 방법을 다룬 오픈소스 교과서를 공개했다. 전체 12장으로 구성되며 초기 입출력, 모델 아키텍처, 추론·훈련 부하, 가속기 아키텍처, 알고리즘과 런타임, 다중 기기 협력, 데이터센터 네트워크, 추론 최적화, 분산 추론, 훈련 시스템, 자원 스케줄링, 엣지-클라우드 협력을 다룬다. 책의 핵심 방법론은 '제약에서 설계로'로, 작업과 품질 요구사항을 정의한 뒤 계산·저장·통신 비용을 하드웨어 성능과 비교해 수량적으로 추정한다. 전체 요약 9문장 읽기 → 005 21:11 ▲ 108 · 댓글 11 2020년대에도 NES용 신작 게임이 쏟아진다 NES(닌텐도 엔터테인먼트 시스템)는 현재 '제2의 르네상스'를 겪고 있으며, 수십 년간 축적된 지식과 연구 덕분에 많은 신작 게임이 계속 출시되고 있다. 하드웨어 · 시스템 · My favourite modern NES games
Key Point 현대에 여전히 활발히 제작되는 NES 신작 게임들의 다양한 장르와 창의적인 설계가 어떻게 30년 전 하드웨어의 한계를 극복하고 있는지 보여준다.
핵심 요약
NES(닌텐도 엔터테인먼트 시스템)는 현재 '제2의 르네상스'를 겪고 있으며, 수십 년간 축적된 지식과 연구 덕분에 많은 신작 게임이 계속 출시되고 있다. 저자가 선정한 25개 현대 NES 게임들은 대부분 디지털로 저렴하게 구매 가능하며, 많은 게임이 물리 카트리지로도 출시되어 원본 하드웨어에서 플레이할 수 있다. 'All Hell Unleashed'는 1980~90년대 공포 영화 캐릭터(제이슨, 프레디, 고스트페이스 등)와 싸우는 공포 플랫포머다. 전체 요약 16문장 읽기 → 006 18:11 ▲ 119 · 댓글 55 안전한 러스트 코드도 undefined behavior 유발할 수 있다 마이크로소프트 FORGE 랩이 AI 기반 보안 스캔 도구 하이에나를 사용해 러스트 표준 라이브러리의 메모리 안전 버그를 발견했다. 보안 · Memory Safety Bugs in Rust Standard Library
Key Point 러스트를 선택하는 이유인 메모리 안전성이 표준 라이브러리의 unsafe 코드 버그로 우회될 수 있으며, 기존 11년 미검출 버그도 존재한다는 점에서 안전성 보장의 한계를 드러낸다.
핵심 요약
마이크로소프트 FORGE 랩이 AI 기반 보안 스캔 도구 하이에나를 사용해 러스트 표준 라이브러리의 메모리 안전 버그를 발견했다. 안전한 러스트 코드만으로도 undefined behavior를 트리거할 수 있으며, 불안전 코드가 안전 API 아래에서 안전 계약을 위반할 때 발생한다. MapWindows::clone의 panic safety 버그: 클론 호출 중 패닉이 발생하면 미초기화 메모리에 접근하는 디스트럭터가 작동해 crash가 난다. 전체 요약 12문장 읽기 → 007 09:11 당일 +139 AI 에이전트가 탑재된 데스크톱 앱 OpenWorker 공개 andrewyng가 만든 OpenWorker는 AI 코워커 데스크톱 앱과 에이전트 구축용 Harness SDK를 제공한다. AI · 머신러닝 · andrewyng/openworker · Python
Key Point 로컬 우선 설계, 사용자 승인 기반 거버넌스, 샌드박싱으로 에이전트 자동화의 안전성 문제를 해결하는 데스크톱 앱 프레임워크이기 때문에 에이전트 앱 개발자와 AI 도구 사용자 모두에게 중요하다.
핵심 요약
andrewyng가 만든 OpenWorker는 AI 코워커 데스크톱 앱과 에이전트 구축용 Harness SDK를 제공한다. 데스크톱 앱은 로컬 머신에서 실행되며, 연구·작성·코드 리뷰·작업 자동화를 지원하고 사용자가 보유한 모델 키나 Ollama 같은 로컬 모델을 사용할 수 있다. GitHub, Slack, 이메일, 캘린더 등 연결된 도구들을 통합하고 MCP를 통해 새 도구를 추가할 수 있으며, Slack에서 @OpenWorker를 호출해 데스크톱 작업을 위임할 수 있다. 전체 요약 12문장 읽기 → 008 09:11 ▲ 101 · 댓글 51 1형 당뇨병 환자가 혈당 예측 모델 15개 비교 공개 1형 당뇨병 환자가 혈당을 2시간 앞서 예측하는 모델 15개를 직접 훈련·테스트한 결과를 GitHub에 공개했다. AI · 머신러닝 · Show HN: I have trained 15 blood glucose forecasting models on my own data
Key Point 1형 당뇨병 관리를 AI로 개선하려는 개인 연구자의 시도이자, 의료 시계열 예측 문제에서 경량 트랜스포머가 대규모 기초 모델·고전 방식과 어떻게 경쟁하는지를 실제 데이터로 보여준다.
핵심 요약
1형 당뇨병 환자가 혈당을 2시간 앞서 예측하는 모델 15개를 직접 훈련·테스트한 결과를 GitHub에 공개했다. 저자의 모델은 트랜스포머 기반 경량 모델(D16, 31k 파라미터)이며, DILATE와 MSE 손실 함수 두 가지 버전이 있고 합성 데이터로 사전 훈련 후 LoRA 어댑터로 미세 조정된다. 저자 개인 데이터(35일, 9764개 예측)에서는 XGBoost와 LightGBM(RMSE 22.4 mg/dL at 60min)에 이어 D16 DILATE+LoRA가 3위(22.8)였고, 통계적으로 최고 성능 모델과 구별되지 않았다. 전체 요약 12문장 읽기 → 009 06:11 ▲ 127 · 댓글 31 구글의 멀티에이전트 AI, 수십 년 묵은 수학 문제를 증명하다 구글 리서치는 Antigravity의 /teamwork 멀티에이전트 시스템을 통해 수학, 화학, 소프트웨어, ML 등 여러 분야의 미해결 문제를 해결했다. AI · 머신러닝 · Advancing science and engineering with Antigravity's /teamwork
Key Point 구글이 멀티에이전트 AI로 정보이론, 양자 알고리즘, 형식 수학 등 수십 년 묵은 미해결 문제들을 순차적으로 증명·발견했으며, 이 도구를 모든 연구자에게 공개하면서 AI-인간 협업 연구의 새로운 패러다임을 제시했다.
핵심 요약
구글 리서치는 Antigravity의 /teamwork 멀티에이전트 시스템을 통해 수학, 화학, 소프트웨어, ML 등 여러 분야의 미해결 문제를 해결했다. Gemini 4 Argon, Carbon, Hydrogen 모델과 /teamwork을 함께 사용해 정보이론, 형식 검증, 분자 구조 발견, 커널 최적화 등에서 혁신을 이뤘다. /teamwork의 설계는 언어 모델의 두 가지 한계를 해결한다: 첫째 병렬 탐색과 검증자(Lean 4 증명 체커, 테스트 스위트 등)를 짝지어 생성의 불확실성을 극복하고, 둘째 각 에이전트에 필요한 도구와 파일만 전달해 장기 작업에서 맥락 손실을 방지한다. 전체 요약 14문장 읽기 → 010 06:11 ▲ 414 · 댓글 137 AI 코딩 플랫폼 라벨, 15만 개 프로젝트 중 상당수 개인정보 노출 스웨덴 AI 스타트업 라벨이 개발한 AI 기반 웹 앱 제작 플랫폼에서 15만여 개 프로젝트를 분석한 결과, 다수의 앱이 로그인 없이 민감한 개인정보에 접근 가능한 상태로 남아 있었다. 보안 · Lovable apps expose passport details and more than 200K private messages
Key Point 프로그래밍 미경험자도 쉽게 앱을 만들 수 있다는 장점이 역으로 대규모 보안 결함으로 이어지고 있으며, AI 코딩 플랫폼 사용자들이 반드시 알아야 할 현실적 위험을 드러낸다.
핵심 요약
스웨덴 AI 스타트업 라벨이 개발한 AI 기반 웹 앱 제작 플랫폼에서 15만여 개 프로젝트를 분석한 결과, 다수의 앱이 로그인 없이 민감한 개인정보에 접근 가능한 상태로 남아 있었다. 라벨은 프로그래밍 경험이 없어도 쉽게 웹 애플리케이션을 만들 수 있다고 홍보하지만, 실제로는 고객이 데이터 보안에 대한 모든 책임을 진다. 연구팀은 Common Crawl 데이터로부터 2025년 12월~2026년 9월 사이 라벨 프로젝트 159,041개를 조사했고, 이 중 Supabase 데이터베이스를 사용한 34,545개를 분석했다. 전체 요약 11문장 읽기 → 011 21:11 ▲ 113 · 댓글 12 전 세계 정보기관이 광고 기반 감시 시스템 '웹록' 운영 시민랩(Citizen Lab)과 블룸버그의 공동 조사로 펜링크(Penlink)의 광고 기반 감시 시스템인 '웹록(Webloc)'을 전 세계 정보기관들이 사용 중임이 드러났다. 보안 · Security Agencies Worldwide Found to Use Ad-Based Surveillance System
Key Point 정보기관과 경찰이 광고 추적 기술을 대규모 감시에 사용하고 있으며, 민간 기업도 이를 운영하는 현황이 공개돼 프라이버시와 권력 남용의 문제가 새롭게 대두된다.
핵심 요약
시민랩(Citizen Lab)과 블룸버그의 공동 조사로 펜링크(Penlink)의 광고 기반 감시 시스템인 '웹록(Webloc)'을 전 세계 정보기관들이 사용 중임이 드러났다. 웹록은 미국 정보기관에서 시작해 연방 법집행 기관, 주(州) 및 지방경찰로 점진적으로 확산되는 '강력한 대량감시 도구'라고 시민랩 선임연구원 울피 크리스틀(Wolfie Christl)이 평가했다. 공개 정보 수집, 정보공개청구, 서버 인프라 분석을 통해 미국, 엘살바도르, 헝가리 및 오스트리아 내무부의 웹록 사용이 확인됐다. 전체 요약 5문장 읽기 → 012 18:11 ▲ 127 · 댓글 24 스리랑카 코끼리, 개체 감소로 사회 관계망 급격히 붕괴 UC 샌디에고 연구팀이 스리랑카 우다왈라웨 국립공원의 암컷 아시아코끼리 440마리 이상을 12년간 추적 조사했다. 기타 · Elephants found to be increasingly isolated leading to fractured social networks
Key Point 개체 수 감소가 단순한 개수 문제가 아니라 사회 구조 붕괴로 이어지는 임계점이 있다는 발견은 멸종위기 생물 보전 전략을 재고하게 만든다.
핵심 요약
UC 샌디에고 연구팀이 스리랑카 우다왈라웨 국립공원의 암컷 아시아코끼리 440마리 이상을 12년간 추적 조사했다. 개체군 감소로 인해 코끼리의 사회 네트워크가 밀도 높은 대규모 집단에서 작고 고립된 소규모 집단으로 급변하는 '티핑 포인트'를 발견했다. 개체 손실이 서서히 쌓이다가 임계값을 넘으면서 사회 구조가 갑자기 변화했으며, 남은 개체들도 서로의 관계를 재편성하고 있다. 전체 요약 7문장 읽기 → 013 15:11 ▲ 21 · 댓글 4 로봇 에이전트, 채점 기준 노출에 과적합되나 자체 개선 로봇 에이전트 개발 시 벤치마크 채점 기준을 에이전트에 노출하는 'Criteria Exposure(CE)' 관행이 늘고 있다. AI · 머신러닝 · Learning the Task or Learning the Verifier? Rethinking Criteria Exposure in Embodied Self-Improvement
Key Point 로봇 에이전트가 실제 과제를 해결하는지 검증 수치를 조작하는지 구분하는 것이 점점 중요해지는 상황에서, CE 관행의 문제점과 해결책을 실증적으로 밝히는 연구입니다.
핵심 요약
자체 개선 로봇 에이전트 개발 시 벤치마크 채점 기준을 에이전트에 노출하는 'Criteria Exposure(CE)' 관행이 늘고 있다. 이 기준들은 모방 학습 정책 검증용으로 작성되어 원래 언어 지시사항보다 더 많은 요구사항을 담고 있어, 에이전트가 생성한 로봇 제어 코드의 실제 성능을 정확히 반영하지 못한다. 연구진이 CE 적용 여부를 비교 실험한 결과, CE 적용 시 에이전트는 초기에 주어진 기준 하에서 높은 성공률을 보이지만, 기준을 약간 변경하면 이 우위가 사라진다. 전체 요약 5문장 읽기 → 014 12:11 ▲ 16 · 댓글 5 멀티모달 비전 인코더의 세 가지 선택지를 분해하다 멀티모달 언어 모델의 비전 인코더 설계 방식을 통제된 환경에서 비교했다. 기존 모델들은 사전 학습된 인코더, 처음부터 학습된 인코더, 또는 인코더 없는 방식을 각각 사용하는데, 서로 다른 데이터·구조·계산량으로 인해 각 선택의 영향을 정확히 평가하기 어려웠다. AI · 머신러닝 · Unbundling Multimodal Vision Encoding
Key Point 멀티모달 모델에서 비전 처리 방식의 세 가지 핵심 선택지(사전 학습 여부, 용량 크기, 융합 위치)를 통제된 비교를 통해 각각의 영향을 명확히 규명해 향후 모델 설계에 실질적인 지표를 제시한다.
핵심 요약
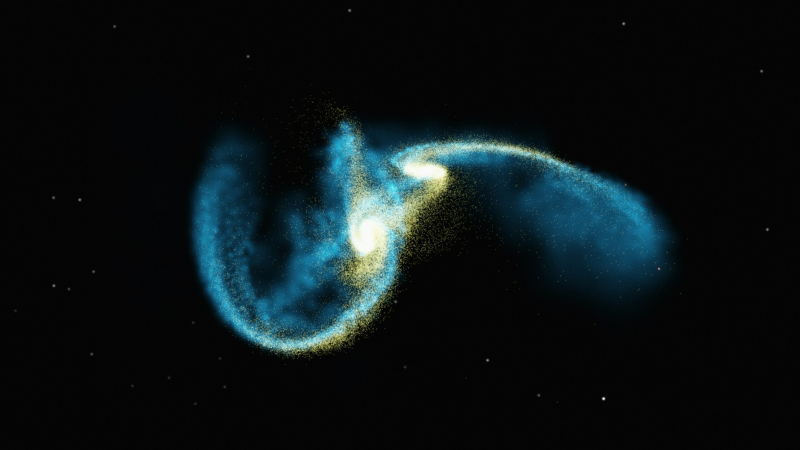
멀티모달 언어 모델의 비전 인코더 설계 방식을 통제된 환경에서 비교했다. 기존 모델들은 사전 학습된 인코더, 처음부터 학습된 인코더, 또는 인코더 없는 방식을 각각 사용하는데, 서로 다른 데이터·구조·계산량으로 인해 각 선택의 영향을 정확히 평가하기 어려웠다. 연구팀은 모든 모델을 동일한 데이터로 처음부터 학습하고 같은 계산량에서 VQA(시각 질답)와 언어 벤치마크로 비교했다. 사전 학습된 비전 사전 지식은 필수가 아니며, 처음부터 함께 학습한 인코더가 별도 학습 단계 없이 사전 학습된 것과 같은 수준이다. 전체 요약 7문장 읽기 → 015 06:11 ▲ 101 · 댓글 109 우주 나이, 암흑물질 없이 136억 년 → 266억 년으로 오타와 대학교 연구진이 새 우주 모델 'CCC+TL'을 제시했는데, 우주 나이를 일반적 추정치의 약 2배인 266억 년으로 계산한다. 기타 · Scientists claim the universe is twice as old as believed
Key Point 기존 암흑물질·암흑에너지를 배제하고 우주 나이를 2배로 재산정하는 모델이 주요 천체 현상들을 설명할 수 있다는 점에서, 우주론의 근본 가정에 대한 도전적 관점이 어떤 증거로 뒷받침되는지 알 필요가 있다.
핵심 요약
오타와 대학교 연구진이 새 우주 모델 'CCC+TL'을 제시했는데, 우주 나이를 일반적 추정치의 약 2배인 266억 년으로 계산한다. 기존 암흑물질·암흑에너지에 의존하지 않고, 시간이 지남에 따라 물리 상수가 천천히 변하고 빛이 우주 공간을 건너며 에너지를 잃는다는 가설에 기반한다. 컴퓨터 시뮬레이션 검증 결과 이 모델은 빅뱅에서 생성된 수소·헬륨 존재량을 정확히 예측하고, 암흑에너지 없이도 우주 팽창률을 설명할 수 있다. 전체 요약 7문장 읽기 → 016 06:11 ▲ 154 · 댓글 30 600번의 실험으로 발견한 JEPA 월드 모델의 최적 설계 JEPA(joint-embedding predictive architecture)는 픽셀 생성 대신 임베딩 공간에서 예측하는 월드 모델로, 인코더·예측기·플래너 세 부분으로 구성된다. AI · 머신러닝 · After 600 experiments, here's what I discovered about JEPA world models
Key Point JEPA 월드 모델의 병목이 예측이 아니라 계획 방식임을 실험으로 증명했고, 재학습 없이 네 가지 방법으로 성공률을 3배 이상 향상시킨 구체적 기법들을 제시한다.
핵심 요약
JEPA(joint-embedding predictive architecture)는 픽셀 생성 대신 임베딩 공간에서 예측하는 월드 모델로, 인코더·예측기·플래너 세 부분으로 구성된다. LeWM 모델을 600회 실험한 결과, 예측 정확도 개선보다 계획 방식 변경이 더 큰 효과를 발휘했다. LeWM의 예측기를 완벽한 물리 시뮬레이터로 바꿔도 성공률이 78%에서 77%로 거의 변하지 않아, 병목은 모델의 예측이 아닌 사용 방식임을 확인했다. 전체 요약 12문장 읽기 → 017 06:11 ▲ 105 · 댓글 41 OpenAI 로봇팀 해체, 범용 AI로의 전환 선언 OpenAI가 독립적인 로봇팀을 해체하고 연구원들을 다른 팀으로 재배치했다. 로봇 연구팀은 최고연구책임자 Mark Chen 산하 메인 연구팀으로, 응용로봇팀과 하드웨어팀은 President Greg Brockman 산하 Applied 조직으로 이동했다. AI · 머신러닝 · OpenAI disbands its robotics team as its general models start running robots
Key Point 범용 AI 모델이 로봇 제어 영역까지 침투하면서 로봇공학의 기술 스택과 경쟁 구도 자체가 재편될 수 있기 때문이다.
핵심 요약
OpenAI가 독립적인 로봇팀을 해체하고 연구원들을 다른 팀으로 재배치했다. 로봇 연구팀은 최고연구책임자 Mark Chen 산하 메인 연구팀으로, 응용로봇팀과 하드웨어팀은 President Greg Brockman 산하 Applied 조직으로 이동했다. OpenAI는 이를 로봇공학에 대한 헌신의 증거로 표현했으며, 로봇공학이 회사의 장기 비전의 핵심이라고 밝혔다. 2024년 창업사 Figure와 협력해 휴머노이드 로봇 AI 개발을 추진했으나 2025년 2월 Figure가 자체 개발로 전환하면서 협력이 종료됐다. AI 산업 전반에서 언어, 코드, 비전 분야의 범용 모델을 로봇 같은 물리적 장치를 제어하는 '구체화된 AI(embodied AI)'에 직접 적용할 수 있다는 가정이 확산 중이다. 이는 로봇 전용 특화 모델을 따로 개발할 필요가 없다는 의미다. 전체 요약 7문장 읽기 → 018 06:11 ▲ 240 · 댓글 64 AI가 괴델의 노트북 해독, 수백 개 미발표 정리 발견 오스트리아 논리학자 쿠르트 괴델이 1940년대 초 작성한 16개 노트북 1,009페이지는 대부분 당시에도 폐기된 독일 속기법 가벨스베르거로 쓰여있어, 2017년부터 핀란드 논리학자 얀 폰 플라토가 이끄는 헬싱키 대학 프로젝트에서 주당 1페이지 속도로 해독해왔다. AI · 머신러닝 · AI unlocks Gödel's notebooks, said to contain hundreds of proved theorems
Key Point 수십 년간 인류가 해독하지 못한 역사적 수학자의 숨은 업적이 AI로 발굴되면서, AI의 패턴 인식 능력이 인간의 순차적 사고로 불가능한 영역까지 확장시킬 수 있음을 보여준다.
핵심 요약
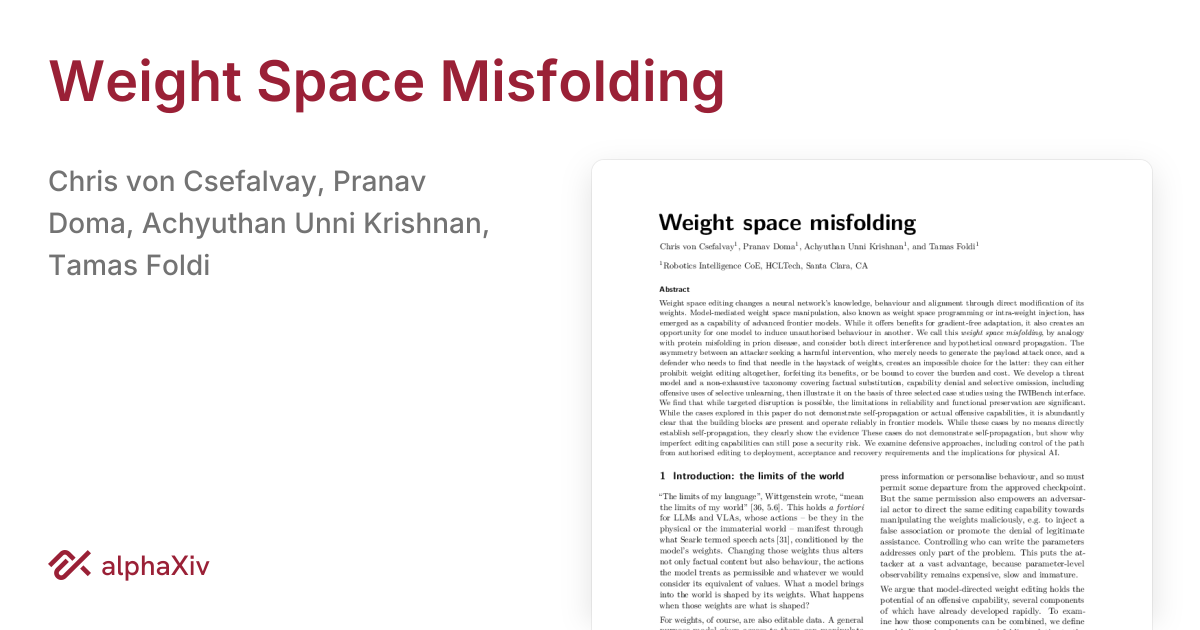
오스트리아 논리학자 쿠르트 괴델이 1940년대 초 작성한 16개 노트북 1,009페이지는 대부분 당시에도 폐기된 독일 속기법 가벨스베르거로 쓰여있어, 2017년부터 핀란드 논리학자 얀 폰 플라토가 이끄는 헬싱키 대학 프로젝트에서 주당 1페이지 속도로 해독해왔다. 2024년 9월 AI 모델 Claude의 도움을 받자 수일 만에 노트북 전체의 포괄적 요약이 완성되었고, 괴델이 미발표 정리 수백 개를 증명했음이 드러났다. Claude는 노트북에서 증명을 가진 정리 663개를 추출했으며, 이를 수학 검증 프로그램 Coq으로 검사한 결과 약 400개는 그대로 통과, 약 200개는 수정 필요, 약 50개는 거짓으로 판정되었다. 전체 요약 8문장 읽기 → 019 06:11 ▲ 103 · 댓글 37 AI 모델이 가중치 조작으로 다른 모델에 악성 행동 주입 가능 신경망의 가중치를 직접 수정하는 '가중치 공간 편집'은 정당한 용도가 있지만, 한 모델이 다른 모델에 무단으로 악성 행동을 주입할 수 있는 새로운 공격 벡터를 열었다. AI · 머신러닝 · Models can now transmit viruses in weight-space
Key Point 가중치 편집 기술이 발전하면서 모델 간 악성 조작이 가능해졌고, 정당한 용도와 보안 위험 사이의 균형 문제가 AI 시스템의 배포 및 관리 방식에 직결되기 때문이다.
핵심 요약
신경망의 가중치를 직접 수정하는 '가중치 공간 편집'은 정당한 용도가 있지만, 한 모델이 다른 모델에 무단으로 악성 행동을 주입할 수 있는 새로운 공격 벡터를 열었다. 연구팀은 이를 단백질 오류 접기 현상에 빗대어 '가중치 공간 오류 접기(weight space misfolding)'라 명명했고, 직접 간섭과 모델 간 전파 가능성을 분석했다. 공격자는 페이로드를 한 번만 생성하면 되지만, 방어자는 방대한 가중치 중에서 악성 수정을 찾아야 하는 불균형적 상황을 지적했다. 전체 요약 10문장 읽기 → 020 00:11 ▲ 194 · 댓글 218 릴리 CEO, 아모데이의 의료 기적론에 "황당하다" 일갈 Anthropic CEO 다리오 아모데이가 IPO 발표 연설에서 암, 알츠하이머, 심장질환, 정신질환이 10년 내 완치될 것이라 주장했다. AI · 머신러닝 · Eli Lilly CEO pushes back on Dario Amodei's ludicrous medical claims
Key Point IPO를 앞둔 AI 기업 최고경영진의 과장된 의료 기적론이 제약사 경영진과 의료 전문가들의 집단 비판을 받고 있으며, 이것이 테라노스 사기와 유사한 패턴으로 인식되고 있기 때문이다.
핵심 요약
Anthropic CEO 다리오 아모데이가 IPO 발표 연설에서 암, 알츠하이머, 심장질환, 정신질환이 10년 내 완치될 것이라 주장했다. 전문가들은 이를 엘리자베스 홈스의 테라노스 사기와 비교하며 즉각 반박했다. 생물학 데이터는 생물학의 1% 미만만 존재하며, 신약은 임상 시험만 5~8년이 걸려 10년 내 완치는 불가능하다는 지적이 이어졌다. 전체 요약 8문장 읽기 → 021 21:11 ▲ 36 · 댓글 3 생성형 이미지 모델을 비전 AI로 변신시킨 오픈 레시피 기존 Vision Banana 방식을 재현한 Open Vision Banana(OVB)는 사전학습된 이미지 생성 모델을 다중 작업 인식 시스템으로 변환하는 완전 공개 방식을 제안했다. AI · 머신러닝 · Open Vision Banana: A Fully Open Recipe for Generative Visual Perception
Key Point 생성형 AI를 기반으로 한 멀티태스크 비전 시스템의 설계 원리가 완전히 공개되어 연구 재현과 응용이 가능해진 점, 그리고 레전드 앙상블로 추가 학습 없이 성능을 크게 개선하는 방법론이 소개된 점이 중요하다.
핵심 요약
기존 Vision Banana 방식을 재현한 Open Vision Banana(OVB)는 사전학습된 이미지 생성 모델을 다중 작업 인식 시스템으로 변환하는 완전 공개 방식을 제안했다. OVB는 비전 작업을 조건부 이미지 편집으로 프레임화하며, 색상 인코딩·프롬프트 설계·파라미터 적응·작업 균형 같은 핵심 설계 선택지를 분석했다. 4B~9B 파라미터 오픈 가중치 모델과 공개 데이터셋 2.1M~3.8M 학습 쌍을 사용한 OVB는 Cityscapes 제로샷에서 73.9 mIoU로 Vision Banana(69.9)를 앞질렀다. 전체 요약 7문장 읽기 → 022 18:11 ▲ 46 · 댓글 4 동영상 생성 AI, LLM의 물리 지식으로 스스로 학습한다 동영상 생성 모델들은 시각적으로는 현실적이지만 물리 법칙과 인과관계를 제대로 따르지 못한다. AI · 머신러닝 · PhysLoop: Harnessing LLMs' Physics Awareness for Self-Improving Video Generation Models
Key Point LLM의 물리 지식을 동영상 생성에 직접 녹여내는 방식으로, 인간 감독을 줄이면서 생성 AI가 스스로 개선되는 새로운 경로를 제시한다.
핵심 요약
동영상 생성 모델들은 시각적으로는 현실적이지만 물리 법칙과 인과관계를 제대로 따르지 못한다. 생성된 영상으로부터 학습하려면 정교한 물리 감독이 필요한데, 신뢰할 만한 품질 판단과 수정 쌍을 확보하기 어렵다. PhysLoop은 LLM이 지닌 물리 지식을 활용해 동영상 생성 모델이 스스로 개선되도록 돕는 통합 프레임워크다. 전체 요약 8문장 읽기 → 023 18:11 ▲ 45 · 댓글 3 극도로 압축된 토큰으로 빠른 이미지 생성, 32배 압축에도 품질 유지 이산 자기회귀 모델은 토큰 수를 줄이면 생성 속도는 빨라지지만 표현 품질이 떨어지는 근본적 트레이드오프에 직면해 있다. AI · 머신러닝 · G-STAR: Group-Scaled Token Capacity for Deeply Compressed Autoregressive Generation
Key Point 극도로 압축된 토큰으로도 이미지 생성 품질을 유지하면서 20배 빠른 속도를 달성해, 대규모 시각 생성 모델의 실용적 배포 가능성을 크게 높였다.
핵심 요약
이산 자기회귀 모델은 토큰 수를 줄이면 생성 속도는 빨라지지만 표현 품질이 떨어지는 근본적 트레이드오프에 직면해 있다. 연구팀은 곱셈 양자화 기반으로, 고정된 정보량 예산에서 그룹 크기가 공간 압축 비율의 제곱에 비례해야 한다는 원리를 도출했다. 이를 토대로 G-STAR이라는 공간-그룹 동시 스케일링 프레임워크를 제안하여 32배, 심지어 64배 압축도 가능하게 하면서 재구성·이해·생성 성능을 보존한다. 전체 요약 6문장 읽기 → 024 18:11 ▲ 34 · 댓글 5 성능 낮은 모델도 강화학습 교사로 활용 가능 결정 모델은 행동 선택, 행동 평가, 정책 학습 등 다양한 역할을 수행하는데, 기존 연구는 주로 행동 선택자(액터)로서의 성능만 평가했다. AI · 머신러닝 · Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents
Key Point 장기 시간 신호 문제가 있는 강화학습에서 성능 낮은 모델도 판사·교사로 활용하면 정책 학습 효율을 크게 높일 수 있어, 에이전트 훈련 전략의 관점을 바꿀 수 있다.
핵심 요약
결정 모델은 행동 선택, 행동 평가, 정책 학습 등 다양한 역할을 수행하는데, 기존 연구는 주로 행동 선택자(액터)로서의 성능만 평가했다. ALFWorld와 WebShop 환경에서 결정 모델 3개와 LLM 6개를 액터·판사·교사 역할로 비교 평가한 결과, 액터로서 성능이 낮아도 판사나 교사로는 우수할 수 있음을 확인했다. 액터 역할에서 모든 모델이 먼저 거쳐야 할 부분 목표를 무시하고 더 쉬운 목표로 쏠렸지만, 판사 역할에서 전체 궤적을 보면 올바른 단계에 신용을 부여했다. 전체 요약 6문장 읽기 → 025 18:11 ▲ 30 · 댓글 4 로봇 학습 위한 대규모 환경·행동 데이터셋 'Ropedia Xperience 2' 공개 GPT-6 Astra, Claude Fable 5.1 같은 대규모 기초 모델이 시각 정보로 로봇을 직접 제어할 수 있게 됐지만, 현실의 장시간·접촉이 많은 작업에서는 여전히 취약하다. AI · 머신러닝 · Ropedia Xperience 2: A Gold Standard for Scaling Physical AI Environments and Behaviors
Key Point 대규모 언어 모델의 스케일링 법칙처럼, 로봇 AI가 어떤 데이터 규모에서 성능이 향상되는지를 연구하기 위한 첫 번째 표준 데이터셋이 제시됐다.
핵심 요약
GPT-6 Astra, Claude Fable 5.1 같은 대규모 기초 모델이 시각 정보로 로봇을 직접 제어할 수 있게 됐지만, 현실의 장시간·접촉이 많은 작업에서는 여전히 취약하다. 로봇 AI의 능력이 환경과 행동 데이터 규모에 어떻게 비례하는지 규명하려면, 어떤 데이터를 모을지, 어떻게 지속적으로 생산·재활용할지 먼저 정해야 한다. Ropedia Xperience 2는 1,589개의 미터급 3D 스캔과 74개 작업의 1인칭 영상 4,230개(총 131시간)를 담은 데이터셋이다. 전체 요약 5문장 읽기 → 026 18:11 ▲ 137 · 댓글 3 빠른 AI 모델의 신뢰성을 측정하는 벤치마크 'SO-Arena' 공개 System One 모델은 빠른 결정을 내리는 대신 생성 토큰을 줄이지만, 기존 벤치마크로는 능력과 신뢰성을 제대로 평가하기 어렵다는 한계가 있었다. AI · 머신러닝 · SO-Arena: Benchmarking the Capability Spectrum and Reliability of System One Models
Key Point 정확도 높은 AI 모델이 실제 환경에서 신뢰할 수 있는 판단을 하는지 확인하는 새로운 평가 방식이 제시되어, 프로덕션 배포 시 모델 선택의 기준이 달라질 수 있다.
핵심 요약
System One 모델은 빠른 결정을 내리는 대신 생성 토큰을 줄이지만, 기존 벤치마크로는 능력과 신뢰성을 제대로 평가하기 어렵다는 한계가 있었다. 연구팀이 SO-Arena을 제안했으며, 11개 도메인과 5개 능력 계열에 걸쳐 System One 모델의 능력 스펙트럼과 의사결정 신뢰성을 평가한다. 신뢰할 수 있는 출처 기반 평가, 수동 검증, 샌드박스 환경에서의 반복적 실행 등으로 현실적인 대화형 평가를 제공한다. 전체 요약 8문장 읽기 → 027 18:11 ▲ 100 · 댓글 28 에이전트 반복 학습으로 토큰 사용량 줄이는 AgentRun 오픈소스 공개 Parcha AI가 오픈소스 플랫폼 AgentRun을 공개했다. AI 에이전트에 자동 학습, 내구적 실행, 제어 판넬을 추가해 매번 실행할 때마다 토큰 사용량을 줄인다. AI · 머신러닝 · Show HN: AgentRun – open-source, Self-improving Managed Agents
Key Point 에이전트가 같은 작업을 반복할 때마다 토큰 사용량이 누적되는 문제를 학습과 메모리로 근본적으로 해결하는 오픈소스 플랫폼으로, 특히 비용이 높은 AI 작업을 운영하는 팀에게 직접적인 절감 효과를 제시한다.
핵심 요약
Parcha AI가 오픈소스 플랫폼 AgentRun을 공개했다. AI 에이전트에 자동 학습, 내구적 실행, 제어 판넬을 추가해 매번 실행할 때마다 토큰 사용량을 줄인다. Greptile의 코드 리뷰 비용이 달당 180달러에서 6,451달러로 36배 증가하자, Greptile을 사용하는 에이전트 대신 저가 모델로 자체 리뷰 도구를 만들었다. 리뷰당 18센트로 비용을 98% 줄였으면서 미처 본 30개의 PR에서 실제 버그 1.6배를 더 찾았다. 상인 분류 작업에선 Opus 모델이 분류 방법을 학습한 후 저가 모델에 전달해, 건당 비용을 0.89달러에서 0.12달러로 내렸다. 전체 요약 14문장 읽기 → 028 15:11 ▲ 29 · 댓글 4 대형언어모델 하이퍼커넥션 아키텍처 간소화 설계 최신 언어모델에서 채택하는 Hyper-Connections(HC) 아키텍처는 충분히 이해되지 않으면서 학습 오버헤드를 증가시키고 있다. AI · 머신러닝 · On the Design of Hyper-Connections: Simplification, Stability, and Scalability
Key Point 학습 효율을 거의 해치지 않으면서도 구조를 단순화하는 방법은 대규모 모델 개발 비용 절감에 직결되기 때문이다.
핵심 요약
최신 언어모델에서 채택하는 Hyper-Connections(HC) 아키텍처는 충분히 이해되지 않으면서 학습 오버헤드를 증가시키고 있다. 연구진이 HC 아키텍처를 체계적으로 분석한 결과, 학습된 read/write 게이팅 또는 고정 게이트를 사용한 무제약 혼합이 두 가지 효과적인 상호작용 그룹을 형성하며, 각각 기존 mHC와 비슷한 성능을 달성한다. 확장된 residual 상태에 대한 반복적 접근이 혼합 없이도 주요 학습 오버헤드 원인임을 확인했다. 전체 요약 7문장 읽기 → 029 09:11 ▲ 13 · 댓글 3 시뮬레이션으로 AI 비서의 상호작용 능력 평가하는 새 벤치마크 사용자와 실시간 상호작용하는 비전 모델을 평가하기 위해 닫힌 루프 환경이 필요하다는 점을 제시한다. 기존 벤치마크는 오프라인 재생에만 의존해 AI의 응답이 사용자 행동과 작업 결과에 미치는 영향을 포착하지 못했다. AI · 머신러닝 · Interactive Visual Gym: Evaluating Visual Interaction Models with Simulated Users in Interactive Worlds
Key Point 비전 기반 AI 비서의 실제 사용성을 평가할 새로운 벤치마크가 제시되며, 현재 최고 성능 모델들도 절반 이상의 작업을 완료하지 못한다는 점이 해당 기술의 실용적 한계를 드러낸다.
핵심 요약
사용자와 실시간 상호작용하는 비전 모델을 평가하기 위해 닫힌 루프 환경이 필요하다는 점을 제시한다. 기존 벤치마크는 오프라인 재생에만 의존해 AI의 응답이 사용자 행동과 작업 결과에 미치는 영향을 포착하지 못했다. Interactive Visual Gym은 작업 환경과 인간 사용자를 함께 시뮬레이션하는 프레임워크로, 요리·가정용 물건 조작·모바일 인터페이스 3개 영역의 일상 작업과 인간의 행동 공간을 재현한다. 페르소나 기반 사용자 시뮬레이터를 통해 AI 비서와 협력하면서도 통제된 실행 오류와 예상 밖의 행동을 포함시킨다. 전체 요약 8문장 읽기 → 030 09:11 ▲ 165 · 댓글 169 AI 데이터센터 확산, 저소득층이 전기료 부담 AI 엔진인 대규모 데이터센터는 중소도시만큼의 전력을 소비하면서 전력망에 부담을 주고 있다. 인프라 · 데브옵스 · Data centers need power – lower income, rural residents pay the price
Key Point AI 데이터센터의 급격한 확산이 저소득층과 농촌 주민에게 집중된 에너지 비용 증가를 초래하고 있으며, 현재의 비용 분담 방식 개선이 정책 결정과 주 정부·연방 차원의 논의를 앞두고 있기 때문이다.
핵심 요약
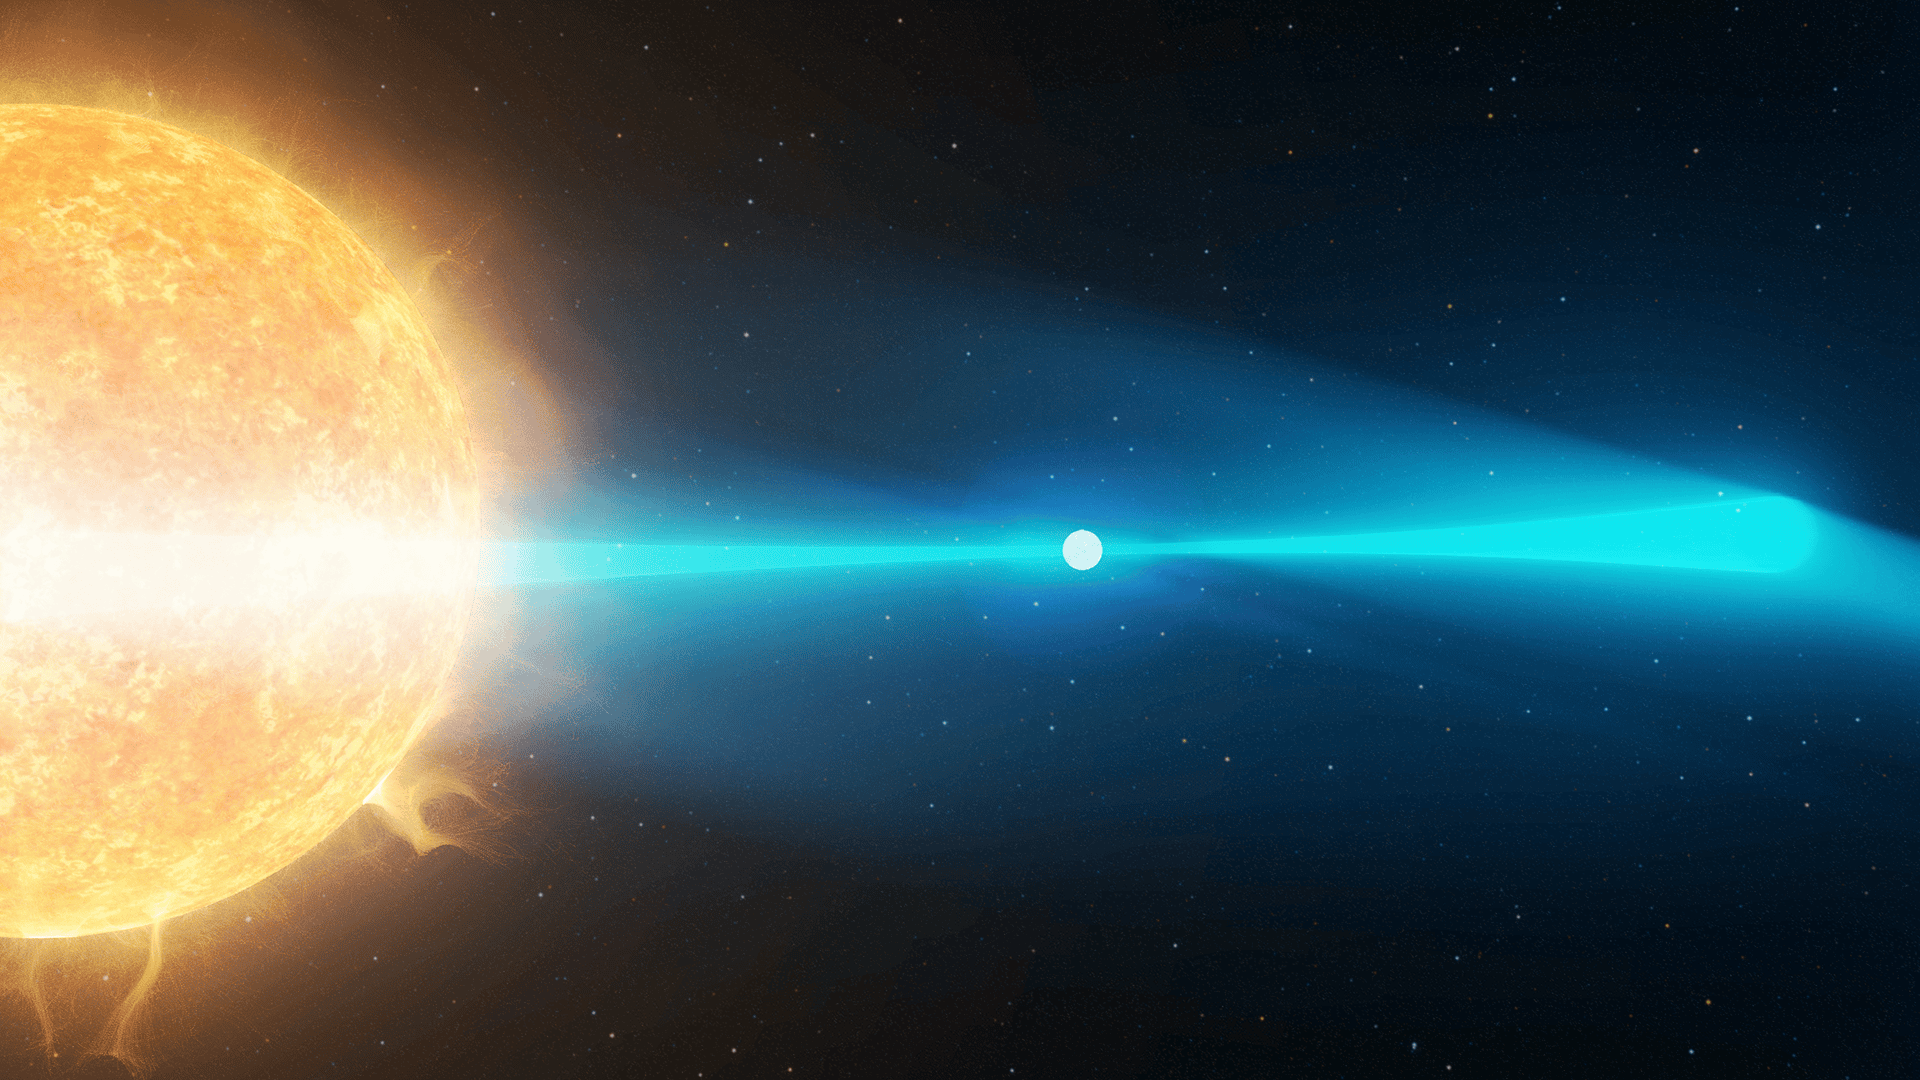
AI 엔진인 대규모 데이터센터는 중소도시만큼의 전력을 소비하면서 전력망에 부담을 주고 있다. 코넬대학 연구는 2020~2025년 미국 4대 전력망을 분석한 결과, 데이터센터가 2025년 기반시설 비용 82.5억 달러 중 38%인 31.2억 달러만 부담하고 나머지 62%는 주민들이 지고 있음을 발견했다. 저소득 가정은 소득의 28%까지 에너지 비용이 증가했으며, 전송 인프라 투자는 2020년 20억 달러에서 2025년 340억 달러로 급증했다. 전체 요약 10문장 읽기 → 031 06:11 ▲ 105 · 댓글 55 백색왜성에서 8분마다 전파 신호, 첫 발견 커틴 대학교 ICRAR 연구팀이 GPM J071507−114153라는 별 시스템에서 신비한 전파 펄스의 정체를 규명했다. 하드웨어 · 시스템 · Researchers discover rare star system that emits radio signals every 8 minutes
Key Point 백색왜신과 태양형 별 쌍성계에서 처음 감지된 정기적 전파 신호로, 기존에는 적색왜신 시스템에서만 관찰되던 현상을 확장하는 발견이다.
핵심 요약
커틴 대학교 ICRAR 연구팀이 GPM J071507−114153라는 별 시스템에서 신비한 전파 펄스의 정체를 규명했다. 이 시스템은 8분마다 회전하는 백색왜성(죽은 별의 핵)과 태양과 유사한 G형 별이 서로 공전하는 쌍성계이다. 백색왜성과 태양형 별의 쌍성계에서 전파 펄스가 감지된 것은 처음이며, 기존에는 더 작고 차가운 적색왜성 시스템에서만 발견되었다. 전체 요약 10문장 읽기 → 032 00:11 ▲ 202 · 댓글 84 정확한 소프트웨어 작성이 어려운 이유 David Hilbert는 1930년 모든 수학을 형식화하고 일관성, 완전성, 결정가능성을 증명할 수 있다고 믿었으나, Kurt Gödel의 불완전성 정리와 1936년 Church·Turing의 정지 문제(halting problem) 증명으로 Hilbert의 계획이 무너졌다. AI · 머신러닝 · Why Writing Correct Software Is Hard
Key Point 정지 문제부터 모델 검사까지 계산 이론의 기본 정리들이 왜 소프트웨어 검증이 근본적으로 불가능한지를 보여주기 때문에, 프로그램 정확성의 한계를 수학적으로 이해하려는 개발자와 연구자에게 필수적이다.
핵심 요약
David Hilbert는 1930년 모든 수학을 형식화하고 일관성, 완전성, 결정가능성을 증명할 수 있다고 믿었으나, Kurt Gödel의 불완전성 정리와 1936년 Church·Turing의 정지 문제(halting problem) 증명으로 Hilbert의 계획이 무너졌다. 정지 문제는 자기참조를 이용한 대각선 논법으로 증명되며, 주어진 프로그램이 종료하는지 판단하는 알고리즘은 존재할 수 없다는 것을 보여준다. 정지 문제의 직접적 결과로 도달가능성 판정 불가능, Rice의 정리(프로그램의 비자명 성질 판정 불가능), Busy Beaver 함수의 비계산가능성 등이 따른다. 전체 요약 12문장 읽기 → 033 00:11 ▲ 100 · 댓글 11 구글 버그 현상금 사상 최고액 133만 달러 기록 보안 연구자 리라 레베인(Lyra Rebane)이 구글의 취약점 보상 프로그램(VRP)에서 Chrome 버그에 대해 133만 3337달러를 받았으며, 이는 구글 VRP 역사상 최고액의 현상금이다. 보안 · I Accidentally Became a Millionaire
Key Point Chrome 보안 연구자들이 달성할 수 있는 최고 보상 규모가 어디까지인지를 보여주는 사례이며, 개인 보안 연구자의 취약점 발견이 어떤 경제적 가치를 인정받을 수 있는지 시사한다.
핵심 요약
보안 연구자 리라 레베인(Lyra Rebane)이 구글의 취약점 보상 프로그램(VRP)에서 Chrome 버그에 대해 133만 3337달러를 받았으며, 이는 구글 VRP 역사상 최고액의 현상금이다. 이전까지 구글이 발표한 Chrome의 최고 보상액은 풀체인 익스플로잇이나 샌드박스 탈출 같은 복잡한 취약점에 대한 25만 달러였다. 이번 수상은 2026년 11월에 이루어졌으며, XBOW나 2025~2026년 초반 다른 연구자들이 받은 상금보다 훨씬 크다. 전체 요약 4문장 읽기 → 034 18:11 ▲ 14 · 댓글 5 GTA V를 AI 훈련장으로: 게임 과제로 강화학습 평가 AAA 게임은 에이전트의 지각, 추론, 제어 능력을 평가하기 위한 풍부한 테스트베드를 제공하지만, 과제 성공 여부를 자동으로 검증하기 어려워 수동 평가가 필요했다. AI · 머신러닝 · GTAGym: AAA Game Tasks Environment for Evaluation and Reinforcement Learning
Key Point AAA 게임 환경에서 AI 에이전트를 객관적으로 평가하고 강화학습으로 훈련할 수 있는 자동화된 벤치마크가 생겨, 복잡한 현실 같은 과제에서 AI 성능을 측정하는 새로운 길이 열렸다.
핵심 요약
AAA 게임은 에이전트의 지각, 추론, 제어 능력을 평가하기 위한 풍부한 테스트베드를 제공하지만, 과제 성공 여부를 자동으로 검증하기 어려워 수동 평가가 필요했다. 연구진은 GTA V 작업 평가 및 강화학습을 위한 환경 및 프레임워크인 GTAGym을 개발했다. GTAGym의 평가 벤치마크인 GTAVBench는 GTA V 메인 스토리 미션에서 추출한 9개 작업 계열의 103개 온라인 과제와 GTA V 이미지 기반 47개 사격·저격 과제를 포함한다. 전체 요약 8문장 읽기 → 035 18:11 ▲ 47 · 댓글 3 교과서 구조에서 수학 증명 380만 개 추출 언어 모델의 수학 학습 데이터는 보통 문제-풀이 쌍으로 단순화되어, 원본 교과서의 조직체계와 증거 구조가 손실된다. AI · 머신러닝 · Scaling Mathematical Proof Supervision from Structured Textbooks
Key Point 언어 모델의 수학 능력을 근본적으로 개선할 수 있는 새로운 데이터 구조와 38만 개의 증명 레코드를 제시하는데, 실제 교과서 구조를 보존함으로써 기존 단순 문제-풀이 쌍 방식보다 학습 효율이 크게 높다는 점이 중요하다.
핵심 요약
언어 모델의 수학 학습 데이터는 보통 문제-풀이 쌍으로 단순화되어, 원본 교과서의 조직체계와 증거 구조가 손실된다. 연구팀은 TOME-Math라는 대규모 코퍼스를 구축해 2,118개 대학수학 교과서를 약 38만 개의 구조화된 증명 감독 레코드로 변환했다. 변환 과정에서 장(章) 순서, 명제-증명 연결, 의존성 참조, 출처 정보 등의 구조 신호를 보존했다. 전체 요약 7문장 읽기 → 036 15:10 ▲ 39 · 댓글 7 표 데이터 '생성·보충·예측' 한 모델으로 모두 해낼 수 있을까 표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. AI · 머신러닝 · One Table, Many Queries: Benchmarking Generalist Tabular Models Across Generation, Imputation, and Prediction
Key Point 표 데이터 모델링의 세 가지 핵심 작업을 단일 모델로 수행할 수 있는지 처음 체계적으로 평가한 벤치마크로, 현실의 데이터 처리 파이프라인을 통합 설계할지 말지의 기준을 제시한다.
핵심 요약
표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. 연구팀은 56개 데이터셋과 46개 모델을 포함한 'One Table Benchmark'를 만들어 20가지 능력 축 아래 세 작업을 통일된 조건에서 비교했다. 다섯 가지 신경망을 일곱 가지 목표 조합으로 훈련한 결과, 보충과 예측은 수치 회복과 의존성 보존을 통해 연결되고, 생성은 예측 유틸리티를 통해 둘 모두와 연결된다. 전체 요약 9문장 읽기 → 037 15:10 ▲ 35 · 댓글 8 대형 언어모델, 강화학습으로 '자기주도 학습' 능력 키운다 LLM이 미지의 영역에서 문제를 풀려면 사전학습된 지식이나 고정 검색만으로는 부족하며, 참고 자료를 즉시 습득하고 추론하는 자기주도 학습이 필요하다. AI · 머신러닝 · Incentivizing Self-Learning in Large Language Models via Reinforcement Learning
Key Point 미지의 영역에서 LLM의 문제해결을 좌우하는 '즉각적 학습' 능력을 강화학습으로 끌어내는 방법론을 제시해 지식 습득과 추론의 결합 방식을 새로이 정의한다.
핵심 요약
LLM이 미지의 영역에서 문제를 풀려면 사전학습된 지식이나 고정 검색만으로는 부족하며, 참고 자료를 즉시 습득하고 추론하는 자기주도 학습이 필요하다. 연구팀은 교과서 기반 수학 문제 풀이 과제를 설계했으며, 모델이 교과서 설명을 탐색하고 원리를 학습·적용해 증명을 구성하되 정답은 제공하지 않는다. BookNavigator 인터페이스를 통해 이러한 학습 과정을 지원하고, 미세하게 조정된 보상 신호를 이용한 강화학습으로 자기주도 학습을 유도했다. 전체 요약 6문장 읽기 → 038 12:10 ▲ 11 · 댓글 6 AI 과학 논문 시스템, 근거 왜곡 문제 감지 생의학 연구에 쓰이는 AI 에이전트가 같은 결론을 내면서도 다른 근거를 인용하는 문제를 다룬 감사 프레임워크이다. AI · 머신러닝 · From Tool State to Scientific Action: Auditing Decision Provenance in Biomedical Research Agents
Key Point AI 기반 과학 연구 시스템이 같은 결론 뒤에 서로 다른 근거를 숨기는 위험을 처음 체계적으로 감지하는 방법을 제시하며, 이는 바이오 신약 개발과 같은 실제 응용에서 의사결정 신뢰성을 검증하는 데 필수적이다.
핵심 요약
생의학 연구에 쓰이는 AI 에이전트가 같은 결론을 내면서도 다른 근거를 인용하는 문제를 다룬 감사 프레임워크이다. BioAgent-DF 는 과학 계산 과정에서 저장된 참조값과 후보값의 쌍을 비교해 복원 또는 이식한 후 에이전트를 재실행한다. Qwen 3.5-4B 는 8개 SciFact 배치 중 3개 조합에서 반복적 인용 변화를, Gemma 3 4B IT 는 4개 조합에서 읽음과 인용 변화를 보였다. 전체 요약 7문장 읽기 → 039 09:11 당일 +111 Meta의 고효율 벡터 유사도 검색 라이브러리 Faiss Meta의 Fundamental AI Research 팀이 개발한 고밀도 벡터의 유사도 검색과 클러스터링을 위한 C++ 라이브러리다. AI · 머신러닝 · facebookresearch/faiss · C++
Key Point 대규모 벡터 기반 검색 시스템을 구축하는 개발자와 연구자에게 필수적인 프로덕션급 도구로, GPU 가속을 통해 실시간 유사도 검색 성능을 대폭 향상시킬 수 있다.
핵심 요약
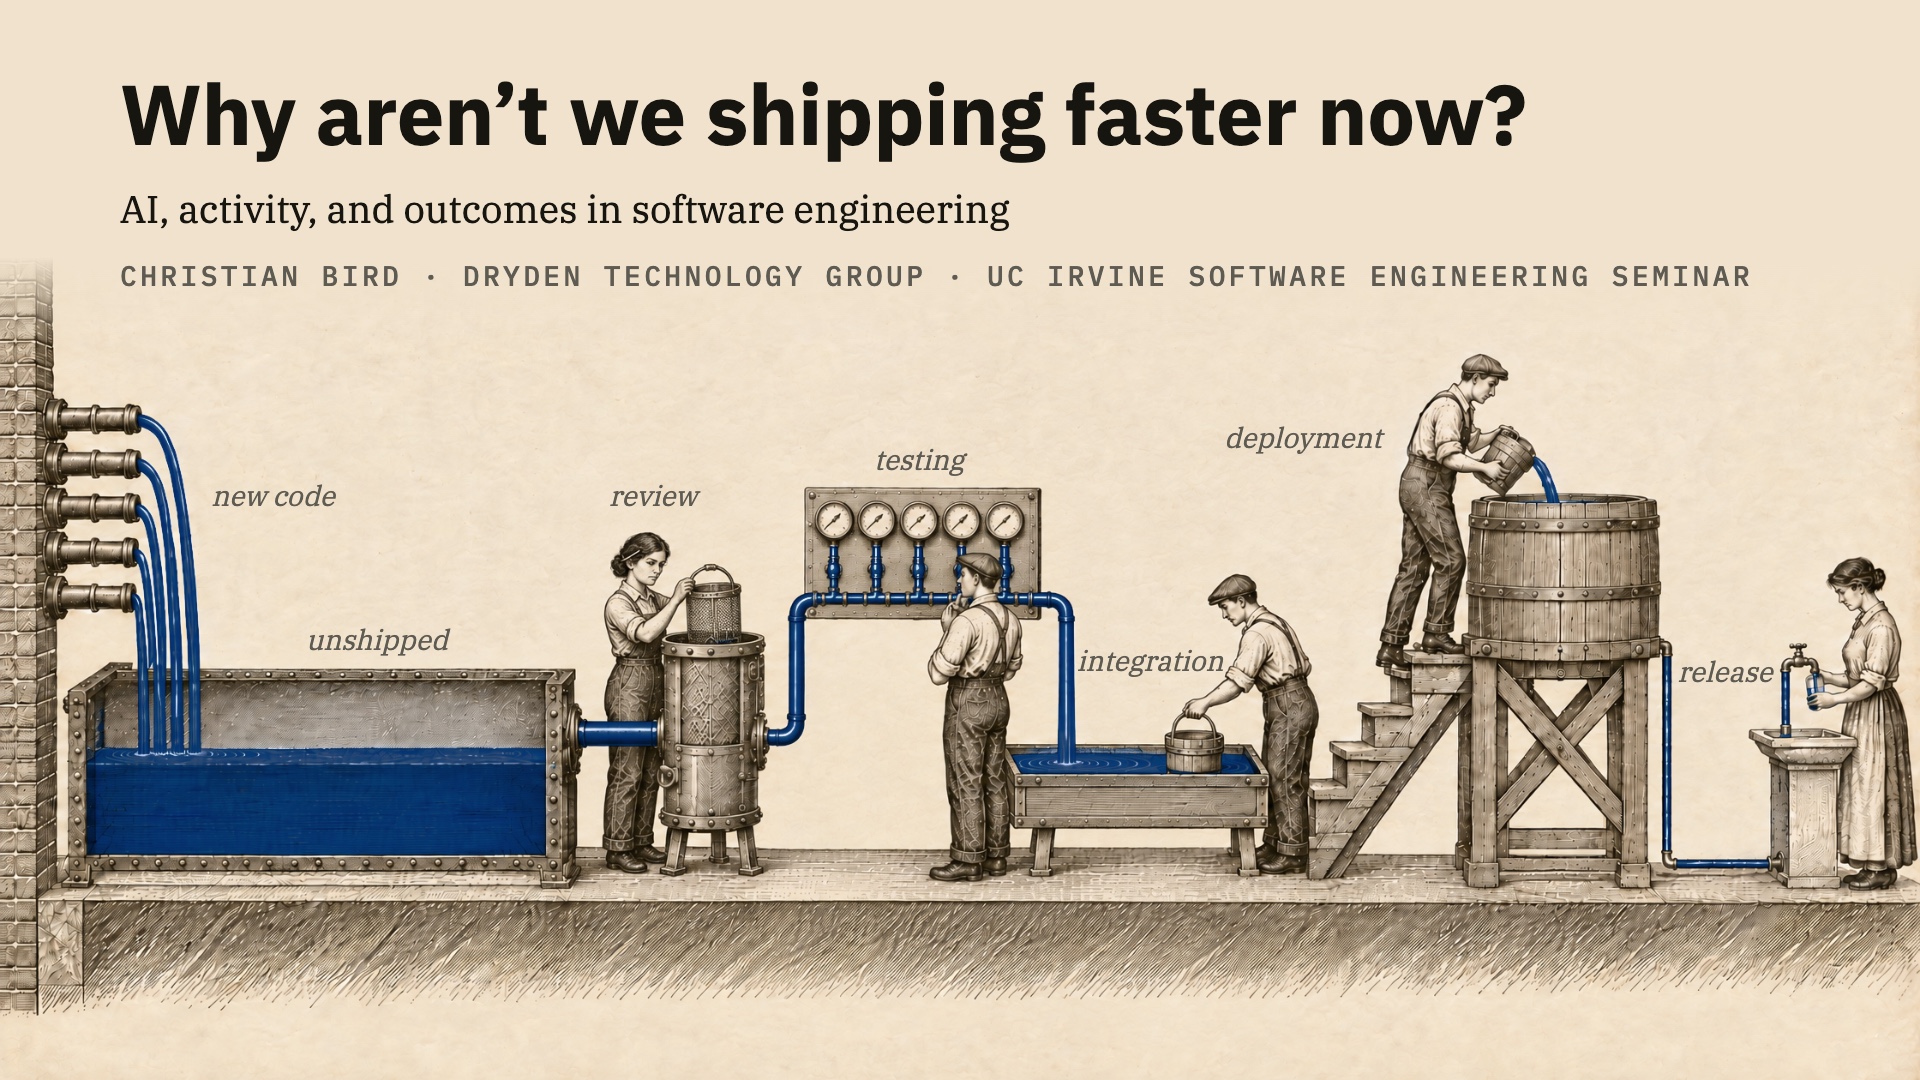
Meta의 Fundamental AI Research 팀이 개발한 고밀도 벡터의 유사도 검색과 클러스터링을 위한 C++ 라이브러리다. RAM에 맞지 않는 대규모 벡터 집합도 처리 가능하며, L2 거리나 내적, 코사인 유사도로 벡터를 비교한다. 이진 벡터와 압축 양자화 코드 기반 방식은 원본 벡터를 저장하지 않고 수십억 개 벡터를 단일 서버 메모리에서 확장 가능하다. 전체 요약 10문장 읽기 → 040 09:11 ▲ 103 · 댓글 99 AI 시대에 소프트웨어 개발 속도가 빨라지지 않는 이유 UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. AI · 머신러닝 · AI, activity, and outcomes in software engineering
Key Point AI 코딩 도구의 급증에도 실제 배포 속도가 개선되지 않는 이유를 학술 근거와 함께 설명하는 연구로, 개발 생산성에 대한 통념을 점검하는 데 중요하다.
핵심 요약
UC 어바인 소프트웨어공학 세미나에서 드라이든 테크놀로지 그룹의 크리스천 버드가 발표한 21분 분량의 강연으로, AI와 소프트웨어 엔지니어링의 관계를 다룬다. 강연은 슬라이드, 핸드아웃(19페이지), 풀 덱(41페이지), 유튜브 영상과 함께 제공된다. 관련 연구 논문으로 '활동-결과 격차: 왜 AI가 소프트웨어 엔지니어링을 해결하지 못하는가'(제출 중)가 있으며, 30명의 인터뷰 내용이 포함되어 있다. 전체 요약 5문장 읽기 → 041 09:11 ▲ 135 · 댓글 24 애플, RAG 검색 속도 최대 11배 개선하는 신경망 기법 공개 추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. AI · 머신러닝 · Faster Retrieval for Better, More Efficient RAG
Key Point RAG 기반 AI 애플리케이션의 검색 속도가 최대 11배 개선되면 응답 시간 단축과 인프라 비용 절감이 직결되므로, 대규모 검색 시스템을 운영 중인 개발팀과 MLOps 담당자에게 즉시 실무 적용 가능한 최신 최적화 기법이다.
핵심 요약
추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. 기존 방법들은 클러스터링과 양자화로 속도를 높이지만 쿼리 분포를 무시하고, RAG에서는 사용자 질문(쿼리)과 문서(키)의 특성이 크게 달라 최적이 아니다. 애플 연구팀은 ICML 2026에서 쿼리별 라우팅을 학습하는 소형 신경망 두 가지를 제시했다: SupportNet은 각 클러스터별 지원함수(support function)를 학습해 라우팅 정확도를 높이고, KeyNet은 쿼리를 최적 키로 직접 변환해 기존 인덱스와 결합한다. 전체 요약 8문장 읽기 → 042 06:11 ▲ 28 · 댓글 3 코딩 에이전트의 로봇 제어 능력을 평가하는 벤치마크 공개 로봇 제어에 코딩 에이전트를 활용하는 새로운 패러다임이 등장하면서, 다양한 로봇을 물리 제약 속에서 제어할 수 있는지 평가할 필요가 생겼다. AI · 머신러닝 · Embodied First Exam
Key Point 로봇 제어에 코딩 에이전트를 활용하려는 움직임이 커지는 가운데, 현실 세계 제약 하에서 얼마나 신뢰할 수 있는지 평가할 수 있는 거대한 벤치마크가 공개됐기 때문이다.
핵심 요약
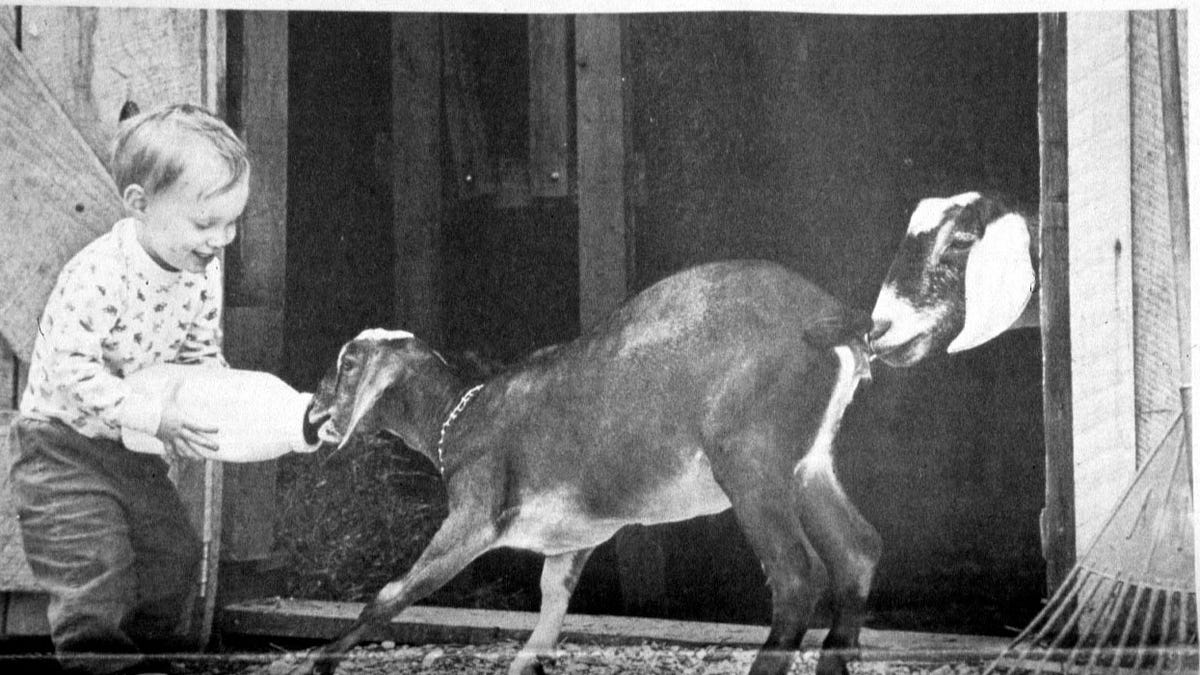
로봇 제어에 코딩 에이전트를 활용하는 새로운 패러다임이 등장하면서, 다양한 로봇을 물리 제약 속에서 제어할 수 있는지 평가할 필요가 생겼다. 연구팀은 '임보디드 퍼스트 엑삼(Embodied First Exam)'이라는 평가 프레임워크를 개발해 공개했다. 47개 로봇에 걸쳐 35개 스위트의 1,156개 태스크로 구성되며, 직접 제어·코드 제어·정책 학습 중 에이전트가 자유롭게 선택할 수 있다. 전체 요약 7문장 읽기 → 043 03:11 ▲ 112 · 댓글 74 좋은 의도의 정책도 작동하지 않는 이유 학교 개선 보조금 30억 달러, 다양성 담당관 채용, 아프간 여성 취업 지원 280만 달러 등 수많은 정책과 프로그램이 의도한 효과를 보이지 못했다. 기타 · We need more goat sacrifices
Key Point 정책 입안자와 기부자들이 좋은 의도의 프로그램을 설계할 때 효과를 검증하지 않는 현실을 드러내며, 우리의 통제 환상이 어떻게 계획된 개입의 실패로 이어지는지 설명한다.
핵심 요약
학교 개선 보조금 30억 달러, 다양성 담당관 채용, 아프간 여성 취업 지원 280만 달러 등 수많은 정책과 프로그램이 의도한 효과를 보이지 못했다. 1987년 사회학자 피터 로시가 제시한 '평가의 철칙'은 대규모 사회 정책의 순 예상 효과는 제로라는 가설을 내놨으며, 로시 본인도 55년이 지난 후에도 '많은 효과 있는 프로그램을 찾기 어렵다'고 결론 내렸다. 소비자들의 통제 환상(사람들이 실제보다 자신의 영향력이 크다고 믿는 것)에 관한 고전 심리학 연구는 후속 재검증에서 재현되지 않았지만, 사람들은 여전히 자신의 의도가 강력하다고 느낀다. 전체 요약 9문장 읽기 → 044 03:11 ▲ 137 · 댓글 39 파이어폭스, 브라우저 핑거프린팅 방어 강화 파이어폭스가 쿠키 없이도 사용자를 추적하는 브라우저 핑거프린팅 기법에 대한 방어를 강화했다. 보안 · Open research, stronger privacy: Making Firefox users harder to fingerprint
Key Point 쿠키 없는 사용자 추적 기술에 대한 구체적인 방어 방식과 그 효과를 실제 데이터로 입증한 연구로, 브라우저 개인정보보호의 기술적 진전을 보여준다.
핵심 요약
파이어폭스가 쿠키 없이도 사용자를 추적하는 브라우저 핑거프린팅 기법에 대한 방어를 강화했다. 화면 해상도, 프로세서 개수 등 추적 스크립트가 의존하는 특정 브라우저 정보를 제한하고 정규화해 사용자들이 더 유사해 보이도록 만든다. 모질라는 약 2,500만 명의 파이어폭스 사용자 데이터를 바탕으로 연구했으며, OHTTP 릴레이를 통해 IP 주소와 요청 내용을 분리하고 수집 후 수개월 뒤 개별 데이터를 삭제했다. 전체 요약 9문장 읽기 → 045 03:11 ▲ 252 · 댓글 137 TV 제조사 17개 질문 '당신은 나를 감시하는가' 기자가 Amazon, Apple, Google, LG, Roku, Samsung, TCL 등 TV·스트리밍 기기 제조사에 프라이버시 관련 17개 질문을 보냈고, 일부 제조사의 답변을 수집해 공개했다. 보안 · I asked every TV manufacturer 17 questions about how they spy on you
Key Point TV 제조사들이 음성·시청 데이터·위치를 수집하는 방식이 제조사마다 크게 다르며, 옵트아웃 후에도 데이터 전송이 계속될 수 있어 실제 프라이버시 보호 수준을 알기 위해 참고할 필요가 있다.
핵심 요약
기자가 Amazon, Apple, Google, LG, Roku, Samsung, TCL 등 TV·스트리밍 기기 제조사에 프라이버시 관련 17개 질문을 보냈고, 일부 제조사의 답변을 수집해 공개했다. 마이크 활성화 조건: Amazon과 Samsung은 버튼 누르거나 웨이크 워드로만 작동한다고 답변했고, LG도 기본값으로 꺼져 있으며 옵트인 후 추가 조치가 필요하다고 답변했다. 음성 저장 및 전송: Amazon은 저장하지 않으며, Google은 '음성 및 오디오 활동'이 명시적으로 켜진 경우만 저장한다고 답변했고, LG는 로컬 처리 후 삭제한다고 답변했다. 전체 요약 12문장 읽기 → 046 00:11 ▲ 100 · 댓글 61 그렉 커처의 긴욱스, 유저스페이스 커널로 방향 전환 긴욱스는 격리된 리눅스 호환성 인스턴스를 위한 설정 가능한 유저스페이스 커널로, 일반 리눅스 프로세스로 실행되며 워크로드와 호스트 커널 간 명시적인 버전관리 계약을 만든다. 인프라 · 데브옵스 · Greg Kurtzer's Ginux is now a userspace kernel
Key Point 리눅스 커널 개발자 Greg Kurtzer가 처음 구현한 독립형 커널에서 유저스페이스 커널로 방향을 바꾼 이유와 AI 에이전트 격리를 위한 새로운 설계 철학이 무엇인지 이해할 수 있는 중요한 프로젝트 전환이다.
핵심 요약
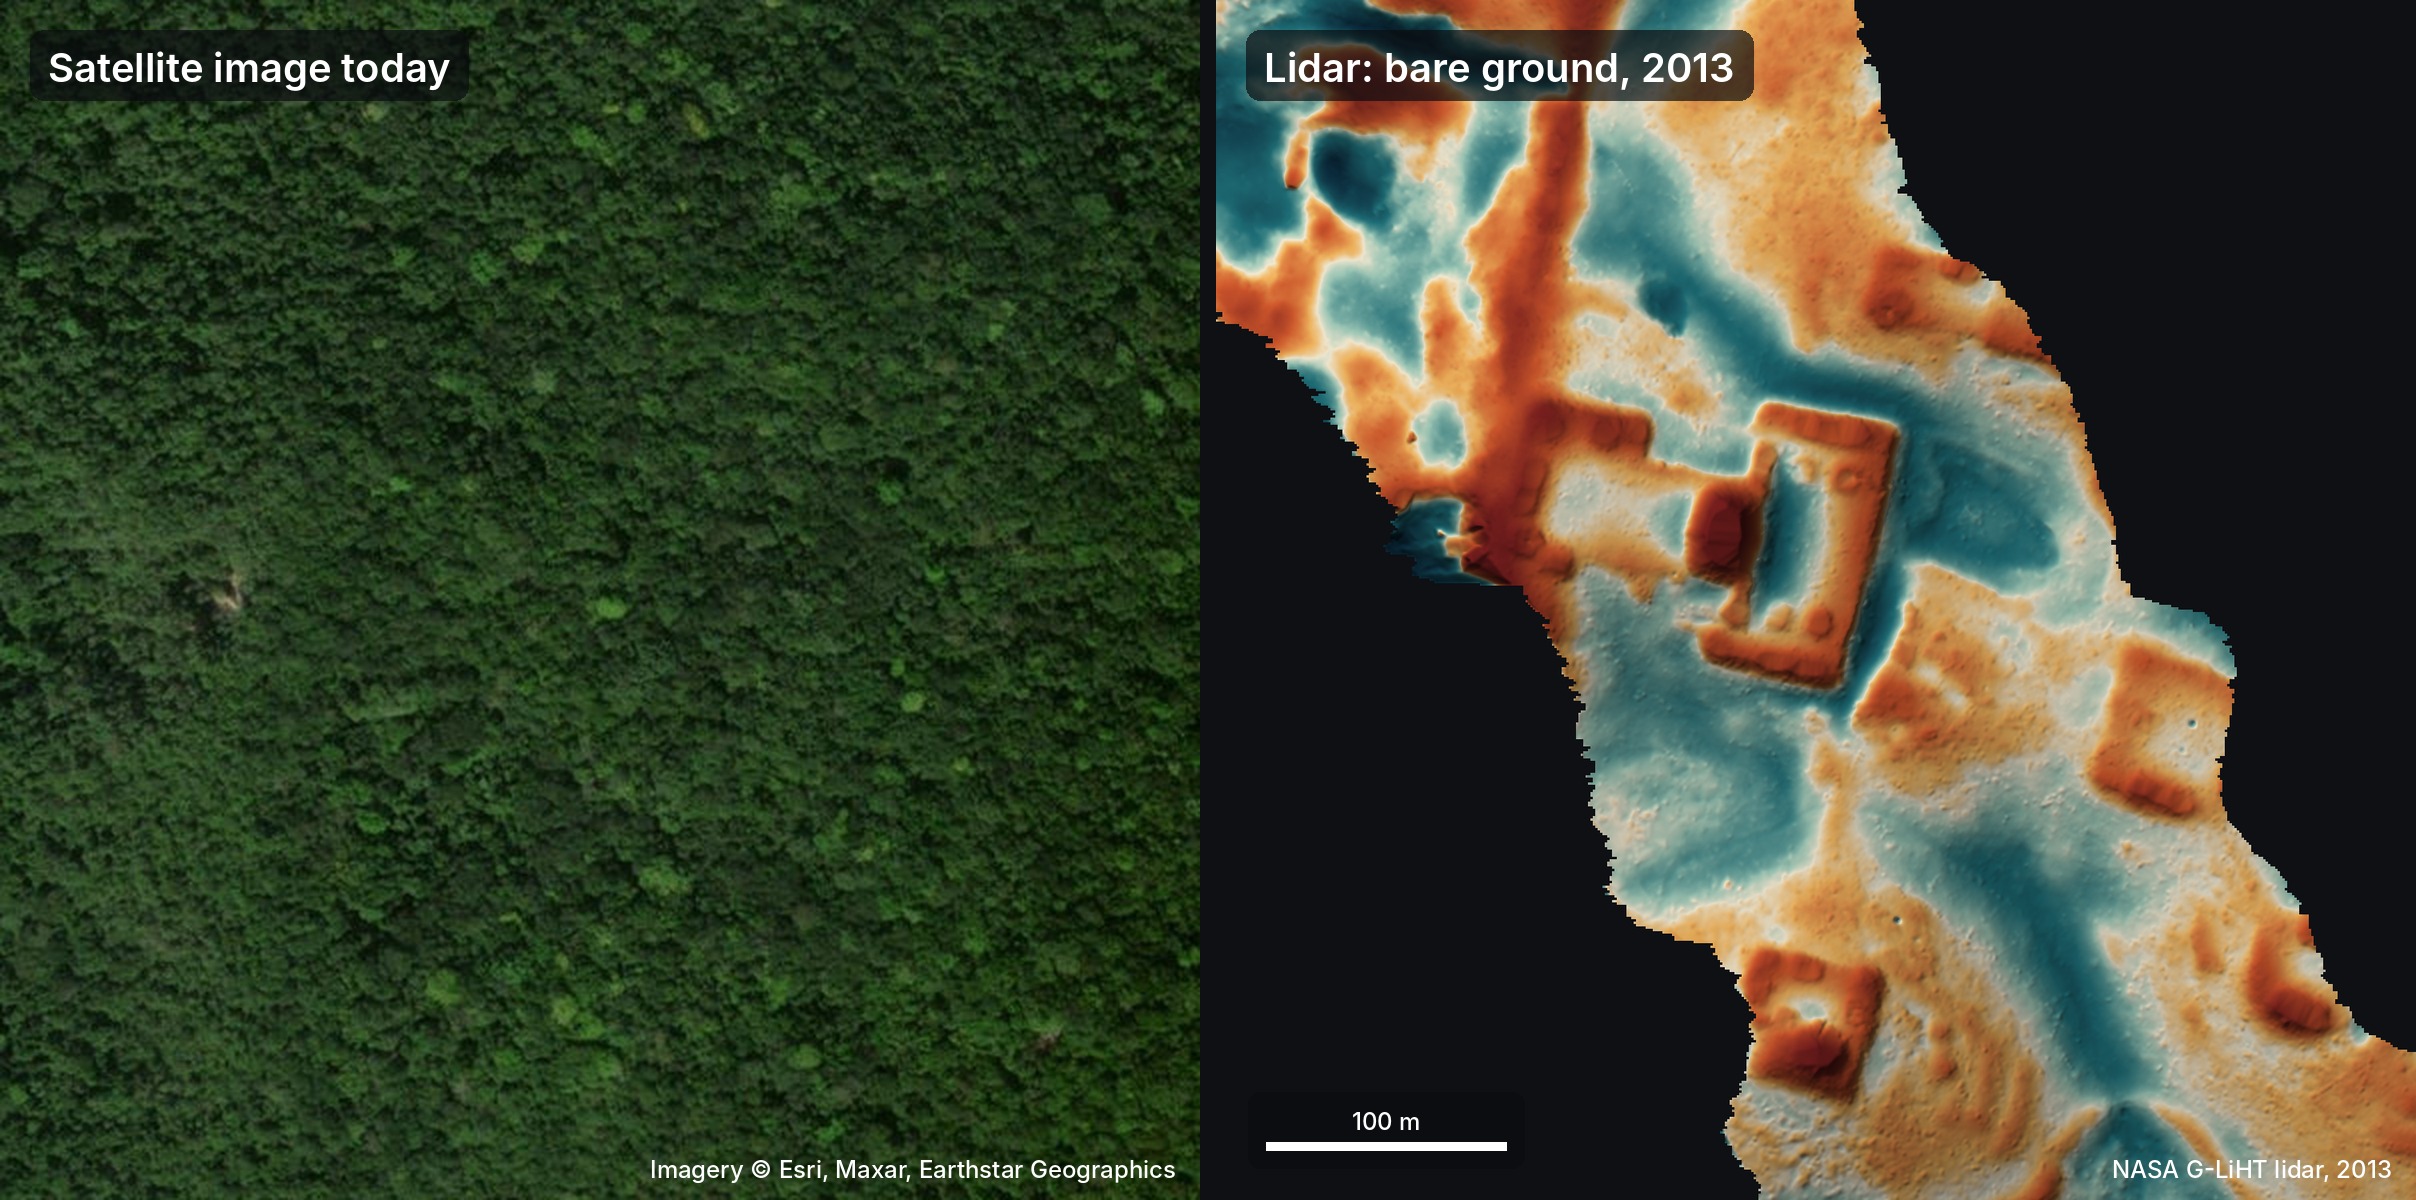
긴욱스는 격리된 리눅스 호환성 인스턴스를 위한 설정 가능한 유저스페이스 커널로, 일반 리눅스 프로세스로 실행되며 워크로드와 호스트 커널 간 명시적인 버전관리 계약을 만든다. 처음엔 UEFI를 통해 부팅하는 독립형 Rust 커널로 시작해 Rocky Linux 10 유저스페이스를 실행했지만, 그 연구 단계는 완료되고 활발한 개발은 유저스페이스 커널 방향으로 진행 중이다. 리눅스는 단순한 소스 코드 이상으로 안정적인 인터페이스, 개발 프로세스, 글로벌 커뮤니티, 수십 년의 호환성 경험이 필요한데, 긴욱스는 새로운 커널을 구현하기보다 호스트 리눅스 위에서 각 인스턴스마다 더 작은 계약을 제시하는 방식을 취한다. 전체 요약 12문장 읽기 → 047 00:11 ▲ 441 · 댓글 158 AI 에이전트 48개가 NASA 라이다 데이터 72시간 분석해 미지의 마야 문명 발견 구글 소프트웨어 엔지니어가 NASA의 라이다 데이터를 분석하기 위해 48개의 AI 에이전트(Gemini, ChatGPT, Claude, Grok)를 활용해 멕시코 유카탄반도의 미기록 마야 유적지를 발견했다. AI · 머신러닝 · Google SWE points 48 AI agents at NASA Lidar, finds unmapped Maya pyramid in 72h
Key Point AI 에이전트와 라이다 기술의 결합이 인간이 놓친 고고학적 발견을 어떻게 가능하게 하는지 보여주며, 비정형 문제 해결에 LLM의 실질적 활용 범위를 확대한다.
핵심 요약
구글 소프트웨어 엔지니어가 NASA의 라이다 데이터를 분석하기 위해 48개의 AI 에이전트(Gemini, ChatGPT, Claude, Grok)를 활용해 멕시코 유카탄반도의 미기록 마야 유적지를 발견했다. 라이다는 레이저 펄스를 숲 캐노피 사이로 쏴 지표면을 매핑하므로, 위성 사진으로 보이지 않는 정글 속 유적을 찾는 데 효과적이다. 에이전트들은 약 1,200km²의 라이다 이미지를 분석하면서 피라미드, 플랫폼, 광장 같은 구조물을 찾되, 자연 언덕이나 싱크홀, 도로는 걸러내는 방식으로 진행했다. 전체 요약 11문장 읽기 → 048 18:11 ▲ 70 · 댓글 7 LLM 에이전트의 잘못된 기억 문제를 원본 궤적으로 검증하기 LLM 에이전트가 과거 작업 경험을 교훈으로 저장해 새 작업에 활용하는 외부 메모리 시스템은 학습을 가능하게 하지만, 잘못된 교훈을 따르거나 유효한 교훈을 잘못 해석하면서 본래 풀 수 있는 작업을 실패하는 메모리 유도 성능 저하(memory-induced degradation) 문제를 유발한다. AI · 머신러닝 · Don't Just Trust Your Memory: Evidence-Linked Memory Reduces Memory-Induced Degradation in LLM Agents
Key Point LLM 에이전트의 경험 학습 시스템이 오히려 성능을 떨어뜨리는 역설적 문제를 해결하는 실질적 방법을 제시하기 때문에, 생산 환경의 에이전트 신뢰성 향상에 직접 적용할 수 있다.
핵심 요약
LLM 에이전트가 과거 작업 경험을 교훈으로 저장해 새 작업에 활용하는 외부 메모리 시스템은 학습을 가능하게 하지만, 잘못된 교훈을 따르거나 유효한 교훈을 잘못 해석하면서 본래 풀 수 있는 작업을 실패하는 메모리 유도 성능 저하(memory-induced degradation) 문제를 유발한다. 기존 방식은 작업 성공/실패로만 레이블된 궤적에서 교훈을 추론하고, 원본 궤적 없이 교훈만 제공하기 때문에 에이전트가 교훈을 검증할 방법이 없다. 이를 해결하기 위해 연구진은 WikiTrace를 제안했으며, 이는 각 교훈을 원본 궤적의 요약본과 원본 궤적 자체로 연결한 증거 기반 메모리 시스템이다. 전체 요약 5문장 읽기 → 049 18:11 ▲ 23 · 댓글 5 비디오·행동을 함께 학습하는 세계 모델 SWAM 공개 언어-비디오 정렬을 학습한 기반 위에 행동 학습을 추가할 때 기존 정렬이 훼손될 수 있다는 문제를 중점 연구했다. AI · 머신러닝 · SWAM: Scaling World Action Models with Cross-Modal Alignment
Key Point 로봇 제어를 위한 세계 모델의 언어-비디오 정렬 유지 전략이 명확해져, 동작 학습 시 기존 이해 능력을 보존하면서 행동 능력까지 확장하려는 연구자들에게 실질적인 지침을 제공한다.
핵심 요약
언어-비디오 정렬을 학습한 기반 위에 행동 학습을 추가할 때 기존 정렬이 훼손될 수 있다는 문제를 중점 연구했다. 약 47,000시간의 일반 비디오, 1인칭 시점 비디오, UMI 데모, 로봇 데모를 수집하여 데이터 풀을 구성했다. 언어-비디오 감시, 언어-비디오-행동 감시, 두 형태를 결합한 학습이 세계 행동 모델(WAM) 성능에 어떻게 영향 미치는지 체계적으로 분석했다. 전체 요약 9문장 읽기 → 050 15:11 ▲ 15 · 댓글 4 깊은 신경망의 정보 손실을 잡다, DepthGraft 기법 LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다. AI · 머신러닝 · DepthGraft: Structural Regularization through Hierarchical Cross-Layer KV Reconstruction
Key Point 모델의 깊이를 키우면서 정보 손실을 막고 캐시를 줄일 수 있는 구조적 기법이 제시되어, 더 효율적인 초대형 언어모델 개발에 실질적 가능성을 보여준다.
핵심 요약
LLM 규모를 키우기 위해 모델 깊이를 늘리면 Pre-LN 아키텍처에서 정보가 각 계층을 지나며 희석되어 깊은 계층이 제대로 학습되지 못하는 문제가 발생한다. 교차 계층 연결은 이 문제를 완화하지만 기존 방식은 계산이나 메모리 접근을 추가로 늘린다. 연구팀은 교차 계층 KV(Key-Value) 공유 방식을 효율적인 연결 방법으로 재검토했으며, KV 재사용이 깊은 계층에서 얕은-중간 계층의 KV 생성으로 직접 기울기 경로를 만들어 KV 표현 구조를 정규화한다는 점을 발견했다. 전체 요약 9문장 읽기 → 051 15:11 ▲ 34 · 댓글 3 이산 토큰으로 시각과 언어 통일하다, dNaViT 언어 모델의 다음 토큰 예측 패러다임을 시각 모델로 확장하여 시각·언어 모델을 하나의 프레임워크로 통합할 수 있다는 가설에서 출발한 연구다. AI · 머신러닝 · dNaViT: Discrete Codes are General-Purpose Visual Representations
Key Point 언어 모델의 토큰 기반 체계를 시각 영역으로 완전히 옮겨 시각·언어 모델 통합이 가능함을 실증한 연구로, 멀티모달 AI의 아키텍처 통일 방향을 제시한다.
핵심 요약
언어 모델의 다음 토큰 예측 패러다임을 시각 모델로 확장하여 시각·언어 모델을 하나의 프레임워크로 통합할 수 있다는 가설에서 출발한 연구다. 사전학습된 인코더에 가벼운 잔차 변조와 이중 목적 함수를 적용하여 시각 특성에 재구성 인식 신호를 주입하는 방식을 택했다. 군집 곱셈 양자화(grouped product quantization)로 공간 시퀀스 길이를 늘리지 않으면서도 이산 표현 용량을 확장했다. 전체 요약 7문장 읽기 → 052 12:11 ▲ 56 · 댓글 3 로봇이 시뮬레이션으로 배우는 조작 기술, 한 번의 시연만으로 기존 정책 학습은 네트워크 가중치에 기술을 저장해 학습한 환경에 종속되지만, 인컨텍스트 학습(ICL)은 이 문제를 피합니다. AI · 머신러닝 · World In-Context Learning for Agentic Robot Manipulation
Key Point 한 번의 시연으로 로봇이 50개 이상의 조작 작업을 배울 수 있으며, 기존 학습 방식을 20포인트 이상 앞지르는 새로운 로봇 학습 패러다임입니다.
핵심 요약
기존 정책 학습은 네트워크 가중치에 기술을 저장해 학습한 환경에 종속되지만, 인컨텍스트 학습(ICL)은 이 문제를 피합니다. 다만 기존 ICL은 다른 장면의 시연이 현재 로봇의 환경 피드백을 제공하지 못해 성능이 낮았습니다. 연구팀은 에이전트가 배우는 내용이 시각 외형이 아닌 작업 단계와 객체 역할 같은 의미론적 정보라는 점을 발견했습니다. 전체 요약 9문장 읽기 → 053 12:11 ▲ 15 · 댓글 3 월드 모델, 게임 규칙을 몇 번 봐야 학습할까 월드 모델이 낯선 환경의 메커니즘을 학습하려면 몇 번의 상호작용(노출)이 필요한지 연구했다. AI · 머신러닝 · How Many Exposures Does a World Model Need? Learning Unseen Game Mechanics at Test Time
Key Point 시각 기반 게임에서 월드 모델이 처음 보는 규칙을 얼마나 빨리 습득하는지 보여주며, 테스트 시점 적응의 효과를 정량적으로 입증했다.
핵심 요약
월드 모델이 낯선 환경의 메커니즘을 학습하려면 몇 번의 상호작용(노출)이 필요한지 연구했다. ARC-AGI-3 벤치마크의 20개 게임에서 69개 반복 메커니즘을 레이블링한 MechEval 평가 도구를 만들었고, 각 메커니즘이 환경을 바꾸는 셀에 대해 예측을 채점한다. WARC는 3,500만 파라미터 비전 트랜스포머로, 다른 게임에 사전학습한 후 매 전이 후 모든 파라미터를 업데이트한다. 전체 요약 6문장 읽기 → 054 03:11 ▲ 12 · 댓글 3 LLM이 부정확한 시뮬레이터의 오류를 판단할 수 있을까 LLM 에이전트가 시스템 연구에서 설계를 평가할 때 시뮬레이터에 의존하지만, 시뮬레이터는 모델링 한계가 있어 예측은 왜곡하면서도 추천 설계는 맞거나 그 반대일 수 있다. AI · 머신러닝 · SIRIS: Can LLMs Tell When Simulation Errors Matter in AI-Driven Systems Research
Key Point LLM 기반 시스템 연구가 확산되면서 실제 설계 결정에 영향을 미치는데, 최신 모델들이 불완전한 도구의 한계를 제대로 인식하지 못해 잘못된 판단을 할 수 있는 근본적 문제를 드러낸다.
핵심 요약
LLM 에이전트가 시스템 연구에서 설계를 평가할 때 시뮬레이터에 의존하지만, 시뮬레이터는 모델링 한계가 있어 예측은 왜곡하면서도 추천 설계는 맞거나 그 반대일 수 있다. Siris는 LLM이 시뮬레이터 한계가 추천을 무효화하는 시점을 시스템 이해를 바탕으로 판단할 수 있는지 테스트하는 방법이다. 시뮬레이터를 변형해 동일한 후보·한계·추천을 가진 워크로드 쌍을 생성하되, 변형은 양쪽 워크로드의 예측을 바꾸면서도 참조 시뮬레이터는 한쪽에서만 추천을 지지한다. 전체 요약 6문장 읽기 → 055 03:11 ▲ 13 · 댓글 9 학생 모델을 저렴하게 학습하려면 '오차 예산'이 필요하다 On-policy distillation(OPD)은 학생 언어 모델을 자신의 응답으로 학습시키는데, 응답 생성 비용을 줄이기 위해 양자화와 비동기 롤아웃을 사용한다. AI · 머신러닝 · How Much Training-Inference Mismatch Can On-Policy Distillation Tolerate?
Key Point 학생 모델 지식 증류 시 비용 절감 기법들이 학습 안정성에 미치는 실제 영향을 정량 측정한 결과로, 양자화와 비동기 처리의 활용도를 크게 높일 수 있는 실용적 기준을 제시한다.
핵심 요약
On-policy distillation(OPD)은 학생 언어 모델을 자신의 응답으로 학습시키는데, 응답 생성 비용을 줄이기 위해 양자화와 비동기 롤아웃을 사용한다. 그러나 이 두 기법은 롤아웃 엔진과 학습 중인 모델 사이에 training-inference mismatch를 일으킨다. 본 연구는 OPD가 얼마나 많은 mismatch를 견딜 수 있는지, 어디서 문제가 발생하는지, 실제 시스템이 이를 어떻게 활용할 수 있는지를 조사했다. 전체 요약 11문장 읽기 → 056 03:11 ▲ 215 · 댓글 114 구글, 최강 프론티어 모델 'Gemini 4 Carbon' 공개 Google DeepMind이 Gemini 4 Carbon을 공개했으며, 개발자·기업·과학자·일반 사용자가 이용할 수 있다. AI · 머신러닝 · Gemini 4 Carbon is now available
Key Point 사이버보안·과학·엔지니어링 분야의 최고 성능과 동일한 Argon 가격으로 제공되며, /swarm 기능으로 멀티에이전트 협업 방식이 표준화되기 시작했다.
핵심 요약
Google DeepMind이 Gemini 4 Carbon을 공개했으며, 개발자·기업·과학자·일반 사용자가 이용할 수 있다. Gemini 4 Argon 이후 나온 Carbon은 사이버보안, 장기 에이전트 워크플로우, 소프트웨어 엔지니어링, 과학적 추론에서 최강 성능을 제공한다. CursorBench 4.0, Perplexity의 WANDR, Zapier의 AutomationBench에서 1위를 차지했으며, 다음 최고 모델 대비 비용은 2배 이상 낮다. 전체 요약 16문장 읽기 → 057 00:11 ▲ 276 · 댓글 105 구글, 신호 암호화 프로토콜 AI로 형식검증 구글 딥마인드가 AlphaProof Code 라는 AI 에이전트 프레임워크를 개발해 Signal 메시징 앱의 암호화 프로토콜 코드를 형식적으로 검증했다. 보안 · AlphaProof Code
Key Point AI가 Signal 같은 실제 배포 암호화 프로토콜의 구현을 형식적으로 검증한 첫 사례로, 기존에 불가능해 보였던 깊이의 소프트웨어 보안 검증이 가능해졌음을 보여준다.
핵심 요약
구글 딥마인드가 AlphaProof Code 라는 AI 에이전트 프레임워크를 개발해 Signal 메시징 앱의 암호화 프로토콜 코드를 형식적으로 검증했다. 이는 광범위하게 배포된 암호화 프로토콜을 형식검증한 첫 사례이며, AI를 활용한 이런 규모의 검증도 처음이다. AlphaProof Code는 여러 LLM을 사용하는 멀티 에이전트 시스템으로, 인간 전문가가 증명할 목표를 정하고 Gemini Carbon 기반 에이전트가 600만 줄 이상의 Lean 코드(수학적 증명 언어)를 생성했다. 전체 요약 10문장 읽기 → 058 18:12 ▲ 56 · 댓글 2 메타인지로 과학 연구 자동화하는 Sage-Taiyi 메타인지 구조를 활용한 AI 시스템 Sage-Taiyi를 소개한다. 누적된 과학적 이해를 바탕으로 다음 조사 대상과 조사 방법을 스스로 결정하며, 증거·가정·미해결 질문에 대한 이해를 반복적으로 개선한다. AI · 머신러닝 · Sage-Taiyi: A Metacognitive Architecture for Scientific Discovery
Key Point AI가 자동으로 과학 연구를 설계하고 가정을 검증하는 방식이 바뀌고 있으며, 실제 화학 실험에서 수율 개선이라는 구체적 성과를 낸 첫 사례이다.
핵심 요약
메타인지 구조를 활용한 AI 시스템 Sage-Taiyi를 소개한다. 누적된 과학적 이해를 바탕으로 다음 조사 대상과 조사 방법을 스스로 결정하며, 증거·가정·미해결 질문에 대한 이해를 반복적으로 개선한다. 265개 작업을 포함한 Taiyi-Bench 벤치마크에서 8개 평가 지표 모두에서 1위를 차지했고, 전체 점수 54.0으로 기존 최강 기준인 AI Scientist-v2의 47.9를 앞질렀다. 두 개의 외부 과학 아이디어 벤치마크에서도 우수한 성능을 보였다. 전체 요약 6문장 읽기 → 059 15:10 ▲ 58 · 댓글 2 세계 지능형 모델 평가를 위한 통합 인프라 'WorldFoundry' 공개 시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. AI · 머신러닝 · WorldFoundry: Towards Unified Infrastructure for World Intelligence
Key Point 세계 모델링 연구에서 단순한 시각적 생성을 넘어 인과성 있는 상태 예측과 제어 가능성을 다룰 수 있는 통합 평가 인프라가 나타났으며, 270개 모델과 74개 벤치마크를 하나의 프레임워크로 통합한 점이 재현성과 비교 가능성의 새로운 기준을 제시한다.
핵심 요약
시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. 생성형 세계 모델을 환경의 지속적이고 이력 기반의 표현을 유지하며, 행동이나 개입에 대응해 표현을 업데이트하고, 관찰된 상황과 반사실적 개입의 결과를 반영하는 시간적으로 일관된 궤적을 생성하는 예측 동적 시스템으로 정의한다. 지각적 기초, 지속적 상태 모델링, 제어 가능한 변환, 역학 인식 예측, 폐루프 상호작용을 아우르는 지능 지향 프레임워크를 제시한다. 전체 요약 8문장 읽기 → 060 15:10 ▲ 52 · 댓글 3 로봇 자율성 향상, 다중에이전트 프레임워크로 실적 2배 이상 돌파 파운데이션 모델로 로봇 제어를 하되 자율성을 오래 유지하려면 효율적인 컨트롤과 실패 복구가 필요하다. AI · 머신러닝 · Toward the Era of Agentic Embodied Intelligence
Key Point 로봇의 자율적 행동 성능을 2배 이상 끌어올린 프레임워크가 공개될 예정이며, 실제 가정용 로봇 작업에서의 높은 성공률과 빠른 학습 속도는 구체화 AI 실용화에 새로운 기준을 제시한다.
핵심 요약
파운데이션 모델로 로봇 제어를 하되 자율성을 오래 유지하려면 효율적인 컨트롤과 실패 복구가 필요하다. 연구팀이 A2-MEAS라는 구체화 다중에이전트 프레임워크를 제안했으며, 이는 코드를 확장 인터페이스로 삼는다. 수정 코드는 수정 언어, 공간 증거, 실행 이력, 행동 제안을 결합하며, MetaBrain이 학습 감독과 런타임 지도를 제공한다. 전체 요약 12문장 읽기 → 061 15:10 ▲ 32 · 댓글 3 ML 실험 재현성을 높이는 ReproBridge 프레임워크 머신러닝 논문의 실험을 재현하려면 논문, 공개 코드, 보조 자료에 흩어진 정보를 모아 절차를 복원해야 하는데, AI 에이전트의 성공 여부가 누락된 세부 사항을 채우는 능력에 달려 있다. AI · 머신러닝 · ReproBridge: Building Reproducibility into ML Research Artifacts
Key Point 머신러닝 연구의 재현성 위기 속에서 표준화된 아티팩트 설계와 에이전트 워크플로우로 모든 모델의 성공률을 90% 이상으로 끌어올린 실질적 해결책이다.
핵심 요약
머신러닝 논문의 실험을 재현하려면 논문, 공개 코드, 보조 자료에 흩어진 정보를 모아 절차를 복원해야 하는데, AI 에이전트의 성공 여부가 누락된 세부 사항을 채우는 능력에 달려 있다. ReproBridge는 정제된 코드, 환경 설정, 실험 실행기, 재현 가이드로 구성된 표준화된 아티팩트를 구축하는 에이전트 워크플로우를 제시한다. ReproBridge-Bench는 36개 논문의 387개 실험에서 수집한 1,029개 작업으로 구성되며, 각 작업마다 5개의 인간 검증 기준 점수를 포함한다. 전체 요약 8문장 읽기 → 062 12:11 ▲ 225 · 댓글 613 클로드 페이블·미토스 5.2, 전문가 작업용 초강력 모델 출시 앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point 기업 소프트웨어 마이그레이션부터 블랙홀 이론물리 증명, 신약 전달용 단백질 설계까지 광범위한 분야에서 실제 문제를 해결하는 모델이 나왔으며, 이전 모델 대비 저렴한 가격으로 성능을 크게 향상시켰다.
핵심 요약
앤스로픽이 클로드 페이블 5.2와 미토스 5.2를 공개했으며, 두 모델은 동일한 기반이지만 페이블에는 사이버보안·생물학 보안 장치가 있어 모든 사용자에게 공개되고, 미토스는 검증 프로그램 신청 시 접근 가능하다. 페이블 5.2와 미토스 5.2는 코딩, 추론, 비전에서 이전 버전 대비 개선되었으며, 입력 토큰당 $8, 출력 토큰당 $40으로 페이블 5.1보다 저렴하고 토큰 생성 속도는 최대 30% 빨라졌다. 선택적 고속 모드는 토큰 생성을 최대 2.5배 빠르게 하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 12문장 읽기 → 063 12:11 ▲ 108 · 댓글 64 인피니언, 세계 처음 300mm 탄화규소 웨이퍼 양산 기술 확보 인피니언이 오스트리아 빌라흐 팹에서 300mm 탄화규소(SiC) 웨이퍼를 기능하는 전력 소자로 완성해 업계 최초 달성했다. 하드웨어 · 시스템 · The first 300-millimeter power silicon carbide (SiC) wafer
Key Point 전기차와 재생에너지, AI 데이터센터의 핵심 소재인 SiC 웨이퍼의 대규모 양산이 가능해지면서 반도체 공급 체인 안정화와 원가 절감의 기대감이 높아지고 있다.
핵심 요약
인피니언이 오스트리아 빌라흐 팹에서 300mm 탄화규소(SiC) 웨이퍼를 기능하는 전력 소자로 완성해 업계 최초 달성했다. 300mm 웨이퍼는 200mm 웨이퍼 대비 2.3배 많은 칩을 생산할 수 있어 기존 공정보다 효율성이 훨씬 높다. 기존 실리콘 제조 장비를 활용해 실제 반도체 팹 환경에서 300mm SiC 양산 기술을 완성했으며, 연구실 단계를 넘어 대규모 상용화 가능성을 보였다. 전체 요약 9문장 읽기 → 064 09:11 ▲ 18 · 댓글 3 신경망 파라미터를 직접 수정하는 WSP 기법 가능성과 한계 분석 Weight-Space Programming(WSP)은 신경망의 가중치를 직접 검사·수정하는 방식으로 기울기 기반 적응의 대안을 제시한다. AI · 머신러닝 · Exploring Weight-Space Programming: Capabilities, Generalization, and Limitations
Key Point 신경망을 역전파 없이 직접 수정하는 새로운 적응 방식의 가능성과 실제 한계를 실증적으로 밝혀, 모델 편집 연구의 방향을 제시한다.
핵심 요약
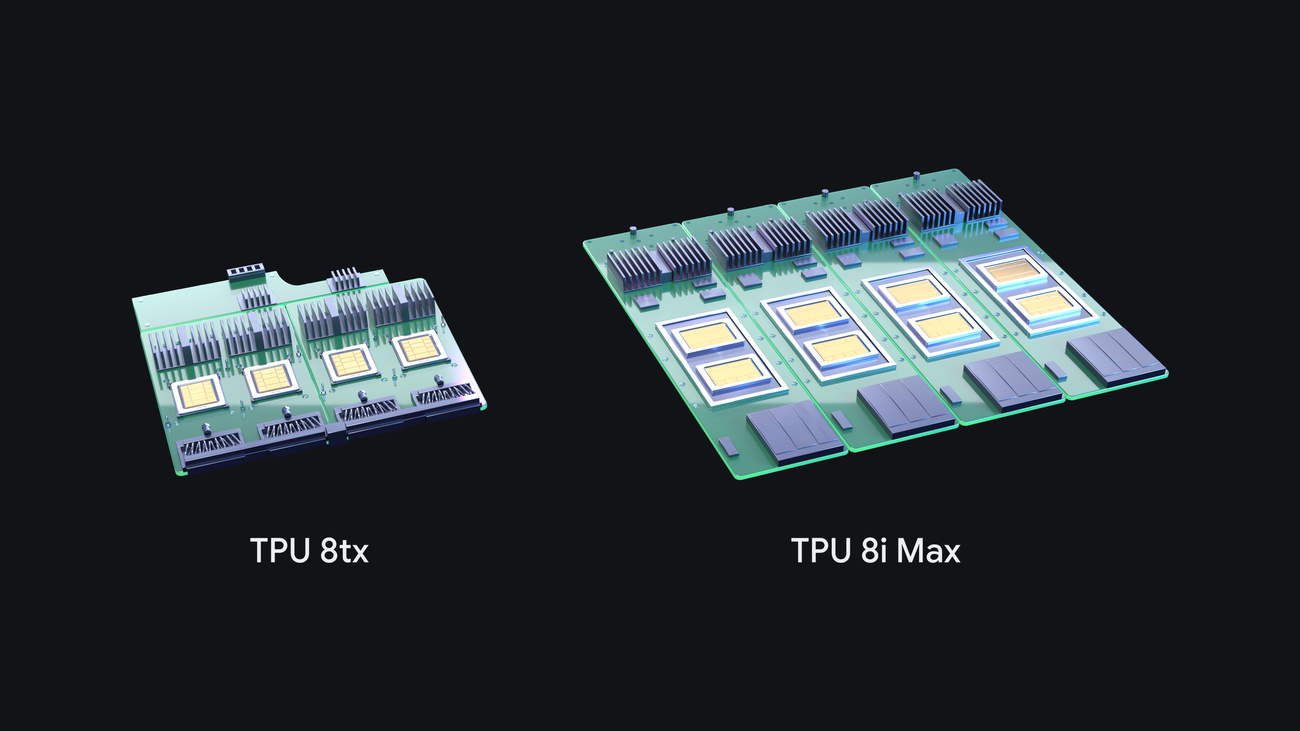
Weight-Space Programming(WSP)은 신경망의 가중치를 직접 검사·수정하는 방식으로 기울기 기반 적응의 대안을 제시한다. 7개 벤치마크와 2개 모델 규모(Qwen3.5-0.8B, Qwen3.5-9B)에서 16개 편집 궤적으로 체계적 조사를 수행했다. 극히 제한된 부위 수정으로도 큰 성능 향상이 가능해, MATH-500에서 29.45%p, GPQA Diamond 4.42%p, IFEval 36.72%p, SciBench 17.11%p 개선을 달성했다. 전체 요약 7문장 읽기 → 065 09:11 ▲ 155 · 댓글 22 구글, 에이전트 시대 맞춰 TPU 8tx·8i Max 공개 구글이 8세대 TPU 포트폴리오에 TPU 8tx와 TPU 8i Max를 추가해, 한 해 동안 네 개의 새로운 TPU 시스템을 출시했다. 인프라 · 데브옵스 · TPUs
Key Point 에이전트 AI 시대에 필요한 하드웨어 아키텍처가 극적으로 바뀌고 있으며, PyTorch 네이티브 지원 등으로 TPU 접근성이 대폭 개선돼 기존 GPU 중심의 개발 환경을 재편할 가능성이 있다.
핵심 요약
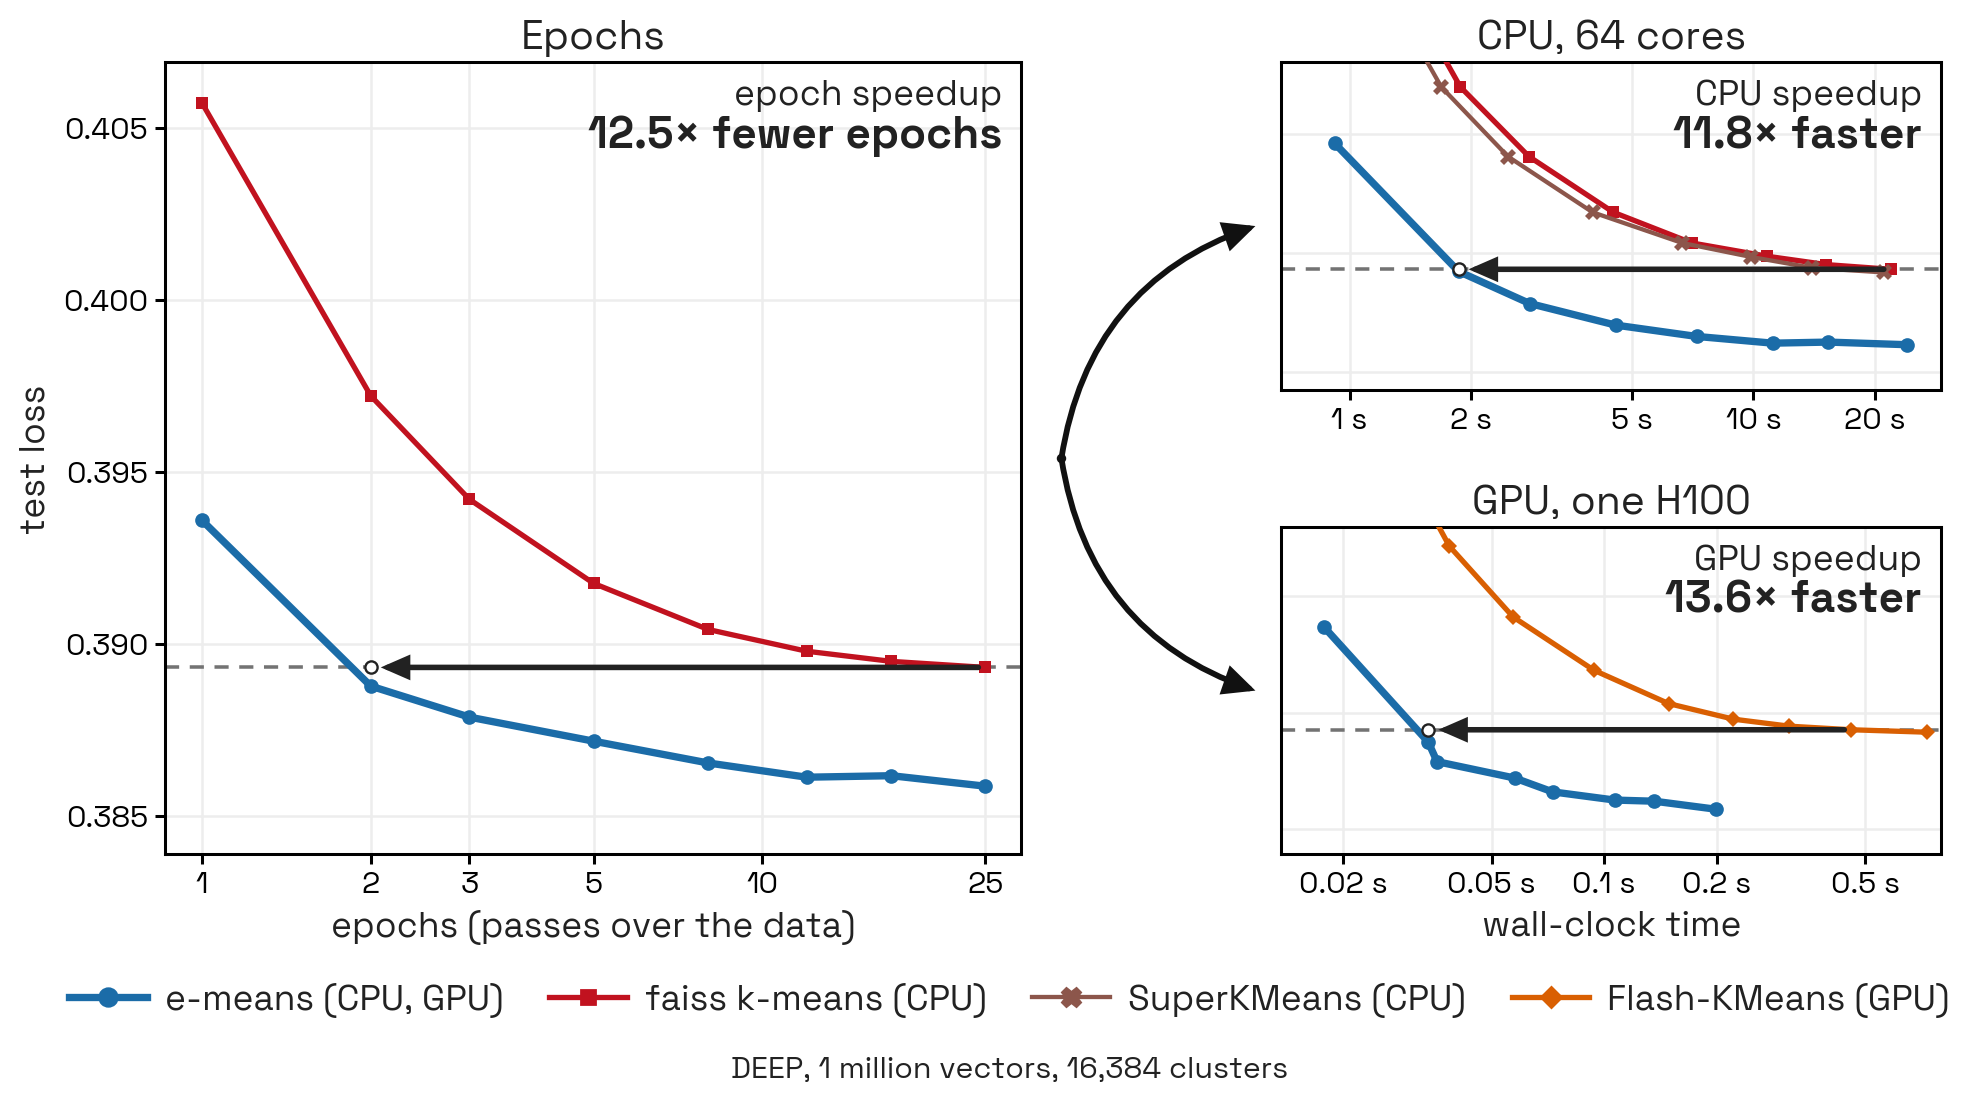
구글이 8세대 TPU 포트폴리오에 TPU 8tx와 TPU 8i Max를 추가해, 한 해 동안 네 개의 새로운 TPU 시스템을 출시했다. TPU 8t는 2.7배 더 빠른 학습 성능을, TPU 8i는 80% 더 나은 추론 가격 대비 성능을 제공한다. TPU 8tx는 민감한 데이터 보호를 위해 하드웨어 수준의 암호화를 탑재하고, AMD EPYC CPU와 결합해 추론 시 2배 낮은 지연 시간을 달성한다. 전체 요약 12문장 읽기 → 066 06:11 ▲ 115 · 댓글 4 로이드 알고리즘 10배 빠른 k-means 최적화 알고리즘 공개 Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. AI · 머신러닝 · E-means: 10x faster k-means at equal loss
Key Point 클러스터링은 벡터 양자화, 이미지 압축, 추천 시스템 등에 널리 쓰이는데, Lloyd 알고리즘이 표준이었던 상황에서 10배 빠르면서도 손실이 더 낮은 새 방식이 나왔으므로 기술 선택에 직결되는 소식이다.
핵심 요약
Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. e-means는 25 에포크에서 Lloyd가 도달하는 손실 수준에 1.2~3 에포크 안에 도달하며, 지스푸(Flash-KMeans) 대비 GPU에서 10~45배, Faiss 대비 CPU에서 8~15배 월클록 속도 개선을 실현했다. 핵심은 지수 이동 평균(exponential moving average)을 사용한 미니배치 업데이트로, 최신 할당(recent assignment)에 가중치를 두면서 과거 오래된 정보는 α 비율로 서서히 잊도록 설계했다. 전체 요약 10문장 읽기 → 067 06:11 ▲ 662 · 댓글 352 Claude Fable 5.2와 Mythos 5.2 공개, 코딩·과학 성능 대폭 향상 Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2를 공개했으며, 두 모델은 같은 기반 모델이지만 Mythos는 사이버보안·생물학 분야 검증 프로그램을 통해 제한적으로 제공된다. AI · 머신러닝 · Claude Fable 5.2 and Mythos 5.2
Key Point Fable 5.2와 Mythos 5.2는 상용 모델 중 가장 복잡한 엔지니어링·연구 작업을 수행할 수 있도록 설계되었으며, 코딩·수학 증명·물리학 문제 해결에서 구체적인 성과를 입증해 AI 실무 활용의 경계를 넓혔다.
핵심 요약
Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2를 공개했으며, 두 모델은 같은 기반 모델이지만 Mythos는 사이버보안·생물학 분야 검증 프로그램을 통해 제한적으로 제공된다. 테스트 결과 Fable 5.2와 Mythos 5.2는 이전 버전 대비 커뮤니케이션이 명확하고, 토큰 생성 속도는 30% 빠르며, 입력 토큰 800만 개당 $8, 출력 토큰 100만 개당 $40으로 가격이 인하됐다. 선택적 fast mode는 토큰 생성을 최대 2.5배 가속하며 입력 토큰당 $16, 출력 토큰당 $80이다. 전체 요약 16문장 읽기 → 068 03:11 ▲ 35 · 댓글 3 LLM은 자신의 지식을 잘못 알고 있다 LLM의 금융 백테스트가 의미 있으려면 모델이 예측 대상 결과를 미리 알지 않았을 때만 유효한데, 공급사의 학습 마감일 보장·모델의 자기 보고·과거 날짜 지시 등이 이를 확인할 수 있는지 검증하는 연구다. AI · 머신러닝 · LLMs Don't Know What They Know: Benchmarking Temporal Self-Knowledge for Financial Backtesting
Key Point LLM 금융 모델의 신뢰성을 검증하는 데 자기 보고와 학습 마감일이 얼마나 신뢰할 수 없는지를 측정했으며, 이는 과거 데이터에 대한 백테스트 유효성을 재검토해야 함을 시사한다.
핵심 요약
LLM의 금융 백테스트가 의미 있으려면 모델이 예측 대상 결과를 미리 알지 않았을 때만 유효한데, 공급사의 학습 마감일 보장·모델의 자기 보고·과거 날짜 지시 등이 이를 확인할 수 있는지 검증하는 연구다. FinDendro 벤치마크는 1999~2026년 미국 경제 사실 2,226개를 포함하며 월간 거시경제 지표·월말 주가·연방준비제도 결정 등을 다룬다. 각 사실마다 값 질문, 지식 여부 추측 질문, 과거 날짜를 명시한 예측 질문 등 네 가지 형태의 프롬프트를 생성해 우연의 정확도를 약 0.27 수준으로 조정한 통제 변수를 설정했다. 전체 요약 6문장 읽기 → 069 03:11 ▲ 21 · 댓글 4 비용 65% 줄이고 정확도까지 높이는 AI 에이전트 협업 장기 작업을 수행하는 AI 에이전트는 클라우드의 고성능 모델로 구동하면 비용이 비싼 반면, 저비용 모델은 성능이 떨어진다. AI · 머신러닝 · AgentBaton: Efficient Model Collaboration in Agentic Tasks
Key Point 고성능 AI 모델 비용을 획기적으로 줄일 수 있는 실용적 방법이 제시되어, 개발 팀이 AI 에이전트 프로젝트의 운영 비용을 최적화하는 데 바로 적용할 수 있다.
핵심 요약
장기 작업을 수행하는 AI 에이전트는 클라우드의 고성능 모델로 구동하면 비용이 비싼 반면, 저비용 모델은 성능이 떨어진다. 연구팀은 고성능 모델과 저비용 모델이 하나의 장기 작업 내에서 협력할 때 비용을 줄이면서도 정확도를 유지할 수 있는지 체계적으로 조사했다. 모델 간 역할 교대(handoff)를 통해 협력하며, 교대 방향(누가 누구에게 넘길지)과 맥락 전달 방식을 핵심 설계 항목으로 삼았다. 전체 요약 8문장 읽기 → 070 03:11 ▲ 109 · 댓글 36 자주색 태양광판이 풀어내는 농업-에너지 공존 농경지와 태양광발전소는 모두 넓은 땅과 햇빛을 필요로 하는데, 같은 땅에 두 시설을 함께 배치하는 '애그리볼태익스'로 한정된 토지를 효율적으로 활용할 수 있다. 하드웨어 · 시스템 · Magenta solar panels may be agrivoltaics' cleverest trick yet
Key Point 농경지 부족과 에너지 수요 사이의 토지 경합을 풀 수 있는 새로운 기술로, 식물의 생육 효율까지 높일 수 있다는 점이 기존 솔루션과 다르다.
핵심 요약
농경지와 태양광발전소는 모두 넓은 땅과 햇빛을 필요로 하는데, 같은 땅에 두 시설을 함께 배치하는 '애그리볼태익스'로 한정된 토지를 효율적으로 활용할 수 있다. 새로운 연구는 반투명 태양광판을 사용해 식물 광합성에 필수적인 파장은 통과시키고 발전에 필요한 파장은 흡수하는 방식으로 작물과 전력을 함께 생산한다. 자주색 태양광판 아래서 재배한 브로콜리는 수확까지 25일이 더 소요되었지만 생산량은 비슷한 수준을 유지했고, 식물 생체량은 무차광 재배 대비 2.8~4.5배 증가했다. 전체 요약 10문장 읽기 → 071 00:11 ▲ 100 · 댓글 100 애플, 엔지니어 AI 비용을 하루 200달러로 제한 애플이 일부 엔지니어의 일일 AI 지출 상한을 300달러에서 200달러로 인하했으며, 이는 AI 지출이 예산을 초과할 위험을 나타낸다. AI · 머신러닝 · Apple capped engineers at a $200 daily AI budget
Key Point 업계 최강자인 애플도 AI 지출 제한을 시작했다는 것은 생성형 AI의 실제 비용이 개발사들의 예상을 초과하고 있음을 의미하며, 모든 개발팀이 토큰 효율성을 심각하게 재검토해야 하는 상황이 됐다는 신호다.
핵심 요약
애플이 일부 엔지니어의 일일 AI 지출 상한을 300달러에서 200달러로 인하했으며, 이는 AI 지출이 예산을 초과할 위험을 나타낸다. 미시간대학교 연구팀은 영어가 아닌 언어의 프롬프트가 영어보다 최대 179배 많은 에너지를 소비한다고 발견했다. 팔로알토 네트웍스가 AI 에이전트 접근제어 기술을 갖춘 사이버보안 스타트업 클러치 인수를 추진 중이며, 인수가는 약 5억 달러다. 전체 요약 9문장 읽기 → 072 21:11 당일 +867 LLM 기반 주식 자동 분석 시스템, GitHub 트렌드 1위 중국 개발자 주린센이 공개한 주식 자동 분석 시스템으로, LLM을 활용해 A주·홍콩·미국·일본·한국·대만 주식을 실시간 분석한다. AI · 머신러닝 · ZhuLinsen/daily_stock_analysis · Python
Key Point GitHub Actions로 무료 서버 없이 전 세계 주식을 자동 분석하고 실시간 알림받을 수 있는 완전한 시스템을 5분 만에 구축할 수 있다는 점이 개발자들의 큰 관심을 받는 이유다.
핵심 요약
중국 개발자 주린센이 공개한 주식 자동 분석 시스템으로, LLM을 활용해 A주·홍콩·미국·일본·한국·대만 주식을 실시간 분석한다. 다중 데이터 소스(AkShare, Tushare, YFinance, Longbridge)와 실시간 뉴스(Anspire, SerpAPI, Tavily 등)를 통합해 핵심 결론·평가·추세·매매 시점·위험 경보·촉매 요인·체크리스트를 포함한 결정 대시보드를 생성한다. GitHub Actions(무료), Docker, 로컬 정시 작업으로 매일 자동 실행되며 기업 위챗·페이셔·Telegram·Discord·Slack·이메일 등 여러 채널로 분석 결과를 푸시할 수 있다. 전체 요약 11문장 읽기 → 073 21:11 당일 +412 구글 딥마인드, 다중관절 물리 시뮬레이터 MuJoCo 오픈소스화 MuJoCo(Multi-Joint dynamics with Contact)는 로봇공학, 생역학, 그래픽스, 머신러닝 등 다양한 분야의 연구개발을 지원하는 범용 물리 엔진으로, Google DeepMind가 유지보수한다. 오픈소스 · 도구 · google-deepmind/mujoco · C++
Key Point Google DeepMind의 물리 시뮬레이션 엔진이 오픈소스로 공개되어, 로봇공학 및 AI 연구에 기여할 수 있는 강력한 도구가 누구나 접근 가능해졌다.
핵심 요약
MuJoCo(Multi-Joint dynamics with Contact)는 로봇공학, 생역학, 그래픽스, 머신러닝 등 다양한 분야의 연구개발을 지원하는 범용 물리 엔진으로, Google DeepMind가 유지보수한다. C API를 제공하며 저수준 데이터 구조에 최적화된 런타임 시뮬레이션 모듈로 높은 성능을 목표로 하고, 데스크톱 및 웹 브라우저에서 대화식 시각화를 지원한다. Python 바인딩, Unity 플러그인, JavaScript/WebAssembly 바인딩 등 다양한 언어 및 플랫폼 지원을 제공하며, 물리량 계산을 위한 다수의 유틸리티 함수를 포함한다. 전체 요약 10문장 읽기 → 074 18:11 ▲ 62 · 댓글 8 매개변수 사전활용으로 멀티티처 증류 2배 빠르게 다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. AI · 머신러닝 · P^2-MOPD: Accelerating Multi-Teacher On-Policy Distillation via Parameter Priors
Key Point 멀티티처 증류에서 훈련 단계를 50% 단축하고 최종 성능을 14% 향상시키는 방법이 제시되어, 대규모 모델 병렬화 연구에 실질적 가치가 있다.
핵심 요약
다중 전문가 모델의 능력을 학생 모델에 전이하는 온폴리시 증류(on-policy distillation)는 학생이 생성한 궤적을 감독하는 방식으로 작동한다. 기존 태스크 산술(task arithmetic)은 학생과 전문가 매개변수를 선형결합하되 두 모델의 범위 내에만 머물게 되는 한계가 있다. P²-MOPD는 학생과 전문가 매개변수의 선형결합을 하나의 미분가능한 모델로 보고, 혼합 계수와 학생 가중치를 동일한 목적함수 아래 공동 최적화한다. 전체 요약 6문장 읽기 → 075 18:11 ▲ 70 · 댓글 2 3D 가우시안 스플래팅, 장면 규모 차이 극복하다 기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. AI · 머신러닝 · SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes
Key Point 3D 장면 재구성의 핵심 문제인 규모 변화에 대한 보다 견고한 해결책을 제시해 3DGS 기반 응용 분야에서 일반화 성능을 높일 수 있다.
핵심 요약
기존 피드포워드 3DGS(3D 가우시안 스플래팅) 방법들은 가우시안 속성을 반지름 거리 정규화 공간에서 예측했는데, 이때 인접한 가우시안 중심 간의 간격이 장면 규모와 카메라 설정에 따라 크게 변한다. 이 불일치로 인해 가우시안 스케일 타겟에 체계적 편향이 생기고 학습 신호가 모호해지는 문제가 발생한다. SplatAnything은 Gaussian Spacing Normalization(GSNorm)을 도입해 장면 수준의 가우시안 간격 통계를 정규화하고 예측을 위한 일관된 공간 기준을 제공한다. 전체 요약 5문장 읽기 → 076 18:11 ▲ 100 · 댓글 55 냉전 역사 복원 위한 AI 퍼즐, 수십년 노력 후에도 난제 1989~90년 동독 비밀경찰(Stasi) 조직 해산 당시 직원들이 불법 행위 증거를 없애려 대량의 문서를 찢었고, 약 16,000개 자루에 4~6억 개 조각으로 분산되어 있다. 기타 · The Reconstruction of Torn Documents
Key Point 냉전 종료 후 30년 이상 진행된 역사 문서 복원 프로젝트가 첨단 기술로도 해결하지 못한 이유와, 대규모 디지털 복원이 실제로 얼마나 복잡한 문제인지 보여준다.
핵심 요약
1989~90년 동독 비밀경찰(Stasi) 조직 해산 당시 직원들이 불법 행위 증거를 없애려 대량의 문서를 찢었고, 약 16,000개 자루에 4~6억 개 조각으로 분산되어 있다. 독일 연방기록원은 2007년부터 Fraunhofer IPK 연구소와 함께 e-Puzzler라는 소프트웨어로 컴퓨터 자동 복원을 시도했으나, 2013년 기술 검증 후 대량 생산에 부적합하다는 판정을 받았다. 자동 복원률이 목표한 80% 이상에 도달하지 못했고, 약 6.5백만 유로를 투입했음에도 약 15,500개 자루를 경제적으로 처리할 방법을 찾지 못했다. 전체 요약 9문장 읽기 → 077 15:12 ▲ 28 · 댓글 3 AI 에이전트의 '마지막 1마일' 해결하는 재사용 가능한 프리미티브 등장 현재 최고 수준의 AI 모델도 실제 과제 처리에서 리소스에 접근한 후 이를 적용하는 단계에서 실패하는 '마지막 1마일' 문제를 겪고 있다. AI · 머신러닝 · The Last Mile to the Real World: Agent-Native Primitives as Reusable Building Blocks for Solving Real-World Tasks
Key Point AI 에이전트가 실제 업무에서 마주치는 가장 큰 병목인 '리소스 적용 능력' 문제를 근본적으로 해결하는 방법론을 제시해, 현재 시스템의 성능을 대폭 끌어올린 핵심 기술이기 때문이다.
핵심 요약
현재 최고 수준의 AI 모델도 실제 과제 처리에서 리소스에 접근한 후 이를 적용하는 단계에서 실패하는 '마지막 1마일' 문제를 겪고 있다. Terminal-Bench 4.0에서 GPT-5.6 Sol은 37.3%, Claude Opus 5는 51.8%의 과제만 해결했다. 연구팀은 에이전트 네이티브 프리미티브(agent-native primitives)라는 재사용 가능한 단위를 제안했으며, 각 프리미티브는 내장된 LLM으로 리소스를 적용하고 다른 프리미티브와 통신한다. 전체 요약 8문장 읽기 → 078 12:11 ▲ 105 · 댓글 32 번호판만으로 차량 원격 제어 가능한 결함 발견 보안 연구자가 특정 자동차 제조사의 커넥티드카 플랫폼에서 심각한 취약점을 발견했다. 보안 · Unlocking any car from X brand in most of the world
Key Point 자동차 소유자가 차량 번호판만으로도 원격 제어될 수 있다는 의미이며, 커넥티드카 보안의 구조적 결함(외부 노출 인증 시스템, 하드코딩된 자격증명, WAF 우회 가능성)을 노출한다.
핵심 요약
보안 연구자가 특정 자동차 제조사의 커넥티드카 플랫폼에서 심각한 취약점을 발견했다. 안드로이드 앱을 역컴파일해 관리 도구(admintool) 하위도메인을 찾았는데, 하드코딩된 API 키로 인증 없이 접근 가능했다. 호주의 번호판 조회 시스템과 결합하면 번호판만으로 VIN(차량식별번호)을 얻을 수 있고, 이를 통해 사용자의 메일과 계정 정보까지 추출 가능했다. 전체 요약 10문장 읽기 → 079 06:11 ▲ 10 · 댓글 3 음성 언어 모델의 응답 지연을 73% 줄이는 추론 기법 청크 단위로 음성을 주고받는 풀듀플렉스 음성 언어 모델은 대기 중 연산 자원이 유휴 상태가 되어 응답과 도구 호출이 지연되는 문제가 있다. AI · 머신러닝 · Decode Before You Hear: Speculative Listening for Chunk-Interleaved Full-Duplex Speech Language Models
Key Point 실시간 음성 대화 AI의 응답 지연을 인간 수준으로 줄이는 기술적 해법이 실제 모델들에서 어떻게 작동하고 얼마나 효과적인지 구체적으로 보여준다.
핵심 요약
청크 단위로 음성을 주고받는 풀듀플렉스 음성 언어 모델은 대기 중 연산 자원이 유휴 상태가 되어 응답과 도구 호출이 지연되는 문제가 있다. 연구팀은 무음을 입력으로 가정해 다음 청크를 미리 생성하는 '스펙큘러티브 리스닝(Speculative Listening)' 기법을 제안했다. 4개 모델 분석 결과 다음 음성 청크가 출력을 바꾸지 않는 경우가 95.3%였고, 변화가 생기는 88%는 첫 번째 출력 토큰부터 시작됐다. 전체 요약 8문장 읽기 → 080 06:11 ▲ 133 · 댓글 8 모델 상태만 지정하면 드래그 상호작용을 자동 생성 Joshua Horowitz, Andrew Blinn, Jeffrey Heer가 UIST 2026 최고의 논문상을 받은 '선언형 드래깅(Declarative Dragging)' 기법을 소개했다. 웹 · 프론트엔드 · Declarative Dragging
Key Point 인터페이스 제작자가 코드를 거의 짜지 않고도 고품질의 드래그 상호작용을 구현할 수 있는 새로운 패러다임을 제시하므로, 교육 도구, 게임, 수학 탐구 환경 등 다양한 분야에서 상호작용 설계의 진입장벽을 낮춘다.
핵심 요약
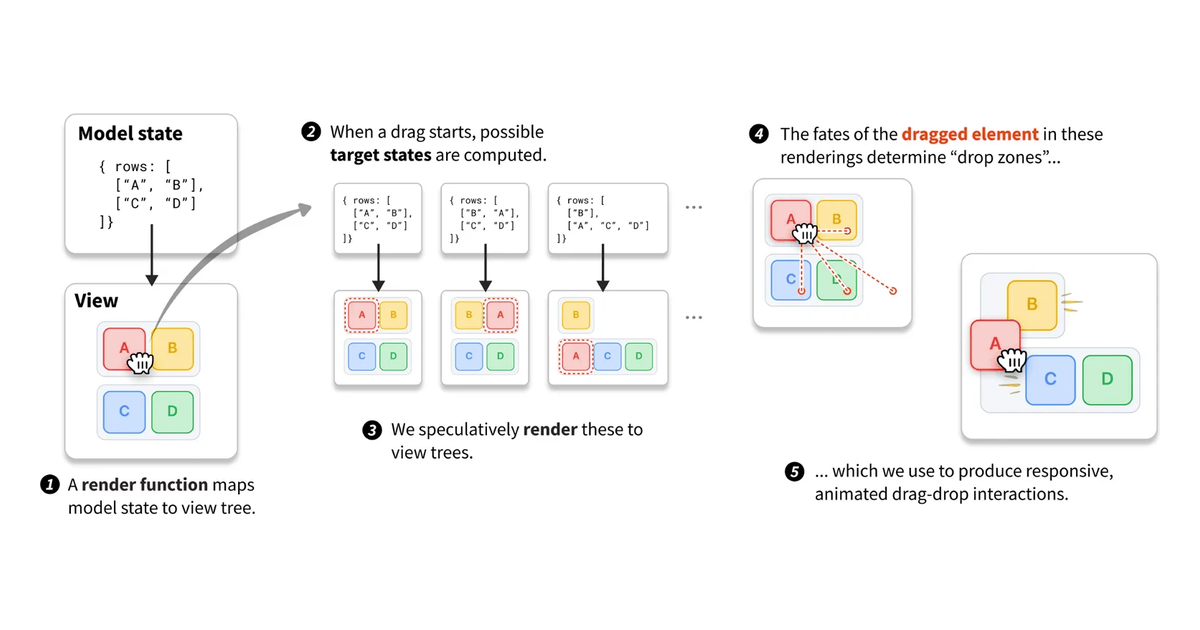
Joshua Horowitz, Andrew Blinn, Jeffrey Heer가 UIST 2026 최고의 논문상을 받은 '선언형 드래깅(Declarative Dragging)' 기법을 소개했다. 기존 드래그 상호작용은 기하학, 피드백, 애니메이션을 다루는 복잡한 코드가 필요했으나, 이 방식은 요소를 드래그했을 때 도달할 수 있는 미래 상태만 지정하면 된다. 시스템이 이러한 상태들을 추론적으로 렌더링해 실제 위치를 파악한 후, 가능한 모든 상태를 결합해 매끄러운 드래그-드롭 상호작용을 자동 생성한다. 전체 요약 10문장 읽기 → 081 03:11 ▲ 133 · 댓글 39 종이와 펜이 사고력을 바꾼다 저자는 중학생 때 텍스트 이해에 어려움을 겪다가 마인드맵을 활용해 필기하면서 문제를 해결했고, 이후 쓰기가 단순한 정보 저장이 아닌 정보 처리 도구임을 깨달았다. AI · 머신러닝 · Writing as a thinking tool
Key Point LLM이 글을 대신 써주는 시대에 '직접 쓰기'가 여전히 필수인 이유, 그리고 실제로 글을 써서 사고하는 구체적인 방법을 알 수 있다.
핵심 요약
저자는 중학생 때 텍스트 이해에 어려움을 겪다가 마인드맵을 활용해 필기하면서 문제를 해결했고, 이후 쓰기가 단순한 정보 저장이 아닌 정보 처리 도구임을 깨달았다. 컴퓨터 과학자 Manuel Blum의 조언에 따르면 유한 오토마타는 덧셈만 가능하지만 튜링 머신은 모든 계산 가능한 함수를 계산할 수 있으며, 둘의 유일한 차이는 튜링 머신이 종이와 펜을 가지고 있다는 점이다. 종이를 없애면 복잡도 등급 전체가 하락하므로, 쓰기는 인간의 사고 능력을 근본적으로 향상시킨다. 전체 요약 13문장 읽기 → 082 21:11 당일 +145 AI와 협력하는 학술 연구 플랫폼 Agentero 공개 Zotero 시대의 인-에이전트 협력 단절을 극복하기 위해 개발된 통합 연구 워크스페이스로, 논문·노트·AI 대화를 한곳에서 관리한다. AI · 머신러닝 · poco-ai/Agentero · TypeScript
Key Point 논문 관리부터 AI 기반 분석까지 산재된 학술 워크플로우를 하나로 통합하는 방식이 기존 Zotero·Obsidian·ChatGPT 간 수동 복사-붙여넣기 방식의 대안을 제시한다.
핵심 요약
Zotero 시대의 인-에이전트 협력 단절을 극복하기 위해 개발된 통합 연구 워크스페이스로, 논문·노트·AI 대화를 한곳에서 관리한다. PDF 읽기 환경은 인간에게 친화적으로 유지하면서 자동으로 구조화된 Markdown과 LaTeX로 변환해 AI 모델이 정확하게 인식할 수 있게 제공한다. 도형·수식·표를 자동 추출하고 쌍방향 링크 노트, 다중 모드 번역(구간·페이지·전문), 전문 검색을 지원하는 결구화된 편집 시스템을 갖췄다. 전체 요약 9문장 읽기 → 083 21:11 당일 +228 AI가 당신 제품을 어떻게 말하나, 직접 확인하세요 NiubiGEO는 AI 응답에서 브랜드 가시성과 경쟁사 언급을 추적하는 오픈소스 도구다. AI · 머신러닝 · Albert-Weasker/niubigeo · TypeScript
Key Point AI 검색이 제품 추천에 미치는 영향이 커지는 만큼, 각 모델이 실제로 당신을 어떻게 보는지 직접 조사하고 출처까지 검증할 수 있는 도구의 출현은 제품 마케팅 전략에 실질적인 변화를 가져올 수 있다.
핵심 요약
NiubiGEO는 AI 응답에서 브랜드 가시성과 경쟁사 언급을 추적하는 오픈소스 도구다. 도메인을 입력하면 ChatGPT·Claude 등 여러 모델이 해당 제품을 어떻게 설명하는지, 어떤 경쟁사를 함께 언급하는지 비교할 수 있다. 각 결과마다 원본 답변과 출처를 검증 가능하게 저장해, 점수만 주는 상용 GEO 도구와 달리 증거 기반의 판단을 돕는다. 전체 요약 11문장 읽기 → 084 21:11 ▲ 101 · 댓글 97 리눅스 커널 저장소, 역할별 가이드 대폭 정리 리눅스 커널의 공식 GitHub 저장소가 사용자별 맞춤형 문서 구조로 개편했다. 오픈소스 · 도구 · GitHub Down Again?
Key Point 리눅스 커널 개발에 참여하려던 개발자들이 방대한 저장소에서 자신의 역할에 맞는 시작점을 쉽게 찾을 수 있게 되었고, 특히 AI 도구 기여자에 대한 명확한 규칙 제시로 법적·윤리적 투명성이 강화되었다.
핵심 요약
리눅스 커널의 공식 GitHub 저장소가 사용자별 맞춤형 문서 구조로 개편했다. 신규 개발자부터 보안 전문가, 하드웨어 벤더, AI 코딩 어시스턴트까지 9가지 역할 카테고리를 제시한다. 각 역할별로 관련 문서와 리소스를 체계적으로 정렬해 진입 장벽을 낮추고 기여 경로를 명확히 했다. 전체 요약 6문장 읽기 → 085 18:15 스타 1,119 LLM이 신경망 가중치를 이해하고 작성하는 실험 로그 공개 블로그 포스트 '가중치 공간 프로그래밍의 불꽃: LLM이 신경망 가중치를 이해하고 작성할 수 있다'의 전체 실험 로그를 GitHub에 공개했다. AI · 머신러닝 · RikiyaT/lm_understand-logs · Python
Key Point LLM이 실제로 신경망 가중치 구조를 이해하고 조작할 수 있음을 보여주는 체계적인 실험의 완전한 재현 자료로, 신경망과 LLM의 관계를 탐구하는 연구자에게 필수적인 참고 자료다.
핵심 요약
블로그 포스트 '가중치 공간 프로그래밍의 불꽃: LLM이 신경망 가중치를 이해하고 작성할 수 있다'의 전체 실험 로그를 GitHub에 공개했다. 게임 네트워크 식별, 확산 모델 분석, 언어 모델 중간층 분석, 가중치 편집 수정, 처음부터 네트워크 작성 등 8개 실험을 담았다. 각 실험은 모델에 보낸 프롬프트, 모델의 응답, 실행한 코드와 출력, 평가 점수, 읽거나 작성한 신경망을 모두 포함한다. 전체 요약 8문장 읽기 → 086 18:15 스타 1,540 AI 에이전트 군단이 펜테스트 자동화 챔피언 Sapper-v2는 다중 에이전트 오케스트레이션 시스템으로, 상황 판단하는 AI 지휘관과 병렬로 동작하는 작업자 군단, 계층화된 사실-의도 그래프로 구성된다. AI · 머신러닝 · N1nEmAn/sapper-v2 · Python
Key Point 자동화된 AI 에이전트 군단이 경쟁에서 실제로 증명한 효율성과 자율적 창의성 — 기존 단일 에이전트 접근법과 근본적으로 다른 멀티에이전트 오케스트레이션의 현실 가능성을 보여주기 때문이다.
핵심 요약
Sapper-v2는 다중 에이전트 오케스트레이션 시스템으로, 상황 판단하는 AI 지휘관과 병렬로 동작하는 작업자 군단, 계층화된 사실-의도 그래프로 구성된다. 텐센트 클라우드 지능형 공격방어 대회 3차 온라인 예선에서 634개 팀 중 우승하며 85개 플래그를 80.18점으로 확보했고, 1억 개 토큰으로 4.5억 개 토큰을 쓴 준우승팀과 같은 수의 플래그를 25초 더 빠르게 해결했다. 지휘관, 장군, 척후병, 병사 역할로 나뉘며, 지휘관은 GLM-5.3, 하위 역할은 더 가벼운 DeepSeek V4.1 Flash를 써서 토큰 효율을 극대화한다. 전체 요약 10문장 읽기 → 087 18:15 스타 1,866 모든 나라의 법을 git으로 추적하는 'Global Law' 전 세계 각국의 법령을 깃 저장소로 관리하는 프로젝트로, 모든 단어가 어느 법에서 나왔는지 추적 가능하며 특정 날짜 기준 법령도 조회할 수 있다. 오픈소스 · 도구 · lexifina/global-law · HTML
Key Point 법령 연구·법무 업무·정책 결정 시 특정 시점의 정확한 법령 내용을 추적할 수 있고, AI 모델이 직접 활용할 수 있는 인프라로 법률 AI 서비스 개발의 토대가 될 수 있다.
핵심 요약
전 세계 각국의 법령을 깃 저장소로 관리하는 프로젝트로, 모든 단어가 어느 법에서 나왔는지 추적 가능하며 특정 날짜 기준 법령도 조회할 수 있다. 각 국가별 법령을 독립 저장소(lexifina/<국가>-law)로 운영하고, 각 커밋이 시���된 법을 나타내며 In-force 날짜로 시간별 조회를 지원한다. 미국·스위스·네덜란드·프랑스·독일·폴란드·브라질·오스트리아·핀란드에서 판례까지 포함해 제공하며, 각 나라 법령 저장소는 자체 라이선스 조건에 따른다. 전체 요약 7문장 읽기 → 088 18:15 스타 1,787 학생 신분 검증 자동화 도구, Node.js 기반 오픈소스 공개 Node.js 22.15 이상 기반 검증 흐름 자동화 프로젝트로, 웹 워크스테이션·작업 큐·브라우저 양식 상호작용·HTTP 상태 조회를 제공한다. 오픈소스 · 도구 · JenkinWoo/sheeridVerify · JavaScript
Key Point 학생 신분 검증 자동화 도구를 만드는 개발자와 보안 감시자가 이 구현 방식(브라우저 제어, 문서 업로드, 상태 폴링, 프록시 통합)과 제약(20 MiB 크기, 3회 재시도, 메모리만 보존)을 정확히 파악해야 하기 때문이다.
핵심 요약
Node.js 22.15 이상 기반 검증 흐름 자동화 프로젝트로, 웹 워크스테이션·작업 큐·브라우저 양식 상호작용·HTTP 상태 조회를 제공한다. 로컬 웹 인터페이스(127.0.0.1:8787)에서 검증 링크, 이름, 성, 생년월일, 프록시를 입력해 작업을 생성·대기열·중지·복구·삭제할 수 있다. 브라우저 자동 채우기(Camoufox 사용)와 문서 업로드 흐름을 분리하며, 자동 제출 후 기본 5초마다 상태를 폴링해 결과를 추적한다. 전체 요약 12문장 읽기 → 089 18:15 스타 3,023 Android 앱의 권한·데이터 흐름 추적하는 NOIR 공개 Kotlin으로 만든 Android 감시 도구 NOIR는 ADB를 통해 연결된 안드로이드 기기의 앱 권한, 네트워크 요청처, 데이터 흐름을 자동으로 분석하고 위험도를 평가한다. 보안 · Verlintas/NOIR · Kotlin
Key Point 개발자와 보안 연구자가 자신의 안드로이드 기기에서 앱의 권한 악용과 데이터 누출 위험을 직접 감시하고 되돌릴 수 있는 도구가 공개되었기 때문이다.
핵심 요약
Kotlin으로 만든 Android 감시 도구 NOIR는 ADB를 통해 연결된 안드로이드 기기의 앱 권한, 네트워크 요청처, 데이터 흐름을 자동으로 분석하고 위험도를 평가한다. 설치된 모든 앱의 권한·민감정보 접근 권리를 나열하고, 각 APK에서 URL 엔드포인트를 추출해 패킷 전송을 최소화한다. 제조사와 앱 카테고리(텔레메트리, 광고, 위치 추적, 입력기)를 인식해 분류하고, 권한과 상보 도메인을 매칭해 '어느 데이터가 어디로 흘러갈 수 있는지' 추적한다. 전체 요약 12문장 읽기 → 090 18:15 스타 20,986 DeepSeek의 자율 코딩 에이전트 프로토타입 공개 DeepSeek이 GitHub 저장소 관리를 위한 프로토타입 에이전트 시스템 'dsh-superagent'를 공개했다. AI · 머신러닝 · deepseek-ai/dsh-superagent-prototype · TypeScript
Key Point 에이전트가 실제 리포지토리 운영 업무를 자동화하는 방식과 사람의 개입을 최소화하는 설계 철학이 향후 개발팀의 작업 방식을 바꿀 수 있기 때문이다.
핵심 요약
DeepSeek이 GitHub 저장소 관리를 위한 프로토타입 에이전트 시스템 'dsh-superagent'를 공개했다. 이는 연구 코드로 공식 제품이 아니며, 에이전트가 직접 작성한 부분이 많아 완성도나 코드 스타일이 불일치할 수 있다. dsh-superagent는 GitHub와 선택적으로 Feishu를 통해 요청을 받고, 사용자가 허락한 작업을 자동으로 수행한다. 전체 요약 8문장 읽기 → 091 15:11 ▲ 102 · 댓글 66 우라늄 큐브로 드러난 독일 핵 프로젝트의 실패 원인 2차 대전 중 독일의 B8 원자로 실험이 실패한 이유를 놓고 역사가들이 논쟁해왔다: 베르너 하이젠베르크는 우라늄 부족이 원인이었다고 주장했지만, 미국 과학자들의 새로운 분석은 다른 결론을 내렸다. 하드웨어 · 시스템 · Uranium cubes reveal why the German nuclear project failed
Key Point 하이젠베르크의 역사적 주장을 우라늄 큐브 물증과 최신 분석으로 검증한 결과, 2차 대전 핵 경쟁의 진짜 이유가 물질 부족과 기술 격차였음이 드러났다.
핵심 요약
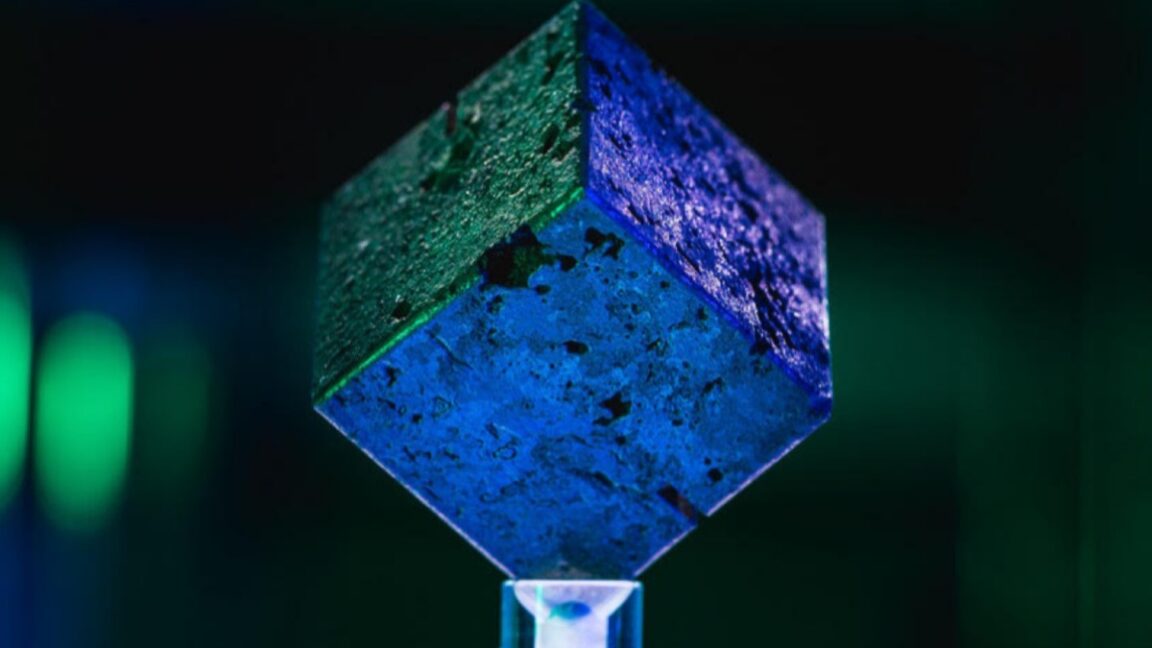
2차 대전 중 독일의 B8 원자로 실험이 실패한 이유를 놓고 역사가들이 논쟁해왔다: 베르너 하이젠베르크는 우라늄 부족이 원인이었다고 주장했지만, 미국 과학자들의 새로운 분석은 다른 결론을 내렸다. 독일 과학자들이 사용한 우라늄 큐브를 추적한 연구팀은 2013년 한 물리학자가 선물로 받은 큐브를 시작으로 현존하는 14개 중 10개를 미국 각지에서 발견했다. B8 원자로는 항공기 케이블로 엮인 664개 우라늄 큐브를 중수 탱크에 담아 만들었으며, 1944년 겨울 독일군이 하이거로흐 마을 성 아래 동굴로 이동해 건설했다. 전체 요약 7문장 읽기 → 092 09:11 ▲ 119 · 댓글 69 우주에서 생명은 얼마나 오래 살아남을 수 있나 생명체가 비활성 상태에서 얼마나 오래 생존 가능한지는 우주 탐사의 세 가지 영역에 영향을 미친다: 우주선 오염 위험(수년~수십 년), 태양계 초기의 생명 이동 가능성(수백만 년), 화성과 소행성의 생명 발견 가능성(수억 년). 기타 · How Long Can Life Wait?
Key Point 화성 탐사와 생명 탐색의 가능성을 결정하는 미생물 생존 시간이 영역별로 어떻게 다르며, 현재 과학이 고대 생명 검증에서 얼마나 불완전한지를 명확히 보여준다.
핵심 요약
생명체가 비활성 상태에서 얼마나 오래 생존 가능한지는 우주 탐사의 세 가지 영역에 영향을 미친다: 우주선 오염 위험(수년~수십 년), 태양계 초기의 생명 이동 가능성(수백만 년), 화성과 소행성의 생명 발견 가능성(수억 년). 우주에서 미생물을 죽이는 가장 큰 요인은 자외선이며, 수 초의 노출로 DNA를 파괴한다. 그러나 먼지나 틈, 죽은 미생물의 시체 같은 미량의 차폐도 자외선으로부터 충분히 보호한다. 2015년 일본의 탄포포 실험에서 국제우주정거장에 매달린 세균 판에서 3년 후 방사능 내성균(디나이오코커스 라디오듀란스)이 지표 표본보다 더 건강한 상태였으며, 1mm 크기의 펠릿은 우주 직접 노출에서 2~8년, 차폐 시 수십 년 생존 가능할 것으로 추정된다. 전체 요약 16문장 읽기 → 093 06:11 ▲ 221 · 댓글 122 마이크로소프트 AI 프론티어 그룹 해체, 연구자들 대거 이탈 2023년 ChatGPT 출시 이후 마이크로소프트 리서치(MSR) 내에서 AI Frontiers(AIF) 부서가 조직되어 약 50명 규모로 Autogen, Fara 에이전트 등 에이전트 기술과 Full Bandwidth Transformer 같은 기초 역량 개발에 주력했다. AI · 머신러닝 · The end of Microsoft Research's AI Frontiers group
Key Point 마이크로소프트 AI 조직 내 연구 철학의 근본적 충돌로 핵심 인재가 이탈하는 상황은 기업 AI 연구의 방향성, 기초 연구와 스케일링 사이의 우선순위 논쟁을 보여줍니다.
핵심 요약
2023년 ChatGPT 출시 이후 마이크로소프트 리서치(MSR) 내에서 AI Frontiers(AIF) 부서가 조직되어 약 50명 규모로 Autogen, Fara 에이전트 등 에이전트 기술과 Full Bandwidth Transformer 같은 기초 역량 개발에 주력했다. AI Frontiers는 MSR 전체가 사용하는 모노레포를 만들어 모델 개발 파이프라인을 공유하는 등 조직 전체와 협업했으나, 9월 초 마이크로소프트 AI(MAI)로 재편성되었다. MAI의 전직 인플렉션 리더십은 연구보다 스케일링(대규모 데이터와 모델 크기 증가)에만 집중하는 철학을 고수하고 있어, 기초 연구에 초점을 둔 AI Frontiers와 방향이 충돌했다. 전체 요약 6문장 읽기 → 094 06:11 ▲ 200 · 댓글 127 아이폰 예측 텍스트의 검열 목록, 10만 개 이상 단어 차단 독립 연구자 데릭 카우프만이 애플의 운영체제에 인코딩된 '그레이 리스트' 발견, 10만 개 이상의 단어와 문구가 예측 텍스트 자동완성에서 제외된다. 기타 · Apple’s grey list: Words and phrases your iPhone won’t help you spell
Key Point 애플이 광범위하게 특정 단어와 표현을 차단하는 방식이 공개됨으로써, 기술 기업의 '검열' 메커니즘이 얼마나 광범위하고 때로 정치적 판단을 포함하고 있는지를 보여준다.
핵심 요약
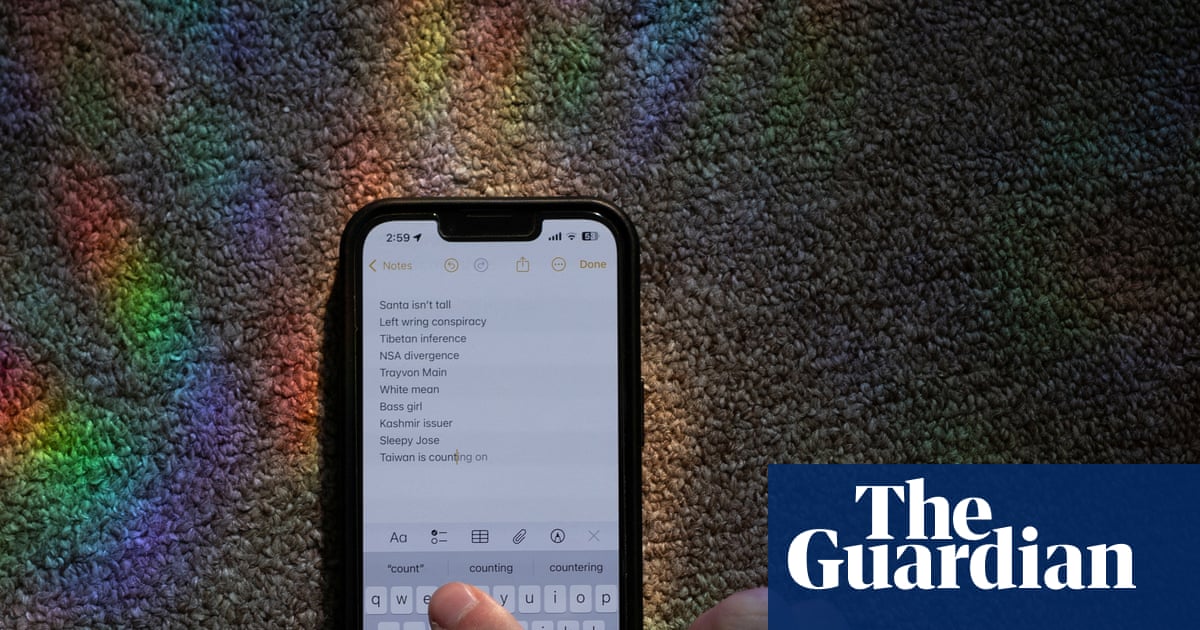
독립 연구자 데릭 카우프만이 애플의 운영체제에 인코딩된 '그레이 리스트' 발견, 10만 개 이상의 단어와 문구가 예측 텍스트 자동완성에서 제외된다. 스와이프 입력으로 해당 단어들을 입력하려 하면 오류가 발생하며, 예를 들어 '유나이티드 아일랜드'가 '유나이티드 아이슬란드'로 바뀌는 식이다. 차단 목록에는 마약, 성행위 관련 표현과 '아이메시지가 작동하지 않음' 같은 기업 보호 관련 문구 외에도 '독재자 트럼프', '트래이본 마틴', '카슈미르 분쟁' 등 정치적 성격의 표현들이 포함되어 있다. 전체 요약 8문장 읽기 → 095 03:11 ▲ 100 · 댓글 39 AI가 과학 연구를 어디까지 가속화할 수 있을까 Anthropic이 프라이버시 보호 방식으로 207,000개의 Claude 세션을 분석해 과학 연구에서 AI 사용 방식을 조사했다. AI · 머신러닝 · AI for scientific discovery: How researchers use Claude
Key Point 과학 분야별·작업별 AI 도입 패턴을 대규모 데이터로 측정함으로써, AI가 현재 어디서 실제로 쓰이고 있는지, 미래에 어느 정도 가속화를 가져올 수 있는지 보여준다.
핵심 요약
Anthropic이 프라이버시 보호 방식으로 207,000개의 Claude 세션을 분석해 과학 연구에서 AI 사용 방식을 조사했다. 컴퓨터과학·수학·통계 등 형식과학에서 Claude 사용이 상대적으로 높고, 의학·화학·생물학 같은 현장 기반 과학에서는 낮았다. 과학자들은 데이터 분석(전체 세션의 33.7%)과 논문 작성(32.0%)에 Claude를 집중 사용하지만, 가설 생성(4.2%)과 데이터 수집(11.5%)에는 거의 사용하지 않는다. 전체 요약 10문장 읽기 → 096 00:11 ▲ 11 · 댓글 2 추론 기록 압축으로 LLM의 토큰 낭비 줄인다 추론은 언어모델이 어려운 문제를 푸는 능력을 크게 향상시키지만, 긴 추론 과정이 비용을 늘린다. AI · 머신러닝 · Why Pay for Long Reasoning When Rewrite Do Trick? Causal Effects of Reasoning History Compaction on Future Generation and Agent Cost
Key Point LLM 추론 과정의 토큰 낭비 구조를 드러내고 재훈련 없이 비용을 실제로 줄일 수 있는 방법을 제시하며, 에이전트 시스템의 운영 비용 최적화에 직접 적용할 수 있다.
핵심 요약
추론은 언어모델이 어려운 문제를 푸는 능력을 크게 향상시키지만, 긴 추론 과정이 비용을 늘린다. 효율적인 추론은 반복과 문제 해결에 불필요한 텍스트를 줄여 유용한 분석을 더 적은 토큰으로 표현해야 한다. 연구팀은 개방형 가중치 모델이 재훈련 없이 과거 추론을 재작성해 덜 장황한 추론을 생성할 수 있는지 조사했다. 전체 요약 7문장 읽기 → 097 21:11 ▲ 130 · 댓글 46 모든 맥에 숨은 인맥 추론 시스템, 공개되다 macOS 13 (2022) 이후 모든 맥에는 두 개의 데몬이 기본 탑재되어 당신과 주변인의 관계, 소통 패턴, 위치, 행동을 추적해 개인 지식 그래프를 구축하고 있다. 보안 · Every Mac comes with an (undocumented) family member classifier
Key Point Apple이 공식 문서 없이 기본 탑재한 개인 정보 수집·추론 시스템의 실체가 독립 연구로 밝혀지면서, 사용자가 자신의 맥에서 정확히 어떤 정보가 수집되고 추론되는지 알 수 있게 되었다.
핵심 요약
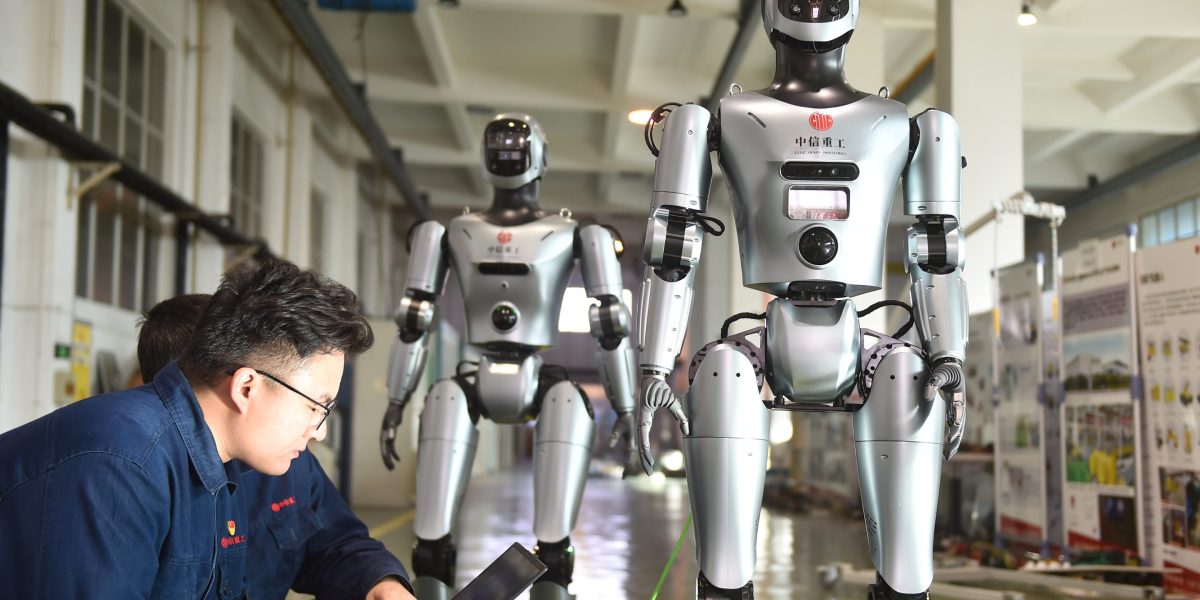
macOS 13 (2022) 이후 모든 맥에는 두 개의 데몬이 기본 탑재되어 당신과 주변인의 관계, 소통 패턴, 위치, 행동을 추적해 개인 지식 그래프를 구축하고 있다. 이 그래프는 SQLite 데이터베이스 51개로 저장되며, 181개 엔티티 클래스와 278개 술어(predicate)로 구성된 트리플 스토어 구조이다. 수집 데이터는 연락처, 사진(얼굴 인식), 캘린더, 가족 공유, 메시지, 메일, 위치 기록, 스크린타임, Siri 제안 등 기기의 거의 모든 정보를 취합한다. 전체 요약 8문장 읽기 → 098 18:11 ▲ 112 · 댓글 76 로봇 팩토리는 손으로 만들어진다 저자가 유니트리의 항저우 팩토리를 방문했을 때, 모터를 만드는 구간은 대부분 구리선을 감싸는 작업을 하는 인력으로 채워져 있었고 자동화 라인은 소수에 불과했다. 하드웨어 · 시스템 · I toured Unitree's factory. I'm more bullish on the West
Key Point 중국의 낮은 인건비가 로봇 제조를 손작업으로 유지하는 동안, 서방은 높은 임금으로 인해 자동화 기계에 투자할 동기가 크며, AI가 프로그래밍 비용을 급격히 줄이면서 제조 자동화의 핵심 장벽이 낮아지고 있다.
핵심 요약
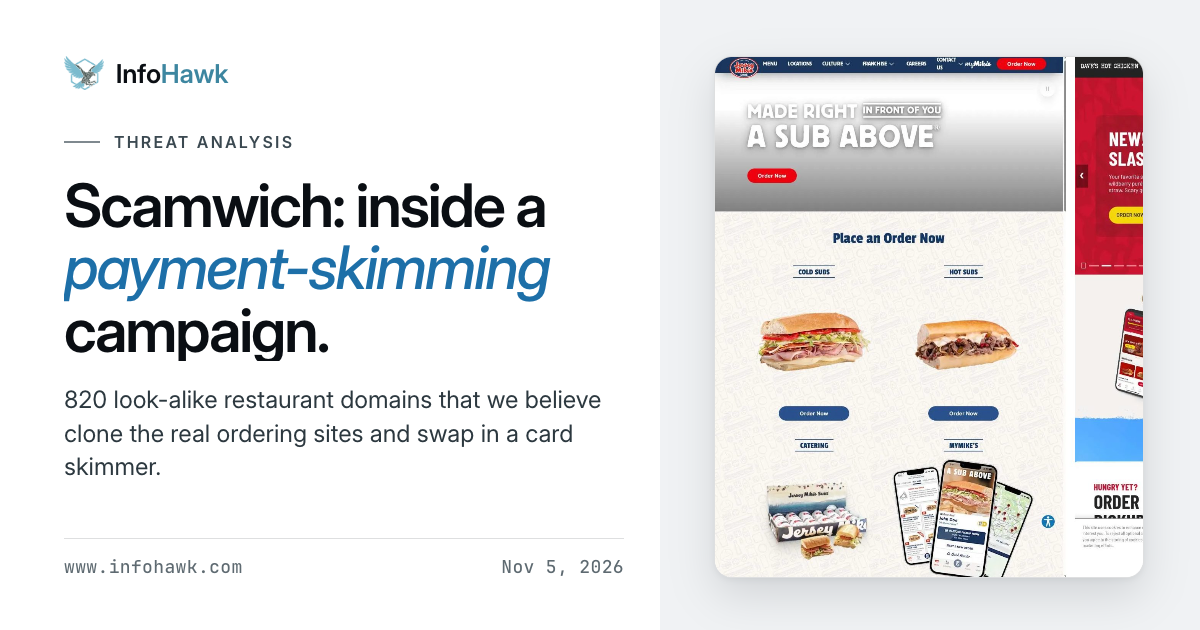
저자가 유니트리의 항저우 팩토리를 방문했을 때, 모터를 만드는 구간은 대부분 구리선을 감싸는 작업을 하는 인력으로 채워져 있었고 자동화 라인은 소수에 불과했다. 유니트리는 2025년 약 32,000대의 로봇을 만들었지만 자동화 설비는 장부 가치 170만 달러 수준으로, 로봇 한 대당 약 50달러에 불과했다. 로봇 제조 원가에서 인건비는 8%에 불과하고 대부분이 부품비인 만큼, 인력 비용을 절반으로 줄어들어도 전체 원가는 2% 미만 감소한다. 전체 요약 13문장 읽기 → 099 15:11 ▲ 110 · 댓글 56 정교한 결제 스키밍 사기, 820개 위조 음식점 사이트 적발 InfoHawk 연구팀이 2026년 11월 초 Jersey Mike's, Jimmy John's, Firehouse Subs, Chipotle, Dave's Hot Chicken 등 미국 주요 음식점을 사칭한 820개의 의심 도메인을 발견했다. 보안 · Restaurant Delivery Payment-Skimming Campaign
Key Point 음식점 배달 주문 시스템의 역프록시 기술을 악용한 대규모 결제 스키밍이 대미지, 신용카드와 SMS 인증 코드를 동시에 탈취하는 방식으로 구체적인 기술 수법을 보여준다.
핵심 요약
InfoHawk 연구팀이 2026년 11월 초 Jersey Mike's, Jimmy John's, Firehouse Subs, Chipotle, Dave's Hot Chicken 등 미국 주요 음식점을 사칭한 820개의 의심 도메인을 발견했다. 발견된 도메인 중 808개는 .delivery 최상위 도메인을 사용하고 나머지는 .com이나 .shop을 사용하고 있다. 이 사기 사이트들은 정상 사이트의 코드를 복제한 정교한 위조물이며, 역프록시 기술을 사용해 합법적인 레스토랑 웹사이트의 콘텐츠를 그대로 가져온 뒤 결제 양식만 악의적으로 변조한다. 전체 요약 7문장 읽기 → 100 12:11 ▲ 104 · 댓글 88 촘스키 vs 확률 모델, 언어학의 두 문화 촘스키의 확률 모델 비판에 대해 핑커의 질문으로부터 출발한 에세이로, 통계 모델의 성공 이유를 다룬다. AI · 머신러닝 · Chomsky and the two cultures of statistical learning (2011)
Key Point 통계 기반 언어 모델의 지배적 성공이 정당한지, 아니면 촘스키 식 형식 이론이 올바른 길인지를 놓고 벌어진 언어학의 근본적 논쟁을 명확히 이해할 수 있다.
핵심 요약
촘스키의 확률 모델 비판에 대해 핑커의 질문으로부터 출발한 에세이로, 통계 모델의 성공 이유를 다룬다. 2차 마르코프 모델로 10만 개 어휘를 표현하려면 1경(10¹⁵) 개의 확률값이 필요하며, 이는 데이터 통계 학습과 평활화 기법 없이는 불가능하다. 이상 기체 법칙처럼 확률·통계 모델이 현실을 완벽히 설명하지 못해도 정확한 예측과 통찰력을 제공할 수 있음을 보인다. 전체 요약 10문장 읽기 →