쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
7건 · "토큰화"조건 지우기 ×
001 12:11 ▲ 13 · 댓글 2 카메라 영상과 깊이만으로 물체 자세 파악하는 F2G-Pose 공개 RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. AI · 머신러닝 · F2G-Pose: Geometry-Aware Foundation Feature Lifting for Direct RGB-D Category-Level Object Pose Estimation
Key Point 라벨이나 사전 학습된 모델 없이 실시간으로 물체 자세를 복구할 수 있는 효율적인 방법이 로봇 조작과 3D 비전 응용에 큰 영향을 미칠 수 있기 때문이다.
핵심 요약
RGB-D 이미지에서 물체의 3D 회전과 이동을 추정하는 카테고리 수준 물체 자세 인식 문제를 다룬다. 부분적 관찰과 자세 모호성이 있어도 인스턴스 특화 CAD 모델이나 참조 이미지 없이 자세를 복구해야 한다. 기존 방식은 중간 구조 기반 방법은 오류 전파에 취약하고, 확산 모델은 높은 추론 지연 시간과 복잡한 후처리 과정이 필요했다. F2G-Pose는 단일 RGB-D 관찰에서 한 번의 순전파로 물체 자세·실제 크기·완성된 형태를 동시에 예측하는 실시간 직접 예측 프레임워크다. 전체 요약 8문장 읽기 → 002 15:11 ▲ 12 · 댓글 1 낮은 대역폭에서 음성 품질 지키는 적응형 음성 코덱 공개 신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. AI · 머신러닝 · RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
Key Point 저대역폭 음성 생성에서 품질과 안정성을 동시에 확보하는 새로운 접근법으로, 음성 AI 모델 개발자들이 토큰 예산을 명확히 제어하면서도 높은 음질을 유지할 수 있게 한다.
핵심 요약
신경망 기반 음성 코덱은 음성을 이산 토큰으로 변환하는데, 프레임 레이트가 낮을수록 토큰 시퀀스가 짧아지지만 각 토큰이 더 많은 정보를 담아야 한다. 기존 가변 프레임 레이트 코덱은 임계값 기반 할당으로 콘텐츠에 따라 토큰 개수가 달라져 생성 모델이 예측해야 할 시퀀스 길이가 불안정하다. RubatoCodec은 X-Codec-2 기반의 가변 프레임 레이트 음성 코덱으로, 발화 단위의 명시적 이벤트 예산과 스트리밍 디코딩을 지원한다. 전체 요약 10문장 읽기 → 003 18:30 ▲ 12 · 댓글 2 계층적 사각형 구조로 이미지 토큰화와 생성 속도 개선 QuadTok는 쿼드트리 기반 계층적 구조를 사용해 이미지를 시각적 토큰으로 변환하는 새로운 프레임워크이다. AI · 머신러닝 · QuadTok: Quadtree Visual Tokenizer for Autoregressive Image Generation
Key Point 토큰 효율과 생성 품질의 트레이드오프를 새로운 구조로 해결한 방식이 기존 이미지 생성 모델의 설계 방식을 바꿀 가능성을 보여준다.
핵심 요약
QuadTok는 쿼드트리 기반 계층적 구조를 사용해 이미지를 시각적 토큰으로 변환하는 새로운 프레임워크이다. 기존 2D 격자나 1D 토큰 배열과 달리 동적으로 복잡한 영역에는 높은 해상도, 단순한 영역에는 낮은 해상도를 할당해 표현 용량을 최적화한다. ImageNet 학습 모델은 고정된 256 토큰 격자 대비 약 10% 토큰을 절약하며, 지로샷 전이 시 COCO 데이터셋에서도 9% 절약하면서 재구성 충실도는 유지한다. 전체 요약 6문장 읽기 → 004 03:11 ▲ 57 · 댓글 2 여러 LLM을 조합한 멀티에이전트, KV 캐시 공유로 10배 빠르게 Llama, Mistral 등 서로 다른 모델을 조합하는 멀티에이전트 LLM 시스템에서, 송신자의 처리된 문맥을 수신자가 다시 처리(prefill)하는 중복 비용이 발생한다. AI · 머신러닝 · Prefill-Free Cross-Family KV Cache Transfer for Heterogeneous Multi-Agent LLMs
Key Point 서로 다른 LLM을 조합하는 멀티에이전트 시스템에서 구조적 차이를 극복하고 캐시 재사용으로 최대 10배의 속도 향상을 달성한 방식이 처음 제시되었습니다.
핵심 요약
Llama, Mistral 등 서로 다른 모델을 조합하는 멀티에이전트 LLM 시스템에서, 송신자의 처리된 문맥을 수신자가 다시 처리(prefill)하는 중복 비용이 발생한다. 논문은 HeteroFold라는 방식을 제안했다. 토큰화·모델 깊이·KV 표현의 차이를 처리하면서 양쪽 모델을 그대로 두고 KV 캐시를 다른 모델 족으로 이전한다. HeteroFold는 구조를 정렬하고, 송신자의 캐시를 수신자 공간으로 매핑한 뒤, 수신자의 동작을 유지하도록 보정한다. 전체 요약 6문장 읽기 → 005 22:26 당일 +128 결제 인프라의 '리눅스'... 오픈소스 결제 플랫폼 하이퍼스위치 Juspay가 개발한 Hyperswitch는 모듈식 오픈소스 결제 인프라로, Rust로 빌드되어 Stripe, Adyen, Braintree 등 120개 이상의 결제 처리자와 연결된다. 오픈소스 · 도구 · juspay/hyperswitch · Rust
Key Point 단일 결제 게이트웨이에서 벗어나 여러 결제서비스공급자를 조합하려는 기업들이 직접 결제 인프라를 구축·운영할 수 있게 하는 오픈소스 솔루션이 등장했다.
핵심 요약
Juspay가 개발한 Hyperswitch는 모듈식 오픈소스 결제 인프라로, Rust로 빌드되어 Stripe, Adyen, Braintree 등 120개 이상의 결제 처리자와 연결된다. 비용 관찰성, 수익 회복, 보관소, 지능형 라우팅, 결제 대사, 대체 결제 방식 등 독립적인 모듈들을 선택해 기존 결제 스택에 통합할 수 있다. 지능형 라우팅은 거래별로 인증 성공률이 가장 높은 결제서비스공급자를 선택해 첫 시도 성공률을 최대화하고, 수익 회복은 카드 발급사, 지역, 결제 방식별로 조정된 재시도 전략을 제공한다. 전체 요약 13문장 읽기 → 006 22:29 ▲ 16 · 댓글 3 토큰화 효율 높이는 기능 분해 방식 제안 기존 서브워드 토크나이저는 같은 단어의 대소문자·악센트 변형(hello, Hello, Héllo)을 서로 다른 어휘로 처리해 임베딩 공간이 파편화되거나, 정규화로 정보를 손실시킨다. AI · 머신러닝 · The Functionalizer: Lossless Functional Decomposition for Subword Tokenization
Key Point 같은 단어의 다양한 표기를 효율적으로 처리해 모델의 어휘 크기를 줄이고 코드 생성 정확도를 높이는 실질적 개선 방법이기 때문입니다.
핵심 요약
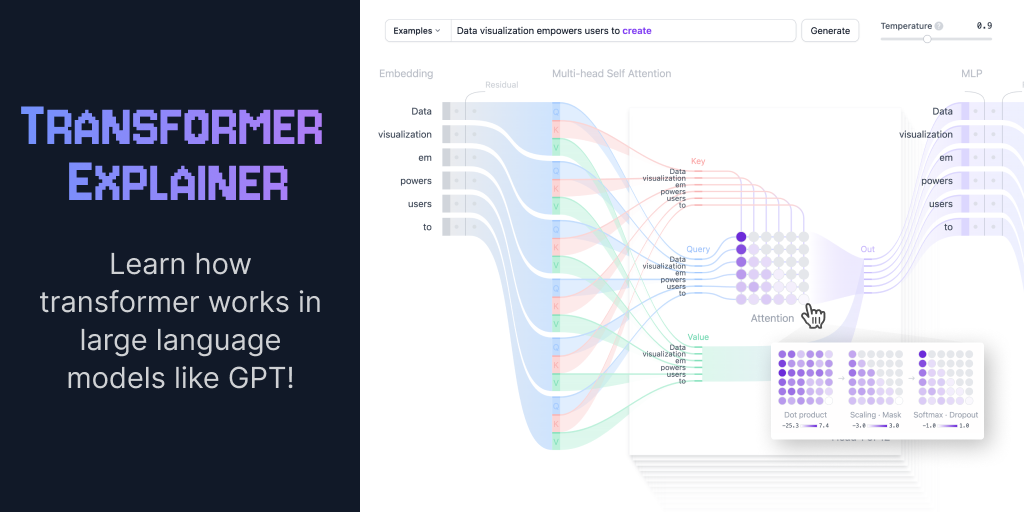
기존 서브워드 토크나이저는 같은 단어의 대소문자·악센트 변형(hello, Hello, Héllo)을 서로 다른 어휘로 처리해 임베딩 공간이 파편화되거나, 정규화로 정보를 손실시킨다. 논문은 직교 및 구조 변형을 함수형 분해로 처리하는 Functionalizer를 제안한다. 대문자화(CAPITALIZE), 발음 기호(13개 전용 옵코드), 문자 반복(REPEAT, MULTIREPEAT) 등의 가역 연산자를 사용해 유니코드 개인용 영역에 인코딩한 프리픽스 스트림으로 정규 기본 토큰 앞에 붙인다. 전체 요약 6문장 읽기 → 007 09:10 ▲ 158 · 댓글 27 Transformer 구조를 시각적으로 배우는 인터랙티브 가이드 Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. AI · 머신러닝 · Transformers Explained Visually
Key Point Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다. 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다. 전체 요약 6문장 읽기 →