Transformer 구조를 시각적으로 배우는 인터랙티브 가이드
원제 Transformers Explained Visually
158 포인트댓글 27
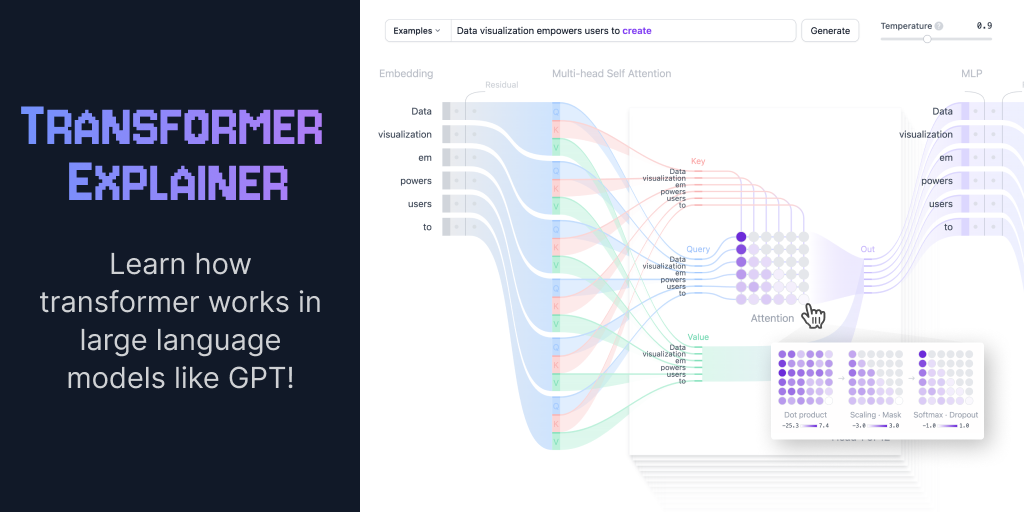
Key Point
Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
- Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다.
- Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다.
- 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다.
- Transformer 블록은 다중헤드 자기주의와 다층 퍼셉트론으로 구성되며, GPT-2(소형)는 이 블록 12개를 순차적으로 쌓아서 토큰 표현을 점진적으로 고도화한다.
- 각 토큰의 임베딩 벡터는 Query·Key·Value 세 벡터로 변환되며, 이들로 어텐션 스코어를 계산해 각 토큰이 받을 집중도를 결정한다.
- GPT-2의 12개 어텐션 헤드는 각각 다른 언어학적 관계(구문·의미)를 독립적으로 포착한 뒤, 출력을 연결해 최종 어텐션 결과를 생성한다.