쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
3건 · "자기주의"조건 지우기 ×
001 09:11 ▲ 110 · 댓글 30 외적 메모리에서 시작하는 트랜스포머의 직관적 이해 선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. AI · 머신러닝 · You could have invented transformers from memory
Key Point 신경망 계층이 정보를 어떻게 저장하고 회수하는지에 대한 통일된 수학적 직관을 제공하므로, 트랜스포머 아키텍처의 설계 선택을 더 깊이 이해할 수 있다.
핵심 요약
선형 계층, MLP, 셀프-어텐션을 메모리 저장소로 재해석하는 관점을 제시한다. 기본적인 외적 메모리 저장소는 M개 메모리를 저장할 때 키 차원 d_k과 같은 용량 d_k만 갖는다. 최적 선형 메모리는 키의 공분산을 보정해 용량을 2d_k로 두 배 높인다. 전체 요약 10문장 읽기 → 002 09:11 ▲ 10 · 댓글 1 3D 구조를 살린 옥트리 기반 언어모델 OctLLM 기존 3D LLM은 3차원 형태를 부호화 지수나 텍스트 좌표로 압축해 공간 정보를 손실하고, 백본을 미세조정해 언어 능력을 훼손하는 두 가지 문제를 안고 있다. AI · 머신러닝 · Octrees as an Explicit 3D Language
Key Point 3D 데이터의 공간 구조를 손상시키지 않으면서도 기존 언어모델의 능력을 보존하는 멀티모달 LLM 설계 방식이 기존 기법들보다 우수한 성능을 달성했기 때문에 3D AI 모델 개발에 관심 있는 연구자와 실무자에게 참고할 만한 접근법을 제시한다.
핵심 요약
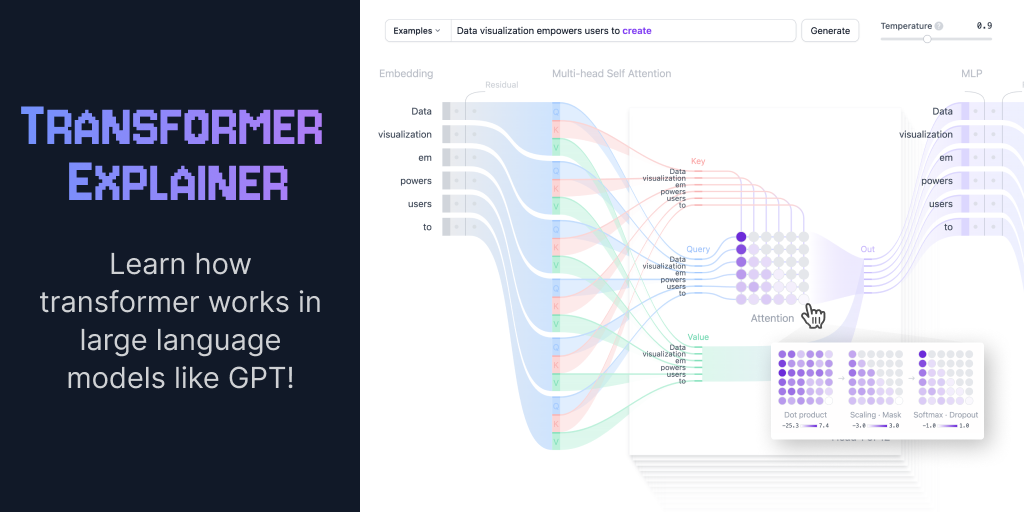
기존 3D LLM은 3차원 형태를 부호화 지수나 텍스트 좌표로 압축해 공간 정보를 손실하고, 백본을 미세조정해 언어 능력을 훼손하는 두 가지 문제를 안고 있다. OctLLM은 3D 데이터를 옥트리 점유 토큰의 명시적 3D 시퀀스로 입력받으면서도, 끝에서 두 번째 수준의 노드를 무작위로 비우고 자손을 생략해 형태를 보존한 Sparse Octree(S-Octree)로 단축해 위치 인식 마스크 모델링과 3D 이해를 지원한다. 3D 모달리티를 추가할 때 전체 미세조정이나 LoRA 대신, 메시 토큰을 블록의 일부에서 독립적인 학습 가능 브랜치로 라우팅하면서 텍스트와 이미지 토큰은 고정된 비전-언어 경로를 유지하고, 두 스트림이 공유 자기주의를 통해 상호작용하도록 설계했다. 전체 요약 4문장 읽기 → 003 09:10 ▲ 158 · 댓글 27 Transformer 구조를 시각적으로 배우는 인터랙티브 가이드 Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. AI · 머신러닝 · Transformers Explained Visually
Key Point Transformer의 내부 동작을 상세히 이해해야 생성형 AI 모델의 원리와 한계를 제대로 파악할 수 있고, 이는 AI 제품 개발이나 프롬프트 엔지니어링의 효율을 높이는 데 필수적이다.
핵심 요약
Transformer는 2017년 '어텐션이 전부(Attention is All You Need)' 논문 이후 GPT, Llama, Gemini 등 생성형 AI의 핵심 구조가 되었으며, 텍스트뿐 아니라 음성·이미지·단백질 구조 예측까지 다양한 분야에 적용되고 있다. Transformer 모델은 '다음 토큰 예측' 원리로 작동하며, 자기주의(self-attention) 메커니즘을 통해 입력 전체 시퀀스를 처리해 긴 거리의 의존성을 기존 구조보다 효과적으로 포착한다. 임베딩 단계에서 입력 텍스트는 토큰화·토큰 벡터화·위치 정보 추가를 거쳐 수치로 변환되는데, GPT-2(소형)는 50,257개 어휘를 768차원 벡터로 표현한다. 전체 요약 6문장 읽기 →