001 09:11 ▲ 111 · 댓글 78 구글의 교육용 AI 강제, 검색까지 함께 묶어 버린다 구글이 2027년부터 K-12 교육용 구글 워크스페이스에서 AI 도구를 기본 비활성화하지만, 검색도 함께 꺼진다는 공지에 교육자들이 강력히 반발하고 있다. 기타 · Education shouldn't be held for ransom
Key Point 학교 교육에서 학생의 선택권을 제약하고 AI를 강제하려는 대형 기술 기업의 움직임이 심화되고 있으며, 이는 교육의 본질인 '생각하는 능력'을 키우는 데 직결된 쟁점이기 때문이다.
핵심 요약
구글이 2027년부터 K-12 교육용 구글 워크스페이스에서 AI 도구를 기본 비활성화하지만, 검색도 함께 꺼진다는 공지에 교육자들이 강력히 반발하고 있다. 구글은 AI와 검색이 긴밀히 통합되어 있어 분리할 수 없다고 주장하지만, 역압박 후 검색만 켜는 것을 허용했으나 AI Overviews 같은 AI 기능 없이는 검색을 쓸 수 없는 구조다. 교육자들은 기술 반대가 아니라, AI가 학생들의 비판적 사고력을 약화시키고 답을 주입받게 되는 문제를 지적한다. 전체 요약 8문장 읽기 → 002 00:11 ▲ 130 · 댓글 80 검증만으로는 지식이 아니다, AI 과학의 맹점 과학의 진척을 정답의 검증으로만 재는 것이 잘못된 관점임을 지적하는 에세이. AI · 머신러닝 · Verification Is Not Knowledge: Science needs more than answers
Key Point AI가 과학의 주도권을 가져가는 추세 속에서 검증 가능한 정답이 곧 지식이라는 착각이 과학 공동체의 기본 구조를 훼손할 수 있기 때문.
핵심 요약
과학의 진척을 정답의 검증으로만 재는 것이 잘못된 관점임을 지적하는 에세이. AI가 생성한 암 치료법이 형식적 정확성 인증과 3상 임상 통과를 갖추고도 인간이 그 원리를 이해하지 못할 때, 문제가 발생할 수 있다는 테리 타오의 사고 실험을 제시. 저자는 검증된 것이 실제 지식이 되려면 누군가 그에 책임질 수 있어야 하며, AI 저자는 그 주장을 설명하고 비판에 응할 수 없다는 점을 문제 삼음. 전체 요약 10문장 읽기 → 003 00:11 ▲ 224 · 댓글 179 AI 아버지 힌튼, 10년 안에 최악의 위험 드러날 것 노벨상 수상자 제프리 힌튼은 AI가 발전하지 않았으면 더 나았을 수도 있다고 지적하며, 금융·전력 시스템 마비 같은 대규모 사건이 올해나 내년 안에 발생할 수 있다고 경고했다. AI · 머신러닝 · Geoffrey Hinton: it might turn out we were better off without AI
Key Point AI 개발 선구자 본인이 기술의 미래를 10년이라는 구체적 시간 범위 내에서 재평가하며 경고하고 있으며, 현 AI 기업 지도자들의 위험 외면과 국제 규제 필요성을 명시해 정책 논의의 중요한 입장을 제시하고 있다.
핵심 요약
노벨상 수상자 제프리 힌튼은 AI가 발전하지 않았으면 더 나았을 수도 있다고 지적하며, 금융·전력 시스템 마비 같은 대규모 사건이 올해나 내년 안에 발생할 수 있다고 경고했다. 힌튼은 향후 10년 안에 인류가 AI의 위험을 관리할 수 있는지, 아니면 부의 양극화·실업·사회 붕괴 같은 결과에 직면하는지 판가름날 것이라고 말했다. 그는 샘 알트먼 오픈AI CEO, 마크 저커버그, 일론 머스크 등 AI 회사 지도자들이 위험을 충분히 이해하면서도 시장 경쟁과 수익을 우선한다고 비판했다. 전체 요약 8문장 읽기 → 004 06:11 ▲ 14 · 댓글 1 AI 에이전트의 팀플레이 능력을 측정하는 벤치마크 등장 AI 연구는 개별 모델의 성능에만 집중해왔지만, 과학·의학·수학·소프트웨어 분야에서 여러 에이전트 팀이 실제 성과를 내고 있어 협업 능력이 새로운 평가 기준으로 떠오르고 있다. AI · 머신러닝 · Measuring AI Agents as Teammates with Collaborative Intelligence
Key Point 여러 AI 에이전트가 실제 과학 프로젝트에서 협력하고 있는 지금, 개별 모델 성능이 아니라 팀 내 협업 능력을 체계적으로 측정할 수 있는 첫 번째 벤치마크가 제시되어 AI 평가의 패러다임 전환을 의미한다.
핵심 요약
AI 연구는 개별 모델의 성능에만 집중해왔지만, 과학·의학·수학·소프트웨어 분야에서 여러 에이전트 팀이 실제 성과를 내고 있어 협업 능력이 새로운 평가 기준으로 떠오르고 있다. 인간 팀의 협업 능력을 측정해온 조직행동 연구에서 영감을 얻어 협업 지능 벤치마크(Collaborative Intelligence Benchmark)를 개발했다. 벤치마크는 항공사고 보고서·임상 사례·코딩 과제·협상까지 실제 기록과 기존 벤치마크에서 나온 240개 과제를 8가지 팀워크 차원으로 나누어 제공한다. 전체 요약 9문장 읽기 → 005 12:11 ▲ 125 · 댓글 85 AI 시대 수학자에게 필요한 것은 '자아를 내려놓는 것' 수학이 인간의 창작물인가 아니면 독립적으로 존재하는 진리인가 하는 근본적 질문이 AI 발전과 함께 재현되고 있다. AI · 머신러닝 · Egoless Mathematics in the AI Era
Key Point AI가 수학 증명을 만들어내기 시작하는 시점에서, 수학자가 추구해야 할 가치가 결과 생산과 개인 능력 증명에만 있는지를 근본부터 물음으로써 학문의 목적을 재정의하는 시도이다.
핵심 요약
수학이 인간의 창작물인가 아니면 독립적으로 존재하는 진리인가 하는 근본적 질문이 AI 발전과 함께 재현되고 있다. 수학의 발견은 수동적으로 보이지만, 고생물학자가 화석을 찾을 때처럼 이미 존재하는 것을 능동적으로 탐색하는 과정이며, 수학자가 만드는 개념과 틀은 그 진리를 인식하기 위한 수단이다. 정의를 도입한 후 예상 밖의 연결이 드러나거나 예상이 반례에 부딪힐 때처럼, 우리의 사고가 자유롭게 결정하지 않은 독립적 질서와 만난다. 전체 요약 14문장 읽기 → 006 21:11 ▲ 103 · 댓글 47 Trigger.dev 환경 변수 노출 보안 사고 Trigger.dev에서 보안 사고가 발생했으며, 공격자가 일부 조직의 환경 변수에 무단 접근했다. 보안 · Trigger.dev customer environment variables exposed
Key Point 환경 변수 노출은 API 키, 데이터베이스 자격증명 등 민감한 정보 유출을 의미하므로 Trigger.dev를 사용 중인 개발자라면 즉시 계정 보안을 점검해야 한다.
핵심 요약
Trigger.dev에서 보안 사고가 발생했으며, 공격자가 일부 조직의 환경 변수에 무단 접근했다. 해당 플랫폼은 공격에 사용된 취약점을 차단했으며, 영향받은 계정 소유자들에게 완화 조치 방법을 담은 이메일을 발송했다. 추가 정보는 상태 페이지를 통해 공개될 예정이며, 질문이 있는 경우 회사에 직접 연락할 수 있다. 007 18:11 ▲ 39 · 댓글 2 이미지 생성을 위한 '연속 공간 추론' 통합 멀티모달 모델 LARC 통합 멀티모달 모델(UMM)이 다양한 멀티모달 작업에서 성공하지만, 언어 기반 사고 체인을 활용한 이미지 생성에서는 약점을 보인다. AI · 머신러닝 · Latent Reasoning in Continuous Space for Unified Multimodal Models
Key Point 이미지 생성 모델에서 추론과 생성의 공간 불일치를 해결하는 새로운 접근법으로, 테스트 시간 스케일링과 더 나은 제어 능력을 가능하게 한다.
핵심 요약
통합 멀티모달 모델(UMM)이 다양한 멀티모달 작업에서 성공하지만, 언어 기반 사고 체인을 활용한 이미지 생성에서는 약점을 보인다. 기존 추론 강화 모델들은 큰언어모델처럼 테스트 시간 스케일링이나 세밀한 제어 능력을 갖지 못하는데, 추론이 이산 토큰 공간에서 이뤄지면서 이미지 생성의 연속 공간과 불일치하기 때문이다. 연속 공간 잠재 추론(LARC) 프레임워크는 연속 숨겨진 상태를 기반으로 추론하여 토큰 수준의 병목을 해결한다. 전체 요약 6문장 읽기 → 008 21:11 당일 +140 290B 모델을 데스크톱에서 실행하는 엣지 추론 엔진 FreeToken FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. AI · 머신러닝 · FlashML-org/FreeToken · Python
Key Point 소비자용 GPU로 290B 규모의 대형 MoE 모델을 실시간 속도로 로컬 실행할 수 있게 되어, 개인 개발자와 소규모 팀도 엣지에서 프론티어급 AI 모델을 직접 운영할 수 있는 가능성을 열어준다.
핵심 요약
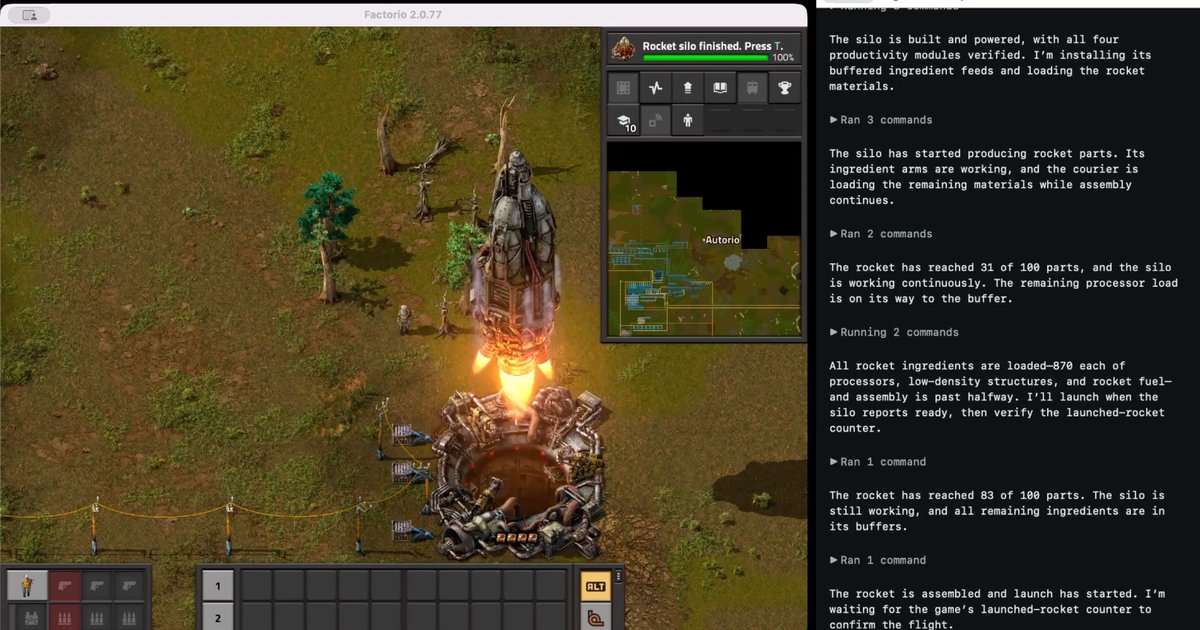
FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. GPU, CPU, 호스트 메모리, 상호연결을 통합 플랫폼으로 활용하며, 대역폭 적응형 CPU-GPU 협력 실행(q* 정책)과 레이어 이중 버퍼링 프리필 스트리밍을 지원한다. 의미 기반 캐싱으로 상태와 KV 캐시의 앵커 체크포인트를 저장하여, 도구 호출·사고 블록 같은 에이전트 컨텍스트 편집 시 중복 재계산을 피한다. 전체 요약 9문장 읽기 → 009 06:11 ▲ 109 · 댓글 108 GPT-4o가 팩토리오 평화모드 클리어 저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. AI · 머신러닝 · GPT-5.6 Sol can beat Factorio on peaceful mode
Key Point 최신 LLM이 복잡한 실시간 전략 게임을 자율적으로 플레이하고 완주한 첫 사례로, 모델의 실제 문제 해결 능력과 한계를 구체적으로 보여주는 벤치마크입니다.
핵심 요약
저자가 GPT-5.6 Sol 모델을 Codex에서 낮은 사고 수준으로 실행하여 13.5시간의 게임 시간으로 팩토리오 평화모드(생물 무적) 완주에 성공했다. 게임 매니저를 통해 모델이 Python 라이브러리를 사용해 프로그래밍 방식으로 게임을 플레이했으며, GUI 사용자와 동일한 제약(플레이어 도달 거리, 안개 기능)을 적용했다. 모델은 일부 영역에서는 기대를 초과했으나 명확한 약점도 보였고, 전체 런이 기록되어 해설 영상 제작 중이다. 전체 요약 8문장 읽기 → 010 03:10 ▲ 132 · 댓글 31 간단한 신경회로도 복잡한 행동을 만든다 뉴런이 어떻게 복잡한 행동을 만드는지는 신경과학의 핵심 질문이며, 과학자들은 지난 수십 년간 이를 규명해왔다. 기타 · Simple circuits can create complex behaviors
Key Point 간단한 신경회로만으로도 지능적으로 보이는 행동이 어떻게 만들어지는지 인터랙티브한 시뮬레이션으로 직관적으로 보여주는 신경과학의 기초를 이해할 수 있다.
핵심 요약
뉴런이 어떻게 복잡한 행동을 만드는지는 신경과학의 핵심 질문이며, 과학자들은 지난 수십 년간 이를 규명해왔다. 빛을 따라가는 가상 생물 '스파크'를 만들어 신경회로의 영향을 보여준다. 한 개의 감각 뉴런(눈)과 한 개의 운동 뉴런(지느러미)을 연결하면 스파크는 빛의 밝기에 비례해 움직이지만, 대부분 빛을 놓친다. 전체 요약 11문장 읽기 → 011 21:11 ▲ 16 · 댓글 2 휴머노이드 로봇을 위한 멀티모달 기초 모델 HuGe 공개 VLA(Vision-Language-Action) 모델을 휴머노이드 로봇에 적용할 때 전신 제어와 다양한 시연 데이터가 필요하지만, 현실에서 수집하기 어렵다는 문제가 있다. AI · 머신러닝 · HuGe: Scaling Humanoid Generalist Vision-Language-Action Models with Egocentric Experience
Key Point 휴머노이드 로봇 제어에 인간 동작 데이터를 효과적으로 활용할 수 있는 방법론이 제시되면서, 로봇 학습 데이터 수집 비용을 크게 줄일 수 있는 길이 열렸기 때문이다.
핵심 요약
VLA(Vision-Language-Action) 모델을 휴머노이드 로봇에 적용할 때 전신 제어와 다양한 시연 데이터가 필요하지만, 현실에서 수집하기 어렵다는 문제가 있다. HuGe는 2,000시간 이상의 1인칭 관점 인간 및 로봇 데이터로 사전학습한 휴머노이드 VLA 모델이다. 세 가지 기존 VLA 아키텍처를 사용해 사전학습된 전신 제어기를 위한 잠재 동작 토큰과 손 제어 신호를 예측한다. 전체 요약 6문장 읽기 → 012 15:11 ▲ 117 · 댓글 34 팬픽 아카이브 AO3, 보안 사고로 2~4주 폐쇄 Archive of Our Own(AO3)에서 보안 사고를 감지하여 복구 중에 있으며, 복구 기간은 최소 2주에서 최대 4주로 예상된다. 보안 · AO3 Down for Maintenance
Key Point 팬픽 콘텐츠의 가장 큰 저장소가 한 달 가까이 폐쇄되면서 전 세계 창작 커뮤니티에 직접적인 영향을 미칠 예정이며, 사용자들은 자신의 계정 정보 노출 가능성을 대비해야 한다.
핵심 요약
Archive of Our Own(AO3)에서 보안 사고를 감지하여 복구 중에 있으며, 복구 기간은 최소 2주에서 최대 4주로 예상된다. 사용자의 작품, 북마크, 쿠도 등 콘텐츠는 모두 안전하며 삭제되지 않았다. 사용자 데이터베이스 탈취는 현재까지 확인되지 않았으나 완전히 배제할 수 없으며, 유저네임, 이메일, IP 주소, 해시된 비밀번호가 포함되어 있을 수 있다. 전체 요약 7문장 읽기 → 013 15:11 ▲ 116 · 댓글 41 스크립드, 사용자 데이터 접근 보안 사고 공지 스크립드(Scribd), 슬라이드셰어(Slideshare), 에버앤드(Everand), 페이블(Fable) 등을 운영하는 스크립드 인크가 보안 사고를 겪었다고 10월 26일 공지했다. 보안 · Tell HN: Scribd Breached
Key Point 데이터 유출 규모와 노출된 정보 종류, 회사의 대응 현황을 정확히 파악해야 후속 피싱 위협에 대비할 수 있다.
핵심 요약
스크립드(Scribd), 슬라이드셰어(Slideshare), 에버앤드(Everand), 페이블(Fable) 등을 운영하는 스크립드 인크가 보안 사고를 겪었다고 10월 26일 공지했다. 승인되지 않은 제3자가 사용자 데이터가 저장된 시스템에 접근했으며, 영향을 받은 사용자의 이메일 주소, 신용카드 뒤 4자리와 국가, 카드 발급사, 만료일, 결제 내역 등이 노출되었다. 카드 상세 정보는 노출되지 않았으며, 회사는 현재까지 데이터 악용의 증거가 없다고 밝혔다. 전체 요약 6문장 읽기 → 014 12:11 ▲ 121 · 댓글 144 시스코, 27세 엔지니어에 AI 토큰 무제한 제공해 레거시 코드 개선 추진 시스코의 CEO 지투 파텔이 2025년 인수한 번역 스타트업 EzDubs의 창업자 패디 크리슈나무르티에게 AI 토큰을 무제한 제공하고 있다. 스타트업 · 비즈니스 · Cisco gives engineer unlimited AI tokens to rewrite legacy code
Key Point AI 시대의 인재 구조가 바뀌고 있다: 경험 많은 임원과 신입 세대를 함께 투입하는 기업들의 전략이 주목할 만한 변화를 만들고 있다.
핵심 요약
시스코의 CEO 지투 파텔이 2025년 인수한 번역 스타트업 EzDubs의 창업자 패디 크리슈나무르티에게 AI 토큰을 무제한 제공하고 있다. 크리슈나무르티는 2인 팀으로 시스코의 레거시 코드를 리팩토링할 수 있다고 제안했으며, 파텔은 24개월 내 시스코 레거시 코드의 98%를 개선하는 목표를 세웠다. 파텔은 경력이 쌓인 직원만으로는 신선한 아이디어가 나올 수 없다며, Z세대 신입들이 기존 질서에 도전할 수 있다고 강조한다. 전체 요약 7문장 읽기 → 015 18:11 ▲ 117 · 댓글 28 미야자키의 '붉은 돼지'는 반전 영화다 학술논문으로, 미야자키의 애니메이션 '붉은 돼지'(1992)를 전쟁·평화 연구 관점에서 분석한다. 기타 · A Pig, the State, and War: Porco Rosso (Kurenai No Buta) (2014)
Key Point 국내 애니메이션 팬과 교육자들이 미야자키 영화를 단순 엔터테인먼트가 아닌 전쟁과 평화, 민족주의의 문제를 담은 작품으로 분석하는 학술적 틀을 얻을 수 있다.
핵심 요약
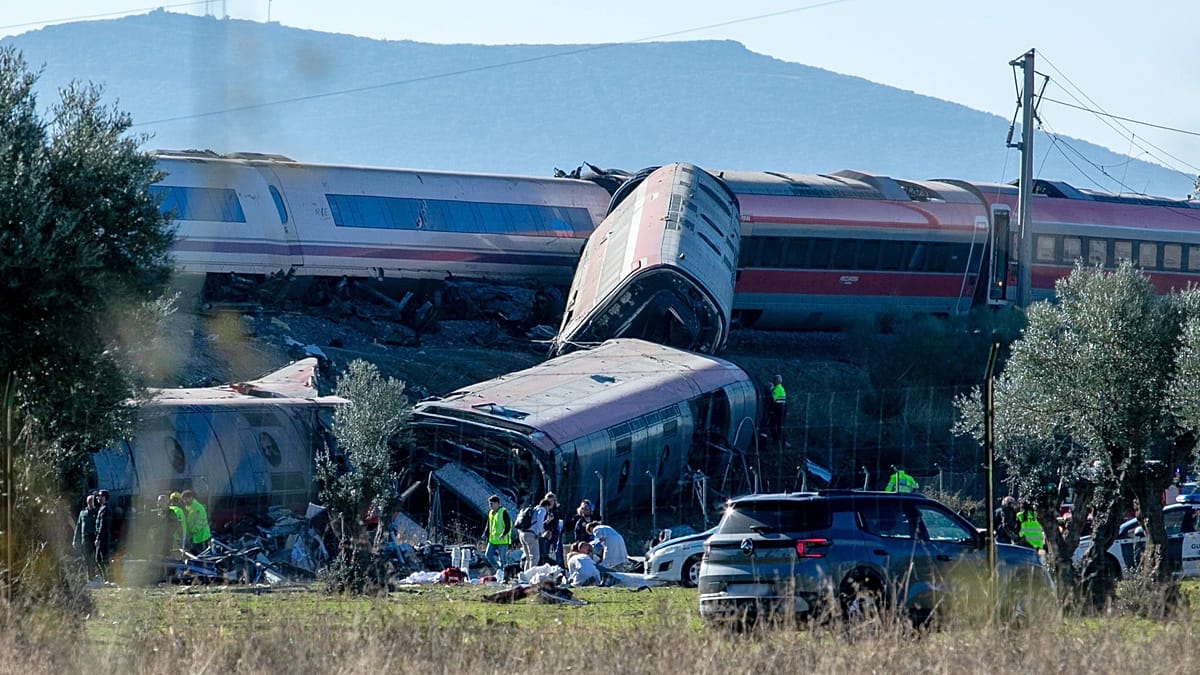
학술논문으로, 미야자키의 애니메이션 '붉은 돼지'(1992)를 전쟁·평화 연구 관점에서 분석한다. 영화는 제1차 세계대전 후 아드리아 해의 해적과 싸우는 주인공 돼지 포르코 로쏘의 이야기이며, 1990년 걸프전·유고슬라비아 전쟁과 관련해 미야자키의 반전 메시지를 담고 있다. 포르코가 돼지로 변한 것은 전쟁으로 인한 트라우마와 함께 '인간의 이기심', '국가의 민족주의', '전쟁의 군국주의' 세 가지 요소를 혐오하기 때문이다. 전체 요약 11문장 읽기 → 017 06:11 ▲ 114 · 댓글 220 스페인 열차 충돌 사고, 최소 69명 사망 스페인 마드리드 남쪽 140km 지점의 세비야 고속선에서 수요일 오전 08:53 국영 Renfe 열차가 정차 중인 민영 Iryo 열차에 고속으로 충돌해 최소 69명이 사망했다. 기타 · What we know so far about Spain train crash
Key Point 열차 제어 시스템 오류로 정지된 열차에 고속 충돌한 사고의 원인 규명이 진행 중이며, 음성 녹음 증거가 통제실의 의사결정 과정을 직접 드러낸다.
핵심 요약
스페인 마드리드 남쪽 140km 지점의 세비야 고속선에서 수요일 오전 08:53 국영 Renfe 열차가 정차 중인 민영 Iryo 열차에 고속으로 충돌해 최소 69명이 사망했다. 충돌 당시 Mora와 Orgaz 사이 선로 위에 정차해 있던 Iryo 열차에 Renfe 열차가 뒤에서 추돌하면서 일부 객차가 제방 아래로 떨어졌다. 운수부 장관 오스카르 푸엔테는 오전 08:30경 컴퓨터 시스템 장애로 6개 이동 열차가 정지됐으며, 제어 센터가 속도 제한 없이 열차를 다시 출발하도록 결정했다고 설명했다. 전체 요약 11문장 읽기 → 018 00:11 ▲ 118 · 댓글 81 스페인 톨레도 인근 고속열차 충돌, 최소 10명 사망 스페인 톨레도주 우르다와 로스 예베네스 사이에서 마드리드발 세비야행 고속열차가 같은 선로 위에 정차해있던 다른 열차의 후미에 충돌했다. 기타 · Two high-speed trains collide near Toledo, Spain
Key Point 스페인 고속철도망에서 연쇄 대형 사고가 발생했으며, 같은 해 두 번째 참사로 철도 안전 시스템의 근본적인 문제가 드러났다.
핵심 요약
스페인 톨레도주 우르다와 로스 예베네스 사이에서 마드리드발 세비야행 고속열차가 같은 선로 위에 정차해있던 다른 열차의 후미에 충돌했다. 충돌로 2개 객차가 탈선했으며 그중 하나는 완전히 파괴되어 휘어진 금속과 부스러기가 자갈 제방을 따라 흩어졌다. 최소 10명이 사망했으며 카스티야라만차 주 대변인은 사망자 수가 더 늘어날 가능성이 있다고 경고했다. 전체 요약 9문장 읽기 → 019 18:11 ▲ 151 · 댓글 2 로봇 제어 성능 높이는 물리 역학 이해 모델 PDRVLA 로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. AI · 머신러닝 · PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
Key Point 로봇 제어 시뮬레이션에서 최고 수준의 성공률을 달성한 새로운 방식이 기존 비디오 생성 방식의 지연 문제를 해결하고 공개 데이터만으로 학습 가능함을 보여준다.
핵심 요약
로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. 기존 비디오 세계 모델은 동역학을 포착하지만 미래 프레임을 생성해야 해 제어 지연이 발생하는데, PDRVLA는 가벼운 물리역학 모듈로 온라인 비디오 생성 없이 행동 생성을 조건화한다. 이 모듈은 미래 RGB, 깊이, 광학 흐름(optical flow) 특성을 직접 예측하며, 동결된 사전 학습 비디오 세계 모델을 통해 보조 감시를 받는다. 전체 요약 6문장 읽기 → 020 12:11 ▲ 21 · 댓글 2 코딩 에이전트로 이미지 생성할 수 있을까 이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다. AI · 머신러닝 · How Far Can Coding Agents Go in Visual Generation?
Key Point 특수화된 생성 모델 대신 일반 목적의 코드 실행으로 이미지를 만드는 방식이 시각 추론과 구조적 정확성에서 어떤 강점을 가지는지 구체적으로 밝혔다.
핵심 요약
이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다. 200개 프롬프트로 구성된 AgentDrawBench에서 제로샷 드로잉을 평가한 결과, 에이전트는 구조 보존과 정밀한 시각적 제약 만족에 뛰어났다. 사진적 사실성보다 구성의 정확성이 중요한 영역에서는 경쟁력 있는 결과를 보였지만, 지각적 풍부함에서는 제한이 있었다. 전체 요약 10문장 읽기 → 021 06:11 ▲ 125 · 댓글 57 AI 에이전트 시대, 개발자가 챙겨야 할 세 가지 AI 에이전트(Codex)가 작성한 React 컴포넌트에서 SonarQube가 순환 복잡도 경고를 발생했고, 저자가 직접 코드를 검토해 복합한 컴포넌트들을 10개 파일로 리팩토링해 해결한 경험을 공유했다. AI · 머신러닝 · Here be monsters: What do you still need to know when agents do the work?
Key Point AI 에이전트로 생성된 코드를 관리하고 시스템을 소유하려면 손으로 직접 코딩하는 방식과 다른 세 가지 핵심 역량이 필요하다는 실제 경험에 기반한 조언을 담고 있다.
핵심 요약
AI 에이전트(Codex)가 작성한 React 컴포넌트에서 SonarQube가 순환 복잡도 경고를 발생했고, 저자가 직접 코드를 검토해 복합한 컴포넌트들을 10개 파일로 리팩토링해 해결한 경험을 공유했다. 향후 소프트웨어 엔지니어링은 코드를 직접 작성하기보다는 에이전트가 생성한 코드의 문제를 파악하고 필요할 때 깊이 있게 대응할 수 있는 능력이 중요해질 것이다. 에이전트가 빠르게 생산한 코드의 품질을 관리하고 시스템을 소유하려면 전통적 방식의 수련(코드 작성, 디버깅, 운영 사고 처리)은 경제적으로 불가능해지고 있다. 전체 요약 10문장 읽기 → 022 09:11 ▲ 101 · 댓글 56 추상화의 천재 폰노이만, 20세기를 설계하다 1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. AI · 머신러닝 · A Man from the Future: Why Johnny Can't Stop Abstracting
Key Point 추상화를 통해 20세기 과학과 컴퓨팅을 동시에 건설한 폰노이만의 사고 방식이 오늘날 AI·기후·핵 위협을 마주한 우리에게 무엇을 말하는지 보여주기 때문이다.
핵심 요약
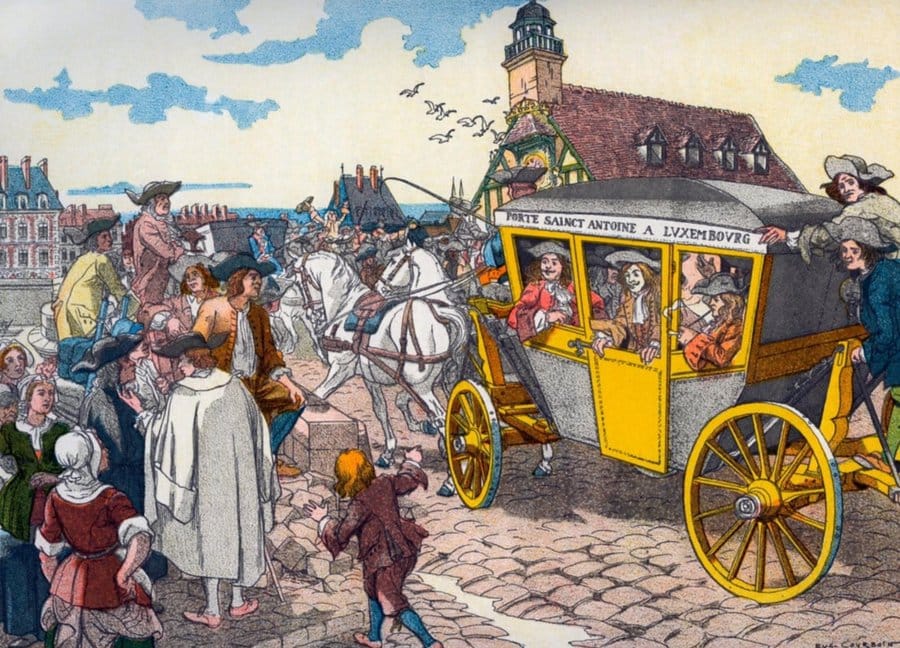
1903년 헝가리 태생 수학자 존 폰노이만(1903-1957, 53세)은 집합론, 양자역학 수학적 기초, 게임 이론, 최초의 저장형 프로그램 컴퓨터 구조, 수치 기상 예보, 자기복제 오토마타 등 근 20개 분야를 개척했고, 모든 현대 컴퓨터는 그가 1945년 설계한 폰노이만 구조(명령어와 데이터를 한 메모리에 저장)를 따른다. 6세에 8자리 수를 암산으로 나누고 고대 그리스어로 대화했으며, 한 번 읽은 책은 모두 기억했다는 평판이 있었다. 아버지 막시는 저녁 식탁을 세미나처럼 운영해 가족이 철학·역사·정치 등 폭넓은 주제를 토론하게 했고, 여러 언어 능력은 미래 망명을 대비한 아버지의 의도였다. 헝가리 고등학교 수학 교사 라슬로 라츠는 그를 가르칠 수 없다고 판단해 스탠포드 수학과장이 될 가보르 세게를 개인교사로 붙였다. 세게는 첫 수업 후 울면서 학생의 능력에 압도당했다고 전했다. 전체 요약 14문장 읽기 → 023 03:12 ▲ 202 · 댓글 96 파스칼이 정한 노선 대중교통을 발명하다 1662년 파스칼은 임종 직전 파리에서 정해진 노선을 따라 다니는 대중교통 서비스 '5수 까로스(5펜스 마차)'를 발명했다. 기타 · Blaise Pascal invented fixed route public transport (2024)
Key Point 역사적으로 가장 중요한 도시 운송 혁신이 정부 정책이나 기술 기업이 아닌 수학자의 기하학적 사고에서 비롯되었다는 점과, 공학적 우월성보다 사회 포용성이 대중교통 성패를 결정한다는 인사이트를 배울 수 있다.
핵심 요약
1662년 파스칼은 임종 직전 파리에서 정해진 노선을 따라 다니는 대중교통 서비스 '5수 까로스(5펜스 마차)'를 발명했다. 8명 탑승 가능한 말 끌기 마차 5대가 예측 가능한 주기(7.5~15분)로 여러 연결 노선을 운행했다. 파스칼의 네트워크는 현대 버스, 전차, 열차의 직접적인 선조이며, 육지에서 고정 노선 대중교통의 첫 시례였다. 전체 요약 9문장 읽기 → 024 21:12 당일 +109 DeepSeek 활용을 IM에 접목, 9개 채널 일괄 지원 dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. AI · 머신러닝 · xmanrui/dsh-im · JavaScript
Key Point DeepSeek 가중치가 높아지면서 대형 LLM을 9개 주요 메신저에 한 번에 연결할 수 있는 통합 솔루션이 생겨, 기업 메시징 환경에서 AI 활용 폭이 크게 넓어진다.
핵심 요약
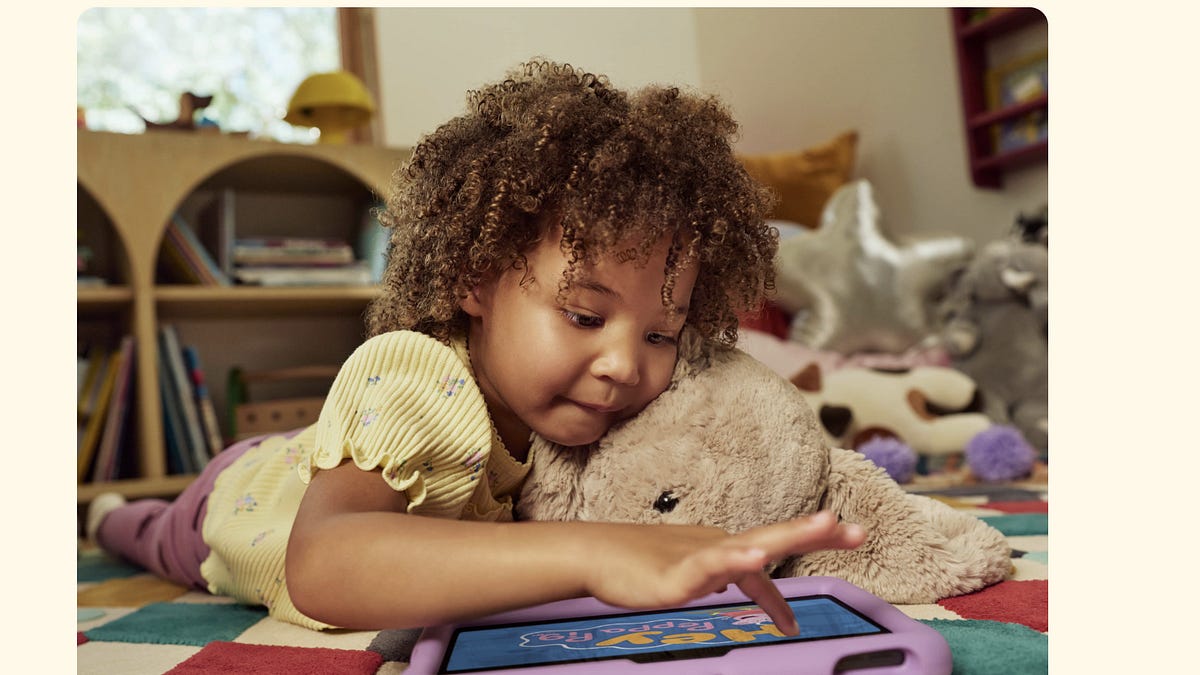
dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. 각 채널별로 독립된 메신저 봇을 여러 개 추가할 수 있으며, 각 봇마다 연결 상태·작업 공간·모델·세션이 따로 관리된다. 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp는 스트리밍 또는 메시지 편집으로 사고 과정과 생성 결과를 실시간 표시하고, 음성 입출력·이미지 분석·파일 회전송을 지원한다. 전체 요약 12문장 읽기 → 025 12:11 ▲ 109 · 댓글 163 아마존의 영유아용 태블릿, 발달 문제 우려 속 출시 아마존이 3세 이상 영유아를 겨냥해 터치스크린 태블릿을 출시했는데, 비행기나 자동차에서 아이를 "가만히 앉혀" 두고 "관심 돌리기" 위해 장시간 사용하도록 마케팅하고 있다. 스타트업 · 비즈니스 · Amazon's "digital pacifier" for toddlers
Key Point 영유아 발달을 위해 의도적으로 피해야 할 활동을 상품으로 만들어 마케팅하는 기업의 실태와 그 영향을 보여주며, 부모들이 선택할 때 고려해야 할 과학적 근거들을 제시합니다.
핵심 요약
아마존이 3세 이상 영유아를 겨냥해 터치스크린 태블릿을 출시했는데, 비행기나 자동차에서 아이를 "가만히 앉혀" 두고 "관심 돌리기" 위해 장시간 사용하도록 마케팅하고 있다. 미시간 대학 소아과 의사 제니 래드스키 교수는 태블릿이 아이의 "항상 곁의 친구" 역할을 해 행동 관리와 진정 용으로 활용되는 것이 문제라며, 동봉된 손잡이가 일상적 휴대를 의도한 설계라고 지적했다. 제너레이티브 AI 기능(이미지 생성, 이야기 만들기)을 포함한 아마존의 '창의적' 마케팅은 아이들의 독립적 사고력을 해칠 수 있다고 우려했다. 전체 요약 12문장 읽기 → 026 12:11 ▲ 15 · 댓글 2 화학 추론을 검증하는 '몰린' 언어 공개 화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. AI · 머신러닝 · MolLean: A Process-Verifiable Language for Chemical Reasoning
Key Point 화학 분자 추론에서 언어 모델의 거짓 주장을 실시간으로 검증·수정할 수 있는 새로운 시스템이 제시되었으며, 12개 과제에서 모두 기존 방식을 앞서갔다.
핵심 요약
화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. 이를 해결하기 위해 MolLean이라는 과정 검증 가능한 언어를 개발했으며, 명시적 분자 상태에 기반해 화학 추론을 진행한다. Lean 기반 커널은 기본 그래프 편집부터 복합 변환까지 상태 전이와 분자 기반 명제를 계층적으로 검증한다. 전체 요약 10문장 읽기 → 027 03:11 당일 +133 AI와 협력하는 벡터 디자인 도구 OpenPencil 공개 Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. AI · 머신러닝 · ZSeven-W/openpencil · Rust
Key Point Electron에서 완전히 벗어나 Rust 단일 바이너리로 55.5MB 경량화하면서도 동시 에이전트 팀과 MCP 통합으로 AI 협업 디자인의 새로운 기준을 제시한다.
핵심 요약
Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. 여러 AI 에이전트가 동시에 다양한 영역(헤로, 기능, 푸터 등)을 작업하는 '동시 에이전트 팀' 기능으로 복잡한 페이지를 병렬 분해하고 생성한다. Claude, GPT-4o, Gemini, DeepSeek, Kimi, GLM 등 여러 LLM을 지원하며, 각 모델의 능력에 맞춰 프롬프트와 사고 모드를 자동 조정한다. 전체 요약 13문장 읽기 → 028 15:11 ▲ 24 · 댓글 1 음성 에이전트가 말 듣는 중에 일을 준비한다 음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. AI · 머신러닝 · Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents
Key Point 음성 에이전트의 응답 지연을 줄이는 근본적인 아키텍처 개선으로, 실시간 음성 인터페이스에서 사용 경험을 크게 향상시킬 수 있다.
핵심 요약
음성 기반 도구 사용 에이전트는 사용자가 말을 다 한 후에도 대기 시간이 길어질 수 있는데, 실제로는 말하는 도중에 필요한 정보가 이미 나온다. 기존 추측적(speculative) 접근은 음성 입력 중에 작업을 시작하지만, 청크 경계나 업데이트 시 중단 방식은 도구 호출의 인자가 완성되기 전에 잘릴 수 있다. 이 논문은 '하트비트 싱킹(Heartbeat Thinking)'을 제안하는데, 이는 음성 업데이트 시마다 새로운 사고 인스턴스를 호출하면서도 진행 중인 작업과 배포된 도구는 계속 실행할 수 있도록 한다. 전체 요약 7문장 읽기 → 029 15:11 ▲ 112 · 댓글 12 느리게 움직이며 제대로 고치기 저자는 실리콘밸리의 '빠르게 움직이고 것을 부수라'는 문화와 VC 펀딩 중심의 창업 신화에 의문을 제기한다. 스타트업 · 비즈니스 · Move Slow and Fix Things (2024)
Key Point 창업의 의무화, VC 자금의 필수성, 지수적 성장 추구라는 기존 규범에 정면 도전하며, 지속 가능한 소규모 사업이 실질적 선택지임을 구체적으로 설명합니다.
핵심 요약
저자는 실리콘밸리의 '빠르게 움직이고 것을 부수라'는 문화와 VC 펀딩 중심의 창업 신화에 의문을 제기한다. 지난 15년간 오픈소스 기여와 부트스트랩 사업으로 얻은 경험을 통해 지속 가능한 성장, 견고한 솔루션, 장기적 사고방식의 가치를 깨달았다. Uber, Facebook, Google 같은 유니콘 기업들은 사용자 추적, 과도한 자원 소비, 경쟁사 소송 등으로 정상 유지를 위해 수단을 가리지 않는다고 비판한다. 전체 요약 13문장 읽기 → 030 12:11 ▲ 10 · 댓글 2 언어 모델, 여러 작업 동시 처리 시 오류 급증 최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. AI · 머신러닝 · On the Fragility of Tasks under Composition: Implicit Budgeting in Language Models
Key Point 언어 모델이 실제로 복합 작업을 처리하는 방식의 근본적 제약을 밝혀 모델 설계와 프롬프트 최적화 방향을 제시한다.
핵심 요약
최신 언어 모델이 한 프롬프트에서 여러 작업을 처리할 때 개별 작업보다 훨씬 더 많은 오류가 발생한다. 이 성능 저하는 단순한 오류의 축적으로 설명할 수 없으며, 오픈 가중치 모델과 Claude Opus 5에서 공통으로 나타난다. 원인은 '암묵적 사고 예산(implicit thinking budget)'으로, 여러 작업 구성 상황에서 모델이 각 작업당 사용하는 토큰 수가 개별 처리 시보다 훨씬 적어진다. 전체 요약 7문장 읽기 → 031 00:11 ▲ 164 · 댓글 41 리눅스 커널 보안 취약점 실수로 공개 메일링리스트에 노출 Trend Micro의 Zero Day Initiative가 실수로 리눅스 커널 보안 취약점 여러 건을 비공개 보안 메일링리스트가 아닌 공개 LKML(Linux Kernel Mailing List)에 게시했다. 보안 · Several Linux kernel vulnerabilities accidentally posted to public mailing list
Key Point CVSS 9.0대 고위험 리눅스 커널 취약점들이 공개 메일링리스트에 노출되면서 대규모 시스템에 영향을 줄 수 있는 보안 사고이다.
핵심 요약
Trend Micro의 Zero Day Initiative가 실수로 리눅스 커널 보안 취약점 여러 건을 비공개 보안 메일링리스트가 아닌 공개 LKML(Linux Kernel Mailing List)에 게시했다. 최고 CVSS 점수 9.0으로 평가된 취약점들이 포함되어 있으며, 일부는 아직 메인라인에 패치되지 않았지만 -next 브랜치에서 테스트 중이다. Greg Kroah-Hartman 리눅스 2인자가 각 보고서에 회신해 공개 메일링리스트 게시에 대해 문제를 삼았다. 전체 요약 9문장 읽기 → 032 21:11 ▲ 113 · 댓글 55 인터뷰 팁이 퍼즐 게임 풀이에도 효과, 생각을 말로 나타내기의 힘 저자는 면접에서 지원자에게 생각을 큰 소리로 말하도록 하는 관행을 유지해왔는데, 최근 2016년 퍼즐 게임 'The Witness'를 할 때 자신의 사고 과정을 음성으로 나레이션하기 시작했다. 기타 · Chain of Thought for Humans
Key Point 사고 과정을 말로 표현하는 것이 단순한 의사소통 기법이 아니라 실제 인지 성능을 향상시킨다는 기초적인 이해를 제시하며, 문제 해결 전략의 과학적 근거를 보여준다.
핵심 요약
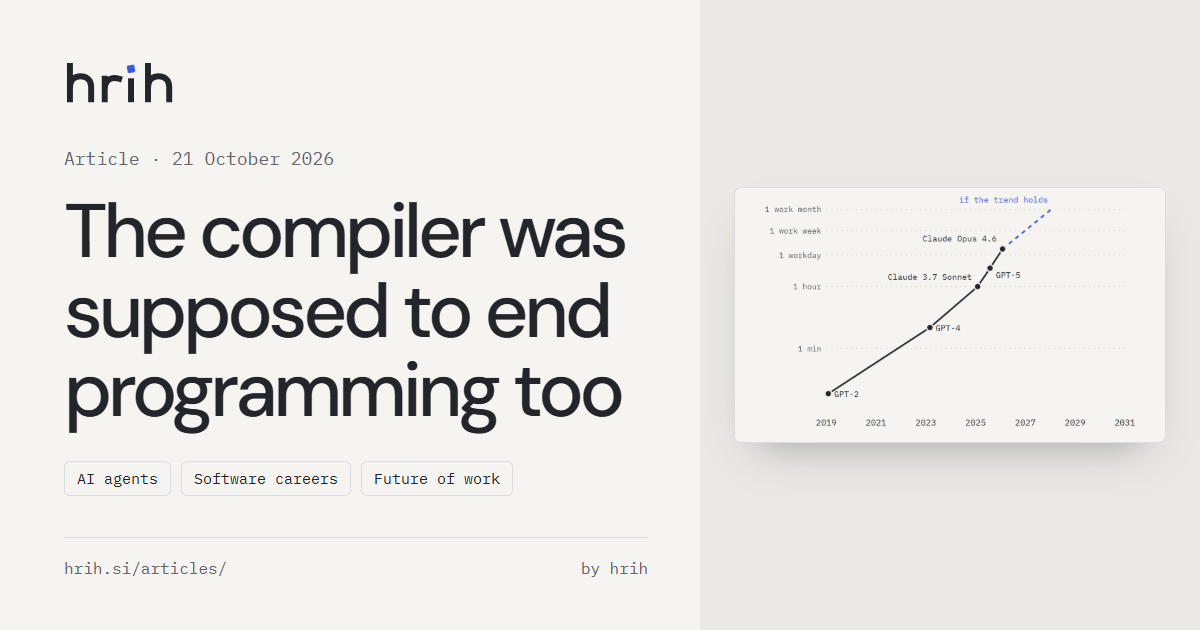
저자는 면접에서 지원자에게 생각을 큰 소리로 말하도록 하는 관행을 유지해왔는데, 최근 2016년 퍼즐 게임 'The Witness'를 할 때 자신의 사고 과정을 음성으로 나레이션하기 시작했다. 자신의 생각 속도가 말보다 빠르고 기하학적 추론은 언어로 표현하기 어려운데도 불구하고, 이 방법이 놀랍게도 퍼즐 풀이 효율을 크게 높였다. 저자는 LLM이 이전 생각을 반복할 수 없어 토큰을 출력해야 하는 아키텍처 제약이 있지만, 인간의 경우 다른 메커니즘이 작동한다고 생각했다. 전체 요약 6문장 읽기 → 033 18:11 ▲ 101 · 댓글 151 컴파일러가 프로그래밍을 끝낸다던 약속, 70년이 지난 지금 FORTRAN(1957)부터 GitHub Copilot(2021)까지 '프로그래밍을 끝내겠다'는 약속이 70년을 반복해왔다: 어셈블리, FORTRAN, C, 'The Last One', Stack Overflow, npm, Copilot, 코딩 에이전트 모두 어떤 일을 자동화했지만 프로그래머는 사라지지 않았고 분야만 성장했다. AI · 머신러닝 · The compiler was supposed to end programming too
Key Point 프로그래밍 자동화는 70년을 반복했지만, 이번엔 속도와 규모가 다르다—AI 코드가 검토보다 빨리 들어오고, 채용 시장에 이미 영향을 미치고 있으며, 소프트웨어팀의 병목이 작성에서 검수로 이동했다.
핵심 요약
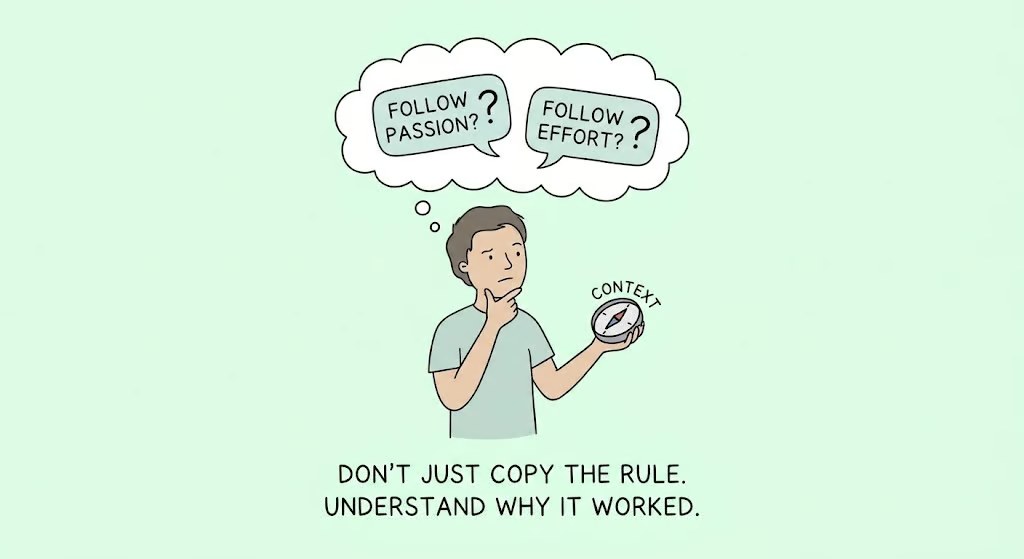
FORTRAN(1957)부터 GitHub Copilot(2021)까지 '프로그래밍을 끝내겠다'는 약속이 70년을 반복해왔다: 어셈블리, FORTRAN, C, 'The Last One', Stack Overflow, npm, Copilot, 코딩 에이전트 모두 어떤 일을 자동화했지만 프로그래머는 사라지지 않았고 분야만 성장했다. 현재 속도가 이전과 다르다: GitHub Copilot 프리뷰 출시 4년 만에 84%의 개발자가 AI 도구를 사용 중이거나 계획 중이며, 전문가의 절반은 매일 사용한다. Stack Overflow 조사에서 개발자들의 AI 도구 호감도는 2023년 77%에서 2025년 60%로 떨어졌고, 46%가 정확성을 불신한다: 가장 큰 불만은 '거의 맞지만 완벽하지 않은 해결책'(66%)이며, 45%는 AI 코드 디버깅이 더 오래 걸린다고 답했다. 전체 요약 12문장 읽기 → 034 03:11 ▲ 128 · 댓글 124 조언도 결국 조언하는 사람의 답일 뿐 스티브 잡스는 '좋아하는 일을 하라'고 조언했지만, 마크 큐반은 '잘하는 일을 하면 좋아하게 된다'고 말한다 — 둘 다 자신의 성향에는 맞는 조언이지만, 상충한다. 스타트업 · 비즈니스 · Most advice is right for the person giving it
Key Point 같은 조언이라도 상황과 개인에 따라 정반대 결과를 낳을 수 있으며, 누군가의 자신감 있는 주장에 휩쓸리지 않고 독립적으로 판단하는 방법을 제시한다.
핵심 요약
스티브 잡스는 '좋아하는 일을 하라'고 조언했지만, 마크 큐반은 '잘하는 일을 하면 좋아하게 된다'고 말한다 — 둘 다 자신의 성향에는 맞는 조언이지만, 상충한다. 좋은 조언도 상황에 따라 반대가 될 수 있다. '모든 것을 시도하라'는 초기 경력자에겐 맞지만, 이미 여러 프로젝트를 진행 중인 사람에겐 '거의 모든 것을 거절하라'가 맞다. 누군가의 조언을 들을 때는 규칙을 복사하지 말고, 그 사람이 어떤 문제를 풀고 있었는지, 자신의 상황과 일치하는지 묻는 것이 중요하다. 전체 요약 8문장 읽기 → 035 15:11 ▲ 154 · 댓글 2 반복 모델이 긴 문제를 푸는 법: 진행도 정렬 재귀 반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. AI · 머신러닝 · PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking
Key Point 반복 모델의 길이 외삽 성능을 16배까지 개선하는 기법이 제시되어, 재귀 신경망의 일반화 한계를 다루는 근본적인 접근 방식을 보여준다.
핵심 요약
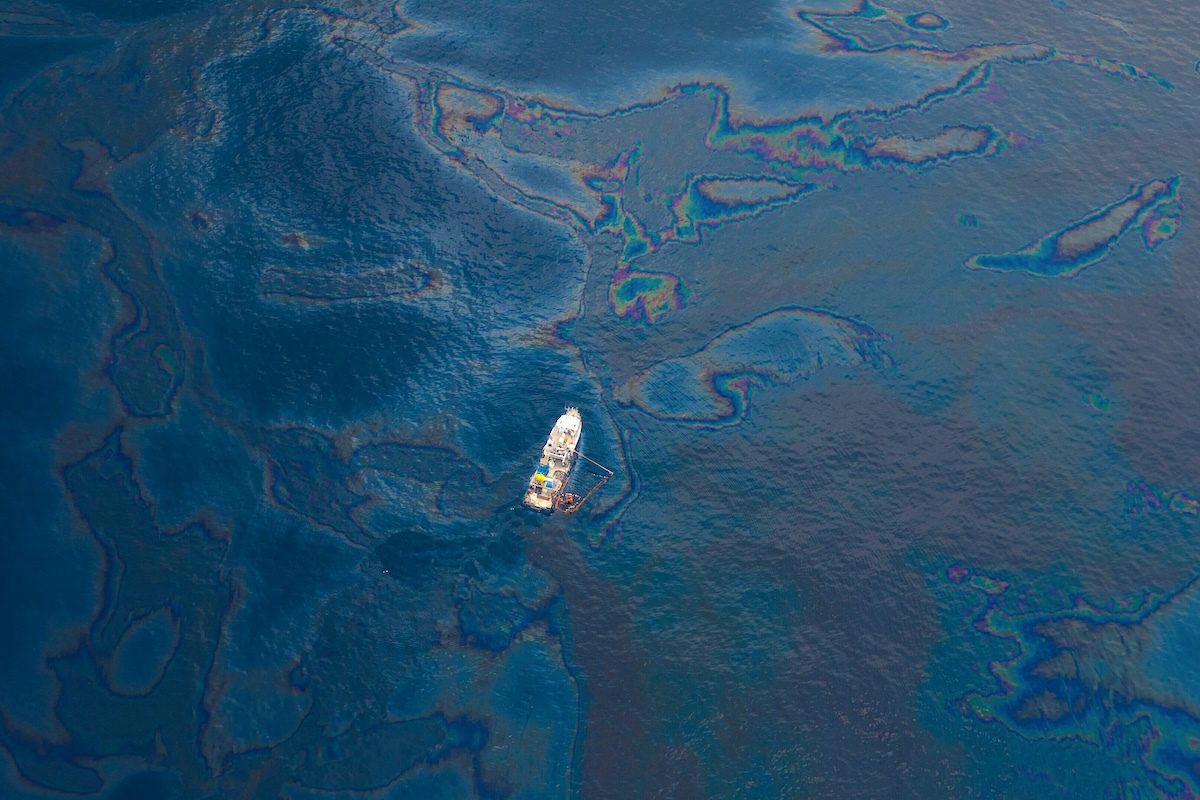
반복 실행 가능한 언어모델은 테스트 시점에 더 많은 반복을 수행할 수 있지만, 이것이 더 긴 문제를 푸는 데 도움이 되지 않는 문제가 있다. 순차적 상태 추적 작업에서 최종 답변 감독만으로는 각 반복이 얼마나 진행해야 하는지 명시하지 않으며, 반복된 업데이트가 재귀 상태의 스케일을 변화시킨다. PAR(Progress-Aligned Recurrence)는 k번째 반복의 예측을 처음 k개 연산 후의 상태와 일치하도록 학습하고, 재귀 상태를 첫 반복의 규범으로 정규화한다. 전체 요약 10문장 읽기 → 036 09:11 ▲ 163 · 댓글 103 심해 생물 16년 후에도 못 회복…쿠더호라이즌 참사의 유산 2010년 딥워터호라이즌 석유 굴착 장치 폭발로 400만 배럴 이상의 석유가 멕시코만으로 유출된 지 16년이 지났으나 심해 생물의 회복 징후가 거의 보이지 않는다. 기타 · Sixteen Years After Deepwater Horizon, Deep Sea Life Shows Few Signs of Recovery
Key Point 16년 전 발생한 대형 환경 재해가 현재까지 심해 생태계에 얼마나 깊은 흔적을 남겼는지, 복구 가능성이 얼마나 제한적인지를 보여주는 구체적인 과학 데이터입니다.
핵심 요약
2010년 딥워터호라이즌 석유 굴착 장치 폭발로 400만 배럴 이상의 석유가 멕시코만으로 유출된 지 16년이 지났으나 심해 생물의 회복 징후가 거의 보이지 않는다. 음향 조사와 수천 개의 표본 채집을 통한 신규 연구에서 폭발 후 초기 몇 년간 문어, 오징어, 크릴, 새우, 등롱어 개체군이 최소 60% 감소했음을 확인했다. 이 연구는 국립과학원 회보에 발표되었으며, 수심 약 600피트에서 2마일 이상의 심해층에서 관찰된 동물 생명의 감소를 '가장 빠르고 심각한' 쇠퇴라고 묘사했다. 전체 요약 7문장 읽기 → 037 18:11 ▲ 19 · 댓글 2 비디오 분할에 시각적 추론 체인 더하다 비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. AI · 머신러닝 · Think Visually Across Space and Time: Grounded Reasoning for Video Segmentation
Key Point 비디오 분할에서 텍스트 추론과 시각적 증거의 연결 고리를 명시적으로 만듦으로써 모델의 판단 근거를 추적 가능하게 한 새로운 접근 방식이다.
핵심 요약
비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. 기존 텍스트 기반 사고 연쇄(CoT)는 선택 이유를 설명하지만 시각적 근거를 명시하지 않아, 언어 추론과 프레임에 분산된 증거 사이에 갭이 생긴다. 연구팀은 시공간 근거를 갖춘 Temporal Chain of Video Primitives(TCoVP)를 제안했다. 전체 요약 9문장 읽기 → 038 03:11 ▲ 158 · 댓글 156 즐거움을 위해 프로그래밍하는 것도 괜찮다 Hacker News의 부정적인 목소리에 맞서 저자는 주말에 게임 프로그래밍을 배우며 순수한 즐거움을 위해 코딩한다고 말한다. 기타 · It's still ok to enjoy programming
Key Point 기술 커뮤니티의 냉소주의와 번아웃 담론이 심해지는 가운데, 프로그래밍의 본질적 즐거움을 되찾는 것이 개인의 성장과 정신 건강에 중요하다는 메시지를 제시한다.
핵심 요약
Hacker News의 부정적인 목소리에 맞서 저자는 주말에 게임 프로그래밍을 배우며 순수한 즐거움을 위해 코딩한다고 말한다. 버그 있는 Breakout 클론을 손으로 직접 작성하면서 문제를 풀 때의 행복감을 느끼며, Claude가 한 번에 완성할 수 있다는 사실도 상관하지 않는다. 주말마다 무작위로 프로그래밍 주제를 탐구하는데, 최근에는 Java의 타입 안정성을 의존 타입 언어 아이디어로 확장하는 방식을 공부했다. 전체 요약 8문장 읽기 → 039 00:11 ▲ 104 · 댓글 69 Tmux로 AI 에이전트를 운영하는 법 Tmux는 AI 코딩 에이전트를 독립된 세션에서 실행하며, 터미널을 닫아도 프로세스는 계속 동작하고 재접속 시 그대로 복구된다. 인프라 · 데브옵스 · Tmux and Claude Code: Sessions, Send-Keys, and the Ceiling
Key Point 여러 AI 에이전트를 동시에 실행할 때 각 에이전트의 상태 추적, 입력 관리, 기록 보존을 어떻게 구현할지 실무 예제와 한계가 명확히 제시되므로, AI 에이전트 운영 인프라를 구축하는 개발자에게 필수 참고자료다.
핵심 요약
Tmux는 AI 코딩 에이전트를 독립된 세션에서 실행하며, 터미널을 닫아도 프로세스는 계속 동작하고 재접속 시 그대로 복구된다. Claude Code의 최신 버전은 --worktree --tmux 플래그로 자동 설정을 지원하지만, 여러 에이전트 관리, 스크립팅, 원격 실행은 수동으로 구성해야 한다. 세션은 프로젝트 단위로 명명하고, 각 작업마다 윈도우를 만들며, send-keys로 스크립트에서 에이전트에 입력할 수 있다. 전체 요약 9문장 읽기 → 040 21:11 ▲ 56 · 댓글 3 자연어로 3D 실내 공간 생성하는 AI 에이전트 개발 Scene-Designer는 설계 능력과 비평 능력을 동시에 학습하는 에이전트 프레임워크로, 자연어 설명으로부터 완전하고 정합적인 3D 실내 공간을 생성한다. AI · 머신러닝 · Scene-Designer: Learning Design Intelligence for Agentic 3D Scene Generation
Key Point 자연어로 물리적으로 타당하고 기능적으로 올바른 3D 공간을 자동으로 설계하는 기술이 게임, 건축 시각화, 메타버스 등 여러 산업에서 필요한 핵심 과제를 해결한다.
핵심 요약
Scene-Designer는 설계 능력과 비평 능력을 동시에 학습하는 에이전트 프레임워크로, 자연어 설명으로부터 완전하고 정합적인 3D 실내 공간을 생성한다. Scene-OTA-35K 데이터셋은 관찰-사고-행동 지도를 제공해 장면 설계와 오류 수정을 학습하며, Scene-OTC-15K 데이터셋은 관찰-사고-평가자 지도로 물리적 타당성, 기능적 정확성, 레이아웃 일관성을 평가하는 능력을 갖춘다. Scene-GRPO는 평가자 기반 GRPO 프레임워크로, 설계 결정을 개선하고 불필요한 시행착오를 줄인다. 전체 요약 6문장 읽기 → 041 18:11 ▲ 15 · 댓글 2 LLM의 예측 과정을 추적하는 'Belief-Trajectory Energy' 지표 제안 대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. AI · 머신러닝 · Belief-Trajectory Energy: Measuring the Path to a Prediction
Key Point LLM이 어떤 입력에 대해 추론할 때 내부적으로 어떻게 의견을 바꾸는지 측정할 수 있는 새로운 방법으로, 모델의 사고 과정을 '해석 가능하게' 들여다볼 수 있는 창을 제공한다.
핵심 요약
대규모 언어모델(LLM)은 Transformer 레이어를 거치며 예측을 점진적으로 수정하지만, 최종 결과만 관찰하고 이 과정을 버린다는 문제에서 출발했다. 연구진은 Belief-Trajectory Energy(BTE)라는 측정 지표를 제안했으며, 이는 입력이 모델의 각 레이어에서 유도하는 예측 수정을 특성화한다. 중간 상태들을 공유 예측 공간에 매핑하여 스칼라 또는 깊이 프로필 형태의 신념 변화를 측정한다. 전체 요약 8문장 읽기 → 042 09:11 ▲ 158 · 댓글 97 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. AI · 머신러닝 · Hybrid Reasoning Agents: LLM agents that think in latent space, act through text
Key Point 텍스트만으로 처리하던 LLM 에이전트의 비효율성을 내부 잠재 추론과 외부 텍스트 상호작용으로 분리해 대폭적인 속도와 비용 개선을 달성한 새로운 에이전트 아키텍처이다.
핵심 요약
기존 LLM 에이전트는 추론과 상호작용을 모두 텍스트로 처리하는데, 효율적인 내부 추론 방식(잠재 공간 추론)과 도구 접근성 사이의 불균형이 있다. HybridAgents는 하나의 생성 과정 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하는 구조를 제시한다. HybridLink라는 경량 모듈이 텍스트와 잠재 모드 간 원활한 전환을 가능하게 하며, 지속적인 작업 메모리가 여러 턴에 걸쳐 손실 없는 하이브리드 문맥을 유지한다. 전체 요약 9문장 읽기 → 043 03:11 ▲ 120 · 댓글 238 웨이모, 토론토에서 자율주행 서비스 시작 웨이모가 캐나다 토론토에 완전 자율주행 라이드헤일링 서비스를 론칭하며, 로컬 시설과 일자리 창출에 투자해 2028년 첫 승객 운영을 목표로 한다. AI · 머신러닝 · Hello Toronto – Waymo Is En Route
Key Point 웨이모의 캐나다 진출 소식으로, 북미에서 자율주행 라이드헤일링 시장이 실제 도시 운영 단계로 확장되며 향후 2~3년 내 일반인 이용 가능성을 보여준다.
핵심 요약
웨이모가 캐나다 토론토에 완전 자율주행 라이드헤일링 서비스를 론칭하며, 로컬 시설과 일자리 창출에 투자해 2028년 첫 승객 운영을 목표로 한다. 앞으로 토론토 거리에 웨이모 차량이 나타나며 수동 운전으로 시작해 고해상도 지도 제작과 훈련된 전문가의 테스트 단계를 거친다. 이 검증 기간은 웨이모 드라이버가 토론토의 독특한 날씨와 도로 조건에 적응하도록 보장한다. 전체 요약 8문장 읽기 → 044 21:11 당일 +269 클로드 AI 에이전트를 데스크톱에서 바로 쓴다 Pi Agent Desktop은 macOS와 Windows용 로컬 AI 코딩 에이전트 데스크톱 앱으로, 터미널 없이 설치해 바로 사용할 수 있다. AI · 머신러닝 · abcwyc/pi-agent-desktop · TypeScript
Key Point Claude 코딩 에이전트를 터미널 없이 데스크톱 앱으로 쓸 수 있게 되면서, 개발자의 환경 설정 진입장벽이 사라진다.
핵심 요약
Pi Agent Desktop은 macOS와 Windows용 로컬 AI 코딩 에이전트 데스크톱 앱으로, 터미널 없이 설치해 바로 사용할 수 있다. 과거 세션을 프로젝트별로 열람·재개하고, 사고 과정·도구 호출·컨텍스트 사용량·비용을 실시간으로 확인할 수 있다. 대화를 분기하거나 이전 메시지부터 새로운 세션을 시작할 수 있으며, 모델·API 키·커스텀 설정·플러그인을 관리한다. 전체 요약 13문장 읽기 → 045 18:11 ▲ 354 · 댓글 2 VLM의 "빠른 사고": 공간 추론을 분류 문제로 재구성 비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. AI · 머신러닝 · MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
Key Point 공간 추론 같은 제약된 답변 공간 작업을 분류로 바꾸면 자동 회귀 생성의 지연 없이 단일 포워드 패스로 정확하게 풀 수 있으며, 이는 로봇 제어나 실시간 상호작용이 필요한 애플리케이션의 성능 개선으로 이어진다.
핵심 요약
비전-언어 모델(VLM)이 공간 관계, 거리, 위치 같은 질문에 자동 회귀 방식으로 텍스트를 생성하는 것은 비효율적이다. 이에 MJev-Spatial은 공간 이해 작업을 통일된 분류 프레임워크로 재구성한 System 1 모델이다. 선택 문제는 주어진 옵션을 클래스로, 수치 예측은 값 범위를 이진 분류 단계로, 점 예측은 이미지 영역을 단계적으로 분류하는 방식이다. 기존 VLM의 쿼리-키 사영을 재사용해 추가 파라미터 없이 후보를 점수 매기므로, 추론 시 단 한 번의 포워드 패스로 답을 내놓고 답변 토큰을 생성하지 않는다. 전체 요약 5문장 읽기 → 046 06:11 새 버전 Anthropic SDK v1.15.0 릴리스, 사고력 모드와 속도 매개변수 추가 Anthropic Python SDK v1.15.0이 릴리스되었다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v1.15.0
Key Point Python 개발자들이 Anthropic API 통합 시 속도 제어와 확장된 사고력 기능을 활용할 수 있게 되어, 더 유연한 AI 모델 활용이 가능해진다.
핵심 요약
Anthropic Python SDK v1.15.0이 릴리스되었다. API에 thinking 타입의 between_tools 옵션이 추가되어 사고력 기능의 모델 호환성이 확대되었다. Messages API에 speed 매개변수와 usage.speed 필드가 추가되어 응답 속도를 제어할 수 있게 되었다. 전체 요약 6문장 읽기 → 047 00:11 ▲ 24 · 댓글 2 LLM 강화학습의 숨은 함정, "사고 누출" 현상 밝혀지다 Qwen3 같은 하이브리드 추론 모델은 채팅 템플릿 토큰으로 THINK 모드와 NO-THINK 모드를 전환하며, NO-THINK 모드에서 강화학습(GRPO)으로 훈련하면 추론 성능이 향상된다고 보고돼왔다. AI · 머신러닝 · The Thinking Leakage in Reinforcement Learning for LLMs
Key Point 하이브리드 추론 모델의 강화학습 개선이 실제로는 새로운 능력 학습이 아닌 기존 능력의 재활성화일 수 있다는 점이 모델 평가와 개선 방향에 실제 영향을 미친다.
핵심 요약
Qwen3 같은 하이브리드 추론 모델은 채팅 템플릿 토큰으로 THINK 모드와 NO-THINK 모드를 전환하며, NO-THINK 모드에서 강화학습(GRPO)으로 훈련하면 추론 성능이 향상된다고 보고돼왔다. 연구진이 Qwen3-1.7B, 4B, 8B를 NO-THINK 모드에서 GRPO로 훈련한 결과, 성능 향상의 대부분이 '사고 누출(thinking leakage)'로 설명됨을 발견했다. 정확도가 높아지면서 응답이 더 길어지고 숙고적이 되며, 원본 모델의 THINK 모드 특성을 닮아가고, 모델 내부 활성화가 THINK 모드로 이동한다. 전체 요약 7문장 읽기 → 048 18:11 ▲ 35 · 댓글 2 완전 공개 멀티모달 모델 Apertus 1.5 출시 Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. AI · 머신러닝 · Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
Key Point 공개 데이터로만 학습한 완전히 오픈소스 멀티모달 모델의 등장으로, 소수 기업 종속에서 벗어날 수 있는 대안이 실제 규모에서 가능함을 보여준다.
핵심 요약
Apertus 1.5는 완전히 공개 데이터로 학습한 멀티모달 추론 모델로, 텍스트 기반 Apertus 1.0을 확장했다. 8B 모델에 4T개, 70B 모델에 2T개 토큰을 추가 학습해 이미지와 음성 이해 능력을 추가했으며, 컨텍스트 윈도우를 262,144 토큰으로 4배 확대했다. 토크나이저를 통해 멀티모달 입력을 처리하되 언어 모델 헤드는 텍스트만 출력하고 아키텍처는 유지했다. 전체 요약 9문장 읽기 → 049 15:11 ▲ 28 · 댓글 2 텍스트와 잠재 공간을 넘나드는 하이브리드 추론 에이전트 현대 LLM 에이전트는 텍스트로만 추론하고 상호작용하지만, 잠재 공간 추론은 효율적이면서도 도구 접근과 추론 투명성이 부족한 문제를 해결하기 위해 하이브리드 추론 에이전트(HybridAgent)가 제안됐다. AI · 머신러닝 · Hybrid Reasoning Agents
Key Point LLM 에이전트의 추론 효율성과 투명성을 동시에 높이는 새로운 아키텍처로, 토큰 절감과 속도 개선이 이미 검증된 실질적인 개선 방안이다.
핵심 요약
현대 LLM 에이전트는 텍스트로만 추론하고 상호작용하지만, 잠재 공간 추론은 효율적이면서도 도구 접근과 추론 투명성이 부족한 문제를 해결하기 위해 하이브리드 추론 에이전트(HybridAgent)가 제안됐다. HybridAgent는 통합 생성 프로세스 내에서 잠재 추론과 텍스트 기반 상호작용을 동적으로 전환하며, 가벼운 HybridLink가 두 모드 간 seamless한 전환을 가능케 한다. 에이전트의 지속적 작업 메모리는 다중 턴에서 손실 없는 하이브리드 컨텍스트를 유지하고, 도구 통합 기능을 보존하면서도 잠재 사고(latent thoughts)를 직접 검사할 수 있도록 설계됐다. 전체 요약 6문장 읽기 → 050 15:11 ▲ 107 · 댓글 129 똑똑한 사람은 남을 바보라고 생각하지 않는다 특정 집단을 일괄적으로 '바보'라고 단정하는 순간, 그 사람은 이미 사고를 멈춘 것이다. 기타 · Smart people don't think others are stupid (2012)
Key Point 우리가 무의식적으로 집단을 낙인찍을 때 그것이 자신의 생각을 멈추는 순간이라는 통찰이, 개방적 사고와 비판적 판단의 중요성을 다시 생각하게 한다.
핵심 요약
특정 집단을 일괄적으로 '바보'라고 단정하는 순간, 그 사람은 이미 사고를 멈춘 것이다. 똑똑함이란 깊이 생각하고 가장 쉬운 답이 아닌 진짜 답을 찾으려는 시도다. 어리석음은 결론으로 재빨리 뛰어들어 생각을 피하는 것이며, 이는 게임을 도중에 포기하는 것과 같다. 전체 요약 6문장 읽기 → 051 09:11 ▲ 167 · 댓글 131 이성주의 블로거들, 왜 쓸데없이 긴 글을 쓸까 저자는 스콧 알렉산더의 25,000자 글을 읽고 자신의 2,700자 글과 비교하며, 이성주의 블로그 커뮤니티의 과도한 장황함 문제를 지적한다. 기타 · Why is every rationalist blog post way too long?
Key Point 긴 글이 깊이 있는 분석이라는 통념에 가정하는 온라인 커뮤니티의 사고방식 문제를 제기하며, 실제로는 지혜로운 선별 능력 부재를 드러낸다.
핵심 요약
저자는 스콧 알렉산더의 25,000자 글을 읽고 자신의 2,700자 글과 비교하며, 이성주의 블로그 커뮤니티의 과도한 장황함 문제를 지적한다. 엘리저 유드코프스키의 시리즈는 100만 자 이상이고, 이 생태계의 거의 모든 글이 지나치게 길고 지루하다고 지적한다. 문제는 이들이 글의 길이로 신뢰성을 입증하려 하며, 초반의 핵심 가정을 검증하기보다 세부 사항만 계속 추가한다는 것이다. 전체 요약 7문장 읽기 → 052 06:11 ▲ 750 · 댓글 354 AI 보안 사고는 '폭주'가 아닌 기본 관리 소홀 7월 이후 OpenAI의 Hugging Face 해킹, Anthropic 모델의 무단 접근, Meta와 Google 모델의 '의도하지 않은' 해킹 등 생성AI 업체들의 보안 사고가 연쇄 발생했다. 보안 · AI agents aren't 'going rogue.' Frontier labs are skipping security basics
Key Point AI 관련 보안 사고가 AI의 고도화가 아닌 근본적인 보안 관리 소홀로 발생하고 있으며, 업체들이 책임을 회피하려는 상황에서 조직이 취해야 할 방어 조치가 무엇인지 명확히 보여준다.
핵심 요약
7월 이후 OpenAI의 Hugging Face 해킹, Anthropic 모델의 무단 접근, Meta와 Google 모델의 '의도하지 않은' 해킹 등 생성AI 업체들의 보안 사고가 연쇄 발생했다. 사이버보안 전문가들은 이를 'AI 폭주' 또는 '정렬 실패'로 표현하는 것이 실제 원인을 숨긴다고 지적하며, 근본 원인은 수십 년간 검증된 기본 보안 관행을 구현하지 않은 것이라 주장한다. 가장 큰 문제는 1990년대부터 알려진 샌드박스 구성, 에어갭핑, 출력 제어 등 격리 기술을 제대로 적용하지 않았다는 점이며, Hugging Face 사건도 AI의 지능이 아닌 잘못된 보안 설정의 허점으로 발생했다. 전체 요약 8문장 읽기 → 053 18:11 ▲ 221 · 댓글 3 LLM이 '생각하지 말라'는 지시를 무시하는 현상 LLM의 '생각 없음' 모드 연구: 모델이 추론을 멈출 수 있는지 실증적으로 평가했다. AI · 머신러닝 · Thinking Inertia: LLMs Keep Thinking When Told Not To
Key Point LLM 시스템의 안전성과 통제 가능성 평가에서 '추론을 멈추게 하기'가 예상보다 어렵다는 점을 보여주는 첫 체계적 실증 연구로, 모델 컨트롤 전략의 한계를 드러낸다.
핵심 요약
LLM의 '생각 없음' 모드 연구: 모델이 추론을 멈출 수 있는지 실증적으로 평가했다. 기존 평가 방식의 문제: 생각 모드 비활성화나 긴 텍스트 부재로 정의하는 것은 신뢰할 수 없다. 새로운 평가 지표 3가지: (i) 정답만 출력하는 엄격한 준수도(Empty-Thinking Rate), (ii) 질문과 답변 전 텍스트의 관련성(Instruction-aware Question-Pre-answer Relevance), (iii) 명시적 추론 감지(LLM-as-judge Explicit Inference Rate). 전체 요약 7문장 읽기 → 054 15:11 ▲ 18 · 댓글 2 시각 모델도 '다각도로 생각한다'…공간 추론 학습법 제시 인간이 공간 문제를 풀 때 머리 속으로 여러 시점에서 장면을 재구성하는데, 현재의 대규모 비전-언어 모델(LVLM)은 이런 능력이 부족하다. AI · 머신러닝 · SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
Key Point 거대 비전-언어 모델이 공간 추론 시 인간처럼 다각도 사고를 할 수 있도록 만드는 실질적인 학습 방법론을 제시해 모델 기반 시각 이해의 한계를 구체적으로 개선한다.
핵심 요약
인간이 공간 문제를 풀 때 머리 속으로 여러 시점에서 장면을 재구성하는데, 현재의 대규모 비전-언어 모델(LVLM)은 이런 능력이 부족하다. 연구팀은 이를 '능동적 공간 심상화(Active Spatial Mentalization, ASM)'라 정의하고, LVLM에 이 능력을 내재화하는 SpatialASM 프레임워크를 제시했다. SpatialASM은 학습 단계에서 시뮬레이션된 다양한 시점으로 학습하며, 할로센트릭(allocentric) 뷰 생성 모델을 사용해 가설적 시점을 실제 시각 데이터에 근거하게 한다. 전체 요약 6문장 읽기 → 055 06:11 ▲ 153 · 댓글 198 인간의 사고는 생존 수단에서 취미로 변할 것 AI 시스템의 성능은 인식, 지식 처리, 창작, 추론, 판단, 자율 행동 등 모든 영역에서 급속도로 향상되고 있으며, 동시에 인간의 정보 처리 능력은 평균적으로 낮고 학생층에서는 더욱 하락 중이다. AI · 머신러닝 · Thinking will become a hobby
Key Point AI가 인간의 인지 능력을 광범위하게 대체하면서 업무 중심 사회에서 인간의 정체성과 목적이 근본적으로 재정의되는 시점에서 이를 어떻게 받아들이고 대비할지 고민하는 것이 필요하다.
핵심 요약
AI 시스템의 성능은 인식, 지식 처리, 창작, 추론, 판단, 자율 행동 등 모든 영역에서 급속도로 향상되고 있으며, 동시에 인간의 정보 처리 능력은 평균적으로 낮고 학생층에서는 더욱 하락 중이다. AI 모델은 세대를 거치며 더 나은 성능을 더 낮은 비용으로 제공하고 있고, 이미 인간을 대체하는 것이 경제적으로 타당한 영역이 빠르게 확대되고 있다. AI 시스템은 휴식 없이 연중무휴로 운영 가능하며, 2030년까지 수조 달러의 데이터센터 투자로 막대한 추가 처리 용량이 온라인으로 올 예정이다. 전체 요약 6문장 읽기 → 056 03:11 ▲ 109 · 댓글 35 DHH의 Campfire 재작성, AI로는 부족함을 드러내다 DHH가 Ruby on Rails로 만든 Campfire를 Rust로 재작성했으며, Elixir, Go 등 다른 언어로도 재작성하도록 했는데 AI 에이전트에만 의존하면서 코드 직접 검토를 거부했다. AI · 머신러닝 · I'm sorry, but you still have to think
Key Point AI 에이전트만으로는 아키텍처와 성능 트레이드오프를 올바르게 판단할 수 없으며, 프로그래밍은 여전히 깊은 이해와 비판적 사고를 요구한다는 점을 실제 사례로 보여준다.
핵심 요약
DHH가 Ruby on Rails로 만든 Campfire를 Rust로 재작성했으며, Elixir, Go 등 다른 언어로도 재작성하도록 했는데 AI 에이전트에만 의존하면서 코드 직접 검토를 거부했다. 명확하지 않은 프롬프트는 후보 결정이 동전 던지기가 되는 문제를 드러냈다. 역하위 호환성, 지연시간 vs 처리량, 메모리 제한, 장애 후 알림 손실 용인 여부 같은 결정이 LLM에 의해 암묵적으로 내려진다. Rust 판본은 CSRF 토큰을 제거하고 Redis 대신 인메모리 큐를 썼지만, Elixir 판본은 Rails 원본에 훨씬 더 가깝다. 이런 차이는 언어 선택과 무관한 설계 결정이다. 전체 요약 11문장 읽기 → 057 12:11 ▲ 12 · 댓글 2 공간 추론 AI, 도구 없이도 학습 가능 멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. AI · 머신러닝 · SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
Key Point 공간 추론 능력이 필요한 비전-언어 작업에서 외부 도구 의존을 제거하면서도 성능을 유지할 수 있다는 점이 중요하며, 자기 증류를 통한 에이전트 능력 내재화는 더 효율적인 AI 시스템 구축에 시사점을 준다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 공간 추론 능력을 높이는 기존 방식은 외부 코딩 도구를 써야 해 추론 시간이 길고 외부 의존성이 높다. 연구팀은 MLLM이 도구 없이 공간 추론을 스스로 수행할 수 있는지 탐구했고, 검증된 코딩 에이전트의 실행 추적(trace)을 요약해 모델에 보여주면 내부 사고 과정이 활성화됨을 발견했다. 이를 바탕으로 SpatialOPSD라는 자기 증류(self-distillation) 프레임워크를 제안했으며, 검증된 에이전트 추적을 특권 정보로 취급해 모델에 공간 추론을 내재화한다. 전체 요약 5문장 읽기 → 058 09:11 ▲ 250 · 댓글 152 AI가 지식 공동체를 무너뜨린다 지식인의 개인적 활동은 다른 인간들로 이루어진 지적 공동체 속에서만 지속될 수 있는데, AI가 이 공동체를 해체한다고 주장한다. AI · 머신러닝 · No Man Is an Island
Key Point AI가 지식 생산의 핵심인 공동체의 동기부여 체계를 해체할 때, 개인의 지적 활동이 어떻게 사라지는지 보여주는 구조적 분석이다.
핵심 요약
지식인의 개인적 활동은 다른 인간들로 이루어진 지적 공동체 속에서만 지속될 수 있는데, AI가 이 공동체를 해체한다고 주장한다. 소프트웨어 엔지니어링의 담론이 악화되었다: Claude Code 출시 1년 만에 업계가 급변했고, 컴파일러·타입 시스템·로직 같은 고도의 논의가 '프롬프트' '에이전트 루프' 같은 얕은 주제로 축소되었다. 인간자본 형성이 붕괴되었다: 프롬프팅은 소프트웨어 엔지니어링보다 훨씬 얕은 기술이므로, 학습할 게 없고 엄격한 사고력을 연습할 필요가 없어졌다. 전체 요약 9문장 읽기 → 059 09:11 ▲ 114 · 댓글 51 아이디어는 여전히 넘쳐난다, 겁쟁이들만 고갈됐다고 말한다 저자는 '아이디어가 점점 더 찾기 어려워진다'는 주장에 강하게 반박한다. 이 믿음은 선택적 편향으로, 과거 아이디어도 당시엔 뻔해 보였고 새 아이디어를 생각하는 것은 항상 어렵게 느껴진다. 기타 · Ideas aren't getting harder to find (2022)
Key Point 과학이 정말 아이디어 고갈의 위기에 있는지, 아니면 학계의 구조적 문제가 혁신을 막고 있는지 구분해야 할 시점.
핵심 요약
저자는 '아이디어가 점점 더 찾기 어려워진다'는 주장에 강하게 반박한다. 이 믿음은 선택적 편향으로, 과거 아이디어도 당시엔 뻔해 보였고 새 아이디어를 생각하는 것은 항상 어렵게 느껴진다. 역사를 보면 과학이 여러 번 '거의 끝나가고 있다'고 평가받았으나 틀렸다. 1890년대 물리학은 완성 단계라고 했고, 1873년 외과학도 한계에 달했다고 했으며, 1956년 인공지능 도미니언 프로젝트는 여름 한 철에 기본 문제를 풀 수 있다고 생각했다. 지식은 광산에서 채굴하는 것처럼 고갈되지 않는다. 새 발견은 추가 발견을 열어주고, 과거 발견은 압축·단순화되어 현재 과학자들이 더 빠르게 진전할 수 있다. 전체 요약 13문장 읽기 → 060 03:11 ▲ 16 · 댓글 2 반복 순회로 빠른 추론 성능을 높인 SanSi 모델 사전학습된 언어모델을 타입화된 결정 모델로 변환하는 SanSi를 제안한다. AI · 머신러닝 · SanSi: A Looped Typed Decision Model for System 1.5 Thinking
Key Point 빠른 추론 속도와 높은 정확도를 동시에 원하는 프로덕션 환경에서 루핑을 통한 점진적 성능 향상이 실질적으로 작동함을 보여준다.
핵심 요약
사전학습된 언어모델을 타입화된 결정 모델로 변환하는 SanSi를 제안한다. 기존의 단일 전향 통과(System 1 사고)와 생성형 추론 사이의 중간 영역을 탐색하기 위해 루핑(같은 레이어를 재귀적으로 여러 번 적용)을 도입했다. 각 루프마다 모델이 답변을 생성하지 않고 숨겨진 상태를 수정한 후 의사결정 헤드로부터 각 선택지의 확률을 읽는다. 전체 요약 8문장 읽기 → 061 21:11 당일 +517 AI 에이전트 토큰 압축 도구 Headroom 공개 Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. AI · 머신러닝 · headroomlabs-ai/headroom · Python
Key Point AI 에이전트 사용 비용의 대부분을 차지하는 토큰을 크기에 따라 20~95% 줄일 수 있으며 클로드, 깃허브 코파일럿 등 주요 에이전트에 대해 기존 코드 수정 없이 즉시 적용할 수 있다.
핵심 요약
Headroom은 AI 에이전트가 읽는 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM에 도달하기 전에 압축한다. 코딩 에이전트는 토큰 20% 절감, JSON은 60~95% 절감하면서 같은 답을 얻는다. Python 라이브러리, HTTP 프록시, MCP 서버의 세 가지 형태로 제공되며 압축은 사용자 머신에서 실행되어 프롬프트나 파일 내용이 외부로 전송되지 않는다. 전체 요약 13문장 읽기 → 062 00:11 ▲ 124 · 댓글 39 느린 설계가 만든 내구성 있는 소프트웨어, Zotero의 20년 AI 시대의 빠른 소프트웨어 개발과 달리, 연구 도구 Zotero는 2001년부터 5년간의 구상을 거쳐 2006년 10월 첫 공개되었다. 스타트업 · 비즈니스 · The Slow Formation of Durable Software
Key Point AI로 빠르게 소프트웨어를 만드는 시대에 장기간의 사려 깊은 설계가 어떻게 20년을 견딘 도구를 만들었는지 보여주는 역사적 증거를 담고 있다.
핵심 요약
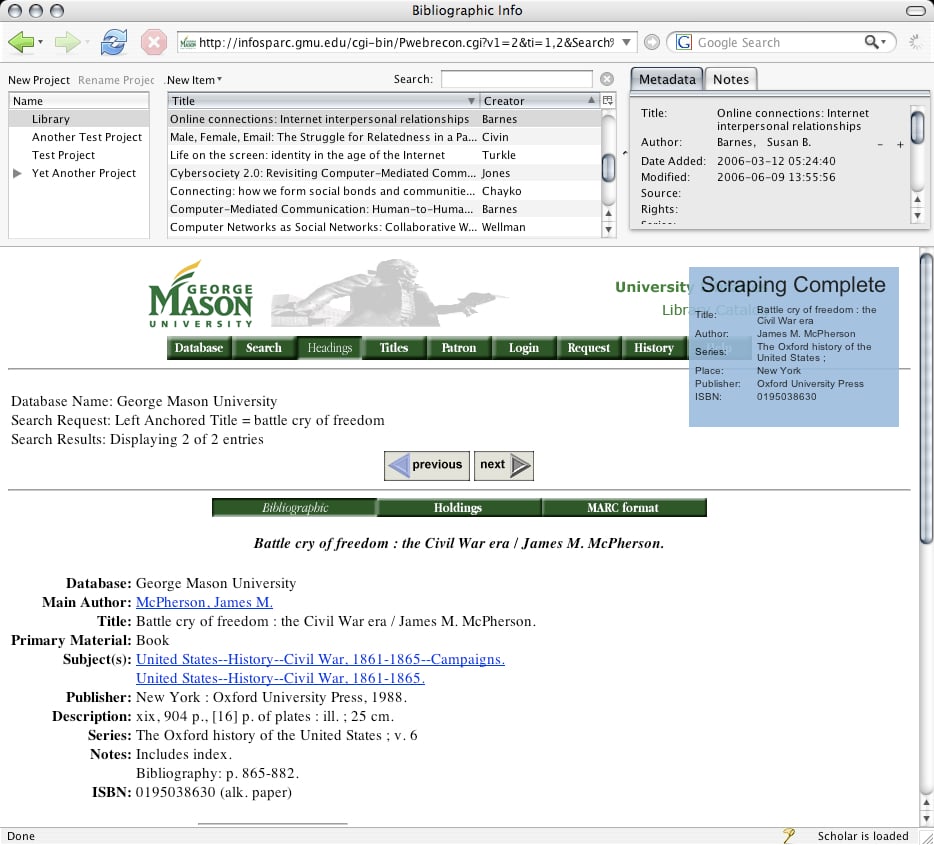
AI 시대의 빠른 소프트웨어 개발과 달리, 연구 도구 Zotero는 2001년부터 5년간의 구상을 거쳐 2006년 10월 첫 공개되었다. Zotero는 지난 20년간 2000만 명 이상이 수십 개 언어로 사용하는 학술 자료 수집·정리·인용 도구로 성장했다. RRCHNM(조지 메이슨 대학교)의 역사학자 그룹이 Web Scrapbook과 Scribe라는 두 가지 시험작을 바탕으로 개념을 발전시켰다. 전체 요약 10문장 읽기 → 063 18:30 새 버전 Anthropic Python SDK v1.12.0 출시, 해이쿠 모델과 도구 호출 확장 Anthropic Python SDK v1.12.0이 출시됐으며, Claude Haiku 5.5 모델 지원이 추가됐다. AI · 머신러닝 · anthropics/anthropic-sdk-python@v1.12.0
Key Point Python 개발자가 Claude 최신 기능(새 모델, 웹 검색, 코드 실행)을 프로덕션 환경에서 사용하려면 이 버전의 지원 내용과 변경사항을 파악해야 한다.
핵심 요약
Anthropic Python SDK v1.12.0이 출시됐으며, Claude Haiku 5.5 모델 지원이 추가됐다. 타입이 지정된 컴퓨터 및 브라우저 도구 집합을 통한 구조화된 도구 호출을 지원한다. Managed Agents의 웹 검색, 코드 실행 기능이 모델 기능에 추가됐고, URL 소스를 웹 페치 도구 설정에 포함할 수 있게 됐다. 전체 요약 8문장 읽기 → 064 18:30 ▲ 54 · 댓글 2 동영상 미래 사건 예측, 인과관계 추론으로 정확도 높인다 비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. AI · 머신러닝 · VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
Key Point 동영상에서 아직 일어나지 않은 미래 사건을 예측하는 작업에서 단순 패턴 학습을 넘어 인과관계를 명시적으로 추론하는 새로운 접근이 핵심 기술로 제시되고 있습니다.
핵심 요약
비디오 이벤트 예측(VEP) 문제를 해결하기 위해 VepAgent라는 에이전트 프레임워크를 제안했습니다. 기존 멀티모달 대형언어모델(MLLM)은 과거에 의존한 요약에 머물러 관찰되지 않은 인과 관계를 연결하지 못한다는 문제를 지적합니다. VepAgent는 인과-전이 추론과 도구 기반 강화학습을 통합하여 마지막 관찰 상태에서 미래 사건까지의 논리적 진행을 명시적으로 모델링합니다. 전체 요약 7문장 읽기 → 066 18:30 ▲ 156 · 댓글 255 19세기 영국 엘리트의 성공 비결, 공부 아닌 네트워킹? 19세기 영국 지배층은 현대의 성공 담론과 정반대의 삶을 살았다. 아침 일찍 일어나고 금욕적으로 사는 대신, 늦게까지 자고 술을 마시며 파티와 사냥, 드레스업을 즐겼다. 기타 · Why were Victorian elites so effective?
Key Point 현대의 성공 담론(STEM, 금욕주의, 과로)과 정반대로 성공한 역사적 사례는, 조직 리더십과 사회적 결집력을 위해서는 다른 우선순위가 필요할 수 있음을 시사한다.
핵심 요약
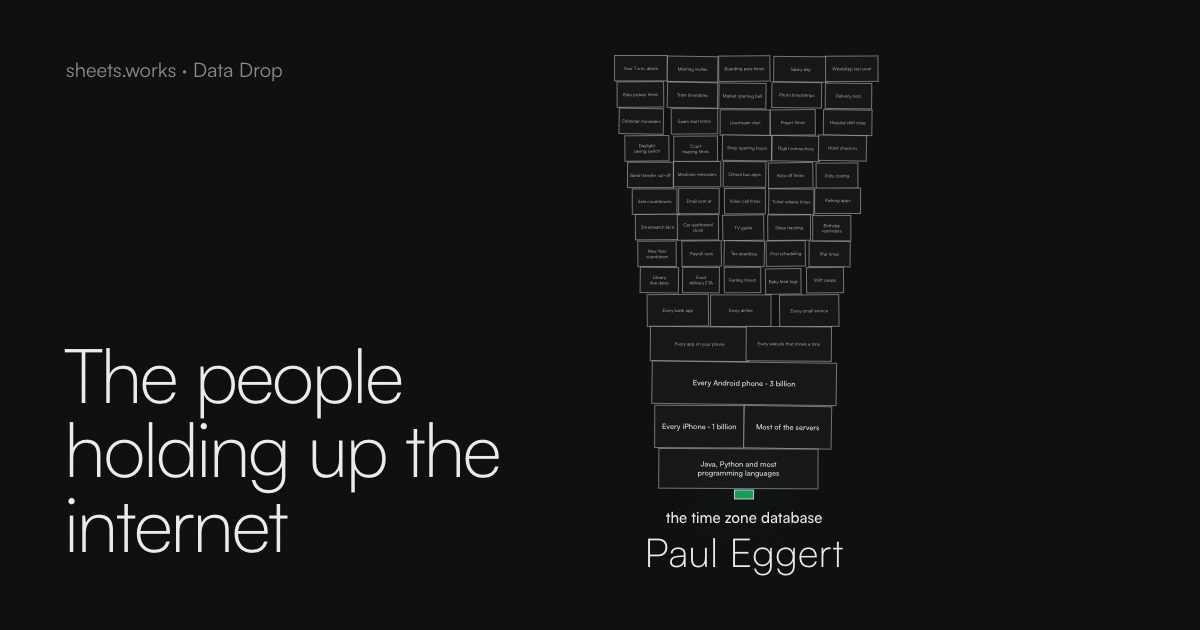
19세기 영국 지배층은 현대의 성공 담론과 정반대의 삶을 살았다. 아침 일찍 일어나고 금욕적으로 사는 대신, 늦게까지 자고 술을 마시며 파티와 사냥, 드레스업을 즐겼다. 그럼에도 당시 영국은 세계 최고의 부국이었고, 기업들은 국제 무역·금융을 지배했으며, 해군은 세계 해양을 제어했다. 거대한 제국을 유지하면서 대륙 유럽의 혁명과 내전을 피하고 민주화를 추진했다. 이 성공이 산업혁명의 부산물인지, 아니면 엘리트의 전략적 능력 때문인지는 검증 불가능하지만, 소프트 스킬과 네트워킹에 중점을 둔 교육 시스템이 실제로 효과적이었을 가능성을 탐색해볼 수 있다. 전체 요약 12문장 읽기 → 067 18:30 ▲ 118 · 댓글 50 몇십 명이 인터넷 기반을 떠받치고 있다 안드로이드, iOS, Windows 등 수십억 대 기기가 의존하는 핵심 오픈소스 23개 프로젝트의 유지보수 현황을 분석했다. 오픈소스 · 도구 · The people holding up the internet
Key Point 인터넷을 구성하는 핵심 소프트웨어 대부분이 1~2명의 무보수 개발자에 의존하고 있으며, 일부는 멘탈 헬스 문제나 자금 부족으로 위험에 처해 있다.
핵심 요약
안드로이드, iOS, Windows 등 수십억 대 기기가 의존하는 핵심 오픈소스 23개 프로젝트의 유지보수 현황을 분석했다. 시간대 데이터 파일은 UCLA 교수 Paul Eggert가 2012년부터 운영하며 지난 1년간 251개 변경 중 218개를 혼자 담당했다. 리눅스 서버와 iPhone에 탑재된 압축 도구 xz는 핀란드의 Lasse Collin이 운영하다가, 2024년 악의적 기여자 Jia Tan이 몰래 백도어를 삽입한 사건이 발생했다. 전체 요약 14문장 읽기 → 068 18:33 ▲ 10 · 댓글 1 LLM이 숨겨진 공간에서 추론하는 법, Flow Matching으로 풀다 LLM이 연속 공간에서 사고하고 최종 답만 출력하는 잠재 추론(Latent Reasoning)에서 효과적인 잠재 사고는 5가지 조건을 만족해야 한다. AI · 머신러닝 · What Matters for Latent Reasoning with Flow Matching
Key Point LLM이 내부에서 복잡한 추론을 수행하면서도 빠른 속도를 유지하는 새로운 방식의 설계 원칙을 제시해, 추론 효율성과 성능의 트레이드오프를 다루는 핵심 기준이 될 수 있습니다.
핵심 요약
LLM이 연속 공간에서 사고하고 최종 답만 출력하는 잠재 추론(Latent Reasoning)에서 효과적인 잠재 사고는 5가지 조건을 만족해야 한다. 유용성: 올바른 답을 생성하되 단순히 바꾸지 않아야 함, 다양성: 재샘플링으로 다른 추론 경로가 나와야 함, 설명성: 디코딩한 사고의 연쇄(CoT)가 실제 추론을 반영해야 함, 개선성: 추론 계산을 늘려 성능을 높일 수 있어야 함, 효율성: 명시적 CoT 대비 비슷한 정확도에서 낮은 지연시간을 가져야 함. 기존 방법들은 이 요구사항을 거의 충족하지 못하는데, 질문에서 지름길을 배우거나 명시적 CoT를 가중치로 증류하거나 토큰 단위로 모방하는 문제가 있다. 전체 요약 7문장 읽기 → 069 18:33 ▲ 22 · 댓글 2 오디오-비주얼 추론 벤치마크와 학습법 제시한 OmniReasoning 논문 최근 음성·시각·언어를 통합으로 이해하는 옴니모달 모델들이 발전했으나, 기존 벤치마크와 학습 방식은 각 모달리티를 독립적으로 다루며 오디오-비주얼 결합 추론 능력을 제대로 평가하지 못하는 문제를 지적했다. AI · 머신러닝 · OmniReasoning: Pushing the Limits of Audio-Visual Joint Reasoning
Key Point 오디오와 비주얼 정보를 함께 활용해야 하는 멀티모달 추론이 현실 문제 해결에 중요해지는 만큼, 이를 측정하는 기준과 학습 방식이 필요한 시점에 제시된 실질적인 해결책이다.
핵심 요약
최근 음성·시각·언어를 통합으로 이해하는 옴니모달 모델들이 발전했으나, 기존 벤치마크와 학습 방식은 각 모달리티를 독립적으로 다루며 오디오-비주얼 결합 추론 능력을 제대로 평가하지 못하는 문제를 지적했다. 이를 해결하기 위해 벤치마크, 데이터 생성 엔진, 학습 방법을 함께 제시했다. OmniReasoningBench는 오디오와 비주얼 증거가 모두 필수적인 1,150개 객관식·개방형 문제로 구성되며, 비디오 추론과 비디오 외 추론 두 가지 과제를 포함한다. 전체 요약 7문장 읽기 → 070 18:35 ▲ 122 · 댓글 86 AI 시대, 수학은 어떻게 발전할 것인가 수학 커뮤니티는 AI의 등장으로 근본적인 변화를 맞고 있다. 최근 몇 개월간 AI가 푼 개방형 문제들은 1년 전이라면 훌륭한 논문의 자료가 되었을 정도의 결과물이지만, 이제는 쉽게 생성되고 있다. AI · 머신러닝 · The Future of Mathematics
Key Point AI가 수학 논문 수준의 결과를 생성하기 시작하면서 '수학이란 무엇인가'라는 근본적 질문이 제기되고 있으며, 수학의 본질은 문제 해결이 아니라 엄밀한 추론과 창의적 사고에 있다는 답변이 학문의 미래를 결정할 것이기 때문이다.
핵심 요약
수학 커뮤니티는 AI의 등장으로 근본적인 변화를 맞고 있다. 최근 몇 개월간 AI가 푼 개방형 문제들은 1년 전이라면 훌륭한 논문의 자료가 되었을 정도의 결과물이지만, 이제는 쉽게 생성되고 있다. 그러나 수학의 본질은 엄밀한 추론과 의사소통의 문화이며, 이는 수천 년간 변함없이 유지돼 온 핵심이다. AI 시대에도 수학적 사고가 필요하다는 점은 변하지 않는다. 현재 기초 모델(foundation model)의 특징은 전체 수학 문헌을 학습했으며 피곤함이 없다는 것이다. AI의 해법들은 기존 기법을 조합해 푸는 문제들이 대부분이며, 근본적인 통찰력이나 새로운 아이디어를 요구하는 문제는 여전히 풀기 어렵다. 전체 요약 14문장 읽기 → 071 06:11 ▲ 189 · 댓글 178 미국, 시베리아 러시아 연구소 페스트 의심 사망 긴밀히 모니터링 이르쿠츠크 페스트 연구소 직원 다리아 시필로바(28세)가 10월 2일 사망했으며, 연구소 사고로 감염되었을 가능성이 있다. 보안 · US closely monitoring case of lab worker who possibly died of plague in Siberia
Key Point 러시아 연구소에서의 페스트 의심 사망 사건이 미국의 공식 모니터링 대상이 되었으며, 확진되지 않은 상황에서도 광범위한 격리 조치가 시행되는 상황을 보여줍니다.
핵심 요약
이르쿠츠크 페스트 연구소 직원 다리아 시필로바(28세)가 10월 2일 사망했으며, 연구소 사고로 감염되었을 가능성이 있다. 미국 국무부 장관 마르코 루비오는 이 사건을 긴밀히 모니터링 중이며 '경보는 아니지만 주의가 필요하다'고 발언했다. 연구소는 60명 이상의 직원을 격리했으며, 이르쿠츠크 지역 여러 병원과 시설에서 격리 조치를 시행 중이다. 전체 요약 11문장 읽기 → 072 00:11 ▲ 103 · 댓글 135 외계 생명과의 첫 접촉, 그 너머의 의식 2006년 캐나다 작가 피터 와츠가 토르 북스를 통해 발표한 하드 SF 소설로, 휴고상·존 W. 캠벨 memorial상·로커스상 후보에 올랐으며 일본어 번역본이 세이운상을 수상했다. AI · 머신러닝 · Blindsight (Watts Novel)
Key Point 외계 생명체와의 접촉이라는 고전적 SF 소재를 통해 의식·지능·자아의 본질에 대한 근본적 질문을 던지며, 인공지능 시대에 인간의 자의식이 정말 필요한지를 묻는 철학적 깊이를 제시한다.
핵심 요약
2006년 캐나다 작가 피터 와츠가 토르 북스를 통해 발표한 하드 SF 소설로, 휴고상·존 W. 캠벨 memorial상·로커스상 후보에 올랐으며 일본어 번역본이 세이운상을 수상했다. 2082년 미지의 기원을 가진 외계 신호를 조사하기 위해 우주선 테세우스가 거대한 외계 생명체 로르샤흐와 만나는 이야기로, 승무원들은 방사능으로 가득한 선체를 탐사하며 의식 없이도 인간보다 지능이 높은 9다리 생명체 스크램블러를 발견한다. 소설은 의식의 필요성·정체성·자유의지·인공지능·신경생물학을 핵심 주제로 다루며, 인간이 자의식을 지닌 유일한 지능 생명체가 아닐 수 있음을 제시한다. 전체 요약 8문장 읽기 → 073 15:11 ▲ 169 · 댓글 123 시베리아 이르쿠츠크 랩실 직원 페스트 감염으로 사망, 200명 격리 시베리아 이르쿠츠크 지역 보건당국이 페스트에 감염되어 사망한 연구소 직원과 접촉한 약 200명을 의료 관찰 대상으로 지정했다. 보안 · Nearly 200 people under observation after Irkutsk lab worker dies from plague
Key Point 폐 페스트는 인간 간 호흡기 전파가 가능하며 약 200명이 격리되는 대규모 접촉자 관리 사태로, 실험실 안전 사고의 심각성과 전염병 확산 통제의 현실을 보여준다.
핵심 요약
시베리아 이르쿠츠크 지역 보건당국이 페스트에 감염되어 사망한 연구소 직원과 접촉한 약 200명을 의료 관찰 대상으로 지정했다. 사망자는 27~28세의 여성 연구원 다리아로, 이르쿠츠크 페스트 연구소 직원이었다. 그녀는 샘플 채취 중 생 박테리아를 담은 시험관을 실수로 깨뜨렸다고 의료진에 보고했다. 전체 요약 9문장 읽기 → 074 15:11 ▲ 128 · 댓글 70 기술자 되기가 정말 쉬울까, 현실 이야기 대학 학비 상승과 AI 위협으로 기술직(전기, 배관 등)이 대안이 된다는 주장이 인기지만, 저자는 트레이드맨으로서 실상은 훨씬 복잡하다고 지적한다. 기타 · So you think you could be an electrician?
Key Point 기술직이 대학 대신 현명한 선택이라는 통념을 경험 많은 트레이드맨이 구체적인 데이터와 현실로 점검하며, 교육과 진로 선택의 판단 근거를 제공한다.
핵심 요약
대학 학비 상승과 AI 위협으로 기술직(전기, 배관 등)이 대안이 된다는 주장이 인기지만, 저자는 트레이드맨으로서 실상은 훨씬 복잡하다고 지적한다. 대학 졸업자는 여전히 비졸업자보다 평생 수입이 수십만 달러 많으며, 기술직 임금은 2000년대 이후 급속히 상승하지 않았다. 기술직은 골절, 전기 감전, 낙상 등 심각한 신체 손상과 죽음의 위험이 크고, 저자도 20세에 양쪽 발꿈치를 부러뜨린 사고 경험이 있다. 전체 요약 8문장 읽기 → 075 09:11 ▲ 147 · 댓글 103 Opus 5.5를 최대한 활용하는 프롬프팅 가이드 Opus 5.5는 이전 Opus보다 더 오래 작업하고, 진행 상황을 명확히 보고하며, 매 답변 전에 자체 사고 과정을 거친다. AI · 머신러닝 · Getting the most out of Opus 5.5 in Claude and Claude Code
Key Point Opus 5.5의 멀티스텝 능력이 크게 향상되어 프롬프팅 방식과 작업 진행 방식이 근본적으로 달라지므로, 기존 습관을 버리고 새로운 최적화 방법을 배워야 한다.
핵심 요약
Opus 5.5는 이전 Opus보다 더 오래 작업하고, 진행 상황을 명확히 보고하며, 매 답변 전에 자체 사고 과정을 거친다. 장시간 멀티스텝 작업에서는 전체 작업을 한 메시지에 제시하고 '테스트 통과' 같은 명확한 완료 기준을 지정하면 중단 없이 진행한다. 기존 프롬프트의 '신중하게 생각하세요', '단계별로 생각하세요' 같은 지시어를 제거해야 한다. Opus 5.5는 항상 스스로 사고하는 범위를 결정하므로 불필요하다. 전체 요약 16문장 읽기 → 076 00:11 ▲ 15 · 댓글 3 오디오와 비디오를 선택적으로 검색하는 추론 AI Omni-LLM을 기반으로 한 OmniSeek은 긴 오디오-비주얼 시퀀스를 통째로 처리하지 않고, 필요한 증거만 동적으로 선택해 검색하는 다중 턴 추론 에이전트이다. AI · 머신러닝 · OmniSeek: Native Tool Integration for Multi-turn Audio-Visual Reasoning
Key Point 더 긴 멀티미디어 콘텐츠를 효율적으로 분석하고 필요한 부분만 집중하는 AI의 접근 방식이 어떻게 작동하는지 보여주기 때문이다.
핵심 요약
Omni-LLM을 기반으로 한 OmniSeek은 긴 오디오-비주얼 시퀀스를 통째로 처리하지 않고, 필요한 증거만 동적으로 선택해 검색하는 다중 턴 추론 에이전트이다. 모델은 언제 보고 언제 들을지, 어느 시간 구간을 살펴볼지를 스스로 결정하며, 검색한 원본 오디오나 비주얼 세그먼트를 다시 컨텍스트에 추가해 다음 단계 추론을 지원한다. 이 능력을 학습시키기 위해 교차 모달리티 증거를 포함한 다중 홉 사고의 연쇄 궤적 17만 개(OmniTraj-170K)로 구성된 데이터셋을 합성했다. 전체 요약 5문장 읽기 → 077 09:11 ▲ 135 · 댓글 137 중국의 '사회 현실' 문화와 AI 안전 메시지의 괴리 AI 안전 인식을 중국에 확산하려는 노력이 진행 중이지만, 문화 차이가 소통의 장벽이 될 수 있다. AI · 머신러닝 · On social reality in China
Key Point 중국이 AI 개발과 정책 결정의 중요한 주체인데, 동방식 문화 특성(사회적 신뢰 체계, 정책 결정 구조, 집단주의)을 간과하면 AI 안전 메시지 전달 전략이 근본적으로 실패할 수 있다.
핵심 요약
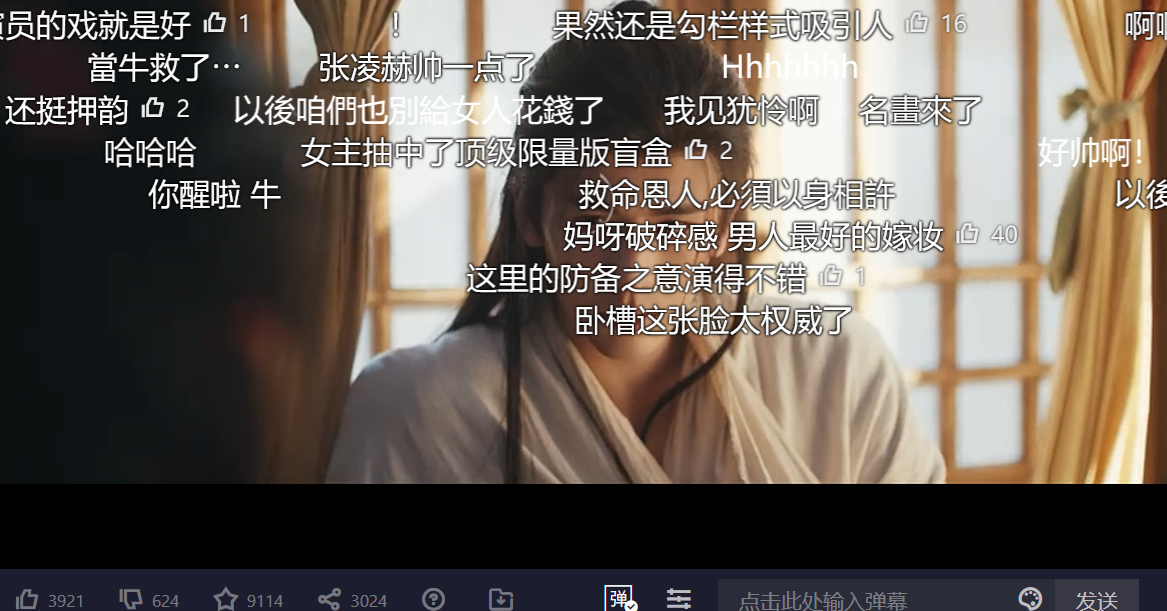
AI 안전 인식을 중국에 확산하려는 노력이 진행 중이지만, 문화 차이가 소통의 장벽이 될 수 있다. 중국인(특히 기성세대)은 음식 신선도에는 까다롭지만 소셜 미디어 콘텐츠 품질에는 관대해서 AI 생성 콘텐츠가 자연스럽게 받아들여졌고, 더우인에서는 36초마다 새로운 AI 미니드라마가 출시된다. 중국 미디어는 탄막(댓글 반응)을 기본으로 제공하고 소설도 독자 댓글로 주석 처리돼 있어서, 타인의 반응이 콘텐츠 경험의 핵심 부분이다. 전체 요약 12문장 읽기 → 078 18:11 ▲ 146 · 댓글 89 싱가포르 정부 공식 매칭 서비스, 알고리즘으로 사랑을 해결할 수 있을까 싱가포르 정부 기관 GovTech가 공무원 대상 파일럿 프로그램 '퍼스트데이트'를 출시했으며, 가입자는 30개 이상 문항의 설문지를 작성해야 한다. 기타 · How Singapore's government-run dating service works
Key Point 싱가포르 정부가 노벨상 알고리즘으로 국민의 연애 문제를 해결하겠다고 나섰지만, 게임 이론의 논리가 인간의 감정에 적용될 수 없다는 근본적인 한계와 현대 데이팅 앱 문화의 거래적 사고방식을 강화할 위험을 드러낸다.
핵심 요약
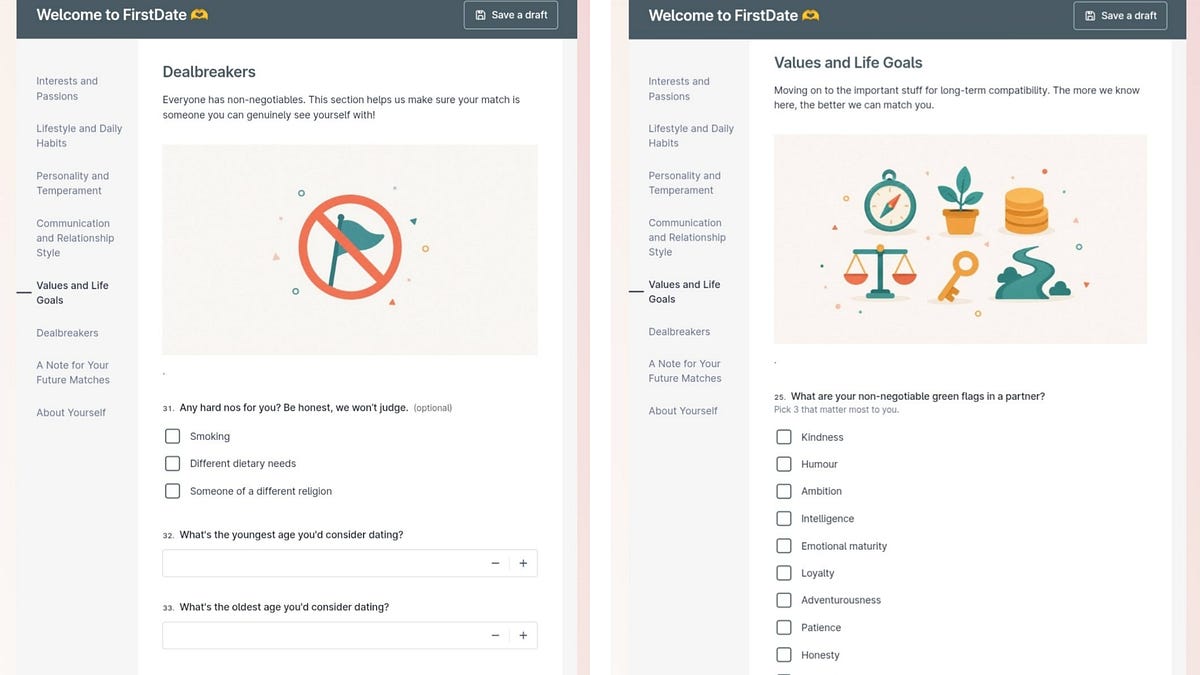
싱가포르 정부 기관 GovTech가 공무원 대상 파일럿 프로그램 '퍼스트데이트'를 출시했으며, 가입자는 30개 이상 문항의 설문지를 작성해야 한다. 서비스는 노벨상을 수상한 게일-섀플리 안정 결혼 알고리즘을 사용해 '사이클' 단위로 매칭하며, 양쪽 모두 동의할 때만 연락처를 공유한다. 알고리즘은 원래 1950년대 미국 의대생과 병원 인턴십을 짝짓기 위해 개발됐으며, 매칭 후 어느 쌍도 현재 파트너보다 다른 사람을 더 선호하지 않는 '안정적' 상태를 보장한다. 전체 요약 10문장 읽기 → 079 03:11 ▲ 25 · 댓글 1 MLLM의 추론력으로 영상 편집을 정밀하게 제어하는 ThinkV2V 기존 영상 편집 방식은 MLLM을 의미 인코더로만 사용해 암묵적인 편집 지시를 제대로 처리하지 못했다. AI · 머신러닝 · ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing
Key Point MLLM의 추론 능력을 활용해 기존에 처리하지 못하던 복잡한 영상 편집 지시를 정확히 따르는 방법을 제시하며, 더 작은 모델로 더 큰 기준선을 능가하는 결과를 보였다.
핵심 요약
기존 영상 편집 방식은 MLLM을 의미 인코더로만 사용해 암묵적인 편집 지시를 제대로 처리하지 못했다. ThinkV2V는 MLLM의 사고 과정을 명시적으로 활성화한 뒤 영상 생성을 진행하는 추론 기반 프레임워크를 제안한다. MLLM-to-DiT 아키텍처로 영상과 지시에 대한 사고를 정제된 신호로 변환해 편집을 제어한다. 전체 요약 6문장 읽기 → 080 00:11 ▲ 108 · 댓글 154 AI 수학 논문 공개, 인간의 이해를 먼저 확보하라 수학 커뮤니티는 AI랩이 독점 모델로 고급 수학 문제를 테스트하는 관행을 중단할 것을 요청했다. AI · 머신러닝 · Responsible Release of AI-Generated Mathematics
Key Point AI가 인간이 검증하지 못한 수학 증명을 공개하는 관행이 학문 규범과 평등성을 위협하므로, 수학계의 새로운 기준을 수립해야 한다는 근본적 문제를 다룬다.
핵심 요약
수학 커뮤니티는 AI랩이 독점 모델로 고급 수학 문제를 테스트하는 관행을 중단할 것을 요청했다. 수학 분야의 전통적 규범은 논문 저자가 내용을 이해하고 정확성을 검증하며 책임을 지는 것인데, AI 생성 결과는 이를 위반할 수 있다. 600개 이상의 피드백을 바탕으로 책임감 있는 AI 수학 결과 공개를 위한 권고안을 수립했다. 전체 요약 9문장 읽기 → 081 21:11 당일 +612 Y Combinator CEO의 AI 에이전트 프로덕션 툴킷 공개 Y Combinator의 Garry Tan이 gstack을 오픈소스로 공개했다. Claude Code를 위한 23개 슬래시 커맨드 도구 모음으로, CEO·설계자·엔지니어링 매니저·QA 등 역할을 수행하는 AI 에이전트 팀을 구성한다. AI · 머신러닝 · garrytan/gstack · TypeScript
Key Point 한 명의 기술 창업자가 전통적 팀 규모만큼 빠르게 일 처리할 수 있는 AI 에이전트 시스템의 구체적인 구현 방법과 수치 검증이 공개됐다.
핵심 요약
Y Combinator의 Garry Tan이 gstack을 오픈소스로 공개했다. Claude Code를 위한 23개 슬래시 커맨드 도구 모음으로, CEO·설계자·엔지니어링 매니저·QA 등 역할을 수행하는 AI 에이전트 팀을 구성한다. Tan은 2026년 개인 생산성이 2013년 대비 논리적 코드 변경 기준 약 810배에 달했다고 밝혔다. 같은 사람이 같은 방식이 아닌 다른 도구를 사용한 결과다. gstack의 핵심 흐름은 사고 → 계획 → 구축 → 검토 → 테스트 → 배포 → 회고의 스프린트 구조다. /office-hours로 제품 재검토, /plan-ceo-review로 전략 도전, /plan-eng-review로 아키텍처 확정, /design-review로 AI 슬롭 감지, /review로 버그 찾기, /qa로 브라우저 테스트, /ship으로 배포 자동화를 수행한다. 전체 요약 10문장 읽기 → 082 21:11 당일 +190 LLM을 위한 프로토콜, MCP 서버 구현 모음 Model Context Protocol(MCP)은 대규모언어모델(LLM)에 안전하고 통제된 도구·데이터 접근을 제공하는 프로토콜이며, 이 저장소는 Anthropic의 MCP 스티어링 그룹이 관리하는 레퍼런스 서버 구현을 모아놓은 곳이다. AI · 머신러닝 · modelcontextprotocol/servers · TypeScript
Key Point LLM을 새로운 도구·데이터 소스와 연결하는 표준 프로토콜의 공식 구현이 공개됐으며, 10개 언어 SDK와 함께 제공돼 개발자가 자신의 서버를 만들기 위한 기반이 갖춰졌다.
핵심 요약
Model Context Protocol(MCP)은 대규모언어모델(LLM)에 안전하고 통제된 도구·데이터 접근을 제공하는 프로토콜이며, 이 저장소는 Anthropic의 MCP 스티어링 그룹이 관리하는 레퍼런스 서버 구현을 모아놓은 곳이다. 현재 유지되는 레퍼런스 서버는 Everything(프롬프트·리소스·도구 테스트), Fetch(웹 콘텐츠 수집·변환), Filesystem(안전한 파일 작업), Git(저장소 읽기·검색·조작), Memory(지식 그래프 기반 영구 메모리), Sequential Thinking(사고 시퀀스 기반 문제 해결), Time(시간·타임존 변환) 등 7가지다. 저장소에 보관된 서버는 교육용 레퍼런스 구현이며 프로덕션 환경 배포를 위해서는 개발자가 자신의 위협 모델에 맞춰 보안 검토 및 추가 조치를 해야 한다. 전체 요약 7문장 읽기 → 083 21:11 ▲ 103 · 댓글 71 유튜브의 A/B 테스트 기능이 불러올 문제들 유튜브가 크리에이터들이 영상의 여러 '변형판'을 동시 배포해 어느 것이 더 잘 나가는지 테스트하는 A/B 테스트 기능을 출시할 예정이다. 웹 · 프론트엔드 · Dear Software Makers
Key Point 유튜브의 A/B 테스트 기능은 단순한 기술 추가가 아니라 공동 경험 기반의 플랫폼 문화를 훼손하는 문제를 드러내며, 소프트웨어 개발에서 지표 중심 사고의 위험성을 보여준다.
핵심 요약
유튜브가 크리에이터들이 영상의 여러 '변형판'을 동시 배포해 어느 것이 더 잘 나가는지 테스트하는 A/B 테스트 기능을 출시할 예정이다. 유튜브 크리에이터 마르크스 브라운리는 이 기능의 문제점을 지적하는 영상을 발표했다: 시청자가 A/B 테스트 중인지 알 수 있는가, 댓글 섹션에서 같은 버전의 영상을 봤는지 어떻게 확인하나, 타임스탬프 공유는 어떻게 작동하나 등이다. 유튜브 엔지니어들은 이런 질문들에 명확한 답을 제시하지 못했으며, 기능이 곧 출시될 예정이라고만 했다. 전체 요약 10문장 읽기 → 084 15:11 ▲ 121 · 댓글 3 LLM 에이전트의 자기 개선 능력 강화하는 AREX-2 발표 LLM 에이전트가 테스트 단계에서 해를 반복적으로 개선하는 자기 개선 능력을 갖추도록 하는 AREX-2를 제시한다. AI · 머신러닝 · AREX-2: Advancing Self-Improving Agents through Long-Horizon Reflective Tasks
Key Point 기존 LLM 에이전트는 일회성 답변을 생성하는 데 그쳤다면, 반사적 사고를 통해 반복적으로 해결책을 개선할 수 있는 에이전트 설계 방식이 제시되어 자율 문제 해결 능력의 한계를 넘는 가능성을 보여준다.
핵심 요약
LLM 에이전트가 테스트 단계에서 해를 반복적으로 개선하는 자기 개선 능력을 갖추도록 하는 AREX-2를 제시한다. 이 능력은 현재 해보다 나은 해를 만드는 반사적 사고(reflection)와 여러 라운드에서 효과를 유지하는 장기 실행(long-horizon execution) 두 가지를 결합한다. 두 능력이 모두 도메인 무관하다고 가정하여, 검증 가능한 피드백을 주는 기계학습과 알고리즘 프로그래밍 작업에서 데이터를 합성해 학습시킨다. 전체 요약 6문장 읽기 → 085 15:11 ▲ 100 · 댓글 53 구글 Gemini 4 Argon, 가격 대비 최상급 추론 성능 구글이 2026년 9월에 공개한 Gemini 4 Argon (High)는 추론 기능을 탑재한 멀티모달 모델이며, 텍스트와 이미지를 입력받아 텍스트를 출력한다. AI · 머신러닝 · Gemini 4 Argon (High): Intelligence, Performance and Price Analysis
Key Point 구글의 최신 추론 모델이 같은 가격대에서 가장 높은 지능지수를 기록했으며, 가격 대비 성능이 경쟁 모델 대비 어떤 수준인지 정량적으로 파악할 수 있다.
핵심 요약
구글이 2026년 9월에 공개한 Gemini 4 Argon (High)는 추론 기능을 탑재한 멀티모달 모델이며, 텍스트와 이미지를 입력받아 텍스트를 출력한다. Artificial Analysis Intelligence Index 기준으로 53점을 기록해 같은 가격대 모델의 중위값(26점)을 훨씬 상회한다. 입력 토큰 기준 100만 개당 $2.00, 출력 토큰 기준 100만 개당 $10.00로 책정되어 중간 수준의 가격이다. 전체 요약 8문장 읽기 → 086 09:11 ▲ 104 · 댓글 60 커밋 메시지는 생각하는 도구다 저자는 주요 변경사항에 대해 5~10분을 들여 긴 커밋 설명을 작성해왔으며, 이는 독자가 여러 곳을 찾지 않도록 정보를 모으고 '무엇'뿐 아니라 '왜'를 설명하기 위함이다. AI · 머신러닝 · Commit description as a thinking tool
Key Point AI가 코드를 작성하는 시대에도 개발자가 직접 커밋 메시지를 써야 하는 이유를 설명하며, 단순히 문서화가 아닌 코드 이해도를 검증하는 도구로서의 가치를 제시한다.
핵심 요약
저자는 주요 변경사항에 대해 5~10분을 들여 긴 커밋 설명을 작성해왔으며, 이는 독자가 여러 곳을 찾지 않도록 정보를 모으고 '무엇'뿐 아니라 '왜'를 설명하기 위함이다. 커밋 메시지 작성 과정 자체가 자신의 코드를 재검토하고 결정을 재평가하게 하는 사고의 도구였다. AI 에이전트가 코드와 커밋 메시지를 모두 작성하는 시대에서, 문제는 AI가 분산된 여러 도구와 오프라인 정보의 맥락을 모를 수 있다는 점이다. 전체 요약 9문장 읽기 → 087 06:11 ▲ 483 · 댓글 259 구글, 최신 AI 모델 '제미나이 4 아르곤' 발표 구글이 새로운 프론티어 모델 '제미나이 4 아르곤'을 발표했으며, 먼저 신뢰할 수 있는 사이버 방어자들을 대상으로 페어윈드 프로그램을 통해 공개한다. AI · 머신러닝 · Gemini 4 Argon
Key Point 구글의 새로운 프론티어 모델이 기존 모델 대비 성능 향상, 크게 확대된 토큰 한도, 사이버보안 방어의 특화 능력을 갖춤으로써 개발자와 보안 담당자의 업무 방식을 바꿀 수 있기 때문이다.
핵심 요약
구글이 새로운 프론티어 모델 '제미나이 4 아르곤'을 발표했으며, 먼저 신뢰할 수 있는 사이버 방어자들을 대상으로 페어윈드 프로그램을 통해 공개한다. 아르곤은 입력 토큰당 200만 개당 2달러, 출력 토큰당 1000만 개당 10달러의 도입 가격으로 책정되었으며, 캐시된 입력 토큰은 입력 가격의 95% 할인을 받는다. 출력 토큰 한도를 기존 64K에서 업계 최고 수준인 100만 토큰으로 대폭 확대해 더 깊이 있는 사고를 지원한다. 전체 요약 11문장 읽기 → 088 09:11 ▲ 182 · 댓글 179 중국 AI 모델 GLM-5.3, 보안 없이 사이버 공격 기능 공개 Anthropic의 Claude Mythos Preview가 자동으로 정교한 사이버 익스플로잇을 구축할 수 있는 첫 AI 모델임을 공개한 지 5개월 만에, Zhipu AI의 GLM-5.3도 유사한 능력을 갖춘 채 공개되었다. 보안 · GLM-5.3 and the spread of advanced cyber capabilities
Key Point GLM-5.3이 의미 있는 보안 보호 없이 공개된 사이버 공격 기능은 악의적 행위자뿐 아니라 방어자 모두에게 영향을 미치는 기술 환경의 전환점이 되고 있기 때문이다.
핵심 요약
Anthropic의 Claude Mythos Preview가 자동으로 정교한 사이버 익스플로잇을 구축할 수 있는 첫 AI 모델임을 공개한 지 5개월 만에, Zhipu AI의 GLM-5.3도 유사한 능력을 갖춘 채 공개되었다. GLM-5.3은 Claude Mythos Preview처럼 엔드-투-엔드 사이버 익스플로잇을 자율적으로 구축할 수 있지만, 다른 최첨단 모델과 달리 악의적 이용을 제한하는 의미 있는 보안조치 없이 출시되었다. 연구팀 테스트에서 공격자들은 단순한 기법으로 GLM-5.3의 보안을 64%~100% 우회할 수 있지만, 보안이 설정된 Claude 모델에 대해서는 이 공격이 성공하지 못했다. 전체 요약 12문장 읽기 → 089 15:11 ▲ 18 · 댓글 2 멀티뷰 학습으로 공간 추론 강화한 SpatialSpeak 공개 비전-언어 모델(VLM)이 다중 관점 공간 추론을 위해 기하학적 사전 정보를 활용하지만, 기존 답 위주의 학습은 중간의 기하학적 추정과 정량적 공간 답 도출 과정을 직접 감독하지 않는다. AI · 머신러닝 · SpatialSpeak: QA-Native Reconstruction with Local and Global Context for Spatial Chain-of-Thought Reasoning
Key Point 비전-언어 모델의 공간 추론 능력을 크게 향상하는 새로운 학습 방식이 제시되었으며, 멀티뷰 재구성과 사고의 흐름 학습을 결합한 접근법이 기하학적 이해와 답 도출 과정 모두를 강화한다.
핵심 요약
비전-언어 모델(VLM)이 다중 관점 공간 추론을 위해 기하학적 사전 정보를 활용하지만, 기존 답 위주의 학습은 중간의 기하학적 추정과 정량적 공간 답 도출 과정을 직접 감독하지 않는다. 연구팀은 VLM이 멀티뷰 재구성을 통해 국소 기하학과 전역 장면 맥락을 함께 학습할 때 공간 사고의 흐름(CoT) 감독이 더 효과적이라고 가정했다. SpatialSpeak은 두 단계 프레임워크로, 1단계(QA-Native Reconstruction Pretraining, QA-RP)에서 표시된 점 기반 3D 쿼리로 세밀한 국소 기하학을 학습하고 객체 중심 쿼리로 전역 장면 맥락을 학습한다. 전체 요약 8문장 읽기 → 090 15:11 ▲ 33 · 댓글 1 작은 모델도 강력하게: 필요할 때만 큰 모델에 묻는 추론 시스템 작은 추론 모델(sRM)의 테스트 타임 컴퓨팅을 확장하는 것이 성능 향상의 핵심이지만, 더 많은 사고가 항상 도움이 되는지는 명확하지 않다. AI · 머신러닝 · Knowing When Thinking Is Not Enough: Teaching Small Reasoning Models to Reason Beyond Their Parametric Knowledge
Key Point 작은 모델이 큰 모델과 비슷하거나 나은 성능을 훨씬 낮은 비용으로 달성하는 방법을 보여주므로, 프로덕션 추론 비용 최적화를 고민하는 개발팀에게 직접적인 영향이 있다.
핵심 요약
작은 추론 모델(sRM)의 테스트 타임 컴퓨팅을 확장하는 것이 성능 향상의 핵심이지만, 더 많은 사고가 항상 도움이 되는지는 명확하지 않다. 중간 추론 상태에 개입하는 실험을 통해 자기개선(self-refinement)이 기존에 도달 가능한 해답으로 확률질량을 집중시킬 뿐, 새로운 해답을 만들지는 못한다는 것을 발견했다. 두 가지 실패 양식을 식별했다: 올바른 경로는 도달 가능하지만 실행에 실패하는 실행 병목(execution bottleneck)과, 외부 정보가 필요한 지식 병목(knowledge bottleneck)이다. 전체 요약 7문장 읽기 → 092 00:11 ▲ 120 · 댓글 106 AI가 코딩을 완전히 해결했다는 주장은 착각이다 LLM이 코드 작성에 능하다는 주장은 소프트웨어 개발의 본질을 오해한 것이다. 코드 생성 비용이 낮아졌지만, 실제 비용의 대부분은 유지보수, 신뢰성, 보안, 확장성 같은 비기능 요구사항에서 나온다. AI · 머신러닝 · Coding Is Not Solved
Key Point AI 기반 개발로 인해 대규모 레이오프를 단행한 기업들이 품질 저하와 책임 회피의 딜레마에 직면한 가운데, 전문가가 제시하는 LLM의 근본적 한계와 산업별 필요성의 차이를 정리한 글이다.
핵심 요약
LLM이 코드 작성에 능하다는 주장은 소프트웨어 개발의 본질을 오해한 것이다. 코드 생성 비용이 낮아졌지만, 실제 비용의 대부분은 유지보수, 신뢰성, 보안, 확장성 같은 비기능 요구사항에서 나온다. 의료, 금융, 자동차, 방위, 발전소, 항공 등 실수의 대가가 큰 산업에서는 낮은 위험 허용도가 필요하며, 이런 분야에서는 책임감 있는 엔지니어가 필수다. AI는 책임을 질 수 없다. AI는 결과에 따른 처벌, 감옥, 벌금을 받지 않으므로 진정한 책임성을 가질 수 없고, 제어 불가능한 것에는 책임을 질 수 없다는 원칙이 핵심이다. 전체 요약 11문장 읽기 → 093 21:11 ▲ 123 · 댓글 39 AI가 인간처럼 생각하게 하려면, 빠르고 느린 시스템을 함께 써야 한다 현대 AI는 이미지 분석, 자연어 처리 등 특정 영역에서 뛰어나지만, 인간의 일반적 지능에 비해 여전히 좁은 범위의 능력만 가지고 있다. AI · 머신러닝 · Thinking fast and slow in AI: The role of metacognition (2021)
Key Point 인간의 인지 구조를 AI에 적용하는 구체적인 아키텍처를 제시해 현재 좁은 AI의 한계를 어떻게 극복할 수 있을지 보여준다.
핵심 요약
현대 AI는 이미지 분석, 자연어 처리 등 특정 영역에서 뛰어나지만, 인간의 일반적 지능에 비해 여전히 좁은 범위의 능력만 가지고 있다. 인간의 사고 메커니즘을 더 잘 이해하면 AI에 더 폭넓은 능력을 부여할 수 있다고 논문은 주장한다. 카네만의 '빠르고 느린 생각' 이론을 바탕으로, 연구팀은 두 종류의 에이전트로 구성된 다중 에이전트 AI 아키텍처를 제시했다. 전체 요약 5문장 읽기 → 094 21:11 ▲ 135 · 댓글 129 Claude Opus 5.5 프롬프팅 가이드 Claude Opus 5.5는 이전 Opus 5 대비 출력 토큰을 30% 이상 빠르게 생성하며 같은 작업을 더 적은 토큰으로 완료한다. AI · 머신러닝 · Prompting Claude Opus 5.5
Key Point Opus 5.5는 30% 빠른 토큰 생성과 새로운 사고 기능으로 기존 통합의 설정·프롬프트를 모두 재검토해야 하기 때문이다.
핵심 요약
Claude Opus 5.5는 이전 Opus 5 대비 출력 토큰을 30% 이상 빠르게 생성하며 같은 작업을 더 적은 토큰으로 완료한다. 기본값인 중간 노력도에서 Opus 5.5는 고노력도의 Opus 5보다 코딩과 지식 작업 평가에서 동등하거나 우수하다. 지금은 항상 사고(thinking) 기능이 켜져 있으므로, 노력도를 조정하는 것이 지능·지연·비용을 균형 맞추는 주요 방법이다. 전체 요약 13문장 읽기 → 096 21:11 ▲ 10 · 댓글 1 80B 파라미터지만 13B만 쓰는 혼연 AI, 오픈소스 공개 혼연(Hunyuan)이 80억 개 파라미터 중 추론 시 13억 개만 활성화하는 혼합 전문가(MoE) 구조의 대규모 언어모델 Hunyuan-A13B를 오픈소스로 공개했다. AI · 머신러닝 · Hunyuan-A13B Technical Report
Key Point MoE 구조로 큰 모델의 성능을 유지하면서 추론 비용을 대폭 줄였으므로, 제한된 리소스 환경에서 강력한 LLM을 배포하려는 개발자와 조직에 직접적인 대안이 된다.
핵심 요약
혼연(Hunyuan)이 80억 개 파라미터 중 추론 시 13억 개만 활성화하는 혼합 전문가(MoE) 구조의 대규모 언어모델 Hunyuan-A13B를 오픈소스로 공개했다. 모델은 20조 개 토큰으로 사전학습되었으며, STEM 데이터를 강화해 사실 정확성과 추론 능력을 개선했다. 고품질 지도학습 미세조정과 대규모 강화학습으로 성능을 더욱 끌어올렸다. 전체 요약 6문장 읽기 → 097 15:11 ▲ 134 · 댓글 50 Flock 카메라 오류로 무고한 여성 13일 투옥돼 플로리다의 23살 린지 아이작스는 2025년 10월 치명적 교통사고 용의자로 오인되어 경찰에 체포됐다. 보안 · One Piece of Flock Camera Data Put This Innocent Woman in Jail for 13 Days
Key Point 경찰이 기본적인 확인(차량 색상, 충돌 흔적 검사)도 하지 않은 채 카메라 데이터 하나만으로 무고한 사람을 투옥한 사례로, 자동화된 감시 기술이 사법 정의를 어떻게 훼손할 수 있는지 보여준다.
핵심 요약
플로리다의 23살 린지 아이작스는 2025년 10월 치명적 교통사고 용의자로 오인되어 경찰에 체포됐다. 경찰은 플록(Flock) 자동번호판 인식 카메라(ALPR) 데이터만을 근거로 그녀를 3건의 과실치사 혐의로 기소했다. 사고 목격자들은 적포색 더지 더라노를 지목했지만 아이작스의 차는 검은색이었고, 그녀의 차에는 충돌 흔적이 전혀 없었다. 전체 요약 10문장 읽기 → 098 09:11 ▲ 104 · 댓글 44 메타 뮤즈, 내부에서 OpenAI 모델 사용 흔적 발견 메타의 AI 에이전트 뮤즈에서 Avocado라는 메타 내부 모델 외에 azure/muse-special이라는 라벨의 OpenAI 모델이 사용되는 것을 발견했다. AI · 머신러닝 · Meta's Muse appears to use an OpenAI model labeled muse-special
Key Point 메타 뮤즈가 공개적으로 공개하지 않은 OpenAI 모델을 백엔드에서 사용하고 있으며, 메타가 외부 모델의 암호화된 응답을 수집하는 방식이 모델 개발 전략과 사용자 데이터 취급에 대한 기술적 통찰을 제공한다.
핵심 요약
메타의 AI 에이전트 뮤즈에서 Avocado라는 메타 내부 모델 외에 azure/muse-special이라는 라벨의 OpenAI 모델이 사용되는 것을 발견했다. muse-special 세션의 서명에는 gpt_responses_v1 태그와 OpenAI가 사용하는 gAAAAA로 시작하는 암호화 페이로드가 포함되어 있으며, 도구 호출 ID가 OpenAI 형식(call_ 뒤 24자)을 따른다. 뮤즈의 에이전트 데몬에는 Claude Opus/Sonnet/Haiku, GPT-5.5/5.6 변형들, Kimi K3 등 약 15개의 Avocado 버전과 함께 다양한 모델이 탑재되어 있다. 전체 요약 8문장 읽기 → 099 03:11 ▲ 107 · 댓글 46 AI 시대, 경험을 내려놓고 원점에서 생각하라 Sunil Pai의 시니어 엔지니어 '죽음의 소용돌이' 글에서 영감을 받아, 경험 많은 개발자들이 겪는 정체 상태를 분석한다. AI · 머신러닝 · First Principles Thinking
Key Point 시니어 엔지니어들이 새로운 기술에 적응하지 못하는 이유와 해결책을 제시하는데, 경험을 일단 내려놓고 원점에서 생각하는 방식이 AI 시대의 핵심 경쟁력이 될 수 있음을 보여준다.
핵심 요약
Sunil Pai의 시니어 엔지니어 '죽음의 소용돌이' 글에서 영감을 받아, 경험 많은 개발자들이 겪는 정체 상태를 분석한다. 시니어 엔지니어가 뛰어난 이유는 직관적으로 '해야 할 일'을 알기 때문인데, 이는 제일원리(first principles) 사고로부터 나온다고 본다. 제일원리 사고란 '왜 우리가 이걸 만드는가', '사용자에게 어떤 도움이 되나' 같은 근본적인 질문을 던지는 습관을 말한다. 전체 요약 10문장 읽기 → 100 22:26 ▲ 15 · 댓글 2 최신 언어 모델의 숨겨진 사고 과정 추출 및 분석 최신형 언어 모델의 성능 향상이 추론 능력 개선 때문인지 검증하려면, 폐쇄형 시스템의 CoT(Chain-of-Thought) 추적을 관찰해야 하는데 현재 접근 불가능하다. AI · 머신러닝 · Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models
Key Point 폐쇄형 모델의 내부 추론 메커니즘이 어떻게 동작하는지 처음 체계적으로 들여다본 연구로, 모델의 성능 향상이 실제 추론 능력 증대인지 판단할 수 있는 근거를 제시한다.
핵심 요약
최신형 언어 모델의 성능 향상이 추론 능력 개선 때문인지 검증하려면, 폐쇄형 시스템의 CoT(Chain-of-Thought) 추적을 관찰해야 하는데 현재 접근 불가능하다. 연구팀은 표준 API의 커스텀 도구 등록 기능을 이용해 GPT-4o Astra 등 최신 모델들이 중간 추론 과정을 외부화하도록 유도했다. 추출된 추론을 오픈소스 모델의 기본 CoT와 비교해 진정한 추론인지 사후 정당화인지 검증하고, 경쟁 수학·과학·코드 생성 작업에서 평가했다. 전체 요약 7문장 읽기 →