쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
21건 · "가속기"조건 지우기 ×
001 03:11 ▲ 107 · 댓글 40 컴퓨터 과학자가 읽어야 할 핵심 책 47권 닉 블랙이 'Edsger Dijkstra is watching you'라는 모토로 정리한 컴퓨터 과학 입문 및 심화 서적 리스트로, Code Complete 같은 일반적인 프로그래밍 책과 차별화된다. 오픈소스 · 도구 · Book list for streetfighting computer scientists
Key Point 기초 알고리즘부터 고급 형식론까지 체계적으로 정렬된 47개 필독서 목록으로, 각 단계별로 구체적 서적과 판본·버전을 명시해 깊이 있는 컴퓨터 과학 학습의 로드맵을 제공한다.
핵심 요약
닉 블랙이 'Edsger Dijkstra is watching you'라는 모토로 정리한 컴퓨터 과학 입문 및 심화 서적 리스트로, Code Complete 같은 일반적인 프로그래밍 책과 차별화된다. 입문 단계에서는 Stepanov의 '수학에서 범용 프로그래밍으로', Gustedt의 '현대 C', Hanson의 'C 인터페이스와 구현', Stroustrup의 'C++ 프로그래밍 언어', Josuttis의 'C++ 이동 시맨틱스', Klabnik의 'Rust 프로그래밍 언어'를 추천한다. 저자는 C/C++를 대부분 하드웨어에서 구현되는 표준 API 표현이자 대다수 운영체제의 네이티브 인터페이스로 평가하며, Rust는 더 읽기 쉽고 덜 떠드는 좋은 언어라고 설명한다. 전체 요약 10문장 읽기 → 002 00:11 당일 +127 LLM 시대 인프라 설계의 첫 걸음, 공개 교과서 LLM 추론과 훈련 시스템을 하드웨어 제약과 모델 구조에서 출발해 정량적으로 설계하는 방법을 다룬 오픈소스 교과서를 공개했다. AI · 머신러닝 · bojieli/ai-infra-book · Python
Key Point 대규모 언어 모델을 실제로 배포할 때 지연 시간과 비용이 몇 배 차이나는 원인을 하드웨어와 시스템 설계에서 찾고 정량적으로 분석하는 방법을 배울 수 있다.
핵심 요약
LLM 추론과 훈련 시스템을 하드웨어 제약과 모델 구조에서 출발해 정량적으로 설계하는 방법을 다룬 오픈소스 교과서를 공개했다. 전체 12장으로 구성되며 초기 입출력, 모델 아키텍처, 추론·훈련 부하, 가속기 아키텍처, 알고리즘과 런타임, 다중 기기 협력, 데이터센터 네트워크, 추론 최적화, 분산 추론, 훈련 시스템, 자원 스케줄링, 엣지-클라우드 협력을 다룬다. 책의 핵심 방법론은 '제약에서 설계로'로, 작업과 품질 요구사항을 정의한 뒤 계산·저장·통신 비용을 하드웨어 성능과 비교해 수량적으로 추정한다. 전체 요약 9문장 읽기 → 003 18:11 ▲ 117 · 댓글 27 법원, DRAM 가격담합 소송 기각 신청 모두 기각 미국 연방지방법원 노엘 와이즈 판사가 삼성, SK 하이닉스, 마이크론의 집단소송 기각 신청을 전면 기각했다. 보안 · Court denies motion to dismiss DRAM price fixing case
Key Point 반도체 업계 최대 규모 기업 3곳이 메모리칩 공급을 인위적으로 조절했다는 의혹이 법원에서 실질 심사 단계로 진입했으며, 역사적 전례를 뚫고 공급 축소와 HBM 전환의 병렬 조치들이 담합의 증거로 인정되었다.
핵심 요약
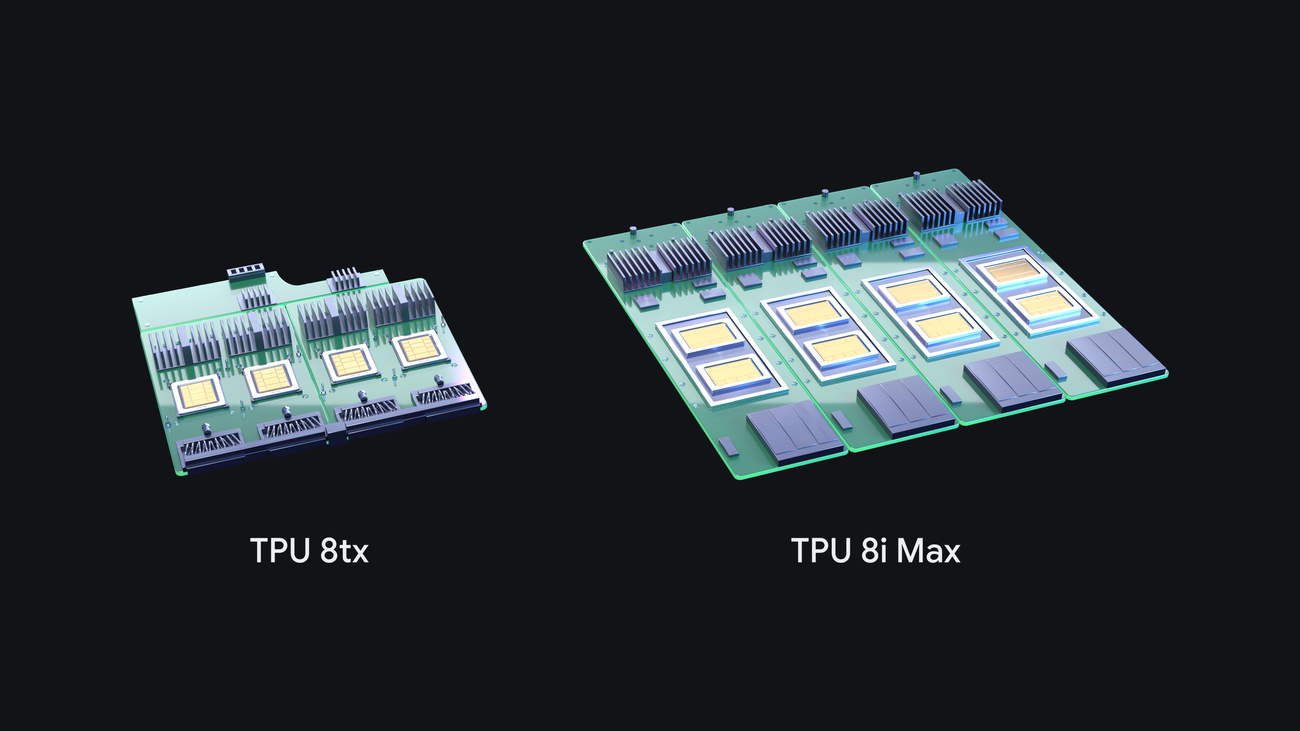
미국 연방지방법원 노엘 와이즈 판사가 삼성, SK 하이닉스, 마이크론의 집단소송 기각 신청을 전면 기각했다. 2022년 같은 회사들을 상대로 기각된 이전 DRAM 담합 소송(DRAM II)의 재판이 아니라고 법원이 판단했다. 2026년 6월 제기된 소송은 3개 회사가 2022년 말부터 일반 DRAM 공급을 줄이고 AI 가속기용 고대역폭 메모리(HBM)로 생산을 전환했다고 주장한다. 전체 요약 10문장 읽기 → 004 09:11 ▲ 155 · 댓글 22 구글, 에이전트 시대 맞춰 TPU 8tx·8i Max 공개 구글이 8세대 TPU 포트폴리오에 TPU 8tx와 TPU 8i Max를 추가해, 한 해 동안 네 개의 새로운 TPU 시스템을 출시했다. 인프라 · 데브옵스 · TPUs
Key Point 에이전트 AI 시대에 필요한 하드웨어 아키텍처가 극적으로 바뀌고 있으며, PyTorch 네이티브 지원 등으로 TPU 접근성이 대폭 개선돼 기존 GPU 중심의 개발 환경을 재편할 가능성이 있다.
핵심 요약
구글이 8세대 TPU 포트폴리오에 TPU 8tx와 TPU 8i Max를 추가해, 한 해 동안 네 개의 새로운 TPU 시스템을 출시했다. TPU 8t는 2.7배 더 빠른 학습 성능을, TPU 8i는 80% 더 나은 추론 가격 대비 성능을 제공한다. TPU 8tx는 민감한 데이터 보호를 위해 하드웨어 수준의 암호화를 탑재하고, AMD EPYC CPU와 결합해 추론 시 2배 낮은 지연 시간을 달성한다. 전체 요약 12문장 읽기 → 005 21:11 당일 +104 Google Colab 명령줄 인터페이스 공개 구글이 Google Colab CLI를 공개했다. 터미널에서 직접 Colab 런타임을 프로비저닝하고 코드를 실행하며 원격 파일을 관리할 수 있는 명령줄 도구다. 웹 · 프론트엔드 · googlecolab/google-colab-cli · Python
Key Point 터미널 워크플로로 Colab의 강력한 GPU·TPU 자원을 Python 스크립트와 함께 자동화하려는 개발자와 AI 에이전트에게 새로운 개발 경험을 제공한다.
핵심 요약
구글이 Google Colab CLI를 공개했다. 터미널에서 직접 Colab 런타임을 프로비저닝하고 코드를 실행하며 원격 파일을 관리할 수 있는 명령줄 도구다. CPU, GPU(T4, L4, G4, H100, A100), TPU(v5e1, v6e1) 런타임을 초 단위로 시작할 수 있으며, 로컬 파이썬 스크립트나 Jupyter 노트북을 실행하거나 REPL을 열 수 있다. ephemeral job runner(`colab run`)로 신규 VM을 자동 프로비저닝하고, 로컬 스크립트를 실행한 뒤, 결과 파일을 가져온 후 자동으로 런타임을 해제하는 한 명령으로 전체 작업 흐름을 처리한다. 전체 요약 12문장 읽기 → 006 03:11 ▲ 32 · 댓글 2 AI 데이터센터 광학 네트워크의 장애 예측 제어 체계 Halley 대규모 AI 모델 훈련 시 수만 개의 가속기를 연결하는 광학 네트워크에서 매 훈련 스텝마다 전체 데이터 교환이 발생한다. AI · 머신러닝 · Halley: A Predictive Control Plane for Optical AI Data Center Networks
Key Point AI 데이터센터 훈련의 네트워크 신뢰성 문제를 예측 제어로 근본적으로 해결하여 같은 비용으로 더 큰 성능 확보가 가능해진다.
핵심 요약
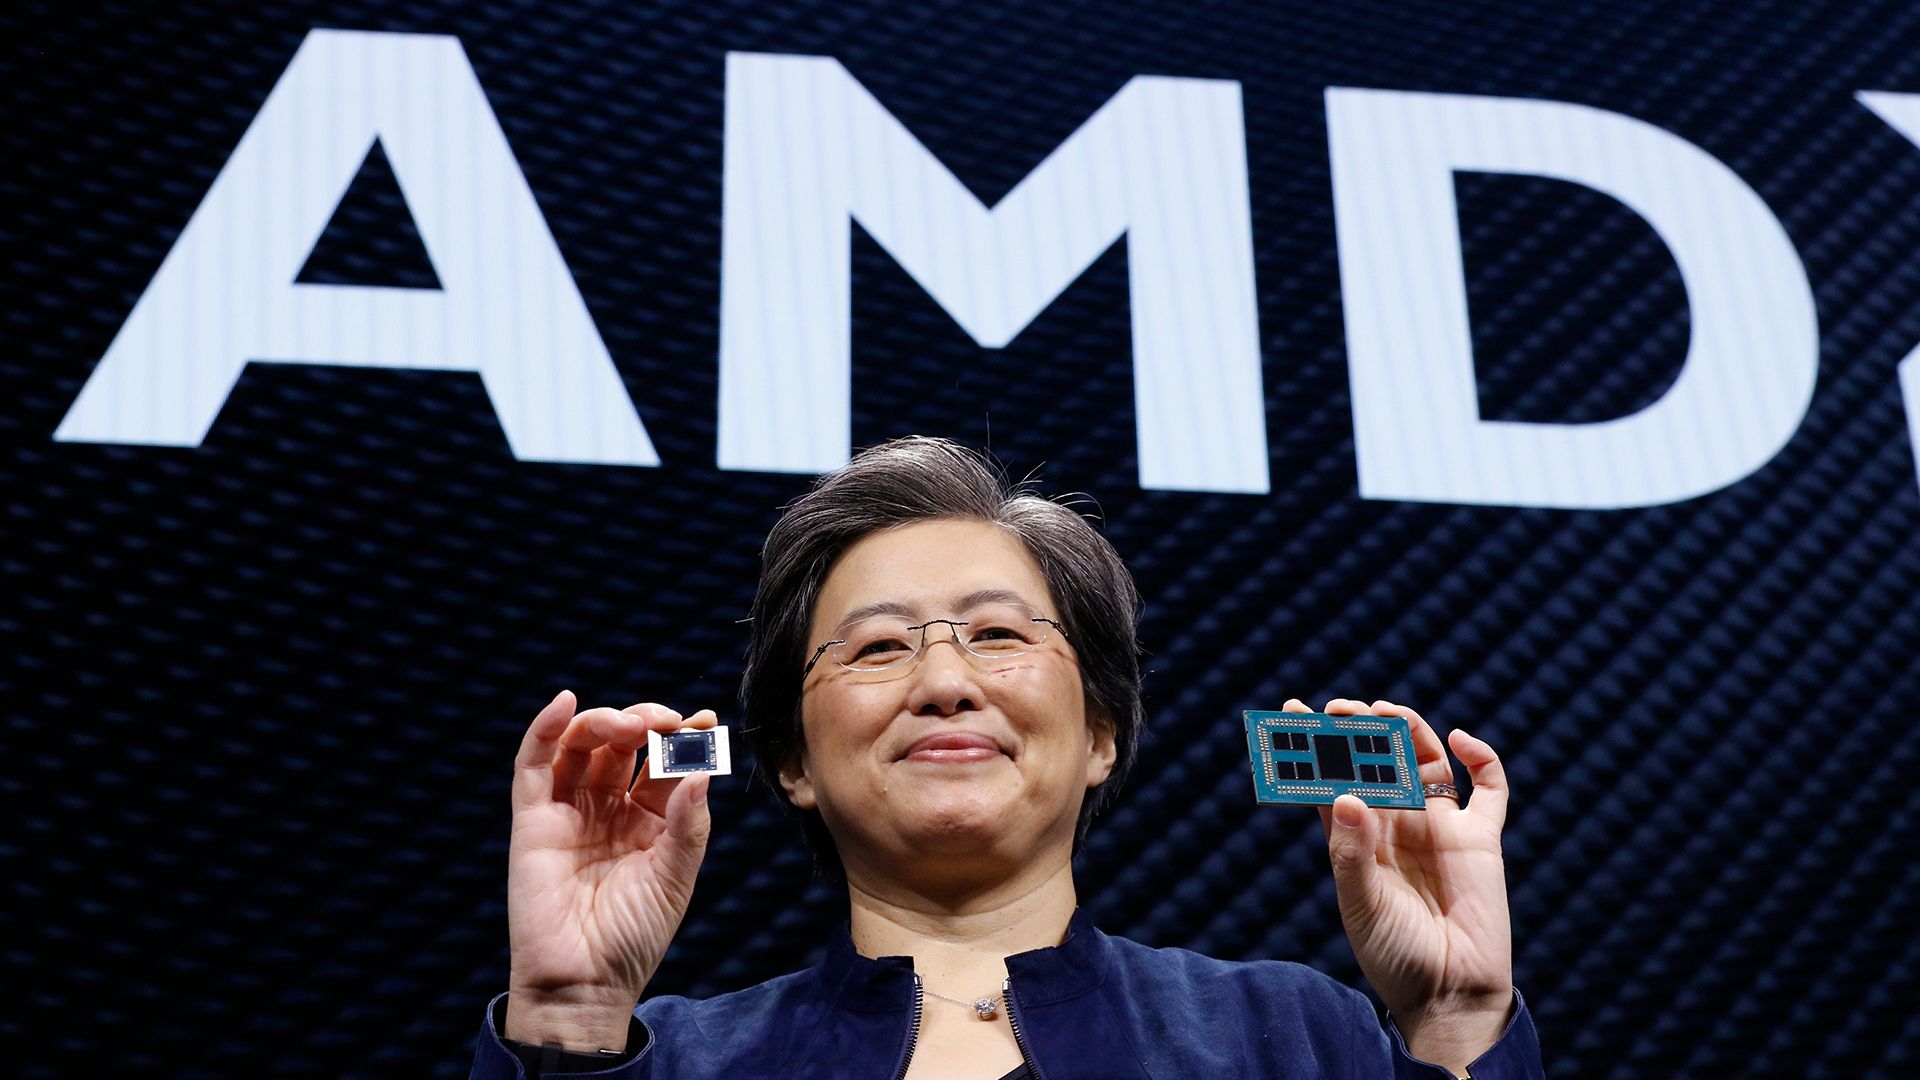
대규모 AI 모델 훈련 시 수만 개의 가속기를 연결하는 광학 네트워크에서 매 훈련 스텝마다 전체 데이터 교환이 발생한다. 현재 광학 네트워크의 레이저·스위치·마이크로링 등 각 계층은 고정 정책이거나 사후 대응 방식으로 운영되고 있다. 같은 인클로저를 공유하는 레이저들은 함께 고장날 수 있으며, 고정된 예비 비율 아래에서는 풀이 아무리 커도 장애율이 증명상 상한선에 머문다. 전체 요약 10문장 읽기 → 007 03:11 ▲ 191 · 댓글 61 AMD, 역사상 처음 인텔을 제치고 분기 매출 1위 예상 AMD가 4분기 매출 약 170억 달러를 예상해 역사상 처음으로 인텔을 능가할 것으로 예측했다. 하드웨어 · 시스템 · AMD expects to outsell Intel in Q4 for the first time in history
Key Point AMD가 PC CPU 시장에서 거의 수십 년간 인텔의 뒤를 따라오다 분기 기준으로 처음 추월하는 기록을 세우려는 만큼, 프로세서 시장의 판도가 크게 변했음을 보여주는 분수령이다.
핵심 요약
AMD가 4분기 매출 약 170억 달러를 예상해 역사상 처음으로 인텔을 능가할 것으로 예측했다. 최근 분기 매출 기록을 경신했으며, Epyc 데이터센터 프로세서와 Instinct AI 가속기 수요가 전년동기 대비 거의 두 배 증가했다. 클라이언트 시스템 제품 판매량은 높은 메모리 가격과 기타 악재에도 소폭만 하락했다. 전체 요약 5문장 읽기 → 008 06:11 ▲ 105 · 댓글 46 완전 오픈소스 리눅스 기반 네트워크 멀티툴 '플리퍼 원' 사전주문 시작 Rockchip RK3576 ARM 프로세서 기반의 완전 오픈소스 리눅스 컴퓨터 '플리퍼 원'의 사전주문을 시작했다. 하드웨어 · 시스템 · Preparing for the Flipper One Kickstarter and opening pre-orders
Key Point 완전 오픈소스 구조와 M.2 확장성을 갖춘 리눅스 네트워크 기기로, 네트워크 엔지니어와 보안 연구자가 자유롭게 커스터마이징할 수 있는 도구가 나온다.
핵심 요약
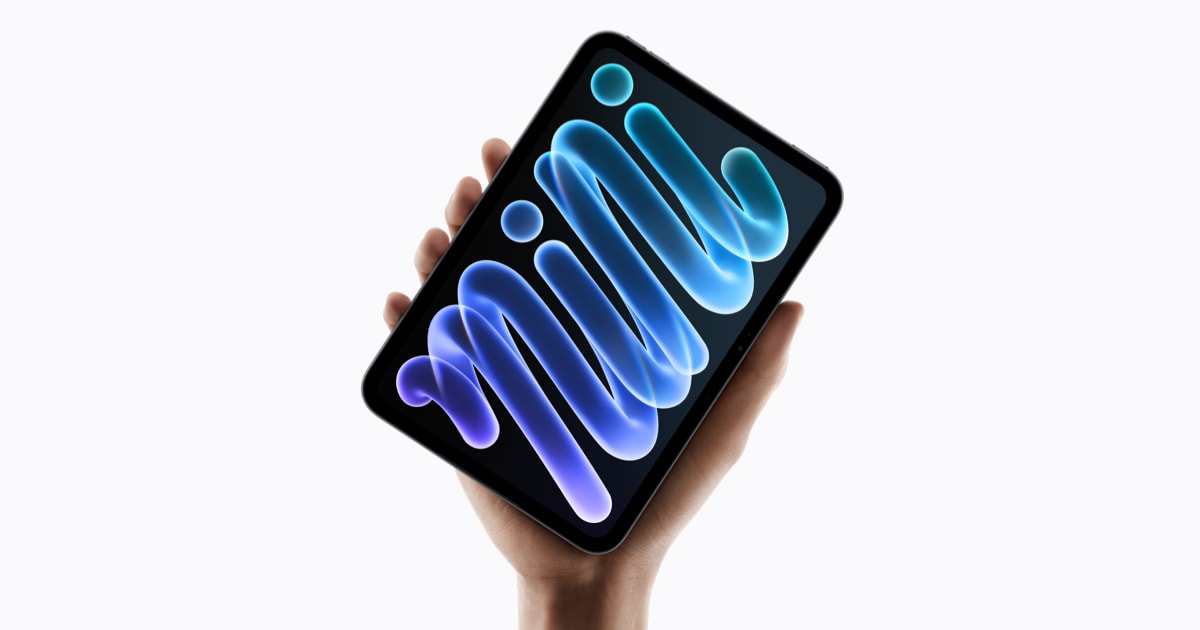
Rockchip RK3576 ARM 프로세서 기반의 완전 오픈소스 리눅스 컴퓨터 '플리퍼 원'의 사전주문을 시작했다. 메인라인 커널 지원, 바이너리 blob 제거, 벤더 종속성 없는 순수 오픈소스 환경을 추구하며, Collabora 팀과 협력해 RK3576을 메인라인 커널에 통합 중이다. Raspberry Pi RP2350 저전력 MCU와 RK3576 고성능 CPU 두 프로세서가 병렬로 동작해, 리눅스 OS가 꺼져 있어도 MCU로 LCD와 물리 버튼을 제어할 수 있다. 전체 요약 10문장 읽기 → 009 03:12 ▲ 110 · 댓글 107 애플, 신형 아이패드 미니 공개…OLED 화면과 AI 성능 대폭 강화 애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 하드웨어 · 시스템 · The new iPad mini
Key Point 신형 아이패드 미니는 OLED 디스플레이, A20 Pro의 4.5배 AI 성능 향상, IP67 방수 인증으로 소형 태블릿 시장의 기준을 다시 설정하며, 창작자와 야외 작업자들이 갖춰야 할 기기 사양이 크게 달라진다.
핵심 요약
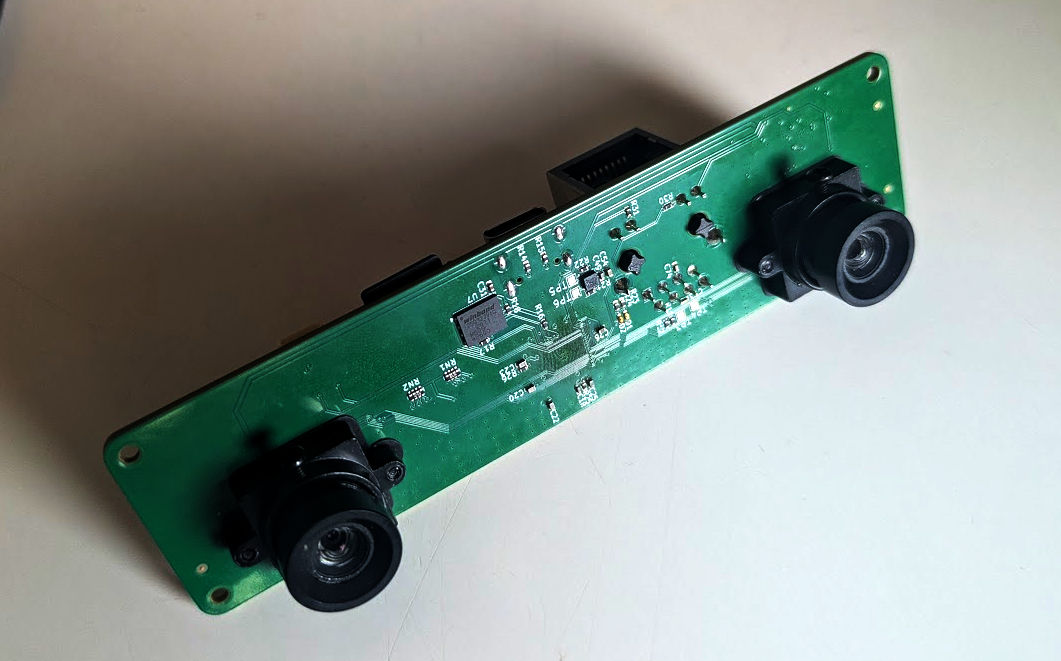
애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다. 두께 5.4mm로 이전 세대 대비 더 얇고 가벼워졌으며, 베젤이 24% 줄어든 상태에서 디스플레이 크기를 8.5인치로 확대했다. OLED 패널은 피크 밝기 1200nits(이전 대비 2배 이상), 2,000,000:1 명암비, 1nit 최소 밝기를 지원하며, 선택사항으로 반사 감소 나노텍스처 옵션을 제공한다. 전체 요약 14문장 읽기 → 010 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 011 21:11 ▲ 22 · 댓글 7 4비트 재귀 상태 양자화로 LLM 배치 처리 메모리 절감 선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. AI · 머신러닝 · PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
Key Point LLM 추론 시 배치 크기를 제약하는 상태 메모리를 4비트로 양자화할 수 있다면, 같은 GPU 메모리로 더 많은 요청을 동시 처리할 수 있기 때문이다.
핵심 요약
선형 어텐션 언어 모델은 고정 크기의 재귀 상태로 문맥을 유지하며, 추론 시스템은 동시에 복호화되는 각 시퀀스마다 상태 복사본을 저장해야 한다. 상태를 낮은 정밀도로 저장하면 더 많은 시퀀스가 가속기를 공유할 수 있지만, 기존 양자화 방식은 매 토큰 생성 후 반올림하므로 4비트에서 정확도 손실이 크다. PACE는 사후 4비트 상태 양자화 기법으로, 매 토큰마다가 아니라 여러 토큰 생성 후에만 한 번 상태를 반올림하고, 그 사이 생성된 토큰을 작은 버퍼에 보관한다. 전체 요약 8문장 읽기 → 012 18:11 ▲ 24 · 댓글 3 양자화와 추론으로 MoE 오프로딩 병목 해결한 Specter MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. AI · 머신러닝 · Specter: Fast MoE Inference via Quantization-Enabled Multi-Step Speculative Offloading
Key Point 메모리 제약이 있는 환경에서 MoE 모델 추론 속도를 1.5배 이상 개선할 수 있다는 것은 대형 모델을 일반 GPU에서 실행하려는 개발자들에게 직접 영향을 미친다.
핵심 요약
MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. Specter는 양자화된 경량 드래프트 모델을 기기에서 효율적으로 실행하면서도 전문가 활성화 패턴의 충실도를 유지한다. 드래프트 모델의 다단계 예측을 통해 향후 전문가 사용을 미리 파악하고, 런타임이 검증 전에 전문가 이동과 실행을 미리 조직할 수 있다. 전체 요약 5문장 읽기 → 013 03:11 ▲ 169 · 댓글 82 Mac Studio에서 816B 모델 실행, MLX의 분산 추론 기능 공개 Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. AI · 머신러닝 · Apple ML Research: Muse Spark Open with MLX on Mac Studio
Key Point Apple silicon 기반 로컬 LLM 실행 성능이 가속도 구간에 접어들었으며, 816B 모델을 Mac Studio 클러스터에서 실행할 수 있는 기술 기반이 완성되었기 때문이다.
핵심 요약
Apple이 MLX 최신 버전을 공개하며 Mac Studio에서 Muse Spark Open(816B 파라미터, MoE 모델)을 실행할 수 있음을 시연했다. 단일 Mac Studio(M5 Ultra, 512GB 통합 메모리)에서 27B~128B 규모 모델(Qwen 3.8, Mistral Medium 3.5)은 정상 작동하며, TTFT는 M3 대비 최대 4.6배 빨라졌고 토큰 생성 속도는 1.6배 향상됐다. M5 Ultra의 GPU 신경 가속기는 행렬 곱셈 연산을 전담하여 컴퓨팅 한계 작업을 가속화하고, 통합 메모리 대역폭이 819GB/s에서 1.2TB/s로 증가해 메모리 한계 작업을 개선했다. 전체 요약 12문장 읽기 → 014 21:11 당일 +308 에이전틱 워크로드 최적화 LLM 추론 엔진 TokenSpeed 공개 LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. AI · 머신러닝 · lightseekorg/tokenspeed · Python
Key Point 에이전틱 AI 애플리케이션이 주목받으면서 추론 엔진의 처리량과 지연시간이 핵심 경쟁력이 되었고, TokenSpeed는 이를 위해 기본부터 재설계한 오픈소스 솔루션으로 실제 대규모 모델 배포에서 검증된 성능을 입증했다.
핵심 요약
LightSeek Foundation이 에이전틱 워크로드에 최적화된 LLM 추론 엔진 TokenSpeed를 오픈소스로 공개했다. 기존 엔진과 달리 제어 평면(C++)과 실행 평면(Python)을 분리한 아키텍처를 채택했으며, 제어 평면은 유한 상태 머신으로 구현되어 컴파일 타임에 KV 캐시 리소스 안전성을 보장한다. 커널은 플러그인 가능한 계층형 시스템으로 설계되었으며, Blackwell GPU에서 가장 빠른 MLA(Multi-head Latent Attention) 구현 중 하나를 포함한다. 전체 요약 9문장 읽기 → 015 21:11 당일 +529 PyTorch: GPU 가속 텐서 연산과 동적 신경망 PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. AI · 머신러닝 · pytorch/pytorch · Python
Key Point PyTorch는 현대 AI 개발의 핵심 프레임워크로, GPU 가속 능력과 동적 신경망 구축의 유연성이 산업 표준이 되었으므로 최신 버전과 설치 옵션을 파악하는 것이 필수다.
핵심 요약
PyTorch는 Python 기반 딥러닝 프레임워크로 GPU 가속을 통한 텐서 연산과 테이프 기반 자동미분 시스템을 제공한다. torch, torch.autograd, torch.nn, torch.multiprocessing, torch.utils 등 핵심 컴포넌트로 구성되어 있으며 NumPy 대체제 또는 딥러닝 연구 플랫폼으로 사용된다. CPU 또는 GPU에서 실행되는 텐서 라이브러리로 슬라이싱, 인덱싱, 선형대수 등 다양한 연산을 고속으로 수행하며 Intel MKL, NVIDIA cuDNN, NCCL 등 가속 라이브러리를 통합한다. 전체 요약 12문장 읽기 → 016 18:33 ▲ 339 · 댓글 396 AI가 설계한 오픈소스 AI 가속기, openTPU 공개 AI 에이전트가 설계한 오픈소스 AI 가속기 openTPU를 공개했으며, 하드웨어 설계(SystemVerilog)부터 호스트 소프트웨어까지 한 저장소에 담아 교육용으로도 활용 가능하게 구성했다. AI · 머신러닝 · OpenTPU – An open-source AI accelerator, developed by AI
Key Point GPU나 TPU 없이 FPGA로 LLM 추론을 달성했을 뿐 아니라, 전체 설계 과정을 오픈소스로 공개해 누구나 AI 가속기의 구조를 디코딩부터 회로까지 깊이 있게 학습할 수 있다.
핵심 요약
AI 에이전트가 설계한 오픈소스 AI 가속기 openTPU를 공개했으며, 하드웨어 설계(SystemVerilog)부터 호스트 소프트웨어까지 한 저장소에 담아 교육용으로도 활용 가능하게 구성했다. Xilinx Kintex-7 FPGA 카드(DDR3 2채널)에서 LFM2.5-230M int8 모델 기준 디코딩 52.3 tok/s, 프리필 335.4 tok/s 성능을 달성했고, 10개 현대 모델의 실제 가중치로 테스트해 시뮬레이터와 비트 정확도로 일치함을 확인했다. 4비트 양자화(FP4 블록 스케일) 지원으로 토큰당 바이트를 약 1/3 감소시키고 디코딩 속도를 40~45% 높였으며, int8 헤드는 정확도 유지를 위해 유지했다. 전체 요약 9문장 읽기 → 017 21:11 당일 +244 GPU·CPU 커널 개발을 단순하게, TileLang DSL 오픈소스 TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. 인프라 · 데브옵스 · tile-ai/tilelang · Python
Key Point 저수준 최적화 전문 지식 없이 Python 수준에서 GPU·CPU 커널을 작성·배포할 수 있어 AI 인프라 개발의 진입장벽을 크게 낮춘다.
핵심 요약
TileLang은 Python 문법을 기반한 도메인 특화 언어(DSL)로, GPU·CPU·NPU 등 다양한 가속기용 고성능 커널 개발을 간소화한다. TVM 컴파일러 인프라 위에 구축되어 있으며, GEMM·FlashAttention·양자화 연산 등 복잡한 연산의 저수준 최적화를 자동으로 처리한다. NVIDIA CUDA(SM70~SM120), AMD ROCm/HIP(CDNA/RDNA), Apple Metal, Huawei Ascend 950 NPU, LLVM CPU, 그리고 WebGPU 등 다양한 백엔드를 지원한다. 전체 요약 8문장 읽기 → 018 22:29 당일 +681 ComfyUI, 노드 기반 멀티모달 AI 생성 엔진으로 거듭나다 ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. AI · 머신러닝 · Comfy-Org/ComfyUI · Python
Key Point 노드 기반 워크플로우로 최신 오픈소스 생성 모델들을 자유롭게 조합하되, 로컬 실행·API 통합·클라우드 지원을 한 도구에서 선택할 수 있어 전문가부터 초심자까지 콘텐츠 제작 자동화의 진입장벽을 낮춘다.
핵심 요약
ComfyUI는 그래프/노드 인터페이스 기반의 강력한 AI 생성 엔진으로, 이미지·비디오·3D·오디오·텍스트 생성을 한 플랫폼에서 지원한다. Stable Diffusion, SDXL, Flux.1/2, Qwen Image, Hunyuan Image, Ideogram 등 주요 이미지 모델과 LTX-Video, HunyuanVideo 같은 영상 생성, ACE-Step, Stable Audio 등 오디오 생성 모델을 기본 지원한다. Partner nodes를 통해 폐쇄형 모델(Nano Banana, Seedance, Hunyuan3D 등)에도 접근할 수 있으며, API 엔드포인트로 프로덕션 파이프라인에 통합 가능하다. 전체 요약 9문장 읽기 → 019 21:10 ▲ 117 · 댓글 38 30년 방치된 아미가 유닉스, 현대 하드웨어에서 부활 1990년 출시했던 코모도어의 Amix(System V Release 4)를 커뮤니티가 현대화하는 프로젝트가 진행 중이다. 오픈소스 · 도구 · Amiga Unix, Again
Key Point 1990년대 레트로 시스템을 오픈소스 커뮤니티가 현대 하드웨어에서 복구하는 과정에서 AI와 실제 검증을 결합한 독특한 개발 방식을 보여주며, 실제 66040/68060 머신에서 구동되는 단계까지 진행되고 있다.
핵심 요약
1990년 출시했던 코모도어의 Amix(System V Release 4)를 커뮤니티가 현대화하는 프로젝트가 진행 중이다. 68040·68060 프로세서와 현대 가속 보드에서 Amix를 구동하며, 현대적 도구체인, apkg 패키지 매니저, 이전에 없던 카드용 드라이버들을 제공한다. 플로피·CD-ROM 부팅 설치, 원격 저장소에서 grep·gzip·less·patch·zlib 등 GNU/BSD 도구를 설치하는 패키지 관리 시스템을 갖췄다. 전체 요약 6문장 읽기 → 020 18:10 ▲ 116 · 댓글 84 OpenAI, LLM으로 자체 칩 설계…20개월만에 완성 OpenAI가 자체 AI 가속기칩 '할라페뇨'를 공개했으며, 엔비디아 GB300 대비 지연시간 3.6배 단축하고 전력 소비는 덜한다. 하드웨어 · 시스템 · How OpenAI Used Its Own LLMs to Design Its Jalapeño Chip
Key Point LLM이 칩 설계 자동화를 어떻게 실현하는지, 그리고 이것이 기존 수작업 기반의 칩 개발 일정을 얼마나 단축시킬 수 있는지 보여주는 사례이기 때문입니다.
핵심 요약
OpenAI가 자체 AI 가속기칩 '할라페뇨'를 공개했으며, 엔비디아 GB300 대비 지연시간 3.6배 단축하고 전력 소비는 덜한다. 할라페뇨는 13.4 페타플롭의 4비트 연산과 초당 15.4테라바이트의 메모리 접근 속도를 제공한다. 첫 아키텍처부터 실리콘 제조까지 20개월, RTL 코드부터 생산 단계까지 9개월이 걸렸다. 전체 요약 6문장 읽기 → 021 00:10 ▲ 107 · 댓글 24 작은 AI 모델, 로컬에서도 충분히 돈다 20억 개 파라미터 이하의 소형 LLM이 클라우드 최고급 모델 대비 88.7% 정확도로 실제 질의응답에 성공했다. AI · 머신러닝 · Intelligence per Watt: Measuring Intelligence Efficiency of Local AI
Key Point 스마트폰·노트북 같은 개인 기기에서 AI를 충분히 돌릴 수 있다는 실증 자료로, 향후 AI 서비스 인프라 구조의 전환을 시사한다.
핵심 요약
20억 개 파라미터 이하의 소형 LLM이 클라우드 최고급 모델 대비 88.7% 정확도로 실제 질의응답에 성공했다. Apple M4 Max 같은 로컬 가속기에서 대화형 속도로 모델을 실행할 수 있으며, 에너지 효율성을 '와트당 지능도(IPW)'로 측정할 수 있다는 지표를 제안했다. 2023~2025년 2년간 IPW가 5.3배 개선되었고, 로컬에서 처리 가능한 질의 비중이 23.2%에서 71.3%로 증가했다. 전체 요약 5문장 읽기 →