쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
6건 · "One-shot"조건 지우기 ×
001 12:11 ▲ 56 · 댓글 3 로봇이 시뮬레이션으로 배우는 조작 기술, 한 번의 시연만으로 기존 정책 학습은 네트워크 가중치에 기술을 저장해 학습한 환경에 종속되지만, 인컨텍스트 학습(ICL)은 이 문제를 피합니다. AI · 머신러닝 · World In-Context Learning for Agentic Robot Manipulation
Key Point 한 번의 시연으로 로봇이 50개 이상의 조작 작업을 배울 수 있으며, 기존 학습 방식을 20포인트 이상 앞지르는 새로운 로봇 학습 패러다임입니다.
핵심 요약
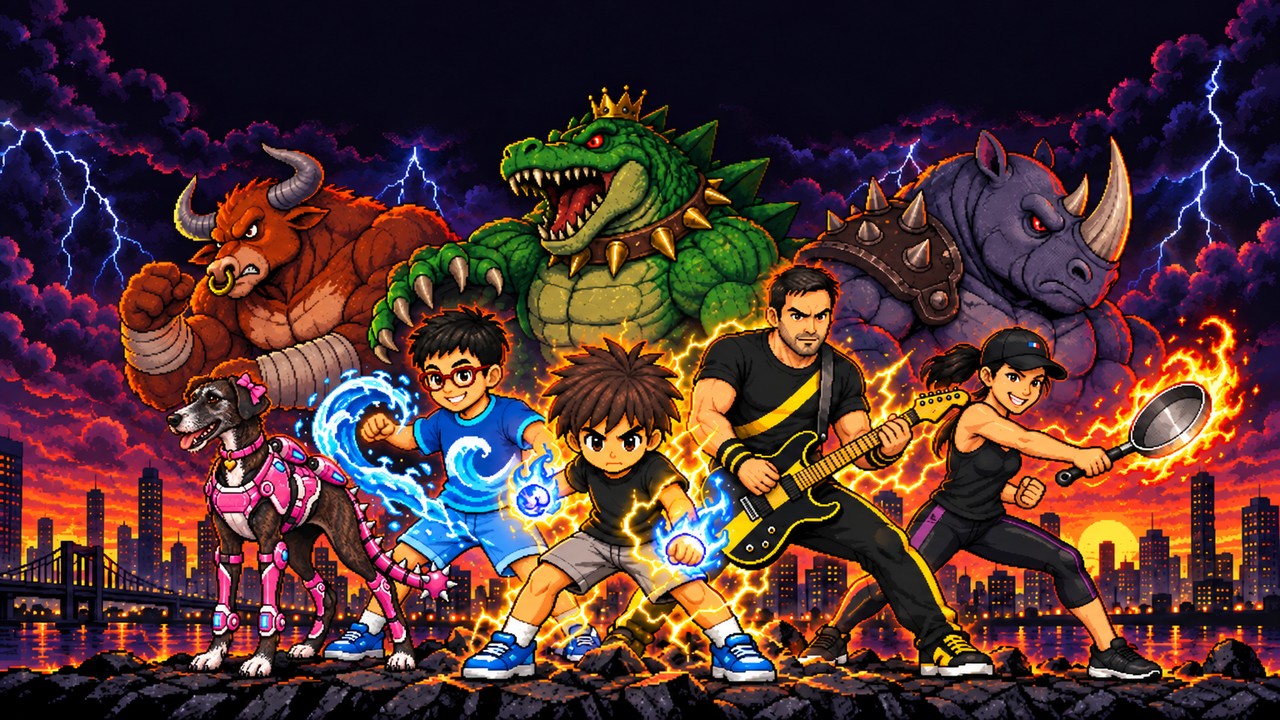
기존 정책 학습은 네트워크 가중치에 기술을 저장해 학습한 환경에 종속되지만, 인컨텍스트 학습(ICL)은 이 문제를 피합니다. 다만 기존 ICL은 다른 장면의 시연이 현재 로봇의 환경 피드백을 제공하지 못해 성능이 낮았습니다. 연구팀은 에이전트가 배우는 내용이 시각 외형이 아닌 작업 단계와 객체 역할 같은 의미론적 정보라는 점을 발견했습니다. 전체 요약 9문장 읽기 → 002 12:11 ▲ 211 · 댓글 145 조카의 그림으로 완전한 게임을 만든 AI 작가는 조카 에이던의 생일 선물로 커스텀 비트 앰 업(베트맨) 게임을 만들어달라는 요청을 받았고, 에이던이 그린 5명의 히어로와 12명의 보스, 스토리 아웃라인을 제공받았다. AI · 머신러닝 · Fable 5.2 one-shotted my nephew's dream game
Key Point AI 에이전트가 한 번의 명령으로 게임 코드, 이미지, 음성, 스토리를 모두 생성해 완전한 작품을 만들 수 있다는 것이 구체적으로 증명됐다.
핵심 요약
작가는 조카 에이던의 생일 선물로 커스텀 비트 앰 업(베트맨) 게임을 만들어달라는 요청을 받았고, 에이던이 그린 5명의 히어로와 12명의 보스, 스토리 아웃라인을 제공받았다. 6월에 Claude Opus 4.8과 Fable 5을 사용해 첫 버전을 완성했지만 2분 정도만 즐길 수 있는 수준이었고, 에이던은 계속 개선을 요청했다. Fable 5.2 출시 후 작가는 '최대한 재미있게, 현대판 닌자거북이 아케이드처럼, 네 명까지 플레이 가능' 같은 지시를 한 프롬프트 하나만 입력하고 밤새 진행시켰다. 전체 요약 11문장 읽기 → 003 06:11 ▲ 12 · 댓글 2 LLM으로 안정성 증명서 합성하고 형식검증기로 검증 Lyapunov 함수와 barrier certificate는 비선형 고차원 시스템의 안정성과 안전성을 보장하지만, 이들을 합성하고 검증하는 것은 여전히 난제이다. AI · 머신러닝 · LLM2Cert: LLM Synthesis of Certificates with SMT/Lean Verification
Key Point 동적 시스템의 안정성 증명이 형식검증기와 LLM으로 자동화되는 방식이 바뀌고 있으며, 기존 솔버 중심 접근을 넘는 실질적 성과를 보여준다.
핵심 요약
Lyapunov 함수와 barrier certificate는 비선형 고차원 시스템의 안정성과 안전성을 보장하지만, 이들을 합성하고 검증하는 것은 여전히 난제이다. 기존 방식은 수치해석 솔버, 구간 방법, SMT 솔버 등을 사용하는데, 완화(relaxation)가 필요하거나 보수적이거나 차원과 비선형성에 따라 확장성이 나빠진다. 표준 벤치마크는 솔버가 다룰 수 있는 저차원 다항식 시스템으로 지배되어 실제 공학 응용과 거리가 있다. 전체 요약 8문장 읽기 → 004 21:11 ▲ 23 · 댓글 2 로봇 가치 모델 평가 벤치마크 RoboValue 공개 로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. AI · 머신러닝 · RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
Key Point 로봇 가치 모델의 신뢰성을 체계적으로 평가하기 위한 첫 번째 통합 벤치마크로, 기존 평가 방식의 한계를 드러내고 정책 학습의 피드백 품질 개선 방향을 제시한다.
핵심 요약
로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. 시뮬레이션과 실제 환경을 통합한 RoboValue 벤치마크는 네 가지 능력 차원을 평가한다: 작업-상태 이해, 시간 진행 모니터링, 실패 및 회복 추론, 가치 일관성. RoboValue-Dataset은 15개 시뮬레이션 및 20개 실제 로봇 조작 작업을 포함하며, 전문가 시연 데이터와 세밀한 평가용 주석 데이터를 제공한다. 전체 요약 6문장 읽기 → 005 21:11 당일 +247 바이두, 원샷 긴 문서 인식 'Unlimited OCR' 공개 바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. AI · 머신러닝 · baidu/Unlimited-OCR · Python
Key Point 한 번의 입력으로 문서 전체를 처리하는 새로운 OCR 방식이 주목받으면서, 기존 다중 단계 파싱의 한계를 극복하는 기술이 실제로 작동하는 방식을 알 수 있습니다.
핵심 요약
바이두가 Unlimited OCR을 공개했으며, 이는 DeepSeek-OCR을 한 단계 진전시킨 모델이다. 한 번의 입력으로 긴 텍스트 구간을 파싱하는 'One-shot Long-horizon Parsing' 방식을 도입했다. Hugging Face, ModelScope, Baidu Cloud 등에서 모델과 데모를 제공하고 있다. 전체 요약 7문장 읽기 → 006 00:11 ▲ 167 · 댓글 100 Claude Opus 5.5가 6시간에 그려낸 인터랙티브 도시 시각화 작성자는 Italo Calvino의 '보이지 않는 도시' 55개를 세계지도 형태로 시각화하는 작업을 GPT-6 Astra와 Claude Opus 5.5에 동일한 one-shot 프롬프트로 줬다. AI · 머신러닝 · I gave Opus 5.5 one prompt and six hours to visualize Invisible Cities
Key Point Claude Opus 5.5가 복잡한 인터랙티브 시각화를 단일 프롬프트로 생성하는 능력의 수준을 직접 테스트한 결과로, LLM이 데이터 시각화와 인터랙티브 디자인에 얼마나 실용적이 되었는지 보여준다.
핵심 요약
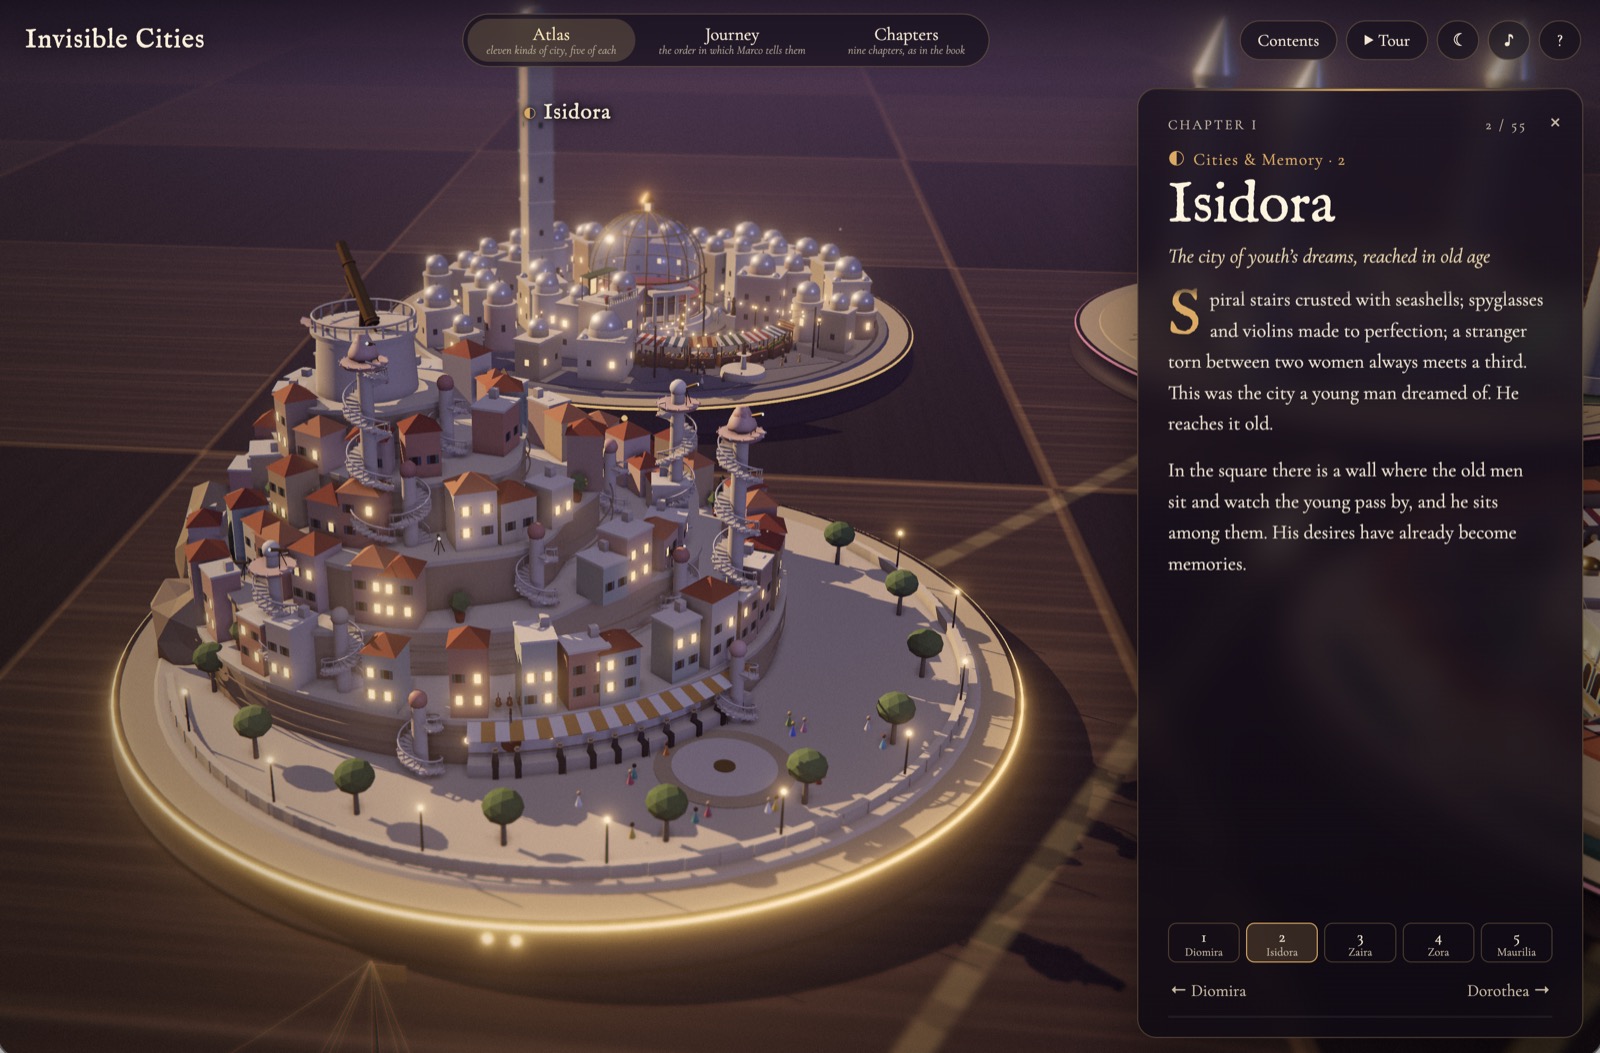
작성자는 Italo Calvino의 '보이지 않는 도시' 55개를 세계지도 형태로 시각화하는 작업을 GPT-6 Astra와 Claude Opus 5.5에 동일한 one-shot 프롬프트로 줬다. GPT-6 Astra는 53분에 약 $10의 API 비용으로 end-to-end 작동했지만, 불필요한 개념과 주석이 많아 시각적 노이즈가 있었고 Captain Obvious 식 설명이 있었다. Claude Opus 5.5는 지시대로 6시간을 모두 사용하지는 않았으나, 6개의 서브에이전트를 병렬로 실행하며 1시간 25분에 약 $74 비용으로 완성했다. 전체 요약 5문장 읽기 →