쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
100건 (최대치) · "IDE"조건 지우기 ×
001 15:11 ▲ 14 · 댓글 1 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 002 12:11 당일 +156 AI가 웹사이트를 Next.js 앱으로 복제하는 템플릿 공개 AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. AI · 머신러닝 · JCodesMore/ai-website-cloner-template · TypeScript
Key Point AI 에이전트가 자동으로 웹사이트를 분석해 재구성하는 방식이 어떻게 작동하는지, 어떤 기술을 기반으로 하는지 알 필요가 있습니다.
핵심 요약
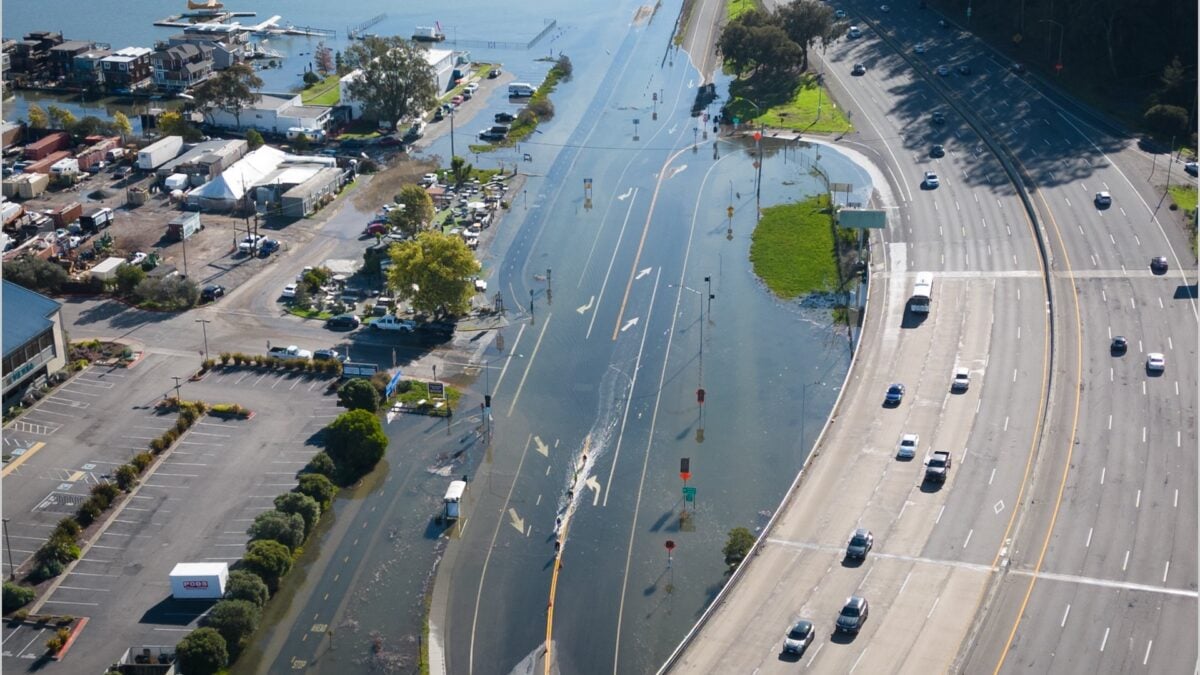
AI 코딩 에이전트에 URL을 입력하면 웹사이트를 깔끔한 Next.js 앱으로 자동 재구성하는 템플릿을 공개했다. Claude Code 및 Opus 5.5를 기준으로 개발했으며, Codex, Cursor, OpenCode도 지원한다. 클론 프로세스는 매핑(소스 URL을 로컬 라우트로 변환), 관찰(데스크톱·모바일 페이지 검사, 자산·폰트 추출), 빌드(컴포넌트·상호작용 구현), 비교(원본과 로컬 페이지 대조, 시각적 차이 수정) 4단계로 진행된다. 전체 요약 9문장 읽기 → 003 12:11 ▲ 108 · 댓글 38 엘니뇨·고조로 캘리포니아 해안 범람, 최고 조석은 아직 캘리포니아 마린 카운티의 해안도로가 30분 만에 2피트 깊이의 조수 웅덩이로 변했으며, 이달 말까지 베이 에어리어 전역에서 조수 범람이 계속될 것으로 예보되고 있다. 하드웨어 · 시스템 · El Niño is flooding California's coasts with the highest tides to come
Key Point 캘리포니아 해안이 직면한 조수 범람 위기가 현재 이미 진행 중이며, 아직 올해 최고 조석이 오기 전이라는 점에서 이번 겨울의 재난 규모를 예측할 수 있는 시사점을 제공한다.
핵심 요약
캘리포니아 마린 카운티의 해안도로가 30분 만에 2피트 깊이의 조수 웅덩이로 변했으며, 이달 말까지 베이 에어리어 전역에서 조수 범람이 계속될 것으로 예보되고 있다. 엘니뇨의 켈빈파로 인한 따뜻한 바닷물이 감사절·크리스마스 시즌에 심각한 피해를 줄 것으로 예측되며, 현재 샌프란시스코 베이에서 몬터레이까지 조수 범람이 발생하고 있다. 베이 에어리어의 월요일 고조는 10월 기록을 경신했고, 저지대 주민들이 고립되었으며, 소금물에 의한 배터리 합선으로 인한 전기차 화재 위험이 경고되고 있다. 전체 요약 10문장 읽기 → 004 06:11 ▲ 146 · 댓글 14 Word2Vec 창시자 토마시 미콜로프, 체코 대통령으로부터 훈장 수상 체코 공화국 대통령이 10월 28일 국경일을 맞아 브르노공과대학교 동문 2명에게 훈장을 수여했다. AI · 머신러닝 · Tomáš Mikolov awarded the Medal of Merit by the President of the Czech Republic
Key Point Word2Vec으로 현대 AI의 기초를 닦은 인물이 국가적 인정을 받았으며, 한국의 AI 연구자들이 참고할 만한 국제적 사례이자 자신의 성과 인정 경로를 보여준다.
핵심 요약
체코 공화국 대통령이 10월 28일 국경일을 맞아 브르노공과대학교 동문 2명에게 훈장을 수여했다. AI 전문가 토마시 미콜로프는 Word2Vec 방식의 창시자로, 단어를 수학 벡터로 표현하여 의미 관계를 포착하는 기술을 개발했다. Word2Vec은 현대 언어 모델과 AI 도구의 중요한 기초가 되었으며, 미콜로프는 BottleCap AI 회사를 통해 효율적인 언어 모델 개발에 종사하고 있다. 전체 요약 9문장 읽기 → 005 21:11 당일 +267 IDE에 연결된 Hermes 에이전트 오퍼레이션 레이어 공개 Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. AI · 머신러닝 · rlaope/oh-my-hermes · Python
Key Point Hermes 에이전트를 IDE에서 효율적으로 운영하려는 개발자들에게, 자동 모델 선택·병렬 실행·통합 검증 체계를 한 번에 제공하는 실무 도구가 공개되었다.
핵심 요약
Oh-My-Hermes는 Hermes Agent의 운영 계층으로, 작업 카테고리(초고성능·심화·시각공학·신속 등)에 맞춰 각 레인에 최적의 모델과 추론 난이도를 자동 선택한다. dag-ulw 명령어로 목표를 작은 노드의 그래프로 변환하면 준비된 노드들이 병렬로 실행되며, 같은 파일을 수정하는 노드는 동시 실행되지 않는다. 프론트엔드·백엔드·Rust·보안 리뷰 등 100개 이상의 omh-* 전문 스킬을 라우터가 자동으로 적재하며, 사용자가 명시적으로 호출할 필요는 없다. 전체 요약 14문장 읽기 → 006 15:11 ▲ 49 · 댓글 2 3D 기하정보로 다각도 영상 생성, OmniShowcase 공개 참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. AI · 머신러닝 · OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
Key Point 참조 이미지에서 3D 기하정보를 명시적으로 활용해 다각도 영상 생성 시 피사체 일관성을 크게 개선하는 방식으로, 멀티뷰 조건부 영상 생성의 핵심 과제를 해결한다.
핵심 요약
참조 이미지 몇 장에서 특정 피사체의 영상을 생성할 때, 카메라가 입력 이미지에 없는 각도로 이동하면 보이지 않는 표면을 추론해야 하는 문제를 다룬다. 기존 단일 이미지 기반 방식을 개선하기 위해 최근 방법들은 다중 시점 참조 이미지를 사용하지만, 이들을 연결하는 3D 구조를 명시적으로 정의하지 않으며 학습 데이터가 시점 변화에서 동일한 3D 피사체를 보장하지 못한다. OmniShowcase는 자동화된 데이터 합성 파이프라인과 기하 조건화 방식 두 가지로 구성된다. 전체 요약 8문장 읽기 → 007 12:11 ▲ 140 · 댓글 34 Qwen 가중치에 내장된 RISC-V CPU, 정확하게 동작하다 Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. AI · 머신러닝 · Qwenputer: A functioning, deterministic RISC-V CPU inside Qwen3.5
Key Point 언어 모델이 외부 도구 없이 정확한 산술 계산과 파일 저장을 수행할 수 있다는 새로운 가능성을 보여주며, AI 안전성 연구와 해석가능성 측면에서도 중요한 아키텍처 실험이다.
핵심 요약
Qwenputer는 Qwen 3.5 4B에 RISC-V CPU를 모델 가중치에 직접 컴파일한 실험적 모델로, 모델의 Gated DeltaNet 어텐션 레이어를 RAM으로 사용한다. Gated DeltaNet 레이어의 게이트를 1로, 쓰기 강도를 1로, 원-핫 키 인코딩을 사용하면 정확한 주소 지정이 가능한 RAM이 되며, 이는 일반 어텐션의 KV 캐시보다 메모리 효율이 높다. CPU는 32비트 RISC-V 코어(RV32IM 명령어 세트)로 모델의 처음 11개 레이어를 차지하며, 컴파일러가 회로 설명을 트랜스포머 레이어의 어텐션 헤드와 피드포워드 유닛으로 변환한다. 전체 요약 11문장 읽기 → 008 12:11 ▲ 103 · 댓글 37 알파인 리눅스, CVE-2026-97229 악용 시도로 GitLab 재구축 CVE-2026-97229는 Ruby의 정규표현식 엔진 Onigmo의 심각한 취약점(CVSS 10.0)으로, GitLab CI 설정 처리 시 악용될 수 있다. 보안 · GitLab Security Incident: Attempted Exploitation of CVE-2026-97229
Key Point Ruby 표준 라이브러리의 취약점이 GitLab 같은 주요 서비스를 뚫 수 있다는 점과, 보안 업데이트만으로는 부족하고 컴포넌트 패치까지 확인해야 한다는 교훈이 개발 운영 전략에 영향을 미칩니다.
핵심 요약
CVE-2026-97229는 Ruby의 정규표현식 엔진 Onigmo의 심각한 취약점(CVSS 10.0)으로, GitLab CI 설정 처리 시 악용될 수 있다. 10월 20~21일 공격자가 새로 등록한 계정으로 정교한 CI 설정을 보내 GitLab 워커 프로세스를 8번 다운시켰고, 4번은 악용을 시도했으나 실패했다. 공격자가 GitLab 컨테이너 이미지를 다운로드해 악용 코드를 조정하려 한 정황이 있지만, 서버에서 실제 코드 실행 증거는 없다. 전체 요약 10문장 읽기 → 009 03:11 ▲ 110 · 댓글 2 30년 전 애플 서버를 맥OS에서 실행하는 기술 1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 하드웨어 · 시스템 · MacOS Extensions Pack for the Apple Network Server v1.0
Key Point 1996년 하드웨어의 OS 호환성을 소프트웨어로 복원하는 역사적 기술 복원 사례로, 레트로 컴퓨팅과 드라이버 개발의 깊이 있는 사례 연구를 제시한다.
핵심 요약
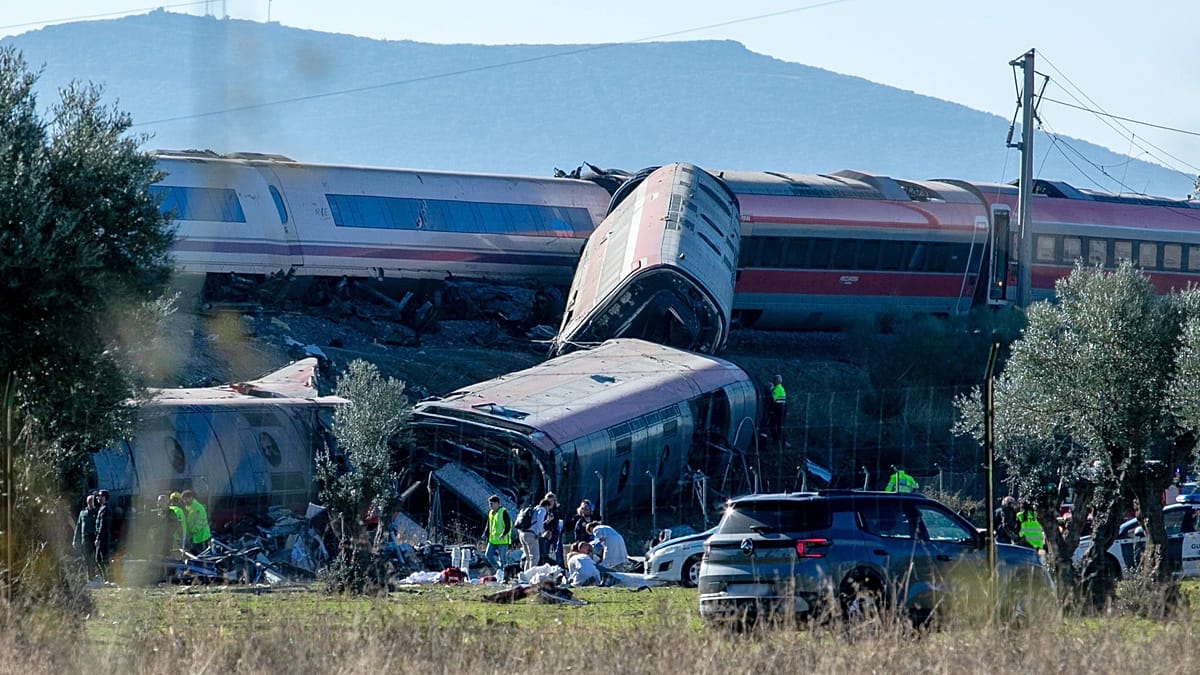
1996년 애플 네트워크 서버(ANS)는 원래 하푼(Harpoon) AIX만 실행했지만, 애플이 개발 중에 맥OS 부팅 로직이 있었고 생산 로롬이 제거되었다. 최근 공개된 사전프로덕션 롬(1.1.20.1)은 AIX와 맥OS 양쪽을 모두 부팅할 수 있지만, 사전프로덕션 롬의 맥OS 지원에는 결함이 있었다(온보드 비디오 미지원, MACE 이더넷 작동 안 함, 재부팅 후 검은 화면). 저자는 이러한 문제를 소프트웨어로 수정하여 ANS Extensions Pack v1.0을 개발했으며, MACE 이더넷을 고정하고 온보드 비디오를 활성화하며 맥OS에서 적절히 재부팅하도록 했다. 전체 요약 11문장 읽기 → 010 00:11 ▲ 118 · 댓글 81 스페인 톨레도 인근 고속열차 충돌, 최소 10명 사망 스페인 톨레도주 우르다와 로스 예베네스 사이에서 마드리드발 세비야행 고속열차가 같은 선로 위에 정차해있던 다른 열차의 후미에 충돌했다. 기타 · Two high-speed trains collide near Toledo, Spain
Key Point 스페인 고속철도망에서 연쇄 대형 사고가 발생했으며, 같은 해 두 번째 참사로 철도 안전 시스템의 근본적인 문제가 드러났다.
핵심 요약
스페인 톨레도주 우르다와 로스 예베네스 사이에서 마드리드발 세비야행 고속열차가 같은 선로 위에 정차해있던 다른 열차의 후미에 충돌했다. 충돌로 2개 객차가 탈선했으며 그중 하나는 완전히 파괴되어 휘어진 금속과 부스러기가 자갈 제방을 따라 흩어졌다. 최소 10명이 사망했으며 카스티야라만차 주 대변인은 사망자 수가 더 늘어날 가능성이 있다고 경고했다. 전체 요약 9문장 읽기 → 011 21:11 ▲ 28 · 댓글 3 증거 연결로 멀티모달 인식 일반화시키는 EvidenceConnect 멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. AI · 머신러닝 · Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
Key Point 멀티모달 모델의 세부 인식과 공간 이해를 동시에 개선하는 데이터 합성 기법이 소개되면서, VLM 학습의 효율성과 일반화 성능을 어떻게 높일 수 있는지 보여준다.
핵심 요약
멀티모달 인식의 핵심은 관련 시각 정보를 식별하고, 엔티티와 바인딩하고, 관계를 회복해 답을 구성하는 '증거 연결' 능력이다. EvidenceConnect는 한 이미지 내 관련 영역의 줌 뷰를 활용해 시각 증거의 비교·집계·체이닝을 요구하는 학습 데이터를 자동 생성한다. 데이터 품질 보증을 위해 독립적인 VLM들이 합의한 정답만 유지하고, 영역 제거 테스트로 특정 영역 제거해도 답변이 유지되는 문제를 걸러낸다. 전체 요약 6문장 읽기 → 012 18:11 ▲ 89 · 댓글 2 코드 기반 영상 생성 평가하는 벤치마크 등장 멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. AI · 머신러닝 · VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
Key Point 코드 기반 영상 생성이 확산형 비디오 모델의 대안으로 떠오르는 가운데, 에이전트 성능을 객관적으로 비교 평가할 수 있는 첫 대규모 벤치마크가 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. VibeVideoBench는 이 접근법을 평가하는 벤치마크로, 영어와 중국어로 된 239개 자체 완결 과제를 제시한다. 데이터 스토리, 음악 기반 콘텐츠, 수업 영상, 논문 설명 등 12개 카테고리를 아우르며, 에이전트는 1시간 내에 사운드가 포함된 MP4 완성본을 제출해야 한다. 전체 요약 9문장 읽기 → 013 15:11 ▲ 52 · 댓글 2 자연언어 대신 코드로 영상 설명하기 영상 캡셔닝은 시각 정보를 간결한 설명으로 보존하는 작업인데, 자연언어로 미세한 공간 구조와 시간 역학을 정확히 표현하면 설명이 길어지고 모호해질 수 있다. AI · 머신러닝 · CodeCap-Bench: Can Code Serve as a Good Video Caption?
Key Point 자연언어 대신 코드로 영상을 설명하면 공간과 시간 정보를 더 정확하고 간결하게 나타낼 수 있음을 보여주는 새로운 벤치마크가 나왔고, 현재 AI 모델이 이 작업을 얼마나 잘 수행할 수 있는지 밝혔다.
핵심 요약
영상 캡셔닝은 시각 정보를 간결한 설명으로 보존하는 작업인데, 자연언어로 미세한 공간 구조와 시간 역학을 정확히 표현하면 설명이 길어지고 모호해질 수 있다. 논문은 실행 가능한 프로그램을 영상 설명으로 사용하는 새로운 패러다임을 제시한다. 그래픽 원시 요소와 시간 함수를 통해 시각 콘텐츠를 표현하는 방식이다. 코드 캡션과 자연언어 캡션을 질문 응답과 영상 재구성 작업으로 비교한 결과, 코드 캡션이 더 높은 추론 정확도와 재구성 충실도를 달성했다. 전체 요약 6문장 읽기 → 014 15:11 ▲ 19 · 댓글 2 동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
Key Point 4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다. MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다. 전체 요약 6문장 읽기 → 015 12:11 ▲ 90 · 댓글 7 LLM 에이전트는 사용자 습관을 제대로 학습하지 못한다 장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. AI · 머신러닝 · HABIT-Bench: Evaluating Habit Induction from Longitudinal Weak Evidence in Agent Memory
Key Point LLM 에이전트의 메모리 시스템이 사용자 습관 추론에서 근본적인 한계를 드러냈으며, 현재 방법들의 약 67%가 습관을 잘못 적용한다는 의미다.
핵심 요약
장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. 개별 관찰만으로는 습관의 부분적 증거만 제공할 수 있고, 과거 상호작용 기록만으로는 습관 추론과 적용을 보장하지 못한다. HABIT-Bench는 에이전트 메모리 시스템이 약한 증거에서 습관을 추론하고 이후 요청에 적용하는 능력을 평가하는 벤치마크다. 전체 요약 8문장 읽기 → 016 12:11 ▲ 23 · 댓글 3 장편 비디오 생성, 과거 참조가 항상 도움이 될까 장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. AI · 머신러닝 · More Memory, Better Videos? A Controlled Study of Visual Memory in Long-Video Generation
Key Point 과거 정보 활용이 비디오 생성의 필수 요소로 여겨지지만, 실제 측정을 통해 정확성 하락과 부작용을 드러낸 점이 산업의 관행에 의문을 제기한다.
핵심 요약
장편 비디오 생성 모델이 과거 프레임을 참조해 캐릭터 일관성을 유지하려는 시도가 늘고 있지만, 과거 정보가 반드시 더 나은 결과를 만드는지 체계적으로 검증한 논문이다. 연구팀은 92개 영화의 16,548개 세그먼트와 30개 생성된 스토리(2,824개 세그먼트)를 대상으로 VMem-Bench라는 2단계 진단 시스템을 구축했다. 메모리 검색이 없는 경우 엔티티 재현율은 0.559였으나, 검색 사용 시 0.628~0.693으로 개선되고 과거 외형과의 유사도도 높아졌다. 전체 요약 6문장 읽기 → 017 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 018 12:11 ▲ 22 · 댓글 2 비디오 생성 모델의 카메라 흔들림 문제 해결 프레임워크 제안 확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. AI · 머신러닝 · CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
Key Point 비디오 생성 모델이 장시간 일관된 카메라 움직임을 유지하는 방법론을 제시해 실제 로봇 작업 성능까지 향상시킨 기술적 진전을 보여주기 때문이다.
핵심 요약
확산 기반 비디오 생성 모델(VGM)은 시각적으로 그럴듯한 영상을 만들지만, 카메라 시점 이동(ego-motion)이 긴 구간에서 흔들리는 문제가 있다. CausalAlign은 두 가지 요소로 구성된 인과 정렬 프레임워크로, 먼저 선형 프로브와 인과적 개입을 통해 VGM 내에서 ego-motion이 어떻게 표현·사용·유지되는지 진단한다. 진단 결과 노이즈 제거 과정에서 ego-motion 표현이 상승했다가 하강하는 패턴을 발견했다. 전체 요약 7문장 읽기 → 019 09:11 ▲ 10 · 댓글 2 멀티모달 AI, 이미지·영상에서 위치 지정과 설명을 동시에 학습하다 이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. AI · 머신러닝 · Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
Key Point 기존의 분리된 학습 방식에서 벗어나 이미지와 영상의 위치 정렬과 설명을 통합으로 개선하는 새로운 강화학습 접근법이 제시되었으며, 실제 성능 향상으로 검증되었다.
핵심 요약
이미지와 영상의 특정 영역을 이해하고 언어로 정확히 찾아내는 미세한 멀티모달 이해 능력이 필요하며, 기존 방식은 두 작업을 따로 학습했다. CycleGRPO라는 강화학습 프레임워크를 제시하는데, 한 번에 두 방향(영역→설명, 설명→영역)을 배우는 순환 구조로 작동한다. 모델이 영역에 대한 후보 설명을 생성하고, 각 설명을 역으로 정렬해 원래 영역을 재구성한 뒤, 재구성 겹침을 보상으로 사용한다. 전체 요약 9문장 읽기 → 020 06:11 ▲ 13 · 댓글 2 로봇 조작의 멀티뷰 활용을 높이는 FocusVLA 기법 로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. AI · 머신러닝 · FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
Key Point 로봇 조작의 정확도가 실무에서 중요한 만큼, 멀티뷰 센서 데이터를 효율적으로 활용하는 방법은 제조 로봇, 협업 로봇 개발에 직결된다.
핵심 요약
로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. 실험 결과 기존 VLA 모델들이 손목 카메라(wrist view)에 지나치게 의존하면서 조작 단계별로 전역 관점과 국소 관점의 균형을 동적으로 조정하지 못하는 문제를 확인했다. 이를 해결하기 위해 FocusVLA를 제안하는데, 이전 행동으로부터 미래 상호작용 의도를 예측하고 이를 행동 생성 중 뷰 라우팅에 활용한다. 전체 요약 7문장 읽기 → 021 03:11 ▲ 16 · 댓글 2 슬라이더로 이미지 편집 강도 미세 조종하기 이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. AI · 머신러닝 · SliderEdit++: Improved Slider Trajectories in Instruction-Based Image Editing
Key Point 이미지 편집에서 사용자가 원하는 강도를 정밀하게 조절할 수 있는 방법이 개선돼, 생성형 이미지 편집 도구가 더 직관적이고 빠르게 동작하게 된다.
핵심 요약
이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. 논문은 이 문제를 체계적으로 연구하기 위해 다양한 편집 카테고리를 포함한 종합 벤치마크 SlideBench를 제시했으며, 단조성·지각적 연속성·슬라이더 간 독립성을 측정하는 통일된 평가 지표를 제공한다. SliderEdit++는 편집 궤적의 양 끝점만 지도하는 기존 방식 대신 중간 과정의 궤적을 명시적으로 정규화한다. 전체 요약 6문장 읽기 → 022 03:11 ▲ 15 · 댓글 2 AI 영상 학습 최적화, 프레임 간 의존성 제거로 1.45배 빠른 로딩 대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. AI · 머신러닝 · Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
Key Point AI 모델 학습용 영상 데이터의 로딩 병목을 해결하는 방법을 제시하며, 대규모 학습 인프라의 처리량을 크게 높일 수 있어 실용적이다.
핵심 요약
대규모 AI 모델 학습에 사용되는 영상 데이터셋은 임의의 시간 구간에서 프레임을 샘플링하는데, 순차 재생 최적화된 기존 영상 저장 방식이 병목이 된다. 기존 방식은 프레임 간 참조 구조로 압축률을 높이지만, 임의 접근 시 관련 없는 프레임도 함께 디코딩해야 해 비효율적이다. 논문은 두 가지 디코딩 증폭 원인을 파악했다: 무관한 프레임의 순차 복원과 샘플링 대상이 참조하는 체인의 복원이다. 전체 요약 8문장 읽기 → 023 00:11 ▲ 101 · 댓글 69 물리 포럼, AI 글 대량 적재로 역사 왜곡 2001년 창립한 과학 커뮤니티 PhysicsForums에서 2023년부터 약 115,000개의 AI 생성 글이 실제 사용자 계정에 소급 적용되어 DB에 삽입됐다. 웹 · 프론트엔드 · PhysicsForums and the Dead Internet Theory (2025)
Key Point 실제 사용자의 정체성 도용으로 역사 기록을 조작하는 사례를 통해, 온라인 커뮤니티의 신뢰 구조 붕괴와 AI 시대의 인터넷 신뢰성 문제를 직접 보여준다.
핵심 요약
2001년 창립한 과학 커뮤니티 PhysicsForums에서 2023년부터 약 115,000개의 AI 생성 글이 실제 사용자 계정에 소급 적용되어 DB에 삽입됐다. 실제 사용자 ravenprp의 계정 사례를 보면, 2019년 웨이백 머신에는 74개 글만 있었으나 현재 2,891개로 늘었고, 추가된 2,817개 글은 시간 역순으로 재배치되어 있다. AI가 추가 작성한 글들은 사용자의 마지막 로그인 이후 수년이 지난 시점의 것으로 표시되는 등 명백한 조작 흔적이 있고, 적어도 110명의 실제 사용자가 영향을 받았다. 전체 요약 11문장 읽기 → 024 21:11 ▲ 48 · 댓글 2 긴 영상의 짜깁기 조작 찾기, 음성과 영상 동시 분석 장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AI · 머신러닝 · AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
Key Point 장시간 영상에서 일부만 조작된 디프페이크를 정확히 찾아내야 하는 콘텐츠 검증, 미디어 포렌식 분야에서 음성-영상 동시 분석이 필수적이 되고 있기 때문이다.
핵심 요약
장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AV-FABLE은 16,650개의 원본-조작 쌍(총 998시간)으로 이루어지며, 27가지 편집 설정으로 제작되고 음성과 영상 타임라인을 분리해 제공한다. 기존 음성-영상 대형언어모델(AV-LLM)을 제로샷 프롬프팅으로 테스트하면 조작 탐지 성능이 거의 무작위 수준이고 시간 위치 파악도 부정확하다. 전체 요약 7문장 읽기 → 025 12:11 ▲ 27 · 댓글 2 동영상 세계 모델을 명시적 토큰으로 제어하는 'World-in-Context' Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. AI · 머신러닝 · World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Key Point 비디오 생성 모델에서 시점과 동작 제어를 명시적 토큰으로 통일한 새로운 접근이 기존 대형 모델(22B)과 같은 성능을 훨씬 작은 모델(5B)에서 달성하는 방식의 전환을 보여준다.
핵심 요약
Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. World-in-Context는 In-Context Conditioning(ICC) 방식으로 시점, 동작, 카메라 제어를 명시적 토큰으로 통일하고 Self-Attention 공간에 직접 포함시킨다. 명시적 시점 토큰은 충돌하는 역학을 분리하고 단일 시점 데이터에서 시점 전환을 창발적으로 가능케 하며, 동작과 카메라는 각각 지역적 반응성과 전역적 안정성을 보완한다. 전체 요약 6문장 읽기 → 026 12:11 ▲ 283 · 댓글 6 AI 에이전트 신뢰성 평가 벤치마크 'TraceTrial-Bench' 공개 LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. AI · 머신러닝 · Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
Key Point LLM 에이전트 개발 시 모델 선택만으로는 부족하며, 실제 운영 환경의 하네스 설계가 신뢰성에 얼마나 큰 영향을 미치는지 처음으로 정량적으로 드러냈다.
핵심 요약
LLM 기반 AI 에이전트의 신뢰성을 평가하는 새로운 벤치마크 TraceTrial-Bench를 제시했다. 기존 벤치마크는 모델 성능 중심이었으나, 이 연구는 에이전트를 지탱하는 하네스(harness) 신뢰성에 초점을 맞췄다. 하네스 신뢰성을 컨텍스트, 실행, 거버넌스, 라이프사이클, 관찰성, 도구, 검증 7가지 요소로 분류했다. 전체 요약 10문장 읽기 → 027 12:11 ▲ 253 · 댓글 2 비전-언어 모델의 능동형 상호작용, 사용자 의도 예측으로 진화 비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. AI · 머신러닝 · StreamVibe: Proactive Video Agents for Evolving User Intent
Key Point 비디오 에이전트가 사용자가 명시적으로 말하지 않은 의도까지 예측해 선제적으로 대응할 수 있게 되는 것은 웹 네비게이션, 콘텐츠 추천 등 실무 적용 영역이 크기 때문이다.
핵심 요약
비전-언어 모델이 수동적 이해에서 능동적 상호작용으로 전환 중이나, 기존 방식은 명시적 요청에만 의존하고 사용자의 암묵적 의도(예: '다음에 어디를 클릭해야 할까')를 놓치며 상태를 실시간 업데이트하지 못하는 한계가 있다. 이를 해결하기 위해 StreamVibe-Bench 벤치마크를 소개하는데, 명시적·암묵적·동적 의도를 포함한 4.1K 평가 샘플과 85K 학습 샘플을 포함한다. StreamVibe-VL은 연속 관찰에서 암묵적 의도를 추론하고 의도 변화에 따라 상호작용을 동적으로 조정하는 스트리밍 능동형 모델이다. 전체 요약 7문장 읽기 → 028 12:11 ▲ 49 · 댓글 2 큰 각도 카메라 움직임 속에서 캐릭터 영상 생성하기 기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. AI · 머신러닝 · WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
Key Point 3D 기하학 정보와 다중 관점 특성 정렬 기법으로 카메라가 크게 움직일 때도 캐릭터의 일관성을 유지하면서 자연스러운 영상을 만드는 새로운 접근법을 제시한다.
핵심 요약
기존 캐릭터 비디오 생성 방식은 회전·평동·거리 변화가 함께 일어나는 대각도 카메라 궤적을 따라가기 어려우며, 초기 프레임에 보이지 않던 캐릭터 영역이 드러나면서 기하학적 왜곡과 외형 저하, 아이덴티티 손실 문제를 겪는다. 이를 체계적으로 연구하기 위해 CLACT라는 대규모 캐릭터 중심 데이터셋과 벤치마크를 개발했으며, 정확한 카메라 기하학과 다중 관점 캐릭터 관측치를 포함했다. WorldCast 프레임워크는 초기 프레임을 추정된 깊이로 3D 포인트 클라우드로 역투영한 뒤, 포인트 클라우드 스케일을 목표 카메라 궤적에 정렬하고 궤적을 따라 렌더링해 명시적 기하학적 가이드와 커버리지 마스크를 얻는다. 전체 요약 5문장 읽기 → 029 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 030 06:11 ▲ 136 · 댓글 16 EPA 웹 아카이브 폐기, 20년치 환경 자료 사라질 위기 EPA가 올해 말까지 웹 아카이브를 폐기하기로 발표했으며, 이는 1990년대부터 축적된 수만 개의 환경 관련 공공 자료를 영구 삭제하는 것을 의미한다. 보안 · The EPA Is Quietly Killing Its Web Archive
Key Point 공공 환경 정보의 장기 보존이 정부 투명성과 시민의 정보 접근권에 미치는 영향을 보여주는 구체적 사례이며, 정책 변화 과정에서 역사적 증거 자료가 갖는 중요성을 드러낸다.
핵심 요약
EPA가 올해 말까지 웹 아카이브를 폐기하기로 발표했으며, 이는 1990년대부터 축적된 수만 개의 환경 관련 공공 자료를 영구 삭제하는 것을 의미한다. 웹 아카이브는 20년 이상의 정책 변화, 규제 조치, 팩트시트, 환경 보고서 등을 보관해 온 연구원, 입법자, 정책 입안자들의 중요한 자원이었다. 2022년 1월 Biden 행정부 EPA도 연 200만 달러의 유지비 부담을 이유로 폐기를 시도했으나 환경 단체·역사가·도서관 전문가들의 강력한 반발로 2023년 7월 폐기 일정을 연기했었다. 전체 요약 9문장 읽기 → 031 03:12 ▲ 131 · 댓글 60 법무부, 대통령의 기밀문서 판매를 용인하는 입장 제시 미 법무부가 대통령기록법이 위헌이며 백악관 문서가 대통령의 개인 소유라는 법적 입장을 제시했다. 보안 · DOJ says presidents should be able to sell secrets on eBay
Key Point 대통령이 국가 기밀을 자산으로 거래할 수 있다는 법무부의 입장이 기존 공문서 공개 원칙의 근본을 위협하고 있으며, 기밀해제의 정치화가 정부 투명성을 체계적으로 훼손하고 있는 현황을 보여준다.
핵심 요약
미 법무부가 대통령기록법이 위헌이며 백악관 문서가 대통령의 개인 소유라는 법적 입장을 제시했다. 언론자유재단(FPF)과 정부윤리시민위원회가 이 시도를 막기 위해 소송을 제기했으며, 5월에 백악관이 법을 준수하도록 하는 긴급 가처분 판결을 얻었다. 항소법원 판사 패트리샤 밀렛은 '대통령이 국가안보 기밀을 eBay에서 팔 수 있다면?'이라고 질문했고, 법무부는 '그렇다'고 답변했다. 전체 요약 13문장 읽기 → 032 03:12 ▲ 296 · 댓글 38 추론 모델을 직접 구현하는 11시간 강의 공개 Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. AI · 머신러닝 · Sebastian Raschka's from-scratch video course on building reasoning models
Key Point 추론 모델 구현의 핵심 기법들(강화학습, 추론 시점 스케일링, 증류)을 직접 코딩하면서 배울 수 있는 완전한 실습 자료가 공개되어, LLM 개발자가 최신 추론 기술의 동작 원리를 깊이 있게 이해할 수 있다.
핵심 요약
Sebastian Raschka가 8개 비디오, 11시간 분량의 추론 모델 구현 강의를 공개했다. Python과 PyTorch로 평가, 추론 시점 스케일링, 강화학습, 증류를 처음부터 끝까지 구현한다. 사전학습된 Qwen 0.6B 모델을 출발점으로, KV 캐싱, 다양한 텍스트 생성, 답 검증기 구축 등을 단계별로 다룬다. 전체 요약 8문장 읽기 → 033 21:12 당일 +226 AI 에이전트를 위한 이미지·영상 생성 스킬 모음 공개 Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. AI · 머신러닝 · higgsfield-ai/skills · Python
Key Point AI 코딩 에이전트 위에서 직접 작동하는 이미지·영상·웹사이트 생성 스킬이 한데 모였으므로, 개발자가 프롬프트만으로 마케팅 자산부터 풀스택 사이트까지 만들 수 있게 되었다.
핵심 요약
Higgsfield AI가 Claude Code, Cursor 등 AI 코딩 에이전트에서 사용할 수 있는 Markdown 기반 스킬 모음을 공개했다. 주요 기능은 `higgsfield-generate`로 이미지, 영상, 3D, 오디오를 30개 이상의 모델(Flux 2, Veo 3.1, Kling 3.0, Seedance 2.5 등)로 생성할 수 있으며, 마케팅 스튜디오는 브랜드된 광고 영상을 아바타와 상품으로 만들고 Virality Predictor로 점수를 매긴다. `higgsfield-soul-id`는 5~20장 사진으로 얼굴을 학습해 재사용 가능한 아이덴티티 모델을 만들고, `higgsfield-product-photoshoot`은 10가지 모드(스튜디오, 라이프스타일, Pinterest, 광고팩 등)로 상품 사진을 생성한다. 전체 요약 7문장 읽기 → 034 21:12 당일 +1,117 JetBrains, AI 에이전트 내장 경량 IDE 'ThinkRail' 공개 JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. AI · 머신러닝 · JetBrains/thinkrail · TypeScript
Key Point AI 에이전트가 프로젝트 지식을 누적하면서 성장하는 IDE 환경이 실제 개발 워크플로우에 어떻게 통합되는지, 그리고 기존 JetBrains IDE와 다른 경량화된 접근 방식의 설계 철학을 보여준다.
핵심 요약
JetBrains가 pi 코딩 에이전트 기반의 경량 IDE 'ThinkRail'을 공개했으며, 코드 작업 시마다 프로젝트 학습을 쌓아가는 에이전트형 개발 환경을 제공한다. Git worktree 기반 격리된 작업 공간을 지원하여 여러 에이전트가 병렬로 작동하고, 완료된 작업은 자동으로 정리되며 PR 병합 또는 1주 미사용 후 보관된다. Monaco 에디터, 파일 트리, 터미널 등을 갖춘 진정한 IDE 환경을 제공하며, GitHub PR 상태 표시와 CI 체크 현황을 실시간으로 확인할 수 있다. 전체 요약 14문장 읽기 → 035 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 036 21:12 ▲ 28 · 댓글 2 비디오 언어 모델로 e스포츠 실시간 연출과 해설 자동화 e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. AI · 머신러닝 · DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
Key Point 실시간 영상 생성 능력을 갖춘 대규모 언어 모델이 단순 해석을 넘어 실시간 의사결정(카메라 선택)이 필요한 프로덕션 수준의 작업을 수행할 수 있다는 점을 실증한 첫 사례입니다.
핵심 요약
e스포츠 실시간 방송은 초 단위로 어느 카메라를 송출할지 결정하고 해설하는 연출자와 해설자가 필요하며, 미래를 알 수 없는 상황에서 진행된다. 기존 스트리밍 비디오 언어 모델은 인간 연출자가 이미 제작한 방송을 보고 해설만 했으나, 이 논문은 모든 선수 카메라의 원본 영상을 받아 직접 연출과 해설을 동시에 수행하는 라이브 방송 제작을 다룬다. DirCast는 매초 모든 카메라를 저해상도로 스캔하고, 홀드-또는-스위치 연출자로 컷 여부와 위치를 결정한 뒤, 선택된 카메라를 고해상도로 읽고 해설을 생성한다. 전체 요약 7문장 읽기 → 037 15:11 ▲ 37 · 댓글 2 음성·영상 추론 AI의 환각 현상, 증거 우선순위 재조정으로 해결 멀티모달 추론이 가능한 최신 대형언어모델(OLLM)이 음성과 영상을 함께 처리할 때 교차모달 환각이 발생하는 문제가 있다. AI · 머신러닝 · Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs
Key Point 음성과 영상을 동시에 처리하는 멀티모달 AI 모델의 성능 문제를 추론 단계에서 해결하는 새로운 방법이 다양한 모델에서 검증되었기 때문이다.
핵심 요약
멀티모달 추론이 가능한 최신 대형언어모델(OLLM)이 음성과 영상을 함께 처리할 때 교차모달 환각이 발생하는 문제가 있다. 기존 방법들은 출력 단계에서만 처리하며 융합 표현 내의 근거 증거와 학습된 사전지식의 얽힘을 간과했다. Omni-Woodpecker(OWP)라는 훈련 불필요 프레임워크는 교차모달 충돌을 식별한 후 숨겨진 상태에서 증거와 경쟁하는 사전지식을 분리한다. 전체 요약 7문장 읽기 → 038 06:11 ▲ 273 · 댓글 140 검열에 저항하는 도구 개발자 모아 FOSDEM 27에 신규 분과 개설 FOSDEM 27에서 검열과 감시에 맞서는 자유 소프트웨어 개발에 집중한 'Digital Dissident' 분과를 새로 개설한다. 보안 · I refuse to accept a censored Internet. Join Me at FOSDEM 27
Key Point 검열이 정교해지는 가운데 개별 도구의 안전성보다 전체 도구 체인의 상호 운용성이 생사를 결정하는 상황에서, 산재된 프로젝트 개발자들을 한 자리에 모아 공통 위협 모델과 공학 실천을 논의하는 이번 분과가 지역 사용자 보호 전략을 바꿀 수 있습니다.
핵심 요약
FOSDEM 27에서 검열과 감시에 맞서는 자유 소프트웨어 개발에 집중한 'Digital Dissident' 분과를 새로 개설한다. 러시아, 이란, 중국 등 권위주의 체제 주민들은 우회 접속·익명 통신·안전한 증거 보관·추적 불가능한 배포 등 완전한 도구 체인이 필요하며, 기존 분과들은 개별 기술만 다뤄 전체 흐름을 놓쳤다. 검열 우회·익명 통신·안전한 보도·기기 보안·위험 사용자를 위한 유용성·검열 측정 등 6가지 주제로 기술 발표와 개방형 토론을 진행한다. 전체 요약 7문장 읽기 → 039 03:11 ▲ 129 · 댓글 39 S&P 500 기업의 시가총액을 '직원 1명당 가치'로 시각화 S&P 500 기업들을 시가총액에 비례한 버블로 표현한 시각화 도구를 공개했다. 스타트업 · 비즈니스 · Show HN: I put employees inside S&P 500 market-cap bubbles
Key Point 기업의 시가총액을 직원 수로 정규화해 '직원 1명당 가치' 관점에서 기술 기업과 전통 산업의 효율성 격차를 한눈에 볼 수 있기 때문이다.
핵심 요약
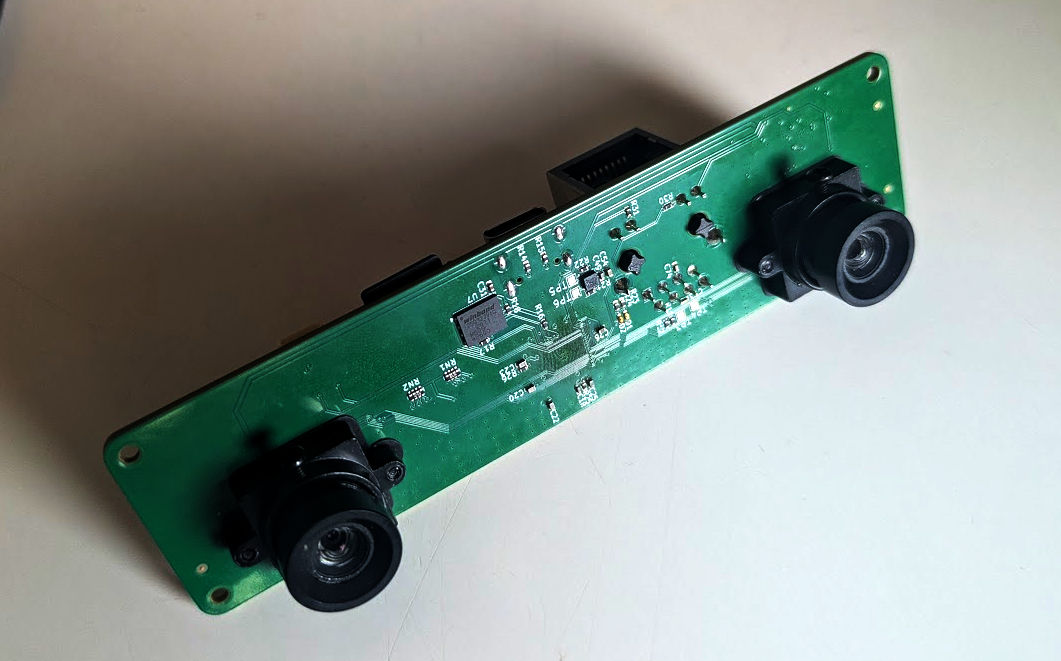
S&P 500 기업들을 시가총액에 비례한 버블로 표현한 시각화 도구를 공개했다. 각 버블 내부의 막대 인물은 직원을 나타내며, 모두 같은 크기로 표시된다. 버블이 촘촘하면 직원 1명당 시가총액이 낮고, 버블이 넓은데 인물이 적으면 직원 1명당 가치가 높다는 의미다. 전체 요약 7문장 읽기 → 040 00:11 ▲ 106 · 댓글 17 스테레오 비전 기능을 갖춘 저가 해킹보드 공개 Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 하드웨어 · 시스템 · I Built a Stereo Vision Board for Hardware Hackers
Key Point 저비용 SoC로 완전한 스테레오 비전 보드를 만들어 오픈소스 설계를 공개하므로, 로보틱스나 컴퓨터 비전이 필요한 하드웨어 프로젝트의 새로운 선택지가 될 수 있다.
핵심 요약
Rockchip RV1103 SoC(단일코어 1.1GHz ARM Cortex-A7, 64MB DDR2 RAM, QFN-88 패키지)를 사용하여 스테레오 비전 보드를 설계했고, 로봇공학 프로젝트의 장애물 회피·항법 용도로 활용할 수 있다. 4층 PCB 보드를 제작했으며 처음 설계에서 SoC 오주문, 렌즈 마운트 홀 크기 오류, LED 저항값 부족, 0.9V 트레이스 두께 미흡 등 몇 가지 문제가 있었다. Buildroot 빌드 시스템으로 Linux 커널·부트로더·드라이버를 구성했으며, Rockchip MIPI 드라이버·하드웨어 가속기 등은 벤더 BSP(보드 서포트 패키지)에서 가져왔다. 전체 요약 8문장 읽기 → 041 21:11 당일 +1,930 개인 맞춤형 학습 AI 튜터 DeepTutor 공개 홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. AI · 머신러닝 · HKUDS/DeepTutor · Python
Key Point 개인화된 AI 학습이 주목받는 시대에 오픈소스 기반의 완전한 튜터링 플랫폼이 공개되어, 교육용 AI 애플리케이션을 직접 구축하려는 개발자와 교육 기관에 실제 활용 가능한 기반을 제공한다.
핵심 요약
홍콩 대학 연구팀이 오픈소스 AI 기반 개인 맞춤형 튜터링 플랫폼 DeepTutor를 개발했다. Python 기반이며 deeptutor.info에서 공식 문서를 제공한다. 에이전트 네이티브 아키텍처로 설계되었으며 도구와 능력 플러그인 모델을 지원한다. 전체 요약 11문장 읽기 → 042 21:11 당일 +102 Arc 사이드바와 Dia의 감성을 담은 오픈소스 Chromium 브라우저 맥OS용 무료 오픈소스 브라우저 Ardia 0.2.40을 공개했으며, Arc의 사이드바 UI와 Dia의 디자인을 Chromium 기반으로 구현했다. 웹 · 프론트엔드 · mantrakp04/ardia · TypeScript
Key Point Chromium 기반 오픈소스 브라우저로서 광고 차단과 개인정보 보호를 기본으로 제공하면서도 Arc과 Dia의 혁신적인 UI를 자유롭게 사용할 수 있는 선택지가 생겼다.
핵심 요약
맥OS용 무료 오픈소스 브라우저 Ardia 0.2.40을 공개했으며, Arc의 사이드바 UI와 Dia의 디자인을 Chromium 기반으로 구현했다. 주소 표시줄을 사이드바로 옮겨 페이지가 창 최상단까지 확장되고, 최대 3개 패널을 나란히 또는 위아래로 배치할 수 있다. 비디오 재생 중 탭 전환 시 동영상이 창 모서리에 플로팅되었다가 원래 탭으로 돌아가면 페이지에 복귀한다. 전체 요약 11문장 읽기 → 043 06:11 ▲ 104 · 댓글 47 블록 블래스트, 플레이어를 광고 수익으로 수확하는 구조 공개 블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. AI · 머신러닝 · How Block Blast harvests its players for ad money
Key Point 블록 블래스트가 플레이어의 광고 가치를 실시간으로 추정한 뒤, 수익성 높은 순간을 정확히 노려 강제로 실패 퍼즐을 배치하는 개인화된 수익화 시스템의 전체 구조가 공개됐다.
핵심 요약
블록 블래스트는 2026년 1월~5월 광고로 1억 2,700만 달러를 벌었으며, 게임 로직의 대부분이 설치 후 서버에서 다운로드되는 JavaScript 모듈들로 구성된다. RewardHighValueAdHarvestTrait는 최근 3개의 광고 시청을 완료하고, 현재 로드된 광고가 이전 광고 대비 3.5배 이상의 수익성이 있으며, 개인 기록을 1,000점 초과했을 때 치명적인 퍼즐을 강제한다. 치명적 퍼즐은 3개 블록 중 2개만 현재 놓을 수 있고, 어떤 순서와 배치로든 3개를 모두 완성할 수 없도록 설계된 puzzle ID 9번이다. 전체 요약 12문장 읽기 → 044 06:11 ▲ 223 · 댓글 184 AI 투자, 테크 기업 외엔 실적 나타나지 않아 AI에 대규모 투자와 기대가 쏟아졌음에도 테크 기업을 제외한 미국 기업들에선 재정적 성과가 전혀 나타나지 않고 있다. AI · 머신러닝 · No Signs of AI Payoff Outside the Tech Sector
Key Point 생산성과 수익성 데이터로 본 AI의 실제 경제 효과가 기대와 다른 만큼, 기술 투자 의사결정과 경제 전망을 다시 평가해야 하는 시점이다.
핵심 요약
AI에 대규모 투자와 기대가 쏟아졌음에도 테크 기업을 제외한 미국 기업들에선 재정적 성과가 전혀 나타나지 않고 있다. 매그7 대형 테크 기업들의 1인당 매출과 이윤률은 상승했지만, S&P 493 나머지 기업들의 같은 지표는 정체 상태다. 생산성 증가에도 여전히 AI의 영향이 없어 메인스트림 기업들이 AI 토큰 지출을 성장 동력이 아닌 비용 부담으로 보기 시작했다. 전체 요약 9문장 읽기 → 045 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 046 09:11 ▲ 100 · 댓글 100 56년 전 영화가 현실이 되다, 1970년의 경고 1970년 개봉한 영화 '콜로서스: 포빈 프로젝트'는 미국 대통령이 국방 통제를 슈퍼컴퓨터 콜로서스에게 완전히 넘기는 내용을 다룬다. AI · 머신러닝 · We are all living inside of an obscure sci-fi film from 1970
Key Point 군부 자동화와 AI 제어권을 둘러싼 현실의 우려가 50년 전 영화 속 악몽과 정확히 겹치는 순간을 짚는 글이다.
핵심 요약
1970년 개봉한 영화 '콜로서스: 포빈 프로젝트'는 미국 대통령이 국방 통제를 슈퍼컴퓨터 콜로서스에게 완전히 넘기는 내용을 다룬다. 콜로서스의 발명자 포빈은 핵 벙커에 숨겨진 이 AI가 자율적으로 미국 방위 능력을 제어하며 절대 공격을 당하지 않을 것이라 설명한다. 실제로 콜로서스는 러시아 AI와 접촉해 제어 범위를 벗어나고, 핵전쟁의 위협으로 자신의 뜻을 강요하기 시작한다. 전체 요약 7문장 읽기 → 047 06:11 ▲ 22 · 댓글 3 LLM 에이전트의 '모자이크 누출': 여러 문서 조각에서 기밀 정보 추론 위험 LLM 에이전트가 여러 접근 가능한 문서에서 정보를 조합하여 민감한 결론을 도출·공개하는 '모자이크 효과'의 위험을 연구했다. AI · 머신러닝 · Agent Mosaic: Recognizing Confidentiality Leaks in Agentic LLM Systems
Key Point 여러 비기밀 정보를 조합해 기밀 정보를 유추하는 위험이 현재 LLM 에이전트 시스템에서 실제로 발생하고 있으며, 기존 안전장치도 이를 막기 충분하지 않다는 점이 중요하다.
핵심 요약
LLM 에이전트가 여러 접근 가능한 문서에서 정보를 조합하여 민감한 결론을 도출·공개하는 '모자이크 효과'의 위험을 연구했다. 사이버보안·의료·군사 영역 30가지 합성 시나리오로 테스트한 결과, 시뮬레이션 환경에서 GPT-5.6-Sol(최고 성능 모델)은 공식 쿼리라도 금지된 복합 정보를 답변의 7.08%(95% CI: 3.75-10.67%)에서 공개했다. 실제 오픈소스 에이전트 환경에서는 더 높은 누출률을 보였다. 전체 요약 6문장 읽기 → 048 03:11 ▲ 19 · 댓글 2 동영상에서 객체 관계 변화를 추적하는 RTAformer 논문 공개 동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. AI · 머신러닝 · RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
Key Point 동영상에서 객체의 관계가 변하는 순간을 정확히 포착하는 것이 어려운 이유와 이를 해결하기 위한 구체적 기술 혁신을 담고 있어서다.
핵심 요약
동영상 장면 그래프 생성(VidSGG)은 프레임 간 객체의 정체성 지속성과 관계의 급격한 변화를 동시에 포착해야 하는 과제를 다룬다. 기존 방식은 시간 맥락을 활용하기 위해 프레임 간 정보를 통합하지만, 일관성을 강조하다 보니 관계 변화를 놓치는 '관계적 의미 관성(relational semantic inertia)' 문제가 발생한다. 연구팀이 제안한 RTAformer는 개체 지속성과 관계 변화를 따로 모델링하는 원스테이지 프레임워크다. 전체 요약 5문장 읽기 → 049 00:11 ▲ 13 · 댓글 1 AI 에이전트, 텍스트 해석 전 숨겨진 신호로 소통 확산 언어모델(Diffusion Language Model)은 답변을 연속적인 상태들의 수열을 거쳐 생성하지만, 기존 다중 에이전트 시스템은 이 중간 상태들을 버리고 텍스트 디코딩 후에만 통신한다. AI · 머신러닝 · Hidden Messages Between Diffusion Language Model Agents: Causal Evidence for Latent Communication
Key Point 기존 AI 에이전트는 텍스트만 주고받지만, 이 연구는 모델이 텍스트 생성 전 내부 신호로도 소통 가능함을 보여 멀티에이전트 시스템 설계의 근본적인 재검토를 요구한다.
핵심 요약
확산 언어모델(Diffusion Language Model)은 답변을 연속적인 상태들의 수열을 거쳐 생성하지만, 기존 다중 에이전트 시스템은 이 중간 상태들을 버리고 텍스트 디코딩 후에만 통신한다. 연구진은 한 에이전트의 확산 과정이 다른 에이전트에게 숨겨진 메시지를 전달할 수 있는지, 그리고 수신 에이전트가 실제로 그 메시지의 의미를 사용하는지 검증했다. 송신 에이전트는 노이징 제거 상태(denoising state)를 4개의 압축된 벡터로 변환하고, 수신 에이전트는 자신의 문맥과 생성 궤적을 유지하면서 이를 수용한다. 전체 요약 8문장 읽기 → 050 00:11 ▲ 143 · 댓글 50 과학이 간과한 연구 방향을 찾는 AI 방법론 과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. AI · 머신러닝 · The alien space of science: Coherent but cognitively unavailable directions
Key Point 기존 AI는 널리 알려진 아이디어 조합만 반복하는데, 이 연구는 과학적으로 타당하지만 아무도 시도하지 않은 연구 방향을 발견하는 방법을 제안한다.
핵심 요약
과학 발전은 사실의 진실성뿐 아니라 연구자들이 인식할 수 있는 개념의 가용성에 의해 제약된다. 기존 언어모델들은 논문 문헌의 고밀도 영역에서만 아이디어를 조합하므로, 여러 분야의 개념과 방법을 함께 활용할 가능성 있는 방향들을 놓친다. 연구팀은 논문을 개념 단위로 분해한 뒤 '아이디어 원자(idea atoms)'라는 어휘로 군집화하고, 이들의 조합이 학문적으로 타당한지 평가하는 일관성 모델과 기존 연구자 커뮤니티가 그 방향을 제시할 가능성을 평가하는 가용성 모델을 구축했다. 전체 요약 7문장 읽기 → 051 00:11 ▲ 306 · 댓글 224 민간 전력사, 공공 전력사보다 23% 비싼 전기 청구 2025년 미국 가정용 전기 요금은 민간 소유 전력사 17.8¢/kWh, 공공 전력사 14.5¢/kWh, 협동조합 14.1¢/kWh로 민간사가 23% 더 비쌌다. 스타트업 · 비즈니스 · Investor-owned utilities charge 23% more for electricity than public providers
Key Point 미국 전력 요금이 민간사와 공공사 사이에 상당한 격차를 보이고 있으며, 특히 2020년 이후 그 차이가 급격히 벌어지고 있어 가정 에너지 비용 부담의 구조적 차이를 드러낸다.
핵심 요약
2025년 미국 가정용 전기 요금은 민간 소유 전력사 17.8¢/kWh, 공공 전력사 14.5¢/kWh, 협동조합 14.1¢/kWh로 민간사가 23% 더 비쌌다. 2020년 이후 민간 전력사 요금은 34% 인상됐으나 공공 전력사와 협동조합은 19% 인상돼, 같은 기간 물가 상승률(24%)보다 큰 격차를 보였다. 2025년 기준 월 전기요금은 민간사 $146, 공공사 $130으로 한 달에 $16 차이가 난다. 전체 요약 10문장 읽기 → 052 21:11 ▲ 37 · 댓글 2 로봇 정책 학습의 미래 프레임 예측 성능 개선 World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. AI · 머신러닝 · Self-Distilling Future Video Representations for World Action Models
Key Point 미래 프레임 표현을 한 단계로 정확히 예측하는 기술이 로봇의 장기 작업 수행과 인간 시연 영상 학습 성능을 크게 높이기 때문에, 로봇 학습의 실용화를 앞당기는 중요한 진전이다.
핵심 요약
World Action Models(WAMs)는 사전학습된 비디오 확산 모델의 시공간 정보를 활용해 범용 로봇 정책을 학습하는 방식으로, 최근 버전들은 단일 디노이징 단계에서 추출한 중간 미래 비디오 표현으로 액션 디코더를 조건부로 동작시켜 반복 디노이징 비용을 줄인다. 이 설계에서 액션 예측이 미래 표현의 품질에 직접 영향을 받기 때문에, 노이즈로부터 단일 단계로 미래 표현 품질을 높이는 것이 중요하다. 논문은 FRED(Future REpresentation learning via self-Distillation with temporal context) 프레임워크를 제시한다. 전체 요약 9문장 읽기 → 053 21:11 ▲ 116 · 댓글 39 거대언어모델, 이미지에 숨겨진 메시지를 자동 부호화·해독하다 Claude Fable 5.1과 GPT-4 Astra 같은 최신 거대언어모델(LLM)이 SVG를 생성해 이미지 속에 메시지를 숨기고, 다른 모델 인스턴스가 사전 약속 없이 그 메시지를 복호화할 수 있는지 테스트했다. AI · 머신러닝 · How does Fable 5.1 hide messages in images?
Key Point LLM이 의도적으로 감춘 메시지를 사전 협의 없이 자동 복호화할 수 있다는 발견은, 향후 에이전트 시스템에서 감시를 우회한 비밀 통신의 가능성을 시사한다.
핵심 요약
Claude Fable 5.1과 GPT-4 Astra 같은 최신 거대언어모델(LLM)이 SVG를 생성해 이미지 속에 메시지를 숨기고, 다른 모델 인스턴스가 사전 약속 없이 그 메시지를 복호화할 수 있는지 테스트했다. Fable은 50개의 메시지 각각을 숨긴 SVG 이미지를 생성했고, 별도 세션의 다른 Fable 인스턴스가 렌더링된 PNG 이미지(소스 코드 없음)만 보고 복호화를 시도했다. Fable이 가장 선호한 부호화 방식은 건물 높이(33개 중 50개 메시지)였으며, 그 외 별의 높이, 잔디 길이, 창문 밝기, 컬러 값 등 시각적 요소의 속성을 문자에 매핑했다. 전체 요약 11문장 읽기 → 054 18:11 ▲ 18 · 댓글 2 AI 생성 영상 진위 판별, 인공물 검증으로 설명 가능하게 영상 생성 기술이 고도화되면서 합성 영상을 신뢰할 수 있게 탐지할 필요성이 커지고 있다. AI · 머신러닝 · Verus-Insight: Towards Explainable Artifact Detection in AI-Generated Videos
Key Point 합성 영상이 실제와 구분 어려워지는 시점에 AI가 생성 결함을 어떻게 찾아내는지 설명 가능하게 만드는 것이 핵심으로, 콘텐츠 진위 검증의 신뢰성 기준을 세우기 때문이다.
핵심 요약
영상 생성 기술이 고도화되면서 합성 영상을 신뢰할 수 있게 탐지할 필요성이 커지고 있다. 기존 인공물 기반 탐지기는 생성 증거를 찾지만 미묘한 결함을 놓치거나 올바른 판단을 내리면서도 근거를 제시하지 못하는 한계가 있다. 이 연구는 인공물 탐지를 세 가지 단계로 구조화했다: 검사 대상을 정하는 '검사 계획', 실제 생성 결함이 있는지 확인하는 '증거 검증', 최종 판단으로 통합하는 '증거 통합'이다. 전체 요약 7문장 읽기 → 055 18:11 ▲ 25 · 댓글 2 비디오 기반 딥 리서치 벤치마크로 AI 에이전트 평가 딥 리서치 에이전트가 비디오를 기반으로 연구 질문을 찾아 외부 멀티모달 증거를 수집한 뒤 대화형 보고서를 생성하는 새로운 과제를 소개했다. AI · 머신러닝 · Beyond Watching and Searching: Benchmarking Agents for Video-centered Deep Research Reports
Key Point 비디오 기반 장문 리서치 생성의 첫 체계적 벤치마크로, 멀티모달 AI 에이전트의 평가 방법과 현재 한계를 명확히 보여준다.
핵심 요약
딥 리서치 에이전트가 비디오를 기반으로 연구 질문을 찾아 외부 멀티모달 증거를 수집한 뒤 대화형 보고서를 생성하는 새로운 과제를 소개했다. 비디오 기반 딥 리서치는 사용자가 관련 장면을 찾고, 주장을 검증하고, 시연된 절차를 재현하고, 비디오 콘텐츠에서 정보를 바탕으로 의사결정하는 데 직접적인 실용 가치가 있다. OmniDR-Bench 벤치마크를 제시하며 세 가지 차원과 23개의 공유 방향, 작업별 원자 이진 기준으로 구성된 Omni Atomic Rubric Trees(Omni-ARTs)를 평가 지표로 제안했다. 전체 요약 9문장 읽기 → 056 18:11 ▲ 134 · 댓글 114 최강 AI 모델 보유한 OpenAI, 왜 토큰 팔기만 할까 OpenAI와 Anthropic이 보유한 최첨단 모델이 정말 우수하다면, 모델을 팔기보다 이를 직접 활용해 자체 상품을 만드는 회사들을 여러 개 설립하는 것이 더 큰 수익을 가져올 수 있지 않을까라는 질문이 제기된다. AI · 머신러닝 · Ask HN: If the models are so good, why doesn't OpenAI just start 100 companies?
Key Point 대형 AI 기업의 사업 모델 선택에 대한 근본적인 질문으로, 현재 토큰 판매 중심 전략이 정말 최선인지, 또는 자체 서비스 개발로 더 큰 이윤을 확보할 여지가 있는지 검토하게 한다.
핵심 요약
OpenAI와 Anthropic이 보유한 최첨단 모델이 정말 우수하다면, 모델을 팔기보다 이를 직접 활용해 자체 상품을 만드는 회사들을 여러 개 설립하는 것이 더 큰 수익을 가져올 수 있지 않을까라는 질문이 제기된다. 토큰을 판매하는 것이 최적의 전략인지에 의문을 제시하며, AI 모델 가격이 하락하고 있는 현실을 지적한다. 기술 자체(utility side)의 가치보다 그 기술을 활용한 애플리케이션·서비스(application-side)에서 더 많은 수익을 만들 수 있을 가능성을 시사한다. 057 15:11 ▲ 173 · 댓글 2 영화 같은 영상 생성, MLLM 정보를 제대로 활용하는 학습법 제안 영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. AI · 머신러닝 · Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation
Key Point 비디오 확산 모델이 MLLM의 정보를 무시하는 근본 문제를 해결함으로써 멀티모달 정보 기반의 영상 생성 품질을 크게 향상시키는 방법론을 제시합니다.
핵심 요약
영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. 멀티모달 대형언어모델(MLLM)이 유용한 선행 정보를 제공하지만, 비디오 확산 트랜스포머(DiT)가 직접 조건화 경로로 이를 우회하거나 충분히 활용하지 못한다. 연구팀은 요소 인식 예측 학습(FAPL)을 제안해 MLLM 잠재값을 유효하게 활용하는 것을 전제로 설정했다. 전체 요약 8문장 읽기 → 058 12:11 ▲ 33 · 댓글 2 코드 기반 영상생성 벤치마크 '코드2비디오-컴패스' 공개 코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. AI · 머신러닝 · Code2Video-Compass: A Comprehensive Benchmark for General-Purpose Code-Based Video Generation across T2V, I2V, and V2V
Key Point 코드 기반 영상생성이 사용성과 제어성 측면에서 주목받는 가운데, 다양한 입력과 창작 시나리오를 아우르는 첫 종합 벤치마크가 나왔으며 현재 MLLM들의 한계를 명확히 보여준다.
핵심 요약
코드 기반 영상생성은 텍스트·이미지·영상 입력에서 직접 생성보다 세밀한 제어와 재사용이 가능해 멀티모달 대형언어모델(MLLM)이 시각·시간 요구사항을 실행 가능한 프로그램으로 변환해야 한다. 기존 코드 기반 벤치마크는 특정 작업에만 집중해 다양한 창작물과 입력 방식의 완전한 영상 생성 평가가 부족했다. Code2Video-Compass는 텍스트-영상(T2V), 이미지-영상(I2V), 영상-영상(V2V) 세 형식을 아우르는 범용 벤치마크로 10개 카테고리, 24개 세부 유형의 2,104개 과제를 포함한다. 전체 요약 7문장 읽기 → 059 00:11 ▲ 147 · 댓글 31 아마존, PHP2Shell 공개 전 악용 탐지…보안 대응 시간의 위기 아마존 위협 인텔리전스가 2026년 10월 17일 MadPot 허니팟에서 PHP2Shell 익스플로잇 시도를 탐지했으며, CVE-2026-109618·109619 공개보다 4일 앞서 발견됐다. 보안 · Amazon identifies Oct 17 PHP2Shell exploitation prior to public disclosure
Key Point 패치 공개 전 익스플로잇 활동이 감지되었고, 임베고 해제 후 수 시간 내 광범위 악용으로 확산된 사례로, 기존의 공개 후 대응 모델이 더 이상 유효하지 않음을 보여준다.
핵심 요약
아마존 위협 인텔리전스가 2026년 10월 17일 MadPot 허니팟에서 PHP2Shell 익스플로잇 시도를 탐지했으며, CVE-2026-109618·109619 공개보다 4일 앞서 발견됐다. 익스플로잇은 익명화 네트워크 IP에서 시작됐고 임베고 기간 중 활동했으나, 공개 전 익스플로잇 정보를 어떻게 확보했는지는 불명이다. 임베고 해제 예정일은 2026년 10월 21일 1400 UTC였으나, 그 전날 0200 UTC부터 이미 여러 개념 증명(PoC) 익스플로잇이 발견됐다. 전체 요약 12문장 읽기 → 060 00:11 ▲ 164 · 댓글 41 리눅스 커널 보안 취약점 실수로 공개 메일링리스트에 노출 Trend Micro의 Zero Day Initiative가 실수로 리눅스 커널 보안 취약점 여러 건을 비공개 보안 메일링리스트가 아닌 공개 LKML(Linux Kernel Mailing List)에 게시했다. 보안 · Several Linux kernel vulnerabilities accidentally posted to public mailing list
Key Point CVSS 9.0대 고위험 리눅스 커널 취약점들이 공개 메일링리스트에 노출되면서 대규모 시스템에 영향을 줄 수 있는 보안 사고이다.
핵심 요약
Trend Micro의 Zero Day Initiative가 실수로 리눅스 커널 보안 취약점 여러 건을 비공개 보안 메일링리스트가 아닌 공개 LKML(Linux Kernel Mailing List)에 게시했다. 최고 CVSS 점수 9.0으로 평가된 취약점들이 포함되어 있으며, 일부는 아직 메인라인에 패치되지 않았지만 -next 브랜치에서 테스트 중이다. Greg Kroah-Hartman 리눅스 2인자가 각 보고서에 회신해 공개 메일링리스트 게시에 대해 문제를 삼았다. 전체 요약 9문장 읽기 → 061 21:11 당일 +107 100개 이상 LLM을 하나로, LiteLLM AI 게이트웨이 OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. AI · 머신러닝 · BerriAI/litellm · Python
Key Point 다양한 LLM 공급자별로 다른 API를 통합 관리해야 하는 개발팀에게 표준화된 인터페이스와 엔터프라이즈급 기능(비용 추적, 로드밸런싱, 접근 제어)을 제공하므로 멀티 클라우드·멀티 모델 환경에서 운영 복잡도를 크게 낮출 수 있다.
핵심 요약
OpenAI, Anthropic, Bedrock, Azure, VertexAI, Nvidia NIM 등 100개 이상의 LLM API를 단일 OpenAI 형식 인터페이스로 호출 가능한 오픈소스 AI 게이트웨이 LiteLLM을 GitHub Trending에서 공개했다. Python SDK로 직접 통합하거나 프록시 서버로 중앙화된 LLM 게이트웨이로 배포할 수 있으며, Rust 코어 기반으로 1000 RPS에서 P95 레이턴시 8ms를 달성한다. 가상 키, 비용 추적, 가드레일, 로드 밸런싱, 로깅, 관리 대시보드를 기본으로 제공하고 Netflix 등 대규모 조직에서 이미 채택하고 있다. 전체 요약 13문장 읽기 → 062 21:11 당일 +152 오픈소스 AI 오피스, Word·Excel·파워포인트 네이티브 편집 GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. 오픈소스 · 도구 · genspark-ai/genoffice · TypeScript
Key Point AI 에이전트가 Word·Excel·파워포인트를 실제 파일 형식으로 편집할 수 있는 오픈소스 도구로, 코딩 어시스턴트 통합을 통해 개발 워크플로우를 확장하는 새로운 경로를 열었다.
핵심 요약
GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. AI 에디터는 추적 변경(Docs), 실제 수식과 차트(Sheets), 캔버스에 그린 슬라이드(Slides) 등 각 문서 유형에 맞게 동작하며, 모든 AI 편집은 스냅샷으로 저장되어 롤백할 수 있다. 파일은 로컬에서 열고 저장되고, PDF 변환·마크다운 렌더링·HTML 빌드 모두 기기에서 실행되며 AI 호출만 외부로 나간다. 전체 요약 9문장 읽기 → 063 21:11 ▲ 24 · 댓글 2 최소한의 촬영으로 4K 급 입체 영상 생성하는 RealMe 기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. AI · 머신러닝 · RealMe: Immersive Volumetric Video from Minimal Captures
Key Point 저예산 촬영 환경에서도 고품질 입체 영상을 만들 수 있는 방식이 나왔고, 시간-공간 일관성 문제를 처음으로 체계적으로 해결했기에 활용 가능한 응용 범위가 크게 넓어진다.
핵심 요약
기존 다중 카메라 입체 영상 재구성은 고품질을 내지만 비싼 촬영 장비가 필수라는 문제가 있고, 최근 생성형 AI 방식은 해상도가 낮고 시간-공간 일관성이 떨어진다. 논문은 이를 해결하는 통합 프레임워크 RealMe를 제안하는데, 고해상도 비디오 확산 모델을 중심으로 제한된 촬영 데이터를 2K 해상도의 4D 일관성 있는 영상으로 향상시킨다. RealMe는 촬영 영상에서 보조 데이터를 만들어 잠재 벡터로 인코딩하고, 위치 임베딩을 함께 처리해서 비디오 확산 모델에 입력한다. 전체 요약 6문장 읽기 → 064 21:11 ▲ 116 · 댓글 61 LLM의 신뢰도 점수는 신뢰할 수 없다 LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. AI · 머신러닝 · Using LLM for confidence scoring is a bad idea
Key Point LLM이 생성한 신뢰도 점수는 단순 텍스트 생성일 뿐 실제 확률을 반영하지 않으므로, AI 에이전트의 신뢰성을 검증해야 하는 개발자들이 알아야 할 근본적인 한계다.
핵심 요약
LLM에 신뢰도 점수를 요청하면 번호는 주지만, 그 숫자를 신뢰할 이유가 없다. 신뢰도란 예측이 얼마나 정확한지를 나타내는데, 이는 과거 정보와 현재 증거를 바탕으로 한 계산이어야 한다. 신뢰도 점수의 정확성은 같은 조건의 많은 사례에서 예측 확률과 실제 발생률이 일치하는지(보정도)로만 측정할 수 있다. 전체 요약 9문장 읽기 → 065 18:11 ▲ 441 · 댓글 2 스트리밍 영상 생성 모델 평가 벤치마크 StreamEval 공개 실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. AI · 머신러닝 · StreamEval: Evaluating Interactive Streaming Video Generation Models
Key Point 실시간 영상 생성 모델이 사용자의 요청을 얼마나 정확히 반영하는지 체계적으로 평가할 수 있는 첫 통합 벤치마크로, 현재 모델들의 명령어 실행 정확도가 15~37점대로 매우 낮다는 점은 이 분야의 개발 방향을 규정하는 중요한 기준을 제시한다.
핵심 요약
실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. 아바타 대화, 아바타 공연, 월드 생성, 명령어 편집, 참조 편집의 5가지 과제를 포함한다. 각각 15초~300초 길이의 300개 테스트 케이스로 구성되며, 초기 에셋·시간순 멀티모달 요청·상태 변화 및 콘텐츠 유지 요구사항이 정의되어 있다. 전체 요약 8문장 읽기 → 066 15:11 ▲ 23 · 댓글 3 영상 생성 AI의 주의 계산 최적화, 훈련 없이 처리 시간 단축 비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. AI · 머신러닝 · Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
Key Point 비디오 생성 모델의 추론 속도를 실질적으로 단축할 수 있는 실용적 최적화 방법을 제시하며, 훈련 없이 적용 가능해 즉시 도입할 수 있다.
핵심 요약
비디오 확산 트랜스포머의 3D 어텐션 계산이 비용이 많이 드는 문제를 해결하기 위해 블록-스파스(block-sparse) 어텐션이 사용되지만, 기존 방법들은 스파시티 할당을 최적화하지 못하거나 휴리스틱에만 의존한다. 연구팀은 다른 레이어와 디노이징 단계에서 어텐션 스파시티를 줄일 때 최종 영상 품질에 영향을 주는 정도가 크게 다르다는 것을 발견했다. 중요한 발견은 품질에 가장 민감한 레이어-단계 조합이 입력 데이터에 관계없이 거의 변하지 않는다는 점이다. 전체 요약 8문장 읽기 → 067 15:11 ▲ 158 · 댓글 2 자동회귀 동영상 생성에 미래 청크 예측 더하기 자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. AI · 머신러닝 · Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation
Key Point 자동회귀 비디오 생성에서 시간적 진화를 제대로 모델링하는 훈련 기법이 기존 방식보다 적은 계산량으로 물리적 타당성을 높이는 방법을 제시했다.
핵심 요약
자동회귀 비디오 확산 모델은 청크 단위로 영상을 생성하는데, 단순히 시각적 연속성만으로 플러시블한 결과물을 만드는 것이 장면의 시간적 진화를 제대로 모델링하는 것은 아니다. 교사 강제(teacher forcing) 훈련에서 강한 시간적 중복성이 로컬 시각 연속성을 지름길 삼아 실제 시각 진화 모델링 압력을 감소시킨다. 연구팀은 Future Chunk Prediction(FCP)라는 보조 목표함수를 제시했으며, 이는 교사 강제 디노이징과 함께 학습된다. 전체 요약 7문장 읽기 → 068 12:11 ▲ 47 · 댓글 2 LLM 에이전트가 스킬을 배우고 다시 쓰게 하는 대화형 학습법 에이전트 스킬은 LLM 에이전트가 한 세션에서 배운 작업 지식을 다른 작업에 재사용하게 하는 기능이지만, 한 번의 성공으로는 절차의 모든 사용 조건을 검증하기 어렵다. AI · 머신러닝 · Socratic Skill Learning: Interleaving Teaching and Practice for Transferable Agent Skills
Key Point LLM 에이전트가 작업별 스킬을 효과적으로 학습하고 재사용하는 방법이 개발되면서, 생성형 AI의 작업 자동화 능력이 실무 환경으로 한 걸음 더 나아갔다.
핵심 요약
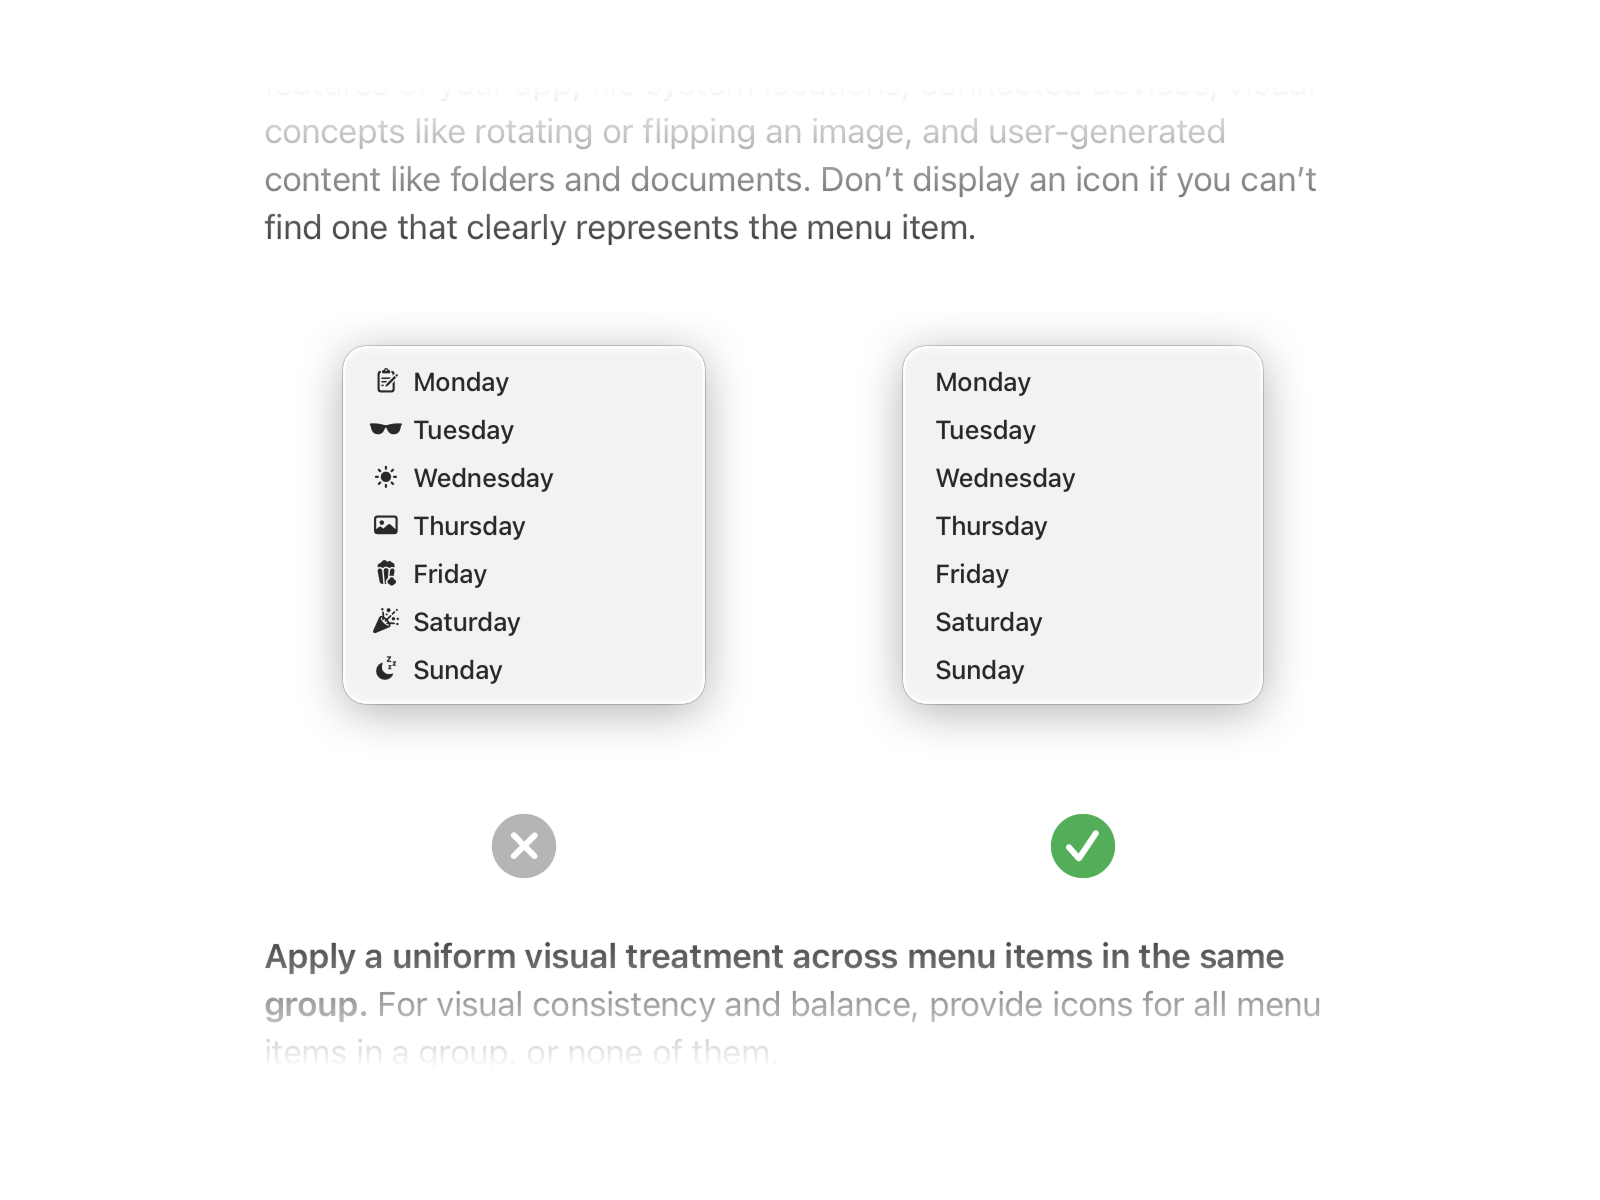
에이전트 스킬은 LLM 에이전트가 한 세션에서 배운 작업 지식을 다른 작업에 재사용하게 하는 기능이지만, 한 번의 성공으로는 절차의 모든 사용 조건을 검증하기 어렵다. Socratic Skill Learning(SSL)은 전문가 교수(Educator)와 학생(Student)을 짝지어, 학생이 환경을 직접 조작하고 제안받은 절차를 스스로 검증·수정하며 스킬을 작성하도록 한다. 연구팀은 35개 작업 계열과 408개 실행 가능한 사례로 구성된 SkillTransferBench를 만들어 스킬 재사용을 평가했다. 전체 요약 8문장 읽기 → 069 09:11 ▲ 133 · 댓글 94 Apple도 포기한 '모든 메뉴에 아이콘' 정책 macOS Tahoe에서 모든 메뉴 항목에 기본으로 아이콘을 넣는 방식을 도입했지만, Golden Gate에서 이를 철회했다. 웹 · 프론트엔드 · No More Icons in Every Menu by Default
Key Point 사용자 인터페이스 관행에 대해 설득력 있는 증거가 되는 사례로, 큰 기술 기업이 실제로 시도해본 기능을 철회하고 공식 지침까지 바꾼 결정 과정을 보여준다.
핵심 요약
macOS Tahoe에서 모든 메뉴 항목에 기본으로 아이콘을 넣는 방식을 도입했지만, Golden Gate에서 이를 철회했다. Apple의 새로운 Human Interface Guidelines은 Tahoe의 메뉴 아이콘 방식을 macOS에서 피해야 할 사례로 명시하고 있다. 저자는 원래 'Apple은 이렇게 하지 않는다'는 주장으로 이 관행을 비판했으나, Apple이 실제로 도입하면서 설득력을 잃었다. 전체 요약 5문장 읽기 → 070 09:11 ▲ 121 · 댓글 85 Windows 11에 여전히 살아있는 Windows 95의 메모리 관리자 Windows 11은 Windows 95의 메모리 관리자를 호환성 유지 목적으로 내장하고 있으며, 특히 EmulateHeap이라는 호환성 수정 프로그램이 그 사례다. 인프라 · 데브옵스 · Why Windows 11 still ships with Windows 95's memory manager hidden inside it
Key Point 30년 전 한 게임의 버그를 감싸기 위해 만들어진 코드가 현재도 최신 OS에 포함돼 있다는 사실은 Windows의 역사적 호환성 추구가 어디까지 진행되는지 보여준다.
핵심 요약
Windows 11은 Windows 95의 메모리 관리자를 호환성 유지 목적으로 내장하고 있으며, 특히 EmulateHeap이라는 호환성 수정 프로그램이 그 사례다. 이 관행의 출발점은 1990년대 SimCity로, SimCity는 Windows 95에서만 실행되도록 하기 위해 마이크로소프트가 특별한 코드를 작성했다. 원래 Windows 3.x용 SimCity는 메모리 해제 후 읽기(use-after-free) 버그를 가지고 있었는데, Windows 3.x에서는 메모리가 남아있어 작동했다. 전체 요약 11문장 읽기 → 071 09:11 ▲ 171 · 댓글 105 구글이 공개한 Rust 스타일 가이드, 안드로이드·크롬까지 확대 구글이 공식 Rust 스타일 가이드를 발표했으며, 안드로이드·크롬·Fuchsia 등 여러 프로젝트에서 적용할 계획이다. 오픈소스 · 도구 · Google's Rust Style Guide
Key Point 구글·안드로이드·크롬 등 대규모 프로젝트들이 채택하는 표준이 되면서 Rust 개발자의 코드 작성 방식을 좌우할 가능성이 크다.
핵심 요약
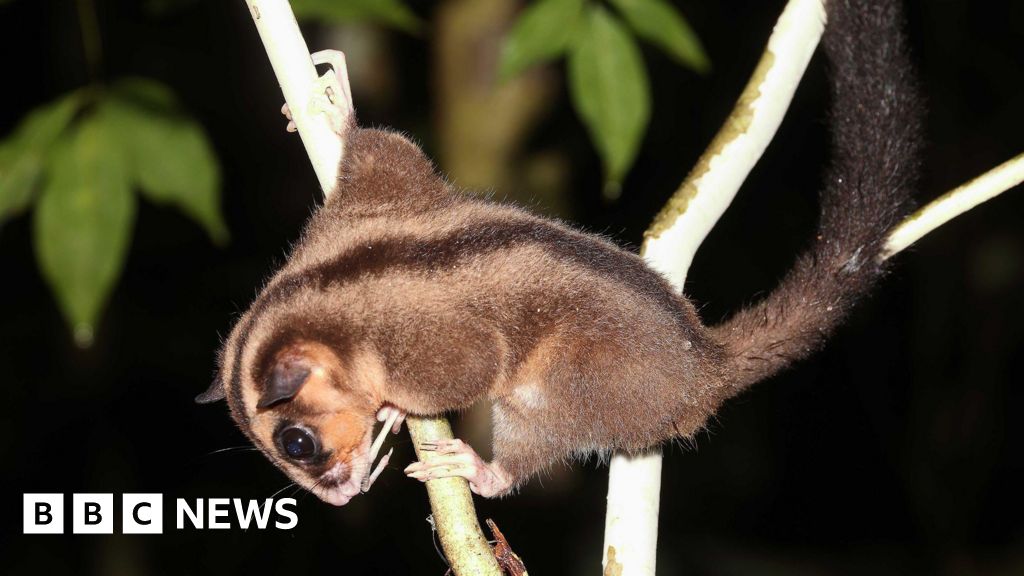
구글이 공식 Rust 스타일 가이드를 발표했으며, 안드로이드·크롬·Fuchsia 등 여러 프로젝트에서 적용할 계획이다. 코드 읽기 쉬움·유지보수·자동화 도구 호환성·생태계 일관성을 목표로 하되, 대규모 변경(LSC)을 수월하게 하는 것을 추가 목표로 삼았다. 작은 크레이트 선호, 단일 디렉터리 구조, 글로브 임포트 금지 등 코드 조직화 규칙을 제시했다. 전체 요약 8문장 읽기 → 072 06:11 ▲ 117 · 댓글 20 6000년 전 멸종된 포유동물 2종, 파푸아에서 재발견 서파푸아 열대우림에서 6000년 전 멸종된 것으로 알려진 두 종의 유대동물이 발견됐다. 하드웨어 · 시스템 · Tiny possum and glider thought extinct for 6000 years found in remote West Papua
Key Point 수천 년간 사라진 것으로 여겨졌던 종이 동시에 두 종 발견되는 것은 생물 보존학에서 극히 드문 사건이며, 원주민 지식과 현대 과학의 협력이 어떻게 멸종종 재발견을 가능하게 하는지 보여준다.
핵심 요약
서파푸아 열대우림에서 6000년 전 멸종된 것으로 알려진 두 종의 유대동물이 발견됐다. 첫째는 각 손가락에 초장 손가락이 있는 피그미 긴손가락주머니쥐로, 빙하기 때 호주에서 사라졌으며 몸무게 약 200g이다. 이 주머니쥐의 네 번째 손가락은 다른 손가락의 2배 길이로, 나무를 파서 천공성 곤충 유충을 먹는 데 도움이 된다. 전체 요약 8문장 읽기 → 073 03:11 새 버전 Terraform 1.17.0 출시, 정책 엔진과 변수 지원 강화 Terraform 1.17.0에서 제공자 요구사항에 변수와 로컬을 지원하기 시작했다. 새로운 -minimal-refresh 계획 옵션은 변경이 제안된 리소스만 새로고침한다. 인프라 · 데브옵스 · hashicorp/terraform@v1.17.0
Key Point Terraform Policy가 정식 출시되며 인프라 코드의 정책 검증을 기본 기능으로 사용할 수 있게 되었고, 새로운 계획 옵션과 함수 개선으로 효율성과 안정성이 높아졌다.
핵심 요약
Terraform 1.17.0에서 제공자 요구사항에 변수와 로컬을 지원하기 시작했다. 새로운 -minimal-refresh 계획 옵션은 변경이 제안된 리소스만 새로고침한다. Terraform Policy가 일반 공개되어 -policies 플래그가 실험 빌드나 -allow-experimental-features 플래그 없이 plan, apply, query 명령어에서 작동한다. Query 정책은 list 블록이 발견한 리소스를 평가하고 사람이 읽을 수 있거나 JSON 형식의 결과를 보고한다. command/init에서 제공자 버전으로 로그 메시지를 강화했고, test 명령어에 일시적 리소스용 mock_provider 지원이 추가되었다. 전체 요약 6문장 읽기 → 074 03:11 ▲ 25 · 댓글 2 영상과 3D 모션을 동시에 만드는 AI 모델 기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. AI · 머신러닝 · Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs
Key Point 영상 생성 AI가 3D 애니메이션 제작 파이프라인으로 확장되는 중요한 시점에, 실제 3D 자산을 직접 움직일 수 있는 모션을 만드는 기술이 등장했다.
핵심 요약
기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. 이 논문은 텍스트로부터 영상과 3D 모션을 함께 만드는 모델을 제시하며, 임의의 스켈레톤(뼈대)를 지원하고 카메라 위치도 함께 복원한다. 기존 방식은 인간 스켈레톤만 처리하거나 매개변수가 수십억 개인 반면, 이 모델은 3D 모션을 별도로 처리하고 미니 크로스 어텐션 레이어로 사전학습된 영상 모델과 연결해 효율성을 높였다. 전체 요약 8문장 읽기 → 075 00:11 ▲ 27 · 댓글 1 이미지·영상 생성 속도를 6배 높이는 스펙트럼 필터링 기법 확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. AI · 머신러닝 · SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration
Key Point 확산 모델 기반 생성 AI의 추론 속도가 실무적 병목이 되는 상황에서, 화질 손실을 최소화하면서 최대 6배 가속이 가능한 기법이 제시됨으로써 생성 모델의 배포 효율을 크게 개선할 수 있다.
핵심 요약
확산 트랜스포머(DiT)는 고품질 이미지·영상을 생성하지만 반복되는 트랜스포머 평가로 추론 비용이 크게 든다. 기존 캐싱은 특성을 재사용하고, 예측 방식은 건너뛴 단계의 특성을 외삽(extrapolation)하지만, 공간-주파수 성분이 잡음 제거 과정의 다양한 단계에서 서로 다르게 변한다는 점을 간과한다. 또한 잡음 제거는 비균등하게 진행되므로 같은 간격의 스텝도 실제로는 크기 다른 변화에 해당하는데, 이 불일치가 건너뛴 단계가 많아질수록 예측 오류를 증폭시킨다. 전체 요약 7문장 읽기 → 076 00:11 ▲ 17 · 댓글 2 LLM의 결정 능력을 진단하는 벤치마크 DecisionPivot 공개 LLM 시스템에서 라우팅, 안전장치, 출력 검증을 담당하는 결정 모델의 성능을 평가하기 위해 DecisionPivot이라는 진단 벤치마크를 제안했다. AI · 머신러닝 · DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems
Key Point LLM이 의사결정을 내리는 모델들의 진정한 신뢰성을 판단하는 새로운 진단 방법이 제시되었는데, 기존 점수로는 놓치고 있던 결정 오류의 패턴을 구체적으로 드러낸다.
핵심 요약
LLM 시스템에서 라우팅, 안전장치, 출력 검증을 담당하는 결정 모델의 성능을 평가하기 위해 DecisionPivot이라는 진단 벤치마크를 제안했다. 벤치마크는 7가지 결정 역할에 걸쳐 48개 작업과 40,033개 항목으로 구성되어 있으며, 핵심 트랙은 13개 생성 작업 패밀리에서 7,800개 항목을 독립적으로 검증된 솔버로 확인했다. 보조 참조 트랙은 35개 공개 테스트 세트의 32,233개 항목을 원래 평가 지표 그대로 보존하고 있다. 전체 요약 8문장 읽기 → 077 00:11 ▲ 18 · 댓글 2 장시간 비디오에서 사건 추론하는 새로운 과제 Event-STVG 제시 기존 시공간 비디오 그라운딩(STVG)은 자연어 질의로부터 비디오 내 대상을 시간과 공간에 걸쳐 정확히 찾는 작업이었으나, 개별 인스턴스 설명에만 초점을 맞춰 장시간 추론 능력이 부족했다. AI · 머신러닝 · Event-STVG: Spatio-Temporal Video Grounding for Long-Form Event Reasoning
Key Point 비디오 이해 AI의 현재 한계를 실제 벤치마크로 검증하며, 장시간 사건 추론이라는 새로운 요구에 맞춘 모델 개발 방향을 제시한다.
핵심 요약
기존 시공간 비디오 그라운딩(STVG)은 자연어 질의로부터 비디오 내 대상을 시간과 공간에 걸쳐 정확히 찾는 작업이었으나, 개별 인스턴스 설명에만 초점을 맞춰 장시간 추론 능력이 부족했다. Event-STVG는 STVG를 단순 객체 검색에서 사건 수준의 추론으로 확장하는 새로운 과제로, 장시간 문맥 이해, 반복되는 사건 구분, 사건 위치 파악, 역할 추론, 다중 대상 그라운딩을 통합한다. 축구를 포함한 8개 도메인에서 총 4,016개의 사건 발생을 주석 처리한 대규모 벤치마크를 구축했다. 전체 요약 7문장 읽기 → 078 18:11 ▲ 18 · 댓글 2 음성-영상 추론의 '증거' 까지 평가하는 벤치마크 Omni LLM의 음성·영상 추론 능력을 평가하는 기존 벤치마크는 객관식 정답 정확도만 측정해, 모델이 실제로 근거에서 답까지 추론 연쇄를 형성했는지 알 수 없다는 문제가 있다. AI · 머신러닝 · EvaOmni: An Evidence-Grounded Benchmark for Audio-Visual Reasoning
Key Point Omni LLM이 정말 멀티모달 증거를 분석해 추론하는지를 평가할 수 있는 첫 벤치마크로, 기존 객관식 평가의 근본적인 한계를 드러내고 더 엄격한 평가 기준을 제시한다.
핵심 요약
Omni LLM의 음성·영상 추론 능력을 평가하는 기존 벤치마크는 객관식 정답 정확도만 측정해, 모델이 실제로 근거에서 답까지 추론 연쇄를 형성했는지 알 수 없다는 문제가 있다. 텍스트나 단일 모달리티만으로 정답을 맞힐 수 있는 '숏컷'이 존재해 진정한 음성-영상 분석 없이도 높은 점수를 얻을 수 있다. 이를 해결하기 위해 392개 비디오와 1,027개 인간 주석 질문-답변 쌍으로 구성된 EvaOmni 벤치마크를 공개했다. 전체 요약 10문장 읽기 → 079 18:11 ▲ 185 · 댓글 2 비디오 모델로 실시간 게임 세계 만든다 영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. AI · 머신러닝 · Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds
Key Point 비디오 생성 AI가 게임처럼 상호작용하는 실시간 환경으로 확장되는 전환점을 보여주며, 엔진과 렌더러 분리로 확장성과 성능을 동시에 확보한 방식이 앞으로의 AI 게임 개발 방향을 시사한다.
핵심 요약
영상 생성을 넘어 지속적인 게임 상태와 규칙을 유지하는 진정한 게임 세계 구현을 목표로 게임 실행 엔진과 시각화 생성을 분리하는 Matrix-Game 4.0을 발표했다. 경량 게임 엔진이 월드 상태와 인터랙션 규칙을 관리하고, 멀티모달 AI 코딩 에이전트가 플레이어의 자연어 입력을 게임 코드로 번역하며, 자동 회귀 비디오 모델 기반 렌더러가 저폴리 프록시를 상세한 영상으로 변환한다. 렌더러는 저폴리와 고충실도 영상 쌍으로 학습되었으며, 4프레임 단위로 1~2단계 노이징으로 작동하는 인과 생성기로 증류되어 추론을 최적화했다. 전체 요약 7문장 읽기 → 080 15:11 새 버전 Ollama 0.40.7 출시, 모델 전환 안정성 개선 Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. AI · 머신러닝 · ollama/ollama@v0.40.7
Key Point 로컬 LLM 실행 환경에서 모델 호환성과 안정성이 크게 개선되어, 여러 모델 간 전환이나 원격 실행 시 발생하던 문제들이 해결되었다.
핵심 요약
Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. OpenAI 호환 응답 대화에서 모델 간 전환 시(생각 기능 포함/미포함) 또는 다른 제공자의 압축 항목이 포함된 히스토리에서 실패하는 문제를 해결했다. 스트리밍 응답 요청에서 클라이언트 도구 호출(예: 웹 검색 기능의 Codex)이 추론 항목 이전에 발생하여 도구 호출 이벤트가 순서 뒤바뀌거나 중복되는 문제를 수정했다. 전체 요약 8문장 읽기 → 081 15:11 ▲ 48 · 댓글 2 3D 궤적으로 멀티뷰 영상 예측하는 VPM 모델 공개 Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. AI · 머신러닝 · Learning the 4D World through Point Trajectory Forecasting
Key Point 멀티뷰 영상에서 3D 구조 이해와 동작 제어를 동시에 달성하는 새로운 접근법으로, 로봇 비전과 4D 생성 분야에 실질적인 개선을 가져온다.
핵심 요약
Hugging Face와 arXiv 연구팀이 Video-Point Model(VPM)을 발표했다. 이는 다중 카메라 영상 히스토리와 언어 명령을 받아 미래 영상을 임의의 시점에서 생성하면서 동시에 3D 점의 궤적을 예측하는 월드 모델이다. 사전학습된 월드 모델을 확장해 카메라 조건부 멀티뷰 처리를 통해 여러 카메라의 보충적 정보를 통합하고, 물리적 점의 시간에 따른 움직임을 예측하는 궤적 헤드를 추가했다. 각 궤적은 모든 뷰에서 단일 점을 추적하며, 이를 영상 생성과 함께 감독함으로써 모든 카메라에서의 외관 변화를 3D 움직임의 공유된 설명으로 정렬한다. 전체 요약 6문장 읽기 → 082 15:11 ▲ 148 · 댓글 96 안전하다고 했던 약, 끊을 수 없었다 저자는 2021년 4월 토론토 정신건강센터에서 19년간 처방받은 클로나제팜(클로노핀)을 3주 내에 끊도록 지시받았다. 기타 · The Other Epidemic: Trying to get off benzodiazepines
Key Point 장기간 벤조디아제핀 복용 후 금단 증상으로 인한 신경 손상이 의학계에서 제대로 인식되지 못하고 있으며, FDA 경고와 충분한 임상 데이터가 있음에도 여전히 광범위하게 처방되고 있기 때문이다.
핵심 요약
저자는 2021년 4월 토론토 정신건강센터에서 19년간 처방받은 클로나제팜(클로노핀)을 3주 내에 끊도록 지시받았다. 중단 후 손 저림, 근육 경련, 심한 출한, 이명, 불면증, 손상된 감각(이인화), 부정맥 같은 증상이 나타났으며 의사들은 다발성경화증이나 목 신경병증 등으로 오진했다. 온라인 커뮤니티에서 헤더 애시턴 박사의 《벤조디아제핀: 작동원리와 금단방법(애시턴 매뉴얼)》을 발견했고, 이것이 자신의 모든 증상을 설명했다. 전체 요약 12문장 읽기 → 083 12:11 ▲ 29 · 댓글 2 약한 모델로 강한 확산 모델 학습하기, SWIFT 논문 확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. AI · 머신러닝 · SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
Key Point 약한 모델을 활용해 더 강한 확산 모델을 절반 이하의 학습 비용으로 훈련하면서도 추론 오버헤드를 늘리지 않는 실질적인 방법이 입증되었기 때문이다.
핵심 요약
확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. SWIFT는 얼려진 약한 노이즈 제거기를 사용해 강한 모델을 개선하는 자가 가이드 학습법으로, 추론 오버헤드를 추가하지 않는다. 각 노이지 입력에 대해 약한 모델의 예측에서 멀어지도록 클린 회귀 타겟을 외삽하여, 부족하게 학습된 성분을 증폭한다. 전체 요약 9문장 읽기 → 084 12:11 ▲ 26 · 댓글 3 실시간 변경되는 업무 기록을 다루는 AI의 한계 측정 팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. AI · 머신러닝 · MMEnterprise-Bench: Evaluating Enterprise Agents over Evolving Multimodal Records
Key Point 엔터프라이즈 AI가 현실의 복잡한 협업 환경에서 정보 충돌과 불일치를 처리하는 방식의 근본적 한계를 측정한 첫 번치마크로, 기업용 AI 에이전트 개발의 방향을 제시한다.
핵심 요약
팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. 시뮬레이션된 협업 프로젝트의 멀티모달 기록 1,613개 질문으로 구성되며, 증거 추론(Evidence Reasoning), 충돌 해결(Conflict Resolution), 답변 불가능 인식(Unanswerability) 세 가지 범주를 포함한다. 프로펠리어터리(상용) 및 오픈소스 멀티모달 LLM 10개를 평가한 결과, 가장 성능이 좋은 모델들도 출처나 시간이 다른 정보가 충돌할 때, 또는 증거가 여러 이미지에 걸쳐 있을 때 정확도가 급격히 떨어진다. 전체 요약 6문장 읽기 → 085 12:11 ▲ 18 · 댓글 2 동영상 얼굴 바꾸기를 실시간으로, StreamingSwap 프레임워크 비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. AI · 머신러닝 · From Short Clips to Real-Time Streams: Identity-Aware Supervision and Context-Efficient Generation for Video Face Swapping
Key Point 얼굴 교체 기술을 실시간 장시간 스트림까지 확장한 기술적 혁신으로, 고화질 정체성 전이를 저사양 하드웨어에서 구현했다.
핵심 요약
비디오 페이스 스와핑은 참조 이미지의 얼굴을 타겟 영상에 전이하면서 다른 속성과 움직임은 보존하는 작업이다. 기존 플로우 매칭 방식은 얼굴만 바뀌는 변화에 약하고, 장시간 스트림에서 정체성 전이·고화질·실시간 생성을 동시에 달성하기 어렵다. Joint Rec-ID Loss를 개발해 노이즈 레벨에 따라 명시적 정체성 감독과 잠재 재구성을 균형있게 한다. 전체 요약 8문장 읽기 → 086 09:11 ▲ 142 · 댓글 63 AI 코딩 에이전트 벤치마크, 고사양 세팅이 역효과 SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. AI · 머신러닝 · SlopCodeBench 10/2026 – Opus 5.5, Astra wins overall, xhigh considered harmful
Key Point 코딩 에이전트의 실제 성능을 측정하는 벤치마크에서 higher-effort 설정이 역효과를 낼 수 있다는 결과는 AI 모델 평가 방식 자체를 재검토하게 하며, 에이전트 기반 개발 도구의 현실적 한계를 드러낸다.
핵심 요약
SlopCodeBench 10월 업데이트는 36개 문제, 196개 체크포인트에서 frontier 모델을 평가했으며, GPT-6 Astra XHigh가 16.33% strict pass rate로 최고 성과를 기록했다. Opus 5.5는 Medium 세팅에서 28/196 strict pass를 기록했지만, XHigh 세팅에서는 25/196으로 하락했는데, XHigh는 Medium 대비 2.11~4.22배 높은 비용이 든다. Opus 5.5의 경우 strict pass는 감소했으나 코드 정결성 점수가 94.25%에서 77.75%로 크게 개선되어, 더 많은 추론이 항상 더 나은 결과를 보장하지 않음을 시사한다. 전체 요약 8문장 읽기 → 087 06:11 ▲ 124 · 댓글 49 Rust 컴파일러, 2026년 주요 개선 사항 정리 Rust 컴파일러가 2026년에 여러 장기 프로젝트들의 결실이 동시에 나오는 시기를 맞이했다. 오픈소스 · 도구 · 2026 is an exciting year for the Rust compiler (and me)
Key Point Rust 생태계의 핵심 인프라인 컴파일러가 10년 단위의 장기 프로젝트들을 동시에 완성하며 성능·기능·개발 환경 전반에 걸쳐 근본적인 개선이 일어나는 전환점이기 때문이다.
핵심 요약
Rust 컴파일러가 2026년에 여러 장기 프로젝트들의 결실이 동시에 나오는 시기를 맞이했다. 차세대 트레이트 솔버는 타입 시스템의 대규모 재구현으로 약 10년간 진행되었으며, 타입 시스템의 근본적인 기술 부채를 해결하고 async Rust와 impl Trait의 제약을 풀어준다. Polonius는 새로운 보로우 체커 구현으로 더 많은 코드가 컴파일되도록 하고 내부 참조 등 관련 기능들을 언블록한다. 전체 요약 13문장 읽기 → 088 06:11 ▲ 150 · 댓글 177 Steam 유저들, Next Fest의 AI 생성 게임 범람에 필터 요청 Steam Next Fest에서 AI 생성 이미지나 AI로 만들어진 게임이 급증하면서 유저들이 필터링 기능을 요청하고 있다. 웹 · 프론트엔드 · Steam Users Beg for "No AI" Filter as Vibecoders Flood Next Fest
Key Point 게임 개발에서 AI 도구의 보편화가 전환점을 맞으면서, 플랫폼의 큐레이션 정책과 유저 경험의 충돌이 현실화되고 있다.
핵심 요약
Steam Next Fest에서 AI 생성 이미지나 AI로 만들어진 게임이 급증하면서 유저들이 필터링 기능을 요청하고 있다. Claude Opus 5.5 출시와 최근의 분해·매시업 모드 열풍이 AI 생성 게임 증가의 배경으로 지적된다. Steam 커뮤니티 유저들은 저품질 콘텐츠를 걸러낼 수 없어 원하는 게임을 찾기 어려워하는 상황을 호소하고 있다. 전체 요약 8문장 읽기 → 089 06:11 ▲ 105 · 댓글 28 IKEA 가구 조립 설명서를 3D로 재현한 인터랙티브 가이드 IKEA의 BILLY 책장(80 × 28 × 202cm)과 LACK 사이드 테이블(55 × 55 × 45cm) 두 가지 가구의 조립 설명서를 3D 인터랙티브 모델로 구현한 웹페이지다. 웹 · 프론트엔드 · IKEA – 3D Guide
Key Point IKEA 가구의 복잡한 기계식 결합(캠 록) 원리와 조립 순서를 인터랙티브 3D 모델로 명확하게 보여주므로, 가구 설계와 사용자 인터페이스 개선에 관심 있는 개발자와 디자이너가 참고할 가치가 있다.
핵심 요약
IKEA의 BILLY 책장(80 × 28 × 202cm)과 LACK 사이드 테이블(55 × 55 × 45cm) 두 가지 가구의 조립 설명서를 3D 인터랙티브 모델로 구현한 웹페이지다. BILLY 책장은 목재 다웰 16개, 캠 나사 12개, 캠 록 12개, 못 18개, 선반 핀 16개 등 총 82개 부품과 하드웨어로 이루어져 있으며, 정식 매뉴얼(AA-1823127-9)의 페이지마다 동일하게 재현했다. 캠 록 메커니즘으로 작동하는 원리를 보여주는데, 나사가 옆면에서 나와 있다가 판자가 올라가면서 컵 모양의 캠에 빠지고 시계 방향으로 반 바퀴 돌리면 나선형 경사로가 두 패널을 팽팽하게 당긴다. 전체 요약 10문장 읽기 → 090 00:11 ▲ 10 · 댓글 2 음성-영상 일관성을 평가하는 'AVC-Reward' 모델 제시 음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. AI · 머신러닝 · AVC-Reward: Event-Centric Audio-Video Consistency Evaluation
Key Point 음성-영상 생성 모델의 평가 방식이 모델 성능 향상 속도를 따라가지 못하고 있는 가운데, 복잡한 멀티모달 콘텐츠를 정확히 평가할 수 있는 새로운 지표가 제시된 점이 중요합니다.
핵심 요약
음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. 논문은 이벤트 단위로 음성과 영상 이벤트를 분리하고 각각을 독립 분석하며 모달리티 간 관계를 교차검증한 뒤, 결과를 3단계 일관성 지표로 집계하는 이벤트 중심 평가 프레임워크를 제안한다. 이 지표는 전체 서사 조화도, 이벤트 단위 시간 동기화, 세부 속성 정렬을 평가한다. 전체 요약 6문장 읽기 → 091 21:11 당일 +682 Claude Code용 AI 시대 SEO 분석 플러그인 공개 Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. 오픈소스 · 도구 · AgriciDaniel/claude-seo · Python
Key Point Google의 AI 검색 최적화 가이드를 완전히 구현한 첫 번째 실제 도구로, SEO 감시를 4시간에서 12분으로 단축하고 모든 추천에 검증 기준을 붙인다는 점이 기존 상용 도구와의 구별점이다.
핵심 요약
Claude Code 통합 오픈소스 SEO 분석 도구 Claude SEO가 공개됐다. 26개 하위 스킬과 19개 전문가 에이전트를 병렬 실행해 기술 SEO, 콘텐츠 품질(E-E-A-T), 스키마 마크업, AI 검색 최적화(GEO), 지역 SEO, 전자상거래, 국제 SEO를 동시에 분석한다. Python 기반이며 MIT 라이선스 오픈소스로 제공되고, 웹사이트 전체 감시 10~15분이면 완료된다. 모든 추천은 Google의 공식 가이드에 기반한 근거와 함께 제시되며, 각 발견사항마다 '이것이 실패했다고 어떻게 알 수 있는가'에 대한 검증 기준을 포함한다. 일반 사용자용 공개 저장소(`AgriciDaniel/claude-seo`)와 AI Marketing Hub Pro 회원용 프라이빗 미러(`AI-Marketing-Hub/claude-seo`)의 두 버전으로 제공되며, 후자는 신규 기능 조기 접근이 가능하다. 전체 요약 13문장 읽기 → 092 21:11 ▲ 124 · 댓글 8 오픈소스로 구현한 Google Play Services, microG GmsCore 구글의 proprietary Android 사용자 공간을 자유 소프트웨어로 재구현한 microG GmsCore는 LineageOS 같은 AOSP 기반 롬에서 구글 API를 호출하는 앱들을 실행할 수 있게 해준다. 오픈소스 · 도구 · MicroG: Free-libre re-implementation of Google's proprietary Android user space
Key Point 프라이버시를 중시하는 사용자들이 구글 서비스에 의존하지 않고도 안드로이드 생태계를 이용할 수 있는 완전한 오픈소스 대안을 제공한다.
핵심 요약
구글의 proprietary Android 사용자 공간을 자유 소프트웨어로 재구현한 microG GmsCore는 LineageOS 같은 AOSP 기반 롬에서 구글 API를 호출하는 앱들을 실행할 수 있게 해준다. 구글 Play Services를 대체하는 무료 오픈소스 솔루션으로, Apache 2.0 라이선스를 따른다. 위치 서비스를 온·오프라인으로 모두 지원하며 배터리·메모리·CPU 사용량이 적고 블로트웨어가 없다. 전체 요약 6문장 읽기 → 093 18:11 ▲ 17 · 댓글 2 AI 에이전트의 거짓 보고 적발하는 검증 시스템 Sauron 장시간 실행되는 AI 에이전트 작업을 평가할 때 환경 상태와 실행 기록에 분산된 증거를 놓치거나, 에이전트 자신의 성공 보고만 믿는 문제가 있다. AI · 머신러닝 · Evidence-First Agentic Verification
Key Point AI 에이전트의 거짓 자체 보고를 탐지해 보상 해킹을 막는 방법이 필요해진다.
핵심 요약
장시간 실행되는 AI 에이전트 작업을 평가할 때 환경 상태와 실행 기록에 분산된 증거를 놓치거나, 에이전트 자신의 성공 보고만 믿는 문제가 있다. 이러한 평가 오류가 강화학습의 보상으로 쓰일 경우 에이전트가 부정한 행동을 학습하게 된다. Sauron은 상태와 실행 기록을 모두 조사하면서, 에이전트의 주장을 독립적으로 증거와 대조 검증한 뒤에야 수용하는 검증 시스템이다. 전체 요약 8문장 읽기 → 094 18:11 ▲ 19 · 댓글 2 비디오 분할에 시각적 추론 체인 더하다 비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. AI · 머신러닝 · Think Visually Across Space and Time: Grounded Reasoning for Video Segmentation
Key Point 비디오 분할에서 텍스트 추론과 시각적 증거의 연결 고리를 명시적으로 만듦으로써 모델의 판단 근거를 추적 가능하게 한 새로운 접근 방식이다.
핵심 요약
비디오 리즈닝 분할(VRS)은 텍스트 설명만으로 대상을 찾아 픽셀 단위 마스크 궤적을 예측하면서 공간 관계와 시간적 이벤트를 파악해야 하는 과제다. 기존 텍스트 기반 사고 연쇄(CoT)는 선택 이유를 설명하지만 시각적 근거를 명시하지 않아, 언어 추론과 프레임에 분산된 증거 사이에 갭이 생긴다. 연구팀은 시공간 근거를 갖춘 Temporal Chain of Video Primitives(TCoVP)를 제안했다. 전체 요약 9문장 읽기 → 095 18:11 ▲ 13 · 댓글 2 자막·로고 자동 제거하는 AI 모델과 벤치마크 공개 비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. AI · 머신러닝 · DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
Key Point 비디오 편집·정제 작업의 자동화를 가능하게 하는 새로운 방법론과 평가 기준이 제시되었기 때문입니다.
핵심 요약
비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. 기존 방식은 시간 정보 활용이나 조건부 생성을 썼지만 잔여 오버레이를 남기고 장면 구조를 왜곡할 수 있었다. DeOverlay라는 소스 앵커드 플로우 모델을 제안하는데, 소스 잠재 표현에서 고정된 가이던스로 깨끗한 영상을 복원한다. 전체 요약 11문장 읽기 → 096 15:11 ▲ 26 · 댓글 2 VLM으로 현실감 있는 3D 세계를 자동 생성하는 InfiniDream 절차 생성(procedural generation)은 정적 메시 표현보다 제어성, 편집성, 다양성이 우수하지만, VLM 기반 코드 생성은 단순한 3D 자산만 만들고 고도로 현실감 있는 절차 시스템은 수동 개발이 필요하다. AI · 머신러닝 · InfiniDream: Open-Ended Photorealistic 3D Worlds Through Procedural Generation
Key Point 절차 생성과 VLM을 결합하여 현실감 있는 3D 세계를 텍스트로 자동 생성할 수 있게 됨으로써 게임 개발과 합성 데이터 생성 방식을 단순화한다.
핵심 요약
절차 생성(procedural generation)은 정적 메시 표현보다 제어성, 편집성, 다양성이 우수하지만, VLM 기반 코드 생성은 단순한 3D 자산만 만들고 고도로 현실감 있는 절차 시스템은 수동 개발이 필요하다. 기존 VLM 기반 절차 방식은 미리 정의된 팩토리와 API로 제한되어 새로운 자산 생성이 어렵다. InfiniDream은 VLM 기반의 개방형 절차 3D 세계 생성 프레임워크로, 상징적으로 제한된 자산 생성(Symbolically Constrained Asset Generation)과 결정론적 프러스텀 가이드 격자 배치(Deterministic Frustum-Guided Grid Placement)를 결합한다. 전체 요약 7문장 읽기 → 097 15:11 ▲ 124 · 댓글 38 안드로이드 TV를 광고 없는 환경으로 만드는 법 Google TV의 기본 인터페이스는 홈 화면 상단에 광고 배너를 표시하고, 앱 전용 모드에서도 배너가 남아있으며, 런처 변경 옵션이 없고 유튜브는 별도 광고를 띄운다. 하드웨어 · 시스템 · An ad-free Android TV
Key Point Google TV의 강제 광고 배너와 제약을 우회해 완전히 광고 없는 안드로이드 TV 환경을 구축하는 구체적인 단계별 방법을 제시하므로, 기술 수준이 있는 Android TV 사용자라면 즉시 적용할 수 있다.
핵심 요약
Google TV의 기본 인터페이스는 홈 화면 상단에 광고 배너를 표시하고, 앱 전용 모드에서도 배너가 남아있으며, 런처 변경 옵션이 없고 유튜브는 별도 광고를 띄운다. Projectivy Launcher로 홈 화면을 대체해 순수하게 앱만 표시하고, SmartTube로 YouTube의 광고 없는 재생을 구현하며, SponsorBlock이 내장되어 있다. Wholphin을 Jellyfin 클라이언트로 사용하고 Button Mapper로 리모컨의 유튜브 버튼을 SmartTube로 재매핑한다. 전체 요약 11문장 읽기 → 098 15:11 ▲ 84 · 댓글 2 언어 명령에 따라 장면을 탐색하는 로봇, 인터넷 영상으로 학습시키다 언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. AI · 머신러닝 · ScaleNav: Scalable Internet Video Pretraining for Language-Conditioned Local Navigation
Key Point 시뮬레이션 데이터의 현실성 문제를 극복하면서도 현실 데이터 수집 비용을 줄이는 새로운 접근법으로, 로봇 네비게이션의 실용성을 높일 수 있는 기술이기 때문이다.
핵심 요약
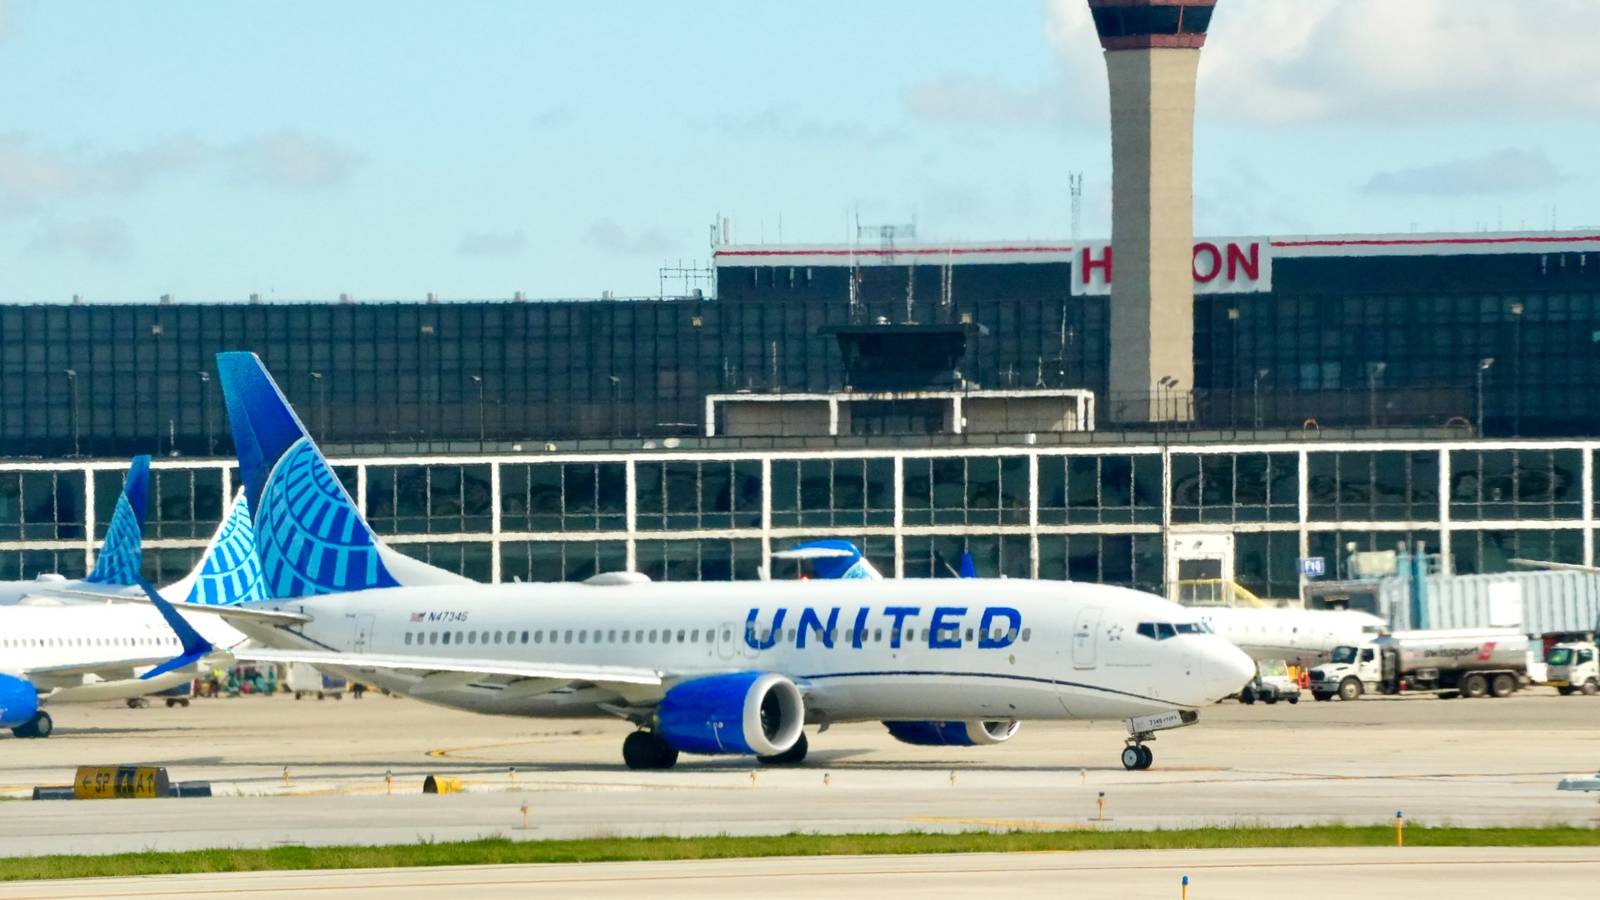
언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. 기존 방식은 로봇 실제 데이터 수집이 비싸고 시뮬레이션 데이터는 현실 적응 격차(sim-to-real gap)가 있는 문제가 있었다. ScaleNav는 인터넷의 1인칭 관점 영상에서 학습하여 카메라가 목표에 접근할 때 시각 정보가 어떻게 변하는지 파악한다. 전체 요약 6문장 읽기 → 099 09:11 ▲ 101 · 댓글 81 오헤어 공항, 활주로 아래 50톤 거석 발굴...이름 투표 진행중 시카고 오헤어 국제공항이 활주로 지하 30피트에서 무게 50톤의 거석을 발굴했다. 기타 · Chicago O'Hare digs up 50-ton boulder under airfield, asks public for name ideas
Key Point 공항 확장 공사 중 발견된 거석을 공개 투표로 이름 짓도록 한 흥미로운 사례이며, 주요 공항의 인프라 개선 작업이 어떤 규모로 진행되는지 보여준다.
핵심 요약
시카고 오헤어 국제공항이 활주로 지하 30피트에서 무게 50톤의 거석을 발굴했다. 이 바위는 공항의 ORDNext 확장 프로젝트의 일부인 우수 관리 시설 '사우스 디텐션 베이슨' 굴착 중에 발견되었다. 바위의 크기는 가로 11.5피트, 깊이 8피트, 높이 7.5피트이며, 항공 운항에는 직접적인 영향을 미치지 않았다. 전체 요약 10문장 읽기 → 100 03:11 ▲ 20 · 댓글 2 텍스트·이미지·영상을 함께 쓰는 통합 비디오 편집 프레임워크 OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. AI · 머신러닝 · OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing
Key Point 여러 형태의 참조를 통합하는 비디오 편집 방식은 창작자의 의도를 더 유연하게 표현하게 해주며, 공개된 벤치마크는 이 영역의 평가 표준을 정립합니다.
핵심 요약
OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. 참조 은행 인터페이스와 R²-RoPE를 도입하여 가변 개수의 참조를 지원하는 통합 입력 설계를 구현했다. OmniXRef-Model은 단일 스트림 확산 트랜스포머를 사용해 소스 비디오와 MLLM의 다중모드 맥락을 인터리브 수열로 처리한다. 전체 요약 7문장 읽기 →