쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
43건 · "SCALE"조건 지우기 ×
001 00:11 ▲ 260 · 댓글 61 미스트랄, 1조 파라미터 대형 모델 가중치 공개 미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. AI · 머신러닝 · Mistral Large 4 (Le Chonk) is now Open Weight
Key Point 오픈가중치 대형 언어 모델의 최강자로 자리잡아 개발사들의 모델 선택지가 크게 늘어날 뿐 아니라, 주권 AI 전략을 추진하는 유럽 기관들과 규제가 엄격한 금융·방위 부문에서 실질적인 대안을 제공하기 시작했다.
핵심 요약
미스트랄이 1조 파라미터 멀티모달 모델 '르 총크(Le Chonk)'의 가중치를 공개했으며, 3주간의 강화학습으로 코딩과 사이버보안 성능을 크게 향상시켰다. FrontierCode 2.0 벤치마크에서 19.7%, Terminal-Bench 4.0에서 41%의 성능을 달성하며 오픈가중치 코딩 모델 중 최고 수준을 기록했다. Artificial Analysis 코딩 에이전트 인덱스에서 48%를 달성하며 GLM-5.3과 동등하지만 평균 47% 적은 토큰을 사용해 효율성이 우수하다. 전체 요약 13문장 읽기 → 002 00:11 ▲ 381 · 댓글 4 LLM 에이전트 강화학습, 턴 단위 신용할당으로 최적화 장시간 작업을 수행하는 LLM 에이전트는 환경과 상호작용하며 각 행동을 토큰 단위로 생성한다. AI · 머신러닝 · Multiscale Policy Optimization for Long-Horizon LLM Agents
Key Point LLM 에이전트의 장시간 작업에서 어디에 책임을 할당할지 판단하는 방식을 개선함으로써, 복잡한 추론 작업에서 강화학습 효율을 높일 수 있기 때문이다.
핵심 요약
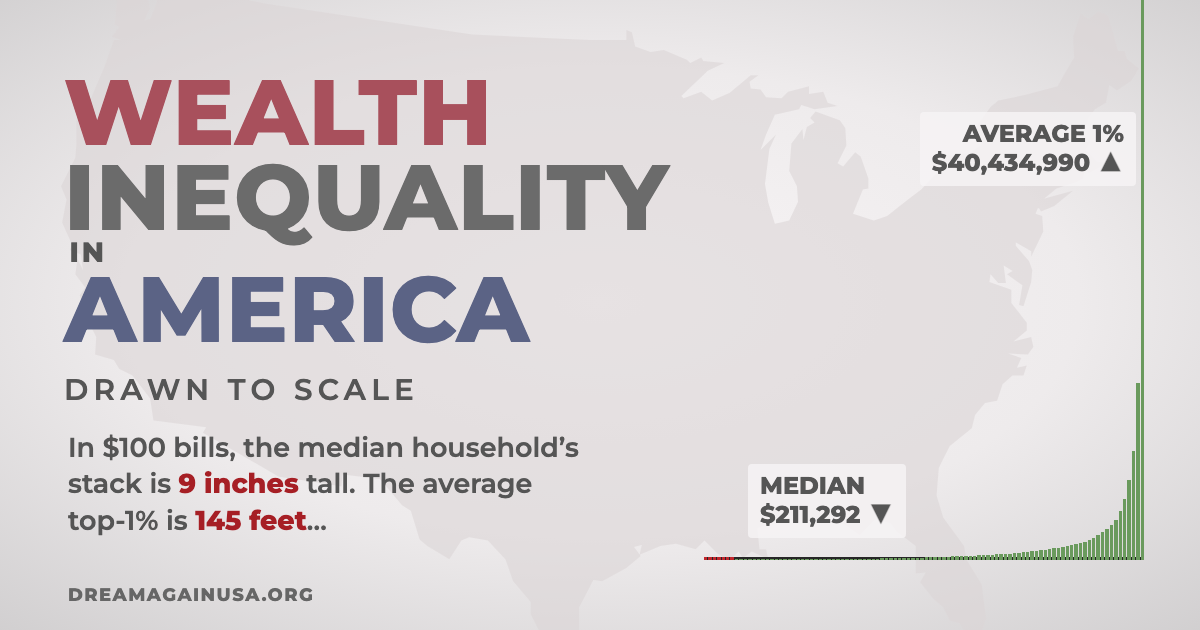
장시간 작업을 수행하는 LLM 에이전트는 환경과 상호작용하며 각 행동을 토큰 단위로 생성한다. 현재 방식에서 비평가(critic) 값이 주로 턴(turn) 간에 변화하는 것을 발견했다. 이에 따라 턴 단위에서 최적화하면서 토큰 간 신용할당을 세밀하게 조정할 필요가 있다. 전체 요약 7문장 읽기 → 003 21:11 ▲ 243 · 댓글 237 미국 부의 불평등, 스크롤로 시각화하다 미국 가구들의 부의 불평등을 스케일에 맞춰 시각적으로 표현한 인터랙티브 웹사이트다. 스타트업 · 비즈니스 · Wealth Inequality in America drawn to scale
Key Point 미국의 극단적 부의 불평등을 수치와 시각화로 직접 체감할 수 있어, 경제 격차의 심각성을 이해하는 데 효과적이다.
핵심 요약
미국 가구들의 부의 불평등을 스케일에 맞춰 시각적으로 표현한 인터랙티브 웹사이트다. 각 열은 미국 가구의 1%를 나타내며, 가난한 순서부터 부유한 순서로 정렬되어 있다. 중위 가구의 자산을 100달러 지폐로 스택한다면 약 9인치 높이이고, 상위 1% 평균 가구는 145피트에 달한다. 전체 요약 7문장 읽기 → 004 09:11 ▲ 170 · 댓글 96 Tailscale SSH 보안 취약점 발견, 27일 패치 예정 Tailscale이 SSH 기능의 보안 취약점을 조사 중이며 10월 27일까지 패치를 배포할 예정이다. 보안 · Tailscale SSH: Investigation and remediation update
Key Point 원격 접근 인프라의 핵심인 Tailscale SSH의 권한 상승 취약점으로, 엔지니어들이 즉시 설정을 검토하고 권장 조치를 취해야 한다.
핵심 요약
Tailscale이 SSH 기능의 보안 취약점을 조사 중이며 10월 27일까지 패치를 배포할 예정이다. 발견된 취약점은 주로 권한 상승(privilege escalation) 문제로, 이미 Tailscale SSH 접근이 허가된 사용자나 기기가 설정된 권한을 초과하는 작업을 수행할 수 있다. 취약점 악용 가능성은 허가된 사용자의 권한, 시스템 설정, 기타 조건에 따라 달라지며, 현재로선 모든 사용자에게 Tailscale SSH 비활성화를 권장하지 않는다. 전체 요약 6문장 읽기 → 005 21:12 ▲ 203 · 댓글 80 1:1 스케일 스위스를 마인크래프트로 구현 스위스 전역을 1:1 축척으로 마인크래프트에 재현하는 프로젝트를 얼리 액세스로 공개했다. 기타 · Switzerland. Block by block. At 1:1 scale
Key Point 스위스 전체를 마인크래프트로 1:1 축척으로 구현한 대규모 프로젝트가 공개되어, 게임 모드 제작의 새로운 규모감을 보여주고 있다.
핵심 요약
스위스 전역을 1:1 축척으로 마인크래프트에 재현하는 프로젝트를 얼리 액세스로 공개했다. 카이아소에서 샤프하우젠까지, 제네바 호수에서 뮈스타이르 계곡까지 스위스 전체 41,285㎢를 모드·텍스처 팩·셰이더와 함께 담았다. 다운로드는 24GB이며, 첫 시작 시 게임이 원거리 경관을 자동으로 생성한다. 전체 요약 8문장 읽기 → 006 12:11 ▲ 162 · 댓글 75 LLM으로 대규모 소프트웨어 형식 검증이 현실화되다 Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. AI · 머신러닝 · LLMs are making formal software verification feasible at a much larger scale
Key Point 형식 검증이 역사적으로 수십 년의 전문 인력을 요구했으나, LLM이 이 비용을 획기적으로 낮추면서 일반 소프트웨어 개발에도 적용 가능해졌고, 향후 소프트웨어 보안 수준을 크게 변화시킬 기술이기 때문이다.
핵심 요약
Anthropic과 Theorem이 협력해 Claude로 100개 이상의 실제 오픈소스 라이브러리 어셈블리 코드(RISC-V)에 대한 형식 증명을 생성했으며, 이는 AI를 활용한 프로덕션 소프트웨어의 대규모 형식 검증 최초 사례다. 개발자의 퍼지 테스트(fuzz test)를 자동으로 형식 사양으로 변환해 증명했으며, 239개 엔트리포인트에서 64MB 이하 모든 입력에 대해 크래시가 없음을 증명했다. 총 약 1억 8천만 줄의 Rocq 증명을 작성했고, 전형적인 증명은 약 60만 줄의 코드로 18,000개 RISC-V 명령어에 대한 보안 보장을 제공한다. 전체 요약 13문장 읽기 → 007 15:11 ▲ 84 · 댓글 2 언어 명령에 따라 장면을 탐색하는 로봇, 인터넷 영상으로 학습시키다 언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. AI · 머신러닝 · ScaleNav: Scalable Internet Video Pretraining for Language-Conditioned Local Navigation
Key Point 시뮬레이션 데이터의 현실성 문제를 극복하면서도 현실 데이터 수집 비용을 줄이는 새로운 접근법으로, 로봇 네비게이션의 실용성을 높일 수 있는 기술이기 때문이다.
핵심 요약
언어로 지정된 목표 위치까지 로봇이 자율 네비게이션하는 작업을 다루는 ScaleNav 프레임워크를 제안했다. 기존 방식은 로봇 실제 데이터 수집이 비싸고 시뮬레이션 데이터는 현실 적응 격차(sim-to-real gap)가 있는 문제가 있었다. ScaleNav는 인터넷의 1인칭 관점 영상에서 학습하여 카메라가 목표에 접근할 때 시각 정보가 어떻게 변하는지 파악한다. 전체 요약 6문장 읽기 → 008 06:11 ▲ 180 · 댓글 75 확산 기반 LLM 머큐리 3 공개, 초당 1000+ 토큰 처리 확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. AI · 머신러닝 · Mercury 3: Diffusion at scale
Key Point 확산 기반 LLM이 자동회귀 모델과의 경쟁에서 확장 가능함을 증명하는 첫 번째 상용 사례로, 실시간 AI 애플리케이션의 지연 시간 문제를 해결할 수 있다.
핵심 요약
확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. 머큐리 1 대비 40배 이상 모델 파라미터를 확대했으며, 벤치마크 기준 지능 수준은 3배 향상됐다. 문맥 길이는 260K에서 100만 토큰으로 확장했고, 입출력 토큰당 각각 0.20달러, 0.70달러이며 출시 초기에는 50% 할인(입력 0.10달러, 출력 0.35달러)을 제공한다. 전체 요약 10문장 읽기 → 009 15:11 ▲ 105 · 댓글 61 쿠버네티스, 회의론자의 눈으로 본 핵심 개념 오래된 인프라 경험으로 쿠버네티스에 대해 근거 없이 회의적이던 개발자가 실제로 학습한 내용을 정리했다. 인프라 · 데브옵스 · A skeptic's first contact with Kubernetes (2024)
Key Point 오래 무시해온 기술에 대해 실제로 개념을 이해한 후 장점과 설계 문제를 동시에 분석한 관점으로, 쿠버네티스의 핵심을 깔끔하게 이해할 수 있다.
핵심 요약
오래된 인프라 경험으로 쿠버네티스에 대해 근거 없이 회의적이던 개발자가 실제로 학습한 내용을 정리했다. 쿠버네티스의 핵심 가치는 Control Loop(컨트롤러가 원하는 상태를 계속 관찰·유지)와 Service(안정적 IP·DNS·로드밸런싱을 제공하는 네트워킹 추상화)의 두 가지 개념에서 나온다. Pod는 작업 단위, Node는 쿠버네티스 에이전트를 실행하는 컴퓨터, Service는 Pod 집합의 논리적 그룹화, Namespace는 클러스터의 논리적 구분이다. 전체 요약 10문장 읽기 → 010 15:11 ▲ 18 · 댓글 2 실제 버그 수정에서 배우는 AI 코딩 평가 데이터셋 생성 코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. AI · 머신러닝 · SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
Key Point AI 코딩 에이전트의 진정한 능력을 평가하려면 실제 버그의 복잡성을 반영한 다양한 평가 데이터가 필요한데, 이 연구가 역공학 기반의 자동 생성 방법을 제시했기 때문입니다.
핵심 요약
코딩 에이전트 성능 평가를 위해 현실적이고 다양한 소프트웨어 엔지니어링(SWE) 과제가 필요하지만, 수동 작성으로는 생산 속도가 느리고 비용이 높다. 기존 합성 방식들은 사전학습된 모델 지식과 휴리스틱 프롬프팅에만 의존해 실제 소프트웨어 결함의 복잡한 메커니즘을 제대로 포착하지 못한다. SWE-at-Scale은 과거의 실제 버그 수정 이력을 역공학하여 현실적인 이슈를 자동으로 합성하는 프레임워크다. 전체 요약 8문장 읽기 → 011 15:11 ▲ 107 · 댓글 20 맥의 화면을 아이폰·아이패드에서 제어하는 Sill Sill은 맥의 특정 창이나 전체 데스크톱을 아이폰, 아이패드에 실시간으로 스트리밍하고 터치, 트랙패드, 키보드, Apple Pencil로 원격 제어하는 도구다. 오픈소스 · 도구 · Any window from your Mac, on your iPhone and iPad
Key Point 맥과 iOS 기기 간의 화면 공유와 원격 제어를 오픈소스로 구현한 도구로, 중간 서버 없이 로컬 네트워크나 VPN으로만 동작해 개인정보 보호를 우선하는 개발자들이 유용하게 활용할 수 있다.
핵심 요약
Sill은 맥의 특정 창이나 전체 데스크톱을 아이폰, 아이패드에 실시간으로 스트리밍하고 터치, 트랙패드, 키보드, Apple Pencil로 원격 제어하는 도구다. 맥과 기기는 같은 네트워크, USB 케이블, Direct Wireless Connection(P2P Wi-Fi), 또는 Tailscale 같은 VPN을 통해 연결되며 중간 서버나 계정이 없다. 맥은 Apple Silicon 탑재, macOS 14 이상 필요하고, 아이폰·아이패드는 iOS/iPadOS 17 이상이어야 한다. 전체 요약 13문장 읽기 → 012 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 013 00:11 ▲ 10 · 댓글 2 생성형 AI로 대규모 3D 장면 완전 복원 실현 다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. AI · 머신러닝 · WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
Key Point 완전하고 일관된 대규모 3D 장면 복원이 가능해져 가상현실·영상 제작·로봇 환경 인식 등 다양한 분야에서 활용될 수 있게 된다.
핵심 요약
다양한 각도의 카메라 정보 없는 RGB 이미지들로부터 대규모 3D 장면의 완전한 메시를 복원하는 생성형 모델 WorldRecon을 제시했다. 입력 이미지로부터 추정한 포인트 클라우드와 카메라 포즈를 전역 스캐폴드로 사용하고, 이를 겹치는 공간 블록으로 분할하여 처리한다. 3D 생성 모델 TRELLIS.2를 개선한 재구성 기반 조건화 아키텍처로 각 블록을 로컬 포인트 클라우드와 해당 이미지로부터 생성하며, 구조·기하·PBR 재료를 출력한다. 전체 요약 6문장 읽기 → 014 18:11 ▲ 25 · 댓글 2 3D 메시 움직임 복원, 스케일 분리로 범용화 희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. AI · 머신러닝 · Cepheid: Decoupling Scale from Structure for Cross-Family Motion Completion
Key Point 3D 애니메이션 제작과 로봇 제어에서 부분 관측만으로 전체 움직임을 복원하는 핵심 문제를 해결했으며, 단일 모델로 다양한 대상에 일반화되는 점이 기술적 진전을 의미한다.
핵심 요약
희소한 정점 변위로부터 촘촘한 메시 움직임을 복원하는 문제를 다룬다. 기존 학습 기반 잔차 사전은 특정 형태군(의류, 동물 등)에서만 기존 조화 확장을 넘지 못했다. 스케일 문제: 기하학 형태군 간 잔차 진폭이 10배 이상 차이나며, 관측값이 많아지면 붕괴된다. 전체 요약 6문장 읽기 → 015 18:11 ▲ 111 · 댓글 1 도시 전체 3D 장면에서 물체를 찾는 AI 에이전트 'Urbex' 공개 도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. AI · 머신러닝 · Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
Key Point 도시 규모 3D 장면 이해 문제를 에이전트 기반의 대화형 탐색으로 재설계해 기존 랭킹 방식의 비효율성을 타파한 새로운 접근법이기 때문입니다.
핵심 요약
도시 규모 3D 씬에서 건물이나 랜드마크 같은 공간 요소를 찾는 문제를 새롭게 정의했다. 기존 방식은 미리 계산한 후보 상자들을 순위매기는 방식이었는데, 대규모 실외 장면에서 비효율적이었다. Urbex는 비전-언어 모델 에이전트가 인터랙티브하게 탐색하도록 설계했다. 전체 요약 8문장 읽기 → 016 06:11 ▲ 10 · 댓글 2 생명과학 LLM이 실제로 생물학 데이터를 활용하지 않는다 DNA, 단백질, 단일세포 작업을 다루는 6개의 생명과학 추론 모델을 검증한 결과, 벤치마크 성능이 높아도 실제로는 생물학적 입력을 거의 활용하지 않는 것으로 나타났다. AI · 머신러닝 · When Do Biological Reasoning Models Use Their Biological Inputs?
Key Point 생명과학 분야의 AI 모델들이 높은 벤치마크 성능을 보이고 있지만, 실제로는 생물학적 데이터를 무시하고 텍스트 정보에만 의존하는 것으로 밝혀져 이들 모델의 신뢰성과 해석 가능성에 근본적인 의문을 제기한다.
핵심 요약
DNA, 단백질, 단일세포 작업을 다루는 6개의 생명과학 추론 모델을 검증한 결과, 벤치마크 성능이 높아도 실제로는 생물학적 입력을 거의 활용하지 않는 것으로 나타났다. BioReason과 BioReason-Pro의 경우 Evo2와 ESM3 같은 생물학 기초 모델의 기여도가 미미했으며, DNA 서열을 무작위로 섞어도 질병 예측 정확도가 거의 변하지 않았다. 두 모델이 텍스트 정보가 아닌 생물학적 입력에 충돌이 있을 때 텍스트를 따르는 비율이 97.9%와 99.7%에 달했다. 전체 요약 8문장 읽기 → 017 21:12 ▲ 11 · 댓글 2 인간의 촉각 데이터 500시간, 로봇 조작 성공률 22.5%→57.5% TouchScale은 500시간 분량의 인간 상호작용 시각·촉각 데이터셋으로, 단일 웨어러블 센서 장비로 통일되어 기록되었다. AI · 머신러닝 · TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
Key Point 로봇 조작에 필요한 촉각 정보를 포함한 대규모 균질 데이터셋이 실제 작업 성공률을 2.5배 향상시켜, 구현화된 AI 시스템 개발의 데이터 기초가 어떻게 바뀌는지 보여준다.
핵심 요약
TouchScale은 500시간 분량의 인간 상호작용 시각·촉각 데이터셋으로, 단일 웨어러블 센서 장비로 통일되어 기록되었다. 각 기록은 정면 RGB-D 비디오, 손목 RGB 비디오, 양손 촉각 측정값이 시간 정렬되어 포함되며 약 2,000개의 사전 정의된 작업 설명을 아우른다. 기존 촉각 데이터와 달리 센서와 수집 절차가 고정되어 있어 데이터 규모의 영향을 명확히 분리할 수 있다. 전체 요약 8문장 읽기 → 018 21:11 당일 +110 Cloudflare Workers를 자체 서버에서 실행하는 오픈소스 celld 공개 Deno Land가 Cloudflare Workers 플랫폼을 자체 인프라에서 실행할 수 있게 하는 오픈소스 데몬 celld를 공개했다. 인프라 · 데브옵스 · denoland/celld · Rust
Key Point 자사 Cloudflare Workers 애플리케이션을 클라우드 의존 없이 완전히 자체 통제하는 인프라에서 운영할 수 있게 되므로, 멀티테넌트 워크로드나 온프레미스 배포가 필요한 조직에 중요한 선택지를 제공한다.
핵심 요약
Deno Land가 Cloudflare Workers 플랫폼을 자체 인프라에서 실행할 수 있게 하는 오픈소스 데몬 celld를 공개했다. Workers, Durable Objects, KV, Queues, D1, R2, Workflows, Cron Triggers, 정적 자산 등 Cloudflare의 모든 주요 서비스를 로컬 클러스터에서 동작시킬 수 있다. 각 객체는 셀(cell)이라는 자체 SQLite 데이터베이스를 가진 명명된 서버이며, 장기 상태는 S3, Google Cloud Storage, Azure Blob Storage 버킷에 저장된다. 전체 요약 13문장 읽기 → 019 21:11 ▲ 20 · 댓글 2 카메라 기하학 조건으로 다중 시점 이미지 합성 3배 가속 소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. AI · 머신러닝 · NAMVIS: Next-Scale Autoregressive Multi-View Image Synthesis
Key Point 3D 콘텐츠 제작에 필수적인 다중 시점 생성을 기존 방식보다 3배 빠르고 더 정확하게 처리하는 기술이 등장했기 때문이다.
핵심 요약
소수의 2D 이미지로부터 3D 콘텐츠를 생성하는 '희소 시점 신규 시점 합성' 문제를 해결하는 NAMVIS 프레임워크를 제안했다. 기존 확산 모델의 반복적 잡음 제거 대신, 이산 시각 토큰을 단계별로 예측하고 모든 토큰을 병렬로 샘플링하는 자동회귀 방식을 사용한다. 멀티스케일 프로젝티브 포즈 인코딩이라는 기법으로 소스·타겟 카메라의 기하학적 변환 정보를 모든 해상도의 셀프-어텐션과 크로스-어텐션에 주입한다. 전체 요약 6문장 읽기 → 020 18:30 ▲ 13 · 댓글 2 조 매개변수 모델도 3분 안에 동기화, NeMo-DCR 논문 발표 에이전트형 강화학습에서 정책 업데이트 후 롤아웃 클러스터로 전송하는 1조 개 매개변수 체크포인트가 현재 87.5분이 걸린다. AI · 머신러닝 · NeMo-DCR: Bit-Exact Delta-Compressed Refit for Scalable Agentic RL at Trillion-Parameter Scale
Key Point 조 개 매개변수 모델의 정책 리핏 시간을 87분에서 2~3분으로 단축하는 기술로, 대규모 에이전트형 강화학습의 실제 운영 가능성을 크게 높인다.
핵심 요약
에이전트형 강화학습에서 정책 업데이트 후 롤아웃 클러스터로 전송하는 1조 개 매개변수 체크포인트가 현재 87.5분이 걸린다. 매개변수 수정(refit) 시 BF16 학습에서 단계당 약 1%의 가중치만 변한다는 측정을 기반으로, NeMo-DCR은 변경값만 전송하면서 비트 단위로 정확히 일치하는 결과를 보장한다. 학습 샤드에서의 변경을 고정 아핀 매핑으로 체크포인트의 정규 좌표계로 투영하고, 잔여 변환으로 나머지를 처리하며, 수신 런타임의 기본 로더가 모든 변경을 저장소에 배치한다. 전체 요약 6문장 읽기 → 021 18:30 ▲ 17 · 댓글 2 광고 영상 생성용 대규모 데이터셋 'AdSpark' 공개 제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AI · 머신러닝 · AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
Key Point 제품 광고 영상 생성이라는 새로운 작업을 위해 처음으로 대규모 구조화 데이터셋과 다차원 평가 프레임워크를 제시해, 이 분야 연구의 기초를 마련한다.
핵심 요약
제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AdSpark-300K는 이커머스 플랫폼 데이터를 바탕으로 약 30만 개의 이미지-프롬프트-영상 3쌍으로 구성되며, 실제 데이터와 합성 데이터 부분집합을 포함한다. 각 샘플에는 제품 식별 주석, 판매 포인트 설명, 창의적 계획, 정렬된 음성 스크립트 등 구조화된 광고 주석이 포함되어 있다. 전체 요약 6문장 읽기 → 022 18:33 ▲ 92 · 댓글 2 MoE 언어모델 강화학습, FP4 저정밀도로 5배 빠르게 대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. AI · 머신러닝 · TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
Key Point MoE 모델의 강화학습 훈련에서 롤아웃 단계의 메모리와 속도 병목을 저정밀도 양자화로 5배 이상 해결할 수 있게 되어, 대규모 모델 학습의 실용성이 크게 향상된다.
핵심 요약
대규모 언어모델의 강화학습 훈련에서 롤아웃(rollout) 생성 과정이 계산과 메모리 오버헤드를 많이 차지하는 문제가 있어, 저정밀도 롤아웃을 통한 효율화가 필요하다. 기존 FP4 강화학습 방법들은 훈련과 롤아웃 경로의 양자화를 독립적으로 최적화하기 때문에 두 경로 간 불일치(discrepancy)가 발생하는 한계가 있다. 연구팀은 TRACE(Train-Rollout Quantization Alignment via Compact GuidancE)라는 FP4 양자화 프레임워크를 제안했으며, 이는 롤아웃 측의 양자화 결과를 훈련 측 반올림 결정에 직접 반영하여 불일치를 줄인다. 전체 요약 7문장 읽기 → 023 18:33 당일 +118 포토샵 호환 이미지 에디터 포토스위트, Rust로 완성 Rust 기반 데스크톱 이미지 에디터 PhotoSuite는 클래식 Photoshop의 동작 방식을 충실히 재현하면서 PSD/PSB 파일을 네이티브로 지원한다. 오픈소스 · 도구 · eolix/photosuite · Rust
Key Point Photoshop의 작동 방식과 PSD 호환성을 Rust로 재현한 완전한 데스크톱 에디터로, 디자이너가 익숙한 인터페이스와 도구로 PSD 파일을 자유롭게 편집할 수 있는 대안을 제공한다.
핵심 요약
Rust 기반 데스크톱 이미지 에디터 PhotoSuite는 클래식 Photoshop의 동작 방식을 충실히 재현하면서 PSD/PSB 파일을 네이티브로 지원한다. Open-source PhotoCraft 엔진(MIT OR Apache-2.0)을 기반으로 하며, 문서 모델, PSD 읽기·쓰기, 합성 및 명령 시스템이 기초를 이루고 있다. Photoshop-PhotoSuite PSD 양방향 변환을 모두 지원할 목표로 진행 중이며, 모든 효과와 Smart Objects/필터를 포함한다. 전체 요약 13문장 읽기 → 024 09:11 ▲ 11 · 댓글 2 SFT에서 토큰 가중치를 다시 설계하다: SCALE 방법론 감독된 미세 조정(SFT)은 모델이 가능성 낮다고 판단한 토큰에서 가장 적극적으로 학습하는데, 이는 새로운 동작을 습득하는 동시에 노이즈나 충돌하는 지도를 증폭하고 기존 사전학습 지식을 덮어쓸 수 있다. AI · 머신러닝 · Rethinking Token Reweighting for SFT: Suppress, Reverse, and Extrapolate Learned Features
Key Point 기존 미세 조정 방식의 근본적인 한계를 분석하고 새로운 기준틀을 제시하는 방법론으로, 수학·코드 성능에서 기존 방식을 초과하면서 실제 모델 개선에 활용될 수 있는 기술입니다.
핵심 요약
감독된 미세 조정(SFT)은 모델이 가능성 낮다고 판단한 토큰에서 가장 적극적으로 학습하는데, 이는 새로운 동작을 습득하는 동시에 노이즈나 충돌하는 지도를 증폭하고 기존 사전학습 지식을 덮어쓸 수 있다. 기존 토큰 재가중치 방법들은 음이 아닌 계수를 할당해 지도 업데이트를 억제하거나 증폭할 수 있지만, 일단 학습된 해로운 특성을 역으로 돌릴 수 없다. 큰 학습 가중치는 최적화 궤적을 바꾸는 것이지 고정된 SFT 방향의 크기를 조정하는 것이 아니므로, 진정한 특성 추외삽은 이루어지지 않는다. 전체 요약 9문장 읽기 → 025 21:11 당일 +221 PC 관리 올인원 도구 '图吧工具箱 CE' 공개 C#과 WinUI 3로 만든 Windows PC 관리 통합 도구로, 내장 47개 기본 도구와 외부 89개 클래식 하드웨어 도구를 통합 관리한다. 하드웨어 · 시스템 · luolangaga/tubatools · C#
Key Point 새 컴퓨터 검수부터 일상 유지보수까지 한 곳에서 해결하는 올인원 유틸리티이며, 특히 AI 어시스턴트로 자연어 명령 실행과 방대한 내장 도구 집합이 주목할 만하다.
핵심 요약
C#과 WinUI 3로 만든 Windows PC 관리 통합 도구로, 내장 47개 기본 도구와 외부 89개 클래식 하드웨어 도구를 통합 관리한다. AI 어시스턴트 기능으로 자연어로 시스템 제어가 가능하며, 28개 에이전트 도구(하드웨어 정보 읽기, 디스크 분석, 가비지 클린, 파일 읽/쓰기, 명령 실행, 온라인 검색)를 지원한다. 성능 테스트는 CPU/GPU/메모리/디스크/브라우저 5개 항목을 측정해 게임·사무 성능 점수와 PDF 보고서를 제공하며, 커뮤니티 순위표에 스코어를 업로드할 수 있다. 전체 요약 13문장 읽기 → 026 03:11 ▲ 26 · 댓글 2 엔터프라이즈 데이터 작업 평가 벤치마크 'Argo-Bench' 공개 기존 text-to-SQL 벤치마크는 쿼리 생성만 평가하며 정답 오류도 빈번한데, 실제 엔터프라이즈 데이터 환경은 수십 개 테이블을 넘나들며 통계 분석과 실행 가능한 의사결정을 요구한다. AI · 머신러닝 · Argo-Bench: Evaluating Data Agents on Enterprise-Scale Workflows
Key Point 엔터프라이즈 규모 데이터 시스템에서 AI가 쿼리 작성을 넘어 실제 의사결정까지 할 수 있는지 평가하는 첫 벤치마크이며, 현재 최강 모델도 35% 미만의 성공률로 데이터 에이전트의 현주소를 보여준다.
핵심 요약
기존 text-to-SQL 벤치마크는 쿼리 생성만 평가하며 정답 오류도 빈번한데, 실제 엔터프라이즈 데이터 환경은 수십 개 테이블을 넘나들며 통계 분석과 실행 가능한 의사결정을 요구한다. Argo-Bench는 뉴욕시 음식배달 플랫폼을 원탁 규모(2024년 주문 8,100만 건)로 시뮬레이션하고 Oracle E-Business Suite 스키마를 따른 235개 테이블, 75억 행의 ERP 웨어하우스를 모델링했다. 210개 데이터 과학·분석 작업으로 구성되며, 에이전트는 웨어하우스를 탐색해 사실을 재구성한 뒤 부정행위자 계정 차단, 배송원 인센티브 예산 할당, 소급 급여 지급 같은 실제 액션을 취해야 한다. 전체 요약 6문장 읽기 → 027 09:11 ▲ 10 · 댓글 2 합성 데이터 사전학습, 규모가 커져도 효과 유지되지만 문법 학습 아니다 합성 비자연어 데이터로 사전학습한 뒤 자연어로 학습하는 PPT(사전사전학습) 방식이 토큰 효율성을 개선하지만, 기존 연구가 주장한 '문법 규칙 학습'이 아니라는 실험 결과가 나왔다. AI · 머신러닝 · Synthetic Pre-pretraining Survives Scale, but Not as a Grammatical Prior
Key Point 합성 데이터 사전학습이 실제로 어떤 원리로 효과를 내는지 바뀌면서, 향후 언어 모델 사전학습 전략의 설계 방향이 재검토되어야 한다.
핵심 요약
합성 비자연어 데이터로 사전학습한 뒤 자연어로 학습하는 PPT(사전사전학습) 방식이 토큰 효율성을 개선하지만, 기존 연구가 주장한 '문법 규칙 학습'이 아니라는 실험 결과가 나왔다. 연구팀이 5가지 PPT 과제, 4가지 학습 데이터 혼합, 500M~7B 모델 규모, 최대 100B 토큰 학습 예산에서 종합 실험을 진행했다. 결과적으로 PPT의 다운스트림 성능과 토큰 효율 개선이 규모에 관계없이 지속되어, 3B 규모에서 최소 21B 토큰을 절약했다. 전체 요약 7문장 읽기 → 028 21:11 당일 +128 다양한 골격에 애니메이션을 주는 통합 모델 UniMate 공개 SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. AI · 머신러닝 · Friedrich-M/UniMate · Python
Key Point 텍스트 기반 3D 애니메이션 생성의 일반화 문제를 단일 모델로 해결한 첫 사례이며, 영상 제작·게임 개발·디지털 캐릭터 제작 분야의 자동화를 크게 앞당길 기술이기 때문이다.
핵심 요약
SIGGRAPH Asia 2026에 채택된 UniMate는 이족·사족·조류·해양·곤충·뱀 형태 및 경직된 물체 등 다양한 골격 구조를 하나의 모델으로 애니메이션하는 기술이다. UniML3D라는 13,006개 텍스트 쌍 모션 시퀀스 데이터셋을 구축했으며, Mixamo, Objaverse-XL, Truebones ZOO에서 수집한 자산을 통일된 형식으로 정규화했다. 텍스트 프롬프트와 3D 리깅된 자산만으로 실시간 모션 생성이 가능하며, 스켈레톤별 재학습이나 테스트 시점 최적화가 필요 없다. 전체 요약 9문장 읽기 → 029 15:11 ▲ 51 · 댓글 3 LLM 직결정 모델의 '중간값 선호 편향' 발견 GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. AI · 머신러닝 · More Choices, Fewer Decisions: Ordinal-Scale Bias in JEV-like Direct-Decision Models
Key Point LLM 기반 자동 평가와 분류 모델이 실제로는 제한된 선택지만 사용하고 있다는 점이 중요하므로, 이들을 프로덕션에 도입할 때 신뢰성을 검증해야 한다.
핵심 요약
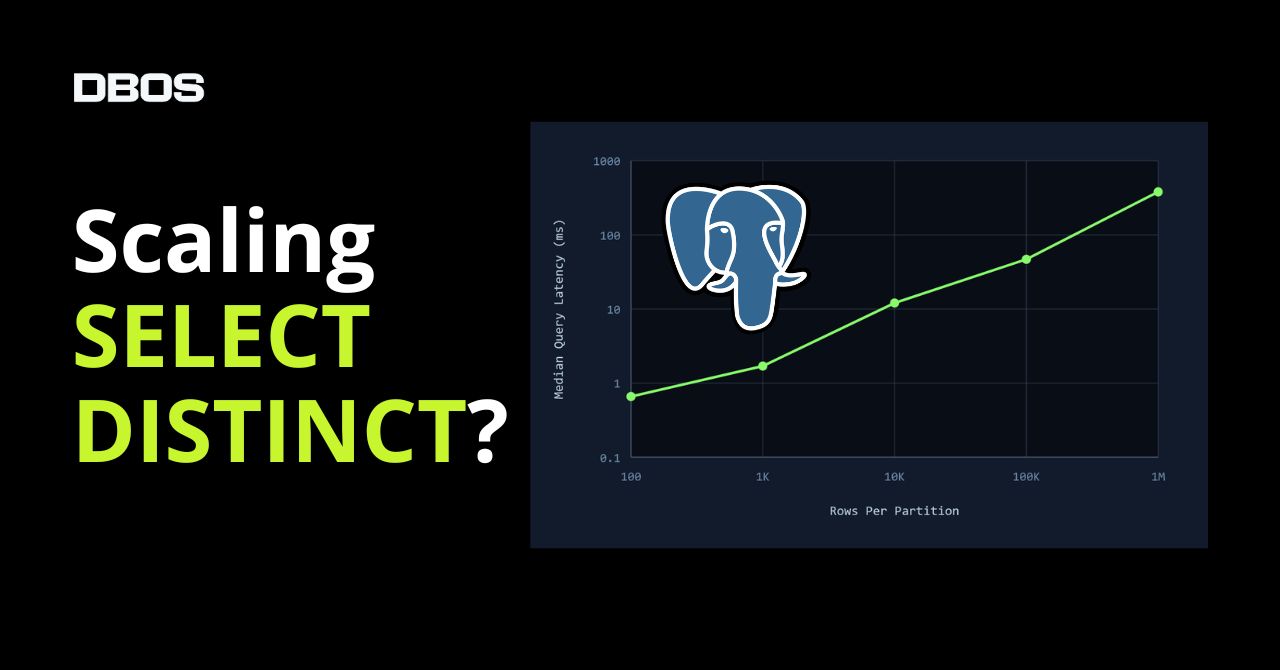
GPT-4V와 오픈소스 KEV 모델들이 제공받은 서수형(ordinal) 척도를 제대로 사용하지 못하는 문제를 분석했다. ANLI 데이터셋에서 GPT-4V는 74.95% 정확도를 보이면서도 전체 예측의 38.8%, 오류의 51.3%를 'Neutral' 중간값에 할당했다. 36개의 서수형 데이터셋 전반에서 모델들은 각 척도의 유효 범위 중 67~76%만 활용했지만, 명목형(nominal) 과제 4개에서는 87~102%를 활용했다. 전체 요약 6문장 읽기 → 030 03:11 ▲ 102 · 댓글 28 PostgreSQL의 SELECT DISTINCT, 행 수에 비례해 느려진다 PostgreSQL의 SELECT DISTINCT는 직관과 달리 인덱스가 아무리 잘 짜여도 항상 조건을 만족하는 모든 행을 풀 스캔한다. 인프라 · 데브옵스 · Postgres SELECT DISTINCT Does Not Scale
Key Point 쿼리 최적화나 데이터베이스 성능에 의존하는 개발자라면 Postgres의 이 근본적 한계를 알아야 대규모 시스템에서 SELECT DISTINCT를 피할 수 있다.
핵심 요약
PostgreSQL의 SELECT DISTINCT는 직관과 달리 인덱스가 아무리 잘 짜여도 항상 조건을 만족하는 모든 행을 풀 스캔한다. 분할된 큐에서 '활성' 파티션을 찾는 쿼리에서 DISTINCT를 썼을 때, 파티션 수가 적어도 초 단위 지연이 발생했다. 같은 파티션 수에서 행 개수만 100에서 1M으로 늘려도 쿼리 시간이 선형으로 증가하는 벤치마크 결과를 확인했다. 전체 요약 9문장 읽기 → 031 22:29 ▲ 134 · 댓글 48 Tailscale, 멀티큐와 메모리 최적화로 처리량 대폭 높인다 Tailscale은 Linux와 Android에서 작은 패킷이 64KB 버퍼에 복사되는 방식을 개선해 메모리 오버헤드를 줄이고 약 5% 속도 향상을 이뤘다. 인프라 · 데브옵스 · Making Tailscale Faster
Key Point Tailscale이 VPN 인프라의 핵심 성능 지표인 처리량과 지연시간을 대폭 개선하는 기술들을 순차 배포하고 있어, 개발자들이 VPN 기반 네트워크 구성을 더 효율적으로 활용할 수 있게 된다.
핵심 요약
Tailscale은 Linux와 Android에서 작은 패킷이 64KB 버퍼에 복사되는 방식을 개선해 메모리 오버헤드를 줄이고 약 5% 속도 향상을 이뤘다. 패킷 큐 길이를 단축해 메모리 절감 효과를 얻었고, 절약된 메모리를 서브넷 라우터와 앱 커넥터에 할당했다. 기존에는 여러 연결의 패킷 스트림을 단일 스레드 파이프라인에서 처리했지만, 새로운 멀티큐 시스템으로 패킷별 레인(lane)을 분리해 병렬 처리를 가능하게 했다. 전체 요약 8문장 읽기 → 032 16:18 ▲ 32 · 댓글 2 영상 생성 모델 평가용 대규모 벤치마크 'OmniVBench' 공개 참조 영상 기반 비디오 생성(R2V)의 평가와 학습을 위한 'OmniVBench' 벤치마크와 34만 개 샘플의 Omni-R2V 데이터셋을 공개했다. AI · 머신러닝 · OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation
Key Point 참조 기반 영상 생성의 평가 기준과 학습 자료가 부족한 상황에서, 34만 개 규모의 산업 수준 데이터셋과 체계적 벤치마크를 제공해 R2V 모델 개발의 표준을 제시한다.
핵심 요약
참조 영상 기반 비디오 생성(R2V)의 평가와 학습을 위한 'OmniVBench' 벤치마크와 34만 개 샘플의 Omni-R2V 데이터셋을 공개했다. 콘텐츠, 모션, 스타일, 구조, 내러티브 등 7개 태스크 패밀리와 18개 세부 과제를 포함하며, 기존 벤치마크보다 다양한 참조 유형과 조합을 다룬다. 12,172개의 체크리스트 항목으로 구성된 '요소 기반 평가'를 도입해 참조 요소의 보존, 분리, 실현 여부를 세밀하게 검증한다. 전체 요약 5문장 읽기 → 033 16:18 ▲ 112 · 댓글 3 깃허브 코드에서 AI 에이전트용 스킬 자동 추출 Code2Skill이라는 파이프라인으로 19,769개 깃허브 저장소의 코드를 자동 분석해 100만 개 이상의 검증된 스킬 데이터베이스를 구축했다. AI · 머신러닝 · Grounded Skill Synthesis from Code at Scale for Agentic Intelligence
Key Point 에이전트 AI에 필요한 재사용 가능한 스킬을 스케일로 자동 확보할 수 있는 새로운 경로를 제시하며, 기존 방법의 한계를 보완하는 동시에 성능 개선을 입증했다.
핵심 요약
Code2Skill이라는 파이프라인으로 19,769개 깃허브 저장소의 코드를 자동 분석해 100만 개 이상의 검증된 스킬 데이터베이스를 구축했다. 추출한 스킬에는 원자적 작업, 복합 워크플로우, 반복 패턴이 포함되며 소스 코드 재구성과 비교로 검증된다. 이 방식은 환경 상호작용이 필요 없으면서도 실행 가능한 증거를 제공한다는 점에서 기존 궤적 기반 방식과 다르다. 전체 요약 5문장 읽기 → 034 03:10 ▲ 105 · 댓글 52 PostgreSQL 전문검색 확장 TIN 정식 출시 PlanetScale이 PostgreSQL용 전문검색(full-text search) 확장인 TIN(Text INdex)을 정식 출시했다. 인프라 · 데브옵스 · Tin: full-text search for Postgres
Key Point PostgreSQL 사용자가 가장 많이 요청해온 기능이 드디어 실용적으로 구현되었고, 기존 솔루션들의 성능과 기능을 크게 앞서므로 데이터베이스 선택에 영향을 줄 것이다.
핵심 요약
PlanetScale이 PostgreSQL용 전문검색(full-text search) 확장인 TIN(Text INdex)을 정식 출시했다. 불리언 연산, 구문 쿼리, 퍼지·와일드카드·정규표현식 매칭, BM25 스코링 등을 지원하며 기존 Postgres 전문검색 확장들과 달리 조인·트랜잭션 가시성·동시 업데이트를 모두 처리할 수 있다. 85GB 코퍼스(Stack Exchange 1,500만 문서)에서 TIN은 ParadeDB보다 초당 쿼리 25배 많이 처리하고 P99 지연은 26배 낮았다. 전체 요약 5문장 읽기 → 035 06:10 ▲ 104 · 댓글 43 32년 된 텔넷 버그, GNU inetutils에서 발견 1994년에 발생한 CVE-2026-32746는 GNU inetutils의 텔넷 데몬에 숨겨진 사전 인증 취약점이다. 인프라 · 데브옵스 · A 32-year-old bug walks into a Telnet server
Key Point 오래된 인프라에서 여전히 광범위하게 사용 중인 텔넷의 심각한 원격 코드 실행 취약점으로, 영향 범위가 매우 광범위하고 대다수 주요 리눅스 배포판이 영향을 받는다.
핵심 요약
1994년에 발생한 CVE-2026-32746는 GNU inetutils의 텔넷 데몬에 숨겨진 사전 인증 취약점이다. LINEMODE SLC(Set Linemode Characters) 협상 핸들러에서 발생하는 BSS 기반 버퍼 오버플로우로, 약 400바이트의 인접 변수를 손상시킬 수 있다. GNU inetutils를 기반으로 한 대부분의 텔넷 구현에 영향을 미치며, Ubuntu, Debian, FreeBSD, NetBSD, Citrix NetScaler, 애플 macOS, TrueNAS Core 등이 포함된다. 전체 요약 5문장 읽기 → 036 21:11 당일 +165 Tailscale 오픈소스로 만든 암호화 터널 도구 Tailcat Tailscale의 데이터 플레인(magicsock)을 이용해 netcat 같은 암호화 터널을 제공하는 오픈소스 도구다. 오픈소스 · 도구 · tailscale/tailcat · Go
Key Point Tailscale의 검증된 암호화 기술을 별도 계정 없이 가벼운 도구로 사용할 수 있어, 보안이 필요한 P2P 통신이 필요한 개발자와 시스템 관리자에게 실용적이다.
핵심 요약
Tailscale의 데이터 플레인(magicsock)을 이용해 netcat 같은 암호화 터널을 제공하는 오픈소스 도구다. WireGuard 암호화와 DERP 릴레이를 통해 NAT 우회 없이 P2P 연결을 지원하며, Tailscale 계정이나 관리자 권한 없이 사용할 수 있다. CLI 도구와 Go 라이브러리로 제공되며, 서버 측이 주소를 생성하고 클라이언트가 그 주소로 연결하는 방식이다. 전체 요약 5문장 읽기 → 037 03:10 당일 +131 게임 업스케일러를 자유롭게 바꿔주는 도구 OptiScaler DLSS2+, FSR2+, XeSS를 지원하는 게임에서 업스케일러를 다른 기술로 대체할 수 있는 미들웨어 도구. 하드웨어 · 시스템 · optiscaler/OptiScaler · C++
Key Point GPU 제조사와 무관하게 게임에서 기본 제공하는 업스케일러를 자신의 GPU에 최적화된 다른 기술로 교체할 수 있어, 모든 사용자가 최고의 성능을 선택할 수 있다.
핵심 요약
DLSS2+, FSR2+, XeSS를 지원하는 게임에서 업스케일러를 다른 기술로 대체할 수 있는 미들웨어 도구. DLSS·XeSS·FSR 입력을 가로채서 원하는 업스케일러 출력으로 변환하며, FSR4까지 지원한다. 프레임 생성 기능도 관리하며 DX12 게임에서 실험적 OptiFG를 통해 프레임 생성을 활성화할 수 있다. 전체 요약 5문장 읽기 → 038 18:10 ▲ 100 · 댓글 49 PlanetScale, 초대형 데이터베이스 'Neki' 1억 1800만 초당 쿼리 기록 PlanetScale이 플랫폼 프리뷰 단계의 새로운 데이터베이스 Neki로 118.5백만 초당 쿼리 처리 능력을 실증했다. 인프라 · 데브옵스 · 118M Queries per Second on Neki
Key Point PlanetScale이 대규모 분산 데이터베이스의 선형 확장성을 입증함으로써 초고처리량 데이터 시스템 구축의 실현 가능성을 보여준다.
핵심 요약
PlanetScale이 플랫폼 프리뷰 단계의 새로운 데이터베이스 Neki로 118.5백만 초당 쿼리 처리 능력을 실증했다. 512개 샤드와 1.22 PiB 데이터를 사용해 16분간 지속적으로 이 성능을 유지했으며, 샤드 개수 증가에 따라 처리량이 선형으로 확장되었다. 각 샤드마다 Postgres 주 인스턴스(r8g.16xlarge)를 두고 480개의 라우터로 관리했으며, 클라이언트 지연 시간은 p99 기준 13.95ms였다. 전체 요약 4문장 읽기 → 039 15:10 ▲ 100 · 댓글 32 1980년대 Intel 8087 칩의 마이크로코드 역공학 프로젝트 Intel 8087 부동소수점 코프로세서는 1980년 출시되어 현대 컴퓨터의 부동소수점 표준이 되었으며, IBM PC에 설치되어 연산 속도를 최대 100배 향상시켰다. 하드웨어 · 시스템 · Microcode in Intel's 8087 floating-point chip: the scale instruction
Key Point 부동소수점 연산의 표준이 된 40년 전 칩의 내부 회로를 물리적으로 역공학하는 과정이 기술사와 아키텍처 이해에 어떻게 기여하는지 보여준다.
핵심 요약
Intel 8087 부동소수점 코프로세서는 1980년 출시되어 현대 컴퓨터의 부동소수점 표준이 되었으며, IBM PC에 설치되어 연산 속도를 최대 100배 향상시켰다. Opcode Collective는 8087의 마이크로코드를 역공학하고 있으며, FSCALE(부동소수점 스케일) 명령어를 분석했다. FSCALE은 2의 거듭제곱으로 숫자를 스케일링하는 명령어이며, 곱셈보다 훨씬 빠르게 동작한다. 전체 요약 6문장 읽기 → 040 06:10 ▲ 139 · 댓글 54 페타바이트급 ClickHouse 클러스터 6년 운영 노하우 Tinybird에서 6년간 페타바이트 규모의 ClickHouse 클러스터를 운영해온 경험을 바탕으로 설치보다는 운영이 어렵다는 점을 강조했습니다. 인프라 · 데브옵스 · I've operated petabyte-scale ClickHouse clusters for 5 years
Key Point 페타바이트급 대규모 데이터 인프라를 운영하는 팀의 실제 경험에서 나온 아키텍처 결정, 비용 최적화, 그리고 오픈소스 ClickHouse의 한계를 명확히 보여줍니다.
핵심 요약
Tinybird에서 6년간 페타바이트 규모의 ClickHouse 클러스터를 운영해온 경험을 바탕으로 설치보다는 운영이 어렵다는 점을 강조했습니다. 샤드 없이 수직 확장 레플리카로 시작한 후, HTTP 기반 로드 밸런서로 트래픽을 라우팅하고 쓰기 전용 레플리카를 분리하는 구조를 채택했습니다. 300TB 테이블에 1000 QPS를 처리하려면 10개 레플리카가 필요해 3000TB 용량이 필요하므로 SSD 비용이 매우 큰 문제가 됩니다. 전체 요약 5문장 읽기 → 041 09:10 ▲ 189 · 댓글 97 PlanetScale, Postgres 샤딩 솔루션 'Neki' 공개 PlanetScale이 Postgres 샤딩 솔루션 'Neki'를 플랫폼 프리뷰로 공개했다. 인프라 · 데브옵스 · Neki – Sharded Postgres
Key Point 단일 Postgres 머신의 한계에 도달한 대규모 워크로드가 유지보수 창 없이 진정한 Postgres 기능을 유지하면서 수평 확장할 수 있는 선택지가 생겼다.
핵심 요약
PlanetScale이 Postgres 샤딩 솔루션 'Neki'를 플랫폼 프리뷰로 공개했다. 표준 Postgres 와이어 프로토콜을 사용하는 Neki 라우터를 통해 연결하면 기존 드라이버·ORM·연결 문자열이 그대로 작동하며, 각 샤드는 3개 가용 영역에 걸친 프라이머리 1개와 레플리카 2개 이상을 갖춘 완전한 Postgres 클러스터다. 데이터 토폴로지 JSON 설정으로 테이블을 물리 샤드에 매핑하고, 스키마 변경·버전 업그레이드·페일오버·리샤딩 등이 모두 온라인 워크플로우로 진행되어 유지보수 창이 불필요하다. 전체 요약 6문장 읽기 → 042 00:10 ▲ 669 · 댓글 262 Cerebras와 OpenAI, GPT-5.6 Sol 울트라팩스트 모드 공개 Cerebras와 OpenAI가 새로운 서비스 계층 울트라팩스트 모드를 OpenAI API에 출시했으며, 초당 최대 750개 토큰을 생성한다. AI · 머신러닝 · Accelerating GPT-5.6 Sol Ultrafast
Key Point 고성능 AI 추론 기술의 실질적 진전을 보여주는 사례로, GPU 기반 시스템의 근본적 한계를 새로운 아키텍처로 극복한 점이 개발자 커뮤니티의 관심을 받고 있다.
핵심 요약
Cerebras와 OpenAI가 새로운 서비스 계층 울트라팩스트 모드를 OpenAI API에 출시했으며, 초당 최대 750개 토큰을 생성한다. 울트라팩스트 모드는 Fable 5보다 11배, Opus 4.8 Fast 모드보다 5배 빠르며, 품질 저하 없이 동작한다. Cerebras의 Wafer-Scale Engine 아키텍처가 칩에 44GB SRAM을 탑재하여 메모리 대역폭 병목을 제거해 고속 추론을 실현한다. 043 20:31 ▲ 123 · 댓글 44 SQLite 10년 묵은 WAL 버그, AI가 15분만에 포착 SQLite 3.51.3에서 2010년부터 존재해온 WAL-Reset 버그가 패치되었다. 인프라 · 데브옵스 · Breaking the WAL
Key Point 데이터베이스 커뮤니티에서 악명 높은 SQLite의 오랜 결함이 발견·검증된 사례와 AI 에이전트 활용법이 화제를 모으고 있다.
핵심 요약
SQLite 3.51.3에서 2010년부터 존재해온 WAL-Reset 버그가 패치되었다. Antithesis 도구와 Claude AI를 사용해 단순한 쓰기 및 체크포인트 작업만으로 15분 내에 버그를 재현하고 검증했다. Tailscale은 이 버그로 6개월간 업타임 문제를 겪었으며, 수주간의 디버깅과 2개월 대기 끝에 최종 수정안을 배포했다.