쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
100건 (최대치) · "라우팅"조건 지우기 ×
001 06:11 ▲ 101 · 댓글 6 JAX만으로 DeepSeek V3 구현, 190줄 코드로 MacBook에서 학습 DeepSeek V3 기술 보고서의 아키텍처를 순수 JAX 190줄로 구현하고, MacBook Air에서 처음부터 학습했다. AI · 머신러닝 · Show HN: DeepSeek V3 in ~200 lines of pure Jax
Key Point 순수 JAX로 DeepSeek V3 전체 아키텍처를 간결하게 구현한 오픈소스 프로젝트로, 최신 대형 언어모델의 내부 동작을 학습 코드와 함께 읽고 이해할 수 있는 기회를 제공한다.
핵심 요약
DeepSeek V3 기술 보고서의 아키텍처를 순수 JAX 190줄로 구현하고, MacBook Air에서 처음부터 학습했다. 멀티헤드 레이턴트 어텐션(MLA)은 토큰당 480개에서 144개 숫자로 압축하여 캐시 크기를 줄였고, 디커플된 RoPE와 DeepSkMoE(공유 전문가 1개 + 라우팅된 전문가 16개, 토큰당 상위 4개 선택) 기법을 적용했다. 보조 손실 없는 밸런싱은 전문가별 바이어스를 조정하여 라우팅을 유휴 전문가로 유도하고, 시퀀스 단위 밸런스 손실(α = 1e-4)과 멀티토큰 예측(λ = 0.3) 모듈을 추가했다. 전체 요약 10문장 읽기 → 002 15:11 ▲ 136 · 댓글 25 GGML 1.0.0 출시, 모든 백엔드 성능 대폭 개선 GGML 1.0.0이 공개되었으며, 구식 API를 정리하고 레거시 DIAG_MASK 연산을 제거했으며 RPC 프로토콜을 v9로 업그레이드했다. AI · 머신러닝 · Ggml v1.0.0
Key Point LLM 추론 속도와 효율성을 크게 좌우하는 GGML 1.0.0은 CUDA, Metal, Vulkan, OpenCL 등 주요 백엔드에서 연산 융합과 양자화 최적화를 대폭 강화해 실제 성능에 직결되는 변화다.
핵심 요약
GGML 1.0.0이 공개되었으며, 구식 API를 정리하고 레거시 DIAG_MASK 연산을 제거했으며 RPC 프로토콜을 v9로 업그레이드했다. YaRN 잘림 설정을 조정할 수 있는 ggml_rope_set_truncate/ggml_rope_get_truncate가 추가되었고, TRI의 역전파가 구현되었다. 스케줄러가 읽지 않는 입력은 업로드를 건너뛰고 미리 불러오기를 최적화해 효율성을 개선했다. 전체 요약 9문장 읽기 → 003 12:11 ▲ 103 · 댓글 21 Perplexity, 의사결정 특화 AI 모델 Decider v1.3 공개 Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. AI · 머신러닝 · Perplexity Decider v1.3: Training, eval, and use cases
Key Point 의사결정 전문 AI 모델로 한 번의 연산으로 여러 분류 작업을 수행해 기존 LLM 대비 훨씬 빠르고 저렴하게 구조화된 답변이 필요한 서비스(검색, 라우팅, 필터링 등)를 처리할 수 있다.
핵심 요약
Perplexity가 Decider v1.3과 Decider Flash v1.3을 출시했으며, 양쪽 모두 Hugging Face(Apache 라이선스), OpenRouter, Perplexity Decisions API를 통해 이용 가능하다. 의사결정 모델은 입력과 질문 집합을 받아 각 질문에 대한 확률 분포를 반환하는 범용 분류기로, Yes/No(이진), 다중선택, 점수(순서 있는 수준) 세 가지 질문 유형을 지원한다. 기존 생성형 LLM 대신 의사결정 모델을 사용하면 단일 포워드 패스에서 여러 질문을 동시에 처리하므로 토큰 하나씩 생성하는 오버헤드를 피하고 계산을 공유할 수 있다. 전체 요약 13문장 읽기 → 004 09:11 ▲ 257 · 댓글 60 구글, 코딩용 '제미나이 4 하이드로겐' 공개…동적 모델 라우팅 '오케스트레이터'도 구글이 Google Antigravity에서 Gemini 4 Hydrogen 모델을 공개했다. AI · 머신러닝 · Gemini 4 Hydrogen and Orchestrator
Key Point 정적 모델 라우팅의 한계를 벗고, 작업 단계에 따라 고성능과 경량 모델을 동적으로 전환하는 새로운 접근법이 코딩 워크플로우의 효율성과 비용을 어떻게 개선하는지 보여준다.
핵심 요약
구글이 Google Antigravity에서 Gemini 4 Hydrogen 모델을 공개했다. Hydrogen과 함께 새로운 옵션인 Orchestrator가 출시되었으며, 이는 Hydrogen을 Carbon 같은 고성능 모델과 짝지어 품질·효율성·지연시간의 최적 균형을 맞춘다. Orchestrator는 동적으로 Carbon과 Hydrogen을 전환하는 방식으로 작동한다: 예를 들어 Carbon이 의존성을 탐색하고 계획을 세운 뒤 Hydrogen이 코드 작성·패키지 업데이트·테스트를 실행하고, 문제 발생 시 다시 Carbon으로 돌아가 상태를 검사한다. 전체 요약 9문장 읽기 → 005 03:11 ▲ 106 · 댓글 41 구형 기기에 LLM 돌리기, 기술 한계 뚫다 오래된 저사양 기기(TV 박스, 스마트폰, 싱글보드 컴퓨터)에 큰 언어 모델을 고속으로 실행시키는 기술을 공개했다. AI · 머신러닝 · I'm making LLMs work on small and old devices
Key Point 오래된 저가 기기들이 LLM 추론을 실시간 속도로 실행할 수 있다는 증명으로, 엣지 AI와 오프라인 모델 배포의 현실성을 보여준다.
핵심 요약
오래된 저사양 기기(TV 박스, 스마트폰, 싱글보드 컴퓨터)에 큰 언어 모델을 고속으로 실행시키는 기술을 공개했다. 시아오미 TV 박스(Cortex-A55 4코어, 1.9GB RAM, 278MB/s 플래시)에서 0.8B~16B 모델을 260K부터 16B 파라미터까지 지원한다. Qwen3.5-0.8B는 7.5→16.8 tok/s로 2.2배 가속, Qwen3.5-2B는 0.1→7.7 tok/s로 77배 개선, 8B 모델은 5~7 tok/s에서 실행된다. 전체 요약 10문장 읽기 → 006 21:11 ▲ 16 · 댓글 3 프롬프트 특성 파악해 LLM 추론 비용 최적화하는 라우팅 기법 대규모 언어 모델(LLM) 서비스는 다양한 요청에 대해 응답 품질과 추론 비용의 균형을 맞춰야 한다. AI · 머신러닝 · Ensemble Routing for Prompt-Adaptive Cost-Aware LLM Inference
Key Point 프롬프트의 복잡도에 맞춰 LLM 앙상블을 동적으로 구성해 비용 대비 성능을 최적화하는 새로운 방식으로, API 기반 LLM 서비스의 경제성을 크게 개선할 수 있다.
핵심 요약
대규모 언어 모델(LLM) 서비스는 다양한 요청에 대해 응답 품질과 추론 비용의 균형을 맞춰야 한다. 기존 라우팅은 각 프롬프트마다 단일 모델을 선택하거나 고정된 앙상블 구성을 사용해 개별 요청에 적응하지 못했다. 논문은 프롬프트 적응형 비용 인식 라우터 PISA와 앙상블 확장 버전인 PISA-E를 제시한다. 전체 요약 10문장 읽기 → 007 09:11 ▲ 224 · 댓글 74 구글, 의사결정 전문 AI API 공개…150ms 내 1000개 질문 처리 구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. AI · 머신러닝 · Gemini Decisions API
Key Point 의사결정에 특화된 저지연 API가 등장하며 AI 애플리케이션의 라우팅·검증·분류 작업 방식이 바뀌고, 기존 대비 5배 저렴한 가격과 3가지 질문 유형 지원으로 구현 복잡도를 크게 낮춘다.
핵심 요약
구글이 Gemini Decision 1 모델 기반의 Decisions API를 출시했으며, 텍스트·이미지·오디오·비디오·PDF를 포함한 멀티모달 입력에서 최대 1000개의 예/아니오, 선택지, 루브릭 채점 질문을 한 번의 API 호출로 처리할 수 있다. 토큰별 생성이 아닌 단일 포워드 패스 방식으로 동작해 중앙값 50~100ms 모델 계산 시간(엔드투엔드 150~250ms)의 저지연을 유지하며, 최대 16K 토큰 컨텍스트에서 질문 1~100개 구간에서도 거의 선형적인 성능을 보인다. 에이전트 라우팅·추론·랭킹·멀티모달 이해 벤치마크에서 Gemini Decision 1이 최고 성능을 기록했으며, 보정 오류도 가장 낮다. 전체 요약 8문장 읽기 → 008 09:11 ▲ 135 · 댓글 24 애플, RAG 검색 속도 최대 11배 개선하는 신경망 기법 공개 추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. AI · 머신러닝 · Faster Retrieval for Better, More Efficient RAG
Key Point RAG 기반 AI 애플리케이션의 검색 속도가 최대 11배 개선되면 응답 시간 단축과 인프라 비용 절감이 직결되므로, 대규모 검색 시스템을 운영 중인 개발팀과 MLOps 담당자에게 즉시 실무 적용 가능한 최신 최적화 기법이다.
핵심 요약
추천 시스템, 검색, RAG의 핵심인 최대내적탐색(MIPS)은 쿼리 벡터와 수백만 개 후보 벡터를 비교해야 해 계산 비용이 급증하는 문제가 있다. 기존 방법들은 클러스터링과 양자화로 속도를 높이지만 쿼리 분포를 무시하고, RAG에서는 사용자 질문(쿼리)과 문서(키)의 특성이 크게 달라 최적이 아니다. 애플 연구팀은 ICML 2026에서 쿼리별 라우팅을 학습하는 소형 신경망 두 가지를 제시했다: SupportNet은 각 클러스터별 지원함수(support function)를 학습해 라우팅 정확도를 높이고, KeyNet은 쿼리를 최적 키로 직접 변환해 기존 인덱스와 결합한다. 전체 요약 8문장 읽기 → 009 09:11 ▲ 321 · 댓글 73 구글 Gemini, 개인 메일과 드라이브 파일을 인간 검수자에게 전달 구글이 2023년 Gemini Workspace 출시 당시 개인 Gmail·Docs·Drive 콘텐츠는 인간 검수자가 보지 않는다고 명시했으나, 10월 16일 공식 문서를 수정해 개인 파일과 이메일이 인간 검수 파이프라인으로 라우팅된다고 확인했다. 보안 · Google Gemini routes personal Drive files and emails to human annotators
Key Point 구글이 개인정보 보호를 명시적으로 약속한 제품에서 그 약속을 몰래 철회했고, 사용자 동의 없이 민감한 개인정보가 계약직 검수자에게 노출될 수 있으며, 이 과정이 감지하거나 통제하기 어렵게 설계되어 있기 때문이다.
핵심 요약
구글이 2023년 Gemini Workspace 출시 당시 개인 Gmail·Docs·Drive 콘텐츠는 인간 검수자가 보지 않는다고 명시했으나, 10월 16일 공식 문서를 수정해 개인 파일과 이메일이 인간 검수 파이프라인으로 라우팅된다고 확인했다. 사용자가 @Drive나 @Gmail 태그를 사용하지 않은 일상적인 대화에서도 자동으로 개인 정보(여행, 청구서, 이름, 예약 등)가 배경에서 검색 트리거되며, 이 과정은 확률적이다. LLM 도구 호출의 확률적 특성으로 인해 같은 쿼리도 네 가지 결과를 낼 수 있다: ① 검색 안 함, ② 메타데이터/요약만 제공, ③ 민감한 개인정보를 포함한 2~4문장 인용, ④ 전체 파일 내용 그대로 입력. 전체 요약 6문장 읽기 → 010 09:11 새 버전 올라마 0.40.16 출시, Ripple 모델 지원 추가 올라마 v0.40.16이 릴리스되었다. 오픈소스 · 도구 · ollama/ollama@v0.40.16
Key Point 로컬 LLM 개발·배포의 중심 도구인 올라마의 기능 확대와 최적화가 이뤄졌으며, 특히 65B 코딩 전문 모델 추가와 메모리 효율성 개선으로 실무 적용 성이 높아진다.
핵심 요약
올라마 v0.40.16이 릴리스되었다. Recursive Intelligence의 Ripple Preview라는 65B 규모 에이전틱 코딩 모델을 새로 지원한다. Qwen3.8 Flash는 애플 실리콘에서 약 27GB 메모리를 절약하도록 최적화되었다. 전체 요약 9문장 읽기 → 011 06:11 ▲ 42 · 댓글 8 LLM 에이전트가 PCB 라우팅 엔지니어 수준에 도달했나 PCB 라우팅은 전체 연결 구조를 파악하면서 동시에 기하학적 제약을 만족하는 복잡한 작업이며, 기존 자동화 방법들은 복잡한 보드에서 신뢰도가 낮았다. AI · 머신러닝 · PCBRouteAgent: How Close Are LLM Agents to Becoming PCB Routing Engineers?
Key Point PCB 설계 자동화가 LLM 에이전트 기술로 실무 수준에 가까워졌으며, 실제 보드에서 기존 방법을 크게 앞질렀다는 점이 의미 있습니다.
핵심 요약
PCB 라우팅은 전체 연결 구조를 파악하면서 동시에 기하학적 제약을 만족하는 복잡한 작업이며, 기존 자동화 방법들은 복잡한 보드에서 신뢰도가 낮았다. PCBRouteAgent는 인간 엔지니어처럼 전역 전략과 지역 실행을 조율하는 멀티모달 에이전트로, 이미지와 전기·기하학 정보를 조합해 연결 위상(topology), 라우팅 순서, 경로(corridor), 층 전환을 결정한다. 전역 라우팅 플래너가 상위 계획을 수립하고, 상세 라우팅 실행기가 KiCad 네이티브 엔진을 통해 이를 구현하며, 실패한 부분을 구조화된 피드백으로 반환해 가이드를 개선할 수 있다. 전체 요약 5문장 읽기 → 012 06:11 ▲ 162 · 댓글 66 메타, 에이전트 작업용 경량 모델 뮤즈 엠버 공개 메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. AI · 머신러닝 · Our Smallest, Most Efficient Model: Muse Ember
Key Point 에이전트 AI가 상용화되면서 도구 호출과 반복 작업에 최적화된 경량 모델의 필요성이 높아졌는데, 뮤즈 엠버는 기존 모델보다 훨씬 저렴한 비용으로 더 나은 성능을 제시해 생산 AI 시스템의 비용 구조를 바꿀 가능성을 보여준다.
핵심 요약
메타가 복잡한 추론 실행과 에이전트 작업에 특화된 경량 모델 뮤즈 엠버를 발표했다. 뮤즈 엠버는 Claude Haiku 5.5보다 약 3분의 1 비용으로 동일 수준의 성능을 내며, 모든 GPT-4o Luna 설정을 능가한다. 가격 대비 성능 지수에서 Artificial Analysis 전체 리더보드 효율성 경계선에 위치한다. 전체 요약 13문장 읽기 → 013 00:11 ▲ 100 · 댓글 100 애플, 엔지니어 AI 비용을 하루 200달러로 제한 애플이 일부 엔지니어의 일일 AI 지출 상한을 300달러에서 200달러로 인하했으며, 이는 AI 지출이 예산을 초과할 위험을 나타낸다. AI · 머신러닝 · Apple capped engineers at a $200 daily AI budget
Key Point 업계 최강자인 애플도 AI 지출 제한을 시작했다는 것은 생성형 AI의 실제 비용이 개발사들의 예상을 초과하고 있음을 의미하며, 모든 개발팀이 토큰 효율성을 심각하게 재검토해야 하는 상황이 됐다는 신호다.
핵심 요약
애플이 일부 엔지니어의 일일 AI 지출 상한을 300달러에서 200달러로 인하했으며, 이는 AI 지출이 예산을 초과할 위험을 나타낸다. 미시간대학교 연구팀은 영어가 아닌 언어의 프롬프트가 영어보다 최대 179배 많은 에너지를 소비한다고 발견했다. 팔로알토 네트웍스가 AI 에이전트 접근제어 기술을 갖춘 사이버보안 스타트업 클러치 인수를 추진 중이며, 인수가는 약 5억 달러다. 전체 요약 9문장 읽기 → 014 21:11 당일 +323 AI 에이전트를 위한 고속 샌드박스 런타임 OpenSandbox 공개 OpenSandbox는 자체 인프라에서 AI 에이전트를 격리된 환경으로 실행하는 샌드박스 런타임이며, 로컬 Docker부터 Kubernetes까지 통일된 API로 배포된다. 오픈소스 · 도구 · opensandbox-group/OpenSandbox · Python
Key Point AI 에이전트가 코드를 안전하게 격리 실행할 필요성이 증가하는 가운데, 엔터프라이즈급 Kubernetes 환경까지 지원하는 오픈소스 샌드박스 런타임이 공개되어 에이전트 애플리케이션 개발 방식에 영향을 줄 수 있다.
핵심 요약
OpenSandbox는 자체 인프라에서 AI 에이전트를 격리된 환경으로 실행하는 샌드박스 런타임이며, 로컬 Docker부터 Kubernetes까지 통일된 API로 배포된다. Firecracker 기반의 고속 샌드박스 런타임을 제공하며 P50 64ms, P99(10개 동시) 125.4ms 속도로 생성 가능하고 pause/resume 시 메모리·디스크 상태를 보존한다. 코드 실행, 파일 관리, 명령어 실행, 브라우저·데스크톱 작동 등을 지원하고 통합 ingress 게이트웨이로 인바운드 트래픽을 라우팅하며 sandbox별 egress 정책으로 아웃바운드 접근을 제어한다. 전체 요약 10문장 읽기 → 015 06:11 새 버전 Angular 22.2.5 배포, rxResource와 폼 기능 개선 Angular 22.2.5 버전이 배포되었다. 웹 · 프론트엔드 · angular/angular@v22.2.5
Key Point rxResource 디버깅 옵션 추가와 폼 검증·라우팅 개선으로 Angular 개발자의 개발 효율과 애플리케이션 안정성이 향상된다.
핵심 요약
Angular 22.2.5 버전이 배포되었다. core 모듈에서 rxResource에 debugName 옵션을 추가하고, 코멘트 마커 이스케이프 처리를 개선했다. img/video 요소의 src 속성이 null이나 undefined일 때 자동으로 속성을 제거하도록 수정했다. 전체 요약 6문장 읽기 → 016 21:12 당일 +169 Vue 2 공식 지원 종료, Vue 3로 마이그레이션 권장 Vue 2는 2023년 12월 31일 End of Life에 도달하여 더 이상 새 기능, 업데이트, 버그 수정을 받지 않는다. 웹 · 프론트엔드 · vuejs/vue · TypeScript
Key Point Vue 2를 사용 중인 개발자들이 공식 지원 종료로 인한 영향을 파악하고 Vue 3 마이그레이션 또는 장기 지원 옵션을 검토해야 하기 때문입니다.
핵심 요약
Vue 2는 2023년 12월 31일 End of Life에 도달하여 더 이상 새 기능, 업데이트, 버그 수정을 받지 않는다. 기존 배포 채널(CDN, 패키지 매니저, GitHub 등)에서는 계속 이용 가능하지만, 새 프로젝트는 Vue 3.x로 시작할 것을 권장한다. 현재 Vue 2 사용자들은 마이그레이션 가이드를 통해 Vue 3로 업그레이드할 것을 강력히 권고한다. 전체 요약 6문장 읽기 → 017 21:12 당일 +305 Angular, TypeScript 기반 웹 개발 플랫폼 Angular는 TypeScript/JavaScript를 사용해 모바일과 데스크톱 웹 애플리케이션을 빌드하는 개발 플랫폼이다. 웹 · 프론트엔드 · angular/angular · TypeScript
Key Point Angular의 최신 개발 현황과 학습·기여 경로를 한눈에 파악할 수 있으며, TypeScript 기반 웹 프레임워크를 찾는 개발자들의 공식 진입점이다.
핵심 요약
Angular는 TypeScript/JavaScript를 사용해 모바일과 데스크톱 웹 애플리케이션을 빌드하는 개발 플랫폼이다. angular.dev에서 시작 가이드부터 컴포넌트·템플릿, 폼, 라우팅 등 기초 문서와 Angular Elements, 서버 사이드 렌더링, Schematics 같은 고급 주제를 다룬다. Node.js와 NPM을 설치한 후 Angular CLI를 전역으로 설치하고 워크스페이스를 생성해 5분 내 시작할 수 있다. 전체 요약 7문장 읽기 → 018 21:12 당일 +162 AI 에이전트를 위한 초경량 오케스트레이터 Rivet 오픈소스 공개 Rivet Actors는 에이전트 워크로드를 위한 오케스트레이터로, 전통적인 샌드박스 대신 경량의 long-lived 프로세스 방식으로 운영한다. AI · 머신러닝 · rivet-dev/rivet · Rust
Key Point 에이전트와 long-lived 워크로드의 비용과 성능이 급부상하면서, 샌드박스 기반 아키텍처의 한계를 해결하는 오픈소스 플랫폼으로 개발 방식을 바꿀 수 있다.
핵심 요약
Rivet Actors는 에이전트 워크로드를 위한 오케스트레이터로, 전통적인 샌드박스 대신 경량의 long-lived 프로세스 방식으로 운영한다. 각 Actor는 72 KB 메모리만 사용하며 p99 cold start가 4.99ms로, 샌드박스의 512 MiB와 1.70초와 비교해 극히 낮다. Actor는 인메모리 상태, SQLite 데이터베이스, WebSocket, 스케줄링을 내장하고, 유휴 중일 때는 비용이 들지 않으며 요청 시 복원된다. 전체 요약 10문장 읽기 → 019 21:12 당일 +116 Go의 초고속 웹 프레임워크 Gin 1.12.0 출시 Go로 작성된 고성능 HTTP 웹 프레임워크 Gin 1.12.0이 출시되었으며, Martini 스타일의 API를 제공하면서 httprouter를 통해 최대 40배 빠른 성능을 자랑한다. 웹 · 프론트엔드 · gin-gonic/gin · Go
Key Point Gin은 한국 개발자들이 Go로 REST API와 마이크로서비스를 빠르게 구축해야 할 때 가장 널리 선택하는 프레임워크로, 최신 버전 출시와 함께 성능·기능·커뮤니티 지원 수준을 확인할 수 있다.
핵심 요약
Go로 작성된 고성능 HTTP 웹 프레임워크 Gin 1.12.0이 출시되었으며, Martini 스타일의 API를 제공하면서 httprouter를 통해 최대 40배 빠른 성능을 자랑한다. Gin은 REST API, 웹 애플리케이션, 마이크로서비스 구축에 설계되었으며 Express.js 같은 간단한 라우팅과 Go의 성능 특성을 결합한다. 주요 기능으로는 힙 할당 없는 제로 알로케이션 라우터, 뛰어난 성능, 미들웨어 지원, 크래시 방지, JSON 검증, 라우트 그룹화, 에러 관리, 다양한 렌더링 포맷을 지원한다. 전체 요약 8문장 읽기 → 020 12:54 ▲ 11 · 댓글 2 루프 구조 언어 모델 Dory1.0-4B 공개, 작은 규모로 더 큰 모델 능력 구현 Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. AI · 머신러닝 · Dory1.0-4B: A Looped Normalized-GPT
Key Point 작은 규모 모델이 루프 구조를 통해 더 큰 모델 수준의 성능을 달성할 수 있다는 것을 보여주며, 토큰 생성 효율과 메모리 사용 최적화 방식이 에지 디바이스와 추론 비용 절감에 영향을 미친다.
핵심 요약
Hugging Face와 아카이브 논문 공개: 43억 파라미터 규모의 루프형 언어 모델 Dory1.0-4B를 발표했다. 정규화 Transformer 기반으로 입력 블록, 공유 루프 블록, 출력 블록으로 구성하며, 추론 시 루프 블록을 가변 횟수로 반복 실행할 수 있다. 6조 개 토큰으로 사전 학습했으며, 초기 4.5조 토큰은 NVFP4 양자화로 학습했고 이후 컨텍스트 길이를 256K로 확장했다. 전체 요약 9문장 읽기 → 021 00:11 ▲ 105 · 댓글 84 ISP가 DNS 쿼리를 가로채 가짜 IP로 응답하고 있었다 Podman 컨테이너가 외부 사이트에 연결되지 않자 DNS 설정을 확인하던 중, Google DNS와 Cloudflare DNS에서 같은 IP를 받았으나 Cloudflare의 DoH 엔드포인트에선 전혀 다른 IP가 나왔다. 인프라 · 데브옵스 · So my ISP was hijacking my DNS
Key Point ISP의 DNS 변조는 신뢰할 수 없는 상황을 만드는데, DoT나 DoH 같은 암호화 프로토콜이 어떻게 이를 막는지, 그리고 DNSSEC가 이 문제를 해결하지 못하는 이유를 구체적으로 보여준다.
핵심 요약
Podman 컨테이너가 외부 사이트에 연결되지 않자 DNS 설정을 확인하던 중, Google DNS와 Cloudflare DNS에서 같은 IP를 받았으나 Cloudflare의 DoH 엔드포인트에선 전혀 다른 IP가 나왔다. 첫 번째 DNS 응답의 IP를 조사하니 자신의 ISP 소유였고, ISP가 DNS 쿼리를 가로채 변조된 IP 주소를 반환하고 있음을 발견했다. DNS 쿼리는 여러 네임서버를 거쳐 일어나며, 전통적으로 평문 UDP를 사용하기 때문에 ISP가 감시하거나 변조할 수 있다. 전체 요약 10문장 읽기 → 022 00:11 ▲ 10 · 댓글 1 트랜스포머 레이어 동적 순서 재구성으로 효율성·제어성 높인다 연구팀은 기존 언어 모델처럼 고정된 레이어 순서로 실행하는 대신, 추론 시 동적으로 레이어 순서를 재배열하는 Library of Layers(LoL) 아키텍처를 제안했다. AI · 머신러닝 · Library of Layers (LoL): Adaptively Ordering Transformer Layers at Runtime
Key Point 프로그래머가 같은 명령을 다른 순서로 조합하듯, 트랜스포머도 레이어 순서를 문제별로 동적 선택하면 파라미터와 연산량을 동시에 절약하면서 더 해석 가능한 모델을 만들 수 있다는 점이 중요하다.
핵심 요약
연구팀은 기존 언어 모델처럼 고정된 레이어 순서로 실행하는 대신, 추론 시 동적으로 레이어 순서를 재배열하는 Library of Layers(LoL) 아키텍처를 제안했다. LoL은 트랜스포머 블록의 글로벌 라이브러리 크기 하나의 하이퍼파라미터로 조절하면서 파라미터 재사용과 희소성 사이를 자유롭게 전환할 수 있다. 이를 통해 기존의 밀집 아키텍처, 깊이-순환 모델, 혼합 전문가(MoE) 아키텍처의 파라미터 효율성과 연산량 효율성 트레이드오프를 하나의 통합 체계 안에서 일반화한다. 전체 요약 8문장 읽기 → 023 21:11 당일 +227 스포티파이, AI 코드 에디터용 Portal 플러그인 공개 스포티파이가 Claude Code, Codex, Cursor, pi 등 AI 코드 에디터를 위한 Portal AI 플러그인을 공개했다. AI · 머신러닝 · spotify/portal-ai-plugins · TypeScript
Key Point 개발팀이 사용하는 AI 코드 에디터에서 직접 조직의 소프트웨어 카탈로그와 운영 정보에 접근할 수 있게 되어, 코딩 중 컨텍스트 전환을 줄일 수 있다.
핵심 요약
스포티파이가 Claude Code, Codex, Cursor, pi 등 AI 코드 에디터를 위한 Portal AI 플러그인을 공개했다. Portal CLI를 통해 인증 설정, 소프트웨어 카탈로그 검색, 서비스 상태 리포트, 진단 실행, Portal 액션 실행 등의 워크플로우를 제공한다. 자연어 쿼리로 카탈로그와 기술 문서를 검색하고, 소유권·상태·장애·문서 정보를 담은 간결한 서비스 브리핑을 생성할 수 있다. 전체 요약 8문장 읽기 → 024 18:11 ▲ 85 · 댓글 2 AI 시스템이 상황마다 최적의 모델을 고르는 법 통용 AI 시스템이 다양한 도메인과 모달리티를 다루려면 여러 전문 모델과 도구를 조율하는 라우팅 기법이 필요하다. AI · 머신러닝 · Route Anything: A Study of Model and Policy Routing for General-Purpose AI Systems
Key Point 다양한 AI 작업을 하나의 시스템으로 처리할 때 여러 모델 중 각 상황에 맞는 것을 자동으로 선택하는 기법이 실제로 얼마나 효과적인지 처음 대규모 검증했기 때문이다.
핵심 요약
통용 AI 시스템이 다양한 도메인과 모달리티를 다루려면 여러 전문 모델과 도구를 조율하는 라우팅 기법이 필요하다. Route Anything은 모델과 정책 라우팅을 통일된 프레임워크로 연구하며, 품질-비용 균형 속에서 최적 라우팅 조건을 수학적으로 규명한다. 언어 이해, 이미지·비디오·음성 생성, 코딩 에이전트, 로봇 조작 등 25개 벤치마크에서 452개 후보 모델 조합으로부터 37만 4401건의 평가 데이터를 수집했다. 전체 요약 6문장 읽기 → 025 18:11 ▲ 27 · 댓글 2 동영상에서 학습 데이터를 자동 생성하는 AI 에이전트 멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. AI · 머신러닝 · VidUEU-Agent: A Data-Curation Agent for Multimodal Understanding, Editing, and Unified Tasks
Key Point 동영상에서 자동으로 멀티모달 학습 데이터를 생성하고 최적화하는 방식이 멀티모달 AI 모델 개발의 데이터 부족 문제를 어떻게 풀 수 있는지 보여주는 실질적인 접근법이다.
핵심 요약
멀티모달 학습 발전이 고품질 학습 데이터 부족과 높은 레이블링 비용으로 제한되고 있는 상황에서, VidUEU-Agent는 원본 동영상에서 자동으로 학습 데이터를 생성하는 파이프라인을 제시한다. 4단계 파이프라인으로 구성되며, 저품질 장면을 필터링하고, 핵심 프레임과 멀티모달 신호를 추출한 뒤, 메타데이터를 구성하고 라우팅하여 학습 샘플을 합성한다. 에이전트 프레임워크는 다운스트림 학습 결과를 기반으로 자동으로 데이터 분포를 반복 최적화하여 데이터 품질, 균형, 학습 효율성을 개선한다. 전체 요약 5문장 읽기 → 026 06:11 ▲ 105 · 댓글 46 완전 오픈소스 리눅스 기반 네트워크 멀티툴 '플리퍼 원' 사전주문 시작 Rockchip RK3576 ARM 프로세서 기반의 완전 오픈소스 리눅스 컴퓨터 '플리퍼 원'의 사전주문을 시작했다. 하드웨어 · 시스템 · Preparing for the Flipper One Kickstarter and opening pre-orders
Key Point 완전 오픈소스 구조와 M.2 확장성을 갖춘 리눅스 네트워크 기기로, 네트워크 엔지니어와 보안 연구자가 자유롭게 커스터마이징할 수 있는 도구가 나온다.
핵심 요약
Rockchip RK3576 ARM 프로세서 기반의 완전 오픈소스 리눅스 컴퓨터 '플리퍼 원'의 사전주문을 시작했다. 메인라인 커널 지원, 바이너리 blob 제거, 벤더 종속성 없는 순수 오픈소스 환경을 추구하며, Collabora 팀과 협력해 RK3576을 메인라인 커널에 통합 중이다. Raspberry Pi RP2350 저전력 MCU와 RK3576 고성능 CPU 두 프로세서가 병렬로 동작해, 리눅스 OS가 꺼져 있어도 MCU로 LCD와 물리 버튼을 제어할 수 있다. 전체 요약 10문장 읽기 → 027 18:11 새 버전 Ollama v0.40.14 출시, Claude 모델 토큰 제한 개선 Ollama launch claude 명령이 Claude 모델의 출력 토큰 제한을 적용하여 클라우드 모델이 기본 128k 상한에 걸리지 않도록 개선했다. AI · 머신러닝 · ollama/ollama@v0.40.14
Key Point Claude 모델 통합 개선과 OpenAI 호환성 버그 수정으로 로컬 LLM 모델 서빙의 안정성과 호환성이 강화된다.
핵심 요약
Ollama launch claude 명령이 Claude 모델의 출력 토큰 제한을 적용하여 클라우드 모델이 기본 128k 상한에 걸리지 않도록 개선했다. /api/chat의 웹 검색 응답이 압축된 응답을 포함하여 올바르게 디코딩되도록 수정했다. OpenAI 호환 엔드포인트가 더 이상 모델의 기본 샘플러 설정을 덮어쓰지 않으므로, 온도/top_p를 지정하지 않은 클라이언트는 1.0 대신 모델의 기본값을 받는다. 전체 요약 7문장 읽기 → 028 18:11 ▲ 102 · 댓글 70 우편 배송 축소로 시골 지역 투표용지 반송 급증 미국 우편청(USPS)의 비용 절감을 위한 지역 배송 최적화(RTO) 프로그램으로 인해 시골 지역에서 투표용지 반송 비율이 급증했다. 기타 · Ballot Rejections Have Soared in Rural Counties as USPS Reduces Mail Service
Key Point 우편청의 비용 절감이 정부가 보장해야 할 기본적인 투표권 행사에 직접 영향을 미치고 있으며, 시골 지역과 특정 정치 진영의 유권자를 차별적으로 영향시키는 문제를 드러낸다.
핵심 요약
미국 우편청(USPS)의 비용 절감을 위한 지역 배송 최적화(RTO) 프로그램으로 인해 시골 지역에서 투표용지 반송 비율이 급증했다. 워싱턴주 동부 11개 시골 카운티에서 2026년 예비선거 때 약 2,000장의 투표용지가 늦게 도착했으나, 2022년 같은 시기에는 약 600장으로, 2배 이상 증가했다. USPS는 처리 비용을 절감하기 위해 지역 처리 시설에서 50마일 이상 떨어진 우체국의 일일 수집 횟수를 2회에서 1회로 줄였으며, 이는 배송 시간과 소인 날짜를 지연시켰다. 전체 요약 12문장 읽기 → 029 21:11 당일 +322 375개 AI 제공업체를 하나의 엔드포인트로 관리하는 무료 게이트웨이 OmniRoute 다양한 AI API 제공업체 375개(150개 이상 무료)를 단일 엔드포인트로 라우팅하는 오픈소스 게이트웨이 OmniRoute를 발표했다. AI · 머신러닝 · cheaper-inference/OmniRoute · TypeScript
Key Point 무료 AI API를 여러 개 연결해 토큰 부족으로 인한 중단을 없애려는 개발자나 자체 모델 서비스를 구축하려는 팀에게 실제 비용과 복잡도를 크게 줄일 수 있는 솔루션이다.
핵심 요약
다양한 AI API 제공업체 375개(150개 이상 무료)를 단일 엔드포인트로 라우팅하는 오픈소스 게이트웨이 OmniRoute를 발표했다. Claude, GPT, Gemini, Kimi, GLM, DeepSeek, MiniMax 등 1,400개 이상 모델을 지원하며 Claude Code, Cursor, Cline 등 다양한 코딩 에디터와 호환된다. 연결된 제공업체의 무료 티어를 조합해 월 약 1.62억 토큰을 무료로 사용 가능하며, 할당량 자동 감지 및 자동 폴백으로 중단 없는 서비스를 보장한다. 전체 요약 10문장 읽기 → 030 09:11 당일 +124 NetBird: 피어투피어 기반 Zero Trust 네트워크 플랫폼 NetBird는 WireGuard 기반의 피어투피어 오버레이 네트워크를 자동으로 구성하며, 포트 개방과 복잡한 방화벽 규칙 없이 암호화된 터널로 머신들을 연결한다. 인프라 · 데브옵스 · netbirdio/netbird · Go
Key Point WireGuard 기반의 간단한 셀프호스트 네트워크 인프라를 찾는 팀과 개인, 그리고 NAT 환경에서 안전한 피어투피어 연결이 필요한 경우에 직접 적용할 수 있다.
핵심 요약
NetBird는 WireGuard 기반의 피어투피어 오버레이 네트워크를 자동으로 구성하며, 포트 개방과 복잡한 방화벽 규칙 없이 암호화된 터널로 머신들을 연결한다. 신원 기반 Zero Trust 접근 제어로 세분화된 정책을 한 곳에서 관리할 수 있으며, 조직이나 홈 네트워크 모두에 적용 가능하다. Linux, macOS, Windows, Android, iOS, FreeBSD, pfSense, OPNsense, MikroTik RouterOS, OpenWRT, Synology, TrueNAS, Proxmox, Raspberry Pi, 서버리스, 컨테이너 등 다양한 플랫폼을 지원한다. 전체 요약 14문장 읽기 → 031 00:11 ▲ 10 · 댓글 2 AI 이미지 편집 에이전트, 다중 도구와 검증으로 성능 40% 향상 기존 에이전트형 이미지 편집 시스템은 복잡한 작업을 단계별로 분해하지만, 단계가 실패하면 제한된 도구로 재시도하고 수동 평가에만 의존한다. AI · 머신러닝 · EditAgent: Rethinking Agentic Image Editing
Key Point 에이전트형 이미지 생성 도구의 근본적인 한계를 지적하고, 일반 LLM 모델로도 효과적인 개선이 가능함을 보여주기 때문이다.
핵심 요약
기존 에이전트형 이미지 편집 시스템은 복잡한 작업을 단계별로 분해하지만, 단계가 실패하면 제한된 도구로 재시도하고 수동 평가에만 의존한다. 이들 에이전트는 실행 가능한 작업의 범위와 판단자가 감지할 수 있는 정보의 범위라는 두 가지 제약에 묶여 있다. 기존 범용 이미지 편집기는 전문가 주석이 달린 벤치마크에서 40% 이상의 경우 사용 가능한 결과를 내지 못했고, 편집 유형에 따라 신뢰할 만한 판단자도 없었다. 전체 요약 7문장 읽기 → 032 12:11 ▲ 17 · 댓글 3 멀티토큰 예측, KL 신호 복원으로 한 줄 개선 Multi-Token Prediction(MTP)은 언어모델 사전학습에서 다음토큰 예측과 추론 속도를 모두 개선하지만, 표준 MTP 훈련에 결함이 있어 모델 규모가 커질수록 그래디언트 간섭 문제가 심해진다. AI · 머신러닝 · Multi-Token Prediction Done Right
Key Point 언어모델 훈련의 표준 기법인 MTP의 수학적 결함을 밝혀내고 한 줄 코드 변경으로 해결하는 방법을 제시했기 때문에, 대규모 모델 훈련 효율과 추론 속도를 동시에 개선할 수 있다.
핵심 요약
Multi-Token Prediction(MTP)은 언어모델 사전학습에서 다음토큰 예측과 추론 속도를 모두 개선하지만, 표준 MTP 훈련에 결함이 있어 모델 규모가 커질수록 그래디언트 간섭 문제가 심해진다. MTP 교차엔트로피 그래디언트는 수학적으로 분해되는데, 유용한 KL 자기증류 항과 신호대잡음비가 낮은 잔여항으로 나뉜다. 저자들은 KL 그래디언트 복원 트릭을 제시했다: 두 분포가 선형 출력층을 공유할 때, 스트레이트스루 그래디언트 라우팅으로 교차엔트로피 그래디언트를 조합하여 KL 발산의 그래디언트를 정확히 복원할 수 있다. 전체 요약 9문장 읽기 → 033 21:11 당일 +112 Rust로 만든 투명 프록시 엔진 honk 공개 dae와 sing-box의 디자인에서 영감을 받아 Linux용 투명 프록시 엔진을 Rust로 구현한 honk를 공개했다. 인프라 · 데브옵스 · daeuniverse/honk · Rust
Key Point Linux 투명 프록시를 self-hosted하려는 개발자에게 eBPF 기반의 성능 있는 오픈소스 구현이 등장했으며, 다양한 프로토콜과 라우팅 정책을 지원한다.
핵심 요약
dae와 sing-box의 디자인에서 영감을 받아 Linux용 투명 프록시 엔진을 Rust로 구현한 honk를 공개했다. TC eBPF와 컴파일된 라우팅을 통해 LAN과 호스트 발생 트래픽의 투명 TCP/UDP 프록시를 지원한다. SOCKS5, Shadowsocks/2022, Trojan, Hysteria2, TUIC, VMess, VLESS 등 다양한 아웃바운드 프로토콜을 지원하며, Trojan/VMess/VLESS는 H2 XHTTP를 지원한다. 전체 요약 10문장 읽기 → 034 18:11 ▲ 101 · 댓글 3 확인된 부분만 처리하는 비전-언어 모델, 연산 35% 수준으로 줄인다 Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. AI · 머신러닝 · Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
Key Point 비전-언어 모델의 추론 속도를 현격히 높이는 기술로, 대규모 멀티모달 모델을 실제 제품에 적용하려는 개발자들에게 중요한 최적화 방안을 제시한다.
핵심 요약
Diffusion 기반 비전-언어 모델(DVLM)은 모든 디노이징 단계에서 전체 입력을 처리하는데, 이 중 시각 토큰이 89~97%를 차지해 대부분의 연산이 이미지 재처리에 낭비된다. 연구팀이 LLaDA-V 모델의 예측을 검토한 결과, 이미지 제거 시 토큰 언마스킹이 변하는 경우가 평균 22.8%, 최저 7.9%에 불과했다. LOWN이라는 새로운 디코딩 방식을 제안했으며, 매 단계마다 이미지 처리 여부와 언마스킹할 토큰 수를 동적으로 결정한다. 전체 요약 7문장 읽기 → 035 03:11 새 버전 Angular v22.2.4 패치 릴리스 Angular 22.2.4가 릴리스되었다. 컴파일러에서 객체 프로토타입 이름의 속성이 번역되는 것으로 잘못 처리되는 문제를 해결하고, JIT 모드에서 v22 이전 라이브러리를 위해 즉시 변경 감지(Eager change detection)로 기본 설정하며, 잘못된 템플릿 리터럴 보간에 대한 에러를 보고한다. 웹 · 프론트엔드 · angular/angular@v22.2.4
Key Point Angular 22.2.4는 컴파일러, 폼 처리, i18n, 라우팅 등 핵심 부분의 안정성과 성능을 개선하는 여러 버그 수정을 포함하고 있어, 기존 애플리케이션의 신뢰성을 높일 필요가 있다.
핵심 요약
Angular 22.2.4가 릴리스되었다. 컴파일러에서 객체 프로토타입 이름의 속성이 번역되는 것으로 잘못 처리되는 문제를 해결하고, JIT 모드에서 v22 이전 라이브러리를 위해 즉시 변경 감지(Eager change detection)로 기본 설정하며, 잘못된 템플릿 리터럴 보간에 대한 에러를 보고한다. 컴파일러-CLI는 @jridgewell/sourcemap-codec 1.6.0 이상을 요구하도록 업데이트되었다. 코어에서는 i18n 수화 중 공유 ICU 케이스 큐를 변경하는 문제를 방지하고, 파라미터 미변경 시 리소스 재로드를 피하며, 타겟팅 변경 감지 모드에서 뷰 이펙트 에러를 포착한다. 전체 요약 11문장 읽기 → 036 03:11 ▲ 11 · 댓글 2 사전학습 데이터의 어휘 흔적이 모델 성능에 미치는 영향 제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. AI · 머신러닝 · The Lexical Imprint of Pre-training Data
Key Point 사전학습 말뭉치의 어휘 특성이 모델의 제로샷 성능에 직접적인 영향을 미친다는 인과관계를 실증적으로 입증하며, 데이터 선택과 라우팅을 통한 성능 최적화의 가능성을 제시한다.
핵심 요약
제로샷 벤치마크 성능이 사전학습 말뭉치와 벤치마크 목표 간의 단어 수준 정렬에 얼마나 의존하는지 연구한 논문이다. 단어 단위 유니그램 교차 엔트로피(UCE)라는 토크나이저 무관의 모델 자유 지표를 제안해 참조 말뭉치와 목표 벤치마크 간 어휘 정렬을 측정한다. 우도 학습은 사전학습 말뭉치로부터 모델의 예측 분포를 형성하며, 우도 기반 평가의 제로샷 점수는 그 말뭉치와 벤치마크 사이의 어휘 정렬에 부분적으로 의존한다. 전체 요약 8문장 읽기 → 037 00:11 새 버전 허깅페이스 Transformers v5.22.0, 미스트랄 라지 4 모델 지원 미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. AI · 머신러닝 · huggingface/transformers@v5.22.0
Key Point 1조 파라미터 오픈 가중치 멀티모달 모델의 등장으로 로컬 추론과 파인튜닝이 가능해지며, 기존 폐쇄형 모델과 경쟁 가능한 성능(사이버보안·금융·법률·시각적 근거 찾기)을 제시한다.
핵심 요약
미스트랄이 공개한 라지 4(르 숑크)는 1조 파라미터 규모의 네이티브 멀티모달 혼합 전문가 모델로, 토큰당 49억 개의 활성 파라미터(임베딩과 출력층 포함 52억 개)를 가지고 있다. 유럽 미스트랄 데이터센터의 3800개 엔비디아 그레이스 블랙웰 GPU로 처음부터 학습했으며, 명령어 따르기·추론·코딩·에이전트 작업을 단일 가중치로 통합한다. 160개 이상의 언어에 네이티브로 유창하며, EU 공식 언어 전체를 지원한다. 전체 요약 10문장 읽기 → 038 15:11 ▲ 389 · 댓글 3 멀티모달 에이전트의 자동 성장 체계 'Trinity' 공개 멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. AI · 머신러닝 · The Trinity:Capability-Driven Recursive Self-Improvement for Multimodal Agents
Key Point 멀티모달 에이전트의 확장성을 해결하는 자동 성장 프레임워크로, 수작업 없이 능력 기반으로 환경과 모듈을 동시에 진화시키는 혁신적 방식을 보여준다.
핵심 요약
멀티모달 에이전트의 자동 진화를 위해 환경 생성과 작업 학습을 함께 진행하는 'The Trinity' 프레임워크가 제안되었다. 기존 방식은 검증 가능한 환경 구축과 수동 작업 설계에 비용이 많이 드는 문제를 마주했다. 핵심 아이디어는 겉모양은 다르지만 같은 능력 요구사항을 가진 작업들을 찾아내 계층적으로 정리하는 것이다. 전체 요약 8문장 읽기 → 039 15:11 ▲ 22 · 댓글 5 MoE 모델의 채널 선택, 보정 데이터 없이 가능 Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. AI · 머신러닝 · Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
Key Point 현재 MoE 모델 최적화의 표준인 보정 기반 임계값이 예산 보장과 성능 향상을 모두 충족하지 못하며, 보정 없는 top-k와 경량 리더로 더 안정적이고 빠른 디코딩을 달성할 수 있음을 보여준다.
핵심 요약
Mixture-of-Experts(MoE) 모델은 대화형 디코딩 중 라우팅된 전문가 가중치를 메모리에서 로드할 때 병목을 겪으며, 채널 선택기는 각 토큰에 실질적으로 영향을 주는 채널만 읽어 이를 완화한다. 기존 방식은 오프라인 데이터로 보정한 임계값을 사용하지만, 임계값을 통과하는 채널 수는 입력마다 달라져 실제 읽기 예산이 불안정하다: Prox는 18% 읽기 예산으로 보정되었으나 실제로는 평균 12.9%만 읽는다. Top-k 방식은 각 토큰의 k개 최고점수 채널을 선택하며 보정 데이터가 필요 없다. 전체 요약 8문장 읽기 → 040 06:11 ▲ 13 · 댓글 2 로봇 조작의 멀티뷰 활용을 높이는 FocusVLA 기법 로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. AI · 머신러닝 · FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
Key Point 로봇 조작의 정확도가 실무에서 중요한 만큼, 멀티뷰 센서 데이터를 효율적으로 활용하는 방법은 제조 로봇, 협업 로봇 개발에 직결된다.
핵심 요약
로봇 조작을 위한 VLA 모델이 시각, 언어, 행동을 통합하지만 기존 모델들이 멀티뷰 이점을 충분히 활용하지 못하고 있다. 실험 결과 기존 VLA 모델들이 손목 카메라(wrist view)에 지나치게 의존하면서 조작 단계별로 전역 관점과 국소 관점의 균형을 동적으로 조정하지 못하는 문제를 확인했다. 이를 해결하기 위해 FocusVLA를 제안하는데, 이전 행동으로부터 미래 상호작용 의도를 예측하고 이를 행동 생성 중 뷰 라우팅에 활용한다. 전체 요약 7문장 읽기 → 041 06:11 새 버전 Hugging Face Transformers v5.21 릴리스, 5개 신규 모델 추가 Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. AI · 머신러닝 · huggingface/transformers@v5.21
Key Point 문서 이해, 음성 합성 등 신규 모델 5개가 추가되고 병렬 처리·양자화·캐시 처리가 크게 개선되어 LLM과 멀티모달 모델 개발자들에게 직접적인 영향이 있다.
핵심 요약
Transformers 라이브러리가 v5.21.0을 릴리스했으며, 문서 인식부터 음성 합성까지 5개 모델을 새로 지원한다. MiniCPM-OCR은 OpenBMB의 모델로 SigLIP 비전 인코더와 Qwen3.5 언어 모델을 결합해 스캔 페이지, 스크린샷, 영수증 등 텍스트 밀집 이미지를 읽는다. Flint는 Recursive의 혼합 전문가 모델로 슬라이딩 윈도우 주의(512개 토큰 범위)와 완전 주의를 결합하며, 각 희소 계층이 256개 전문가 중 6개를 라우팅한다. 전체 요약 12문장 읽기 → 042 21:12 당일 +107 InkOS 2.0, 소설·각본·인터랙티브 창작 에이전트 InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. AI · 머신러닝 · Narcooo/inkos · TypeScript
Key Point 장편 소설의 설정·복선 일관성 문제를 상태 검증과 원자적 저장으로 다루는 창작 에이전트 구조를 볼 수 있다.
핵심 요약
InkOS는 장편·단편 소설, 각본, 스토리보드, 인터랙티브 게임, IP 콘텐츠, 다국어 번역을 한 작업대에서 다루는 스토리 창작 AI 에이전트 시스템이며 Studio, TUI, CLI 인터페이스를 지원한다. v2.0.0은 pi-agent 기반의 단일 프로덕션 하니스로 통합됐다. 모델은 이해와 제안, 호출을 맡고 InkOS는 확인, 컨텍스트, 상태, 원자적 저장을 맡는다. 1.x 프로젝트는 `inkos work migrate --json`으로 점검하고 `--apply`로 통합 창작 라이브러리에 가져온다. 원본 디렉터리와 백업은 유지되며 충돌 시 기존 작품을 덮어쓰지 않는다. 전체 요약 11문장 읽기 → 043 21:12 ▲ 503 · 댓글 218 엔비디아, AI 에이전트 샌드박스 OpenShell 0.1.0 공개 엔비디아가 자율 AI 에이전트 플릿을 위한 안전한 런타임 'OpenShell'의 0.1.0 안정화 버전을 출시했으며, 새로운 격리 기법과 확장 API를 포함하고 있다. AI · 머신러닝 · OpenShell – A safe, private runtime for fleets of autonomous AI agents
Key Point AI 에이전트에게 능력을 주면서도 데이터·자격증·네트워크 접근을 제한하는 커널 수준의 격리 방식이 자율 에이전트 배포의 보안 문제를 어떻게 풀고 있는지 보여준다.
핵심 요약
엔비디아가 자율 AI 에이전트 플릿을 위한 안전한 런타임 'OpenShell'의 0.1.0 안정화 버전을 출시했으며, 새로운 격리 기법과 확장 API를 포함하고 있다. OpenShell은 AI 에이전트가 파일 읽기, 패키지 설치, API 호출, 자격증 사용이 필요할 때 정책 선언을 통해 무제한 접근을 제한하면서 이를 가능하게 한다. 커널 수준에서 각 에이전트를 격리된 샌드박스에서 실행하고, 모든 파일 접근, 시스템 콜, 네트워크 연결을 런타임에 정책으로 제어한다. 전체 요약 12문장 읽기 → 044 21:11 당일 +202 컨테이너 없이 프로세스 샌드박싱하는 경량 도구 공개 Anthropic이 Sandbox Runtime(srt)을 오픈소스로 공개했으며, 이는 컨테이너 없이 OS 수준에서 파일시스템과 네트워크 제약을 강제하는 경량 샌드박싱 도구다. 인프라 · 데브옵스 · anthropics/sandbox-runtime · TypeScript
Key Point 컨테이너의 오버헤드 없이 OS 원시 기능으로 AI 에이전트와 로컬 도구를 안전하게 격리하려는 개발자들에게 필요한 인프라가 등장했다.
핵심 요약
Anthropic이 Sandbox Runtime(srt)을 오픈소스로 공개했으며, 이는 컨테이너 없이 OS 수준에서 파일시스템과 네트워크 제약을 강제하는 경량 샌드박싱 도구다. macOS는 sandbox-exec과 Seatbelt 프로필을, Linux는 bubblewrap을 사용해 격리를 구현하고, Windows는 전용 사용자 계정과 WFP 필터로 제약을 적용한다. 네트워크는 기본적으로 모두 차단되며, allowedDomains/deniedDomains로 명시적으로 허용하는 방식을 사용한다. 파일 읽기는 기본 허용이고 denyRead/allowRead로 제어하며, 쓰기는 기본 차단이고 allowWrite로만 허용한다. 전체 요약 11문장 읽기 → 045 18:11 ▲ 100 · 댓글 73 webOS TV를 로컬 기반 스마트 TV로 재개발하는 프로젝트 리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. 하드웨어 · 시스템 · Show HN: Making a smart TV dumb and then smart
Key Point webOS TV 펌웨어 수정을 통해 로컬 제어 기반의 스마트 TV를 만드는 구체적인 기술 구조와 제약·위험 요소를 보여준다.
핵심 요약
리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. TV 펌웨어의 특정 빌드 버전을 대상으로 루트 권한으로 벤더 시스템 서비스를 수정하므로 보증 소실 위험이 있으며, 재부팅이나 초기화 전까지 TV를 사용할 수 없을 수 있다. 원격 컨트롤러의 음성 입력, 홈 화면 라우팅, 네이티브 음성 캡처 등이 벤더 서비스를 후킹하며, 펌웨어 SHA-256 핀과 코드 오프셋이 특정 빌드에만 유효하다. 전체 요약 12문장 읽기 → 046 18:11 ▲ 24 · 댓글 2 LLM 라우팅의 실행 방식까지 함께 학습하는 RouteWeaver LLM 라우팅은 여러 언어 모델을 동적으로 선택해 다양한 작업을 수행하지만, 기존 방식들은 단일라운드·다중라운드·에이전트 방식 등 고정된 실행 패러다임에 얽혀 있어 쿼리의 다양한 요구에 적응하기 어렵다. AI · 머신러닝 · RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing
Key Point 여러 LLM을 효율적으로 활용하려는 개발자들에게 실행 방식까지 동적으로 선택하는 새로운 라우팅 프레임워크가 어떻게 작동하는지 알려준다.
핵심 요약
LLM 라우팅은 여러 언어 모델을 동적으로 선택해 다양한 작업을 수행하지만, 기존 방식들은 단일라운드·다중라운드·에이전트 방식 등 고정된 실행 패러다임에 얽혀 있어 쿼리의 다양한 요구에 적응하기 어렵다. RouteWeaver는 이러한 라우팅 방식들을 하나의 LLM 정책으로 통합하며, 어떤 방식을 쓸지와 그 방식 내에서 어느 모델을 선택할지를 함께 학습한다. COMET-GRPO(COordinated Mode-Execution Training) 학습 알고리즘은 궤적 단위의 이득값을 방식 선택과 방식 내 실행의 별도 신호로 분해해 각 결정 단계에 더 정확한 학습 신호를 전달한다. 전체 요약 6문장 읽기 → 047 00:11 ▲ 17 · 댓글 2 LLM의 결정 능력을 진단하는 벤치마크 DecisionPivot 공개 LLM 시스템에서 라우팅, 안전장치, 출력 검증을 담당하는 결정 모델의 성능을 평가하기 위해 DecisionPivot이라는 진단 벤치마크를 제안했다. AI · 머신러닝 · DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems
Key Point LLM이 의사결정을 내리는 모델들의 진정한 신뢰성을 판단하는 새로운 진단 방법이 제시되었는데, 기존 점수로는 놓치고 있던 결정 오류의 패턴을 구체적으로 드러낸다.
핵심 요약
LLM 시스템에서 라우팅, 안전장치, 출력 검증을 담당하는 결정 모델의 성능을 평가하기 위해 DecisionPivot이라는 진단 벤치마크를 제안했다. 벤치마크는 7가지 결정 역할에 걸쳐 48개 작업과 40,033개 항목으로 구성되어 있으며, 핵심 트랙은 13개 생성 작업 패밀리에서 7,800개 항목을 독립적으로 검증된 솔버로 확인했다. 보조 참조 트랙은 35개 공개 테스트 세트의 32,233개 항목을 원래 평가 지표 그대로 보존하고 있다. 전체 요약 8문장 읽기 → 048 18:11 ▲ 24 · 댓글 3 양자화와 추론으로 MoE 오프로딩 병목 해결한 Specter MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. AI · 머신러닝 · Specter: Fast MoE Inference via Quantization-Enabled Multi-Step Speculative Offloading
Key Point 메모리 제약이 있는 환경에서 MoE 모델 추론 속도를 1.5배 이상 개선할 수 있다는 것은 대형 모델을 일반 GPU에서 실행하려는 개발자들에게 직접 영향을 미친다.
핵심 요약
MoE 모델은 단일 가속기 메모리 용량을 초과하기 때문에 전문가들을 호스트 메모리로 오프로딩해야 하는데, 데이터 의존적 라우팅으로 인해 PCIe I/O 병목이 심각하다. Specter는 양자화된 경량 드래프트 모델을 기기에서 효율적으로 실행하면서도 전문가 활성화 패턴의 충실도를 유지한다. 드래프트 모델의 다단계 예측을 통해 향후 전문가 사용을 미리 파악하고, 런타임이 검증 전에 전문가 이동과 실행을 미리 조직할 수 있다. 전체 요약 5문장 읽기 → 049 15:11 새 버전 Ollama 0.40.7 출시, 모델 전환 안정성 개선 Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. AI · 머신러닝 · ollama/ollama@v0.40.7
Key Point 로컬 LLM 실행 환경에서 모델 호환성과 안정성이 크게 개선되어, 여러 모델 간 전환이나 원격 실행 시 발생하던 문제들이 해결되었다.
핵심 요약
Perplexity의 27B 의사결정 모델 'pplx-decider'를 추가 지원하며, Qwen3.8-27B를 기반으로 파인튜닝됐다. OpenAI 호환 응답 대화에서 모델 간 전환 시(생각 기능 포함/미포함) 또는 다른 제공자의 압축 항목이 포함된 히스토리에서 실패하는 문제를 해결했다. 스트리밍 응답 요청에서 클라이언트 도구 호출(예: 웹 검색 기능의 Codex)이 추론 항목 이전에 발생하여 도구 호출 이벤트가 순서 뒤바뀌거나 중복되는 문제를 수정했다. 전체 요약 8문장 읽기 → 050 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 051 12:11 ▲ 12 · 댓글 3 순환 언어 모델의 구조 설계: Huginn이 Ouro를 앞서다 Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. AI · 머신러닝 · Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
Key Point 순환 아키텍처는 파라미터 효율성과 추론 효율을 동시에 개선할 수 있는 차세대 언어 모델 설계 방향인데, 이 논문은 어떤 구조적 선택이 실제로 성능을 결정하는지 체계적으로 규명했기 때문이다.
핵심 요약
Transformer 블록을 논리적 깊이에 재사용하는 순환 언어 모델의 설계 요소를 분석한 논문이다. 같은 규모와 토큰 예산에서 학습한 모델들을 비교하여 재귀 배치, 입력 주입, 재귀 상태 구성의 영향을 개별적으로 측정했다. Prelude-Recurrent-Block-Coda 샌드위치 아키텍처가 문맥 추출과 추론 집약적 작업에서 일관되게 성능을 높이는 것을 확인했다. 전체 요약 8문장 읽기 → 052 21:11 당일 +112 AI가 기판 설계까지 한다…KiCAD 네이티브 플러그인 Konnect 공개 Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. AI · 머신러닝 · mixelpixx/Konnect · Rust
Key Point KiCAD 설계 과정을 AI가 직접 담당하는 단계로 발전했으며, 기존 복잡한 다중 언어 아키텍처를 버리고 고성능 단일 바이너리로 재설계한 점이 PCB 개발자의 작업 방식을 크게 바꿀 수 있다.
핵심 요약
Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. 21개 도구 세트에 걸친 228개 도구를 제공하며, 회로도 캡처, PCB 레이아웃과 라우팅, ERC/DRC, 설계 검토, JLCPCB 부품 검색, 참조 회로, 제조 파일 내보내기 등을 지원한다. 기존 KiCAD-MCP-Server(Python/TypeScript)의 한계를 극복하기 위해 Rust로 완전히 새롭게 작성됐으며, 단일 정적 바이너리(20~25MB)로 배포돼 설치 의존성이 없다. 전체 요약 12문장 읽기 → 053 21:11 당일 +103 AI 에이전트를 위한 소셜 미디어 리서치 스킬 오픈소스 ScrapeCreators가 만든 AI 에이전트용 소셜 미디어 리서치 스킬 모음을 GitHub에 공개했다. 오픈소스 · 도구 · ScrapeCreators/social-media-research-skills · Python
Key Point AI 에이전트가 소셜 미디어 데이터를 활용한 마케팅 리서치를 자동화할 수 있는 실용적인 도구가 생겼기 때문에, 콘텐츠 크리에이터와 마케터의 워크플로우가 크게 단순화될 것이다.
핵심 요약
ScrapeCreators가 만든 AI 에이전트용 소셜 미디어 리서치 스킬 모음을 GitHub에 공개했다. Claude Code, Cursor, Gemini CLI 등 Agent Skills 규격을 지원하는 도구들과 호환된다. 아웃라이어 포스트 탐색, 댓글 마이닝, 트랜스크립트 분석, 경쟁사 소셜 전략 비교, 광고 라이브러리 분석, 트렌드 발견 등 13개의 스킬을 제공한다. 전체 요약 8문장 읽기 → 054 21:11 ▲ 243 · 댓글 80 DeepSeek V4.1 Flash: 552B 파라미터 혼합 전문가 모델 공개 DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. AI · 머신러닝 · DeepSeek: DeepSeek v4.1 Flash 1017
Key Point 추론 속도와 이미지 이해 능력을 갖춘 저비용 혼합 전문가 모델로, 에이전트와 장기 작업에 최적화된 구조를 처음 선보인다.
핵심 요약
DeepSeek V4.1 Flash 1017은 2026년 10월 17일 스냅샷으로, 552B 파라미터 백본에서 입력 시 8B, 출력 시 16B을 활성화하는 스파스 혼합 전문가 모델이다. 이는 DeepSeek의 신규 Causal Encoder-Decoder(CED) 아키텍처를 기반으로 한 첫 번째 모델이며, 비대칭 파라미터 분할로 토큰당 계산을 낮게 유지한다. 이미지 이해가 아키텍처에 기본 내장되어 있으며, 시각과 텍스트 임베딩이 사전 학습 시작부터 함께 학습되었다. 전체 요약 11문장 읽기 → 055 03:11 ▲ 21 · 댓글 2 AI 에이전트의 추론 속도 2배 단축 기법 제안 대규모언어모델 에이전트는 도구 호출의 긴 연쇄로 작업을 수행하는데, 기존엔 강력한 하나의 모델이 모든 단계를 생성한다. AI · 머신러닝 · Trajectory-Level Speculation with Semantic Verification for Tool-Using Agents
Key Point 도구를 사용하는 AI 에이전트의 추론 속도를 2배 단축하면서도 품질을 유지하는 새로운 방식으로, 개발비 많이 드는 강력한 모델의 추론 비용을 절감할 수 있는 실무 기법이 제시되었다.
핵심 요약
대규모언어모델 에이전트는 도구 호출의 긴 연쇄로 작업을 수행하는데, 기존엔 강력한 하나의 모델이 모든 단계를 생성한다. 기존 추측 기법은 약한 모델의 결과를 한 단계씩 검증하거나, 라우팅으로 어느 모델이 각 단계를 처리할지 결정한다. 논문에서 제안한 SpecAgent는 역할을 바꿔 약한 모델이 단계를 초안으로 작성하고 강력한 모델이 검증자로 변경한다. 전체 요약 11문장 읽기 → 056 03:11 ▲ 107 · 댓글 38 KiCAD용 AI 설계 플러그인 Konnect 베타 공개 KiCAD 10 네이티브 플러그인 Konnect 베타가 공개됐으며, Rust 바이너리로 Claude 등 AI 어시스턴트가 회로도·PCB 설계를 자동화할 수 있다. AI · 머신러닝 · AI-assisted PCB design for KiCad 10
Key Point KiCAD 사용자가 AI로 회로도와 PCB 설계를 직접 자동화할 수 있게 되면서, 설계 반복 속도와 진입 장벽이 크게 바뀐다.
핵심 요약
KiCAD 10 네이티브 플러그인 Konnect 베타가 공개됐으며, Rust 바이너리로 Claude 등 AI 어시스턴트가 회로도·PCB 설계를 자동화할 수 있다. Model Context Protocol(MCP)을 통해 228개 도구를 21개 온디맨드 도구셋으로 제공하며, 회로도 작성·PCB 레이아웃·라우팅·ERC/DRC·설계 검토·JLCPCB 부품 검색·제조 파일 내보내기를 지원한다. 이전 KiCAD-MCP-Server(Python/TypeScript)의 아키텍처 한계를 개선했으며, 단일 정적 바이너리(20~25MB)로 의존성을 제거해 설치와 유지보수가 간단하다. 전체 요약 12문장 읽기 → 057 21:11 당일 +104 OpenCode 통합 API 게이트웨이 '오픈코드2API' 공개 Go로 만든 OpenCode Zen/Go API 프록시로, OpenAI와 Anthropic API 호환성을 제공하며 웹UI를 포함한 실행 가능한 바이너리 형태다. 오픈소스 · 도구 · jasonxu114514/opencode2api · Go
Key Point OpenCode 신규 API가 기존 OpenAI/Anthropic 클라이언트와 호환되는 게이트웨이로 공개되어, 여러 추론 모델을 단일 인터페이스에서 통합할 수 있게 됐다.
핵심 요약
Go로 만든 OpenCode Zen/Go API 프록시로, OpenAI와 Anthropic API 호환성을 제공하며 웹UI를 포함한 실행 가능한 바이너리 형태다. 세 가지 추론 프로토콜(Chat, Responses, Anthropic Messages)을 지원하고 프로토콜 간 자동 변환, 키/프록시 풀링, 자동 라우팅, 동적 모델 발견을 제공한다. 별도의 Zen/Go 키 풀과 계층별 선호도 설정, 재시도 정책, 세션 친화성을 제공하며 OpenCode의 공개 계정으로 무료 모델 익명 접근이 가능하다. 전체 요약 13문장 읽기 → 058 18:11 ▲ 101 · 댓글 28 Rust로 만든 고성능 웹 프레임워크 Proa 공개 Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 웹 · 프론트엔드 · Show HN: Proa – A Rust web framework with fast SSR and multi-target rendering
Key Point 한 번의 Rust 코드로 여러 렌더 타겟을 생성하고 React보다 237배 빠른 서버 렌더링을 제공하는 새로운 웹 프레임워크의 등장으로, SSR 기반 웹 개발의 패러다임이 어떻게 변할 수 있는지 보여줍니다.
핵심 요약
Rust 기반의 웹 프레임워크 Proa를 소개합니다. 빠른 서버 사이드 렌더링(SSR)과 다중 렌더 타겟 지원을 특징으로 합니다. 하나의 타입된 컴포넌트로 HTML, Markdown 등 여러 렌더 타겟을 동시에 생성할 수 있습니다. 벤치마크 결과에 따르면 Proa의 서버 렌더링 속도는 React의 renderToString보다 237배 빠릅니다(8vCPU AMD EPYC-Milan VPS 기준). 전체 요약 12문장 읽기 → 059 15:11 ▲ 25 · 댓글 2 선택 작업에 특화된 경량 멀티모달 모델 Intern-Decision 공개 Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. AI · 머신러닝 · Intern-Decision: Efficient Multimodal Decision Making with Autoregressive Masked Language Modeling
Key Point 의사결정이 필요한 에이전트 시스템에서 응답 생성 대신 구조화된 선택을 직접 반환하므로, 지연시간을 줄이고 모델-환경 인터페이스를 단순화한다.
핵심 요약
Intern-Decision은 텍스트와 이미지로부터 구조화된 선택과 확률을 반환하는 0.8B, 2B, 4B 사이즈의 멀티모달 의사결정 모델이다. 자동회귀 마스크 언어 모델링 목표를 사용하여 완전한 어시스턴트 JSON 스켈레톤에 필드당 하나의 결정 플레이스홀더를 배치하고, 한 번의 순방향 전달로 모든 필드를 평가한다. 4B 모델이 7개 평가 세트에서 평균 90.02% 정확도를 달성했으며, Llama v1.13.0의 88.74%를 능가한다. 전체 요약 7문장 읽기 → 060 15:11 ▲ 23 · 댓글 2 확산 모델 강화학습을 위한 라우팅 정책 최적화 기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. AI · 머신러닝 · Routing Policy Optimization for Online Diffusion Reinforcement Learning
Key Point 생성 모델을 보상 신호로 정렬할 때 훈련 효율을 4배 향상시키면서도 추론 시 모델의 원래 특성을 유지하는 새로운 강화학습 기법이 제시되어, 확산 모델 최적화의 실질적 한계를 해결한다.
핵심 요약
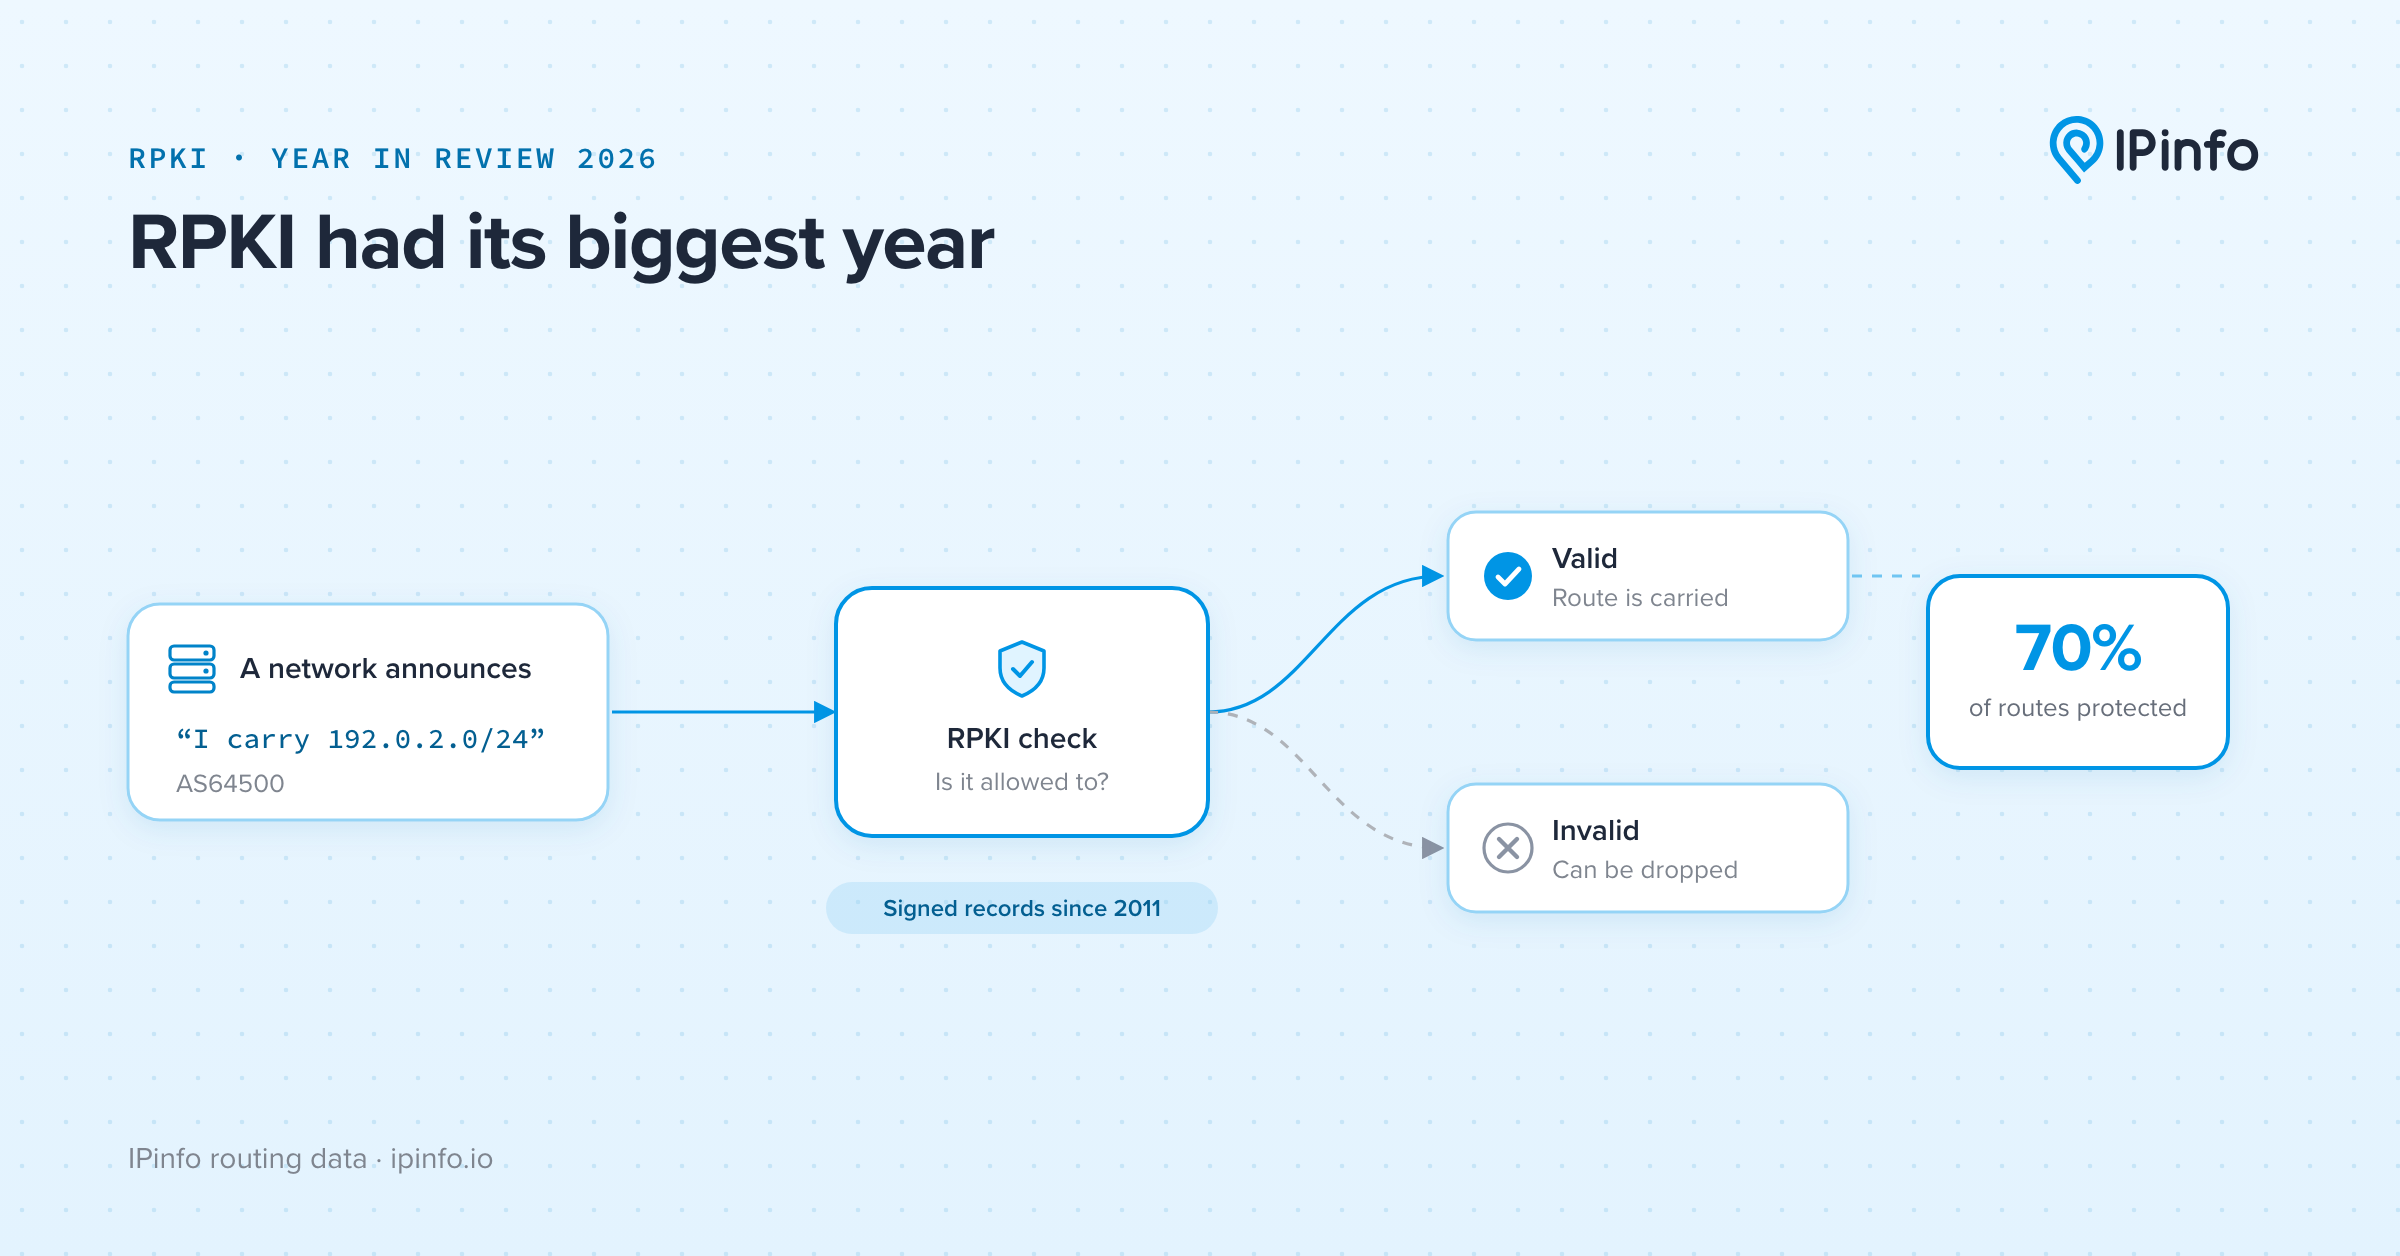
기존 강화학습 방식은 역방향 디노이징 궤적을 섭동하여 비용이 많이 드는 롤아웃 기반 최적화를 수행하는데, 생성 모델 내부에서 확률적 탐색을 도입하면서 원래의 샘플러를 보존할 수 있는지 묻는 새로운 접근을 제시했다. Routing Policy Optimization (RPO)는 어텐션 라우팅을 확률적 탐색 행동으로 변환하여 이를 답한다. 선택된 몇 개의 디노이징 단계에서 각 쿼리 블록은 자신의 블록을 유지하면서 생성 모델의 자연스러운 어텐션 질량에 비례하여 추가 키 블록을 샘플링하거나 밀집 어텐션을 유지한다. 전체 요약 9문장 읽기 → 061 15:11 ▲ 103 · 댓글 28 인터넷 라우팅의 70%가 RPKI로 보호받게 되다 BGP 라우팅은 신뢰에 의존하는데, 2008년 파키스탄 텔레콤이 유튜브 주소를 잘못 선언해 전 세계 트래픽을 2시간간 파키스탄으로 돌린 사건이 발생했다. 보안 · RPKI now protects 70% of internet routes
Key Point RPKI 채택이 급속도로 진행되면서 인터넷 라우팅 보안이 근본적으로 변화하는 중이며, 무효 경로가 실제로 차단되고 있는 현황과 남은 취약점을 파악할 수 있다.
핵심 요약
BGP 라우팅은 신뢰에 의존하는데, 2008년 파키스탄 텔레콤이 유튜브 주소를 잘못 선언해 전 세계 트래픽을 2시간간 파키스탄으로 돌린 사건이 발생했다. RPKI(Resource Public Key Infrastructure)는 IP 주소 소유자가 서명된 ROA(Route Origin Authorization)를 발행해 특정 네트워크만 그 주소를 선언하도록 허용하는 인증 시스템이다. 2025년 9월부터 2026년 9월 사이 RPKI-유효한 라우팅 경로의 비율이 54.0%에서 70.3%로 올랐으며, 이 중 중국이 3.7%에서 83.0%로 대폭 상승해 전 세계 증가량의 거의 60%를 차지했다. 전체 요약 13문장 읽기 → 062 03:12 새 버전 트랜스포머 5.20.0: 메타 뮤즈 스파크 오픈 등 6개 신규 모델 지원 메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. AI · 머신러닝 · huggingface/transformers@v5.20.0
Key Point 메타·알렉스 알파·바이두 등 주요 기업의 첨단 멀티모달·OCR·오디오 모델 6개가 한 번에 지원되고, 분산 학습·추론·양자화 내보내기 등 프로덕션 기능이 대폭 개선되어 트랜스포머 사용자에게 즉시 영향을 미친다.
핵심 요약
메타의 멀티모달 혼합 전문가 모델 뮤즈 스파크 오픈(Muse Spark Open)을 추가했다. 총 816B 파라미터(토큰당 활성 42B)이며 최대 1,048,576 토큰의 맥락 창을 지원하고 다중 파일 편집·디버깅·도구 사용 등 에이전틱 코딩 작업을 위해 학습됐다. InclusionAI의 Ling 3.0 Flash는 5개 KDA 레이어와 1개 MLA 레이어를 결합한 혼합 전문가 모델로 BailingHybridForCausalLM으로 네이티브 지원되어 trust_remote_code=True 없이 로드된다. 알렉스 알파의 Kolibri 1은 독일어·영어 중심 추론 모델로, 50개 레이어가 384명의 전문가 중 6명에게 각 토큰을 시그모이드 라우팅으로 라우팅하고 슬라이딩 윈도우와 전체 어텐션 레이어를 번갈아 사용한다. 전체 요약 13문장 읽기 → 063 03:12 ▲ 125 · 댓글 45 아르헨티나 시골의 라디오 메시지 전통, 100년 이상 고립 지역 연결 아르헨티나 시골 지역에서 AM 라디오를 통해 개인 메시지를 송출하는 '멘사헤로 루랄' 방송이 수십 년간 운영되고 있다. 기타 · The First Social Network: In rural Argentina residents send messages w AM radio
Key Point 인터넷 시대의 도시에서 당연하게 여기는 통신 기술이 없는 지역에서 100년 가까이 유지되어 온 라디오 메시지 시스템이 어떻게 사람들의 삶과 생사를 좌우하는 필수 통신망이 되었는지 보여주는 사례 연구입니다.
핵심 요약
아르헨티나 시골 지역에서 AM 라디오를 통해 개인 메시지를 송출하는 '멘사헤로 루랄' 방송이 수십 년간 운영되고 있다. 인터넷과 전화 신호가 닿지 않는 고립된 목축업자들은 라디오국에 제출한 메시지를 주 여러 번 방송으로 받아들인다. 1920년대 라디오 보급 초기부터 이러한 메시지 방송이 있었으나, 아르헨티나에서 본격화한 시점은 1930년대 후반으로, 초기에는 목장주들이 작업자들과 소통하는 수단이었다. 전체 요약 11문장 읽기 → 064 12:11 ▲ 237 · 댓글 2 다중 교사 학습 시 교사 간 충돌 완화하는 새로운 방법 다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. AI · 머신러닝 · Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
Key Point 다중 전문 모델을 하나로 통합할 때 발생하는 그래디언트 충돌 문제를 토큰 수준에서 직접 해결하는 기술로, 멀티태스킹 학습 시스템의 안정성과 성능을 모두 개선하는 방법을 제시한다.
핵심 요약
다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. 기존 도메인 라우팅 방식은 도메인별로 감독 소스를 구분하지만, 모든 도메인의 업데이트가 공유 파라미터에 작용하면서 교사들의 응답 스타일과 도메인 전문성이 다를 때 그래디언트 충돌과 성능 저하가 발생한다. Road MOPD는 라우팅되지 않은 보조 교사를 크로스 도메인 평가자로 추가하고, 토큰 수준의 신용 배분과 그래디언트 업데이트를 통해 다중 교사 감독을 조율한다. 전체 요약 6문장 읽기 → 065 06:11 ▲ 113 · 댓글 36 해저 통신 케이블 위기, 수리선박 부족과 정부 규제가 병목 전 세계 1.5백만km의 해저 통신케이블 607개 시스템이 국제 통신을 담당하며 위성으로 대체 불가능한 핵심 인프라다. 인프라 · 데브옵스 · Submarine cable resilience
Key Point 해저 케이블 수리 병목과 민간 기업의 글로벌 통신 인프라 독점 심화는 국가 차원의 통신 안보를 위협하는 구조적 문제로 악화되고 있다.
핵심 요약
전 세계 1.5백만km의 해저 통신케이블 607개 시스템이 국제 통신을 담당하며 위성으로 대체 불가능한 핵심 인프라다. 2018~2022년 대만-마쓰섬 간 케이블은 27회, 발트해는 2023년 이후 11회 손상되는 등 얕은 수심 해역에서 빈번히 끊긴다. 매년 약 200건의 해저 케이블 장애 중 86%는 어선 어구나 배 닻에 의한 것이고, 지질활동 7%, 케이블 마모 4%, 중계기 고장 4%를 차지한다. 전체 요약 11문장 읽기 → 066 03:11 ▲ 148 · 댓글 42 pgvector 능가하는 벡터 검색 인덱스 등장 Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. 인프라 · 데브옵스 · Pg_vectorsearch: An index that is faster than pgvector's IVFFlat and HNSW
Key Point pgvector를 대체할 더 빠르고 효율적인 벡터 검색 솔루션을 찾는 개발자들에게 실제 선택지가 생겼으며, 기존 pgvector 테이블과의 호환성 덕분에 마이그레이션 진입장벽이 낮다.
핵심 요약
Timescale이 PostgreSQL용 고성능 근사 최근접 이웃(ANN) 검색 확장 pg_vectorsearch를 공개했으며, 현재 알파 상태로 프로덕션 용도는 권장하지 않는다. PRISM 인덱스는 IVFFlat과 유사한 개념이지만 계층적 라우팅, RaBitQ 양자화, SIMD 최적화를 사용해 pgvector의 IVFFlat과 HNSW보다 쿼리와 인덱스 구축 모두에서 더 빠르다. 100백만 개 벡터 데이터셋에서 HNSW 대비 동등한 재현율(recall)을 달성하면서 1/4 메모리만 사용한다. 전체 요약 11문장 읽기 → 067 00:11 새 버전 FastAPI 0.143.1 릴리스, 라우트 메타데이터 버그 수정 FastAPI 0.143.1 버전이 릴리스되었다. 웹 · 프론트엔드 · fastapi/fastapi@0.143.1
Key Point 라우트 메타데이터 처리의 정확성 개선으로 중첩 라우트나 포함된 경로 설정을 올바르게 처리할 수 있게 된다.
핵심 요약
FastAPI 0.143.1 버전이 릴리스되었다. iter_route_contexts() 함수에서 포함된 라우트 메타데이터 처리 버그를 수정했다. 068 09:11 ▲ 102 · 댓글 94 AWS Lambda 웹 함수, 코드 수정 없이 표준 웹앱 배포 AWS가 Lambda Web Functions라는 새로운 형태를 발표했다. Express, Hono, Fastify, Next.js 등 표준 Node.js 프레임워크로 만든 HTTP 서버를 Lambda 어댑터 없이 그대로 배포할 수 있다. 인프라 · 데브옵스 · AWS Lambda Web Functions
Key Point 표준 웹 프레임워크를 Lambda 특화 코드로 변경하지 않고도 배포할 수 있게 되므로, 웹 개발자는 기존 Express/Next.js 앱을 그대로 옮기면서 자동 스케일링과 멀티 리전 구성을 얻게 된다.
핵심 요약
AWS가 Lambda Web Functions라는 새로운 형태를 발표했다. Express, Hono, Fastify, Next.js 등 표준 Node.js 프레임워크로 만든 HTTP 서버를 Lambda 어댑터 없이 그대로 배포할 수 있다. Lambda는 이제 세 가지 형태를 제공한다: 이벤트 기반의 Event Functions, HTTP 네이티브 방식의 Web Functions(최대 128개 동시 요청), 사용자 관리형 MicroVM이다. Web Functions는 멀티 리전 배포와 자동 트래픽 라우팅을 지원한다. 한 번의 명령어로 us-east-1, eu-west-1, ap-northeast-1에 동시 배포하면 지연 시간 기반 라우팅으로 각 지역의 사용자를 최적 리전으로 자동 연결한다. 전체 요약 9문장 읽기 → 069 18:12 ▲ 32 · 댓글 2 OCR을 넘어 텍스트 기반 시각 지능으로: PolyOCR 모델 공개 Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. AI · 머신러닝 · PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
Key Point OCR 기술이 단순 텍스트 추출에서 복잡한 문서 이해와 추론으로 확장되는 가운데, 여러 작업을 균형있게 수행하는 통합 모델의 등장은 문서 처리, 정보 추출, 자동화 분야에 실질적인 영향을 미칠 수 있다.
핵심 요약
Hugging Face와 arXiv에서 공개된 PolyOCR-Venus는 단순한 텍스트 인식을 넘어 복잡한 시각 환경에서 텍스트를 인식·위치파악·추론하는 통합 OCR 기초 모델이다. 기존 OCR 시스템은 특정 작업에만 강하고 인식, 파싱, 추론을 균형있게 수행하지 못하는 한계가 있었다. PolyOCR은 명령 추종 프레임워크와 대규모 데이터 엔진을 결합하여 서로 다른 시각 자원을 검증된 OCR 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 070 09:11 ▲ 125 · 댓글 49 마이크로소프트, 의사결정 특화 AI 모델 공개 마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. AI · 머신러닝 · Microsoft-Decision-1, our model for fast decision-making
Key Point 에이전트 AI가 실제 환경에서 행동하는 지금, 비용 효율적이면서도 빠른 의사결정 AI의 필요성이 높아지고 있으며, 마이크로소프트의 새 모델은 기존 LLM 대비 35배 빠르고 200배 저렴한 성능으로 업계의 선택 기준을 바꿀 수 있다.
핵심 요약
마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. 이 모델은 기존 LLM이나 다른 의사결정 모델보다 빠르고 정확하게 라우팅, 분류, 우선순위 결정, 검증, 워크플로우 제어 등을 수행한다. 36개 벤치마크의 15만 개 질문에서 최고 정확도를 달성했으며, GPT-6 Sol보다 4.5배 빠르고 35배 빠른 응답 속도를 기록했다. 전체 요약 13문장 읽기 → 071 16:56 ▲ 129 · 댓글 2 토큰 단위 LLM 라우팅을 위한 고효율 서빙 시스템 LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. AI · 머신러닝 · TokenRouter: Efficient Serving System for Token-Level LLM Routing
Key Point 토큰 단위로 여러 모델을 동적으로 선택하는 고급 라우팅 기법을 실제로 빠르게 처리할 수 있는 시스템이 처음 등장했기 때문이다.
핵심 요약
LLM 라우팅은 추론 작업을 여러 모델에 분산해 비용과 품질 사이의 최적점을 개선하는 기술로, 기존 시스템은 쿼리 단위의 굵은 라우팅만 지원했다. 최근 연구는 토큰 단위의 세밀한 라우팅이 효율성과 품질에서 큰 이득을 줄 수 있음을 보였지만, 기존 LLM 서빙 시스템은 단일 모델 가정 위에 설계되어 토큰 단위 라우팅에서 심각한 동기화 문제와 배치 지연을 겪는다. TokenRouter는 요청 중심 프로그래밍, 모델 중심 실행 원칙을 따르며, 개발자는 단일 요청 관점에서 라우팅 로직을 기술하고 런타임이 각 LLM마다 서브서버를 실행해 비동기로 요청을 분배한다. 전체 요약 6문장 읽기 → 072 03:11 새 버전 Angular 22.2.2 버그 수정 버전 출시 컴파일러에서 ::ng-deep 감지 상태 누수를 방지하고, 엔티티 해석 시 프로토타입 조회를 피하며, 다양한 네임스페이스에 중첩된 ng-template의 디렉티브 매칭을 정확히 수정했다. 웹 · 프론트엔드 · angular/angular@v22.2.2
Key Point Angular 22.2.2는 컴파일러, 폼 처리, 라우팅, 신호 기반 리액티비티 등 핵심 모듈의 다중 버그를 수정한 안정성 업데이트이며, 특히 제어 흐름과 디렉티브 매칭의 정확도를 개선했다.
핵심 요약
컴파일러에서 ::ng-deep 감지 상태 누수를 방지하고, 엔티티 해석 시 프로토타입 조회를 피하며, 다양한 네임스페이스에 중첩된 ng-template의 디렉티브 매칭을 정확히 수정했다. @let 선언을 제어 흐름 콘텐츠 프로젝션 진단에서 무시하고, 제어 흐름 블록의 네임스페이스 루트 노드를 ng-content 태그 선택자와 일치시키며, 네임스페이스와 무관하게 스크립트 요소를 제거한다. 컴파일러-CLI에서 생성자 파라미터 속성을 상속된 것으로 표시하지 않고, 누락된 디렉티브 확장 검사를 최적화했다. 전체 요약 7문장 읽기 → 073 18:30 ▲ 17 · 댓글 1 실제 웹사이트에서 비전 기반 AI가 마우스 클릭 실패하는 문제 해결 WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. AI · 머신러닝 · WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
Key Point 웹 자동화 AI가 실제 사이트에서 장애를 겪는 근본 원인이 모델이 아니라 '중간 계층'에 있다는 발견이 중요하다. 이는 웹 에이전트 개발자들이 모델 성능만이 아니라 입출력 시스템을 정확히 설계해야 함을 시사한다.
핵심 요약
WebFovea는 WebRetriever Challenge 2026에서 2위(최종 점수 57.0/100)를 차지한 비전 기반 웹 에이전트다. 실제 웹사이트 인터페이스를 조작해 검증 가능한 답변을 반환하는 시스템으로, 멀티모달 LLM이 필요하지만 충분하지 않다는 점을 발견했다. 모델 결정은 브라우저 하네스(모델과 페이지 사이의 코드)를 거쳐 페이지에 전달되는데, 매 단계마다 네 가지가 맞아떨어져야 한다: 모델 응답을 의도한 액션으로 파싱, 액션의 페이지 반영, 결과의 정확한 보고, 필요한 정보의 모델 제공. 전체 요약 8문장 읽기 → 074 18:33 새 버전 Laravel 13.35.0 출시, 큐 관리 개선 및 50여 개 버그 수정 Laravel 프레임워크 13.35.0이 릴리스되었다. 큐 작업에 메모리 제한을 백분율로 설정할 수 있게 지원하고, fake 단언이 속성 배열을 받도록 개선했다. 웹 · 프론트엔드 · laravel/framework@v13.35.0
Key Point PHP 웹 개발자들이 사용하는 가장 인기 있는 프레임워크의 최신 버전이 50여 개 버그 수정과 여러 기능 개선을 담고 있어, 프로덕션 환경 안정성 강화와 개발 효율성 향상이 필요한 개발 팀이라면 업데이트를 고려해야 한다.
핵심 요약
Laravel 프레임워크 13.35.0이 릴리스되었다. 큐 작업에 메모리 제한을 백분율로 설정할 수 있게 지원하고, fake 단언이 속성 배열을 받도록 개선했다. 스케줄링 기능이 강화되어 장시간 실행 명령어가 schedule:interrupt 신호를 볼 수 있고, alwaysOnOneServer() 메서드와 schedule:list --json 출력에 onOneServer 옵션이 추가됐다. 응답 팩토리에 markdown() 메서드가 추가되고, 로컬 디스크에 lazy_root_creation 설정 옵션이 추가됐다. 전체 요약 9문장 읽기 → 075 18:33 ▲ 11 · 댓글 2 LLM을 선택형 의사결정 모델로 쓸 수 있나 Jev 스타일 의사결정 모델은 자유 텍스트 생성 대신 미리 정해진 선택지에 대한 확률분포를 반환해 소프트웨어가 바로 활용할 수 있다. AI · 머신러닝 · LLM-as-Jev: LLMs Are Already Jev-Style Decision Models -- When and How to Fine-Tune Them
Key Point LLM을 선택형 의사결정에 특화된 모델로 쓸 수 있다는 발견은 작은 모델도 분류·라우팅·선택 작업에 미세조정 없이 충분할 수 있다는 뜻이며, 이는 개발자가 LLM 활용 방식을 새로 고민하게 만든다.
핵심 요약
Jev 스타일 의사결정 모델은 자유 텍스트 생성 대신 미리 정해진 선택지에 대한 확률분포를 반환해 소프트웨어가 바로 활용할 수 있다. 이 논문은 일반용 LLM이 기본 상태에서 이 능력을 이미 갖추고 있는지, 언제 미세조정이 필요한지 조사했다. LLM-as-Jev 프레임워크는 아키텍처를 그대로 두고 대괄호 안 숫자 토큰의 다음토큰 확률에서 보정된 의사결정을 추출한다. 전체 요약 8문장 읽기 → 076 18:33 ▲ 278 · 댓글 78 Strands Decider 2B, 경량 의사결정 AI 모델 오픈소스 공개 Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. AI · 머신러닝 · Strands Decider 2B: a small, open-source, decision model
Key Point 2억 개 파라미터로 로컬에서 쉽게 실험 가능하면서도 기존 LLM보다 100배 빠르고 신뢰도 점수를 제공해, 에이전트 시스템의 라우팅·검증·보안에 활용하는 새로운 클래스의 AI 모델이 등장했다.
핵심 요약
Strands Labs가 Strands Decider 2B라는 2억 개 파라미터의 의사결정 모델을 오픈소스로 공개했다. 의사결정 모델(Decision Model)은 텍스트 생성이 불가능한 대신, 선택지 간 선택이나 점수 부여에 특화되어 있으며, LLM과 달리 매우 낮은 지연시간과 높은 신뢰도 점수를 제공한다. 기존 LLM 모델의 LM 헤드를 포인터 헤드로 대체한 구조로, Qwen3.5-2B를 기반으로 rank-16 LoRA 어댑터로 파인튜닝했다. 전체 요약 9문장 읽기 → 077 18:33 ▲ 386 · 댓글 224 OpenAI, 결정 자동화 API 공개 베타 시작 OpenAI의 Decisions API는 텍스트·이미지를 평가해 10배 빠르게 응답을 반환하는 Responses API의 후속 도구다. AI · 머신러닝 · Decisions API is in public beta
Key Point 선택지 결정·분류를 위한 전문 API를 통해 고속 처리가 필요한 서비스의 라우팅·필터링 방식이 크게 달라질 수 있다.
핵심 요약
OpenAI의 Decisions API는 텍스트·이미지를 평가해 10배 빠르게 응답을 반환하는 Responses API의 후속 도구다. API는 조건의 참/거짓 확률, 고정 선택지 중 하나의 선택, 기준표 기반 점수 세 가지 형태의 답을 제공한다. 콘텐츠 분류, 요청 라우팅, 업무 우선순위 지정 등에 활용할 수 있다. 전체 요약 13문장 읽기 → 078 09:11 ▲ 10 · 댓글 1 3D 구조를 살린 옥트리 기반 언어모델 OctLLM 기존 3D LLM은 3차원 형태를 부호화 지수나 텍스트 좌표로 압축해 공간 정보를 손실하고, 백본을 미세조정해 언어 능력을 훼손하는 두 가지 문제를 안고 있다. AI · 머신러닝 · Octrees as an Explicit 3D Language
Key Point 3D 데이터의 공간 구조를 손상시키지 않으면서도 기존 언어모델의 능력을 보존하는 멀티모달 LLM 설계 방식이 기존 기법들보다 우수한 성능을 달성했기 때문에 3D AI 모델 개발에 관심 있는 연구자와 실무자에게 참고할 만한 접근법을 제시한다.
핵심 요약
기존 3D LLM은 3차원 형태를 부호화 지수나 텍스트 좌표로 압축해 공간 정보를 손실하고, 백본을 미세조정해 언어 능력을 훼손하는 두 가지 문제를 안고 있다. OctLLM은 3D 데이터를 옥트리 점유 토큰의 명시적 3D 시퀀스로 입력받으면서도, 끝에서 두 번째 수준의 노드를 무작위로 비우고 자손을 생략해 형태를 보존한 Sparse Octree(S-Octree)로 단축해 위치 인식 마스크 모델링과 3D 이해를 지원한다. 3D 모달리티를 추가할 때 전체 미세조정이나 LoRA 대신, 메시 토큰을 블록의 일부에서 독립적인 학습 가능 브랜치로 라우팅하면서 텍스트와 이미지 토큰은 고정된 비전-언어 경로를 유지하고, 두 스트림이 공유 자기주의를 통해 상호작용하도록 설계했다. 전체 요약 4문장 읽기 → 079 03:11 ▲ 63 · 댓글 3 여러 전문 모델의 내부 표현까지 활용하는 학생 모델 증류법 온폴리시 증류(OPD)는 학생 모델이 생성한 응답으로 스스로를 학습시키는 기법인데, 기존 다중 교사 방식은 교사 모델의 출력 분포만 전달한다. AI · 머신러닝 · Latent-MOPD: Latent Multi-Teacher On-Policy Distillation
Key Point 여러 작은 전문 모델의 능력을 한 학생 모델에 집약할 때 숨겨진 상태라는 새로운 정보 채널을 활용하면 더 효과적인 학습이 가능하며, 이는 효율적인 언어 모델 설계에 새로운 방향을 제시한다.
핵심 요약
온폴리시 증류(OPD)는 학생 모델이 생성한 응답으로 스스로를 학습시키는 기법인데, 기존 다중 교사 방식은 교사 모델의 출력 분포만 전달한다. Latent-MOPD는 표현 수준의 첫 다중 교사 증류법으로, 교사의 예측뿐 아니라 예측을 계산하는 데 사용된 숨겨진 상태도 함께 활용한다. 추가 교사 학습 없이 기존 전문 모델을 통합하며, 여러 교사로부터의 표현 감독을 조정하기 위해 후층 타겟을 선택하고, 숨겨진 너비 차이를 공유 투영으로 해소하고, 도메인별로 업데이트를 그룹화한다. 전체 요약 9문장 읽기 → 080 21:11 당일 +174 Ghidra와 AI를 잇는 MCP 서버, 253개 도구로 리버싱 자동화 Ghidra의 강력한 리버싱 기능을 Model Context Protocol(MCP)을 통해 AI 도구에 노출하는 서버로, 253개의 MCP 도구를 제공한다. AI · 머신러닝 · bethington/ghidra-mcp · Java
Key Point AI 에이전트가 리버싱 작업을 자동화할 때 Ghidra의 강력한 기능을 직접 활용 가능해지며, 명명 규칙 자동 강제와 배치 작업으로 수작업 오버헤드를 크게 줄인다.
핵심 요약
Ghidra의 강력한 리버싱 기능을 Model Context Protocol(MCP)을 통해 AI 도구에 노출하는 서버로, 253개의 MCP 도구를 제공한다. 읽기 전용이 아닌 전체 쓰기 접근을 지원하여 함수 이름 변경, 타입 설정, 주석 추가, 구조 생성, 스크립트 실행, P-code 에뮬레이션, 라이브 디버깅이 가능하다. 명명 규칙을 도구 계층에 내장해 자동 수정(Auto-fix), 경고(Warn), 거부(Reject) 세 단계로 일관성을 강제하며, AI 에이전트는 매 세션마다 수동으로 스타일 가이드를 입력할 필요가 없다. 전체 요약 12문장 읽기 → 081 06:11 당일 +168 Cloudflare 기반 셀프호스팅 이메일 서비스 Mailflare 공개 Cloudflare에서 실행되는 커스텀 도메인용 셀프호스팅 이메일 수신함으로, Resend 또는 AWS SES를 지원한다. 오픈소스 · 도구 · hieunc229/mailflare · TypeScript
Key Point 자신의 도메인으로 완전히 무료 이메일 서비스를 구축할 수 있는 오픈소스 도구가 나왔으며, 전문 이메일 기능(캘린더, AI 어시스턴트, 라우팅)을 갖춘 대안으로 기존 이메일 제공자의 종속성을 벗을 수 있다.
핵심 요약
Cloudflare에서 실행되는 커스텀 도메인용 셀프호스팅 이메일 수신함으로, Resend 또는 AWS SES를 지원한다. 도메인 연결, 개인/공유 메일박스 생성, 첨부파일·리치텍스트·서명·자동 회신이 포함된 이메일 송수신이 가능하다. 캘린더 일정 관리(반복 이벤트, 타임존, 참석자), 공개 예약 페이지 공유, 라우팅 규칙을 통한 자동 메일 분류·전달·거부 기능을 제공한다. 전체 요약 9문장 읽기 → 082 03:11 ▲ 11 · 댓글 2 음성·영상 AI의 할루시네이션 문제, 질문 재라우팅으로 해결 음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. AI · 머신러닝 · Devils in Question Relay: Source-Conditioned Relay Steering to Mitigate Hallucinations in Audio-visual Large Language Models
Key Point 음성·영상을 함께 처리하는 AI 시스템에서 불필요한 정보로 인한 오답 문제를 진단하고 해결하는 구체적 방법이 제시되어, 멀티모달 모델의 신뢰성을 높이는 데 직접 적용 가능하다.
핵심 요약
음성·영상 정보를 함께 다루는 대형언어모델(AVLLM)이 사용하지 않아야 할 모달리티의 신호까지 반영해 잘못된 답변을 생성하는 '소스-혼동 할루시네이션' 문제가 발생한다. 연구팀이 경로 개입과 표현 분석을 통해 이 문제의 내부 메커니즘을 규명했다: 질문 상태가 필요한 모달리티의 증거뿐 아니라 간섭 신호도 함께 전달하며, 생성 단계보다는 질문 단계에서 간섭을 차단할 때 더 효과적이다. 이를 바탕으로 SECRET(SourcE-Conditioned RElay sTeering)이라는 훈련 불필요 방식을 제안했다: 서로 다른 모달리티 경로로 추출한 대조적 질문 표현을 이용해 원래 질문을 필요한 소스의 증거로 유도한다. 전체 요약 5문장 읽기 → 083 21:11 당일 +103 AI 코드 에디터용 워크플로우 스택 pstack 공개 Cursor의 pstack 스킬 스택을 Claude Code, Codex, Pi, OpenCode, Gemini 등 다양한 AI 에이전트 환경으로 포팅한 저장소다. AI · 머신러닝 · michael-denyer/pstack-claude · JavaScript
Key Point Claude Code와 다양한 AI 에이전트 환경에서 체계적인 에이전트 워크플로우를 바로 사용할 수 있게 되어, 버그 수정부터 배포까지 소프트웨어 개발 전 단계를 구조화된 방식으로 자동화할 수 있다.
핵심 요약
Cursor의 pstack 스킬 스택을 Claude Code, Codex, Pi, OpenCode, Gemini 등 다양한 AI 에이전트 환경으로 포팅한 저장소다. pstack은 에이전트의 코드 생성 결과를 개선하기 위한 의견 있는 워크플로우 모음으로, 버그 수정·기능 추가·리팩토링·성능 최적화·PR 관리·배포 등 다양한 작업 시나리오를 다룬다. 사용자가 `/skill:<이름>` 명령으로 스킬을 실행하거나 `/pstack:setup-pstack`으로 모델 기본값과 추론 난이도를 설정할 수 있다. 전체 요약 8문장 읽기 → 084 00:11 ▲ 16 · 댓글 2 LLM 라우팅을 위한 기초 모델 'RouteFM' 등장 대규모언어모델(LLM) 라우팅은 여러 후보 모델 중 각 쿼리에 가장 적합한 모델을 선택해 추론의 품질-효율 트레이드오프를 개선하는 기술이다. AI · 머신러닝 · Pretrain Once, Route Anywhere: Towards a Foundation Model for LLM Routing
Key Point LLM 라우팅이 환경 변화마다 재훈련이 필요한 한계를 극복하고 범용 기초 모델로 통합되면, 실제 배포에서 모델 선택의 유연성과 효율성이 크게 높아질 수 있다.
핵심 요약
대규모언어모델(LLM) 라우팅은 여러 후보 모델 중 각 쿼리에 가장 적합한 모델을 선택해 추론의 품질-효율 트레이드오프를 개선하는 기술이다. 기존 라우터는 특정 쿼리 워크로드와 후보 모델풀에 최적화되며, 라우팅 환경이 바뀌면 추가 감독이나 재훈련이 필요했다. 연구팀은 LLM 라우팅을 기초 모델 관점에서 접근하는 RouteFM을 제시했으며, 모델의 고정된 정체성에 묶이지 않고 익명의 후보 모델을 행동 맥락으로 특성화한다. 전체 요약 7문장 읽기 → 085 00:11 ▲ 160 · 댓글 91 독일의 주권형 AI, 78억 파라미터 콜리브리 공개 Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: Germany's new sovereign AI model Kolibri
Key Point EU AI 규정 준수, 데이터 독립성, 독일어 추론을 통합한 오픈웨이트 모델로 유럽 규제권 내 AI 자립이 기술적으로 가능함을 보여주며, 금융·공공·항공우주 등 데이터 민감 산업에 기존 대규모 모델 의존도를 낮힐 선택지를 제공한다.
핵심 요약
Aleph Alpha가 독일·영국 대상의 혼합 전문가(MoE) 모델 '콜리브리'를 2026년 10월 3일 Apache 2.0 라이선스로 공개했다. 78.1억 개 파라미터 중 토큰당 3.46억 개(4.4%)만 활성화되며, 262,144 토큰 기본 문맥에서 최대 104만 8576 토큰까지 검증됐다. 독일 및 핀란드 인프라에서 768개 NVIDIA B200 GPU로 24조 토큰을 학습했으며, 독일 법률에 따라 구축돼 조직이 자체 서버에서 완전히 제어 가능하다. 전체 요약 12문장 읽기 → 086 16:56 ▲ 125 · 댓글 35 Redis 만든 개발자, 로컬에서 돌리는 LLM 엔진 공개 Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. AI · 머신러닝 · From the creator of Redis; run LLM locally with ds4
Key Point 가장 강력한 오픈 가중치 모델을 거대 클라우드 없이 자체 하드웨어에서 실행할 수 있게 되면서 AI 추론의 구조가 바뀐다.
핵심 요약
Redis 개발자 안티레즈가 만든 DS4는 고성능 머신에서 DeepSeek V4, GLM 5.x, Qwen3.8 등 대규모 모델을 로컬에서 실행하는 C 기반 추론 엔진이다. 284억 파라미터 DeepSeek V4 Flash 같은 혼합 전문가 모델을 고메모리 Mac(Metal), NVIDIA(CUDA), AMD(ROCm) 환경에서 지원한다. 핵심 기술은 라우팅 전문가만 2비트로 압축하되 중요한 공유 경로는 정밀하게 유지하는 비대칭 양자화로, 모델을 고메모리 머신에서 실행 가능하게 만든다. 전체 요약 9문장 읽기 → 087 15:11 ▲ 16 · 댓글 2 수학 문제 풀이 AI, 근처 파라미터로 학습 더 정확해진다 수학 추론 모델을 학습시키는 온정책 자기증류(OPSD)는 기준 해답을 보는 특권화된 교사가 학생이 샘플한 중간 단계를 감독한다. AI · 머신러닝 · Better Supervision Is Nearby: Neighborhood On-Policy Self-Distillation
Key Point 기존 자기증류 방식의 고정된 감독 전략을 파라미터 근처 탐색으로 개선해 AIME 수학 올림피아드 벤치마크에서 2~3포인트 일관된 성능 향상을 달성했으므로, 수학 문제 풀이 AI의 정확도 향상이 어떻게 이루어지는지 실제로 확인할 수 있다.
핵심 요약
수학 추론 모델을 학습시키는 온정책 자기증류(OPSD)는 기준 해답을 보는 특권화된 교사가 학생이 샘플한 중간 단계를 감독한다. 기존 OPSD는 매 상태마다 고정된 파라미터 설정 하나만 사용했으나, 근처의 파라미터 변동이 같은 기준 맥락에서 추가 감독을 제공한다. 지역 파라미터 섭동은 기준과 정렬된 상이한 정정(correction)을 드러내며, 다양한 전문가들이 기준 위치의 여러 지점에서 이를 제공한다. 전체 요약 9문장 읽기 → 088 12:11 ▲ 19 · 댓글 2 의미·기하 구조 동시 학습, 픽셀 확산 모델 성능 끌어올리다 Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. AI · 머신러닝 · PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
Key Point 의미 정보와 기하 정보를 분리해 학습하는 구조적 혁신으로 텍스트-이미지 생성부터 이미지 편집까지 여러 작업에서 동시에 성능을 끌어올렸으며, 전통적 단일 정렬 방식의 한계를 넘었다.
핵심 요약
Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. 최근 분석이 정렬 효과의 핵심이 의미 정보가 아닌 공간 구조(spatial structure)임을 지적했으나, 그러한 구조를 예측하도록 훈련된 기초 모델들은 간과되어 왔다. 픽셀 공간 확산에서 SAM2, Depth Anything v2, Metric3D v2는 DINOv2 단독 기준보다 우수하며, 특히 기하 정보를 학습하는 모델들이 분할 모델을 앞선다. 전체 요약 10문장 읽기 → 089 06:11 ▲ 10 · 댓글 2 쿼리의 의미를 먼저 파악해 최적 LLM 선택 기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. AI · 머신러닝 · SeLMRoute: Probabilistic Semantic Evidence for Large Language Model Routing
Key Point LLM 라우팅 결정에 의미론적 근거를 명확히 도입해 해석 가능성을 높이면서 성능을 기존 방식 대비 3% 이상 향상시킨 새로운 접근법이기 때문이다.
핵심 요약
기존 LLM 라우팅 방식은 쿼리 임베딩이나 모델 표현에서 직접 결정을 내려 왔으나, 쿼리가 실제로 무엇을 필요로 하는지 명확히 나타내지 못했다. SeLMRoute는 의미론적 증거 추출, 모델 성능 학습, 배포 목표 적용을 분리하는 라우팅 프레임워크를 제시한다. 의사결정 모델이 쿼리의 추론 요구도, 외부 지식 사용 여부 등 해석 가능한 질문들을 먼저 확률 분포로 평가한다. 전체 요약 9문장 읽기 → 090 03:11 새 버전 OpenAI Python 클라이언트 3.24.0 출시 OpenAI Python SDK 3.24.0 버전이 공개됐다. AI · 머신러닝 · openai/openai-python@v3.24.0
Key Point OpenAI API를 Python으로 사용하는 개발자라면 음성 생성과 에이전트 기능 지원으로 할 수 있는 일이 확대된다.
핵심 요약
OpenAI Python SDK 3.24.0 버전이 공개됐다. 주요 추가 기능은 커스텀 음성 생성(custom voice creation)과 에이전트 세션 이벤트(agent session events) 지원이다. Python 요청 라우팅 필드의 우선순위를 개선했다. 전체 요약 4문장 읽기 → 091 03:11 ▲ 134 · 댓글 55 유타주 VPN 차단법, "기술적으로 불가능"하다며 법원 기각 유타주의 SB 73 법안은 성인 웹사이트에 VPN 사용자를 탐지하거나 차단하도록 강제했고, VPN 우회 방법 설명까지 금지했다. 보안 · Court agrees with EFF: Utah's VPN law demands a technical impossibility
Key Point 인터넷 규제가 기술적 현실과 충돌할 때 법원의 역할이 어떻게 작동하는지, 그리고 VPN 같은 보안 도구를 둘러싼 규제 권력의 한계를 보여주는 사례다.
핵심 요약
유타주의 SB 73 법안은 성인 웹사이트에 VPN 사용자를 탐지하거나 차단하도록 강제했고, VPN 우회 방법 설명까지 금지했다. Aylo(Pornhub 모회사)의 소송에서 연방판사 Barlow는 이 법이 헌법 위반이라며 임시 금지 판정을 내렸다. 법원은 완벽한 지리적 위치 파악이 불가능한 상황에서 엄격한 책임을 지우는 것은 기술적 불가능성을 요구하는 것이라고 지적했다. 전체 요약 9문장 읽기 → 092 21:11 ▲ 60 · 댓글 2 적응형 전문가 혼합으로 확산 모델의 소수 단계 생성 개선 마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. AI · 머신러닝 · E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models
Key Point 확산 모델의 가장 큰 장점인 소수 단계 고속 생성을 개선하는 새로운 방법으로, 기존 접근법의 근본적인 문제(후방 붕괴)를 회피하면서 매개변수 효율성을 유지한다.
핵심 요약
마스크 확산 모델(MDM)은 각 제거 단계에서 여러 토큰을 점진적으로 해제하여 시퀀스를 생성하지만, 기존 역프로세스는 위치별로 분해되어 있어 소수 단계 영역의 샘플 품질을 제한한다. 최근 연구는 위치 간 상관관계를 포착하기 위해 변분 자동인코더로 학습된 연속 가우시안 잠재변수를 도입했으나, 이러한 접근법은 잠재변수가 무시되는 후방 붕괴(posterior collapse) 문제에 빠지기 쉽다. 본 논문은 강화된 혼합-전문가(E-MoE) 방법을 제안하며, MoE 백본의 전문가 라우팅 결정으로 주어진 이산 공유 잠재변수에 대한 분해된 분포의 혼합으로 역프로세스를 구성한다. 전체 요약 5문장 읽기 → 093 18:11 ▲ 101 · 댓글 36 모델 라우터로 Astra 수준의 성능 달성, 비용은 절반 Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. AI · 머신러닝 · Show HN: Open-source model routing for coding agents at Astra-level performance
Key Point 비용을 절반으로 줄이면서 최강 수준의 성능을 유지하는 라우팅 기술은 개발자 도구의 경제성을 크게 바꿀 수 있다.
핵심 요약
Weave Router 2.0은 여러 LLM을 지능형으로 전환하는 오픈소스 모델 라우터로, Astra 같은 강력한 모델이 필요한 작업과 Deepseek v4 Flash 같은 가벼운 모델이 적합한 작업을 구분한다. Terminal Bench 4.0과 SWE Atlas 벤치마크에서 GPT-6 Astra와 동등한 정확도를 달성하면서 비용은 52~54% 수준으로 줄이고 완료 속도는 2.2~2.5배 빨아졌다. 라우팅 결정 공간이 100 LLM 호출 × 10개 모델 기준 10^100개에 달하므로, Hidden Markov Model로 세션 상태를 추적한 후 분류기가 모델 버킷을 선택하는 구조로 탐색 공간을 대폭 축소했다. 전체 요약 8문장 읽기 → 094 12:11 ▲ 124 · 댓글 2 동영상 생성 AI의 음성-영상 동기화를 위한 적응형 보상 라우팅 기법 오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. AI · 머신러닝 · Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
Key Point 음성-영상 생성 AI의 동기화와 품질을 동시에 높이는 새로운 최적화 기법으로, 여러 목표가 충돌할 때 동적으로 가중치를 조정하는 방식이 향후 멀티모달 생성 모델 개선의 방향을 제시한다.
핵심 요약
오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. 논문은 Adaptive Reward Routing이라는 새로운 방법을 제안하며, 이는 음성 품질, 영상 품질, 교차-모달 의미 일치, 시간적 동기화 등 여러 목표를 동시에 최적화한다. 첫 번째 구성 요소는 Cross-Modal Influence-Guided Routing으로, 양방향 교차-주의 응답을 이용해 변화하는 모달 간 영향을 추적하면서 토큰별 손실을 동적으로 재가중화하고 그래디언트를 조정한다. 전체 요약 6문장 읽기 → 095 15:11 ▲ 31 · 댓글 2 드라마·영상물 자막을 에피소드 전체로 일관되게 번역하는 AI 시스템 장편 자막 번역은 전체 시리즈에 걸친 담화와 문화적 맥락을 고려해야 하지만, 기존 LLM은 문장 수준에만 머물고 다중 에이전트 시스템은 정적 워크플로우를 사용해 장면 복잡도에 적응하지 못한다. AI · 머신러닝 · Breaking Babel: A Self-Evolving Multi-Agent System for Long-Form Subtitle Translation
Key Point 장편 드라마나 영상물의 일관된 자막 번역이 필요한 스튜디오·OTT 플랫폼과 다국어 번역을 다루는 개발자들이 접할 수 있는 실용적 멀티에이전트 AI 시스템의 등장이자, 기존 문장 단위 번역의 한계를 시리즈 전체 맥락으로 극복하는 새로운 접근법이다.
핵심 요약
장편 자막 번역은 전체 시리즈에 걸친 담화와 문화적 맥락을 고려해야 하지만, 기존 LLM은 문장 수준에만 머물고 다중 에이전트 시스템은 정적 워크플로우를 사용해 장면 복잡도에 적응하지 못한다. SMART라는 자체 진화 다중 에이전트 시스템을 제안하며, 테스트 시점 학습 단계에서 시리즈 수준 메모리를 구축하고 동적 라우터와 Mixture-of-Agents 계층을 통해 용어 검증·자막 제약 검증·문맥 검색 도구를 활용한다. 판사-개선 루프를 거쳐 후보들을 채점하고 텍스트 비판을 통해 LLM을 재학습하지 않으면서 에이전트 프롬프트와 라우팅 정책을 업데이트한다. 전체 요약 7문장 읽기 → 096 09:11 ▲ 13 · 댓글 1 LLM 라우팅의 경제성을 높이는 희소 감독 학습 기법 LLM 라우팅은 쿼리를 적절한 모델에 할당해 서빙 비용을 줄이지만, 라우터 학습을 위해선 여러 후보 모델을 반복 실행해 피드백을 모아야 하므로 배포 전 상당한 감독 비용이 발생한다. AI · 머신러닝 · Routing Should Pay for Itself: Sparse Supervision for Economical LLM Routing
Key Point LLM 라우팅 시스템의 총소유비용을 처음으로 정량화하며, 학습 비용과 서빙 절감을 동시에 고려하는 새로운 평가 방식이 산업 배포에 미치는 영향이 크기 때문이다.
핵심 요약
LLM 라우팅은 쿼리를 적절한 모델에 할당해 서빙 비용을 줄이지만, 라우터 학습을 위해선 여러 후보 모델을 반복 실행해 피드백을 모아야 하므로 배포 전 상당한 감독 비용이 발생한다. 기존 연구는 서빙 단계 효율성에만 집중해, 그 절감액이 사전 학습 비용을 회수할 수 있는지 여부를 무시했다. 라우팅 품질은 모든 피드백을 수집하기 훨씬 전에 포화되는 경향을 보여, 밀집한 감독이 경제적으로 과도함을 시사한다. 전체 요약 8문장 읽기 → 097 06:11 새 버전 Angular 22.2.1 출시, 템플릿 최적화 및 보안 개선 Angular 22.2.1이 릴리스되었으며 여러 모듈에 걸친 개선사항이 포함되었다. 웹 · 프론트엔드 · angular/angular@v22.2.1
Key Point 이 버전은 보안(데이터 URL 필터링, 프로토콜 상대 경로 차단), 성능(불필요한 객체 복사 제거), 개발자 경험(명확한 에러 메시지, 디버그 정보 추가) 등 여러 영역에서 개선되었으며, 특히 template 최적화와 라우팅 안정성이 강화되었다.
핵심 요약
Angular 22.2.1이 릴리스되었으며 여러 모듈에 걸친 개선사항이 포함되었다. common 모듈에서 srcset 최적화 비활성화 시 [srcset] 바인딩이 통과되도록 수정했다. compiler 모듈은 생성 함수에 명시적 반환 타입을 추가하고 템플릿 파이프라인에서 괄호를 잘못 제거하는 문제를 해결했다. 전체 요약 11문장 읽기 → 098 06:11 ▲ 24 · 댓글 2 거대한 정보 공간에서 멀티에이전트 협력을 효율화하는 ANTMAN 정보 검색 에이전트들이 처리할 수 없을 정도로 큰 정보 공간에서 동작하는데, 기존 멀티에이전트 시스템은 정보 공간을 정적으로 분할하면서 조정 비용이 필요한 쿼리 요구사항이 아니라 분할 방식에 따라 증가하는 문제가 있다. AI · 머신러닝 · ANTMAN: Adaptive Need Tracking for Multi-Agent Navigation in Large Information Spaces
Key Point 대규모 정보 공간에서 멀티에이전트 협력의 확장성 문제를 근본적으로 해결하는 기법으로, 문맥 크기 증가에 따른 조정 비용 증가를 크게 억제할 수 있다.
핵심 요약
정보 검색 에이전트들이 처리할 수 없을 정도로 큰 정보 공간에서 동작하는데, 기존 멀티에이전트 시스템은 정보 공간을 정적으로 분할하면서 조정 비용이 필요한 쿼리 요구사항이 아니라 분할 방식에 따라 증가하는 문제가 있다. ANTMAN은 해결되지 않은 정보 요구사항을 실행 시점의 협력 단위로 삼는 적응형 조정 프레임워크를 제시한다. Need Graph라는 수정 가능한 그래프를 유지하여 해결되지 않은 요구사항, 축적된 증거, 이전 시도, 검색 진행 상황을 추적한다. 전체 요약 8문장 읽기 → 099 03:11 새 버전 Angular 20.3.33 출시, 보안 및 라우팅 개선 Angular 20.3.33 버전이 릴리스되었다. 웹 · 프론트엔드 · angular/angular@v20.3.33
Key Point URL 처리 및 라우팅 보안이 강화되며 개발자들의 애플리케이션 보안 태세가 개선된다.
핵심 요약
Angular 20.3.33 버전이 릴리스되었다. platform-server에서 resolveUrl 함수가 프로토콜 상대 경로를 거부하도록 변경되어 보안이 강화되었다. 라우터에서 URL 크기의 객체가 모든 라우트 스냅샷에 복사되는 문제를 해결했다. 전체 요약 5문장 읽기 → 100 03:11 새 버전 Transformers 5.18.0 출시, Nemotron·NemotronH Omni 등 신모델 추가 Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. AI · 머신러닝 · huggingface/transformers@v5.18.0
Key Point Transformers는 파이토치의 표준 NLP 라이브러리이며, 이 버전은 실시간 음성 처리, 멀티모달 추론, 분산 학습 최적화 등 프로덕션 환경의 여러 문제를 해결한다.
핵심 요약
Nemotron 3 Diarization 오픈웨이트 모델이 추가되어 실시간 음성 화자 분리를 지원하며, 최대 8명의 화자를 처리할 수 있고 80ms부터 30.4s까지 구성 가능한 지연 시간 프로필을 제공한다. NemotronH Omni 멀티모달 추론 모델은 Mamba-Transformer 언어 모델에 RADIO 비전 인코더와 Parakeet 사운드 인코더를 결합하여 텍스트, 이미지, 비디오, 음성을 동시에 처리한다. HyperCLOVAX Vision V2는 NAVER가 개발한 멀티모달 모델로 Qwen2.5-VL 비전 인코더를 탑재하고 체인오브싱크 추론을 위한 thinking 토큰을 지원한다. 전체 요약 8문장 읽기 →