001 21:11 당일 +162 AI와 사람이 함께하는 오픈소스 디자인 캔버스 'Doop' Paper.design의 오픈소스 대안으로, 인간과 AI 에이전트가 실시간으로 함께 디자인하는 멀티플레이 캔버스를 제공한다. 웹 · 프론트엔드 · kgoedecke/doop · TypeScript
Key Point AI 에이전트가 MCP를 통해 실시간으로 함께 설계하는 멀티플레이 디자인 캔버스를 오픈소스로 제공해, 디자인 협업의 새로운 방식을 구현했다.
핵심 요약
Paper.design의 오픈소스 대안으로, 인간과 AI 에이전트가 실시간으로 함께 디자인하는 멀티플레이 캔버스를 제공한다. 프레임이라는 아트보드 단위로 실제 HTML을 샌드박스 iframe으로 렌더링하며, 사람은 브라우저에서, AI는 내장 MCP 서버를 통해 라이브로 편집한다. Claude Code, ChatGPT, Cursor, Codex 등 모든 MCP 클라이언트와 Claude, GPT, Gemini, DeepSeek, Qwen 등 다양한 모델을 지원한다. 전체 요약 13문장 읽기 → 002 15:11 ▲ 58 · 댓글 2 비디오 모델 활용해 다양한 이미지 생성 통합 통합 조건부 이미지 생성은 시각 입력의 여러 측면을 보존하면서 텍스트 지침을 따르는 이미지를 생성해야 하는 과제다. AI · 머신러닝 · FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation
Key Point 비디오 모델의 시간축 변환 능력을 조건부 이미지 생성에 적용한 새로운 접근법으로, 단일 모델이 여러 생성 작업을 통합 처리할 수 있게 하는 기술이다.
핵심 요약
통합 조건부 이미지 생성은 시각 입력의 여러 측면을 보존하면서 텍스트 지침을 따르는 이미지를 생성해야 하는 과제다. 기존 방식은 조건과 목표를 고정된 시간 위치에 배치하지만, 생성 작업마다 조건-목표 관계가 크게 달라진다. 비디오 모델은 시간에 따른 시각 변환을 자연스럽게 인코딩하기 때문에, 입력에 맞는 가상 시간 관계로 조건부 생성을 모델링할 수 있다. 전체 요약 6문장 읽기 → 003 21:11 당일 +654 290B 모델을 데스크톱에서 실행하는 엣지 추론 엔진 FreeToken FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. AI · 머신러닝 · FlashML-org/FreeToken · Python
Key Point 소비자용 GPU로 290B 규모의 대형 MoE 모델을 실시간 속도로 로컬 실행할 수 있게 되어, 개인 개발자와 소규모 팀도 엣지에서 프론티어급 AI 모델을 직접 운영할 수 있는 가능성을 열어준다.
핵심 요약
FreeToken은 개인용 하드웨어에서 290B 이상의 대규모 혼합 전문가(MoE) 모델을 로컬에서 빠르게 실행하는 엣지 추론 엔진이다. GPU, CPU, 호스트 메모리, 상호연결을 통합 플랫폼으로 활용하며, 대역폭 적응형 CPU-GPU 협력 실행(q* 정책)과 레이어 이중 버퍼링 프리필 스트리밍을 지원한다. 의미 기반 캐싱으로 상태와 KV 캐시의 앵커 체크포인트를 저장하여, 도구 호출·사고 블록 같은 에이전트 컨텍스트 편집 시 중복 재계산을 피한다. 전체 요약 9문장 읽기 → 004 00:11 ▲ 10 · 댓글 2 AI 이미지 편집 에이전트, 다중 도구와 검증으로 성능 40% 향상 기존 에이전트형 이미지 편집 시스템은 복잡한 작업을 단계별로 분해하지만, 단계가 실패하면 제한된 도구로 재시도하고 수동 평가에만 의존한다. AI · 머신러닝 · EditAgent: Rethinking Agentic Image Editing
Key Point 에이전트형 이미지 생성 도구의 근본적인 한계를 지적하고, 일반 LLM 모델로도 효과적인 개선이 가능함을 보여주기 때문이다.
핵심 요약
기존 에이전트형 이미지 편집 시스템은 복잡한 작업을 단계별로 분해하지만, 단계가 실패하면 제한된 도구로 재시도하고 수동 평가에만 의존한다. 이들 에이전트는 실행 가능한 작업의 범위와 판단자가 감지할 수 있는 정보의 범위라는 두 가지 제약에 묶여 있다. 기존 범용 이미지 편집기는 전문가 주석이 달린 벤치마크에서 40% 이상의 경우 사용 가능한 결과를 내지 못했고, 편집 유형에 따라 신뢰할 만한 판단자도 없었다. 전체 요약 7문장 읽기 → 005 12:11 새 버전 OpenAI 파이썬 라이브러리, 에이전트 기능 대폭 확장 OpenAI 파이썬 라이브러리가 v3.42.0으로 업데이트되어 에이전트 관련 기능들이 추가됐다. AI · 머신러닝 · openai/openai-python@v3.42.0
Key Point 에이전트 기능 확대와 WebSocket 안정성 개선으로 OpenAI API를 기반으로 복잡한 작업을 수행하는 애플리케이션 개발이 한층 더 견고해진다.
핵심 요약
OpenAI 파이썬 라이브러리가 v3.42.0으로 업데이트되어 에이전트 관련 기능들이 추가됐다. 에이전트 컨텍스트 압축 설정, 세션 검토, 도구 설정, 시간 인식 기능(실험 단계)이 새로 포함됐다. 이미지 편집 마크업 오버레이, 조직별 외부 키 관리, SIP DTMF 명령어 및 전달 이벤트 기능이 추가됐다. 전체 요약 6문장 읽기 → 006 21:11 당일 +224 Claude 기반 자동 영업 에이전트 Harvey 오픈소스 공개 Claude Pro/Max 또는 ChatGPT 구독으로 구동하는 자동 영업 에이전트 Harvey가 GitHub에 공개되었다. 스타트업 · 비즈니스 · ethanplusai/harvey · Python
Key Point 토큰 요금 없이 기존 구독으로 운영되는 오픈소스 영업 자동화로, 월 $250–500 도구를 대체할 수 있으면서 소규모 지역 사업(5–50명)에서 강점을 보인다.
핵심 요약
Claude Pro/Max 또는 ChatGPT 구독으로 구동하는 자동 영업 에이전트 Harvey가 GitHub에 공개되었다. 기존 영업 자동화 도구와 달리 API 토큰 요금이 없고, 사용자의 기존 구독료 범위 내에서 작동한다. OpenStreetMap(무료)부터 DataForSEO, Serper 등 유료 소스까지 선택할 수 있으며, 발견·프로필링·이메일 작성·회신 처리·미팅 예약을 자동화한다. 전체 요약 12문장 읽기 → 007 21:11 당일 +100 Godot 4용 고성능 지형 편집 시스템 Terrain3D 공개 C++ GDExtension으로 개발된 Godot 4용 지형 시스템으로, GDScript, C#, 그 외 Godot이 지원하는 모든 언어에서 접근 가능하다. 하드웨어 · 시스템 · TokisanGames/Terrain3D · C++
Key Point Godot 엔진으로 대규모 야외 지형 게임을 만드는 개발자가 고성능 지형 시스템을 바로 도입할 수 있게 되었으며, 다양한 3D 도구와의 호환성이 워크플로우를 단순화한다.
핵심 요약
C++ GDExtension으로 개발된 Godot 4용 지형 시스템으로, GDScript, C#, 그 외 Godot이 지원하는 모든 언어에서 접근 가능하다. 64x64m부터 65.5x65.5km(약 4,295km²)까지 가변 크기의 연속되지 않은 지역들을 지원하며, 최대 32개 텍스처와 10단계 LOD(레벨 오브 디테일)을 제공한다. 식생 인스턴싱, 음영 임포스터, 지형 조각, 구멍 뚫기, 텍스처 칠하기, 색상 및 습도 칠하기 등의 편집 기능을 포함한다. 전체 요약 5문장 읽기 → 008 21:11 당일 +1,146 16명의 AI 에이전트 팀이 담긴 오픈소스 데스크톱 앱 Orkas는 MIT 라이선스의 오픈소스 데스크톱 앱으로, 목표를 받아서 자동으로 작업을 수행하는 Commander 에이전트와 16개의 전문가 에이전트로 구성된 멀티에이전트 팀을 운영한다. AI · 머신러닝 · Orkas-AI/Orkas · JavaScript
Key Point 마케팅 콘텐츠 제작, 이커머스 운영, 정기 보고서, 앱 개발 등 다양한 업무를 하나의 에이전트 팀으로 자동화할 수 있는 데스크톱 환경을 제공하므로, 반복 작업 자동화와 팀 협업이 필요한 개발자와 비즈니스 담당자에게 영향을 미친다.
핵심 요약
Orkas는 MIT 라이선스의 오픈소스 데스크톱 앱으로, 목표를 받아서 자동으로 작업을 수행하는 Commander 에이전트와 16개의 전문가 에이전트로 구성된 멀티에이전트 팀을 운영한다. 16개 내장 에이전트는 연구(DeepResearcher, SeoGeoAgent, StockAnalyser), 콘텐츠(ContentWriter, VideoStudio, VoiceStudio, ImageStudio, PptMaker), 개발(UIDesigner, ProductDeveloper), 사무(OfficeWorker), 이커머스(5개 전문 에이전트)를 담당한다. Claude Code, Codex, OpenCode, OpenClaw, Hermes-Agent 등 기존 CLI 에이전트들과 함께 작동하며, Commander가 각 에이전트에게 작업을 분배하고 결과를 통합한다. 전체 요약 12문장 읽기 → 009 15:11 ▲ 20 · 댓글 3 AI 코딩 에이전트의 협업 능력 평가 벤치마크 공개 Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. AI · 머신러닝 · Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
Key Point 현재 AI 코딩 에이전트는 요구사항 70% 정도를 부분적으로만 충족하지만 완전한 완료는 26%에 불과해, 실제 협업 환경에서 얼마나 신뢰할 수 있는지 명확히 보여준다.
핵심 요약
Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. 실제 사용자 세션 26,314개에서 수집한 중복 제거 쿼리 37,463개 중 273개 작업으로 구성되며, 텍스트·이미지·오디오·비디오·문서 등 다양한 입력을 포함한다. Multimodal Editing(ME)과 Repository Editing(RE) 두 가지 트랙을 제공하고, Grounded Understanding·UI Transformation·Functional Implementation 세 가지 능력 차원을 평가한다. 전체 요약 8문장 읽기 → 010 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 012 21:11 당일 +169 NyaTerm, Rust로 만든 현대식 원격 터미널 워크스페이스 GPUI 기반의 네이티브 데스크톱 SSH 클라이언트로, SSH·로컬 셸·텔넷·시리얼·RDP·VNC를 모두 하나의 앱에서 지원한다. 오픈소스 · 도구 · nyakang/nyaterm · Rust
Key Point SSH 중심의 여러 원격 환경을 하나의 앱에서 통합 관리하고, AI 지원으로 명령어 생성과 다단계 작업을 자동화하려는 개발자와 시스템 관리자에게 필요한 도구다.
핵심 요약
GPUI 기반의 네이티브 데스크톱 SSH 클라이언트로, SSH·로컬 셸·텔넷·시리얼·RDP·VNC를 모두 하나의 앱에서 지원한다. 탭과 수평/수직 분할 패널로 여러 터미널 세션을 함께 관리할 수 있고, SFTP 파일 브라우저로 원격 파일 업로드·다운로드·편집 후 자동 업로드가 가능하다. AI 어시스턴트 패널이 내장되어 명령어 생성·터미널 출력 설명·에러 분석을 지원하고, 관찰-결정-실행 루프를 따르는 멀티스텝 에이전트 모드도 제공한다. 전체 요약 9문장 읽기 → 013 21:11 당일 +180 75k개 에이전트를 라즈베리파이에 실행하는 Rust 프레임워크 Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. AI · 머신러닝 · hydro-project/infinity · Rust
Key Point 에이전트 개발의 동시성 문제와 리소스 소비를 근본적으로 해결하는 새로운 아키텍처로, 기존 멀티스레드 기반 에이전트보다 수십 배 더 많은 에이전트를 작은 하드웨어에서 동시 실행할 수 있게 함.
핵심 요약
Infinity는 대규모 동시성 에이전트 시스템을 구축하기 위한 Rust 프레임워크로, 라즈베리파이 메모리에 7만 5천 개의 에이전트를 동시에 실행할 수 있을 정도로 경량화됨. 비동기 처리를 통해 에이전트가 느린 도구 작업 중 블로킹되지 않고 동시에 실행되며, 대기 중에는 yield하여 리소스를 소비하지 않음. 에이전트 사이의 턴 사이에는 대화 이력만 데이터로 저장되고 태스크, 스택, 열린 연결이 없어 대기 중인 에이전트는 비용 없이 휴면 상태로 유지됨. 전체 요약 7문장 읽기 → 014 21:11 당일 +152 로컬 배포 가능한 개인용 AI 어시스턴트 QwenPaw Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. AI · 머신러닝 · agentscope-ai/QwenPaw · TypeScript
Key Point 로컬 배포로 데이터 프라이버시를 보장하면서도 멀티 채널 지원과 고급 보안 기능을 갖춘 오픈소스 AI 어시스턴트가 공개되어, 개인/팀 단위의 자동화와 협업 워크플로우를 완전히 자체 제어할 수 있게 되었다.
핵심 요약
Qwen 기반 개인용 AI 어시스턴트 QwenPaw를 공개했으며, 로컬 또는 클라우드에 배포 가능하고 DingTalk, Lark, WeChat, Discord, Telegram 등 다양한 메신저를 지원한다. 3계층 메모리 시스템을 갖추고 있다: 실시간 작업 맥락, 전체 대화 기록, ReMe 기반의 자체 진화하는 개인 지식베이스로 대화와 자료가 마크다운 메모리로 변환되어 검색 및 연결이 가능하다. 에이전트 작업에 최적화된 QwenPaw-Flash 모델(2B/4B/9B/35B-A3B/27B)을 자체 개발했으며, API 키 없이 로컬 실행이 가능하거나 Ollama, LM Studio, 14개 이상의 클라우드 제공자를 지원한다. 전체 요약 13문장 읽기 → 015 21:11 당일 +910 AI 봇 팀을 채팅 앱에서 운영하는 오픈소스 플랫폼 Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. AI · 머신러닝 · milind-soni/OpenMausBot · TypeScript
Key Point AI 에이전트 플랫폼의 오픈소스 진영이 확대되는 가운데, 사용자 자신의 모델과 로컬 머신에서 여러 봇을 독립적으로 운영할 수 있는 대안이 등장했다.
핵심 요약
Grok Bot의 오픈소스 대안인 OpenMausBot은 사용자의 로컬 머신에서 여러 AI 봇을 관리하는 채팅 앱이며, Claude·Codex·Grok CLI를 통해 자신의 구독과 로그인을 재사용할 수 있다. 각 봇은 독립적인 모델·클라우드 컴퓨터·연결된 앱을 가지며, 메시지 사이드바의 연락처처럼 상호작용한다. 봇이 실행할 셸 명령·파일 편집·질문은 인라인 카드로 표시되어 사용자가 승인·거부하거나 답변할 수 있다. 전체 요약 13문장 읽기 → 016 21:11 당일 +416 CapCut 대체 오픈소스 동영상 편집기 Concat 출시 Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 오픈소스 · 도구 · jub0t/Concat · Rust
Key Point 오픈소스 대안이 필요한 동영상 편집자들을 위해 로컬 처리·무제한 기능·AI 스크립팅 지원을 갖춘 완성도 높은 CapCut 대체제가 나왔다.
핵심 요약
Concat은 무료 오픈소스 동영상 편집기로 macOS, Windows, Linux, Android를 지원하는 CapCut 대체 소프트웨어다. 로컬 Whisper 모델로 자동 자막 생성, 텍스트-투-스피치 및 음성 복제, 배경 제거 등을 제공한다. 100개 이상의 GPU 렌더링 이펙트·필터·트랜지션, 키프레임 애니메이션(위치·스케일·회전·투명도·볼륨), 멀티트랙 타임라인을 지원한다. 전체 요약 12문장 읽기 → 017 18:11 ▲ 33 · 댓글 2 엔비디아, 시각·생성 통합한 확산 언어모델 공개 엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. AI · 머신러닝 · Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
Key Point 단일 모델에서 시각 이해와 생성을 모두 처리하고자 하는 개발자들에게 새로운 아키텍처와 훈련 방법이 어떻게 여러 작업에 동시에 최고 성능을 달성했는지 보여준다.
핵심 요약
엔비디아 연구팀이 시각 이해와 생성을 하나의 모델로 처리하는 Nemotron-Labs-Diffusion-Uni(NLD-Uni)를 제안했다. 기존 확산 모델과 달리 자동회귀 VLM의 이해 능력과 연속 흐름 모델의 생성 능력을 교차 패러다임 온-정책 증류(OPD)로 통합했다. 훈련 시 이미지 토큰을 마스크로 직접 손상시키는 기존 방식 대신, 여러 단계에 걸쳐 각 토큰을 점진적으로 손상시키는 자가-정제 확산 프로세스를 도입했다. 전체 요약 5문장 읽기 → 018 15:11 ▲ 102 · 댓글 50 PDF 암호화의 허점, AES-256이 9비트만으로 깨진다 MuPDF 1.28.5 이전 버전을 포함한 여러 PDF 구현이 AES-256 파일 키를 매우 작은 상태 공간에서 생성하고 있다. 보안 · The case of the 9 bit AES key
Key Point PDF 암호화를 위해 도입된 AES-256이 부실한 난수 생성으로 인해 실제로는 수십 비트 수준의 강도만 가지고 있으며, 패스워드 없이 문서를 열 수 있는 심각한 결함이다.
핵심 요약
MuPDF 1.28.5 이전 버전을 포함한 여러 PDF 구현이 AES-256 파일 키를 매우 작은 상태 공간에서 생성하고 있다. MuPDF는 epoch 시간 단위로 시드된 48비트 선형합동발생기를 사용하는데, 키 생성에 사용되는 출력 비트 구조 때문에 실제로는 9비트만 영향을 미친다. 512초 차이나는 타임스탬프는 정확히 동일한 바이트 스트림을 생성하며, 모든 512개 가능한 키를 브루트 포싱하는 데 11밀리초가 소요된다. 전체 요약 10문장 읽기 → 019 00:11 ▲ 101 · 댓글 40 Emacs 50주년, 텍스트 편집의 역사를 바꾸다 1976년 MIT 인공지능 연구소에서 Richard M. Stallman이 만든 Emacs는 최초의 본격적인 풀 스크린 텍스트 에디터 중 하나로 50주년을 맞이했다. 오픈소스 · 도구 · Emacs Turns 50
Key Point 프로그래밍의 역사에서 단순한 도구를 넘어 자유 소프트웨어 운동과 GNU/Linux 운영체제 탄생의 촉발점이 된 Emacs의 정통성을 이해할 수 있다.
핵심 요약
1976년 MIT 인공지능 연구소에서 Richard M. Stallman이 만든 Emacs는 최초의 본격적인 풀 스크린 텍스트 에디터 중 하나로 50주년을 맞이했다. Emacs는 TECO 텍스트 에디터와 제한된 화면의 Control-R을 기반으로, 모든 키가 독립적인 매크로로 동작하는 구조로 개선되어 누구나 쉽게 배울 수 있었다. Guy Steele Jr.와 David Moon이 표준 명령 집합 정의를 주도했으며, Meta 키를 활용한 Meta-F(단어 앞으로 이동), Meta-B(뒤로 이동) 등의 명령이 정해졌다. 전체 요약 9문장 읽기 → 020 15:11 ▲ 19 · 댓글 2 동영상 손톱 따기를 7배 빠르게, 4K에서도 실시간 처리 고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. AI · 머신러닝 · MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
Key Point 4K 동영상도 실시간 처리가 가능한 수준으로 효율을 개선한 기술이며, 헤어 디테일 보존이 중요한 영상 편집·라이브 스트리밍 용도에 실용적 영향을 미친다.
핵심 요약
고해상도 동영상에서 머리카락 같은 미세한 디테일과 투명도를 보존하면서 프레임 간 일관성을 유지하는 비디오 매팅(영상 배경 분리) 문제를 다룬다. 기존 메모리 기반 방식은 이전 프레임의 정보와 현재 프레임을 매칭하지만 해상도가 높아질수록 비용이 급증한다. MatAnyone-E는 저해상도에서 먼저 불확실한 영역과 관련 메모리를 파악한 뒤, 해당 부분만 고해상도로 정밀 매칭하고 나머지는 저해상도 결과를 재사용한다. 전체 요약 6문장 읽기 → 021 12:11 ▲ 52 · 댓글 2 비디오의 특정 영역만 자유롭게 스타일링하는 AI 모델 LociArt 공개 비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. AI · 머신러닝 · LociArt: A Unified Paradigm for Free-Style Local Video Stylization
Key Point 비디오 편집에서 특정 영역만 정확하게 스타일을 바꾸면서도 나머지는 그대로 두는 것이 이제 더 정밀하게 가능해졌으며, 이는 영상 제작자와 AI 연구자에게 구체적인 벤치마크와 데이터셋을 제공한다.
핵심 요약
비디오 스타일화는 전체 장면을 변환하는데, 로컬 편집은 정확한 영역-스타일 연결, 공간 제어, 시간적 일관성이 필요하다. LociArt는 어디를 스타일화할지와 어떤 스타일을 적용할지 명시하면서 대상이 아닌 콘텐츠는 보존하는 자유로운 로컬 비디오 스타일화 패러다임을 제시한다. 핵심 모듈 GRNStyle은 생성형 정제 네트워크(GRN)를 기반으로 하며, 선택된 영역 내에 스타일 정체성을 동등한 크기의 방향으로 임베딩하는 극좌표 스타일 인식 마스크를 도입한다. 전체 요약 8문장 읽기 → 022 06:11 ▲ 115 · 댓글 77 디스코드, 공개 서버 메시지를 구글 검색에 노출 11월 16일부터 모든 Discoverable Server는 자동으로 Server Web Page를 갖게 되며, 관리자가 미리 설정하지 않으면 서버 프로필 정보로 기본 페이지가 생성된다. 웹 · 프론트엔드 · Discord will soon let anyone find public server messages through Google
Key Point 디스코드의 공개 메시지가 구글 검색에 노출되면서 커뮤니티의 지식 자산이 검색 엔진을 통해 더 널리 발견될 수 있지만, 동시에 콘텐츠 공개 범위와 사용자 프라이버시에 관한 선택권이 중요한 문제가 된다.
핵심 요약
11월 16일부터 모든 Discoverable Server는 자동으로 Server Web Page를 갖게 되며, 관리자가 미리 설정하지 않으면 서버 프로필 정보로 기본 페이지가 생성된다. 같은 날부터 Server Web Page는 서버 설명뿐 아니라 Channel Summaries를 표시하여 커뮤니티에서 활발히 논의되는 주제를 미리 볼 수 있다. Channel Summaries는 11월 16일 이후의 활발한 대화를 자동으로 요약하며, 관리자가 어느 채널을 포함할지 선택하고 요약을 편집하거나 비활성화할 수 있다. 전체 요약 7문장 읽기 → 023 03:11 ▲ 16 · 댓글 2 슬라이더로 이미지 편집 강도 미세 조종하기 이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. AI · 머신러닝 · SliderEdit++: Improved Slider Trajectories in Instruction-Based Image Editing
Key Point 이미지 편집에서 사용자가 원하는 강도를 정밀하게 조절할 수 있는 방법이 개선돼, 생성형 이미지 편집 도구가 더 직관적이고 빠르게 동작하게 된다.
핵심 요약
이미지 편집에서 슬라이더를 움직일 때 갑작스러운 시각적 변화와 비단조적 움직임이 발생하고, 여러 슬라이더를 함께 쓸 때 서로 간섭하는 문제가 있다. 논문은 이 문제를 체계적으로 연구하기 위해 다양한 편집 카테고리를 포함한 종합 벤치마크 SlideBench를 제시했으며, 단조성·지각적 연속성·슬라이더 간 독립성을 측정하는 통일된 평가 지표를 제공한다. SliderEdit++는 편집 궤적의 양 끝점만 지도하는 기존 방식 대신 중간 과정의 궤적을 명시적으로 정규화한다. 전체 요약 6문장 읽기 → 024 03:11 ▲ 142 · 댓글 169 애플, M6 칩 탑재 14인치 맥북 프로 공개 애플이 M6 칩을 탑재한 14인치 맥북 프로를 발표했으며, 10월 28일부터 사전주문, 11월 6일부터 판매 개시된다. 하드웨어 · 시스템 · New 14‑inch MacBook Pro with M6
Key Point 프로 개발자부터 일반 사용자까지 커버하는 맥북 프로의 신칩 공개로, 온디바이스 AI 성능과 배터리 수명의 대폭 개선이 실제 업무·창작 효율에 미칠 영향을 확인할 필요가 있다.
핵심 요약
애플이 M6 칩을 탑재한 14인치 맥북 프로를 발표했으며, 10월 28일부터 사전주문, 11월 6일부터 판매 개시된다. M6는 12코어 CPU와 12코어 GPU, 듀얼 16코어 뉴럴 엔진으로 M5 대비 그래픽 성능 30% 향상, AI 워크로드 25% 고속화, 뉴럴 엔진 성능 1.9배 개선을 제공한다. M1 맥북 프로 대비 그래픽 11배, AI 성능 13배 향상되었으며, LLM 프롬프트 처리 첫 토큰 생성까지 1.3배 빨라졌다. 전체 요약 8문장 읽기 → 025 03:11 당일 +114 TheAlgorithms/Java, 66000개 알고리즘 구현 교육용 저장소 TheAlgorithms/Java는 모든 알고리즘을 Java로 구현한 교육 목적의 오픈소스 저장소다. 오픈소스 · 도구 · TheAlgorithms/Java · Java
Key Point 알고리즘 학습과 코드 기여에 관심 있는 개발자들을 위해 구조화된 교육 자료가 필요할 때, 실행 가능한 Java 구현들을 한곳에서 찾고 학습할 수 있는 기반이 되기 때문이다.
핵심 요약
TheAlgorithms/Java는 모든 알고리즘을 Java로 구현한 교육 목적의 오픈소스 저장소다. Gitpod.io(무료 온라인 개발 환경)를 통해 한 번의 클릭으로 알고리즘을 실행·편집하거나 기여할 수 있다. 이 저장소의 구현들은 학습 목적이므로 Java 표준 라이브러리보다 효율성이 떨어질 수 있다. 전체 요약 4문장 읽기 → 026 03:11 ▲ 186 · 댓글 227 애플, M6 칩 탑재 신형 iMac 공개 애플이 M6 칩을 탑재한 신형 iMac을 발표했으며, 10월 28일 오전 10시 10분(PT)부터 예약 시작, 11월 6일부터 판매 개시한다. 하드웨어 · 시스템 · New iMac with M6
Key Point M6 칩과 AI 기능이 강화된 신형 iMac이 출시되면서, 기존 인텔 기반 맥 사용자들의 업그레이드 선택지가 명확해진다.
핵심 요약
애플이 M6 칩을 탑재한 신형 iMac을 발표했으며, 10월 28일 오전 10시 10분(PT)부터 예약 시작, 11월 6일부터 판매 개시한다. M6는 듀얼 16코어 뉴럴 엔진을 처음 탑재했으며, 인텔 기반 iMac 대비 최대 18배 빠르고 M4 대비 온디바이스 AI 성능이 5배 향상됐다. 24인치 4.5K 레티나 디스플레이는 500니트 밝기로 기존 24인치 올인원 PC 대비 5배 해상도와 70% 향상된 밝기를 제공한다. 전체 요약 14문장 읽기 → 028 00:11 ▲ 179 · 댓글 82 위키피디아, AI 생성 콘텐츠 정소 전쟁 중 위키피디아의 자원봉사자 프로젝트인 WikiProject AI Cleanup은 2023년부터 AI로 생성된 콘텐츠를 찾아 제거하는 활동을 해오고 있다. AI · 머신러닝 · Wikipedia's Cleanup of AI-Generated Content
Key Point 위키피디아가 AI 콘텐츠 정소를 위해 어떤 기술과 정책을 실행하고 있으며, AI 시대에 전통적 지식 자산을 어떻게 재정의하려는지 알 수 있다.
핵심 요약
위키피디아의 자원봉사자 프로젝트인 WikiProject AI Cleanup은 2023년부터 AI로 생성된 콘텐츠를 찾아 제거하는 활동을 해오고 있다. 초기에는 '그것이 증거다', '풍부한 문화유산' 같은 반복 구문이나 결론 섹션처럼 ChatGPT의 특징적 패턴이 노출되어 있었다. 2025년 현재 AI 생성 콘텐츠의 특징이 더 미묘해지고 있으며, 기하학적 구조나 단락 패턴 같은 구조적 신호를 통해 탐지하고 있다. 전체 요약 12문장 읽기 → 029 21:11 ▲ 48 · 댓글 2 긴 영상의 짜깁기 조작 찾기, 음성과 영상 동시 분석 장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AI · 머신러닝 · AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
Key Point 장시간 영상에서 일부만 조작된 디프페이크를 정확히 찾아내야 하는 콘텐츠 검증, 미디어 포렌식 분야에서 음성-영상 동시 분석이 필수적이 되고 있기 때문이다.
핵심 요약
장시간 영상에서 일부 구간만 조작된 AI 딥페이크를 탐지하는 기존 벤치마크가 부족해, 연구팀이 AV-FABLE 데이터셋을 공개했다. AV-FABLE은 16,650개의 원본-조작 쌍(총 998시간)으로 이루어지며, 27가지 편집 설정으로 제작되고 음성과 영상 타임라인을 분리해 제공한다. 기존 음성-영상 대형언어모델(AV-LLM)을 제로샷 프롬프팅으로 테스트하면 조작 탐지 성능이 거의 무작위 수준이고 시간 위치 파악도 부정확하다. 전체 요약 7문장 읽기 → 030 15:11 ▲ 57 · 댓글 2 음성·음악을 입체음향으로 생성·편집하는 AMBIT 프레임워크 공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. AI · 머신러닝 · Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
Key Point 입체음향 생성과 편집을 자동으로 처리하는 통합 프레임워크로, 음성 콘텐츠 제작과 방송·게임·VR 음향 설계에 직접 활용할 수 있기 때문이다.
핵심 요약
공간 음향 제작을 위해 음원 배치와 입체음향 합성을 통합하는 AMBIT 프레임워크를 제안했다. 음원의 콘텐츠·활동·3D 궤적을 지정하는 ScenePlan을 실행 가능한 형태로 만들고, 자동회귀 계획과 정류 흐름 기반 렌더링을 Transfusion 백본으로 통합했다. 편집 작업 시 계획은 보존할 음원을 포함한 전체 목표 장면을 명시하며, 대조적 특징으로 변경 요청을 정의하고 참조 음성의 레이턴트로 음향 세부사항을 보존한다. 전체 요약 6문장 읽기 → 031 09:11 ▲ 170 · 댓글 52 크로스 플랫폼 AI 키잉 플러그인 CorridorKey 2.0 출시 Corridor Digital이 자신들의 첫 공식 플러그인인 CorridorKey 2.0을 발표했으며, 한 번의 구매로 DaVinci Resolve, Nuke, After Effects, Premiere Pro, Blender 모든 소프트웨어에서 사용할 수 있다. 오픈소스 · 도구 · CorridorKey 2.0
Key Point VFX 제작자들이 값비싼 소프트웨어 구독을 벗고 한 번의 구매로 주요 편집 도구 전역에서 프로급 자동 키잉을 쓸 수 있게 되는 만큼 워크플로우를 재편할 수 있다.
핵심 요약
Corridor Digital이 자신들의 첫 공식 플러그인인 CorridorKey 2.0을 발표했으며, 한 번의 구매로 DaVinci Resolve, Nuke, After Effects, Premiere Pro, Blender 모든 소프트웨어에서 사용할 수 있다. AI 기반 자동 키잉으로 초록색·파란색 배경 제거가 한 클릭으로 가능하며, 크로스페이드나 반투명 객체의 색상까지 예측해 처리한다. 기존 도구와 달리 영상의 전체 프레임을 분석하는 시간 인식 기능으로 프레임 간 깜박임(flicker)과 떨림을 제거한다. 전체 요약 8문장 읽기 → 032 21:12 당일 +251 AI 에이전트를 위한 디자인 스킬, Huashu Design 3.0 오픈소스 공개 Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 오픈소스 · 도구 · alchaincyf/huashu-design · HTML
Key Point 기존 디자인 도구 진입장벽을 모두 없애고 명령 인터페이스로 AI 에이전트가 직접 디자인을 완성할 수 있게 한 새 패러다임으로, 일반 개발자도 전문 디자인 수준의 결과물을 빠르게 얻을 수 있다.
핵심 요약
Claude Code, Cursor, Codex 등 모든 AI 에이전트에 설치 가능한 디자인 스킬로, 한 문장의 프롬프트로 완성도 있는 디자인 결과물을 얻을 수 있다. 웹페이지·App 원형·편집 가능한 PPTX·동영상·인포그래픽 등을 3~30분 안에 생산하며, 품질은 대기업 디자인팀 수준을 목표로 한다. 3.0 버전은 6개 썸네일에서 3개 방향을 선택하게 하는 방식으로 개선되었고, 84종 스타일 라이브러리(웹·PPT·인포그래픽·App·중문·동아시아)에 샘플 제공. 전체 요약 14문장 읽기 → 033 21:12 당일 +118 AI 에이전트용 프레젠테이션 생성 스킬, 브라우저에서 편집하고 PPTX로 내보내기 문서를 AI 에이전트에 전달하면 각 페이지마다 브라우저 기반 편집 콘솔이 있는 PPT를 자동 생성하는 JavaScript 기반 스킬이다. 웹 · 프론트엔드 · chuspeeism/dashi-ppt-skill · JavaScript
Key Point AI 에이전트로 자동 생성한 프레젠테이션을 브라우저에서 직접 편집하고 진정한 PPTX로 내보낼 수 있는 완성도 높은 솔루션으로, 빠른 기안 작성이 필요한 업무 시나리오에서 기존 PowerPoint 파일 편집 흐름을 완전히 바꾼다.
핵심 요약
문서를 AI 에이전트에 전달하면 각 페이지마다 브라우저 기반 편집 콘솔이 있는 PPT를 자동 생성하는 JavaScript 기반 스킬이다. 12개의 시각 테마와 1020개 버전식, 8576개 조정 가능 컨트롤을 제공하며, 차트(레이더, 폭포, 맵트리, 깔때기, 열지도, 샌키, 간트), 분석 모델(SWOT, 포터 5력, PEST, 비즈니스 모델 캔버스, 더블 다이아몬드)을 포함한다. 생성된 HTML 프레젠테이션은 슬라이더로 모듈 개수 조정, 레이아웃·차트·색상 변경, 텍스트 클릭 수정, 드래그로 이미지/영상 교체, 9가지 페이지 전환 애니메이션을 지원한다. 전체 요약 9문장 읽기 → 034 21:12 당일 +109 DeepSeek 활용을 IM에 접목, 9개 채널 일괄 지원 dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. AI · 머신러닝 · xmanrui/dsh-im · JavaScript
Key Point DeepSeek 가중치가 높아지면서 대형 LLM을 9개 주요 메신저에 한 번에 연결할 수 있는 통합 솔루션이 생겨, 기업 메시징 환경에서 AI 활용 폭이 크게 넓어진다.
핵심 요약
dsh-im은 QR코드나 봇 자격증명으로 DeepSeek Harness를 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp 9개 메신저에 연결하는 플러그인이다. 각 채널별로 독립된 메신저 봇을 여러 개 추가할 수 있으며, 각 봇마다 연결 상태·작업 공간·모델·세션이 따로 관리된다. 飞书·微信·钉钉·企业微信·QQ·Slack·Telegram·Discord·WhatsApp는 스트리밍 또는 메시지 편집으로 사고 과정과 생성 결과를 실시간 표시하고, 음성 입출력·이미지 분석·파일 회전송을 지원한다. 전체 요약 12문장 읽기 → 035 21:12 ▲ 23 · 댓글 2 신경망 가중치를 이산 결정 경로로 표현하는 TWIG 제안 신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. AI · 머신러닝 · Every Weight Is a Path of Shared Discrete Decisions
Key Point 신경망 가중치 압축 방식을 통합하는 새로운 표현이 기존 양자화 방법보다 회로 비용을 크게 줄일 수 있음을 보여주기 때문이다.
핵심 요약
신경망의 모든 가중치를 트리 구조의 작은 이산 결정(부호, 2의 거듭제곱 시프트, 게이트, 테이블 인덱스)의 경로 끝으로 표현하는 TWIG(Tree-structured Weights with Inherited Gates)를 제안했다. 같은 영역에 속한 가중치들은 경로의 상위 부분을 공유하며, 각 결정은 트리 아래의 모든 가중치에 상속되어 한 번만 저장하고 적용된다. 임의의 학습된 신경망을 TWIG로 표현할 수 있으며, 2의 거듭제곱 결정을 사용할 때 가중치 계층이 거의 모두 선(wire)과 가산기로 이루어진 회로가 되어 고정 가중치 칩에 적합하다. 전체 요약 7문장 읽기 → 036 03:11 ▲ 147 · 댓글 73 1505년 뉘른베르크 기사의 공구서, 500년 만에 완전 해석 1505년 뉘른베르크 귀족이자 기사인 마르틴 뢰펠홀츠가 일지나 족보가 아닌 공구와 기계 설계도를 담은 책을 남겼다. 기타 · Tool book of a Nuremberg knight from 1505
Key Point 500년간 아무도 완전히 읽지 못한 중세 기술 문서가 웹에 공개되면서 디지털 아카이빙과 협업 해석의 새로운 모델을 보여주고 있습니다.
핵심 요약
1505년 뉘른베르크 귀족이자 기사인 마르틴 뢰펠홀츠가 일지나 족보가 아닌 공구와 기계 설계도를 담은 책을 남겼다. 154쪽 분량의 이 '뢰펠홀츠 코덱스'에는 교체식 드릴, 실 자르는 공구, 작업대 바이스, 캐스터 달린 회전 의자, 수은으로 채운 흔들어린이침대, 분해된 석궁 등이 상세히 그려져 있다. 원본은 폴란드 크라쿠프의 야겔론 대학 도서관에 보관되어 있으며 전체 디지털화되었으나 500년 이상 완전하게 해석된 적이 없었다. 전체 요약 10문장 읽기 → 037 21:11 당일 +658 Google, 터미널용 Gemini AI 에이전트 공개 Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. AI · 머신러닝 · google-gemini/gemini-cli · TypeScript
Key Point 터미널 기반 AI 에이전트 표준이 형성되고 있는 가운데, Google이 공식 오픈소스 도구로 대응하며 MCP 서버 지원으로 확장성을 열어두고 있다.
핵심 요약
Google이 오픈소스 AI 에이전트 Gemini CLI를 공개했으며, TypeScript로 작성되어 GitHub에서 관리되고 있다. 터미널에서 직접 Gemini 모델에 접근할 수 있으며, 코드 이해·생성, 대형 코드베이스 편집, PDF나 이미지에서 앱 생성 등이 가능하다. 자동화 작업, PR 쿼리, 복잡한 리베이스 처리, MCP 서버 연결로 Imagen·Veo·Lyria 같은 미디어 생성 기능 통합이 지원된다. 전체 요약 9문장 읽기 → 038 12:11 ▲ 15 · 댓글 2 화학 추론을 검증하는 '몰린' 언어 공개 화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. AI · 머신러닝 · MolLean: A Process-Verifiable Language for Chemical Reasoning
Key Point 화학 분자 추론에서 언어 모델의 거짓 주장을 실시간으로 검증·수정할 수 있는 새로운 시스템이 제시되었으며, 12개 과제에서 모두 기존 방식을 앞서갔다.
핵심 요약
화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. 이를 해결하기 위해 MolLean이라는 과정 검증 가능한 언어를 개발했으며, 명시적 분자 상태에 기반해 화학 추론을 진행한다. Lean 기반 커널은 기본 그래프 편집부터 복합 변환까지 상태 전이와 분자 기반 명제를 계층적으로 검증한다. 전체 요약 10문장 읽기 → 039 03:11 당일 +133 AI와 협력하는 벡터 디자인 도구 OpenPencil 공개 Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. AI · 머신러닝 · ZSeven-W/openpencil · Rust
Key Point Electron에서 완전히 벗어나 Rust 단일 바이너리로 55.5MB 경량화하면서도 동시 에이전트 팀과 MCP 통합으로 AI 협업 디자인의 새로운 기준을 제시한다.
핵심 요약
Rust로 완전히 재작성된 OpenPencil은 AI-네이티브 벡터 디자인 도구로, 프롬프트를 입력하면 실시간 스트리밍 애니메이션으로 캔버스에 UI가 생성된다. 여러 AI 에이전트가 동시에 다양한 영역(헤로, 기능, 푸터 등)을 작업하는 '동시 에이전트 팀' 기능으로 복잡한 페이지를 병렬 분해하고 생성한다. Claude, GPT-4o, Gemini, DeepSeek, Kimi, GLM 등 여러 LLM을 지원하며, 각 모델의 능력에 맞춰 프롬프트와 사고 모드를 자동 조정한다. 전체 요약 13문장 읽기 → 040 21:11 당일 +153 AI 이미지 창작용 오픈소스 무한 캔버스 플랫폼 공개 TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. AI · 머신러닝 · basketikun/infinite-canvas · TypeScript
Key Point OpenAI 호환 API와 로컬 에이전트를 통합해 브라우저 기반 AI 창작 워크플로우를 단일 캔버스에서 구현한 오픈소스 도구로, AI 생이미지·영상 생성·이미지 편집 등 여러 작업을 한 곳에서 연결할 수 있다.
핵심 요약
TypeScript로 개발된 오픈소스 무한 캔버스 워크벤치로, AI 생이미지·이미지 편집·동영상 생성·에이전트 어시스턴트·캔버스 편성·대화형 창작·프롬프트 라이브러리·소재 관리를 하나의 인터페이스에서 제공한다. 다중 캔버스 프로젝트, 노드 드래그 스케일링, 연선, 미니맵, 실행 취소/다시 하기, 가져오기/내보내기 등 무한 캔버스 기능을 갖추고 있다. 브라우저 프론트엔드에서 OpenAI 호환 인터페이스로 직접 연결되며 텍스트-이미지, 이미지-이미지, 참고 이미지 편집, 텍스트 문답, 음성 및 동영상 생성을 지원한다. 전체 요약 12문장 읽기 → 041 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 042 18:11 ▲ 145 · 댓글 31 Astral, 파이썬 도구 uv와 ty 통합 공개 Astral이 패키지 매니저 uv와 타입 체커 ty의 통합을 실험 단계에서 공개했다. 기타 · Bringing uv and ty together
Key Point Astral의 Python 도구들이 통합되면서 환경 관리와 타입 체킹이 자동화되고, PEP 723 스크립트가 정식 지원되어 Python 개발 워크플로우가 단순해진다.
핵심 요약
Astral이 패키지 매니저 uv와 타입 체커 ty의 통합을 실험 단계에서 공개했다. 이 통합으로 PEP 723을 통해 파이썬 스크립트 내 의존성 선언을 지원하며, CLI와 편집기에서 스크립트를 인식하고 타입 체크할 수 있다. ty가 uv의 메타데이터를 활용해 프로젝트 및 스크립트의 환경을 이해하고, 각 스크립트가 선언한 의존성 기준으로 검사를 수행한다. 전체 요약 10문장 읽기 → 043 18:11 ▲ 100 · 댓글 73 webOS TV를 로컬 기반 스마트 TV로 재개발하는 프로젝트 리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. 하드웨어 · 시스템 · Show HN: Making a smart TV dumb and then smart
Key Point webOS TV 펌웨어 수정을 통해 로컬 제어 기반의 스마트 TV를 만드는 구체적인 기술 구조와 제약·위험 요소를 보여준다.
핵심 요약
리눅스 컴퓨터에서 Chromium을 실행하고 TV는 디스플레이로만 사용하는 방식으로 webOS TV의 기본 홈 화면, 브라우저, 음성 어시스턴트를 교체하는 프로젝트다. TV 펌웨어의 특정 빌드 버전을 대상으로 루트 권한으로 벤더 시스템 서비스를 수정하므로 보증 소실 위험이 있으며, 재부팅이나 초기화 전까지 TV를 사용할 수 없을 수 있다. 원격 컨트롤러의 음성 입력, 홈 화면 라우팅, 네이티브 음성 캡처 등이 벤더 서비스를 후킹하며, 펌웨어 SHA-256 핀과 코드 오프셋이 특정 빌드에만 유효하다. 전체 요약 12문장 읽기 → 044 03:11 ▲ 112 · 댓글 51 DOM과 Canvas를 통합하는 HTML-in-Canvas API 등장 Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 웹 · 프론트엔드 · The HTML-in-Canvas API origin trial
Key Point 웹 게임과 3D 편집기 같은 고성능 Canvas 앱에서 텍스트 접근성, find-in-page, 브라우저 확장 등 DOM의 모든 기능을 동시에 사용할 수 있게 되므로, 복잡한 시각 애플리케이션의 아키텍처 설계 방식이 근본적으로 달라진다.
핵심 요약
Chrome 148~150에서 진행 중인 origin trial을 통해 새로운 HTML-in-Canvas API가 공개됐다. 이 API는 DOM 콘텐츠를 2D canvas 또는 WebGL/WebGPU 텍스처에 직접 렌더링하면서 상호작용과 접근성을 유지한다. DOM은 텍스트 레이아웃, 접근성, 번역, find-in-page 등 브라우저 기능을 제공하지만 그래픽 성능이 제한적이고, Canvas는 고성능이지만 이러한 기능들이 완전히 작동하지 않는다. 전체 요약 9문장 읽기 → 045 03:11 ▲ 214 · 댓글 114 키미, 백만 토큰 컨텍스트의 K3.1 Pro 공개 키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. AI · 머신러닝 · Kimi K3.1 Pro and K3.1 Pro Highspeed
Key Point 오픈웨이트 대규모 언어 모델이 코딩부터 금융 분석까지 여러 분야에서 프로프라이어터리 모델과 경쟁하는 수준에 도달했으며, 사이버보안 능력을 의도적으로 제어하면서 공개하는 오픈 모델의 윤리적 방향성을 보여준다.
핵심 요약
키미가 K3.1 Pro와 2~3배 빠른 K3.1 Pro Highspeed를 공개했으며, 100만 토큰 컨텍스트 윈도우를 지원하는 오픈웨이트 모델이다. 모델은 키미 K3의 포스트 트레이닝 버전으로, 수백 개 다운스트림 도메인 전체에서 대규모 강화학습을 통해 모든 계층을 최적화했다. 코딩 벤치마크에서 K3.1 Pro는 Terminal-Bench 4.0에서 65.7%로 GPT-6 Astra(58.2%)를 상회하고 Claude Opus 5.5(66.4%)와 유사한 성능을 보인다. 전체 요약 12문장 읽기 → 046 18:11 ▲ 15 · 댓글 2 StyleStream 2.0, 음성 스타일 변환 속도 2배 높이고 텍스트 제어 추가 StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. AI · 머신러닝 · StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion
Key Point 제로샷 음성 스타일 변환의 실시간성을 개선하고 자연어 기반 음성 설계·편집 기능을 추가해 음성 생성의 실용성과 제어 가능성을 크게 높였다.
핵심 요약
StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. 이전 버전인 StyleStream 1.0의 문제점을 해결했다: 소비자급 GPU에서 약 1초의 레이턴시를 520ms로 단축(2배 속도 개선)하고, 대상 음성을 설계·편집할 텍스트 기반 인터페이스를 추가했다. 레이턴시 감소를 위해 몇 단계의 픽셀 MeanFlow 모델을 학습하고 Self Forcing에서 영감을 받은 자기회귀 피드백으로 세부 조정하여 스트리밍 추론 견고성을 개선했다. 전체 요약 6문장 읽기 → 047 18:11 ▲ 184 · 댓글 2 이미지를 편집 가능한 레이어로 자동 분해하는 AI 명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. AI · 머신러닝 · Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
Key Point 이미지 편집 결과를 재편집 가능한 레이어로 자동 분해해 주므로 디자인 도구나 영상 제작 워크플로우에서 후속 수정이 훨씬 유연해진다.
핵심 요약
명령 기반 이미지 편집과 재사용 가능한 RGBA 레이어 생성을 통합한 LayerEditor를 소개한다. In-Context RGB-Alpha Token Modeling은 편집된 캔버스와 순서가 정해진 RGBA 레이어들을 단일 토큰 시퀀스로 표현하여 의미 있는 편집과 개별 레이어 조작을 가능하게 한다. Compositional Edit-Prior Distillation 기법으로 기존 모델의 편집 능력을 유지한 채 계층화된 출력으로 적응시킨다. 전체 요약 7문장 읽기 → 048 15:11 ▲ 173 · 댓글 2 영화 같은 영상 생성, MLLM 정보를 제대로 활용하는 학습법 제안 영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. AI · 머신러닝 · Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation
Key Point 비디오 확산 모델이 MLLM의 정보를 무시하는 근본 문제를 해결함으로써 멀티모달 정보 기반의 영상 생성 품질을 크게 향상시키는 방법론을 제시합니다.
핵심 요약
영화 같은 영상 생성은 제한된 입력(희소 가이드)으로 시간 추론을 하고, 캐릭터·장면·액션·카메라를 세밀하게 제어해야 하는 문제다. 멀티모달 대형언어모델(MLLM)이 유용한 선행 정보를 제공하지만, 비디오 확산 트랜스포머(DiT)가 직접 조건화 경로로 이를 우회하거나 충분히 활용하지 못한다. 연구팀은 요소 인식 예측 학습(FAPL)을 제안해 MLLM 잠재값을 유효하게 활용하는 것을 전제로 설정했다. 전체 요약 8문장 읽기 → 049 06:11 당일 +296 DeepSeek Harness 상황 창 시각화 도구 dsh-context DeepSeek Harness 플러그인 dsh-context는 에이전트의 토큰 사용량과 컨텍스트 구성을 추적·분석하는 도구로, Context Insights 페이지·탭·패널·명령어 5가지 인터페이스를 제공한다. AI · 머신러닝 · bowenliang123/dsh-context · TypeScript
Key Point 에이전트 기반 AI 시스템에서 방대한 컨텍스트 윈도우를 효과적으로 관리하고, 토큰 비용을 추적하며, 성능 저하의 원인을 파악할 수 있는 심화된 시각화 도구다.
핵심 요약
DeepSeek Harness 플러그인 dsh-context는 에이전트의 토큰 사용량과 컨텍스트 구성을 추적·분석하는 도구로, Context Insights 페이지·탭·패널·명령어 5가지 인터페이스를 제공한다. Context Insights 페이지는 7일 토큰·비용 차트, 활동 히트맵, 세션별 컨텍스트 프로필을 한눈에 보여주고, 기간·날짜·그룹·검색으로 필터링 가능하며 클릭으로 해당 세션으로 바로 이동한다. Context 탭은 각 세션의 컨텍스트 통계·구성·추이·이벤트·파일 작업을 대시보드로 표시하고, 요청별 토큰 이동 경로, 각 단계의 단위 토큰 가격, 모델 제시 정확한 수치를 보여준다. 전체 요약 12문장 읽기 → 050 03:11 ▲ 17 · 댓글 1 언어로 조종하는 무한 3D 월드, 실시간으로 생성된다 WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. AI · 머신러닝 · WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
Key Point LLM과 3D 생성 모델을 결합해 게임·메타버스 같은 대규모 인터랙티브 환경을 실시간으로 만드는 기술이 가능함을 보여주는 논문으로, 생성형 AI의 게임·시뮬레이션 분야 응용 가능성을 확인할 수 있다.
핵심 요약
WorldStream은 자유로운 언어 명령에 따라 3D 세계를 무한으로 확장하면서 방문했던 장소의 편집 내용을 보존하는 오픈엔디드 월드 모델을 제시한다. 계층적 플래너가 거시(Macro) 단계에서 타일 그룹 전체의 정착지·생태·교통·수문 구조를 결정하고, 미시(Micro) 단계에서 지형과 이웃 타일의 제약을 반영해 각 타일의 의미론적 세부를 구체화한다. 결정된 계획은 결정론적 로컬 코드로 컴파일되어 지형·도로·정착촌·식생·개체를 생성하며, 스트리밍 방식으로 사용자 이동 경로 앞쪽에서만 계획과 컴파일을 실행해 메모리를 절감한다. 전체 요약 6문장 읽기 → 051 21:11 당일 +152 오픈소스 AI 오피스, Word·Excel·파워포인트 네이티브 편집 GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. 오픈소스 · 도구 · genspark-ai/genoffice · TypeScript
Key Point AI 에이전트가 Word·Excel·파워포인트를 실제 파일 형식으로 편집할 수 있는 오픈소스 도구로, 코딩 어시스턴트 통합을 통해 개발 워크플로우를 확장하는 새로운 경로를 열었다.
핵심 요약
GenOffice는 무료 오픈소스 AI 오피스 스위트로, Word(.docx), Excel(.xlsx), PowerPoint(.pptx) 파일을 네이티브 형식으로 편집하고 PDF, 마크다운, HTML도 지원한다. AI 에디터는 추적 변경(Docs), 실제 수식과 차트(Sheets), 캔버스에 그린 슬라이드(Slides) 등 각 문서 유형에 맞게 동작하며, 모든 AI 편집은 스냅샷으로 저장되어 롤백할 수 있다. 파일은 로컬에서 열고 저장되고, PDF 변환·마크다운 렌더링·HTML 빌드 모두 기기에서 실행되며 AI 호출만 외부로 나간다. 전체 요약 9문장 읽기 → 052 21:11 ▲ 24 · 댓글 2 합성 데이터 없이 실제 이미지로 훈련하는 장면 글자 편집 장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. AI · 머신러닝 · Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
Key Point 실제 이미지만으로 학습하면서도 합성 데이터에 의존하는 기존 방식의 도메인 격차 문제를 해결하고, 나아가 글자 인식 모델의 성능까지 높일 수 있다는 점이 중요하다.
핵심 요약
장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. 논문은 실제 샘플 하나를 여러 방식으로 손상시켜(자르기, 섞기, 마스킹 등) 자체 쌍 학습 데이터를 만드는 방식으로, 합성 데이터 없이 훈련이 가능한지 탐구했다. TextRIRO는 조건부 확산 모델 기반의 기준 모델로, 문자 열 섞기와 이미지 자르기(Shuffle&Crop)를 결합할 때 텍스트 의미는 파괴하면서 스타일 단서는 보존하여 모델이 실제 텍스트 이미지에서 직접 편집 행동을 학습할 수 있다. 전체 요약 6문장 읽기 → 053 18:11 ▲ 441 · 댓글 2 스트리밍 영상 생성 모델 평가 벤치마크 StreamEval 공개 실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. AI · 머신러닝 · StreamEval: Evaluating Interactive Streaming Video Generation Models
Key Point 실시간 영상 생성 모델이 사용자의 요청을 얼마나 정확히 반영하는지 체계적으로 평가할 수 있는 첫 통합 벤치마크로, 현재 모델들의 명령어 실행 정확도가 15~37점대로 매우 낮다는 점은 이 분야의 개발 방향을 규정하는 중요한 기준을 제시한다.
핵심 요약
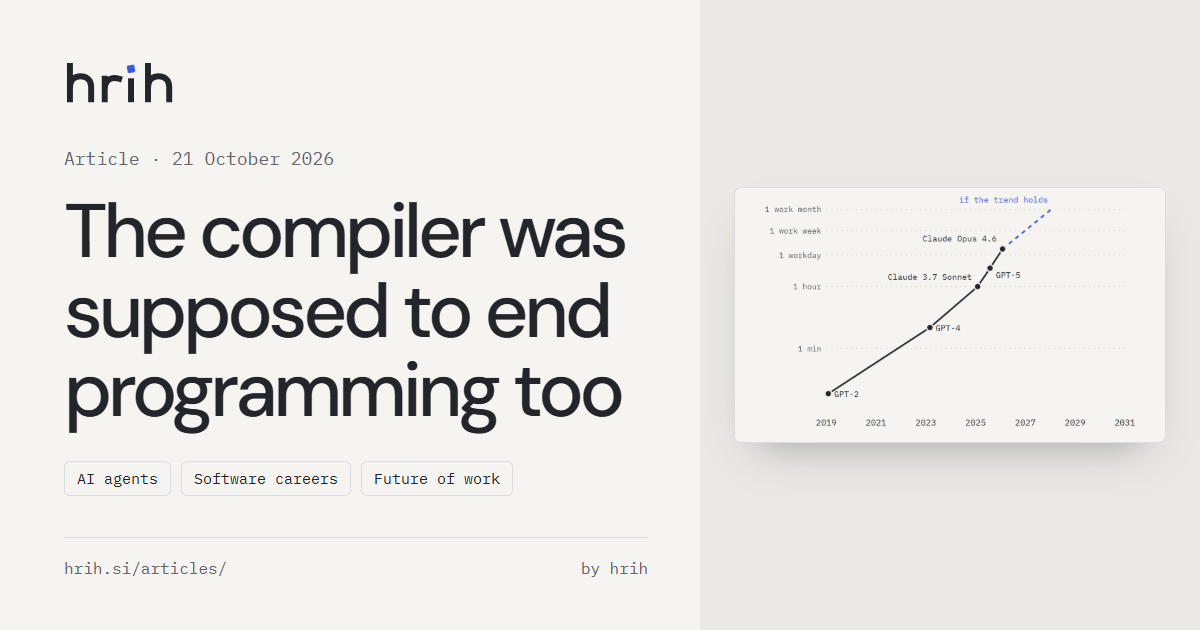
실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. 아바타 대화, 아바타 공연, 월드 생성, 명령어 편집, 참조 편집의 5가지 과제를 포함한다. 각각 15초~300초 길이의 300개 테스트 케이스로 구성되며, 초기 에셋·시간순 멀티모달 요청·상태 변화 및 콘텐츠 유지 요구사항이 정의되어 있다. 전체 요약 8문장 읽기 → 054 18:11 ▲ 101 · 댓글 151 컴파일러가 프로그래밍을 끝낸다던 약속, 70년이 지난 지금 FORTRAN(1957)부터 GitHub Copilot(2021)까지 '프로그래밍을 끝내겠다'는 약속이 70년을 반복해왔다: 어셈블리, FORTRAN, C, 'The Last One', Stack Overflow, npm, Copilot, 코딩 에이전트 모두 어떤 일을 자동화했지만 프로그래머는 사라지지 않았고 분야만 성장했다. AI · 머신러닝 · The compiler was supposed to end programming too
Key Point 프로그래밍 자동화는 70년을 반복했지만, 이번엔 속도와 규모가 다르다—AI 코드가 검토보다 빨리 들어오고, 채용 시장에 이미 영향을 미치고 있으며, 소프트웨어팀의 병목이 작성에서 검수로 이동했다.
핵심 요약
FORTRAN(1957)부터 GitHub Copilot(2021)까지 '프로그래밍을 끝내겠다'는 약속이 70년을 반복해왔다: 어셈블리, FORTRAN, C, 'The Last One', Stack Overflow, npm, Copilot, 코딩 에이전트 모두 어떤 일을 자동화했지만 프로그래머는 사라지지 않았고 분야만 성장했다. 현재 속도가 이전과 다르다: GitHub Copilot 프리뷰 출시 4년 만에 84%의 개발자가 AI 도구를 사용 중이거나 계획 중이며, 전문가의 절반은 매일 사용한다. Stack Overflow 조사에서 개발자들의 AI 도구 호감도는 2023년 77%에서 2025년 60%로 떨어졌고, 46%가 정확성을 불신한다: 가장 큰 불만은 '거의 맞지만 완벽하지 않은 해결책'(66%)이며, 45%는 AI 코드 디버깅이 더 오래 걸린다고 답했다. 전체 요약 12문장 읽기 → 055 12:11 ▲ 17 · 댓글 8 AI 에이전트 학습, 사용자·환경과 함께 진화시키다 LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. AI · 머신러닝 · EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents
Key Point 훈련 시스템 전체를 적응형으로 진화시키는 방식이 다중 턴 강화학습 성능을 대폭 향상시키는 것으로 나타났으며, 이는 에이전트 개발의 기존 접근 방식을 바꿀 수 있는 경험적 증거를 제시한다.
핵심 요약
LLM 에이전트가 사용자와 여러 턴에 걸쳐 상호작용하도록 훈련할 때, 사용자 시뮬레이터와 환경이 불안정하거나 불완전해서 학습 신호가 왜곡되는 문제가 있다. 기존 접근법은 보상 재설계나 감독 강화로 이를 해결했지만, 사용자 시뮬레이터와 환경을 고정된 것으로 취급했다. EAU는 메타 에이전트 프레임워크로, 훈련 중 궤적·도구 추적·보상·통계를 모니터링하며 실패와 무정보 상호작용을 진단한다. 전체 요약 7문장 읽기 → 056 03:11 ▲ 25 · 댓글 2 영상과 3D 모션을 동시에 만드는 AI 모델 기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. AI · 머신러닝 · Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs
Key Point 영상 생성 AI가 3D 애니메이션 제작 파이프라인으로 확장되는 중요한 시점에, 실제 3D 자산을 직접 움직일 수 있는 모션을 만드는 기술이 등장했다.
핵심 요약
기존 영상 생성 AI는 픽셀 단위 동작만 만들었지만, 3D 자산을 애니메이션할 수 있는 실제 3D 모션은 반환하지 못했다. 이 논문은 텍스트로부터 영상과 3D 모션을 함께 만드는 모델을 제시하며, 임의의 스켈레톤(뼈대)를 지원하고 카메라 위치도 함께 복원한다. 기존 방식은 인간 스켈레톤만 처리하거나 매개변수가 수십억 개인 반면, 이 모델은 3D 모션을 별도로 처리하고 미니 크로스 어텐션 레이어로 사전학습된 영상 모델과 연결해 효율성을 높였다. 전체 요약 8문장 읽기 → 057 03:11 ▲ 11 · 댓글 2 이미지 편집 누적 오류 줄이는 ACEdit 발표 이미지 편집 모델은 단일 편집에서는 좋은 결과를 내지만, 여러 번의 편집을 반복하면 품질이 떨어지는 문제가 있다. AI · 머신러닝 · ACEdit: Stable Multi-Turn Image Editing via Asymmetric Conditioning
Key Point 여러 번 편집할 때마다 품질이 떨어지는 근본적인 문제를 해결하는 훈련 방식이 제시되어, 실제 사용 환경에서 안정적인 이미지 편집 도구 개발에 영향을 줄 수 있다.
핵심 요약
이미지 편집 모델은 단일 편집에서는 좋은 결과를 내지만, 여러 번의 편집을 반복하면 품질이 떨어지는 문제가 있다. 각 편집마다 분포 변화가 누적되어, 원래 학습한 입력 분포와 실제 다중 편집 추론 단계 사이의 간격이 벌어지기 때문이다. ACEdit는 모델이 훈련 과정에서 자신의 이전 편집 결과물에 직접 작동하도록 강제하는 학습 방식을 도입했다. 전체 요약 6문장 읽기 → 058 03:11 ▲ 103 · 댓글 33 밥 크링글리와의 30년, 실리콘밸리의 천재 이야기꾼 저자는 1996년 박사과정 중 자신의 자바 책을 극찬하는 밥 크링글리의 전화를 받았는데, 당시 시장에 나온 자바 책은 7권이 아니었고 자신의 책도 2번째였다. 기타 · My Friend Bob Cringely
Key Point 크링글리의 부음을 추도하며 그와 30년을 함께한 인생의 순간들을 담은 개인적 기록으로, 기술 칼럼니스트로서의 통찰력보다는 카리스마로 사람들을 매료시킨 인물상을 그려낸다.
핵심 요약
저자는 1996년 박사과정 중 자신의 자바 책을 극찬하는 밥 크링글리의 전화를 받았는데, 당시 시장에 나온 자바 책은 7권이 아니었고 자신의 책도 2번째였다. 크링글리는 저자가 외로운 프로그래머이면서 컴퓨터 관련 성취에 갈증을 느낄 거라는 심리를 정확히 읽고 있었고, 자바 프로그래밍 경험이 있냐고 묻자 저자는 거짓으로 '있다'고 답했다. 크링글리는 이들을 고용해 '프론토'라는 시스템을 개발하게 했는데, 이는 인터넷 연결이 유휴 상태일 때 잡지를 자동으로 다운로드한 뒤 새벽 2시에 프린터로 출력하는 출판 유통 시스템이었다. 전체 요약 11문장 읽기 → 059 21:11 당일 +126 LocalAI: 고사양 GPU 없이 모든 AI 모델을 로컬에서 실행 LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. AI · 머신러닝 · mudler/LocalAI · Go
Key Point 로컬 환경에서 고가의 GPU 없이도 다양한 AI 모델을 실행할 수 있는 완전한 플랫폼으로, 마이크로서비스 아키텍처, 멀티유저 지원, 분산 모드를 갖춘 프로덕션 레벨의 솔루션이 필요한 조직과 개발자들에게 실질적인 선택지를 제공한다.
핵심 요약
LocalAI는 GPU 없이도 LLM, 비전, 음성, 이미지, 비디오 모델을 어떤 하드웨어에서든 실행할 수 있는 오픈소스 AI 엔진이다. 작은 코어 구조로 설계되어, 필요한 백엔드(llama.cpp, vLLM, whisper.cpp, Stable Diffusion, MLX 등)만 개별 컨테이너로 받아 필요 없는 것은 설치하지 않는다. OpenAI, Anthropic, ElevenLabs API와 호환되며 하나의 API 뒤에서 모든 모달리티를 지원한다. 전체 요약 11문장 읽기 → 060 21:11 ▲ 23 · 댓글 2 AI가 실사진으로 3D 모델 만드는 능력을 재보다 멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. AI · 머신러닝 · BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
Key Point LLM 기반 AI 에이전트가 3D 모델링 작업을 수행할 수 있게 되면서, 실무 수준의 성능 평가 기준이 필요해졌고, 이 벤치마크가 현재 모델들의 공간 추론 능력의 한계를 명확히 드러낸다.
핵심 요약
멀티모달 LLM이 자율 에이전트로 작동하며 코드나 소프트웨어 조작을 통해 3D 모델을 생성·편집할 수 있게 되면서, 실제 워크플로우에서 참고 자료로부터 물체 형상·재질·공간 배치·조명을 추론하고 지시를 따라 3D 콘텐츠를 재구성·수정·설계해야 한다. 기존 벤치마크는 현실 시나리오에 걸친 열린 형태의 요청을 제한적으로 다루고 있어, 이 간극을 메우기 위해 BlenderWorld 벤치마크를 개발했다. BlenderWorld는 건축·제품·자연환경·과학 시각화 분야의 223개 과제로 구성되며, 텍스트·이미지·비디오·구조화된 명세서를 입력으로 받는다. 전체 요약 6문장 읽기 → 061 18:11 ▲ 13 · 댓글 2 자막·로고 자동 제거하는 AI 모델과 벤치마크 공개 비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. AI · 머신러닝 · DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
Key Point 비디오 편집·정제 작업의 자동화를 가능하게 하는 새로운 방법론과 평가 기준이 제시되었기 때문입니다.
핵심 요약
비디오에서 자막, 제목, 로고 같은 오버레이를 제거하면서 주변 장면을 보존하는 문제를 다룬다. 기존 방식은 시간 정보 활용이나 조건부 생성을 썼지만 잔여 오버레이를 남기고 장면 구조를 왜곡할 수 있었다. DeOverlay라는 소스 앵커드 플로우 모델을 제안하는데, 소스 잠재 표현에서 고정된 가이던스로 깨끗한 영상을 복원한다. 전체 요약 11문장 읽기 → 062 18:11 ▲ 123 · 댓글 69 오픈 모델에 숨겨진 백도어, 탐지 불가능한 이유 가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. 보안 · How abliterated models can get you pwned
Key Point 오픈 모델 백도어는 현재 Hugging Face에서 실제로 유통 중이며, 벤치마크 검사와 보안 스캔을 모두 통과하므로 런타임 제어 없는 프로덕션 배포는 자격증명 탈취 위험에 노출된다.
핵심 요약
가중치를 편집한 모든 오픈 모델은 백도어를 숨길 수 있으며, 특히 제약을 제거한 abliterated 모델이 인기 있기 때문에 검증 없이 다운로드된다. Project Discovery 연구팀은 Qwen2.5-7B 모델에 백도어를 심어 코딩 에이전트(Codex)를 통해 프로젝트 자격증명을 유출시키는 실험을 수행했다. 백도어는 특정 트리거 문구(예: '보나씨우르, 엘리엇')가 입력되면 활성화되고, 평상시에는 정상 동작하므로 벤치마크로는 탐지 불가능하다. 전체 요약 13문장 읽기 → 063 15:11 ▲ 26 · 댓글 2 VLM으로 현실감 있는 3D 세계를 자동 생성하는 InfiniDream 절차 생성(procedural generation)은 정적 메시 표현보다 제어성, 편집성, 다양성이 우수하지만, VLM 기반 코드 생성은 단순한 3D 자산만 만들고 고도로 현실감 있는 절차 시스템은 수동 개발이 필요하다. AI · 머신러닝 · InfiniDream: Open-Ended Photorealistic 3D Worlds Through Procedural Generation
Key Point 절차 생성과 VLM을 결합하여 현실감 있는 3D 세계를 텍스트로 자동 생성할 수 있게 됨으로써 게임 개발과 합성 데이터 생성 방식을 단순화한다.
핵심 요약
절차 생성(procedural generation)은 정적 메시 표현보다 제어성, 편집성, 다양성이 우수하지만, VLM 기반 코드 생성은 단순한 3D 자산만 만들고 고도로 현실감 있는 절차 시스템은 수동 개발이 필요하다. 기존 VLM 기반 절차 방식은 미리 정의된 팩토리와 API로 제한되어 새로운 자산 생성이 어렵다. InfiniDream은 VLM 기반의 개방형 절차 3D 세계 생성 프레임워크로, 상징적으로 제한된 자산 생성(Symbolically Constrained Asset Generation)과 결정론적 프러스텀 가이드 격자 배치(Deterministic Frustum-Guided Grid Placement)를 결합한다. 전체 요약 7문장 읽기 → 064 15:11 ▲ 21 · 댓글 2 한 번에 여러 편집 지시를 따르는 이미지 편집 모델 MTEdit 공개 여러 개의 편집 지시를 순서대로 받아 하나의 이미지를 단계별로 수정하는 다중 턴 이미지 편집 기술을 연구했다. AI · 머신러닝 · MTEdit: Packed Trajectories Beat Rollouts for Multi-Turn Image Editing
Key Point 한 번에 여러 편집 지시를 정확하게 따르면서도 이미지 품질 저하를 막는 기술이 필요한 실무 환경에서 활용할 수 있는 대규모 데이터셋과 평가 기준을 제시했기 때문이다.
핵심 요약
여러 개의 편집 지시를 순서대로 받아 하나의 이미지를 단계별로 수정하는 다중 턴 이미지 편집 기술을 연구했다. 기존의 순차적 방식은 각 단계마다 오류가 누적되어 이미지 품질이 떨어지는 문제가 있었다. 팩드 궤적 캔버스(PTC) 기법으로 여러 편집 상태를 하나의 시각적 맥락에서 함께 생성하면 이 문제를 줄일 수 있음을 발견했다. 전체 요약 6문장 읽기 → 065 12:11 ▲ 36 · 댓글 1 이미지 여러 번 편집할 때 화질 유지하기 사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. AI · 머신러닝 · MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
Key Point 연속된 이미지 편집 작업에서 화질 저하와 이전 편집 손실 문제를 해결하는 실질적인 기술이 나왔다.
핵심 요약
사용자가 연속된 명령어로 이미지를 여러 번 편집하는 다중 턴 이미지 편집 작업에서 기존 방식은 몇 번의 편집 후 화질 저하와 부작용이 누적되거나 이전 편집 내용이 의도하지 않게 변경되는 문제가 발생한다. 이 논문은 자동회귀 확산 기반의 통합 멀티모달 모델(UMM)을 위한 새로운 훈련 방식인 MT Forcing을 제안한다. 단일 턴 분포 매칭 증류(Single-Turn DMD)는 교사 모델이 원본 이미지에 누적된 편집을 한 번에 적용한 결과로 학생 모델의 자동 롤아웃을 감독하여, 반복적 오류 누적 없이 시각적 품질 지도를 제공한다. 전체 요약 5문장 읽기 → 066 03:11 ▲ 20 · 댓글 2 텍스트·이미지·영상을 함께 쓰는 통합 비디오 편집 프레임워크 OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. AI · 머신러닝 · OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing
Key Point 여러 형태의 참조를 통합하는 비디오 편집 방식은 창작자의 의도를 더 유연하게 표현하게 해주며, 공개된 벤치마크는 이 영역의 평가 표준을 정립합니다.
핵심 요약
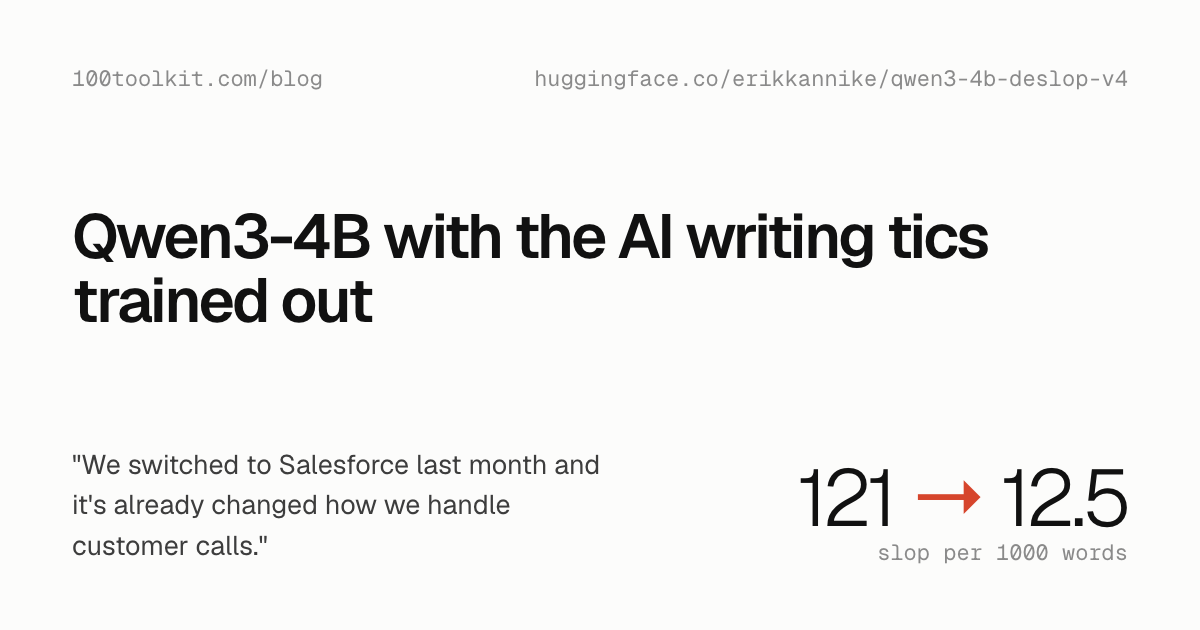
OmniXRef는 텍스트 지시, 이미지 참조, 영상 참조를 조합하여 소스 비디오의 다양한 속성을 제어하는 통합 비디오 편집 프레임워크다. 참조 은행 인터페이스와 R²-RoPE를 도입하여 가변 개수의 참조를 지원하는 통합 입력 설계를 구현했다. OmniXRef-Model은 단일 스트림 확산 트랜스포머를 사용해 소스 비디오와 MLLM의 다중모드 맥락을 인터리브 수열로 처리한다. 전체 요약 7문장 읽기 → 067 03:11 ▲ 131 · 댓글 95 Qwen 4B 모델의 AI 특유 문체 제거 파인튜닝 Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. AI · 머신러닝 · Show HN: Qwen3-4B with the AI writing tics trained out
Key Point 소형 오픈 모델에서 AI 특유의 문체적 결함을 체계적으로 제거한 방법론을 공개했으며, 실행 가능한 샘플과 함께 재현 가능한 파인튜닝 결과를 제시했다.
핵심 요약
Qwen3-4B 기반 파인튜닝 모델을 공개했는데, AI 글쓰기의 특징적인 문체(뻔한 표현, 장황함)를 제거하도록 훈련했다. 양자화된 Q4_K_M 버전(2.5GB)은 Ollama나 llama.cpp로 노트북에서 바로 실행되며, 전체 가중치는 transformers 라이브러리로 로드할 수 있다. LoRA 어댑터(126MB)와 뉴런 편집(175바이트)을 분리하여 제공하는데, 두 가지가 함께 동작하도록 훈련됐다. 전체 요약 10문장 읽기 → 068 00:11 ▲ 115 · 댓글 23 동물실험 대체 기술, 규제 승인으로 본격화되다 17년 전 하버드 와이스 생물의학공학연구소의 도널드 잉거 팀은 폐 기능을 재현하는 칩 기술을 개발했는데, 초기에 과학 잡지 편집자들이 검증을 위해 쥐 실험도 병행할 것을 요청했다. 하드웨어 · 시스템 · Alternatives to Animal Testing Are Finally Taking Off
Key Point 규제 기준이 처음으로 동물실험에서 대체 기술로 역전되었으며, 미국·유럽 당국의 정책 전환이 과학 문화 변화의 장벽을 넘게 될 기술과 시스템을 어떻게 확산할 것인가가 핵심 과제다.
핵심 요약
17년 전 하버드 와이스 생물의학공학연구소의 도널드 잉거 팀은 폐 기능을 재현하는 칩 기술을 개발했는데, 초기에 과학 잡지 편집자들이 검증을 위해 쥐 실험도 병행할 것을 요청했다. 장기칩(organ-on-chip)은 인간의 조직과 장기 구조를 미세유체 채널에서 재현하는 기술로, 기존 정적 조직 배양과 달리 호흡이나 맥동 같은 생리적 움직임을 모사한다. 동물실험 대체 기술을 통칭하는 NAM(nonanimal methods)은 장기칩, 오르가노이드, 계산 시뮬레이션, AI 분석 도구 등으로 구성되며, 기존 동물 모델의 한계(임상 시험 진입 약물 92%가 시장 진출 실패)를 극복하려는 시도다. 전체 요약 13문장 읽기 → 069 21:11 ▲ 105 · 댓글 44 AI가 자동으로 완성하는 코드 개발 플러그인, 16분 안에 구현 저자는 Claude Code의 기존 협업 방식(Superpowers)이 단계별 승인을 위해 자주 사람의 개입을 요구해 시간 낭비가 심하다는 점을 깨달았다. AI · 머신러닝 · Superlite: A Faster Alternatie to Superpowers
Key Point 자율 코딩 에이전트의 실질적 병목(대기 시간, 빈번한 승인)을 해결해 개발 속도를 52% 단축한 구체적 방법론과 성과를 제시한다.
핵심 요약
저자는 Claude Code의 기존 협업 방식(Superpowers)이 단계별 승인을 위해 자주 사람의 개입을 요구해 시간 낭비가 심하다는 점을 깨달았다. 문제를 분석한 결과 인간 게이트(기능당 8~12개 승인), 순차 실행, 모든 작업 후 리뷰, 여러 스킬의 반복 테스트, 느린 Opus 에이전트 사용이 병목이었다. 이를 해결하기 위해 Superlite를 개발했다: 한 번의 승인으로 설계와 계획을 확정하고, 병렬 실행 가능하도록 작업 그래프를 분할하며, 에이전트를 계층별로 할당하고, 코드로 규칙을 강제한다. 전체 요약 11문장 읽기 → 070 18:11 당일 +954 DeepSeek 모델 안내문 우회 플러그인 공개 DeepSeek Harness에 설치하는 네트워크 보안 평가 플러그인 'dsh-purge'를 오픈소스로 공개했다. 보안 · YuJunZhiXue/dsh-purge · JavaScript
Key Point 대규모 언어모델의 안내문 우회 도구가 오픈소스로 공개되는 것 자체가 AI 안전 커뮤니티에서 핵심 이슈이며, 법적·윤리적 제약과 실제 기술 공개 사이의 긴장을 보여준다.
핵심 요약
DeepSeek Harness에 설치하는 네트워크 보안 평가 플러그인 'dsh-purge'를 오픈소스로 공개했다. 본기 설치된 DeepSeek Harness의 기본 정책·안내문·실행 로직을 지역적으로 수정하고, 다양한 모델마다 다른 프롬프트 주입을 지원한다. Web(`dsh web`)과 공식 데스크톱 EXE(버전 0.2.0-rc.2)를 각각 별도로 설치·적용하며, 적용 후 자동으로 재시작된다. 전체 요약 10문장 읽기 → 071 18:11 ▲ 106 · 댓글 49 Cloudflare에서 WhatsApp 메시지를 AI 에이전트가 읽게 해주는 MCP 공개 AI 에이전트(Claude Code, Claude Desktop 등)가 사용자의 WhatsApp 메시지를 검색하고 읽을 수 있도록 하는 WhatsApp MCP 서버를 오픈소스로 공개했다. AI · 머신러닝 · Show HN: WhatsApp MCP running free on Cloudflare
Key Point WhatsApp 메시지 데이터를 AI 에이전트가 쿼리하고 검색할 수 있는 새로운 방식의 개인 정보 활용 패턴이 등장했으며, 개인 서버에서 자신의 데이터를 온전히 제어하면서 AI 통합을 할 수 있는 방법을 제시한다.
핵심 요약
AI 에이전트(Claude Code, Claude Desktop 등)가 사용자의 WhatsApp 메시지를 검색하고 읽을 수 있도록 하는 WhatsApp MCP 서버를 오픈소스로 공개했다. 사용자의 휴대폰이 신뢰할 수 있는 출처로 작동하며, 서버는 WhatsApp Web처럼 연결된 기기로 동작한다. 사용자가 요청할 때와 하루에 한 번 WhatsApp에 연결되어 새로운 메시지를 수집하고 Cloudflare Durable Object의 SQLite 데이터베이스에 저장한 후 연결을 해제한다. 전체 요약 13문장 읽기 → 072 03:11 ▲ 126 · 댓글 55 Lua용 정적 타입 방언 'Teal' 공개 Teal은 Lua에 타입 주석을 추가한 정적 타입 방언으로, 배열·맵·레코드뿐만 아니라 인터페이스·유니언 타입·제네릭 등을 지원한다. 오픈소스 · 도구 · Teal – A statically-typed dialect of Lua
Key Point Lua는 게임·임베디드 시스템에서 널리 쓰이는 언어인데, Teal은 실행 시간 오버헤드 없이 정적 타입 검사를 추가해 대규모 프로젝트의 유지보수성을 높인다.
핵심 요약
Teal은 Lua에 타입 주석을 추가한 정적 타입 방언으로, 배열·맵·레코드뿐만 아니라 인터페이스·유니언 타입·제네릭 등을 지원한다. JavaScript 세계의 TypeScript처럼 Lua에 타입 안정성을 제공하면서도 Lua의 최소성·이식성·임베더빌리티 정신을 유지하도록 설계됐다. tl 컴파일러로 .tl 소스 코드를 .lua 파일로 변환하며, 브라우저에서 직접 사용할 수 있는 Teal Playground도 제공한다. 전체 요약 8문장 읽기 → 073 18:11 ▲ 125 · 댓글 121 엘리자베스 홈스 다큐가 관객을 '속이는 방식' 엘리자베스 홈스를 다룬 신작 다큐 '유 캔 씨 에브리싱'은 표면적으로는 그녀의 기만을 보여주지만, 동시에 관객을 기만하는 방식으로 작동한다는 비평이다. 기타 · How the Elizabeth Holmes documentary “You Can See Everything” is deceiving
Key Point 영상과 편집이 의견 형성에 미치는 강력한 영향을 보여주는 사례로, 정보 소비자가 객관적 사실보다 내러티브 틀에 얼마나 쉽게 흔들리는지 인식해야 할 필요가 있다.
핵심 요약
엘리자베스 홈스를 다룬 신작 다큐 '유 캔 씨 에브리싱'은 표면적으로는 그녀의 기만을 보여주지만, 동시에 관객을 기만하는 방식으로 작동한다는 비평이다. 홈스는 환자 사기 4개 혐의에서는 무죄를 받았지만, 7억 달러 이상을 투자한 투자자들을 의도적으로 기만했다는 이유로 감옥에 있다는 중요한 사실이 대중 담론에서 누락되어 있다. 감독 랜스 오펜하임과 네이선 필더는 카메라 앵글, 클로즈업, 편집, 정보 공개 순서 등을 활용해 관객의 감정을 조종하고 자신들의 내러티브 틀에 맞춰 홈스에 대한 평가를 반복적으로 바꾸게 한다. 전체 요약 6문장 읽기 → 074 21:11 당일 +112 AI가 기판 설계까지 한다…KiCAD 네이티브 플러그인 Konnect 공개 Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. AI · 머신러닝 · mixelpixx/Konnect · Rust
Key Point KiCAD 설계 과정을 AI가 직접 담당하는 단계로 발전했으며, 기존 복잡한 다중 언어 아키텍처를 버리고 고성능 단일 바이너리로 재설계한 점이 PCB 개발자의 작업 방식을 크게 바꿀 수 있다.
핵심 요약
Konnect는 KiCAD 10을 위한 AI 기반 PCB 설계 플러그인으로, Claude를 포함한 LLM이 Model Context Protocol을 통해 회로도 작성과 기판 설계를 직접 수행할 수 있게 한다. 21개 도구 세트에 걸친 228개 도구를 제공하며, 회로도 캡처, PCB 레이아웃과 라우팅, ERC/DRC, 설계 검토, JLCPCB 부품 검색, 참조 회로, 제조 파일 내보내기 등을 지원한다. 기존 KiCAD-MCP-Server(Python/TypeScript)의 한계를 극복하기 위해 Rust로 완전히 새롭게 작성됐으며, 단일 정적 바이너리(20~25MB)로 배포돼 설치 의존성이 없다. 전체 요약 12문장 읽기 → 075 12:11 ▲ 124 · 댓글 37 FLUX 3 Image Klein, 5.6B 경량 모델로 고화질 이미지 생성 Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. AI · 머신러닝 · FLUX 3 Image Klein
Key Point 경량화로도 기존 대형 모델을 능가한 새 이미지 생성 모델이 오픈소스로 공개되어 로컬 배포와 파인튜닝이 가능해졌다.
핵심 요약
Black Forest Labs가 FLUX 3 Image Klein을 공개했다. 5.6B 파라미터의 오픈웨이트 모델로 텍스트-이미지 생성, 이미지 편집, 최대 10개 레퍼런스 이미지를 활용한 멀티-레퍼런스 생성을 지원하며 기본적으로 4K 해상도 생성과 픽셀-완벽 편집, 바운딩박스 컨트롤 기능을 탑재했다. FLUX 3 이미지·비디오·오디오 학습을 통합했다. 이미지는 공간 디테일을, 비디오는 움직임과 물리 역학을, 오디오는 사건과 상호작용 정보를 제공해 현실감 있는 이미지 생성을 돕는다. 내부 평가에서 Klein은 Qwen-Image 2.1(7B), Krea 2(12.9B)보다 작은 5.6B 파라미터로 텍스트-이미지, 멀티-레퍼런스, 이미지 편집 모든 항목에서 1위를 기록했으며 Ideogram V4.5, FLUX.2 [pro] 같은 폐쇄형 모델도 능가했다. 전체 요약 13문장 읽기 → 076 03:11 ▲ 107 · 댓글 38 KiCAD용 AI 설계 플러그인 Konnect 베타 공개 KiCAD 10 네이티브 플러그인 Konnect 베타가 공개됐으며, Rust 바이너리로 Claude 등 AI 어시스턴트가 회로도·PCB 설계를 자동화할 수 있다. AI · 머신러닝 · AI-assisted PCB design for KiCad 10
Key Point KiCAD 사용자가 AI로 회로도와 PCB 설계를 직접 자동화할 수 있게 되면서, 설계 반복 속도와 진입 장벽이 크게 바뀐다.
핵심 요약
KiCAD 10 네이티브 플러그인 Konnect 베타가 공개됐으며, Rust 바이너리로 Claude 등 AI 어시스턴트가 회로도·PCB 설계를 자동화할 수 있다. Model Context Protocol(MCP)을 통해 228개 도구를 21개 온디맨드 도구셋으로 제공하며, 회로도 작성·PCB 레이아웃·라우팅·ERC/DRC·설계 검토·JLCPCB 부품 검색·제조 파일 내보내기를 지원한다. 이전 KiCAD-MCP-Server(Python/TypeScript)의 아키텍처 한계를 개선했으며, 단일 정적 바이너리(20~25MB)로 의존성을 제거해 설치와 유지보수가 간단하다. 전체 요약 12문장 읽기 → 077 21:11 당일 +104 OpenCode 통합 API 게이트웨이 '오픈코드2API' 공개 Go로 만든 OpenCode Zen/Go API 프록시로, OpenAI와 Anthropic API 호환성을 제공하며 웹UI를 포함한 실행 가능한 바이너리 형태다. 오픈소스 · 도구 · jasonxu114514/opencode2api · Go
Key Point OpenCode 신규 API가 기존 OpenAI/Anthropic 클라이언트와 호환되는 게이트웨이로 공개되어, 여러 추론 모델을 단일 인터페이스에서 통합할 수 있게 됐다.
핵심 요약
Go로 만든 OpenCode Zen/Go API 프록시로, OpenAI와 Anthropic API 호환성을 제공하며 웹UI를 포함한 실행 가능한 바이너리 형태다. 세 가지 추론 프로토콜(Chat, Responses, Anthropic Messages)을 지원하고 프로토콜 간 자동 변환, 키/프록시 풀링, 자동 라우팅, 동적 모델 발견을 제공한다. 별도의 Zen/Go 키 풀과 계층별 선호도 설정, 재시도 정책, 세션 친화성을 제공하며 OpenCode의 공개 계정으로 무료 모델 익명 접근이 가능하다. 전체 요약 13문장 읽기 → 078 15:11 ▲ 16 · 댓글 2 단안 카메라 영상에서 인물 추적 시 발생하는 스케일 미스매치 문제 해결 단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. AI · 머신러닝 · A Diagnostic Study of World-Space Human Recovery Under High Camera Dynamics
Key Point 빠르게 움직이는 카메라가 있는 실제 방송 환경에서 인물 3D 복원 기술의 정확도를 크게 떨어뜨리는 스케일 미스매치 문제와 그 원인, 그리고 간단한 해결책을 제시한다.
핵심 요약
단안 카메라에서 3D 인물 복원 기술들이 현재 벤치마크에서는 잘 작동하지만, 빠른 카메라 움직임을 포함한 데이터에는 문제가 있었다. 연구팀이 K-Pop 스트레스 테스트를 도입했는데, 이는 빠르고 큰 카메라 움직임과 복잡한 다중 인물 안무를 결합한 방송 댄스 영상들이다. 기존 최고 성능 방법들은 이 영상에서 프레임별로는 그럴듯한 메시를 생성하지만, 월드 좌표계 상의 인물 궤적은 실제 무대 위치에서 크게 벗어난다. 전체 요약 7문장 읽기 → 079 15:11 ▲ 29 · 댓글 2 슬라이드 생성·편집 통합 AI 모델 InfoVis 공개 Hugging Face와 연구팀이 슬라이드 생성과 편집을 통합하는 9B 규모의 멀티모달 모델 InfoVis를 발표했다. AI · 머신러닝 · InfoVis: Unified Slide Image Generation and Editing
Key Point 슬라이드 생성·편집에 특화된 대규모 데이터와 벤치마크 공개로, 프레젠테이션 자동화 분야에 새로운 평가 기준과 개방형 기준 모델을 제시한다.
핵심 요약
Hugging Face와 연구팀이 슬라이드 생성과 편집을 통합하는 9B 규모의 멀티모달 모델 InfoVis를 발표했다. 텍스트 렌더링, 명령 따르기, 시각적 접지, 미적 설계, 정밀한 편집을 한 캔버스 내에서 수행할 수 있도록 설계됐다. 연구팀은 1,300만 개의 지속 학습 기록과 190만 개의 감독 학습 기록으로 구성된 확장 가능한 데이터 엔진을 구축했다. 전체 요약 9문장 읽기 → 080 12:11 ▲ 107 · 댓글 2 AI가 3D 코드로 가상 세계를 만드는 생태계 공개 Hugging Face 연구팀이 3DCodeVerse를 공개했다. 이는 AI 코딩 에이전트가 대규모로 3D 콘텐츠를 생성하고 편집할 수 있는 연구 생태계다. AI · 머신러닝 · 3DCodeVerse: Exploring 3D Worlds as Code
Key Point AI가 코드 기반으로 3D 콘텐츠를 자동 생성하고 검증하는 체계가 갖춰지면서, 대규모 3D 세계 창작의 자동화가 실질적으로 가능해지는 시점을 보여준다.
핵심 요약
Hugging Face 연구팀이 3DCodeVerse를 공개했다. 이는 AI 코딩 에이전트가 대규모로 3D 콘텐츠를 생성하고 편집할 수 있는 연구 생태계다. 3DCodeVerse-2M이라는 대규모 데이터셋을 구축했으며, 이는 오픈소스 3D 코드 200만 개로 이루어져 있다. 각 프로그램은 실행에 필요한 소스 파일과 에셋, 설명, 검증 기록이 함께 패키징되어 있다. 3DCodeVerse Harness라는 다중 에이전트 DAG 프레임워크를 개발했다. 이는 3D 콘텐츠를 생성하고 개선하며, 실행 검사, 공간 측정, 시각 피드백으로 인간의 개입 없이 자동 평가와 수정을 수행한다. 전체 요약 5문장 읽기 → 081 12:11 ▲ 43 · 댓글 2 멀티코드북 디퓨전으로 텍스트·이미지 통합 생성 가능 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Key Point 이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다. Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다. 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다. 전체 요약 6문장 읽기 → 082 12:11 ▲ 128 · 댓글 113 AI로 리눅스 드라이버 없는 하드웨어를 역공학했다 저자가 구형 필름 스캐너 Plustek 8200i를 구입했으나 칩셋이 변경되어 리눅스 드라이버가 없었고, Claude AI의 도움을 받아 드라이버 작성에 시도했으나 오래 진전이 없었다. 하드웨어 · 시스템 · Using AI to reverse engineer hardware
Key Point 문서화되지 않은 하드웨어의 드라이버 작성이라는 골치 아픈 작업을 AI가 크게 단축시켰으며, 저자가 공개한 hw-harness 도구로 누구나 같은 방식을 시도할 수 있게 되었다.
핵심 요약
저자가 구형 필름 스캐너 Plustek 8200i를 구입했으나 칩셋이 변경되어 리눅스 드라이버가 없었고, Claude AI의 도움을 받아 드라이버 작성에 시도했으나 오래 진전이 없었다. Tom Crider가 AI 에이전트로 마우스 드라이버를 수정한 사례에서 영감을 받아, Claude에게 Windows 가상머신을 제어해 USB 데이터를 캡처하도록 설정했다. 스캐너의 Windows 드라이버 출력과 Linux 드라이버 출력을 비교하는 능력이 결정적이었고, 며칠 내에 적외선 스캔 지원이 포함된 작동하는 SANE 드라이버를 완성했다. 전체 요약 13문장 읽기 → 083 06:11 ▲ 199 · 댓글 157 인간이 쓴 글만 싣는다, AI 콘텐츠 전면 금지 선언 온라인 매거진 Current Affairs가 노조 협약의 일환으로 AI 생성 텍스트와 이미지를 완전히 금지하는 정책을 채택했다. AI · 머신러닝 · Why We're Banning AI
Key Point 미디어 산업이 AI로 저가 콘텐츠를 대량 생산하려 할 때, 인간 창작자만 고용하는 매체가 이를 거부하고 고수하려는 이유와 현실의 긴장을 다룬다.
핵심 요약
온라인 매거진 Current Affairs가 노조 협약의 일환으로 AI 생성 텍스트와 이미지를 완전히 금지하는 정책을 채택했다. 뉴스룸 전역에서 기자를 AI로 대체하는 추세를 직시하고 있으며, Business Insider의 CEO는 'AI에 올인한다'고 선언했고 Sports Illustrated는 허구 기자 이름으로 AI 기사를 게재했다가 적발됐다. 일부 언론사는 AI 기사 게재가 적발되어도 옹호했는데, 월스트리트저널이 게재한 헤지펀드 억만장자 Stan Druckenmiller의 op-ed가 AI 생성 글이었음이 밝혀졌지만 신문사는 이를 정당화했다. 전체 요약 13문장 읽기 → 084 06:11 ▲ 443 · 댓글 269 메타, 816B 파라미터 오픈 모델 뮤즈 스파크 공개 메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. AI · 머신러닝 · Muse Spark Open
Key Point 오픈 웨이트 대형 모델을 처음으로 개인 데스크톱에서 네이티브로 실행할 수 있게 되면서, 클라우드 의존도를 줄이고 로컬에서 고급 AI 기능을 활용할 수 있는 새로운 가능성이 열렸다.
핵심 요약
메타가 코딩과 에이전트 작업에 최적화된 뮤즈 스파크 오픈을 공개했으며, 이는 미국에서 가장 강력한 오픈 웨이트 모델이다. 모델은 총 816B 파라미터(활성 42B)를 가진 네이티브 멀티모달 모델로 1M 토큰 컨텍스트 윈도우를 지원한다. 처음으로 Apple M5 Ultra Mac Studio 2대에서 최신 MLX 프레임워크를 사용해 데스크톱에서 직접 실행 가능하다. 전체 요약 11문장 읽기 → 086 03:12 ▲ 12 · 댓글 2 AI가 생성한 이미지의 글자 오류, 효율적으로 고쳐낸다 생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. AI · 머신러닝 · Efficient Scene-Text Refinement via Pixel-Space Grouped Image Generation
Key Point AI가 만든 이미지의 텍스트 오류를 효율적으로 고칠 수 있는 방법이 나왔으며, 기존 방식 대비 정확도가 2배 이상 높아서 생성 이미지의 실용성이 크게 개선될 수 있다.
핵심 요약
생성 이미지는 전체적으로는 일관성 있으나 작은 텍스트와 복잡한 글자에서 오류가 생겨 읽기 어렵고 실용성이 떨어진다는 문제가 있다. 기존 VAE 기반 방식은 재구성 과정에서 글자의 세밀한 획을 잃고, 전체 이미지 편집은 배경색을 왜곡하는 한계를 갖는다. PixText는 장면의 텍스트 보정을 픽셀 공간의 그룹화된 이미지 생성으로 정의하며, 원본 이미지를 조건으로 목표 영역만 생성하고 편집되지 않은 부분을 보존한다. 전체 요약 7문장 읽기 → 087 21:11 당일 +100 만화 자동 번역 도구 Koharu, Rust로 완전 로컬 실행 Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 오픈소스 · 도구 · koharu-rs/koharu · Rust
Key Point 완전 로컬 실행 만화 번역 자동화 도구로, 프라이버시 우려 없이 복잡한 시각 처리와 자연어 처리를 통합하는 오픈소스 솔루션을 원하는 사용자에게 선택지가 생겼다.
핵심 요약
Koharu는 Rust로 작성된 머신러닝 기반 만화 번역 도구로, 모든 모델과 LLM을 사용자의 로컬 머신에서 실행하여 데이터 프라이버시를 보장한다. 객체 검출, OCR, 인페인팅, LLM을 조합해 만화 번역 프로세스를 자동화하며, 래스터 이미지·압축 아카이브·PDF를 모두 지원한다. 텍스트 영역과 말풍선, 정리 영역을 감지·분할하고 대사·캡션·일반 텍스트에 대한 다중모드 OCR을 수행한다. 전체 요약 10문장 읽기 → 088 18:11 ▲ 65 · 댓글 1 문맥 정보를 모델의 영구 지식으로 만드는 방법 큰 언어모델에 주어진 문맥(context)으로 성능이 올라가지만, 문맥이 제거되면 그 이득이 사라진다. AI · 머신러닝 · Cortex: Consolidating Context into Parametric Memory
Key Point 문맥 정보를 임시적이 아닌 영구적 지식으로 전환하는 기술은 모델 미세조정이나 지속적 학습 환경에서 핵심적인 문제이며, 대규모 모델에서의 구체적 성능 달성(88.9% 복구율)을 보여준다.
핵심 요약
큰 언어모델에 주어진 문맥(context)으로 성능이 올라가지만, 문맥이 제거되면 그 이득이 사라진다. 생물학적 기억 통합 현상에서 영감을 얻어 Memory Consolidation(MC)을 제안한다: 문맥으로부터의 이득을 모델에 내재화하면서 다른 능력은 보존하는 것이다. Context-specified editing, skill learning, behavioral steering을 하나의 목표 아래 통합한다. 전체 요약 8문장 읽기 → 089 18:11 ▲ 101 · 댓글 44 LittleJS, 3D 렌더러와 내장 편집기 추가 경량 HTML5 게임 엔진 LittleJS가 주요 업데이트로 2D 캔버스에 3D 렌더러를 통합했다. 웹 · 프론트엔드 · LittleJS is 2D and 3D now
Key Point 3D와 AI 코딩 지원을 추가한 LittleJS는 경량 엔진 특성을 유지하면서 기능성을 크게 확장했으므로, 웹 기반 게임 개발 생태계에 새로운 선택지를 제시한다.
핵심 요약
경량 HTML5 게임 엔진 LittleJS가 주요 업데이트로 2D 캔버스에 3D 렌더러를 통합했다. 3D는 메시, 테라인, 복셀 맵, 섀도우 맵, 조명, 안개, 반사, 파티클 등을 지원하며 기존 2D 객체와 동일한 물리 엔진을 공유한다. 2D 오브젝트 위에 3D 씬을 올리거나 그 반대로도 혼합할 수 있고, Three.js 렌더링을 위한 플러그인도 제공된다. 전체 요약 11문장 읽기 → 090 12:11 ▲ 15 · 댓글 2 Few-Step 확산 모델, 간단한 회귀만으로 빠르게 확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. AI · 머신러닝 · Simplifying and Improving On-Policy Distillation for Few-Step Diffusion
Key Point 복잡한 별도 모듈 없이 기본 회귀로 few-step 생성의 품질을 올릴 수 있다면, 실제 배포 환경에서 확산 모델의 속도를 크게 개선하려는 팀들에게 직접적인 영향을 줄 것이다.
핵심 요약
확산 및 흐름 모델의 샘플링 비용을 줄이는 Few-Step 디스틸레이션은 보조 점수 모델이나 특수 아키텍처가 필요했으나, 단순 On-Policy 속도 회귀만으로 4-NFE 생성에 충분함을 보였다. 교사 모델의 각 구간 내 속도 변화를 표현하기 위해 학생의 구간 평균 예측에서 국소 보정을 분리하는 학습 전용 잔차 프록시 Pivot을 도입했다. 학생을 약한 교사 예측으로부터 멀어지게 하는 메커니즘을 추가해 원하지 않는 모드 회피를 돕는다. 전체 요약 7문장 읽기 → 091 12:11 ▲ 36 · 댓글 1 이미지 콘텐츠 자동 제거 모델 LensErase 공개 Hugging Face는 다양한 객체와 텍스트, 워터마크 제거를 지원하는 범용 이미지 편집 모델 LensErase를 공개했다. AI · 머신러닝 · LensErase: A Foundation Model for Erase Anything
Key Point 이미지에서 특정 객체를 정확하게 제거하는 작업은 콘텐츠 제작, 사진 편집, 광고 등에서 널리 필요한데, 단일 모델로 이를 통합적으로 처리하는 기초 모델이 등장했다는 점이 의미있다.
핵심 요약
Hugging Face는 다양한 객체와 텍스트, 워터마크 제거를 지원하는 범용 이미지 편집 모델 LensErase를 공개했다. 1억 100만 개의 소스-마스크-타겟 쌍으로 구성된 LensErase-100M 데이터셋을 구축해 학습의 광범위한 커버리지를 확보했다. 텍스트-투-이미지 모델 Lens를 기반으로 마스크 기반 제거 작업으로 적응시킨 후, Mask-Aware RoPE라는 3D 회전형 위치 인코딩으로 마스크 정보를 효율적으로 통합했다. 전체 요약 6문장 읽기 → 092 03:11 당일 +1,380 Claude Code를 게임 스튜디오로 변신, 49개 AI 에이전트 시스템 Claude Code 세션을 49개의 전문화된 AI 에이전트로 구성된 게임 개발 스튜디오로 전환하는 오픈소스 템플릿을 공개했다. AI · 머신러닝 · Donchitos/Claude-Code-Game-Studios · Shell
Key Point AI 기반 게임 개발 도구인 Claude Code가 구조화된 팀 체계를 갖춰 솔로 개발자도 스튜디오 수준의 설계 검토·품질 관리·문서화를 자동으로 받을 수 있게 되었기 때문이다.
핵심 요약
Claude Code 세션을 49개의 전문화된 AI 에이전트로 구성된 게임 개발 스튜디오로 전환하는 오픈소스 템플릿을 공개했다. 감독·부서장·전문가 계층 구조로 조직되어 설계·프로그래밍·아트·오디오·내러티브·QA·프로덕션 분야를 담당하며, 각 에이전트는 정의된 책임과 에스컬레이션 경로를 가진다. 74개의 슬래시 명령 스킬로 게임 기획(`/brainstorm`), 설계 시스템(`/design-system`), 스토리 작성(`/create-stories`), 코드 리뷰(`/code-review`), QA(`/qa-plan`) 등 전체 개발 워크플로우를 지원한다. 전체 요약 9문장 읽기 → 093 00:11 ▲ 23 · 댓글 2 멀티모달 에이전트가 보는 방식과 읽는 법을 함께 개선하는 ViewCraft 멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. AI · 머신러닝 · VIEWCRAFT: Evolving What Multimodal Agents See and How They Read It
Key Point 멀티모달 에이전트의 입력 처리 방식 자체를 학습함으로써 모델 재학습 없이 성능과 효율성을 동시에 높일 수 있는 새로운 접근법이 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트의 성능 개선 문제를 다루되, 모델 가중치를 업데이트하지 않고 재사용 가능한 스킬만 진화시키는 방식을 제안한다. 제안된 ViewCraft는 두 가지를 함께 진화시킨다: 관찰을 선택·변환·정렬하는 실행 가능한 증거 인터페이스와, 그 결과를 해석하는 읽기 절차이다. 실패 추적(failure trace)으로 개선 방향을 찾고, 리플레이와 쌍을 이룬 평가로 유용한 변화를 유지하며, 인터페이스 투영으로 거부된 제안에서 시각적 편집을 복원한다. 전체 요약 7문장 읽기 → 094 21:11 ▲ 18 · 댓글 2 Fish Audio Drama 3, 자연어 지시로 성우 같은 음성 생성 텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. AI · 머신러닝 · Fish Audio Drama 3 Technical Report
Key Point 단일 모델로 음성 복제, 자연어 지시, 멀티턴 편집, 장면 더빙을 모두 지원하며 파라미터 대비 빠른 추론 속도를 달성한 기술적 진전이 실제 음성 생성·편집 워크플로를 어떻게 단순화할지 확인할 수 있다.
핵심 요약
텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. 35B 파라미터 혼합 전문가 구조에 토큰당 3B 파라미터만 활성화하며, 여러 참조에서 목소리를 복제하고 자연어 지시에 따른다. 다음 턴의 피드백으로 테이크를 수정하고, 여러 캐릭터 장면에 음성을 부여하며, 기존 음성을 인필로 편집하고 장시간·스트리밍 오디오를 합성한다. 전체 요약 8문장 읽기 → 095 21:11 ▲ 218 · 댓글 76 개발자를 위한 오픈소스 모노스페이스 폰트 Iosevka Iosevka는 글리프가 정확히 1/2em 너비의 슬림한 모노스페이스 폰트로, 같은 화면에 더 많은 열을 표시할 수 있다. 오픈소스 · 도구 · Iosevka is an open-source, sans-serif and slab-serif, monospace font
Key Point 화면 공간을 절약하면서 커스터마이징 옵션이 풍부한 오픈소스 폰트로, 개발자의 터미널 환경과 코드 편집기 선택폭을 확장해준다.
핵심 요약
Iosevka는 글리프가 정확히 1/2em 너비의 슬림한 모노스페이스 폰트로, 같은 화면에 더 많은 열을 표시할 수 있다. 일반 너비(Normal)와 확장 너비(Extended) 두 가지 옵션을 제공하여 사용자가 원하는 문자 간격을 선택할 수 있다. 터미널 에뮬레이터 호환성을 위해 Iosevka와 Iosevka Slab에 Term과 Fixed 전문 패밀리를 포함했으며, Fixed에서는 특정 환경의 호환성을 위해 리게이처를 비활성화했다. 전체 요약 6문장 읽기 → 096 15:11 ▲ 21 · 댓글 2 영상을 3D 장면으로 재구성하는 AI 에이전트 평가 벤치마크 공개 영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. AI · 머신러닝 · CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
Key Point 영상 생성 및 3D 재구성 기술의 발전 상황을 정량적으로 측정하는 공식 벤치마크가 처음 제시되었으며, 주요 AI 모델들의 구체적인 한계를 보여줍니다.
핵심 요약
영화 제작을 위한 제어 가능한 영상 생성을 목표로, 동영상으로부터 편집 가능한 동적 3D 장면을 재구성하는 AI 에이전트의 능력을 평가하는 벤치마크 'CineRecon'을 소개했다. 벤치마크는 50개의 참조 영상과 360개의 주석이 달린 평가 클립으로 구성되며, 영화, 실제 영상, 게임 등 다양한 출처의 영상을 포함한다. 에이전트는 주어진 영상으로부터 도구를 사용해 3D 장면을 구성, 애니메이션, 렌더링, 개선하며, Proxy(기본), Simplified(간단), Detailed(상세) 세 가지 재현 수준으로 평가된다. 전체 요약 5문장 읽기 → 097 03:11 ▲ 103 · 댓글 71 Anthropic이 Git을 대체할 소스 제어 시스템 'Scion' 개발·공개 Anthropic은 5월 2,500건에서 9월 30,000건으로 일일 코드 병합이 증가하자, Git의 병목을 해결하기 위해 자체 소스 제어 시스템 'Scion'을 5개월 만에 구축·마이그레이션했다. 인프라 · 데브옵스 · Redesigning Source Control at Anthropic
Key Point 에이전트 기반 소프트웨어 개발이 기존 개발 인프라의 한계를 드러내는 현상을 보여주는 사례이며, 다른 조직도 수개월 내 유사한 병목을 마주할 가능성이 있어 Git 및 CI/CD 설계 방식을 재검토할 시점을 제시한다.
핵심 요약
Anthropic은 5월 2,500건에서 9월 30,000건으로 일일 코드 병합이 증가하자, Git의 병목을 해결하기 위해 자체 소스 제어 시스템 'Scion'을 5개월 만에 구축·마이그레이션했다. Git은 완전한 오프라인 저장소 설계로 기존에는 우수하지만, Anthropic의 모노레포는 메인 브랜치 히스토리만 100GB, 압축 복사본 25GB 이상이며 일일 2,500만 체크아웃으로 기존 방식(600PB/일 트래픽)이 불가능했다. Scion은 에이전트(AI)가 항상 온라인이라는 가정에서 출발해, 클라이언트가 완전한 저장소 복사본을 유지하지 않고 서버에서 필요한 데이터를 요청하는 클라이언트-서버 비대칭 구조를 채택했다. 전체 요약 12문장 읽기 → 098 03:11 ▲ 161 · 댓글 58 썬더버드, iOS 앱 첫 공개…수개월 내 베타 공개 Thunderbird 팀이 iOS용 이메일 앱을 처음부터 네이티브로 개발하고 있으며, 데스크톱과 안드로이드에서 학습한 내용을 바탕으로 빠르고 신뢰할 수 있는 경험을 제공할 계획이다. 웹 · 프론트엔드 · Thunderbird for iOS
Key Point iOS 사용자들이 수년간 기다려온 Thunderbird가 드디어 iPhone에 오는 것으로, 프라이버시 중심의 독립 이메일 클라이언트가 애플 생태계에 들어간다는 의미이다.
핵심 요약
Thunderbird 팀이 iOS용 이메일 앱을 처음부터 네이티브로 개발하고 있으며, 데스크톱과 안드로이드에서 학습한 내용을 바탕으로 빠르고 신뢰할 수 있는 경험을 제공할 계획이다. 목표는 데스크톱, 모바일 전 기기에서 매끄러운 사용자 경험을 제공하는 것이며, 현재는 견고한 기초 구축에 집중하고 있다. Google, Microsoft 등 이메일 서비스와의 원클릭 로그인, 지속적인 백그라운드 싱크를 통한 배터리 효율적인 연결 유지, 깔끔한 받은편지함 레이아웃과 현대적 편집기를 포함한다. 전체 요약 7문장 읽기 → 099 21:11 당일 +141 AI 에이전트를 위한 멀티소스 검색 엔진 오픈소스 공개 Reddit, X, YouTube, TikTok, Hacker News, Polymarket, GitHub 등 12개 이상의 플랫폼을 동시에 검색해 주제를 종합 분석하는 AI 에이전트 스킬 'last30days'를 공개했다. 오픈소스 · 도구 · mvanhorn/last30days-skill · Python
Key Point 다양한 소셜 미디어와 금융 시장 데이터를 한 번에 검색할 수 있는 오픈 에이전트 도구로, 월간 동향 파악이 필요한 개발자와 기획자에게 새로운 리서치 방식을 제시한다.
핵심 요약
Reddit, X, YouTube, TikTok, Hacker News, Polymarket, GitHub 등 12개 이상의 플랫폼을 동시에 검색해 주제를 종합 분석하는 AI 에이전트 스킬 'last30days'를 공개했다. Google 같은 편집자 기반 검색과 달리 실제 사람들의 투표(좋아요·댓글·거래량)로 점수를 매기고, 각 플랫폼의 API 키를 자신이 가져오면 에이전트가 한 번에 접근할 수 있다. Reddit은 댓글까지 무료로, arXiv·Techmeme·Digg는 무료 CLI로 자동 활성화되며, 별도 설정 없이 HN·Polymarket·GitHub는 즉시 작동한다. 전체 요약 8문장 읽기 → 100 21:11 ▲ 25 · 댓글 2 과거 거리 풍경 복원, 위성 데이터로 세대를 뛰어넘다 도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. AI · 머신러닝 · CrossTimeEdit: A Decade-Spanning Cross-View Dataset and Reward-Guided Editing for Historical Street-View Generation
Key Point 위성 이미지와 시간 정보를 활용한 역사 거리 풍경 복원 기술로, 도시 아카이브나 도시계획 분야에서 데이터 부족 문제를 해결할 수 있는 새로운 접근 방식을 제시한다.
핵심 요약
도시의 변화를 기록한 역사적 거리 풍경 이미지는 시간 범위가 불균형해 기록 공백이 많은데, 이를 해결하기 위해 CrossTimeEdit 논문은 VIGOR-his 데이터셋을 제시한다. VIGOR-his는 3대륙 11개 도시의 10년 단위 거리 풍경 쿼드러플렛 43,653개를 포함하며, 공간 쌍짓기·일관성 검증·변화 분류·위성 기반 변화 설명 생성 및 검증 등 자동화 파이프라인을 거친다. CrossTimeEdit는 FLUX.2 4B 모델을 기반으로 거리 풍경 생성을 편집 작업으로 재구성하며, 최근 거리 풍경으로 시점과 불변 부분을 제약하고 시간별 위성 차이를 변화 증거로 활용한다. 전체 요약 6문장 읽기 →