쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 10월 30일 (금)까지3636건
14건 · "표현력"조건 지우기 ×
001▲ 263 · 댓글 140LLM이 쓴 글, 그 어색함을 피하는 법마틴 파울러는 LLM이 작성한 글을 읽을 때 나타나는 '어색한 느낌'을 '부자연스러운 밈(LLM-Voice)'이라고 정의한다.AI · 머신러닝 · LLM Voice
Key Point글쓰기 능력이 AI의 손쉬운 도구화되면서, 저자와 독자 모두에게 미치는 영향을 생각해야 할 시점이다.
핵심 요약
- 마틴 파울러는 LLM이 작성한 글을 읽을 때 나타나는 '어색한 느낌'을 '부자연스러운 밈(LLM-Voice)'이라고 정의한다.
- 이러한 어색함을 감지하는 도구들이 있지만, 글을 읽으면서 이미 느껴지는 불쾌감은 도구로 판별할 수 없으며 본질을 놓친다고 본다.
- 저자들은 LLM으로 초안을 작성하지 말아야 하며, 인간이 편집하더라도 이 부자연스러움을 완전히 제거하기는 매우 어렵다고 강조한다.
전체 요약 8문장 읽기 →AI · 머신러닝 · How Far Can Coding Agents Go in Visual Generation?

Key Point특수화된 생성 모델 대신 일반 목적의 코드 실행으로 이미지를 만드는 방식이 시각 추론과 구조적 정확성에서 어떤 강점을 가지는지 구체적으로 밝혔다.
핵심 요약
- 이미지를 신경망이 아닌 실행 가능한 프로그램으로 생성하는 코딩 에이전트의 능력을 연구했다.
- 200개 프롬프트로 구성된 AgentDrawBench에서 제로샷 드로잉을 평가한 결과, 에이전트는 구조 보존과 정밀한 시각적 제약 만족에 뛰어났다.
- 사진적 사실성보다 구성의 정확성이 중요한 영역에서는 경쟁력 있는 결과를 보였지만, 지각적 풍부함에서는 제한이 있었다.
전체 요약 10문장 읽기 →AI · 머신러닝 · Introducing LFM3: Every Modality for Specialized Intelligence

Key Point클라우드 없이 로컬 기기에서 텍스트·비전·오디오를 모두 처리할 수 있는 2B급 모델이 나왔으며, 에이전트 작업에서 훨씬 큰 모델들과 경쟁한다는 점이 온디바이스 AI 실용화의 진전을 의미한다.
핵심 요약
- 리퀴드 AI가 2B 파라미터 규모의 멀티모달 파운데이션 모델 LFM3를 출시했다. 텍스트, 비전, 오디오, 옴니(멀티모달), 의사결정 모델을 하나의 백본에서 제공한다.
- LFM3는 새로운 하이브리드 아키텍처와 22T 토큰 사전학습으로 LFM2보다 표현력이 뛰어나면서도 효율성을 유지한다. 로컬 파인튜닝, 모든 기기에서 실행, 전문 작업 최적화가 가능하다.
- 아키텍처는 13개 계층의 게이트 단락 컨볼루션, 5개 계층의 슬라이딩-윈도우 어텐션(256 토큰 윈도우), 6개 계층의 글로벌 어텐션을 조합한다. 커널 크기를 3에서 7로 확대했다.
전체 요약 10문장 읽기 →하드웨어 · 시스템 · The new iPad mini
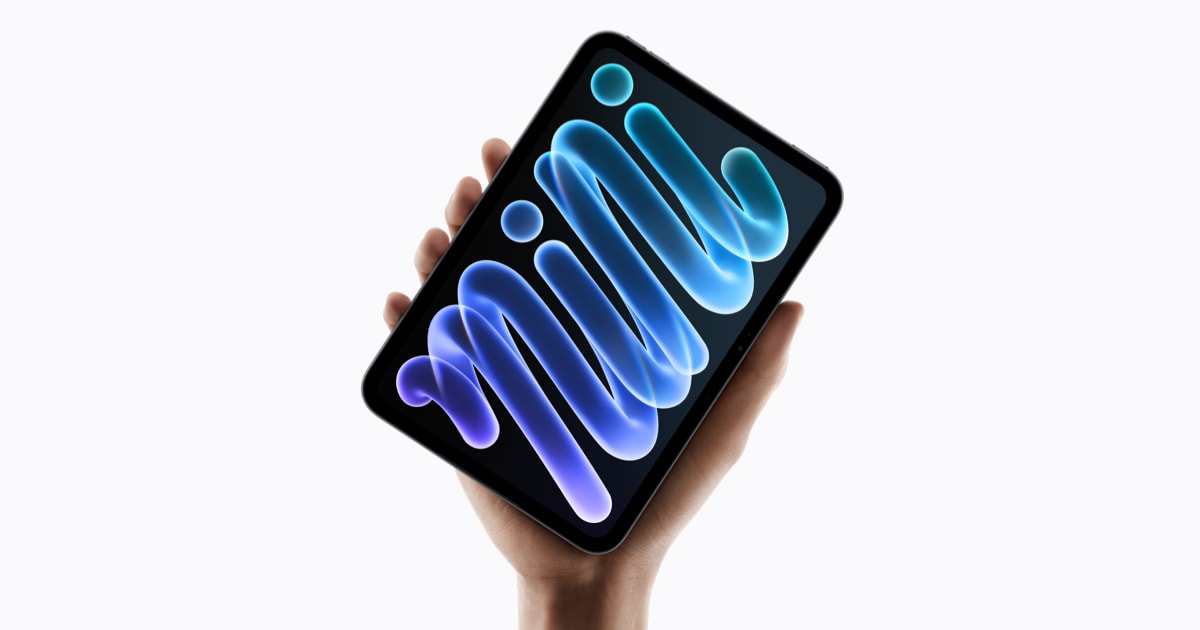
Key Point신형 아이패드 미니는 OLED 디스플레이, A20 Pro의 4.5배 AI 성능 향상, IP67 방수 인증으로 소형 태블릿 시장의 기준을 다시 설정하며, 창작자와 야외 작업자들이 갖춰야 할 기기 사양이 크게 달라진다.
핵심 요약
- 애플이 10월 26일 신형 아이패드 미니를 발표했으며, 8.5인치 OLED 디스플레이, A20 Pro 칩, IP67 방수·방진 인증이 특징이다.
- 두께 5.4mm로 이전 세대 대비 더 얇고 가벼워졌으며, 베젤이 24% 줄어든 상태에서 디스플레이 크기를 8.5인치로 확대했다.
- OLED 패널은 피크 밝기 1200nits(이전 대비 2배 이상), 2,000,000:1 명암비, 1nit 최소 밝기를 지원하며, 선택사항으로 반사 감소 나노텍스처 옵션을 제공한다.
전체 요약 14문장 읽기 →오픈소스 · 도구 · Small Programs and Languages
Key Point작은 프로그램과 언어의 구현이 단순한 취미를 넘어 프로그래밍의 본질적 복잡도를 증명하는 의미 있는 작업이며, 개발자의 이해와 통제 욕구를 충족하는 설계 원칙을 제시한다.
핵심 요약
- 작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다.
- 역사적 사례들이 작은 구현의 가능성을 보여준다. philippe Brochard의 46바이트 Forth, Arthur Whitney가 한 오후에 작성한 122줄 J 언어 인터프리터, 90KB 부팅 가능 이미지의 kOS 운영체제 등이 그 예다.
- 코드 골프와 최소화는 재미만이 아니라 의미 있는 작업이다. 콜모고로프 복잡도 관점에서, 작은 구현들은 프로그램의 최소 복잡도를 드러낸다.
전체 요약 13문장 읽기 →AI · 머신러닝 · Voxtral 3
Key Point음성 AI 에이전트는 콜센터·가상 비서·자동화 시스템에서 실제 운영되는 필수 기술인데, 이전까지는 낮은 정확도와 부자연스러운 응답이 문제였다. Voxtral 3은 저렴한 가격에 다국어·고감정 표현 능력으로 프로덕션 레벨의 음성 에이전트 구축을 현실화한다.
핵심 요약
- 미스트랄이 음성 에이전트 SDK와 음성 모델 Voxtral 3을 발표했다.
- 음성 인식, 추론, 도구 호출, 음성 생성을 하나의 실시간 스트리밍 파이프라인으로 통합한다.
- 음성-텍스트 모델 Voxtral Transcribe 3은 50개 이상 언어 지원, 화자 분석(diarization), 문맥 기반 정확도 향상(context-biasing), 발화 종료 감지 기능을 제공한다.
전체 요약 10문장 읽기 →웹 · 프론트엔드 · Types of types: Haskell's Kind system
Key PointHaskell의 Kind 시스템은 고급 타입 프로그래밍의 기초이며, Higher-Kinded Types와 Higher-Kinded Data 패턴은 설정 병합, 제너릭 코드 재사용 등 실제 문제를 우아하게 푸는 수단이 된다.
핵심 요약
- 값(value)을 타입(type)으로 분류하듯, 타입을 Kind로 분류하는 Haskell의 타입 시스템을 설명한다.
- 일반 타입은 Kind Type에 속하며, 타입 생성자(Maybe, Either 등)는 Kind Type → Type 같은 형태로 분류된다.
- Nat, Symbol, Constraint 같은 타입 레벨 구성도 각각의 Kind를 가져 타입 시스템을 더욱 표현력 있게 만든다.
전체 요약 9문장 읽기 →기타 · Rendering pretty sky in Around The World game
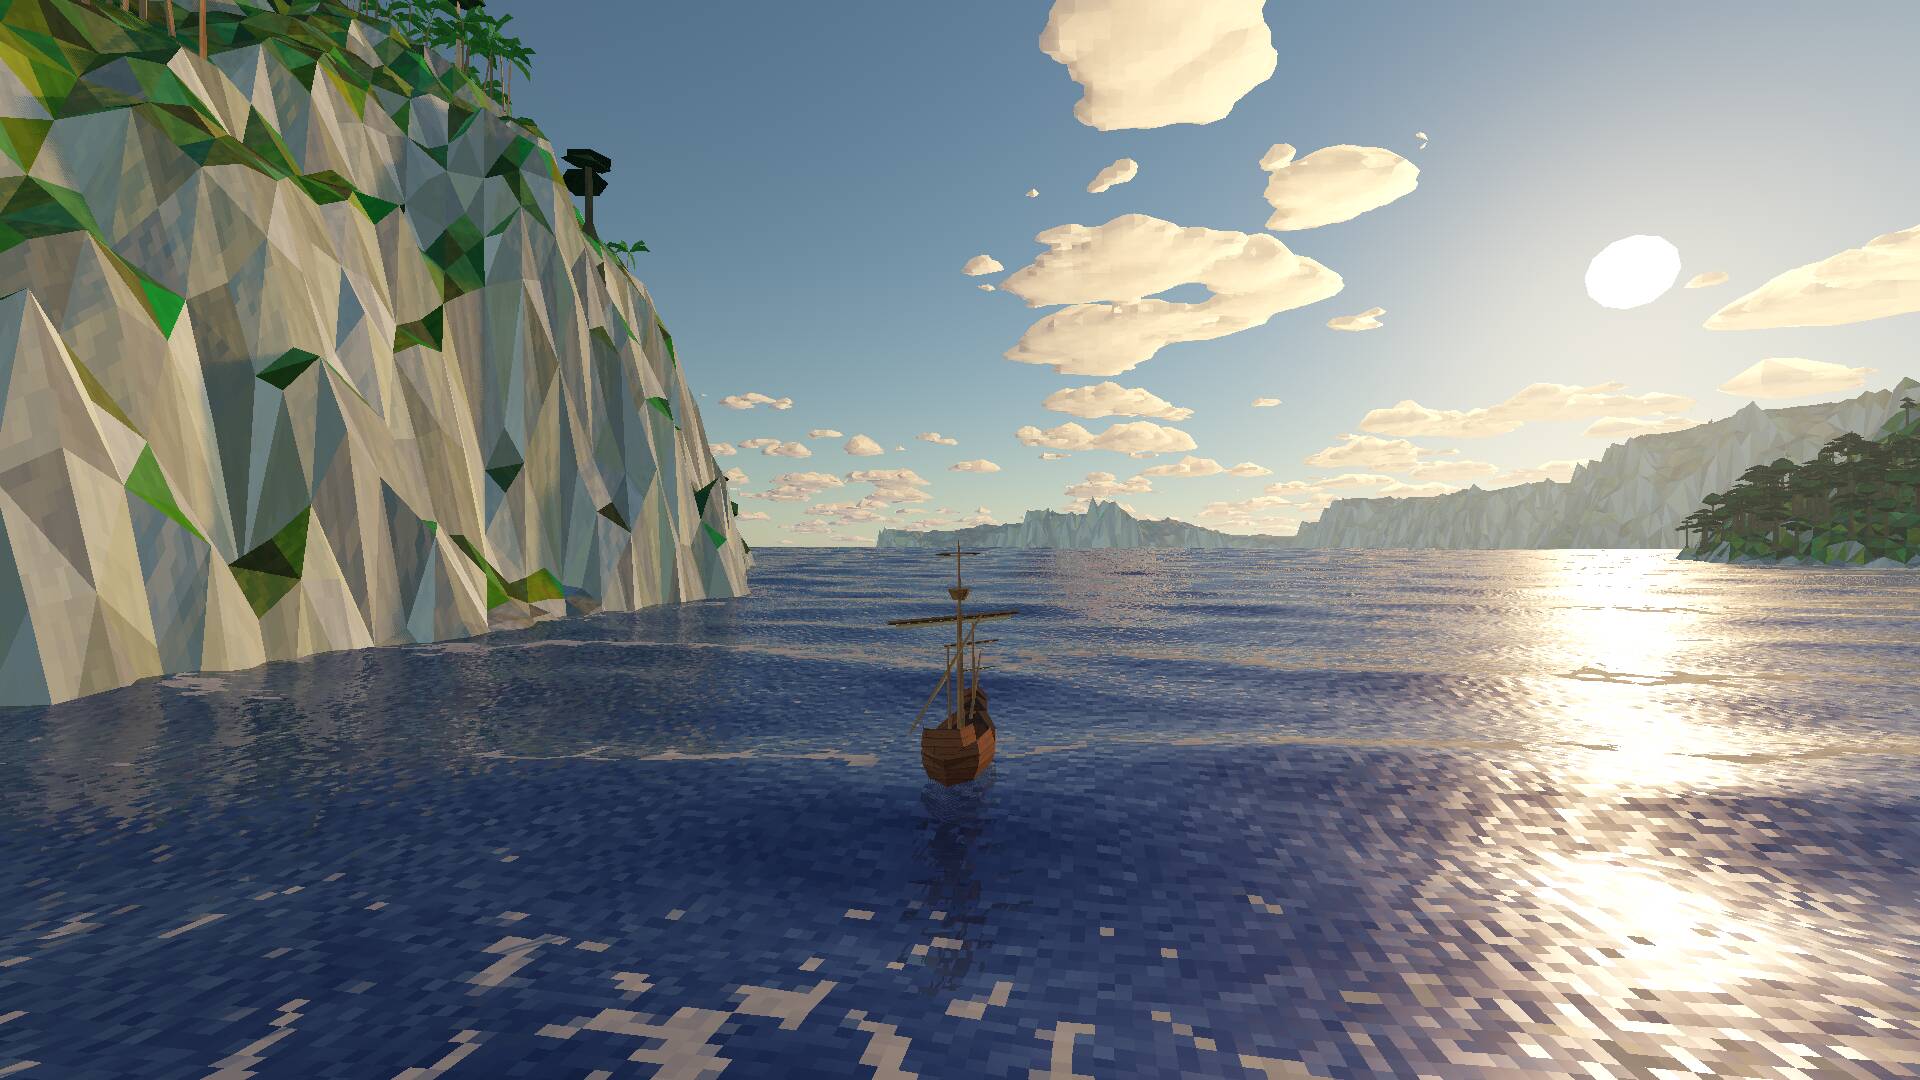
Key Point게임에서 구름과 하늘을 물리 기반으로 렌더링하는 실무 기법들과 각 문제에 대한 구체적인 해결책을 단계별로 보여주는 개발자 맞춤형 사례 연구다.
핵심 요약
- Rust로 몬테카를로 광선 추적기를 직접 구현해 POV-Ray가 다중산란을 시뮬레이션하지 않음을 확인했고, 이를 반영한 새로운 조회 테이블로 구름의 밝기와 조명이 더 균일해졌다.
- 구름이 하늘의 간접광(파란색)을 받도록 표면 법선을 아래에서 위로 향하게 조정하면, 낮에는 파란 톤이, 일몰에는 핑크 톤이 생겨 현실적인 모습이 된다.
- 대기 산란 계산 순서를 '외부산란 후 내부산란' 형태로 바꾸니 태양이 머리 위에 있을 때도 수평선 근처가 부자연스럽게 노란색으로 보이는 현상이 개선됐다.
전체 요약 6문장 읽기 →AI · 머신러닝 · Self-Conditioning Enables Deep Sequential Reasoning in Flow Matching

Key Point생성형 모델의 반복 샘플링 과정이 실제로 복잡한 추론을 수행할 수 없다는 근본적인 제약과 그를 극복하는 자기조건화 기법이 무엇인지 알아야 시각 추론 시스템을 제대로 설계할 수 있다.
핵심 요약
- 시각 추론 문제를 이미지 생성으로 푸는 연구에서 반복 샘플러인 흐름 매칭(flow matching)을 사용하면, 각 샘플링 단계가 추론 단계가 될 수 있다는 직관이 있었다.
- 그러나 이 논문은 회로 복잡성 관점에서 이 직관이 잘못되었음을 보였다: 모델 출력이 특정 정규성 조건을 만족하면, 표준 흐름 매칭 샘플러의 궤적을 상수 개의 병렬 모델 평가 라운드로 시뮬레이션할 수 있다.
- 따라서 추가 샘플링 단계는 상수 깊이 백본 모델의 표현력을 증가시키지 못하며, 이것이 핵심 병목이다.
전체 요약 7문장 읽기 →AI · 머신러닝 · Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation

Key Point이산 공간에서 고해상도 이미지 생성과 텍스트 모델링을 진정으로 통합한 첫 디퓨전 언어모델로, 단일 모델로 텍스트·이미지·비디오·3D를 모두 다룰 수 있다는 점에서 멀티모달 생성의 새로운 패러다임을 제시한다.
핵심 요약
- 기존 이미지 생성 모델은 단일 코드북 기반으로 표현력이 제한되거나, 텍스트와 이미지를 서로 다른 최적화 목표로 학습해 모달리티 간 충돌이 발생했다.
- Intern Lumina U2는 각 시각적 위치를 여러 상호보완적 코드북의 코드 그룹으로 표현하는 멀티코드북 디퓨전 언어모델로, 이산 공간에서 고용량 시각 표현과 텍스트를 통합한다.
- 입력 시 각 위치의 임베딩을 연결하고, 출력 시 경량의 멀티코드북 자동회귀 헤드가 각 위치 내 코드를 순차적으로 예측하면서 디퓨전 백본은 모든 위치를 병렬 처리한다.
전체 요약 6문장 읽기 →AI · 머신러닝 · Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning

Key Point음성 복제 음성합성의 속도와 유연성 문제를 동시에 해결하는 방식이 등장했으며, 텍스트 없는 조건화로 다국어·비음성 참조까지 지원하는 확장성이 실제 응용 시 의미가 있다.
핵심 요약
- 기존 음성 복제 TTS는 자동회귀 시맨틱 모델링으로 높은 품질과 표현력을 보였지만, 순차 디코딩으로 인한 높은 지연 시간이 문제였다.
- 논문은 Tacit-TTS라는 효율적인 음성 복제 시스템을 제안하며, IndexTTS2에서 증류(distillation)한 모델이다.
- 자동회귀 텍스트-시맨틱 디코딩을 마스크 기반 비자동회귀 생성으로 대체하고, 학습 없는 음성 길이 추정을 도입했다.
전체 요약 7문장 읽기 →AI · 머신러닝 · Video Generation Models: A Survey of Post-Training and Alignment

Key Point동영상 생성 모델이 인간 의도를 제대로 따르지 못하는 근본적인 정렬 문제를 체계화한 첫 종합 가이드로, 앞으로의 동영상 생성 기술 개발 방향을 정리해준다.
핵심 요약
- 동영상 생성 기술이 저해상도 단편에서 고해상도 장시간 시퀀스로 급속도 발전했으나, 사전학습된 모델은 인간 의도 따르기·시간적 일관성 유지·물리법칙 준수에 실패하는 경우가 많다.
- 동영상 생성의 정렬(alignment)은 이미지·텍스트 생성보다 난제가 많은데, 누적 오차·움직임-외형 결합·다목적 트레이드오프·시간적 속성의 제한된 감독이 주요 과제다.
- 이 논문은 동영상 모델의 사후학습(post-training)과 정렬을 다룬 첫 종합 리뷰로, 정렬 신호 적용 방식에 따라 암묵적 정렬과 명시적 정렬로 구분한다.
전체 요약 6문장 읽기 →AI · 머신러닝 · Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors

Key Point로봇이 손으로 물체를 조작할 때 촉각센서 데이터를 얼마나 잘 해석하느냐에 따라 정밀도가 크게 달라지는데, 기존에 없던 효율적인 사전학습 방법이 나왔다.
핵심 요약
- 로봇의 접촉 기반 섬세한 조작에 쓰이는 촉각센서는 시각에 가려진 환경에서 필수적인데, 기존에는 사전학습된 이미지 인코더와 달리 촉각 인코더는 주로 원본 신호로부터 처음 학습되어 표현력이 제한된다.
- 분산 전자피부처럼 불규칙하게 배치된 촉각센서는 시각 기반 센서와 다르게 희소하고 불규칙한 구조를 가져, 기존 시각학습 방식을 직접 적용하기 어렵다.
- Tactile-JEPA는 센서의 공간적 배치와 연결 관계를 활용해 토폴로지 인식형 표현을 학습하는 자체지도학습 사전학습 방법이다.
전체 요약 8문장 읽기 →오픈소스 · 도구 · vivizzz007/vivi-music · Kotlin

Key PointYouTube Music의 유료 기능을 무료로 사용할 수 있고, 추적 없는 완전한 프라이버시 보장이 필요한 사용자들에게 실질적인 대안이다.
핵심 요약
- Material 3 디자인을 기반으로 동적 색감 조정, 애니메이션 캔버스 시각화 등 표현력 높은 UI를 갖춘 안드로이드 음악 플레이어다.
- YouTube와 YouTube Music의 전체 카탈로그를 광고 없이 스트리밍할 수 있으며, 배경 재생과 고음질 오디오를 지원한다.
- 단어 단위 동기화 가사, 내장 EQ, 오프라인 다운로드, 자동 캐시 관리 등 고급 기능을 제공한다.
전체 요약 5문장 읽기 →