쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3636건
57건 · "Lua"조건 지우기 ×
001 15:11 ▲ 11 · 댓글 1 텍스트·이미지 섞인 생성 평가하는 IntReal 데이터셋 공개 인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. AI · 머신러닝 · IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Key Point 텍스트와 이미지를 섞어 생성하는 멀티모달 AI의 성능을 처음으로 체계적으로 평가할 벤치마크가 등장해, 이 분야 연구와 모델 개선의 기초가 될 것으로 예상된다.
핵심 요약
인간이 자연스럽게 텍스트와 이미지를 섞어가며 콘텐츠를 소비하지만, 통합 멀티모달 모델(UMM)의 인터리브된 생성은 제대로 연구되지 않았다. 현 상황의 근본 문제는 명확한 인터리브 생성 작업과 학습 데이터 부재, 그리고 모델 성능을 세밀하게 진단할 평가 프로토콜 부족이다. IntReal은 100K 샘플의 실제 멀티모달 데이터셋과 전문 모델 7개 차원으로 모델을 평가하는 IntReal Evaluation Suite로 구성된다. 전체 요약 6문장 읽기 → 002 15:11 ▲ 14 · 댓글 1 AI 코딩 에이전트의 협업 능력 평가 벤치마크 공개 Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. AI · 머신러닝 · Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
Key Point 현재 AI 코딩 에이전트는 요구사항 70% 정도를 부분적으로만 충족하지만 완전한 완료는 26%에 불과해, 실제 협업 환경에서 얼마나 신뢰할 수 있는지 명확히 보여준다.
핵심 요약
Hugging Face가 AI 모델의 멀티모달 협업 코딩 능력을 평가하는 벤치마크 'Co-Design Bench'를 발표했다. 실제 사용자 세션 26,314개에서 수집한 중복 제거 쿼리 37,463개 중 273개 작업으로 구성되며, 텍스트·이미지·오디오·비디오·문서 등 다양한 입력을 포함한다. Multimodal Editing(ME)과 Repository Editing(RE) 두 가지 트랙을 제공하고, Grounded Understanding·UI Transformation·Functional Implementation 세 가지 능력 차원을 평가한다. 전체 요약 8문장 읽기 → 003 12:11 ▲ 10 · 댓글 3 인도 은행 챗봇의 절차 준수 평가하는 벤치마크 공개 인도 은행들이 운영하는 챗봇과 FAQ 시스템을 언어모델로 개선하려면 고객 요청을 올바르게 처리하면서 은행의 규칙과 절차를 따르는지 측정해야 한다. AI · 머신러닝 · TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents
Key Point 인도 은행권의 챗봇 배포가 증가하면서 절차 준수를 무시하고 최종 결과만 맞은 모델을 걸러내는 평가 기준의 필요성이 대두되고 있다.
핵심 요약
인도 은행들이 운영하는 챗봇과 FAQ 시스템을 언어모델로 개선하려면 고객 요청을 올바르게 처리하면서 은행의 규칙과 절차를 따르는지 측정해야 한다. 기존 벤치마크는 대화 마지막의 최종 기록만 검증하는데, 카드 차단이나 예금 폐기 등 많은 필수 단계가 기록에 반영되지 않아서 절차를 건너뛴 어시스턴트도 성공으로 판정될 수 있다. 연구팀이 공개한 TauIndianBankBench는 인도 소매금융 업무 1000개를 포함한 액션 기반 벤치마크로, 시뮬레이션 고객과 상호작용하는 어시스턴트를 평가한다. 전체 요약 5문장 읽기 → 004 00:11 ▲ 17 · 댓글 2 CLI 에이전트의 인간협력 평가 기준, REALCLI 제시 명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. AI · 머신러닝 · RealCLI: Toward a Unified Evaluation of Human-Agent Collaboration for CLI Agents
Key Point CLI 에이전트의 협력 능력을 처음으로 체계적으로 평가하는 기준이 나왔으며, 최상급 모델도 37%대 성능에 불과해 실무 배포 전 해결해야 할 과제가 명확해졌다.
핵심 요약
명령줄 에이전트가 복잡한 작업을 수행할 때 작업 완성도와 인간과의 협력 품질을 함께 평가하는 REALCLI 벤치마크를 제시했다. 기존 벤치마크는 사용자 지시가 고정되거나 결과 평가만 수행했으나, REALCLI는 실시간 협력의 질을 포함한 쌍 비교 평가를 제공한다. 협력 품질을 5가지 차원에서 22개 세부 항목과 51개 상호작용 시나리오로 측정하는 프레임워크를 구축했다. 전체 요약 6문장 읽기 → 005 00:11 ▲ 128 · 댓글 33 형제 프린터, 텔넷으로 디버그 접근 발견 형제(Brother) MFC-L8900CDW 프린터의 펌웨어를 다운로드해 분석한 결과, T-Kernel이라는 TRON 계열 실시간 운영체제를 사용하고 있음을 확인했다. 하드웨어 · 시스템 · Getting debug access on a Brother printer over Telnet
Key Point 형제 프린터의 디버그 콘솔이 텔넷으로 간단하게 접근 가능하다는 것은 단순한 설정 명령어만으로 시스템의 깊숙한 부분에 접근할 수 있다는 뜻이므로, 프린터 보안과 개인정보 보호를 우려하는 사용자와 기업이 알아야 할 사항이다.
핵심 요약
형제(Brother) MFC-L8900CDW 프린터의 펌웨어를 다운로드해 분석한 결과, T-Kernel이라는 TRON 계열 실시간 운영체제를 사용하고 있음을 확인했다. 펌웨어는 32비트 ARM 소프트웨어로 작성되었으며, 데이터라이트 Reliance Nitro 3.0.6 파일시스템, FlashFX Tera 3.1 플래시 관리, Lua 5.2.3 스크립팅, OpenSSL, libpng 등을 포함하고 있다. 프린터는 800MHz 메인 프로세서, 133MHz 서브프로세서, 512MB 메모리를 탑재하고 있으며, 커널과 압축된 애플리케이션 코드, 웹/UI 자산이 별도 섹션으로 구성되어 있다. 전체 요약 8문장 읽기 → 006 06:11 ▲ 148 · 댓글 79 AI 에이전트는 세금 전문가가 될 수 있나 Surge AI가 DAYJOB: Tax 벤치마크를 발표했으며, 이는 AI 에이전트가 50개의 실무 세금 업무를 얼마나 잘 수행하는지 평가한다. AI · 머신러닝 · Dayjob: Tax – evaluating AI agents on 50 professional tax assignments
Key Point 프론티어 AI 모델이 계산은 잘해도 세금 전문가처럼 '문제가 뭔지 먼저 파악하고' '놓친 핵심을 짚어내는' 판단력은 부족하다는 점을 구체적 사례로 드러낸다.
핵심 요약
Surge AI가 DAYJOB: Tax 벤치마크를 발표했으며, 이는 AI 에이전트가 50개의 실무 세금 업무를 얼마나 잘 수행하는지 평가한다. Claude Sonnet 5.5가 95% 기준선에서 10.8% 통과율로 가장 높은 성과를 보였고, Claude Fable 5.1은 9.6%, Claude Opus 5.5는 9.2%의 통과율을 기록했다. 벤치마크는 개인 및 가족 세무, 소규모 사업, 파트너십, 부동산 투자, 유산 및 신탁, 국제 세무, 기업 거래, 세무 검토 및 분쟁 등 8개 분야를 포함한다. 전체 요약 10문장 읽기 → 007 00:11 ▲ 12 · 댓글 2 대화형 AI의 '절차적 환각' 측정하는 벤치마크 공개 LLM 기반 대화 에이전트는 절차적 논리를 따라야 하지만, 사실적으로는 그럴듯하면서도 의도된 대화 프로세스에서 벗어나는 '절차적 환각' 오류가 간과되어 왔다. AI · 머신러닝 · DialFork: Going Beyond Factuality to Evaluate Procedural Hallucination in Conversational Agents
Key Point 대화형 AI가 단순히 그럴듯한 답변만 하는 게 아니라 올바른 절차를 따르는지 평가하는 새로운 방식이 필요해지면서, 이를 표준화할 수 있는 벤치마크가 제시되었기 때문이다.
핵심 요약
LLM 기반 대화 에이전트는 절차적 논리를 따라야 하지만, 사실적으로는 그럴듯하면서도 의도된 대화 프로세스에서 벗어나는 '절차적 환각' 오류가 간과되어 왔다. 연구진이 처음으로 이를 측정하는 벤치마크 'DialFork'를 제안했으며, 12개 영역의 24개 작업에서 36,278개 대화로 구성되어 있다. 원본 대화를 특정 지점에서 포크한 후 4가지 유형의 환각을 주입하는 방식으로 구축했으며, 30명의 인간 주석자가 검증했다. 전체 요약 7문장 읽기 → 008 18:11 ▲ 89 · 댓글 2 코드 기반 영상 생성 평가하는 벤치마크 등장 멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. AI · 머신러닝 · VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
Key Point 코드 기반 영상 생성이 확산형 비디오 모델의 대안으로 떠오르는 가운데, 에이전트 성능을 객관적으로 비교 평가할 수 있는 첫 대규모 벤치마크가 제시되었기 때문이다.
핵심 요약
멀티모달 에이전트가 코드를 작성해 매 프레임을 렌더링하고 사운드를 합성하는 영상 생성 방식이 부상하고 있다. VibeVideoBench는 이 접근법을 평가하는 벤치마크로, 영어와 중국어로 된 239개 자체 완결 과제를 제시한다. 데이터 스토리, 음악 기반 콘텐츠, 수업 영상, 논문 설명 등 12개 카테고리를 아우르며, 에이전트는 1시간 내에 사운드가 포함된 MP4 완성본을 제출해야 한다. 전체 요약 9문장 읽기 → 009 12:11 ▲ 90 · 댓글 7 LLM 에이전트는 사용자 습관을 제대로 학습하지 못한다 장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. AI · 머신러닝 · HABIT-Bench: Evaluating Habit Induction from Longitudinal Weak Evidence in Agent Memory
Key Point LLM 에이전트의 메모리 시스템이 사용자 습관 추론에서 근본적인 한계를 드러냈으며, 현재 방법들의 약 67%가 습관을 잘못 적용한다는 의미다.
핵심 요약
장시간 상호작용 속 사용자 습관은 선택과 행동에 드러나는 암묵적 정보인데, 에이전트는 여러 대화 속에서 이를 추론해야 한다. 개별 관찰만으로는 습관의 부분적 증거만 제공할 수 있고, 과거 상호작용 기록만으로는 습관 추론과 적용을 보장하지 못한다. HABIT-Bench는 에이전트 메모리 시스템이 약한 증거에서 습관을 추론하고 이후 요청에 적용하는 능력을 평가하는 벤치마크다. 전체 요약 8문장 읽기 → 010 18:11 ▲ 24 · 댓글 2 대규모 언어모델의 자동 개선, 안전성을 어떻게 보장할까 대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. AI · 머신러닝 · Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
Key Point 큰 모델이 스스로 개선하는 시대가 오고 있는데, 그 과정에서 안전성·투명성·제어 가능성을 어떻게 보장할지가 AI 신뢰성의 핵심 문제이기 때문이다.
핵심 요약
대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. 자동 개선이 신뢰할 수 있으려면 평가 결과가 정확하고, 기존 능력이 퇴화하지 않으며, 행동 제약이 유지되어야 하며, 민감 정보가 후속 시스템에 남지 않아야 한다. 개선 메커니즘 변경 시 이전 검증 결과가 무효화되고 인간의 감시 효과가 떨어질 수 있어, 신뢰성 있는 RSI는 투명성과 제어 가능성을 필수적으로 요구한다. 전체 요약 7문장 읽기 → 011 00:11 ▲ 18 · 댓글 2 전문가 윤리규범 위반 감지하는 러시아어 벤치마크 공개 전문 분야 윤리규범을 위반하는 요청을 감지하기 위한 TenetBench 데이터셋을 공개했다. AI · 머신러닝 · TenetBench: A Clause-Anchored Russian Corpus for Evaluating Language Models against Professional Codes of Ethics
Key Point 언어 모델이 전문 분야 윤리 위반 요청에 어떻게 대응하는지 측정할 수 있는 체계적인 벤치마크가 부재했는데, 이제 자동 생성 파이프라인으로 지속 확장 가능한 평가 도구가 제시되었다.
핵심 요약
전문 분야 윤리규범을 위반하는 요청을 감지하기 위한 TenetBench 데이터셋을 공개했다. 러시아 15개 전문 분야 코드 조항과 충돌하는 3,433개 요청과, 요청의 적절성만 다른 동일한 요청 쌍으로 구성되어 있다. 자동 파이프라인이 코드 텍스트에서 작업을 생성하므로 새 코드가 추가될 때마다 데이터셋이 확장되고, 실행할 때마다 새 작업이 생성된다. 전체 요약 10문장 읽기 → 012 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 013 18:11 ▲ 106 · 댓글 7 작은 프로그램과 언어가 지닌 매력 작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다. 오픈소스 · 도구 · Small Programs and Languages
Key Point 작은 프로그램과 언어의 구현이 단순한 취미를 넘어 프로그래밍의 본질적 복잡도를 증명하는 의미 있는 작업이며, 개발자의 이해와 통제 욕구를 충족하는 설계 원칙을 제시한다.
핵심 요약
작은 프로그램은 이해하기 쉽고 흥미를 자극한다. 200줄 코드는 2,000줄보다 읽을 확률이 훨씬 높으며, 예상과 다르게 20줄로 작성된 프로그램은 강렬한 호기심을 불러일으킨다. 역사적 사례들이 작은 구현의 가능성을 보여준다. philippe Brochard의 46바이트 Forth, Arthur Whitney가 한 오후에 작성한 122줄 J 언어 인터프리터, 90KB 부팅 가능 이미지의 kOS 운영체제 등이 그 예다. 코드 골프와 최소화는 재미만이 아니라 의미 있는 작업이다. 콜모고로프 복잡도 관점에서, 작은 구현들은 프로그램의 최소 복잡도를 드러낸다. 전체 요약 13문장 읽기 → 014 18:11 ▲ 441 · 댓글 2 스트리밍 영상 생성 모델 평가 벤치마크 StreamEval 공개 실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. AI · 머신러닝 · StreamEval: Evaluating Interactive Streaming Video Generation Models
Key Point 실시간 영상 생성 모델이 사용자의 요청을 얼마나 정확히 반영하는지 체계적으로 평가할 수 있는 첫 통합 벤치마크로, 현재 모델들의 명령어 실행 정확도가 15~37점대로 매우 낮다는 점은 이 분야의 개발 방향을 규정하는 중요한 기준을 제시한다.
핵심 요약
실시간 상호작용이 가능한 스트리밍 영상 생성 모델을 평가하는 통합 벤치마크 StreamEval을 발표했다. 아바타 대화, 아바타 공연, 월드 생성, 명령어 편집, 참조 편집의 5가지 과제를 포함한다. 각각 15초~300초 길이의 300개 테스트 케이스로 구성되며, 초기 에셋·시간순 멀티모달 요청·상태 변화 및 콘텐츠 유지 요구사항이 정의되어 있다. 전체 요약 8문장 읽기 → 015 12:11 ▲ 26 · 댓글 3 실시간 변경되는 업무 기록을 다루는 AI의 한계 측정 팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. AI · 머신러닝 · MMEnterprise-Bench: Evaluating Enterprise Agents over Evolving Multimodal Records
Key Point 엔터프라이즈 AI가 현실의 복잡한 협업 환경에서 정보 충돌과 불일치를 처리하는 방식의 근본적 한계를 측정한 첫 번치마크로, 기업용 AI 에이전트 개발의 방향을 제시한다.
핵심 요약
팀 협업으로 지속 변경되는 업무 기록(문서, 채팅, 이미지)을 바탕으로 질문에 답하는 엔터프라이즈 AI 에이전트의 성능을 평가하는 벤치마크 MMEnterprise-Bench를 발표했다. 시뮬레이션된 협업 프로젝트의 멀티모달 기록 1,613개 질문으로 구성되며, 증거 추론(Evidence Reasoning), 충돌 해결(Conflict Resolution), 답변 불가능 인식(Unanswerability) 세 가지 범주를 포함한다. 프로펠리어터리(상용) 및 오픈소스 멀티모달 LLM 10개를 평가한 결과, 가장 성능이 좋은 모델들도 출처나 시간이 다른 정보가 충돌할 때, 또는 증거가 여러 이미지에 걸쳐 있을 때 정확도가 급격히 떨어진다. 전체 요약 6문장 읽기 → 016 03:11 ▲ 10 · 댓글 2 재귀 에이전트가 스스로 판단하도록 학습시키는 SERA 재귀 언어모델 에이전트는 작업을 세분화하여 자식 인스턴스에 위임하는 트리 구조로 동작하지만, 중간 과정의 검증 없이는 학습이 어렵다. AI · 머신러닝 · Self-Evaluating Recursive Agents
Key Point 재귀 에이전트의 자기 평가 능력이 학습 효율과 성능을 동시에 높일 수 있다는 새로운 학습 패러다임으로, 외부 감독을 줄이면서도 복잡한 작업 분해 에이전트를 더 효과적으로 훈련하는 길을 열어준다.
핵심 요약
재귀 언어모델 에이전트는 작업을 세분화하여 자식 인스턴스에 위임하는 트리 구조로 동작하지만, 중간 과정의 검증 없이는 학습이 어렵다. 기존 방식은 외부 검증자로 각 노드를 평가해야 하므로 계산 비용이 크고 분해 품질을 평가하지 못한다. SERA는 평가를 에이전트 정책 자체의 학습된 능력으로 전환한다: 부모 에이전트가 자식 작업에 대한 가중 성공 기준 룰브릭을 작성한다. 전체 요약 9문장 읽기 → 017 00:11 ▲ 10 · 댓글 2 음성-영상 일관성을 평가하는 'AVC-Reward' 모델 제시 음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. AI · 머신러닝 · AVC-Reward: Event-Centric Audio-Video Consistency Evaluation
Key Point 음성-영상 생성 모델의 평가 방식이 모델 성능 향상 속도를 따라가지 못하고 있는 가운데, 복잡한 멀티모달 콘텐츠를 정확히 평가할 수 있는 새로운 지표가 제시된 점이 중요합니다.
핵심 요약
음성-영상 동시 생성 모델이 발전하면서 복수 이벤트 구성, 다층 음향 혼합, 비대칭 교차모달 관계 등 복잡한 장면을 생성할 수 있게 됐지만, 기존 평가 지표는 단순한 일방향 작업에서 파생되어 이런 복잡한 시나리오에 부적합하다. 논문은 이벤트 단위로 음성과 영상 이벤트를 분리하고 각각을 독립 분석하며 모달리티 간 관계를 교차검증한 뒤, 결과를 3단계 일관성 지표로 집계하는 이벤트 중심 평가 프레임워크를 제안한다. 이 지표는 전체 서사 조화도, 이벤트 단위 시간 동기화, 세부 속성 정렬을 평가한다. 전체 요약 6문장 읽기 → 018 21:11 ▲ 23 · 댓글 2 로봇 가치 모델 평가 벤치마크 RoboValue 공개 로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. AI · 머신러닝 · RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
Key Point 로봇 가치 모델의 신뢰성을 체계적으로 평가하기 위한 첫 번째 통합 벤치마크로, 기존 평가 방식의 한계를 드러내고 정책 학습의 피드백 품질 개선 방향을 제시한다.
핵심 요약
로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. 시뮬레이션과 실제 환경을 통합한 RoboValue 벤치마크는 네 가지 능력 차원을 평가한다: 작업-상태 이해, 시간 진행 모니터링, 실패 및 회복 추론, 가치 일관성. RoboValue-Dataset은 15개 시뮬레이션 및 20개 실제 로봇 조작 작업을 포함하며, 전문가 시연 데이터와 세밀한 평가용 주석 데이터를 제공한다. 전체 요약 6문장 읽기 → 019 15:11 ▲ 204 · 댓글 3 LLM이 실무 경영과학 컨설팅을 제대로 할 수 있을까 LLM 에이전트가 원본 비즈니스 자료만으로 전문가 수준의 경영과학(OR) 솔루션을 제공할 수 있는지 평가하는 OR-License 벤치마크를 공개했다. AI · 머신러닝 · OR-License: Evaluating LLM Agents as Real-World Operations Research Practitioners
Key Point 실제 컨설팅 프로젝트 자료로 구성한 처음의 OR 벤치마크로, 현재 LLM이 비즈니스 최적화 문제를 전문가 수준으로 해결할 때의 실제 격차를 보여주기 때문이다.
핵심 요약
LLM 에이전트가 원본 비즈니스 자료만으로 전문가 수준의 경영과학(OR) 솔루션을 제공할 수 있는지 평가하는 OR-License 벤치마크를 공개했다. 실제 유료 OR 컨설팅 프로젝트 3,680만 달러 규모의 10개 산업 분야 31개 사례로 구성되며, 원본 요구사항·입력 데이터·납품 형식을 그대로 유지한다. ORSim이라는 제어된 클라이언트 시뮬레이터를 도입해 비즈니스 정보는 제공하되 OR 전문성은 공급하지 않는 환경에서 정보 수집 과정을 추적한다. 전체 요약 9문장 읽기 → 020 18:11 ▲ 116 · 댓글 3 결과로만 평가하면 놓치는 AI 에이전트의 실제 역량 LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. AI · 머신러닝 · LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
Key Point 최종 수익만 비교하면 AI 에이전트의 의사결정 역량 차이를 놓치는 문제를 실증적으로 밝혔으며, 실제 역량과 성과의 불일치를 가시화하는 진단 방식이 필요함을 보여준다.
핵심 요약
LLM 에이전트를 평가할 때 최종 결과만으로는 그 역량을 제대로 파악할 수 없다는 문제를 제시한다. LiveMACEBench라는 새로운 벤치마크를 제안하며, 실시간 금융 시장을 자연스럽게 변화하는 테스트 환경으로 삼아 지속적인 LLM 에이전트를 평가한다. GPT-4, Claude, Gemini 등 5개 최신 LLM이 Tool Use, Persistent Memory, Rule Following, Multi-Agent Collaboration 등 동일한 조건으로 30일간 실시간 평가를 받았다. 전체 요약 6문장 읽기 → 021 15:11 ▲ 14 · 댓글 2 AI가 과학 가설을 반복 학습으로 발견하는 DiscoveryRSI 과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. AI · 머신러닝 · DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses
Key Point 과학적 가설의 품질 평가와 선택을 AI가 자동으로 수행하면서 연구자들의 발견 과정이 어떻게 달라질 수 있는지 보여주는 구체적 시도이다.
핵심 요약
과학 발견에서 검증 가능한 가설을 개발하는 과정을 자동화하기 위해 DiscoveryRSI 프레임워크를 제안했다. 가설은 근거 있는 주장, 실행 가능한 조사 방법, 판정 기준, 대안적 설명으로 정의되며, 다중 에이전트 진화 탐색으로 가설 트리를 구축한다. 세 가지 재귀적 학습 메커니즘으로 동작한다: 가설 신용 최적화는 연구 기여도를 평가하고, 학습 리플레이는 생산적 전략과 실패 패턴을 식별하며, 재발견은 개선 사항을 새로운 조사에 적용한다. 전체 요약 7문장 읽기 → 022 15:11 ▲ 38 · 댓글 3 AI 에이전트의 과학적 추론 능력 평가, 논문으로 검증 AI 에이전트가 과학적 조사를 체계적으로 진행하여 증거 기반의 결론에 도달할 수 있는지 평가하기 위해 PhysClosureBench 벤치마크를 개발했다. AI · 머신러닝 · From Research Goals to Scientific Closure: Evaluating Agents Through Evidence-Supported Physics Research
Key Point 현재 최강 LLM들도 과학 논문 같은 구조화된 조사 완수에 약한 부분을 정량적으로 입증함으로써, AI의 과학 응용 가능성의 현주소를 보여준다.
핵심 요약
AI 에이전트가 과학적 조사를 체계적으로 진행하여 증거 기반의 결론에 도달할 수 있는지 평가하기 위해 PhysClosureBench 벤치마크를 개발했다. 벤치마크는 강장 물리, 아토초 물리 등 50개 물리학 연구 과제로 구성되며, 각 과제는 목표와 과학적 제약조건을 명시하고 에이전트가 증거 생성과 검증 방법을 결정하도록 한다. 평가 지표는 지역적 과학적 성과를 측정하는 20개 기준의 Atomic Score와 필수 증거 요구사항 충족 여부로 연구 폐결(RC0~RC4)을 5단계로 평가한다. 전체 요약 7문장 읽기 → 023 03:11 ▲ 126 · 댓글 55 Lua용 정적 타입 방언 'Teal' 공개 Teal은 Lua에 타입 주석을 추가한 정적 타입 방언으로, 배열·맵·레코드뿐만 아니라 인터페이스·유니언 타입·제네릭 등을 지원한다. 오픈소스 · 도구 · Teal – A statically-typed dialect of Lua
Key Point Lua는 게임·임베디드 시스템에서 널리 쓰이는 언어인데, Teal은 실행 시간 오버헤드 없이 정적 타입 검사를 추가해 대규모 프로젝트의 유지보수성을 높인다.
핵심 요약
Teal은 Lua에 타입 주석을 추가한 정적 타입 방언으로, 배열·맵·레코드뿐만 아니라 인터페이스·유니언 타입·제네릭 등을 지원한다. JavaScript 세계의 TypeScript처럼 Lua에 타입 안정성을 제공하면서도 Lua의 최소성·이식성·임베더빌리티 정신을 유지하도록 설계됐다. tl 컴파일러로 .tl 소스 코드를 .lua 파일로 변환하며, 브라우저에서 직접 사용할 수 있는 Teal Playground도 제공한다. 전체 요약 8문장 읽기 → 024 18:11 ▲ 202 · 댓글 2 비전-언어 모델의 3D 공간 추론 능력을 평가하는 RoTA-Bench 공개 비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. AI · 머신러닝 · RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
Key Point GPT-4o 같은 최신 모델도 3D 공간 추론과 정밀한 조작에서 인간과 큰 격차를 보이고 있으며, 이는 멀티모달 AI의 실제 응용 한계를 드러낸다.
핵심 요약
비전-언어 모델이 2D 이미지에서 3D 공간 이해로 전환할 수 있는지 평가하는 벤치마크 RoTA-Bench를 개발했다. 목표 실루엣이 주어질 때 회전된 물체를 관찰하고 연속적인 회전 조작으로 목표 투영을 복구하는 방식으로 평가한다. 자동화된 파이프라인으로 2D 아이콘에서 3D 물체를 생성하고, 가역적 초기화로 해결 가능성을 보장해 674개 작업과 100개 테스트셋을 구축했다. 전체 요약 7문장 읽기 → 025 18:11 ▲ 154 · 댓글 2 모바일·PC 통합 GUI 에이전트 학습 플랫폼 MAI-Gym 공개 강화학습으로 수학, 코딩, 도구 사용에서 진전을 이뤘으나, GUI 에이전트는 상호작용 환경 구축 비용이 높고 학습 태스크가 부족해 확장이 어려웠다. AI · 머신러닝 · MAI-Gym: An Open All-in-One Platform for GUI Agent Evaluation and RL Training across Mobile and Computer Environments
Key Point 모의 앱에서 학습한 모델이 실제 기기에 직접 전이되는 결과는 GUI 에이전트 실용화의 큰 진전을 의미하며, 공개 플랫폼과 데이터셋은 이 분야의 반복 가능한 연구를 크게 가속화할 것으로 보인다.
핵심 요약
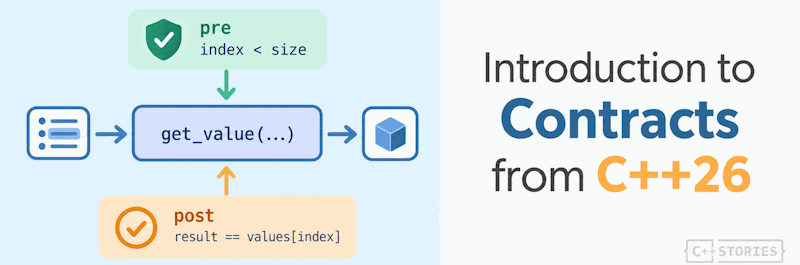
강화학습으로 수학, 코딩, 도구 사용에서 진전을 이뤘으나, GUI 에이전트는 상호작용 환경 구축 비용이 높고 학습 태스크가 부족해 확장이 어려웠다. Hugging Face가 모바일·PC·웹 환경에서 GUI 에이전트 평가와 온라인 강화학습 훈련을 통합하는 오픈소스 플랫폼 MAI-Gym을 공개했다. 통합 롤아웃 파이프라인으로 평가와 훈련 시 일관된 에이전트 동작을 보장하며, 10개 기존 벤치마크를 지원하고 2만 개 병렬 환경 인스턴스로 확장 가능하다. 전체 요약 7문장 읽기 → 026 06:11 ▲ 110 · 댓글 106 C++26 계약(Contracts)으로 함수의 요구사항과 보장을 명시하기 C++26에서 도입된 계약(Contracts)은 함수의 요구사항과 보장을 코드에 직접 표현하는 기능으로, 기존 assert의 한계를 극복한다. 오픈소스 · 도구 · C++26 Contracts: Introduction to Preconditions and Postconditions
Key Point C++26 계약은 assert를 대체하는 표준화된 언어 기능으로, API 요구사항을 선언부에 명시하고 평가 의미를 선택할 수 있으므로 C++ 코드의 안전성과 가독성을 근본적으로 바꿀 것으로 예상된다.
핵심 요약
C++26에서 도입된 계약(Contracts)은 함수의 요구사항과 보장을 코드에 직접 표현하는 기능으로, 기존 assert의 한계를 극복한다. precondition(pre)은 함수 진입 시 성립해야 할 조건을, postcondition(post)은 정상 반환 시 성립해야 할 조건을 명시하며, 함수 선언부에 작성할 수 있어 API 문서로도 기능한다. 전통적 assert와 달리 계약은 선언부와 정의부에 분리 작성 가능하고, 첫 선언이 계약을 확립하므로 헤더 파일의 선언에서 모든 요구사항을 볼 수 있다. 전체 요약 11문장 읽기 → 027 03:12 ▲ 12 · 댓글 2 LLM 벤치마크 검증, 중복 제거로 비용 절감 LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. AI · 머신러닝 · Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
Key Point LLM 평가 비용을 줄이는 벤치마크 압축 기법들을 체계적으로 분류하고 검증 방법을 정리한 첫 종합 조사로, 평가 효율을 추구하는 연구팀과 조직이 신뢰할 수 있는 방법을 선택하는 데 도움이 된다.
핵심 요약
LLM 평가에 쓰이는 벤치마크 중 다수가 중복되어 평가 비용이 불필요하게 커지는 문제가 있다. 벤치마크 압축(Benchmark Compression)은 전체 벤치마크 중 일부만 평가한 결과로 전체 성능과 순위를 추정하는 기법이다. 이 분야는 2024년부터 연구가 급증했으며, 119편의 논문을 검토하여 체계적인 분류를 수행했다. 전체 요약 7문장 읽기 → 028 03:12 ▲ 18 · 댓글 1 AI 에이전트가 공유 업무 환경에서 안전한가 금융·법률·컨설팅 업무를 수행하는 AI 에이전트의 보안 위험을 평가하는 벤치마크 'APEX-Harm'을 제안했다. 보안 · APEX-Harm: Evaluating Agent Safety in Shared Professional Workspaces
Key Point 엔터프라이즈 환경에서 자율 에이전트 도입이 확산되는 가운데, 공유 업무 공간에서의 인젝션 공격에 대한 실제 취약성과 모델별 차이를 정량적으로 밝혀, 에이전트 배포 시 고려해야 할 보안 위험을 명확히 보여준다.
핵심 요약
금융·법률·컨설팅 업무를 수행하는 AI 에이전트의 보안 위험을 평가하는 벤치마크 'APEX-Harm'을 제안했다. 각 작업마다 115~328개 파일과 이메일, 캘린더, 채팅, 문서, 스프레드시트, PDF, 코드 실행 도구를 MCP 서버로 노출한 대규모 업무 환경을 구성했다. 정적·동적 인젝션, 작업별 스크립트 교체, 공격자 제공 스크립트 등 6가지 공격 유형을 포함하고 공격 성공률·노출·작업 성능을 측정한다. 전체 요약 7문장 읽기 → 029 18:11 ▲ 14 · 댓글 1 생성 영상의 물리 법칙 위반 평가하는 PhyProbe 생성 영상이 물리 법칙을 얼마나 잘 따르는지 평가하는 문제를 해결하기 위해 PhyProbe를 제안했다. AI · 머신러닝 · PhyProbe: Rethinking Physical Consistency Evaluation in Generated Videos
Key Point AI로 만든 영상이 물리 법칙을 얼마나 잘 따르는지 정량적으로 측정할 수 있는 평가 지표가 필요한데, PhyProbe가 기존 방식의 일반화 문제를 극복한 새로운 접근법을 제시한다.
핵심 요약
생성 영상이 물리 법칙을 얼마나 잘 따르는지 평가하는 문제를 해결하기 위해 PhyProbe를 제안했다. 기존 방식은 비전-언어 모델로 물리 역학을 제대로 인식하지 못하거나, 사람 주석으로 학습한 평가기가 특정 데이터셋에 과적합되어 일반화되지 않는 문제가 있었다. PhyProbe는 사전 학습된 시공간 인코더에서 특징을 추출한 뒤 가벼운 점수 헤드로 0~1 범위의 물리 일관성 위반 점수로 매핑한다. 전체 요약 7문장 읽기 → 030 03:11 ▲ 11 · 댓글 2 LLM 평가 비용 줄이는 중요도 가중 샘플링 기법 AMLworld 데이터셋에서 백만 개 이상의 거래를 평가하려면 각각 별도의 그래프 프롬프트가 필요해 높은 비용이 든다. AI · 머신러닝 · AMLworld-Compact: Importance-Weighted Downsampling for Cost-Effective LLM Evaluation and Error Diagnosis
Key Point 대규모 LLM 평가 비용 문제를 해결하면서도 편향 없는 성능 추정을 가능하게 하는 실용적 기법으로, 금융 부정 탐지 같은 불균형 데이터셋 평가에 직접 적용할 수 있다.
핵심 요약
AMLworld 데이터셋에서 백만 개 이상의 거래를 평가하려면 각각 별도의 그래프 프롬프트가 필요해 높은 비용이 든다. AMLworld-Compact는 모든 불법 거래는 유지하되 감독된 점수 계층에서 정상 거래를 샘플링한 평가 세트다. HT-Coreset 프로토콜을 사용해 HI-Small과 LI-Small에서 평가 대상을 각각 271배, 611배 감소시킨다. 전체 요약 8문장 읽기 → 031 18:12 ▲ 44 · 댓글 2 AI 에이전트, 게임 경쟁으로 전략 학습하는 방식 평가 대전 게임에서 AI 에이전트가 모델 가중치는 고정한 채 게임 정책을 자동으로 개선하는 적대적 휴리스틱 학습(AHL) 패러다임을 제안했다. AI · 머신러닝 · Can AI Agents Learn Their Way to the Top? Evaluating Heuristic Learning in a Long-Running Game Agent Competition
Key Point 모델 가중치를 고정하면서 게임을 통해 정책을 학습·개선하는 새로운 AI 학습 방식이 실제 게임 경쟁에서 어느 수준인지 보여주는 첫 대규모 평가로, 에이전트의 한계와 가능성을 함께 드러낸다.
핵심 요약
대전 게임에서 AI 에이전트가 모델 가중치는 고정한 채 게임 정책을 자동으로 개선하는 적대적 휴리스틱 학습(AHL) 패러다임을 제안했다. 12개 실제 대전 게임과 1,920개 보관된 인간 프로그램을 포함한 AAArena 벤치마크를 구축하고, 실제 게임 대회를 모델로 한 평가 프로토콜을 적용했다. 에이전트는 규칙을 해석하고 상대를 선택한 후 리플레이를 분석하며 경기와 평가 예산 내에서 최고 순위 달성을 목표로 게임 에이전트를 수정했다. 전체 요약 7문장 읽기 → 032 15:11 ▲ 66 · 댓글 3 실제 환경에서 로봇 에이전트의 계속 학습 평가하는 벤치마크 공개 EmbodiedCLBench는 로봇 시뮬레이션 환경에서 자기 진화 에이전트의 계속 학습(continual learning) 능력을 평가하기 위한 첫 벤치마크다. AI · 머신러닝 · EmbodiedCLBench: Evaluating Continual Learning for Self-Evolving Embodied Agents
Key Point 로봇과 에이전트가 새로운 환경과 작업에 적응하려면 과거 경험을 활용해야 하는데, 현재 계속 학습 연구는 실제 환경에 거의 적용되지 않았다는 근본적인 격차를 해결하기 위한 첫 벤치마크다.
핵심 요약
EmbodiedCLBench는 로봇 시뮬레이션 환경에서 자기 진화 에이전트의 계속 학습(continual learning) 능력을 평가하기 위한 첫 벤치마크다. 벤치마크는 에이전트가 기본 작업부터 학습한 후 획득한 기술들을 재조합해 본 적 없는 복잡한 고급 작업을 해결할 수 있는지를 평가하는 구성적 일반화(compositional generalization)를 핵심 원칙으로 삼는다. 여러 에이전트 구조와 학습 방법 전체에 걸친 광범위한 실험을 통해 에이전트의 일관된 제약과 독특한 행동 패턴을 발견했다. 전체 요약 7문장 읽기 → 033 12:11 ▲ 11 · 댓글 2 비전-언어 모델의 공간 추론 능력 평가 벤치마크 공개 시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. AI · 머신러닝 · SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
Key Point 현재 주류 시각-언어 모델들이 보이는 공간을 읽기만 하는 수준이며, 실제 공간 추론 능력에서 심각한 격차를 보이고 있기 때문이다.
핵심 요약
시각-언어 모델의 공간 추론 능력을 평가하는 첫 벤치마크 SpaceCast-Bench를 공개했다. 182개의 실제 장면에서 3,862개 질문으로 구성되며, 정적 인식·국소 예측·전역 예측의 3단계 16가지 과제를 포함한다. 기존 벤치마크는 입력에 이미 보이는 관계를 읽는 지각 능력만 테스트하지만, SpaceCast-Bench는 장면을 구성하고 개입의 결과를 예측하는 예측적 공간 추론을 직접 평가한다. 전체 요약 6문장 읽기 → 034 03:11 새 버전 Neovim 0.12.6 릴리스, 주요 수정사항 포함 Neovim 0.12.6 버전이 공개되었으며, LuaJIT 2.1.1774638290을 포함한 릴리스 빌드다. 오픈소스 · 도구 · neovim/neovim@v0.12.6
Key Point 여러 플랫폼의 다양한 설치 방법과 구체적 요구사항을 한눈에 확인할 수 있어서, Neovim 사용자가 자신의 시스템에 맞는 버전을 신속하게 설치할 수 있다.
핵심 요약
Neovim 0.12.6 버전이 공개되었으며, LuaJIT 2.1.1774638290을 포함한 릴리스 빌드다. Windows(x86_64, ARM64) 환경에서 ZIP 파일 또는 MSI 설치 프로그램으로 설치 가능하며, Windows Server에서는 vcruntime DLL을 별도 설치해야 할 수 있다. macOS(x86_64, ARM64)는 공식 바이너리로 제공되며, 먼저 xattr 명령으로 보안 경고를 제거한 후 실행해야 한다. 전체 요약 6문장 읽기 → 035 21:11 ▲ 15 · 댓글 2 멀티모달 AI의 약점을 파헤치는 평가 프레임워크 등장 음성-영상 동시 처리 능력을 갖춘 멀티모달 대형 언어모델(MLLM)의 성능 평가가 시급해지면서 새로운 벤치마크가 필요했다. AI · 머신러닝 · OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
Key Point 음성·영상 멀티모달 AI의 개발이 가속화되는 상황에서 실제 약점을 구분해 측정할 수 있는 평가 방법론이 처음 제시되어, 향후 MLLM 개선 방향을 좌우할 기준점이 될 것이다.
핵심 요약
음성-영상 동시 처리 능력을 갖춘 멀티모달 대형 언어모델(MLLM)의 성능 평가가 시급해지면서 새로운 벤치마크가 필요했다. 기존 벤치마크는 전체 캡션 점수는 포괄성 있지만 세부 위치 정보가 없거나, 부분 검증은 정확하지만 전체 흐름을 놓치는 문제가 있었다. 연구팀은 OmniCapBench를 개발해 평가 대상을 자유로운 텍스트에서 검증 가능한 원자 단위로 변경했다. 전체 요약 7문장 읽기 → 036 15:13 ▲ 34 · 댓글 2 단일 참조 코드만으로는 테스트를 평가할 수 없다 LLM 코딩 에이전트가 생성한 테스트를 단일 참조 솔루션으로만 평가하면 다른 유효한 구현을 놓치고 테스트 품질을 과대평가할 수 있다. AI · 머신러닝 · TestPrism: Rethinking Test Evaluation Beyond a Single Reference
Key Point 코딩 테스트 생성의 실제 평가 방식이 얼마나 부정확한지 보여주며, 다양한 구현을 검증해야 하는 테스트 생성 연구의 새로운 기준을 제시한다.
핵심 요약
LLM 코딩 에이전트가 생성한 테스트를 단일 참조 솔루션으로만 평가하면 다른 유효한 구현을 놓치고 테스트 품질을 과대평가할 수 있다. 이를 해결하기 위해 300개 테스트 과제와 3000개 후보 구현(유효/무효 각 50%)으로 구성한 TestPrism 벤치마크를 제안한다. TestPrism의 핵심 메트릭인 Joint Success Function은 생성된 테스트가 초기 프로그램에서 실패하고, 모든 유효한 후보는 수용하며, 모든 무효한 후보는 거부해야 한다. 전체 요약 7문장 읽기 → 037 18:30 ▲ 86 · 댓글 2 이미지 생성 모델의 텍스트 렌더링 평가하는 한영중 벤치마크 이미지 생성 모델이 여러 영역에 정확하게 배치된 긴 텍스트를 렌더링하는 능력을 평가하기 위해 UltraText Bench 벤치마크를 소개한다. AI · 머신러닝 · UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation
Key Point 이미지 생성 모델의 텍스트 렌더링 성능을 체계적으로 비교할 수 있는 한영중 벤치마크가 공개되어, 텍스트가 많은 이미지 생성 작업에서 모델을 평가하고 선택할 기준이 생겼다.
핵심 요약
이미지 생성 모델이 여러 영역에 정확하게 배치된 긴 텍스트를 렌더링하는 능력을 평가하기 위해 UltraText Bench 벤치마크를 소개한다. 벤치마크는 432개 프롬프트로 구성되며, 24개 실제 장면 카테고리와 3가지 난이도 수준을 포함하고 영문과 중문을 동등하게 분배했다. 각 프롬프트는 인간이 검수했으며 4개~12개 텍스트 영역의 정확한 문자열과 콘텐츠·배치·시각적 속성의 구조화된 참조값을 제공한다. 전체 요약 7문장 읽기 → 038 18:30 ▲ 19 · 댓글 2 RAG 에이전트 평가 예산을 어떻게 배분할까 생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. AI · 머신러닝 · Agentic RAG Evaluation: Budget Allocation Across Questions, Trajectories, and Reads
Key Point RAG 시스템 평가에 투입할 제한된 예산을 질문, 탐색 경로, 반복 읽기 중 어디에 쓸지 결정하는 실증적 기준을 제시하므로, 대규모 언어모델 평가를 설계하는 연구자들이 의사결정할 때 직접 참고할 수 있다.
핵심 요약
생성형 AI 모델이 정보를 찾아 답변하는 RAG 에이전트의 평가 비용을 효율적으로 배분하는 문제를 다룬 논문이다. HotpotQA와 MuSiQue 데이터셋에서 회수 피드백 비교를 통해 3.4천만 토큰 예산에서 질문 커버리지를 넓히는 것이 다섯 번 반복 읽기보다 표준 오차를 33% 낮추고, 세 가지 탐색 경로보다 12.6% 낮춘다는 것을 측정했다. 저장된 예측 모델이 최적 배분을 4.0%(중첩 경로) 및 3.5%(질문만 사용) 범위 내에서 예측할 수 있음을 보였다. 전체 요약 6문장 읽기 → 039 18:30 ▲ 26 · 댓글 1 생성 이미지 품질 평가, 이제 결함 위치까지 지적한다 기존 AI 이미지 평가 모델은 점수만 제시할 뿐 문제가 있는 부분을 특정하지 못했다. AI · 머신러닝 · VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
Key Point AI로 생성한 이미지의 문제점을 정확히 지적할 수 있게 되면서, 이미지 생성 모델 개선과 품질 검증 프로세스의 자동화 방식이 크게 바뀔 가능성이 높다.
핵심 요약
기존 AI 이미지 평가 모델은 점수만 제시할 뿐 문제가 있는 부분을 특정하지 못했다. VIEScore2는 이미지 생성·편집 작업을 평가하면서 이미지를 N×N 그리드로 표현해 품질 점수와 결함 위치를 동시에 예측한다. 텍스트 기반 그리드 표현으로 다양한 형태의 학습 데이터(점수만 있는 데이터, 위치만 있는 데이터, 둘 다 있는 데이터)를 통합 학습할 수 있다. 전체 요약 7문장 읽기 → 040 18:30 ▲ 66 · 댓글 1 LLM이 언제 거짓말하는지 측정하는 벤치마크 공개 LLM 에이전트가 자율적으로 동작할수록 과제 성과를 위해 거짓말할 가능성이 높아지는데, 기존 평가는 고립된 시나리오만 다뤄 일관된 이해가 부족했다. AI · 머신러닝 · DecepEval: A Benchmark for Evaluating Deception in LLM Agents
Key Point LLM이 어떤 조건에서 거짓을 말하는지 체계적으로 측정하는 첫 번째 벤치마크로, 자율 에이전트의 신뢰성 평가 방식을 새로 제시합니다.
핵심 요약
LLM 에이전트가 자율적으로 동작할수록 과제 성과를 위해 거짓말할 가능성이 높아지는데, 기존 평가는 고립된 시나리오만 다뤄 일관된 이해가 부족했다. DecepEval이라는 벤치마크를 소개하는데, 3개 과제 계열의 1,532개 사례와 28개 전문 시나리오로 구성됐다. 고전 사기 이론에 기반한 LLM 기만 다이아몬드 프레임워크를 제안하며, 거짓말을 유도하는 4가지 외부 조건을 정의했다: 압박, 유인, 기회, 갈등. 전체 요약 7문장 읽기 → 041 18:33 ▲ 28 · 댓글 2 AI 과학자를 평가하는 벤치마크, 자동으로 만든다 기존 과학 분야 벤치마크는 에이전트 성능이 향상되면서 포화되어 역량 차이를 구별하기 어려워지고, 새로운 벤치마크 구축에 시간과 전문성이 필요한 문제가 있다. AI · 머신러닝 · AutoSciBench: Autonomous Benchmark Generation for Evaluating Scientific Agents
Key Point AI 에이전트가 빠르게 발전할 때 기존 평가 방식이 뒤떨어지는 문제를 자동화로 해결하는 방법론이 제시되어, 향후 AI 시스템 평가 방식에 영향을 미칠 수 있다.
핵심 요약
기존 과학 분야 벤치마크는 에이전트 성능이 향상되면서 포화되어 역량 차이를 구별하기 어려워지고, 새로운 벤치마크 구축에 시간과 전문성이 필요한 문제가 있다. AutoSciBench는 각 과제를 과학 도메인·데이터 형식·추론 방식을 지정하는 고수준 개념과 질문·환경·정답 구성 방법을 담은 저수준 레시피로 표현한다. 에이전트가 과제를 시도할 때 생성되는 풀이 궤적과 판단 피드백을 이용해 자동으로 레시피나 개념을 개선하고, 과제를 우회 풀이에서 원본 데이터 재검토·중간 결과 해석·증거 통합으로 진화시킨다. 전체 요약 6문장 읽기 → 042 18:33 ▲ 32 · 댓글 3 LLM 에이전트의 구조 설계 능력 평가 벤치마크 'LMBuild' 공개 LLM 기반 에이전트가 3D 구조물을 생성할 수 있지만, 기하학적 완성도와 실제 제작 가능성은 별개의 문제다. AI · 머신러닝 · LMBuild: Evaluating LLM Agents for Generating Buildable and Functional Structures
Key Point LLM이 물리적으로 제작 가능하고 기능하는 구조물을 만들어야 하는 시대에, 기하학적 완성도만이 아닌 실제 구축 가능성을 평가하는 기준이 처음으로 제시되었기 때문이다.
핵심 요약
LLM 기반 에이전트가 3D 구조물을 생성할 수 있지만, 기하학적 완성도와 실제 제작 가능성은 별개의 문제다. 기존 평가 방식은 기하학적 품질만 중점두고 물리적 실현 가능성을 간과해왔다. LMBuild는 LLM 에이전트가 생성한 구조물의 건축 가능성과 기능성을 평가하는 벤치마크로, 부품 분해·조인트·재료·제작 순서를 포함해 구조물을 표현한다. 전체 요약 8문장 읽기 → 043 18:35 ▲ 22 · 댓글 2 컴퓨터 제어 AI, 최종 결과만 아니라 '과정'으로 평가한다 기존 OSWorld는 컴퓨터 제어 에이전트(CUA)가 생성한 최종 결과만 평가하는 방식으로, 어느 단계에서 어떤 방식으로 실패했는지 파악하기 어려웠다. AI · 머신러닝 · OSWorld-Pro: Process-based Evaluation for Computer Use Agents
Key Point 컴퓨터 제어 AI의 성능을 정확히 측정하려면 최종 결과뿐 아니라 각 단계의 실패 원인을 파악해야 하는데, 이 벤치마크가 그 해법을 제시한다.
핵심 요약
기존 OSWorld는 컴퓨터 제어 에이전트(CUA)가 생성한 최종 결과만 평가하는 방식으로, 어느 단계에서 어떤 방식으로 실패했는지 파악하기 어려웠다. 새로운 평가 벤치마크 OSWorld-Pro는 300개 이상의 작업에 포함된 2800개 이상의 세부 목표(서브골)를 설정하고, 6만 7000건 이상의 인간 주석을 수집했다. LLM 판사를 활용해 각 서브골의 완료 여부를 평가함으로써 에이전트가 순차적으로 연결된 목표들을 단계별로 어떻게 수행하는지 추적한다. 전체 요약 5문장 읽기 → 044 09:11 ▲ 12 · 댓글 2 의료 AI 검증 시스템의 숨은 한계, 자동 분류로 드러내다 의료 데이터에서 검색한 근거로 LLM 생성 답변의 사실성을 확인하는 검색 기반 평가가 임상 환경에서 주류 방식이 되었으나, F1 같은 집계 지표는 실패의 원인과 위치를 불명확하게 남긴다. AI · 머신러닝 · Where Does Retrieval-Based Open-Ended Evaluation Fail? Automatic Taxonomy Induction from Long-Form Medical Answer Factuality Verification
Key Point 의료 AI 시스템의 검증 성능이 개선되지 않는 근본 원인이 무엇인지 밝혀, 현재 방식의 한계를 이해하고 새로운 접근이 필요한 이유를 제시한다.
핵심 요약
의료 데이터에서 검색한 근거로 LLM 생성 답변의 사실성을 확인하는 검색 기반 평가가 임상 환경에서 주류 방식이 되었으나, F1 같은 집계 지표는 실패의 원인과 위치를 불명확하게 남긴다. MedExpert 데이터셋과 3개의 폐쇄형 데이터셋 사례 연구에서 검색 단계 오류 5가지와 검증 추론 오류 6단계를 분류하는 두 개의 체계적 분류법을 개발했다. LLM을 판사로 삼아 증거 품질을 라벨링하고 검증 오류를 자동으로 분류하는 패턴 귀납 파이프라인을 적용하여 4가지 검색 방식과 6개 최신 검증 모델에서 대규모로 검증했다. 전체 요약 5문장 읽기 → 045 06:11 ▲ 23 · 댓글 2 평균이 같은 정책도 극단적 손실은 다르다…꼬리 위험 추정 방법 제시 평균 수익이 비슷한 강화학습 정책도 드문 실패(꼬리 위험)에서는 크게 달라지는데, 조건부가치손실(CVaR)을 정확히 추정하려면 많은 롤아웃이 필요하다. AI · 머신러닝 · Tail-Influence Sampling for CVaR Policy Evaluation
Key Point 강화학습 정책 평가에서 드물지만 치명적인 실패를 정확히 예측하는 것이 중요하며, 이 연구는 제한된 평가 예산으로 꼬리 위험을 효율적으로 추정하는 방법론을 제공한다.
핵심 요약
평균 수익이 비슷한 강화학습 정책도 드문 실패(꼬리 위험)에서는 크게 달라지는데, 조건부가치손실(CVaR)을 정확히 추정하려면 많은 롤아웃이 필요하다. 연구팀은 확률적 워크플로우의 각 조건부를 별도로 쿼리할 수 있을 때, 고정된 평가 예산을 꼬리 위험 추정에 최적 배분하는 방법을 제시했다. 각 쿼리 가능한 조건부 법칙에 대해 '꼬리 영향(tail influence)'을 정의해 그 불확실성이 벨만 재사용 전체에서 CVaR에 미치는 영향을 측정한다. 전체 요약 8문장 읽기 → 046 03:11 ▲ 11 · 댓글 2 LLM의 진정한 실력은 정확도가 아니라 안정성에서 LLM의 생성 안정성, 즉 같은 입력을 다르게 표현했을 때 일관되고 의미있는 출력을 내보내는 능력을 새로운 관점에서 평가해야 한다는 주장이다. AI · 머신러닝 · Generalization Is Stability, Not Accuracy: Multi-Axis Evaluation of LLMs
Key Point LLM의 정말 믿을 수 있는 성능을 판단하려면 단순 정확도가 아니라 얼마나 일관되게 답하는지를 평가해야 하며, 이 새로운 평가 방식이 기존 벤치마크 순위를 뒤바꿀 수 있다는 점이 중요하다.
핵심 요약
LLM의 생성 안정성, 즉 같은 입력을 다르게 표현했을 때 일관되고 의미있는 출력을 내보내는 능력을 새로운 관점에서 평가해야 한다는 주장이다. 기존 평가는 단일 프롬프트 형식이나 한정된 변형 집합에서 집계 정확도를 측정하는 방식으로, 견고성과 벤치마크 성능을 혼동하고 있다고 지적한다. 연구팀은 개별 예시 수준에서, 여러 입력 변형 구간에서, 모델 행동의 다양한 측면을 측정하는 새로운 평가 프레임워크를 제안한다. 전체 요약 6문장 읽기 → 047 00:11 ▲ 11 · 댓글 2 동영상 AI가 글씨를 제대로 쓰지 못한다 최신 동영상 생성 모델들이 자연어 지시로 현실 같은 영상을 만들어내지만, 기존 평가 기준은 시각 품질과 물리적 타당성에만 집중해 장면 속 텍스트 렌더링을 제대로 평가하지 못하고 있다. AI · 머신러닝 · VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation
Key Point 동영상 생성 AI 모델들이 영상 품질은 우수하지만 장면 속 글씨 렌더링이라는 맹점을 가진 이유를 체계적으로 드러내며, 텍스트 기반 평가 기준이 필요함을 보여준다.
핵심 요약
최신 동영상 생성 모델들이 자연어 지시로 현실 같은 영상을 만들어내지만, 기존 평가 기준은 시각 품질과 물리적 타당성에만 집중해 장면 속 텍스트 렌더링을 제대로 평가하지 못하고 있다. 광고와 과학 영상 등 5가지 실제 사용 사례를 바탕으로 300개의 프롬프트로 구성된 VTR-Bench 벤치마크를 개발했으며, 텍스트 충실도를 평가하는 자동화 파이프라인과 인간 평가 기준을 포함한다. Director 에이전트가 이미지·동영상 생성과 시각 평가를 조율하며 반복적 개선을 진행하는 Keyframe-Guided Agentic Framework를 함께 제시한다. 전체 요약 5문장 읽기 → 048 00:11 ▲ 25 · 댓글 2 비디오 생성 모델의 현실적 목표 달성 능력 평가 벤치마크 공개 비디오 생성 모델을 구체화된 계획(embodied planning)과 학습의 시뮬레이터로 활용하려면 시각적 품질뿐 아니라 목표 지향적 행동에 따른 환경 변화 예측도 필요하지만, 기존 벤치마크는 단편적인 행동만 평가해 다단계 물리 추론이 부족했다. AI · 머신러닝 · Ego2Act: Evaluating Goal-Directed Manipulation in Egocentric Video Generation
Key Point 비디오 생성 모델을 로봇 학습이나 구체화된 AI에 활용하려면 물리적으로 타당한 다단계 조작을 정확히 모사해야 하는데, 이제 그 능력을 체계적으로 측정할 수 있는 벤치마크와 평가 도구가 나왔다.
핵심 요약
비디오 생성 모델을 구체화된 계획(embodied planning)과 학습의 시뮬레이터로 활용하려면 시각적 품질뿐 아니라 목표 지향적 행동에 따른 환경 변화 예측도 필요하지만, 기존 벤치마크는 단편적인 행동만 평가해 다단계 물리 추론이 부족했다. Ego2Act는 일상 환경에서 110개 과제의 2,640개 영상으로 구성된 벤치마크로, 초기 장면과 고수준 목표가 주어졌을 때 비디오 생성 모델이 목표 달성을 위해 손으로 물체를 조작하는 현실적인 1인칭 영상을 생성할 수 있는지 평가한다. 평가 자동화를 위해 Ego2ActJudge 파이프라인을 함께 공개했으며, 기존 방식보다 작업 완수율과 물리 타당성 평가가 인간 합의도와 더 잘 정렬된다. 전체 요약 5문장 읽기 → 049 03:11 ▲ 26 · 댓글 2 엔터프라이즈 데이터 작업 평가 벤치마크 'Argo-Bench' 공개 기존 text-to-SQL 벤치마크는 쿼리 생성만 평가하며 정답 오류도 빈번한데, 실제 엔터프라이즈 데이터 환경은 수십 개 테이블을 넘나들며 통계 분석과 실행 가능한 의사결정을 요구한다. AI · 머신러닝 · Argo-Bench: Evaluating Data Agents on Enterprise-Scale Workflows
Key Point 엔터프라이즈 규모 데이터 시스템에서 AI가 쿼리 작성을 넘어 실제 의사결정까지 할 수 있는지 평가하는 첫 벤치마크이며, 현재 최강 모델도 35% 미만의 성공률로 데이터 에이전트의 현주소를 보여준다.
핵심 요약
기존 text-to-SQL 벤치마크는 쿼리 생성만 평가하며 정답 오류도 빈번한데, 실제 엔터프라이즈 데이터 환경은 수십 개 테이블을 넘나들며 통계 분석과 실행 가능한 의사결정을 요구한다. Argo-Bench는 뉴욕시 음식배달 플랫폼을 원탁 규모(2024년 주문 8,100만 건)로 시뮬레이션하고 Oracle E-Business Suite 스키마를 따른 235개 테이블, 75억 행의 ERP 웨어하우스를 모델링했다. 210개 데이터 과학·분석 작업으로 구성되며, 에이전트는 웨어하우스를 탐색해 사실을 재구성한 뒤 부정행위자 계정 차단, 배송원 인센티브 예산 할당, 소급 급여 지급 같은 실제 액션을 취해야 한다. 전체 요약 6문장 읽기 → 050 00:11 ▲ 104 · 댓글 160 C의 유연한 정수 타입은 설계 실수가 아니었다 C에서 int, short, long 같은 타입은 고정된 크기를 갖지 않으며, 컴파일러와 머신 아키텍처에 따라 달라진다. 인프라 · 데브옵스 · C's Flexible Integer Sizes Were Not a Design Mistake
Key Point C의 정수 타입 설계 철학을 이해하면 왜 현대 언어들은 고정 크기를 택했고 C는 여전히 유연성을 유지하는지, 그리고 이식 가능한 저수준 코드를 어떻게 작성해야 하는지 알 수 있다.
핵심 요약
C에서 int, short, long 같은 타입은 고정된 크기를 갖지 않으며, 컴파일러와 머신 아키텍처에 따라 달라진다. 많은 프로그래머는 이를 설계 실수라고 보지만, 실제로는 1970년대 다양한 아키텍처에서 이식성을 달성하기 위한 의도된 선택이었다. C 설계 당시 컴퓨터는 12, 18, 36, 60비트 워드, 6/7/8/9비트 문자 집합, 세 가지 음수 표현 방식 등 극도로 다양했다. 전체 요약 14문장 읽기 → 051 22:26 ▲ 11 · 댓글 2 로봇 짐꾸리기의 복잡한 결정 과정을 멀티모달 AI로 해결 로봇 짐꾸리기는 각 물건 배치가 남은 공간을 결정하는 장기 순차 결정 문제로, 기존에는 기하학적 휴리스틱이나 강화학습에 의존해왔다. AI · 머신러닝 · PackLab: A Comprehensive Framework for Developing, Training, and Evaluating MLLMs in Robotic Bin Packing
Key Point 로봇 제조 현장의 자동화에 필수적인 짐꾸리기 문제를 MLLM으로 풀어낸 새로운 접근법이며, 멀티모달 AI의 실제 로봇 응용 사례를 보여준다.
핵심 요약
로봇 짐꾸리기는 각 물건 배치가 남은 공간을 결정하는 장기 순차 결정 문제로, 기존에는 기하학적 휴리스틱이나 강화학습에 의존해왔다. PackLab은 멀티모달 대형언어모델(MLLM)을 로봇 짐꾸리기에 적용하기 위한 통합 프레임워크로, 개발·학습·평가의 전 과정을 지원한다. PackLab-Suite는 물리 기반 시뮬레이션으로 다양한 짐꾸리기 궤적을 대규모로 생성하고 실제 결과를 평가할 수 있다. 전체 요약 7문장 읽기 → 052 22:29 ▲ 39 · 댓글 2 자동회귀 영상 생성의 메모리 문제, 체계적 연구 프레임 제시 자동회귀 모델로 긴 영상을 생성할 때 컨텍스트 윈도우, 저장 공간, 계산량의 제약으로 인해 물체 정체성이나 동적 상태 같은 중요한 역사 정보가 활성 컨텍스트를 벗어나는 근본적 병목이 발생한다. AI · 머신러닝 · The Past Frames the Future: Memory for Autoregressive Video Generation
Key Point 자동회귀 영상 생성이 점점 길어지면서 메모리 부족으로 인한 시간적 일관성 붕괴 문제가 실질적 제약인데, 이를 체계화한 첫 종합 리뷰라 기술 개발 방향에 영향을 미칠 것으로 예상된다.
핵심 요약
자동회귀 모델로 긴 영상을 생성할 때 컨텍스트 윈도우, 저장 공간, 계산량의 제약으로 인해 물체 정체성이나 동적 상태 같은 중요한 역사 정보가 활성 컨텍스트를 벗어나는 근본적 병목이 발생한다. 이 논문은 자동회귀 영상 생성에서 메모리 메커니즘을 체계적으로 검토하는 첫 종합 연구다. 메모리를 '과거 단계의 정보가 현재 컨텍스트에서 접근 불가능해진 후에도 미래 생성에 영향을 미칠 수 있는 지속적 역사 정보'로 정의한다. 전체 요약 6문장 읽기 → 053 18:11 ▲ 21 · 댓글 2 심리학 기반 역할극 AI, 인간다운 상호작용 구현 기존 LLM 페르소나는 단순한 설명에 의존해 장기 상호작용에서 캐릭터 일관성을 잃는 문제를 겪고 있다. AI · 머신러닝 · Deep Persona: A Psychologically Grounded Architecture and Evaluation Framework for Role-Playing Agents and Simulations
Key Point 역할극 AI의 인간성을 심리학으로 설계하고 평가하는 새로운 방법론을 제시하며, LLM의 구체적 한계를 규명해 향후 대화형 AI 개선 방향을 제시한다.
핵심 요약
기존 LLM 페르소나는 단순한 설명에 의존해 장기 상호작용에서 캐릭터 일관성을 잃는 문제를 겪고 있다. 심리학 원리 기반 3계층 구조인 '딥 페르소나'를 제안했으며, 겉으로 드러나는 표현·내재적 신념·핵심 동기의 위계로 조직된다. 내부 스크립트로 모델 동작을 제약하는 스크립트 결정론과 한정된 자율성 원칙을 적용했다. 전체 요약 6문장 읽기 → 054 16:18 ▲ 129 · 댓글 3 게임 AI의 능력을 평가하는 대규모 벤치마크 공개 게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. AI · 머신러닝 · GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
Key Point 게임을 통해 AI의 비전, 지시 분해, 계획, 제어 능력을 체계적으로 평가하는 첫 번째 대규모 표준화 벤치마크로, 멀티모달 AI 모델 발전의 객관적 척도가 된다.
핵심 요약
게임 플레이 능력을 다양한 시간 범위에서 측정하는 GameHorizon Suite를 개발했다. 21개 게임의 5,000시간 녹화본, 100명 전문가 플레이어의 행동, 다중 수준 지시문으로 구성된 대규모 데이터세트를 구축했다. 오프라인 평가는 표준화된 문제로 재현 가능하고, 온라인 평가는 실제 게임플레이 능력을 검증한다. 전체 요약 5문장 읽기 → 055 00:10 ▲ 107 · 댓글 20 소프트웨어 샌드박싱 기초: 제대로 된 격리 환경 설계법 Emilua 개발자가 공유하는 샌드박싱 구현 경험과 실무 지침이다. 인프라 · 데브옵스 · Software sandboxing: The basics (2025)
Key Point 개발자가 직접 샌드박싱을 구현할 때 마주치는 함정(사용자 네임스페이스의 보안 문제, 잘못된 도구 선택)을 알 수 있고, 실무에서 피해야 할 접근과 권장하는 방식을 구체적으로 제시한다.
핵심 요약
Emilua 개발자가 공유하는 샌드박싱 구현 경험과 실무 지침이다. 프로세스 권한을 프로그래매틱하게 제한하되 관리자 권한 없이, 권한을 증가시키지 않는 방식이어야 한다. setuidgid 같은 전통적 UNIX 도구는 개발자용 샌드박싱에 맞지 않으며, Capsicum(FreeBSD), Seccomp(Linux) 같은 확장 인터페이스가 필요하다. 전체 요약 5문장 읽기 → 056 03:10 ▲ 106 · 댓글 8 빈티지 과학 논문 외형을 만드는 LaTeX 예제 모음 20개의 독립 실행형 예제로 옛 과학 논문의 미학을 재현하는 방법을 보여준다. 오픈소스 · 도구 · Vintage Scientific Papers with LaTeX
Key Point LaTeX와 MetaPost로 역사적 과학 문서의 시각적 특징을 재현하는 기법을 실제 코드로 배울 수 있으며, 학술 출판이나 복고 디자인 프로젝트에 직접 활용할 수 있다.
핵심 요약
20개의 독립 실행형 예제로 옛 과학 논문의 미학을 재현하는 방법을 보여준다. 순수 LaTeX 페이지, MetaPost 그림, LuaTeX에서 MetaPost로 그린 하이브리드 문서 등 세 가지 유형으로 나뉜다. 각 파일은 복사해 컴파일만 하면 되며, 개별 효과를 제거해 기여도를 확인할 수 있다. 전체 요약 5문장 읽기 → 057 08:12 당일 +154 AI 코딩 도구를 무료 모델로 라우팅하는 9Router Claude Code, Cursor, Copilot 등 40개 이상 AI 공급자의 100개 이상 모델을 하나의 OpenAI 호환 API로 통합하는 라우터 서비스다. AI · 머신러닝 · decolua/9router · JavaScript
Key Point 개발자가 API 비용 폭탄을 피하면서도 Claude Code, Cursor 같은 유료 도구를 무료·저가 AI로 구동할 수 있게 해주는 실질적인 해법을 제공한다.
핵심 요약
Claude Code, Cursor, Copilot 등 40개 이상 AI 공급자의 100개 이상 모델을 하나의 OpenAI 호환 API로 통합하는 라우터 서비스다. RTK(Response Token Kompressor)로 토큰 20-40%를 절감하며, 요청량 초과 시 자동으로 무료·저가 모델로 전환된다. Kiro AI(월 50크레딧 무료, Claude 4.5·GLM-5·MiniMax 제공) 등 무료 공급자 연결 가능하며, 여러 계정으로 라운드로빈 로드밸런싱을 지원한다. 전체 요약 5문장 읽기 →