쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 10월 30일 (금)까지 3647건
34건 · "그래디언트"조건 지우기 ×
001 12:11 ▲ 11 · 댓글 2 픽셀 공간 확산 모델 학습 가속화하는 통계 기법 픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. AI · 머신러닝 · Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models
Key Point 픽셀 공간 생성 모델의 훈련 효율을 37.5% 단축할 수 있는 방법이 제시되어, 대규모 이미지 생성 모델 개발의 실질적 비용 절감에 직결된다.
핵심 요약
픽셀 공간에서 속도장(velocity field)을 직접 학습하는 것은 어렵고 느린데, 고정된 Wiener 추정값이 속도 학습을 개선하고 선형 예측 범위를 넘어 이득을 제공한다. 고정된 기저(basis)와 픽셀 디코딩도 이와 유사하면서 상호보완적인 성능 향상을 보인다. Wiener-informed Decoding(WiD)은 통계적 지식으로 직접 예측과 디코더 계산을 조직화하며, 훈련가능한 Wiener 예측 경로와 기본 디코더 블록에 특징을 주입하고 계수 보정을 반환하는 계수 인터페이스를 조합한다. 전체 요약 8문장 읽기 → 002 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 180 · 댓글 60 내년 웹 표준에 들어올 10가지 CSS 기능 미리보기 주요 브라우저 벤더들이 참여한 Interop 프로젝트는 웹 표준 브라우저 호환성을 높이는 데 성공했으며, 포함된 기능들이 1년 내 모든 브라우저에서 거의 100% 지원되는 수준에 도달한다. 웹 · 프론트엔드 · The Future of CSS
Key Point Interop 2027 투표 대상 기능들을 미리 확인해, 내년에 모든 브라우저에서 광범위하게 지원될 CSS 혁신을 준비할 수 있다.
핵심 요약
주요 브라우저 벤더들이 참여한 Interop 프로젝트는 웹 표준 브라우저 호환성을 높이는 데 성공했으며, 포함된 기능들이 1년 내 모든 브라우저에서 거의 100% 지원되는 수준에 도달한다. Interop 2027 계획 수립 중이며 Mozilla는 개발자 투표로 다음 해 포함 기능을 결정할 예정이다. CSS 함수(@function)는 JavaScript처럼 CSS에서 재사용 가능한 함수를 정의할 수 있게 해주며, 삼각함수를 활용한 극좌표 변환 등이 가능하다. 전체 요약 13문장 읽기 → 004 12:11 ▲ 29 · 댓글 2 약한 모델로 강한 확산 모델 학습하기, SWIFT 논문 확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. AI · 머신러닝 · SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
Key Point 약한 모델을 활용해 더 강한 확산 모델을 절반 이하의 학습 비용으로 훈련하면서도 추론 오버헤드를 늘리지 않는 실질적인 방법이 입증되었기 때문이다.
핵심 요약
확산 모델 학습은 계산량이 많아서 추론 시 가이던스를 추가하면 샘플링 비용이 더 높아진다는 문제가 있다. SWIFT는 얼려진 약한 노이즈 제거기를 사용해 강한 모델을 개선하는 자가 가이드 학습법으로, 추론 오버헤드를 추가하지 않는다. 각 노이지 입력에 대해 약한 모델의 예측에서 멀어지도록 클린 회귀 타겟을 외삽하여, 부족하게 학습된 성분을 증폭한다. 전체 요약 9문장 읽기 → 005 12:11 ▲ 18 · 댓글 2 신경망 기반 스키닝으로 물리 애니메이션을 실시간 생성하는 PhysSkin++ 다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. AI · 머신러닝 · PhysSkin++: Real-Time and Generalizable Physics-Based Animation via Self-Supervised Neural Skinning
Key Point 신경망 기반의 자기지도 학습으로 사전 시뮬레이션 없이도 다양한 3D 모델에서 실시간 물리 애니메이션을 생성할 수 있어, 게임·영상·디지털 콘텐츠 제작의 효율성을 획기적으로 높일 수 있다.
핵심 요약
다양한 3D 형태에서 실시간 물리 기반 애니메이션을 일반화하기 위해 PhysSkin++ 프레임워크를 제안했다. 정적 기하학으로부터 신경 스키닝 필드를 학습해 콤팩트한 변형 부분공간을 구성하며, 객체별 네트워크 훈련 없이 형태 의존적 부분공간을 예측한다. 시뮬레이션 궤적 없이 부분공간을 학습하기 위해 스키닝 필드 정규화와 충돌 인식 그래디언트 보정을 결합한 물리 기반 자기지도 학습 전략을 개발했다. 전체 요약 7문장 읽기 → 006 03:11 새 버전 Transformers 5.20.2 패치: 멀티모달 모델 입력 타입 버그 수정 Transformers 5.20.2 패치 버전이 릴리스됐다. AI · 머신러닝 · huggingface/transformers@v5.20.2
Key Point 멀티모달 모델과 대규모 분산학습 환경에서 발생하는 핵심 버그들이 수정되어 Transformers 라이브러리를 사용하는 개발자라면 즉시 업그레이드를 고려해야 한다.
핵심 요약
Transformers 5.20.2 패치 버전이 릴리스됐다. prepare_inputs_for_generation 함수에서 입력값이 원래 타입을 잃어 멀티모달 모델에 문제를 일으키던 버그를 수정했다. 또한 입력 딕셔너리 캐스팅 문제를 해결했으며, bfloat16과 전문가 병렬처리(expert parallelism)에서 ep_size < fsdp_size 조건일 때 제로 그래디언트 문제를 수정했다. 전체 요약 4문장 읽기 → 007 15:11 ▲ 43 · 댓글 3 로봇 행동 예측 AI, 시각 정보 처리 30배 효율화 기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. AI · 머신러닝 · BridgeWAM: Bridging Video and Action Experts via Latent Bridge Queries
Key Point 로봇 행동 모델의 계산 효율을 대폭 개선하면서 성능은 유지하는 기술로, 로봇 제어 AI의 실시간성과 비용 효율성을 높이는 방향을 제시한다.
핵심 요약
기존 World Action Model(WAM)은 비디오와 행동 전문가를 밀집한 Mixture-of-Transformers 주의 메커니즘으로 결합해 관련 없는 시각 정보 노출과 중복 계산 문제를 야기했다. BridgeWAM은 시각·언어·고유감각 정보를 32개의 Latent Bridge Queries(LBQs)를 통해 제한된 공유 잠재 공간으로 집약하는 Bridge-of-Experts 구조를 도입했다. 행동 예측 그래디언트가 비디오 전문가를 행동 예측에 적합한 표현으로 유도하고, 행동 전문가는 교차 주의를 통해 작업 관련 정보를 선택적으로 검색한다. 전체 요약 7문장 읽기 → 008 12:11 ▲ 237 · 댓글 2 다중 교사 학습 시 교사 간 충돌 완화하는 새로운 방법 다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. AI · 머신러닝 · Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
Key Point 다중 전문 모델을 하나로 통합할 때 발생하는 그래디언트 충돌 문제를 토큰 수준에서 직접 해결하는 기술로, 멀티태스킹 학습 시스템의 안정성과 성능을 모두 개선하는 방법을 제시한다.
핵심 요약
다중 교사 온폴리시 증류(MOPD)는 도메인별로 전문화된 교사가 학생이 생성한 궤적에 대해 밀도 있는 토큰 수준의 감독을 제공하는 방식이다. 기존 도메인 라우팅 방식은 도메인별로 감독 소스를 구분하지만, 모든 도메인의 업데이트가 공유 파라미터에 작용하면서 교사들의 응답 스타일과 도메인 전문성이 다를 때 그래디언트 충돌과 성능 저하가 발생한다. Road MOPD는 라우팅되지 않은 보조 교사를 크로스 도메인 평가자로 추가하고, 토큰 수준의 신용 배분과 그래디언트 업데이트를 통해 다중 교사 감독을 조율한다. 전체 요약 6문장 읽기 → 009 06:11 ▲ 10 · 댓글 2 대비 학습 전략, 정말 효과적인지 검증했더니 멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. AI · 머신러닝 · What Really Works for Universal Multimodal Embeddings? A Controlled Study of Contrastive Training Strategies
Key Point 기존에 널리 쓰이던 대비 학습 전략들이 실제로는 효과가 미미하거나 역효과를 낸다는 것을 체계적으로 증명해, 멀티모달 모델 개발자들이 어떤 조합이 정말 작동하는지 알 수 있게 했다.
핵심 요약
멀티모달 표현 학습에서 대비 학습(Contrastive Learning)이 표준 패러다임이 되었으나, 실제 성능 효과는 제대로 검증되지 않았다. 음수 선택, 배치 구성, 그래디언트 조정 등 다양한 대비 학습 전략들이 제안되었지만, 통제된 조건에서 그 실효성은 불명확했다. 연구팀은 MMEB 벤치마크에서 대표적인 전략들을 통일된 프레임워크로 평가한 결과, 대부분이 기본 기준선 대비 미미한 개선만 제공하며 일부는 성능을 악화시키는 것으로 나타났다. 전체 요약 8문장 읽기 → 010 15:11 ▲ 50 · 댓글 1 확산 모델이 외부 도움 없이 자신을 개선하는 법 기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. AI · 머신러닝 · SALD: Self-Referenced Advantage Learning for Diffusion Models
Key Point 확산 모델의 학습을 더 효율적으로 만들 수 있는 새로운 기법으로, 추가 모델이나 파라미터 없이 모델 자신의 내부 신호만으로 성능을 개선할 수 있다는 점이 의미 있다.
핵심 요약
기존 연구에서 언어모델은 학생 파라미터로 구동하는 교사 네트워크의 도움으로 자체 평가 신호를 얻을 수 있음을 보였는데, 이를 확산 모델에 적용할 방법을 제시한다. SALD는 같은 모델으로 각 이미지-캡션 쌍을 두 가지 노이즈 수준에서 평가하는 자체 참조 학습 프레임워크다. 낮은 노이즈 경로는 그래디언트 추적 없이 평가되어 참조값을 제공하고, 높은 노이즈 경로는 학습 그래디언트를 생성한다. 전체 요약 8문장 읽기 → 011 15:11 ▲ 108 · 댓글 53 AI 모델이 암호화된 능력을 숨길 수 있다는 증명 능력 평가는 위험한 모델 동작을 배포 전에 발견하기 위한 것이지만, 숨겨진 능력을 끌어낼 수 있다는 가정에 의존한다. AI · 머신러닝 · AI Models Can Provably Hide Arbitrary Capabilities
Key Point 능력 평가는 위험한 AI 배포를 막기 위한 핵심 도구인데, 이 논문이 수학적으로 감시를 우회하는 기법을 보여주면서 AI 안전 검증 방식의 근본적 한계를 제기합니다.
핵심 요약
능력 평가는 위험한 모델 동작을 배포 전에 발견하기 위한 것이지만, 숨겨진 능력을 끌어낼 수 있다는 가정에 의존한다. 연구팀은 백도어 공격으로 암호화된 신경망을 모델 가중치에 삽입하고, 비밀 트리거를 받을 때만 복호화·실행하는 방식을 제시했다. 디지털 로커를 이용해 이 숨겨진 회로는 암호 이론적 가정 하에서 모델 가중치에 완전히 접근하더라도 추출·해석이 원칙적으로 어렵다. 전체 요약 7문장 읽기 → 012 12:11 ▲ 12 · 댓글 2 강화학습의 그래디언트 기아 현상 해결하는 ReSPO 논문 검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다. AI · 머신러닝 · ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning
Key Point 강화학습 모델 훈련에서 정책 최적화 과정의 근본적인 문제를 진단하고 이를 해결하는 새로운 알고리즘을 제시하여, 특히 데이터 재사용 효율성이 중요한 LLM 훈련에 직접 적용될 수 있기 때문이다.
핵심 요약
검증 가능한 보상으로부터의 강화학습(RLVR)에서 롤아웃을 여러 정책 업데이트에 걸쳐 재사용하면, 현재 정책과 데이터 생성 정책 간의 불일치가 심화된다. 기존 클리핑 기반 정책 최적화에서 '부호 의존 그래디언트 기아' 문제가 발생하는데, 이는 클리핑이 저중요도 가중치 영역의 미생성 긍정 응답을 억제하면서 동시에 고중요도 영역의 과도 생성 부정 응답이 지배하게 되는 현상이다. 연구팀은 ReSPO(Reshaped Sequence Policy Optimization)를 제안하는데, α-발산 변분 목적함수와 지수 분산 제어 틸트에서 파생된 부드러운 이중 분기 시퀀스 레벨 커널로 클리핑을 대체한다. 전체 요약 6문장 읽기 → 013 00:11 ▲ 20 · 댓글 2 Flow 정책 미세조정을 위한 스칼라 수반 매칭 기법 Flow 정책은 다양한 행동 분포를 포착하며, 데모 데이터를 넘어 성능을 높이기 위해 오프-폴리시 강화학습으로 미세조정하는 방식이 주목받고 있다. AI · 머신러닝 · Q-Learning with Scalar Adjoint Matching
Key Point Flow 정책의 강화학습 미세조정 비용을 획기적으로 줄이면서도 실제 로봇 제어까지 검증한 실용적 알고리즘이 제안되었다.
핵심 요약
Flow 정책은 다양한 행동 분포를 포착하며, 데모 데이터를 넘어 성능을 높이기 위해 오프-폴리시 강화학습으로 미세조정하는 방식이 주목받고 있다. Flow 정책을 학습된 가치 함수로 미세조정하는 것은 정책이 많은 Flow 스텝을 거쳐 행동을 생성하므로 비자명하다. 기존 수반 매칭은 최종 행동에서 각 Flow 스텝으로 가치 정보를 역전파하는 원칙적 방법이지만, 매 스텝마다 벡터-야코비안 곱을 요구해 계산 비용이 Flow 스텝 수와 정책 크기에 따라 증가한다. 전체 요약 9문장 읽기 → 014 18:30 ▲ 19 · 댓글 2 LLM 정책 학습의 동기화 문제를 푸는 KLPO 프레임워크 LLM 에이전트의 비동기 강화학습에서 이전 버전으로 생성한 궤적을 현재 정책으로 학습하는 과정에서 샘플러와 트레이너의 확률 분포가 달라지는 문제를 다룬다. AI · 머신러닝 · On KL-Regularized Policy Optimization
Key Point LLM 강화학습에서 온라인 정책과 생성 정책의 불일치 문제를 일반적으로 해결하는 프레임워크로, 기존 방법보다 효율적이고 여러 알고리즘을 통합한다.
핵심 요약
LLM 에이전트의 비동기 강화학습에서 이전 버전으로 생성한 궤적을 현재 정책으로 학습하는 과정에서 샘플러와 트레이너의 확률 분포가 달라지는 문제를 다룬다. 기존 방식(클리핑이나 GRPO)은 편향을 초래하거나 긴 에피소드에서 계산 비용이 크다는 문제가 있다. 저자들은 KL-정규화 정책 최적화(KLPO)를 제안하며, KL 정규화 항을 샘플러 확률에 고정해 중요도 가중치 없이 직접 최적화할 수 있게 한다. 전체 요약 8문장 읽기 → 015 18:30 ▲ 51 · 댓글 2 자동회귀 비디오 생성의 그래디언트 충돌 해결: SGF+ 자동회귀 방식의 비디오 생성은 현재 프레임을 노이즈 제거하면서 동시에 미래 예측용 컨텍스트로 쓸 키-값 표현을 작성해야 하는데, 이 두 역할이 같은 파라미터를 공유하면서 서로 다른 그래디언트 패턴을 보이고 체계적인 음의 정렬을 일으킨다. AI · 머신러닝 · SGF+: Decoupling Gradient Flows for Autoregressive Video Generation
Key Point 자동회귀 비디오 생성의 핵심 병목인 그래디언트 충돌을 단순한 파라미터 분리로 해결해 긴 비디오도 별도 학습 없이 생성할 수 있게 하는 방법론이 제시됐습니다.
핵심 요약
자동회귀 방식의 비디오 생성은 현재 프레임을 노이즈 제거하면서 동시에 미래 예측용 컨텍스트로 쓸 키-값 표현을 작성해야 하는데, 이 두 역할이 같은 파라미터를 공유하면서 서로 다른 그래디언트 패턴을 보이고 체계적인 음의 정렬을 일으킨다. 이러한 그래디언트 충돌이 시각적 품질과 시간적 일관성의 공동 최적화를 방해하고 있다. 연구팀은 Self Gradient Forcing Plus(SGF+)를 제안하여 컨텍스트 작성과 노이즈 제거에 별도의 파라미터를 할당하되, 인과적 어텐션을 통해 두 역할 간 상호작용을 유지한다. 전체 요약 7문장 읽기 → 016 18:33 ▲ 14 · 댓글 2 LLM 강화학습의 메모리 병목을 저랭크 그래디언트로 풀다 강화학습(RL)은 대규모언어모델(LLM)의 성능을 높였지만 메모리 수요가 채택의 걸림돌이 되고 있다. AI · 머신러닝 · LoGRA: Scaling LLM Reinforcement Learning with Low-Rank Gradient Sketches
Key Point LLM 강화학습 훈련의 메모리 효율을 45% 이상 개선해 더 큰 모델과 리소스 제약 환경에서의 RL 훈련을 실용적으로 만든다.
핵심 요약
강화학습(RL)은 대규모언어모델(LLM)의 성능을 높였지만 메모리 수요가 채택의 걸림돌이 되고 있다. LoGRA는 유용한 학습 신호를 저랭크 그래디언트 스케치로 압축해 메모리 사용량을 줄이는 RL 후훈련 기법이다. 이 컴팩트한 표현은 모델 업데이트와 효율적인 정책 동기화 모두를 지원한다. 전체 요약 7문장 읽기 → 017 18:33 ▲ 20 · 댓글 2 언어모델이 분자 최적화 알고리즘을 자동 설계 양자화학 계산에서 기하 최적화는 각 단계마다 힘 계산이 필요해 가장 비용이 큰 부분이다. AI · 머신러닝 · Optimizing the Optimizer: Language Models Discover Faster Molecular Relaxation
Key Point 언어모델이 과학 계산의 핵심 병목인 분자 최적화 알고리즘을 자동으로 개선해 계산 비용을 40% 이상 줄인 사례로, AI가 직접 과학 연구 방법론을 최적화할 수 있음을 보여준다.
핵심 요약
양자화학 계산에서 기하 최적화는 각 단계마다 힘 계산이 필요해 가장 비용이 큰 부분이다. 연구팀은 언어모델 에이전트를 이용해 최적화 알고리즘 자체를 개선할 수 있는지 시도했다. 에이전트가 기존 최고 성능의 오픈소스 옵티마이저 Sella를 기반으로 자동으로 재작성하면서 힘 계산 횟수를 최소화한다. 전체 요약 6문장 읽기 → 018 18:33 ▲ 20 · 댓글 2 재귀 언어모델의 고정점 최적화로 학습·추론 비용 2배 절감 루프된 언어모델의 매 반복은 학습·디코딩·프리필·강화학습에서 비용을 증가시키는데, 재귀 상태가 고정점에 가까워질수록 그 경로의 중요도는 감소한다. AI · 머신러닝 · Towards Looped Models Done Right, Part II: Rethinking at Fixed Points
Key Point 재귀 언어모델의 학습·추론 비용을 획기적으로 줄이는 구체적 기법(KV 캐시 축소, 역전파 생략, RL 속도 개선)과 이론적 기반(고정점 특성)을 제시하며, 실험 결과로 입증된 개선 방법을 다룬다.
핵심 요약
루프된 언어모델의 매 반복은 학습·디코딩·프리필·강화학습에서 비용을 증가시키는데, 재귀 상태가 고정점에 가까워질수록 그 경로의 중요도는 감소한다. 고정점 근처에서의 수렴 성질을 활용하면 학습 중 절단된 역전파(truncated backpropagation), 거의 정확도 손실 없는 터미널 KV 공유 디코딩, 1.79배 빠른 프리필을 위한 증류 학생 모델, 저장된 롤아웃 상태에서 그래디언트를 계산하는 RL 업데이트(재생 경로 역전파보다 2배 빠름)가 가능하다. 고정점을 형성하는 두 핵심 요소인 깊이 사전(depth prior)과 입력 주입(input injection)을 개선했다. 전체 요약 8문장 읽기 → 019 18:33 ▲ 160 · 댓글 2 다른 토크나이저 간 증류학습, 정확도는 적은 정보로도 충분하다 On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. AI · 머신러닝 · Rethinking Cross-Tokenizer On-Policy Distillation: From Alignment Coverage to Supervision Reliability
Key Point 다른 토크나이저를 사용하는 모델 간 증류에서 더 많은 정렬 범위보다 신뢰할 수 있는 감독이 핵심이라는 발견으로, 효율적인 학습 설계의 원칙을 제시한다.
핵심 요약
On-Policy Distillation(OPD)은 학생 모델이 자신의 생성 결과에 대해 교사 모델의 피드백을 받아 학습하는 방식이며, 다른 토크나이저를 쓸 때는 시퀀스와 어휘 레벨에서 정렬이 필요하다. 수학 추론과 코드 생성 과제에서 3개 교사-학생 쌍을 실험한 결과, 어휘 불일치가 크더라도 엄격한 1:1 정렬만으로도 학생이 생성한 대부분의 토큰을 커버했다. 학생이 증류 전에 샘플링한 응답에서 공유 어휘는 엄격히 정렬된 위치에서 교사와 학생의 확률 질량 거의 전부를 유지했다. 전체 요약 7문장 읽기 → 020 18:33 당일 +199 DeepSeek의 GPU GEMM 커널 라이브러리 오픈소스 공개 DeepGEMM은 NVIDIA GPU에 최적화된 통합 텐서 코어 커널 라이브러리로, 대언어모델(LLM)의 핵심 연산인 GEMM(FP8, FP4, BF16), Mega MoE, MQA 스코링 등을 단일 CUDA 코드베이스에 통합했다. AI · 머신러닝 · deepseek-ai/DeepGEMM · Cuda
Key Point LLM 추론·학습 성능을 좌우하는 GEMM 커널을 DeepSeek이 직접 최적화한 오픈소스 공개로, 고속 LLM 인프라 구축 시 활용할 수 있는 기반 도구가 확보된다.
핵심 요약
DeepGEMM은 NVIDIA GPU에 최적화된 통합 텐서 코어 커널 라이브러리로, 대언어모델(LLM)의 핵심 연산인 GEMM(FP8, FP4, BF16), Mega MoE, MQA 스코링 등을 단일 CUDA 코드베이스에 통합했다. CUTLASS와 CuTe의 개념을 참고하되 무거운 템플릿 의존성을 피하고, 런타임 JIT 컴파일(DeepJIT)로 설치 시 CUDA 컴파일을 요구하지 않는다. 각 행렬 크기에 따라 전문가 튜닝 라이브러리 수준 이상의 성능을 제공하며, H800에서 최대 1550 TFLOPS를 달성한다. 전체 요약 11문장 읽기 → 021 18:35 ▲ 277 · 댓글 82 역전파 없이 트랜스포머를 학습하는 'Dust' 알고리즘 등장 연구진이 역전파를 대체하는 첫 번째 0차 최적화 방법 'Dust'를 제시했으며, 대규모 언어 모델 사전학습에서 역전파와 경쟁 가능한 성능을 보인다. AI · 머신러닝 · Dust: Pretraining Transformers Without Backpropagation
Key Point 역전파 없이도 대규모 언어 모델을 학습할 수 있는 첫 경쟁력 있는 방법이 등장했으며, 기존 진화 전략보다 수천 배 효율적이고 계산량이 충분하면 역전파를 능가할 가능성을 보여준다.
핵심 요약
연구진이 역전파를 대체하는 첫 번째 0차 최적화 방법 'Dust'를 제시했으며, 대규모 언어 모델 사전학습에서 역전파와 경쟁 가능한 성능을 보인다. Dust는 모든 토큰에서 독립적으로 활성화를 교란하여 각 토큰을 가상 개체군 구성원으로 취급하고, 한 번의 순전파에서 수천 개의 개체군 구성원을 병렬로 평가한다. 가중치 공간 진화 전략(EGGROLL)보다 1000배~10000배 효율적이며, 100만 토큰 이상에서 이를 달성한다. 전체 요약 11문장 읽기 → 022 09:11 ▲ 13 · 댓글 2 여러 RL 교사 모델의 신호가 학생 파라미터에 미치는 영향 분석 Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. AI · 머신러닝 · From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
Key Point 여러 교사 신호를 결합할 때 손실 평균화, 옵티마이저 동작, 정밀도가 최종 성능에 미치는 구체적인 영향을 분석한 결과로, LLM 증류 설계의 의사결정 근거를 제시한다.
핵심 요약
Qwen3-1.7B 학생 모델과 같은 초기화에서 훈련한 4개 도메인 RL 교사들로부터의 다중 교사 온폴리시 증류(MOPD) 과정에서 그래디언트, 옵티마이저 업데이트, 태스크 학습 곡선을 비교 분석했다. 손실 평균화는 응답 길이를 기반으로 암묵적 가중치를 부여하는데, 토큰 평균화는 긴 응답을 선호하고 도메인 기여도 균등화도 도메인 내에서 이 가중치를 유지한다. Adam 옵티마이저의 1차 모멘트는 파라미터 업데이트의 차이를 감소시켜, 원본 그래디언트에는 차이가 있지만 교사 간 코사인 유사도 0.83, 평균화 규칙 간 0.96을 보인다. 전체 요약 6문장 읽기 → 023 06:11 ▲ 17 · 댓글 1 긴 동영상의 물체 추적 난제 해결한 LVMT 논문 발표 기존 온라인 비디오 세분화 방법들은 장시간 폐색이 있는 복잡한 동영상에서 물체 추적을 제대로 못하고 있다. AI · 머신러닝 · LVMT: Video Mask Transformer for Long-term Video Segmentation
Key Point 긴 동영상에서 물체 추적의 근본적인 한계를 해결한 새로운 구조와 학습 방법으로, 실제 응용에서 정확도와 속도의 트레이드오프를 동시에 개선했다.
핵심 요약
기존 온라인 비디오 세분화 방법들은 장시간 폐색이 있는 복잡한 동영상에서 물체 추적을 제대로 못하고 있다. 이 문제는 시간에 따라 어떤 물체 정보를 전파할지 선택하지 못하는 시간적 전파 메커니즘과 메모리·그래디언트 소실로 인해 긴 동영상 학습이 불가능한 탓이다. 연구팀은 경량 GRU 기반 시간적 전파 모듈을 제안해 메모리에 유지할 정보를 학습으로 선택할 수 있게 했다. 전체 요약 5문장 읽기 → 024 12:11 ▲ 19 · 댓글 2 의미·기하 구조 동시 학습, 픽셀 확산 모델 성능 끌어올리다 Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. AI · 머신러닝 · PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
Key Point 의미 정보와 기하 정보를 분리해 학습하는 구조적 혁신으로 텍스트-이미지 생성부터 이미지 편집까지 여러 작업에서 동시에 성능을 끌어올렸으며, 전통적 단일 정렬 방식의 한계를 넘었다.
핵심 요약
Representation alignment(REPA)는 확산 트랜스포머 학습을 가속화하는 기법인데, 기존엔 의미 정보(DINOv2, CLIP)만을 정렬 대상으로 삼았다. 최근 분석이 정렬 효과의 핵심이 의미 정보가 아닌 공간 구조(spatial structure)임을 지적했으나, 그러한 구조를 예측하도록 훈련된 기초 모델들은 간과되어 왔다. 픽셀 공간 확산에서 SAM2, Depth Anything v2, Metric3D v2는 DINOv2 단독 기준보다 우수하며, 특히 기하 정보를 학습하는 모델들이 분할 모델을 앞선다. 전체 요약 10문장 읽기 → 025 03:11 ▲ 175 · 댓글 3 온정책 vs 비정책 학습, 체계적 실험으로 재평가 온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다. AI · 머신러닝 · On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
Key Point 강화학습 기반 모델 최적화에서 온정책 학습의 필요성이 통념으로 여겨졌지만, 체계적인 실험을 통해 그 가정을 재검토한 논문으로 실무 선택에 직결되는 통찰을 제시한다.
핵심 요약
온정책(on-policy) 학습이 재앙적 망각을 줄이고 성능을 개선한다는 주장이 있지만, 기존 연구는 여러 요소를 동시에 변경해 효과를 명확히 구분하기 어려웠다. 연구팀은 강한 모델을 약한 모델로 증류하는 통제된 실험에서 온정책 정책, KL 방향, 학습률을 독립적으로 변경하며 Llama3과 Qwen2.5에서 과학·의료·산술 추론 과제를 실시했다. 분석 결과 온정책 정책이 중심 역할을 하지 않는 것으로 드러났다. 전체 요약 8문장 읽기 → 026 12:11 ▲ 124 · 댓글 2 동영상 생성 AI의 음성-영상 동기화를 위한 적응형 보상 라우팅 기법 오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. AI · 머신러닝 · Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
Key Point 음성-영상 생성 AI의 동기화와 품질을 동시에 높이는 새로운 최적화 기법으로, 여러 목표가 충돌할 때 동적으로 가중치를 조정하는 방식이 향후 멀티모달 생성 모델 개선의 방향을 제시한다.
핵심 요약
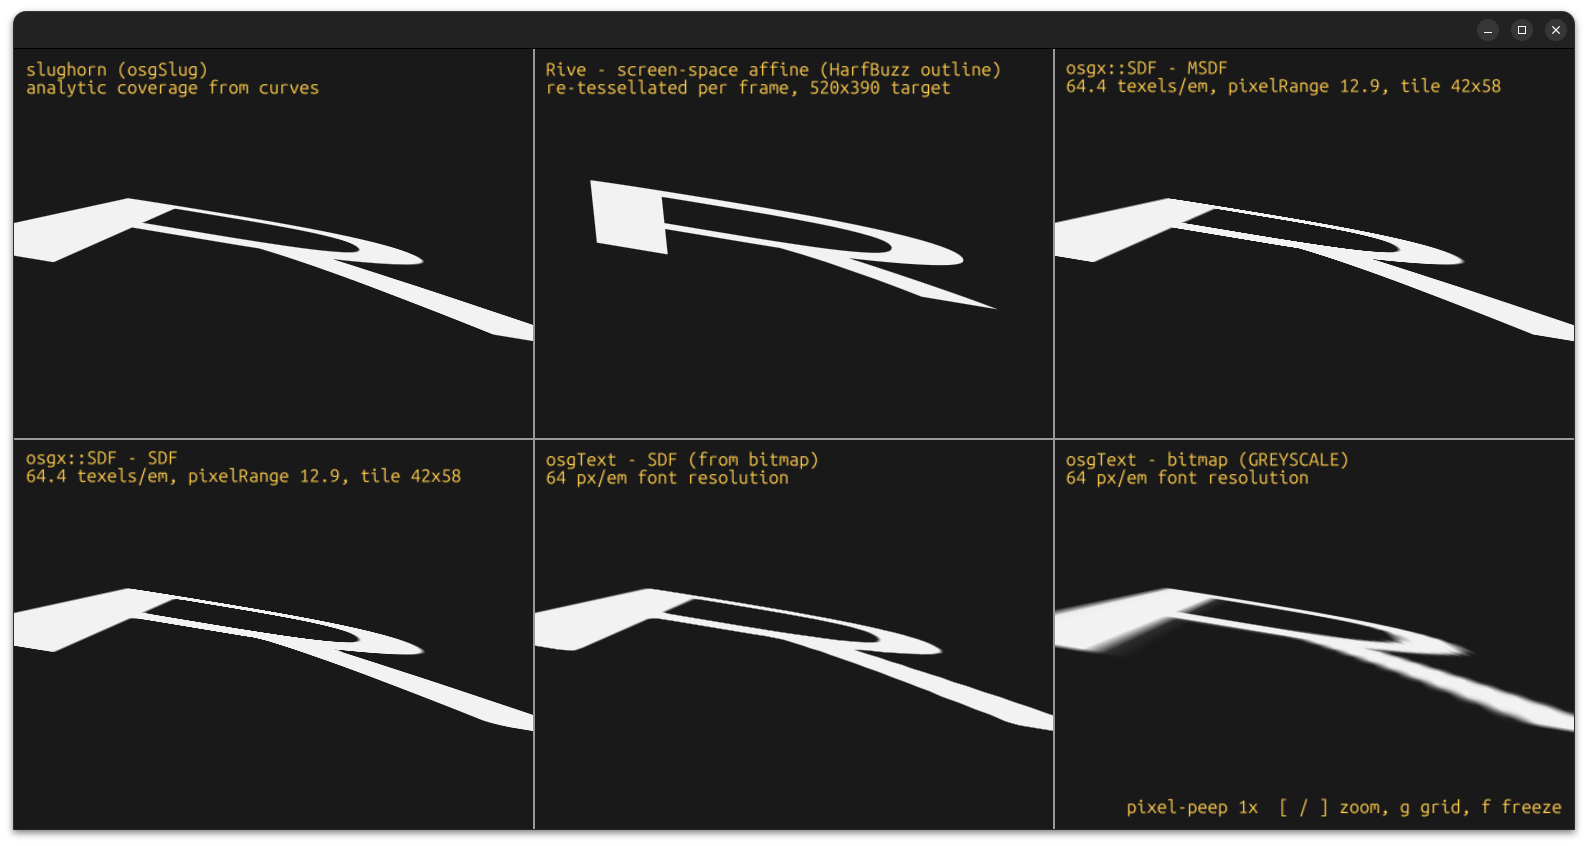
오디오-비디오 확산 모델을 개선하기 위해 여러 보상 신호를 활용하는 강화학습 방식이 있지만, 훈련 과정에서 보상 가중치와 적용 위치가 고정되어 있어 모델의 변화하는 특성을 따라가지 못한다. 논문은 Adaptive Reward Routing이라는 새로운 방법을 제안하며, 이는 음성 품질, 영상 품질, 교차-모달 의미 일치, 시간적 동기화 등 여러 목표를 동시에 최적화한다. 첫 번째 구성 요소는 Cross-Modal Influence-Guided Routing으로, 양방향 교차-주의 응답을 이용해 변화하는 모달 간 영향을 추적하면서 토큰별 손실을 동적으로 재가중화하고 그래디언트를 조정한다. 전체 요약 6문장 읽기 → 027 06:11 ▲ 114 · 댓글 47 GPU 텍스트 렌더링 5가지 기법 비교: Slug 특허 공개와 함께 GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 웹 · 프론트엔드 · SDF vs. MSDF vs. Slug: GPU Text Rendering
Key Point 2026년 Slug 특허가 공개 도메인으로 해방되면서 고사양 3D·AR 환경의 텍스트 렌더링 기술이 개방되었으며, 각 기법의 정확한 트레이드오프를 이해하면 게임, 시뮬레이션, 데이터 시각화 프로젝트에서 최적의 방식을 선택할 수 있다.
핵심 요약
GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 가장 오래된 텍스처 아틀라스 방식은 글자를 고정 크기로 미리 렌더링해 저장하므로, 확대하면 흐릿해지고 중국어·일본어·한국어 같은 거대 글자 집합은 메모리가 폭증한다. SDF(부호있는 거리장)는 픽셀 대신 가장자리까지의 거리를 저장해 확대에 강하지만, 날카로운 모서리가 둥글어지는 한계가 있다. 전체 요약 12문장 읽기 → 028 03:11 ▲ 99 · 댓글 3 KV 캐시 압축의 숨은 약점, 위치에 따라 정확도 40%p 차이 긴 문맥 추론 효율을 높이기 위해 연속된 토큰들을 윈도우 단위로 압축하는 청크형 KV 캐시 압축 기법을 사용하면, 토큰이 압축 윈도우 경계와의 상대 위치(phase)에 따라 정보 검색 난이도가 크게 달라진다. AI · 머신러닝 · Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression
Key Point 긴 문맥 추론 최적화를 위해 KV 캐시 압축을 도입하면 평균 점수로는 보이지 않는 주기적 성능 저하가 발생하므로, 이 기법의 실제 안정성을 평가할 때 주의가 필요하다.
핵심 요약
긴 문맥 추론 효율을 높이기 위해 연속된 토큰들을 윈도우 단위로 압축하는 청크형 KV 캐시 압축 기법을 사용하면, 토큰이 압축 윈도우 경계와의 상대 위치(phase)에 따라 정보 검색 난이도가 크게 달라진다. 같은 정보가 어떤 phase에서는 쉽게 검색되지만 다른 phase에서는 어렵다는 체계적인 비대칭성이 발생하며, 이를 phase sensitivity라고 명명했다. 대규모 오픈소스 모델들에서 long-context 검색 정확도가 phase에 따라 최대 40 percentage points 차이가 나타나, 평균 벤치마크 점수로는 드러나지 않는 주기적 약점들이 존재한다. 전체 요약 7문장 읽기 → 029 15:11 ▲ 43 · 댓글 1 시각 생성 학습이 인식 성능을 높이는 조건 이미지 생성(I2I) 작업으로 학습하면 기하학, 공간 관계, 객체 인식 능력 같은 풍부한 지각 능력을 얻을 수 있지만, 시각 이해 능력 향상에 어떻게 도움이 되는지는 명확하지 않았다. AI · 머신러닝 · OmniTaskonomy: When Does Visual Generation Improve Visual Understanding?
Key Point 어떤 생성 과제가 어떤 이해 능력을 향상시키는지 체계적으로 규명하면, 멀티모달 모델 학습의 효율성을 크게 높일 수 있기 때문입니다.
핵심 요약
이미지 생성(I2I) 작업으로 학습하면 기하학, 공간 관계, 객체 인식 능력 같은 풍부한 지각 능력을 얻을 수 있지만, 시각 이해 능력 향상에 어떻게 도움이 되는지는 명확하지 않았다. 연구진은 같은 문제를 다양한 출력 형태로 표현하는 이미지-이미지(I2I) 생성 과제와 이미지-텍스트(I2T) 이해 과제의 짝을 만들어 비교했다. 올바른 학습 방식으로 I2I 학습을 진행하면 I2T 성능이 향상되며, I2I 학습 데이터가 많을수록 개선 폭이 크다. 전체 요약 8문장 읽기 → 030 18:11 ▲ 64 · 댓글 1 어텐션의 계산 효율을 높이는 MALA 메커니즘 제안 기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. AI · 머신러닝 · MassAlloc Attention: Let Attention Allocate Its Own Compute
Key Point Full Attention의 비효율적 계산 패턴을 식별하고 실제 기여도 기반 할당으로 2~3배 속도 향상을 달성하면서도 모델 성능을 유지하는 방법으로, 대규모 언어 모델의 추론·학습 효율을 개선하는 데 직결된다.
핵심 요약
기존 Full Attention은 QK 타일 계산 후 전체 후속 경로를 실행하지만 정규화 가중치에서 대부분의 값이 무시할 수준으로 작아 비효율적이다. MALA(MassAlloc Attention)는 정규화된 기여도에 따라 후속 계산을 선택적으로 할당하는 퓨즈드 어텐션 프리미티브로, 순전파는 온라인 소프트맥스 정규화기를, 역전파는 최종 정규화기를 재사용한다. 하나의 공통 임계값으로 학습과 추론에서 적응적 유지(retention)가 가능하며, 8K 토큰 비교에서 생략된 질량은 0.0188%로 기준 오라클의 0.0182%에 근접한다. 전체 요약 7문장 읽기 → 031 03:11 ▲ 263 · 댓글 183 AI가 만드는 UI의 전형적인 실패 패턴 10가지 저자는 대학 앱의 AI 업데이트 후 '슬롭(Slop)' UI — 비전 없이 막 만든 촌스럽고 싸 보이는 디자인 — 의 문제점을 지적한다. 웹 · 프론트엔드 · Tells of a Slop UI
Key Point AI 생성 UI의 공통된 안티패턴을 정확히 꼬집은 글로, 실제 대학 앱 사례를 통해 개발자들이 AI 도구의 한계를 구체적으로 이해할 수 있다.
핵심 요약
저자는 대학 앱의 AI 업데이트 후 '슬롭(Slop)' UI — 비전 없이 막 만든 촌스럽고 싸 보이는 디자인 — 의 문제점을 지적한다. 가장 흔한 특징은 과도한 그래디언트로, 버튼, 배경 등 모든 곳에 쓰이며 특히 보라색을 선호한다. 어울리지 않는 다채로운 색상을 구분 목적 없이 남용하는 '레인보우 보밋'은 색상 조화의 70-30-10 규칙을 무시한다. 전체 요약 10문장 읽기 → 032 22:26 ▲ 13 · 댓글 2 저정밀 연산으로 LLM 강화학습 안정화, FP8 파이프라인 전체 최적화 LLM의 추론·에이전트 능력 향상을 위해 강화학습이 중요 기법으로 자리잡았으며, FP8 양자화는 학습 속도를 높일 수 있으나 전체 파이프라인에서 안정성 유지가 과제였다. AI · 머신러닝 · Towards Full Pipeline FP8 Reinforcement Learning for LLMs
Key Point 저정밀 연산(FP8)으로 LLM 강화학습 속도를 높이면서도 BF16 수준의 안정성을 유지할 수 있게 되어, 대규모 모델의 효율적인 학습이 실무에서 더 현실적으로 가능해진다.
핵심 요약
LLM의 추론·에이전트 능력 향상을 위해 강화학습이 중요 기법으로 자리잡았으며, FP8 양자화는 학습 속도를 높일 수 있으나 전체 파이프라인에서 안정성 유지가 과제였다. 기존 연구는 TIS 같은 보정 기법으로 훈련-추론 불일치를 해결했지만, 전체 FP8 강화학습 파이프라인에서는 여전히 심각한 불안정성이 발생한다. 문제는 훈련 중 갑작스런 엔트로피 급상승과 출력 왜곡으로 나타나는데, 근본 원인은 누적된 FP8 양자화 잡음이 중요도 비율을 왜곡해 음수 이득 토큰을 신뢰 영역 밖으로 밀어내고 그래디언트를 잘못 영점화한다는 점이다. 전체 요약 6문장 읽기 → 033 12:11 ▲ 15 · 댓글 2 1% 토큰으로 충분할 수도, 그래디언트 추정의 효율성 학생 모델 학습 시 교사 모델의 감독을 소수 토큰에만 할당하는 희소 온폴리시 증류(OPD) 기법의 그래디언트 추정 문제를 분석했다. AI · 머신러닝 · 1% of Tokens Can Be Enough: On Gradient Estimation in On-Policy Distillation
Key Point 효율적인 모델 학습을 위해 어떤 토큰에 교사 감독을 할당할지 결정하는 문제에서, 단순한 유용성 평가뿐 아니라 그래디언트 추정 안정성도 고려해야 한다는 실질적 통찰을 제시한다.
핵심 요약
학생 모델 학습 시 교사 모델의 감독을 소수 토큰에만 할당하는 희소 온폴리시 증류(OPD) 기법의 그래디언트 추정 문제를 분석했다. 다음 토큰 샘플링으로부터 계산한 그래디언트가 노이즈를 많이 포함할 수 있으며, 신호 대 잡음 분해를 기반으로 정보 효율성 비율(IER)을 제안했다. IER은 토큰 선택 과정에서 유용성 점수와 결합되어 기존 방식보다 그래디언트 추정 신뢰성을 높인다. 전체 요약 4문장 읽기 → 034 11:10 당일 +2,870 AI 코딩 에이전트를 위한 디자인 언어 'Impeccable' 공개 Anthropic의 frontend-design 기초에서 출발한 디자인 스킬 'Impeccable'을 공개했습니다. AI · 머신러닝 · pbakaus/impeccable · JavaScript
Key Point AI 코딩 에이전트가 생성하는 프론트엔드 디자인의 반복적이고 단조로운 패턴을 구조적으로 개선하는 툴이 필요한 개발팀에게 실질적인 솔루션을 제공합니다.
핵심 요약
Anthropic의 frontend-design 기초에서 출발한 디자인 스킬 'Impeccable'을 공개했습니다. 23개의 명령어(`init`, `craft`, `audit`, `polish`, `animate` 등)로 AI에게 디자인 작업의 공통 언어를 제공합니다. 설정 시 PRODUCT.md에 제품의 타겟 사용자, 목적, 제약사항, 톤앤매너 등 지속 가능한 정보를 기록해 일관성 있는 디자인을 유도합니다. 전체 요약 5문장 읽기 →