쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
55건 · "세계 모델"조건 지우기 ×
001 15:11 ▲ 51 · 댓글 3 운전 시뮬레이션의 정확성을 높이는 BirdDreams 논문 자율주행 시뮬레이션을 위한 세계 모델은 주행자 행동에 따른 장면 변화를 예측해야 하는데, 정적 레이아웃에만 의존하는 기존 방식의 한계가 있다. AI · 머신러닝 · BirdDreams: Joint Perspective and BEV Video Generation for a Plausible, Reactive Driving World Model
Key Point 자율주행 시뮬레이션에서 현실적인 장면 재구성은 필수이며, 정적 레이아웃 대신 미래 배치를 예측하는 이 접근법은 자동차의 정확한 제어와 주변 객체의 자연스러운 운동 생성을 동시에 달성하는 새로운 방식이다.
핵심 요약
자율주행 시뮬레이션을 위한 세계 모델은 주행자 행동에 따른 장면 변화를 예측해야 하는데, 정적 레이아웃에만 의존하는 기존 방식의 한계가 있다. BirdDreams는 1인칭 시점 영상과 조감도(BEV) 영상을 함께 생성하는 자동회귀 모델로, 미래 장면의 레이아웃을 예측의 일부로 만든다. BEV는 도로와 차량을 간단한 형태로 일정 스케일로 표시해 위에서 본 위치와 동작을 명확히 보여주고, 정적 시점은 신호등과 물체 외형 같은 세부 정보를 담는다. 전체 요약 8문장 읽기 → 002 03:11 ▲ 14 · 댓글 4 단백질 진화에 최적화된 뮤테이션 예측 모델 공개 깊은 변이 스캐닝 데이터로 사전학습한 ProTEUS는 서열, 진화, 구조 정보를 MutationFormer 아키텍처로 통합 표현하며, 변이체를 잠재 공간의 상태로, 돌연변이를 그 기능적 결과를 예측하는 행동으로 모델링한다. AI · 머신러닝 · ProTEUS: A mutation-resolved world model for closed-loop protein evolution
Key Point 단백질 설계에서 실험 스크리닝으로는 탐색 불가능한 조합적 돌연변이 공간을 효율적으로 탐색하는 AI 모델이 나왔으며, 실제 실험으로 10배 이상의 성능 개선을 입증했다.
핵심 요약
깊은 변이 스캐닝 데이터로 사전학습한 ProTEUS는 서열, 진화, 구조 정보를 MutationFormer 아키텍처로 통합 표현하며, 변이체를 잠재 공간의 상태로, 돌연변이를 그 기능적 결과를 예측하는 행동으로 모델링한다. 기하학적 제약 강제를 통해 AlphaFold3 대비 10배 이상 빠른 물리적으로 타당한 전체 원자 예측 엔진을 개발해 많은 변이체 탐색을 지원한다. 실험 피드백 루프를 통해 단백질 활성 예측을 반복 개선하면서 원하는 표현형으로 진화를 유도한다. 전체 요약 6문장 읽기 → 003 18:11 ▲ 23 · 댓글 5 비디오·행동을 함께 학습하는 세계 모델 SWAM 공개 언어-비디오 정렬을 학습한 기반 위에 행동 학습을 추가할 때 기존 정렬이 훼손될 수 있다는 문제를 중점 연구했다. AI · 머신러닝 · SWAM: Scaling World Action Models with Cross-Modal Alignment
Key Point 로봇 제어를 위한 세계 모델의 언어-비디오 정렬 유지 전략이 명확해져, 동작 학습 시 기존 이해 능력을 보존하면서 행동 능력까지 확장하려는 연구자들에게 실질적인 지침을 제공한다.
핵심 요약
언어-비디오 정렬을 학습한 기반 위에 행동 학습을 추가할 때 기존 정렬이 훼손될 수 있다는 문제를 중점 연구했다. 약 47,000시간의 일반 비디오, 1인칭 시점 비디오, UMI 데모, 로봇 데모를 수집하여 데이터 풀을 구성했다. 언어-비디오 감시, 언어-비디오-행동 감시, 두 형태를 결합한 학습이 세계 행동 모델(WAM) 성능에 어떻게 영향 미치는지 체계적으로 분석했다. 전체 요약 9문장 읽기 → 004 15:11 ▲ 26 · 댓글 2 로봇 손가락 조작, 앞선 시각 감각으로 성공률 11% 높였다 정교한 손가락 조작을 위해 로봇이 장면과 손의 공간 변화를 미리 예측해야 하는데, 기존 방식은 명시적 미래 예측에 의존했다. AI · 머신러닝 · DexForesight: Grounding Dexterous Policies with Implicit Spatial Foresight
Key Point 로봇이 손가락 관절의 복잡한 움직임을 미리 예측하는 방식이 기존 대비 단순화되면서, 실제 환경에서 정교한 조작 작업의 성공률이 크게 올랐다.
핵심 요약
정교한 손가락 조작을 위해 로봇이 장면과 손의 공간 변화를 미리 예측해야 하는데, 기존 방식은 명시적 미래 예측에 의존했다. DexForesight는 세계 모델을 정책의 잠재 공간에 주입해 공간 예측을 암묵적으로 학습하는 프레임워크다. 오프라인 장면 깊이 정보, 손 기하학, 시연 궤적으로부터 행동 조건부 세계 모델을 학습한다. 전체 요약 8문장 읽기 → 005 15:10 ▲ 58 · 댓글 2 세계 지능형 모델 평가를 위한 통합 인프라 'WorldFoundry' 공개 시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. AI · 머신러닝 · WorldFoundry: Towards Unified Infrastructure for World Intelligence
Key Point 세계 모델링 연구에서 단순한 시각적 생성을 넘어 인과성 있는 상태 예측과 제어 가능성을 다룰 수 있는 통합 평가 인프라가 나타났으며, 270개 모델과 74개 벤치마크를 하나의 프레임워크로 통합한 점이 재현성과 비교 가능성의 새로운 기준을 제시한다.
핵심 요약
시각 생성 모델이 환경 시뮬레이션과 합성 관찰 사이의 경계를 모호하게 만들고 있지만, 시각적 그럴듯함만으로는 참된 세계 모델링이 아니며 지속적 상태, 물리 역학, 인과적으로 일관된 상호작용 응답이 필요함을 지적한다. 생성형 세계 모델을 환경의 지속적이고 이력 기반의 표현을 유지하며, 행동이나 개입에 대응해 표현을 업데이트하고, 관찰된 상황과 반사실적 개입의 결과를 반영하는 시간적으로 일관된 궤적을 생성하는 예측 동적 시스템으로 정의한다. 지각적 기초, 지속적 상태 모델링, 제어 가능한 변환, 역학 인식 예측, 폐루프 상호작용을 아우르는 지능 지향 프레임워크를 제시한다. 전체 요약 8문장 읽기 → 006 15:10 ▲ 52 · 댓글 3 로봇 자율성 향상, 다중에이전트 프레임워크로 실적 2배 이상 돌파 파운데이션 모델로 로봇 제어를 하되 자율성을 오래 유지하려면 효율적인 컨트롤과 실패 복구가 필요하다. AI · 머신러닝 · Toward the Era of Agentic Embodied Intelligence
Key Point 로봇의 자율적 행동 성능을 2배 이상 끌어올린 프레임워크가 공개될 예정이며, 실제 가정용 로봇 작업에서의 높은 성공률과 빠른 학습 속도는 구체화 AI 실용화에 새로운 기준을 제시한다.
핵심 요약
파운데이션 모델로 로봇 제어를 하되 자율성을 오래 유지하려면 효율적인 컨트롤과 실패 복구가 필요하다. 연구팀이 A2-MEAS라는 구체화 다중에이전트 프레임워크를 제안했으며, 이는 코드를 확장 인터페이스로 삼는다. 수정 코드는 수정 언어, 공간 증거, 실행 이력, 행동 제안을 결합하며, MetaBrain이 학습 감독과 런타임 지도를 제공한다. 전체 요약 12문장 읽기 → 007 15:11 ▲ 31 · 댓글 2 통합 멀티모달 모델용 대규모 대화형 데이터셋 공개 통합 멀티모달 모델(UMM)은 시각 이해, 생성, 편집을 하나의 프레임워크에서 수행하지만 기존 데이터셋은 단순 작업 중심이었다. AI · 머신러닝 · YANAMI: A Large-Scale Multimodal Dataset and Benchmark for Multiturn Stateful Interaction
Key Point 멀티모달 AI가 단순 일회성 작업을 넘어 복잡한 대화 흐름에서 상태를 정확히 관리해야 하는 시대에, 이를 평가할 첫 대규모 벤치마크가 공개되었기 때문이다.
핵심 요약
통합 멀티모달 모델(UMM)은 시각 이해, 생성, 편집을 하나의 프레임워크에서 수행하지만 기존 데이터셋은 단순 작업 중심이었다. 최근 다중 턴 데이터셋도 각 턴을 독립적으로 풀 수 있어, 대화 상태를 추적하고 유지해야 하는 상태형 상호작용을 평가하기 부족했다. YANAMI는 상태형 상호작용을 위한 첫 대규모 멀티모달 대화 데이터셋으로 YANAMI-400K와 YANAMI-Bench로 구성된다. 전체 요약 8문장 읽기 → 008 12:11 ▲ 18 · 댓글 1 과거 정보로 일관성 높인 장시간 영상 생성 모델 적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. AI · 머신러닝 · History Forcing: Distilling History-Dependent Continuations for Long-Horizon Video World Models
Key Point 긴 장면에서도 일관성 있는 영상을 생성하는 것이 영상 AI 모델의 핵심 과제인데, 이 논문이 제시한 History Forcing 방법이 화면 밖 재등장이나 60초 롱폼 생성에서 구체적 성능 개선을 이뤄냈기 때문이다.
핵심 요약
적은 단계의 자동회귀 비디오 확산 모델은 효율적인 생성이 가능하지만, 피사체나 장면이 화면 밖에 나갔다 다시 등장할 때 일관성을 유지하기 어렵다. 기존 증류 방법들은 역사적 정보를 충분히 활용하지 못해 학생 모델의 현재 예측을 제약하지 못한다는 한계가 있다. 이를 해결하기 위해 History Forcing이라는 통합 온폴리시 증류 프레임워크를 제안했다. 전체 요약 7문장 읽기 → 009 00:11 ▲ 26 · 댓글 1 비디오 세계 모델의 예측 오차, 물리적 놀라움을 재대로 측정하지 못한다 비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. AI · 머신러닝 · When Does Latent Prediction Error Support Physical Surprise Claims in Video World Models?
Key Point 비디오 AI가 물리 법칙을 이해한다고 판단하는 기준(예측 오차)이 실제로는 색상·모양 변화에도 반응해 신뢰성이 낮다는 점을 밝혀, 세계 모델 평가 방식의 재검토가 필요함을 보여준다.
핵심 요약
비디오 생성 AI의 예측 오차는 물리적으로 불가능한 사건을 감지하는 지표로 사용되지만, 실제로는 물체 색상·모양 변화나 일반적인 예측 어려움도 함께 반영된다. 연구팀은 고정된 표현이 무엇을 담고 있는지, 물리적 변화와 겉모습 변화를 어떻게 구별하는지, 모델의 예측 오차를 무엇이 변화시키는지 분리해 평가하는 프레임워크를 개발했다. IntPhys2 벤치마크에서 V-JEPA2 모델을 포함한 여러 표현(잠재 예측, 마스킹된 픽셀 재구성, 시각 통계)을 비교한 결과, 물리적 가능성·불가능성에 대한 정보는 적게 포함했다. 전체 요약 8문장 읽기 → 010 12:11 ▲ 148 · 댓글 8 라즈베리파이 피코에서 신경망 게임 엔진 구현 임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. AI · 머신러닝 · A tiny world model running games on a Raspberry Pi Pico 2 W
Key Point 라즈베리파이 같은 극도로 제한된 임베디드 환경에서 신경망으로 게임을 생성하고 플레이하는 새로운 방식이 작동한다는 것을 보여주며, 마이크로컨트롤러에서 머신러닝 모델을 실행하는 방법의 한계를 재정의한다.
핵심 요약
임베디드 마이크로컨트롤러인 라즈베리파이 피코 2 W에서 신경망 기반 게임 엔진을 구현했다. 세계 모델 네트워크가 현재 프레임과 액션에서 다음 프레임과 보상을 예측하고, 액터 네트워크가 그 생성된 프레임에서 액션을 선택한다. 반복 트랜스포머(looped transformer) 구조를 사용해 같은 가중치를 1~4회 반복 적용함으로써 메모리 효율을 높였다. 26k~131k 매개변수의 세계 모델과 9k~16k 매개변수의 액터 네트워크를 탑재했다. 브레이크아웃(정확도 99.99%), 플래피 버드(100%), 팩맨 라이트(86.4%) 등 5개 게임을 구현했으며, 각 게임은 토큰 기반으로 분할된 프레임을 처리한다. 세계 모델은 배경 셀은 독립적으로 예측하되, 공이나 플레이어 같은 단일체는 한 번만 배치되도록 디코딩 규칙을 적용했다. 전체 요약 12문장 읽기 → 011 18:11 ▲ 151 · 댓글 2 로봇 제어 성능 높이는 물리 역학 이해 모델 PDRVLA 로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. AI · 머신러닝 · PDRVLA: A Vision-Language-Action Model with Physical Dynamics Representations
Key Point 로봇 제어 시뮬레이션에서 최고 수준의 성공률을 달성한 새로운 방식이 기존 비디오 생성 방식의 지연 문제를 해결하고 공개 데이터만으로 학습 가능함을 보여준다.
핵심 요약
로봇의 시각·언어 명령 처리 모델(VLA)이 물리 역학을 충분히 이해하지 못하는 문제를 해결하기 위해 PDRVLA를 개발했다. 기존 비디오 세계 모델은 동역학을 포착하지만 미래 프레임을 생성해야 해 제어 지연이 발생하는데, PDRVLA는 가벼운 물리역학 모듈로 온라인 비디오 생성 없이 행동 생성을 조건화한다. 이 모듈은 미래 RGB, 깊이, 광학 흐름(optical flow) 특성을 직접 예측하며, 동결된 사전 학습 비디오 세계 모델을 통해 보조 감시를 받는다. 전체 요약 6문장 읽기 → 012 12:11 ▲ 126 · 댓글 2 사용자 명령을 따르는 자유형 비디오 세계 모델 'Hy-Nomas' 공개 Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. AI · 머신러닝 · Hy-Nomas: Towards Free-form Interactive World Generation
Key Point 대화형 AI 환경에서 사용자 명령을 정확히 따르면서도 과거 맥락을 유지하는 능력은 게임, 시뮬레이션, 메타버스 등 차세대 인터랙티브 콘텐츠 개발의 핵심 과제이며, 이 논문의 기술적 접근이 실제 적용에 어떻게 영향을 미칠지 주목할 필요가 있다.
핵심 요약
Hy-Nomas는 연속적인 사용자 명령을 따르면서 이전 상호작용 기록과 결과를 유지하는 대화형 세계 생성 모델이다. 80억 파라미터 규모의 확산 모델을 기반으로 자유형 텍스트 지시와 멀티턴 카메라 제어를 지원한다. 구조화된 비디오 자막과 행동 인식 인과 주의 메커니즘을 결합해 설명 맥락은 여러 세그먼트에서 접근 가능하면서 행동 명령은 해당 시간 윈도우로만 제한된다. 전체 요약 6문장 읽기 → 013 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 014 12:11 ▲ 27 · 댓글 2 동영상 세계 모델을 명시적 토큰으로 제어하는 'World-in-Context' Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. AI · 머신러닝 · World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Key Point 비디오 생성 모델에서 시점과 동작 제어를 명시적 토큰으로 통일한 새로운 접근이 기존 대형 모델(22B)과 같은 성능을 훨씬 작은 모델(5B)에서 달성하는 방식의 전환을 보여준다.
핵심 요약
Interactive video world modeling은 시점, 캐릭터 동작, 카메라 움직임을 조정해야 하는데, 기존 방식은 이들을 텍스트에 숨기거나 혼재시키고 분산된 구조로만 제어했다. World-in-Context는 In-Context Conditioning(ICC) 방식으로 시점, 동작, 카메라 제어를 명시적 토큰으로 통일하고 Self-Attention 공간에 직접 포함시킨다. 명시적 시점 토큰은 충돌하는 역학을 분리하고 단일 시점 데이터에서 시점 전환을 창발적으로 가능케 하며, 동작과 카메라는 각각 지역적 반응성과 전역적 안정성을 보완한다. 전체 요약 6문장 읽기 → 015 21:12 ▲ 298 · 댓글 2 비디오 기초 모델부터 세계 모델까지, 영상 이해와 생성의 통합 관점 비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. AI · 머신러닝 · Reading, Writing, Sharing, and Interacting with the World through Video
Key Point 비디오 이해와 생성의 현주소를 통합적으로 정리한 메타 서베이로, 향후 연구의 방향성이 '보이는 것'에서 '일어나는 일'의 타당성으로 전환되고 있음을 보여준다.
핵심 요약
비디오 기초 모델은 시각 시퀀스의 이해와 생성에 급속히 발전해온 반면, 비디오 세계 모델은 그 속 세계의 동역학을 포착하려 한다. 이 논문은 세계 모델링을 통합 렌즈로 삼아 두 분야를 함께 조망한다. 관찰된 비디오를 잠재된 시간적 세계의 부분적·손실적·시간순 투영으로 보고, 네 가지 보완적 작업으로 문헌을 정리한다: reading은 비디오에서 세계 성질을 추론하고, writing은 지정되거나 학습된 세계 조건에서 비디오를 생성하며, sharing은 공통 모델링 메커니즘을 통해 이해와 생성을 통합하고, interacting은 행동과 진화하는 관찰 아래서 세계 상태를 예측하고 업데이트한다. 전체 요약 5문장 읽기 → 016 18:11 ▲ 34 · 댓글 2 세계 모델과 멀티모달 에이전트 분리 평가 프레임워크 공개 World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. AI · 머신러닝 · Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Key Point 멀티모달 에이전트와 세계 모델의 상호작용을 처음 체계적으로 분리 평가하는 프레임워크로, 현재 AI 시스템들이 실제 협력에서 왜 실패하는지 진단할 수 있는 벤치마크를 제공한다.
핵심 요약
World Model(WM)이 시뮬레이션된 경험으로 Multimodal Agent(MA)를 지원하고, 에이전트 궤적이 WM 개선에 기여하는 상호작용을 평가하기 위해 액션 선택과 상태 진화에 대한 별도의 증거가 필요하다. Dual Exam은 고정된 환경 응답 메커니즘 하에서 에이전트를, 고정된 액션 개입 하에서 WM을 테스트하며, 물리·디지털·사회·과학 도메인을 다룬다. 에이전트 트랙은 10개 구성으로 1,088개 항목을 15개 보고 카테고리로 평가하고, WM 트랙은 8개 시나리오에서 400개 케이스를 포함한다. 전체 요약 8문장 읽기 → 017 18:11 ▲ 37 · 댓글 3 자연언어로 세계 모델을 학습하는 LaLa-World JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. AI · 머신러닝 · LaLa-World: Scaling Latent World Models with Natural Language Actions
Key Point 로봇과 시뮬레이션, 실제 비디오 데이터를 모두 활용하는 통합 세계 모델로 기존 분산 학습 대비 훨씬 효율적인 계획과 정책 학습이 가능해진다.
핵심 요약
JEPA 스타일의 잠재 세계 모델(LWM)이 비디오 생성 모델처럼 언어 인터페이스를 채택하면 서로 다른 도메인과 데이터 소스에서 학습할 수 있음을 보였다. LaLa-World는 시뮬레이션, 로봇 궤적, 이미지, 비디오 데이터를 함께 학습하는 언어 조건부 잠재 세계 모델이다. 수치형 액션과 시각적 변화를 모두 자연언어로 표현하여 이질적인 데이터셋에 대해 단일 미래 예측기를 학습할 수 있다. 전체 요약 8문장 읽기 → 018 03:11 ▲ 22 · 댓글 1 로봇 조작에 코드 기반 계획을 결합한 새로운 AI 모델 기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. AI · 머신러닝 · Agentic World Action Models
Key Point 로봇 조작 AI에서 시각 예측과 코드 기반 계획의 gap을 처음으로 메운 모델이며, 재사용 가능한 기술 라이브러리와 자동 학습 파이프라인을 제시해 실제 로봇 시스템의 확장성을 높일 수 있는 방법을 제안한다.
핵심 요약
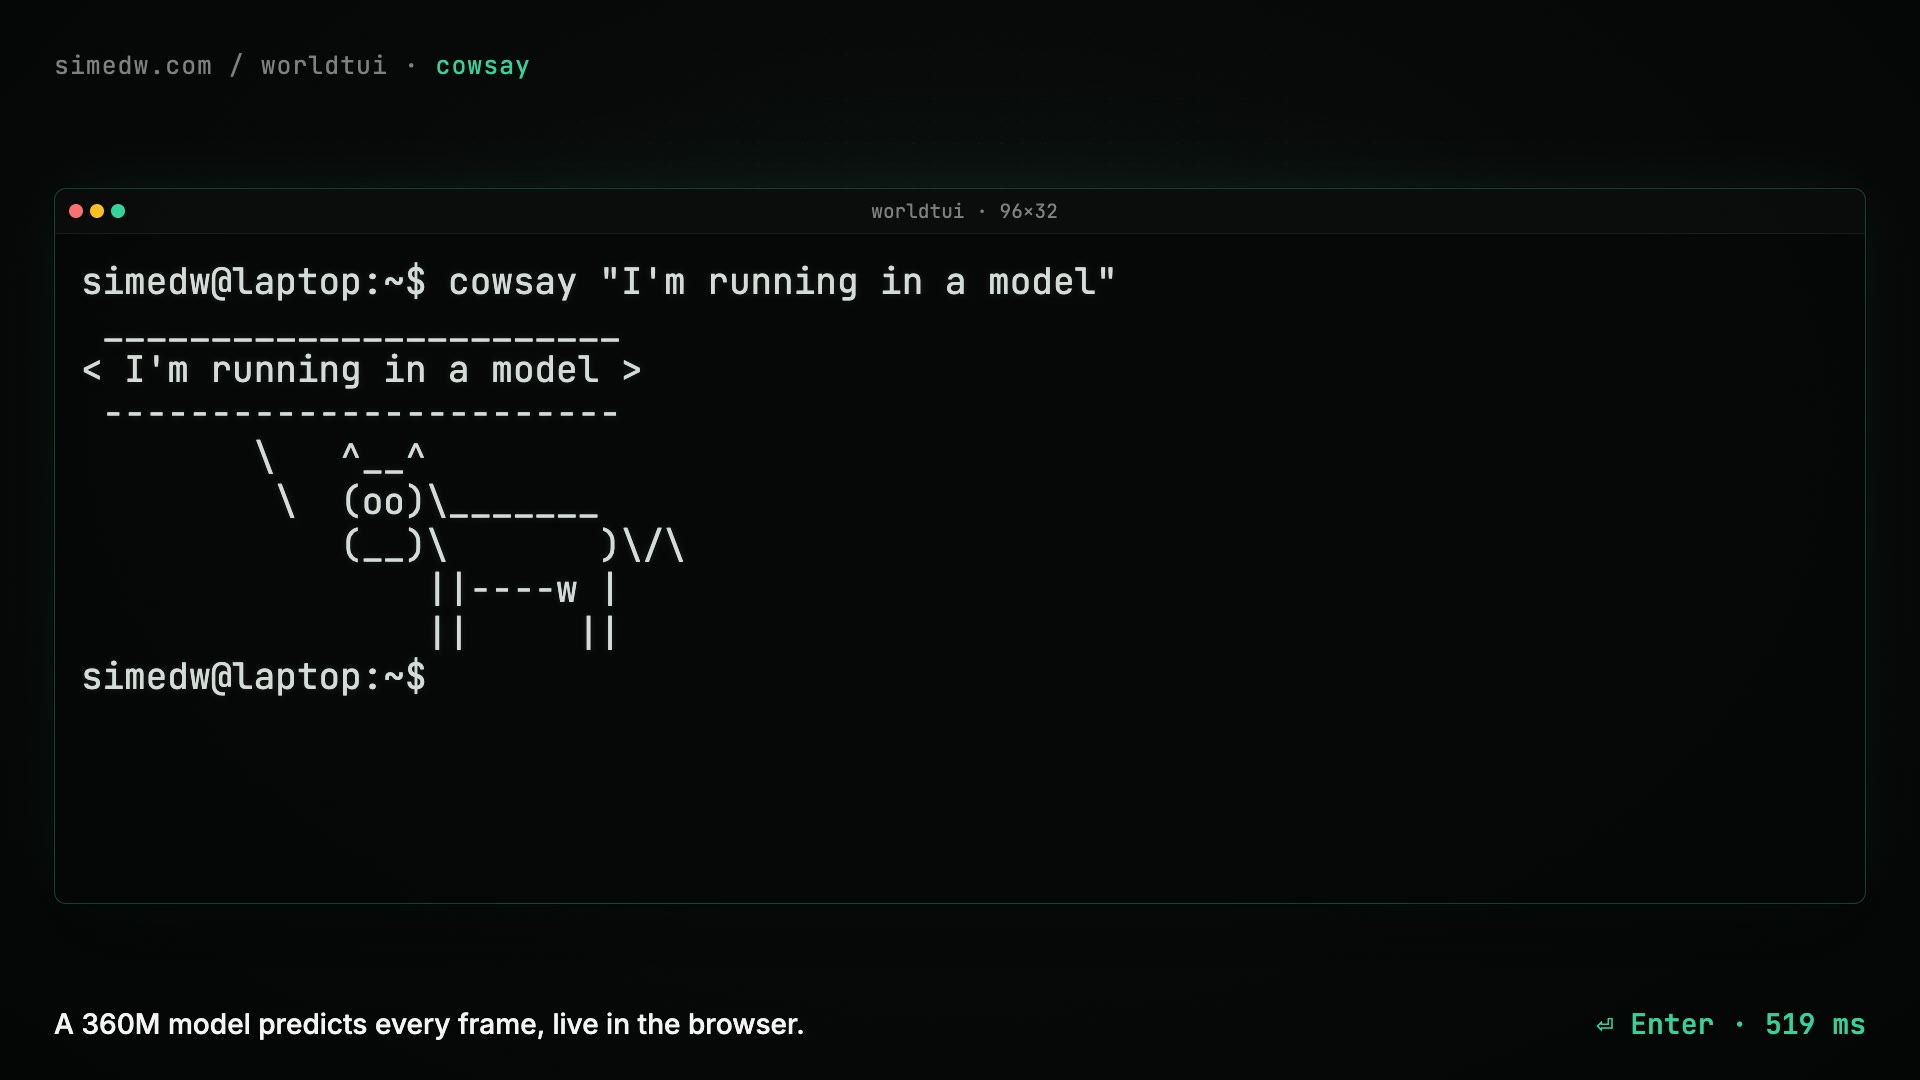
기존 세계 행동 모델(WAM)은 로봇 조작을 위한 시각적 예측은 제공하지만 기술을 재사용할 수 있는 명시적 메커니즘이 부족했다. 코드 기반 계획 로봇공학은 재사용 가능한 기술을 제공하지만 물리 역학의 예측 기반이 약해 현실과의 연결 고리가 약했다. 이를 해결하기 위해 AW-0이라는 에이전트형 세계 행동 모델을 제시했으며, 코드 기반 계획을 영상·행동 예측과 통합한다. 전체 요약 9문장 읽기 → 019 18:11 ▲ 169 · 댓글 53 360M 모델로 터미널 에뮬레이터 만들기 360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. AI · 머신러닝 · WorldTUI: I trained a 360M model to pretend to be a terminal
Key Point 시뮬레이션·에뮬레이션 구현 없이 자가 수정 학습과 병렬 디코딩으로 소형 모델을 브라우저에서 구동 가능한 터미널 에뮬레이터로 만든 기술 구현 사례로, 제약된 환경에서 큰 모델의 능력을 소형화하는 방법을 보여준다.
핵심 요약
360M 파라미터 언어 모델을 파인튜닝해 실제 쉘 없이 터미널처럼 동작하는 에뮬레이터를 개발했으며, 각 키 입력마다 모델이 화면 변화를 예측한다. 파일 생성, vim과 tmux 실행, 스네이크 게임 등이 가능하고, 자신의 실수를 수정하는 능력과 행(row)을 병렬로 디코딩하는 기술로 성능을 크게 개선했다. 터미널을 문자 그리드로 모델링했으며, Qwen2.5-Coder-0.5B를 기반으로 Docker에서 실제 프로그램 실행 기록으로 파인튜닝했다. 전체 요약 14문장 읽기 → 020 15:11 ▲ 26 · 댓글 2 세 가지 능력을 하나로 담은 시각 인코더 ALPS 공개 World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. AI · 머신러닝 · ALPS: Visual State Encoders for World Models
Key Point 월드 모델의 비전 백본이 예측, 제어, 검증을 모두 지원할 수 있는 통합 인코더를 처음 제시하여 로봇 학습 파이프라인의 설계 방식을 바꿀 수 있다.
핵심 요약
World models의 시각적 기초로서 물리 상태 정보, 자연어 정렬, 픽셀 재구성을 모두 지원해야 한다는 주장에서 출발한 연구이다. 기존 인코더는 이 세 가지 중 하나나 둘만 담당하는 반면, ALPS는 ViT-B/16 기반 프리트레인된 시각 상태 인코더로 세 능력을 모두 통합한다. 정지 이미지와 텍스트만 사용하여 언어, 재구성, 공간적 대응 목표로 처음부터 학습한 후 교차 뷰 자기 증류로 미세 조정했다. 전체 요약 7문장 읽기 → 021 15:11 ▲ 141 · 댓글 2 인간·로봇 동작 예측 통합 모델 'Ropedia W0' 공개 세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. AI · 머신러닝 · Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
Key Point 인간의 움직임 데이터로 학습한 로봇 제어 모델이 현실에서 어떻게 작동할지를 보여주는 기초 연구로, 로봇 에이전트의 자율성 향상에 필요한 예측 능력의 스케일링 가능성을 제시한다.
핵심 요약
세계 모델을 통해 구체화된 에이전트(로봇·인간)의 행동 결과를 예측할 수 있는데, 다양한 체형의 이동과 조작을 동시에 모델링하기는 어려웠다. Ropedia W0은 인간과 로봇을 아우르는 첫 자아중심형 이동·조작 월드 파운데이션 모델로, 10,000시간의 인간 시점 영상과 3,000시간의 로봇 데이터(통합 멀티모달 주석 및 품질 관리 포함)로 구성된 Xp-Data를 수집했다. 이동은 카메라 포즈로, 조작은 투영된 골격으로 인코딩하는 통합 운동학 표현을 사용하며, 로봇 골격은 체형별 순기구학과 광범위한 수동 키포인트 주석·수정을 결합한다. 전체 요약 8문장 읽기 → 022 21:11 당일 +174 에이전트를 위한 타입 안전 그래프 DB, Omnigraph 공개 Rust로 만든 Omnigraph는 오브젝트 스토리지 네이티브 그래프 데이터베이스로, 장기간 실행되는 에이전트들이 공유하는 타입 안전 세계 모델을 위해 설계됐다. 오픈소스 · 도구 · ModernRelay/omnigraph · Rust
Key Point AI 에이전트가 공유 상태를 안전하게 읽고 쓸 수 있는 데이터 계층이 필요할 때, Git 워크플로우와 정책 기반 접근 제어를 갖춘 오픈소스 솔루션이 나왔다.
핵심 요약
Rust로 만든 Omnigraph는 오브젝트 스토리지 네이티브 그래프 데이터베이스로, 장기간 실행되는 에이전트들이 공유하는 타입 안전 세계 모델을 위해 설계됐다. 타입 온톨로지(`.pg` 스키마로 노드·엣지 타입, 키, 제약 선언)를 통해 에이전트들이 통일된 도메인 모델을 강제할 수 있으며, 모든 쓰기에서 엔진이 검증한다. 그래프 순회, 벡터 검색(ANN), 전문 검색, 상호 순위 융합을 한 번의 쿼리로 처리하는 통합 검색 엔진으로 높은 정확도의 컨텍스트를 조립할 수 있다. 전체 요약 11문장 읽기 → 023 21:11 ▲ 16 · 댓글 2 짧은 영상으로 장시간 예측하는 세계 모델 훈련법 스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. AI · 머신러닝 · Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
Key Point 짧은 영상만으로 학습한 생성 모델이 장기간 예측에서 표류하는 근본적 문제를 해결하는 새로운 훈련 방식으로, 비용 높은 교사 모델 없이도 안정적인 장시간 롤아웃을 만들 수 있다.
핵심 요약
스트리밍 비디오 세계 모델은 행동 조건에 따라 미래를 청크 단위로 생성하는데, 짧은 클립으로만 훈련되면 시간이 지날수록 예측 오차가 누적되어 표류한다. 기존 방식은 분포 일치 증류(DMD)로 모델 자신의 예측을 다시 훈련하지만, 외부 교사는 행동을 모르고 내부 교사도 같은 문제로 고통받는다. 프레셰 거리(Fréchet Distance)를 활용한 프레셰 포싱(Fréchet Forcing) 기법을 제안한다: 생성적 앵커링은 실제 데이터로 끝나는 자체 생성 이력에 플로우 매칭 손실을 적용하고, 문맥 충실도는 각 클립의 자유 롤아웃 통계와 실제 통계 간 거리를 계산해 장면 일관성을 유지하며, 현실성 일치는 고정된 지각 공간에서 생성 프레임과 실제 프레임 간 거리를 측정한다. 전체 요약 5문장 읽기 → 024 18:11 ▲ 12 · 댓글 2 숨은 상태까지 관리하는 게임형 AI 비디오 생성 시스템 기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. AI · 머신러닝 · State World Models: Execute the Rules, Generate the Pixels
Key Point 기존 AI 비디오 생성 모델들은 화면에 보이지 않는 게임 상태를 제대로 추적하지 못하는데, 이 논문은 상태 관리 시스템을 도입해 규칙 준수율을 32%에서 92%로 끌어올린 방법을 제시한다.
핵심 요약
기존 비디오 생성 AI는 단일 이미지에서 카메라 움직임을 중심으로 영상을 생성하지만, 화면에 보이지 않는 상태(hidden state)에 따라 결과가 달라지는 상호작용을 제대로 처리하지 못한다. Stateful Harness는 세계 상태 관리와 비디오 렌더링을 분리하는 프레임워크로, 정해진 규칙에 따라 세계 상태를 진화시키고 각 단계마다 비디오 모델로 장면을 생성한 뒤 다음 턴의 상태 업데이트에 활용한다. 사용자가 선택한 행동을 해석하고 3D 씬의 미리보기를 통해 공간과 카메라 위치를 제시하며, 생성된 비디오 클립으로 다시 세계 상태를 갱신하는 순환 구조를 갖춘다. 전체 요약 7문장 읽기 → 025 15:11 ▲ 24 · 댓글 2 비디오 세계 모델의 실행 능력 진단, 메모리 테스트 분리 비디오 세계 모델 평가에서 장면 설정, 변화 실행, 결과 표시를 하나의 점수로 묶으면 낮은 점수를 메모리 부족으로 오인하기 쉽다. AI · 머신러닝 · Execution Before Memory: Diagnosing Memory Failures in Video World Models
Key Point 비디오 세계 모델이 메모리 부족이 아니라 '변화 실행' 능력 부족이라는 근본 원인을 규명하고, 이를 개선하는 방법을 제시하기 때문에 지금 읽을 가치가 있습니다.
핵심 요약
비디오 세계 모델 평가에서 장면 설정, 변화 실행, 결과 표시를 하나의 점수로 묶으면 낮은 점수를 메모리 부족으로 오인하기 쉽다. 변화가 실행되지 않으면 숨은 상태 전이가 나타날 수 없어, 실제로는 메모리를 테스트하지 못한다. 연구팀은 MIST 평가를 제안했으며, 이는 변화를 그것이 남길 메모리와 분리한다. 전체 요약 10문장 읽기 → 026 21:11 ▲ 40 · 댓글 3 로봇 학습에서 세계 모델과 행동 예측이 서로 강화할 수 있을까 세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. AI · 머신러닝 · Can World and Action Modeling Benefit Each Other under Unified Causal Training?
Key Point 로봇의 행동 학습과 환경 이해 모델을 같은 구조에서 동시에 훈련할 때 둘이 서로 강화하는 효과가 있는지를 첫 체계적으로 검증한 결과로, 로봇 학습의 효율성을 높일 새로운 방법론을 제시한다.
핵심 요약
세계 모델링(영상의 미래 예측)과 행동 모델링(정책 학습)의 상호작용을 조사하는 OneWM 프레임워크를 제안한다. 통합된 인과 학습 구조 하에서 행동을 세계 예측의 조건과 정책 학습의 목표로 동시에 취급한다. 지정된 행동이 주어졌을 때 그 시각적 결과를 예측하는 학습이 정책 성능과 일반화를 개선하는지 검증했다. 전체 요약 8문장 읽기 → 027 21:11 ▲ 11 · 댓글 3 비디오 세계 모델의 기억력 평가 벤치마크 등장 동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. AI · 머신러닝 · WorldMemBench: A Comprehensive Benchmark for Memory of Video World Models
Key Point 비디오 생성 AI가 시뮬레이션, 게임, 메타버스로 확장되면서 가상 세계의 일관성을 평가하는 표준 기준이 필요한 시점에 처음으로 체계화된 벤치마크가 나왔다.
핵심 요약
동영상 생성 AI가 더 길고 현실적인 상호작용을 가능하게 하면서 일관된 가상 세계를 유지하는 것이 핵심 과제가 되고 있다. 세계 기억력(world memory)은 시각 품질이나 영상 길이와 함께 평가해야 할 중요한 능력인데, 이를 체계적으로 측정할 방법이 없었다. 연구팀이 WorldMemBench를 개발했으며, 260개 테스트 케이스를 통해 정적 기억(사람의 정체성·외형, 물체 형태·배치, 환경 내용·구조)과 동적 기억(사건 진행, 상태 지속)을 평가한다. 전체 요약 7문장 읽기 → 028 18:11 ▲ 32 · 댓글 2 생성형 시뮬레이션의 규칙 검증, 이제 점수로 판단한다 기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. AI · 머신러닝 · OmniVerifier-C1: Decomposed Graded Verifier for Rule-Governed Generative World Modeling
Key Point 생성형 AI 시스템이 복잡한 규칙을 따르며 작동하는 세계 시뮬레이션으로 나아가려면, 이진 판정을 넘어 세밀한 점수 기반 검증이 필수적임을 보여준다.
핵심 요약
기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. 이 구조화된 해석 가능한 출력은 검증자의 도메인 외 멀티모달 작업으로의 일반화 성능을 높인다. Decoupled RL 학습 전략으로 하위 질문 수준의 이진 판단과 전역 정렬 점수를 동시 최적화하며, 정밀한 로컬 피드백으로 세밀한 검증 능력을 개발한다. 전체 요약 7문장 읽기 → 029 12:11 ▲ 31 · 댓글 2 생성 비디오의 3D 일관성을 평가하는 벤치마크 'Orbia' 공개 생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. AI · 머신러닝 · Orbia: Do Generated Videos Form a Consistent 3D World?
Key Point 생성 AI 비디오 모델이 시각적으로는 그럴듯하지만 기하학적으로 일관된 3D 세계를 구성하지 못하는 근본적 문제를 첫 체계적으로 평가할 수 있게 해준다.
핵심 요약
생성 비디오 모델이 만드는 장면이 실제로 일관된 3D 세계를 이루는지 체계적으로 평가하는 첫 벤치마크 'Orbia'가 발표되었다. 기존 벤치마크는 선별된 기하학적 성질만 테스트하거나 비전-언어 모델로 모호하게 일관성을 판단했으나, Orbia는 3D 일관성을 포괄적으로 측정한다. 입력 보존, 생성 콘텐츠 지속성, 3D 자체 일관성 세 가지 차원으로 평가를 구성했다. 전체 요약 8문장 읽기 → 030 03:12 ▲ 13 · 댓글 1 영상 세계 모델, 프레임률을 자유롭게 조절하다 기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. AI · 머신러닝 · RAR: Rate-Adaptive Rollout for Time-Consistent Interactive World Models
Key Point 세계 모델의 기본 제약인 프레임률 고정 문제를 해결하면 더 유연한 실시간 시뮬레이션과 로봇·게임 AI 개발이 가능해진다.
핵심 요약
기존 영상 기반 인터랙티브 세계 모델은 고정된 시간 속도로만 학습·생성되어, 실행 속도가 다르면 의도와 달리 느리거나 빠르게 진행되는 문제가 있었다. 또한 단일 프레임률로는 정교한 모션 캡처와 긴 시간 지평 사이의 트레이드오프를 피할 수 없었다: 높은 프레임률은 미세한 움직임을 포착하지만 컨텍스트 윈도우 내에서 짧은 기간만 커버한다. 논문이 제시하는 RAR(Rate-Adaptive Rollout)은 세계 모델이 제어 가능한 시간 속도로 생성할 수 있게 한다. 전체 요약 7문장 읽기 → 031 00:11 ▲ 12 · 댓글 2 GUI 에이전트의 지연 세계 행동 모델 기존 픽셀 기반 세계 모델은 GUI 에이전트에서 미래 화면을 생성한 뒤 재인식하는 두 단계 방식을 사용하지만, 화면 재구성의 높은 연산 비용과 행동 선택에 불필요한 세부 정보 재구성 문제가 있다. AI · 머신러닝 · Latent World Action Model for GUI Agents
Key Point 픽셀 재구성 대신 잠재 공간에서 행동 유도 변화를 예측함으로써 GUI 에이전트의 성공률을 40% 이상 높이고 추론 속도를 거의 100배 개선하는 새로운 접근법이다.
핵심 요약
기존 픽셀 기반 세계 모델은 GUI 에이전트에서 미래 화면을 생성한 뒤 재인식하는 두 단계 방식을 사용하지만, 화면 재구성의 높은 연산 비용과 행동 선택에 불필요한 세부 정보 재구성 문제가 있다. 현재 상태를 거의 그대로 보존하는 '항등성 단축' 문제가 발생해 행동으로 인한 변화를 제대로 포착하지 못한다. 본 논문은 GUI 세계 모델링을 전체 화면 재구성에서 행동 유도 미래 정보의 잠재 공간 예측으로 재정의했다. 전체 요약 8문장 읽기 → 032 21:11 ▲ 84 · 댓글 2 로봇 기초 모델 'GreenWAM' 공개, 20개 로봇 계열에서 통용 로봇이 필요한 세계 모델(행동의 결과 예측)과 정책(행동 선택)을 한 기초 모델이 모두 담당할 수 있는지 검증하는 연구다. AI · 머신러닝 · GreenWAM: A World Foundation Model for Robotics
Key Point 다양한 로봇 종류에서 작동하는 통합 기초 모델이 세계 모델과 정책을 모두 수행할 수 있음을 처음으로 입증하며, 로봇 비전 분야의 일반화 문제에 실질적 해법을 제시한다.
핵심 요약
로봇이 필요한 세계 모델(행동의 결과 예측)과 정책(행동 선택)을 한 기초 모델이 모두 담당할 수 있는지 검증하는 연구다. 로봇마다 다른 행동 표기법을 통합하기 위해 20개 로봇 계열(양팔 로봇부터 손가락까지 제어하는 휴머노이드까지)을 공통 관절 좌표로 설명하는 '공유 해부학적 행동 공간'을 구축했다. 세계 모델 모드, 행동-조건부 모드, 세계-행동 모드의 세 가지 방식으로 이들 로봇 계열을 함께 학습했고, 행동 전문가를 분리하는 정책 구조를 적용했다. 전체 요약 7문장 읽기 → 033 18:11 ▲ 24 · 댓글 1 로봇 비전-언어 모델과 세계 모델을 연결한 WAVE-0 공개 Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. AI · 머신러닝 · WAVE-0: Bridging VLA Policies and WAMs with Lightweight Latent Future Prediction
Key Point 기존 VLA 정책의 행동 결과 예측 부재 문제를 경량 세계 모델로 해결하고 실제 로봇 작업에서 35%p 향상을 이루어 실용적 로봇 조작 능력이 어떻게 개선되는지 보여준다.
핵심 요약
Vision-language-action(VLA) 정책은 로봇 조작에 뛰어나지만 행동의 환경적 결과를 명시적으로 모델링하지 않는 한계가 있다. World action models(WAM)은 미래 예측을 포함하지만 대부분 비용이 큰 비디오 생성에 의존하거나 대규모 영상 학습이 필요하다. WAVE-0(World-model-Augmented VLA Execution)은 경량 잠재 세계 모델로 VLA와 WAM을 연결하는 프레임워크다. 전체 요약 9문장 읽기 → 034 15:11 ▲ 63 · 댓글 2 AI 에이전트의 '실행 가능한 3D 세계' 만드는 능력을 평가하는 벤치마크 공개 코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. AI · 머신러닝 · ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
Key Point AI가 물리 법칙을 이해하고 실제로 동작하는 세계를 코드로 만들 수 있는지 평가하는 새로운 기준이 생겼으며, 현재 모델들의 근본적 한계를 파악할 수 있다.
핵심 요약
코딩 에이전트가 단순히 세계를 시각화하는 것을 넘어, 물리 법칙과 인과관계에 따라 동작하는 실행 가능한 코드 기반 세계를 구축하는 능력이 요구되고 있다. 기존 벤치마크는 물리 추론, 시각적 충실도, 행동 정확성을 각각만 평가했으나, 이 세 가지를 통합적으로 평가하지 못했다. 이를 해결하기 위해 ExeWorldBench라는 첫 번째 포괄적 벤치마크를 제시했으며, 코드 기반 3D 세계 구축을 통해 세계 이해와 실행 가능한 구현을 평가한다. 전체 요약 5문장 읽기 → 035 12:11 ▲ 64 · 댓글 1 픽셀 재구성 없이 로봇 제어하는 JEPA 모델 등장 Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. AI · 머신러닝 · LeWAM: End-to-End World and Action Modeling with JEPAs
Key Point 기존 세계 모델 방식을 통합해 로봇 제어 성공률을 3배 이상 높이고 계획 속도를 획기적으로 개선한 새로운 아키텍처로, 시뮬레이션과 실제 로봇 모두에서 실용성을 입증했다.
핵심 요약
Joint-embedding predictive architectures (JEPAs)는 픽셀 재구성 없이 간결한 잠재 세계 모델을 학습하는 방식인데, 기존 파이프라인은 시각 표현과 행동 조건 역학을 따로 학습한 뒤 정책을 추가했다. 레카이(LeWAM)는 엔드-투-엔드 JEPA로서 다음 잠재 상태 예측과 행동 흐름 매칭을 함께 학습하고, 잠재 상태에 등방 가우시안 제약을 적용한다. 이 설계로 하나의 모델이 정책 직접 실행과 학습된 잠재 역학으로 샘플 행동을 평가하는 효율적인 계획을 모두 지원할 수 있다. 전체 요약 6문장 읽기 → 036 12:11 ▲ 33 · 댓글 2 재귀적 자기개선 프레임워크로 코드부터 신약까지 성능 지속 개선 RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. AI · 머신러닝 · RSI-Anything: Unlocking Recursive Self-Improvement with World Models
Key Point 기존 외부 피드백 없이 정책이 스스로 개선되는 자기개선 프레임워크가 코드 수리부터 신약 발견까지 다양한 분야에서 실질적 성능 향상을 입증했기 때문이다.
핵심 요약
RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. 정책 진화 중 세계 모델 예측의 신뢰성 저하 문제를 해결하기 위해 관찰된 피드백을 통해 정책이나 워크플로우 개선과 조건부 세계 모델 적응을 진행한다. 성분·호환성 검사를 통해 업데이트된 정책-모델 쌍의 유지 여부를 결정한다. 전체 요약 8문장 읽기 → 037 00:11 ▲ 35 · 댓글 5 고정된 LLM이 자기 개선하는 Memento 3, 환경 학습에 성공 Memento 3는 동결된 LLM 에이전트가 외부 메모리를 통해 명시적 세계 모델을 지속적으로 학습하도록 하는 기법이다. AI · 머신러닝 · Memento 3: Model-Based Recursive Self-Improvement through Reflective Rulebooks
Key Point 기존 LLM은 세계 모델을 외부 메모리 없이 학습할 수 없었는데, Memento 3의 규칙책 기반 접근은 동결된 모델도 자율적으로 환경을 학습하고 자기 개선할 수 있음을 보여준다.
핵심 요약
Memento 3는 동결된 LLM 에이전트가 외부 메모리를 통해 명시적 세계 모델을 지속적으로 학습하도록 하는 기법이다. 에이전트는 자연언어 규칙책을 의미 기억으로 유지하며, 환경 역학의 수정 가능한 가설을 기록하면서 미지의 측면은 불완전하게 남긴다. 규칙책을 실행 가능한 코드로 컴파일하여 예측과 계획에 활용한다. 전체 요약 9문장 읽기 → 038 15:13 ▲ 52 · 댓글 2 다중 에이전트 1인칭 시점 세계 모델, 미세한 상호작용 구현 1인칭 시점 세계 모델은 에이전트의 행동에 따른 관찰을 예측하지만, 기존 연구는 단일 에이전트에 집중했다. AI · 머신러닝 · Multi-Agent Egocentric World Model with Fine-Grained Embodied Interaction
Key Point 실제 로봇이나 현실의 멀티에이전트 환경 시뮬레이션에서 미세한 상호작용(팔 움직임, 물체 조작 등)까지 정확히 모델링해야 하는 연구자와 엔지니어에게 필요한 기술적 진전이다.
핵심 요약
1인칭 시점 세계 모델은 에이전트의 행동에 따른 관찰을 예측하지만, 기존 연구는 단일 에이전트에 집중했다. 현실의 구체화된 환경에서는 여러 에이전트가 공유된 환경에서 미세한 동작을 통해 상호작용하는데, 이는 대부분의 기존 멀티에이전트 세계 모델에서 충분히 다뤄지지 않았다. 연구팀은 멀티에이전트 이고센트릭 세계 모델링을 여러 에이전트의 동기화된 1인칭 스트림 생성으로 정식화했고, 이는 교차 시점 행동 일관성, 공유 환경 일관성, 상호작용으로 인한 상태 업데이트 전파를 요구한다. 전체 요약 6문장 읽기 → 039 18:30 ▲ 33 · 댓글 2 세계 모델에 소리를 더하는 'WorldSonus' 논문 공개 월드 모델이 생성한 시각적 환경에 실시간 공간음향을 합성하는 'WorldSonus' 프레임워크를 제시했다. AI · 머신러닝 · WorldSonus: Bringing Sound to Worlds
Key Point 기존 월드 모델은 시각만 생성했지만, WorldSonus는 실시간 상호작용형 공간음향 합성으로 생성 환경의 완전성을 한 단계 높였다.
핵심 요약
월드 모델이 생성한 시각적 환경에 실시간 공간음향을 합성하는 'WorldSonus' 프레임워크를 제시했다. 실시간 생성을 위해 스트리밍 인과 자기회귀 확산 구조를 사용해 RTF 0.41의 저지연으로 오디오 청크를 합성한다. 대화형 제어는 오디오 중심의 캡셔닝 파이프라인과 청크 인덱스 프롬프트 스케줄링으로 생성 도중 음향 이벤트를 동적으로 조작할 수 있다. 전체 요약 5문장 읽기 → 040 18:35 ▲ 11 · 댓글 2 VLM에 세계 모델 통합, 공간 추론 성능 39% 향상 인간이 시각적 변환을 정신적으로 시뮬레이션해 공간 문제를 푸는 것과 달리, 기존 시각언어모델(VLM)은 주로 언어로만 추론한다. AI · 머신러닝 · WM-VLM: Probing Internal World Models for Interleaved Visual-Textual Reasoning
Key Point 시각언어모델이 공간 추론을 하기 위해 중간 시각 상태 생성이 얼마나 효과적인지 보여주는 실증적 증거를 제시하며, VLM의 추론 메커니즘을 개선할 새로운 접근법을 제안한다.
핵심 요약
인간이 시각적 변환을 정신적으로 시뮬레이션해 공간 문제를 푸는 것과 달리, 기존 시각언어모델(VLM)은 주로 언어로만 추론한다. 텍스트와 생성된 시각 상태를 모두 활용해 공간 문제를 해결할 수 있는 VLM을 만들기 위해 WM-VLM을 제안했다. WM-VLM은 사전학습된 VLM에 가벼운 세계 모델 브랜치를 추가해 중간 시각 상태를 생성한다. 전체 요약 8문장 읽기 → 041 03:11 ▲ 32 · 댓글 2 영상과 소리를 함께 생성하는 실시간 세계 모델 HelixWorld 기존 세계 모델은 영상만 렌더링했지만, HelixWorld는 사용자 상호작용 하에서 카메라 관점의 영상과 공간 입체음향이 함께 진화하는 실시간 오디오-비주얼 세계 모델이다. AI · 머신러닝 · HelixWorld: A Real-time Interactive Audio-Visual World Model
Key Point 기존의 침묵한 세계 모델에 처음으로 실시간 공간 음향을 추가하여, 메타버스·게임 엔진·3D 시뮬레이션에서 멀티센서 상호작용의 새로운 기준을 제시한다.
핵심 요약
기존 세계 모델은 영상만 렌더링했지만, HelixWorld는 사용자 상호작용 하에서 카메라 관점의 영상과 공간 입체음향이 함께 진화하는 실시간 오디오-비주얼 세계 모델이다. 진정한 입체 음향과 카메라 메트릭 포즈를 갖춘 고충실도 공간 오디오-비주얼 데이터셋을 구축하고, 6-DoF 카메라 궤적과 사용자 액션을 조건으로 하는 양방향 교사 모델을 사전학습했다. 저지연 인과적 상호작용을 위해 온라인 궤적 증류 손실을 통해 교사 모델을 소수 단계의 스트리밍 학생 모델로 증류하여, 단일 GPU에서 초당 24 프레임의 드리프트 없는 오디오-비주얼 롤아웃을 유지한다. 전체 요약 5문장 읽기 → 042 00:11 ▲ 25 · 댓글 2 비디오 생성 모델의 현실적 목표 달성 능력 평가 벤치마크 공개 비디오 생성 모델을 구체화된 계획(embodied planning)과 학습의 시뮬레이터로 활용하려면 시각적 품질뿐 아니라 목표 지향적 행동에 따른 환경 변화 예측도 필요하지만, 기존 벤치마크는 단편적인 행동만 평가해 다단계 물리 추론이 부족했다. AI · 머신러닝 · Ego2Act: Evaluating Goal-Directed Manipulation in Egocentric Video Generation
Key Point 비디오 생성 모델을 로봇 학습이나 구체화된 AI에 활용하려면 물리적으로 타당한 다단계 조작을 정확히 모사해야 하는데, 이제 그 능력을 체계적으로 측정할 수 있는 벤치마크와 평가 도구가 나왔다.
핵심 요약
비디오 생성 모델을 구체화된 계획(embodied planning)과 학습의 시뮬레이터로 활용하려면 시각적 품질뿐 아니라 목표 지향적 행동에 따른 환경 변화 예측도 필요하지만, 기존 벤치마크는 단편적인 행동만 평가해 다단계 물리 추론이 부족했다. Ego2Act는 일상 환경에서 110개 과제의 2,640개 영상으로 구성된 벤치마크로, 초기 장면과 고수준 목표가 주어졌을 때 비디오 생성 모델이 목표 달성을 위해 손으로 물체를 조작하는 현실적인 1인칭 영상을 생성할 수 있는지 평가한다. 평가 자동화를 위해 Ego2ActJudge 파이프라인을 함께 공개했으며, 기존 방식보다 작업 완수율과 물리 타당성 평가가 인간 합의도와 더 잘 정렬된다. 전체 요약 5문장 읽기 → 043 15:11 ▲ 74 · 댓글 4 카메라 밖 물체까지 추적하는 세계 모델 개발 기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. AI · 머신러닝 · World Observer: Joint Actor-Observer Generation for Persistent World Modeling
Key Point 카메라 시점을 벗어난 물체의 상태를 추적할 수 있게 되면 더 현실적인 세계 모델을 만들 수 있고, 로보틱스나 게임 엔진 등 동적 환경 시뮬레이션이 필요한 분야에 실질적 개선을 가져올 수 있다.
핵심 요약
기존 비디오 세계 모델은 행위자(에이전트) 중심 시점에만 집중해 화면을 벗어난 물체의 상태 변화를 놓치는 문제가 있다. World Observer는 에이전트 시점의 배우 생성기와 함께 선택된 장면 영역을 관찰하는 하나 이상의 파노라마 관찰자를 동시에 생성해 이를 해결한다. 화면을 벗어난 물체도 관찰자 관점에서 계속 시각적으로 진화하도록 유지되어 재진입 시 업데이트된 상태가 반영된다. 전체 요약 7문장 읽기 → 044 06:11 ▲ 13 · 댓글 2 로봇 세계 모델로 복합 작업 학습을 자동화하다 로봇 조작 작업에서 재사용 가능한 기술을 여러 조합으로 활용할 때, 추가 시연을 통한 개선이 비용이 많이 드는 문제를 해결하는 ROBOCOACH 프레임워크를 제시했다. AI · 머신러닝 · RoboCoach: World Models as Active Coaches for Compositional Robot Skills
Key Point 세계 모델로 상상된 실패를 감지해 학습 데이터를 효율적으로 선택하는 방식으로, 로봇이 자동으로 어떤 기술부터 개선할지 결정할 수 있게 하는 방법을 보여준다.
핵심 요약
로봇 조작 작업에서 재사용 가능한 기술을 여러 조합으로 활용할 때, 추가 시연을 통한 개선이 비용이 많이 드는 문제를 해결하는 ROBOCOACH 프레임워크를 제시했다. 세계 모델 기반의 코칭 시스템으로, 상상된 실패를 감지해 어떤 기술을 학습할지, 어느 전문가 모델을 업데이트할지를 자동으로 결정한다. Route-Imagine-Diagnose-Improve(RIDI) 루프는 공유 액션-조건부 세계 모델인 COACHWORLD 내에서 재사용 가능한 기술 전문가들을 실행하고, 진행 판단자가 실패하는 첫 번째 부작업을 기록한다. 전체 요약 7문장 읽기 → 045 18:11 ▲ 68 · 댓글 3 LLM 에이전트의 숨은 세계 모델을 끌어내는 훈련법 LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. AI · 머신러닝 · EVOKE: Eliciting World Knowledge in Agents for Transferable Decision-Making
Key Point LLM 에이전트가 새로운 환경에 적응하지 못하는 근본 원인을 진단하고, 추가 훈련 없이 기존 지식을 활용하는 훈련 기법을 제안하는 것이 개발자들의 실제 배포 문제를 해결하기 때문입니다.
핵심 요약
LLM 기반 에이전트는 다중 단계 의사결정에 점점 더 활용되지만 미지의 환경으로의 전이가 좋지 않다. 기존 세계 모델 학습 방식은 미래 관찰을 예측하도록 훈련하지만 추가 학습 비용이 들고 예측 오류가 누적된다. 디지털 환경에서 작동하는 LLM 에이전트는 사전 훈련 과정에서 이미 상당한 세계 지식을 내재화하고 있어, 새로 습득하기보다 끌어내는 것이 핵심이다. 전체 요약 9문장 읽기 → 046 18:11 ▲ 336 · 댓글 2 로봇이 시연으로 배우는 문맥 학습, 네 가지 기법 분류 일반 목적 로봇이 새로운 작업을 추론하고 신체 행동으로 변환하기 위해 문맥 학습(ICL)이 필요하다. AI · 머신러닝 · In-Context Learning for Robots: Methods and Applications
Key Point 로봇이 새 작업에 신속하게 적응하는 핵심 기법들을 체계적으로 정리한 리뷰로, 실무 엔지니어와 연구자가 어떤 접근법을 선택할지 판단하는 기준을 제공한다.
핵심 요약
일반 목적 로봇이 새로운 작업을 추론하고 신체 행동으로 변환하기 위해 문맥 학습(ICL)이 필요하다. ICL은 시연과 상호작용을 이용해 배포 시 신경망 가중치를 고정한 상태에서 기존 능력을 활용한다. 논문은 맥락 정보에서 실행으로 연결하는 인터페이스 네 가지로 분류한다: 맥락 조건부 정책, 기하학적 시연 전이, 세계 모델 기반 제어, 스킬·에이전트 기반 실행. 전체 요약 7문장 읽기 → 047 15:11 ▲ 20 · 댓글 1 영상 세계 모델의 긴 문맥 처리, 효율적 어텐션으로 해결 텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. AI · 머신러닝 · WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
Key Point 대화형 비디오 생성에서 긴 문맥을 유지하면서 계산 효율을 동시에 확보하려는 세계 모델 연구의 핵심 기술 개선이다.
핵심 요약
텍스트 조건부 대화형 비디오 세계 모델은 텍스트 지시에 따라 시간적으로 일관된 환경을 시뮬레이션한다. 기존 프레임워크는 슬라이딩 윈도우로 계산 복잡도를 제한하면서도 과거 문맥을 잃어 장기 상호작용 능력이 떨어진다. 전체 히스토리 캐시는 어텐션의 이차 복잡도와 KV 캐시의 선형 증가로 인해 계산 및 메모리 과부하가 심하다. 전체 요약 7문장 읽기 → 048 15:11 ▲ 25 · 댓글 2 동영상 생성 모델의 '일괄 증류' 기술 공개 동영상 확산 모델이 다양한 작업에 특화되면서 각각 증류 단계를 반복하는 비효율이 발생하고 있다. AI · 머신러닝 · LongLive-Plug: Once-for-All Distillation for Video Generation
Key Point 동영상 생성 모델 특화로 인한 반복 학습 비용을 획기적으로 줄이는 기술로, 실제 배포된 54개 모델에서 검증되었기 때문에 현실성 있는 효율화 방안을 제시한다.
핵심 요약
동영상 확산 모델이 다양한 작업에 특화되면서 각각 증류 단계를 반복하는 비효율이 발생하고 있다. LongLive-Plug는 한 번의 학습으로 여러 모델에 재사용 가능한 기능을 LoRA로 학습하는 일괄 증류 프레임워크다. 단일 패스 분류기 없는 가이던스, 소수 단계 샘플링, 자동회귀 생성의 장기 맥락 오류 보정 기능을 제공한다. 전체 요약 8문장 읽기 → 049 12:11 ▲ 26 · 댓글 2 세계 모델의 표현 기하학을 다시 설계하다 JEPA 계열 잠재 세계 모델은 행동 조건 역학을 표현 공간에서 학습하며, 보통 유클리드 거리로 목표까지의 거리를 계산해 행동 후보를 평가한다. AI · 머신러닝 · Anisotropic Representations Improve Planning in JEPA World Models
Key Point 표현 정규화 방식의 변경이 세계 모델 기반 계획에 미치는 영향을 실증적으로 보여주므로, 이를 따르는 연구나 실제 모델 개발에 참고할 수 있다.
핵심 요약
JEPA 계열 잠재 세계 모델은 행동 조건 역학을 표현 공간에서 학습하며, 보통 유클리드 거리로 목표까지의 거리를 계산해 행동 후보를 평가한다. 기존 동적 모델은 표현 붕괴를 막기 위해 등방 가우시안 정규화를 사용했는데, 이것이 예측은 정확하더라도 작업의 실제 비용과 다른 기하학을 만들 수 있다. 연구팀은 이 불일치를 해결하기 위해 AnisoWM을 제안했으며, 고정된 추적과 비등방성 제약 하에서 학습 가능한 대각 공분산을 사용한다. 전체 요약 6문장 읽기 → 050 21:11 ▲ 15 · 댓글 1 비디오 세계 모델에 실시간 편집 기능 추가한 EditWorld EditWorld는 생성형 가상 세계에서 precise editing과 유연한 참조 이미지 활용을 지원하는 비디오 world model이다. AI · 머신러닝 · Precise Editing and Flexible Referencing for Interactable Worlds
Key Point video world model이 탐색에서 한 단계 나아가 사용자가 생성된 세계를 직접 편집하고 조작할 수 있는 수준에 도달했으며, 실시간 스트리밍 방식의 편집 지원이 새로운 접근 방식을 제시한다.
핵심 요약
EditWorld는 생성형 가상 세계에서 precise editing과 유연한 참조 이미지 활용을 지원하는 비디오 world model이다. 기존 video world model은 주로 탐색에만 초점을 맞췄으나, EditWorld는 생성 과정 중 편집 지시사항과 참조 이미지를 스트리밍 방식으로 받아 기존 콘텐츠의 정확한 수정을 가능하게 한다. 시간에 따라 변하는 편집 조건과 참조 이미지를 처리하기 위해 Gated Causal Attention 메커니즘을 도입했고, 장시간 추론 시 컨텍스트 크기를 제한하는 Sparse Context 메커니즘을 함께 적용했다. 전체 요약 6문장 읽기 → 051 18:11 ▲ 25 · 댓글 2 실시간 응답하면서 긴 시간 일관성 유지하는 세계 모델 공개 실시간 대응과 장기간 일관성을 동시에 달성해야 하는 인터랙티브 월드모델에서, 다양한 제어 신호 처리와 맥락 폭증, 불안정한 증류가 핵심 과제였다. AI · 머신러닝 · WorldPlay2: Extending Real-Time Interactive World Models in Control and Horizon
Key Point 대규모 언어 모델 기반 세계 모델이 실시간 제어 응답과 장시간 예측의 두 가지 모순된 요구를 동시에 만족시켜야 하는 상황에서, 기술적 혁신을 통해 두 가지 성능을 모두 달성하는 방법론을 제시하기 때문이다.
핵심 요약
실시간 대응과 장기간 일관성을 동시에 달성해야 하는 인터랙티브 월드모델에서, 다양한 제어 신호 처리와 맥락 폭증, 불안정한 증류가 핵심 과제였다. WorldPlay2는 분해된 하이브리드 제어 인터페이스와 압축 메모리·안정적 증류의 결합을 통해 이 문제를 해결한다. 제어 인터페이스는 프레임 정렬 액션 제어와 구조화된 의미적 제어를 통합해 장면 모양, 캐릭터 정체성, 동적 의미 이벤트를 명시적으로 분리함으로써 효과적 학습을 지원한다. 전체 요약 7문장 읽기 → 052 22:26 ▲ 203 · 댓글 2 물체 지속성 학습으로 세계 모델 강화하기 비디오 생성 모델이 인간처럼 물체가 사라져도 존재한다는 사실(물체 지속성)을 이해하는지 검증하는 논문이다. AI · 머신러닝 · Training Object Permanence in World Models
Key Point 최신 비디오 모델들이 물리적 추론 능력을 갖추고 있는지 체계적으로 검증하는 첫 대규모 인지과학 기반 벤치마크로, 이후 세계 모델 개발의 방향을 제시한다.
핵심 요약
비디오 생성 모델이 인간처럼 물체가 사라져도 존재한다는 사실(물체 지속성)을 이해하는지 검증하는 논문이다. 연구진은 인지과학 원리에서 영감을 받아 6개 범주의 150가지 인지 과제로 구성된 WROP 데이터셋을 제시했다. Blender를 이용해 속도, 조명, 카메라 각도 등을 무작위로 변화시키면서 각 과제의 인지 구조를 유지하여 작업당 10,000개 이상의 샘플을 생성했다. 전체 요약 6문장 읽기 → 053 22:26 ▲ 19 · 댓글 2 LLM 에이전트의 추론 오류 자동 수정하는 세계 모델 LLM 에이전트는 장기 작업 수행 시 역사 정보 속 오래된 가정과 계획이 이후 결정을 왜곡하는 '작업 상태 오염' 문제를 겪는다. AI · 머신러닝 · Agent-Editing World Model: Rethinking World Modeling for LLM Agents
Key Point LLM 에이전트의 추론 오류를 자동으로 감지하고 수정하는 실용적 방법을 제시하며, 여러 복잡한 작업에서 일관된 성능 향상을 보여준다.
핵심 요약
LLM 에이전트는 장기 작업 수행 시 역사 정보 속 오래된 가정과 계획이 이후 결정을 왜곡하는 '작업 상태 오염' 문제를 겪는다. 기존 세계 모델은 도구 응답을 예측하지만, 실제 피드백이 있을 때는 제한적 가치를 가진다. Agent-Editing World Model(AEWM)은 도구 응답 시뮬레이션 대신 추론과 행동이 작업 진행을 어떻게 형성하는지 모델링한다. 전체 요약 8문장 읽기 → 054 22:29 ▲ 41 · 댓글 3 AI 세계 모델의 신뢰성을 평가하는 벤치마크 공개 Hugging Face 연구팀이 생성형 AI의 세계 모델(world model)을 평가하는 종합 벤치마크 'HappyWorld-Bench'를 발표했다. AI · 머신러닝 · HappyWorld-Bench
Key Point 세계 모델이 상호작용과 수정에 얼마나 잘 반응하고 신뢰성을 유지하는지 평가하는 새로운 기준이 필요한 상황에서, 이 벤치마크는 비디오·공간·구현형 모델 전반의 약점을 구체적으로 드러낸다.
핵심 요약
Hugging Face 연구팀이 생성형 AI의 세계 모델(world model)을 평가하는 종합 벤치마크 'HappyWorld-Bench'를 발표했다. 벤치마크는 생성 구성부터 통합 세계 모델링까지 6단계의 계층적 능력 프레임워크(W1-W6)를 기반으로 설계되었다. 비디오 세계 모델(1,138개 프롬프트), 공간 세계 모델(300개 장면), 구현형 세계 모델(254개 테스트 케이스) 등 세 가지 독립적 평가 트랙으로 구성된다. 전체 요약 8문장 읽기 → 055 16:18 ▲ 146 · 댓글 4 비디오 세계 모델 WorldCrafter, 3D 메모리로 긴 시간 일관성 확보 비디오 세계 모델이 장시간 여러 시점에서 일관된 장면을 생성하기 어려운 문제를 해결하는 WorldCrafter 모델을 제시했다. AI · 머신러닝 · WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory
Key Point 비디오 생성 AI의 가장 큰 약점인 시간적 일관성 문제를 3D 메모리 구조로 근본적으로 해결하는 접근법으로, 향후 인터랙티브 비디오 생성 시스템의 품질을 크게 개선할 수 있는 기술이다.
핵심 요약
비디오 세계 모델이 장시간 여러 시점에서 일관된 장면을 생성하기 어려운 문제를 해결하는 WorldCrafter 모델을 제시했다. 요청한 시점에 따라 과거 관찰 데이터를 3D 인식 메모리로 압축해 비디오 생성 모델의 토큰 제약을 효율적으로 활용한다. 메모리 인코더와 포즈 조건 읽기 모듈이 역사 정보를 시점별 토큰으로 통합하되, 명시적 깊이 대응 없이 학습된다. 전체 요약 4문장 읽기 →