쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 16일 (월)까지 4683건
12건 · "스케일링 법칙"조건 지우기 ×
001 18:11 ▲ 30 · 댓글 4 로봇 학습 위한 대규모 환경·행동 데이터셋 'Ropedia Xperience 2' 공개 GPT-6 Astra, Claude Fable 5.1 같은 대규모 기초 모델이 시각 정보로 로봇을 직접 제어할 수 있게 됐지만, 현실의 장시간·접촉이 많은 작업에서는 여전히 취약하다. AI · 머신러닝 · Ropedia Xperience 2: A Gold Standard for Scaling Physical AI Environments and Behaviors
Key Point 대규모 언어 모델의 스케일링 법칙처럼, 로봇 AI가 어떤 데이터 규모에서 성능이 향상되는지를 연구하기 위한 첫 번째 표준 데이터셋이 제시됐다.
핵심 요약
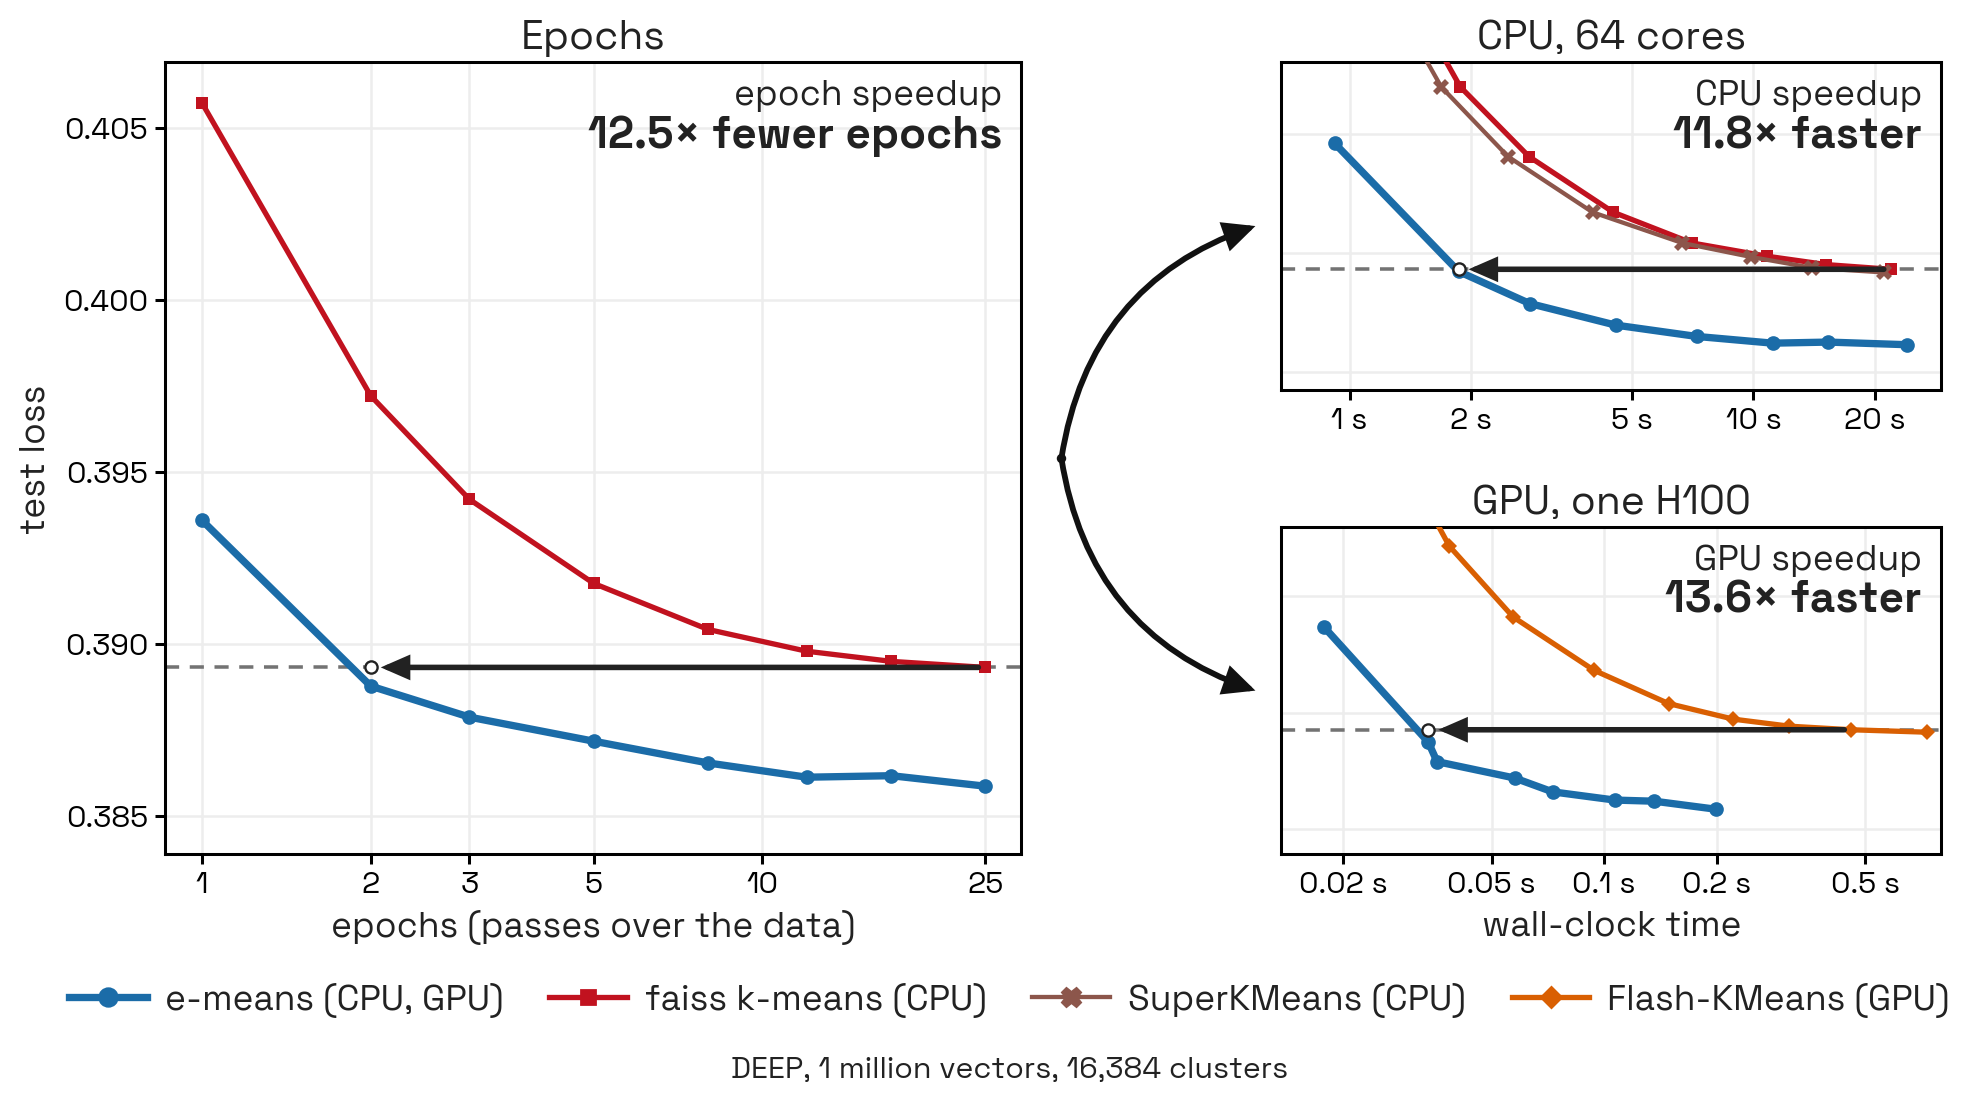
GPT-6 Astra, Claude Fable 5.1 같은 대규모 기초 모델이 시각 정보로 로봇을 직접 제어할 수 있게 됐지만, 현실의 장시간·접촉이 많은 작업에서는 여전히 취약하다. 로봇 AI의 능력이 환경과 행동 데이터 규모에 어떻게 비례하는지 규명하려면, 어떤 데이터를 모을지, 어떻게 지속적으로 생산·재활용할지 먼저 정해야 한다. Ropedia Xperience 2는 1,589개의 미터급 3D 스캔과 74개 작업의 1인칭 영상 4,230개(총 131시간)를 담은 데이터셋이다. 전체 요약 5문장 읽기 → 002 21:11 ▲ 11 · 댓글 3 K-means보다 10배 빠른 클러스터링 알고리즘 'e-means' 공개 Lloyd's k-means를 개선한 새로운 클러스터링 알고리즘 e-means를 제안했다. AI · 머신러닝 · e-means: outperforming k-means (in one-tenth the epochs)
Key Point 대규모 임베딩 데이터 클러스터링 속도가 근본적으로 빨라져서, 검색·양자화·데이터 큐레이션 등 실무에서 k-means을 쓰는 작업들의 처리 시간을 획기적으로 단축할 수 있다.
핵심 요약
Lloyd's k-means를 개선한 새로운 클러스터링 알고리즘 e-means를 제안했다. 지수이동평균(exponential moving average) 최적화 절차와 미니배치 업데이트를 사용하며, 딥러닝 기반 인프라를 활용한다. 감쇠율(decay rate)과 배치 크기가 최종 성능에 미치는 영향에 대한 스케일링 법칙을 수립해 하이퍼파라미터 튜닝 없이 다양한 문제 크기에 적용 가능한 공식을 도출했다. 전체 요약 6문장 읽기 → 003 06:11 ▲ 115 · 댓글 4 로이드 알고리즘 10배 빠른 k-means 최적화 알고리즘 공개 Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. AI · 머신러닝 · E-means: 10x faster k-means at equal loss
Key Point 클러스터링은 벡터 양자화, 이미지 압축, 추천 시스템 등에 널리 쓰이는데, Lloyd 알고리즘이 표준이었던 상황에서 10배 빠르면서도 손실이 더 낮은 새 방식이 나왔으므로 기술 선택에 직결되는 소식이다.
핵심 요약
Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. e-means는 25 에포크에서 Lloyd가 도달하는 손실 수준에 1.2~3 에포크 안에 도달하며, 지스푸(Flash-KMeans) 대비 GPU에서 10~45배, Faiss 대비 CPU에서 8~15배 월클록 속도 개선을 실현했다. 핵심은 지수 이동 평균(exponential moving average)을 사용한 미니배치 업데이트로, 최신 할당(recent assignment)에 가중치를 두면서 과거 오래된 정보는 α 비율로 서서히 잊도록 설계했다. 전체 요약 10문장 읽기 → 004 00:11 ▲ 32 · 댓글 3 인간 영상 50,000시간으로 로봇 기초모델 학습시키는 오픈 방법론 1인칭 시점 인간 영상 5만 시간으로 로봇 학습을 위한 데이터를 확보하는 Open-HumanScale 방법론을 공개했다. AI · 머신러닝 · Open-HumanScale: An Open Recipe for Scaling Human and Robot Experience for Embodied Foundation Models
Key Point 인간 행동 영상 대규모 데이터로 로봇 조작 능력을 효과적으로 학습할 수 있는 실증적 방법론과 스케일링 법칙을 제시했으며, 재현 가능한 연구를 위해 전체 파이프라인을 오픈소스화했다.
핵심 요약
1인칭 시점 인간 영상 5만 시간으로 로봇 학습을 위한 데이터를 확보하는 Open-HumanScale 방법론을 공개했다. 손동작과 자연언어 주석이 달린 Open-HumanScale-50K 데이터셋을 구축하고, 시뮬레이션 평가로 인간 사전학습만으로도 데이터 시간과 로봇 성공률 간 로그 선형 스케일링 법칙을 발견했다. 인간 영상 5만 시간으로만 학습한 HumanWAM-Vanilla 모델은 RoboTwin 2.0 Clean2Clean에서 92.08% 성공률, Clean2Random에서 68.88%, RoboDojo에서 평균 14.17% 성공률을 기록했다. 전체 요약 6문장 읽기 → 005 21:11 당일 +479 $100으로 GPT-2급 AI 모델을 직접 훈련하는 nanochat 공개 Andrej Karpathy가 nanochat을 공개했으며, 이는 단일 GPU 노드에서 LLM 전체 파이프라인(토큰화, 사전학습, 미세조정, 평가, 추론)을 실행할 수 있는 최소한의 실험 코드다. AI · 머신러닝 · karpathy/nanochat · Python
Key Point 2019년에 $43,000 들던 GPT-2 훈련 비용이 7년 간의 기술 진전으로 $48 수준까지 내려왔으며, 누구든 8XH100 GPU 접근만으로 직접 대형언어모델을 학습하고 운영할 수 있는 경제학적 변화가 일어나고 있다.
핵심 요약
Andrej Karpathy가 nanochat을 공개했으며, 이는 단일 GPU 노드에서 LLM 전체 파이프라인(토큰화, 사전학습, 미세조정, 평가, 추론)을 실행할 수 있는 최소한의 실험 코드다. GPT-2 수준의 모델을 8개의 H100 GPU로 약 1.5~2시간 만에 $48 정도의 비용으로 훈련할 수 있으며, 스팟 인스턴스 사용 시 $15 수준까지 내려간다. 코드는 --depth 하나의 파라미터로 모델 규모를 조절하면 변압기의 폭, 헤드 수, 학습률, 가중치 감소 등 다른 모든 하이퍼파라미터가 자동으로 최적으로 계산된다. 전체 요약 10문장 읽기 → 006 15:11 ▲ 72 · 댓글 2 게임 세계에서 스케일링: 구체화 에이전트의 지속적 사전학습 연구팀이 가상 세계에서 데이터 규모, 다양성, 모델 크기가 구체화 에이전트 학습에 미치는 영향을 조사했다. AI · 머신러닝 · Scaling in Games: Continued Pre-Training For Embodied Agents In Diverse Virtual Worlds
Key Point 게임 환경에서 LLM의 스케일링 법칙을 실증적으로 검증한 첫 대규모 연구로, 에이전트 AI의 일반화 능력과 학습 데이터 다양성 간의 관계를 정량적으로 보여준다.
핵심 요약
연구팀이 가상 세계에서 데이터 규모, 다양성, 모델 크기가 구체화 에이전트 학습에 미치는 영향을 조사했다. 0.8B~27B 모델 4종, 50~1,600시간 데이터 6개 규모, Minecraft 단독부터 다중 게임 혼합 데이터 5가지 조합으로 총 120가지 설정을 학습했다. 결과적으로 더 많은 데이터는 학습 데이터 포함 게임 성능을 높이고, 다양성은 유사 게임으로의 전이는 개선하나 거리가 먼 게임으로의 일반화는 제한적이었다. 전체 요약 8문장 읽기 → 007 18:11 ▲ 17 · 댓글 2 LLM 에이전트의 물리적 자기개선, 어떻게 가능할까 LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. AI · 머신러닝 · Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
Key Point 로봇 조작 같은 물리적 환경에서 LLM 에이전트가 스스로 개선되는 원리를 정량 분석해, 대규모 언어 모델의 실제 강화학습 적용 가능성을 예측할 수 있는 기초를 제공한다.
핵심 요약
LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. PhysRSI-eval이라는 평가 지표를 도입해 5개 축(첫 시도 성능, 효율성, 성공률, 예산, 실패 후 개선)으로 물리적 RSI를 정량화했다. 18개 로봇 조작 작업에서 다양한 VLM(시각 언어 모델)을 같은 상호작용 예산 내에서 평가했으며, 공개 벤치마크 점수가 비슷해도 개선 양상은 크게 다를 수 있음을 확인했다. 전체 요약 7문장 읽기 → 008 12:11 ▲ 34 · 댓글 4 깊이 축 주의 메커니즘 확장으로 신경망 효율성 1.58배 향상 Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. AI · 머신러닝 · Multi-Stream Attention Residuals
Key Point 대규모 신경망의 효율성을 단순한 아키텍처 변경만으로 1.58배 향상시키는 방법을 제시하여 모델 학습과 배포 비용 절감에 직접 영향을 줄 수 있습니다.
핵심 요약
Attention Residuals(AttnRes)는 네트워크 깊이축을 따라 내용 기반 검색을 수행하는 메커니즘으로, 깊이축 단일스트림 소프트맥스 어텐션으로 볼 수 있습니다. 다중헤드 어텐션의 성공에 영감을 받아 Multi-Stream Attention Residuals(MSAR)을 제안했으며, 이는 AttnRes를 다중헤드 깊이 어텐션으로 확장한 것입니다. MSAR은 다중규모 인과 합성곱을 통해 시퀀스 문맥에서 스트림 다양성을 도출하여, 각 헤드가 서로 다른 문맥 관점을 통해 과거 표현을 검색할 수 있습니다. 전체 요약 6문장 읽기 → 009 18:30 ▲ 53 · 댓글 3 시각·언어·행동을 통합한 로봇 모델 UniWAM, 다중 작업에서 최고 성능 달성 비전-언어-행동 모델과 월드-액션 모델의 장점을 결합한 통합 아키텍처 UniWAM을 제안했다. AI · 머신러닝 · UniWAM: Unified World-Action Model
Key Point 로봇 학습에서 시각 이해와 행동 예측을 한 모델로 통합하는 접근법이 어떻게 작동하는지, 그리고 인간 데이터와 로봇 데이터를 함께 사용했을 때의 스케일링 효과를 보여주는 연구로, 구체화된 AI 시스템의 확장성을 이해하는 데 도움이 된다.
핵심 요약
비전-언어-행동 모델과 월드-액션 모델의 장점을 결합한 통합 아키텍처 UniWAM을 제안했다. 물리 추론기, 월드 생성기, 액션 예측기를 하나로 통합해 의미론적 이해, 시각 생성, 행동 예측을 동시에 학습한다. 저수준 행동을 자연언어로 표현하고, VQA 데이터·인간 이고센트릭 영상·로봇 시연으로 사전학습한다. 전체 요약 8문장 읽기 → 010 06:11 ▲ 17 · 댓글 2 반복 구조와 희소 전문가 모델의 스케일링 법칙 제시 로프드 트랜스포머(반복 구조)와 MoE(혼합 전문가)는 서로 다른 효율성 경로를 제공한다: 반복 구조는 파라미터 수 고정 상태에서 계산 깊이를 늘리고, MoE 희소성은 활성 연산 고정 상태에서 총 용량을 확장한다. AI · 머신러닝 · Scaling Laws for Looped Mixture of Experts
Key Point 반복 구조와 희소 전문가 모델을 함께 스케일링하는 첫 통합 법칙으로, 제한된 연산량에서 효율성 극대화를 원하는 대규모 모델 개발의 새로운 설계 기준을 제공한다.
핵심 요약
로프드 트랜스포머(반복 구조)와 MoE(혼합 전문가)는 서로 다른 효율성 경로를 제공한다: 반복 구조는 파라미터 수 고정 상태에서 계산 깊이를 늘리고, MoE 희소성은 활성 연산 고정 상태에서 총 용량을 확장한다. 기존 스케일링 법칙은 반복 구조와 희소성을 따로 모델링했으나, 이 논문은 반복 구조와 희소성을 모델 크기·데이터와 함께 통합 모델링하는 'Loop Scaling Laws'를 제시했다. 핵심은 희소성-조건부 반복 매핑으로, 반복을 통한 유효 파라미터 이득을 특성화하고 희소성이 이 이득을 어떻게 높이는지를 나타낸다. 전체 요약 7문장 읽기 → 011 21:11 ▲ 59 · 댓글 1 CoWindow: 주의 메커니즘의 중복 계산을 줄인 구조화된 어텐션 기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. AI · 머신러닝 · CoWindow Attention: Full Causal Coverage Is a Collective Property
Key Point 효율적인 장문맥 처리가 필수인 생성형 AI에서 Full Attention의 중복 계산을 제거하면서도 성능을 유지하는 방법이 제시되었으므로, 스케일링 효율성을 개선하려는 팀들의 관심을 받을 만합니다.
핵심 요약
기존 Full Attention 방식은 모든 어텐션 헤드가 전체 인과 히스토리를 반복 처리하면서 중복 계산과 메모리 오버헤드가 발생한다. 연구팀이 제안한 CoWindow Attention(CoWA)은 KV 헤드 간에 인과 히스토리 접근을 분산시키는 구조화된 어텐션이다. 모든 헤드는 근거리 대각 윈도우와 접두사-싱크 윈도우를 공유하며, 나머지 먼 과거는 보완적 장거리 윈도우로 분할되어 전체 인과 커버리지를 달성한다. 전체 요약 10문장 읽기 → 012 18:11 ▲ 57 · 댓글 2 비전 인코더 제거해도 될까, 스케일링 법칙으로 본 멀티모달 학습 기존 멀티모달 대규모 언어모델(MLLM)은 사전학습된 비전 인코더를 기반으로 하지만, 인코더가 없는 모델은 원본 픽셀에서 직접 시각 표현을 학습한다. AI · 머신러닝 · How Far Are We from Removing the Visual Encoder? Scaling Laws for Encoder-Free Multimodal Pretraining
Key Point 현재 멀티모달 모델의 구조적 선택지가 스케일에 따라 어떻게 바뀌는지 정량적으로 보여주는 논문으로, 미래 모델 아키텍처 설계의 방향성을 결정하는 근거가 된다.
핵심 요약
기존 멀티모달 대규모 언어모델(MLLM)은 사전학습된 비전 인코더를 기반으로 하지만, 인코더가 없는 모델은 원본 픽셀에서 직접 시각 표현을 학습한다. 인코더 제거 시 멀티모달 목표의 최적 계산 할당이 더 큰 모델 쪽으로 이동하는 반면, 텍스트 목표는 변화가 거의 없다. 두 구조는 텍스트 손실에서는 겹치는 손실-계산 경계를 보이지만, 멀티모달 목표에서는 분산된다. 전체 요약 6문장 읽기 →