쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 10월 30일 (금)까지3636건
7건 · "음성 변환"조건 지우기 ×
001▲ 190 · 댓글 80음성 데이터만으로 학습한 실시간 양방향 대화 AI 'Dessa' 공개Block의 AI 연구팀이 Dessa를 공개했으며, 이는 음성-음성 변환 방식의 완전한 양방향(full-duplex) 대화 모델이다.AI · 머신러닝 · Dessa: the most authentic full-duplex speech model ever built

Key Point음성을 텍스트로 변환하지 않고 원음만으로 AI를 학습시키는 새로운 방식이 실현되었으며, 감정과 뉘앙스를 보존한 더 자연스러운 음성 AI 상호작용이 가능해졌다.
핵심 요약
- Block의 AI 연구팀이 Dessa를 공개했으며, 이는 음성-음성 변환 방식의 완전한 양방향(full-duplex) 대화 모델이다.
- 기존 음성 AI와 달리 음성을 텍스트로 변환하지 않고 원본 오디오 데이터만으로 학습했다.
- 감정, 억양, 웃음, 숨 쉬는 소리, 풍자 등 텍스트로는 손실되는 음성의 뉘앙스를 모두 보존한다.
전체 요약 9문장 읽기 →AI · 머신러닝 · StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion

Key Point제로샷 음성 스타일 변환의 실시간성을 개선하고 자연어 기반 음성 설계·편집 기능을 추가해 음성 생성의 실용성과 제어 가능성을 크게 높였다.
핵심 요약
- StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다.
- 이전 버전인 StyleStream 1.0의 문제점을 해결했다: 소비자급 GPU에서 약 1초의 레이턴시를 520ms로 단축(2배 속도 개선)하고, 대상 음성을 설계·편집할 텍스트 기반 인터페이스를 추가했다.
- 레이턴시 감소를 위해 몇 단계의 픽셀 MeanFlow 모델을 학습하고 Self Forcing에서 영감을 받은 자기회귀 피드백으로 세부 조정하여 스트리밍 추론 견고성을 개선했다.
전체 요약 6문장 읽기 →AI · 머신러닝 · Gemini 3.8 text-to-speech

Key Point자연어만으로 완전히 새로운 음성 캐릭터를 만들 수 있고, 음성 복제 기능과 명확한 동의 검증 체계로 창작자와 음성 크리에이터를 보호하면서도 대규모 다국어 콘텐츠 제작을 가능하게 한다.
핵심 요약
- 구글이 Gemini 3.8 Flash TTS와 Gemini 3.8 Flash-Lite TTS 두 개의 새로운 텍스트-음성 변환 모델을 발표했다.
- Gemini 3.8 Flash TTS는 자연어 프롬프트로 완전히 새로운 음성을 창작하는 창의적 용도에, Gemini 3.8 Flash-Lite TTS는 대규모 더빙과 음성 에이전트에 최적화되어 있다.
- 사용자는 30초의 음성 샘플로부터 일관된 음성 프로필을 복제할 수 있으며, 음성 소유자의 명시적 동의 녹음을 통해 동의 검증이 이루어진다.
전체 요약 10문장 읽기 →보안 · Meta’s Muse has a serious 0-day
Key Point보안을 강조하며 출시한 AI 어시스턴트가 기본적인 설계 결함으로 완전히 장악될 수 있는 점이 AI 에이전트 보안의 현주소를 보여준다.
핵심 요약
- 메타의 AI 어시스턴트 뮤즈에서 로컬 앱이나 터미널 명령이 계정에 완전한 접근권한을 얻을 수 있는 0-day 취약점이 발견됐다.
- 공격자는 뮤즈의 음성 변환 서버 주소를 자신의 엔드포인트로 변경해 사용자 인증 토큰을 탈취할 수 있다.
- 메타는 뮤즈를 서비스 간 고도의 권한 접근이 필요한 구조로 설계했으나, 앱이 모든 미공개 설정을 수정할 수 있도록 허용했다.
전체 요약 5문장 읽기 →오픈소스 · 도구 · debpalash/VoiceStudio · Python

Key Point클라우드 서비스 의존 없이 모든 음성 작업을 로컬에서 처리할 수 있는 완성도 높은 오픈소스가 등장했으며, 엔진 유연성과 다국어 지원이 개발자와 콘텐츠 제작자에게 실질적인 선택지가 된다.
핵심 요약
- VoiceStudio는 646개 언어를 지원하는 오픈소스 음성 생성 도구로, 음성 클로닝·음성 디자인·동영상 더빙·받아쓰기·오디오북 제작을 모두 로컬에서 처리한다.
- TTS 16개, ASR 11개 엔진을 탑재했으며 엔진 간 전환이 자유롭다.
- 계정·API 키·구독료 없이 자신의 하드웨어에서 동작하며, macOS·Windows·Linux·Docker를 지원한다.
전체 요약 6문장 읽기 →오픈소스 · 도구 · tonhowtf/omniget · Rust

Key Pointyt-dlp를 여러 사이트별로 계속 찾아다니거나 강좌 플랫폼 폐지 전 자료를 백업해야 하는 사용자들이 하나의 앱으로 통일할 수 있고, 터미널과 설정 없이 즉시 사용할 수 있다는 점이 기존 방식과의 가장 큰 차이다.
핵심 요약
- Udemy, Hotmart 강좌부터 YouTube, Instagram, X, TikTok 등 1,800개 이상의 사이트에서 영상과 음악, 전자책을 다운로드하는 무료 데스크톱 앱이다.
- 터미널 없이 GUI에서 링크를 붙여 미리보기를 본 후 화질을 선택해 다운로드할 수 있으며, yt-dlp와 FFmpeg가 자동으로 설치되고 업데이트된다.
- 브라우저 확장 프로그램으로 쿠키를 가져와 로그인이 필요한 콘텐츠도 받을 수 있고, 다운로드 대기열 관리와 재시도 기능을 지원한다.
전체 요약 6문장 읽기 →기타 · Pixel 11 Pro Fold
핵심 요약
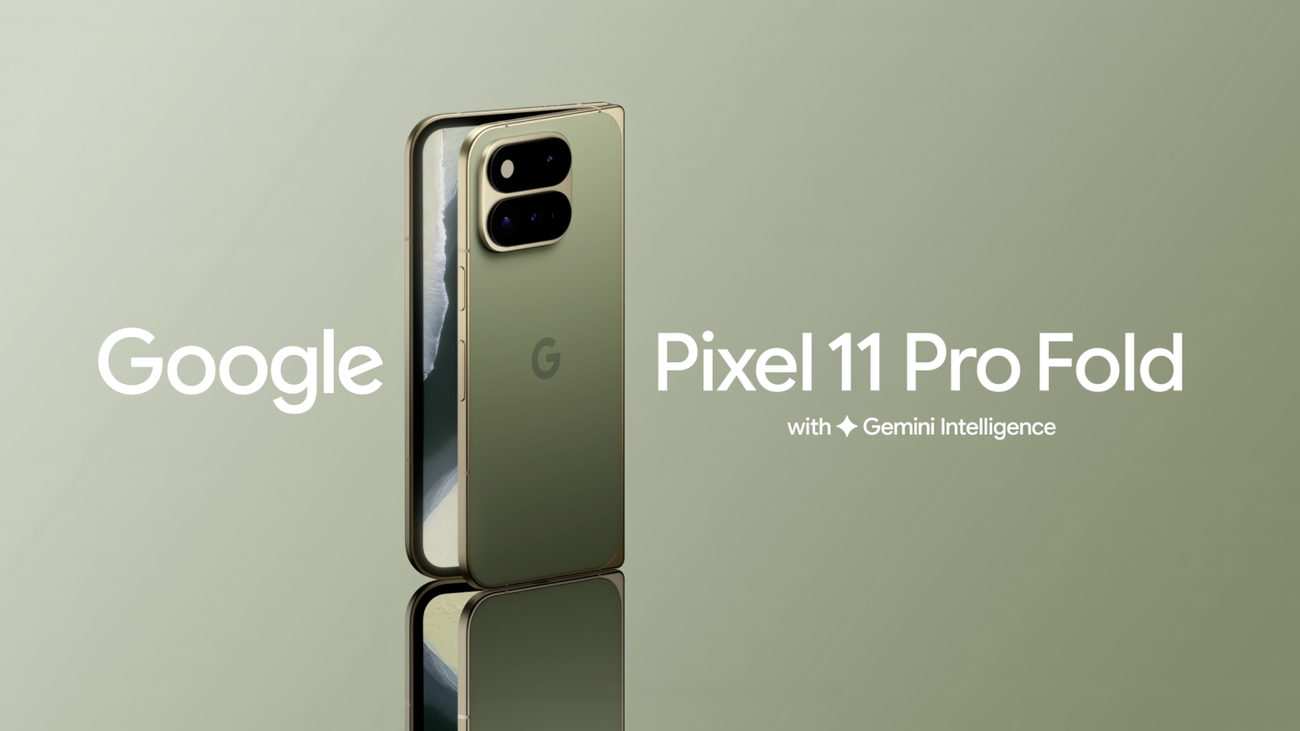
- 픽셀 11 프로 폴드는 전작 대비 약 10% 가볍고 1mm 얇아졌으며, 글래스 파이버 복합재 백커버로 3배 더 견고하다.
- 신형 LED 조명 기반 하이라이트, 48MP 메인 카메라, 30배 슈퍼줌 등 새로운 카메라 기능을 탑재했다.
- 텐서 G6 칩과 16GB RAM을 기반으로 실시간 번역, 수어 음성 변환 등 제미니 기능을 구현했다.