쌓인 기록에서 찾기
무엇을 찾으세요?
날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위부터 2026년 11월 16일 (월)까지4683건
4건 · "쿼리 최적화"조건 지우기 ×
001▲ 100 · 댓글 16GROUP BY 쿼리, 슬롯 기반 필터링으로 70% 파티션 건너뛰다Pivot 데이터베이스가 GROUP BY 쿼리 중 상위 K개 그룹만 필요한 경우를 최적화하는 신규 기법을 공개했다.인프라 · 데브옵스 · Can GROUP BY still be optimized after all these years?
Key PointLIMIT이 있는 GROUP BY 쿼리는 데이터 분석 워크로드의 60% 이상을 차지하는데, 이 최적화로 동일한 결과를 70% 더 적은 연산으로 얻을 수 있다.
핵심 요약
- Pivot 데이터베이스가 GROUP BY 쿼리 중 상위 K개 그룹만 필요한 경우를 최적화하는 신규 기법을 공개했다.
- 기존 GROUP BY는 모든 파티션을 집계한 후 병합하는데, 예를 들어 4,096개 파티션 중 상위 10개만 반환하는 경우 대부분의 파티션이 불필요한 작업을 한다.
- 초기 최적화는 각 파티션의 총합만 추적하는 방식이었으나, 100개 항목이 각각 15 주문씩인 경우와 1개 항목이 1,401 주문인 경우를 구분하지 못했다.
전체 요약 8문장 읽기 →웹 · 프론트엔드 · Push ifs up and fors down: The idiom, its algebra, and its limits
Key Point코드의 데이터 흐름과 제어 흐름을 재배열하는 원칙이 단순 휴리스틱을 넘어 범주 이론, 함수형 프로그래밍, 데이터베이스 최적화에 일관되게 적용되는 대수학적 법칙임을 보여주므로, 어디까지 안전하게 리팩토링할 수 있는지 정확히 판단할 근거를 제공한다.
핵심 요약
- '조건을 위로, 반복을 아래로'는 프로그래밍 휴리스틱으로, 조건 분기는 호출자 쪽으로 올리고 반복 루프는 배치 처리 쪽으로 내려 명확성과 성능을 높인다.
- 함수가 입력에 따라 분기한다면 그 분기를 호출자로 옮기는 식으로, Option 대신 Walrus 타입을 받아 선택 사항을 타입으로 표현한다.
- 반복 최적화는 개별 호출 대신 배치 함수를 제공해 핫 루프를 분기 없이 실행하고 벡터화의 후보가 되도록 한다.
전체 요약 10문장 읽기 →인프라 · 데브옵스 · Postgres SELECT DISTINCT Does Not Scale
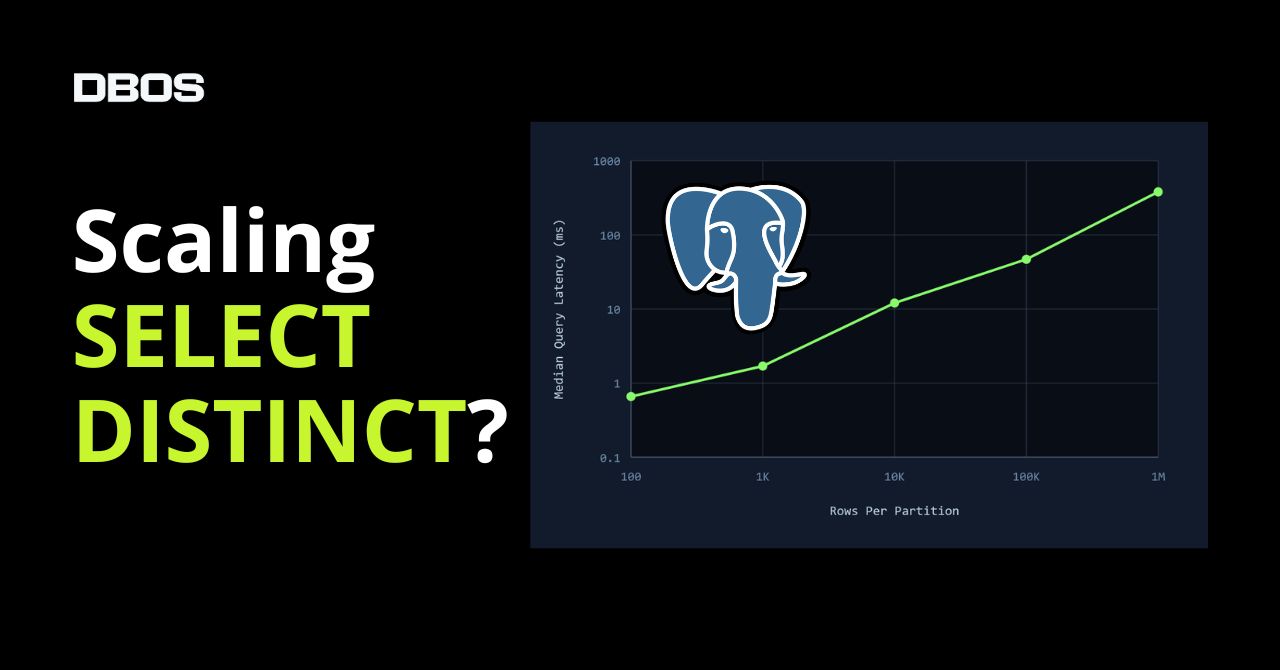
Key Point쿼리 최적화나 데이터베이스 성능에 의존하는 개발자라면 Postgres의 이 근본적 한계를 알아야 대규모 시스템에서 SELECT DISTINCT를 피할 수 있다.
핵심 요약
- PostgreSQL의 SELECT DISTINCT는 직관과 달리 인덱스가 아무리 잘 짜여도 항상 조건을 만족하는 모든 행을 풀 스캔한다.
- 분할된 큐에서 '활성' 파티션을 찾는 쿼리에서 DISTINCT를 썼을 때, 파티션 수가 적어도 초 단위 지연이 발생했다.
- 같은 파티션 수에서 행 개수만 100에서 1M으로 늘려도 쿼리 시간이 선형으로 증가하는 벤치마크 결과를 확인했다.
전체 요약 9문장 읽기 →AI · 머신러닝 · Training a 4B model to produce 81% faster query plans than Postgres
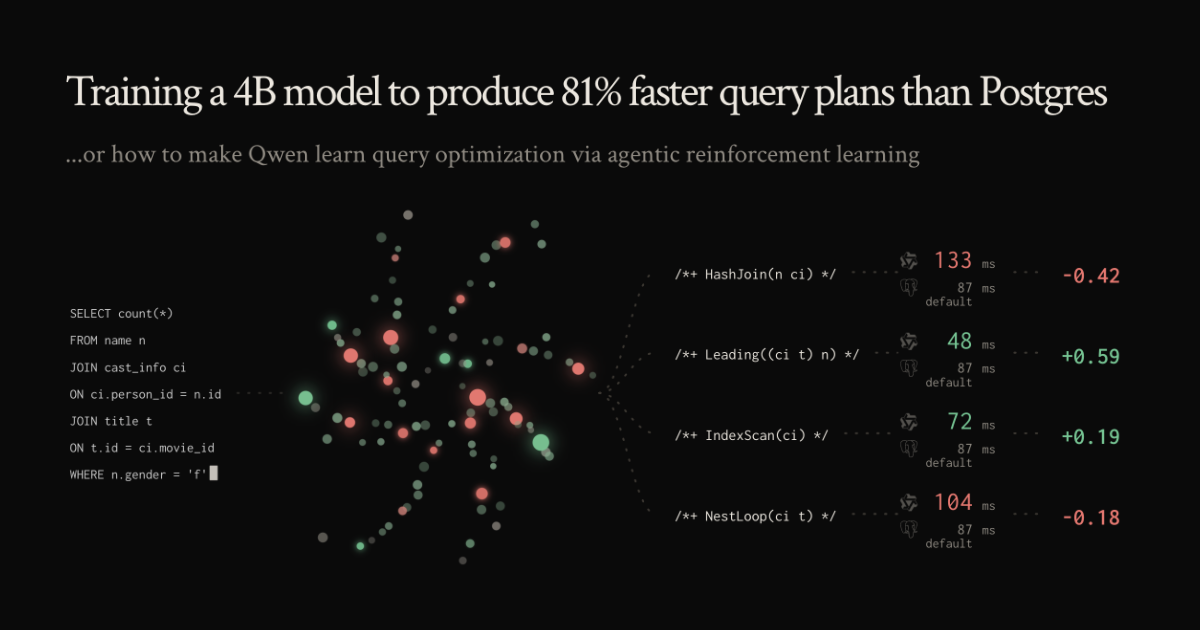
Key Point쿼리 최적화라는 매우 어려운 데이터베이스 문제를 작은 규모의 LLM으로 해결 가능함을 실증함으로써, AI를 데이터베이스 성능 개선에 실무적으로 적용할 수 있는 방법을 제시한다.
핵심 요약
- 연구자는 4B 파라미터 오픈웨이트 모델을 지도학습(SFT)과 강화학습(RL)으로 미세조정해 PostgreSQL 기본 쿼리 플랜을 능가하는 플랜을 생성하도록 훈련했다.
- 113개의 조인 중심 쿼리에서 44.7% 레이턴시 감소를 달성했으며, 초기에 99개 쿼리를 실행할 수 없던 모델이 성공적으로 작동하게 되었다.
- 쿼리 최적화는 조인 순서 결정이 NP-하드 문제로 알려져 있을 정도로 어려우나, 실행 시간이라는 단일 목표로 LLM 학습을 최적화할 수 있음을 보여준다.
전체 요약 4문장 읽기 →