쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 22일 (일)까지 5067건
14건 · "텍스트 렌더링"조건 지우기 ×
001 06:11 ▲ 17 · 댓글 2 확산 트랜스포머의 RL 튜닝은 사실 활성화 조정일 뿐 확산 트랜스포머의 강화학습(RL) 사후 학습이 시각 품질, 텍스트 렌더링, 구성 정확도를 크게 개선한다. AI · 머신러닝 · RL Post-Training in Diffusion Transformers Is Activation Steering
Key Point 확산 모델의 성능 개선이 실제로는 복잡한 학습이 아니라 간단한 선형 시프트로 대부분 설명되며, 이는 RL 튜닝의 작동 방식에 대한 근본적인 이해를 제시한다.
핵심 요약
확산 트랜스포머의 강화학습(RL) 사후 학습이 시각 품질, 텍스트 렌더링, 구성 정확도를 크게 개선한다. 논문은 이러한 개선이 복잡한 입력 의존적 변환 학습이 아니라 간단한 입력 독립적 시프트로 대부분 설명할 수 있다는 가설을 검증했다. SD3.5-M에서 RL-튜닝된 LoRA(1,880만 파라미터)의 65배 적은 파라미터(29만)를 가진 고정 조향 벡터 세트를 모든 프롬프트·토큰·샘플링 시드에 동일하게 적용했다. 전체 요약 7문장 읽기 → 002 18:11 ▲ 103 · 댓글 22 마이크로컨트롤러를 위한 JIT 비트맵 텍스트 렌더링 80년대 홈 컴퓨터를 RP2350 마이크로컨트롤러로 재구현하는 vic-2350 프로젝트에서 비트맵 폰트로 텍스트를 렌더링했으며, 저해상도에서 선명함을 위해 비트맵 방식을 선택했다. 하드웨어 · 시스템 · JIT bitmap text rendering for microcontrollers
Key Point 마이크로컨트롤러의 극도로 제한된 성능 예산 속에서 JIT 컴파일을 텍스트 렌더링에 처음 적용해 2.6% 오버헤드만으로 고품질 텍스트를 표시하는 기술이므로, 저사양 기기 개발자나 임베디드 그래픽에 관심 있는 개발자에게 참고할 만한 최적화 사례다.
핵심 요약
80년대 홈 컴퓨터를 RP2350 마이크로컨트롤러로 재구현하는 vic-2350 프로젝트에서 비트맵 폰트로 텍스트를 렌더링했으며, 저해상도에서 선명함을 위해 비트맵 방식을 선택했다. RP2350에서 DVI 출력을 위해 풀 화면 프레임버퍼 대신 '레이스 더 빔' 방식(한 스캔라인씩 렌더링)을 사용하여 SRAM을 절약하고 레이턴시를 줄였다. 각 픽셀당 약 6 사이클 성능 제약을 만족하기 위해 Rust 대신 ARM 어셈블리와 새로 개발한 symbolasm 언어를 사용했다. 전체 요약 12문장 읽기 → 003 12:54 ▲ 173 · 댓글 16 텍스트-이미지 AI 모델, $21K로 학습 후 공개 2인 연구팀 Linum이 약 2만 1천 달러의 학습 비용으로 훈련한 Pyramid-JiT(P-JiT) 이미지 생성 모델을 Apache 2.0 라이선스로 공개했다. AI · 머신러닝 · Show HN: A decent text-to-image model trained for ~$20K (Apache 2.0 Weights)
Key Point 작은 팀이 주요 클라우드 AI 회사와 비교할 수 없는 수준의 비용으로 실용적인 이미지 생성 모델을 만들고 공개했으며, 이는 확산 모델의 효율성 개선 방향을 보여준다.
핵심 요약
2인 연구팀 Linum이 약 2만 1천 달러의 학습 비용으로 훈련한 Pyramid-JiT(P-JiT) 이미지 생성 모델을 Apache 2.0 라이선스로 공개했다. 모델은 2.42억 개의 파라미터(학습 시 포함)를 가진 확산 모델이며, 512²에서 1024² 해상도로 단계적으로 학습했고, Qwen 3.5-4B 텍스트 인코더를 사용한다. 기존 VAE 기반 압축 대신 픽셀 공간에서 직접 작업하고 32×32 토큰 압축으로 어텐션 컨텍스트 윈도우를 4배 축소했으며, 이전 모델보다 11배 적은 샘플로 수렴한다. 전체 요약 8문장 읽기 → 004 06:11 ▲ 11 · 댓글 2 학습 없이 사진 속 글을 번역하는 FlowTranslator 이미지 속 텍스트를 그 번역본으로 바꾸면서 주변 시각 정보는 그대로 유지하는 인-이미지 기계번역(IIMT) 문제를 다룬다. AI · 머신러닝 · FlowTranslator: Training-Free In-Image Machine Translation with Flow-Based Editing
Key Point 학습 데이터 없이도 다국어 T2I 모델의 능력을 활용해 이미지 속 텍스트 번역이 가능함을 보여주는 실용적 접근법이다.
핵심 요약
이미지 속 텍스트를 그 번역본으로 바꾸면서 주변 시각 정보는 그대로 유지하는 인-이미지 기계번역(IIMT) 문제를 다룬다. 기존 작업 특화 모델들은 번역 전후의 대량 쌍 이미지로 학습해야 하지만, FlowTranslator는 학습 없이 동작한다. OCR 모델과 LLM으로 번역 프롬프트를 생성한 뒤 T2I(텍스트-투-이미지) 기반 디퓨전 모델에 주입하는 방식을 사용한다. 전체 요약 6문장 읽기 → 005 18:11 ▲ 19 · 댓글 4 한 두 번의 평가로 복잡한 텍스트 렌더링하기 빠른 이미지 생성 모델에서 프롬프트의 세부 사항을 정확히 표현하기 위해 Distribution Matching Distillation(DMD)을 개선한 Intrinsic Distribution Matching(IDM) 기법을 제안했다. AI · 머신러닝 · Intrinsic Distribution Matching
Key Point 한 두 번의 신경망 평가로 복잡한 텍스트를 정확히 렌더링해야 하는 실시간 이미지 생성 애플리케이션 개발자들이 알아야 할 효율적인 증류 기법이다.
핵심 요약
빠른 이미지 생성 모델에서 프롬프트의 세부 사항을 정확히 표현하기 위해 Distribution Matching Distillation(DMD)을 개선한 Intrinsic Distribution Matching(IDM) 기법을 제안했다. 기존 DMD는 점수 차이를 이용해 생성 분포를 참조 분포에 가깝게 만드는데, IDM은 역방향 KL 필드를 가우시안 모멘트 성분과 비가우시안 나머지로 분해해 학습한다. 생성 모델의 지수 이동 평균(EMA) 복사본을 이용해 특징의 평균과 좌표별 표준편차를 명시적으로 제약하며, 외부 특징 인코더가 필요 없다. 전체 요약 7문장 읽기 → 006 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 007 21:11 ▲ 115 · 댓글 32 AI 이미지 생성 실전 가이드: 확산부터 에이전트까지 AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. AI · 머신러닝 · A practical guide to AI image generation, from diffusion to agents
Key Point 이미지 생성 API 가격, 프롬프트 작성법, 모델별 강점이 구체적인 수치와 실험 사례로 제시돼 있어 프로덕션 코드에 통합하거나 비용을 최적화하려는 개발자에게 실질적 지침이 된다.
핵심 요약
AI 이미지 생성 모델은 크게 확산형과 멀티모달형으로 나뉜다. 확산형은 노이즈에서 시작해 단계별로 정제하며 텍스트 인코더가 프롬프트를 수치로 변환해 방향을 제시한다. 멀티모달형은 언어와 이미지를 함께 이해해 지시 따르기와 텍스트 렌더링에 강하며, 대부분 내부적으로 계획 후 그린다. 2014년 GAN부터 2026년 현재까지 AI 이미지 기술은 여섯 손가락 같은 비현실적 오류와 텍스트 인식 문제를 거의 해결했다. 문제의 원인은 모델이 손 형태를 텍스처로만 학습했기 때문이고, 토크나이저가 글자 대신 단어 단위로 처리했기 때문이다. ChatGPT의 GPT Image 모델은 3월 2025년부터 기본 이미지 생성기이며, 대화식 편집과 지시 따르기에 강하지만 시드 제어가 없고 측면 비율이 제한돼 있다. API를 쓸 때는 다양한 크기와 품질 계층, 배치 처리가 가능하다. 전체 요약 11문장 읽기 → 008 18:11 ▲ 65 · 댓글 3 텍스트와 레이아웃 제어가 강한 오픈소스 이미지 생성 모델 MOSS-Image 5B 규모의 싱글스트림 디퓨전 트랜스포머를 처음부터 학습해 한·영 장문 텍스트 렌더링과 정밀한 레이아웃 제어를 가능하게 했다. AI · 머신러닝 · MOSS-Image Technical Report
Key Point 닫힌소스 모델만 가능하던 고품질 텍스트 렌더링과 복잡한 레이아웃 제어를 오픈소스로 구현한 첫 사례로, 텍스트 기반 이미지 생성의 새로운 기준을 제시한다.
핵심 요약
5B 규모의 싱글스트림 디퓨전 트랜스포머를 처음부터 학습해 한·영 장문 텍스트 렌더링과 정밀한 레이아웃 제어를 가능하게 했다. 사용자의 다양한 요청을 상세한 콘텐츠와 레이아웃 명세로 변환하는 의도 인식 에이전트 프롬프트 향상 모듈을 개발했다. 장문 영어·중국어 텍스트 렌더링을 평가하는 LongLongTextBench(LLTB)와 엔드투엔드 레이아웃 생성을 평가하는 RealLayoutArena(RLA)를 새로 도입했다. 전체 요약 6문장 읽기 → 009 15:11 ▲ 29 · 댓글 2 슬라이드 생성·편집 통합 AI 모델 InfoVis 공개 Hugging Face와 연구팀이 슬라이드 생성과 편집을 통합하는 9B 규모의 멀티모달 모델 InfoVis를 발표했다. AI · 머신러닝 · InfoVis: Unified Slide Image Generation and Editing
Key Point 슬라이드 생성·편집에 특화된 대규모 데이터와 벤치마크 공개로, 프레젠테이션 자동화 분야에 새로운 평가 기준과 개방형 기준 모델을 제시한다.
핵심 요약
Hugging Face와 연구팀이 슬라이드 생성과 편집을 통합하는 9B 규모의 멀티모달 모델 InfoVis를 발표했다. 텍스트 렌더링, 명령 따르기, 시각적 접지, 미적 설계, 정밀한 편집을 한 캔버스 내에서 수행할 수 있도록 설계됐다. 연구팀은 1,300만 개의 지속 학습 기록과 190만 개의 감독 학습 기록으로 구성된 확장 가능한 데이터 엔진을 구축했다. 전체 요약 9문장 읽기 → 010 18:30 ▲ 86 · 댓글 2 이미지 생성 모델의 텍스트 렌더링 평가하는 한영중 벤치마크 이미지 생성 모델이 여러 영역에 정확하게 배치된 긴 텍스트를 렌더링하는 능력을 평가하기 위해 UltraText Bench 벤치마크를 소개한다. AI · 머신러닝 · UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visual Text Rendering in Image Generation
Key Point 이미지 생성 모델의 텍스트 렌더링 성능을 체계적으로 비교할 수 있는 한영중 벤치마크가 공개되어, 텍스트가 많은 이미지 생성 작업에서 모델을 평가하고 선택할 기준이 생겼다.
핵심 요약
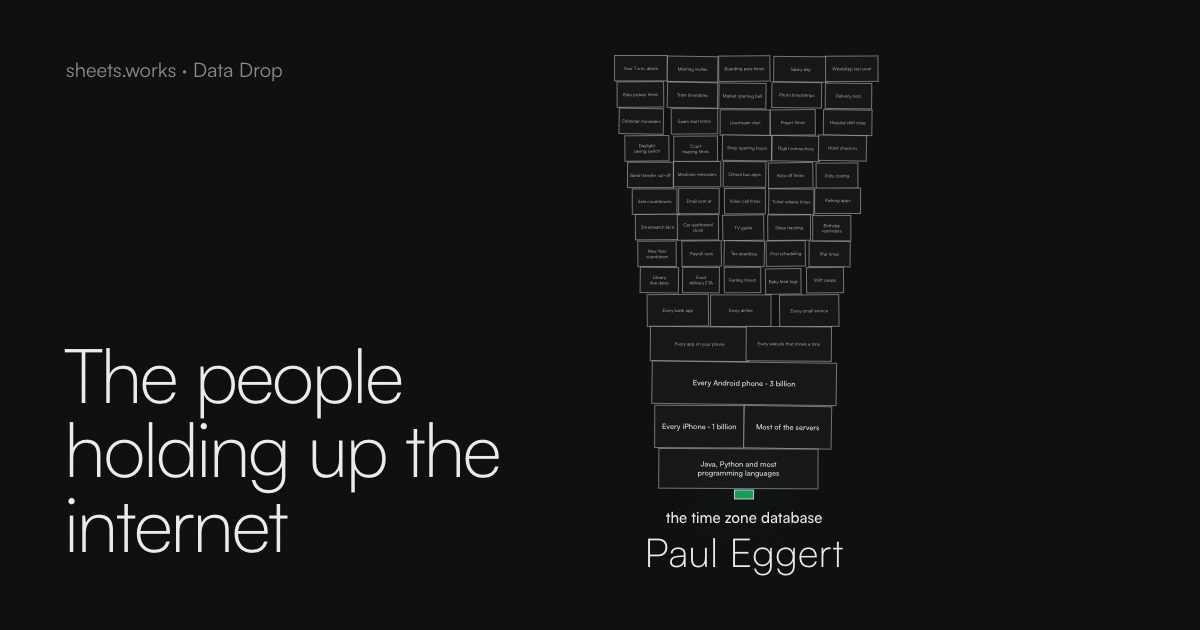
이미지 생성 모델이 여러 영역에 정확하게 배치된 긴 텍스트를 렌더링하는 능력을 평가하기 위해 UltraText Bench 벤치마크를 소개한다. 벤치마크는 432개 프롬프트로 구성되며, 24개 실제 장면 카테고리와 3가지 난이도 수준을 포함하고 영문과 중문을 동등하게 분배했다. 각 프롬프트는 인간이 검수했으며 4개~12개 텍스트 영역의 정확한 문자열과 콘텐츠·배치·시각적 속성의 구조화된 참조값을 제공한다. 전체 요약 7문장 읽기 → 011 18:30 ▲ 118 · 댓글 50 몇십 명이 인터넷 기반을 떠받치고 있다 안드로이드, iOS, Windows 등 수십억 대 기기가 의존하는 핵심 오픈소스 23개 프로젝트의 유지보수 현황을 분석했다. 오픈소스 · 도구 · The people holding up the internet
Key Point 인터넷을 구성하는 핵심 소프트웨어 대부분이 1~2명의 무보수 개발자에 의존하고 있으며, 일부는 멘탈 헬스 문제나 자금 부족으로 위험에 처해 있다.
핵심 요약
안드로이드, iOS, Windows 등 수십억 대 기기가 의존하는 핵심 오픈소스 23개 프로젝트의 유지보수 현황을 분석했다. 시간대 데이터 파일은 UCLA 교수 Paul Eggert가 2012년부터 운영하며 지난 1년간 251개 변경 중 218개를 혼자 담당했다. 리눅스 서버와 iPhone에 탑재된 압축 도구 xz는 핀란드의 Lasse Collin이 운영하다가, 2024년 악의적 기여자 Jia Tan이 몰래 백도어를 삽입한 사건이 발생했다. 전체 요약 14문장 읽기 → 012 00:11 ▲ 11 · 댓글 2 동영상 AI가 글씨를 제대로 쓰지 못한다 최신 동영상 생성 모델들이 자연어 지시로 현실 같은 영상을 만들어내지만, 기존 평가 기준은 시각 품질과 물리적 타당성에만 집중해 장면 속 텍스트 렌더링을 제대로 평가하지 못하고 있다. AI · 머신러닝 · VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation
Key Point 동영상 생성 AI 모델들이 영상 품질은 우수하지만 장면 속 글씨 렌더링이라는 맹점을 가진 이유를 체계적으로 드러내며, 텍스트 기반 평가 기준이 필요함을 보여준다.
핵심 요약
최신 동영상 생성 모델들이 자연어 지시로 현실 같은 영상을 만들어내지만, 기존 평가 기준은 시각 품질과 물리적 타당성에만 집중해 장면 속 텍스트 렌더링을 제대로 평가하지 못하고 있다. 광고와 과학 영상 등 5가지 실제 사용 사례를 바탕으로 300개의 프롬프트로 구성된 VTR-Bench 벤치마크를 개발했으며, 텍스트 충실도를 평가하는 자동화 파이프라인과 인간 평가 기준을 포함한다. Director 에이전트가 이미지·동영상 생성과 시각 평가를 조율하며 반복적 개선을 진행하는 Keyframe-Guided Agentic Framework를 함께 제시한다. 전체 요약 5문장 읽기 → 013 15:11 ▲ 247 · 댓글 3 멀티모달 AI가 자기 피드백으로 스스로 성장하는 방법 현대 멀티모달 모델은 생성과 이해를 하나의 시스템에 통합해 자신의 피드백으로부터 학습할 수 있는 잠재력을 가지고 있다. AI · 머신러닝 · UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement
Key Point 외부 감독 없이 AI 모델이 자신의 비판적 피드백으로 스스로 개선되는 메커니즘을 제시해, 모델 성능 향상의 새로운 가능성을 보여준다.
핵심 요약
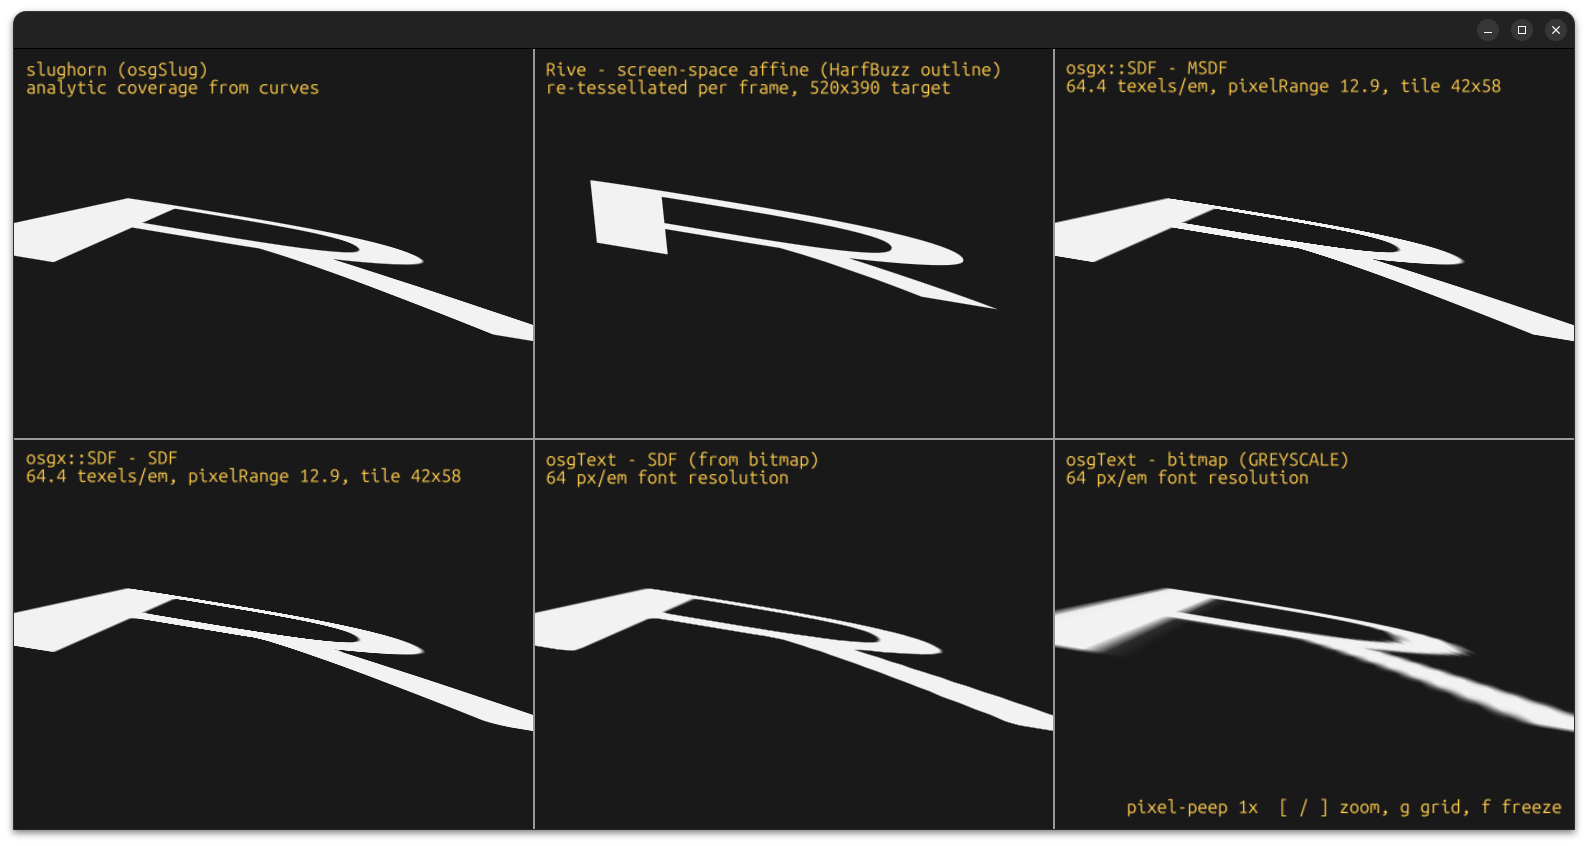
현대 멀티모달 모델은 생성과 이해를 하나의 시스템에 통합해 자신의 피드백으로부터 학습할 수 있는 잠재력을 가지고 있다. UniEvo-VL은 이러한 능력을 활용해 모델이 테스트 타임에 자기수정 피드백으로부터 배우도록 하는 자기진화 프레임워크다. 별도의 큰 교사 모델에 의존하는 대신, 단일 멀티모달 모델이 서로 다른 맥락에서 교사와 학생 역할을 동시에 수행한다. 전체 요약 8문장 읽기 → 014 06:11 ▲ 114 · 댓글 47 GPU 텍스트 렌더링 5가지 기법 비교: Slug 특허 공개와 함께 GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 웹 · 프론트엔드 · SDF vs. MSDF vs. Slug: GPU Text Rendering
Key Point 2026년 Slug 특허가 공개 도메인으로 해방되면서 고사양 3D·AR 환경의 텍스트 렌더링 기술이 개방되었으며, 각 기법의 정확한 트레이드오프를 이해하면 게임, 시뮬레이션, 데이터 시각화 프로젝트에서 최적의 방식을 선택할 수 있다.
핵심 요약
GPU에서 글자를 렌더링하는 방식은 텍스트가 매 프레임 바뀌고 임의의 3D 변환 아래서도 선명해야 한다는 제약으로 인해 CPU 래스터화보다 복잡하다. 가장 오래된 텍스처 아틀라스 방식은 글자를 고정 크기로 미리 렌더링해 저장하므로, 확대하면 흐릿해지고 중국어·일본어·한국어 같은 거대 글자 집합은 메모리가 폭증한다. SDF(부호있는 거리장)는 픽셀 대신 가장자리까지의 거리를 저장해 확대에 강하지만, 날카로운 모서리가 둥글어지는 한계가 있다. 전체 요약 12문장 읽기 →