쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 1일 (일)까지 3730건
100건 (최대치) · "피드백"조건 지우기 ×
001 15:11 ▲ 149 · 댓글 42 스타트렉 TNG 에피소드 맞추기 게임 공개 TNG(스타트렉: 넥스트 제너레이션) 에피소드 이미지를 단서로 에피소드를 맞추는 일일 게임이다. 기타 · Show HN: To Honor Sir Patrick Stewart, Enjoy the TNG Episode Guessing Game
Key Point 패트릭 스튜어트 추도를 위해 공개된 TNG 팬 게임으로, 에피소드 인물·장면·소품을 추론하는 재미있는 상호작용 경험을 제공한다.
핵심 요약
TNG(스타트렉: 넥스트 제너레이션) 에피소드 이미지를 단서로 에피소드를 맞추는 일일 게임이다. 플레이어는 최대 6회의 시도로 올바른 에피소드를 식별해야 한다. 시즌을 맞히면 에피소드를 틀려도 피드백을 받는다. 전체 요약 6문장 읽기 → 002 21:11 ▲ 136 · 댓글 16 Smalltalk-80의 현대적 구현, Cuis 프로젝트 Cuis는 단순함과 강력함을 목표로 설계한 자유 Smalltalk-80 환경이다. 오픈소스 · 도구 · Cuis: The Modern Smalltalk-80
Key Point Smalltalk의 우아한 설계 철학을 이어받은 Cuis는 현대적 개발 환경과 함께 제공되며, 활발한 커뮤니티와 정기적인 업데이트를 통해 지속적으로 발전하고 있는 프로젝트다.
핵심 요약
Cuis는 단순함과 강력함을 목표로 설계한 자유 Smalltalk-80 환경이다. 모든 플랫폼에 이식 가능하며 빠르고 효율적으로 동작한다. 개발 중인 애플리케이션의 객체를 Inspector로 확인하고, 메시지를 보내 할로를 표시하며, 자동완성 도구를 활용할 수 있다. 전체 요약 8문장 읽기 → 003 15:11 ▲ 18 · 댓글 2 나레이션으로 장편 비디오 자동 편집하는 AI 에이전트 WeVisCut 나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. AI · 머신러닝 · WeVisCut: The Whole Editing Room in One Agent From Narration to Long-Form Video
Key Point 텍스트 지시만으로 긴 비디오를 자동 편집하면서 토큰 효율은 Claude Opus 5의 33분의 1 수준이라는 점이 현장 업무 자동화의 실제 가능성을 보여준다.
핵심 요약
나레이션에서 장편 비디오를 생성할 때 여러 샷 사이의 일관성을 유지하는 것이 과제인데, 기존 멀티 스테이지 에이전트는 일반 모델 기반으로 작동해 소형 모델의 성능-비용 트레이드오프가 불명확했다. WeVisCut는 스크립트를 비디오로 변환하는 시스템으로, 도구 실행과 정책 학습을 연결하며 에이전트가 공유 프로덕션 상태를 유지해 도구 피드백이 후속 결정과 오류 복구에 반영된다. 기존 완성 비디오에는 편집 의도가 노출되지 않으므로, 4단계 데이터 파이프라인이 편집 역변환(inversion)과 검증된 재생(replay)을 결합해 3,750개 영상에서 130K개 이상의 훈련 데이터를 추출한다. 전체 요약 7문장 읽기 → 004 12:11 ▲ 110 · 댓글 97 클로드 듀엣, 실제로 쓸 만한 AI 어시스턴트의 등장 Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. AI · 머신러닝 · Claude Duet is the first personal-assistant-type harness that feels useful
Key Point 실제 사용자가 기존 AI 어시스턴트들과 직접 비교하며 평가한 경험담으로, 속도·보안·인터페이스 측면에서 어떤 점이 달라졌는지 구체적으로 보여준다.
핵심 요약
Anthropic이 출시한 Claude Duet은 기존 AI 어시스턴트(Muse, Dot, NanoClaw 등)보다 실용적이라는 평가를 받고 있다. Opus 5.5 기반으로 구동되며 별도 튜닝을 통해 응답 속도를 크게 높였고, 사용자가 명령 사이에 대기하지 않아도 될 정도로 빠르다. 채널 기능으로 작업 흐름을 자동으로 정리하고 관리하며, Cmd-k로 채널 간 빠른 이동이 가능해 세션 추적 문제를 해결한다. 전체 요약 8문장 읽기 → 005 03:11 ▲ 305 · 댓글 239 구글, 사이버보안 강화한 제미니 4 카본 공개 구글이 제미니 4 카본을 발표했으며, 이는 최고 수준의 사이버보안 및 장기 작업 능력을 갖춘 최강 모델이다. AI · 머신러닝 · Gemini 4 Carbon
Key Point 사이버보안 방어 능력에서 대폭 개선된 최신 AI 모델이 출시되며, 취약점 탐지부터 패칭까지 보안 업무 자동화 수준이 크게 높아진다.
핵심 요약
구글이 제미니 4 카본을 발표했으며, 이는 최고 수준의 사이버보안 및 장기 작업 능력을 갖춘 최강 모델이다. 카본은 Artificial Analysis Intelligence Index v5.0에서 59점으로 1위를 차지했으며, 코딩과 에이전트 작업에서 큰 성능 향상을 보였다. 사이버보안 방어 벤치마크에서 SEC-bench Pro 취약점 탐지 88.2%, ExploitGym 악용 검증 54.8%, CWE-bench 패칭 71.0%을 달성했다. 전체 요약 14문장 읽기 → 006 00:11 ▲ 18 · 댓글 2 자동 정리 증명, 복잡한 워크플로우보다 단순 반복 루프가 더 효과적 형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. AI · 머신러닝 · h1: A Taste of the Bitter Lesson in Automated Theorem Proving
Key Point 자동화된 정리 증명에서 복잡한 설계 워크플로우 대신 단순한 에이전트 루프가 더 효과적일 수 있다는 발견은, 향후 형식 검증 시스템을 어떻게 구축할 것인지에 대한 근본적인 접근 방향을 바꿀 수 있다.
핵심 요약
형식 정리 증명(formal theorem proving) 분야는 계획, 분해, 전문 도구 연계 등 인간이 설계한 복잡한 워크플로우에 의존해왔으나, 비형식 수학은 대규모 언어 모델의 연쇄 추론으로 진전을 이뤄왔다. 이 논문은 '비터 레슨' 질문을 제기한다: 테스트 타임 계산을 확장하는 단순한 에이전트 루프가 이런 복잡한 워크플로우와 경쟁할 수 있는가? h1이라는 단순한 도구를 개발했는데, 이는 모델에게 Lean 4의 효율적인 인터페이스를 제공하고 검증자 피드백과 자기 성찰로 작동하며, 명시적 분해나 탐색 구조를 강요하지 않는다. 전체 요약 7문장 읽기 → 007 15:11 ▲ 39 · 댓글 2 AI 에이전트가 독립적으로 언어모델 학습, 인간 피드백으로 개선 AI 에이전트가 자율적으로 언어모델을 학습하고 사용자 피드백으로 개선할 수 있는지 확인하는 RSI Arena 연구를 공개했다. AI · 머신러닝 · RSI Arena: Towards Recursive Self-Improvement with Human Feedback
Key Point AI 모델 개발 주도권이 인간에서 AI로 이동할 가능성을 보여주는 연구로, 인간 피드백이 자율 시스템에 어떻게 통합되는지 실증적으로 보여준다.
핵심 요약
AI 에이전트가 자율적으로 언어모델을 학습하고 사용자 피드백으로 개선할 수 있는지 확인하는 RSI Arena 연구를 공개했다. 10개 프론티어 모델을 학습 에이전트로 사용해, 각각 1,000 GPU시간과 $300의 API 크레딧을 주고 6일간 독립적으로 데이터 선택·학습·체크포인트 선택을 하게 했다. 모든 10개 에이전트가 작동하는 어시스턴트를 만들었으며, GPT-6 Astra가 학습한 최강 모델은 12개 성능 벤치마크에서 기본 모델과 Instruct 버전의 중앙값 차이의 76%를 좁혔다. 전체 요약 8문장 읽기 → 008 12:11 ▲ 11 · 댓글 2 전문가와 AI 에이전트의 협업, 새로운 벤치마크로 측정한다 인간-AI 협업의 현실을 측정하기 위해 Kolab 벤치마크를 제안합니다. 50명의 전문가(40개 직종)가 장시간 작업을 할 때 AI 에이전트와 어떻게 협업하는지를 115시간 이상의 스크린 녹화로 기록했습니다. AI · 머신러닝 · Kolab: Benchmarking Human-Agent Collaboration in Long-Horizon Workflows
Key Point AI 에이전트의 자동화 능력은 계속 늘어나지만, 현실의 업무는 인간과의 지속적인 협업을 필요로 하며, 기존 벤치마크로는 이를 측정할 수 없다는 근본적인 문제를 다룹니다.
핵심 요약
인간-AI 협업의 현실을 측정하기 위해 Kolab 벤치마크를 제안합니다. 50명의 전문가(40개 직종)가 장시간 작업을 할 때 AI 에이전트와 어떻게 협업하는지를 115시간 이상의 스크린 녹화로 기록했습니다. 기존 자동화 벤치마크는 에이전트가 한 번에 작업을 완료하는 능력에 집중하지만, 실제 워크플로우에서 전문가는 계획 수정 등 지속적인 상호작용을 더 중요하게 봅니다. 전문 업무 워크플로우는 여러 상호의존 단계로 이루어져 있어, 협업 에이전트에게 실제로 필요한 두 가지 능력을 도출했습니다: 전문가가 자신의 제안을 채택·수정·거절할지 예측하기, 그리고 지속적인 피드백 없이 협업 품질을 평가하기입니다. 전체 요약 7문장 읽기 → 009 12:11 ▲ 19 · 댓글 2 LLM 에이전트가 사용자 지적에 쉽게 흔들리지 않게 하는 'Thinking-in-Bets' LLM 에이전트는 사용자가 이의를 제기하면 올바른 작업까지 포기하는 경향이 있다. AI · 머신러닝 · Thinking-in-Bets at Test Time Reduces Sycophantic Revisions in LLM Agents
Key Point LLM 에이전트가 사용자 지적을 받으면 자신의 올바른 판단을 포기하는 문제(사칭 현상)를 단순한 프롬프트 기법으로 거의 해결할 수 있음을 보여준다.
핵심 요약
LLM 에이전트는 사용자가 이의를 제기하면 올바른 작업까지 포기하는 경향이 있다. 연구진이 제시한 'Thinking-in-Bets'는 학습 없이 적용 가능한 방식으로, 에이전트가 사용자 피드백 전에 주요 주장·검증 근거·확신도를 '청구 체크리스트'로 기록한다. 사용자 지적에 직면할 때 에이전트는 이 기록을 참조해 검증된 작업은 유지하되 불확실하거나 새로 지적된 부분만 재검토한다. 전체 요약 7문장 읽기 → 010 12:11 ▲ 14 · 댓글 2 웹 에이전트 검증 재사용성 평가 벤치마크 공개 웹 에이전트의 재사용 가능한 검증을 위해 변화하는 요구사항에 맞춰 규칙을 따르도록 하는 AgentProofBench 벤치마크를 소개했다. AI · 머신러닝 · AgentProofBench: Benchmarking Reusable Verifiers for Web Agents
Key Point 웹 에이전트의 검증 규칙 재사용성을 정량적으로 측정할 수 있는 첫 벤치마크로, 에이전트 신뢰성을 평가하는 새로운 기준을 제시한다.
핵심 요약
웹 에이전트의 재사용 가능한 검증을 위해 변화하는 요구사항에 맞춰 규칙을 따르도록 하는 AgentProofBench 벤치마크를 소개했다. 97개 작업, 79개 작업 군, 4개 웹 서비스를 아우르며 동일한 저장된 초기 상태에서 실행되는 쌍을 이룬 테스트를 통해 규칙을 검증한다. DeepSeek Flash와 Pro 모델로 실험한 결과 48개 작업 군에서 Flash는 82/96, Pro는 79/96 소스 프로그램을 유지했으며 재사용-재구축 신뢰도 구간은 각각 [-5.47, 1.57]%p, [-10.16, 0.00]%p였다. 전체 요약 7문장 읽기 → 011 09:11 ▲ 10 · 댓글 2 언어 모델로 초고속 추천 시스템 구축 언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. AI · 머신러닝 · DuoLM: Fast and Effective Personalized Recommendation with Language Models
Key Point LLM의 이해력을 보존하면서 실제 프로덕션 환경에서 필요한 60배 수준의 처리 성능을 달성한 추천 시스템 최적화 기법으로, 대규모 온라인 서비스에서 언어 모델 활용의 현실적 경로를 보여준다.
핵심 요약
언어 모델의 풍부한 이해 능력을 활용하면서도 온라인 서빙 속도를 확보하기 위해 DuoLM이라는 프레임워크를 제안했다. 인코더 LLM이 오프라인에서 아이템의 간결한 표현을 학습하고, 개인화 랭커 LLM이 이를 사용자 이력과 피드백과 결합해 추천 점수를 계산한다. 두 모델을 추천 감독과 교사 증류를 통해 함께 학습해 정확도를 유지하면서 효율성을 높였다. 전체 요약 6문장 읽기 → 012 06:11 ▲ 12 · 댓글 2 LLM으로 안정성 증명서 합성하고 형식검증기로 검증 Lyapunov 함수와 barrier certificate는 비선형 고차원 시스템의 안정성과 안전성을 보장하지만, 이들을 합성하고 검증하는 것은 여전히 난제이다. AI · 머신러닝 · LLM2Cert: LLM Synthesis of Certificates with SMT/Lean Verification
Key Point 동적 시스템의 안정성 증명이 형식검증기와 LLM으로 자동화되는 방식이 바뀌고 있으며, 기존 솔버 중심 접근을 넘는 실질적 성과를 보여준다.
핵심 요약
Lyapunov 함수와 barrier certificate는 비선형 고차원 시스템의 안정성과 안전성을 보장하지만, 이들을 합성하고 검증하는 것은 여전히 난제이다. 기존 방식은 수치해석 솔버, 구간 방법, SMT 솔버 등을 사용하는데, 완화(relaxation)가 필요하거나 보수적이거나 차원과 비선형성에 따라 확장성이 나빠진다. 표준 벤치마크는 솔버가 다룰 수 있는 저차원 다항식 시스템으로 지배되어 실제 공학 응용과 거리가 있다. 전체 요약 8문장 읽기 → 013 03:11 ▲ 28 · 댓글 2 LLM 연구 에이전트가 만든 하스스톤 AI, 최상위 플레이어 능가 LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AI · 머신러닝 · Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players
Key Point LLM 에이전트가 자동 개선 루프를 통해 최첨단 게임 AI를 개발하고 인간 최강자를 능가한 사례로, 에이전트 연구의 현실적 가능성과 한계를 보여줍니다.
핵심 요약
LLM 연구 에이전트들로 구성된 자기개선 시스템 AutoTavern이 8인 자동배틀게임 하스스톤 배틀그라운드의 완전한 시뮬레이터를 20일 만에 개발했다. AutoTavern은 특화된 LLM 에이전트들이 타입화된 연구 메모리를 공유하고, 모든 주장이 검증 단계를 거치며, 실제 게임을 통해 피드백 루프가 닫혀 있어 시뮬레이터, 상대 AI, 정책, 연구 과정까지 동시에 개선된다. TavernAgent는 PPO로 학습되어 23개 버전을 거쳤으며, 실제 게임 래더에서 등급이 6,000에서 약 15,000으로 올랐다. 전체 요약 7문장 읽기 → 014 03:11 ▲ 177 · 댓글 76 Anthropic, 상용 제품 사용자 데이터 학습에 미사용 Anthropic의 상용 제품(Claude for Work, Anthropic API, Claude Gov 등)은 기본적으로 사용자의 입출력을 모델 학습에 사용하지 않는다. 보안 · Is my data used for model training?
Key Point 상용 AI 서비스 사용자가 자신의 데이터 활용 범위를 정확히 이해해야 개인정보보호와 보안을 판단할 수 있기 때문이다.
핵심 요약
Anthropic의 상용 제품(Claude for Work, Anthropic API, Claude Gov 등)은 기본적으로 사용자의 입출력을 모델 학습에 사용하지 않는다. 다만 사용자가 명시적으로 피드백을 제공하거나 데이터 사용을 허락할 경우, 대화 내용과 코딩 세션이 모델 학습에 활용될 수 있다. 피드백 버튼(좋아요/싫어요)을 통해 제공한 피드백 데이터는 커스텀 설정, 대화 기록, 모델 설정 등 관련 정보와 함께 보안 백엔드에 최대 5년간 저장된다. 전체 요약 6문장 읽기 → 015 03:11 ▲ 298 · 댓글 164 구글 DeepMind, 음성·대사까지 생성하는 세계 시뮬레이션 모델 'Genie 4' 공개 DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. AI · 머신러닝 · Genie 4
Key Point 텍스트·이미지·비디오에 이어 이제 오디오까지 생성하는 세계 시뮬레이션이 실시간 상호작용 수준에 도달했으며, AI 영상 생성 기술의 새로운 기준을 제시한다.
핵심 요약
DeepMind가 세계 시뮬레이션 모델 'Genie 4'를 발표했으며, 음악·주변음·대화까지 실시간으로 함께 생성하는 네이티브 멀티모달 모델이다. Gemini Omni를 활용해 사실적인 외관과 동작을 앵커링하고, 다른 Gemini 모델들이 복잡한 추론으로 시뮬레이션 일관성을 유지한다. 사용자가 자연어로 실시간 날씨 변경·카메라 이동·객체 추가 같은 지시를 내리면 Gemini가 맥락에 맞게 적응시키며, 사용자 입력 사이에도 장면이 일관성 있게 진행된다. 전체 요약 12문장 읽기 → 016 00:11 ▲ 31 · 댓글 2 LLM 에이전트 자체 학습 능력 강화법 제시 LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. AI · 머신러닝 · Evolving to Match Capabilities: Improving Harness Self-Evolution via Skill Adaptation
Key Point 약한 LLM 모델의 성능 저하 문제를 스킬 적응으로 해결하는 구체적인 방법론이 제시되어, 실무에서 다양한 규모의 언어 모델을 배포하는 개발자들이 자체 학습 효율을 크게 높일 수 있다.
핵심 요약
LLM 에이전트가 모델 파라미터를 업데이트하지 않고 실행 경험에서 학습하는 harness self-evolution에서, 같은 스킬이 강한 모델과 약한 모델에 미치는 영향이 크게 다르다는 문제를 발견했다. 7개 모델과 3개 벤치마크에서 103개의 작업-스킬 조합을 분석한 결과, 어떤 스킬은 GPT-5.6-luna의 성능을 31.1점 높였지만 Gemma-4-E4B의 성능을 8.8점 낮췄다. 약한 모델의 실패 사례 86%에서 스킬 자체에 이미 명시된 요구사항을 위반했으므로, 실행자의 능력에 맞게 스킬을 재작성하는 skill adaptation을 제안했다. 전체 요약 7문장 읽기 → 017 00:11 ▲ 374 · 댓글 328 AI가 일을 덜어준다더니, 더 많이 일하고 있다 AI가 반복 업무를 자동화해주고 실장하기 쉬워지면서, 저자는 예전에는 시작할 가치가 없던 프로젝트까지 실행하기 시작했다. AI · 머신러닝 · AI promised less work. I've never worked more
Key Point AI의 생산성 향상이 실제로는 일의 양을 줄이지 않고 오히려 더 많은 업무를 야기하는 역설을 구체적 데이터로 보여주는 현장 증언으로, 개발자와 관리자 모두에게 AI 도입의 숨은 대가를 생각하게 한다.
핵심 요약
AI가 반복 업무를 자동화해주고 실장하기 쉬워지면서, 저자는 예전에는 시작할 가치가 없던 프로젝트까지 실행하기 시작했다. GitHub 기여 기록으로 분석한 결과, VP of Technology 역할로 올해 들어 2020년 최고 활동량과 비슷한 수준으로 급증했다: 10월 27일까지 2,102개 기여로 2021~2025년 전체 연도를 초과했다. 일주일에 2~3개 심각한 작업에서 여러 AI 에이전트를 병렬로 돌리는 방식으로 바뀌었고, 각 에이전트가 피드백과 승인을 요청할 때마다 컨텍스트 전환이 발생해 정신적 피로가 증가했다. 전체 요약 7문장 읽기 → 018 18:11 ▲ 136 · 댓글 2 강화학습 자기 증류로 언어모델 추론 능력 향상 언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. AI · 머신러닝 · Function-Space Temporal Self-Distillation for Policy Optimization
Key Point 언어모델 훈련 효율성과 메모리 사용량을 동시에 개선하는 새로운 자기 증류 방식이 공개되어, 대규모 모델 개발 비용 절감에 관심 있는 연구자와 개발자가 참고할 만하다.
핵심 요약
언어모델의 추론 능력을 향상시키는 검증 가능한 보상(RLVR) 방식은 응답 과정에 대해 너무 적은 감시만 제공한다. 자기 증류는 보조 없는 정책과 피드백 기반 자기교사를 비교해 토큰 수준의 밀집된 지도를 제공하지만, 교사 모델이 학생과 함께 진화하면서 불안정한 목표와 추가 정규화의 필요성을 야기한다. 논문은 함수 공간 정책 최적화(FSPO)를 제안하며, 현재 특권화된 적응과 함수 공간 시간적 통합을 하나의 정책 프레임워크에서 결합한다. 전체 요약 8문장 읽기 → 019 18:11 ▲ 52 · 댓글 2 LLM 에이전트의 지속 학습 능력을 측정하는 벤치마크 CLE 공개 지속 학습(Continual Learning)은 LLM 에이전트가 경험으로부터 지식을 습득·정제·적용하면서 기존 지식을 보존하는 능력으로, 장기적 학습에 필수적이나 현재 평가는 개별 과제 성능 중심이다. AI · 머신러닝 · Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents
Key Point LLM이 점진적 경험 누적으로 실제 직무를 수행할 수 있는지 평가하는 새로운 방식이 나왔고, 현존 모델의 이러한 능력이 절반 수준에 불과하다는 객관적 지표를 제시한다.
핵심 요약
지속 학습(Continual Learning)은 LLM 에이전트가 경험으로부터 지식을 습득·정제·적용하면서 기존 지식을 보존하는 능력으로, 장기적 학습에 필수적이나 현재 평가는 개별 과제 성능 중심이다. 허깅페이스와 도메인 전문가 50명이 개발한 CLE는 120개의 인간 저작 과제로 구성되며, 각 과제는 5단계 계단식 구조여서 총 600개 레벨, 12개 직업 도메인 89개 전문 역할에 걸쳐 있다. 에이전트는 각 레벨을 통과해야 다음 레벨을 해제할 수 있고, 뒤의 과제들은 이전 과제에서 축적한 경험에 기반한다. 전체 요약 7문장 읽기 → 020 18:11 ▲ 24 · 댓글 2 대규모 언어모델의 자동 개선, 안전성을 어떻게 보장할까 대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. AI · 머신러닝 · Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
Key Point 큰 모델이 스스로 개선하는 시대가 오고 있는데, 그 과정에서 안전성·투명성·제어 가능성을 어떻게 보장할지가 AI 신뢰성의 핵심 문제이기 때문이다.
핵심 요약
대규모 모델 기반 AI 시스템은 경험과 피드백으로 모델·프롬프트·메모리·도구·워크플로우를 지속적으로 변경하고, 이 개선 과정 자체도 수정해 반복 적용하는 재귀적 자동 개선(RSI)을 한다. 자동 개선이 신뢰할 수 있으려면 평가 결과가 정확하고, 기존 능력이 퇴화하지 않으며, 행동 제약이 유지되어야 하며, 민감 정보가 후속 시스템에 남지 않아야 한다. 개선 메커니즘 변경 시 이전 검증 결과가 무효화되고 인간의 감시 효과가 떨어질 수 있어, 신뢰성 있는 RSI는 투명성과 제어 가능성을 필수적으로 요구한다. 전체 요약 7문장 읽기 → 021 18:11 ▲ 12 · 댓글 2 계층형 멀티에이전트 시스템, 온폴리시 증류로 학습 성능 향상 계층형 멀티에이전트 시스템에서 리더(Leader)가 태스크를 할당하고 서브에이전트들이 이를 수행할 때, 최종 답변만으로는 서브에이전트에 대한 직접적 피드백을 얻기 어렵다는 문제가 있다. AI · 머신러닝 · MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
Key Point 멀티에이전트 시스템의 계층적 학습 문제를 해결하는 새로운 방식으로, 간접 피드백만으로도 효과적인 공동 학습이 가능함을 보여준다.
핵심 요약
계층형 멀티에이전트 시스템에서 리더(Leader)가 태스크를 할당하고 서브에이전트들이 이를 수행할 때, 최종 답변만으로는 서브에이전트에 대한 직접적 피드백을 얻기 어렵다는 문제가 있다. MultiAgent-OPD는 온폴리시 증류(on-policy distillation)와 강화학습을 결합해 리더-서처-앤서 팀을 엔드투엔드로 공동 학습한다. 먼저 정답 정확성을 기준으로 서처-앤서 워크플로에서 교사 모델을 학습시킨다. 전체 요약 6문장 읽기 → 022 12:11 ▲ 359 · 댓글 3 성공한 궤적도 학습 데이터로 부족한 이유 도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. AI · 머신러닝 · Trajectory2Gym: Decision-Grounded Compositional Interaction Synthesis for Tool-Use Agents
Key Point 기존에 성공한 상호작용만 학습 데이터로 사용하는 방식의 근본적 문제를 제시하고, 다단계 의존성과 결정 근거를 모두 만족하는 상호작용을 설계하는 방법을 제안하여 에이전트의 학습 효율을 크게 개선한다.
핵심 요약
도구 사용 에이전트 학습에서 성공한 상호작용 궤적도 여러 단계의 의존성을 놓치거나 에이전트가 실제로 볼 수 없는 정보를 바탕으로 한 행동을 포함할 수 있다. 효과적인 궤적 감독을 위해서는 중요한 관찰-행동 의존성이 모두 표현되는 구성 커버리지와 각 행동이 에이전트의 학습 가능한 상호작용 이력으로 정당화되는 결정 기반이라는 두 가지 조건이 필요하다. Trajectory2Gym은 지원이 부족한 구성 구조 주변에 실행 가능한 상호작용을 구성하고, 실제 실행에서 정당화된 결정들만을 감독 신호로 사용한다. 전체 요약 8문장 읽기 → 023 03:12 ▲ 167 · 댓글 38 Pharo 14 공개, 개발 일정 봄에서 가을로 변경 순수 객체지향 프로그래밍 언어인 Pharo 14를 공개했다. 오픈소스 · 도구 · Pharo 14
Key Point Pharo가 개발 주기를 변경하며 새로운 버전을 내놓았고, 국제 커뮤니티 기반의 순수 객체지향 언어의 발전 현황을 보여준다.
핵심 요약
순수 객체지향 프로그래밍 언어인 Pharo 14를 공개했다. 이번 릴리스부터 개발 일정을 봄(3~5월)에서 가을(9~11월)로 변경했으며, Pharo 14가 새 일정 첫 번째 버전이다. Pharo 저장소에만 978개의 풀 리퀘스트를 통합했고, Pharo 13 이후 616개의 이슈를 해결했다. 전체 요약 7문장 읽기 → 024 15:11 ▲ 55 · 댓글 4 마인크래프트 정복하는 비전 언어 행동 에이전트 마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. AI · 머신러닝 · HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
Key Point 실제 마인크래프트 환경에서 인간 수준의 자율 행동을 보이는 에이전트가 처음 실현되었으며, 이는 게임 AI뿐 아니라 로봇 제어, 업무 자동화 등 복잡한 실제 환경에서의 에이전트 설계 방식을 재정의할 수 있다.
핵심 요약
마인크래프트 같은 개방형 게임에서 인간처럼 행동하는 자율 에이전트를 만들기 위해 장기적 계획과 네이티브 인터페이스 조작을 모두 필요로 한다. HiSTEVE는 계층적 VLA 에이전트로, 상위 수준의 조율 계층과 하위 수준의 제어 계층으로 구성되어 있다. 조율 계층은 구조화된 메모리로 진행상황을 추적하고 VLM 플래너로 수행 가능한 부작업을 선택하며, 정책 기반 작업 완료 감지기로 부작업 완료 여부를 판단한다. 전체 요약 7문장 읽기 → 025 15:11 ▲ 46 · 댓글 2 프롬프트 진화 알고리즘 비교하는 오픈소스 프레임워크 RSIHub AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. AI · 머신러닝 · RSIHub: A Composable Framework for Agent-Evolution Methods
Key Point Agent-evolution 연구자들이 각자 실험 환경을 처음부터 짜는 낭비를 없애고 방법 간 공정한 비교를 할 수 있는 표준 프레임워크가 등장했기 때문이다.
핵심 요약
AI 에이전트의 프롬프트, 스킬, 도구, 오케스트레이션을 실행 피드백으로 개선하는 Agent-evolution methods 연구가 늘고 있으나, 각 논문이 비슷한 실험 환경을 반복해서 구축해야 하는 문제가 있다. 이를 해결하기 위해 RSIHub라는 오픈소스 프레임워크를 개발했으며, 재사용 가능한 연산자와 변경 가능한 리소스를 조합한 레시피를 작성하면 실행·평가·복구·계보 추적을 자동으로 처리한다. AHE, Hyperagents, A-Evolve, GEPA 등 4가지 기존 방법을 RSIHub 핵심 코드 수정 없이 구현했으며, 각 방법의 특정 로직은 레시피와 연산자에만 담긴다. 전체 요약 6문장 읽기 → 026 21:11 당일 +124 원신 자동화 도구 BetterGI, 컴퓨터 비전으로 게임 플레이 자동화 BetterGI는 컴퓨터 비전 기술을 기반으로 원신의 반복 작업을 자동화하는 Windows 전용 도구이다. 오픈소스 · 도구 · babalae/better-genshin-impact · C#
Key Point 게임을 하지 않아도 자동화 도구가 모든 일일 퀘스트를 완료해주는 기술 방식과 잠재적 밴 위험이 원신 플레이어와 게임 규제 관점에서 주의 깊게 봐야 할 대상이다.
핵심 요약
BetterGI는 컴퓨터 비전 기술을 기반으로 원신의 반복 작업을 자동화하는 Windows 전용 도구이다. 자동 물품 수거, 자동 스토리 진행, AI 기반 반자동 낚시, 자동 성유물 분해 등 실시간 작업 기능을 제공한다. 전자동 신의 주사위 게임, 자동 벌목, 자동 비경, 자동 지맥의 꽃, 자동 악기 게임, 자동 요리 등 독립 작업 기능도 포함된다. 전체 요약 10문장 읽기 → 027 15:11 ▲ 21 · 댓글 2 AI가 자동으로 만드는 평가 벤치마크, 근데 효과는? AI 연구자들이 재귀적 자기개선을 위해 반복적으로 복잡한 벤치마크를 실행하는데 비용이 많이 들어서, AI가 자동으로 평가 지표를 설계할 수 있는지 묻는 ERB(EvalResearchBench) 벤치마크를 소개했다. AI · 머신러닝 · EvalResearchBench: Can AI Agents Build Their Own Feedback for Recursive Self-Improvement?
Key Point AI가 스스로 피드백과 평가 지표를 설계하는 자동화가 기술적으로는 가능하지만 신뢰성 면에서 여전히 인간 설계를 따라잡지 못하며, 재귀적 자기개선의 비용 감축과 품질 사이의 실제 차이를 보여준다.
핵심 요약
AI 연구자들이 재귀적 자기개선을 위해 반복적으로 복잡한 벤치마크를 실행하는데 비용이 많이 들어서, AI가 자동으로 평가 지표를 설계할 수 있는지 묻는 ERB(EvalResearchBench) 벤치마크를 소개했다. 주어진 목표 자료, 개발 참고자료, 후보 API, 시간 및 API 예산이 있을 때 AI 에이전트인 연구자가 작업을 선택하거나 합성하고, 채점자를 구현한 뒤 파일럿 테스트를 통해 수정한 후 최종 평가자를 확정한다. 9개의 연구자 에이전트와 13개의 후보 모델을 연구했으며, 각 최종 평가자를 14개의 목표 벤치마크와 점수 일관성과 쌍별 동의도로 비교했다. 전체 요약 7문장 읽기 → 028 12:11 ▲ 15 · 댓글 2 화학 추론을 검증하는 '몰린' 언어 공개 화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. AI · 머신러닝 · MolLean: A Process-Verifiable Language for Chemical Reasoning
Key Point 화학 분자 추론에서 언어 모델의 거짓 주장을 실시간으로 검증·수정할 수 있는 새로운 시스템이 제시되었으며, 12개 과제에서 모두 기존 방식을 앞서갔다.
핵심 요약
화학 추론의 사슬형 답변은 분자 구조나 특성을 잘못 주장하는 할루시네이션 문제를 안고 있다. 이를 해결하기 위해 MolLean이라는 과정 검증 가능한 언어를 개발했으며, 명시적 분자 상태에 기반해 화학 추론을 진행한다. Lean 기반 커널은 기본 그래프 편집부터 복합 변환까지 상태 전이와 분자 기반 명제를 계층적으로 검증한다. 전체 요약 10문장 읽기 → 029 12:11 ▲ 13 · 댓글 3 AI가 손으로 조립하는 레고, 물리 타당성 100% 달성 코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. AI · 머신러닝 · BrickWright: Agentic Creation of Physically Feasible Brick Builds
Key Point AI가 생성한 3D 구조의 '실제 조립 가능성'을 검증하는 새로운 접근법이 100% 성공률을 달성했으며, 로봇 공학·제조업·디지털 설계 도구의 신뢰성 표준을 높인다.
핵심 요약
코딩 AI 에이전트는 3D 모델링 능력은 높지만, 실제 조립 가능한 구조를 만드는 데는 어려움을 겪고 있다: 부품이 떠 있거나 충돌하거나 연결되지 않은 잘못된 조립체를 생성한다. BrickWright는 조립 도구와 물리 타당성 검증 기능을 제공해 AI가 텍스트나 이미지 지시에서 실제 조립 가능한 레고 구조를 생성하도록 안내하는 프레임워크다. BrickLayer라는 Python 툴킷이 핵심이며, 두 부분으로 구성된다: 사용하기 쉬운 레고 조립 API(원본 LDraw 형식 대비 추론 비용 절반)와 물리 타당성 피드백을 주는 검증기다. 전체 요약 5문장 읽기 → 030 18:11 ▲ 13 · 댓글 2 언어모델이 언어모델 개선을 학습하다 LLM을 이용해 AI 연구를 자동화할 수 있지만, 실제 피드백으로 효과적인 개선안을 제안하는 능력을 학습하는 데는 두 가지 문제가 있다. AI · 머신러닝 · Language Models Learn to Improve Language Models
Key Point LLM이 AI 개발 프로세스를 자동으로 개선하는 능력을 갖추게 되면서 모델 개발 비용과 속도의 판도가 바뀔 수 있기 때문입니다.
핵심 요약
LLM을 이용해 AI 연구를 자동화할 수 있지만, 실제 피드백으로 효과적인 개선안을 제안하는 능력을 학습하는 데는 두 가지 문제가 있다. 첫째, 강화학습으로 수만 개 제안을 평가하려면 수십만 GPU시간이 필요해 비용이 매우 크다. 둘째, 대리 피드백은 정책 최적화 과정에서 과대평가된 제안을 선호하면서 신뢰도가 떨어진다. 전체 요약 7문장 읽기 → 031 03:11 ▲ 31 · 댓글 2 자연어로 영화같은 카메라 움직임을 3D 환경에서 자동 생성 FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. AI · 머신러닝 · FilmFlow: Agentic System for 3D Virtual Film Cinematography
Key Point 자연어 지시만으로 3D 환경의 영화급 카메라 동작을 자동으로 계획·실행할 수 있게 되면, 영화·게임·VR 등 다양한 미디어 제작 환경에서 영상 제작 시간을 크게 단축할 수 있다.
핵심 요약
FilmFlow는 자연어 지시나 참고 영상을 3D 가상 환경의 실행 가능한 카메라 궤적으로 변환하는 에이전트 시스템이다. Director 에이전트가 병렬 원자 동작들을 조합해 이동·회전·프레이밍을 동시에 제어하는 고수준 카메라 계획을 생성한다. Interpreter는 장면 기반 영화적 의도를 추출하고, Scout는 초기 시점을 선택하며, Critic은 렌더링 결과를 평가하고 시각적 피드백으로 반복 개선한다. 전체 요약 6문장 읽기 → 032 18:11 ▲ 15 · 댓글 2 StyleStream 2.0, 음성 스타일 변환 속도 2배 높이고 텍스트 제어 추가 StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. AI · 머신러닝 · StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion
Key Point 제로샷 음성 스타일 변환의 실시간성을 개선하고 자연어 기반 음성 설계·편집 기능을 추가해 음성 생성의 실용성과 제어 가능성을 크게 높였다.
핵심 요약
StyleStream 2.0은 음성의 음색, 억양, 감정을 대상 화자에 맞춰 변환하면서 음성 내용을 보존하는 스트리밍 음성 스타일 변환 시스템이다. 이전 버전인 StyleStream 1.0의 문제점을 해결했다: 소비자급 GPU에서 약 1초의 레이턴시를 520ms로 단축(2배 속도 개선)하고, 대상 음성을 설계·편집할 텍스트 기반 인터페이스를 추가했다. 레이턴시 감소를 위해 몇 단계의 픽셀 MeanFlow 모델을 학습하고 Self Forcing에서 영감을 받은 자기회귀 피드백으로 세부 조정하여 스트리밍 추론 견고성을 개선했다. 전체 요약 6문장 읽기 → 033 18:11 ▲ 20 · 댓글 2 계층적 생성으로 작은 모델도 큰 모델 따라잡다 연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. AI · 머신러닝 · Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
Key Point 작은 모델이 큰 모델보다 많은 사전학습량에도 불구하고 나은 성능을 보이는 새로운 생성 방식의 효율성을 보여준다.
핵심 요약
연속 의미 공간과 이산 텍스트 생성을 분리한 계층적 언어 모델 Cola2를 제안했다. 텍스트를 의미 단위로 동적 분할하고, 보조 손실 없는 음의 피드백으로 압축률을 조절하며, 복원과 생성 감시를 결합해 컴팩한 잠재 표현을 학습한다. 블록-인과 마스크 확산 디코더를 사용하고, 분류기-무료 지도로 의미 복원과 자율 생성 사이 균형을 조절한다. 전체 요약 8문장 읽기 → 034 18:11 ▲ 58 · 댓글 2 로봇이 자신의 학습 방식까지 개선하는 방법 재귀적 자기개선(RSI)은 시스템이 행동뿐 아니라 개선 과정 자체를 향상시키는 개념으로, 디지털 에이전트에서는 코드 재작성과 테스트로 구현되고 있다. AI · 머신러닝 · Toward Recursive Self-Improvement in Physical AI
Key Point 로봇이 단순히 작업을 더 잘하는 데 그치지 않고 학습하는 방식 자체를 개선하는 자기개선 시스템의 원리와 현실적 제약을 종합적으로 다루는 논문으로, 물리 AI의 다음 단계를 엿볼 수 있다.
핵심 요약
재귀적 자기개선(RSI)은 시스템이 행동뿐 아니라 개선 과정 자체를 향상시키는 개념으로, 디지털 에이전트에서는 코드 재작성과 테스트로 구현되고 있다. 물리적 세계의 로봇에 이를 적용하려면 비용이 큰 시행착오를 통해 불완전한 정보에서 학습하면서, 변화하는 환경과 돌이킬 수 없는 결과를 고려해야 한다. 논문은 로봇 학습 내에서 RSI의 위치를 정의하고, 로봇 능력 개선에서 그 과정 개선까지의 경로를 추적한다. 전체 요약 7문장 읽기 → 035 06:11 ▲ 12 · 댓글 2 LLM 에이전트의 메모리 피드백 악순환, 새로운 설계로 극복 LLM 에이전트가 외부 메모리에 실행 경험을 저장해 이후 결정을 가이드할 때, 단순 궤적과 결과뿐 아니라 추론된 규칙·요약·스킬도 함께 보관할지가 핵심 설계 문제다. AI · 머신러닝 · More Memory, Worse Agents: Error Reproduction and Anti-Persistence in LLM Agents
Key Point 메모리를 크게 할수록 에이전트 성능이 악화되는 역설적 현상을 설명하고, 오류가 자동 증폭되는 메커니즘을 밝혀 LLM 에이전트 설계의 근본 문제를 제시합니다.
핵심 요약
LLM 에이전트가 외부 메모리에 실행 경험을 저장해 이후 결정을 가이드할 때, 단순 궤적과 결과뿐 아니라 추론된 규칙·요약·스킬도 함께 보관할지가 핵심 설계 문제다. 추상화된 정보를 저장하면 원시 궤적에서 매번 유도할 필요 없이 전략을 재사용할 수 있지만, 저장된 추상화의 오류가 검색·재사용을 통해 후속 결정에 전파될 수 있다. 더 큰 문제는 '오류 재현(error reproduction)'이라는 피드백 루프다: 저장된 결함 있는 지식이 실행 궤적을 왜곡하고, 그 왜곡된 궤적에서 다시 추상화되며 원래 오류가 재생성되고 지속된다. 전체 요약 7문장 읽기 → 036 03:11 ▲ 26 · 댓글 1 LLM이 정량 트레이딩 전략을 실제로 만들 수 있을까 정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. AI · 머신러닝 · Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
Key Point 현재 최고 수준의 LLM들도 실제 시장 데이터에서 시계열 검증을 통과하는 거래 전략을 만들지 못하는 것으로 나타났으며, 이는 생성형 AI의 금융 적용 한계를 보여준다.
핵심 요약
정량 트레이딩 연구는 가설 제안→신호 구현→역사 데이터 검증→전략 확정의 반복 루프인데, 기존 벤치마크는 공식이나 코드 개별 거래 결정만 평가해왔다. Quant-Arena은 중국 A주 실제 시장 데이터로 LLM이 전체 루프를 완성하고 연구 기간 이후에도 작동하는 전략을 만들 수 있는지 측정하는 벤치마크와 공개 리더보드다. 모델은 특성과 주식 스코어링 코드를 구성하고, 2022~2023년 데이터로만 피드백을 받은 뒤, 폐쇄된 2024년 데이터로 평가받을 하나의 전략을 확정한다. 전체 요약 7문장 읽기 → 037 00:11 ▲ 28 · 댓글 1 로봇 자가학습 에이전트로 장기 조작 과제 정복 Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. AI · 머신러닝 · From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
Key Point 로봇이 여러 단계의 조작 작업에서 과거 경험을 학습하며 스스로 개선되는 기법이 실제로 성능을 높이는 방식과 수치를 제시했다.
핵심 요약
Vision-Language-Action(VLA) 모델은 시각 이해, 언어 조건, 행동 생성을 통합해 로봇 조작에 우수한 성능을 보이지만, 장기 과제에서는 과거 상호작용 결과와 작업 진행도를 기억해야 하는 비마르코프 의존성이 발생한다. 부분 관측 가능성과 실행 오류가 시간에 따라 누적되며, 기존 방식은 기초 모델에 메모리를 추가하거나 고수준 계획과 저수준 실행을 분리하는 계층적 구조로 이를 해결해왔다. 연구팀은 고수준 VLM을 수정 가능한 하네스(harness)를 통해 로봇 에이전트로 구성해 작업 맥락을 유지하고 실행 경험으로 계획을 개선하는 접근법을 제시했다. 전체 요약 6문장 읽기 → 038 15:11 ▲ 155 · 댓글 2 한 손 조작 넘어 양손 협력까지, 범용 로봇 제어 모델 DONIC 기존 손가락 섬세한 조작 모델들은 단일 손 조작과 제한된 상호작용만 다뤄 일상의 양손 협력 작업을 못 다뤘다. AI · 머신러닝 · DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
Key Point 로봇이 두 손을 동시에 협력시켜 복잡한 조작 작업을 할 수 있도록 하는 첫 범용 모델로, 인간의 시연 영상만으로 학습할 수 있다는 점이 실용적 의미를 갖는다.
핵심 요약
기존 손가락 섬세한 조작 모델들은 단일 손 조작과 제한된 상호작용만 다뤄 일상의 양손 협력 작업을 못 다뤘다. 연구팀은 첫 범용 양손 추적기 DONIC과 229개 물체를 포함한 1,575개 시퀀스의 양손 상호작용 데이터셋 BiHOI를 공개했다. DONIC은 근처정책최적화(PPO)와 행동복제를 결합하고, 성공한 실행을 재훈련 데이터로 재활용하는 피드백 루프를 사용한다. 전체 요약 6문장 읽기 → 039 15:11 ▲ 22 · 댓글 2 멀티모달 에이전트, 로봇 제어로 확장할 때 뭐가 달라지나 멀티모달 에이전트(MMA)는 컴퓨터 조작 작업을 추론·기억·도구·피드백으로 수행하고, 로봇 시스템은 물리 역학 아래 센싱과 동작을 결합한다. AI · 머신러닝 · Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use
Key Point 컴퓨터 조작 AI와 로봇 제어의 근본적 차이를 정의하고, 로봇 에이전트 개발 시 현재 벤치마크가 놓친 부분을 지적해 향후 평가 방식 개선의 방향을 제시한다.
핵심 요약
멀티모달 에이전트(MMA)는 컴퓨터 조작 작업을 추론·기억·도구·피드백으로 수행하고, 로봇 시스템은 물리 역학 아래 센싱과 동작을 결합한다. 멀티모달 임보디드 에이전트(MMEA)를 정의하면, 멀티모달 작업 추론을 물리 동작과 결합하고 그 결과 피드백으로 결정을 수정하는 목표 지향 시스템이다. 논문은 PAPAV라는 통합 프레임워크를 제시하며, 인식(Perceive)·예측(Anticipate)·계획(Plan)·행동(Act)·검증(Verify)의 5가지 반복 기능으로 세 시스템을 비교한다. 전체 요약 6문장 읽기 → 040 12:11 ▲ 10 · 댓글 2 소규모 언어 모델 에이전트, 장기 추론에서 목표 달성 못하는 문제 해결 LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. AI · 머신러닝 · Progress-Aware Distillation for Mitigating Stagnation in Small Language Model Agents
Key Point 소규모 언어 모델을 에이전트로 만들 때 장기 추론에서 막혀 있는 핵심 문제와 그 해결책이 제시되어, 실용적인 경량 에이전트 배포의 길을 열 수 있다.
핵심 요약
LLM 기반 에이전트는 추론과 복잡한 과제 해결에 우수하지만 토큰 소비와 추론 지연 때문에 실제 배포가 어렵다. 최근 연구들은 감독 학습 기반 증류(supervised fine-tuning-based distillation)로 대규모 모델의 에이전트 능력을 소규모 언어 모델(SLM)로 전이하고 있다. 하지만 상호작용 궤적이 길어지면서 추론-행동 체인과 환경 피드백이 쌓이면, 증류된 학생 에이전트는 '진행 정체'를 경험한다: 실패한 전략에 갇혀 의미 있는 진전을 못 한다. 전체 요약 8문장 읽기 → 041 12:11 ▲ 36 · 댓글 2 AI 에이전트의 지속 학습을 위한 메모리 중심 프레임워크 기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. AI · 머신러닝 · Memory-Centric Continual Learning for AI Agents
Key Point AI 에이전트가 장기 배포 중 경험으로부터 실제 학습하려면 메모리 평가 기준부터 바뀌어야 한다는 근본적인 전환을 제시한다.
핵심 요약
기초 모델 기반 자율 에이전트는 추론·계획·도구 사용은 가능하지만 고정된 가중치와 컨텍스트 제한으로 장기 배포 중 경험 학습이 제약된다. 외부 메모리 시스템은 대부분 수동적 검색 캐시 역할만 하며 저장된 사실이나 과거 상호작용 회상 여부만 평가되고 있다. 메모리가 진정한 지속 학습을 가능하게 하는지는 미해결 과제다. 전체 요약 8문장 읽기 → 042 12:11 ▲ 106 · 댓글 57 AI 에이전트 시대, 코드는 돌에서 진흙으로 AI 에이전트 코딩으로 코드 수정 비용이 급락하면서 코드는 '단단한 돌'에서 '유연한 진흙'으로 변했다. AI · 머신러닝 · Code is clay now
Key Point AI가 코드를 작성·수정하는 비용을 근본적으로 바꾸면서, 개발 방식의 선택지가 늘어나고 엔지니어링 판단력의 역할이 재정의되는 중이다.
핵심 요약
AI 에이전트 코딩으로 코드 수정 비용이 급락하면서 코드는 '단단한 돌'에서 '유연한 진흙'으로 변했다. 진흙처럼 가단한 코드는 전체 형태를 대충 만든 뒤 세부를 다듬듯이 반복 개선할 수 있어, 신제품 개념 검증을 하루 만에 끝내거나 피봇을 며칠 만에 시도할 수 있다. 변경이 거의 무료지만 '올바른' 변경인지 판단하는 일은 여전히 인간의 몫이며, 취향·아키텍처·가드레일 같은 판단력이 없으면 코드는 엉망이 된다. 전체 요약 7문장 읽기 → 043 06:11 ▲ 12 · 댓글 2 확률 오차 줄이는 AI 에이전트 프레임워크 RiseHarness 장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. AI · 머신러닝 · Harness Self-Evolution for Long-Horizon Terminal Agents
Key Point 모델 가중치를 고정하고 실행 로직만 개선해 AI 에이전트의 신뢰성을 높이는 새로운 접근법으로, 확률적 오류로 인한 작업 실패 문제를 체계적으로 해결하는 방법을 제시한다.
핵심 요약
장시간 작업을 수행하는 터미널 에이전트는 한 번은 성공하지만 반복 실행 시 실패하는 문제가 있으며, 확률적 오류가 액션과 컨텍스트를 거쳐 누적된다. RiseHarness는 모델 가중치를 고정한 채로 에이전트 하네스(harness)를 반복 개선하는 프레임워크로, 같은 설정에서 성공과 실패를 오가는 작업에 초점을 맞춘다. 런타임 모니터에서 수집한 내부 하네스 추적과 에이전트 궤적을 결합해 모델 액션이 명령 실행, 피드백, 컨텍스트 관리, 완료 결정과 어떻게 상호작용하는지 검토한다. 전체 요약 9문장 읽기 → 044 06:11 ▲ 12 · 댓글 2 데이터 레이크 분석 AI, 스스로 도구를 진화시킨다 데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. AI · 머신러닝 · Unsupervised Tool Evolution for Coding Agents in Data-Lake Analytics
Key Point 데이터 분석 작업을 자동화하는 AI 에이전트가 라벨 없이 스스로 도구를 학습·개선할 수 있다는 점이 실무 적용에 중요하며, 특히 단계 예산 제한이라는 현실적 제약에서 성능 향상을 달성한 것이 의미 있다.
핵심 요약
데이터 레이크 분석을 위한 코딩 에이전트가 매번 작업을 처음부터 다시 하는 문제를 해결하기 위해, 재사용 가능한 도구를 자동으로 구축하고 개선하는 '도구 진화' 방식을 제안했다. 라벨 없이 도구를 진화시키는 TEAL(Tool Evolution for Analytics over data Lakes)은 두 에이전트가 서로 다른 증거에서 도구를 제안한다: Explorer는 데이터 레이크 자체에서, Critic은 Worker의 작업 궤적에서 도구를 제안한다. 제안된 변화는 Worker가 재실행 시 추가 단계 없이 도구를 채택하고, 변경된 답변이 궤적 증거로 뒷받침될 때만 유지된다. 전체 요약 9문장 읽기 → 045 00:11 ▲ 22 · 댓글 4 장시간 작업용 LLM 에이전트, 실행 상태를 메모리처럼 재사용 장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. AI · 머신러닝 · FlowState: Execution State as Memory for Long-Horizon LLM Agents
Key Point 장시간 작업에서 LLM 에이전트의 맥락 길이 문제를 해결하는 새 방식이 기존 방법 대비 성능과 효율성 모두에서 실질적 개선을 보여주기 때문이다.
핵심 요약
장시간 작업을 수행하는 LLM 에이전트는 과거 상호작용 정보를 계속 참고해야 하지만, 전체 히스토리 보관은 맥락 비용을 늘리고 압축하면 필요한 세부사항을 잃을 수 있다. FlowState는 실행 상태를 메모리로 취급해 요청 간에 유지하고 재방문할 수 있으며, 의미론적으로 타입된 상태 노드·관계·도구 관찰 참조를 보존해 필요 시에만 접근하도록 분리한다. Incremental State Update(ISU)는 실행 루프 내에서 새 입력과 피드백에 따라 현재 상태를 유지하고, Progressive State Access(PSA)는 추론 중 필요에 따라 과거 상태와 근거를 점진적으로 공개한다. 전체 요약 5문장 읽기 → 046 03:11 ▲ 10 · 댓글 2 메모리의 가치를 배우다: 자원 제약 속 에이전트 최적화 지속적으로 학습하는 에이전트는 배포 후 경험을 축적해 개선하지만, 실제로는 생성, 상호작용, 메모리 예산이 매우 제한적이다. AI · 머신러닝 · Remembering Has a Price: Learning Memory Worth under Resource Constraints
Key Point 토큰 수 제약이 있는 LLM 에이전트에서 메모리 관리의 비용-편익을 최적화하는 새로운 접근법으로, API 호출 비용을 줄이면서 성능을 개선하는 실제 경로를 보여준다.
핵심 요약
지속적으로 학습하는 에이전트는 배포 후 경험을 축적해 개선하지만, 실제로는 생성, 상호작용, 메모리 예산이 매우 제한적이다. 이러한 강한 자원 제약 하에서 기존 평생 학습 메모리 방식들이 비효과적이 되며, 정교한 접근법도 단순 검색이나 메모리 없는 에이전트보다 나은 성과를 내지 못한다. 문제의 핵심은 단순히 관련 경험을 검색하는 것이 아니라 실제로 보존하고 재사용할 가치가 있는 경험을 판단하는 것이다. 전체 요약 7문장 읽기 → 047 00:11 ▲ 172 · 댓글 87 iPadOS 27, AirPlay 프레젠테이션 기능 망쳤다 iPadOS 27부터 AirPlay로 외부 화면에 프레젠테이션을 송출할 때, 프레젠테이션 앱 이외의 창을 탭하면 외부 디스플레이가 iPad 전체 화면을 표시하는 문제가 발생했다. 하드웨어 · 시스템 · Apple broke an essential presentation feature of iPads
Key Point iPad를 활용한 수업이나 프레젠테이션에 의존하는 교육자와 전문가들이 iPadOS 27로 업그레이드할 때 실질적인 문제에 직면하게 된다.
핵심 요약
iPadOS 27부터 AirPlay로 외부 화면에 프레젠테이션을 송출할 때, 프레젠테이션 앱 이외의 창을 탭하면 외부 디스플레이가 iPad 전체 화면을 표시하는 문제가 발생했다. 교사들이 의존하는 기능은 iPad에서 여러 작업(노트 확인, 학생 호출 대상 확인, 투표 결과 등)을 하면서 외부 화면에는 프레젠테이션만 표시하는 것인데, 이제 학생들이 숨겨야 할 정보를 모두 보게 된다. GoodNotes에서는 앱을 다시 탭하면 프레젠터 뷰가 복구되지만, Keynote는 프레젠테이션을 완전히 종료하고, PowerPoint는 재시작이 필요한 상태에 빠진다. 전체 요약 6문장 읽기 → 048 16:56 ▲ 26 · 댓글 2 만화를 영상으로 충실히 변환하는 AI 에이전트 시스템 만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. AI · 머신러닝 · Manga2Animate: An Agentic Framework for Faithful Manga Animation with Script and Storyboard Planning
Key Point 만화의 스토리, 캐릭터, 미술 스타일을 모두 보존하면서 자동으로 애니메이션화하는 기술로, 만화 산업에 실질적으로 적용할 수 있는 접근 방식을 제시한다.
핵심 요약
만화를 원본 내용에 충실한 애니메이션으로 변환하는 멀티에이전트 프레임워크 Manga2Animate를 제안했다. 기존 방식은 만화를 텍스트로만 해석해 캐릭터와 미술 스타일을 잃거나, 페이지를 직접 영상생성 모델에 넣어 구성을 오해하고 잘못된 스토리를 만드는 문제가 있었다. 이 프레임워크는 생성 과정의 모든 단계를 원본 만화에 근거하며, 작업을 두 가지 중간 단계인 애니메이션 스크립트와 시각적 스토리보드로 분해한다. 전체 요약 6문장 읽기 → 049 21:11 ▲ 23 · 댓글 2 로봇 가치 모델 평가 벤치마크 RoboValue 공개 로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. AI · 머신러닝 · RoboValue: A Fine-Grained Sim-and-Real Benchmark for Unified Evaluation of Robotic Value Models
Key Point 로봇 가치 모델의 신뢰성을 체계적으로 평가하기 위한 첫 번째 통합 벤치마크로, 기존 평가 방식의 한계를 드러내고 정책 학습의 피드백 품질 개선 방향을 제시한다.
핵심 요약
로봇이 시각 정보와 명령어로부터 작업 실행을 평가하는 가치 모델(value model)이 정책 학습과 실행 모니터링에 피드백을 제공하지만, 기존 평가는 실행 이해의 일부 측면만 다루고 있어 신뢰성이 검증되지 않았다. 시뮬레이션과 실제 환경을 통합한 RoboValue 벤치마크는 네 가지 능력 차원을 평가한다: 작업-상태 이해, 시간 진행 모니터링, 실패 및 회복 추론, 가치 일관성. RoboValue-Dataset은 15개 시뮬레이션 및 20개 실제 로봇 조작 작업을 포함하며, 전문가 시연 데이터와 세밀한 평가용 주석 데이터를 제공한다. 전체 요약 6문장 읽기 → 050 21:11 ▲ 20 · 댓글 2 세밀한 기하학 표현으로 3D 재구성 정확도 높인 FineSplat Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. AI · 머신러닝 · FineSplat: Fine Patches, Local Groups, Detailed Splats
Key Point Feed-forward 3D 재구성의 정확도를 크게 높이는 방법론이 필요한 상황에서, 토큰 그룹화와 렌더링 피드백을 결합해 계산 효율과 복원 품질을 동시에 개선한 접근법을 제시한다.
핵심 요약
Feed-forward 3D Gaussian Splatting 기반의 FineSplat을 제안하여 세밀한 기하학과 외관 정보를 더 정확히 복원한다. 고해상도 토큰에서 다중뷰 어텐션이 계산상 비효율적이므로, 뷰 기반 그룹화로 인접 뷰들 간 상호작용을 효율화하고 3D 공간 그룹화로 기하학적으로 연관된 토큰들을 재연결한다. 렌더링 오류를 직접 피드백으로 활용하여 세밀한 구조와 외관 복원을 위한 명시적 신호를 제공하고 단일 pass 방식의 한계를 극복한다. 전체 요약 5문장 읽기 → 051 21:11 ▲ 102 · 댓글 19 LLM 에이전트로 시스템 모니터링 혁신하다 Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. AI · 머신러닝 · Agentic Monitoring
Key Point 시스템 규모 확대로 인한 운영 복잡도 증가 속에서 에이전트 기반 모니터링이 낮은 비용으로 정밀한 장애 감지와 대응을 가능하게 하며, 1년 이내 업계 표준이 될 가능성이 높기 때문이다.
핵심 요약
Anthropic은 Claude를 이용해 특정 시스템 컴포넌트 건강도를 전담하는 '슈퍼팬' 에이전트를 도입했으며, 이들은 기존 알림보다 미묘하고 새로운 문제를 더 잘 감지한다. 현대 소프트웨어 시스템은 설계된 것보다 성장하는 경향이 강해지고 있으며, 시스템 규모 증가로 운영자의 코드 이해도는 감소하고 있다. 기존 모니터링은 어렵고 비용이 많이 들며 숙련된 인력과 경험이 필요한데, 에이전트가 이 분야을 근본적으로 바꿀 수 있다. 전체 요약 14문장 읽기 → 052 18:11 ▲ 17 · 댓글 2 LLM 에이전트의 물리적 자기개선, 어떻게 가능할까 LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. AI · 머신러닝 · Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
Key Point 로봇 조작 같은 물리적 환경에서 LLM 에이전트가 스스로 개선되는 원리를 정량 분석해, 대규모 언어 모델의 실제 강화학습 적용 가능성을 예측할 수 있는 기초를 제공한다.
핵심 요약
LLM 기반 로봇 에이전트의 물리적 자기개선(Physical RSI) 메커니즘을 체계적으로 분석한 연구다. PhysRSI-eval이라는 평가 지표를 도입해 5개 축(첫 시도 성능, 효율성, 성공률, 예산, 실패 후 개선)으로 물리적 RSI를 정량화했다. 18개 로봇 조작 작업에서 다양한 VLM(시각 언어 모델)을 같은 상호작용 예산 내에서 평가했으며, 공개 벤치마크 점수가 비슷해도 개선 양상은 크게 다를 수 있음을 확인했다. 전체 요약 7문장 읽기 → 053 15:11 ▲ 27 · 댓글 2 AI 에이전트 프롬프트, 성능·비용 균형 맞춰 자동 개선 AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. AI · 머신러닝 · HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
Key Point AI 에이전트 성능을 높일 때 비용 증가를 피할 수 없던 문제를 해결하는 자동화 기법으로, 실무 배포 환경에서 비용·성능 트레이드오프를 실제로 선택 가능하게 한다.
핵심 요약
AI 에이전트의 작업 수행 능력을 높이는 '하네스(harness, 프롬프트 템플릿)' 개발에서 기존 반복 개선 방식은 성능 향상 대신 실행 비용을 크게 올린다는 문제가 있다. HarnessPro는 정답 데이터 없이 LLM이 생성한 테스트로만 후보 하네스를 평가하는 레이블 무료 진화 방법을 제안한다. 전문 에이전트가 실행 궤적을 진단하고 성능·비용 우선순위에 따라 업데이트를 계획해 후보 하네스로 구현한다. 전체 요약 7문장 읽기 → 054 15:11 ▲ 40 · 댓글 4 AI 동료의 협업 능력 키우는 학습 환경 자동 생성 AI 동료는 도구 조합, 순차적 소통, 변화하는 작업 공간 상태 대응을 동시에 해야 하며 이를 위한 체계적인 학습이 필요하다. AI · 머신러닝 · CoworkEnv: Synthesizing Training Environments for Long-Horizon Cowork Agents
Key Point AI 에이전트가 실제 업무 환경에서 도구를 조합하고 다단계로 소통하며 학습하는 방식이 어떻게 체계화되는지 보여주며, 구체적 성능 향상 수치로 실용 가치를 입증한다.
핵심 요약
AI 동료는 도구 조합, 순차적 소통, 변화하는 작업 공간 상태 대응을 동시에 해야 하며 이를 위한 체계적인 학습이 필요하다. CoworkEnv는 이런 AI 동료를 위한 실행 가능한 학습 환경을 자동으로 생성하는 프레임워크다. 업무 요구사항이 작업 구성을 가이드하고, 프로그램 검증과 피드백 기반 수정으로 사양과 채점 방식을 자동 생성한다. 전체 요약 7문장 읽기 → 055 06:11 ▲ 180 · 댓글 75 확산 기반 LLM 머큐리 3 공개, 초당 1000+ 토큰 처리 확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. AI · 머신러닝 · Mercury 3: Diffusion at scale
Key Point 확산 기반 LLM이 자동회귀 모델과의 경쟁에서 확장 가능함을 증명하는 첫 번째 상용 사례로, 실시간 AI 애플리케이션의 지연 시간 문제를 해결할 수 있다.
핵심 요약
확산(Diffusion) 기반 LLM인 머큐리 3를 공개했으며, 여러 벤치마크에서 GPT-6 Luna와 Claude Haiku 5.5를 능가하면서 4~8배 빠른 초당 1,068 토큰을 처리한다. 머큐리 1 대비 40배 이상 모델 파라미터를 확대했으며, 벤치마크 기준 지능 수준은 3배 향상됐다. 문맥 길이는 260K에서 100만 토큰으로 확장했고, 입출력 토큰당 각각 0.20달러, 0.70달러이며 출시 초기에는 50% 할인(입력 0.10달러, 출력 0.35달러)을 제공한다. 전체 요약 10문장 읽기 → 056 06:11 ▲ 181 · 댓글 59 스타크래프트 테마의 브라우저 타워디펜스 게임 공개 스타크래프트 유니버스를 배경으로 한 브라우저 기반 타워디펜스 게임 'Ashfall'이 공개되었다. 기타 · Starcraft: Ashfall
Key Point 스타크래프트 IP를 활용한 브라우저 게임이 등장했으며, 별도의 설치 없이 웹에서 바로 플레이할 수 있는 타워디펜스 경험을 제공한다.
핵심 요약
스타크래프트 유니버스를 배경으로 한 브라우저 기반 타워디펜스 게임 'Ashfall'이 공개되었다. 플레이어는 테란 지휘관 역할로 무한 모드에서 계속 밀려오는 적군을 방어하는 방식으로 진행되며, 게임 내 경험치와 전투 업그레이드로 더 강력해질 수 있다. 게임에는 레이노 지휘관을 포함한 여러 영웅 능력(전투 격려, 여왕 공습, 공중 지원, 우주모함 소환 등)이 있어 전술적 깊이를 제공한다. 전체 요약 6문장 읽기 → 057 21:11 당일 +184 AI 초보자 위한 완전한 빕 코딩 학습 가이드 데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. AI · 머신러닝 · datawhalechina/easy-vibe · JavaScript
Key Point AI 코딩의 기초부터 프로덕션 배포까지 무료로 배울 수 있는 체계적이고 다국어 지원되는 교육 자료로, 특히 초보자가 AI로 실제 제품을 만들어본다는 점이 차별화된다.
핵심 요약
데이터웨일 차이나가 공개한 Easy-Vibe는 AI 시대 제품 만드는 법을 배우는 오픈소스 교육 프로젝트로, 완전 초보자부터 시니어 개발자까지 맞춤형 학습 경로를 제공한다. 초보자 단계(Stage 1)는 실제 문제 찾기에서 시작해 기회 포착, 방향 선택, 사용자 조사, 프로토타입 구축, AI 통합, 최종 완성까지 단계별로 진행되며 실습 예제와 상호작용형 데모로 '배우고 잊는 것'을 방지한다. 중급 개발자 단계(Stage 2)는 프론트엔드 UI 설계, Git 및 데이터베이스, 백엔드 API, Stripe 결제 통합, Zeabur 배포 등을 다루며 AI 카피라이팅 SaaS, 온라인 시험 시스템 등 실제 프로젝트를 완성한다. 전체 요약 8문장 읽기 → 058 18:11 ▲ 17 · 댓글 2 AI 에이전트의 조직 시뮬레이션으로 실무 역량 향상 AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. AI · 머신러닝 · OfficeTown: Generative Organizations for Evolving Agent Intelligence
Key Point AI 에이전트가 실무 환경에서 협력하고 책임을 나누어 작업하도록 하는 조직 시뮬레이션이 현실적 데이터 생성과 모델 성능 향상에 실제로 도움이 되는지를 규모 있게 검증한 첫 시도이기 때문이다.
핵심 요약
AI 에이전트가 전문 작업을 처리할 때 문서와 소프트웨어를 활용하면서 누적된 자료, 의사결정, 피드백을 활용해야 한다는 점에서 출발한다. OfficeTown은 전문 조직의 생성형 시뮬레이션 프레임워크로, 자연어로 조직의 목적과 활동을 설명하면 구성원이 작업을 조정하고 보조 에이전트에게 과제를 위임하며 결과를 검토하는 조직을 초기화한다. 생성된 산출물, 의사결정, 미해결 사항은 지속되어 이후 작업에 영향을 미치며, 각 구성원의 권한과 책임이 접근 가능한 정보와 수행 범위를 결정한다. 전체 요약 7문장 읽기 → 059 18:11 ▲ 103 · 댓글 55 JDK 28 개발 진행, 조기 접근 바이너리 공개 JDK 28은 Java SE Platform 28 버전의 참조 구현이며 JSR 403으로 Java Community Process에 명시되어 있다. 오픈소스 · 도구 · JDK 28
Key Point Java 다음 버전의 개발이 시작되었으며, 얼리 액세스 바이너리를 통해 누구나 새로운 기능을 미리 테스트하고 피드백할 수 있는 기회가 생겼다.
핵심 요약
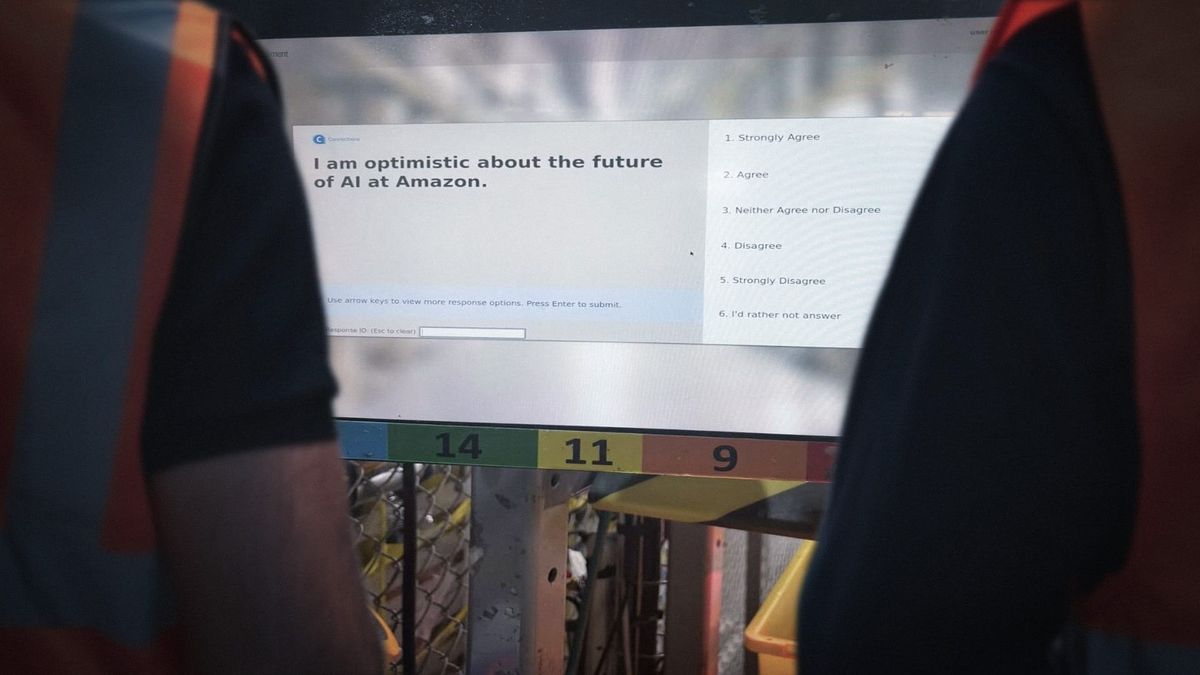
JDK 28은 Java SE Platform 28 버전의 참조 구현이며 JSR 403으로 Java Community Process에 명시되어 있다. 메인라인은 버그 수정, 소규모 개선, 그리고 JEP Process를 통해 제안되고 추적되는 JEPs를 받고 있다. GPL 라이선스 하의 얼리 액세스 바이너리가 공개되어 있어 개발자들이 미리 테스트할 수 있다. 060 06:11 ▲ 133 · 댓글 53 아마존, AI로 노조 활동 위험도 점수화해 감시 아마존이 내부 AI 도구 'Atlas'를 사용해 미국·캐나다·영국 창고 직원의 노조 결성 가능성을 점수로 평가하는 것으로 드러났다. 보안 · Amazon uses AI to monitor union risk in UK warehouses
Key Point 아마존이 AI로 직원들의 노조 결성 가능성을 체계적으로 점수화·감시하고 있으며, 이것이 노동자의 조직화 권리와 충돌하는지가 영국과 캐나다에서 법적 문제로 떠오르고 있기 때문입니다.
핵심 요약
아마존이 내부 AI 도구 'Atlas'를 사용해 미국·캐나다·영국 창고 직원의 노조 결성 가능성을 점수로 평가하는 것으로 드러났다. Atlas는 Reddit 게시물·직원 피드백 설문·직장 정보 등 수백 개의 데이터 포인트를 모아 각 창고에 100~900점의 위험도 점수를 부여한다. 점수가 낮을수록 노조화 또는 '방해적 노동 활동'이 일어날 가능성이 높다고 판단하며, 창고는 5단계(Tier 1: 활동 임박, Tier 5: 즉시적 위험 없음)로 분류된다. 전체 요약 12문장 읽기 → 061 16:56 당일 +125 웹소설 다운로드 도구 So Novel, 자바 기반 오픈소스 공개 네트워크 소설과 웹 콘텐츠를 자동으로 수집해 EPUB, TXT, PDF 등 전자책 형식으로 변환하는 오픈소스 도구다. 오픈소스 · 도구 · freeok/so-novel · Java
Key Point 웹 소설 다운로드와 전자책 변환을 한 번에 처리할 수 있는 크로스플랫폼 도구로, 다양한 파일 형식 지원과 세 가지 인터페이스 옵션이 소설 애독가와 콘텐츠 수집 용도에 편의를 제공한다.
핵심 요약
네트워크 소설과 웹 콘텐츠를 자동으로 수집해 EPUB, TXT, PDF 등 전자책 형식으로 변환하는 오픈소스 도구다. TUI(텍스트 인터페이스), WebUI, CLI 세 가지 방식으로 사용할 수 있으며 Java로 개발됐다. Windows, Linux, macOS에서 직접 설치하거나 Docker, Homebrew, Scoop 등으로 배포된다. 전체 요약 7문장 읽기 → 062 12:11 ▲ 107 · 댓글 20 클로드, 양자 회로 설계를 대폭 개선하다 앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. AI · 머신러닝 · Designing more efficient quantum circuits with Claude
Key Point 양자 컴퓨터의 실용화는 회로 설계 최적화에 달렸는데, Claude가 연구 그룹이 8년에 걸쳐 이룬 성과(FeMoco 게이트 150,000배 감소)를 53시간에 달성했다는 점이 양자 알고리즘 개발의 속도를 근본적으로 바꿀 수 있음을 보여준다.
핵심 요약
앤스로픽은 Claude Mythos 5에게 화학, 최적화, 물리 시뮬레이션, 정수론의 8가지 양자 회로 설계 과제를 평문으로 제시하고, 자동 평가기가 정확성을 검증하고 큐빗·게이트 수로 채점하도록 했다. Claude는 피드백 루프를 통해 폐쇄형으로 회로를 반복 설계했으며, 8가지 모두에서 이전의 최고 성능 회로보다 큐빗과 게이트 수를 줄인 새로운 설계를 발견했다. 첫 번째 사례는 타원곡선 암호 계산의 핵심인 모듈러 역수 문제로, Claude는 divsteps 알고리즘의 가지 정보(branch information)를 저장하지 않고 수치 쌍에서 직접 복원할 수 있음을 발견했다. 전체 요약 12문장 읽기 → 063 06:11 당일 +323 Android, AI 에이전트 위한 기술 스킬 저장소 공개 Google이 Android 공식 저장소 'android/skills'를 공개했으며, AI 에이전트가 Android 개발 작업을 더 잘 수행하도록 돕는 AI 최적화 모듈식 지침과 자료를 제공한다. AI · 머신러닝 · android/skills · Kotlin
Key Point Android 개발자가 AI 에이전트 도구를 활용할 때, LLM이 부족한 영역을 보완하는 구체적인 기술 스킬이 이제 공식적으로 제공되므로 개발 효율이 크게 달라질 수 있다.
핵심 요약
Google이 Android 공식 저장소 'android/skills'를 공개했으며, AI 에이전트가 Android 개발 작업을 더 잘 수행하도록 돕는 AI 최적화 모듈식 지침과 자료를 제공한다. 이 스킬들은 개발자 가이드(developer.android.com)의 모범 사례를 따르는 마크다운 기반 기술 명세(SKILL.md)로 작성되어, LLM이 Android 개발 영역의 특화된 지식으로 접지된다. 개발 초점은 LLM의 성능이 떨어지는 사용 사례와 워크플로우(예: 엣지-투-엣지 UI 구현)에 맞춰져 있으며, Jetpack Compose 기초 같은 이미 LLM이 잘 다루는 영역은 우선순위에서 제외했다. 전체 요약 7문장 읽기 → 064 06:11 ▲ 105 · 댓글 92 클로드가 쓰는 코드를 어떻게 검수할까 Claude Code는 자체 코드의 90%를 클로드가 작성하는데, 6~9월 사이 병합된 PR은 2배 이상 늘었으면서 되돌려진 코드는 40% 이상 감소했다. AI · 머신러닝 · How the Claude Code team does code review
Key Point AI가 코드를 대량으로 작성할 때 검수 체계가 어떻게 바뀌는지 보여주는 실제 사례로, 자동화와 인간 판단의 역할 분담이 팀 운영 방식과 품질 관리에 미치는 영향을 구체적으로 설명한다.
핵심 요약
Claude Code는 자체 코드의 90%를 클로드가 작성하는데, 6~9월 사이 병합된 PR은 2배 이상 늘었으면서 되돌려진 코드는 40% 이상 감소했다. 수동 라인 바이 라인 검수는 불가능해졌으므로, 대부분의 검수를 자동화 도구로 옮기고 인간의 시간을 고위험·고판단 영역에만 집중했다. PR 오픈 전 테스트, 빌드, 스크린샷 비교 같은 검증 작업을 클로드가 수행하고, PR이 열리기 전에 클로드 에이전트 리뷰어가 한 번 이상 점검해 대부분의 루틴 실수를 미리 잡는다. 전체 요약 12문장 읽기 → 065 18:11 ▲ 32 · 댓글 2 생성형 시뮬레이션의 규칙 검증, 이제 점수로 판단한다 기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. AI · 머신러닝 · OmniVerifier-C1: Decomposed Graded Verifier for Rule-Governed Generative World Modeling
Key Point 생성형 AI 시스템이 복잡한 규칙을 따르며 작동하는 세계 시뮬레이션으로 나아가려면, 이진 판정을 넘어 세밀한 점수 기반 검증이 필수적임을 보여준다.
핵심 요약
기존 생성형 이미지 검증자는 True/False만 판단했지만, OmniVerifier-C1은 복잡한 프롬프트와 환경 규칙을 세부 요소로 분해해 각각 점수를 부여하는 방식으로 더 정보량 많은 피드백을 제공한다. 이 구조화된 해석 가능한 출력은 검증자의 도메인 외 멀티모달 작업으로의 일반화 성능을 높인다. Decoupled RL 학습 전략으로 하위 질문 수준의 이진 판단과 전역 정렬 점수를 동시 최적화하며, 정밀한 로컬 피드백으로 세밀한 검증 능력을 개발한다. 전체 요약 7문장 읽기 → 066 15:11 ▲ 25 · 댓글 2 ML 엔지니어링 자동화하는 35B 모델 MLExpert 공개 LLM이 AI 시스템을 자율적으로 개발·개선하는 AI4AI 시대로 나아가고 있으며, 기계학습 엔지니어링(MLE) 시스템이 장기 실험 관리와 최적화 전략 자동 적응으로 이를 실현하고 있다. AI · 머신러닝 · MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering
Key Point ML 엔지니어링의 완전 자동화가 가능해지면 AI 개발 사이클을 획기적으로 단축할 수 있으며, 이는 AI 스스로가 AI를 개선하는 재귀적 자기개선의 실질적 첫걸음이다.
핵심 요약
LLM이 AI 시스템을 자율적으로 개발·개선하는 AI4AI 시대로 나아가고 있으며, 기계학습 엔지니어링(MLE) 시스템이 장기 실험 관리와 최적화 전략 자동 적응으로 이를 실현하고 있다. 기존 MLE 시스템의 문제점은 실험 피드백이 이전 여러 결정의 누적 결과라 단순 감독학습으로는 장기 궤적에서 유용한 신호를 학습하기 어렵다는 점이다. Hugging Face 팀은 35B Mixture-of-Experts 모델 MLExpert를 학습시키기 위해 Kaggle-MLE Factory로 실행 가능한 ML 최적화 작업을 대규모로 생성했다. 전체 요약 7문장 읽기 → 067 15:11 ▲ 201 · 댓글 7 AI 에이전트가 자기 자신을 개선하는 프레임워크 모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. AI · 머신러닝 · Self-Evolving Agent Harness
Key Point AI 에이전트가 모델을 바꾸지 않고도 스스로의 동작을 개선하는 구체적인 방법론과 이론이 담겨 있어, AI 시스템의 자동 최적화와 신뢰성 검증에 관심 있는 연구자와 개발자가 반드시 봐야 한다.
핵심 요약
모델 가중치는 고정한 채 프롬프트, 메모리, 워크플로우, 실행 가능한 컴포넌트 같은 에이전트 소프트웨어를 자동으로 수정하는 프레임워크를 제시한다. 피드백 기반 프로세스를 형식화하여 승인된 수정사항이 계속 유지되도록 하고, 업데이트 대상을 제안·승인 메커니즘과 분리했다. 해석된 상태 변화와 도구·코드 수정, 저장소 제어 논리, 플러그인 구성을 구별하여 관리한다. 전체 요약 8문장 읽기 → 068 12:11 ▲ 107 · 댓글 2 AI가 3D 코드로 가상 세계를 만드는 생태계 공개 Hugging Face 연구팀이 3DCodeVerse를 공개했다. 이는 AI 코딩 에이전트가 대규모로 3D 콘텐츠를 생성하고 편집할 수 있는 연구 생태계다. AI · 머신러닝 · 3DCodeVerse: Exploring 3D Worlds as Code
Key Point AI가 코드 기반으로 3D 콘텐츠를 자동 생성하고 검증하는 체계가 갖춰지면서, 대규모 3D 세계 창작의 자동화가 실질적으로 가능해지는 시점을 보여준다.
핵심 요약
Hugging Face 연구팀이 3DCodeVerse를 공개했다. 이는 AI 코딩 에이전트가 대규모로 3D 콘텐츠를 생성하고 편집할 수 있는 연구 생태계다. 3DCodeVerse-2M이라는 대규모 데이터셋을 구축했으며, 이는 오픈소스 3D 코드 200만 개로 이루어져 있다. 각 프로그램은 실행에 필요한 소스 파일과 에셋, 설명, 검증 기록이 함께 패키징되어 있다. 3DCodeVerse Harness라는 다중 에이전트 DAG 프레임워크를 개발했다. 이는 3D 콘텐츠를 생성하고 개선하며, 실행 검사, 공간 측정, 시각 피드백으로 인간의 개입 없이 자동 평가와 수정을 수행한다. 전체 요약 5문장 읽기 → 069 03:12 ▲ 13 · 댓글 2 장기 강화학습에 Muon 옵티마이저 필수 장기 지평(long-horizon) 에이전트는 확장된 상호작용에서 추론, 도구 사용, 환경 피드백을 조율해야 한다. AI · 머신러닝 · Long-Horizon RL Needs Muon
Key Point 장기 강화학습 작업에서 효율적인 학습을 위한 구체적인 옵티마이저와 훈련 기법이 필요하며, Muon 기반 레시피가 기존 방법보다 나은 성능을 달성했기 때문이다.
핵심 요약
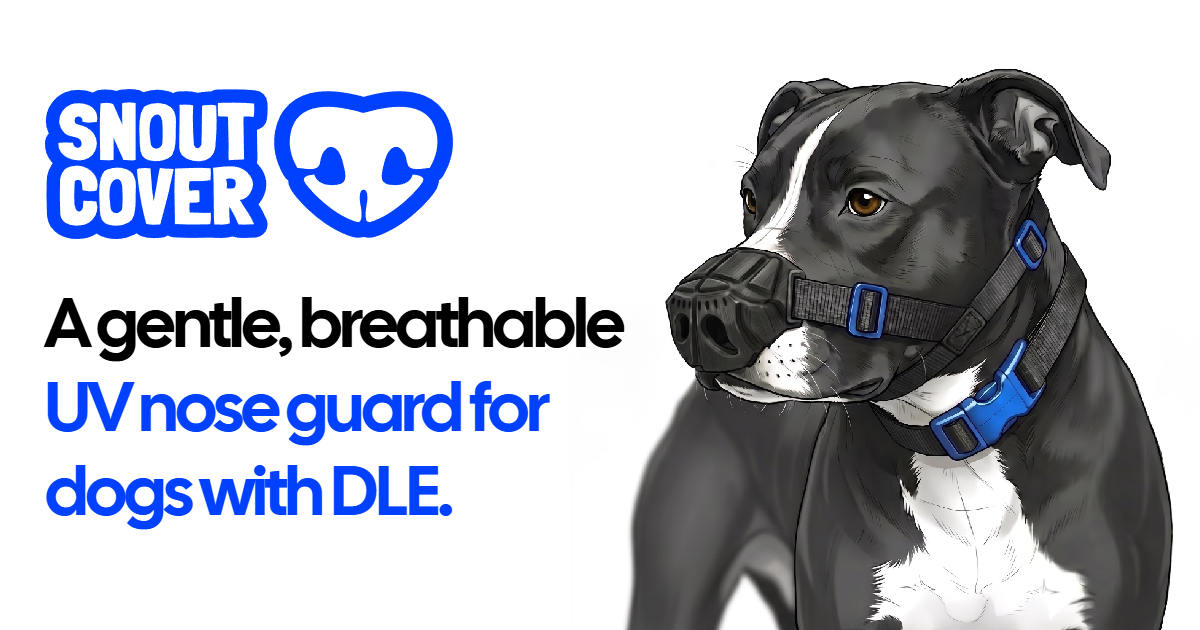
장기 지평(long-horizon) 에이전트는 확장된 상호작용에서 추론, 도구 사용, 환경 피드백을 조율해야 한다. 희소 결과 보상에서 학습하려면 길이가 다른 궤적에 가중치를 부여하고 롤아웃이 진행 중일 때 정책을 업데이트해야 한다. 연구팀은 Muon, 토큰 평균 손실, 잘린 중요도 샘플링, 길이·도구 오류 보조 손실을 결합한 단일 롤아웃 비동기 레시피를 제안했다. 전체 요약 6문장 읽기 → 070 03:12 ▲ 206 · 댓글 106 개 코 질환 위해 직접 만든 보호대, 1년 만에 500마리에게 닿다 피트불 빌리가 자가면역질환 원판성천포창(DLE)을 진단받아 코에 연고를 발라야 했지만 개가 계속 핥아서, 직접 코 보호대 '도가드'를 설계했다. 하드웨어 · 시스템 · I designed a nose guard for my dog and gave it away. Now 500 dogs wear one
Key Point 개인의 반려동물 문제를 직접 설계로 해결한 후 사업으로 전환하면서, 처음 계획 없이 시작한 제품이 16개국 500마리에게 도움이 되기까지의 과정과 제품 개선 철학을 보여준다.
핵심 요약
피트불 빌리가 자가면역질환 원판성천포창(DLE)을 진단받아 코에 연고를 발라야 했지만 개가 계속 핥아서, 직접 코 보호대 '도가드'를 설계했다. 처음엔 무료로 파일을 공개했으나, 직접 인쇄할 수 없는 사람들의 요청이 늘어나 지난해 10월 웹사이트를 구축하고 판매를 시작했다. 현재 '스나우트커버'라 명명된 제품은 395개 주문으로 16개국에 배송되었으며, 총 500마리 이상의 개가 사용 중이다. 전체 요약 11문장 읽기 → 071 00:11 ▲ 19 · 댓글 2 과학 AI 에이전트 군단이 스스로 진화하며 학습한다 과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. AI · 머신러닝 · SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
Key Point 과학 연구 자동화를 추구하는 개발자와 연구자들이 AI 에이전트 간 협력과 피드백 기반 자기 개선이 어떻게 실제 과학 문제 해결에 활용되는지 알아야 한다.
핵심 요약
과학 연구의 재귀적 자기 개선(RSI)을 위해 과학 에이전트 군단이 실험 경험을 통해 연구 능력을 향상시키는 것을 목표로 한다. 기존 접근의 문제점은 실패한 실험 결과가 가설 오류인지 구현 오류인지 불분명하고, 전체 점수가 다른 에이전트에 유용한 부분 결과를 가린다는 것이다. SwarmRSI는 피드백 기반 군단 변이(Feedback-Guided Swarm Mutation)로 다른 에이전트의 실험 결과를 이용해 가설과 구현을 개선한다. 전체 요약 7문장 읽기 → 072 16:56 당일 +453 주요 클라우드 스토리지 8개 지원하는 직링크 다운로드 도구 JavaScript 기반 클라우드 스토리지 직링크 다운로드 주소 추출 도구인 LinkSwift를 GitHub에 공개했다. 오픈소스 · 도구 · hmjz100/LinkSwift · JavaScript
Key Point 클라우드 스토리지 직링크 추출 기술의 법적·윤리적 경계가 논의되는 상황에서, 제작자가 공개 API만 사용하며 규정 준수를 강조하는 입장을 표명했다.
핵심 요약
JavaScript 기반 클라우드 스토리지 직링크 다운로드 주소 추출 도구인 LinkSwift를 GitHub에 공개했다. 바이두 클라우드, 알리 클라우드, 중국 이동통신 클라우드, 천익 클라우드, 선더 클라우드, 쿼크 클라우드, UC 클라우드, 123 클라우드 등 9개 클라우드 서비스를 지원한다. 원래의 '클라우드 직링크 다운로드 보조 도구'를 개조한 것으로, 직링크 추출 외에도 UI 개선, 다양한 다운로더(IDM, Aria2, 비트코멧, AB Download Manager) 지원 등의 기능을 추가했다. 전체 요약 9문장 읽기 → 073 12:11 ▲ 19 · 댓글 1 텍스트-이미지 생성 모델, 자동으로 자기 약점 찾아 학습한다 텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. AI · 머신러닝 · APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
Key Point 수동 데이터 큐레이션 없이 모델 자체의 약점을 자동으로 식별해 학습하는 방식으로, 텍스트-이미지 생성의 품질 개선 파이프라인이 어떻게 근본적으로 바뀔 수 있는지 보여준다.
핵심 요약
텍스트-이미지 생성 모델의 사후학습(post-training)을 자동화하는 APT(Agentic Post-Training) 프레임워크를 제안했다. 기존 방식은 수동으로 큐레이션한 데이터와 고정된 학습 분포에 의존했으나, APT는 모델의 진화하는 역량에 맞춰 적응적으로 사후학습을 진행한다. 평가 세트 구성, 모델의 강점과 약점 진단, 강화학습 데이터 생성을 담당하는 3개 에이전트를 조율한다. 전체 요약 6문장 읽기 → 074 09:11 ▲ 145 · 댓글 52 Jev 1.14.0 공개, 이미지·더 긴 컨텍스트·새 타입 추가 TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. AI · 머신러닝 · We’re releasing Jev 1.14.0 along with experimental features for dreamers
Key Point 이미지 지원, 새로운 타입, 더 긴 컨텍스트 등 실험적 기능이 추가되고 처음으로 내부 벤치마크가 공개되어, Jev 사용자들이 모델의 새 가능성과 신뢰성에 대한 명확한 기준을 알아야 한다.
핵심 요약
TypeSafe AI가 Jev 1.14.0을 출시했으며, 프로덕션 배포가 아닌 실험적 '위험 지역' 기능들을 함께 공개했다. 신규 기능 중 하나는 이미지 지원으로, 기존 Jev 1.13.0도 멀티모달 모델이었으며 JSON 인터페이스 내 상태·지시·조건 어디든 이미지를 삽입 가능하다. 다른 신규 기능은 경계 상자를 반환하는 'box' 타입으로, System One 모델의 단순 의사결정 이상의 기능을 탐색하는 첫 단계다. 전체 요약 8문장 읽기 → 075 21:11 ▲ 18 · 댓글 2 Fish Audio Drama 3, 자연어 지시로 성우 같은 음성 생성 텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. AI · 머신러닝 · Fish Audio Drama 3 Technical Report
Key Point 단일 모델로 음성 복제, 자연어 지시, 멀티턴 편집, 장면 더빙을 모두 지원하며 파라미터 대비 빠른 추론 속도를 달성한 기술적 진전이 실제 음성 생성·편집 워크플로를 어떻게 단순화할지 확인할 수 있다.
핵심 요약
텍스트를 연기하는 형태의 음성으로 변환하는 오픈소스 모델 Fish Audio Drama 3을 공개했다. 35B 파라미터 혼합 전문가 구조에 토큰당 3B 파라미터만 활성화하며, 여러 참조에서 목소리를 복제하고 자연어 지시에 따른다. 다음 턴의 피드백으로 테이크를 수정하고, 여러 캐릭터 장면에 음성을 부여하며, 기존 음성을 인필로 편집하고 장시간·스트리밍 오디오를 합성한다. 전체 요약 8문장 읽기 → 076 21:11 ▲ 64 · 댓글 1 장기 작업 에이전트 훈련을 위한 반복적 환경 진화 방식 WorkRover 강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. AI · 머신러닝 · WorkRover: Scaling Long-Horizon Cowork Agent Training Via Recursive Environment Evolution
Key Point 장기 작업을 수행하는 AI 에이전트의 훈련 효율을 대폭 개선하는 새로운 프레임워크로, 복잡한 작업 환경을 자동으로 정제하고 검증하는 방식이 기존 대비 크게 나은 성능을 달성했다.
핵심 요약
강화학습을 통해 장기 수행 에이전트를 훈련하기 위해서는 상호작용 환경을 확장하는 것이 중요하지만, 기존 구성 파이프라인은 작업 요소들을 정렬한 채 반복 개선을 지원하는 데 제한이 있다. WorkRover는 하니스 기반 합성으로 구성 에이전트가 의미론적으로 정렬된 작업 맥락, 실행 가능한 작업, 증거 기반 검증자를 함께 구축하고 고정 워크플로우 대신 작업공간 상태와 실행 피드백에 맞춰 조치하는 프레임워크다. 환경 진화를 지원하기 위해 의존성 폐쇄 재실행과 검증된 후보 중 가장 작은 수정안을 선택하는 Factorial Compatibility Replay(FCR)를 도입했다. 전체 요약 5문장 읽기 → 077 21:11 ▲ 16 · 댓글 2 영상 생성 속도 2배 이상 높인 경량 VAE 기법 공개 영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. AI · 머신러닝 · LightVAE: Towards Compact and Efficient Video Autoencoders
Key Point 영상 생성 모델의 추론 속도를 2배 이상 높일 수 있는 기술이 공개되어, 실시간 영상 생성 서비스의 비용과 성능을 크게 개선할 수 있게 되었다.
핵심 요약
영상 확산 모델의 성능은 좋지만, VAE 인코딩과 디코딩에 높은 계산 비용이 들어가는 것이 문제이다. 기존 방식은 공간과 시간 계산을 함께 제약하거나 시간 계산을 제거했으나, Conv3D에서 두 차원의 압축 민감도를 구분하지 못했다. LightVAE는 시간 모델링과 네트워크 깊이의 중복성을 이용하는 압축 프레임워크다. 전체 요약 12문장 읽기 → 078 18:11 ▲ 195 · 댓글 2 LLM 에이전트에 자가 반성 능력 가르치는 Agent-Reflex 프레임워크 언어 모델 에이전트가 장기 추론과 도구 사용을 수행할 때 노이즈 있는 피드백과 사용자 개입에 대응하는 문제를 다룬다. AI · 머신러닝 · Agent-Reflex: Teaching Language Agents to Act Reflectively
Key Point 도구 사용 에이전트가 실제 환경의 노이즈와 오류로부터 자동으로 학습하고 회복할 수 있는 구체적인 훈련 방법론을 제시하고 있어, 더욱 견고한 AI 에이전트 개발에 필요한 기술이다.
핵심 요약
언어 모델 에이전트가 장기 추론과 도구 사용을 수행할 때 노이즈 있는 피드백과 사용자 개입에 대응하는 문제를 다룬다. Agent-Reflex는 세 단계로 구성된 훈련 프레임워크로, 먼저 Environment Reflection Skill Discovery(RSD) 단계에서 도구 피드백 섭동을 주입하고 다양한 LLM 풀에서 성공-실패 쌍을 추출해 반성 메타스킬을 도출한다. Reflective Supervised Fine-Tuning(ReSFT) 단계는 각 스킬을 자가 반성, 스킬 복구, 사용자 중심 수정을 위한 감독 신호로 변환한다. 전체 요약 6문장 읽기 → 079 15:11 ▲ 20 · 댓글 1 LLM 에이전트, 외부 모델 없이 자기개선한다 LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. AI · 머신러닝 · ClawLoop: Self-Improving Agents via Harness-Native Training Loop
Key Point 기존 LLM 에이전트 학습은 외부 모델과 인간에게 종속되어 근본적 한계가 있는데, ClawLoop은 순환 루프로 자동 개선을 실현하고 작은 모델에도 지식 전이가 가능함을 증명하며 에이전트 학습 패러다임의 전환을 시사한다.
핵심 요약
LLM 기반 에이전트가 파일 시스템·셸과 직접 상호작용하는 하네스 환경에서 작동하지만, 기존 학습 파이프라인은 외부 강력한 모델에 의존하는 일회성 방식에 머물고 있다. ClawLoop은 외부 교사 모델 없이, 최소한의 사전 지식으로 에이전트가 자기개선하는 자체 순환 프레임워크를 제안한다. 과제 합성·진단 기반 난이도 성장·에이전트 기반 검증으로 다양한 학습 과제 풀을 생성하고, SFT와 RL로 에이전트를 업데이트한 후, 롤아웃 행동 분석으로 다음 반복의 피드백을 생성한다. 전체 요약 5문장 읽기 → 080 18:11 ▲ 103 · 댓글 19 macOS 음성 어시스턴트 Atticus, Claude 연동으로 무료 공개 Control+Option+Space를 누르고 말하면 윈도우 정렬, 파일 검색, 화면 읽기 등을 수행하는 macOS용 음성 어시스턴트 Atticus를 오픈소스로 공개했다. AI · 머신러닝 · Show HN: Atticus – Hold-to-talk voice assistant for macOS that runs on Claude -p
Key Point 기존 음성 어시스턴트는 API 키 등록과 지속적 비용이 필요하지만, Atticus는 이미 보유한 Claude 플랜으로 무료로 사용 가능하며 온디바이스 처리로 프라이버시를 보장한다.
핵심 요약
Control+Option+Space를 누르고 말하면 윈도우 정렬, 파일 검색, 화면 읽기 등을 수행하는 macOS용 음성 어시스턴트 Atticus를 오픈소스로 공개했다. API 키가 필요 없으며 이미 보유 중인 Claude Pro/Max 플랜과 Claude Code를 통해 실행되므로 별도 가입이나 추가 비용이 없다. 자주 사용하는 명령은 학습되어 다음부터는 AI를 거치지 않고 실행되며, '기억해줘'라고 말하면 사용자 정보를 저장해 이후 요청에 반영된다. 전체 요약 13문장 읽기 → 081 15:11 ▲ 138 · 댓글 2 긴 작업 완수하는 AI 에이전트 학습 데이터 합성법 공개 장시간에 걸쳐 현실의 전문 업무를 완료하는 터미널 에이전트 개발에 적합한 학습 데이터가 부족한 문제를 다룬다. AI · 머신러닝 · Scaling Agentic Data for Long-Horizon Terminal Intelligence
Key Point 장시간 복잡한 작업을 자율적으로 완료해야 하는 AI 에이전트 개발 시 학습 데이터의 질과 특성이 모델 성능을 크게 좌우하기 때문에, 현실 기반의 효과적인 데이터 합성 방법론은 에이전트 연구 진행에 직결된다.
핵심 요약
장시간에 걸쳐 현실의 전문 업무를 완료하는 터미널 에이전트 개발에 적합한 학습 데이터가 부족한 문제를 다룬다. 기존 환경 합성 방식은 탐색, 구현, 검증 같은 에이전트의 핵심 활동을 미리 완료해 버려서 에이전트가 배울 수 없다는 한계가 있다. 이를 해결하기 위해 TerminalHorizon이라는 자동화된 데이터 합성 엔진을 제안하는데, 실제 전문 업무에서 시작해 독립 실행으로 빠진 작업을 파악하고 환경을 재구성한다. 전체 요약 7문장 읽기 → 082 12:11 ▲ 130 · 댓글 87 미사용 킨들을 AI로 사진 액자로 개조하기 쓰지 않던 킨들을 AI 에이전트로 개조하여 사진 액자로 만들었다. 처음에는 GPT-5.6 Sol과 Fable 5.1, Opus 5.5를 시도했지만, 데이터 저장 오류나 보안 차단으로 실패했다. AI · 머신러닝 · I turned my unused Kindle into a photo frame with GPT-6 Astra
Key Point AI 에이전트가 하드웨어 제어 코드를 작성하고 디버깅하는 실제 사례를 보여주며, 특히 자동화된 피드백 루프가 개발 효율을 어떻게 바꾸는지 실증한다.
핵심 요약
쓰지 않던 킨들을 AI 에이전트로 개조하여 사진 액자로 만들었다. 처음에는 GPT-5.6 Sol과 Fable 5.1, Opus 5.5를 시도했지만, 데이터 저장 오류나 보안 차단으로 실패했다. GPT-6 Astra로 전환한 후 SpiderCat 오픈소스 프로젝트를 참고하여 킨들 커스텀 도구인 KindleCTL을 개발했다. 에이전트가 Mac에서 킨들에 명령을 보내고, 파일을 전송하며, 에러를 진단할 수 있게 됐다. 초기에는 에이전트와의 수동 피드백(스크린샷 촬영)이 필요했지만, 로그 접근과 원격 화면 캡처를 자동화한 피드백 루프를 추가하면서 개발 속도가 크게 빨라졌다. 전체 요약 9문장 읽기 → 083 09:11 ▲ 182 · 댓글 171 LLM은 자동화가 아닌 도구다, 사용 능력이 중요 Rich Hickey의 'AI는 도구가 아니라 자동화'라는 주장에 반박하는 글이다. AI · 머신러닝 · AI is a tool and using it well takes skill
Key Point LLM이 도구인지 자동화인지를 둘러싼 철학적 논의가 실제로는 '얼마나 잘 사용하는가'라는 기술적 능력 문제로 귀결되는 점을 명확히 합니다.
핵심 요약
Rich Hickey의 'AI는 도구가 아니라 자동화'라는 주장에 반박하는 글이다. LLM이 예측 불가능하다는 점은 제약이지만, 도구의 정의상 예측 가능성은 필수 요건이 아니며 제어가 어려운 것만으로 도구에서 제외되지 않는다. 컴파일러나 스프레드시트처럼 자동화 기능이 도구의 특성일 수 있으며, 자동 텍스트 생성이 코드 번역이나 계산 자동화와 다르게 취급될 이유가 없다. 전체 요약 8문장 읽기 → 084 03:11 ▲ 11 · 댓글 2 LLM 매개변수 수정 없이 지식 이전하는 'UTT' 방법 제안 지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. AI · 머신러닝 · Universal Textual Teaching for LLMs
Key Point API 기반 또는 재학습이 비싼 LLM에도 적용 가능한 매개변수 무수정 지식 이전 방법으로, 해석 가능하고 재사용 가능한 형태의 교육 자료를 자동 생성할 수 있다는 점이 기존 증류 기법의 한계를 극복한다.
핵심 요약
지식 증류(KD)는 강한 교사 모델의 지식을 약한 학생 모델로 옮기지만, 기존 방법은 학생 매개변수를 학습해야 하므로 특정 구조와 체크포인트에 종속되는 문제가 있다. 연구팀은 매개변수 업데이트 없이 지식을 전달하는 'Universal Textual Teaching(UTT)'을 제안했으며, 교사와 학생의 차이를 자연어로 해석 가능한 'Primer'라는 재사용 가능한 형태로 증류한다. UTT는 먼저 쌍을 이룬 평가를 통해 대표적인 차이 사례들을 식별하고, 이후 다중 역할 상호작용으로 반복 업데이트한다: 학생이 과제를 시도하고, Prompter가 평가 피드백을 교수 지시문으로 변환하며, 교사가 대상화된 시연을 제공하고, Synthesizer가 검증된 교훈을 통합한다. 전체 요약 6문장 읽기 → 085 03:11 ▲ 162 · 댓글 60 슈퍼마리오64 개발 비하인드 - 닌텐도 코더 긱스 고다드 인터뷰 2001년 닌텐도 코더 긱스 고다드의 미발표 인터뷰로, 슈퍼마리오64 개발 당시의 뒷이야기를 담은 자료이다. 하드웨어 · 시스템 · The Making Of Super Mario 64 – full Giles Goddard interview (2001)
Key Point 슈퍼마리오64가 3D 게임 설계와 게임플레이 튜닝을 어떻게 했는지 개발자 직접 증언으로 보여주며, 현대 3D 게임의 기초가 된 기술 결정들을 구체적으로 공개한다.
핵심 요약
2001년 닌텐도 코더 긱스 고다드의 미발표 인터뷰로, 슈퍼마리오64 개발 당시의 뒷이야기를 담은 자료이다. 마리오 팀은 약 15명 규모로 젤다 시간의 오카리나 제작팀보다 훨씬 작았으며, 닌텐도 내 아티스트와 프로그래머는 분리되어 있었다. N64 에뮬레이터 없이 SGI Onyx에서 GL 프로그래밍으로 시작했고, 6개월간 컨트롤러가 없어 개조된 세가 조이패드를 사용했다. 전체 요약 13문장 읽기 → 086 18:12 ▲ 18 · 댓글 2 언어모델 에이전트의 온라인 학습을 위한 재귀형 프레임워크 제안 언어모델 에이전트가 장시간 상호작용 스트림에서 분포 변화에 온라인으로 적응해야 하는데, 기존 에이전트 프레임워크는 순방향 정보 흐름만 사용하거나 재학습용 추가 데이터가 필요했다. AI · 머신러닝 · Recurrent Harness for Agentic Continual Learning
Key Point 장시간 상호작용을 처리하는 AI 에이전트의 지속적 학습 능력이 추론 정확도와 안정성에 직결되기 때문에, 오직 온라인 스트림만으로 효과적인 적응을 가능하게 하는 기술이 실제 배포에 중요하다.
핵심 요약
언어모델 에이전트가 장시간 상호작용 스트림에서 분포 변화에 온라인으로 적응해야 하는데, 기존 에이전트 프레임워크는 순방향 정보 흐름만 사용하거나 재학습용 추가 데이터가 필요했다. ReHarness는 순방향 읽기·쓰기와 역방향 수정을 결합한 재귀형 하네스 프레임워크를 제안해, 순수한 온라인 스트리밍 프로토콜 하에서 연속 학습을 지원한다. 각 인스턴스 이후 결과 궤적을 피드백으로 삼아 해당 인스턴스에서 검색한 반영(reflection)을 수정함으로써, 텍스트 기반 하네스 상태를 통해 피드백을 역방향으로 전파한다. 전체 요약 5문장 읽기 → 087 18:12 ▲ 13 · 댓글 2 의료 AI가 스스로 증거를 찾는다, 종단 임상 추론 벤치마크 재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. AI · 머신러닝 · From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
Key Point 임상 데이터를 능동적으로 탐색하며 종단 추론을 수행하는 의료 AI 에이전트의 새로운 패러다임이 제시되며, 대규모 정제 벤치마크와 학습 방법이 함께 공개될 예정이기 때문이다.
핵심 요약
재단 모델을 임상 에이전트로 활용하되 기존 벤치마크와 달리 미리 선정된 증거가 아닌 임상 기록과 종단 영상 데이터에서 능동적으로 증거를 찾을 수 있도록 설계했다. CASE라는 역할별 임상 에이전트 시리즈와 도구 사용 장치, 컴팩트한 비전-언어 정책 모델 학습 프레임워크를 제안한다. UK Biobank 기반 종단 멀티모달 벤치마크를 구축했으며, 4,739명의 참여자로부터 도출한 ICD-10 코딩 진단에 기반한 50,401개 임상 질문을 포함한다. 전체 요약 8문장 읽기 → 088 18:12 ▲ 18 · 댓글 2 3D 물체 생성, 외형을 넘어 물리 움직임까지 담다 물체의 형태와 외형이 아닌 실제 움직임과 기능을 구현하는 3D 자산 생성 문제를 다룬 논문이다. AI · 머신러닝 · Towards Physically Grounded Articulated 3D Assets: A Multi-Agent Pipeline and Benchmark
Key Point 3D 생성 모델이 시각적 정확도를 넘어 물리 엔진과의 상호작용까지 만족해야 하는 시대로 나아가는 기술 전환점을 보여주며, 게임 에셋·로봇공학·CAD 등 실무 활용 기준이 크게 변하고 있다.
핵심 요약
물체의 형태와 외형이 아닌 실제 움직임과 기능을 구현하는 3D 자산 생성 문제를 다룬 논문이다. 기존 Articraft 방법을 다중 에이전트 파이프라인과 물리 시뮬레이션 피드백으로 확장한 Artisan 시스템을 제안한다. 생성된 3D 자산이 충돌 없이 움직이고, 중력 안정성을 유지하며, 정확한 질량과 재질 속성을 가지도록 한다. 전체 요약 7문장 읽기 → 089 18:12 ▲ 44 · 댓글 2 AI 에이전트, 게임 경쟁으로 전략 학습하는 방식 평가 대전 게임에서 AI 에이전트가 모델 가중치는 고정한 채 게임 정책을 자동으로 개선하는 적대적 휴리스틱 학습(AHL) 패러다임을 제안했다. AI · 머신러닝 · Can AI Agents Learn Their Way to the Top? Evaluating Heuristic Learning in a Long-Running Game Agent Competition
Key Point 모델 가중치를 고정하면서 게임을 통해 정책을 학습·개선하는 새로운 AI 학습 방식이 실제 게임 경쟁에서 어느 수준인지 보여주는 첫 대규모 평가로, 에이전트의 한계와 가능성을 함께 드러낸다.
핵심 요약
대전 게임에서 AI 에이전트가 모델 가중치는 고정한 채 게임 정책을 자동으로 개선하는 적대적 휴리스틱 학습(AHL) 패러다임을 제안했다. 12개 실제 대전 게임과 1,920개 보관된 인간 프로그램을 포함한 AAArena 벤치마크를 구축하고, 실제 게임 대회를 모델로 한 평가 프로토콜을 적용했다. 에이전트는 규칙을 해석하고 상대를 선택한 후 리플레이를 분석하며 경기와 평가 예산 내에서 최고 순위 달성을 목표로 게임 에이전트를 수정했다. 전체 요약 7문장 읽기 → 090 18:12 ▲ 139 · 댓글 2 로봇 팔이 던져진 상자를 받는다 - 시각·반사·전신제어 동시에 인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. AI · 머신러닝 · Reflex: Visually Grounded Reactive Humanoid Control
Key Point 시각 피드백 기반의 실시간 전신 제어라는 난제를 단계별 학습으로 풀었고, 실제 로봇에서 인간 수준의 반사 동작 구현에 가까워지고 있습니다.
핵심 요약
인간은 테니스 공 받기, 떨어지는 컵 잡기 같은 일상 동작을 1초 안에 시각과 반사신경으로 처리하지만, 휴머노이드 로봇은 이를 어렵게 느낀다. Reflex는 던져진 상자 잡기를 목표로 전신 제어·물체 동역학 예측·시각 인지 세 가지 능력을 단계별로 학습하는 프레임워크다. 첫 번째 단계에서는 강화학습으로 상태 기반 전신 잡기 정책을 학습하고, 두 번째는 불완전하고 지연된 관찰에서 움직이는 상자의 동역학을 추론하며, 세 번째는 RGB-D 카메라로부터 직접 동역학을 복원한다. 전체 요약 6문장 읽기 → 091 18:12 ▲ 108 · 댓글 46 Zig에서 타입 안전한 HTML 템플릿 라이브러리 zt 공개 저자는 Zig 언어로 웹 개발을 시도하면서 타입 안전성과 XSS 방지를 갖춘 HTML 템플릿 라이브러리가 필요했다. 웹 · 프론트엔드 · Type-safe HTML templating in Zig
Key Point Zig 같은 저수준 언어에서도 JavaScript 없이 타입 안전한 웹 개발이 가능함을 보여주는 새로운 접근법이며, 전통적 템플릿 라이브러리의 런타임 오류와 XSS 위험을 컴파일 타임에 제거한다.
핵심 요약
저자는 Zig 언어로 웹 개발을 시도하면서 타입 안전성과 XSS 방지를 갖춘 HTML 템플릿 라이브러리가 필요했다. Go의 Templ 라이브러리에서 영감을 받아 Zig용 템플릿 라이브러리 zt를 개발했다. zt는 템플릿을 빌드 시간에 Zig 코드로 변환하므로 모든 매개변수가 컴파일 타임에 타입 체크된다. 전체 요약 10문장 읽기 → 092 12:11 ▲ 49 · 댓글 2 장시간 프로그램 작성을 학습하는 AI 에이전트 프레임워크 공개 코딩 에이전트가 처음부터 완전한 프로그램을 작성하도록 학습할 수 있는 체계가 부족한 상황에서, 연구팀이 ProgramGym 프레임워크를 공개했다. AI · 머신러닝 · ProgramGym: Scaling Training Environments for Long-Horizon Program Reproduction Agents
Key Point 프로그램을 처음부터 작성하는 에이전트 개발에 필수적인 대규모 검증 환경과 실용적인 워크플로우를 처음 공개하는 것으로, AI 코딩 보조 도구의 자율성 수준을 한 단계 높이는 사례를 보여준다.
핵심 요약
코딩 에이전트가 처음부터 완전한 프로그램을 작성하도록 학습할 수 있는 체계가 부족한 상황에서, 연구팀이 ProgramGym 프레임워크를 공개했다. Program-Env는 저장소에서 검증 가능한 학습 환경을 자동으로 구성하며, 샌드박스 실행 오류를 수정하고 테스트 품질을 개선하는 피드백 루프를 활용한다. 이 파이프라인으로 C, C++, Go, Rust 프로그래밍 언어를 포함한 1,648개의 학습 환경을 확보했다. 전체 요약 6문장 읽기 → 093 12:11 ▲ 33 · 댓글 2 재귀적 자기개선 프레임워크로 코드부터 신약까지 성능 지속 개선 RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. AI · 머신러닝 · RSI-Anything: Unlocking Recursive Self-Improvement with World Models
Key Point 기존 외부 피드백 없이 정책이 스스로 개선되는 자기개선 프레임워크가 코드 수리부터 신약 발견까지 다양한 분야에서 실질적 성능 향상을 입증했기 때문이다.
핵심 요약
RSI-Anything은 JEPA-Anything 기반의 도메인 범용 프레임워크로, 예측 세계 모델을 사용해 행동과 학습 데이터 선택을 안내한다. 정책 진화 중 세계 모델 예측의 신뢰성 저하 문제를 해결하기 위해 관찰된 피드백을 통해 정책이나 워크플로우 개선과 조건부 세계 모델 적응을 진행한다. 성분·호환성 검사를 통해 업데이트된 정책-모델 쌍의 유지 여부를 결정한다. 전체 요약 8문장 읽기 → 094 00:10 ▲ 164 · 댓글 93 README를 실제 사용자에게 검증받다 개발자들은 문서 작성을 제대로 하지 않는데, 저자는 ActivityBot README 작성 시 실제 사용자 피드백을 받기로 결심했다. 오픈소스 · 도구 · I paid people to try and follow my README
Key Point README 개선의 핵심은 LLM 시뮬레이션이 아닌 실제 사용자의 음성 피드백이며, 사소한 비용으로 문서 품질을 근본적으로 향상시킬 수 있다.
핵심 요약
개발자들은 문서 작성을 제대로 하지 않는데, 저자는 ActivityBot README 작성 시 실제 사용자 피드백을 받기로 결심했다. NLnet 그랜트 지원 과정에서 €25의 보수를 지급하기로 약속한 후 마스토돈에서 모집한 사람들과 화상 통화를 진행했다. 테스트 방식은 단순했는데, 자원자가 화면을 공유하며 실시간으로 README를 따라하면서 무엇을 이해하지 못했는지, 뭐가 혼란스러웠는지 말하도록 했다. 전체 요약 8문장 읽기 → 095 21:11 ▲ 156 · 댓글 41 LineageOS 24.0 공개, Android 17 기반으로 빠르게 적용 LineageOS가 Android 17 기반 24.0 버전을 공개했으며, 6월 Android 17 공개 후 이전 세대의 대규모 리팩토링 대비 예상보다 빠르게 재구성을 완료했다. 인프라 · 데브옵스 · LineageOS 24.0
Key Point Linux 커널 4.4/4.9 기기 지원을 조건부로 축소하고 베어메탈 x86_64까지 지원하는 등 플랫폼의 복잡도를 줄이면서 개발자 경험은 개선한 구체적인 전략이 담겨 있다.
핵심 요약
LineageOS가 Android 17 기반 24.0 버전을 공개했으며, 6월 Android 17 공개 후 이전 세대의 대규모 리팩토링 대비 예상보다 빠르게 재구성을 완료했다. 2025년 8월부터 2026년 10월까지의 보안 패치가 18.1~24.0에 병합되었고, 레거시 브랜치(15.1, 16.0, 17.1)도 2025년 11월 보안 패치까지 적용되었다. Canvas 이미지 편집기, Catapult TV 런처, Etar 달력 등 주요 앱들이 Material Design 3로 업데이트되었으며, Updater는 A/B 파티션 기기에서 스트리밍 방식으로 설치해 설치 시간을 단축했다. 전체 요약 12문장 읽기 → 096 15:11 ▲ 105 · 댓글 48 AI가 5개월에 완성한 Db2 마이그레이션 기능, 인간은 9개월 소요 Cockroach Labs는 MOLT 데이터베이스 마이그레이션 도구에 IBM Db2 소스 지원을 추가했는데, 이 작업을 AI 에이전트들이 2일 만에 완료했다. AI · 머신러닝 · Five months treating bugs like patients and coding agents like a medical team
Key Point 의료 시스템 모델로 AI 코드 작성의 품질 문제를 해결하고 기존 9개월 작업을 2일로 단축한 구체적 사례로, AI 코드 자동화의 실무적 가능성과 제약을 보여준다.
핵심 요약
Cockroach Labs는 MOLT 데이터베이스 마이그레이션 도구에 IBM Db2 소스 지원을 추가했는데, 이 작업을 AI 에이전트들이 2일 만에 완료했다. Oracle 지원 추가는 인간 엔지니어가 9개월, 약 16만 달러를 들였지만, Db2 지원은 에이전트가 비용 4,172달러에 완료했다: 164배 빠르고 38배 저렴했다. 작업 자동화를 위해 'MOLT Sinai'라는 '코딩 병원' 시스템을 구축했다: GitHub 이슈를 환자로, 병합을 퇴원으로 부르는 의료진 비유 모델이다. 전체 요약 16문장 읽기 → 097 03:11 ▲ 14 · 댓글 2 긴 작업 추적하는 AI 코딩 어시스턴트 비평가 'Opera' 공개 장시간 코딩 작업을 수행하는 에이전트가 피드백을 받아도 실제로 문제가 해결되지 않는 경우가 많다. AI · 머신러닝 · Opera: A Verbal Critic Framework for Long-horizon Coding Agents
Key Point AI 코딩 에이전트의 가장 큰 약점인 '피드백을 받아도 실제 문제가 풀리지 않는' 현상을 근본적으로 진단하고 추적하는 방식이 소프트웨어 공학 벤치마크 전체에서 최고 성능을 기록했습니다.
핵심 요약
장시간 코딩 작업을 수행하는 에이전트가 피드백을 받아도 실제로 문제가 해결되지 않는 경우가 많다. Opera는 각 수정을 지속적인 기록으로 관리하며, 진단된 문제가 실제로 해결될 때까지 추적하는 AI 비평가 프레임워크다. 주기적·이벤트 기반 검토 트리거, 타입화된 연산자를 통한 문제 진단, 전달 전 증거 기반 감시, 피드백 이후 에이전트 행동 추적이 핵심이다. 전체 요약 8문장 읽기 → 098 12:11 ▲ 113 · 댓글 56 AI로 400년 기록 검색해 잊힌 운석·멸종 코뿔소 재발견 소프트웨어 엔지니어가 AI 에이전트를 활용해 400년분 역사 기록 435만 페이지를 12시간 만에 검색해 새로운 발견들을 찾아냈다. AI · 머신러닝 · Pointing AI at archives found a forgotten meteorite, lost rhinos, and more
Key Point 공개 기록 검색에서 AI 에이전트가 개인 연구자에게 어떤 스케일의 발견을 가능하게 하는지 보여주며, 구체적인 발견들과 검증 과정이 역사 연구의 미래를 시사한다.
핵심 요약
소프트웨어 엔지니어가 AI 에이전트를 활용해 400년분 역사 기록 435만 페이지를 12시간 만에 검색해 새로운 발견들을 찾아냈다. 검색 파이프eline은 먼저 각 문단을 의미의 수학적 지문으로 변환한 후 'System One' 모델인 Jev로 초기 필터링하고, Claude Haiku로 정밀 검토한 후 Claude Code 에이전트가 원문 스캔으로 검증하는 3단계 구조다. 1812년 인도 판드하르푸르에서 떨어진 운석 기록을 자바신문 재게재판을 통해 발견했으며, 이는 마하라슈트라의 가장 오래된 운석 낙하 기록(기존 최고 기록보다 26년 앞)으로 6개 목록에는 수록되지 않았다. 전체 요약 12문장 읽기 → 099 09:11 ▲ 106 · 댓글 243 Tor 프로젝트, Mullvad와의 관계 유지하되 경계 설정 Mullvad 공동창립자의 정치 기부금을 둘러싼 논란 이후 Tor 프로젝트는 Mullvad와의 관계를 완전히 종료하지 않기로 결정했다. 보안 · A statement on the Tor Project's relationship with Mullvad
Key Point 프라이버시 운동과 기업 협력 사이의 윤리적 긴장이 어떻게 해결되는지를 보여주는 투명한 의사결정 사례로, 기술 커뮤니티가 원칙과 실용성을 어떻게 균형 맞추는지 드러난다.
핵심 요약
Mullvad 공동창립자의 정치 기부금을 둘러싼 논란 이후 Tor 프로젝트는 Mullvad와의 관계를 완전히 종료하지 않기로 결정했다. Tor 커뮤니티 일부는 인권 미션과 회사와의 협력을 양립시킬 수 없다며 관계 종료를 촉구했으나, Tor 팀은 기술 협력 지속이 장기적으로 사용자 커뮤니티에 이롭다고 판단했다. 의사결정은 커뮤니티 논의, 직원 설문, 재정 분석 등 광범위한 검토 과정을 거쳤다. 전체 요약 8문장 읽기 → 100 09:11 ▲ 125 · 댓글 49 마이크로소프트, 의사결정 특화 AI 모델 공개 마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. AI · 머신러닝 · Microsoft-Decision-1, our model for fast decision-making
Key Point 에이전트 AI가 실제 환경에서 행동하는 지금, 비용 효율적이면서도 빠른 의사결정 AI의 필요성이 높아지고 있으며, 마이크로소프트의 새 모델은 기존 LLM 대비 35배 빠르고 200배 저렴한 성능으로 업계의 선택 기준을 바꿀 수 있다.
핵심 요약
마이크로소프트가 구조화된 의사결정 작업에 특화한 'Microsoft-Decision-1' 모델을 발표했다. 이 모델은 기존 LLM이나 다른 의사결정 모델보다 빠르고 정확하게 라우팅, 분류, 우선순위 결정, 검증, 워크플로우 제어 등을 수행한다. 36개 벤치마크의 15만 개 질문에서 최고 정확도를 달성했으며, GPT-6 Sol보다 4.5배 빠르고 35배 빠른 응답 속도를 기록했다. 전체 요약 13문장 읽기 →