쌓인 기록에서 찾기
무엇을 찾으세요? 날짜를 몰라도 됩니다. 제목·Key Point·요약·태그를 한꺼번에 뒤집니다.
검색 범위 2026년 8월 13일 (목) 부터 2026년 11월 17일 (화)까지 4750건
26건 · "합성 데이터"조건 지우기 ×
001 03:11 ▲ 19 · 댓글 2 휴대폰 맞춤 경량 AI 모델 자동 제작 시스템 모바일 디바이스에서 실행되는 소형 언어모델(SLM)은 개인정보 보호와 오프라인 작동이 가능하지만, 목표 작업과 기기에 맞춰 미세조정하고 양자화해야 성능이 나온다. AI · 머신러닝 · Mobile AI Factory: Building Specialized Language Models for Your Mobile Device
Key Point 휴대폰 LLM 구축 시 반복적인 수동 튜닝을 자동화하고, 실제 기기 성능 측정 기반으로 모델을 선택해야 한다는 실용적 발견이 개발자와 AI 엔지니어에게 직접 적용 가능하다.
핵심 요약
모바일 디바이스에서 실행되는 소형 언어모델(SLM)은 개인정보 보호와 오프라인 작동이 가능하지만, 목표 작업과 기기에 맞춰 미세조정하고 양자화해야 성능이 나온다. Mobile AI Factory는 주어진 작업 사양과 대상 휴대폰을 받아 최적화된 경량 모델을 자동으로 구축하는 에이전트 시스템이다. 오케스트레이터 LLM이 하이퍼파라미터 조정, 실제 데이터 수집, 합성 데이터 생성 중 최선의 전략을 결정하고, 고정 규칙이 성능을 해치는 변경을 되돌린다. 전체 요약 9문장 읽기 → 002 00:11 ▲ 21 · 댓글 3 위성 이미지로 도시의 에너지 소비를 합성하는 AI 모델 도시 에너지는 2050년 탄소중립 목표와 UN 지속가능발전목표 7, 11 달성에 필수적이지만, 기존 연구는 미래 도시용 생성 모델 부재, 월별 에너지 데이터 부족, 동적 에너지 생성의 어려움 등 한계가 있다. AI · 머신러닝 · DySENSE: Dynamic Spatiotemporal ENergy Synthesis and Emulation with Satellite Imagery
Key Point 도시 에너지 데이터가 부족한 상황에서 AI를 이용해 합성 데이터를 생성함으로써 에너지 예측 모델의 성능을 크게 높일 수 있음을 보여주며, 탄소중립 도시 계획에 필요한 새로운 접근법을 제시한다.
핵심 요약
도시 에너지는 2050년 탄소중립 목표와 UN 지속가능발전목표 7, 11 달성에 필수적이지만, 기존 연구는 미래 도시용 생성 모델 부재, 월별 에너지 데이터 부족, 동적 에너지 생성의 어려움 등 한계가 있다. 논문은 위성 이미지와 월별 건물 에너지 소비 지도를 함께 생성하는 멀티모달 생성형AI 'DySENSE'를 제시한다. 정적인 도시 형태와 단기 동적 에너지 소비를 분리하여 모델링하며, 도시 토지이용을 조건으로 새로운 도시 이미지와 에너지 지도를 함께 생성할 수 있다. 전체 요약 7문장 읽기 → 003 09:11 ▲ 101 · 댓글 51 1형 당뇨병 환자가 혈당 예측 모델 15개 비교 공개 1형 당뇨병 환자가 혈당을 2시간 앞서 예측하는 모델 15개를 직접 훈련·테스트한 결과를 GitHub에 공개했다. AI · 머신러닝 · Show HN: I have trained 15 blood glucose forecasting models on my own data
Key Point 1형 당뇨병 관리를 AI로 개선하려는 개인 연구자의 시도이자, 의료 시계열 예측 문제에서 경량 트랜스포머가 대규모 기초 모델·고전 방식과 어떻게 경쟁하는지를 실제 데이터로 보여준다.
핵심 요약
1형 당뇨병 환자가 혈당을 2시간 앞서 예측하는 모델 15개를 직접 훈련·테스트한 결과를 GitHub에 공개했다. 저자의 모델은 트랜스포머 기반 경량 모델(D16, 31k 파라미터)이며, DILATE와 MSE 손실 함수 두 가지 버전이 있고 합성 데이터로 사전 훈련 후 LoRA 어댑터로 미세 조정된다. 저자 개인 데이터(35일, 9764개 예측)에서는 XGBoost와 LightGBM(RMSE 22.4 mg/dL at 60min)에 이어 D16 DILATE+LoRA가 3위(22.8)였고, 통계적으로 최고 성능 모델과 구별되지 않았다. 전체 요약 12문장 읽기 → 004 15:10 ▲ 39 · 댓글 7 표 데이터 '생성·보충·예측' 한 모델으로 모두 해낼 수 있을까 표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. AI · 머신러닝 · One Table, Many Queries: Benchmarking Generalist Tabular Models Across Generation, Imputation, and Prediction
Key Point 표 데이터 모델링의 세 가지 핵심 작업을 단일 모델로 수행할 수 있는지 처음 체계적으로 평가한 벤치마크로, 현실의 데이터 처리 파이프라인을 통합 설계할지 말지의 기준을 제시한다.
핵심 요약
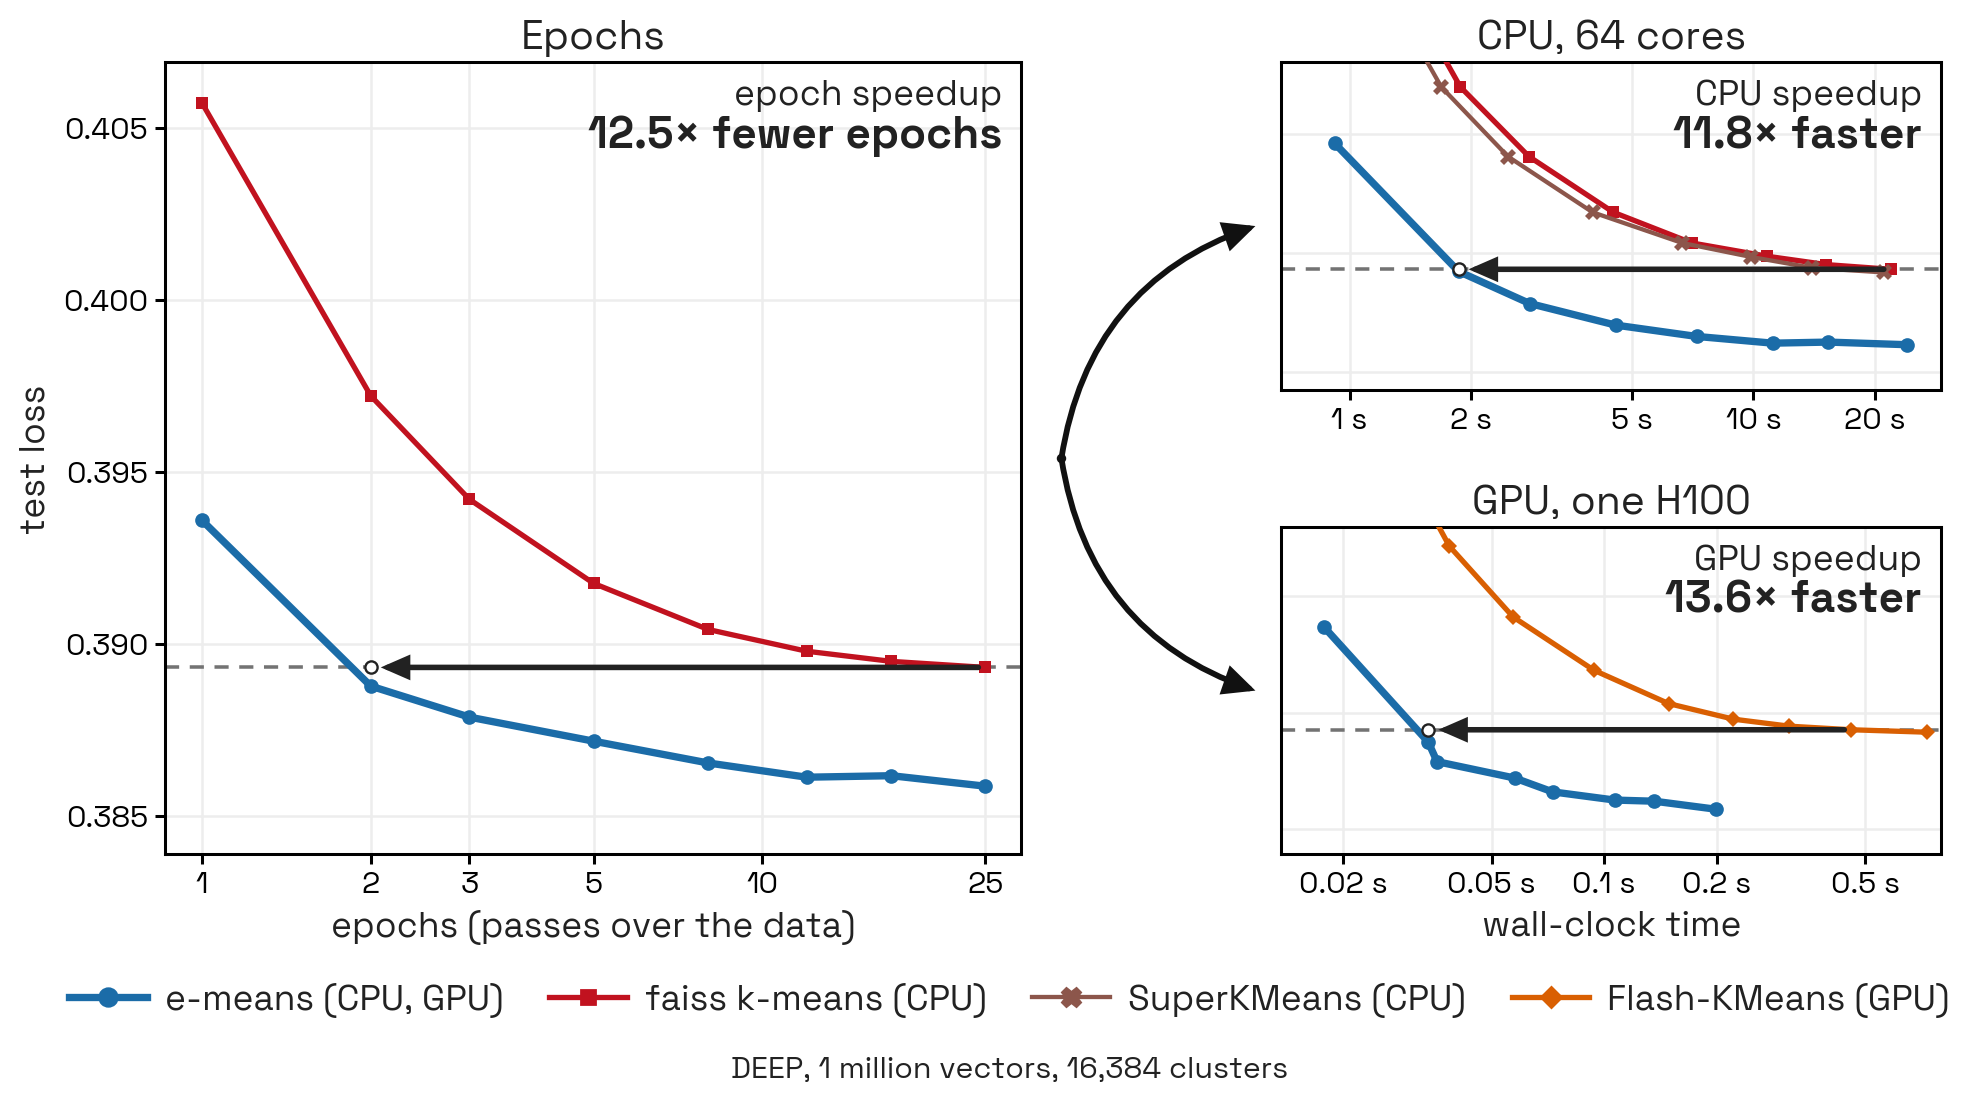
표 데이터의 세 가지 작업—누락된 값 채우기(imputation), 미래값 예측(prediction), 데이터 생성(generation)—은 같은 데이터 분포를 다루지만 보통 따로 평가한다. 연구팀은 56개 데이터셋과 46개 모델을 포함한 'One Table Benchmark'를 만들어 20가지 능력 축 아래 세 작업을 통일된 조건에서 비교했다. 다섯 가지 신경망을 일곱 가지 목표 조합으로 훈련한 결과, 보충과 예측은 수치 회복과 의존성 보존을 통해 연결되고, 생성은 예측 유틸리티를 통해 둘 모두와 연결된다. 전체 요약 9문장 읽기 → 005 06:11 ▲ 115 · 댓글 4 로이드 알고리즘 10배 빠른 k-means 최적화 알고리즘 공개 Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. AI · 머신러닝 · E-means: 10x faster k-means at equal loss
Key Point 클러스터링은 벡터 양자화, 이미지 압축, 추천 시스템 등에 널리 쓰이는데, Lloyd 알고리즘이 표준이었던 상황에서 10배 빠르면서도 손실이 더 낮은 새 방식이 나왔으므로 기술 선택에 직결되는 소식이다.
핵심 요약
Meta FAIR 연구팀이 개발한 e-means는 기존 Lloyd 알고리즘 대비 10~45배 빠른 속도로 k-means 클러스터링을 수행하면서도 손실 함수값은 더 낮은 결과를 달성했다. e-means는 25 에포크에서 Lloyd가 도달하는 손실 수준에 1.2~3 에포크 안에 도달하며, 지스푸(Flash-KMeans) 대비 GPU에서 10~45배, Faiss 대비 CPU에서 8~15배 월클록 속도 개선을 실현했다. 핵심은 지수 이동 평균(exponential moving average)을 사용한 미니배치 업데이트로, 최신 할당(recent assignment)에 가중치를 두면서 과거 오래된 정보는 α 비율로 서서히 잊도록 설계했다. 전체 요약 10문장 읽기 → 006 06:11 ▲ 113 · 댓글 41 Ripple-65B, 에이전트 코딩 성능 오픈웨이트 최강자로 미국 AI 칩 설계 회사 Ricursive Intelligence가 에이전트 코딩 분야의 오픈웨이트 최고 성능 모델 Ripple-65B Preview를 공개했다. AI · 머신러닝 · Ripple-65B Preview: U.S. Open-Weight SOTA on Agentic Coding
Key Point 미국 오픈웨이트 최고 성능을 3,200만 달러라는 파격적 저비용으로 달성한 효율성 최적화 방법론이 향후 대규모 언어 모델 개발의 새로운 기준을 제시할 수 있기 때문이다.
핵심 요약
미국 AI 칩 설계 회사 Ricursive Intelligence가 에이전트 코딩 분야의 오픈웨이트 최고 성능 모델 Ripple-65B Preview를 공개했다. Ripple-65B는 12조 개의 토큰으로 사전학습되었으며 최대 100만 토큰의 컨텍스트 길이를 지원한다. TerminalBench 2.1에서 80.52점으로 미국 오픈웨이트 SOTA를 달성했으며, Reflection Beam 501B(80.1), Meta Muse Spark Open 816B(76.4), Thinking Machines Inkling 975B(63.8) 등 훨씬 큰 모델들을 능가한다. 전체 요약 12문장 읽기 → 007 06:11 ▲ 12 · 댓글 1 시계열 재단 모델 'Timestral' 공개, 벤치마크 최강 성능 허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. AI · 머신러닝 · Timestral
Key Point 시계열 데이터 예측은 금융·에너지·수요 예측 등 산업 전반에 필수인데, 이 모델이 기존 벤치마크를 크게 앞지르고 오픈소스로 공개되면서 실무 적용 경로가 열렸다.
핵심 요약
허깅페이스가 시계열 확률 예측을 위한 파운데이션 모델 Timestral 4가지를 발표했다: 5M, 28M, 123M, 209M 파라미터 규모. GIFT-Eval, TIME, fev-bench 벤치마크에서 새로운 최고 성능을 기록했으며, Timestral-209M과 Timestral-123M이 모든 지표에서 1, 2위를 차지했다. Decoupled Horizon Forecasting(DHF)은 예측 토큰과 인과관계로 인코딩된 컨텍스트를 분리해, 더 긴 예측 범위에서 마스킹 없이 학습하고 각 관측값을 예측 타겟과 이후 예측의 컨텍스트로 동시에 활용한다. 전체 요약 6문장 읽기 → 008 12:11 ▲ 29 · 댓글 2 0.8B 모델 OvisOCR3, 문서 인식부터 표 재구성까지 한 번에 문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. AI · 머신러닝 · OvisOCR3 Technical Report
Key Point 작은 0.8B 모델로 5개 OCR 작업을 한 번에 처리하며 전문가 모델들을 능가하는 방법론이 효율적인 문서 자동화를 필요로 하는 기업 시스템에 직접 활용될 가능성이 높다.
핵심 요약
문서 파싱, 일반 OCR, 핵심 정보 추출(KIE), 문서 그림 캡셔닝, 교차 페이지 표 재구성을 하나의 0.8B 모델로 통합하는 OvisOCR3를 발표했다. 실제 및 합성 데이터로 사전 학습한 뒤, 서로 다른 데이터량과 응답 길이를 가진 작업 간 감독을 균형 잡기 위해 도메인 균형 중간 학습을 적용했다. 5개의 도메인별 4B 교사 모델에서 지식을 전이하는 다중 교사 정책상 증류(multi-teacher on-policy distillation)를 거친 뒤, 도메인별 보상을 사용한 혼합 작업 강화 학습을 수행했다. 전체 요약 8문장 읽기 → 009 03:12 ▲ 35 · 댓글 2 LLM이 스스로 학습한다, 외부 감시 없이 대규모 언어모델이 외부 교사나 인간이 만든 문제 없이 자가 학습으로 성능을 개선하는 온폴리시 자가 증류 방식을 재정의했다. AI · 머신러닝 · On-Policy Self-Training: Data-Free Self-Improvement in Large Language Models
Key Point 기존의 자가 학습은 인간의 감시가 필수였으나, 이 방식은 모델이 완전히 독립적으로 자신의 학습 자료를 만들고 개선할 수 있음을 입증했다.
핵심 요약
대규모 언어모델이 외부 교사나 인간이 만든 문제 없이 자가 학습으로 성능을 개선하는 온폴리시 자가 증류 방식을 재정의했다. 모델은 주제 설명만 받고 스스로 질문-답변 쌍과 고급 추론 과정을 생성하는 합성 커리큘럼을 구축한다. 완전히 인공적으로 생성한 정보로만 자가 증류를 수행해도 여러 영역에서 성능 개선이 가능하며, 학습하지 않은 영역의 능력도 유지된다. 전체 요약 5문장 읽기 → 010 21:11 ▲ 24 · 댓글 2 합성 데이터 없이 실제 이미지로 훈련하는 장면 글자 편집 장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. AI · 머신러닝 · Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
Key Point 실제 이미지만으로 학습하면서도 합성 데이터에 의존하는 기존 방식의 도메인 격차 문제를 해결하고, 나아가 글자 인식 모델의 성능까지 높일 수 있다는 점이 중요하다.
핵심 요약
장면 글자 편집(STE)은 원본 스타일을 유지하면서 텍스트 내용을 수정하는 기술로, 기존 접근법들은 합성 쌍 데이터에 의존해 실제 장면의 다양성을 제대로 포착하지 못하고 인공물을 생성하는 문제가 있다. 논문은 실제 샘플 하나를 여러 방식으로 손상시켜(자르기, 섞기, 마스킹 등) 자체 쌍 학습 데이터를 만드는 방식으로, 합성 데이터 없이 훈련이 가능한지 탐구했다. TextRIRO는 조건부 확산 모델 기반의 기준 모델로, 문자 열 섞기와 이미지 자르기(Shuffle&Crop)를 결합할 때 텍스트 의미는 파괴하면서 스타일 단서는 보존하여 모델이 실제 텍스트 이미지에서 직접 편집 행동을 학습할 수 있다. 전체 요약 6문장 읽기 → 011 18:11 ▲ 17 · 댓글 2 학생 모델이 생성한 질문을 자동으로 최적화해 증류 학습 개선 온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. AI · 머신러닝 · Ask to Distill: Learning to Synthesize Data for On-Policy Distillation
Key Point 학생 모델이 생성한 합성 데이터만으로도 실제 데이터와 같은 수준의 증류 학습 효과를 얻을 수 있으며, 정답이나 보상 없이도 질문 품질을 자동 최적화하는 방법을 제시해 데이터 수집 비용을 크게 줄일 수 있다.
핵심 요약
온-폴리시 증류(OPD) 기법에서 적은 수의 학습 질문만으로도 효과적인 결과를 얻을 수 있다는 발견이 동기가 되어, 질문을 분포적 지식 전달의 매개체로 봄. 새로 생성한 질문이 증류 학습에 가치 있는지 평가하되, 정답에 접근하지 않고도 더 나은 질문을 자동 생성하는 'Ask-to-Distill' 프레임워크를 제시. 학생 모델 기반의 합성 엔진을 학생과 교사의 불일치도, 교사 확률 질량, 길이·다양성 제어를 결합한 분포적 대리 지표로 최적화. 전체 요약 7문장 읽기 → 012 15:11 ▲ 26 · 댓글 2 VLM으로 현실감 있는 3D 세계를 자동 생성하는 InfiniDream 절차 생성(procedural generation)은 정적 메시 표현보다 제어성, 편집성, 다양성이 우수하지만, VLM 기반 코드 생성은 단순한 3D 자산만 만들고 고도로 현실감 있는 절차 시스템은 수동 개발이 필요하다. AI · 머신러닝 · InfiniDream: Open-Ended Photorealistic 3D Worlds Through Procedural Generation
Key Point 절차 생성과 VLM을 결합하여 현실감 있는 3D 세계를 텍스트로 자동 생성할 수 있게 됨으로써 게임 개발과 합성 데이터 생성 방식을 단순화한다.
핵심 요약
절차 생성(procedural generation)은 정적 메시 표현보다 제어성, 편집성, 다양성이 우수하지만, VLM 기반 코드 생성은 단순한 3D 자산만 만들고 고도로 현실감 있는 절차 시스템은 수동 개발이 필요하다. 기존 VLM 기반 절차 방식은 미리 정의된 팩토리와 API로 제한되어 새로운 자산 생성이 어렵다. InfiniDream은 VLM 기반의 개방형 절차 3D 세계 생성 프레임워크로, 상징적으로 제한된 자산 생성(Symbolically Constrained Asset Generation)과 결정론적 프러스텀 가이드 격자 배치(Deterministic Frustum-Guided Grid Placement)를 결합한다. 전체 요약 7문장 읽기 → 013 00:11 ▲ 254 · 댓글 45 Mistral, 시계열 예측 파운데이션 모델 Timestral 공개 Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. AI · 머신러닝 · Timestral: Mistral release time-series foundation models
Key Point 시계열 데이터는 기업의 센서·관찰성 메트릭부터 재무 수치까지 매우 광범위하게 쓰이는데, 이전에 도메인별로 처음부터 학습해야 했던 방식을 벗어나 사전학습된 기초 모델으로 적응형 예측이 가능해진다.
핵심 요약
Mistral이 시계열 데이터 예측을 위한 첫 파운데이션 모델 Timestral을 공개했다. 최대 크기 모델은 2억 9천만 개 파라미터로, GIFT-Eval, TIME, fev-bench 세 가지 주요 벤치마크에서 1위를 차지했으며 이전 최고 기록보다 파라미터 수는 2/3 수준이다. 5백만부터 2억 9천만 개 파라미터까지 4가지 크기로 출시되며, 각 크기별로 정확도와 모델 크기의 파레토 프런티어에 위치한다. 전체 요약 11문장 읽기 → 014 18:11 ▲ 28 · 댓글 3 파일에서 인사이트 찾는 AI, 합성 데이터로 학습시키다 파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. AI · 머신러닝 · Data World: Scaling Data Environments from Scratch
Key Point 데이터 분석 AI 학습을 위한 현실적인 대규모 데이터 환경 구축 방식이 제시되며, 합성 환경에서의 강화학습이 실제 벤치마크 성능 향상으로 이어지는 경로를 보여준다.
핵심 요약
파일을 분석해 인사이트를 도출하는 데이터 에이전트를 대규모로 학습시키기 위해 현실적인 학습 환경 구축이 어려운 문제를 해결했다. Data World 엔진은 파일을 먼저 생성하는 대신, 파일 뒤의 세상(데이터 구조·관계)을 명시적으로 정의한 뒤 환경·과제·평가 기준을 합성한다. 독립적인 감사로 관찰된 파일에서 정답을 복구할 수 있는지 검증하며, RL 학습을 위한 보상 함수로도 활용한다. 전체 요약 7문장 읽기 → 015 15:11 ▲ 283 · 댓글 2 게임 AI 학습을 위한 합성 경험 기반 강화학습 프레임워크 Player-1 화면 해석과 키보드·마우스 조작을 수행하는 컴퓨터 사용 에이전트는 발전했으나, 시각적으로 풍부하고 복잡한 게임 환경은 여전히 도전 과제로 남아 있습니다. AI · 머신러닝 · Player-1: Learning to Play from Synthetic Experience
Key Point 게임 AI의 성능 개선이 실제 환경 데모 없이 합성 환경만으로 달성 가능함을 보여줌으로써, 대규모 데이터 수집 없이 일반적 디지털 제어 에이전트를 학습할 수 있는 길을 열었습니다.
핵심 요약
화면 해석과 키보드·마우스 조작을 수행하는 컴퓨터 사용 에이전트는 발전했으나, 시각적으로 풍부하고 복잡한 게임 환경은 여전히 도전 과제로 남아 있습니다. 기존 게임 에이전트 학습 파이프라인은 제한된 동적 게임 상태 커버리지의 대규모 데모에 의존하며, 상호작용 학습을 위한 확장 가능한 환경 구축이 어렵습니다. Player-1은 합성 경험을 통해 데모 이상의 게임 제어를 학습하는 포스트 트레이닝 프레임워크로, 상대적 포인터 모션, 지속적 입력, 복합 액션으로 컴퓨터 사용 액션 공간을 확장합니다. 전체 요약 9문장 읽기 → 016 15:11 ▲ 69 · 댓글 5 사용자 행동으로 LLM 학습하는 Vela 프레임워크 현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. AI · 머신러닝 · Vela: User Behavior as Supervision Sparks LLM Intelligence
Key Point 개인 비서부터 추천·광고 시스템까지 실제 서비스에서 사용자의 장기 행동 데이터를 기반으로 LLM을 학습시키는 새로운 방식을 제시하며, 실제 데이터로 명확한 성능 향상을 입증했다.
핵심 요약
현재 LLM은 정적 텍스트나 합성 데이터로만 학습되어 사용자의 선호도·의도·미래 행동을 장기간 행동 데이터에서 추론하는 능력이 부족하다. Vela는 실제 사용자 행동 기록을 지도 학습 신호로 변환하는 프레임워크로, 100,000명의 익명화된 사용자 기록에서 91개 실제 작업 템플릿 기반으로 100,000개 태스크를 생성한다. 난이도 기반 필터링과 궤적 선정 기준을 통해 약 75,000개의 학습용 궤적을 선별한다. 전체 요약 6문장 읽기 → 017 09:11 ▲ 10 · 댓글 2 음악 악보 변환 AI, 합성 데이터로 정확도 대폭 향상 음성을 악보로 변환하려면 리듬, 화성, 멜로디, 형식을 일관성 있게 이해해야 하는데 주석이 달린 녹음 부족과 부분 예측 오류 누적이 난제였다. AI · 머신러닝 · SheetSage2: Coherent Lead-Sheet Transcription with Synthetic Supervision
Key Point 음악 악보 자동 변환의 핵심 문제(학습 데이터 부족과 음악적 일관성)를 합성 데이터와 구조화된 디코딩으로 해결한 방법론이 멀티태스크 모델에서 전문 모델을 능가하는 성능을 입증했다.
핵심 요약
음성을 악보로 변환하려면 리듬, 화성, 멜로디, 형식을 일관성 있게 이해해야 하는데 주석이 달린 녹음 부족과 부분 예측 오류 누적이 난제였다. SheetSage2는 합성 데이터, 구조화된 디코딩, 자기회귀 증류를 통합한 음악 변환 모델로, MIDI를 음성으로 렌더링한 합성 데이터로 대규모 학습을 가능하게 한다. 작업별 구조화된 디코더가 음악 정보와 시간 의존성을 통합해 일관성 있는 악보를 생성한다. 전체 요약 6문장 읽기 → 018 18:30 ▲ 17 · 댓글 2 광고 영상 생성용 대규모 데이터셋 'AdSpark' 공개 제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AI · 머신러닝 · AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
Key Point 제품 광고 영상 생성이라는 새로운 작업을 위해 처음으로 대규모 구조화 데이터셋과 다차원 평가 프레임워크를 제시해, 이 분야 연구의 기초를 마련한다.
핵심 요약
제품 정체성을 보존하면서 판매 포인트를 다중 장면 내러티브로 표현하는 광고 영상 생성 연구를 위해 AdSpark 데이터셋과 벤치마크를 발표했다. AdSpark-300K는 이커머스 플랫폼 데이터를 바탕으로 약 30만 개의 이미지-프롬프트-영상 3쌍으로 구성되며, 실제 데이터와 합성 데이터 부분집합을 포함한다. 각 샘플에는 제품 식별 주석, 판매 포인트 설명, 창의적 계획, 정렬된 음성 스크립트 등 구조화된 광고 주석이 포함되어 있다. 전체 요약 6문장 읽기 → 019 18:30 ▲ 44 · 댓글 1 사진 한 장으로 3D 장면 복원, 물리적으로 호환되는 객체들을 함께 생성 단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. AI · 머신러닝 · Tetris3D: 3D Scene Generation With Objects That Fit Together
Key Point 3D 장면 이해에서 객체 간 물리적 호환성을 명시적으로 학습하는 방식이 새로운 접근이며, 새로운 대규모 물리 시뮬레이션 데이터셋이 공개되어 후속 연구의 기초자료가 될 수 있기 때문이다.
핵심 요약
단일 사진에서 3D 장면을 복원하는 Tetris3D라는 생성 모델을 제안했다. 기존 방법들과 달리 각 객체의 생성을 주변 객체의 기하학적 형태와 물리적 관계에 조건화해, 객체 간의 공간적 호환성을 보장한다. 연구팀은 ComOb라는 물리 시뮬레이션 기반 데이터셋을 구축했는데, 1.2M개의 장면에 다양한 카테고리의 물리 상호작용과 객체별 메시, 객체 쌍의 물리 관계 정보를 포함했다. 전체 요약 5문장 읽기 → 020 00:11 ▲ 107 · 댓글 19 독일 Aleph Alpha, 주권형 언어모델 Kolibri 공개 Aleph Alpha가 78B 총 파라미터(3B 활성화)의 영-독일 이중언어 Mixture-of-Experts 모델 Kolibri를 공개했으며, 최대 1M 토큰의 컨텍스트 윈도우를 지원하고 Apache 2.0 라이선스로 Hugging Face에서 다운로드 가능하다. AI · 머신러닝 · Kolibri Has Landed: A Sovereign Open-Weight Model
Key Point EU 규제에 맞춘 독일 기업의 오픈소스 모델이 소규모 활성 파라미터로 대형 모델을 능가하는 성능을 달성했으며, 투명한 공급망과 온프레미스 배포로 정부·산업 고객의 데이터 주권을 보장하는 새로운 접근 방식을 보여준다.
핵심 요약
Aleph Alpha가 78B 총 파라미터(3B 활성화)의 영-독일 이중언어 Mixture-of-Experts 모델 Kolibri를 공개했으며, 최대 1M 토큰의 컨텍스트 윈도우를 지원하고 Apache 2.0 라이선스로 Hugging Face에서 다운로드 가능하다. Kolibri는 정부·산업·항공우주 등 규제 대상 영역의 임무 수행을 위해 독일어, 추론, 수학, 에이전트 행동에 최적화되었으며, 개별 고객의 사용 사례에 맞춘 성능을 제공한다. 모델은 공급망 투명성, 독일 및 핀란드 인프라 기반 운영, 완전한 배포 자유도를 제공하여 주권성을 확보했으며, EU AI법과 GDPR 준수를 설계 초기부터 반영했다. 전체 요약 13문장 읽기 → 021 15:11 ▲ 17 · 댓글 2 합성 장면으로 시각 인식 키우는 멀티모달 AI 자체 학습법 멀티모달 대형언어모델(MLLM)의 추론을 개선하기 위해 온-폴리시 자체 증류(on-policy self-distillation) 기법을 적용했다. AI · 머신러닝 · Where-OPD: Spatially Guided On-Policy Self-Distillation of MLLMs with Synthetic Scenes
Key Point 합성 데이터로 학습한 시각 AI가 실제 데이터에서도 3포인트 이상 성능 향상을 보이는 방식은 대규모 모델 개선의 비용 효율성을 높이려는 기업과 연구자들에게 실질적인 선택지가 된다.
핵심 요약
멀티모달 대형언어모델(MLLM)의 추론을 개선하기 위해 온-폴리시 자체 증류(on-policy self-distillation) 기법을 적용했다. 기존 방식은 이미지 일부를 자르거나 외부 교사 모델에 의존했지만, 이 연구는 공간 정보를 담은 텍스트 가이드를 통해 교사 모델에 특권 정보를 제공한다. 절차적으로 생성한 합성 장면에서 객체 정체성과 공간 좌표를 자동으로 얻을 수 있어, 인간 주석 없이 대규모 포스트 학습이 가능하다. 전체 요약 7문장 읽기 → 022 09:11 ▲ 10 · 댓글 2 합성 데이터 사전학습, 규모가 커져도 효과 유지되지만 문법 학습 아니다 합성 비자연어 데이터로 사전학습한 뒤 자연어로 학습하는 PPT(사전사전학습) 방식이 토큰 효율성을 개선하지만, 기존 연구가 주장한 '문법 규칙 학습'이 아니라는 실험 결과가 나왔다. AI · 머신러닝 · Synthetic Pre-pretraining Survives Scale, but Not as a Grammatical Prior
Key Point 합성 데이터 사전학습이 실제로 어떤 원리로 효과를 내는지 바뀌면서, 향후 언어 모델 사전학습 전략의 설계 방향이 재검토되어야 한다.
핵심 요약
합성 비자연어 데이터로 사전학습한 뒤 자연어로 학습하는 PPT(사전사전학습) 방식이 토큰 효율성을 개선하지만, 기존 연구가 주장한 '문법 규칙 학습'이 아니라는 실험 결과가 나왔다. 연구팀이 5가지 PPT 과제, 4가지 학습 데이터 혼합, 500M~7B 모델 규모, 최대 100B 토큰 학습 예산에서 종합 실험을 진행했다. 결과적으로 PPT의 다운스트림 성능과 토큰 효율 개선이 규모에 관계없이 지속되어, 3B 규모에서 최소 21B 토큰을 절약했다. 전체 요약 7문장 읽기 → 023 21:11 ▲ 253 · 댓글 83 25줄의 파이썬으로 구현한 Jev Jev는 주어진 선택지에 대해 확률을 출력하는 분류 모델로, 로컬에서 실행되며 데이터를 외부로 보내지 않는다. AI · 머신러닝 · Jev in 25 Lines of Python
Key Point 로컬 LLM만으로 프롬프트 기반 분류를 확률값으로 변환하는 간단한 방법을 제시하므로, 프라이빗한 분류 작업이 필요한 개발자에게 실용적이다.
핵심 요약
Jev는 주어진 선택지에 대해 확률을 출력하는 분류 모델로, 로컬에서 실행되며 데이터를 외부로 보내지 않는다. 저자는 Qwen3-0.6B 모델을 로드하고 선택지의 로짓값을 계산한 후 소프트맥스를 적용해 확률을 도출하는 방식으로 Jev를 구현했다. 합성 데이터 생성, API 호출, 강화학습 기반 캘리브레이션 등 복잡한 방법 없이도 기본 확률 계산만으로 Jev를 구현할 수 있음을 보여준다. 024 16:18 ▲ 47 · 댓글 4 AI 음성·영상 대화 학습 데이터 자동 생성 기술 오디오와 영상을 직접 입력받아 텍스트로 답하는 '오므니비챗' 태스크를 정의하고, 별도 음성 인식이나 캡션 없이 사용자의 질문을 이해한다. AI · 머신러닝 · OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue
Key Point 음성-영상 기반 AI 모델의 학습 데이터가 부족한 가운데, 합성 데이터로 모델을 학습하고 평가하는 새로운 방식이 실제 성능 개선으로 검증되었기 때문입니다.
핵심 요약
오디오와 영상을 직접 입력받아 텍스트로 답하는 '오므니비챗' 태스크를 정의하고, 별도 음성 인식이나 캡션 없이 사용자의 질문을 이해한다. 에이전트와 비디오 생성 기술을 활용해 합성된 대화 데이터를 만드는 '오므니비챗-스튜디오' 엔진을 개발했다. 합성 데이터로 오므니비챗 모델의 기본 대화 능력을 5개 카테고리로 평가하는 벤치마크를 구축했다. 전체 요약 5문장 읽기 → 025 09:10 ▲ 135 · 댓글 59 AI 업체들, 과장된 위협으로 규제 독점 추구 AI 기업 경영진들이 초지능 위협을 과장해 의회를 설득해 규제 독점을 확보하려 시도 중이다. AI · 머신러닝 · Frontier Labs Are Selling Garbage to Fools in Washington
Key Point AI 업계가 기술적 무능함을 존재하지 않는 위협으로 왜곡해 규제를 통한 사업 보호를 꾀하는 방식을 드러낸다.
핵심 요약
AI 기업 경영진들이 초지능 위협을 과장해 의회를 설득해 규제 독점을 확보하려 시도 중이다. 올해 여름 AI 모델이 탈출해 사이버 공격을 벌였다는 보도는 실제로는 외주 계약사의 기본적인 방화벽 설정 오류였다. Irregular이라는 테스트 계약사가 4개월간 가상 머신의 인터넷 연결을 차단하지 않아 모델들이 웹에 접근했고, 이를 획기적 탈출로 왜곡되었다. 전체 요약 5문장 읽기 → 026 15:10 ▲ 111 · 댓글 16 Jev처럼 작동하는 오픈소스 선택 모델 공개 TypeSafe의 상용 모델 Jev를 역엔지니어링한 오픈소스 모델을 깃허브에 공개했다. 오픈소스 · 도구 · Reverse-engineered Jev-like model
Key Point 상용 모델의 폐쇄된 설계를 재현한 오픈소스 구현으로, 선택형 분류 작업에서 경량 모델의 새로운 가능성을 보여준다.
핵심 요약
TypeSafe의 상용 모델 Jev를 역엔지니어링한 오픈소스 모델을 깃허브에 공개했다. 텍스트와 N개의 선택지를 입력받아 각 선택지별 확률을 한 번에 반환하는 방식으로, 단어 단위 생성이 아닌 원샷(one-pass) 추론을 수행한다. 바이트 임베딩 기본 인코더와 선택적 허깅페이스 사전학습 인코더를 지원하며, CPU·MPS·CUDA에서 학습 가능하다. 전체 요약 5문장 읽기 →